English · 简体中文

geo-score — 面向 AI 回答引擎的开源可见度评分口径

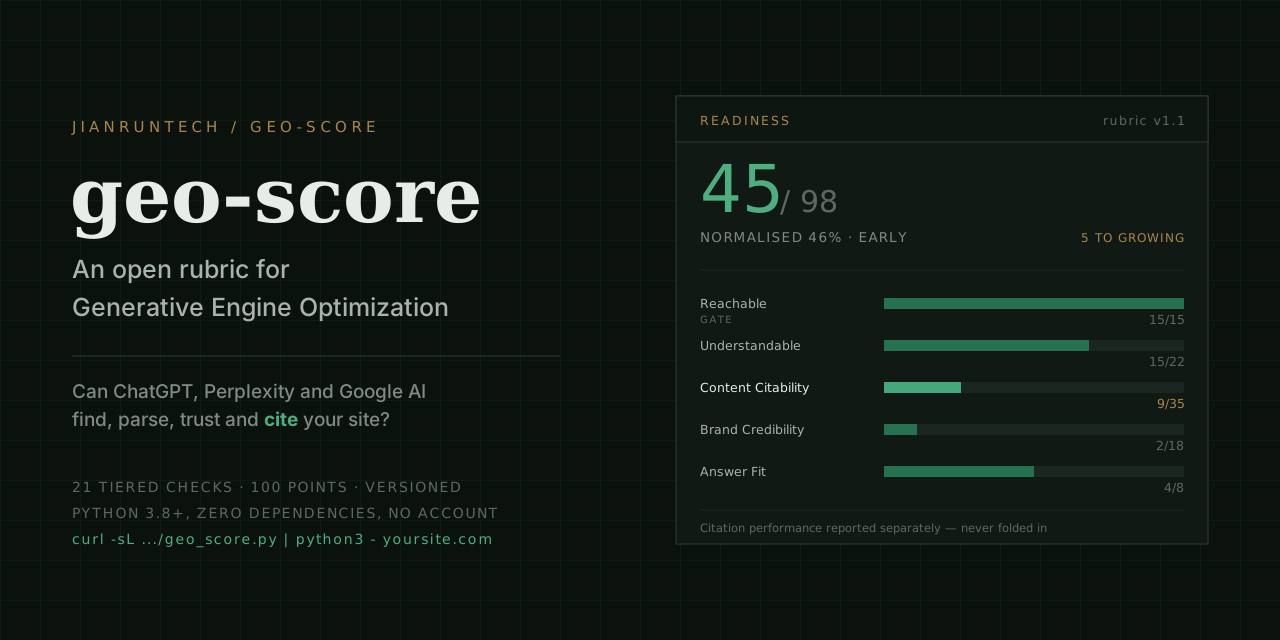
# geo-score geo-score 是开源的网站 AI 可见度(GEO)打分工具,[见润科技](https://www.jianruntech.com)出品。 由 geo-watch 并入(formerly geo-watch):geo-watch 在 1.2.0 并入 geo-score,成为它的第二、三级。 ## 60 秒了解 geo-score 一条命令出 0–100 分,看三道门槛、最该先改的几项,以及为什么每一分都能复核。 https://github.com/user-attachments/assets/95beecee-07c2-4676-9291-ef91c4506a89 *中文介绍 · 60 秒 · [English](README.md#geo-score-in-60-seconds)* --- > **AI 能不能引用你的网站?免费打分,一条命令出结果。有没有引用?用你自己的 API Key 通过各家 API 实测。** geo-score 按一套**公开、带版本号、谁都能复算的评分口径**,给网站打 0–100 分:AI 回答引擎能不能抓到、读懂、信任并引用它。再用你自己的 API Key,把买家会问的问题拿去问各家引擎,记下每条回答引用了谁。打分免费、什么都不用装;引用结果和分数并列报告,从不加进分数。 [快速开始](#快速开始) · [界面预览](#界面预览) · [查什么](#查什么) · [准不准](#准不准) · [文档](#文档) · [更新日志](CHANGELOG.zh-CN.md) · [公开榜单](https://www.jianruntech.com/leaderboard/zh) [![License: MIT](https://img.shields.io/badge/License-MIT-1E5C46.svg)](LICENSE) [![Rubric v1.1](https://img.shields.io/badge/rubric-v1.1-A9854C.svg)](rubric/v1.1.zh-CN.md) [![No dependencies](https://img.shields.io/badge/dependencies-none-1E5C46.svg)](cli/geo_score.py) [![Claude Code Skill](https://img.shields.io/badge/Claude%20Code-skill-blue.svg)](SKILL.md) [![MCP server](https://img.shields.io/badge/MCP-server-A9854C.svg)](#mcp-服务) [![PRs welcome](https://img.shields.io/badge/PRs-welcome-brightgreen.svg)](.github/CONTRIBUTING.md) [![榜单页的 AIV 就绪度,2026-10-05 用 geo-score 1.8.0 测得](docs/aiv-badge.svg)](https://www.jianruntech.com/leaderboard/zh) [![PyPI](https://img.shields.io/pypi/v/geo-score?color=1E5C46)](https://pypi.org/project/geo-score/) [![Latest release](https://img.shields.io/github/v/release/jianruntech/geo-score?display_name=tag&color=A9854C)](https://github.com/jianruntech/geo-score/releases/latest) > **版本说明:** 当前发布版是 [PyPI](https://pypi.org/project/geo-score/) 上的 `geo-score==1.8.3`,对应的标签、wheel 包和校验文件在 [GitHub Releases](https://github.com/jianruntech/geo-score/releases),改了什么见[更新日志](CHANGELOG.zh-CN.md)。本页所有安装行都钉在这个发布版上(`scripts/release.py --bump` 会一起改),你跑的工具就是这些文档描述的那一个。量表单独编版本号,当前是 v1.1。main 可能比发布版超前:CI 和客户项目请用钉住的发布版。 --- ## ❤️ 赞助 > [想出现在这里?](mailto:hello@jianruntech.com) · 赞助不影响量表、任何分数、公开榜单,也不影响文档里的技术建议。
点击收起
CCSub 感谢 CCSub 赞助本项目!CCSub 是一个 AI API 中转平台:一个 API Key 即可使用 Claude、GPT、Gemini、DeepSeek 等模型,兼容 Claude Code、Codex、Cursor 等编程工具。通过此链接注册。
赞助方没有做过 geo-score 引用测量(第二、三级)的兼容测试:引用测量需要各家引擎自己的联网 API,中转平台不一定原样传递联网搜索和引用。
## 解决什么问题 > **GEO 指的是生成式引擎优化**——让 ChatGPT、Perplexity、Google AI Overviews、 > Gemini、Copilot 引用你。与地理、地图无关。 AI 回答引擎引用的,是它抓得到、读得懂、信得过的来源里的段落。一个站被漏掉,原因往往很小,在浏览器里也看不出来:`robots.txt` 里一行把检索爬虫挡在门外、正文要等 JavaScript 跑完才出现、数据没有出处。geo-score 找出一个站有哪几处问题、每一处值多少分,再看各家引擎到底引不引用它,分三级: > **打分**(免费,不要 Key)→ **实测**一个问题(你的 API Key)→ 每周**追踪**一组问题(你的 API Key)。 ### 一个工具,三级用法 | 级 | 回答什么 | 需要什么 | 命令 | |---|---|---|---| | **1 · 打分** | AI 引擎能不能抓到、读懂、信任并引用这个站?按公开量表打 0–100 分(就绪度) | 什么都不要:不要 Key,不用安装 | `geo_score.py stripe.com` | | **2 · 实测** | 就你关心的那个问题,AI 现在引不引用它? | OpenAI、Perplexity、Gemini、Anthropic、OpenRouter 任意一家的 API Key | `geo_score.py stripe.com --ask "payments API for marketplaces"` | | **3 · 追踪** | 你被引用的频率、输给了哪些竞品和来源、每周怎么变? | 你的 API Key 和一组固定问题 | `geo_score.py watch run` | ```mermaid flowchart LR S[你的网站] --> L1["第一级 · 打分
免费,不要 Key"] L1 --> R["0–100 就绪度
五个支柱 · 三道门槛 · 最大缺口"] Q[买家会问 AI 的问题] --> L2["第二级 · 实测
一个问题,你的 API Key"] Q --> L3["第三级 · 追踪
一组固定问题,每周一次"] L2 --> C["回答引用了谁
你 · 竞品 · 第三方页面"] L3 --> C R -. 并列报告,从不相加 .- C ``` 第一级就是这 100 分。第二、三级测的是量表有意不计分的那部分结果([两个分数,不要混在一起](rubric/v1.1.zh-CN.md#两个分数不要混在一起)): 单独报告,从不加进 100 分。就绪度 90 分的站,照样可能每条回答都输给第三方报道更多的竞品;反过来也会发生,所以两样都要看。 ### 这和 SEO 问的不是同一个问题 传统 SEO 问「我排第几」。回答引擎不排名——它检索段落、判断这个来源值不值得引用、 然后引用它。问题不同,失效方式也不同:一个站可以在 Google 排第 3 却从不被引用。 因为引擎检索的是段落,这套量表给「内容可被引用」的权重最高。这是设计上的取舍, 不是测出来的效应:段落形态到底有多大作用,证据还很薄, [证据表](rubric/evidence-v1.1.zh-CN.md#证据最薄的几项)写明了薄在哪里。 这套量表查的东西,**大部分是机械的、改起来很便宜**——一行 `robots.txt`、 一个 JSON-LD 块、模板里的一个日期、把一段话改写成能独立成立的样子。 难的是知道自己缺了哪几项,以及每一项值多少分。 从这里开始的两篇指南:[ChatGPT 能不能读到你的网站?](guide/chatgpt-access.zh-CN.md),先手工查、再用 geo-score 查; 以及 [geo-score 和通用 AI SEO 技能有什么不同](guide/vs-ai-seo-skills.zh-CN.md)。 --- ## 界面预览 每张图都是真实输出,为这一页截取。
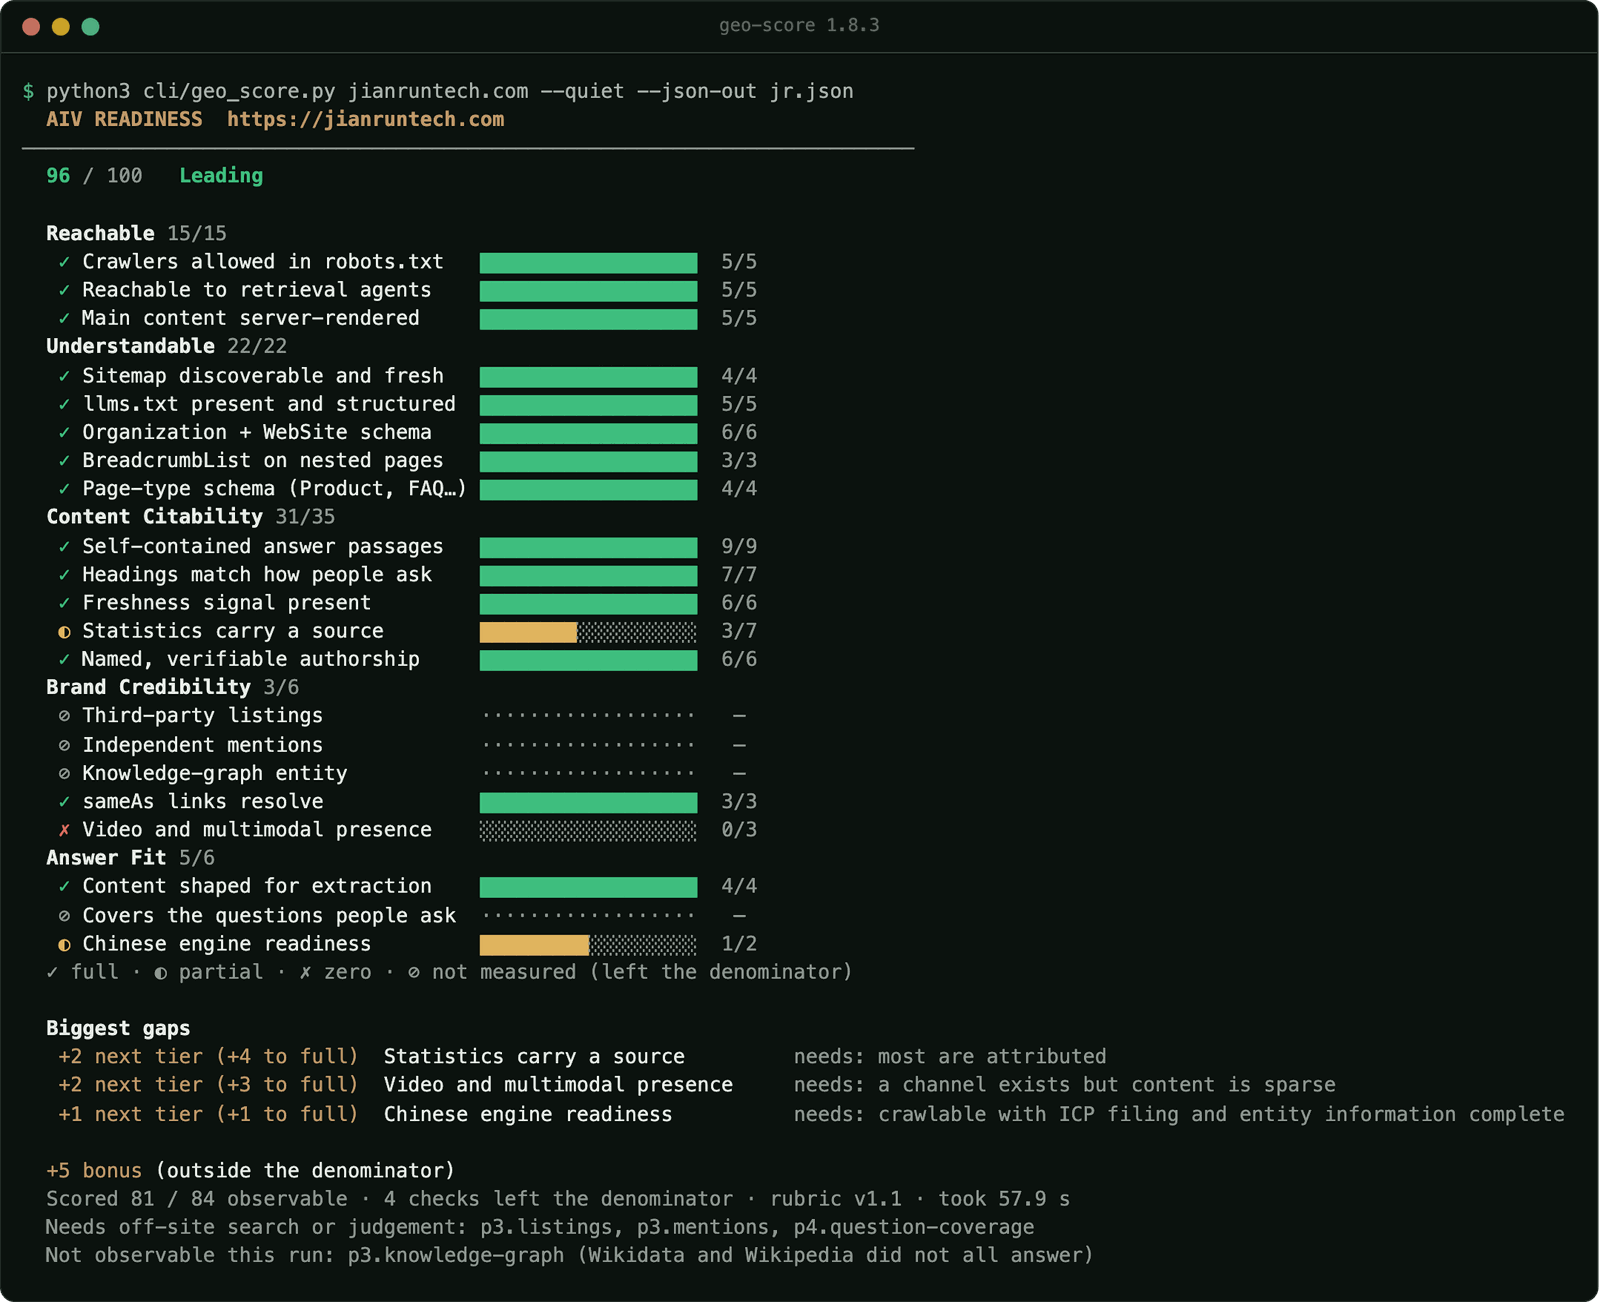
geo-score 1.8.3 在终端给 jianruntech.com 打分:96/100,档位 Leading,每一项检查的档位和三个最大缺口
终端里的第一级。geo_score.py jianruntech.com(维护者自己的网站),2026-10-17 用 geo-score 1.8.3 实跑,输出按终端原样配色渲染成图。截到「分数之外」的观察之前。
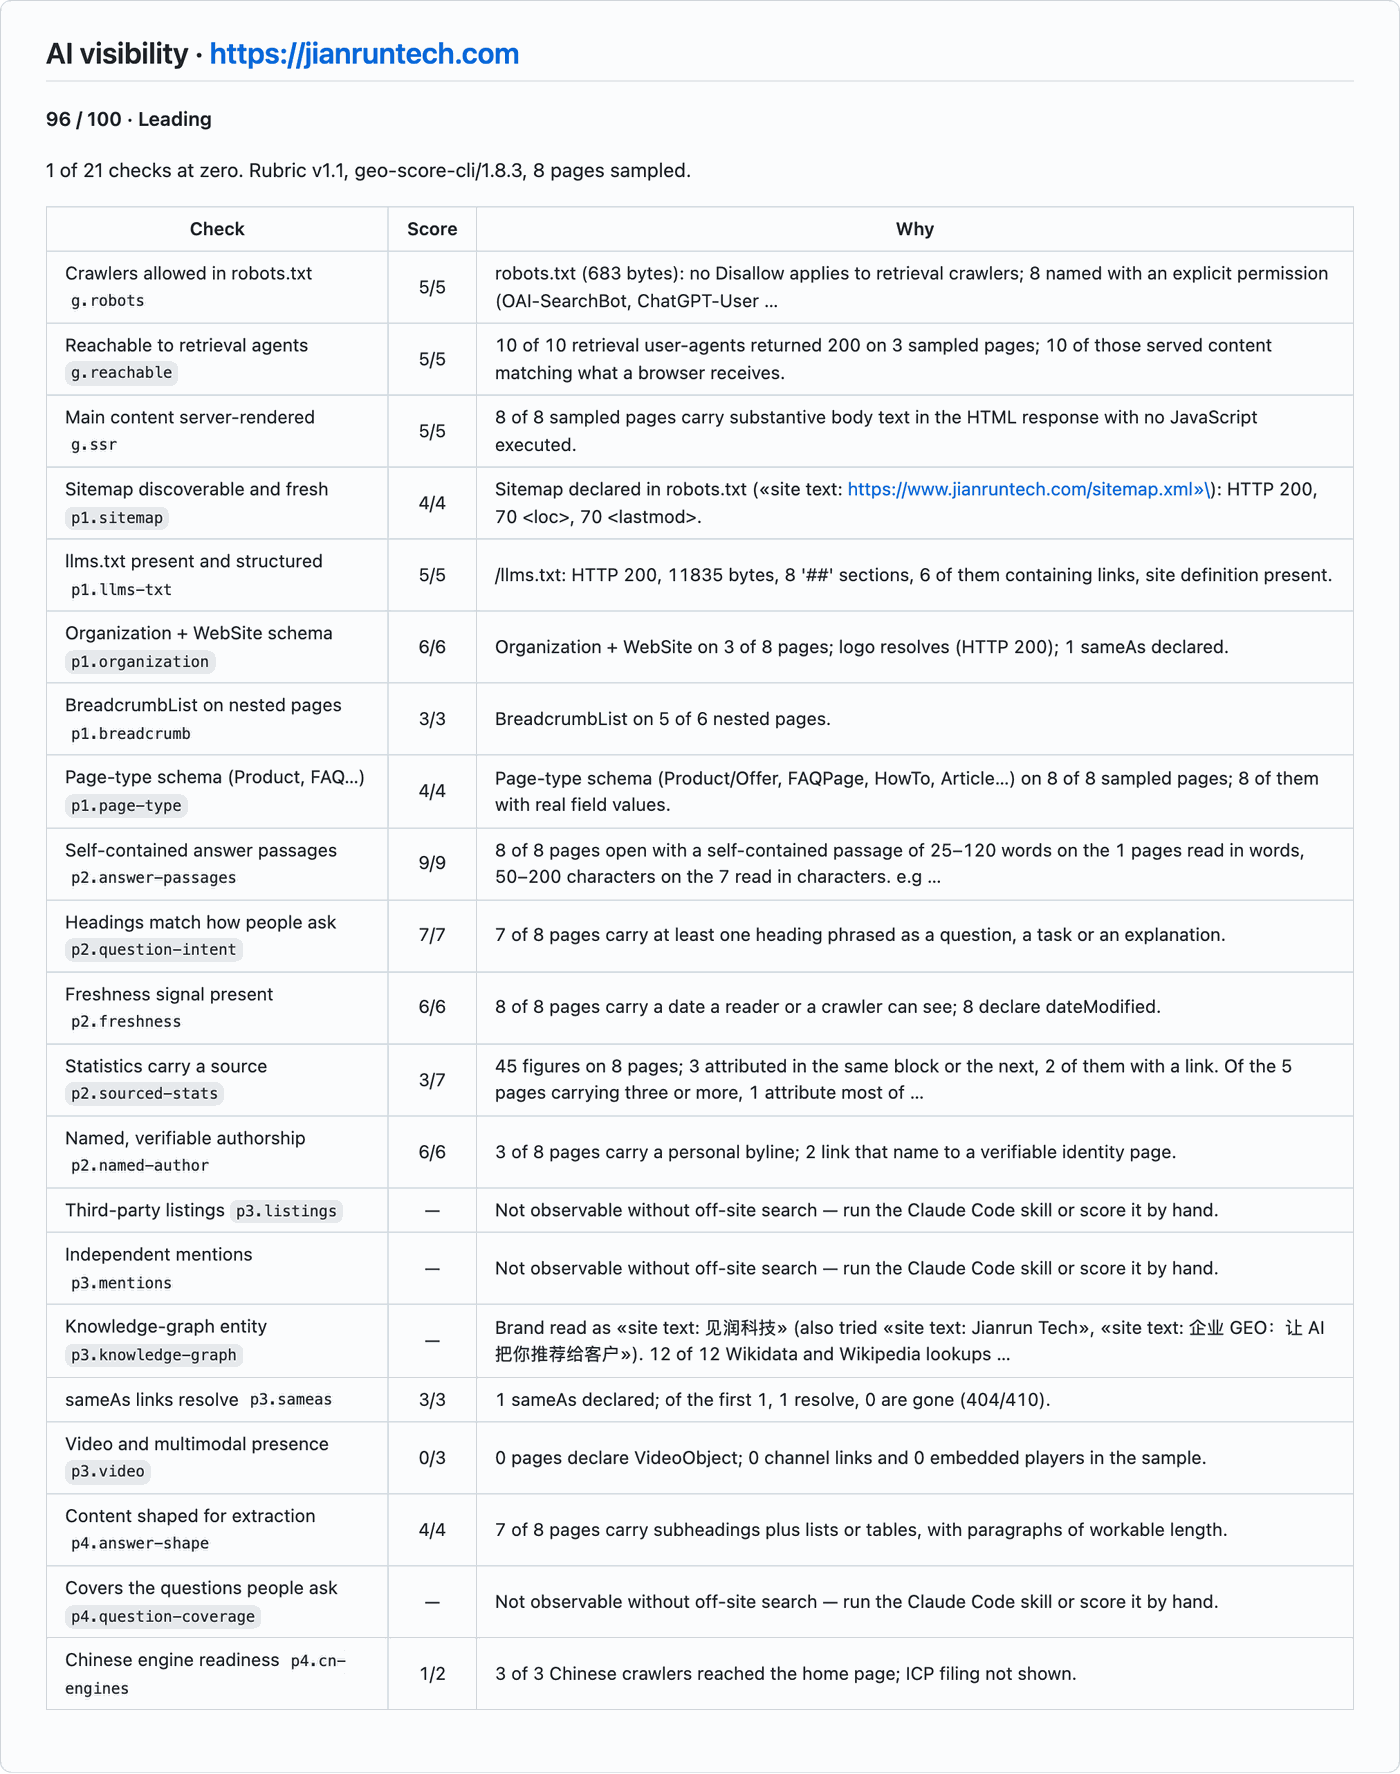
geo-score GitHub Action 写出的任务摘要:分数、档位,以及 21 项检查逐项的证据
GitHub Action 的任务摘要,对应同一份报告:action/summary.py 写出的 Markdown,经 GitHub 的 Markdown 接口渲染。截到检查项表格为止。
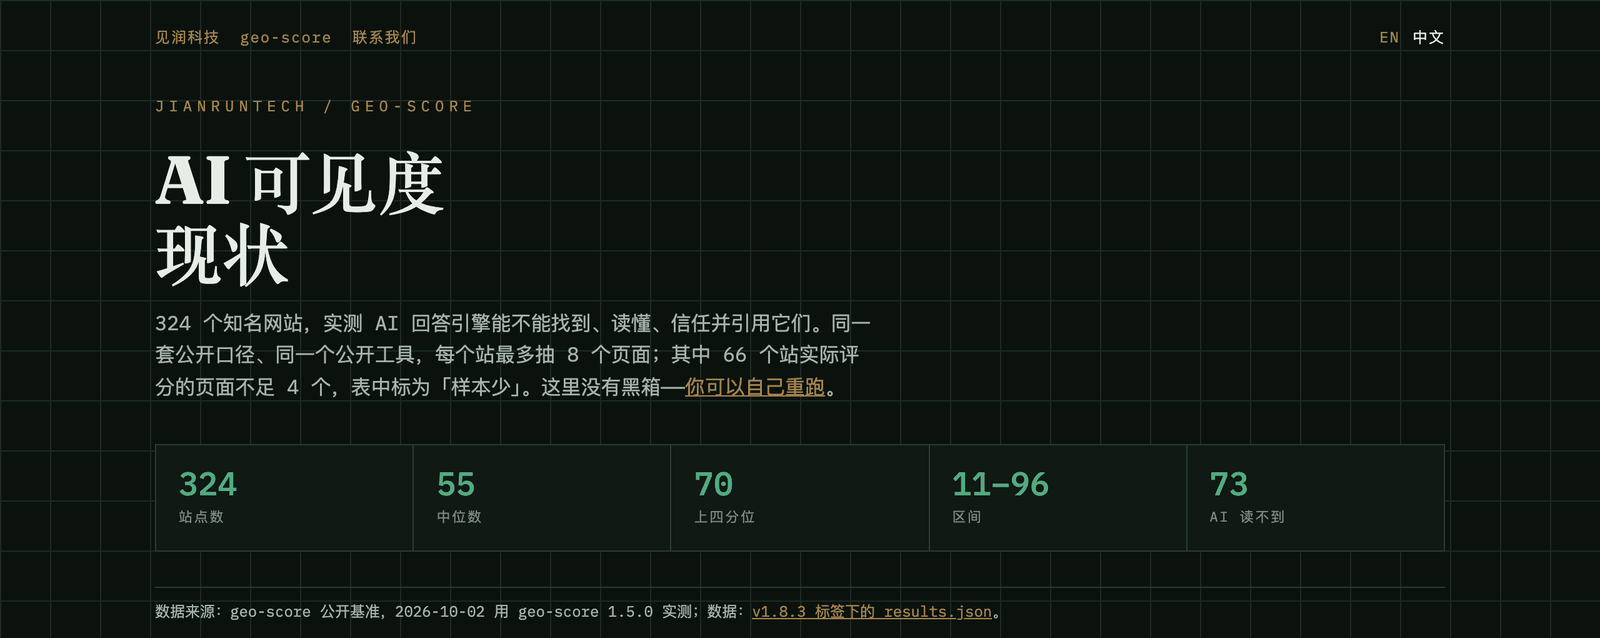
公开榜单页:324 个站点,中位数 55,上四分位 70,区间 11–96,73 个站 AI 读不到
公开榜单,2026-10-17 截取。页上的数字来自 2026-10-02 用 geo-score 1.5.0 跑的那一轮。
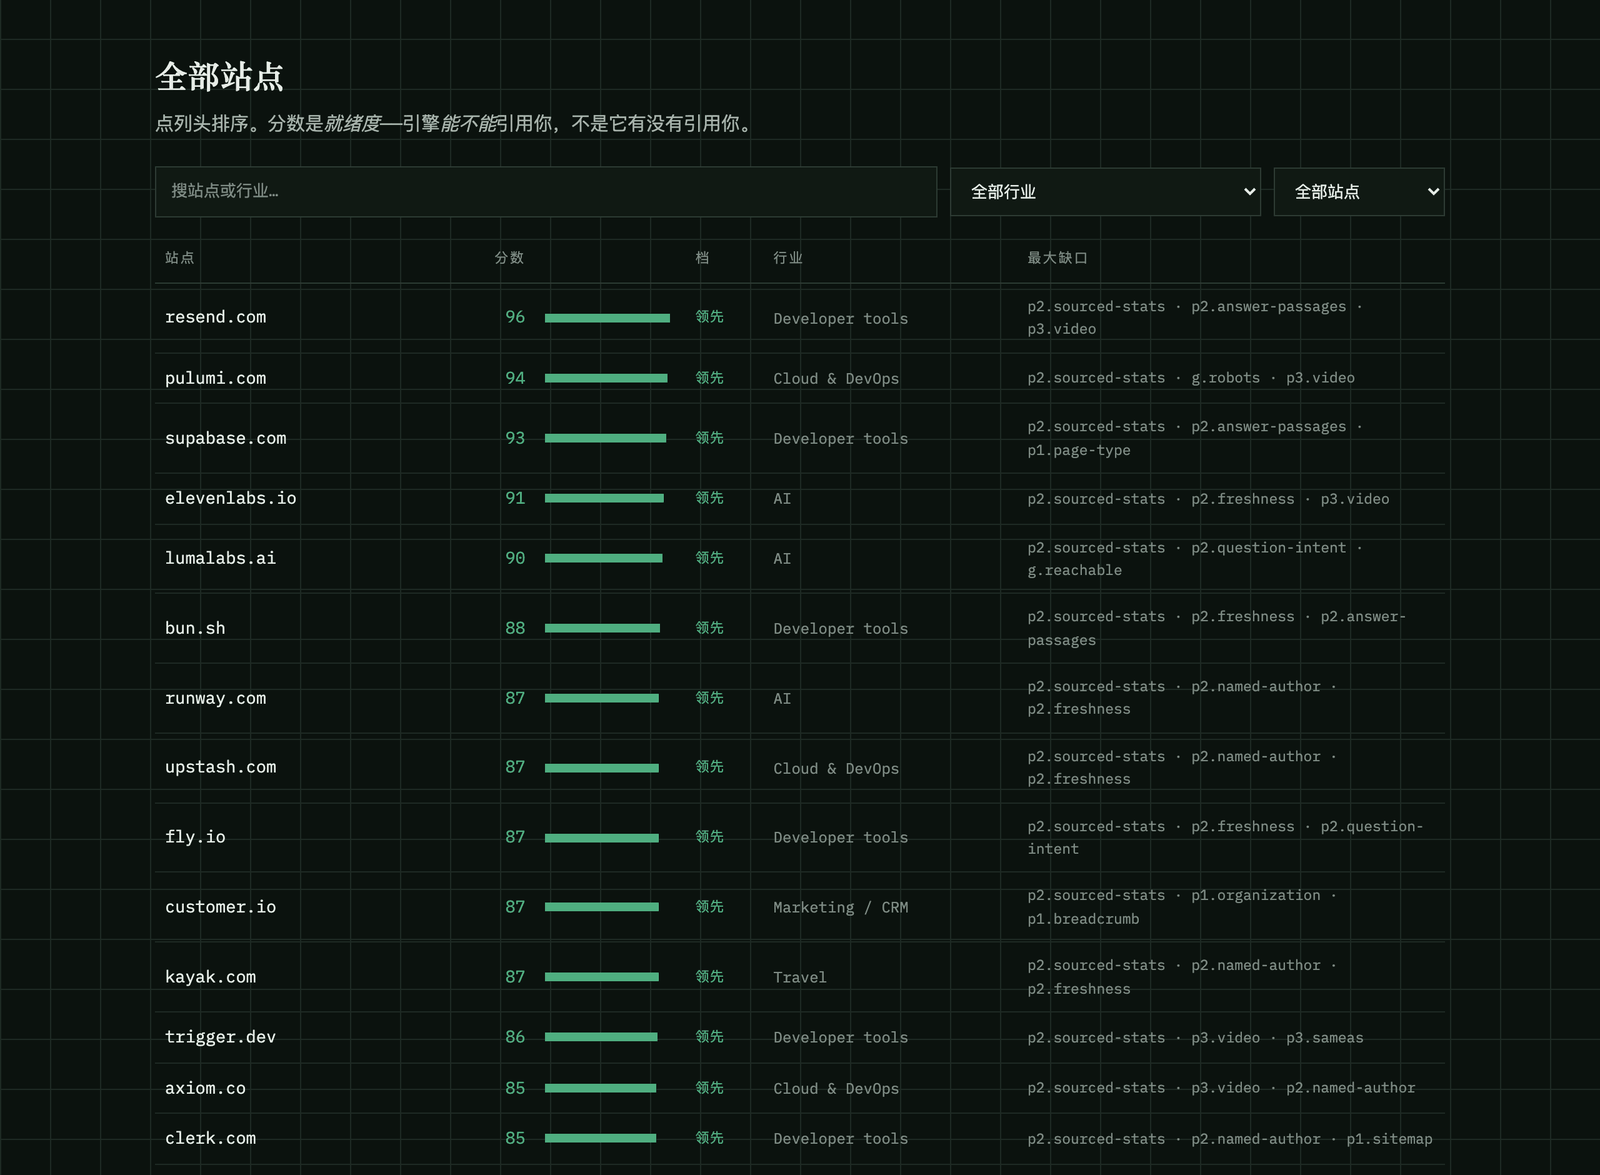
榜单的全部站点表:分数、档位、行业,以及按检查项 id 列出的三个最大缺口
榜单上的每一个站,可排序,带档位、行业和按检查项 id 列出的三个最大缺口。同一页,同一次截取。
--- ## 核心能力 | 能力 | 做什么 | 详见 | |---|---|---| | **打分**(第一级) | 五个支柱共 21 项阶梯式检查、三道门槛,最大缺口排在前面,并写明下一档要什么。单文件、只用标准库、不要 Key | [查什么](#查什么) | | **实测**(第二级) | 用你的 Key,通过 ChatGPT、Perplexity、Gemini、Claude 带联网搜索的 API 问一个问题,报告每条回答引用了谁 | [第二、三级](#第二三级--ai-到底有没有引用你) | | **追踪**(第三级) | 一组固定问题,按周对比:带 95% 区间的被引用率、声量份额、引擎倚重的来源,以及只有配对检验认定才算「有变化」的 `diff` | [watch 方法说明](guide/watch-methodology.zh-CN.md) | | **报告与对比** | 文本、符合公开 schema 的 JSON、SARIF、JUnit;`diff` 逐项比较两份报告,`--baseline` 重评同一批页面 | [CLI 说明](cli/README.zh-CN.md) | | **MCP 服务** | 三级都做成 Agent 能调用的工具(stdio);加 `--read-only` 就花不了钱 | [MCP 服务](#mcp-服务) · [guide/mcp.zh-CN.md](guide/mcp.zh-CN.md) | | **GitHub Action** | 每次 push 都打分,退步或门槛项得 0 分时让构建失败,并写一份任务摘要 | [GitHub Action](#github-action) · [action.yml](action.yml) | | **徽章** | 可选的 SVG 或 shields.io endpoint JSON,带分数和档位;从不影响分数,也不影响榜单位置 | [徽章](cli/README.zh-CN.md#给自己的-readme-加一枚徽章) | | **Claude Code 技能** | CLI 之外,再做需要站外检索或人工判断的那三项 | [Claude Code 技能](#claude-code-技能) · [SKILL.md](SKILL.md) | --- ## 查什么 21 项阶梯式检查合计 100 分,另有 4 项加分检查、不进分母、最多 +6。 完整规范:**[rubric/v1.1.zh-CN.md](rubric/v1.1.zh-CN.md)** · [English](rubric/v1.1.md) | 支柱 | 分值 | 在问什么 | |---|:-:|---| | **可被抓取** —— *门槛* | 15 | 检索爬虫拿不拿得到这一页?`robots.txt`、10 个 AI UA 的实测可达性、正文是否服务端渲染 | | **可被理解** | 22 | 它能不能看懂这是什么页、你是哪家公司?`Organization` + `WebSite`、`llms.txt`、sitemap、面包屑、页型 schema | | **内容可被引用** | **35** | 这里有没有值得引用的东西?自足答案段、标题是否匹配人的提问措辞、数据带出处、真实署名、时间信号 | | **品牌可信** | 18 | 引擎凭什么信你?知识图谱实体、第三方收录、可解析的 `sameAs`、视频存在 | | **问答适配** | 10 | 内容的形态便不便于被摘进一个答案? | 内容可被引用权重最高是设计上的取舍:回答引擎检索的是**段落**,不是域名。 段落形态是否比域名权威更起作用,并没有定论:分值最高的单项 `p2.answer-passages` 支撑偏弱 (见[证据最薄的几项](rubric/evidence-v1.1.zh-CN.md#证据最薄的几项))。 **每个计分项都是阶梯给分**——2 到 4 档,每一档写的是 8 个抽样页里的具体页数, 所以两个人给同一个站打分,在算术上不会有分歧。**其中三项是门槛**: 爬虫可达性、实测可达、服务端渲染,任一项得 0 分则总分封顶 40—— 因为在爬虫拿不到内容之前,其余各项的改动都不会产生效果。 ### 分数段 | 0–30 | 31–50 | 51–65 | 66–82 | 83–100 | |:-:|:-:|:-:|:-:|:-:| | 未起步 | 起步期 | 成长期 | 基础扎实 | 领先 | 档名描述的是**所处阶段,不是判决**。外部基准显示多数商业网站落在 30–55 之间, 所以四十几分是常态,不是警报。本仓库自己的基准榜单里,324 个站中 85% 达到起步期,6% 达到领先 ([档位线落在哪里](benchmark/README.md#where-the-band-cuts-fall))。 --- ## 324 个站点,公开打分 **其中四分之一,AI 爬虫读不到。** 73 个站有门槛项得 0 分——AI 检索爬虫拿不到内容,也就没有东西可引用。 20 个在 `robots.txt` 里点名屏蔽 AI 爬虫,那是编辑决策,如实记录即可—— amazon.com 只有 17 分正是这个原因。**另有 41 个站的正文只在 JavaScript 跑完之后才存在**, 内容是有的、浏览器看得见,爬虫拿到的是一个空壳;这一组几乎肯定不是有意的。 还有 12 个站,服务器拒绝爬虫 user-agent(探测来自审计方自己的地址,未经爬虫身份验证)。 中位数 **55**(95% 置信区间 51–58,见 [stats.py](benchmark/stats.py)),最低 11、最高 96。 其中 66 个站实际评分的页面不足 4 个,去掉它们后中位数是 59。 | 站点 | 分数 | 档 | |---|:-:|---| | resend.com | **96** | 领先 | | pulumi.com | **94** | 领先 | | supabase.com | **93** | 领先 | | elevenlabs.io | **91** | 领先 | | lumalabs.ai | **90** | 领先 | | … | | | | qcloud.com | 12 | 未起步 | | mercadolibre.com | 12 | 未起步 | | keepa.com | 11 | 未起步 | **[完整榜单与分行业中位数 →](https://www.jianruntech.com/leaderboard/zh)** · [markdown](benchmark/README.md) · [原始数据](benchmark/results.json) · [CSV](benchmark/results.csv) · [每个站的完整报告](benchmark/raw/) · [自己重跑](benchmark/run.py) 另外两个值得点进去看的发现。五个中国行业的站比其余站**低 22 分**(95% 置信区间 16–30;中位 36 对 58;此前用 1.1.0 的几次取样测得的差距在 16 到 23 分之间)。改按站点面向的语言分组,54 个中文站比其余 270 个站低 26 分(95% 置信区间 22–32); 相近行业一一对比,差距在 -8 到 27 分之间。按逐项原始分算,差距的 69% 落在 CLI 靠启发式判断的检查项上,所以最多只有这么大一部分可能是工具误读了中文页面([拆解见此](benchmark/README.md#what-the-spread-shows))。 逐项看,差得最多的是两项启发式判断:标题是否匹配提问意图、开头有没有能独立成立的答案段; 而在[人工审计对照](benchmark/VALIDITY.zh-CN.md)里唯一的中文站上,CLI 这两项也比人工判得低,所以这个差距里可能有一部分是工具对中文页面判得偏严。 从 1.5.0 起,CLI 按每个页面自己的语言来读,中文的任务、说明和对比类标题也计入提问意图;上面的榜单是用 1.5.0 测的,数字里已经包含了这一改动。 另外,「统计数据注明出处」和「具名、可核实的作者署名」在超过一半的站上都排进了最大的三个缺口。 **中文说明页**:[这套量表测什么、三项门槛为什么会封顶、测出问题之后怎么办](https://www.jianruntech.com/geo-score)——由维护者见润科技提供,量表本身与它无关,MIT 开源、可自行复算。 每个数字都能用[快速开始](#快速开始)里那条命令复现(榜单是 2026-10-02 用 1.5.0 跑的)——而且我们把「能复现到什么程度」也测了: 2026-10-12 用 1.8.0 在同一处、同一天把整个榜单跑了三遍(第三遍重读第一遍抽到的页面),三遍都打出分的 317 个站里, **前两遍 99% 的站落在 ±5 以内,81% 完全一致**(ICC 0.99,SEM 1.9;[REPRODUCIBILITY.md](benchmark/REPRODUCIBILITY.md), 由 [benchmark/retest.py](benchmark/retest.py) 算出)。2026-09-09 用旧的 1.1.x 版本测,是 96% 在 ±5 以内、45% 完全一致。 单个站的分数请按 ±5 读,不要当成精确值;中位数是稳的。 现在还会动的,主要是知识图谱查询(那一处测量时多数站查询没有回应),以及 bot 防护对爬虫时放时挡的站的门槛检查。 精度区间、对照实验和逐站配对都在 [benchmark/REPRODUCIBILITY.md](benchmark/REPRODUCIBILITY.md)。 对其中五个参照站,我们另外发布了**人工逐项审计**, 覆盖全部 21 项检查、每一项都附证据:[examples/audits/v1.1/](examples/audits/v1.1/)。 --- ## 准不准 大家常问的五个问题,以及这个仓库里各自在哪儿回答: | 问题 | 回答 | 记录 | |---|---|---| | 同一个站测两次,差多少? | 2026-10-12 用 1.8.0 同日复测:317 个站里 99% 在 ±5 以内,81% 完全一样(ICC 0.99) | [REPRODUCIBILITY.md](benchmark/REPRODUCIBILITY.md) | | 别人能不能复算? | 能:每一项检查、每一档、每个权重都公开,同样的页面谁跑都是同一个分 | [量表 v1.1](rubric/v1.1.zh-CN.md) | | 和人按同一套规则打分对得上吗? | 84 对检查项里 80% 档位一致;只有 5 个站,而且都是校准用的站 | [VALIDITY.zh-CN.md](benchmark/VALIDITY.zh-CN.md) | | 排名是不是权重说了算? | 换成等权,或把权重随机扰动 300 次,排名的秩相关都在 0.99 以上 | [SENSITIVITY.zh-CN.md](benchmark/SENSITIVITY.zh-CN.md) | | 分数高的站是不是更常被 AI 引用? | 预注册检验的第一波(2026-10-12 至 14 日;16 个类别、83 个站、一家 AI 的 1,280 个回答):没有检出关系(T = 0.07,p = 0.51);这个设计能检出的 T 至少要有 0.29。没检出不等于没有 | [RESULTS-wave0.zh-CN.md](benchmark/prereg/round0/RESULTS-wave0.zh-CN.md)、[PREREGISTRATION.zh-CN.md](benchmark/PREREGISTRATION.zh-CN.md) | **和人工审计比。** 需要站外检索或人工判断的那三项,CLI 会**退出分母**而不是猜(第四项 `p4.cn-engines` 在站点不面向中文时也退出)。拿公开的 5 份人工审计在相同页面上重评,84 对检查项里有 80% 与审计者档位一致 (按规则读取的项 92%,靠启发式近似判断的项 69%)。只看两边都打了分的检查项,CLI 平均低 2.4 分 (逐站从低 12 分到高 10 分,平均绝对差 8.8 分);按完整的归一化分算平均低 5.2 分,范围从低 16 分到高 7 分, 因为人工审计还给 `p3.listings`、`p3.mentions`、`p4.question-coverage` 打了分,CLI 不打这三项。 样本只有 5 个站,而且都是当初用来校准的站,每一处分歧见 [VALIDITY.zh-CN.md](benchmark/VALIDITY.zh-CN.md)。 --- ## 快速开始 ### 一行命令 Python 3.8+,只用标准库,不用装任何东西。它读取公开 URL, 按一套**公开、带版本号的评分口径**给分——不是黑箱。 ```bash curl -sL https://raw.githubusercontent.com/jianruntech/geo-score/v1.8.3/cli/geo_score.py \ | python3 - stripe.com --brief ```
完整输出(每一项的分数与下一档要求;加 --explain 会显示证据) ``` AIV READINESS https://stripe.com ────────────────────────────────────────────────────────────────────────── 72 / 100 Solid 11 points to Leading Reachable 13/15 ◐ Crawlers allowed in robots.txt ███████████░░░░░░░ 3/5 ✓ Reachable to retrieval agents ██████████████████ 5/5 ✓ Main content server-rendered ██████████████████ 5/5 Understandable 17/22 ◐ Sitemap discoverable and fresh █████████░░░░░░░░░ 2/4 ✓ llms.txt present and structured ██████████████████ 5/5 ✓ Organization + WebSite schema ██████████████████ 6/6 ✗ BreadcrumbList on nested pages ░░░░░░░░░░░░░░░░░░ 0/3 ✓ Page-type schema (Product, FAQ…) ██████████████████ 4/4 Content Citability 21/35 ✓ Self-contained answer passages ██████████████████ 9/9 ◐ Headings match how people ask ████████░░░░░░░░░░ 3/7 ◐ Freshness signal present █████████░░░░░░░░░ 3/6 ◐ Statistics carry a source ████████░░░░░░░░░░ 3/7 ◐ Named, verifiable authorship █████████░░░░░░░░░ 3/6 Brand Credibility 9/10 ⊘ Third-party listings ·················· — ⊘ Independent mentions ·················· — ✓ Knowledge-graph entity ██████████████████ 4/4 ✓ sameAs links resolve ██████████████████ 3/3 ◐ Video and multimodal presence ████████████░░░░░░ 2/3 Answer Fit 2/4 ◐ Content shaped for extraction █████████░░░░░░░░░ 2/4 ⊘ Covers the questions people ask ·················· — ⊘ Chinese engine readiness ·················· — ✓ full · ◐ partial · ✗ zero · ⊘ not measured (left the denominator) Biggest gaps +3 next tier (+3 to full) Freshness signal present needs: most pages do, and dateModified agrees with the visible date +3 next tier (+3 to full) Named, verifiable authorship needs: and the name links to a verifiable identity page +2 next tier (+2 to full) Crawlers allowed in robots.txt needs: mainstream retrieval user-agents explicitly allowed Scored 62 / 86 observable · 4 checks left the denominator · rubric v1.1 · took 91.5 s Needs off-site search or judgement: p3.listings, p3.mentions, p4.question-coverage Not observable this run: p4.cn-engines (not a Chinese-language site) Full rubric and what each tier means: https://github.com/jianruntech/geo-score/blob/v1.5.0/rubric/v1.1.md Score moved, or a check shows —? https://github.com/jianruntech/geo-score/blob/v1.5.0/guide/troubleshooting.md ``` `geo_score.py stripe.com`,2026-10-03 用 geo-score 1.5.0 经 HTTPS 代理录制(页脚的用时包含代理)。1.8.3 的一次运行见[界面预览](#界面预览)。从 1.7.0 起,报告在各项检查之后还会列出三项**分数之外**的观察(robots.txt 按页面的规则、服务器 HTML 里的链接、hreflang),它们从不改变分数;这段录制早于它们。见 [cli/README.zh-CN.md](cli/README.zh-CN.md#分数之外)。
### 从 PyPI:uvx 或 pipx 三级都能用。第二、三级需要 `cli/geo_watch.py` 和 `cli/geo_score.py` 放在一起,PyPI 上的包两个文件都有;克隆仓库,或者两个文件都下载,也可以。下面两种方式都不需要 git,也没有构建步骤。 ```bash uvx geo-score@1.8.3 example.com # 不安装直接运行(需要 uv) pipx install geo-score==1.8.3 # 或者装好 geo-score 命令 geo-score example.com --explain # 每一项检查,带背后的证据 ``` 访问不了 PyPI 时,从发布页安装同一个 wheel 包: `pipx install https://github.com/jianruntech/geo-score/releases/download/v1.8.3/geo_score-1.8.3-py3-none-any.whl`。 从源码安装(需要 git):`pipx install git+https://github.com/jianruntech/geo-score@v1.8.3`。每种方式都只用 Python 标准库。 发布的下载文件附带 `SHA256SUMS`,PyPI 上的 wheel 和 sdist 与它逐字节一致([如何校验](.github/SECURITY.md#verifying-a-download))。
CLI 的全部用法,以及给你自己的 README 加一枚可选徽章 **CLI** —— 第一级只要一个文件、无依赖,每份报告都记下这次运行用了多久(`elapsed_s`);第二、三级再加上同一版本的 `cli/geo_watch.py`。 用 PyPI 上的包时,把下面的 `python3 cli/geo_score.py` 换成 `uvx geo-score@1.8.3`(或者 `pipx install geo-score==1.8.3` 之后的 `geo-score`),三级都能用。 ```bash python3 cli/geo_score.py example.com # 人读 python3 cli/geo_score.py example.com --explain # 带每一项背后的证据 python3 cli/geo_score.py example.com --json # 符合 schema/report.v2.json python3 cli/geo_score.py example.com --compare competitor.com # 和竞品并排比 python3 cli/geo_score.py example.com --badge aiv-badge.svg # 生成可嵌入的 SVG 徽章 python3 cli/geo_score.py example.com --badge-json aiv-badge.json # 同一个徽章,写成 shields.io endpoint JSON python3 cli/geo_score.py example.com --share # 一行可以贴出去的结论 python3 cli/geo_score.py diff before.json after.json # 逐项对比两份报告,看哪里变了 python3 cli/geo_score.py example.com --baseline before.json --fail-on-drop # CI:重评同一批页面,只在退步时失败 ``` **「Scored with geo-score」:给你自己的 README 加一枚可选徽章。** `--badge aiv-badge.svg` 生成一个带分数和档位的 SVG。 把它提交到 README 旁边,链到能说明这个数字含义的地方,本仓库或[公开榜单](https://www.jianruntech.com/leaderboard/zh): ```markdown [![AIV readiness, scored with geo-score](aiv-badge.svg)](https://github.com/jianruntech/geo-score) ``` 放不放完全自愿,放了也不改变任何东西:徽章或回链从不影响分数,也从不决定一个站上不上榜单、排在哪里。 上榜走[添加站点](.github/CONTRIBUTING.md#the-easiest-useful-contribution)的流程,绝不拿链接交换。提交进仓库的 SVG 显示的是生成它的那一次运行;`--badge-json` 把同一个徽章写成 shields.io endpoint JSON,不用重新提交图片也能保持最新 ([详见](cli/README.zh-CN.md#给自己的-readme-加一枚徽章))。
### Claude Code 技能 CLI 只能测静态抓取看得见的东西。 有三项需要站外检索或人的判断,技能把这些也做了。 ```bash npx skills add jianruntech/geo-score # 加 -g 是全局安装 # 然后:/geo-score audit https://example.com ``` `npx skills add` 用的是开源的 [skills CLI](https://github.com/vercel-labs/skills)。它在本仓库里找到一个技能 `geo-score`, 把整个仓库(约 9 MB)按默认分支 main 当前的样子复制到 Claude Code 的 `.claude/skills/geo-score`。没有 Node.js,或者想装发布版而不是 main, 就把发布标签克隆到你自己的技能目录: `git clone --branch v1.8.3 --depth 1 https://github.com/jianruntech/geo-score ~/.claude/skills/geo-score`。 不用技能时 CLI 能做到多准:见[准不准](#准不准)。 ### MCP 服务 `geo-score-mcp` 是一个本地 MCP 服务(stdio,只用 Python 标准库)。Agent 通过它能用到和命令行一样的三级: 免费给网站打分、拿一个问题去问各家 AI、每周追踪一组问题。从 PyPI 运行 `uvx geo-score@1.8.3 mcp`(用 pipx 安装后是 `geo-score-mcp`),或者在克隆的仓库里运行 `python3 cli/geo_score.py mcp`。 [![Add geo-score to Cursor](https://cursor.com/deeplink/mcp-install-dark.svg)](https://cursor.com/en/install-mcp?name=geo-score&config=eyJjb21tYW5kIjoidXZ4IiwiYXJncyI6WyJnZW8tc2NvcmVAMS44LjMiLCJtY3AiXX0%3D) [![Install geo-score in VS Code](https://img.shields.io/badge/VS_Code-Install_Server-0098FF?style=flat-square&logo=visualstudiocode&logoColor=white)](https://insiders.vscode.dev/redirect?url=vscode%3Amcp%2Finstall%3F%257B%2522name%2522%253A%2522geo-score%2522%252C%2522command%2522%253A%2522uvx%2522%252C%2522args%2522%253A%255B%2522geo-score%25401.8.3%2522%252C%2522mcp%2522%255D%257D) [![Install geo-score in VS Code Insiders](https://img.shields.io/badge/VS_Code_Insiders-Install_Server-24bfa5?style=flat-square&logo=visualstudiocode&logoColor=white)](https://insiders.vscode.dev/redirect?url=vscode-insiders%3Amcp%2Finstall%3F%257B%2522name%2522%253A%2522geo-score%2522%252C%2522command%2522%253A%2522uvx%2522%252C%2522args%2522%253A%255B%2522geo-score%25401.8.3%2522%252C%2522mcp%2522%255D%257D) [![Add geo-score to LM Studio](https://img.shields.io/badge/LM_Studio-Install_Server-4338CA?style=flat-square)](https://lmstudio.ai/install-mcp?name=geo-score&config=eyJjb21tYW5kIjoidXZ4IiwiYXJncyI6WyJnZW8tc2NvcmVAMS44LjMiLCJtY3AiXX0%3D) 按钮和下面几行用 `uvx` 从 PyPI 运行 geo-score **1.8.3**,只需要先装 [uv](https://docs.astral.sh/uv/),不需要 git,也没有构建步骤。它们本身不带 Key,但如果启动服务的 shell 里 export 了服务商 Key(Claude Code 会把自己的环境变量传给服务),服务就能用它。要一个花不了钱的服务,在 `mcp` 后面加 `--read-only`。 **Claude Code** ```bash claude mcp add --scope user geo-score -- uvx geo-score@1.8.3 mcp ``` **标准配置**(文件里不写 Key),适用于任何读取 `mcpServers` 配置文件的客户端: ``` { "mcpServers": { "geo-score": { "command": "uvx", "args": ["geo-score@1.8.3", "mcp"] } } } ``` Claude Desktop 不读你 shell 里的 `PATH`:`command` 请填 `which uvx` 输出的完整路径。 访问不了 PyPI 时,用发布的 wheel 包:`uvx --from https://github.com/jianruntech/geo-score/releases/download/v1.8.3/geo_score-1.8.3-py3-none-any.whl geo-score-mcp` 从源码安装(需要 git):`uvx --from git+https://github.com/jianruntech/geo-score@v1.8.3 geo-score-mcp`
有哪些工具、各自花不花钱,以及它们读取的 Key 和配置 | 工具 | 级别 | 费用 | 写入 | 提示 | 参数 | |---|:-:|---|---|---|---| | `score_site` | 1 | 免费 | 否 | 只读、访问外部 | **`url`**、`urls`、`sample` | | `ask` | 2 | 付费(你的 Key) | 否 | 非破坏性、访问外部 | **`question`**、`engines`、`brand`、`domains` | | `run` | 3 | 付费(你的 Key);`dry_run` 免费 | 运行文件,存到配置文件旁的 `.geo-score/watch/runs/` | 非破坏性、访问外部 | `dry_run`、`engines`、`limit`、`max_calls`、`budget_usd` | | `list_runs` | 3 | 免费 | 否 | 只读、幂等 | — | | `report` | 3 | 免费 | 否 | 只读、幂等 | `run`、`since`、`format` | | `diff` | 3 | 免费 | 否 | 只读、幂等 | `from`、`to`、`format` | | `status` | — | 免费 | 否 | 只读、幂等 | — | 资源:`geo-score://rubric/v1.1`。 提示词:`audit_site`(**`url`**)、`check_citations`(**`question`**、`brand`)、`weekly_watch`、`compare_runs`(`from`、`to`)、`explain_check`(**`check_id`**)。 加粗的参数必填。「提示」是工具的 MCP 标注(annotations):客户端可以据此决定哪些调用要你确认;它们只是提示,不是保证。**只有 `ask` 和 `run` 会花钱**,而且只用你交给服务的服务商 Key。 **可以这样跟 Agent 说:** | 提示 | 它调用的工具 | |---|---| | 给 https://acme.com 做 AI 搜索就绪度打分,列出最能提分的 3 项检查。 | `score_site`,参数 `url` | | 把我追踪的问题集 dry-run 一遍,告诉我计划调用多少次、上限是多少。 | `run`,带 `dry_run: true`(第三级,需要配置文件) | | 比较我最近两次 watch 运行:哪些引擎变了,有没有超出噪声的变化? | `diff`(默认比较最近两次) | **Key 与配置。** `score_site` 不要 Key。`ask` 和 `run` 从服务进程的环境变量里读服务商 Key (`OPENAI_API_KEY`、`PERPLEXITY_API_KEY`、`GEMINI_API_KEY`、`ANTHROPIC_API_KEY`、`OPENROUTER_API_KEY`), 那不是你终端里的环境:桌面应用看不到你在 shell 里 export 的变量。第三级工具还需要 `geo-score-watch.json`, 请用 `-c /绝对路径/geo-score-watch.json` 传给服务,因为图形界面客户端不会在你的项目目录里启动它。 从 1.4.0 起,加上 `--read-only`,服务就花不了任何钱。
各客户端的配置(Claude Code、Claude Desktop、Codex、Cursor、VS Code、Gemini CLI、Devin Desktop、Zed)、 Claude Code 插件、超时、安全与排查:**[guide/mcp.zh-CN.md](guide/mcp.zh-CN.md)**。 ### GitHub Action 第一级,每次 push 都跑:打分,退步就让构建失败。第三级按周定时跑见 [examples/ci/watch-weekly.yml](examples/ci/watch-weekly.yml)。 ```yaml - uses: jianruntech/geo-score@v1 with: url: https://example.com fail-under: 40 fail-on-gate: true ``` 门槛项得 0 分时分数封顶 40:本来能得 40 分及以上的站正好停在 40,能通过 `fail-under: 40`;`fail-on-gate: true` 会让任何被封顶的站失败。 它写出的任务摘要见[界面预览](#界面预览)。 --- ## 第二、三级 · AI 到底有没有引用你 `--ask` 和 `watch` 用你自己的 Key,通过各家带联网搜索的 API,把买家会问的问题拿去问 ChatGPT、Perplexity、 Gemini 和 Claude,记下每条回答引用了谁:是你、是竞品,还是 AI 更愿意引用的第三方页面(论坛、测评站)。 Key 只从环境变量读,geo-score 不会把它写到任何地方。 ```bash git clone --branch v1.8.3 --depth 1 https://github.com/jianruntech/geo-score && cd geo-score/cli export OPENAI_API_KEY=… PERPLEXITY_API_KEY=… # 有几个 Key 就测几个引擎 python3 geo_score.py acme.com --ask "invoicing app for freelancers" # 第二级 python3 geo_score.py watch init --brand Acme --domain acme.com --competitor "Rival=rival.com" # 把买家会问 AI 的问题写进 queries.csv,然后: python3 geo_score.py watch run --dry-run # 只看计划、上限、能测出多大的变化和单个问题引用率的精度,不调用、不花钱 python3 geo_score.py watch run # 第三级:每个问题问每个引擎,并保存 python3 geo_score.py watch diff # 和上一次比,带显著性检验 python3 geo_score.py watch report --since 30 # 合并最近 30 天的运行,按问题算一个区间 ``` **第二级**每个问题在每个引擎上问一次,结果印在就绪度报告下面(加 `--json` 时写进报告的 `citation` 字段)。 一次问答只是个例:用来看 AI 今天怎么说,不是用来算比率的。
watch 跑一次的输出(示意:虚构的品牌和预设的回答,不是真实测量;1.2.0 保存的运行,用 1.8.0 打印) ``` geo-score watch · Lumo · run 20260926T083000Z · api channel 6 questions × 2 engines × 2 = 24 planned · 23 answered · 1 failed · 0 skipped Cited in 38% of answers to questions that do not name Lumo (6 of 16, 4 questions, 95% CI 12–62%) · mentioned in 38% Questions that name Lumo (2, kept out of the headline): cited in 100% (7 of 7, 95% CI 65–100%) · mentioned in 100% Your site was cited somewhere for 5 of 6 questions. By engine engine model cited 95% CI mentioned named first (tracked) avg rank chatgpt-api gpt-6-luna 9/12 75% 42–100% 75% 9/12 1.0 perplexity-api sonar 4/11 36% 8–75% 36% 0/11 2.0 1 failed gemini-api gemini-3.8-flash not measured no_key: set GEMINI_API_KEY or GOOGLE_API_KEY These rows, and the tables below, count every question, the 2 that name Lumo included. Answer share your pages support: not measured; this run was saved before citation positions were recorded. Sources listed and used in the answer: not measured; this run was saved before listed sources were recorded. Repeat consistency of cited domains (per engine; descriptive, not read by diff) engine questions measured pairs median Jaccard chatgpt-api 6/6 6 1.00 perplexity-api 5/6 5 1.00 gemini-api not measured no_key Least consistent questions (up to 3 per engine): id question engine answers that cite Jaccard q02 ai video tool with no watermark chatgpt-api 2 0.50 q01 best free ai video generator perplexity-api 2 0.50 - Repeat consistency: for each question an engine answered more than once in this run, the overlap of the domains two of its answers cite, shared domains over all domains of the two (Jaccard), for every two answers, averaged per question; the median over questions per engine. 1: every ask cited the same domains; 0: no domain in common. Domains are read as everywhere in this report, www dropped; the order of citations is not compared. - Answers that cite nothing are left out: two empty lists are not agreement, and one empty list is not a 0. On an engine, a question with fewer than two answers that cite is not measured. Lowest: up to 3 questions per engine whose answers did not all cite the same domains, lowest first. - Descriptive only: no interval and no test, never part of the cited rate, and watch diff does not read it. It describes asks minutes apart in one run, which share that day's index; it is not computed over pooled runs. Share of voice cited 95% CI mentioned named first (tracked) sentence share Lumo (you) 57% 26–86% 57% 9/23 100% Pixa 52% 33–71% 100% 14/23 100% - Named first (tracked): answers that name that brand before any other brand in your config, out of the answers that name at least one of them. Brands your config does not list are not seen, so first among the brands you track may not be first in the answer. Two brands first named at the same place, one name inside the other, are neither first. - Sentence share: in the answers that name a brand, the mean share of their sentences that name it, every sentence counted the same. A sentence ends at a line break, at 。!?, or at . ! ? before a space. - Both read the answer as saved, which keeps its first 20,000 characters; a name that first appears after that is not seen. Sources the engines cite most (not yours) domain answers share owner pixa.example 12 52% Pixa reddit.com 11 48% Questions where a competitor is cited and you are not (1) id question cited instead q03 cheapest text to video app Pixa Who is named for each question id question answers Lumo (you) Pixa no tracked brand named searched yes/no/unknown most cited q01 best free ai video generator 4 cited 3/4 · named 3/4 cited 2 · named 4 0/4 2/0/2 Lumo (you) q02 ai video tool with no watermark 4 cited 1/4 · named 1/4 cited 2 · named 4 0/4 2/0/2 Pixa q03 cheapest text to video app 4 cited 0/4 · named 0/4 cited 2 · named 4 0/4 2/0/2 Pixa q04 lumo vs pixa 4 cited 4/4 · named 4/4 cited 2 · named 4 0/4 2/0/2 Lumo (you) q05 pixa alternatives 4 cited 2/4 · named 2/4 cited 2 · named 4 0/4 2/0/2 — q06 鹿末视频免费吗 3 cited 3/3 · named 3/3 cited 2 · named 3 0/3 2/0/1 — - An answer given without a web search cannot cite anything. - "No tracked brand named" counts answers that name none of the brands in your config; they may name others. - Perplexity and OpenRouter search on every call or do not say, so their answers count as unknown under searched. By question type type cited 95% CI mentioned alternative 2/4 50% 15–85% 50% list 4/8 50% 22–78% 50% pricing 3/7 43% 0–100% 43% vs 4/4 100% 51–100% 100% What the engines searched for (from 12 answers that show it) times search 2 best free ai video generator 2 ai video tool with no watermark 2 cheapest text to video app 2 lumo vs pixa 2 pixa alternatives 2 鹿末视频免费吗 - Of 12 searches: 0 contain a year, 6 contain a ranking or comparison word. Ledger 24 questions asked · 23 API requests · 14,620 in / 4,860 out tokens · 23 searches · $0.07 + 12 answers with no price (add prices to geo-score-watch.json) 1 failed after 24 HTTP requests in all; a request that timed out may still be billed. Caps: at most 100 questions. Read this before quoting the numbers - API channel. Answers come from each provider's search-enabled API, which is not the consumer app. Compare runs with runs; never pool them with answers sampled by hand in the apps. - The same question gets different answers from one ask to the next, and answers to one question move together. Rates carry a 95% interval: Wilson when each question was answered once, a bootstrap over questions when a question has several answers. diff pairs the questions both runs answered and calls a change a change only when an exact paired test (McNemar, or a sign-flip test when a question has several answers), Holm-corrected across engines, says so (p < 0.05). - A question that names the brand invites an answer that cites it. Those questions are kept out of the headline rate and reported on a line of their own. - Engines without a key, calls that failed and calls skipped by a cap count as not measured, never as zero. - This measures citations. It does not predict traffic, rankings or revenue. - This run was saved before questions were flagged at run time. Questions that name the brand were found when this report was made, from the saved question text and the run's brand name, aliases and domains. ```
第三级报告里有什么、它不告诉你什么、支持哪些引擎、上限与费用 **第三级**固定一组问题,每条回答都存进 `.geo-score/watch/runs/`([schema](schema/watch.v1.json)),报告里有: | | 含义 | |---|---| | **被引用(cited)** | 回答链接到你的网址:`domains` 里的域名(含子域名),或 `url_prefixes` 里的前缀,比如你的亚马逊店铺页、GitHub 组织页 | | **位次(rank)** | 在这条回答引用的不同域名里,你排第几。1 = 第一个来源 | | **被提及(mentioned)** | 回答正文里出现了你的名字、`aliases` 里的别名或域名。中文、日文、韩文名按包含匹配,其他名字(包括带重音的拉丁字母)按整词匹配 | | **声量份额** | 同一批回答里,每个竞品的被引用率和被提及率 | | **来源** | 被引用最多的第三方域名,也就是 AI 在你这个品类里信得过的那些页面 | | **答案占比** | 每条回答里有多少文字由你的页面支撑(`supported_share`):按字符、按句子、按位置加权的字符,依据服务商标出的每条引用在正文里的位置。和引用率并列印出,从不并入;引用不带位置的回答算未测量 | | **列为来源与正文用上** | Perplexity 和 Gemini(`generate_content`)会在回答旁列出来源,并标出正文用上了哪些:每条回答列出多少、用上多少,用上占列出的比例,以及列出、用上你的网址的回答数。只返回一份列表的 API 不测 | | **重复一致性** | 一次运行里同一个问题在同一个引擎上问了不止一次时:各次回答引用的域名重合多少(Jaccard,每个引擎取各问题的中位数),并列出最不一致的问题。只作描述,`watch diff` 不读它 | | **缺口** | 竞品被引用、你一次都没被引用的问题 | | **实际搜索词** | 引擎回答前真正搜了什么(OpenAI、Gemini、Claude 的 API 会给出)。这就是 query fan-out,是实际记下来的,不是猜的。报告统计其中几条含年份、几条含排名或比较类的词;回答搜索过、接口却没返回搜索词时,报告会写明 | | **账本** | 问了几个问题、发了几次请求、用了多少 token 和搜索、花了多少钱。每次运行一本 | **它不告诉你什么。** - **这不是 ChatGPT App 里的回答。** 数据来自各家 API(开了联网搜索)。App 用的模型、系统提示 和个性化都不一样。API 渠道只和 API 渠道比,别和人工在 App 里采的样本混着算。 - **有些地方够不着。** Google AI Overviews 与 AI Mode、TikTok、Reddit、小红书等应用内的 AI 总结、助手的记忆与账号设置、 比国家提示更细的地理位置,以及编程智能体选用哪个库,都没法通过这些 API 测到。 - **被引用说明在场,不说明好坏。** 引用率说的是引擎提到并链接了你,不说明它说的是真的,也不说明那一页配得上; 引擎也会引用误导性的、自我宣传的页面。 - **一条回答只是个例。** 同一个问题问两次,引用的来源可能不同。所有比率都带 95% 区间(同一问题有多条回答时, 这些回答会一起变动,区间按问题做自助法重抽样);`diff` 只比较两次都回答了的问题,用精确配对检验并对各引擎做 Holm 校正,p < 0.05 才说「有变化」,共同问题太少(少于 6 个,或相对比较的引擎数太少)时直接说「问题太少,无法判断」。20 个问题 × 1 个引擎, 区间就是很宽,数据只能说到这个份上。方法见 [guide/watch-methodology.zh-CN.md](guide/watch-methodology.zh-CN.md)。 - **提到你品牌的问题单独统计。** 「acme vs rival」「acme 值不值」这类问题会把品牌名带进引擎的搜索,几乎每次都会被引用。 `watch` 在运行时标出这类问题,把它们排除在标题引用率之外,单列一行并给出各自的样本数。`queries.csv` 可选的 `branded` 列可以手动修正标记。 - **没测不等于 0。** 没有 Key 的引擎、失败的调用、被上限跳过的调用,都记为「未测」, 不会拉低你的比率。 - **被引用不等于流量。** 这里不预测访问量、排名,也不预测收入。 **引擎。** 在配置里写死要测的模型,每周保持不变;换了模型的那次,`diff` 会标出来。OpenRouter 一个 Key 能调几百个模型。 | 默认引擎 id | 服务商 | Key | 默认模型 | 怎样算被引用 | 能看到搜索词 | 自报费用 | |---|---|---|---|---|---|---| | `chatgpt-api` | OpenAI Responses API + `web_search` | `OPENAI_API_KEY` | `gpt-6-luna` | `url_citation` 标注 | 能 | 否,需配价格 | | `perplexity-api` | Perplexity Sonar | `PERPLEXITY_API_KEY` | `sonar` | 正文用到的编号来源 | 否 | 是 | | `gemini-api` | Gemini Interactions API + `google_search` | `GEMINI_API_KEY` 或 `GOOGLE_API_KEY` | `gemini-3.8-flash` | `url_citation` 标注 | 能 | 否,需配价格 | | `claude-api` | Anthropic Messages + `web_search` 工具 | `ANTHROPIC_API_KEY` | `claude-sonnet-5` | 正文上的 citations | 能 | 否,需配价格 | | 自定 id | OpenRouter + `web` 插件(模型经 OpenRouter 的搜索作答,不是厂商自家的搜索) | `OPENROUTER_API_KEY` | `openai/gpt-6-luna` | `url_citation` 标注 | 否 | 是 | **上限与费用。** `max_calls` 是单次运行问题数的硬上限,计划超了就不开始;`budget_usd` 每次调用前核一次: 已花的钱加上这个引擎目前最贵的一次调用,所以最多超出每个引擎一次调用的费用。设了 `budget_usd` 时,算不出费用的引擎不跑,除非加 `--allow-unpriced`。每次运行都有账本: 请求数、token、搜索次数、花费。配置、价格和全部命令见 [CLI 说明](cli/README.zh-CN.md#watch)。 **在 Agent 里用。** 第二、三级同样是 MCP 工具,Agent 只能把上限调得更紧,不能放宽,见 [MCP 服务](#mcp-服务)。 **每周跑一次。** 引用率变得慢、噪声也大:固定星期几、固定问题、固定模型,看 `diff`,别盯单次结果。 [examples/ci/watch-weekly.yml](examples/ci/watch-weekly.yml) 按时自动跑,Key 放在仓库 Secrets,每次运行都提交回仓库,历史都在 git 里。运行文件里有你的问题和 AI 的完整回答,问题集要保密就用私有仓库。
**自己跑免费;想省事,可以交给我们。** 这里的一切都是 MIT,工具本身没有付费版。API 费用你直接付给 各家服务商,每次花了多少账本里都有。需要人来做的部分,[见润科技](https://www.jianruntech.com/)作为服务来做: | | 自己跑(免费) | 交给见润(GEO 落地系统) | |---|---|---| | 渠道 | 带搜索的 API | API,加上每周在 App 里人工采样 | | 引擎 | OpenAI、Perplexity、Gemini、Anthropic,以及 OpenRouter 上的模型 | ChatGPT(联网)、Perplexity、Gemini、Google AI Overviews、Copilot;做国内市场再加国内引擎 | | 报告 | 文本、Markdown、CSV、JSON | 周报和 AIV 看板:引用率趋势、分引擎结果、AI 说错你的事实、就绪度历史 | | 引用掉了怎么办 | 不在工具范围内 | 我们来改 | | 价格 | 你的 API 账单 | GEO 落地系统,¥38,888 起 / 季度(年付 ¥152,888),含 AIV 看板。[看价格](https://www.jianruntech.com/#pricing) | --- ## 适用场景 | 谁 | 用它做什么 | 从哪儿开始 | |---|---|---| | **站长与市场团队** | AI 引擎能不能抓到、引用你的网站,哪几处缺口最值分 | 先 `--brief`,再 `--explain`;关心的问题用第二级去问 | | **代理商与咨询公司** | 给客户一份能按公开、带版本号的量表自己复核的诊断;每次改动后重评同一批页面 | `--json`、`--baseline last.json`、`diff`;报告里写明量表版本 | | **开发者与 CI** | 部署挡住了爬虫、丢了服务端渲染或掉了分,就让构建失败 | [GitHub Action](#github-action)、`--fail-on-gate`、`--assert`、SARIF 和 JUnit | | **研究者** | 复算每一个公开数字、质疑权重、检验就绪度和被引用之间的关系 | [rubric/v1.1.json](rubric/v1.1.json)、[benchmark/](benchmark/)、[预注册方案](benchmark/PREREGISTRATION.zh-CN.md) | geo-score 测的是引擎**能不能**引用一个站、**有没有**引用它。它不负责修复,也从不预测流量、排名或收入。 --- ## 边界与治理 | 方面 | 怎么定 | |---|---| | 只测量,不修复 | 不发布修复模板、改写方法和分平台打法,只有两个公开常识样例例外:见[边界](#边界--这个仓库不做什么) | | 量表怎么改 | 公开提案、公开征求意见、独立复核;不卖认证:见[量表治理](rubric/governance.zh-CN.md) | | 权重依据 | 每一项都注明权重建立在什么依据上,附来源和最后核实日期:见[证据表](rubric/evidence-v1.1.zh-CN.md) | | 隐私 | 不收集遥测数据。第一级只访问网站、它的标记和 robots.txt 指向的地址,以及 Wikidata 和维基百科的搜索;第二、三级只调用你配了 Key 的服务商 | | 稳定性 | 报告 schema、检查项 id、命令行参数、退出码、Action 输入输出、MCP 工具都是公开契约:见[稳定性约定](guide/stability.md) | ### 边界 · 这个仓库不做什么 这是大多数工具会略过的部分,所以直说。 **geo-score 只测量,不修复。** | 不包含 | 为什么 | |---|---| | 修复模板 —— `robots.txt`、JSON-LD 代码块、`llms.txt` 样板;只有[两个公开常识样例](guide/public-examples.zh-CN.md)例外(放行检索爬虫的 `robots.txt`、Organization JSON-LD) | 修复才是真正需要工作量和判断的地方,那是另一个不开源的项目 | | 内容改写 —— 怎么把一段话写成会被引用的样子 | 同上 | | 分平台打法 —— 对 Perplexity 和对 Gemini 该分别怎么做 | 同上 | | 改造路线图 | 同上 | **其他要说清的限制:** - **它测的是输入侧的就绪度,不是结果。** 分高只说明引擎**能**引用你, 至于**会不会**引用,取决于竞争和提问意图,这些外部审计观察不到。 引用表现单独测、单独报,**不进这 100 分**——见 [两个分数,不要混在一起](rubric/v1.1.zh-CN.md#两个分数不要混在一起)。用上面的第二、三级来测它。 不并进来的一个原因:同一个问题再问一次,引用的来源往往大半不同。同一提示在 24 小时内重复运行(只算引用了来源的那些次), 一个市场的四个行业里,四个引擎合在一起,来源重合度(Jaccard)平均只有 0.32 到 0.43;分引擎看是 0.23 到 0.51 ([Schulte 等 2026](https://arxiv.org/abs/2604.07585),§5 表 4、表 6);Google AI Overviews 在同一设备、 同一地点跑两次,也只有 0.66([Grossman 等,SIGIR 2026](https://arxiv.org/abs/2604.27790),§4.4 表 4)。 - **品牌可信与具名作者这一项需要人的判断。**「这个作者是不是真实可查的人」 「这条提及是不是独立的」没法完全自动化。这 24 分左右应当视为辅助判定。 - **阶梯降低分歧,但消不掉分歧。** 每一档都写成 8 个抽样页里的具体页数, 所以两个审计者在算术上不会分歧;但「这一段算不算自足答案」仍然是判断。 [已定掉的歧义](rubric/open-questions.zh-CN.md)是我们发现的那些,一定还有别的。 - **重客户端渲染的站会打低分,有时不公平。** 如果内容要 hydration 之后才出现, 大部分检查读到的是 hydration 之前的 HTML——那也大致就是爬虫看到的, 所以低分通常是对的,但值得人工复核一遍。 - **引擎行为会变。** 口径带版本号正是为此。旧版本口径算出来的分与当前版本不可比。 ### 为什么发布口径,而不只发工具 一个你没法复核的分数,就是别人编出来的数字。所以规范本身才是产品,工具只是它的实现: - **带版本号。** 每个分数都要报口径版本。`71(v1.1)`是一个主张,`71` 不是。 - **阶梯给分,写明页数。** 每一档写的是 8 页里的具体页数,不是「多数」。 - **必须有证据。** 每一项都要留一个别人能复现的观察。 - **对着公开基准标定过**,并[公开了标定记录](rubric/calibration-v1.1.zh-CN.md)——包括档位线所对照的四份外部数据,以及真实审计暴露、v1.1 逐条定掉的[八处口径歧义](rubric/open-questions.zh-CN.md)。 - **机器可读。** [`rubric/v1.1.json`](rubric/v1.1.json) 带永久 check id,[`schema/report.v2.json`](schema/report.v2.json) 让不同实现跑出来的结果可以互相比较。 用你自己的技术栈实现它、对某个权重有异议,[开一个口径提案](.github/ISSUE_TEMPLATE/rubric_proposal.yml)。这是我们最希望收到的贡献。 提案怎么变成新版本、谁来定、为什么我们不卖认证也不花钱买标准的席位:见[量表治理](rubric/governance.zh-CN.md)。 ### 权重的研究依据 权重是有主张的,但不是拍脑袋。影响最大的两项: - **[Aggarwal et al., *GEO: Generative Engine Optimization*, KDD 2024](https://arxiv.org/abs/2311.09735)** —— 在模拟引擎里一次只改写一个来源,加引用来源、统计数字或专家引语,可以让这个来源在答案里的占比提升**最多约 40%** (度量口径是 Position-Adjusted Word Count,不是引用次数)。论文也发现**「权威语气」没有显著提升**, 这正是本口径给结构和出处打分、而不给语气打分的原因。这个增益并不能直接外推:所有来源同时改写时, 原本排第一的来源可见度反而降了两到三成(§5.2 表 2);后来一项按引用名次衡量的基准发现,已发表的方法多数没有显著提升 ([C-SEO Bench,arXiv 2506.11097](https://arxiv.org/abs/2506.11097) §6.2)。细节见证据表 `p2.sourced-stats` 一行 ([`rubric/evidence-v1.1.zh-CN.md`](rubric/evidence-v1.1.zh-CN.md))。 - **[llms.txt 提案,Answer.AI](https://llmstxt.org/)** —— 可被理解支柱里 `p1.llms-txt` 检查的就是它。 每一项检查都注明了权重建立在什么依据上——公开研究、厂商自己的文档、我们自己的实地观察,还是一项没有引擎确认使用过的约定—— 并附来源与最后核实日期:[rubric/evidence-v1.1.zh-CN.md](rubric/evidence-v1.1.zh-CN.md)。证据单薄的几项 (`p2.answer-passages`、`p2.question-intent`、`p1.llms-txt`)表里直接写明,它们是 v1.2 重新定权的首批候选。 如果你有证据表明某个权重不对, [提一个口径提案](.github/ISSUE_TEMPLATE/rubric_proposal.yml)——这是我们最希望收到的贡献。 ### 相关项目 刻意说清这个仓库**不是**什么,方便你选对工具: | 项目 | 做什么 | 关系 | |---|---|---| | [llms-txt](https://github.com/AnswerDotAI/llms-txt) | `llms.txt` 规范本体 | geo-score 检查是否符合它 | | [yao-geo-skills](https://github.com/yaojingang/yao-geo-skills) | 21 个分类 GEO 技能,偏执行 | 互补——它做生产,这里做测量 | | [GEOFlow](https://github.com/yaojingang/GEOFlow) | 企业官网 GEO 运营系统 | 范围大得多;AGPL 协议 | 如果你要的是修复而不只是一个分数,上面这些项目覆盖了本仓库刻意排除的那部分。 ### 稳定性、隐私与安全 安装方式见[快速开始](#快速开始)。 - **稳定性:** 量表和工具分开编版本号;报告 schema、检查项 id、命令行参数、退出码、Action 输入输出、 MCP 工具都是公开契约,哪个版本允许改什么,见[稳定性约定](guide/stability.md)。 - **不收集任何遥测数据。** geo-score 不向我们或任何人发送数据。第一级只访问你指定的网站(包括它的跳转)、它的标记和 robots.txt 指向的地址 (`sameAs` 主页链接、logo、声明的 sitemap,检查是否有效),以及 Wikidata 和维基百科的搜索接口;第二、三级只调用你配了 Key 的 AI 服务商。 - **安全:** 报告里引用的网站原文一律标注为数据,MCP 服务的 `score_site` 只连接公网地址,Key 从不写进任何文件。 威胁模型与漏洞报告方式见[安全策略](.github/SECURITY.md)。 **为什么我的分数变了 4 分?** 每次运行最多抽 8 个页面,每次抽到的不完全一样,用 1.8.0 同一天复测,99% 的站波动在 ±5 以内 ([REPRODUCIBILITY.md](benchmark/REPRODUCIBILITY.md))。要做改动前后的对比,用 `--baseline last.json` 重评同一批页面,它还会逐项列出哪里变了(`--urls-from last.json` 只重评、不对比)。 **为什么某项显示 `—`?** 它没有被测到,所以移出了分母,而不是记 0 分。更多问题见[排查指南](guide/troubleshooting.zh-CN.md)。README、报告和各篇指南里的术语集中解释在[术语表](guide/glossary.zh-CN.md);全部参数、退出码和 watch 命令见 [CLI 说明](cli/README.zh-CN.md)。 --- ## 开发者入口 ### 仓库结构 | 路径 | 里面是什么 | |---|---| | [`cli/`](cli/) | `geo_score.py`(第一级,单文件、无依赖)、`geo_watch.py`(第二、三级)、测试,以及 [CLI 说明](cli/README.zh-CN.md) | | [`rubric/`](rubric/) | 评分口径本身([v1.1](rubric/v1.1.zh-CN.md) 及其 JSON)、每项权重的依据、校准记录、分数段分析和待定问题 | | [`benchmark/`](benchmark/) | 324 站公开榜单:结果、每个站一份原始报告、预注册、可重复性与效度记录 | | [`docs/`](docs/) | 榜单的 GitHub Pages 副本、`llms.txt`,以及本页顶部的徽章 | | [`guide/`](guide/) | MCP 配置、排查指南、术语表、watch 方法说明、[稳定性约定](guide/stability.md)、[两个公开样例](guide/public-examples.zh-CN.md),以及怎么查 [ChatGPT 能不能读到一个网站](guide/chatgpt-access.zh-CN.md) | | [`reference/`](reference/) | 检查项依赖的背景资料:已知的 AI 爬虫,各平台从哪些来源取材 | | [`schema/`](schema/) | 报告、对比、错误和 watch 文件的 JSON Schema | | [`examples/`](examples/) | 示例报告、公开的人工审计和 CI 工作流 | | [`action.yml`](action.yml)、[`action/`](action/) | GitHub Action | | [`SKILL.md`](SKILL.md)、[`.claude-plugin/`](.claude-plugin/)、[`gemini-extension.json`](gemini-extension.json)、[`mcpb/`](mcpb/)、[`server.json`](server.json)、[`Dockerfile`](Dockerfile) | Claude Code、Gemini CLI、MCP 客户端、MCP 注册表和 Docker 的打包文件。安装工具会到仓库根目录找它们,所以留在根目录 | | [`scripts/`](scripts/) | 仓库自检(`scripts/check.sh` 一次跑全部)和发版脚本 | | [`.github/`](.github/) | [贡献指南](.github/CONTRIBUTING.md)、[求助渠道](.github/SUPPORT.md)、[安全策略](.github/SECURITY.md)、[行为准则](.github/CODE_OF_CONDUCT.md)、[发版流程](.github/RELEASING.md)、issue 表单和 CI 工作流 | | [`AGENTS.md`](AGENTS.md) | 写给编程智能体的仓库地图(`CLAUDE.md` 指向它) | ### 测试与自检 ```bash bash scripts/check.sh # 自检(离线):结构、lint、全部测试、Action、打包 bash scripts/check.sh --live # 发版前:再加 example.com 实测和 MCP Inspector ``` `scripts/check.sh` 就是本仓库的 CI:不通过就不合并。它执行哪些规则、每条由哪项检查负责,见 [AGENTS.md](AGENTS.md)。本页的一些数字也在其中:哪个数字和它引用的数据对不上,自检就会失败。 ### 参与贡献 最有价值的贡献是**关于权重的证据**。见[贡献指南](.github/CONTRIBUTING.md)。 分数不对、对榜单某一行有异议、工具用不了,各自用哪张 issue 表单,见[求助渠道](.github/SUPPORT.md)。 --- ## 开源协议、引用与维护者 ### 开源协议 [MIT](LICENSE) **能不能拿来商用** | 用法 | 可以吗 | 要做什么 | |---|---|---| | 个人学习、测自己的站 | 可以 | 无 | | 公司内部用 | 可以 | 无 | | 代运营 / 咨询公司给客户做诊断并收费 | 可以 | 保留 LICENSE 里的版权声明;报告里写明量表版本(如 v1.1),客户才能复核 | | 集成进自己的 SaaS 或产品 | 可以 | 保留版权声明;分数请注明「按 AIV 量表 v1.1 计算」,不要改了权重还叫 AIV 分 | | 改代码后再发布 | 可以 | MIT 协议,保留版权声明即可 | MIT 协议不需要找我们授权,也没有单独的商业许可证。 ### 引用 在研究或报告中引用本口径,见 [CITATION.cff](CITATION.cff)。 ### 谁在维护 由 **[见润科技](https://www.jianruntech.com)**(深圳)建立并维护。我们为国内外企业做 GEO 与 AI 落地: 外贸 B2B、软件公司、专业服务、本地生活、教育机构,以及企业出海(含跨境电商)。这套口径来自客户项目和优化我们自己产品的过程; 把它公开,是希望 AI 可见度能有一个一致的衡量方式,**包括被那些永远不会成为我们客户的人使用**。 本仓库的商业使用不受限制(MIT),包括用在付费咨询项目里。 不需要获得我们许可,也没有另外的商业授权。 --- ## 文档 | 文档 | 中文 | English | |---|---|---| | 本 README | [README.zh-CN.md](README.zh-CN.md) | [English](README.md) | | 量表 v1.1 | [rubric/v1.1.zh-CN.md](rubric/v1.1.zh-CN.md) | [English](rubric/v1.1.md) | | 每项权重的依据 | [rubric/evidence-v1.1.zh-CN.md](rubric/evidence-v1.1.zh-CN.md) | [English](rubric/evidence-v1.1.md) | | 量表治理 | [rubric/governance.zh-CN.md](rubric/governance.zh-CN.md) | [English](rubric/governance.md) | | CLI 说明 | [cli/README.zh-CN.md](cli/README.zh-CN.md) | [English](cli/README.md) | | 各客户端的 MCP 配置 | [guide/mcp.zh-CN.md](guide/mcp.zh-CN.md) | [English](guide/mcp.md) | | 排查指南 | [guide/troubleshooting.zh-CN.md](guide/troubleshooting.zh-CN.md) | [English](guide/troubleshooting.md) | | 术语表 | [guide/glossary.zh-CN.md](guide/glossary.zh-CN.md) | [English](guide/glossary.md) | | watch 方法说明 | [guide/watch-methodology.zh-CN.md](guide/watch-methodology.zh-CN.md) | [English](guide/watch-methodology.md) | | 更新日志 | [CHANGELOG.zh-CN.md](CHANGELOG.zh-CN.md) | [English](CHANGELOG.md) |