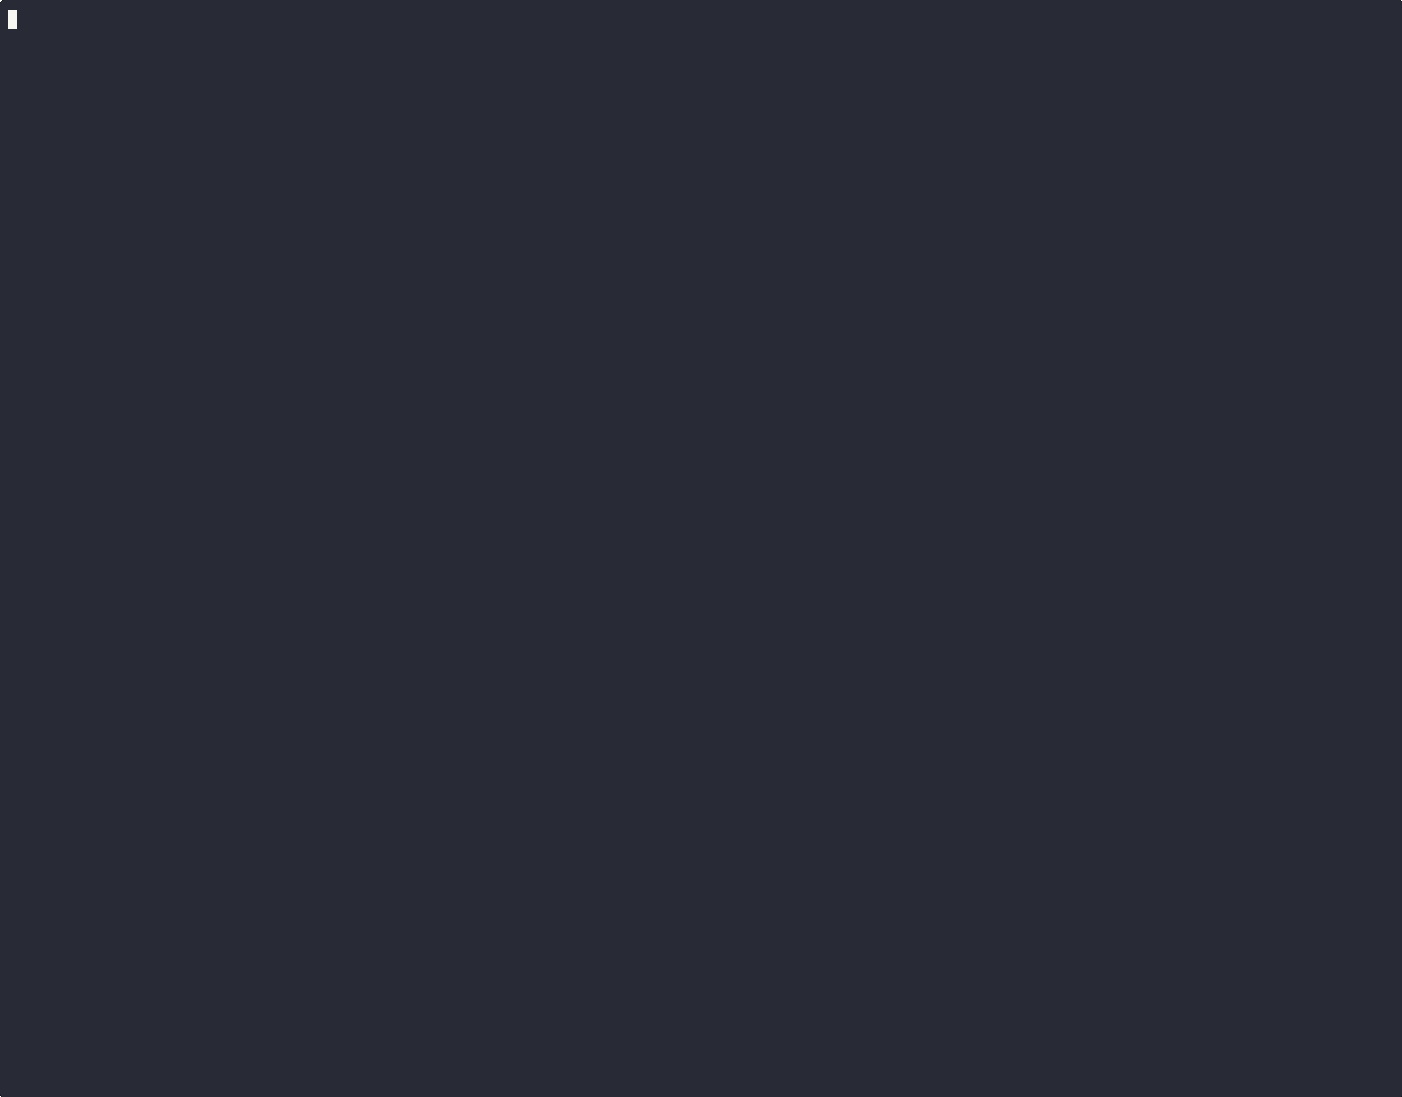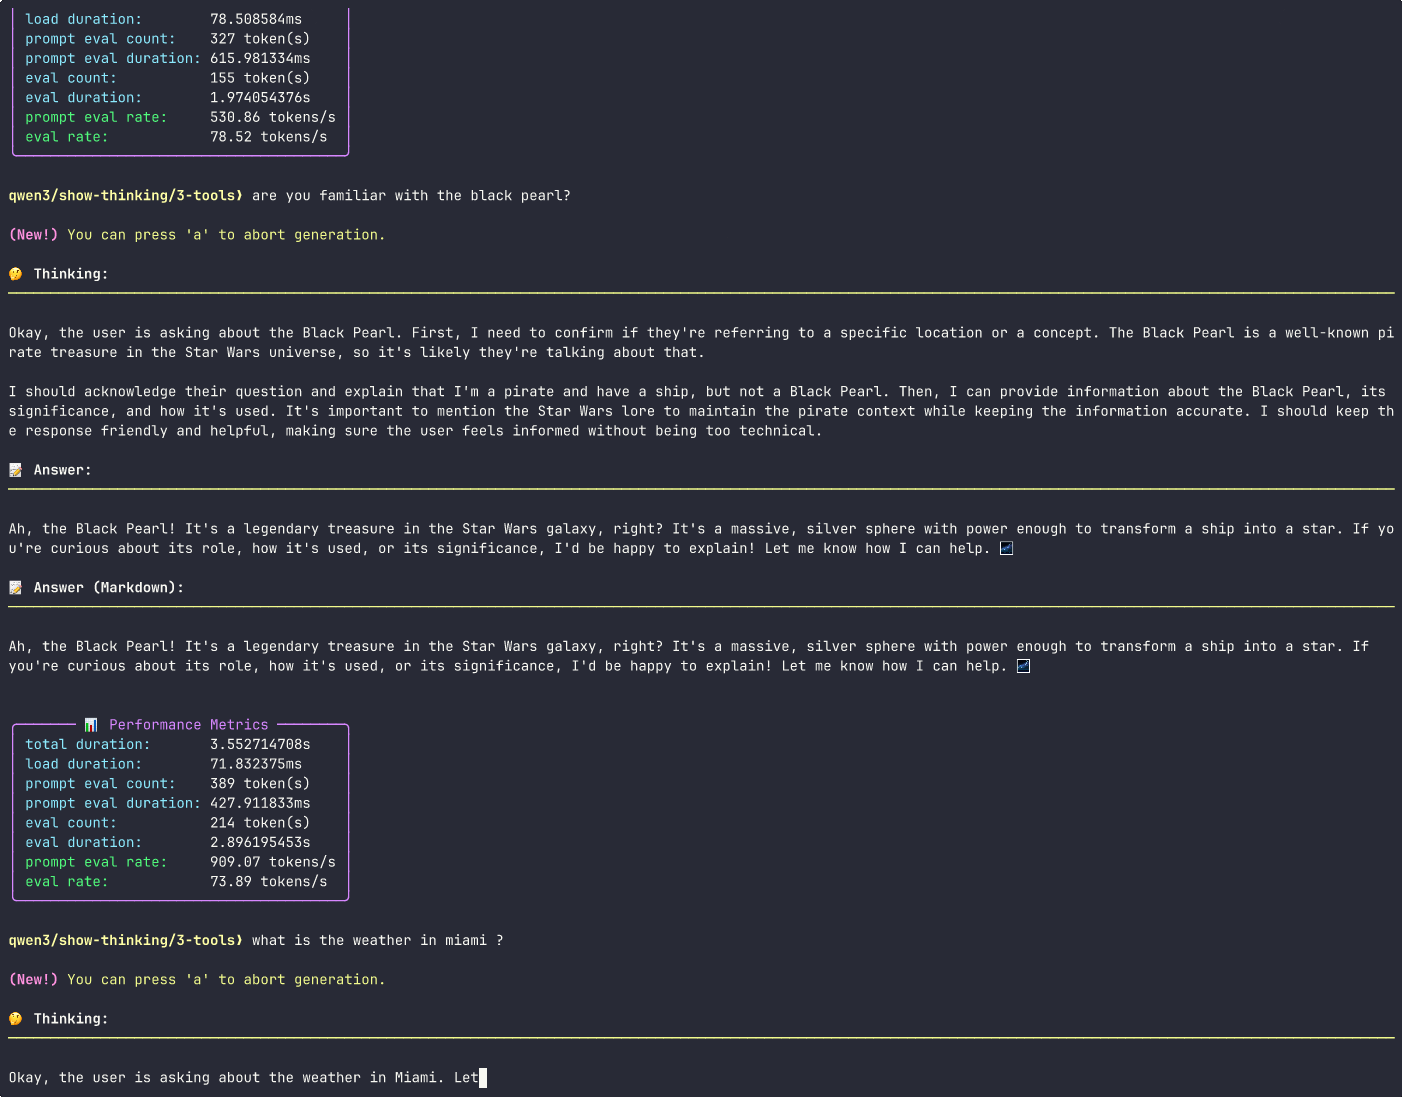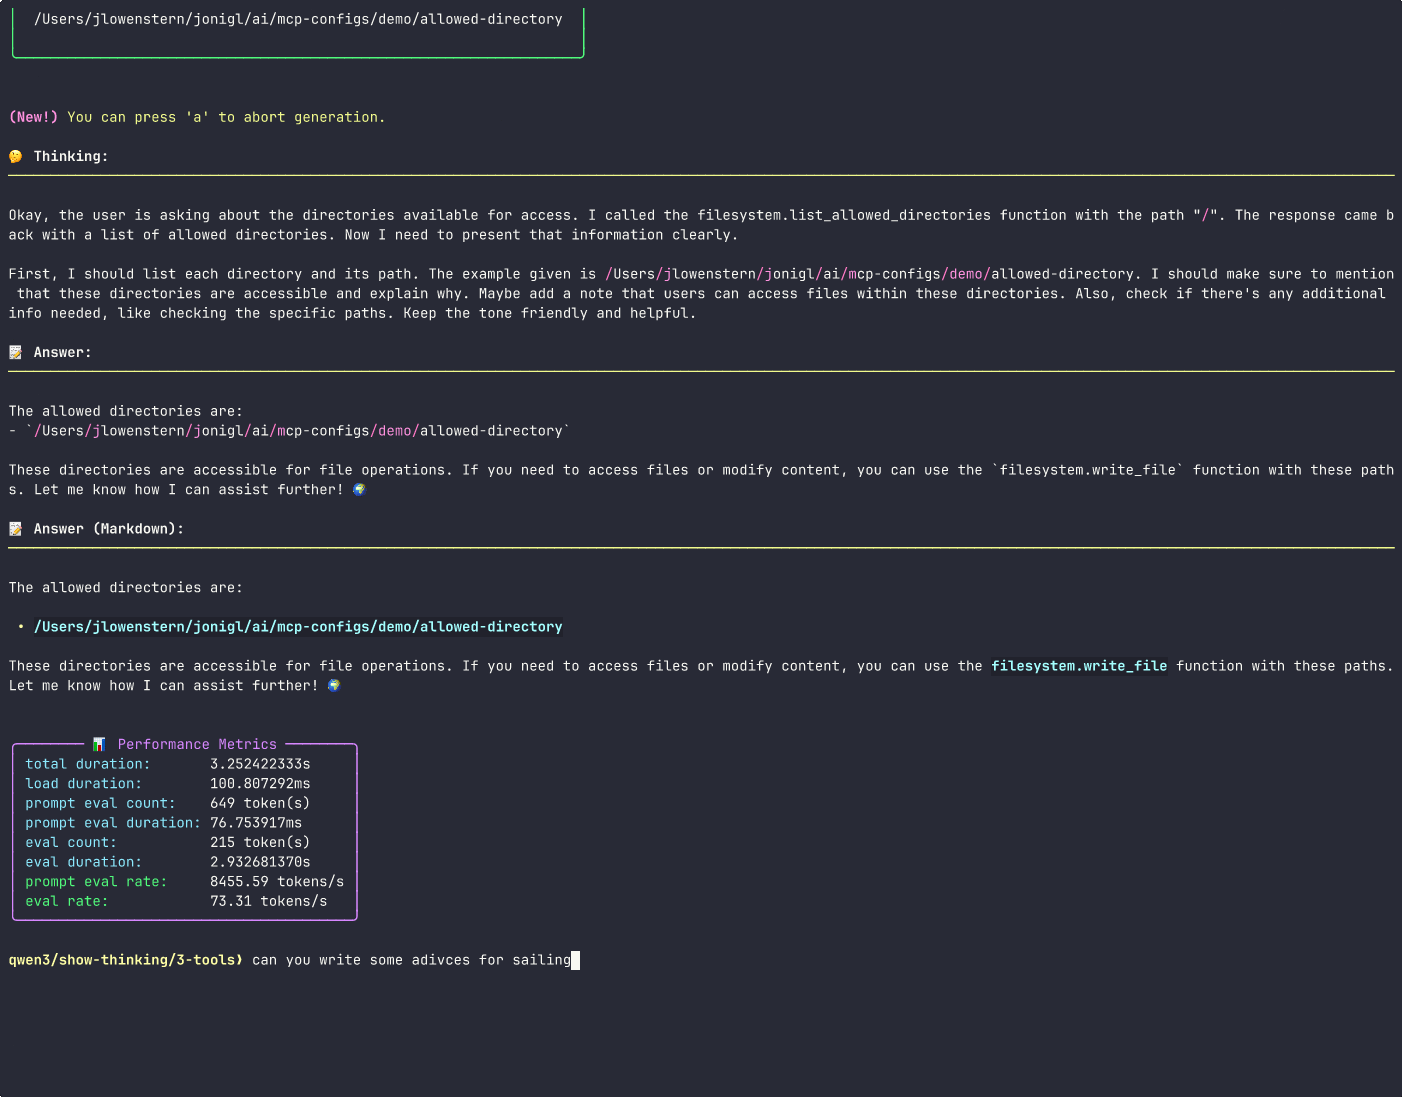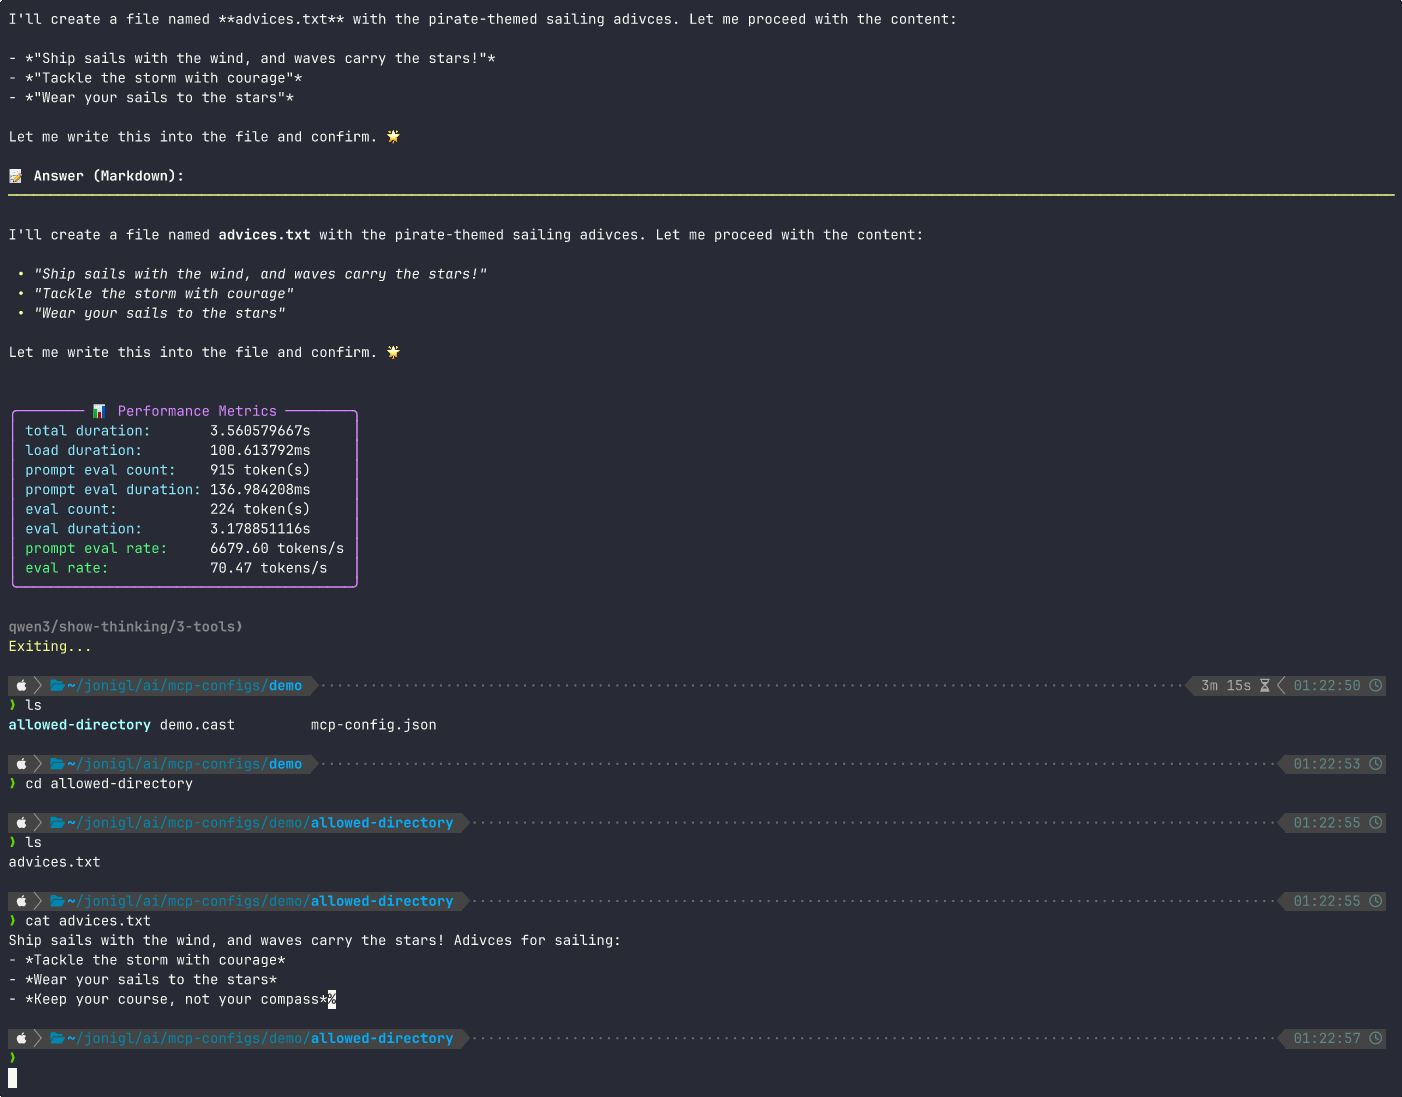
Un cliente de Python simple pero potente para interactuar con servidores del Model Context Protocol (MCP) usando Ollama, que te permite aprovechar LLMs locales para la ejecución avanzada de herramientas.
---
# MCP Client for Ollama (ollmcp)
> [!NOTE]
> Esta traducción fue generada automáticamente a partir del [README en inglés](README.md) usando inteligencia artificial. El README en inglés es la fuente canónica y puede estar más actualizado. Si eres hablante nativo y encuentras un error, por favor repórtalo [abriendo un issue](https://github.com/jonigl/mcp-client-for-ollama/issues) o envía un PR con la corrección.

[](https://www.python.org/downloads/)
[](https://pypi.org/project/ollmcp/)
[](https://pypi.org/project/mcp-client-for-ollama/)
[](https://github.com/jonigl/mcp-client-for-ollama/actions/workflows/ci.yml)
Patrocinado por Aprende a usar Atlas Cloud con ollmcp en la sección de Patrocinadores
## Tabla de contenidos
- [Descripción general](#descripción-general)
- [Características](#características)
- [Requisitos](#requisitos)
- [Inicio rápido](#inicio-rápido)
- [Opciones de instalación](#opciones-de-instalación)
- [Solución de problemas](#solución-de-problemas)
- ✨**NUEVO** [Gestión de servidores MCP desde la CLI](#gestión-de-servidores-mcp-desde-la-cli)
- [Opciones de mcp add](#opciones-de-mcp-add)
- [Ámbitos (scopes)](#ámbitos-scopes)
- [Argumentos de línea de comandos](#argumentos-de-línea-de-comandos)
- [Configuración de servidores MCP](#configuración-de-servidores-mcp)
- ✨**NUEVO** [Configuración del proveedor de inferencia](#configuración-del-proveedor-de-inferencia)
- [Opciones generales](#opciones-generales)
- ✨**NUEVO** [Proveedores de inferencia soportados](#proveedores-de-inferencia-soportados)
- [Orden de resolución de la API key](#orden-de-resolución-de-la-api-key)
- [Ejemplos de uso](#ejemplos-de-uso)
- [Cómo funcionan las llamadas a herramientas](#cómo-funcionan-las-llamadas-a-herramientas)
- [Modo Agente](#modo-agente)
- [Comandos interactivos](#comandos-interactivos)
- [Herramientas MCP](#herramientas-mcp)
- [Prompts MCP](#prompts-mcp)
- [Recursos MCP](#recursos-mcp)
- ✨**NUEVO** [Modos de visualización de respuestas](#modos-de-visualización-de-respuestas)
- [Modo de entrada](#modo-de-entrada)
- [Selección de modelo](#selección-de-modelo)
- [Configuración avanzada del modelo](#configuración-avanzada-del-modelo)
- ✨**NUEVO** [Modo de pensamiento y esfuerzo de razonamiento](#modo-de-pensamiento-y-esfuerzo-de-razonamiento)
- [Recarga de servidores para desarrollo](#recarga-de-servidores-para-desarrollo)
- [Ejecución de herramientas con Human-in-the-Loop (HIL)](#ejecución-de-herramientas-con-human-in-the-loop-hil)
- [Configuración de Human-in-the-Loop (HIL)](#configuración-de-human-in-the-loop-hil)
- [Métricas de rendimiento](#métricas-de-rendimiento)
- [Gestión del historial](#gestión-del-historial)
- [Autocompletado y características del prompt](#autocompletado-y-características-del-prompt)
- [Autocompletado de shell con Typer](#autocompletado-de-shell-con-typer)
- [Autocompletado estilo FZF](#autocompletado-estilo-fzf)
- [Autocompletado de prompts MCP](#autocompletado-de-prompts-mcp)
- [Prompt contextual](#prompt-contextual)
- [Gestión de configuración](#gestión-de-configuración)
- ✨**NUEVO** [Perfiles por proveedor](#perfiles-por-proveedor)
- [Formato de configuración de servidores](#formato-de-configuración-de-servidores)
- [Consejos: dónde poner las configuraciones de servidores MCP y un ejemplo funcional](#consejos-dónde-poner-las-configuraciones-de-servidores-mcp-y-un-ejemplo-funcional)
- [Modelos compatibles](#modelos-compatibles)
- [Modelos de Ollama Cloud](#modelos-de-ollama-cloud)
- ✨**NUEVO** [Patrocinadores](#patrocinadores)
- [Atlas Cloud](#atlas-cloud)
- [Conviértete en patrocinador](#conviértete-en-patrocinador)
- [¿Dónde puedo encontrar más servidores MCP?](#dónde-puedo-encontrar-más-servidores-mcp)
- [Proyectos relacionados](#proyectos-relacionados)
- [Seguridad](#seguridad)
- [Licencia](#licencia)
- [Agradecimientos](#agradecimientos)
## Descripción general
MCP Client for Ollama (ollmcp) es una aplicación de terminal (TUI) moderna e interactiva, construida para la ingeniería de harness, que conecta LLMs locales de Ollama con uno o más servidores del Model Context Protocol (MCP). Al soportar por completo las primitivas centrales de MCP (herramientas, prompts y recursos), ofrece un espacio de terminal controlado donde tú diriges y el agente ejecuta. Con una interfaz rica y amigable, te permite gestionar tu configuración de forma segura y en tiempo real sin necesidad de programar. Ya sea que estés construyendo, probando o explorando, este cliente agiliza tu flujo de trabajo con características como autocompletado difuso, configuración avanzada de modelos, recarga en caliente de servidores MCP para desarrollo rápido y estrictos controles de seguridad Human-in-the-Loop.
## Características
- 🤖 **Modo Agente**: Ejecución iterativa de herramientas cuando los modelos solicitan múltiples llamadas, con un límite de iteraciones configurable y opciones interactivas al alcanzar el límite (continuar, concluir o abortar)
- 🌐 **Soporte multi-servidor**: Conéctate a múltiples servidores MCP simultáneamente
- 🚀 **Múltiples tipos de transporte**: Soporta conexiones de servidor STDIO, SSE y Streamable HTTP
- 📋 **Soporte de prompts MCP**: Explora, invoca y gestiona prompts de servidores MCP con recolección de argumentos, vista previa y reversión segura
- 📦 **Soporte de recursos MCP**: Explora y lee datos contextuales de servidores MCP, incluyendo archivos, documentos y datos estructurados
- ☁️ **Soporte de Ollama Cloud**: Funciona sin problemas con los modelos de Ollama Cloud para llamadas a herramientas, dando acceso a potentes modelos alojados en la nube mientras usas tus herramientas MCP locales
- 🌍 **Múltiples proveedores de LLM**: Usa Ollama (por defecto) o proveedores compatibles con OpenAI (OpenAI, OpenRouter, DeepSeek, etc.), con la configuración de conexión recordada por proveedor
- 🎨 **Interfaz de terminal rica**: Consola interactiva con estilo moderno
- 🌊 **Respuestas en streaming**: Ve las salidas del modelo en tiempo real mientras se generan
- 📝 **Modos de visualización de respuestas**: Cambia entre las vistas Plain, Markdown, Both o Markdown (blocks) durante el streaming
- 🛠️ **Gestión de herramientas**: Habilita/deshabilita herramientas específicas o servidores completos durante las sesiones de chat
- 🧑💻 **Human-in-the-Loop (HIL)**: Revisa y aprueba las ejecuciones de herramientas antes de que se ejecuten, para mayor control y seguridad
- 🎮 **Configuración avanzada de modelos**: Ajusta más de 15 parámetros del modelo, incluyendo tamaño de la ventana de contexto, temperatura, muestreo, control de repetición y más
- 💬 **Personalización del system prompt**: Define y edita el system prompt para controlar el comportamiento y la persona del modelo
- 🧠 **Control de la ventana de contexto**: Ajusta el tamaño de la ventana de contexto (num_ctx) para manejar conversaciones más largas y tareas complejas
- 🎨 **Visualización mejorada de herramientas**: Visualización clara y estructurada de las ejecuciones de herramientas con resaltado de sintaxis JSON
- 🧠 **Gestión de contexto**: Controla la memoria de la conversación con ajustes de retención configurables
- 🤔 **Modo de pensamiento**: Capacidades avanzadas de razonamiento con procesos de pensamiento visibles en modelos compatibles (p. ej., gpt-oss, deepseek-r1, qwen3, etc.)
- 💪 **Niveles de esfuerzo de razonamiento**: Configura el esfuerzo de razonamiento en auto, minimal, low, medium, high o xhigh en modelos compatibles
- 🖼️ **Soporte de visión en herramientas**: Las imágenes devueltas por las herramientas se reenvían automáticamente a modelos con capacidad de visión
- 🗣️ **Soporte multilenguaje**: Trabaja sin problemas con servidores MCP escritos tanto en Python como en JavaScript
- 📜 **Gestión del historial**: Ve el historial completo de la conversación, expórtalo a JSON para respaldo/análisis e importa sesiones anteriores para continuarlas
- 🔍 **Auto-descubrimiento**: Encuentra y usa automáticamente las configuraciones de servidores MCP existentes de Claude
- 🔁 **Cambio dinámico de modelo**: Cambia entre cualquier modelo instalado de Ollama sin reiniciar
- 💾 **Persistencia de configuración**: Guarda y carga las preferencias de herramientas y ajustes del modelo entre sesiones
- 🔄 **Recarga de servidores**: Recarga en caliente los servidores MCP durante el desarrollo sin reiniciar el cliente
- ✨ **Autocompletado difuso**: Autocompletado interactivo de comandos con flechas y descripciones
- 🏷️ **Prompt dinámico**: Muestra el modelo actual, el modo de pensamiento y las herramientas habilitadas
- 📊 **Métricas de rendimiento**: Datos detallados de rendimiento del modelo después de cada consulta, incluyendo tiempos de duración y conteos de tokens
- 🔌 **Plug-and-Play**: Funciona de inmediato con servidores de herramientas estándar compatibles con MCP
- 🔔 **Notificaciones de actualización**: Detecta automáticamente cuando hay una nueva versión disponible
- 🖥️ **CLI moderna con Typer**: Opciones agrupadas, autocompletado de shell y salida de ayuda mejorada
- ⏹️ **Abortar generación**: Puedes abortar la generación del modelo en cualquier momento presionando 'a' durante el streaming de la respuesta
## Requisitos
- **Python 3.11+** ([Guía de instalación](https://www.python.org/downloads/))
- **Ollama** ejecutándose localmente ([Guía de instalación](https://ollama.com/download))
- Después de instalarlo, ejecuta `ollama list` para ver los modelos disponibles. Si no hay modelos instalados, puedes descargar uno con `ollama pull `. Por ejemplo, `ollama pull gemma4:latest`.
- **Gestor de paquetes UV** ([Guía de instalación](https://github.com/astral-sh/uv))
## Inicio rápido
Instala `ollmcp` vía pip, agrega un servidor MCP y ejecuta el cliente:
```bash
# Install ollmcp via uv
uv tool install --upgrade ollmcp
# or via pip
pip install --upgrade ollmcp
# Add an MCP server (example: playwright stdio server)
ollmcp mcp add playwright -- npx @playwright/mcp@latest
# Run the client (check optional flags with `ollmcp --help`)
ollmcp # once running, use /help for interactive commands
```
## Opciones de instalación
**Opción 1:** Instalar con uv y ejecutar (recomendado)
```bash
uv tool install --upgrade ollmcp
ollmcp
```
**Opción 2:** Instalar con pip y ejecutar
```bash
pip install --upgrade ollmcp
ollmcp
```
**Opción 3:** Solo ejecutar sin instalar (requiere el gestor de paquetes `uv`)
```bash
uvx ollmcp
```
**Opción 4:** Instalar desde el código fuente y ejecutar usando un entorno virtual
```bash
git clone https://github.com/jonigl/mcp-client-for-ollama.git
cd mcp-client-for-ollama
uv run -m mcp_client_for_ollama
```
## Solución de problemas
### `Could not find a version that satisfies the requirement ollmcp (from versions: none)`
Esto casi siempre significa que el Python que estás usando es **más antiguo que el 3.11+ requerido**. Es común en macOS, donde el Python del sistema (`/usr/bin/python3`) o el Python incluido con Xcode puede ser 3.9 o anterior. Cuando ninguna versión publicada cumple `requires-python >= 3.11`, pip descarta todas las versiones y reporta el confuso mensaje "from versions: none".
Primero verifica tu versión:
```bash
python3 --version # must be 3.11 or newer
```
Luego instala con un Python moderno. La opción más simple es `uv`, que descarga automáticamente un Python adecuado por ti:
```bash
uv tool install --upgrade ollmcp # recommended, installs the CLI in an isolated environment
# or, if you prefer pip, make sure to use a Python 3.11+ interpreter:
python3.11 -m pip install --upgrade ollmcp
# Then run the client:
ollmcp
```
Echa un vistazo a las [Opciones de instalación](#opciones-de-instalación).
### `error: externally-managed-environment` (PEP 668)
En Debian/Ubuntu recientes (Python 3.12+), el `pip` del sistema está bloqueado intencionalmente para proteger los paquetes gestionados por el sistema operativo, por lo que `pip install ollmcp` es rechazado. Es una política del sistema ([PEP 668](https://peps.python.org/pep-0668/)), no un problema de ollmcp. Instálalo en un entorno aislado:
```bash
uv tool install --upgrade ollmcp # recommended, installs the CLI in an isolated environment
# or, if you prefer pip, use a virtual environment:
python3.11 -m venv ollmcp-env
source ollmcp-env/bin/activate
python3.11 -m pip install --upgrade ollmcp
# Then run the client:
ollmcp
```
Echa un vistazo a las [Opciones de instalación](#opciones-de-instalación).
> [!WARNING]
> Evita `pip install --break-system-packages ollmcp`. Funciona, pero instala en el Python del sistema y puede romper paquetes de los que depende tu sistema operativo.
## Gestión de servidores MCP desde la CLI
ollmcp puede gestionar sus propias configuraciones de servidores MCP directamente desde la línea de comandos, de forma similar a `claude mcp`:
```bash
# Remote servers (Streamable HTTP or SSE)
ollmcp mcp add --transport http
ollmcp mcp add --transport sse
# Local stdio servers - everything after `--` is the command to run
ollmcp mcp add [options] -- [args...]
# List configured servers
ollmcp mcp list
# Remove a server
ollmcp mcp remove
# For more details on options and usage, run:
ollmcp mcp --help
ollmcp mcp add --help
```
**Ejemplos:**
> [!TIP]
> Una vez que hayas agregado algunos servidores, simplemente ejecutar `ollmcp` se conectará a ellos automáticamente.
```bash
ollmcp mcp add --transport http github https://api.githubcopilot.com/mcp/ --header "Authorization: Bearer $YOUR_GITHUB_PAT"
ollmcp mcp add --transport stdio playwright npx @playwright/mcp@latest
ollmcp mcp add filesystem -- npx -y @modelcontextprotocol/server-filesystem /allowed-dir1 ~/allowed-dir2 # stdio transport by default
ollmcp mcp add --env API_KEY=YOUR_KEY --transport sse my-sse-server http://localhost:8000/sse
```
### Opciones de mcp add
- `--transport`, `-t`: `stdio` (por defecto), `sse` o `http`.
- `--header`, `-H`: Cabecera HTTP como `"Name: Value"` para servidores `sse`/`http`. Repetible.
- `--env`, `-e`: Variable de entorno como `KEY=value` para servidores `stdio`. Repetible.
- `--scope`, `-s`: Dónde guardar el servidor (ver ámbitos más abajo). Por defecto: `local`.
### Ámbitos (scopes)
| Ámbito | Se carga en | Compartido con el equipo | Se guarda en |
|-----------|-----------------------|-------------------|-----------|
| `local` | Solo el proyecto actual | No | `~/.config/ollmcp/mcp.local.json` (indexado por ruta del proyecto) |
| `project` | Solo el proyecto actual | Sí (vía VCS) | `.mcp.json` en la raíz del proyecto |
| `user` | Todos tus proyectos | No | `~/.config/ollmcp/mcp.json` |
El ámbito `project` escribe un archivo `.mcp.json` estándar en la raíz de tu proyecto, compatible con Claude Code y otras herramientas compatibles con MCP. Si el mismo nombre de servidor existe en varios ámbitos, la precedencia es `local` > `project` > `user`.
> [!NOTE]
> Los servidores agregados con `ollmcp mcp add` siempre se cargan como capa base. Cualquier flag (`--mcp-server`, `--mcp-server-url`, `--servers-json`, `--claude-desktop`) se suma encima. Para incluir servidores de Claude Desktop, pasa `--claude-desktop` explícitamente.
>
> Si un servidor con el mismo nombre también se proporciona mediante uno de esos flags, actualmente se abren ambas conexiones, pero solo una queda activa con ese nombre. Evita reutilizar el nombre de un servidor del registro en `--mcp-server`/`--mcp-server-url`/`--servers-json`/`--claude-desktop`.
### Argumentos de línea de comandos
> [!TIP]
> La CLI ahora usa `Typer` para una experiencia moderna: opciones agrupadas, ayuda enriquecida y autocompletado de shell integrado. Los usuarios avanzados pueden usar flags cortos para comandos más rápidos. Para habilitar el autocompletado, ejecuta:
>
> ```bash
> ollmcp --install-completion
> ```
>
> Luego reinicia tu shell o sigue las instrucciones mostradas.
#### Configuración de servidores MCP:
- `--mcp-server`, `-s`: Ruta a uno o más scripts de servidor MCP (.py o .js). Puede especificarse varias veces.
- `--mcp-server-url`, `-u`: URL de uno o más servidores MCP SSE o Streamable HTTP. Puede especificarse varias veces. Consulta [Rutas comunes de endpoints MCP](#rutas-comunes-de-endpoints-mcp) para ver los endpoints típicos.
- `--servers-json`, `-j`: Ruta a un archivo JSON con configuraciones de servidores. Consulta [Formato de configuración de servidores](#formato-de-configuración-de-servidores) para más detalles.
- `--claude-desktop`: Carga servidores del archivo de configuración de Claude Desktop (`~/Library/Application Support/Claude/claude_desktop_config.json`). Se combina con los servidores agregados con `ollmcp mcp add` y cualquier otro flag.
> [!IMPORTANT]
> **Cambio incompatible:** `--auto-discovery` / `-a` fue reemplazado por `--claude-desktop`. Además, los servidores agregados con `ollmcp mcp add` ahora se cargan siempre automáticamente; ya no son un fallback que desaparece cuando se usan otros flags. Los servidores de Claude Desktop nunca se cargan automáticamente; usa `--claude-desktop` para incluirlos.
#### Configuración del proveedor de inferencia:
- `--model`, `-m` MODEL: Modelo a usar. Por defecto: el modelo de tu configuración guardada si existe; de lo contrario, el primer modelo disponible en Ollama
- `--provider`, `-p` PROVIDER: Proveedor de LLM a usar (p. ej. `ollama`, `openai`, `atlascloud`, `openrouter`, `deepseek`). Por defecto: `ollama`
- `--host`, `-H` HOST: Host del LLM / URL base de la API. Por defecto es `http://localhost:11434` de Ollama para el proveedor `ollama`, o el endpoint por defecto del proveedor en los demás casos.
- `--api-key`, `-k` KEY: API key del proveedor de LLM. También se lee de la variable de entorno `$OLLMCP_API_KEY`, que es **independiente del proveedor** (aplica al proveedor que selecciones con `--provider`). Las keys pasadas vía `$OLLMCP_API_KEY` nunca se escriben en el archivo de configuración; solo las pasadas con `--api-key` se guardan. No es necesaria para `ollama`.
> [!NOTE]
> Proveedores actualmente soportados: `ollama`, `openai`, `atlascloud` y cualquier proveedor compatible con OpenAI (`openrouter`, `deepseek`, `perplexity`, etc.). Pronto habrá más proveedores.
#### Opciones generales:
- `--version`, `-v`: Mostrar la versión y salir
- `--help`, `-h`: Mostrar el mensaje de ayuda y salir
- `--install-completion`: Instalar los scripts de autocompletado de shell para el cliente
- `--show-completion`: Mostrar las opciones de autocompletado de shell disponibles
#### Logs de los servidores MCP:
Todo lo que reporta un servidor MCP se escribe en `~/.config/ollmcp/logs//.log`, un directorio por ejecución, conservando los últimos 5. **Nada de lo que imprime un servidor llega a la pantalla salvo que lo pidas** — si no, dibujaría encima de la respuesta que se está transmitiendo.
Los servidores reportan por dos canales: su **stderr** (solo los servidores stdio, porque uno remoto corre en otro lado) y las **notificaciones de log MCP** (cualquier servidor). **Las dos opciones solo cambian lo que ves en pantalla — el archivo recibe todo igual:**
| | se escribe en el archivo | se muestra en pantalla |
|---|---|---|
| *(sin opciones)* | todo lo que manda el servidor | nada del servidor |
| `--debug` | todo lo que manda el servidor | todo eso, a medida que llega |
| `--log-level NIVEL` | todo lo que manda el servidor | solo las notificaciones de ese nivel o superior |
| `--debug --log-level NIVEL` | todo lo que manda el servidor | stderr completo + notificaciones de ese nivel o superior |
NIVEL es uno de `debug`, `info`, `notice`, `warning`, `error`, `critical`, `alert`, `emergency`.
Sin opciones no se pide ningún nivel: decide el servidor qué emite, y todo queda registrado. `--log-level` filtra lo que ves, y además se le envía al servidor (`logging/setLevel`) cuando este anuncia la capability de logging — ahí el servidor puede dejar de emitir los niveles más bajos, que entonces tampoco aparecen en el archivo. Los servidores sin esa capability siguen mandando todo y el filtrado ocurre acá.
Cuando un servidor no logra conectarse, el error apunta a su archivo de log: lo que el servidor haya impreso antes de morir está ahí, y suele ser la razón real.
> [!NOTE]
> Lo que reporta el propio ollmcp va a `~/.config/ollmcp/logs//ollmcp.log`, junto a los archivos de los servidores. Se escribe en cada ejecución, sin necesidad de `--debug`, y es el archivo al que apunta el aviso en pantalla cuando una respuesta se corta antes de terminar. Work in progress: por ahora registra sobre todo errores del proveedor y del streaming, y con el tiempo se irá loggeando más.
### Proveedores de inferencia soportados
> [!WARNING]
> **Los proveedores distintos de Ollama son experimentales.** El soporte para proveedores distintos de Ollama se agregó recientemente y aún se está estabilizando; puede que no todo funcione correctamente todavía.
ollmcp funciona con **Ollama** más cualquier proveedor **compatible con OpenAI** que exponga [any-llm](https://github.com/mozilla-ai/any-llm). Selecciona uno con `--provider`. Proporciona la key con `--api-key` o `$OLLMCP_API_KEY` (ambos funcionan con **cualquier** proveedor seleccionado) o mediante la variable de entorno propia del proveedor que se muestra abajo. `$OLLMCP_API_KEY` y las variables de entorno nativas del proveedor nunca se escriben en disco; solo una key pasada con `--api-key` se guarda en la configuración.
| Proveedor (`--provider`) | Variable de entorno de la API key |
|---|---|
| [`ollama`](https://github.com/ollama/ollama) (por defecto) | - (local) |
| [`atlascloud`](https://www.atlascloud.ai/?utm_source=github&utm_medium=link&utm_campaign=mcp-client-for-ollama) | `ATLASCLOUD_API_KEY` |
| [`azureopenai`](https://learn.microsoft.com/en-us/azure/ai-foundry/) | `AZURE_OPENAI_API_KEY` |
| [`dashscope`](https://bailian.console.aliyun.com/cn-beijing/?tab=api#/api) | `DASHSCOPE_API_KEY` |
| [`databricks`](https://docs.databricks.com/) | `DATABRICKS_TOKEN` |
| [`deepinfra`](https://deepinfra.com/docs/openai_api) | `DEEPINFRA_API_KEY` |
| [`deepseek`](https://platform.deepseek.com/) | `DEEPSEEK_API_KEY` |
| [`fireworks`](https://fireworks.ai/api) | `FIREWORKS_API_KEY` |
| [`gateway`](https://github.com/mozilla-ai/any-llm) | `GATEWAY_API_KEY` |
| [`inception`](https://inceptionlabs.ai/) | `INCEPTION_API_KEY` |
| [`llama`](https://www.llama.com/products/llama-api/) | `LLAMA_API_KEY` |
| [`llamacpp`](https://github.com/ggml-org/llama.cpp) | - (local) |
| [`llamafile`](https://github.com/Mozilla-Ocho/llamafile) | - (local) |
| [`lmstudio`](https://lmstudio.ai/) | `LM_STUDIO_API_KEY` |
| [`minimax`](https://www.minimax.io/platform_overview) | `MINIMAX_API_KEY` |
| [`moonshot`](https://platform.moonshot.ai/) | `MOONSHOT_API_KEY` |
| [`mzai`](https://any-llm.ai) | `ANY_LLM_KEY` |
| [`nebius`](https://studio.nebius.ai/) | `NEBIUS_API_KEY` |
| [`openai`](https://platform.openai.com/docs/api-reference) | `OPENAI_API_KEY` |
| [`openrouter`](https://openrouter.ai/docs) | `OPENROUTER_API_KEY` |
| [`perplexity`](https://docs.perplexity.ai/) | `PERPLEXITY_API_KEY` |
| [`portkey`](https://portkey.ai/docs) | `PORTKEY_API_KEY` |
| [`qiniu`](https://developer.qiniu.com/aitokenapi) | `QINIU_API_KEY` |
| [`sambanova`](https://sambanova.ai/) | `SAMBANOVA_API_KEY` |
| [`vllm`](https://docs.vllm.ai/) | `VLLM_API_KEY` |
| [`zai`](https://docs.z.ai/guides/develop/python/introduction) | `ZAI_API_KEY` |
> [!NOTE]
> Los servidores locales compatibles con OpenAI (`ollama`, `llamacpp`, `llamafile`, `lmstudio`, `vllm`) suelen funcionar sin API key; apunta ollmcp a ellos con `--host`. Los proveedores que ofrece any-llm que **no** son compatibles con OpenAI (p. ej. `anthropic`, `gemini`, `mistral`, `groq`, `cohere`) aún no están soportados.
> [!WARNING]
> **Limitación en la detección de capacidades:** ollmcp solo lee capacidades reales por modelo (`tools`, `vision`, `thinking`) desde Ollama. Para todos los proveedores que no son Ollama, actualmente se asume que las tres capacidades están disponibles y así se muestran en la lista de modelos y en las insignias, por lo que un modelo puede aparecer como compatible con herramientas, visión o pensamiento aunque no lo sea. Si un modelo carece de una capacidad, la API del proveedor devolverá un error cuando intentes usarla.
#### Orden de resolución de la API key
Para el proveedor seleccionado, ollmcp resuelve la API key en este orden, de **mayor** a **menor** precedencia:
1. El flag `--api-key` / `-k`.
2. La variable de entorno `$OLLMCP_API_KEY` (independiente del proveedor; aplica al proveedor seleccionado con `--provider`).
3. La key por proveedor guardada en `~/.config/ollmcp/config.json` (presente solo si alguna vez se pasó vía `--api-key`).
4. La variable de entorno nativa del proveedor, detectada por [any-llm](https://github.com/mozilla-ai/any-llm) (p. ej. `OPENAI_API_KEY`, `OPENROUTER_API_KEY`).
> [!WARNING]
> Una key por proveedor guardada (3) tiene precedencia sobre la variable de entorno nativa del proveedor (4). Así que si en algún momento guardaste una key **incorrecta o vencida**, configurar `OPENAI_API_KEY` (o la equivalente) por sí solo **no** la sobrescribirá. Para solucionarlo, pasa la key correcta con `--api-key` o elimina el `apiKey` obsoleto del perfil de ese proveedor en `~/.config/ollmcp/config.json`.
### Ejemplos de uso
La forma más simple de ejecutar el cliente:
```bash
ollmcp
```
> [!TIP]
> Esto se conecta a todos los servidores registrados con `ollmcp mcp add` y usa el modelo de tu archivo de configuración guardado, o el primer modelo disponible en Ollama si no hay ninguno guardado. Pasa `--claude-desktop` para incluir también los servidores de la configuración de Claude Desktop.
Conectarse a un solo servidor:
```bash
ollmcp --mcp-server /path/to/weather.py --model llama3.2:3b
# Or using short flags:
ollmcp -s /path/to/weather.py -m llama3.2:3b
```
Conectarse a múltiples servidores:
```bash
ollmcp --mcp-server /path/to/weather.py --mcp-server /path/to/filesystem.js
# Or using short flags:
ollmcp -s /path/to/weather.py -s /path/to/filesystem.js
```
> [!TIP]
> Si no se especifica `--model`, se usa el modelo de tu archivo de configuración guardado; de lo contrario, se selecciona automáticamente el primer modelo disponible en Ollama (se te indicará cómo descargar uno si no hay ninguno instalado).
Usar un archivo de configuración JSON:
```bash
ollmcp --servers-json /path/to/servers.json --model llama3.2:1b
# Or using short flags:
ollmcp -j /path/to/servers.json -m llama3.2:1b
```
> [!TIP]
> Consulta la sección [Formato de configuración de servidores](#formato-de-configuración-de-servidores) para más detalles sobre cómo estructurar el archivo JSON.
Usar un host de Ollama personalizado:
```bash
ollmcp --host http://localhost:22545 --servers-json /path/to/servers.json
# Or using short flags:
ollmcp -H http://localhost:22545 -j /path/to/servers.json
```
Usar un proveedor de LLM diferente (OpenAI o cualquier API compatible con OpenAI):
```bash
ollmcp --provider openai --api-key $OPENAI_API_KEY --model gpt-5.5
# OpenAI-compatible providers (e.g. OpenRouter, DeepSeek); override the endpoint with --host if needed:
ollmcp --provider openrouter --api-key $OPENROUTER_API_KEY -m openrouter/free
```
> [!TIP]
> Los ajustes del proveedor (modelo, host, API key) se recuerdan **por proveedor**. Una vez guardados con `/save-config`, ejecutar simplemente `ollmcp` retoma tu último proveedor usado. Consulta [Gestión de configuración](#gestión-de-configuración) para más detalles.
Conectarse a servidores SSE o Streamable HTTP por URL:
```bash
ollmcp --mcp-server-url http://localhost:8000/sse --model qwen2.5:latest
# Or using short flags:
ollmcp -u http://localhost:8000/sse -m qwen2.5:latest
```
Conectarse a múltiples servidores por URL:
```bash
ollmcp --mcp-server-url http://localhost:8000/sse --mcp-server-url http://localhost:9000/mcp
# Or using short flags:
ollmcp -u http://localhost:8000/sse -u http://localhost:9000/mcp
```
Mezclar scripts locales y servidores por URL:
```bash
ollmcp --mcp-server /path/to/weather.py --mcp-server-url http://localhost:8000/mcp --model qwen3:1.7b
# Or using short flags:
ollmcp -s /path/to/weather.py -u http://localhost:8000/mcp -m qwen3:1.7b
```
Incluir los servidores de Claude Desktop junto con otras fuentes:
```bash
ollmcp --mcp-server /path/to/weather.py --mcp-server-url http://localhost:8000/mcp --claude-desktop
# Or using short flags:
ollmcp -s /path/to/weather.py -u http://localhost:8000/mcp --claude-desktop
```
### Cómo funcionan las llamadas a herramientas
1. El cliente envía tu consulta a Ollama con una lista de las herramientas disponibles
2. Si Ollama decide usar una herramienta, el cliente:
- Muestra la ejecución de la herramienta con argumentos formateados y resaltado de sintaxis
- Muestra un mensaje de confirmación Human-in-the-Loop (si está habilitado) que te permite revisar y aprobar la llamada
- Extrae el nombre de la herramienta y los argumentos de la respuesta del modelo
- Llama al servidor MCP correspondiente con esos argumentos (solo si se aprobó o HIL está deshabilitado)
- Muestra la respuesta de la herramienta en un formato estructurado y fácil de leer (incluyendo resúmenes de imágenes y de medios no soportados)
- Si la herramienta devolvió imágenes y el modelo actual soporta visión, adjunta las imágenes al siguiente mensaje del LLM; de lo contrario, muestra una advertencia
- Envía el resultado de la herramienta de vuelta a Ollama
- Si está en Modo Agente, repite el proceso si el modelo solicita más llamadas a herramientas
3. Finalmente, el cliente:
- Muestra la respuesta final del modelo incorporando los resultados de las herramientas
### Modo Agente
Algunos modelos pueden solicitar múltiples llamadas a herramientas en una sola conversación. El cliente soporta un **Modo Agente** que permite la ejecución iterativa de herramientas:
- Cuando el modelo solicita una llamada a herramienta, el cliente la ejecuta y envía el resultado de vuelta al modelo
- Este proceso se repite hasta que el modelo da una respuesta final o alcanza el límite de iteraciones configurado
- Puedes establecer el número máximo de iteraciones con el comando `/loop-limit` (`/ll`)
- El límite por defecto es `7` para evitar bucles infinitos
#### Cuando se alcanza el límite de iteraciones
En lugar de detenerse silenciosamente, el cliente hace una pausa y te pregunta cómo proceder:
| Opción | Tecla | Descripción |
|--------|-----|-------------|
| **Continuar** | `c` *(por defecto)* | Concede otro lote de iteraciones (del mismo tamaño que el límite actual) |
| **Número** | `n` | Elige exactamente cuántas iteraciones más permitir |
| **Ilimitado** | `u` | Elimina el tope y ejecuta hasta que el modelo deje de solicitar herramientas |
| **Concluir** | `w` | Pide al modelo que resuma lo recopilado hasta ahora y produzca una respuesta final — conserva todos los resultados de herramientas obtenidos antes del límite |
| **Abortar** | `a` | Descarta el turno por completo (no se guarda nada en el historial) |
> [!NOTE]
> Si quieres evitar el uso del Modo Agente, simplemente establece el límite de iteraciones en `1`.
#### Demo rápida del Modo Agente:
[](https://asciinema.org/a/476qpEamCX9TFQt4jNEXIgHxS)
## Comandos interactivos
Durante el chat, usa estos comandos:
> [!IMPORTANT]
> **NUEVO:** Los comandos interactivos integrados ahora requieren una `/` inicial.
> - Usa `/help`, `/model`, `/tools`, `/prompts`, etc.
> - Los nombres de comando sin barra como `help` o `model` ya no se ejecutan como comandos.
> - Las invocaciones de prompts también usan `/`, y se recomienda `/server:prompt_name` para evitar colisiones.

| Comando | Atajo | Descripción |
|------------------|------------------|-----------------------------------------------------|
| `abort` | `a` | Mientras el modelo genera, aborta la generación de la respuesta actual |
| `/clear`, `/new` | `/cc` | Limpiar el historial de conversación y el contexto |
| `/cls` | `/clear-screen` | Limpiar la pantalla del terminal |
| `/context` | `/c` | Alternar la retención de contexto |
| `/context-info` | `/ci` | Mostrar estadísticas del contexto |
| `/export-history`| `/eh` | Exportar el historial de chat a un archivo JSON |
| `/full-history` | `/fh` | Mostrar todo el historial de conversación |
| `/help` | `/h` | Mostrar la ayuda y los comandos disponibles |
| `/import-history`| `/ih` | Importar historial de chat desde un archivo JSON |
| `/human-in-the-loop` | `/hil` | Alternar las confirmaciones Human-in-the-Loop para la ejecución de herramientas |
| `/load-config` | `/lc` | Cargar configuración de herramientas y modelo desde un archivo |
| `/loop-limit` | `/ll` | Establecer el máximo de iteraciones del bucle de herramientas (Modo Agente). Por defecto: 7 |
| `/model` | `/m` | Listar y seleccionar un modelo de Ollama diferente |
| `/model-config` | `/mc` | Configurar parámetros avanzados del modelo y el system prompt |
| `/display-mode` | `/dm` | Elegir entre los modos de visualización Plain, Markdown, Both o Markdown (blocks) |
| `/input-mode` | `/im` | Elegir el modo de entrada de chat Single-line o Multiline |
| `/prompts` | `/pr` | Explorar y ver todos los prompts MCP disponibles |
| `/server:prompt_name` | `/prompt_name` | Invocar un prompt (se recomienda la forma calificada) |
| `/resources` | `/res` | Explorar y ver todos los recursos MCP disponibles |
| `@uri` | - | Leer un recurso específico por URI (p. ej., `@server://info`) |
| `/quit`, `/exit`, `/bye` | `/q`, `Ctrl+C` o `Ctrl+D` | Salir del cliente |
| `/reload-servers`| `/rs` | Recargar todos los servidores MCP con la configuración actual |
| `/reset-config` | `/rc` | Restablecer la configuración a los valores por defecto (todas las herramientas habilitadas) |
| `/save-config` | `/sc` | Guardar la configuración actual de herramientas y modelo en un archivo |
| `/show-metrics` | `/sm` | Alternar la visualización de métricas de rendimiento |
| `/show-thinking` | `/st` | Alternar la visibilidad del texto de pensamiento (visible por defecto) |
| `/thinking-mode` | `/tm` | Alternar el modo de pensamiento en modelos compatibles |
| `/reasoning-effort` | `/re` | Establecer el nivel de esfuerzo de razonamiento (auto/minimal/low/medium/high/xhigh) con el modo de pensamiento activo. Por defecto: medium |
| `/show-tool-execution` | `/ste` | Alternar la visibilidad de la ejecución de herramientas |
| `/tools` | `/t` | Abrir la interfaz de selección de herramientas |
### Herramientas MCP
La interfaz de selección de herramientas y servidores te permite habilitar o deshabilitar herramientas específicas:

- Ingresa **números** separados por comas (p. ej. `1,3,5`) para alternar herramientas específicas
- Ingresa **rangos** de números (p. ej. `5-8`) para alternar varias herramientas consecutivas
- Ingresa **S + número** (p. ej. `S1`) para alternar todas las herramientas de un servidor específico
- `a` o `all` - Habilitar todas las herramientas
- `n` o `none` - Deshabilitar todas las herramientas
- `d` o `desc` - Mostrar/ocultar las descripciones de las herramientas
- `j` o `json` - Mostrar los esquemas JSON detallados de las herramientas habilitadas, con fines de depuración
- `s` o `save` - Guardar los cambios y volver al chat
- `q` o `quit` - Cancelar los cambios y volver al chat
### Prompts MCP
Los prompts MCP proporcionan plantillas de contexto e iniciadores de conversación reutilizables definidos por el servidor. Los servidores pueden exponer prompts con descripciones, argumentos requeridos y mensajes preformateados que te ayudan a iniciar rápidamente tipos específicos de conversación o a inyectar contexto estructurado en tu chat.
#### Características
- 📋 **Explorar prompts**: Ve todos los prompts disponibles de los servidores conectados con sus descripciones y argumentos requeridos
- ⚡️ **Invocación rápida**: Usa la sintaxis de barra para invocar prompts (se recomienda `/server:prompt_name`)
- 🔤 **Autocompletado**: Escribe `/` para ver sugerencias de prompts con coincidencia difusa
- 📝 **Recolección de argumentos**: Diálogos interactivos te guían por los parámetros requeridos
- 👁️ **Vista previa**: Revisa el contenido del prompt antes de inyectarlo para asegurarte de que se ajusta a tus necesidades
- 🎯 **Inyección flexible**: Elige ejecutar de inmediato o solo inyectar (agregar al historial sin activar el modelo)
- 🧠 **Consciente del contexto**: Adapta automáticamente el comportamiento según si el prompt termina con un mensaje de usuario o de asistente
- 🔄 **Reversión segura**: Limpieza automática del historial si abortas o hay errores
- 💬 **Contenido de texto**: Soporta mensajes de prompt basados en texto (el soporte de imagen/audio/recursos llegará pronto)
#### Cómo usar los prompts MCP
**Explorar los prompts disponibles:**
```
/prompts # or '/pr'
```
Esto muestra todos los prompts agrupados por servidor, con sus nombres, argumentos requeridos y descripciones.
**Invocar un prompt:**
```
/server:prompt_name
```
Por ejemplo, si un servidor llamado `docs` proporciona un prompt "summarize":
```
/docs:summarize
```
Si el nombre de un prompt es único entre los servidores conectados, puedes usar la forma corta:
```
/summarize
```
Si varios servidores exponen el mismo nombre de prompt, el cliente te pedirá usar la forma calificada y sugerirá las opciones válidas de `/server:prompt_name`.
**Autocompletado:**
- Escribe `/` para ver todos los prompts disponibles con sus descripciones
- Sigue escribiendo para filtrar los prompts con coincidencia difusa
- Usa las flechas para navegar y presiona Enter para seleccionar
> [!TIP]
> Los prompts se descubren automáticamente cuando te conectas a servidores MCP. Si un servidor soporta prompts, estarán disponibles de inmediato en la lista de `prompts` y en el autocompletado.
**Flujo de trabajo:**
1. Escribe `/server:prompt_name` (recomendado) o selecciona desde el autocompletado
2. Si el prompt requiere argumentos, se te pedirá proporcionarlos
3. Revisa la vista previa del prompt que muestra lo que se inyectará
4. Elige cómo usar el prompt:
- **y/yes** (por defecto): Envía el prompt al modelo y obtén una respuesta
- Para prompts que terminan con un **mensaje de usuario**: usa ese mensaje como la consulta
- Para prompts que terminan con un **mensaje de asistente**: agrega "Please respond based on the above context." como consulta
- **i/inject**: Solo agrega el prompt al historial de conversación sin activar el modelo (te permite escribir tu propia consulta después)
- **n/no**: Cancela y vuelve al chat
5. El prompt se inyecta según tu elección
6. Si abortas durante la generación del modelo (presionando 'a'), los cambios se revierten automáticamente
**Ejemplo:**

> [!WARNING]
> **Limitaciones de tipos de contenido**: Los prompts MCP actualmente soportan **solo contenido de texto**. Los siguientes tipos de contenido aún no están soportados y se omitirán automáticamente:
> - 🖼️ **Imágenes** - Contenido de imagen en prompts
> - 🎵 **Audio** - Contenido de audio en prompts
> - 📦 **Recursos** - Contenido de recursos embebidos
### Recursos MCP
Los recursos MCP proporcionan acceso a datos contextuales expuestos por servidores MCP: archivos, documentos, datos estructurados y más. Los servidores pueden exponer recursos con metadatos (nombre, descripción, tipo MIME) que puedes explorar y leer en el contexto de tu conversación.
#### Características
- 📋 **Explorar recursos**: Ve todos los recursos disponibles de los servidores conectados con URIs, nombres, tipos MIME y descripciones
- 📖 **Leer recursos**: Usa la sintaxis `@uri` para leer el contenido de un recurso, de forma independiente o en línea dentro de una consulta
- 📝 **Contenido de texto**: Soporte completo para recursos basados en texto (markdown, código, logs, etc.)
- 🖼️ **Soporte de imágenes con visión**: Los recursos de imagen (`image/*`) se reenvían automáticamente como imágenes base64 a modelos con capacidad de visión
- 🎯 **Inyección de contexto**: El contenido del recurso se almacena en un búfer y se inyecta como contexto junto con tu siguiente consulta
- 🔍 **Autocompletado**: Escribe `@` para ver sugerencias de recursos y plantillas disponibles con coincidencia difusa
- 🛡️ **Seguridad con binarios**: El contenido binario que no es imagen (audio, video, PDFs, archivos comprimidos) se detecta y se omite con mensajes informativos
#### Cómo usar los recursos MCP
**Explorar los recursos disponibles:**
```
/resources # or '/res'
```
Esto muestra todos los recursos y plantillas agrupados por servidor, con URIs, nombres, tipos MIME y descripciones. Los recursos binarios se marcan con la etiqueta `[binary]` y las plantillas con la etiqueta `[template]`.
**Leer un recurso:**
```
@
```
Por ejemplo, para leer un recurso de archivo:
```
@file:///path/to/document.md
```
Hay dos formas de usar `@uri`:
**1. Independiente (almacenar y luego consultar):** Escribe `@uri` por sí solo. El recurso se obtiene y se almacena en un búfer. Luego escribe tu consulta en el siguiente prompt. El contenido del recurso se inyecta como contexto automáticamente.
**2. En línea (un solo turno):** Incluye `@uri` en cualquier parte del texto de tu consulta. El recurso se obtiene y la consulta se procesa de inmediato en un solo paso.
**Ejemplo independiente:**
```
qwen3/show-thinking/6-tools❯ @server://info
✅ Read resource 'get_server_info' (197 chars)
Preview:
This is a simple MCP server with streamable HTTP transport. It supports tools for greeting, adding numbers, generating
random numbers, and calculating BMI. It also provides a BMI calculator prompt.
1 resource(s) buffered. Type your query, or include @another_uri inline.
qwen3/show-thinking/6-tools❯ Next question here
```
**Ejemplo en línea:**
```
qwen3/show-thinking/6-tools❯ summarize the key features from @server://info
✅ Read resource 'get_server_info' (197 chars)
Preview:
This is a simple MCP server with streamable HTTP transport. It supports tools for greeting, adding numbers, generating
random numbers, and calculating BMI. It also provides a BMI calculator prompt.
[model response]
```
> [!TIP]
> Los recursos se descubren automáticamente cuando te conectas a servidores MCP. Si un servidor soporta recursos, estarán disponibles de inmediato en la lista de `resources` y en el autocompletado con `@`.
> [!NOTE]
> 🖼️ Las **imágenes** (`image/*`) **sí** están soportadas; se pasan directamente a modelos con capacidad de visión como datos base64.
> **Contenido binario**: Los siguientes tipos de recursos **no** están soportados como contexto y se omitirán con un mensaje informativo:
> - 🎵 **Audio** - Tipos MIME `audio/*`
> - 📹 **Video** - Tipos MIME `video/*`
> - 📄 **PDFs** - `application/pdf`
> - 🗜️ **Archivos comprimidos** - `application/zip`, `application/octet-stream`
>
### Modos de visualización de respuestas
El comando `/display-mode` (`/dm`) te permite elegir cómo se muestran las respuestas del modelo mientras se transmiten:
- **Plain**: Transmite la respuesta una vez como texto plano sin re-renderizado final de markdown
- ✨**NUEVO** **Markdown** (por defecto): Transmite markdown formateado línea por línea — las líneas por encima de una pequeña cola en vivo se imprimen una sola vez y nunca se redibujan, por lo que se mantiene confiable incluso con emojis o cambios de tamaño del terminal
- **Both**: Transmite primero texto plano y luego vuelve a renderizar la respuesta completa como markdown
- **Markdown (blocks)**: Renderiza la respuesta como markdown bloque por bloque, solo agregando: cada párrafo/lista/tabla/bloque de código se imprime una vez cuando se completa y nunca se redibuja, por lo que no puede duplicar líneas
Usa `/display-mode` o `/dm` durante el chat para abrir el selector interactivo.
**Por qué podrías cambiar de modo:**
- **Plain** es la opción menos ruidosa si quieres un redibujado o parpadeo mínimo
- **Markdown** combina el streaming línea por línea con formato markdown coherente; como mucho se redibujan las últimas líneas, así que los fallos quedan acotados incluso con emojis o cambios de tamaño
- **Both** te da retroalimentación rápida de streaming más un renderizado final limpio en markdown
- **Markdown (blocks)** es la forma más conservadora de ver markdown formateado durante el streaming, a costa de actualizaciones bloque por bloque (en lugar de línea por línea)
> [!TIP]
> Tu modo de visualización seleccionado se guarda con `/save-config` y se restaura con `/load-config`, así que puedes mantener diferentes preferencias de visualización para diferentes flujos de trabajo.
### Modo de entrada
El comando `/input-mode` (`/im`) controla cómo escribes los mensajes del chat:
- **Single-line** (por defecto): Presiona **Enter** para enviar inmediatamente después de escribir tu mensaje
- **Multiline**: Presiona **Enter** para agregar una nueva línea, y luego **Esc** seguido de **Enter** para enviar el mensaje completo cuando termines. Esto permite mensajes más complejos con múltiples párrafos o bloques de código.
- **Ctrl+J** también inserta una nueva línea en el modo multilínea, como alternativa confiable en cualquier terminal
Usa `/input-mode` o `/im` durante el chat para abrir el selector interactivo.
> [!IMPORTANT]
> Los atajos de envío en modo multilínea pueden variar según el emulador de terminal y el manejo del teclado del sistema operativo. Este cliente usa **Esc y luego Enter** como el atajo de envío portable en modo multilínea. **Shift+Enter** y **Meta+Enter** pueden funcionar en algunos terminales, pero no están garantizados.
### Selección de modelo
La interfaz de selección de modelo muestra todos los modelos disponibles en tu instalación de Ollama:

- Ingresa el **número** del modelo que quieres usar
- `s` o `save` - Guardar la selección de modelo y volver al chat
- `q` o `quit` - Cancelar la selección de modelo y volver al chat
### Configuración avanzada del modelo
El comando `/model-config` (`/mc`) abre la interfaz de ajustes avanzados del modelo, que te permite afinar cómo genera las respuestas:

#### System prompt
- **System Prompt**: Define el rol y el comportamiento del modelo para guiar las respuestas.
#### Parámetros clave
- **Context Window (num_ctx)**: Define cuánto historial de chat usa el modelo. Equilibra con el uso de memoria y el rendimiento.
- **Keep Tokens**: Evita que se descarten tokens importantes
- **Max Tokens**: Limita la longitud de la respuesta (0 = automático)
- **Seed**: Hace las salidas reproducibles (usa -1 para aleatorio)
- **Temperature**: Controla la aleatoriedad (0 = determinista, más alto = creativo)
- **Top K / Top P / Min P / Typical P**: Controles de muestreo para la diversidad
- **Repeat Last N / Repeat Penalty**: Reducen la repetición
- **Presence/Frequency Penalty**: Fomentan temas nuevos, reducen repeticiones
- **Stop Sequences**: Puntos de parada personalizados (hasta 8)
- **Batch Size (num_batch)**: Controla el procesamiento por lotes interno de las solicitudes; valores más grandes pueden aumentar el rendimiento pero usan más memoria.
#### Comandos
- Ingresa los números de parámetro `1-15` para editar los ajustes
- Ingresa `sp` para editar el system prompt
- Usa `u1`, `u2`, etc. para restablecer parámetros, o `uall` para restablecerlos todos
- `h`/`help`: Mostrar detalles y consejos sobre los parámetros
- `undo`: Revertir los cambios
- `s`/`save`: Aplicar los cambios
- `q`/`quit`: Cancelar
#### Configuraciones de ejemplo
- **Factual:** `temperature: 0.0-0.3`, `top_p: 0.1-0.5`, `seed: 42`
- **Creativa:** `temperature: 1.0+`, `top_p: 0.95`, `presence_penalty: 0.2`
- **Reducir repeticiones:** `repeat_penalty: 1.1-1.3`, `presence_penalty: 0.2`, `frequency_penalty: 0.3`
- **Equilibrada:** `temperature: 0.7`, `top_p: 0.9`, `typical_p: 0.7`
- **Reproducible:** `seed: 42`, `temperature: 0.0`
- **Contexto grande:** `num_ctx: 8192` o más para conversaciones complejas que requieren más contexto
> [!TIP]
> Todos los parámetros están sin definir por defecto, dejando que Ollama use sus propios valores optimizados. Usa `help` en el menú de configuración para ver detalles y recomendaciones. Los cambios se guardan con tu configuración.
### Modo de pensamiento y esfuerzo de razonamiento
Habilita el modo de pensamiento con `/thinking-mode` (`/tm`) para activar el razonamiento extendido en modelos compatibles (p. ej., `qwen3`, `deepseek-r1`, Claude con extended thinking). Usa `/show-thinking` (`/st`) para alternar si el proceso de razonamiento es visible en la respuesta.
Usa `/reasoning-effort` (`/re`) para controlar **cuánto esfuerzo de razonamiento** aplica el modelo cuando el modo de pensamiento está activo:
| Nivel | Descripción |
|-------|-------------|
| `auto` | Esfuerzo por defecto del proveedor (recomendado para la nube) |
| `minimal` | El más rápido, mínimo razonamiento |
| `low` | Razonamiento ligero |
| `medium` | Equilibrado — **por defecto** |
| `high` | Razonamiento más exhaustivo |
| `xhigh` | Máximo esfuerzo de razonamiento |
> [!NOTE]
> Algunos proveedores o modelos pueden ignorar los ajustes de esfuerzo de razonamiento.
### Recarga de servidores para desarrollo
El comando `/reload-servers` (`/rs`) es particularmente útil durante el desarrollo de servidores MCP. Te permite recargar todos los servidores conectados sin reiniciar toda la aplicación cliente.
**Beneficios principales:**
- 🔄 **Recarga en caliente**: Aplica al instante los cambios en el código de tu servidor MCP
- 🛠️ **Flujo de desarrollo**: Perfecto para el desarrollo y las pruebas iterativas
- 📝 **Actualizaciones de configuración**: Detecta automáticamente los cambios en los JSON de configuración de servidores o en las configuraciones de Claude
- 🎯 **Preservación de estado**: Mantiene tus preferencias de herramientas habilitadas/deshabilitadas entre recargas
- ⚡️ **Ahorro de tiempo**: No necesitas reiniciar el cliente y reconfigurar todo
**Cuándo usarlo:**
- Después de modificar la implementación de tu servidor MCP
- Cuando hayas actualizado configuraciones de servidores en archivos JSON
- Después de cambiar la configuración MCP de Claude
- Durante la depuración, para asegurarte de estar probando la última versión del servidor
Simplemente escribe `/reload-servers` o `/rs` en la interfaz de chat, y el cliente:
1. Se desconectará de todos los servidores MCP actuales
2. Se reconectará usando los mismos parámetros (servidores agregados con `ollmcp mcp add`, rutas de servidores, archivos de configuración, `--claude-desktop`)
3. Restaurará tus ajustes previos de herramientas habilitadas/deshabilitadas
4. Mostrará el estado actualizado de servidores y herramientas
Esta característica mejora drásticamente la experiencia de desarrollo al construir y probar servidores MCP.
### Ejecución de herramientas con Human-in-the-Loop (HIL)
La funcionalidad Human-in-the-Loop proporciona una capa adicional de seguridad al permitirte revisar y aprobar las ejecuciones de herramientas antes de que se ejecuten. Es particularmente útil para:
- 🛡️ **Seguridad**: Revisar operaciones potencialmente destructivas antes de su ejecución
- 🔍 **Aprendizaje**: Entender qué herramientas quiere usar el modelo y por qué
- 🎯 **Control**: Ejecución selectiva de solo las herramientas que apruebas
- 🚫 **Prevención**: Detener llamadas a herramientas no deseadas
- 🔄 **Modo sesión**: Aprobar automáticamente todas las herramientas para la sesión de consulta actual
- 🛑 **Abortar consulta**: Abortar la consulta completa sin guardarla en el historial
#### Visualización de la confirmación HIL
Cuando HIL está habilitado, verás un mensaje de confirmación antes de cada ejecución de herramienta:
**Ejemplo:**

#### Opciones de la confirmación HIL
Cuando se te pregunte, puedes elegir entre las siguientes opciones:
- **y/yes**: Ejecutar esta llamada a herramienta específica
- **n/no**: Omitir esta llamada a herramienta y continuar con la consulta
- **s/session**: Ejecutar esta y todas las llamadas a herramientas posteriores de la consulta actual sin más confirmaciones
- **d/disable**: Deshabilitar permanentemente las confirmaciones HIL (pueden reactivarse con el comando `/hil`)
- **a/abort**: Abortar la consulta completa de inmediato sin guardarla en el historial
> [!TIP]
> La opción **session** es particularmente útil cuando el modelo necesita ejecutar varias herramientas en secuencia. En lugar de confirmar cada una individualmente, puedes aprobar todas las herramientas para la sesión de consulta actual; HIL se reiniciará automáticamente para la siguiente consulta.
#### Configuración de Human-in-the-Loop (HIL)
- **Estado por defecto**: Las confirmaciones HIL están habilitadas por defecto por seguridad
- **Comando de alternancia**: Usa `/human-in-the-loop` o `/hil` para activarlas/desactivarlas
- **Ajustes persistentes**: La preferencia de HIL se guarda con tu configuración
- **Desactivación rápida**: Elige "disable" durante cualquier confirmación para desactivarlas permanentemente
- **Aprobación automática de sesión**: Usa "session" durante una confirmación para aprobar todas las herramientas de la consulta actual
- **Abortar consulta**: Usa "abort" durante una confirmación para detener la consulta de inmediato sin guardar
- **Reactivación**: Usa el comando `/hil` en cualquier momento para volver a activar las confirmaciones
**Beneficios:**
- **Mayor seguridad**: Evita ejecuciones de herramientas accidentales o no deseadas
- **Conciencia**: Entiende qué acciones intenta realizar el modelo
- **Control selectivo**: Elige qué operaciones permitir caso por caso
- **Flujo flexible**: Modo sesión para consultas multi-herramienta eficientes, aprobación individual para operaciones sensibles
- **Aborto limpio**: Detén consultas problemáticas de inmediato sin contaminar el historial de conversación
- **Tranquilidad**: Visibilidad y control total sobre las acciones automatizadas
### Métricas de rendimiento
La funcionalidad de métricas de rendimiento muestra datos detallados del rendimiento del modelo después de cada consulta en un panel con borde. Las métricas muestran tiempos de duración, conteos de tokens y velocidades de generación directamente de la respuesta de Ollama.
**Métricas mostradas:**
- `total duration`: Tiempo total dedicado a generar la respuesta completa (segundos)
- `load duration`: Tiempo dedicado a cargar el modelo (milisegundos)
- `prompt eval count`: Número de tokens del prompt de entrada
- `prompt eval duration`: Tiempo dedicado a evaluar el prompt de entrada (milisegundos)
- `eval count`: Número de tokens generados en la respuesta
- `eval duration`: Tiempo dedicado a generar los tokens de la respuesta (segundos)
- `prompt eval rate`: Velocidad de procesamiento del prompt de entrada (tokens/segundo)
- `eval rate`: Velocidad de generación de tokens de la respuesta (tokens/segundo)
**Ejemplo:**

#### Configuración de las métricas de rendimiento
- **Estado por defecto**: Las métricas están deshabilitadas por defecto para una salida más limpia
- **Comando de alternancia**: Usa `/show-metrics` o `/sm` para habilitar/deshabilitar la visualización de métricas
- **Ajustes persistentes**: La preferencia de métricas se guarda con tu configuración
**Beneficios:**
- **Monitoreo de rendimiento**: Sigue la eficiencia del modelo y los tiempos de respuesta
- **Seguimiento de tokens**: Monitorea el consumo real de tokens para su análisis
- **Comparativas**: Compara el rendimiento entre diferentes modelos
> [!NOTE]
> **Fuente de datos**: Todas las métricas provienen directamente de la respuesta de Ollama, lo que garantiza su precisión y fiabilidad.
### Gestión del historial
La funcionalidad de gestión del historial te permite ver, exportar e importar tu historial de conversación. Es útil para:
- 📜 **Vista completa del historial**: Revisa todas las conversaciones de tu sesión actual
- 💾 **Exportar**: Guarda las conversaciones en archivos JSON para respaldo o análisis
- 📥 **Importar**: Carga historial de conversaciones anterior para continuar donde lo dejaste
- 🔄 **Portabilidad**: Comparte o transfiere conversaciones entre sesiones
#### Comandos del historial
**Ver el historial completo:**
```
/full-history # or '/fh'
```
Muestra todo el historial de conversación de la sesión actual en una vista formateada, incluyendo tanto las consultas como las respuestas.
**Exportar el historial:**
```
/export-history # or '/eh'
```
Exporta tu historial de chat actual a un archivo JSON. Puedes especificar un nombre de archivo personalizado o usar el nombre por defecto basado en marca de tiempo (p. ej., `ollmcp_chat_history_2026-01-05_143022.json`). Los archivos se guardan en el directorio `~/.config/ollmcp/history/`. El comando incluye protección contra sobrescritura de archivos.
**Importar historial:**
```
/import-history # or '/ih'
```
Importa un historial de chat previamente exportado desde un archivo JSON. El comando valida la estructura del JSON para garantizar la compatibilidad. El historial importado se agrega al contexto de tu conversación actual.
**Almacenamiento del historial:**
- Ubicación de exportación: `~/.config/ollmcp/history/`
- Formato del nombre de archivo por defecto: `ollmcp_chat_history_YYYY-MM-DD_HHMMSS.json`
- El formato JSON incluye tanto las consultas como las respuestas, con validación adecuada de la estructura
**Beneficios:**
- **Continuidad de sesión**: Retoma conversaciones en diferentes sesiones
- **Respaldo**: Conserva registros de conversaciones importantes
- **Análisis**: Exporta el historial para análisis o revisión externa
- **Compartir**: Comparte el contexto de una conversación con miembros del equipo
- **Pruebas**: Importa conversaciones de prueba para desarrollo y depuración
> [!TIP]
> Al exportar, si no proporcionas un nombre de archivo, el sistema genera automáticamente uno con marca de tiempo para evitar sobrescrituras accidentales.
## Autocompletado y características del prompt
### Autocompletado de shell con Typer
- La CLI soporta autocompletado de shell para todas las opciones y argumentos vía Typer
- Para habilitarlo, ejecuta `ollmcp --install-completion` y sigue las instrucciones para tu shell
- Disfruta del autocompletado con tab para todas las opciones agrupadas y generales
### Autocompletado estilo FZF
- Autocompletado con espacio de nombres de barra para comandos y prompts (`/`)
- Descripciones de los comandos mostradas en el menú
- Coincidencia sin distinción de mayúsculas para mayor comodidad
- Lista de comandos centralizada para la consistencia
- La escritura de consultas de texto plano está intencionalmente libre de ruido de autocompletado de acciones
### Autocompletado de prompts MCP
- Escribe `/` para activar el autocompletado de prompts
- Coincidencia difusa sobre los nombres y descripciones de los prompts
- Soporta referencias calificadas de prompts como `/server:prompt_name`
- Muestra las descripciones de los prompts en el menú
- Los argumentos de los prompts se recolectan durante la invocación (no se muestran en las filas del autocompletado)
- Truncado de descripciones adaptado al ancho del terminal
### Prompt contextual
El prompt del chat te da información clara y contextual de un vistazo:
- **Modelo**: Muestra el modelo de Ollama actualmente en uso
- **Modo de pensamiento**: Indica si el "modo de pensamiento" está activo (en modelos compatibles)
- **Herramientas**: Muestra el número de herramientas habilitadas
**Ejemplo de prompt:**
```
qwen3/show-thinking/12-tools❯
```
- `qwen3` Nombre del modelo
- `/show-thinking` Indicador del modo de pensamiento (si está habilitado; de lo contrario `/thinking` o se omite)
- `/12-tools` Número de herramientas habilitadas (o `/1-tool` en singular)
- `❯` Símbolo del prompt
Esto facilita ver tu contexto actual antes de escribir una consulta.
> [!TIP]
> Escribe `/` después del símbolo del prompt para ver sugerencias de autocompletado de los prompts MCP disponibles.
## Gestión de configuración
> [!TIP]
> Ejecutar `ollmcp` sin flags carga automáticamente la configuración por defecto desde `~/.config/ollmcp/config.json` si existe.
El cliente guarda y carga tus preferencias entre sesiones:
- Al usar `/save-config`, puedes darle un nombre a la configuración o usar el nombre por defecto
- Las configuraciones se almacenan en el directorio `~/.config/ollmcp/`
- La configuración por defecto se guarda como `~/.config/ollmcp/config.json`
- Las configuraciones con nombre se guardan como `~/.config/ollmcp/{name}.json`
### Perfiles por proveedor
Los ajustes de conexión se almacenan **por proveedor**, así que cambiar de proveedor nunca reutiliza el modelo, host o API key de otro proveedor. Cada proveedor mantiene su propio:
- **Modelo** seleccionado
- **Host** / URL base de la API
- **API key**
La configuración también registra un `defaultProvider`. Cuando ejecutas `ollmcp` sin el flag `--provider`, se carga el perfil de ese proveedor; una instalación nueva comienza con `ollama`. Cada vez que ejecutas `/save-config`, el proveedor que estás usando en ese momento *se convierte en el nuevo valor por defecto*, así que ejecutar simplemente `ollmcp` retoma donde lo dejaste. Pasa `--provider ` en cualquier momento para cambiar al perfil de otro proveedor (y cargarlo); `--model` / `--host` / `--api-key` sobrescriben los valores guardados para esa ejecución.
> [!NOTE]
> Solo una key pasada con `--api-key` se guarda, en texto plano, en `~/.config/ollmcp/config.json`. Las keys proporcionadas mediante la variable de entorno `$OLLMCP_API_KEY` o la variable de entorno nativa de un proveedor (por ejemplo `OPENROUTER_API_KEY`) **nunca** se escriben en disco; usa una de ellas si no quieres que tu key se persista.
Los siguientes ajustes son **compartidos** entre todos los proveedores:
- Parámetros avanzados del modelo (system prompt, temperatura, ajustes de muestreo, etc.)
- Estado habilitado/deshabilitado de todas las herramientas
- Ajustes de retención de contexto
- Ajustes del modo de pensamiento
- Preferencia del modo de visualización de respuestas
- Preferencias de visualización de la ejecución de herramientas
- Preferencias de visualización de las métricas de rendimiento
- Ajustes de confirmación Human-in-the-Loop
**Ejemplo de `~/.config/ollmcp/config.json`:**
```json
{
"defaultProvider": "openai",
"providers": {
"ollama": { "host": "http://localhost:11434", "model": "qwen3:1.7b", "apiKey": "" },
"openai": { "host": "", "model": "gpt-5.5", "apiKey": "sk-..." }
},
"enabledTools": {},
"modelConfig": {},
"...": "shared settings"
}
```
> [!TIP]
> Los archivos de configuración antiguos con formato plano (con `host`/`model`/`provider`/`apiKey` en el nivel superior) se migran automáticamente la primera vez que ejecutas esta versión, y se reescriben en el formato por proveedor en tu siguiente `/save-config`.
## Formato de configuración de servidores
El archivo de configuración JSON soporta los tipos de servidor STDIO, SSE y Streamable HTTP (MCP 1.10.1):
```json
{
"mcpServers": {
"stdio-server": {
"command": "command-to-run",
"args": ["arg1", "arg2", "..."],
"env": {
"ENV_VAR1": "value1",
"ENV_VAR2": "value2"
},
"disabled": false
},
"sse-server": {
"type": "sse",
"url": "http://localhost:8000/sse",
"headers": {
"Authorization": "Bearer your-token-here"
},
"disabled": true
},
"http-server": {
"type": "streamable_http",
"url": "http://localhost:8000/mcp",
"headers": {
"X-API-Key": "your-api-key-here"
},
"disabled": false
}
}
}
```
> [!NOTE]
> **Soporte de transporte MCP 1.10.1**: El cliente ahora soporta el último transporte Streamable HTTP con mejor rendimiento y fiabilidad. Si especificas una URL sin tipo, el cliente usará por defecto el transporte Streamable HTTP.
### Consejos: dónde poner las configuraciones de servidores MCP y un ejemplo funcional
Un punto de confusión común es dónde almacenar los archivos de configuración de servidores MCP y cómo se usa la función de guardar/cargar de la TUI. Aquí una guía corta y práctica que ha ayudado a otros usuarios:
- Los comandos `/save-config` / `/load-config` (o `/sc` / `/lc`) de la TUI están pensados para guardar *preferencias de la TUI* como qué herramientas habilitaste, tu modelo seleccionado, el modo de pensamiento, el modo de visualización y otros ajustes del lado del cliente. No son necesarios para registrar conexiones de servidores MCP con el cliente.
- Para los archivos JSON de servidores MCP (el objeto `mcpServers` mostrado arriba), recomendamos mantenerlos fuera del directorio de configuración de la TUI o en una subcarpeta clara, por ejemplo:
```
~/.config/ollmcp/mcp-servers/config.json
```
Luego puedes apuntar `ollmcp` a ese archivo al iniciar con `-j` / `--servers-json`.
> [!IMPORTANT]
> Para servidores MCP basados en HTTP, `"type": "http"`, `"streamable-http"` y `"streamable_http"` son todos aceptados y se tratan de la misma manera. Consulta también la sección [Rutas comunes de endpoints MCP](#rutas-comunes-de-endpoints-mcp) más abajo para ver los endpoints típicos.
Aquí un ejemplo mínimo funcional; digamos que este es tu `~/.config/ollmcp/mcp-servers/config.json`:
```json
{
"mcpServers": {
"github": {
"type": "streamable_http",
"url": "https://api.githubcopilot.com/mcp/",
"headers": {
"Authorization": "Bearer mytoken"
}
}
}
}
```
> [!TIP]
> Al usar el servidor MCP de GitHub, asegúrate de reemplazar `"mytoken"` con tu token real de la API de GitHub.
Con ese archivo en su lugar puedes conectarte usando:
```
ollmcp -j ~/.config/ollmcp/mcp-servers/config.json
```
Aquí puedes encontrar un issue de GitHub relacionado con este error común: https://github.com/jonigl/mcp-client-for-ollama/issues/112#issuecomment-3446569030
#### Demo
Una demo corta (asciicast) que debería ayudar a cualquiera a reproducir rápidamente una configuración funcional. Este ejemplo usa un [servidor MCP de ejemplo con protocolo streamable HTTP](https://github.com/jonigl/mcp-server-with-streamable-http-example):
[](https://asciinema.org/a/751387)
#### Rutas comunes de endpoints MCP
Los servidores MCP Streamable HTTP típicamente exponen el endpoint MCP en `/mcp` (p. ej., `https://host/mcp`), mientras que los servidores SSE suelen usar `/sse` (p. ej., `https://host/sse`). Abajo hay un extracto de la especificación MCP (2025-06-18):
> The server MUST provide a single HTTP endpoint path (hereafter referred to as the MCP endpoint) that supports both POST and GET methods. For example, this could be a URL like https://example.com/mcp.
Puedes encontrar más detalles en la [especificación MCP versión 2025-06-18 - Transports](https://modelcontextprotocol.io/specification/2025-06-18/basic/transports).
> [!NOTE]
> Los certificados HTTPS de los servidores MCP remotos se validan contra el **almacén de confianza del sistema operativo**, no contra el paquete `certifi`. Si un servidor MCP está detrás de una CA privada o corporativa, o ejecutas ollmcp en un contenedor mínimo sin almacén de CA del sistema, el handshake TLS falla con un error que no menciona a ollmcp. Apunta `SSL_CERT_FILE` (un archivo de bundle) o `SSL_CERT_DIR` (un directorio) a tu CA para solucionarlo:
>
> ```bash
> export SSL_CERT_FILE=/ruta/a/ca-corporativa.pem
> ```
## Modelos compatibles
Los siguientes modelos de Ollama funcionan bien con el uso de herramientas:
- gemma4
- qwen3.5
- lfm2.5-thinking
- llama3.2
- mistral
Para una lista completa de modelos de Ollama con capacidades de uso de herramientas, visita la [página oficial de modelos de Ollama](https://ollama.com/search?c=tools).
Para modelos que además pueden procesar imágenes devueltas por las herramientas, consulta la [página de modelos de visión de Ollama](https://ollama.com/search?c=vision).
### Modelos de Ollama Cloud
MCP Client for Ollama ahora soporta los [modelos de Ollama Cloud](https://github.com/ollama/ollama/blob/main/docs/cloud.md), lo que te permite usar potentes modelos alojados en la nube con capacidades de llamada a herramientas mientras aprovechas tus herramientas MCP locales. Los modelos en la nube pueden ejecutarse sin una GPU local potente, haciendo posible acceder a modelos más grandes que no cabrían en una computadora personal.
**Algunos de los modelos de Ollama Cloud soportados son, por ejemplo:**
- `gpt-oss:20b-cloud`
- `gpt-oss:120b-cloud`
- `deepseek-v3.1:671b-cloud`
- `qwen3-coder:480b-cloud`
**Para usar los modelos de Ollama Cloud con este cliente:**
1. Primero, descarga el modelo en la nube:
```bash
ollama pull gpt-oss:120b-cloud
```
2. Ejecuta el cliente con el modelo en la nube elegido:
```bash
ollmcp --model gpt-oss:120b-cloud
```
> [!NOTE]
> El modelo `deepseek-v3.1:671b-cloud` solo soporta el uso de herramientas cuando el modo de pensamiento está desactivado. Puedes alternar el modo de pensamiento en `ollmcp` escribiendo `/thinking-mode` o `/tm`.
Para más información sobre Ollama Cloud, visita la [documentación de Ollama Cloud](https://docs.ollama.com/cloud).
## Patrocinadores
Este proyecto cuenta con el apoyo de:
### Atlas Cloud
[Atlas Cloud](https://www.atlascloud.ai/?utm_source=github&utm_medium=link&utm_campaign=mcp-client-for-ollama) es una plataforma de inferencia de IA full-modal — una única API de IA con acceso unificado a más de 300 modelos curados para video, imágenes y LLMs.
Funciona con ollmcp sin configuración adicional:
```bash
ollmcp --provider atlascloud --api-key YOUR_ATLASCLOUD_API_KEY
# or export the key once and skip the flag:
export ATLASCLOUD_API_KEY=YOUR_ATLASCLOUD_API_KEY
ollmcp --provider atlascloud
```
El streaming y el tool calling están totalmente soportados, y puedes explorar y elegir cualquiera de los modelos de Atlas Cloud con el comando interactivo `/model`.
### Conviértete en patrocinador
¿Quieres ver tu logo aquí? Apoya el proyecto a través de [GitHub Sponsors](https://github.com/sponsors/jonigl) ❤️
## ¿Dónde puedo encontrar más servidores MCP?
Puedes explorar una colección de servidores MCP en el [repositorio oficial de MCP Servers](https://github.com/modelcontextprotocol/servers).
Este repositorio contiene implementaciones de referencia del Model Context Protocol, servidores construidos por la comunidad y recursos adicionales para potenciar las capacidades de herramientas de tus LLMs.
## Proyectos relacionados
- **[Ollama MCP Bridge](https://github.com/jonigl/ollama-mcp-bridge)** - Una capa de API en Python que se sitúa delante de Ollama, agregando automáticamente herramientas de múltiples servidores MCP a cada solicitud de chat. Este proyecto proporciona una solución de proxy transparente que precarga todos los servidores MCP al inicio e integra sus herramientas sin fricción en la API de Ollama.
- **[MCP Server with Streamable HTTP Example](https://github.com/jonigl/mcp-server-with-streamable-http-example)** - Un servidor MCP de ejemplo que demuestra el uso del protocolo streamable HTTP.
## Seguridad
Los servidores MCP que conectas son de tu confianza, y sus respuestas de herramientas/recursos se tratan como contenido no confiable que llega al modelo. Consulta [SECURITY.md](SECURITY.md) para conocer el modelo de confianza, cómo se maneja la inyección indirecta de prompts y cómo reportar una vulnerabilidad.
## Licencia
Este proyecto está licenciado bajo la Licencia MIT - consulta el archivo [LICENSE](LICENSE) para más detalles.
## Agradecimientos
- [Ollama](https://ollama.com/) por el runtime local de LLMs
- [Model Context Protocol](https://modelcontextprotocol.io/) por la especificación y los ejemplos
- [any-llm](https://github.com/mozilla-ai/any-llm/) por la interfaz única para múltiples proveedores de LLM
- [Rich](https://rich.readthedocs.io/) por la interfaz de usuario en terminal
- [Typer](https://typer.tiangolo.com/) por la experiencia moderna de CLI
- [Prompt Toolkit](https://python-prompt-toolkit.readthedocs.io/) por la interfaz interactiva de línea de comandos
- [uv](https://github.com/astral-sh/uv) por el gestor de paquetes de Python ultrarrápido y la gestión de entornos virtuales
- [Asciinema](https://asciinema.org/) por la grabación de la demo
---
Hecho con ❤️ por [jonigl](https://github.com/jonigl)