
一个简单而强大的 Python 客户端,用于通过 Ollama 与 Model Context Protocol(MCP)服务器交互,让你利用本地 LLM 实现高级工具执行。
English | 简体中文 | Español
---
# MCP Client for Ollama (ollmcp)
> [!NOTE]
> 本文档由 AI 自动翻译自[英文版 README](README.md)。英文版是权威来源,内容可能更新。如果你是中文母语者并发现翻译错误,请[提交 issue](https://github.com/jonigl/mcp-client-for-ollama/issues) 反馈,或直接发起 PR 修正。

[](https://www.python.org/downloads/)
[](https://pypi.org/project/ollmcp/)
[](https://pypi.org/project/mcp-client-for-ollama/)
[](https://github.com/jonigl/mcp-client-for-ollama/actions/workflows/ci.yml)
由以下赞助商支持

了解如何在 ollmcp 中使用 Atlas Cloud — 参见赞助商一节
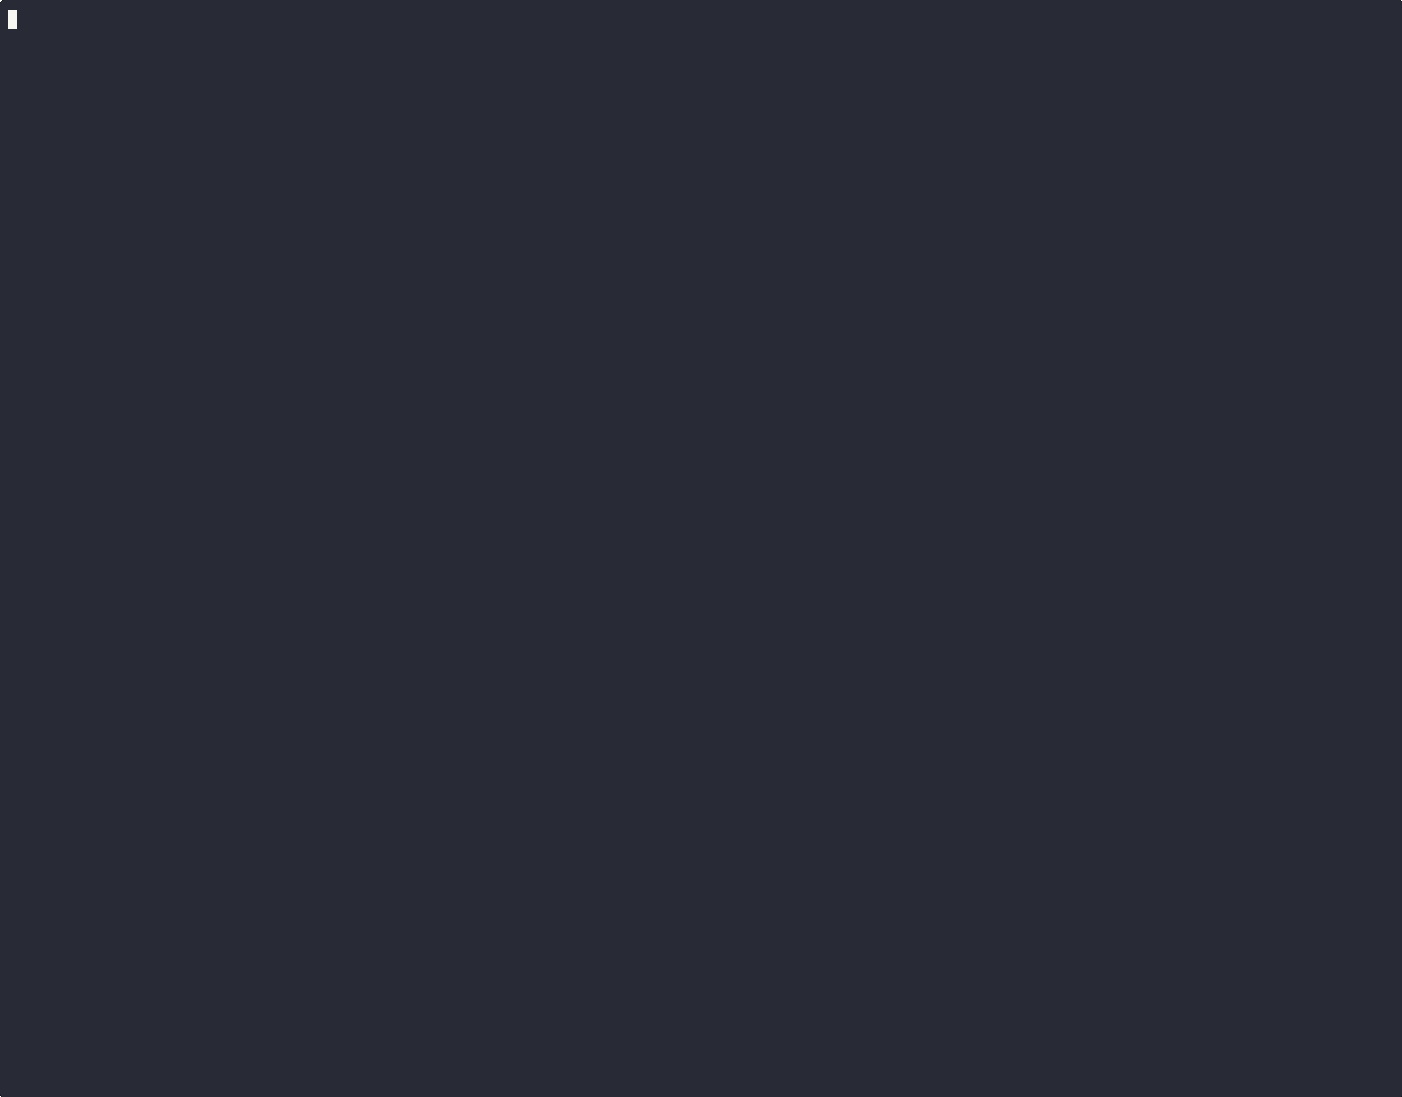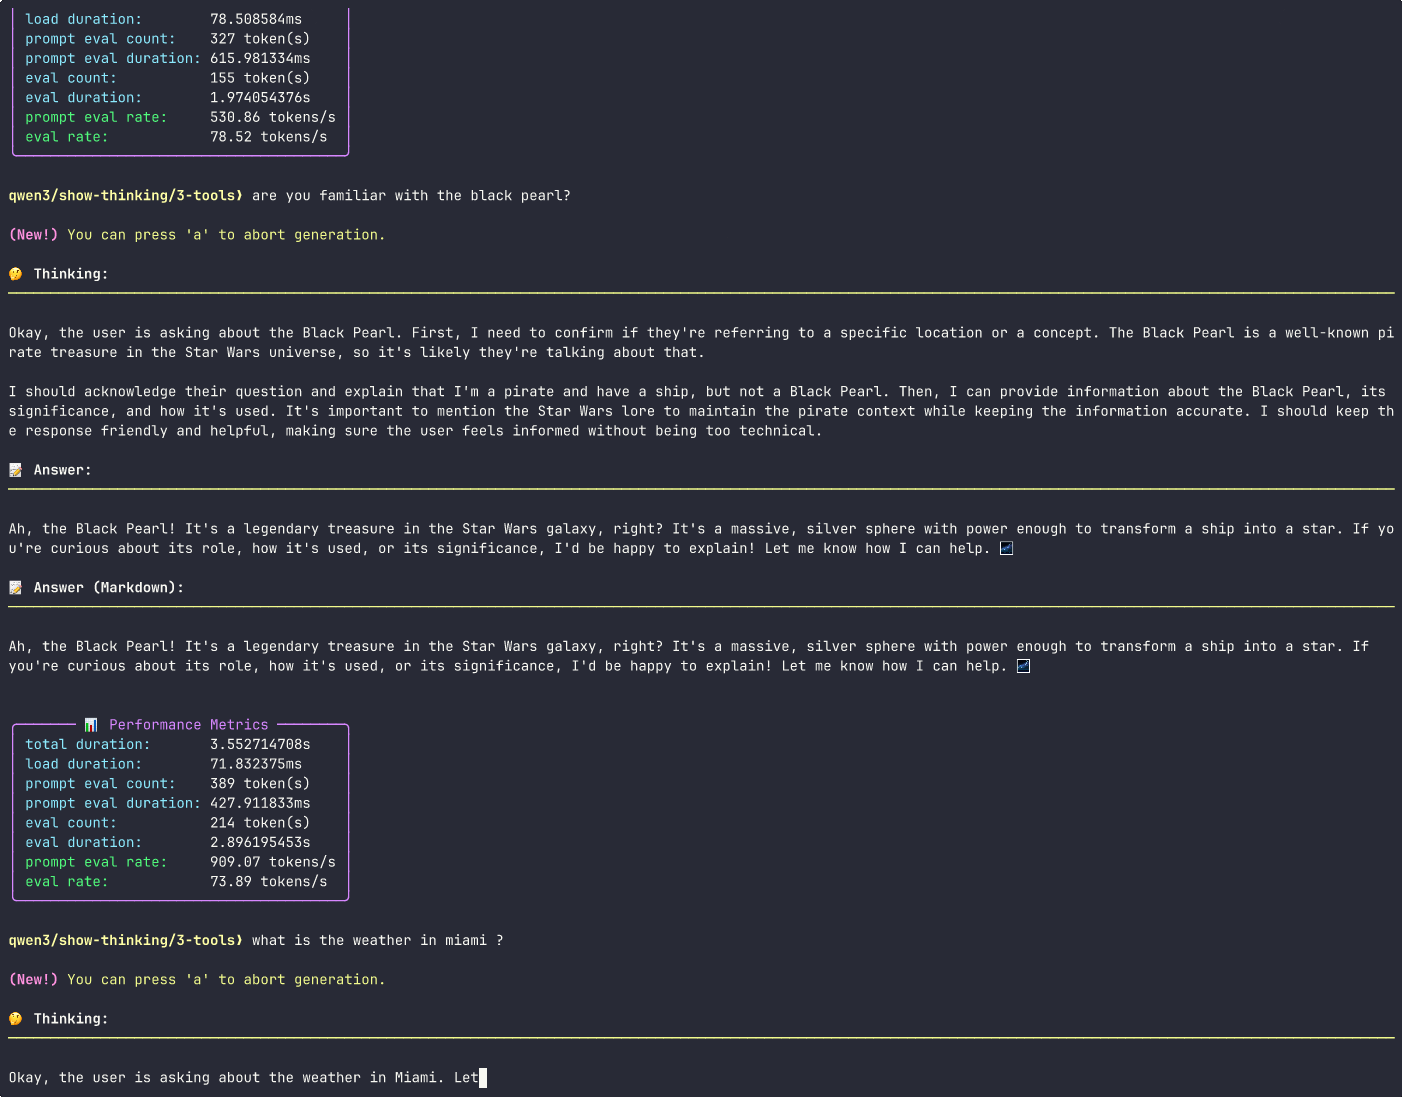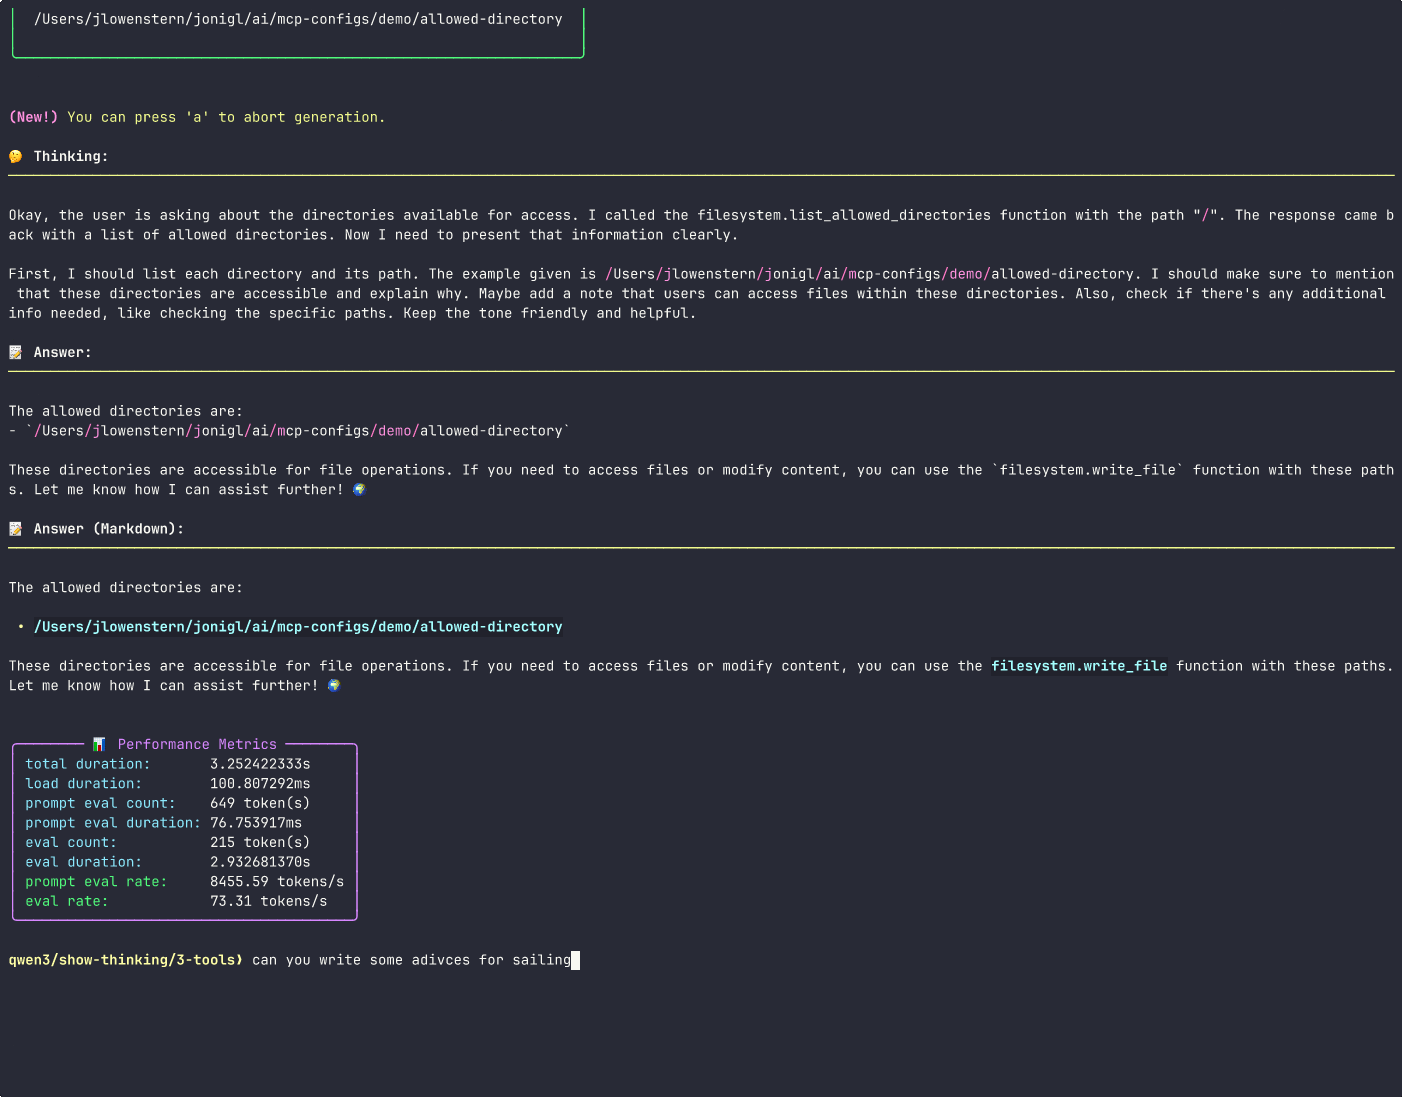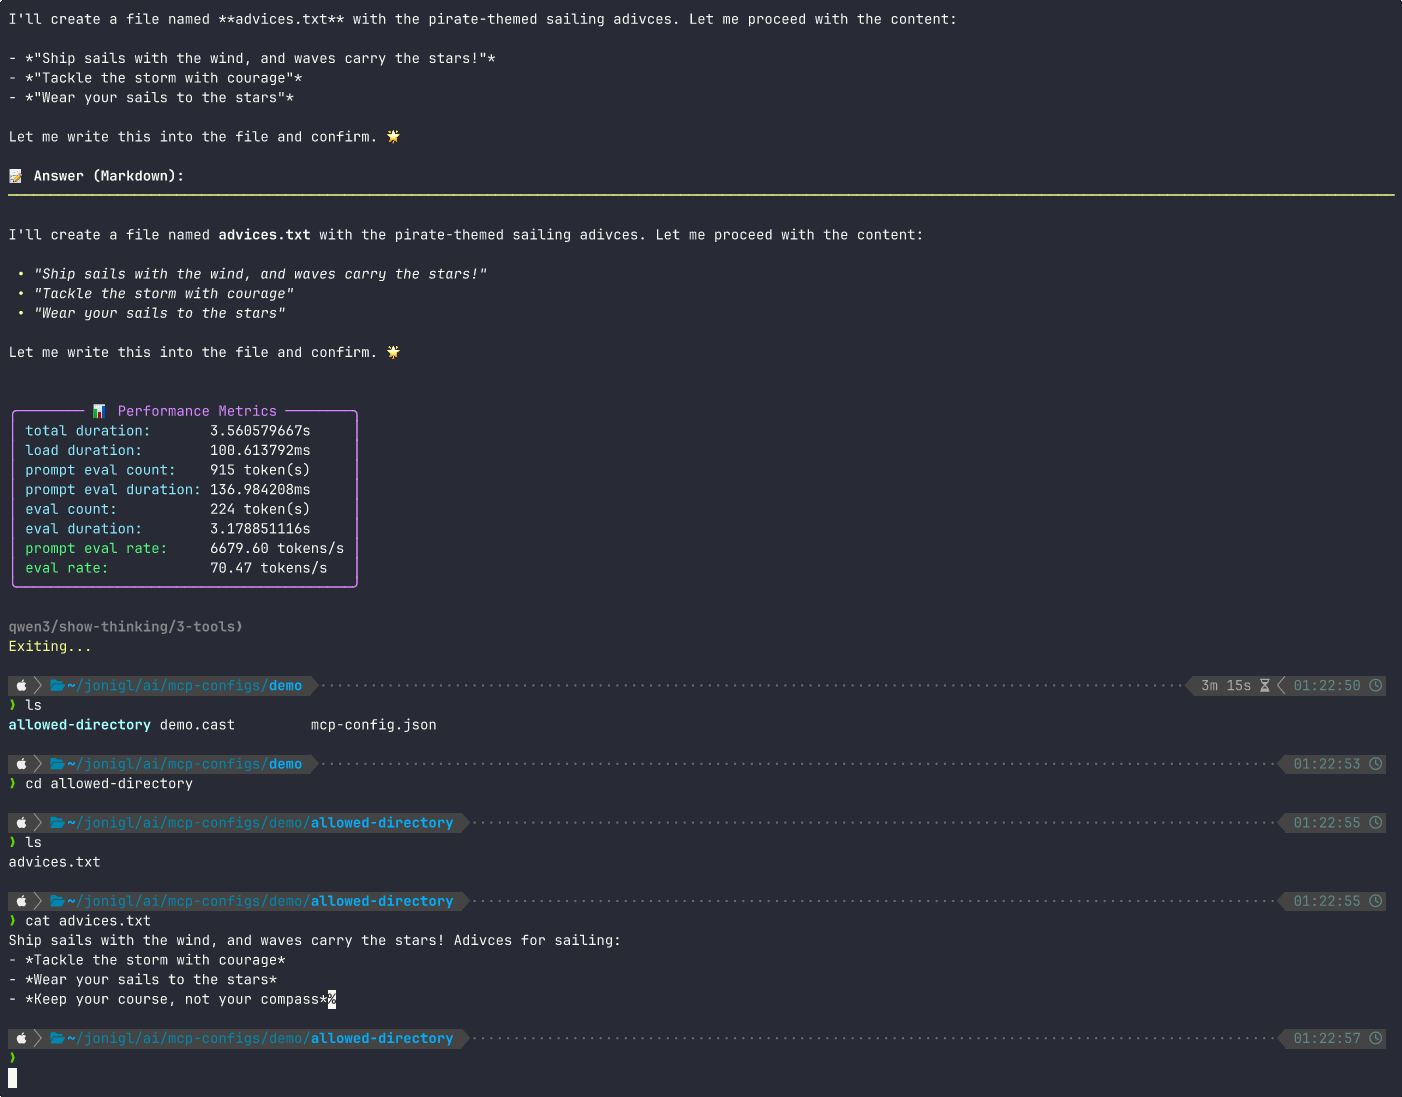
🎥 以 Asciinema 录像方式观看此演示
## 目录
- [概述](#概述)
- [功能特性](#功能特性)
- [环境要求](#环境要求)
- [快速开始](#快速开始)
- [安装方式](#安装方式)
- [故障排除](#故障排除)
- ✨**新** [通过 CLI 管理 MCP 服务器](#通过-cli-管理-mcp-服务器)
- [mcp add 选项](#mcp-add-选项)
- [作用域 (Scopes)](#作用域-scopes)
- [命令行参数](#命令行参数)
- [MCP 服务器配置](#mcp-服务器配置)
- ✨**新** [推理提供商配置](#推理提供商配置)
- [通用选项](#通用选项)
- ✨**新** [支持的推理提供商](#支持的推理提供商)
- [API key 解析顺序](#api-key-解析顺序)
- [使用示例](#使用示例)
- [工具调用的工作原理](#工具调用的工作原理)
- [Agent 模式](#agent-模式)
- [交互式命令](#交互式命令)
- [MCP 工具](#mcp-工具)
- [MCP 提示词](#mcp-提示词)
- [MCP 资源](#mcp-资源)
- ✨**新** [回答显示模式](#回答显示模式)
- [输入模式](#输入模式)
- [模型选择](#模型选择)
- [高级模型配置](#高级模型配置)
- ✨**新** [思考模式与推理强度](#思考模式与推理强度)
- [面向开发的服务器重载](#面向开发的服务器重载)
- [Human-in-the-Loop (HIL) 工具执行](#human-in-the-loop-hil-工具执行)
- [Human-in-the-Loop (HIL) 配置](#human-in-the-loop-hil-配置)
- [性能指标](#性能指标)
- [历史记录管理](#历史记录管理)
- [自动补全与提示符功能](#自动补全与提示符功能)
- [Typer shell 自动补全](#typer-shell-自动补全)
- [FZF 风格自动补全](#fzf-风格自动补全)
- [MCP 提示词自动补全](#mcp-提示词自动补全)
- [上下文提示符](#上下文提示符)
- [配置管理](#配置管理)
- ✨**新** [按提供商的配置档案](#按提供商的配置档案)
- [服务器配置格式](#服务器配置格式)
- [小贴士: MCP 服务器配置文件的存放位置及可用示例](#小贴士-mcp-服务器配置文件的存放位置及可用示例)
- [兼容的模型](#兼容的模型)
- [Ollama Cloud 模型](#ollama-cloud-模型)
- ✨**新** [赞助商](#赞助商)
- [Atlas Cloud](#atlas-cloud)
- [成为赞助商](#成为赞助商)
- [在哪里可以找到更多 MCP 服务器?](#在哪里可以找到更多-mcp-服务器)
- [相关项目](#相关项目)
- [安全](#安全)
- [许可证](#许可证)
- [致谢](#致谢)
## 概述
MCP Client for Ollama(ollmcp)是一款为 harness 工程打造的现代化交互式终端应用(TUI),它将本地的 Ollama LLM 连接到一个或多个 Model Context Protocol(MCP)服务器。通过完整支持 MCP 的核心原语(工具、提示词和资源),它提供了一个可控的终端空间:你来掌舵,代理来执行。凭借丰富且友好的界面,你可以实时、安全地管理你的配置,无需编写任何代码。无论你是在构建、测试还是探索,这个客户端都能通过模糊自动补全、高级模型配置、用于快速开发的 MCP 服务器热重载以及严格的 Human-in-the-Loop 安全控制等功能来简化你的工作流。
## 功能特性
- 🤖 **Agent 模式**: 当模型请求多次工具调用时进行迭代式工具执行,可配置循环上限,并在达到上限时提供交互式选择(继续、收尾或中止)
- 🌐 **多服务器支持**: 同时连接多个 MCP 服务器
- 🚀 **多种传输类型**: 支持 STDIO、SSE 和 Streamable HTTP 服务器连接
- 📋 **MCP 提示词支持**: 浏览、调用和管理 MCP 服务器的提示词,支持参数收集、预览和安全回滚
- 📦 **MCP 资源支持**: 浏览并读取 MCP 服务器的上下文数据,包括文件、文档和结构化数据
- ☁️ **Ollama Cloud 支持**: 与 Ollama Cloud 模型的工具调用无缝协作,在使用本地 MCP 工具的同时访问强大的云端模型
- 🌍 **多 LLM 提供商**: 使用 Ollama(默认)或兼容 OpenAI 的提供商(OpenAI、OpenRouter、DeepSeek 等),连接设置按提供商分别记忆
- 🎨 **丰富的终端界面**: 具有现代风格的交互式控制台 UI
- 🌊 **流式响应**: 实时查看模型生成的输出
- 📝 **回答显示模式**: 在流式输出时于 Plain、Markdown、Both 或 Markdown (blocks) 视图之间切换
- 🛠️ **工具管理**: 在聊天会话中启用/禁用特定工具或整个服务器
- 🧑💻 **Human-in-the-Loop (HIL)**: 在工具执行前审查并批准,以获得更强的控制和安全性
- 🎮 **高级模型配置**: 微调 15 个以上的模型参数,包括上下文窗口大小、温度、采样、重复控制等
- 💬 **系统提示词自定义**: 定义并编辑系统提示词以控制模型的行为和人设
- 🧠 **上下文窗口控制**: 调整上下文窗口大小(num_ctx)以处理更长的对话和复杂任务
- 🎨 **增强的工具显示**: 美观、结构化的工具执行可视化,带 JSON 语法高亮
- 🧠 **上下文管理**: 通过可配置的保留设置控制对话记忆
- 🤔 **思考模式**: 在支持的模型上提供高级推理能力,可查看思考过程(例如 gpt-oss、deepseek-r1、qwen3 等)
- 💪 **推理强度级别**: 在支持的模型上将推理强度设置为 auto、minimal、low、medium、high 或 xhigh
- 🖼️ **视觉工具支持**: 工具返回的图像会自动转发给具备视觉能力的模型
- 🗣️ **跨语言支持**: 与 Python 和 JavaScript 编写的 MCP 服务器均可无缝协作
- 📜 **历史记录管理**: 查看完整对话历史,导出为 JSON 以备份/分析,并导入先前会话以延续对话
- 🔍 **自动发现**: 自动查找并使用 Claude 已有的 MCP 服务器配置
- 🔁 **动态模型切换**: 无需重启即可在任意已安装的 Ollama 模型之间切换
- 💾 **配置持久化**: 在会话之间保存和加载工具偏好与模型设置
- 🔄 **服务器重载**: 开发期间热重载 MCP 服务器,无需重启客户端
- ✨ **模糊自动补全**: 交互式、方向键操作的命令自动补全,带说明
- 🏷️ **动态提示符**: 显示当前模型、思考模式和已启用的工具
- 📊 **性能指标**: 每次查询后显示详细的模型性能数据,包括耗时和 token 数量
- 🔌 **即插即用**: 与符合 MCP 标准的工具服务器开箱即用
- 🔔 **更新通知**: 自动检测新版本发布
- 🖥️ **基于 Typer 的现代 CLI**: 分组选项、shell 自动补全和更好的帮助输出
- ⏹️ **中止生成**: 在响应流式输出期间随时按下 'a' 即可中止模型生成
## 环境要求
- **Python 3.11+**([安装指南](https://www.python.org/downloads/))
- 本地运行的 **Ollama**([安装指南](https://ollama.com/download))
- 安装后,运行 `ollama list` 查看可用模型。如果尚未安装任何模型,可以用 `ollama pull ` 拉取一个。例如 `ollama pull gemma4:latest`。
- **UV 包管理器**([安装指南](https://github.com/astral-sh/uv))
## 快速开始
通过 pip 安装 `ollmcp`,添加一个 MCP 服务器并运行客户端:
```bash
# Install ollmcp via uv
uv tool install --upgrade ollmcp
# or via pip
pip install --upgrade ollmcp
# Add an MCP server (example: playwright stdio server)
ollmcp mcp add playwright -- npx @playwright/mcp@latest
# Run the client (check optional flags with `ollmcp --help`)
ollmcp # once running, use /help for interactive commands
```
## 安装方式
**方式 1:** 使用 uv 安装并运行(推荐)
```bash
uv tool install --upgrade ollmcp
ollmcp
```
**方式 2:** 使用 pip 安装并运行
```bash
pip install --upgrade ollmcp
ollmcp
```
**方式 3:** 免安装直接运行(需要 `uv` 包管理器)
```bash
uvx ollmcp
```
**方式 4:** 从源码安装并使用虚拟环境运行
```bash
git clone https://github.com/jonigl/mcp-client-for-ollama.git
cd mcp-client-for-ollama
uv run -m mcp_client_for_ollama
```
## 故障排除
### `Could not find a version that satisfies the requirement ollmcp (from versions: none)`
这几乎总是意味着你使用的 Python **低于要求的 3.11+**。这在 macOS 上很常见:系统自带的 Python(`/usr/bin/python3`)或 Xcode 附带的 Python 可能是 3.9 或更旧的版本。当没有任何发行版本满足 `requires-python >= 3.11` 时,pip 会过滤掉所有版本,并报出令人误解的 "from versions: none"。
先检查你的版本:
```bash
python3 --version # must be 3.11 or newer
```
然后使用较新的 Python 进行安装。最简单的方式是 `uv`,它会自动为你获取合适的 Python:
```bash
uv tool install --upgrade ollmcp # recommended, installs the CLI in an isolated environment
# or, if you prefer pip, make sure to use a Python 3.11+ interpreter:
python3.11 -m pip install --upgrade ollmcp
# Then run the client:
ollmcp
```
请参阅[安装方式](#安装方式)。
### `error: externally-managed-environment` (PEP 668)
在较新的 Debian/Ubuntu(Python 3.12+)上,系统的 `pip` 被有意锁定以保护由操作系统管理的软件包,因此 `pip install ollmcp` 会被阻止。这是系统策略([PEP 668](https://peps.python.org/pep-0668/)),并非 ollmcp 的问题。请改为安装到隔离环境中:
```bash
uv tool install --upgrade ollmcp # recommended, installs the CLI in an isolated environment
# or, if you prefer pip, use a virtual environment:
python3.11 -m venv ollmcp-env
source ollmcp-env/bin/activate
python3.11 -m pip install --upgrade ollmcp
# Then run the client:
ollmcp
```
请参阅[安装方式](#安装方式)。
> [!WARNING]
> 避免使用 `pip install --break-system-packages ollmcp`。它虽然可行,但会安装到系统 Python 中,可能破坏操作系统依赖的软件包。
## 通过 CLI 管理 MCP 服务器
ollmcp 可以直接从命令行管理自己的 MCP 服务器配置,类似于 `claude mcp`:
```bash
# Remote servers (Streamable HTTP or SSE)
ollmcp mcp add --transport http
ollmcp mcp add --transport sse
# Local stdio servers - everything after `--` is the command to run
ollmcp mcp add [options] -- [args...]
# List configured servers
ollmcp mcp list
# Remove a server
ollmcp mcp remove
# For more details on options and usage, run:
ollmcp mcp --help
ollmcp mcp add --help
```
**示例:**
> [!TIP]
> 添加一些服务器后,直接运行 `ollmcp` 就会自动连接它们。
```bash
ollmcp mcp add --transport http github https://api.githubcopilot.com/mcp/ --header "Authorization: Bearer $YOUR_GITHUB_PAT"
ollmcp mcp add --transport stdio playwright npx @playwright/mcp@latest
ollmcp mcp add filesystem -- npx -y @modelcontextprotocol/server-filesystem /allowed-dir1 ~/allowed-dir2 # stdio transport by default
ollmcp mcp add --env API_KEY=YOUR_KEY --transport sse my-sse-server http://localhost:8000/sse
```
### mcp add 选项
- `--transport`, `-t`: `stdio`(默认)、`sse` 或 `http`。
- `--header`, `-H`: 用于 `sse`/`http` 服务器的 HTTP 头,格式为 `"Name: Value"`。可重复。
- `--env`, `-e`: 用于 `stdio` 服务器的环境变量,格式为 `KEY=value`。可重复。
- `--scope`, `-s`: 服务器的存储位置(见下方作用域)。默认: `local`。
### 作用域 (Scopes)
| 作用域 | 加载范围 | 是否与团队共享 | 存储位置 |
|-----------|-----------------------|-------------------|-----------|
| `local` | 仅当前项目 | 否 | `~/.config/ollmcp/mcp.local.json`(按项目路径索引) |
| `project` | 仅当前项目 | 是(通过 VCS) | 项目根目录下的 `.mcp.json` |
| `user` | 你的所有项目 | 否 | `~/.config/ollmcp/mcp.json` |
`project` 作用域会在项目根目录写入标准的 `.mcp.json` 文件,与 Claude Code 及其他支持 MCP 的工具兼容。如果同一服务器名称存在于多个作用域,优先级为 `local` > `project` > `user`。
> [!NOTE]
> 通过 `ollmcp mcp add` 添加的服务器始终作为基础层加载。任何标志(`--mcp-server`、`--mcp-server-url`、`--servers-json`、`--claude-desktop`)都会叠加在其之上。要包含 Claude Desktop 的服务器,请显式传递 `--claude-desktop`。
>
> 如果同名服务器也通过上述某个标志提供,目前两个连接都会被打开,但该名称下只有一个保持活跃。请避免在 `--mcp-server`/`--mcp-server-url`/`--servers-json`/`--claude-desktop` 中重用注册表中服务器的名称。
### 命令行参数
> [!TIP]
> CLI 现在使用 `Typer` 提供现代体验: 分组选项、丰富的帮助信息和内置的 shell 自动补全。高级用户可以使用短标志加快命令输入。要启用自动补全,请运行:
>
> ```bash
> ollmcp --install-completion
> ```
>
> 然后重启你的 shell 或按照打印的说明操作。
#### MCP 服务器配置:
- `--mcp-server`, `-s`: 一个或多个 MCP 服务器脚本(.py 或 .js)的路径。可多次指定。
- `--mcp-server-url`, `-u`: 一个或多个 SSE 或 Streamable HTTP MCP 服务器的 URL。可多次指定。典型端点参见[常见的 MCP 端点路径](#常见的-mcp-端点路径)。
- `--servers-json`, `-j`: 包含服务器配置的 JSON 文件路径。详情参见[服务器配置格式](#服务器配置格式)。
- `--claude-desktop`: 从 Claude Desktop 的配置文件(`~/Library/Application Support/Claude/claude_desktop_config.json`)加载服务器。与通过 `ollmcp mcp add` 添加的服务器及其他标志合并。
> [!IMPORTANT]
> **重大变更:** `--auto-discovery` / `-a` 已被 `--claude-desktop` 取代。此外,通过 `ollmcp mcp add` 添加的服务器现在始终自动加载,不再是使用其他标志时会消失的后备选项。Claude Desktop 的服务器从不自动加载;请使用 `--claude-desktop` 来包含它们。
#### 推理提供商配置:
- `--model`, `-m` MODEL: 要使用的模型。默认: 已保存配置中的模型(如有设置),否则为 Ollama 中第一个可用的模型
- `--provider`, `-p` PROVIDER: 要使用的 LLM 提供商(例如 `ollama`、`openai`、`atlascloud`、`openrouter`、`deepseek`)。默认: `ollama`
- `--host`, `-H` HOST: LLM 主机 / API 基础 URL。对 `ollama` 提供商默认为 Ollama 的 `http://localhost:11434`,其他提供商则使用其自身的默认端点。
- `--api-key`, `-k` KEY: LLM 提供商的 API key。也可从环境变量 `$OLLMCP_API_KEY` 读取,该变量**与提供商无关**(作用于你通过 `--provider` 选择的任何提供商)。通过 `$OLLMCP_API_KEY` 传入的 key 永远不会写入配置文件;只有通过 `--api-key` 传入的 key 才会被保存。`ollama` 不需要 key。
> [!NOTE]
> 当前支持的提供商: `ollama`、`openai`、`atlascloud` 以及任何兼容 OpenAI 的提供商(`openrouter`、`deepseek`、`perplexity` 等)。更多提供商即将支持。
#### 通用选项:
- `--version`, `-v`: 显示版本并退出
- `--help`, `-h`: 显示帮助信息并退出
- `--install-completion`: 为客户端安装 shell 自动补全脚本
- `--show-completion`: 显示可用的 shell 补全选项
#### MCP 服务器日志:
MCP 服务器报告的所有内容都会写入 `~/.config/ollmcp/logs//.log`,每次运行一个目录,保留最近 5 次。**除非你主动要求,服务器打印的内容都不会显示在屏幕上** —— 否则它会覆盖正在流式输出的回答。
服务器通过两个渠道报告:**stderr**(仅限 stdio 服务器,因为远程服务器运行在别处)和 **MCP 日志通知**(任何服务器)。**这两个选项只改变屏幕上显示的内容 —— 日志文件无论如何都会收到全部内容:**
| | 写入日志文件 | 显示在屏幕上 |
|---|---|---|
| *(不加选项)* | 服务器发送的全部内容 | 服务器的内容都不显示 |
| `--debug` | 服务器发送的全部内容 | 全部内容,实时显示 |
| `--log-level LEVEL` | 服务器发送的全部内容 | 仅该级别及以上的通知 |
| `--debug --log-level LEVEL` | 服务器发送的全部内容 | 完整的 stderr + 该级别及以上的通知 |
LEVEL 为 `debug`、`info`、`notice`、`warning`、`error`、`critical`、`alert`、`emergency` 之一。
不加选项时不会请求任何级别:由服务器决定发送什么,并全部记录下来。`--log-level` 用于过滤你看到的内容;当服务器声明了 logging capability 时,该级别还会通过 `logging/setLevel` 发送给服务器 —— 此时服务器可能不再发送更低的级别,那些内容也就不会出现在文件里。没有该 capability 的服务器会照常发送全部内容,过滤在客户端进行。
当服务器连接失败时,错误信息会指向它的日志文件:服务器退出前打印的内容都在里面,那通常才是真正的原因。
> [!NOTE]
> ollmcp 自身报告的内容写入 `~/.config/ollmcp/logs//ollmcp.log`,与服务器的日志文件放在同一目录。它每次运行都会写入,不需要 `--debug`;屏幕上提示响应流提前结束时,指向的就是这个文件。目前仍在完善中(work in progress):现在主要记录提供商和流式输出的错误,以后会记录更多内容。
### 支持的推理提供商
> [!WARNING]
> **非 Ollama 提供商仍处于实验阶段。** 对 Ollama 以外提供商的支持是最近添加的,仍在稳定化过程中,可能还有部分功能无法正常工作。
ollmcp 支持 **Ollama** 以及 [any-llm](https://github.com/mozilla-ai/any-llm) 暴露的任何**兼容 OpenAI** 的提供商。通过 `--provider` 选择一个。通过 `--api-key` 或 `$OLLMCP_API_KEY`(两者对**任何**选定的提供商都有效)提供 key,或者使用下方所示提供商自己的环境变量。`$OLLMCP_API_KEY` 和提供商原生环境变量永远不会写入磁盘;只有通过 `--api-key` 传入的 key 才会保存到配置中。
| 提供商(`--provider`) | API key 环境变量 |
|---|---|
| [`ollama`](https://github.com/ollama/ollama)(默认) | -(本地) |
| [`atlascloud`](https://www.atlascloud.ai/?utm_source=github&utm_medium=link&utm_campaign=mcp-client-for-ollama) | `ATLASCLOUD_API_KEY` |
| [`azureopenai`](https://learn.microsoft.com/en-us/azure/ai-foundry/) | `AZURE_OPENAI_API_KEY` |
| [`dashscope`](https://bailian.console.aliyun.com/cn-beijing/?tab=api#/api) | `DASHSCOPE_API_KEY` |
| [`databricks`](https://docs.databricks.com/) | `DATABRICKS_TOKEN` |
| [`deepinfra`](https://deepinfra.com/docs/openai_api) | `DEEPINFRA_API_KEY` |
| [`deepseek`](https://platform.deepseek.com/) | `DEEPSEEK_API_KEY` |
| [`fireworks`](https://fireworks.ai/api) | `FIREWORKS_API_KEY` |
| [`gateway`](https://github.com/mozilla-ai/any-llm) | `GATEWAY_API_KEY` |
| [`inception`](https://inceptionlabs.ai/) | `INCEPTION_API_KEY` |
| [`llama`](https://www.llama.com/products/llama-api/) | `LLAMA_API_KEY` |
| [`llamacpp`](https://github.com/ggml-org/llama.cpp) | -(本地) |
| [`llamafile`](https://github.com/Mozilla-Ocho/llamafile) | -(本地) |
| [`lmstudio`](https://lmstudio.ai/) | `LM_STUDIO_API_KEY` |
| [`minimax`](https://www.minimax.io/platform_overview) | `MINIMAX_API_KEY` |
| [`moonshot`](https://platform.moonshot.ai/) | `MOONSHOT_API_KEY` |
| [`mzai`](https://any-llm.ai) | `ANY_LLM_KEY` |
| [`nebius`](https://studio.nebius.ai/) | `NEBIUS_API_KEY` |
| [`openai`](https://platform.openai.com/docs/api-reference) | `OPENAI_API_KEY` |
| [`openrouter`](https://openrouter.ai/docs) | `OPENROUTER_API_KEY` |
| [`perplexity`](https://docs.perplexity.ai/) | `PERPLEXITY_API_KEY` |
| [`portkey`](https://portkey.ai/docs) | `PORTKEY_API_KEY` |
| [`qiniu`](https://developer.qiniu.com/aitokenapi) | `QINIU_API_KEY` |
| [`sambanova`](https://sambanova.ai/) | `SAMBANOVA_API_KEY` |
| [`vllm`](https://docs.vllm.ai/) | `VLLM_API_KEY` |
| [`zai`](https://docs.z.ai/guides/develop/python/introduction) | `ZAI_API_KEY` |
> [!NOTE]
> 本地的兼容 OpenAI 服务器(`ollama`、`llamacpp`、`llamafile`、`lmstudio`、`vllm`)通常无需 API key 即可运行,用 `--host` 将 ollmcp 指向它们即可。any-llm 提供的**不**兼容 OpenAI 的提供商(例如 `anthropic`、`gemini`、`mistral`、`groq`、`cohere`)尚未支持。
> [!WARNING]
> **能力检测的局限:** ollmcp 只能从 Ollama 读取每个模型的真实能力(`tools`、`vision`、`thinking`)。对于所有非 Ollama 提供商,目前默认这三种能力全部可用,并在模型列表和徽标中如此显示,因此某个模型即使不支持工具、视觉或思考,也可能被显示为支持。如果模型缺少某项能力,你在尝试使用时提供商的 API 会返回错误。
#### API key 解析顺序
对于所选提供商,ollmcp 按以下顺序解析 API key,从**最高**到**最低**优先级:
1. `--api-key` / `-k` 标志。
2. 环境变量 `$OLLMCP_API_KEY`(与提供商无关,作用于通过 `--provider` 选择的提供商)。
3. 保存在 `~/.config/ollmcp/config.json` 中的按提供商 key(仅当曾通过 `--api-key` 传入时才存在)。
4. 由 [any-llm](https://github.com/mozilla-ai/any-llm) 检测的提供商原生环境变量(例如 `OPENAI_API_KEY`、`OPENROUTER_API_KEY`)。
> [!WARNING]
> 已保存的按提供商 key(3)优先于提供商的原生环境变量(4)。因此,如果你之前保存了**错误或已过期**的 key,仅设置 `OPENAI_API_KEY`(或等价变量)**不会**覆盖它。要修复,请通过 `--api-key` 传入正确的 key,或从 `~/.config/ollmcp/config.json` 中该提供商的档案里删除过期的 `apiKey`。
### 使用示例
运行客户端最简单的方式:
```bash
ollmcp
```
> [!TIP]
> 这会连接所有通过 `ollmcp mcp add` 注册的服务器,并使用已保存配置文件中的模型;若没有保存,则使用 Ollama 中第一个可用的模型。传递 `--claude-desktop` 可同时包含 Claude Desktop 配置中的服务器。
连接单个服务器:
```bash
ollmcp --mcp-server /path/to/weather.py --model llama3.2:3b
# Or using short flags:
ollmcp -s /path/to/weather.py -m llama3.2:3b
```
连接多个服务器:
```bash
ollmcp --mcp-server /path/to/weather.py --mcp-server /path/to/filesystem.js
# Or using short flags:
ollmcp -s /path/to/weather.py -s /path/to/filesystem.js
```
> [!TIP]
> 如果未指定 `--model`,则使用已保存配置文件中的模型;否则自动选择 Ollama 中第一个可用的模型(如果没有安装任何模型,会提示你如何拉取)。
使用 JSON 配置文件:
```bash
ollmcp --servers-json /path/to/servers.json --model llama3.2:1b
# Or using short flags:
ollmcp -j /path/to/servers.json -m llama3.2:1b
```
> [!TIP]
> 关于 JSON 文件的结构,请参见[服务器配置格式](#服务器配置格式)一节。
使用自定义 Ollama 主机:
```bash
ollmcp --host http://localhost:22545 --servers-json /path/to/servers.json
# Or using short flags:
ollmcp -H http://localhost:22545 -j /path/to/servers.json
```
使用其他 LLM 提供商(OpenAI 或任何兼容 OpenAI 的 API):
```bash
ollmcp --provider openai --api-key $OPENAI_API_KEY --model gpt-5.5
# OpenAI-compatible providers (e.g. OpenRouter, DeepSeek); override the endpoint with --host if needed:
ollmcp --provider openrouter --api-key $OPENROUTER_API_KEY -m openrouter/free
```
> [!TIP]
> 提供商设置(模型、主机、API key)按**提供商**分别记忆。用 `/save-config` 保存后,直接运行 `ollmcp` 会恢复你上次使用的提供商。详情参见[配置管理](#配置管理)。
通过 URL 连接 SSE 或 Streamable HTTP 服务器:
```bash
ollmcp --mcp-server-url http://localhost:8000/sse --model qwen2.5:latest
# Or using short flags:
ollmcp -u http://localhost:8000/sse -m qwen2.5:latest
```
连接多个 URL 服务器:
```bash
ollmcp --mcp-server-url http://localhost:8000/sse --mcp-server-url http://localhost:9000/mcp
# Or using short flags:
ollmcp -u http://localhost:8000/sse -u http://localhost:9000/mcp
```
混合使用本地脚本和 URL 服务器:
```bash
ollmcp --mcp-server /path/to/weather.py --mcp-server-url http://localhost:8000/mcp --model qwen3:1.7b
# Or using short flags:
ollmcp -s /path/to/weather.py -u http://localhost:8000/mcp -m qwen3:1.7b
```
在其他来源之外同时包含 Claude Desktop 的服务器:
```bash
ollmcp --mcp-server /path/to/weather.py --mcp-server-url http://localhost:8000/mcp --claude-desktop
# Or using short flags:
ollmcp -s /path/to/weather.py -u http://localhost:8000/mcp --claude-desktop
```
### 工具调用的工作原理
1. 客户端将你的查询连同可用工具列表发送给 Ollama
2. 如果 Ollama 决定使用某个工具,客户端会:
- 以格式化的参数和语法高亮展示工具执行
- 显示 Human-in-the-Loop 确认提示(如已启用),让你审查并批准该工具调用
- 从模型响应中提取工具名称和参数
- 使用这些参数调用相应的 MCP 服务器(仅在获得批准或 HIL 已禁用时)
- 以结构化、易读的格式显示工具响应(包括图像和不支持媒体的摘要)
- 如果工具返回了图像且当前模型支持视觉,则将图像附加到下一条 LLM 消息;否则显示警告
- 将工具结果发送回 Ollama
- 如果处于 Agent 模式,且模型请求更多工具调用,则重复该过程
3. 最后,客户端:
- 显示模型整合了工具结果的最终响应
### Agent 模式
某些模型可能在一次对话中请求多次工具调用。客户端支持 **Agent 模式**,实现迭代式工具执行:
- 当模型请求工具调用时,客户端执行它并将结果发回给模型
- 该过程不断重复,直到模型给出最终答案或达到配置的循环上限
- 你可以用 `/loop-limit`(`/ll`)命令设置最大迭代次数
- 默认循环上限为 `7`,以防止无限循环
#### 达到循环上限时
客户端不会静默停止,而是暂停并询问你如何继续:
| 选项 | 按键 | 说明 |
|--------|-----|-------------|
| **继续** | `c` *(默认)* | 再授予一批迭代次数(与当前上限相同) |
| **数量** | `n` | 精确选择还允许多少次迭代 |
| **不限制** | `u` | 移除上限,运行到模型不再请求工具为止 |
| **收尾** | `w` | 让模型总结目前收集到的信息并给出最终答案 — 保留达到上限前收集的所有工具结果 |
| **中止** | `a` | 完全丢弃本轮(不保存任何内容到历史记录) |
> [!NOTE]
> 如果你想避免使用 Agent 模式,只需将循环上限设为 `1`。
#### Agent 模式快速演示:
[](https://asciinema.org/a/476qpEamCX9TFQt4jNEXIgHxS)
## 交互式命令
聊天期间可以使用以下命令:
> [!IMPORTANT]
> **新:** 内置交互式命令现在需要以 `/` 开头。
> - 使用 `/help`、`/model`、`/tools`、`/prompts` 等。
> - 像 `help` 或 `model` 这样不带斜杠的命令名不再作为命令执行。
> - 提示词调用同样使用 `/`,推荐使用 `/server:prompt_name` 以避免冲突。

| 命令 | 快捷方式 | 说明 |
|------------------|------------------|-----------------------------------------------------|
| `abort` | `a` | 模型生成期间,中止当前响应的生成 |
| `/clear`, `/new` | `/cc` | 清除对话历史和上下文 |
| `/cls` | `/clear-screen` | 清空终端屏幕 |
| `/context` | `/c` | 切换上下文保留 |
| `/context-info` | `/ci` | 显示上下文统计信息 |
| `/export-history`| `/eh` | 将聊天历史导出为 JSON 文件 |
| `/full-history` | `/fh` | 显示全部对话历史 |
| `/help` | `/h` | 显示帮助和可用命令 |
| `/import-history`| `/ih` | 从 JSON 文件导入聊天历史 |
| `/human-in-the-loop` | `/hil` | 切换工具执行的 Human-in-the-Loop 确认 |
| `/load-config` | `/lc` | 从文件加载工具和模型配置 |
| `/loop-limit` | `/ll` | 设置工具循环的最大迭代次数(Agent 模式)。默认: 7 |
| `/model` | `/m` | 列出并选择其他 Ollama 模型 |
| `/model-config` | `/mc` | 配置高级模型参数和系统提示词 |
| `/display-mode` | `/dm` | 选择 Plain、Markdown、Both 或 Markdown (blocks) 回答显示模式 |
| `/input-mode` | `/im` | 选择单行或多行聊天输入模式 |
| `/prompts` | `/pr` | 浏览并查看所有可用的 MCP 提示词 |
| `/server:prompt_name` | `/prompt_name` | 调用提示词(推荐使用带服务器名的完整形式) |
| `/resources` | `/res` | 浏览并查看所有可用的 MCP 资源 |
| `@uri` | - | 按 URI 读取特定资源(例如 `@server://info`) |
| `/quit`, `/exit`, `/bye` | `/q`、`Ctrl+C` 或 `Ctrl+D` | 退出客户端 |
| `/reload-servers`| `/rs` | 使用当前配置重载所有 MCP 服务器 |
| `/reset-config` | `/rc` | 将配置重置为默认值(启用所有工具) |
| `/save-config` | `/sc` | 将当前工具和模型配置保存到文件 |
| `/show-metrics` | `/sm` | 切换性能指标显示 |
| `/show-thinking` | `/st` | 切换思考文本的可见性(默认可见) |
| `/thinking-mode` | `/tm` | 在支持的模型上切换思考模式 |
| `/reasoning-effort` | `/re` | 思考模式开启时设置推理强度级别(auto/minimal/low/medium/high/xhigh)。默认: medium |
| `/show-tool-execution` | `/ste` | 切换工具执行显示的可见性 |
| `/tools` | `/t` | 打开工具选择界面 |
### MCP 工具
工具和服务器选择界面允许你启用或禁用特定工具:

- 输入以逗号分隔的**数字**(例如 `1,3,5`)来切换特定工具
- 输入数字**范围**(例如 `5-8`)来切换多个连续的工具
- 输入 **S + 数字**(例如 `S1`)来切换某个服务器的全部工具
- `a` 或 `all` - 启用所有工具
- `n` 或 `none` - 禁用所有工具
- `d` 或 `desc` - 显示/隐藏工具描述
- `j` 或 `json` - 显示已启用工具的详细 JSON schema,用于调试
- `s` 或 `save` - 保存更改并返回聊天
- `q` 或 `quit` - 取消更改并返回聊天
### MCP 提示词
MCP 提示词提供可复用的、由服务器定义的对话开场白和上下文模板。服务器可以暴露带有描述、必填参数和预格式化消息的提示词,帮助你快速开始特定类型的对话,或向聊天中注入结构化上下文。
#### 功能特性
- 📋 **浏览提示词**: 查看已连接服务器的所有可用提示词及其描述和参数要求
- ⚡️ **快速调用**: 使用斜杠语法调用提示词(推荐 `/server:prompt_name`)
- 🔤 **自动补全**: 输入 `/` 查看带模糊匹配的提示词建议
- 📝 **参数收集**: 交互式引导你填写必需的参数
- 👁️ **预览**: 注入前查看提示词内容,确保符合你的需求
- 🎯 **灵活注入**: 选择立即执行或仅注入(添加到历史记录而不触发模型)
- 🧠 **上下文感知**: 根据提示词以用户消息还是助手消息结尾自动调整行为
- 🔄 **安全回滚**: 中止或出错时自动清理历史记录
- 💬 **文本内容**: 支持基于文本的提示词消息(图像/音频/资源支持即将推出)
#### 如何使用 MCP 提示词
**浏览可用的提示词:**
```
/prompts # or '/pr'
```
这会按服务器分组显示所有提示词,包括名称、必填参数和描述。
**调用提示词:**
```
/server:prompt_name
```
例如,如果名为 `docs` 的服务器提供了 "summarize" 提示词:
```
/docs:summarize
```
如果某个提示词名称在所有已连接服务器中是唯一的,可以使用简短形式:
```
/summarize
```
如果多个服务器暴露了同名提示词,客户端会要求你使用完整形式,并给出有效的 `/server:prompt_name` 选项。
**自动补全:**
- 输入 `/` 查看所有可用提示词及其描述
- 继续输入可用模糊匹配过滤提示词
- 用方向键导航,按 Enter 选择
> [!TIP]
> 连接 MCP 服务器时会自动发现提示词。如果服务器支持提示词,它们会立即出现在 `prompts` 列表和自动补全中。
**工作流程:**
1. 输入 `/server:prompt_name`(推荐)或从自动补全中选择
2. 如果提示词需要参数,系统会提示你提供
3. 查看提示词预览,了解将要注入的内容
4. 选择如何使用该提示词:
- **y/yes**(默认): 将提示词发送给模型并获得响应
- 对以**用户消息**结尾的提示词: 使用该消息作为查询
- 对以**助手消息**结尾的提示词: 添加 "Please respond based on the above context." 作为查询
- **i/inject**: 仅将提示词添加到对话历史而不触发模型(之后你可以输入自己的查询)
- **n/no**: 取消并返回聊天
5. 提示词根据你的选择被注入
6. 如果在模型生成期间中止(按 'a'),更改会自动回滚
**示例:**

> [!WARNING]
> **内容类型限制**: MCP 提示词目前**仅支持文本内容**。以下内容类型尚不支持,将被自动跳过:
> - 🖼️ **图像** - 提示词中的图像内容
> - 🎵 **音频** - 提示词中的音频内容
> - 📦 **资源** - 内嵌的资源内容
### MCP 资源
MCP 资源提供对 MCP 服务器所暴露上下文数据的访问——文件、文档、结构化数据等。服务器可以暴露带有元数据(名称、描述、MIME 类型)的资源,你可以浏览这些资源并将其读入对话上下文。
#### 功能特性
- 📋 **浏览资源**: 查看已连接服务器的所有可用资源,包括 URI、名称、MIME 类型和描述
- 📖 **读取资源**: 使用 `@uri` 语法读取资源内容,可单独使用或内联在查询中
- 📝 **文本内容**: 完整支持基于文本的资源(markdown、代码、日志等)
- 🖼️ **视觉图像支持**: 图像资源(`image/*`)会自动以 base64 图像形式转发给具备视觉能力的模型
- 🎯 **上下文注入**: 资源内容会被缓冲,并在你的下一次查询时作为上下文注入
- 🔍 **自动补全**: 输入 `@` 查看带模糊匹配的可用资源和模板建议
- 🛡️ **二进制安全**: 非图像的二进制内容(音频、视频、PDF、压缩包)会被检测并优雅地跳过,同时给出提示信息
#### 如何使用 MCP 资源
**浏览可用的资源:**
```
/resources # or '/res'
```
这会按服务器分组显示所有资源和模板,包括 URI、名称、MIME 类型和描述。二进制资源标有 `[binary]` 标签,模板标有 `[template]` 标签。
**读取资源:**
```
@
```
例如,读取一个文件资源:
```
@file:///path/to/document.md
```
`@uri` 有两种用法:
**1. 单独使用(先缓冲后查询):** 单独输入 `@uri`。资源会被获取并缓冲。然后在下一个提示符输入你的查询。资源内容会自动作为上下文注入。
**2. 内联使用(单轮完成):** 在查询文本中的任意位置包含 `@uri`。资源被获取后,查询会在一步内立即处理。
**单独使用示例:**
```
qwen3/show-thinking/6-tools❯ @server://info
✅ Read resource 'get_server_info' (197 chars)
Preview:
This is a simple MCP server with streamable HTTP transport. It supports tools for greeting, adding numbers, generating
random numbers, and calculating BMI. It also provides a BMI calculator prompt.
1 resource(s) buffered. Type your query, or include @another_uri inline.
qwen3/show-thinking/6-tools❯ Next question here
```
**内联使用示例:**
```
qwen3/show-thinking/6-tools❯ summarize the key features from @server://info
✅ Read resource 'get_server_info' (197 chars)
Preview:
This is a simple MCP server with streamable HTTP transport. It supports tools for greeting, adding numbers, generating
random numbers, and calculating BMI. It also provides a BMI calculator prompt.
[model response]
```
> [!TIP]
> 连接 MCP 服务器时会自动发现资源。如果服务器支持资源,它们会立即出现在 `resources` 列表和 `@` 自动补全中。
> [!NOTE]
> 🖼️ **图像**(`image/*`)**是**受支持的,它们会以 base64 数据的形式直接传给具备视觉能力的模型。
> **二进制内容**: 以下资源类型**不**支持作为上下文,将被跳过并给出提示信息:
> - 🎵 **音频** - `audio/*` MIME 类型
> - 📹 **视频** - `video/*` MIME 类型
> - 📄 **PDF** - `application/pdf`
> - 🗜️ **压缩包** - `application/zip`、`application/octet-stream`
>
### 回答显示模式
`/display-mode`(`/dm`)命令让你选择模型回答在流式输出时的显示方式:
- **Plain**: 以纯文本形式流式输出一次,最后不进行 markdown 重新渲染
- ✨**新** **Markdown**(默认): 逐行流式输出格式化的 markdown——位于小段实时尾部之上的行只打印一次且不再重绘,因此即使遇到 emoji 或终端大小调整也保持可靠
- **Both**: 先流式输出纯文本,然后将完整响应再次渲染为 markdown
- **Markdown (blocks)**: 逐块将响应渲染为 markdown,仅追加不重绘: 每个段落/列表/表格/代码块在完成时打印一次且不再重绘,因此不会出现重复行
在聊天中使用 `/display-mode` 或 `/dm` 打开交互式选择器。
**为什么可能需要切换模式:**
- **Plain** 是干扰最小的选项,适合想要最少重绘或闪烁的情况
- **Markdown** 将逐行流式输出与连贯的 markdown 格式结合;最多只有最后几行会被重绘,因此即使有 emoji 或大小调整,异常也保持在有限范围内
- **Both** 提供快速的流式反馈,外加干净的最终 markdown 渲染
- **Markdown (blocks)** 是在流式输出中查看格式化 markdown 最保守的方式,代价是按块(而非按行)更新
> [!TIP]
> 你选择的显示模式会随 `/save-config` 保存并随 `/load-config` 恢复,因此可以为不同的工作流保留不同的查看偏好。
### 输入模式
`/input-mode`(`/im`)命令控制你如何撰写聊天消息:
- **单行**(默认): 输入消息后按 **Enter** 立即发送
- **多行**: 按 **Enter** 换行,完成后先按 **Esc** 再按 **Enter** 发送整条消息。这适合包含多个段落或代码块的复杂消息。
- **Ctrl+J** 在多行模式下也可以插入新行,是在各种终端上都可靠的备用方式
在聊天中使用 `/input-mode` 或 `/im` 打开交互式选择器。
> [!IMPORTANT]
> 多行发送快捷键可能因终端模拟器和操作系统键盘处理而异。本客户端依赖 **Esc 然后 Enter** 作为多行模式下可移植的发送快捷键。**Shift+Enter** 和 **Meta+Enter** 在某些终端可能可用,但不作保证。
### 模型选择
模型选择界面显示你的 Ollama 安装中所有可用的模型:

- 输入你想使用的模型**编号**
- `s` 或 `save` - 保存模型选择并返回聊天
- `q` 或 `quit` - 取消模型选择并返回聊天
### 高级模型配置
`/model-config`(`/mc`)命令打开高级模型设置界面,让你微调模型生成响应的方式:

#### 系统提示词
- **System Prompt**: 设置模型的角色和行为以引导响应。
#### 关键参数
- **Context Window (num_ctx)**: 设置模型使用多少聊天历史。需要在内存占用和性能之间权衡。
- **Keep Tokens**: 防止重要的 token 被丢弃
- **Max Tokens**: 限制响应长度(0 = 自动)
- **Seed**: 使输出可复现(设为 -1 表示随机)
- **Temperature**: 控制随机性(0 = 确定性,越高越有创造性)
- **Top K / Top P / Min P / Typical P**: 控制多样性的采样参数
- **Repeat Last N / Repeat Penalty**: 减少重复
- **Presence/Frequency Penalty**: 鼓励新话题,减少重复
- **Stop Sequences**: 自定义停止点(最多 8 个)
- **Batch Size (num_batch)**: 控制请求的内部批处理;更大的值可以提高吞吐量,但占用更多内存。
#### 命令
- 输入参数编号 `1-15` 编辑设置
- 输入 `sp` 编辑系统提示词
- 使用 `u1`、`u2` 等取消设置某个参数,或用 `uall` 重置全部
- `h`/`help`: 显示参数详情和建议
- `undo`: 撤销更改
- `s`/`save`: 应用更改
- `q`/`quit`: 取消
#### 配置示例
- **事实型:** `temperature: 0.0-0.3`、`top_p: 0.1-0.5`、`seed: 42`
- **创意型:** `temperature: 1.0+`、`top_p: 0.95`、`presence_penalty: 0.2`
- **减少重复:** `repeat_penalty: 1.1-1.3`、`presence_penalty: 0.2`、`frequency_penalty: 0.3`
- **均衡型:** `temperature: 0.7`、`top_p: 0.9`、`typical_p: 0.7`
- **可复现:** `seed: 42`、`temperature: 0.0`
- **大上下文:** `num_ctx: 8192` 或更高,用于需要更多上下文的复杂对话
> [!TIP]
> 所有参数默认均未设置,让 Ollama 使用其自身的优化值。在配置菜单中使用 `help` 查看详情和建议。更改会随你的配置一起保存。
### 思考模式与推理强度
使用 `/thinking-mode`(`/tm`)启用思考模式,在支持的模型上激活扩展推理(例如 `qwen3`、`deepseek-r1`、带 extended thinking 的 Claude)。使用 `/show-thinking`(`/st`)切换推理过程在响应中是否可见。
使用 `/reasoning-effort`(`/re`)控制思考模式开启时模型投入**多少推理强度**:
| 级别 | 说明 |
|-------|-------------|
| `auto` | 提供商的默认强度(云端推荐) |
| `minimal` | 最快,推理最少 |
| `low` | 轻度推理 |
| `medium` | 均衡 — **默认** |
| `high` | 更充分的推理 |
| `xhigh` | 最大推理强度 |
> [!NOTE]
> 某些提供商或模型可能忽略推理强度设置。
### 面向开发的服务器重载
`/reload-servers`(`/rs`)命令在 MCP 服务器开发期间特别有用。它允许你重载所有已连接的服务器,而无需重启整个客户端应用。
**主要优势:**
- 🔄 **热重载**: 即时应用你对 MCP 服务器代码的更改
- 🛠️ **开发工作流**: 非常适合迭代开发和测试
- 📝 **配置更新**: 自动拾取服务器 JSON 配置或 Claude 配置中的变化
- 🎯 **状态保留**: 重载后保持你的工具启用/禁用偏好
- ⚡️ **节省时间**: 无需重启客户端并重新配置一切
**何时使用:**
- 修改了你的 MCP 服务器实现之后
- 更新了 JSON 文件中的服务器配置时
- 更改了 Claude 的 MCP 配置之后
- 调试期间,确保你测试的是最新的服务器版本
只需在聊天界面输入 `/reload-servers` 或 `/rs`,客户端就会:
1. 断开与当前所有 MCP 服务器的连接
2. 使用相同的参数重新连接(通过 `ollmcp mcp add` 添加的服务器、服务器路径、配置文件、`--claude-desktop`)
3. 恢复你之前的工具启用/禁用设置
4. 显示更新后的服务器和工具状态
这一功能极大地改善了构建和测试 MCP 服务器的开发体验。
### Human-in-the-Loop (HIL) 工具执行
Human-in-the-Loop 功能提供了额外的安全层,让你可以在工具执行前审查并批准。它在以下场景特别有用:
- 🛡️ **安全**: 在执行前审查可能具有破坏性的操作
- 🔍 **学习**: 了解模型想使用哪些工具以及原因
- 🎯 **控制**: 只选择性执行你批准的工具
- 🚫 **防护**: 阻止不需要的工具调用执行
- 🔄 **会话模式**: 为当前查询会话自动批准所有工具
- 🛑 **查询中止**: 中止整个查询且不保存到历史记录
#### HIL 确认界面
启用 HIL 后,每次工具执行前都会看到确认提示:
**示例:**

#### HIL 确认选项
出现提示时,你可以从以下选项中选择:
- **y/yes**: 执行这一次工具调用
- **n/no**: 跳过这次工具调用并继续查询
- **s/session**: 执行这次以及当前查询后续所有的工具调用,不再逐一提示
- **d/disable**: 永久禁用 HIL 确认(可用 `/hil` 命令重新启用)
- **a/abort**: 立即中止整个查询,不保存到历史记录
> [!TIP]
> 当模型需要按顺序执行多个工具时,**session** 选项特别有用。你可以为当前查询会话批准所有工具,而不必逐一确认;HIL 会在下一次查询时自动重置。
#### Human-in-the-Loop (HIL) 配置
- **默认状态**: 出于安全考虑,HIL 确认默认启用
- **切换命令**: 使用 `/human-in-the-loop` 或 `/hil` 开启/关闭
- **持久化设置**: HIL 偏好会随配置保存
- **快速禁用**: 在任意确认时选择 "disable" 即可永久关闭
- **会话自动批准**: 在确认时使用 "session" 为当前查询批准所有工具
- **查询中止**: 在确认时使用 "abort" 立即停止查询且不保存
- **重新启用**: 随时使用 `/hil` 命令重新开启确认
**优势:**
- **更高安全性**: 防止意外或不需要的工具执行
- **知情**: 了解模型试图执行哪些操作
- **选择性控制**: 逐个决定允许哪些操作
- **灵活工作流**: 会话模式高效处理多工具查询,敏感操作可逐一批准
- **干净中止**: 立即停止有问题的查询,不污染对话历史
- **安心**: 对自动化操作拥有完全的可见性和控制权
### 性能指标
性能指标功能会在每次查询后在带边框的面板中显示详细的模型性能数据。这些指标直接来自 Ollama 的响应,包括耗时、token 数量和生成速率。
**显示的指标:**
- `total duration`: 生成完整响应的总耗时(秒)
- `load duration`: 加载模型的耗时(毫秒)
- `prompt eval count`: 输入提示词中的 token 数量
- `prompt eval duration`: 评估输入提示词的耗时(毫秒)
- `eval count`: 响应中生成的 token 数量
- `eval duration`: 生成响应 token 的耗时(秒)
- `prompt eval rate`: 输入提示词的处理速度(token/秒)
- `eval rate`: 响应 token 的生成速度(token/秒)
**示例:**

#### 性能指标配置
- **默认状态**: 指标默认关闭,以获得更简洁的输出
- **切换命令**: 使用 `/show-metrics` 或 `/sm` 启用/禁用指标显示
- **持久化设置**: 指标偏好会随配置保存
**优势:**
- **性能监控**: 跟踪模型效率和响应时间
- **Token 跟踪**: 监控实际的 token 消耗以便分析
- **基准测试**: 比较不同模型之间的性能
> [!NOTE]
> **数据来源**: 所有指标均直接来自 Ollama 的响应,确保准确可靠。
### 历史记录管理
历史记录管理功能让你查看、导出和导入对话历史。它适用于:
- 📜 **完整历史查看**: 回顾当前会话的所有对话
- 💾 **导出**: 将对话保存为 JSON 文件以备份或分析
- 📥 **导入**: 加载以前的对话历史,从上次中断处继续
- 🔄 **可移植性**: 在会话之间共享或转移对话
#### 历史记录命令
**查看完整历史:**
```
/full-history # or '/fh'
```
以格式化视图显示当前会话的全部对话历史,包括查询和响应。
**导出历史:**
```
/export-history # or '/eh'
```
将当前聊天历史导出为 JSON 文件。你可以指定自定义文件名,或使用基于时间戳的默认名称(例如 `ollmcp_chat_history_2026-01-05_143022.json`)。文件保存在 `~/.config/ollmcp/history/` 目录中。该命令包含文件覆盖保护。
**导入历史:**
```
/import-history # or '/ih'
```
从 JSON 文件导入之前导出的聊天历史。命令会验证 JSON 结构以确保兼容性。导入的历史会添加到当前对话上下文中。
**历史存储:**
- 导出位置: `~/.config/ollmcp/history/`
- 默认文件名格式: `ollmcp_chat_history_YYYY-MM-DD_HHMMSS.json`
- JSON 格式包含查询和响应,并进行正确的结构验证
**优势:**
- **会话连续性**: 跨会话恢复对话
- **备份**: 保留重要对话的记录
- **分析**: 导出历史用于外部分析或审查
- **共享**: 与团队成员分享对话上下文
- **测试**: 导入测试对话用于开发和调试
> [!TIP]
> 导出时如果不提供文件名,系统会自动生成带时间戳的文件名,以防止意外覆盖。
## 自动补全与提示符功能
### Typer shell 自动补全
- CLI 通过 Typer 支持所有选项和参数的 shell 自动补全
- 要启用,运行 `ollmcp --install-completion` 并按照你的 shell 对应的说明操作
- 享受所有分组选项和通用选项的 Tab 补全
### FZF 风格自动补全
- 命令和提示词的斜杠命名空间自动补全(`/`)
- 菜单中显示命令说明
- 匹配不区分大小写,使用更方便
- 集中管理的命令列表保证一致性
- 纯文本查询输入有意不受操作自动补全的干扰
### MCP 提示词自动补全
- 输入 `/` 触发提示词自动补全
- 对提示词名称和描述进行模糊匹配
- 支持带限定名的提示词引用,如 `/server:prompt_name`
- 在菜单中显示提示词描述
- 提示词参数在调用时收集(不在自动补全行中显示)
- 描述截断会适配终端宽度
### 上下文提示符
聊天提示符让你一眼就能看到清晰的上下文信息:
- **模型**: 显示当前使用的 Ollama 模型
- **思考模式**: 指示"思考模式"是否激活(对支持的模型)
- **工具**: 显示已启用工具的数量
**提示符示例:**
```
qwen3/show-thinking/12-tools❯
```
- `qwen3` 模型名称
- `/show-thinking` 思考模式指示(启用时显示,否则为 `/thinking` 或省略)
- `/12-tools` 已启用工具的数量(单数时为 `/1-tool`)
- `❯` 提示符符号
这让你在输入查询前就能轻松了解当前上下文。
> [!TIP]
> 在提示符后输入 `/` 可查看可用 MCP 提示词的自动补全建议。
## 配置管理
> [!TIP]
> 不带标志运行 `ollmcp` 时,如果 `~/.config/ollmcp/config.json` 存在,会自动加载默认配置。
客户端会在会话之间保存和加载你的偏好:
- 使用 `/save-config` 时,你可以为配置命名或使用默认名称
- 配置存储在 `~/.config/ollmcp/` 目录中
- 默认配置保存为 `~/.config/ollmcp/config.json`
- 命名配置保存为 `~/.config/ollmcp/{name}.json`
### 按提供商的配置档案
连接设置**按提供商**存储,因此切换提供商时绝不会复用其他提供商的模型、主机或 API key。每个提供商各自保留:
- 选择的**模型**
- **主机** / API 基础 URL
- **API key**
配置还会记录一个 `defaultProvider`。当你不带 `--provider` 标志运行 `ollmcp` 时,会加载该提供商的档案;全新安装从 `ollama` 开始。每次执行 `/save-config` 时,你当前使用的提供商*会成为新的默认值*,因此直接运行 `ollmcp` 会从你上次停下的地方继续。随时可以传递 `--provider ` 切换到(并加载)另一个提供商的档案,`--model` / `--host` / `--api-key` 会在该次运行中覆盖已保存的值。
> [!NOTE]
> 只有通过 `--api-key` 传入的 key 会以明文形式存储在 `~/.config/ollmcp/config.json` 中。通过环境变量 `$OLLMCP_API_KEY` 或提供商原生环境变量(例如 `OPENROUTER_API_KEY`)提供的 key **永远不会**写入磁盘;如果不想让 key 被持久化,请使用其中之一。
以下设置在所有提供商之间**共享**:
- 高级模型参数(系统提示词、温度、采样设置等)
- 所有工具的启用/禁用状态
- 上下文保留设置
- 思考模式设置
- 回答显示模式偏好
- 工具执行显示偏好
- 性能指标显示偏好
- Human-in-the-Loop 确认设置
**`~/.config/ollmcp/config.json` 示例:**
```json
{
"defaultProvider": "openai",
"providers": {
"ollama": { "host": "http://localhost:11434", "model": "qwen3:1.7b", "apiKey": "" },
"openai": { "host": "", "model": "gpt-5.5", "apiKey": "sk-..." }
},
"enabledTools": {},
"modelConfig": {},
"...": "shared settings"
}
```
> [!TIP]
> 旧的扁平格式配置文件(顶层包含 `host`/`model`/`provider`/`apiKey`)会在你首次运行此版本时自动迁移,并在下次 `/save-config` 时以按提供商的格式重写。
## 服务器配置格式
JSON 配置文件支持 STDIO、SSE 和 Streamable HTTP 服务器类型(MCP 1.10.1):
```json
{
"mcpServers": {
"stdio-server": {
"command": "command-to-run",
"args": ["arg1", "arg2", "..."],
"env": {
"ENV_VAR1": "value1",
"ENV_VAR2": "value2"
},
"disabled": false
},
"sse-server": {
"type": "sse",
"url": "http://localhost:8000/sse",
"headers": {
"Authorization": "Bearer your-token-here"
},
"disabled": true
},
"http-server": {
"type": "streamable_http",
"url": "http://localhost:8000/mcp",
"headers": {
"X-API-Key": "your-api-key-here"
},
"disabled": false
}
}
}
```
> [!NOTE]
> **MCP 1.10.1 传输支持**: 客户端现已支持最新的 Streamable HTTP 传输,性能和可靠性更佳。如果你指定的 URL 没有类型,客户端将默认使用 Streamable HTTP 传输。
### 小贴士: MCP 服务器配置文件的存放位置及可用示例
一个常见的困惑点是 MCP 服务器配置文件应存放在哪里,以及 TUI 的保存/加载功能如何使用。这里有一份简短实用的指南,已帮助过其他用户:
- TUI 的 `/save-config` / `/load-config`(或 `/sc` / `/lc`)命令旨在保存 *TUI 偏好*,比如你启用了哪些工具、选择的模型、思考模式、显示模式和其他客户端设置。它们不是向客户端注册 MCP 服务器连接所必需的。
- 对于 MCP 服务器 JSON 文件(上面展示的 `mcpServers` 对象),我们建议将它们放在 TUI 配置目录之外,或放在一个清晰的子文件夹中,例如:
```
~/.config/ollmcp/mcp-servers/config.json
```
然后你可以在启动时用 `-j` / `--servers-json` 将 `ollmcp` 指向该文件。
> [!IMPORTANT]
> 对于基于 HTTP 的 MCP 服务器,`"type": "http"`、`"streamable-http"` 和 `"streamable_http"` 均可接受且处理方式相同。也请查看下方的[常见的 MCP 端点路径](#常见的-mcp-端点路径)一节了解典型端点。
这是一个最小可用示例;假设这是你的 `~/.config/ollmcp/mcp-servers/config.json`:
```json
{
"mcpServers": {
"github": {
"type": "streamable_http",
"url": "https://api.githubcopilot.com/mcp/",
"headers": {
"Authorization": "Bearer mytoken"
}
}
}
}
```
> [!TIP]
> 使用 GitHub MCP 服务器时,请确保将 `"mytoken"` 替换为你真实的 GitHub API token。
有了这个文件,你就可以这样连接:
```
ollmcp -j ~/.config/ollmcp/mcp-servers/config.json
```
这里有一个与此常见问题相关的 GitHub issue: https://github.com/jonigl/mcp-client-for-ollama/issues/112#issuecomment-3446569030
#### 演示
一个简短的演示(asciicast),可以帮助任何人快速复现可用的配置。此示例使用了一个[基于 streamable HTTP 协议的 MCP 服务器示例](https://github.com/jonigl/mcp-server-with-streamable-http-example):
[](https://asciinema.org/a/751387)
#### 常见的 MCP 端点路径
Streamable HTTP MCP 服务器通常在 `/mcp` 暴露 MCP 端点(例如 `https://host/mcp`),而 SSE 服务器通常使用 `/sse`(例如 `https://host/sse`)。以下摘自 MCP 规范(2025-06-18):
> The server MUST provide a single HTTP endpoint path (hereafter referred to as the MCP endpoint) that supports both POST and GET methods. For example, this could be a URL like https://example.com/mcp.
更多详情见 [MCP 规范 2025-06-18 版 - Transports](https://modelcontextprotocol.io/specification/2025-06-18/basic/transports)。
> [!NOTE]
> 远程 MCP 服务器的 HTTPS 证书是根据**操作系统信任库**验证的,而不是 `certifi` 证书包。如果 MCP 服务器位于私有或企业 CA 之后,或者你在没有系统 CA 库的精简容器中运行 ollmcp,TLS 握手会失败,且错误信息不会提及 ollmcp。将 `SSL_CERT_FILE`(证书包文件)或 `SSL_CERT_DIR`(目录)指向你的 CA 即可解决:
>
> ```bash
> export SSL_CERT_FILE=/path/to/corporate-ca.pem
> ```
## 兼容的模型
以下 Ollama 模型在工具使用方面表现良好:
- gemma4
- qwen3.5
- lfm2.5-thinking
- llama3.2
- mistral
如需具备工具使用能力的 Ollama 模型完整列表,请访问 [Ollama 官方模型页面](https://ollama.com/search?c=tools)。
如需还能处理工具返回图像的模型,请参见 [Ollama 视觉模型页面](https://ollama.com/search?c=vision)。
### Ollama Cloud 模型
MCP Client for Ollama 现已支持 [Ollama Cloud 模型](https://github.com/ollama/ollama/blob/main/docs/cloud.md),让你在利用本地 MCP 工具的同时,使用具备工具调用能力的强大云端模型。云端模型无需强大的本地 GPU 即可运行,使你能够访问个人电脑装不下的更大模型。
**支持的 Ollama Cloud 模型例如:**
- `gpt-oss:20b-cloud`
- `gpt-oss:120b-cloud`
- `deepseek-v3.1:671b-cloud`
- `qwen3-coder:480b-cloud`
**在此客户端中使用 Ollama Cloud 模型:**
1. 首先,拉取云端模型:
```bash
ollama pull gpt-oss:120b-cloud
```
2. 使用你选择的云端模型运行客户端:
```bash
ollmcp --model gpt-oss:120b-cloud
```
> [!NOTE]
> 模型 `deepseek-v3.1:671b-cloud` 仅在思考模式关闭时支持工具使用。你可以在 `ollmcp` 中输入 `/thinking-mode` 或 `/tm` 来切换思考模式。
关于 Ollama Cloud 的更多信息,请访问 [Ollama Cloud 文档](https://docs.ollama.com/cloud)。
## 赞助商
本项目得到以下赞助商的支持:
### Atlas Cloud
[Atlas Cloud](https://www.atlascloud.ai/?utm_source=github&utm_medium=link&utm_campaign=mcp-client-for-ollama) 是一个全模态 AI 推理平台 — 单一 AI API 即可统一访问 300+ 精选模型,覆盖视频、图像和 LLM 场景。
它与 ollmcp 开箱即用:
```bash
ollmcp --provider atlascloud --api-key YOUR_ATLASCLOUD_API_KEY
# or export the key once and skip the flag:
export ATLASCLOUD_API_KEY=YOUR_ATLASCLOUD_API_KEY
ollmcp --provider atlascloud
```
流式输出和工具调用均受支持,使用交互式 `/model` 命令即可浏览并选择 Atlas Cloud 的任意模型。
### 成为赞助商
想在这里展示你的 logo?欢迎通过 [GitHub Sponsors](https://github.com/sponsors/jonigl) 支持本项目 ❤️
## 在哪里可以找到更多 MCP 服务器?
你可以在官方 [MCP Servers 仓库](https://github.com/modelcontextprotocol/servers)中探索 MCP 服务器合集。
该仓库包含 Model Context Protocol 的参考实现、社区构建的服务器以及增强 LLM 工具能力的其他资源。
## 相关项目
- **[Ollama MCP Bridge](https://github.com/jonigl/ollama-mcp-bridge)** - 一个位于 Ollama 前端的 Python API 层,自动将多个 MCP 服务器的工具添加到每个聊天请求中。该项目提供透明代理方案,在启动时预加载所有 MCP 服务器,并将其工具无缝集成到 Ollama API 中。
- **[MCP Server with Streamable HTTP Example](https://github.com/jonigl/mcp-server-with-streamable-http-example)** - 一个演示 streamable HTTP 协议用法的示例 MCP 服务器。
## 安全
你所连接的 MCP 服务器由你自己信任,而它们的工具/资源响应会被视为到达模型的不可信内容。有关信任模型、间接提示词注入的处理方式以及如何报告漏洞,请参阅 [SECURITY.md](SECURITY.md)。
## 许可证
本项目基于 MIT 许可证授权 - 详情见 [LICENSE](LICENSE) 文件。
## 致谢
- [Ollama](https://ollama.com/) 提供本地 LLM 运行时
- [Model Context Protocol](https://modelcontextprotocol.io/) 提供规范和示例
- [any-llm](https://github.com/mozilla-ai/any-llm/) 提供面向多个 LLM 提供商的统一接口
- [Rich](https://rich.readthedocs.io/) 提供终端用户界面
- [Typer](https://typer.tiangolo.com/) 提供现代 CLI 体验
- [Prompt Toolkit](https://python-prompt-toolkit.readthedocs.io/) 提供交互式命令行界面
- [uv](https://github.com/astral-sh/uv) 提供闪电般快速的 Python 包管理和虚拟环境管理
- [Asciinema](https://asciinema.org/) 提供演示录制
---
由 [jonigl](https://github.com/jonigl) 用 ❤️ 打造
