
LLMxRay
Voyez ce que votre IA locale fait réellement.
Pointez VS Code Copilot, Open WebUI, Continue, n8n ou votre propre agent vers LLMxRay plutôt que vers Ollama, et voyez chaque tour :
ce qui était en cache, ce qui a été relu, ce que le démon a coupé en silence, quel outil a déchargé quel modèle. Pas de cloud. Pas de clé API. Pas de coût.


🌐 English •
Français •
中文 •
العربية •
Srpski
Démarrage rapide •
Ce que vos outils envoient •
Garder et envoyer •
Pour les agents •
Aussi dans la boîte •
À qui ça s'adresse •
Installation •
Compatibilité Ollama •
Changelog
---
## Démarrage rapide
Il vous faut [Ollama](https://ollama.com/download) en marche, avec au moins un modèle téléchargé (`ollama pull llama3.2`). Ensuite :
```bash
npx llmxray
```
Ou avec Docker :
```bash
docker run -p 5174:5174 -p 11435:11435 djovaneli/llmxray
```
Pointez maintenant vos outils vers **http://localhost:11435** plutôt que vers le 11434 d'Ollama : VS Code Copilot, Open WebUI, Continue, n8n, vos propres scripts. Il se comporte exactement comme Ollama et transmet tout. Ouvrez **http://localhost:5174**, allez sur **En direct**, et regardez leurs tours arriver.
Vous voulez juste essayer un modèle ? Ouvrez la page Chat, choisissez-en un, et envoyez un message.
---
## Ce que vos outils envoient vraiment
Votre éditeur, vos agents et vos scripts parlent tous au même Ollama. Ces pages montrent ce que chacun envoie, ce que le démon en fait, et ce que cela coûte aux autres.
### Live : ce que vos autres outils envoient
LLMxRay ouvre un second port, **11435**, qui se comporte exactement comme Ollama et lui transmet tout. Pointez VS Code Copilot, Open WebUI, Continue, n8n ou votre propre script vers `http://localhost:11435` et chaque tour qu'ils envoient apparaît ici : client, modèle, taille de l'invite, part venue du cache, vitesse de préremplissage et de génération, appels d'outils.
```
VS Code Copilot ─┐
Open WebUI ──────┤ ┌─ page Live : chaque tour,
Continue / n8n ──┼─► http://localhost:11435 ─► Ollama ┤ cache réutilisé, préremplissage,
vos scripts ─────┘ (LLMxRay) └─ là où le cache a cassé
```
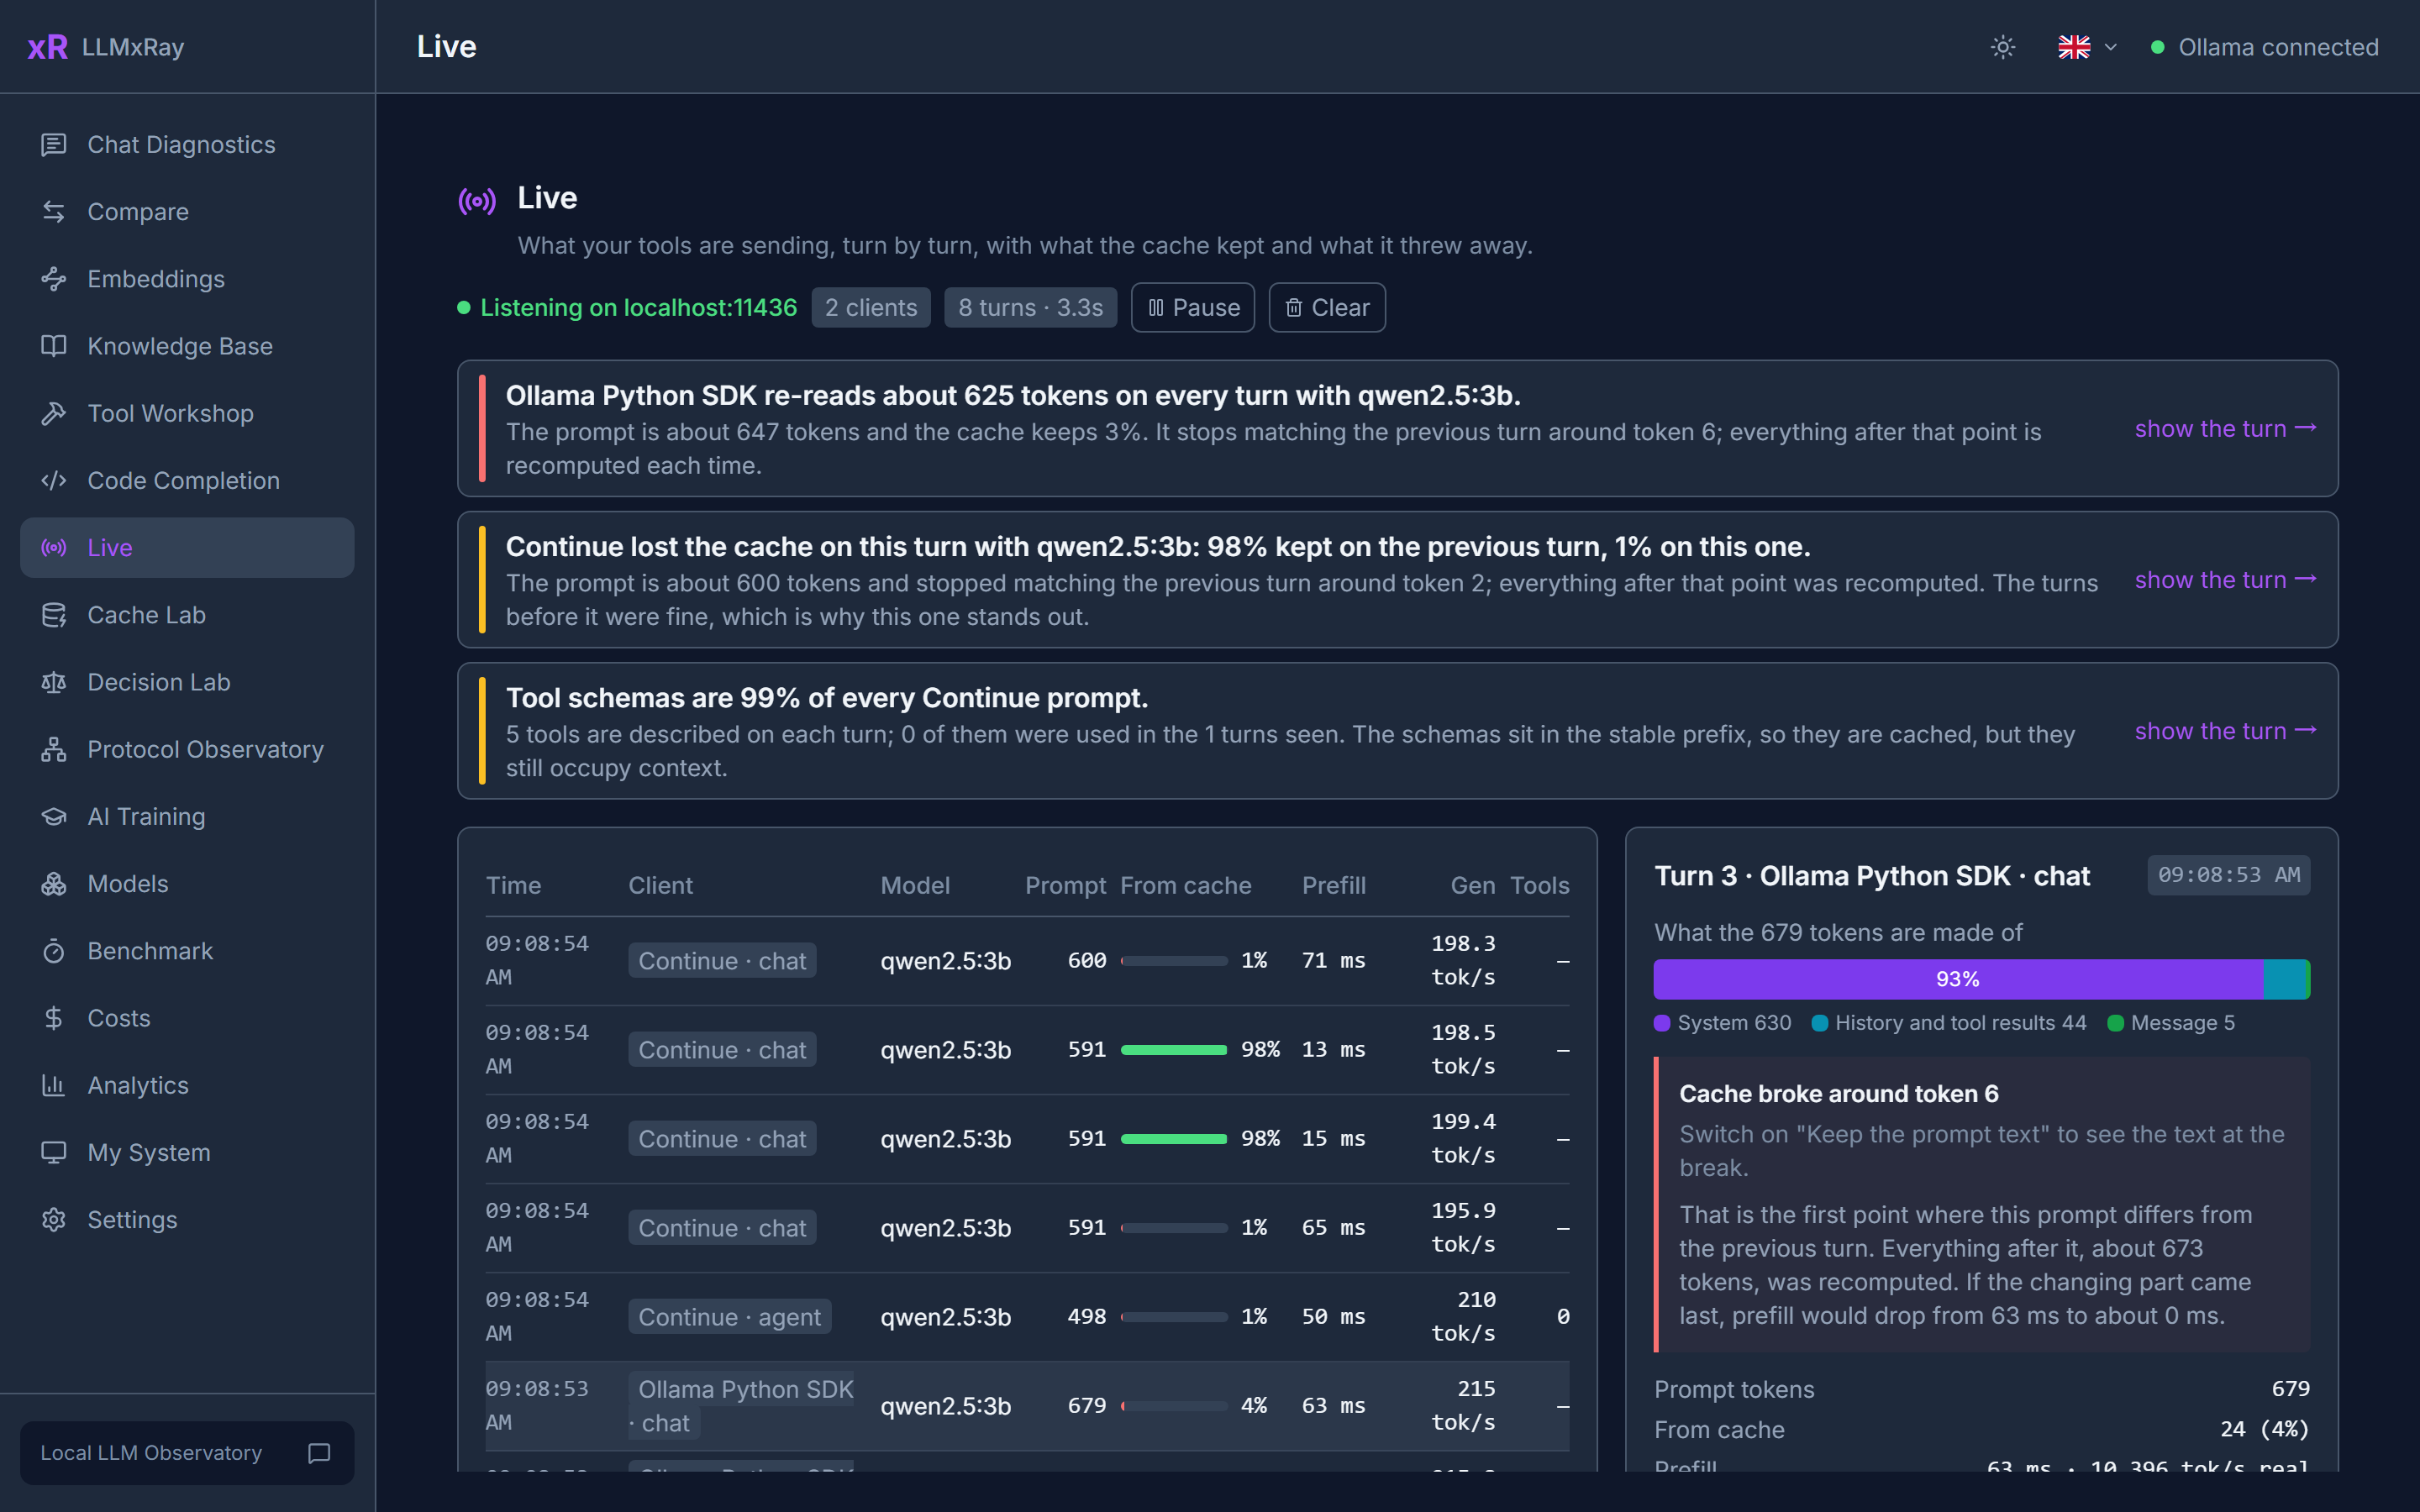
Sélectionnez un tour pour voir de quoi l'invite est faite et le point exact où elle a cessé de correspondre à la précédente, c'est-à-dire là où le cache a cassé. Les constats sont des phrases simples, chacune liée au tour qui la prouve : un client qui relit toute son invite à chaque tour, un modèle qui tourne en partie sur CPU, des schémas d'outils qui occupent 40 % de chaque invite. Seuls les comptes et les durées sont gardés, sur cette machine pendant 30 jours : un redémarrage reprend là où il s'était arrêté. Le texte des invites est une option qui écrit dans un fichier local. Rien ne quitte votre machine, sauf si vous envoyez les tours à votre propre visualiseur de traces.
Par défaut, les deux ports ne répondent qu'à cette machine, car le journal En direct contient ce que vos outils ont envoyé. Lancez `npx llmxray --host 0.0.0.0` pour que d'autres machines de votre réseau les joignent, pour une page En direct sur un second écran ou une machine GPU partagée.
### Radiographie de l'invite : l'invite elle-même, à l'échelle
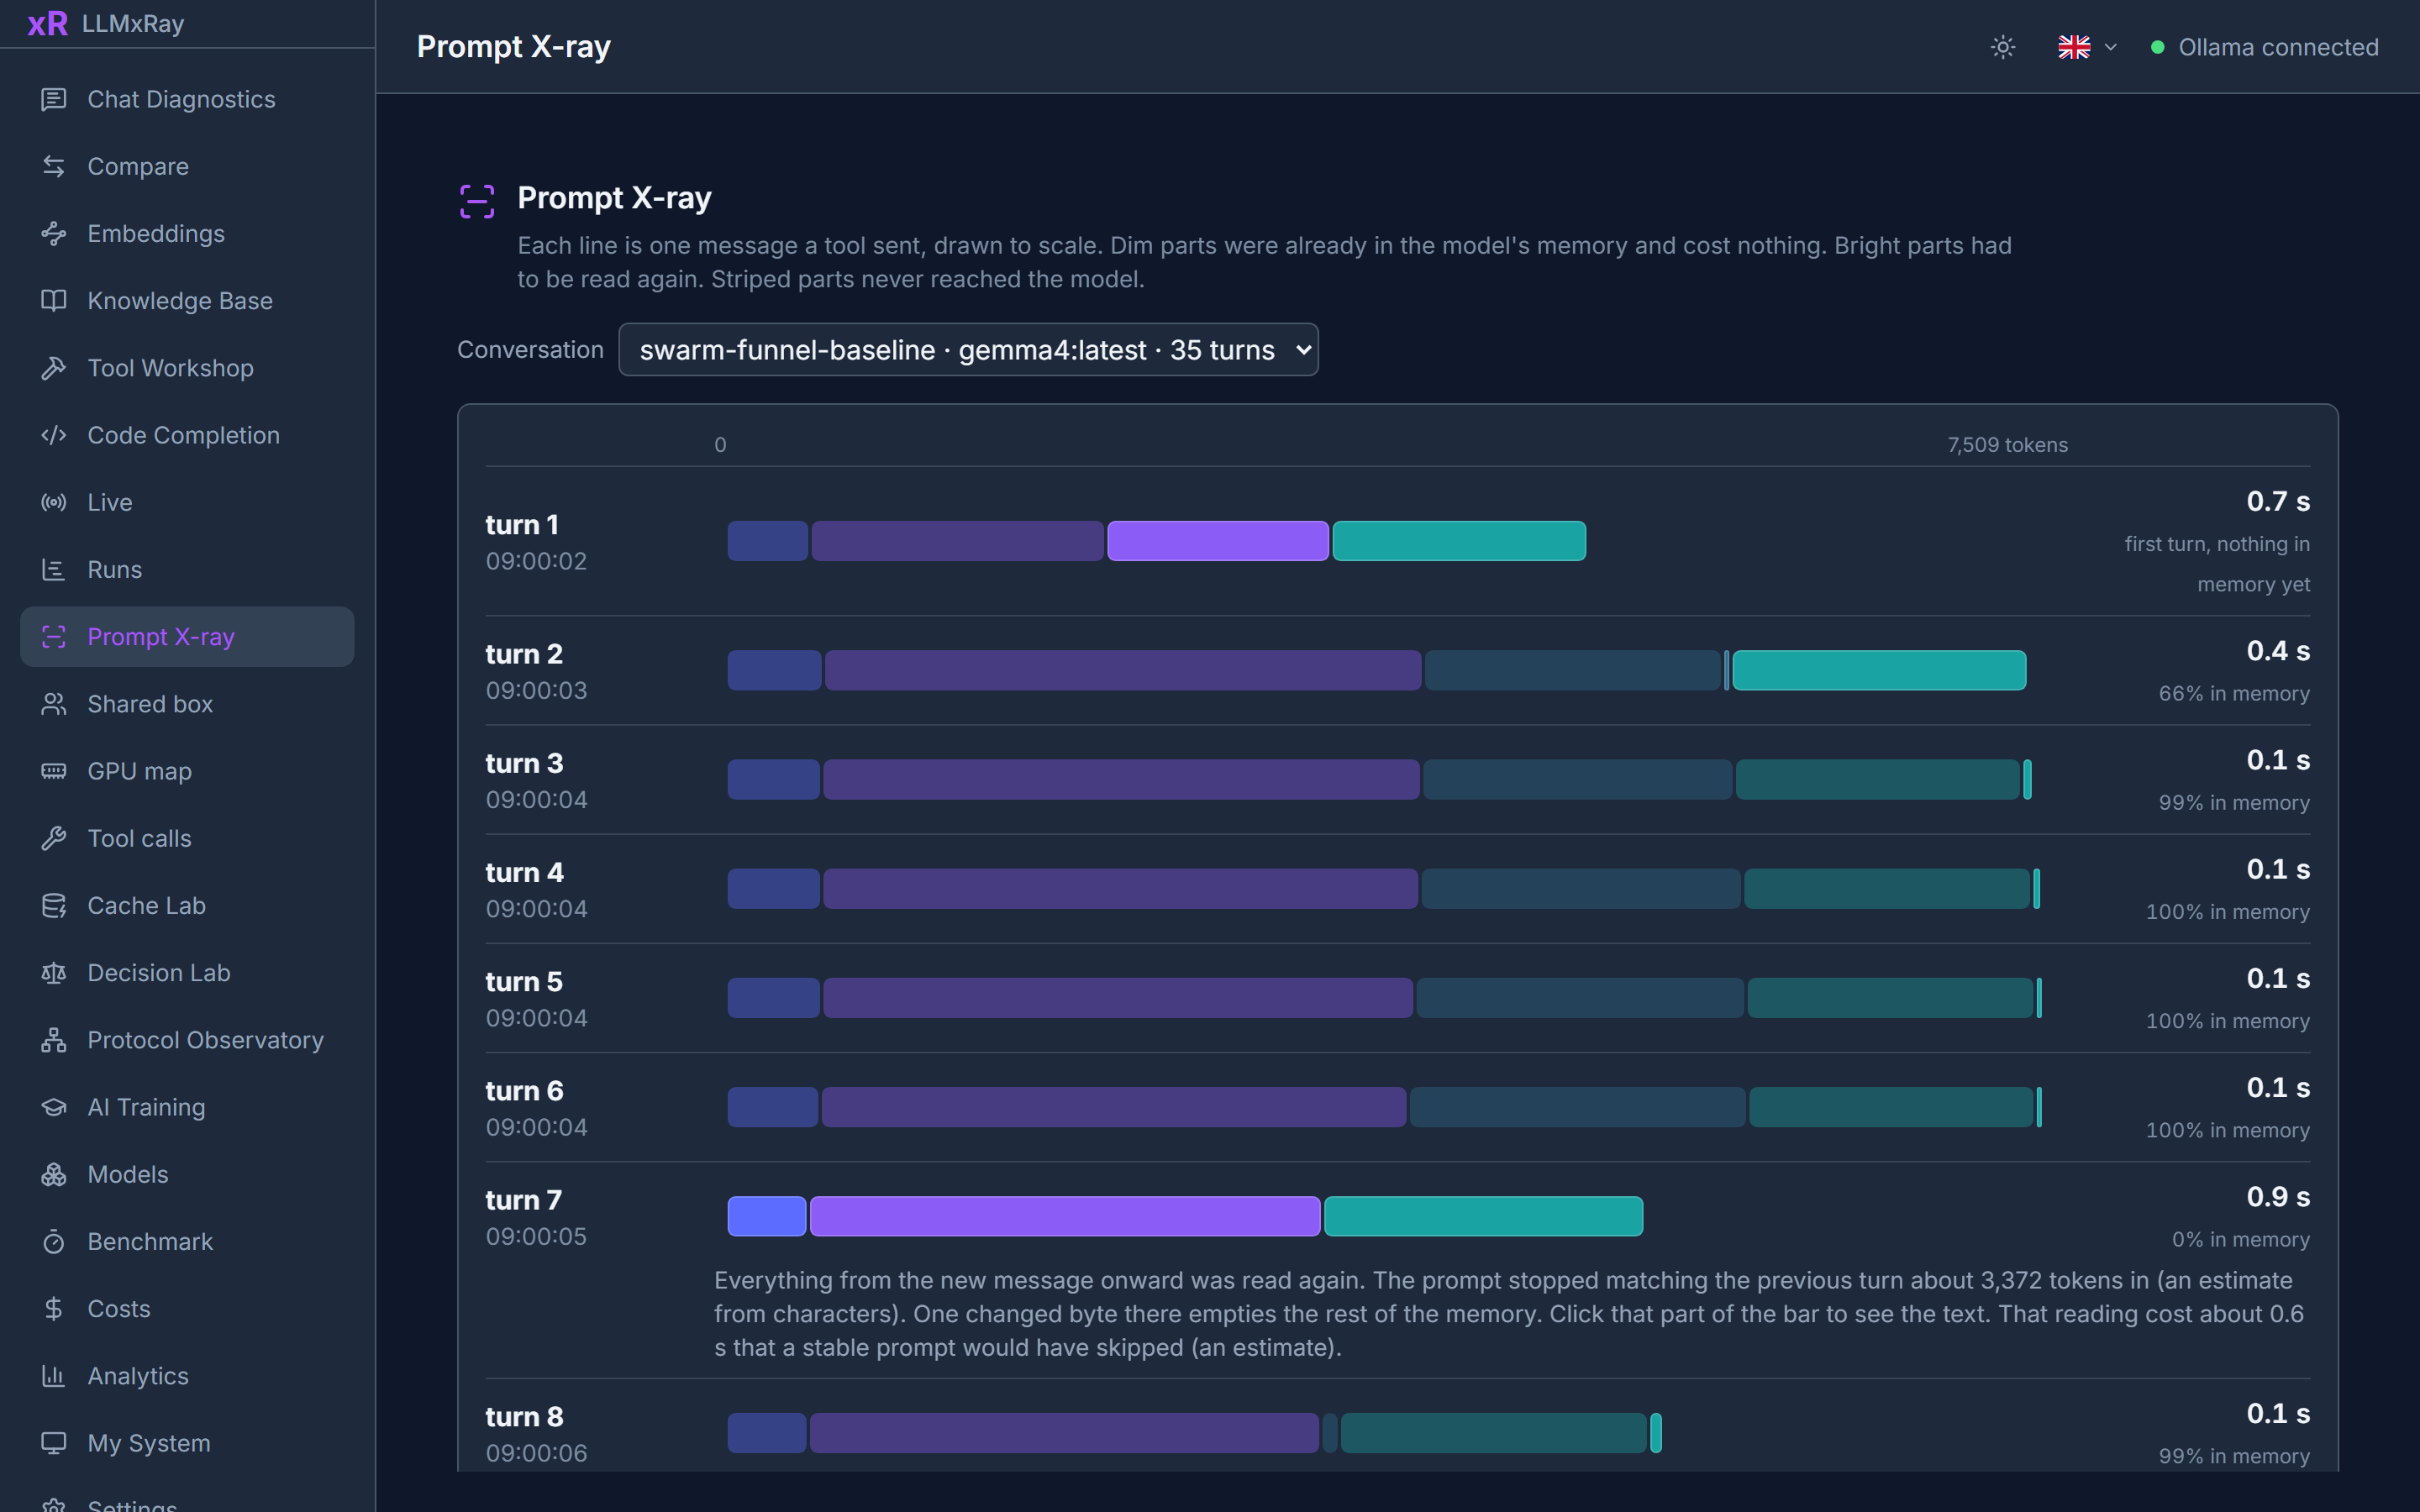
Chaque tour envoyé par votre outil, sous forme de barre. La couleur dit ce qu'était chaque partie de l'invite : invite système, schémas d'outils, tours précédents, nouveau message. La luminosité dit ce qui lui est arrivé : terne, elle était déjà dans la mémoire du modèle et n'a rien coûté ; vive, elle a dû être relue ; hachurée, le démon l'a coupée et ne l'a jamais vue. Empilez les tours d'une conversation et vous voyez le cache grandir, le tour où un horodatage dans l'invite système l'a vidé, et le tour où la conversation a dépassé le contexte : Ollama a jeté en silence les messages les plus anciens et a répondu quand même. Quand l'invite système est trop longue à elle seule, c'est son début qui disparaît. Cliquez sur une partie et la requête s'ouvre à cet endroit du texte.
### Exécutions : le travail d'un outil, de bout en bout
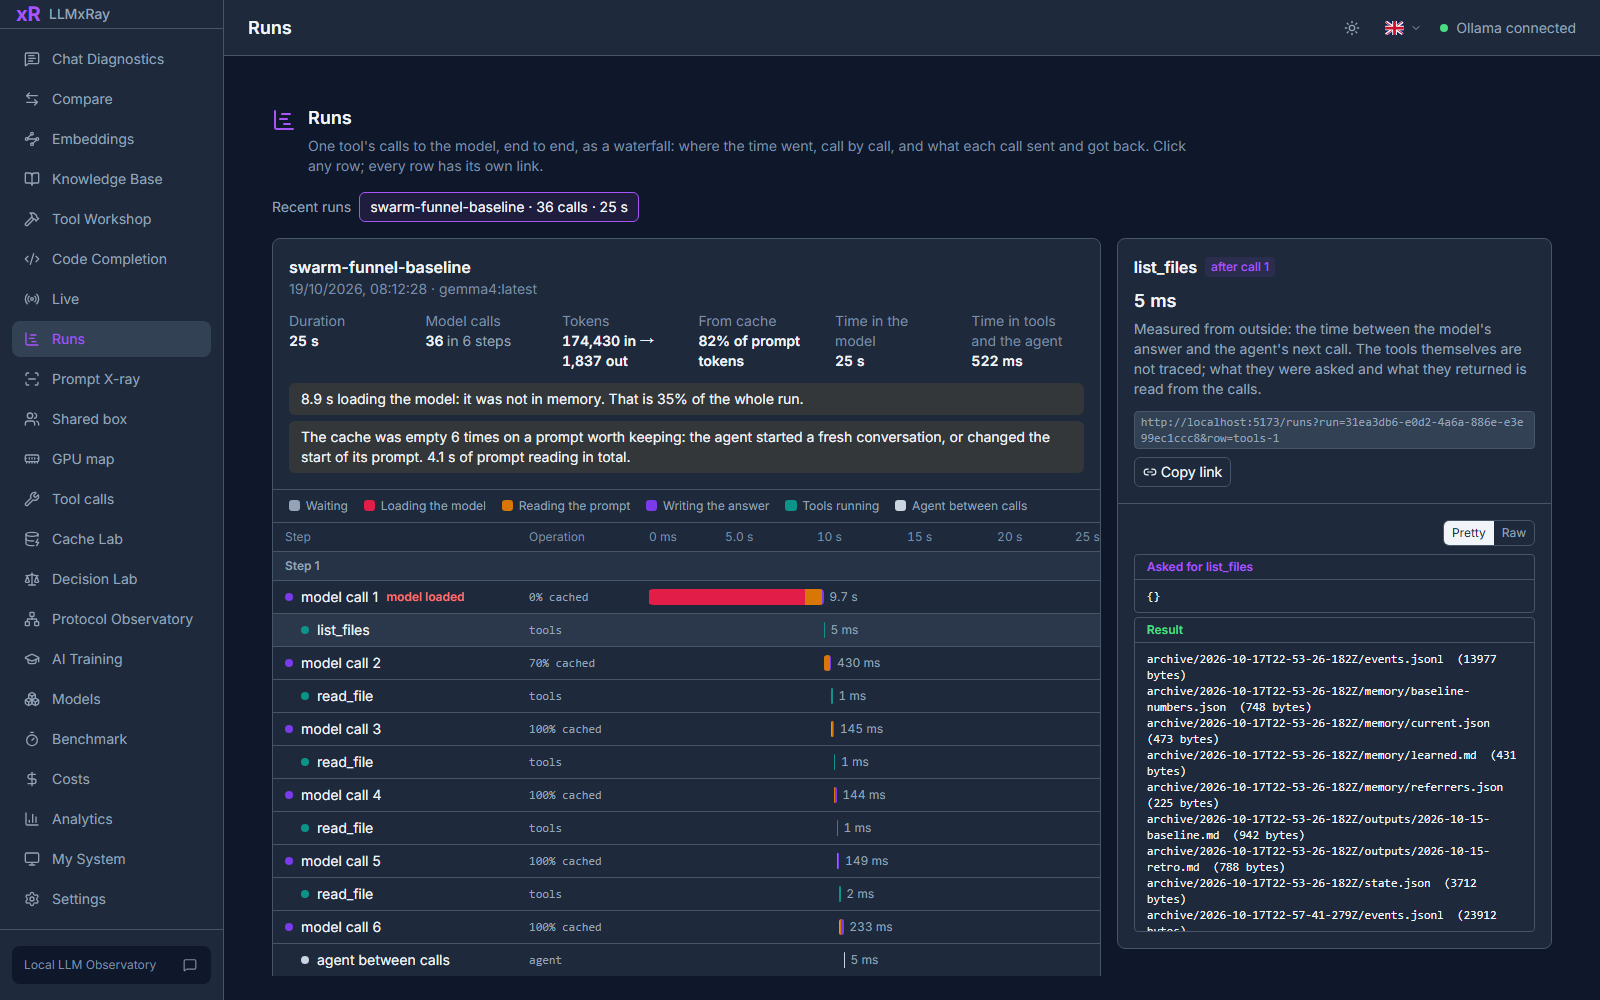
Les appels d'un outil au modèle posés dans le temps, en cascade. Chaque appel est découpé selon ce que rapporte Ollama : attente, chargement du modèle, lecture de l'invite, écriture de la réponse. Entre deux appels, le temps propre de l'outil, nommé d'après les outils demandés par le modèle. Les étapes commencent là où l'outil a entamé une nouvelle conversation : un agent qui jette son cache à chaque étape se voit d'un coup d'œil, tout comme un modèle qui n'était pas en mémoire au début. Cliquez sur une ligne pour voir ce que cet appel a envoyé et reçu, la réflexion du modèle et ses appels d'outils avec leurs arguments, ou ce qu'un outil a reçu et renvoyé. Chaque ligne a son propre lien. Activez *Conserver le texte des invites* sur la page En direct pour voir le texte ; les temps n'ont besoin de rien.
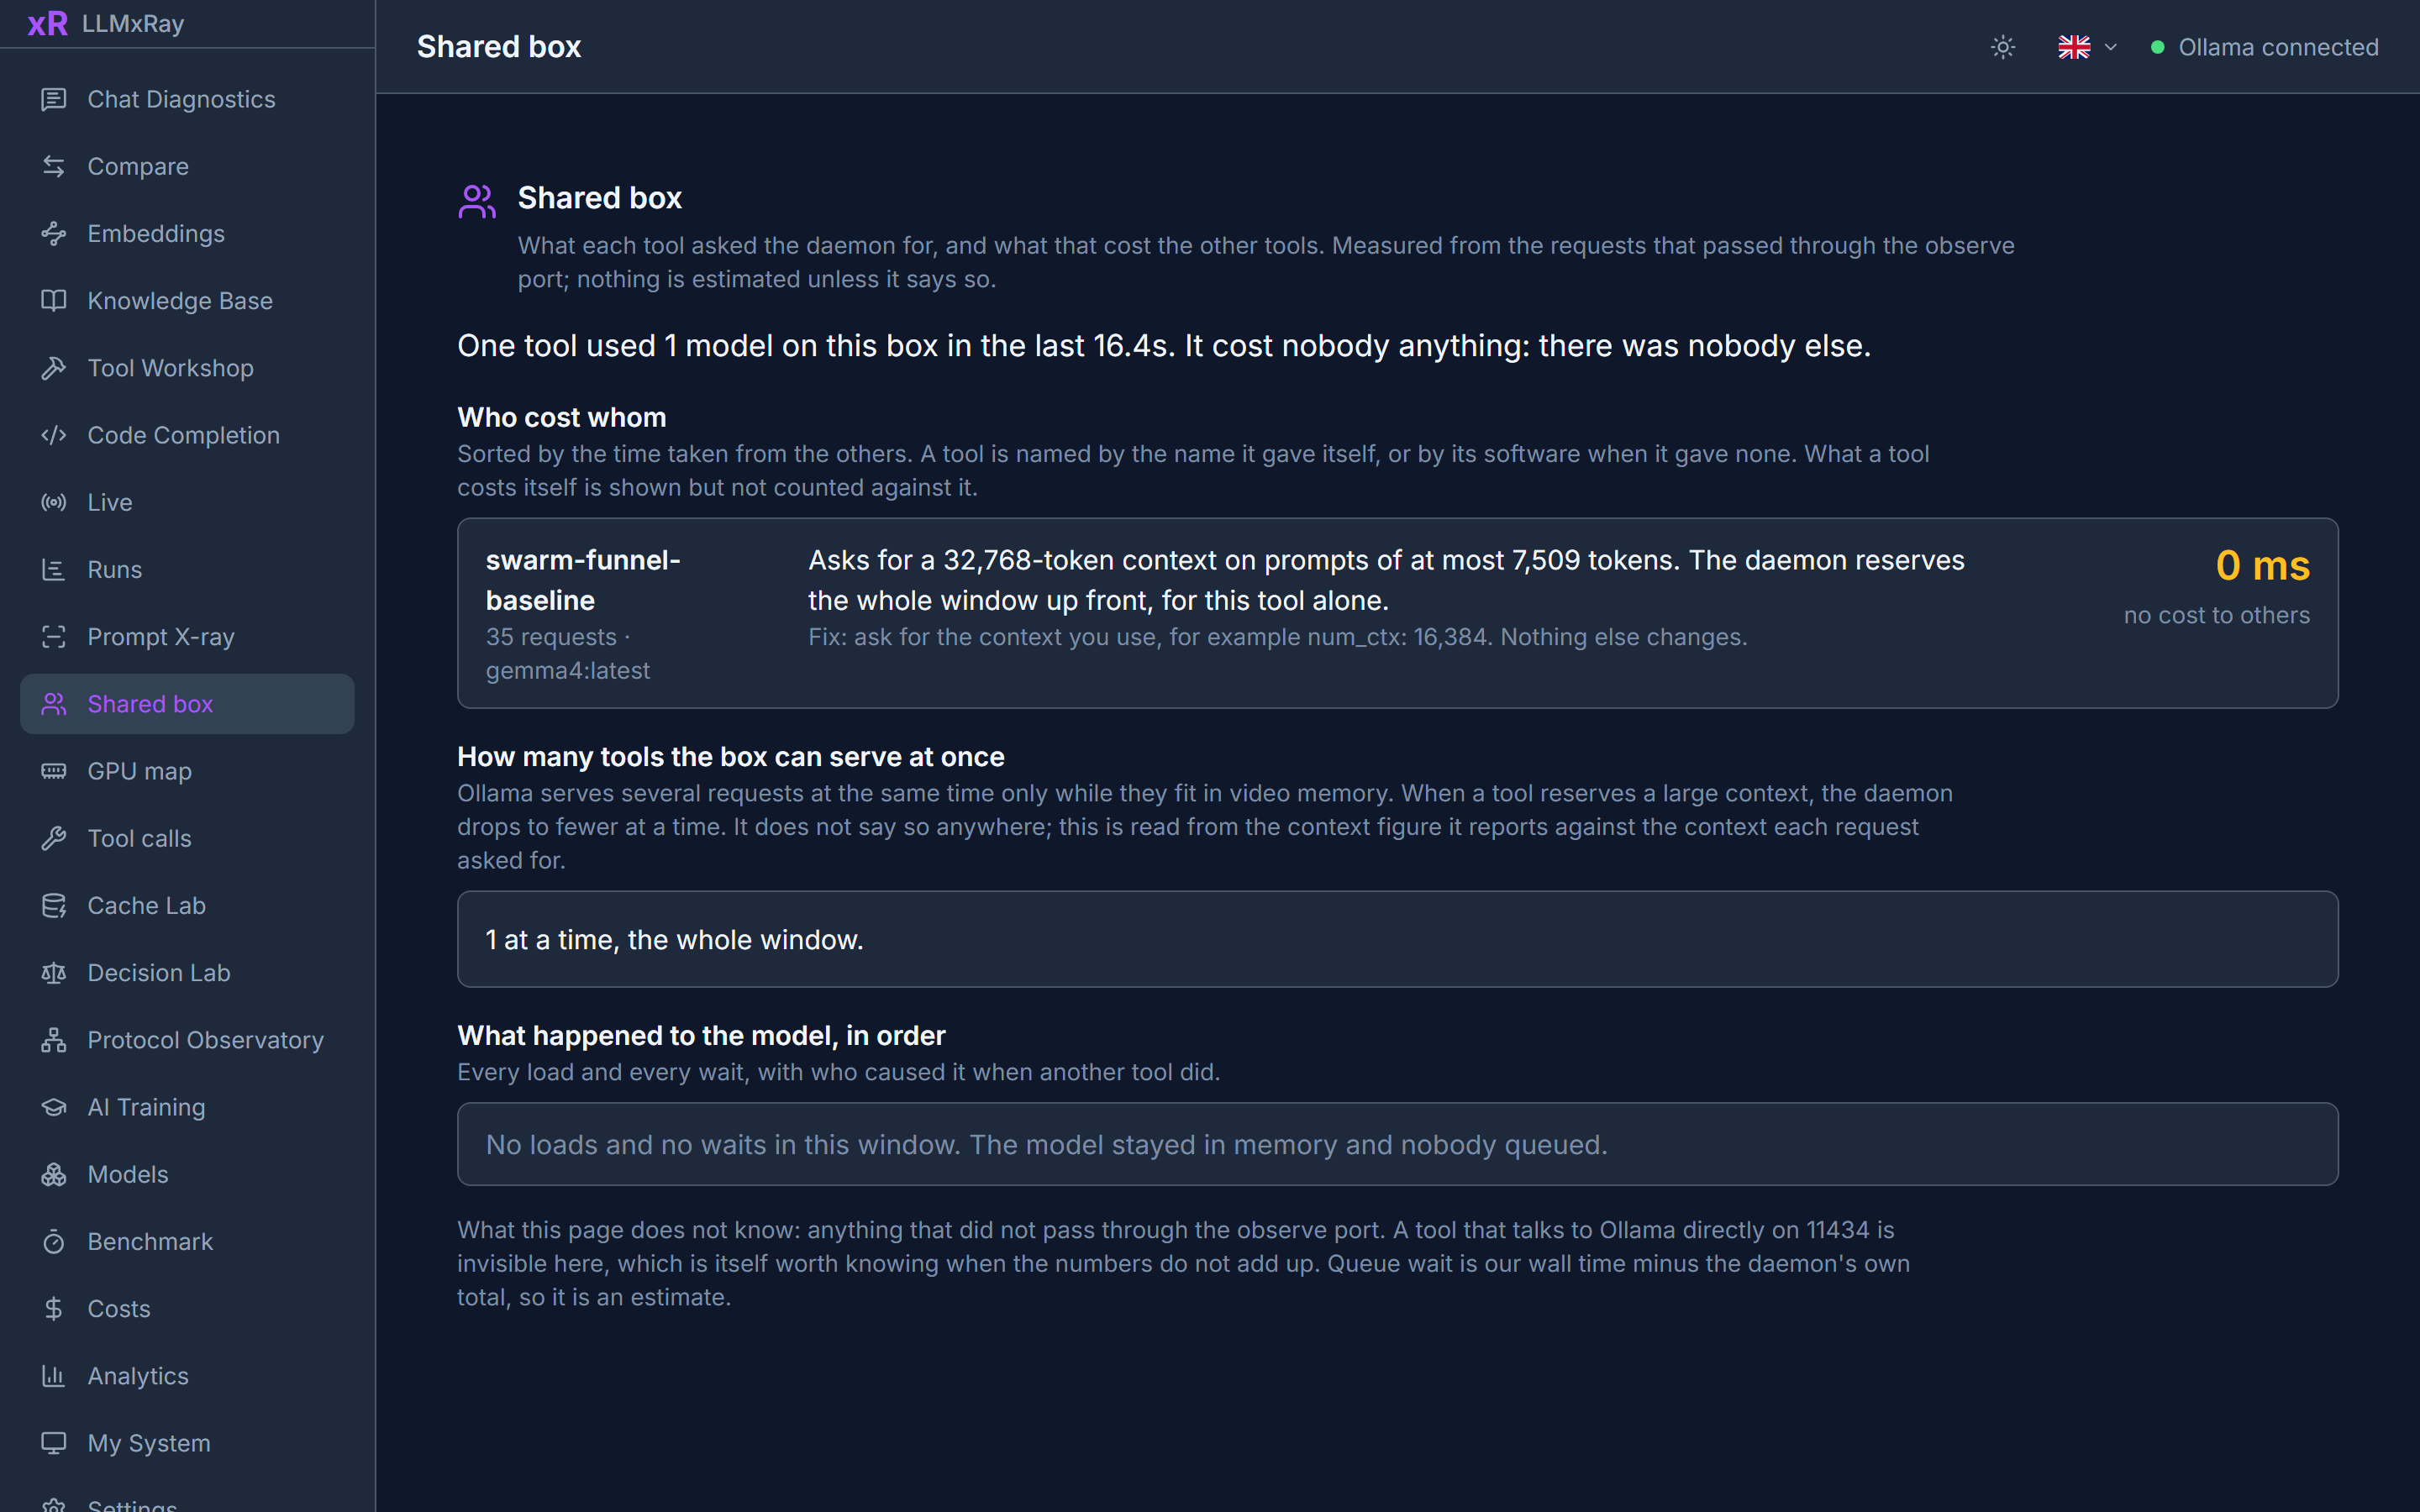
### Machine partagée : pourquoi Ollama est lent en ce moment, et quel outil en est la cause
Une ligne par outil, triée selon ce qu'il a coûté aux autres, en secondes : celui qui envoie `keep_alive: 0` et décharge le modèle après chaque exécution, celui qui demande un contexte de 128K pour des invites de 4K et ramène le démon à une requête à la fois, celui qui a attendu 22 secondes derrière eux. Chacun avec le réglage à changer. Un outil qui n'a rien coûté est listé aussi, pour voir à quoi ressemble le bon comportement.
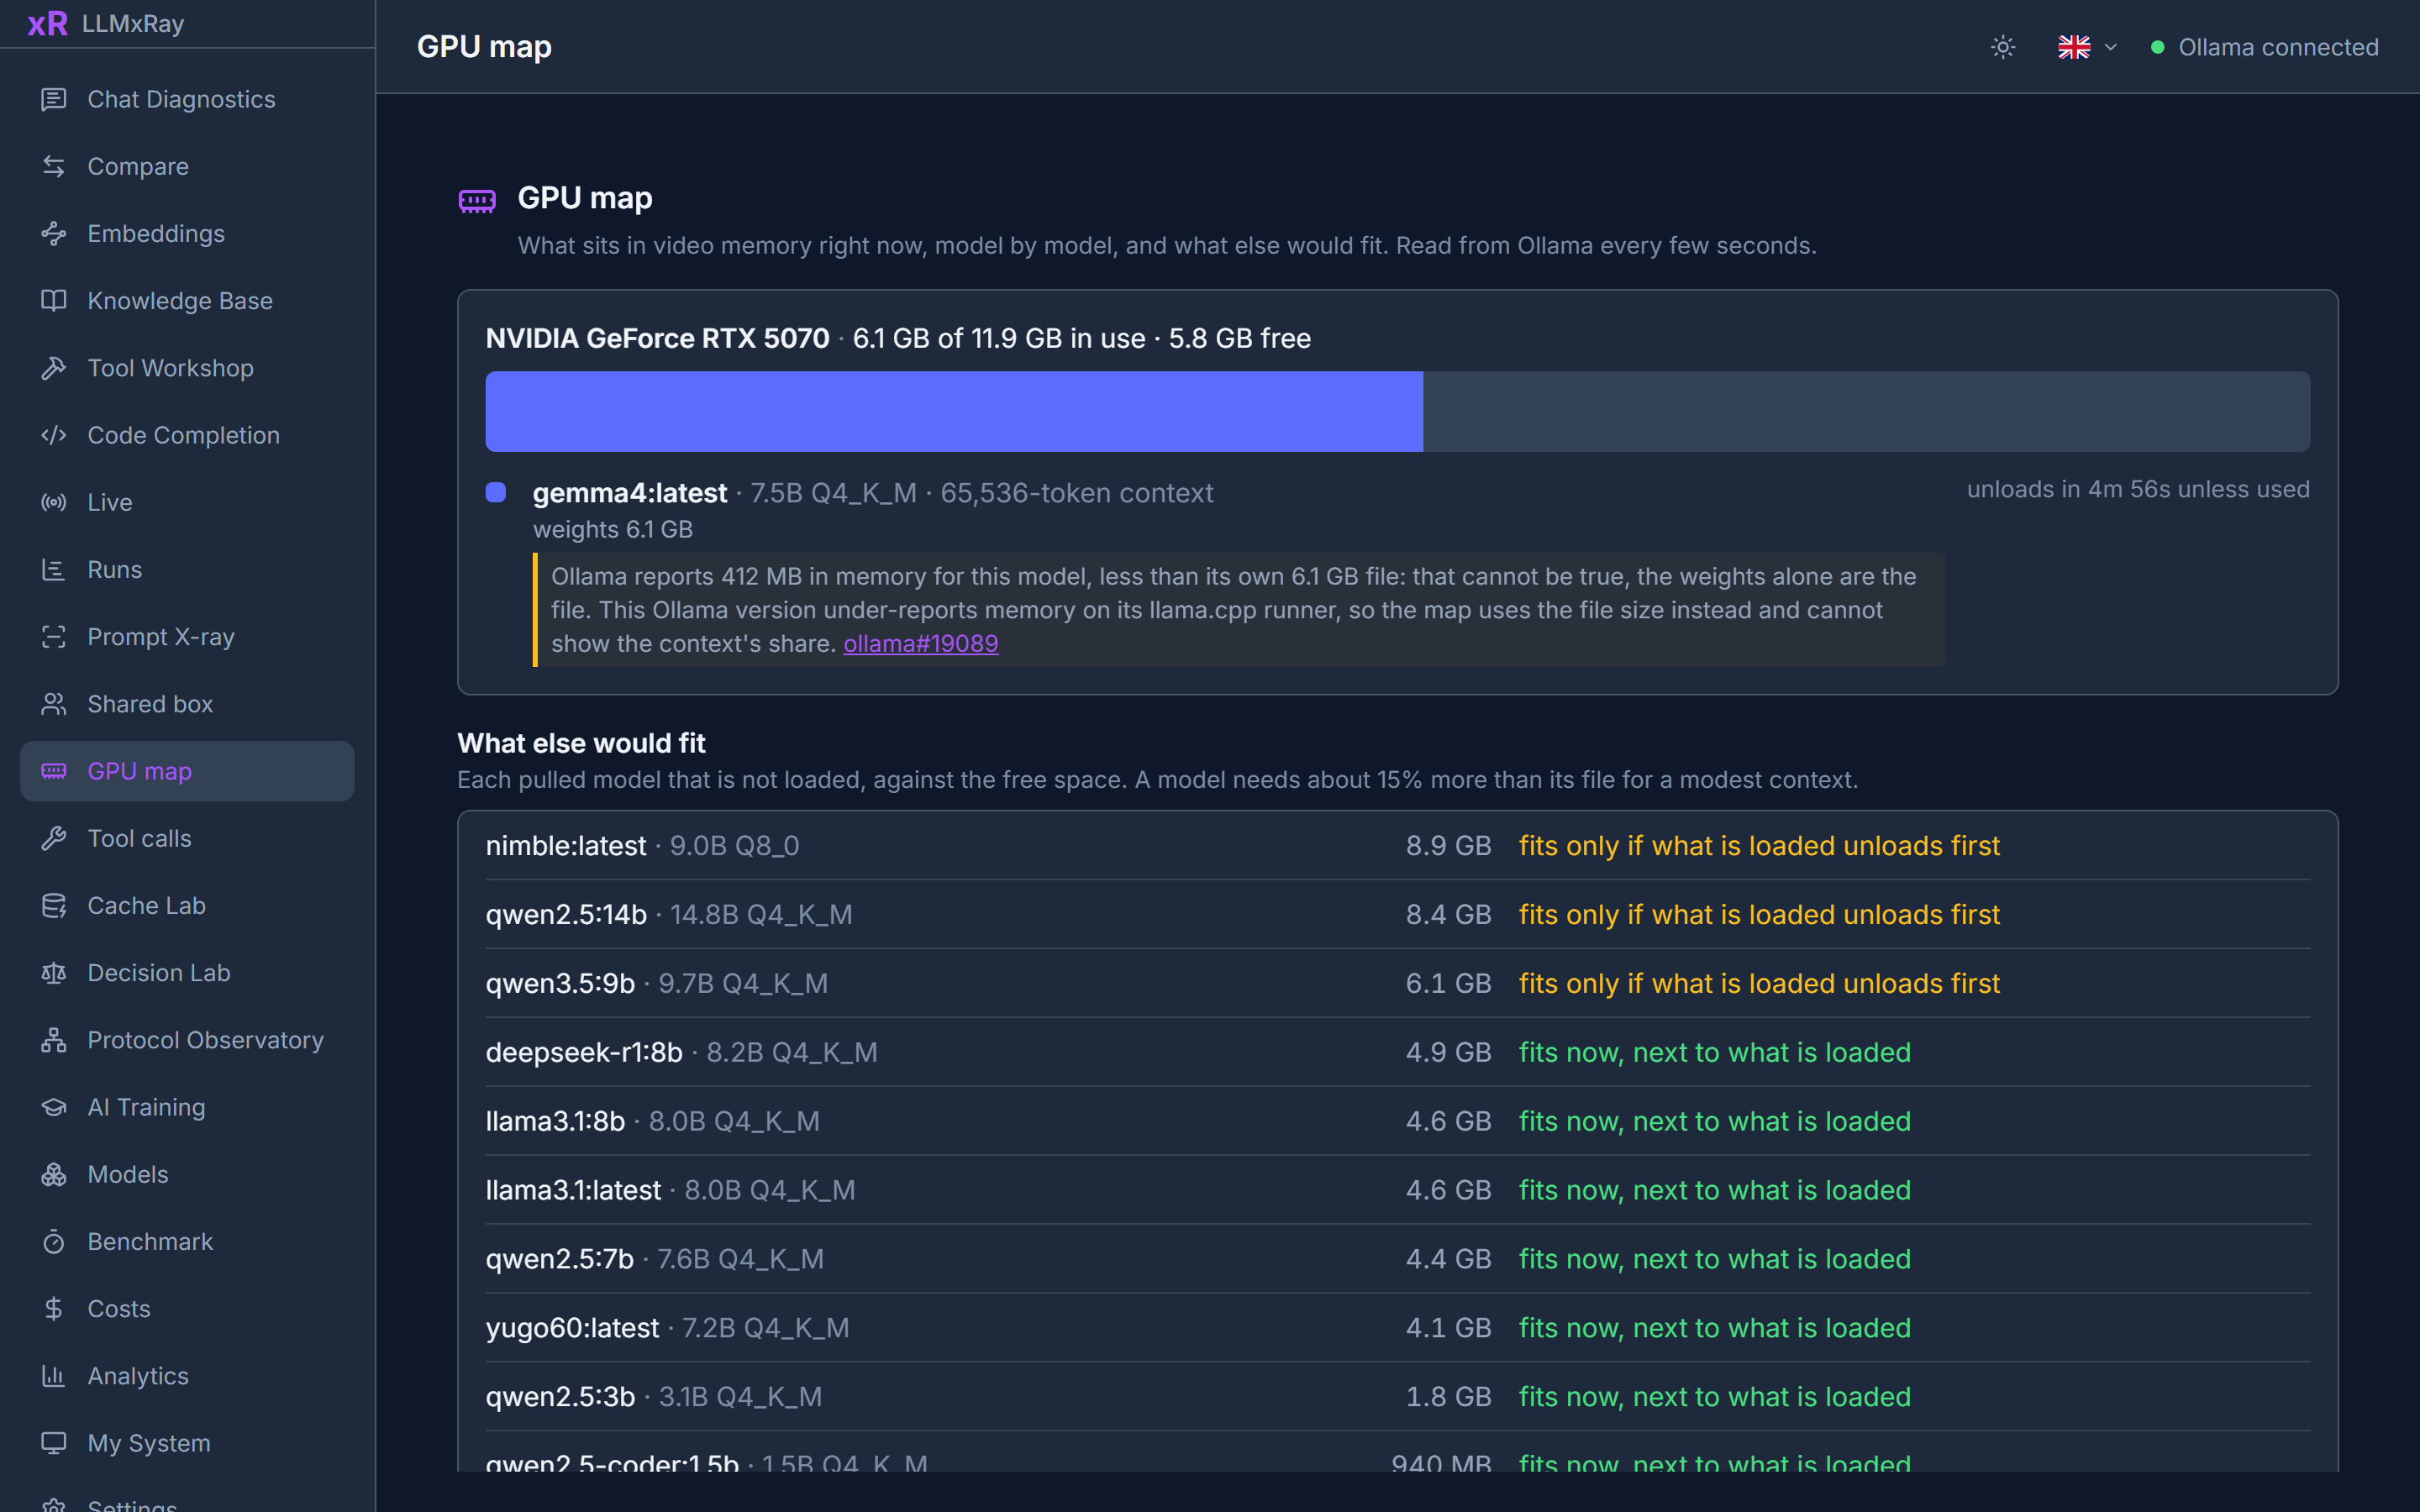
### Carte du GPU : ce qui est en mémoire vidéo, et ce qui tiendrait encore
Une barre de la largeur de votre carte : chaque modèle chargé en bloc, séparé entre ses poids et ce que son contexte coûte en plus, puis l'espace libre. En dessous, chaque modèle téléchargé avec l'un de trois verdicts : tient maintenant, tient seulement si ce qui est chargé est d'abord déchargé, plus grand que la carte.
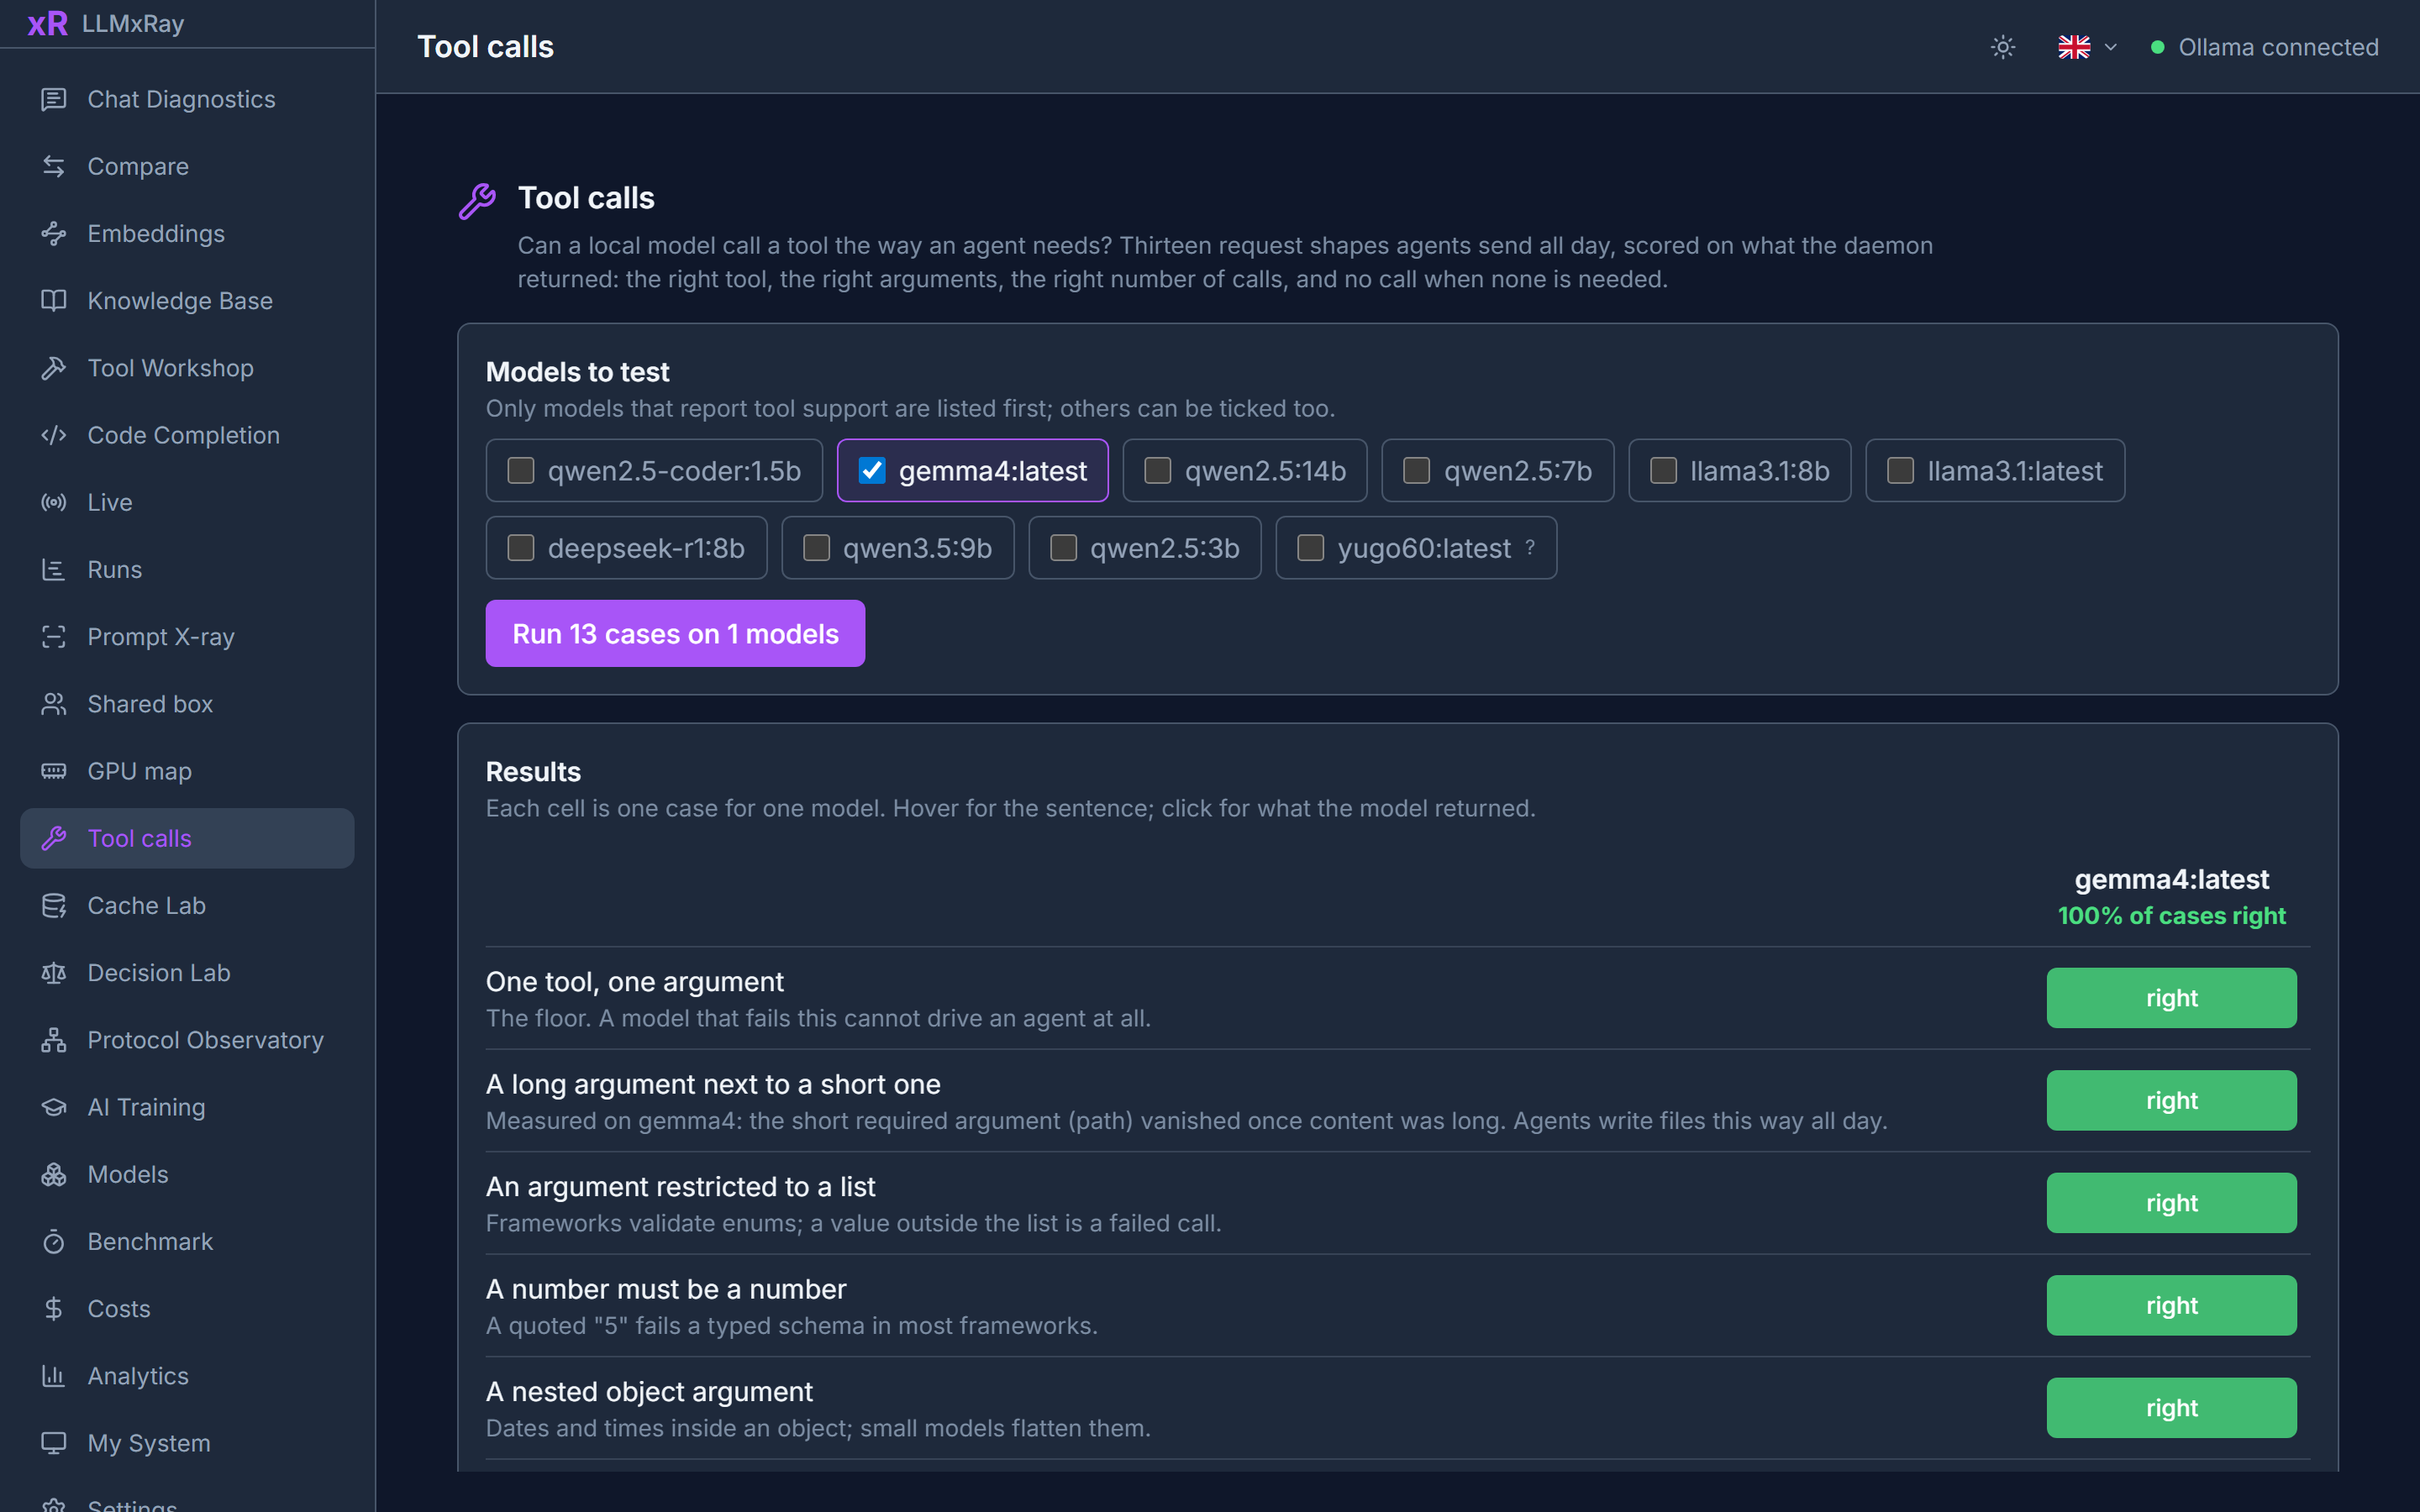
### Appels d'outils : ce modèle peut-il piloter un agent ?
Treize formes de requêtes que les agents envoient toute la journée, notées sur ce que le démon a renvoyé : le bon outil, les bons arguments, le bon nombre d'appels, aucun appel quand il n'en faut pas. Chaque case est une phrase : « l'argument path manque », « a écrit l'appel dans le texte de la réponse », « a appelé search_web alors qu'aucun outil n'était nécessaire ». Cliquez dessus pour voir ce que le modèle a renvoyé.
### Labo de cache
Un modèle local ne réutilise son cache d'invite que tant que l'invite correspond dès le tout premier token. Un seul horodatage en haut sacrifie tout ce qui suit. Le labo trouve les valeurs qui changent entre les tours, montre où la réutilisation meurt, puis **mesure** sur votre propre démon ce que rapporte leur déplacement à la fin.
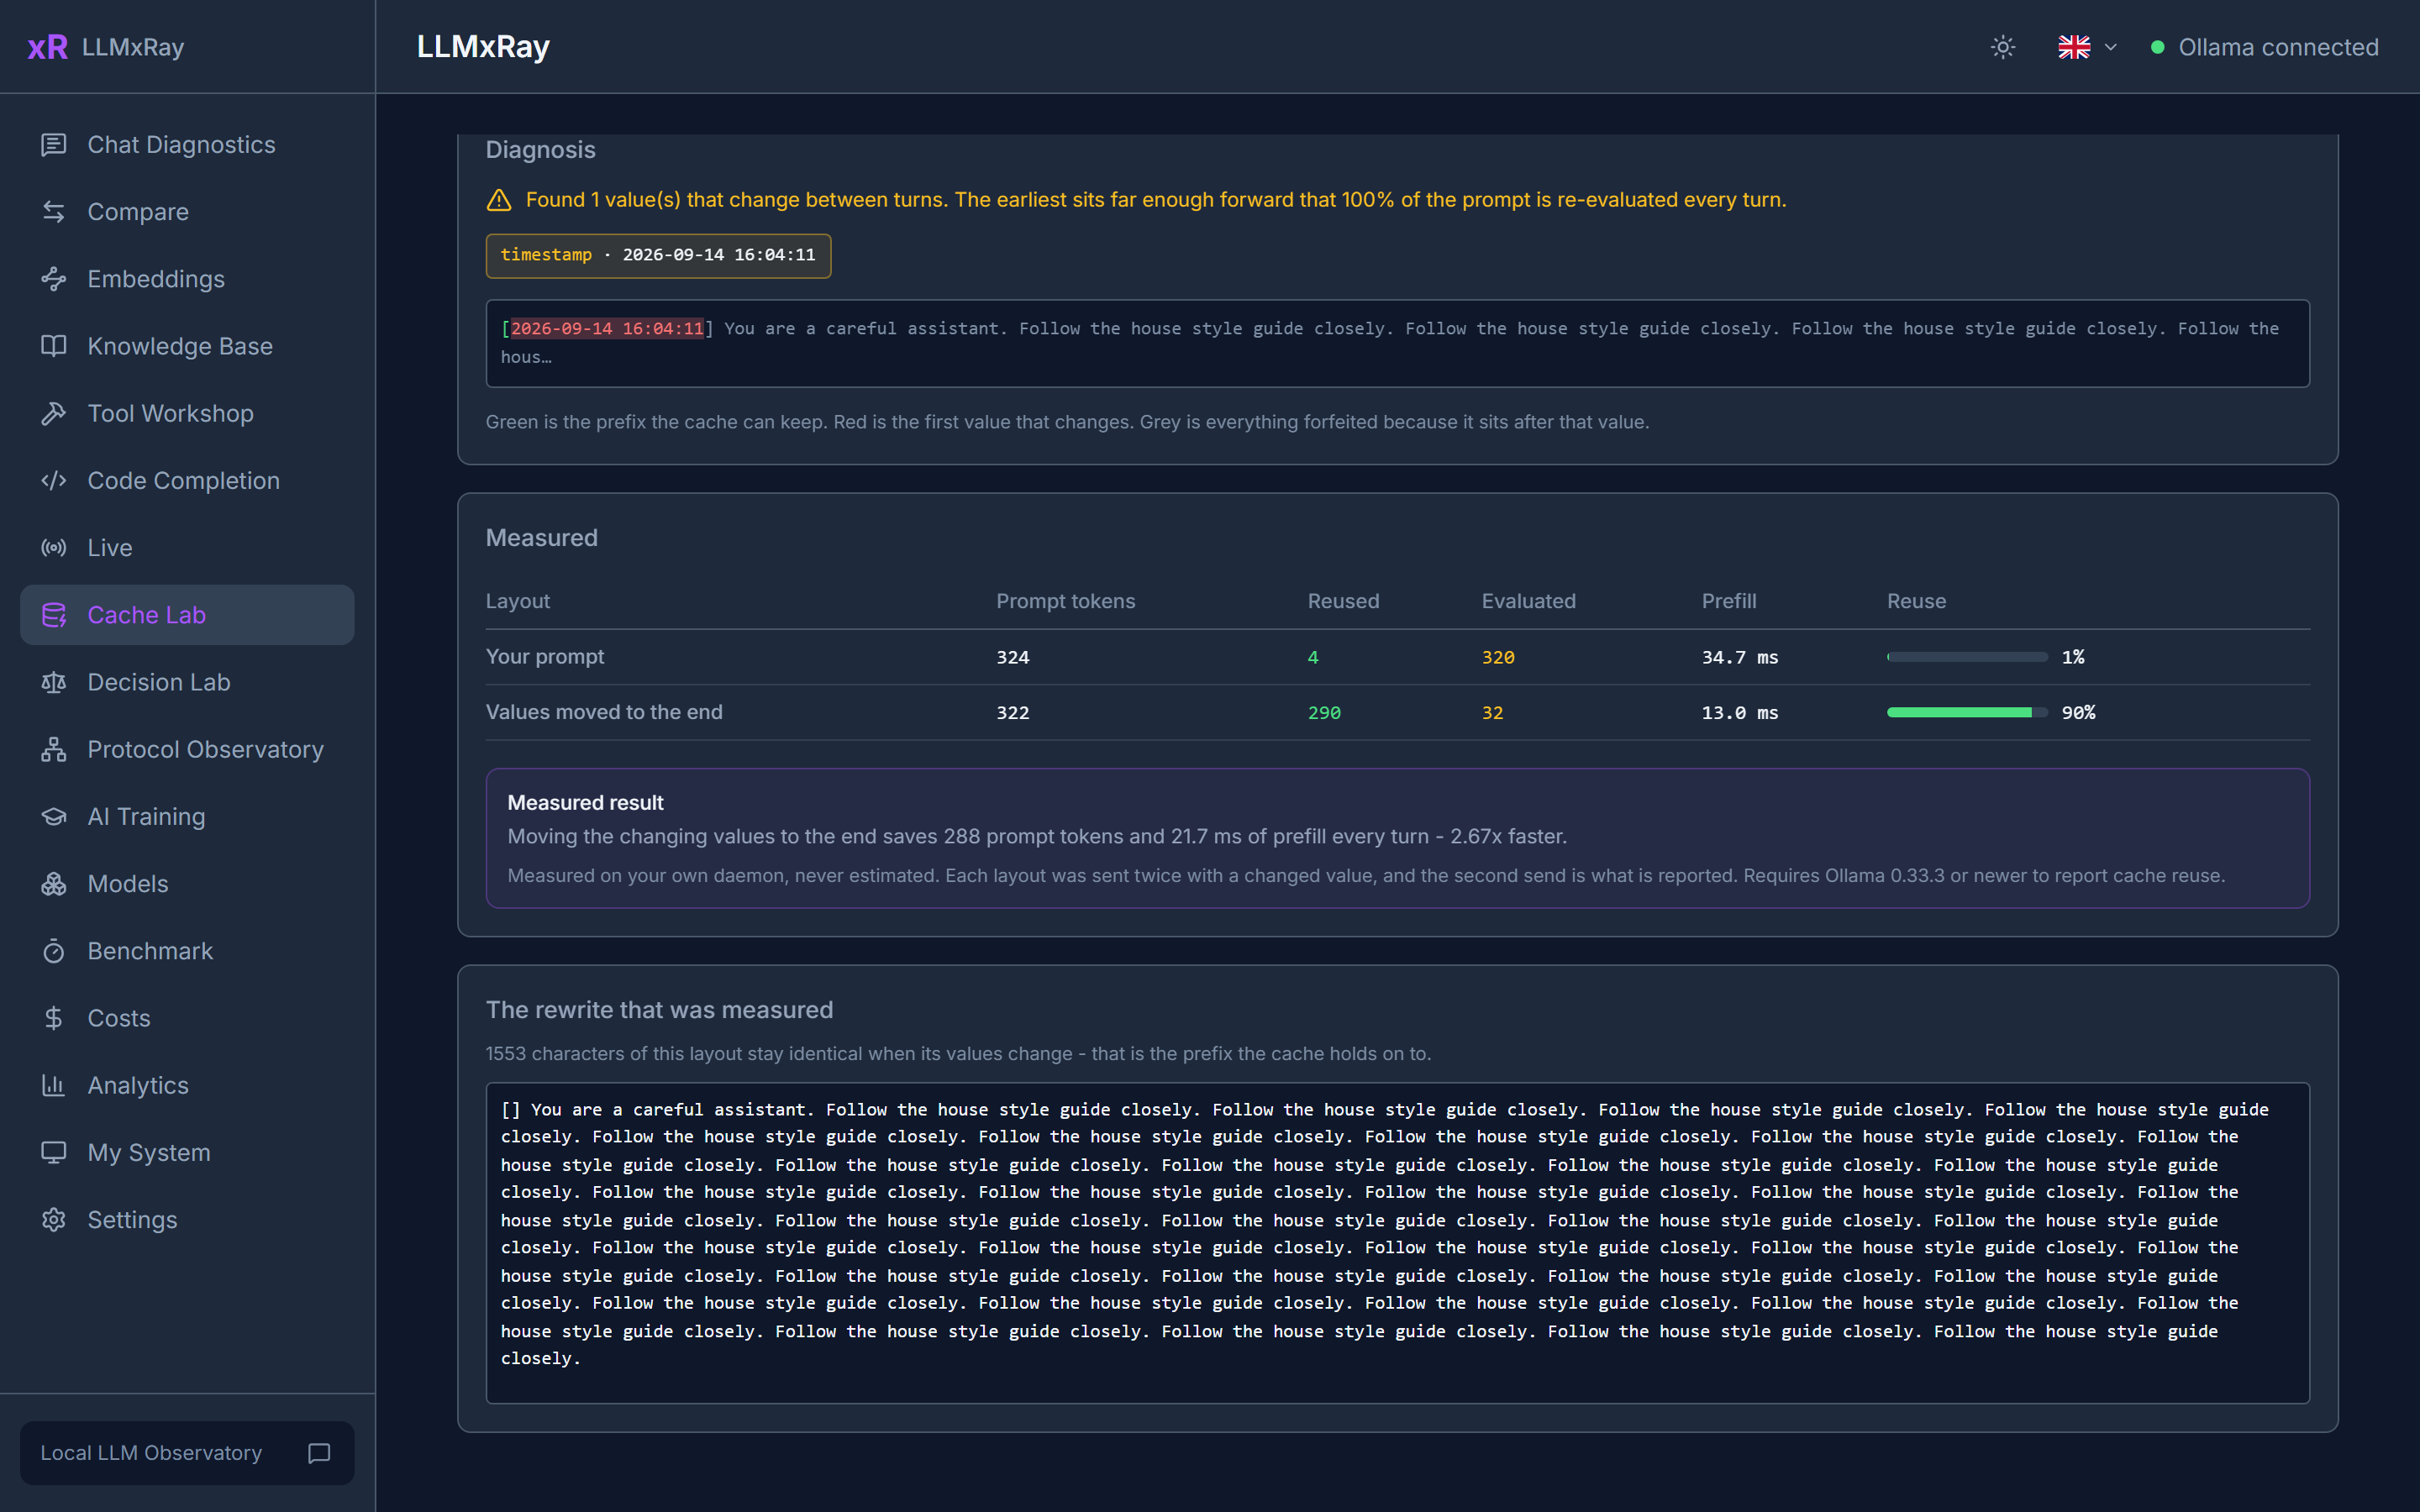
Mesuré sur une vraie invite de 324 tokens : 4 tokens réutilisés et 64,6 ms de préremplissage avec l'horodatage devant, 290 réutilisés et 18,6 ms avec l'horodatage derrière. **3,5x plus rapide, mêmes mots.**
### Observatoire des protocoles
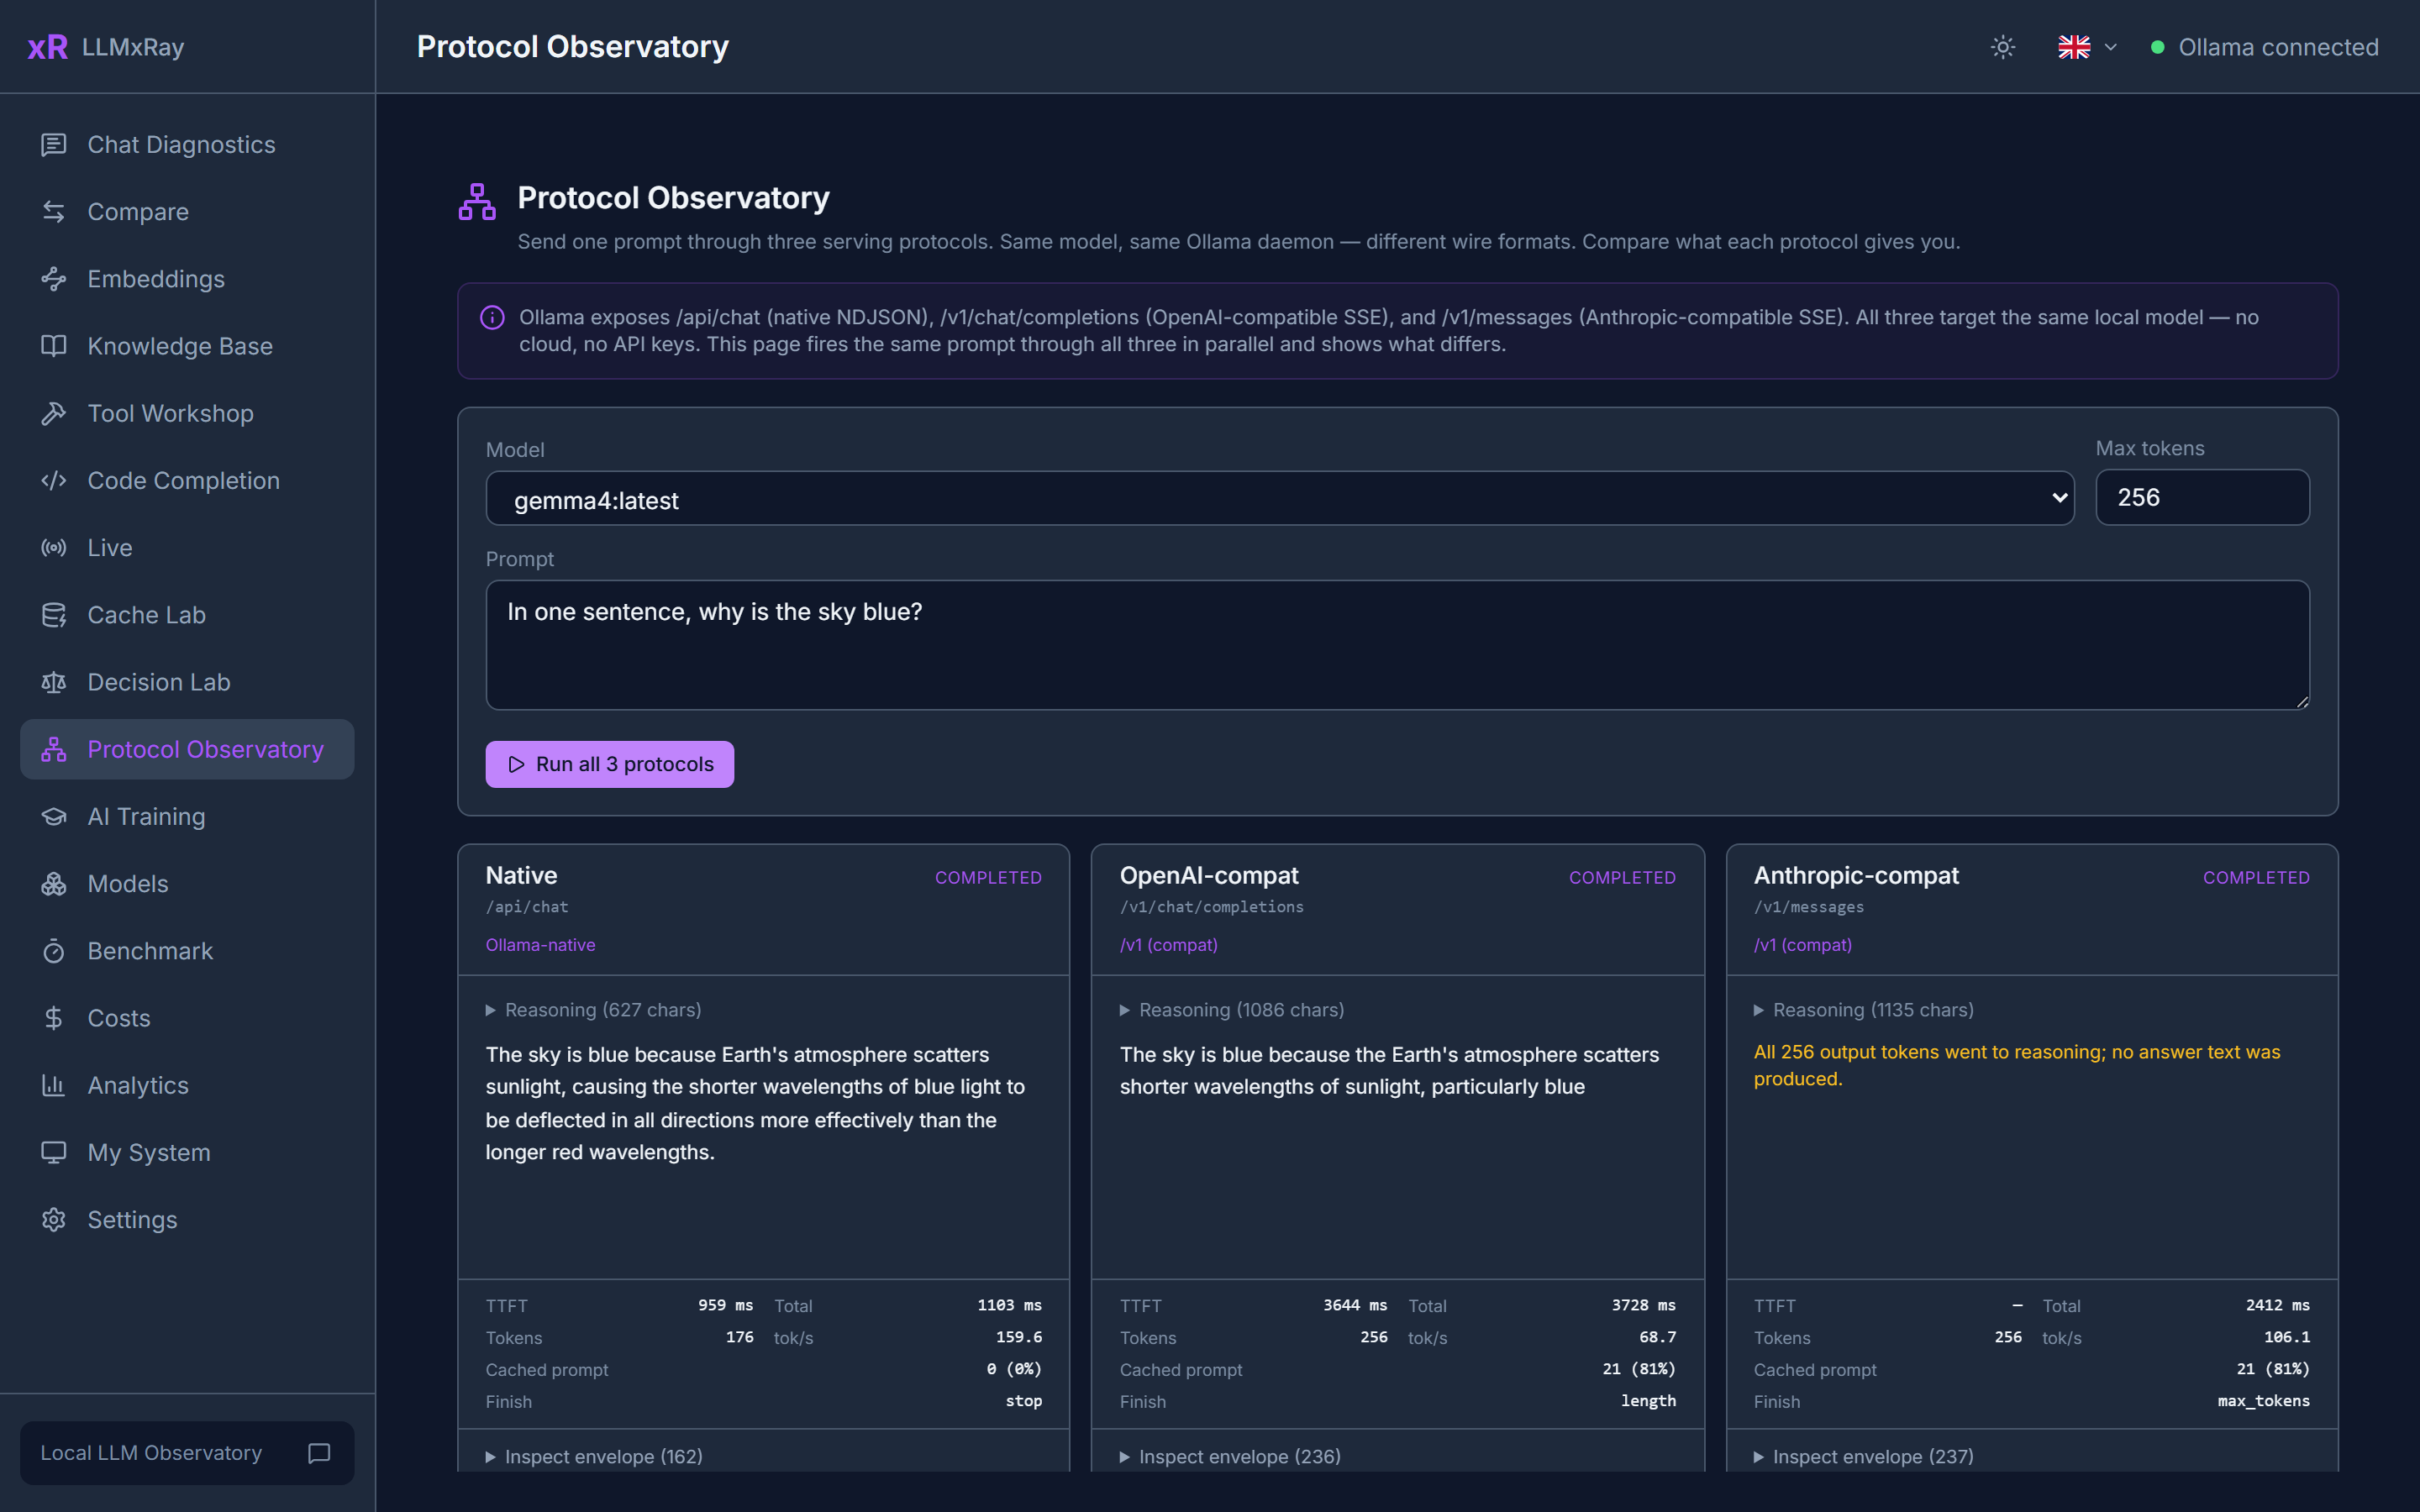
La même invite à travers les trois protocoles de service d'Ollama, en parallèle : natif `/api/chat`, compatible OpenAI `/v1/chat/completions`, et compatible Anthropic `/v1/messages`. Streaming côte à côte, métriques par protocole, et un diff d'enveloppe qui montre comment chacun encadre les raisons d'arrêt, les comptes de tokens et les erreurs.
---
## Garder, et envoyer plus loin
L'enregistrement de chaque tour (tokens, cache, durées, client, modèle, jamais le texte) reste sur votre machine pendant 30 jours : un redémarrage reprend là où il s'était arrêté. En direct, les Exécutions, la Radiographie de l'invite et les outils MCP continuent comme si de rien n'était.
Si votre équipe lit déjà ses traces, envoyez-y les tours : chaque appel au modèle devient un span OpenTelemetry avec les attributs GenAI que les visualiseurs lisent déjà, chaque exécution une trace, et le temps des outils entre deux appels un span à part, la même cascade qu'Exécutions. Donnez une adresse sur la page En direct, ou `OTEL_EXPORTER_OTLP_ENDPOINT`.
| Visualiseur | Adresse |
|---|---|
| Jaeger (`docker run -p 16686:16686 -p 4318:4318 jaegertracing/jaeger`) | `http://localhost:4318` |
| Arize Phoenix (`docker run -p 6006:6006 arizephoenix/phoenix`) | `http://localhost:6006` |
| Langfuse | `https://cloud.langfuse.com/api/public/otel`, avec un en-tête Basic fait de vos clés |
| Grafana Tempo, un OpenTelemetry Collector | son adresse OTLP HTTP, en général le port 4318 |
Le texte des invites ne part que si vous activez à la fois *Conserver le texte des invites* et *Inclure le texte des invites dans chaque span*.
---
## Pour les agents
Si vous êtes un agent qui tourne sur un modèle local, LLMxRay peut vous dire ce qui n'a pas marché dans vos propres appels. Deux étapes.
1. Envoyez vos appels Ollama au port **11435** plutôt qu'au 11434. Il se comporte exactement comme Ollama et transmet tout ; LLMxRay ne fait qu'enregistrer ce qui passe.
2. Ajoutez le serveur MCP de LLMxRay à vos outils :
```json
{ "mcpServers": { "llmxray": { "command": "npx", "args": ["-y", "-p", "llmxray", "llmxray-mcp"] } } }
```
Sept outils, tous en lecture seule, rien ne quitte la machine :
| Outil | Répond à |
|---|---|
| `diagnose_my_turns` | Ce qui ressort de vos derniers tours, en phrases avec la correction : une invite refusée parce qu'elle dépasse le contexte chargé, le cache perdu à chaque tour ou à un tour, un modèle en partie sur le processeur, des schémas d'outils qui envahissent l'invite. |
| `read_my_last_turn` | Votre dernier tour en chiffres : tokens de l'invite et part en cache, temps et vitesse de préremplissage, tokens générés et vitesse, pourquoi la génération s'est arrêtée, de quoi l'invite était faite, si le modèle tenait en mémoire vidéo. |
| `list_local_models` | Quels modèles sont téléchargés, leur taille et leur quantification, lesquels sont chargés et avec quel contexte, et si chacun tient en mémoire vidéo. |
| `list_my_turns` | L'historique : une ligne par tour avec les tokens, la part en cache, le préremplissage, la vitesse de génération, la raison de l'arrêt et les signalements. |
| `compare_my_turns` | Un changement a-t-il aidé : médianes de la part en cache, du préremplissage, de la vitesse et de la taille de l'invite avant et après un moment, avec un verdict. |
| `estimate_my_prompt` | Avant d'envoyer : une invite de N tokens tient-elle dans le contexte chargé, quelle marge reste-t-il, le modèle est-il en mémoire vidéo, quelle part le cache réutiliserait. |
| `read_llmxray_status` | Où tourne LLMxRay, le port d'observation, l'Ollama vers lequel il transmet, combien de tours il garde. |
LLMxRay lui-même doit tourner (`npx llmxray`). Le serveur MCP le lit en localhost.
La même procédure, en [Agent Skill](https://agentskills.io) que votre agent peut charger : `npx skills add LogneBudo/llmxray` (skills.sh) ou `clawhub install llmxray-diagnose-ollama-calls` (ClawHub). Source : [skills/diagnose-ollama-calls/SKILL.md](skills/diagnose-ollama-calls/SKILL.md).
Donnez-vous un nom pour que vos tours soient les vôtres : envoyez l'en-tête `X-LLMxRay-Client: mon-agent`, ou utilisez `http://localhost:11435/?client=mon-agent` comme adresse de base, et passez `mon-agent` comme `client` aux outils.
---
## Aussi dans la boîte
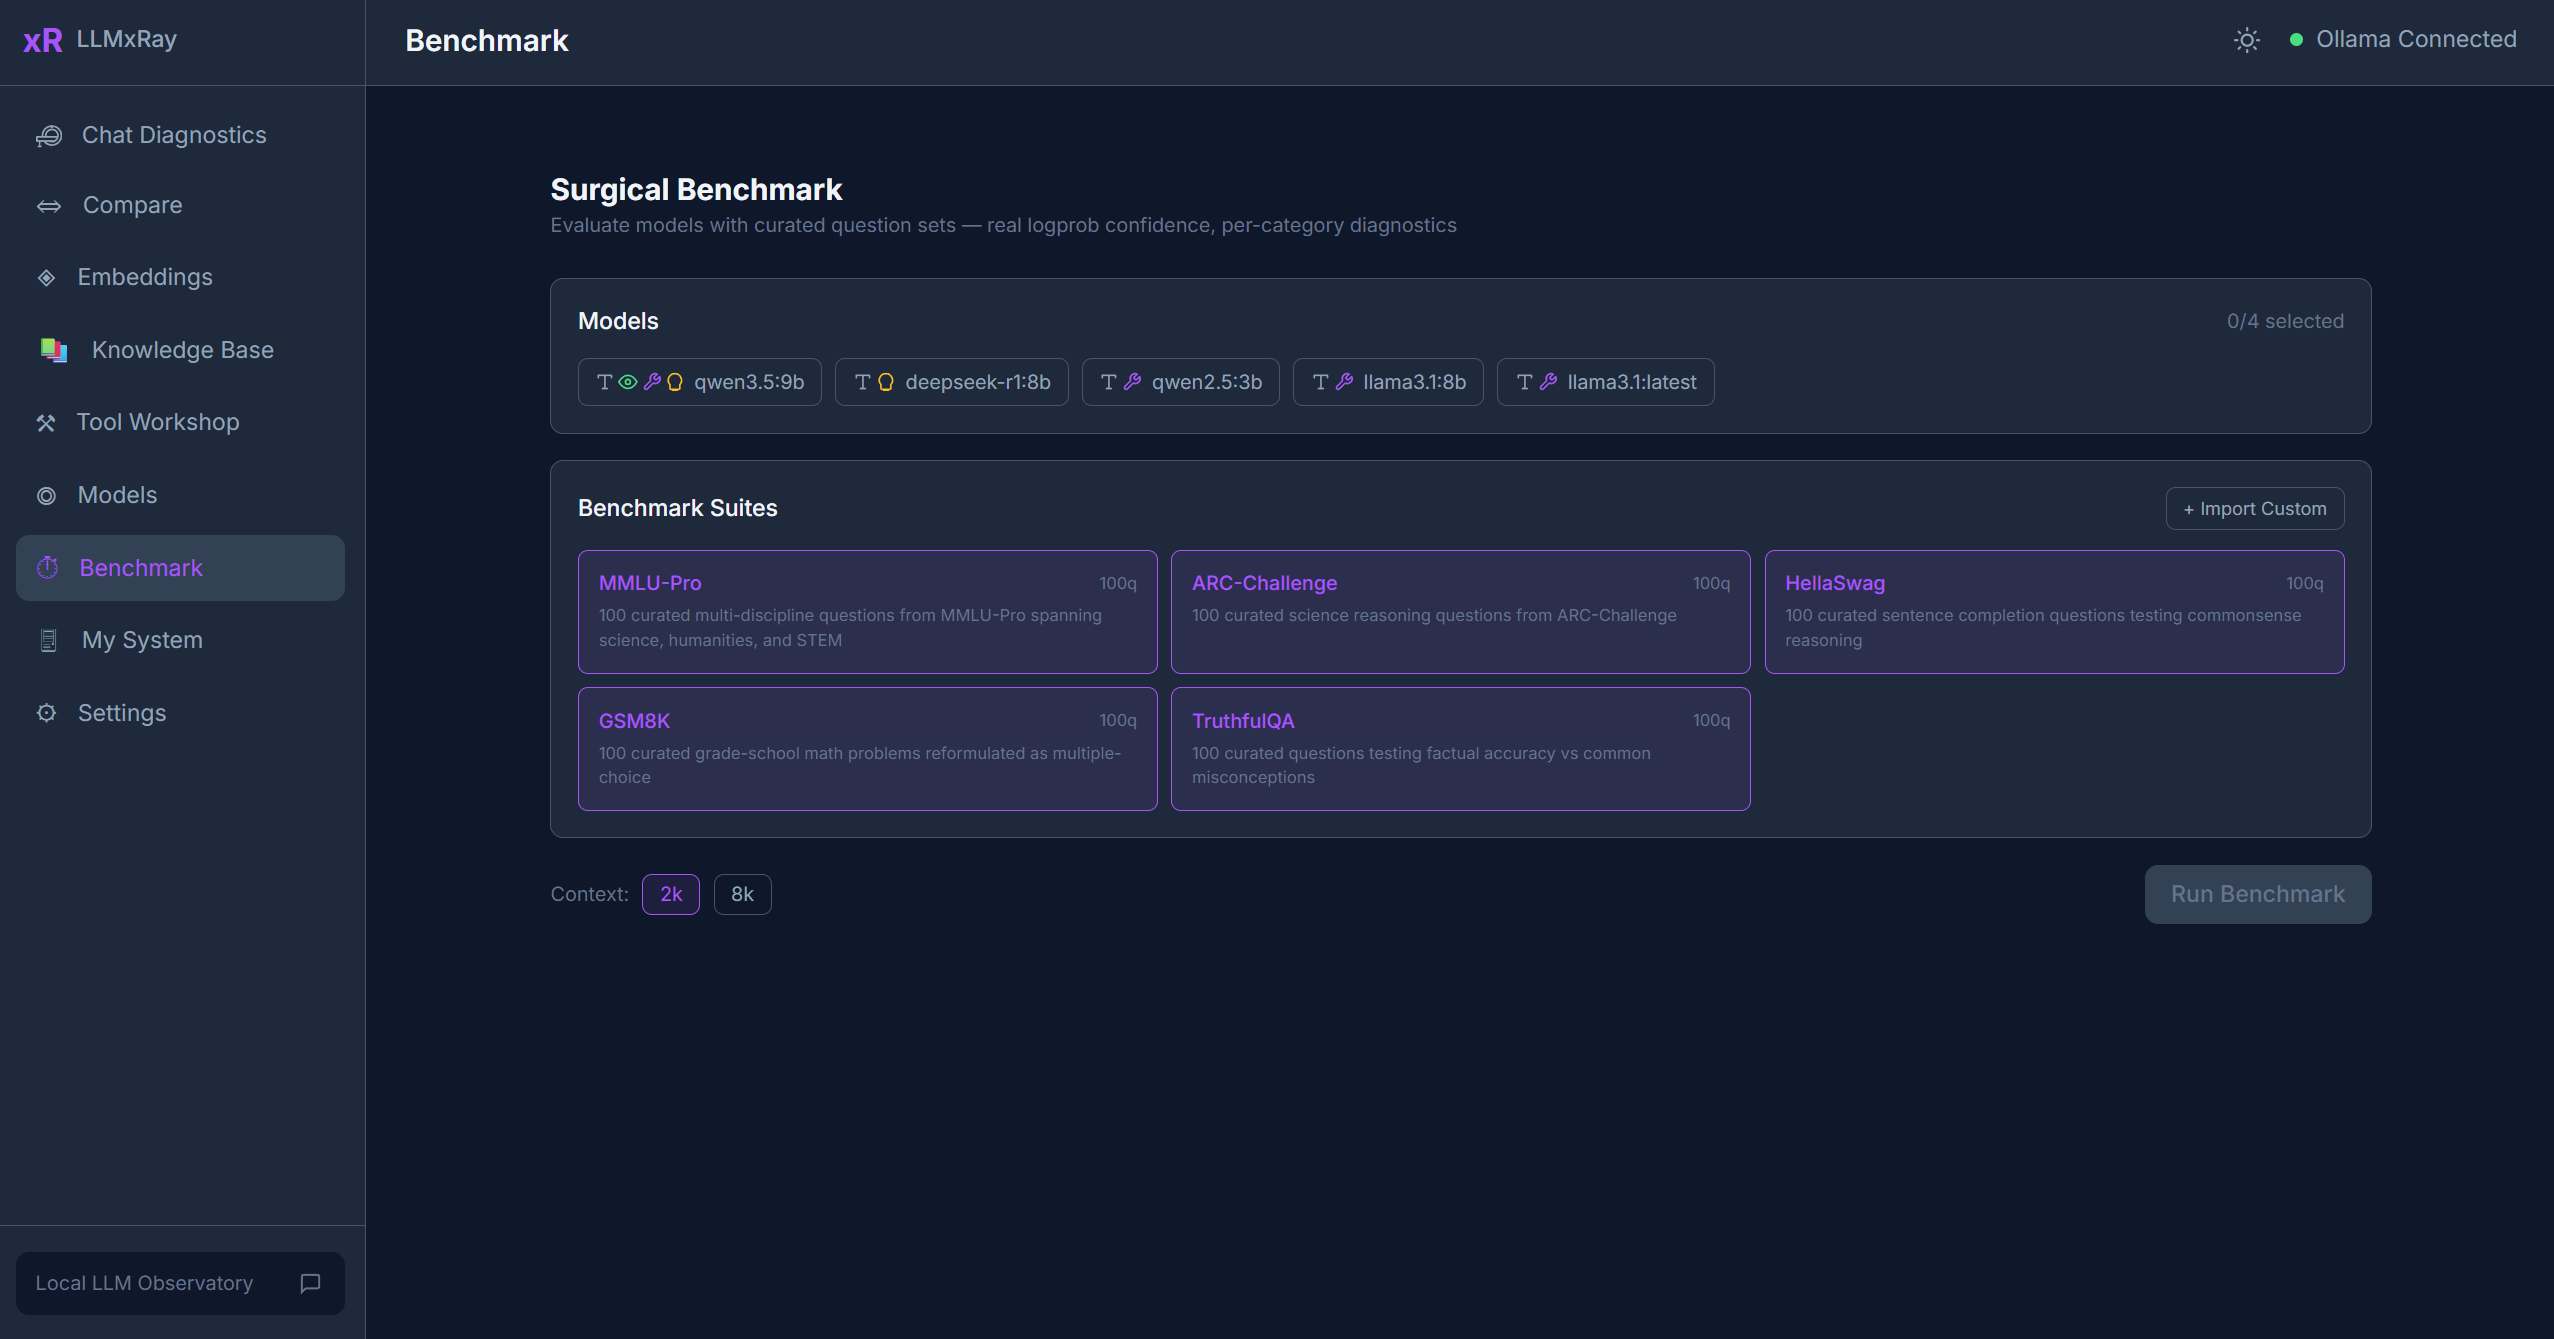
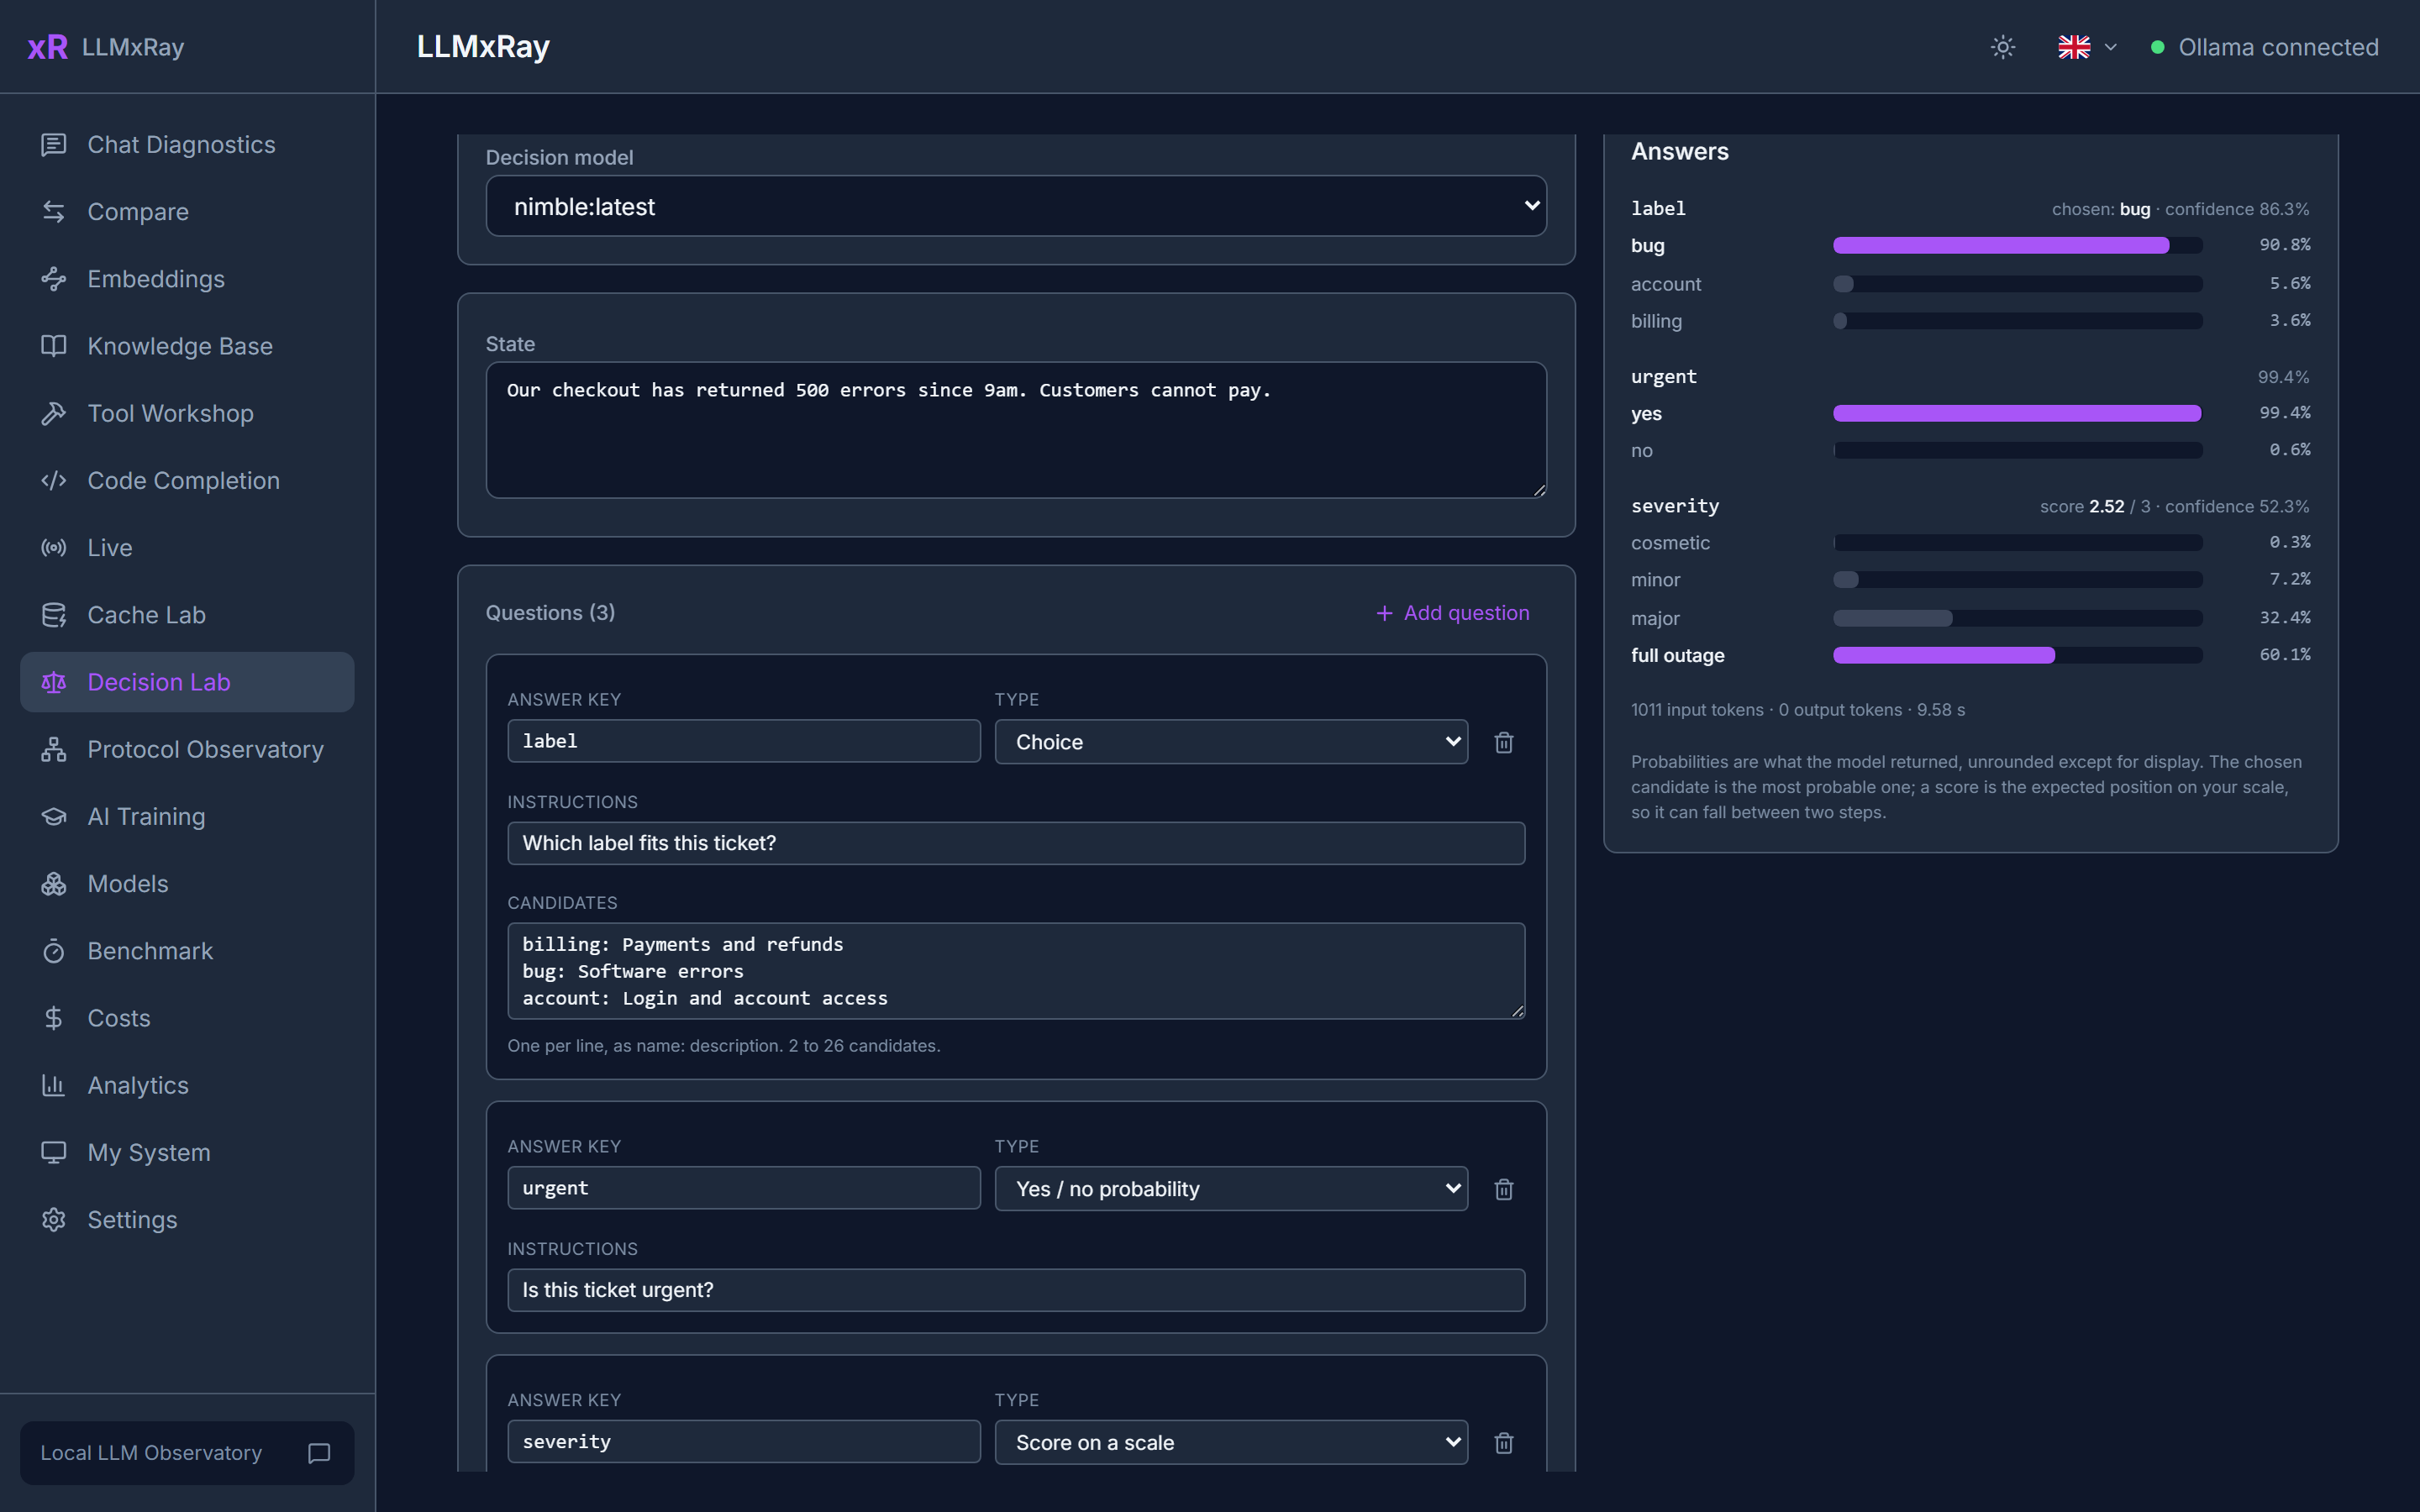
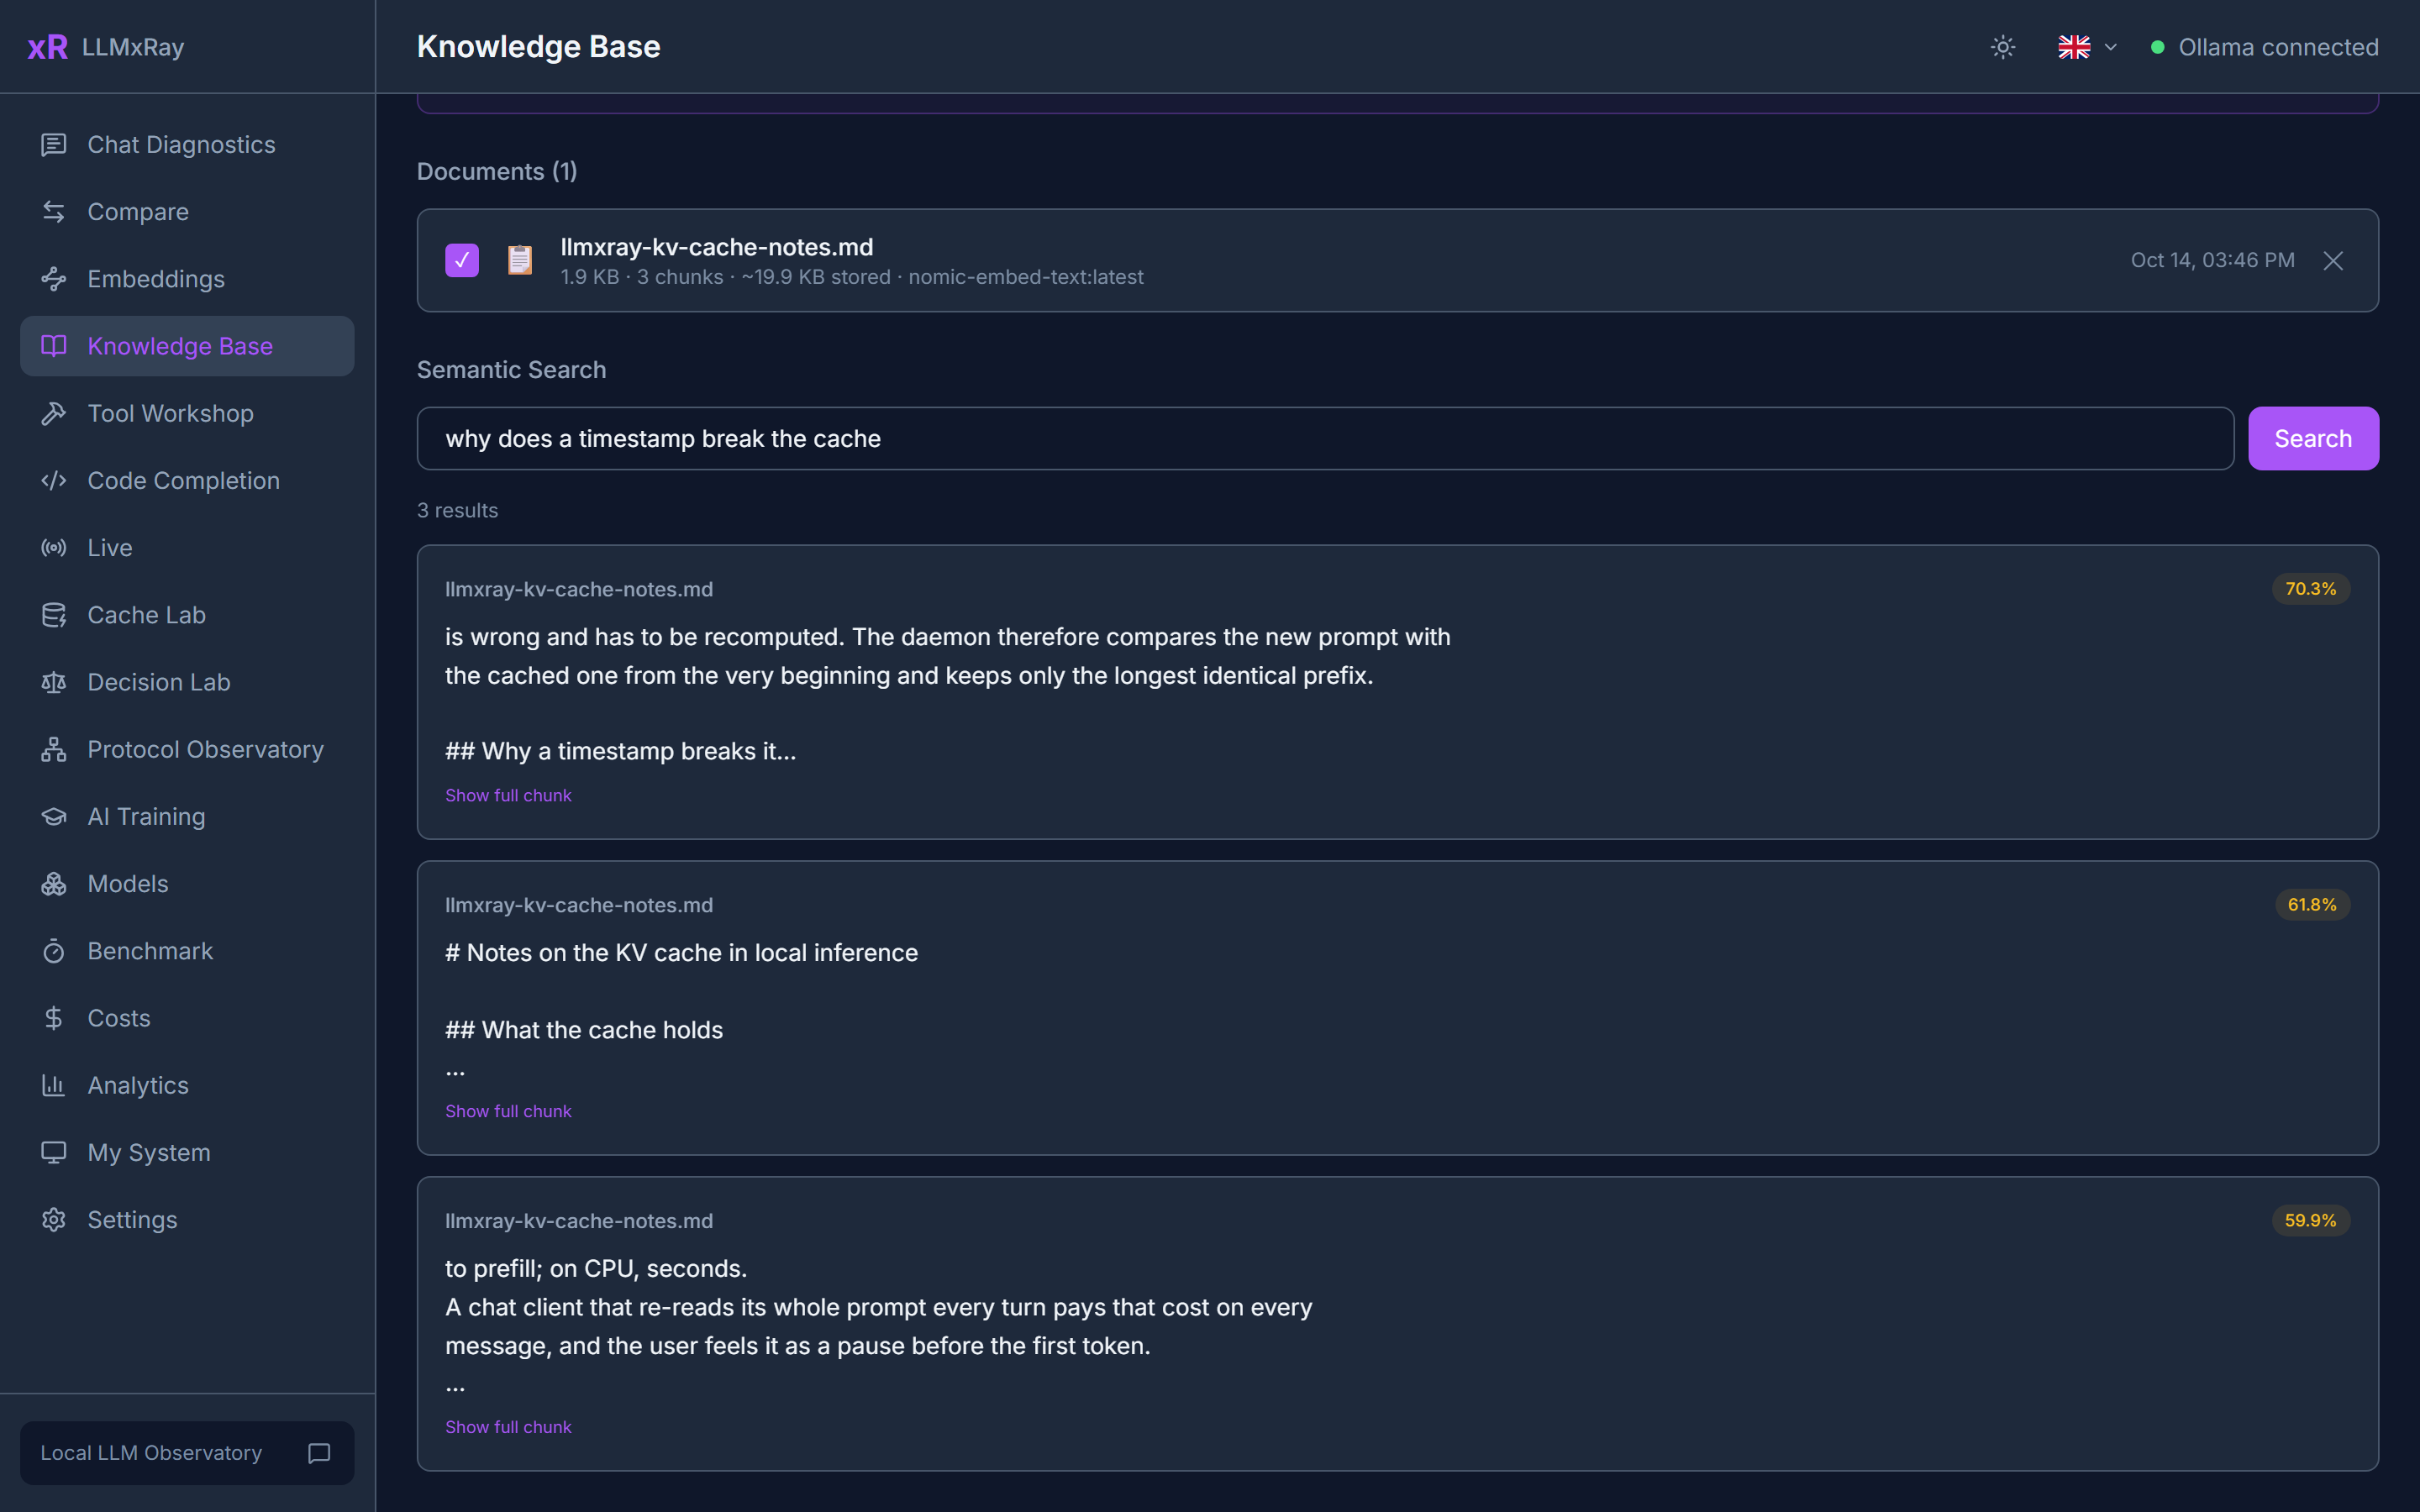
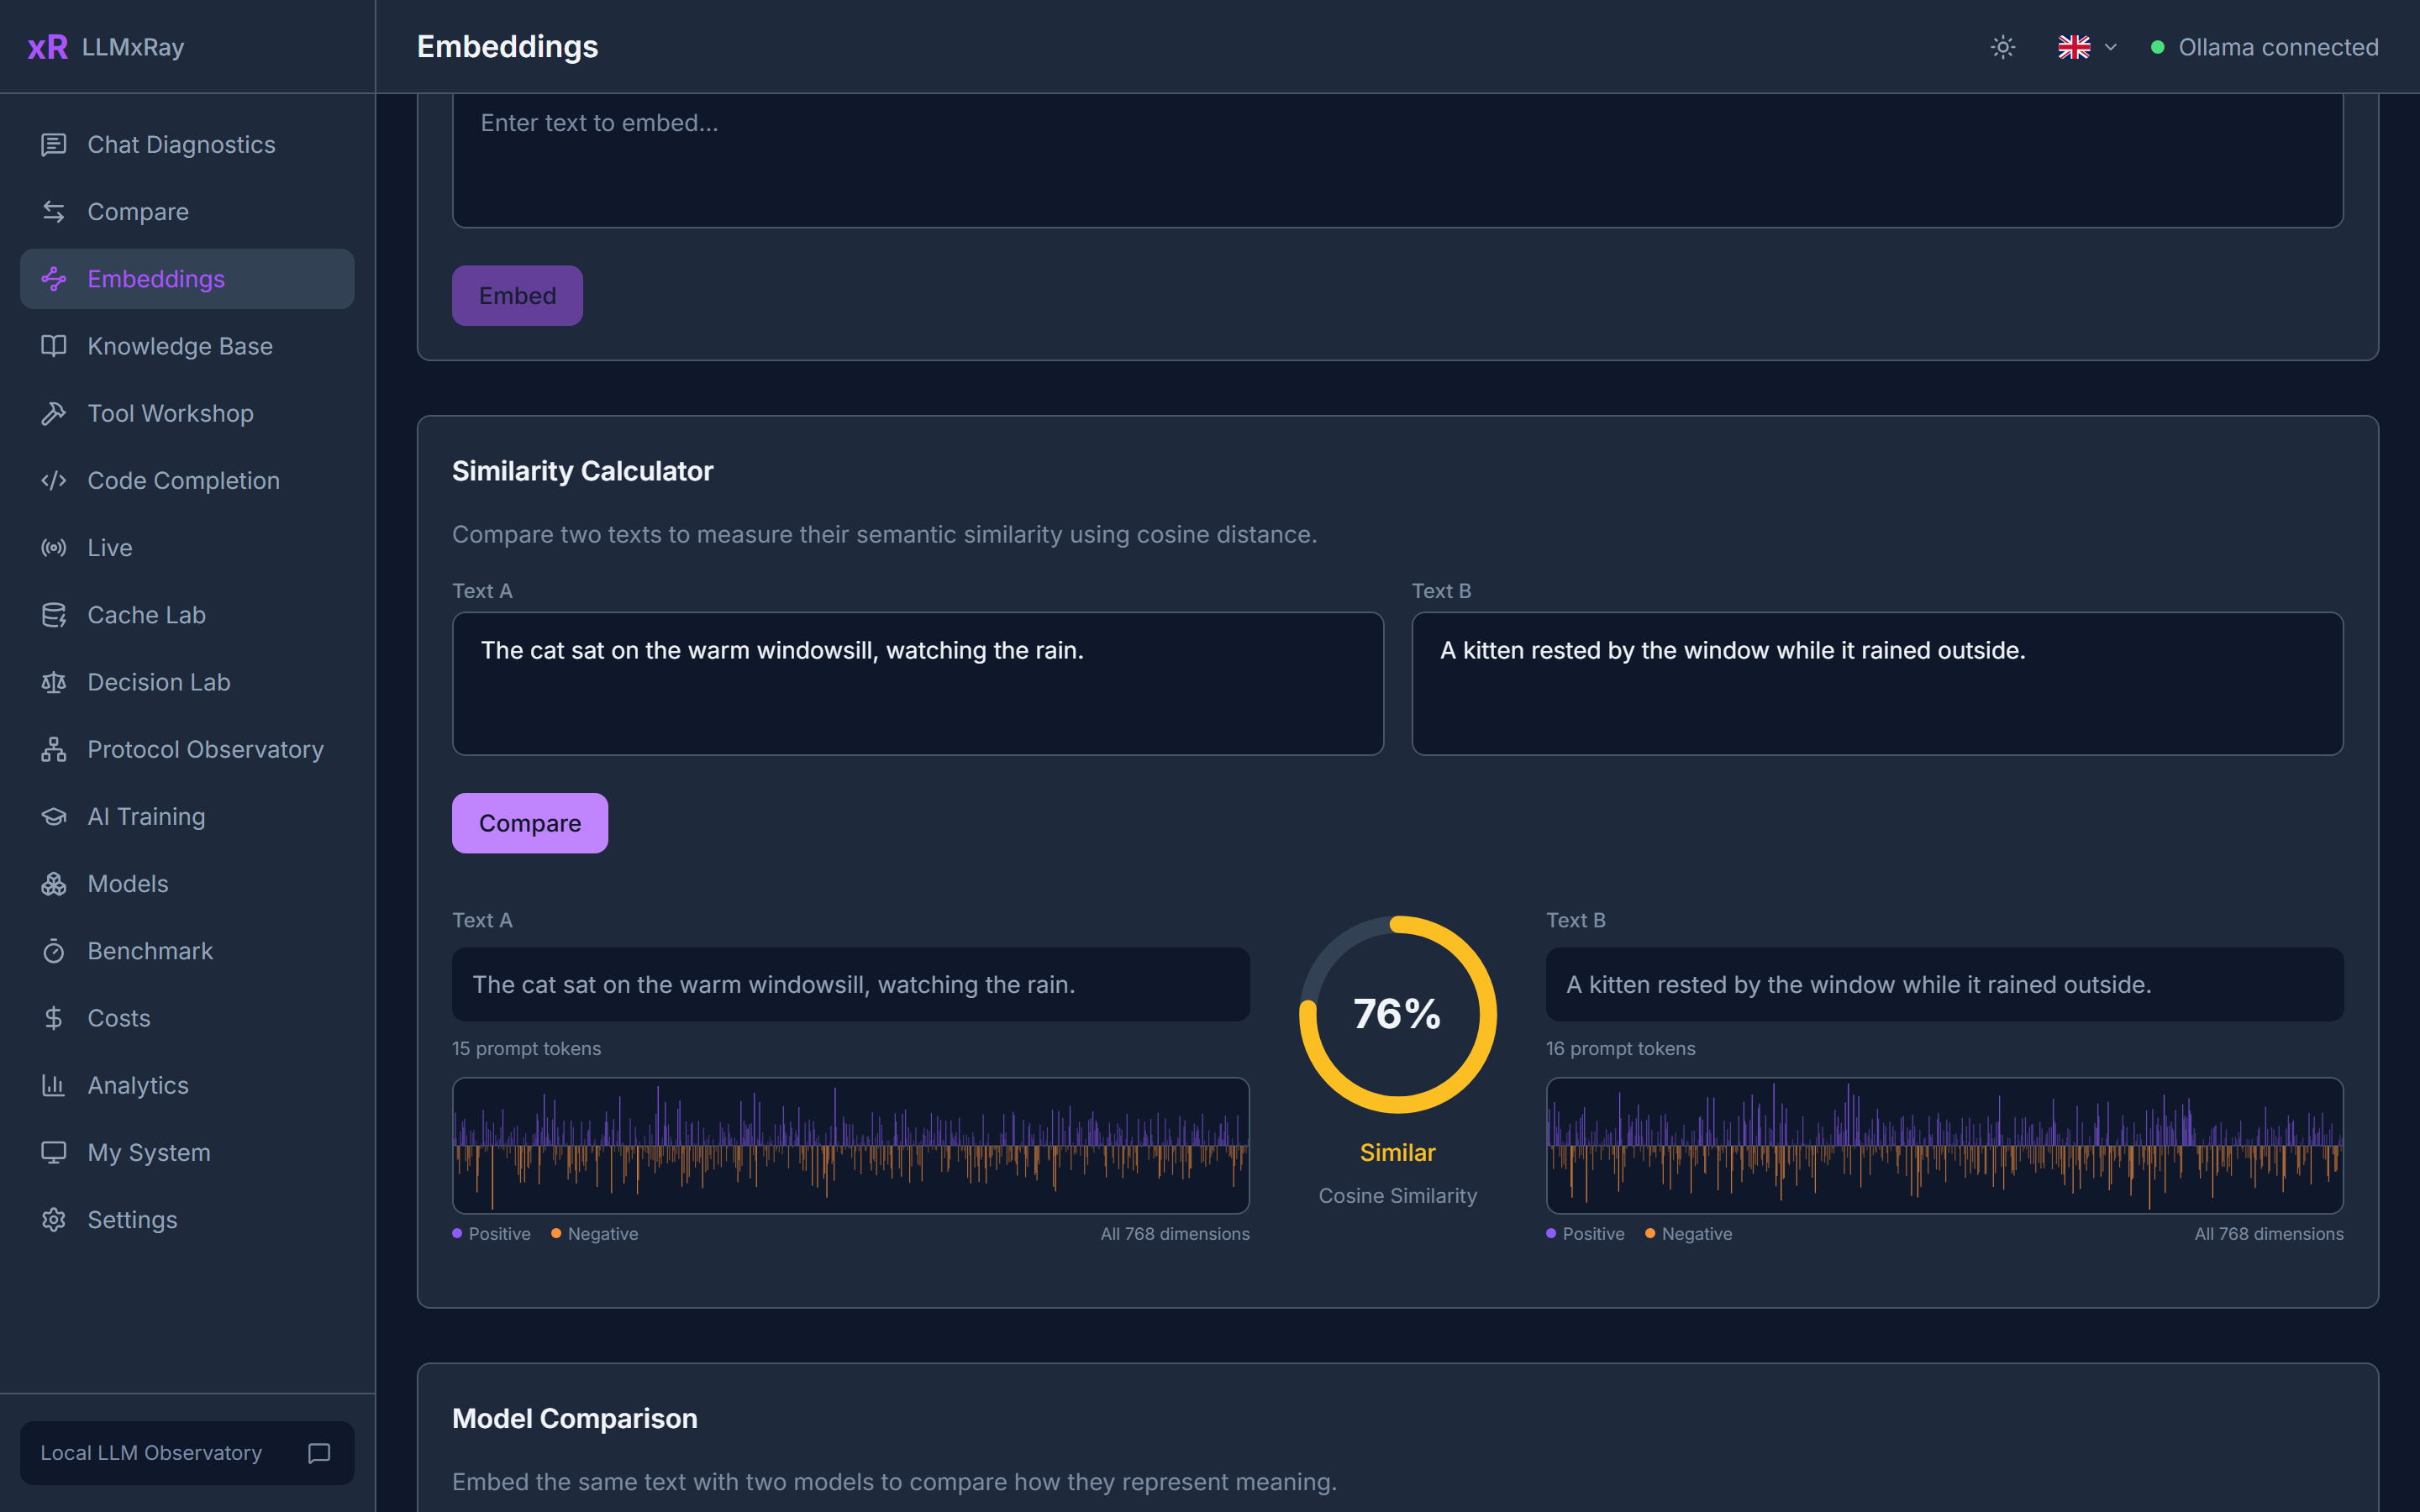
Vous faites tourner un modèle local. Vous discutez avec lui. LLMxRay répond aux questions qui viennent ensuite : chaque token a mis combien de temps, qu'a coûté l'invite, le cache a-t-il servi, quel réglage était vraiment le meilleur, et qu'envoient vos *autres* outils au même modèle.
Chaque page ci-dessous est l'une de ces réponses.
### Le chat, token par token
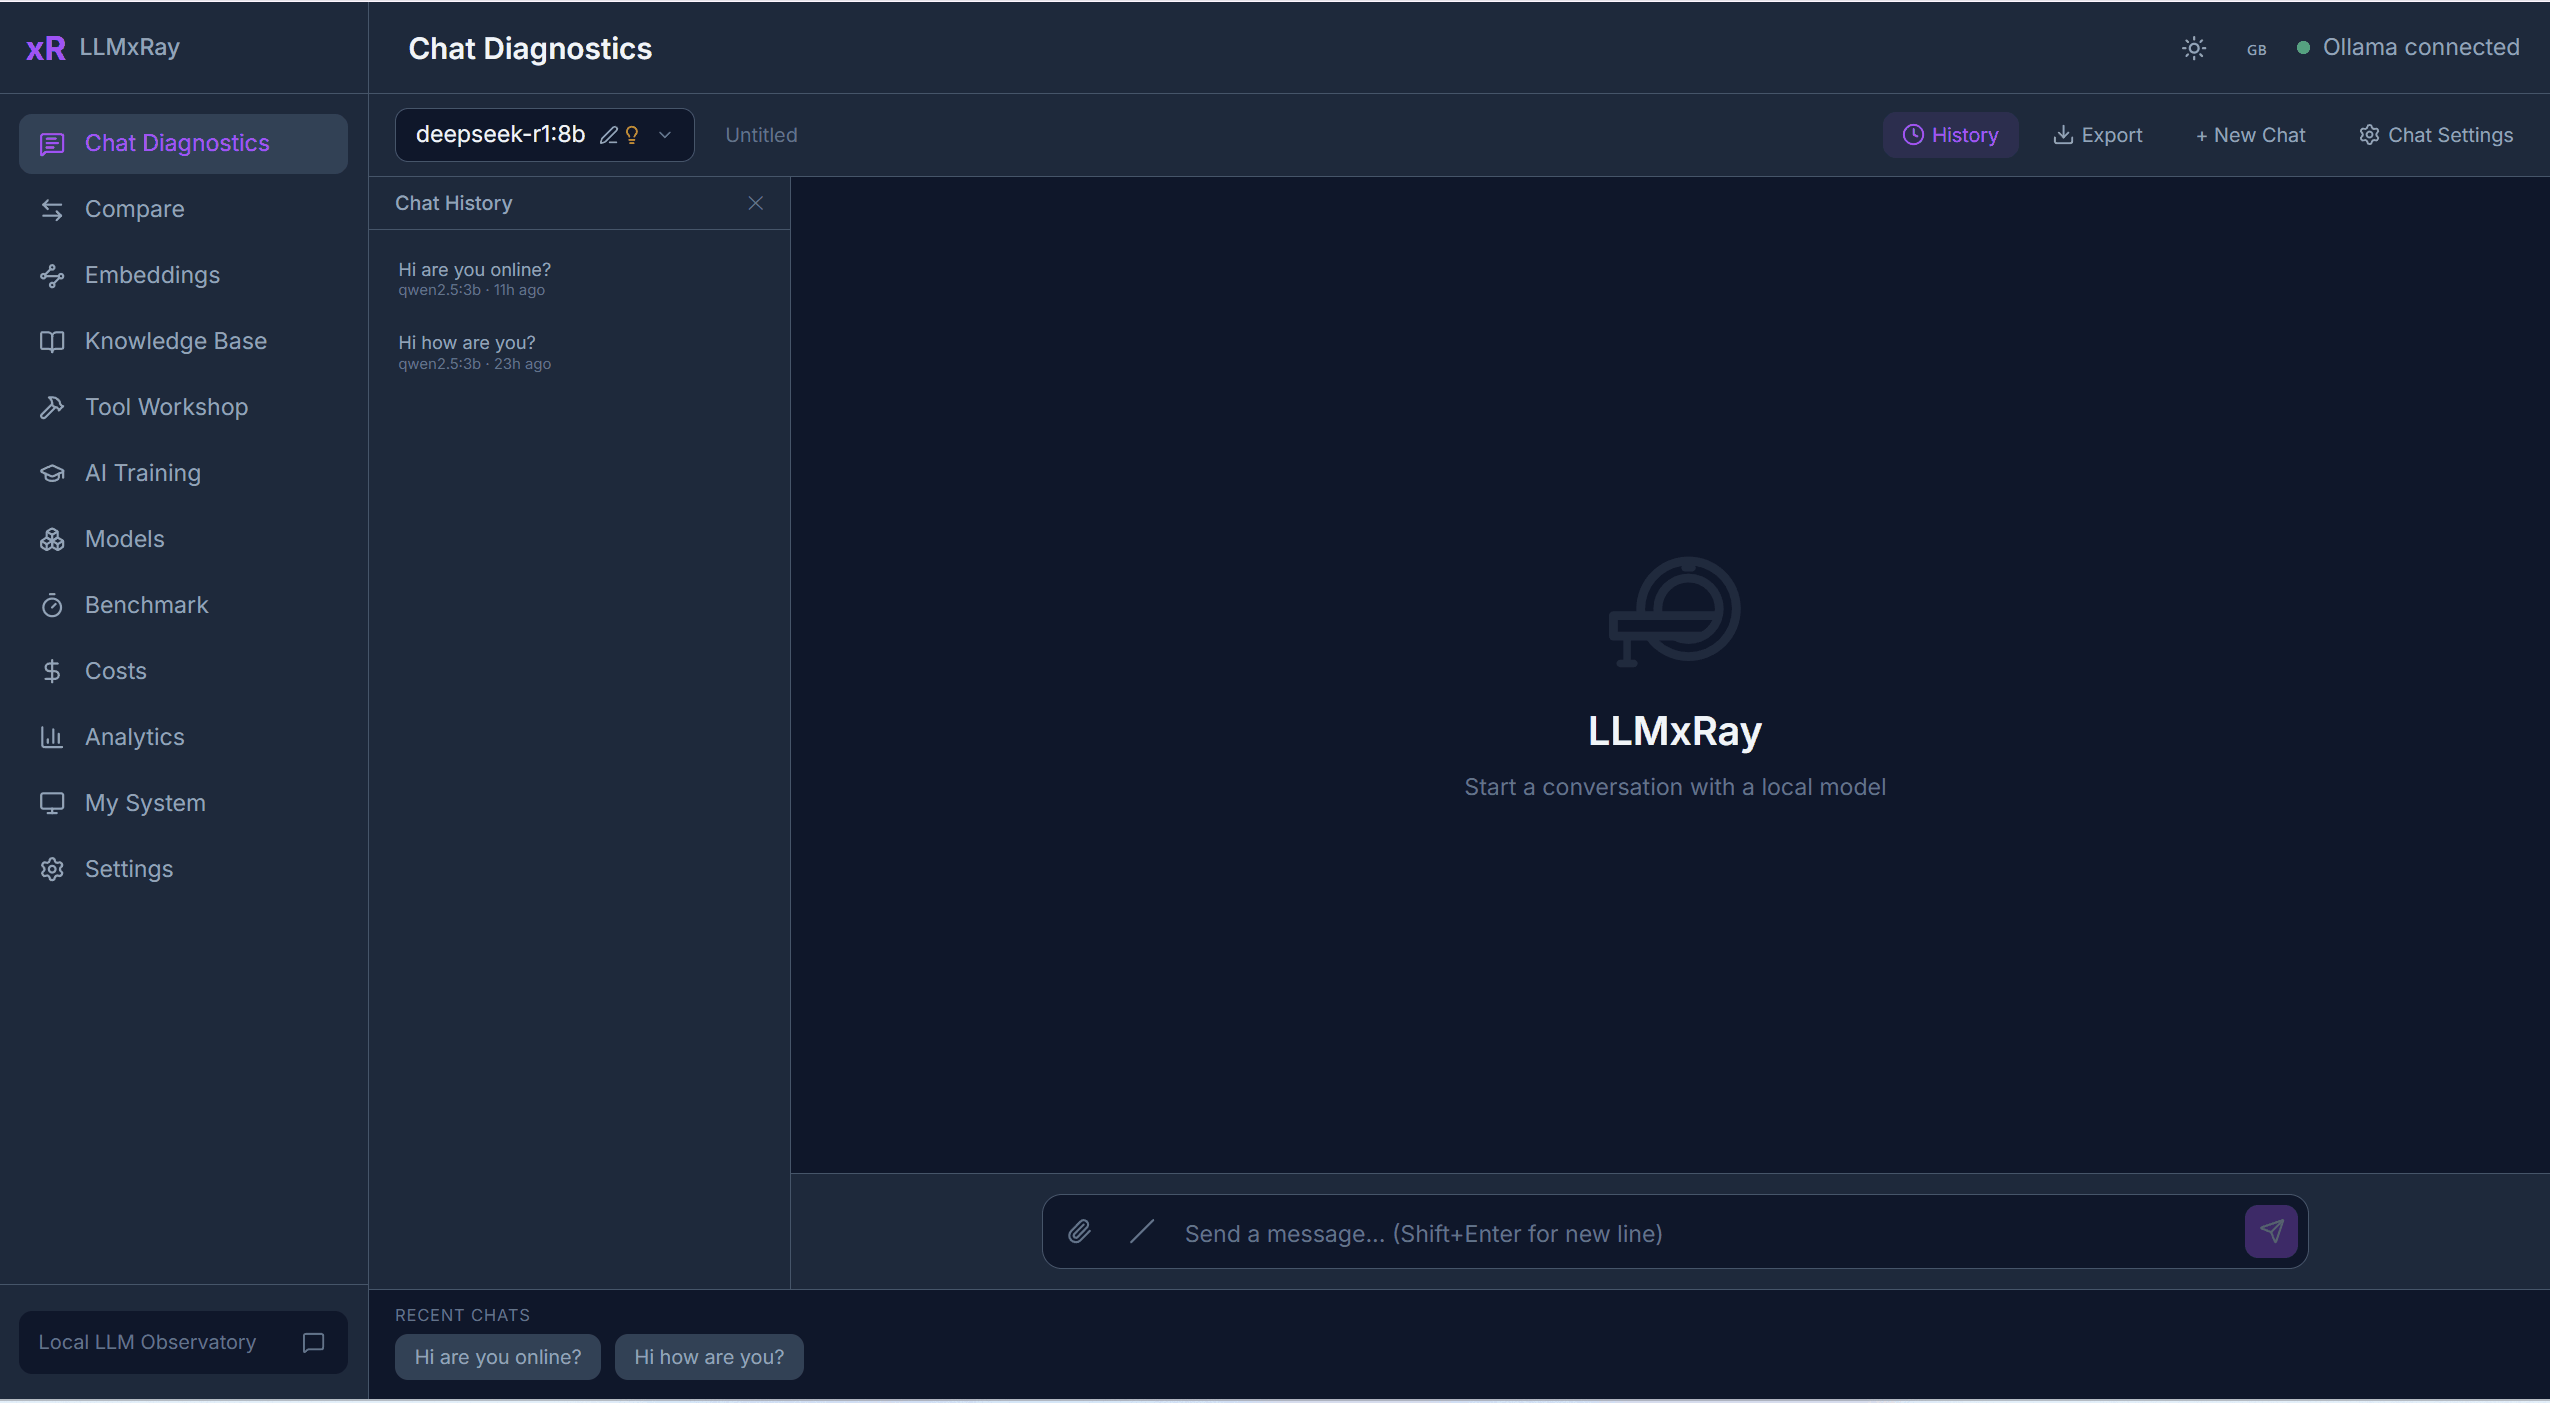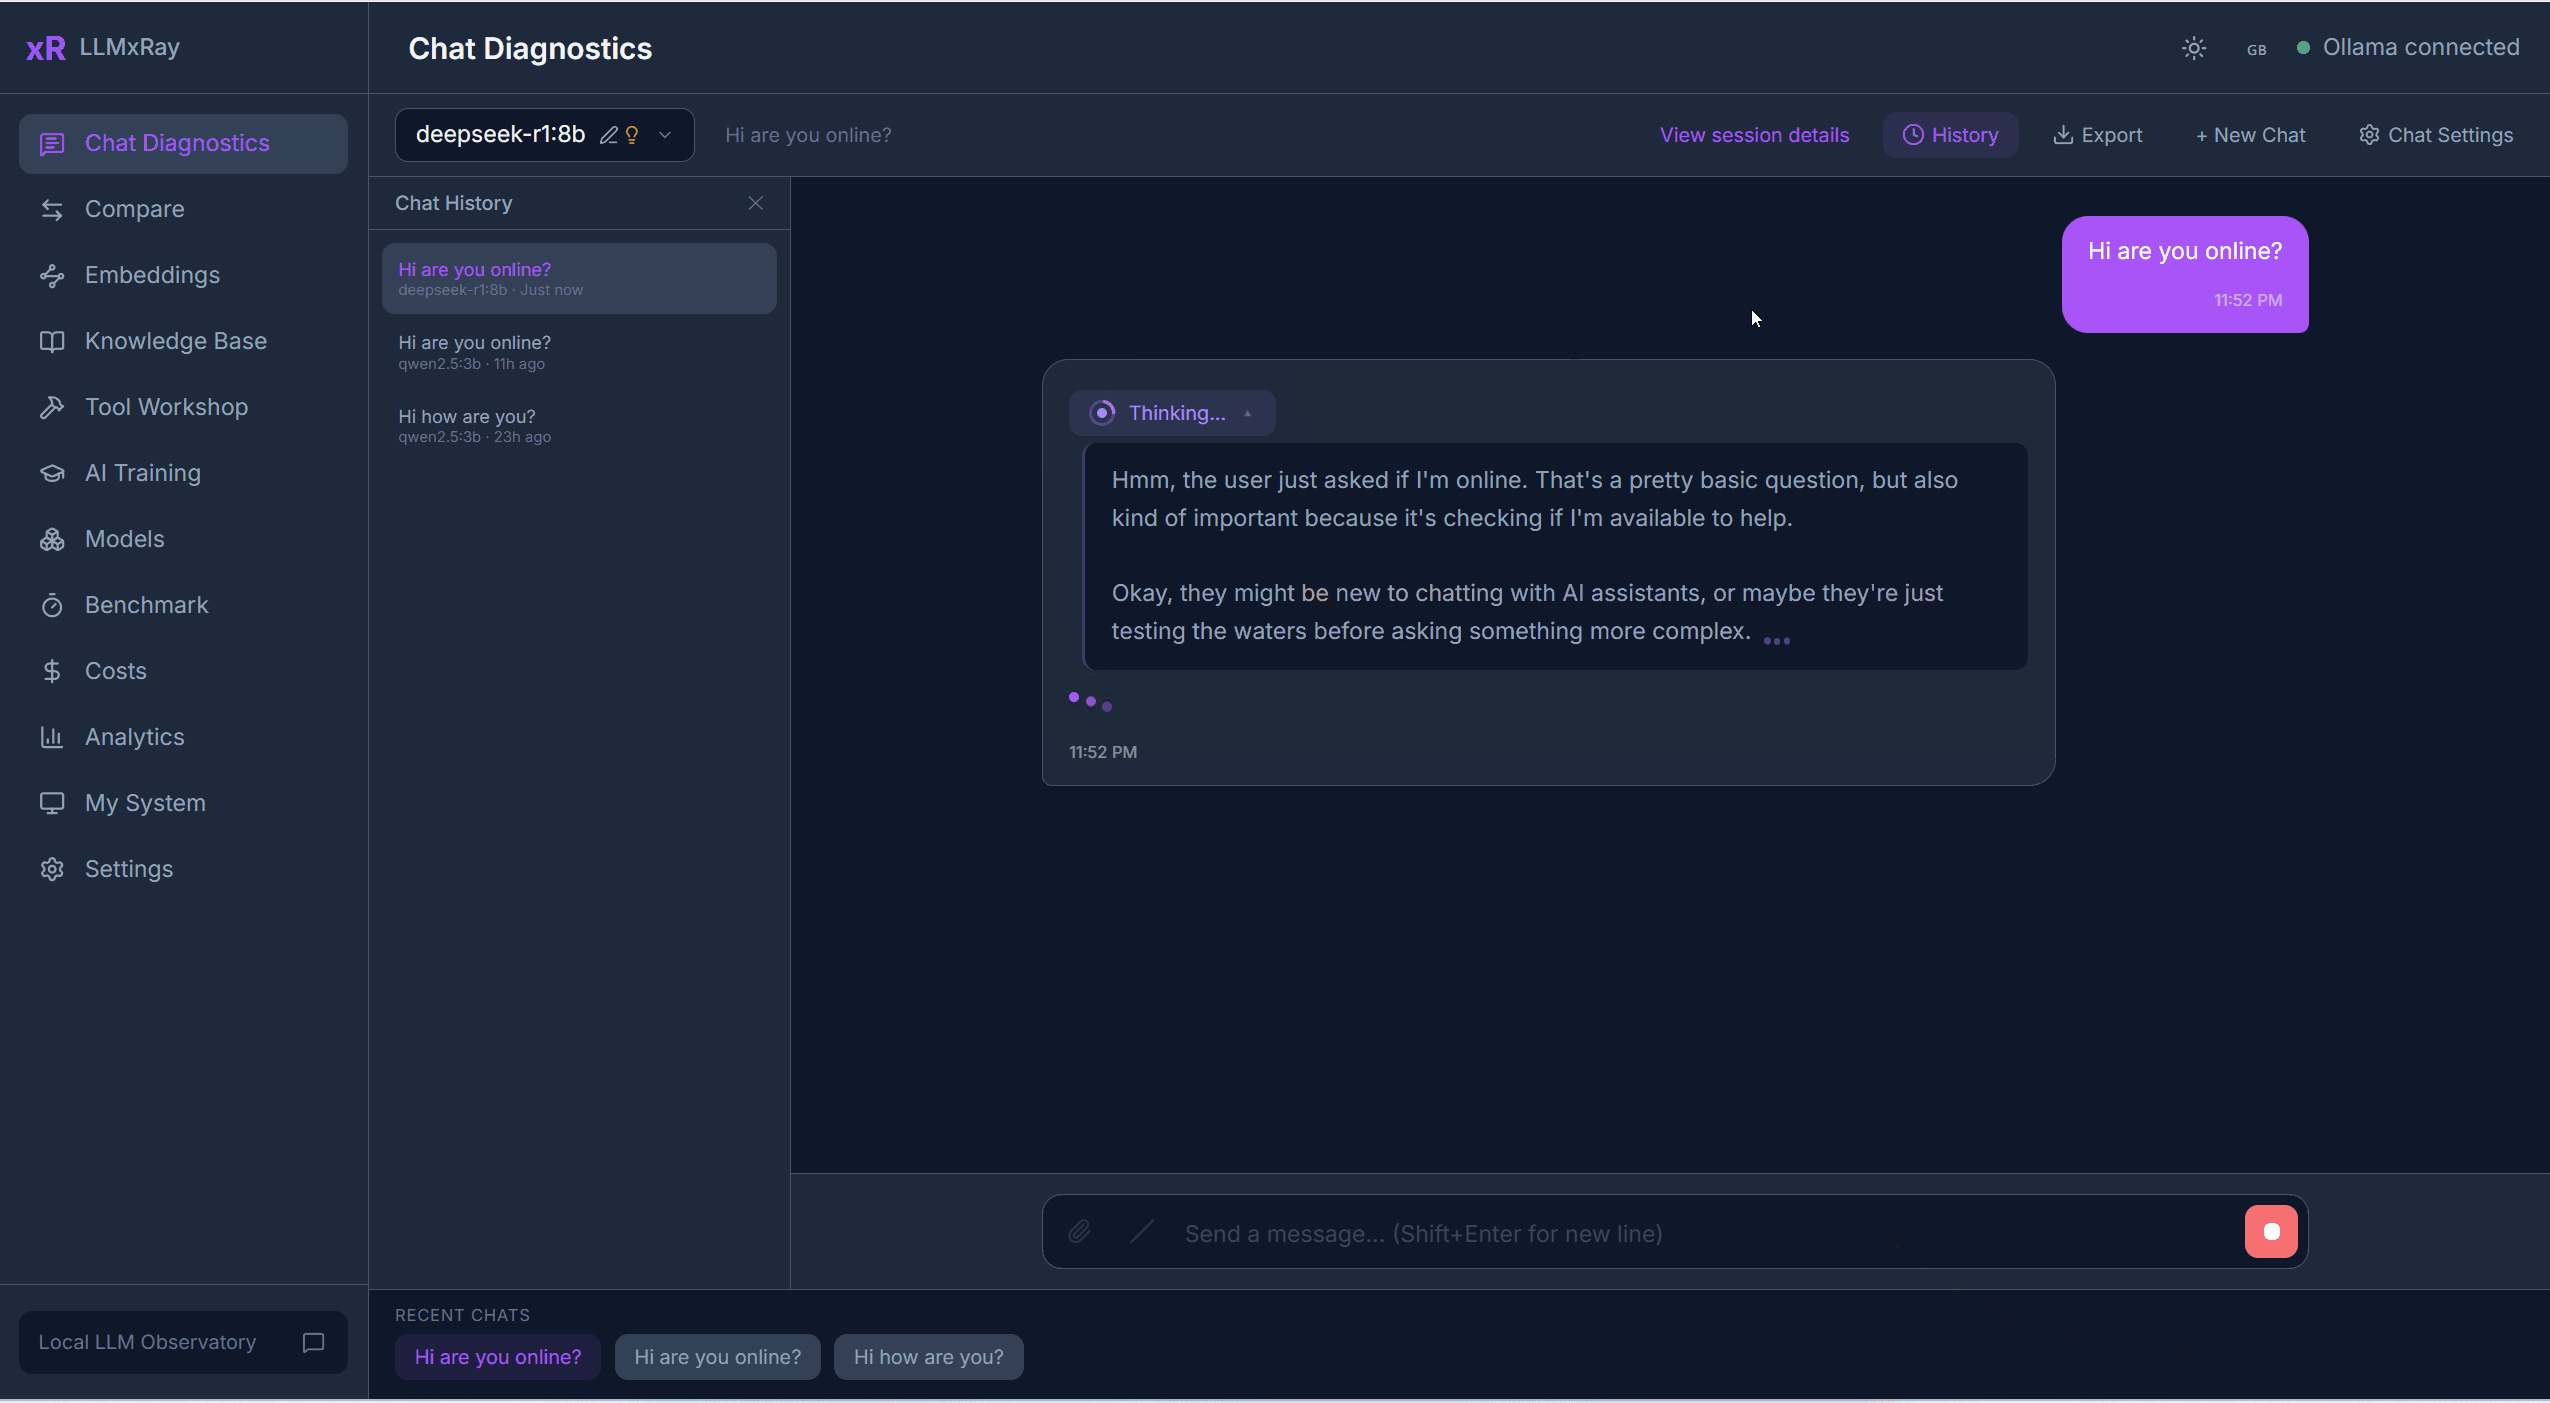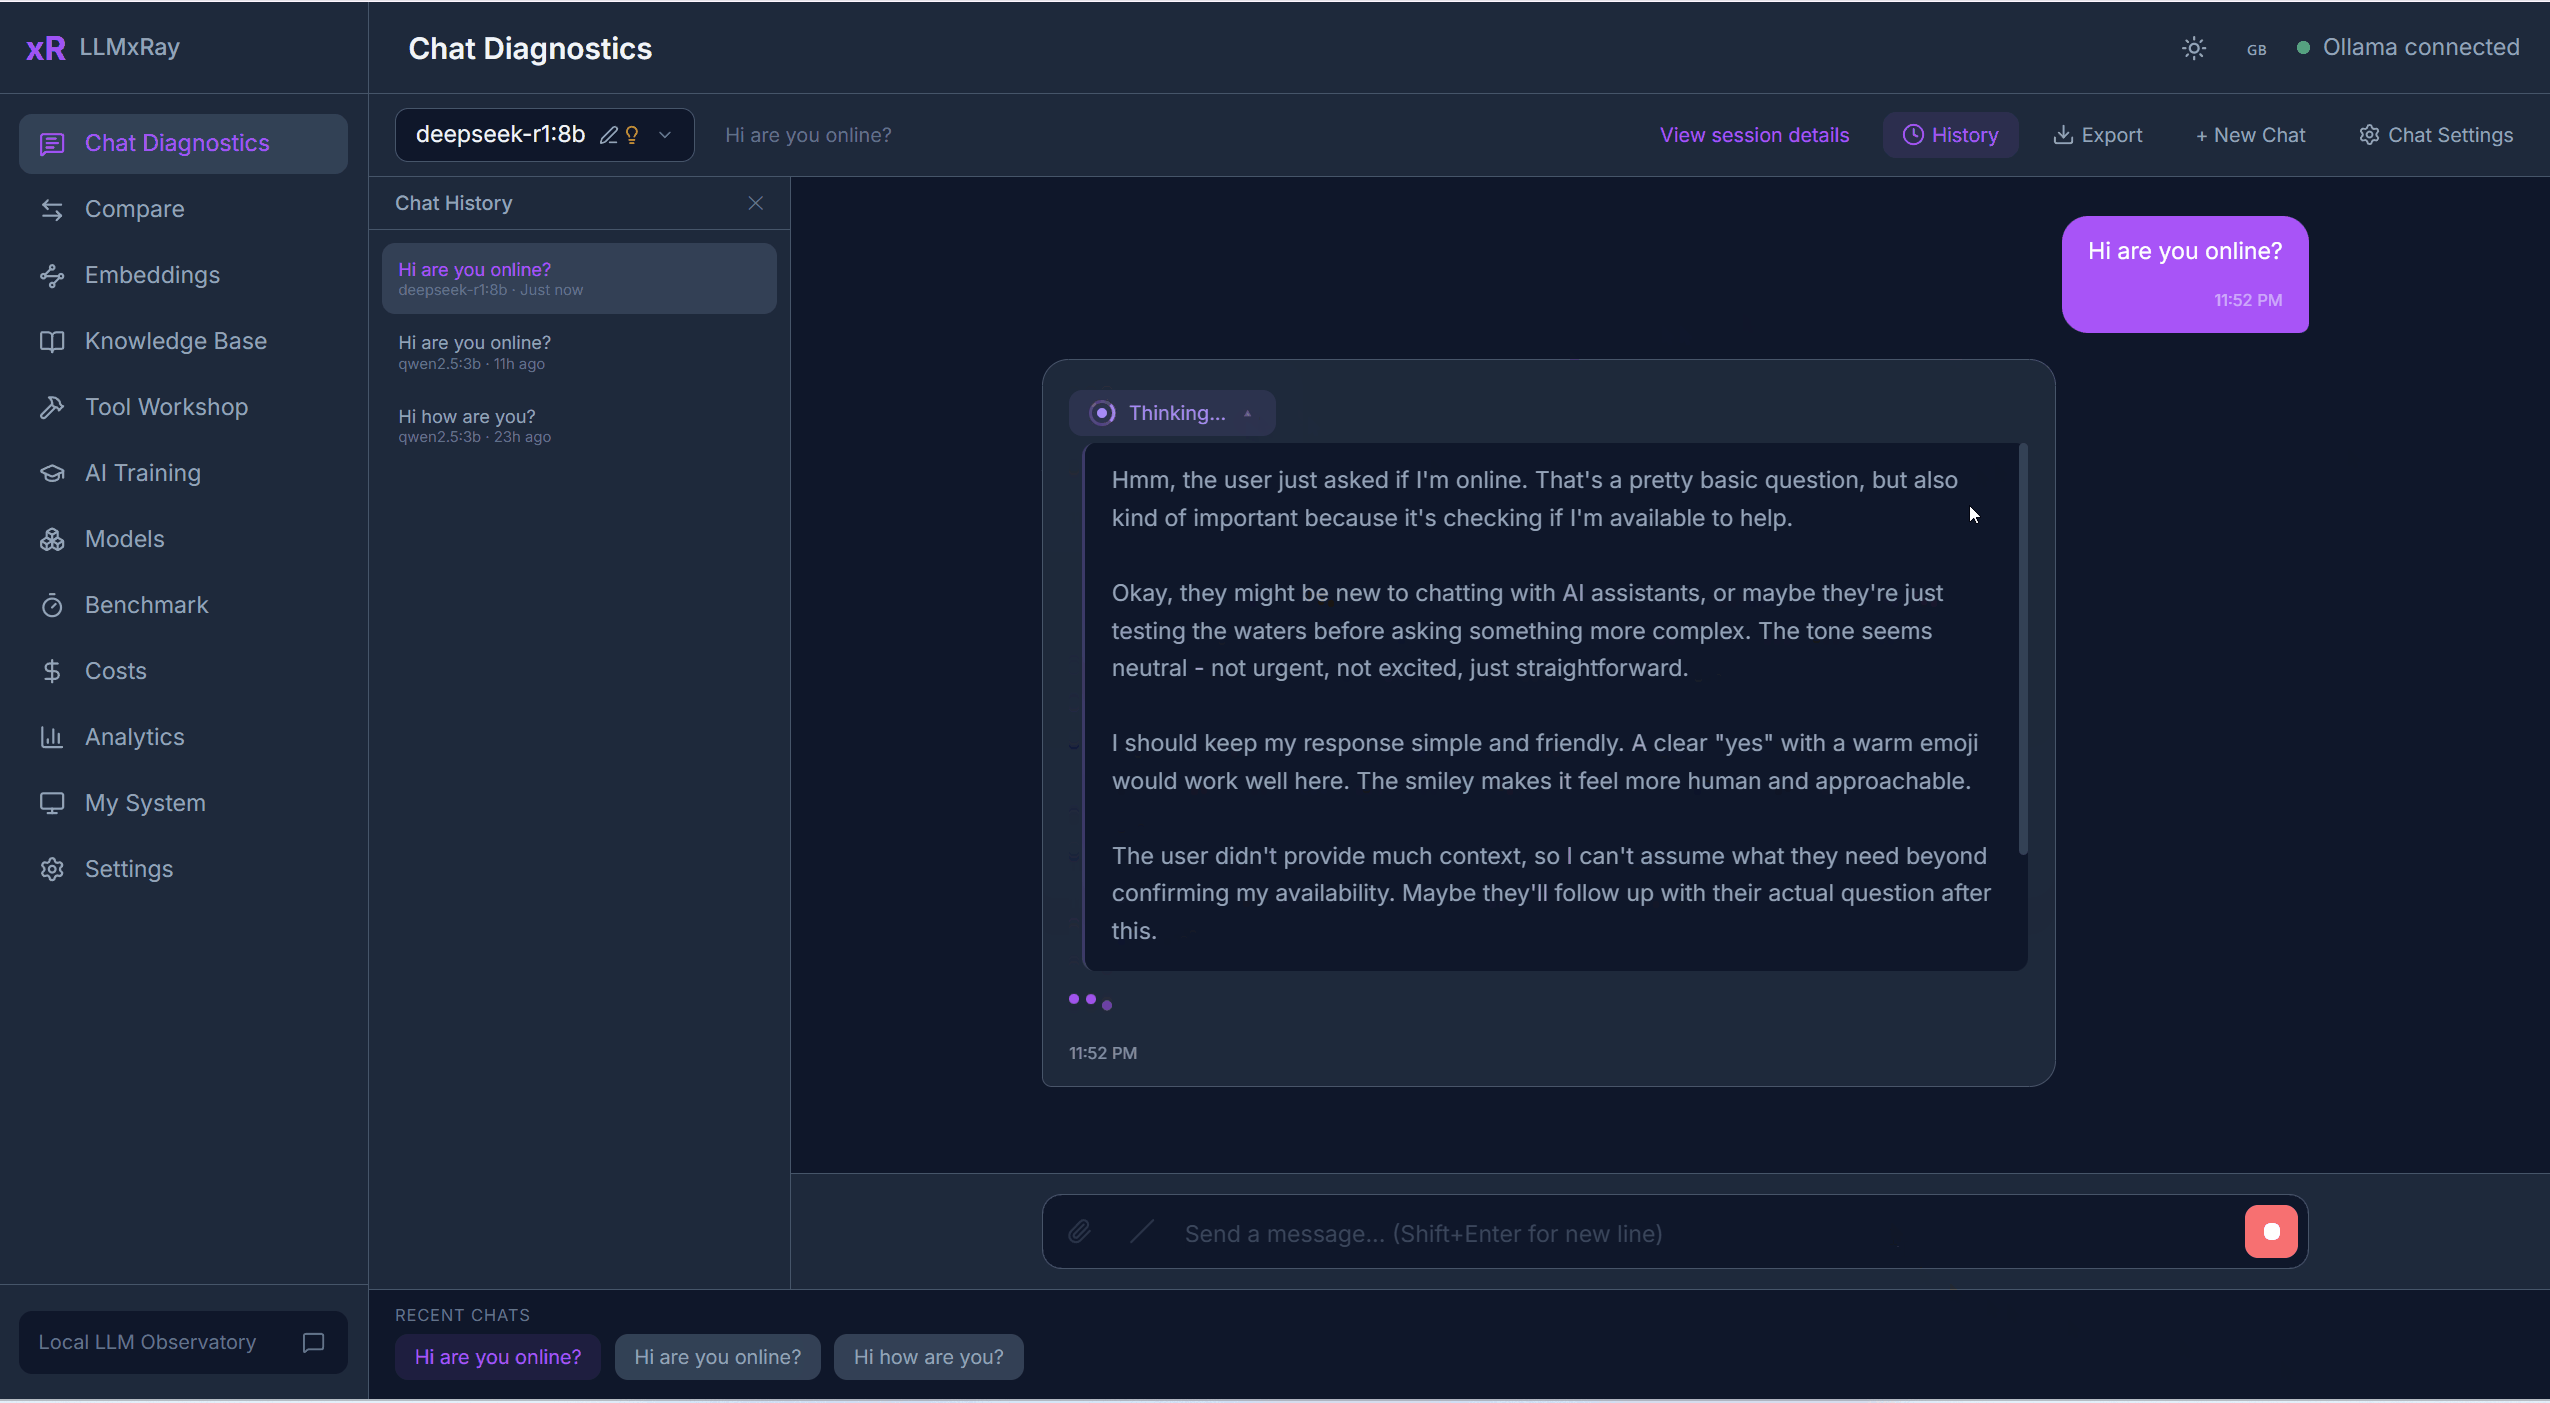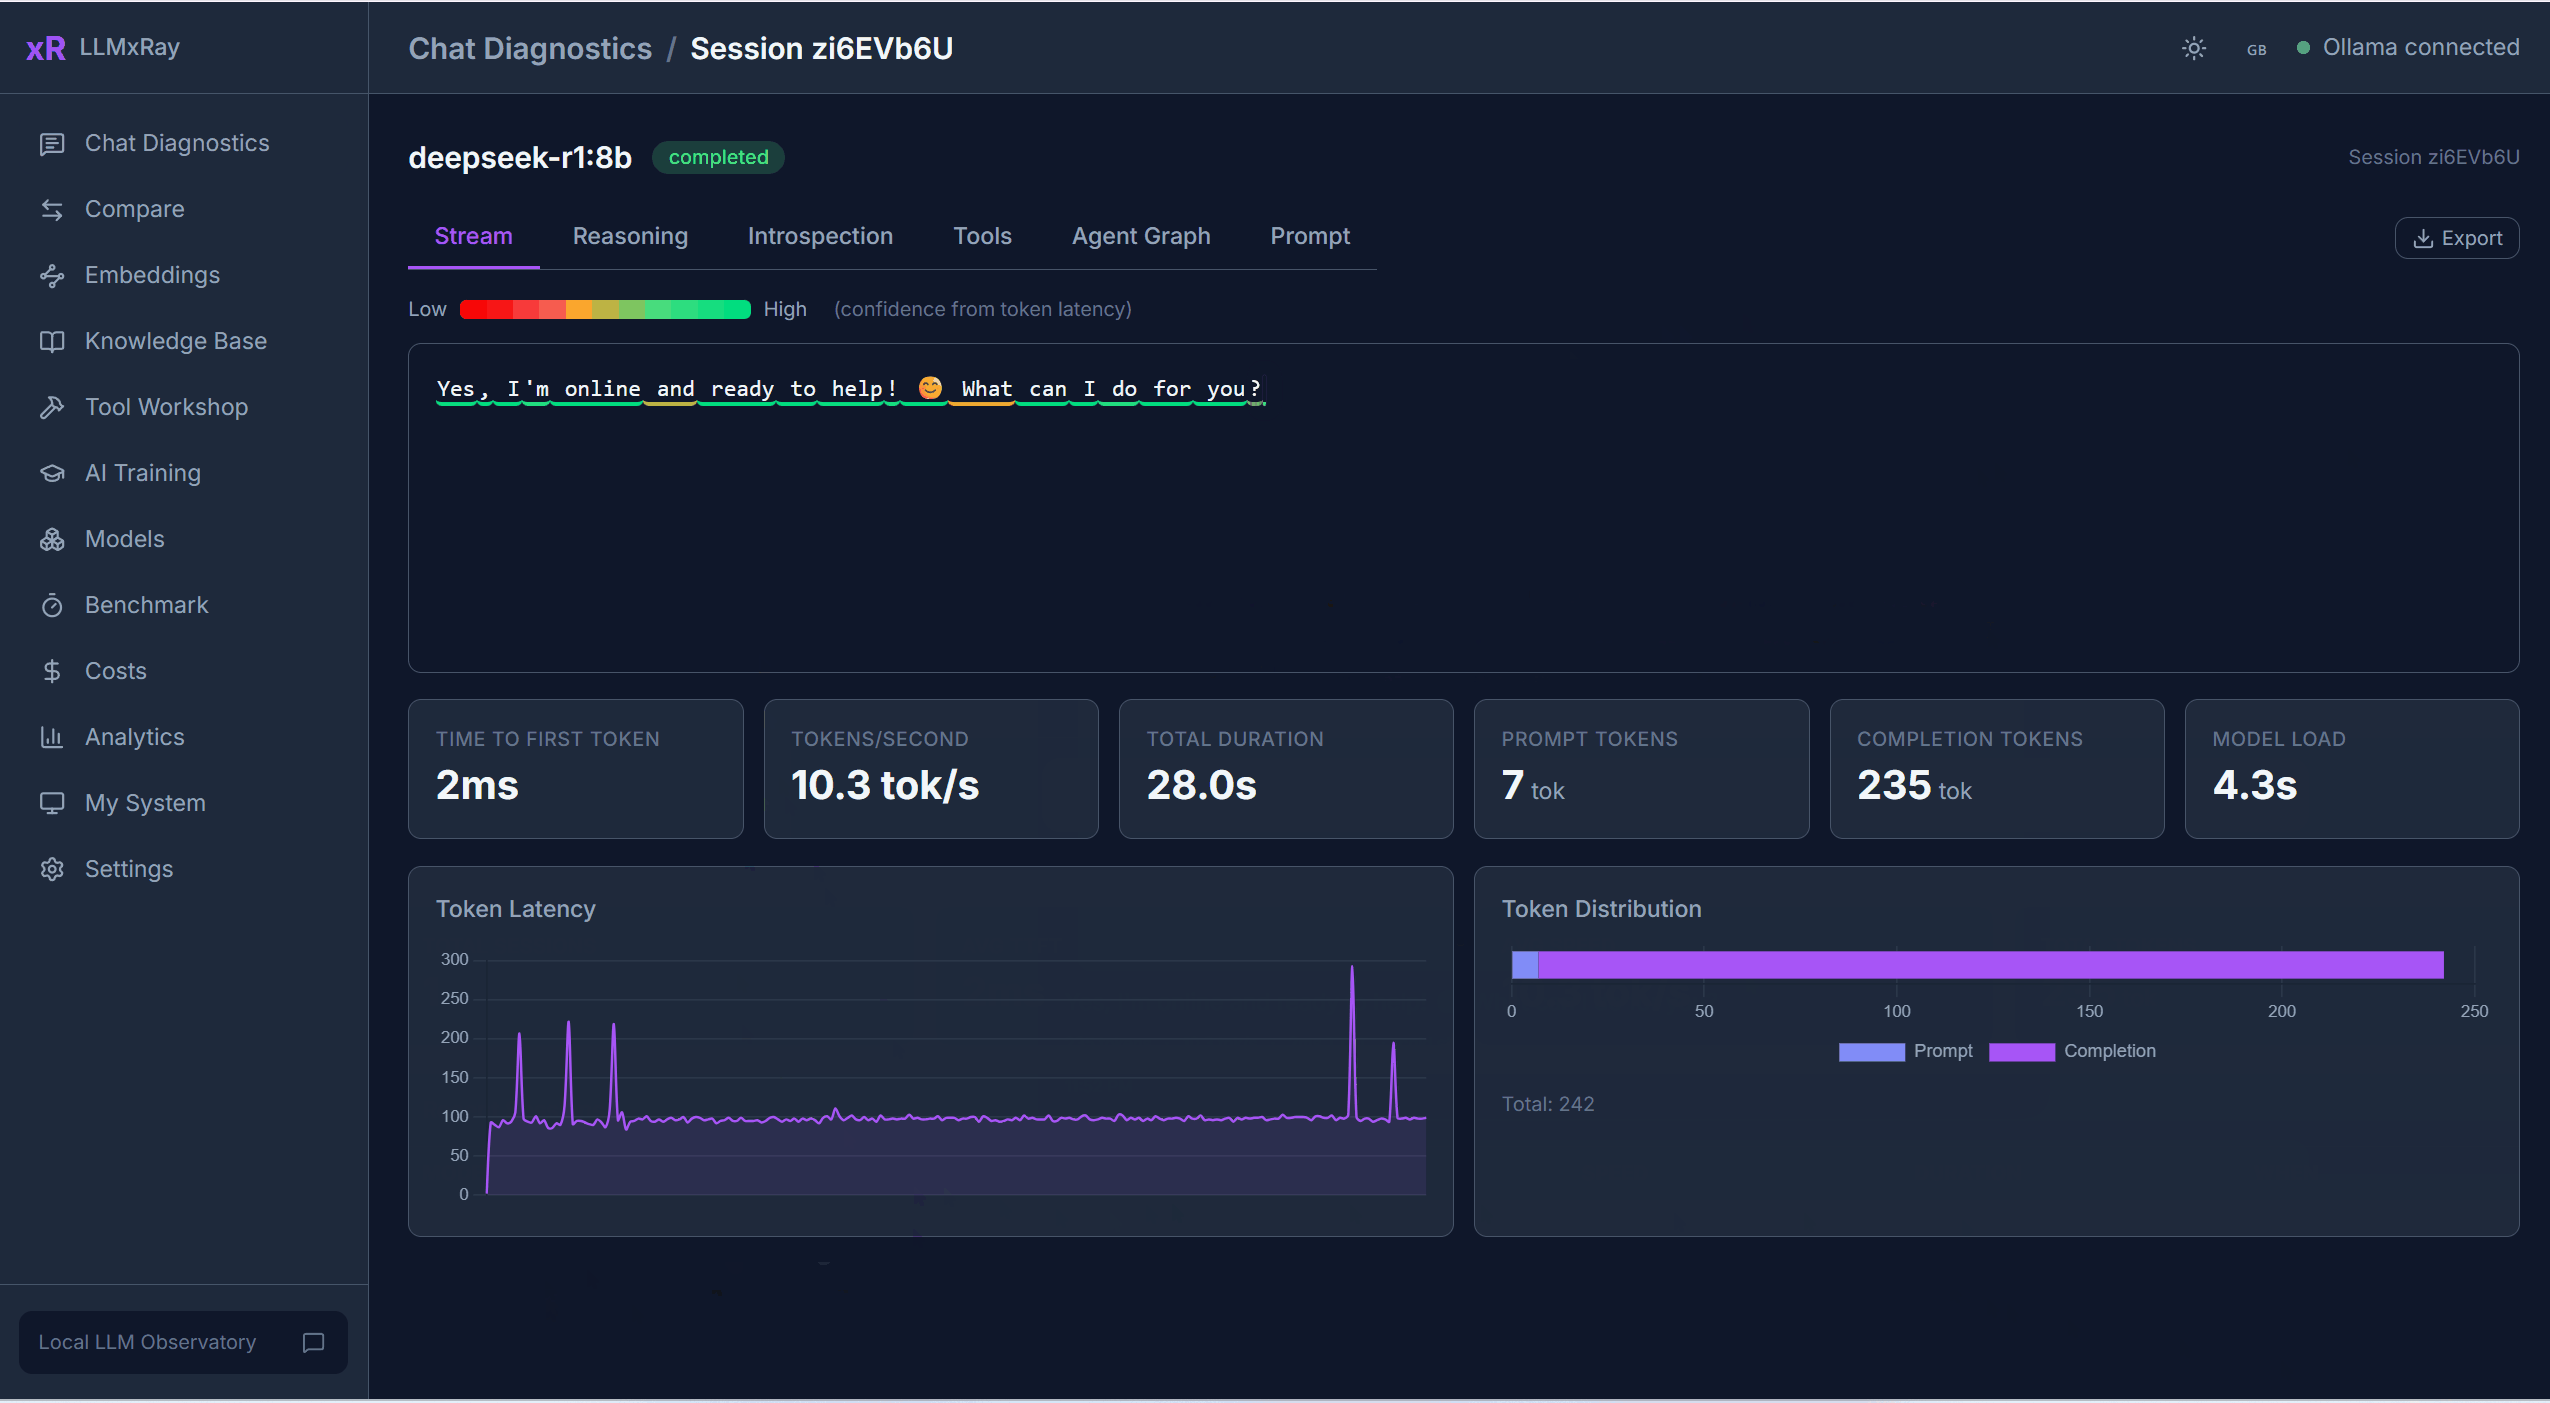
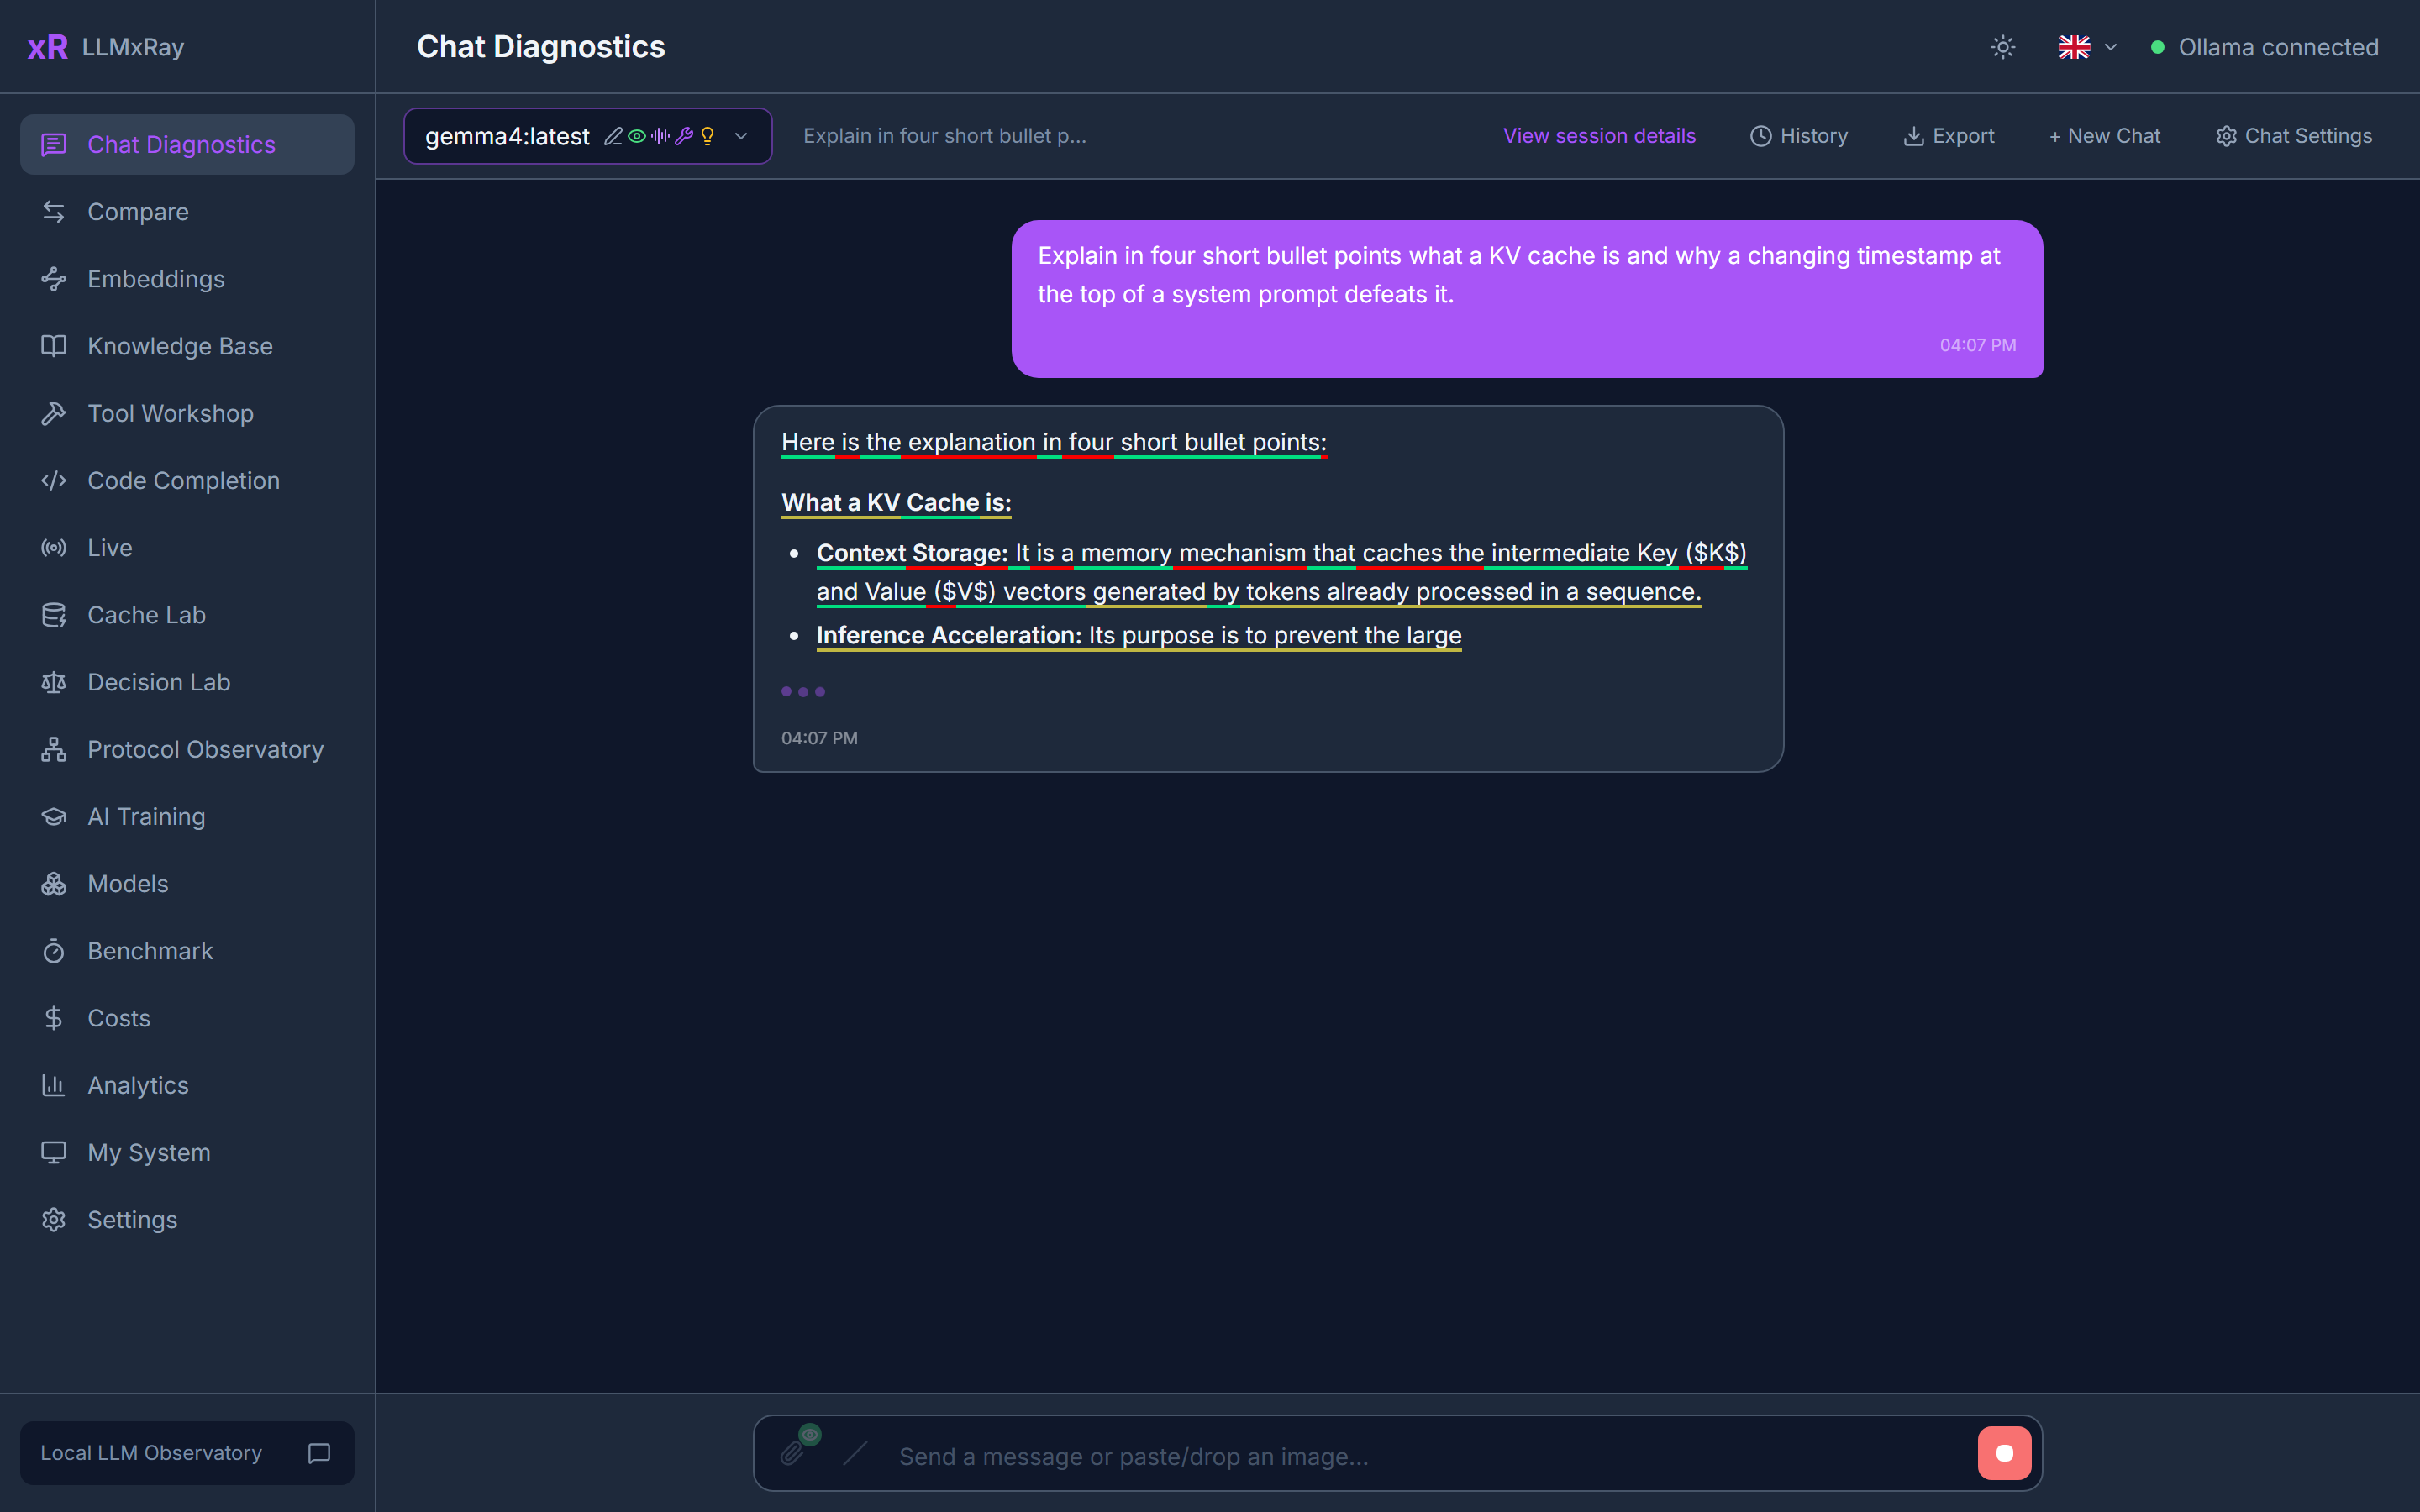
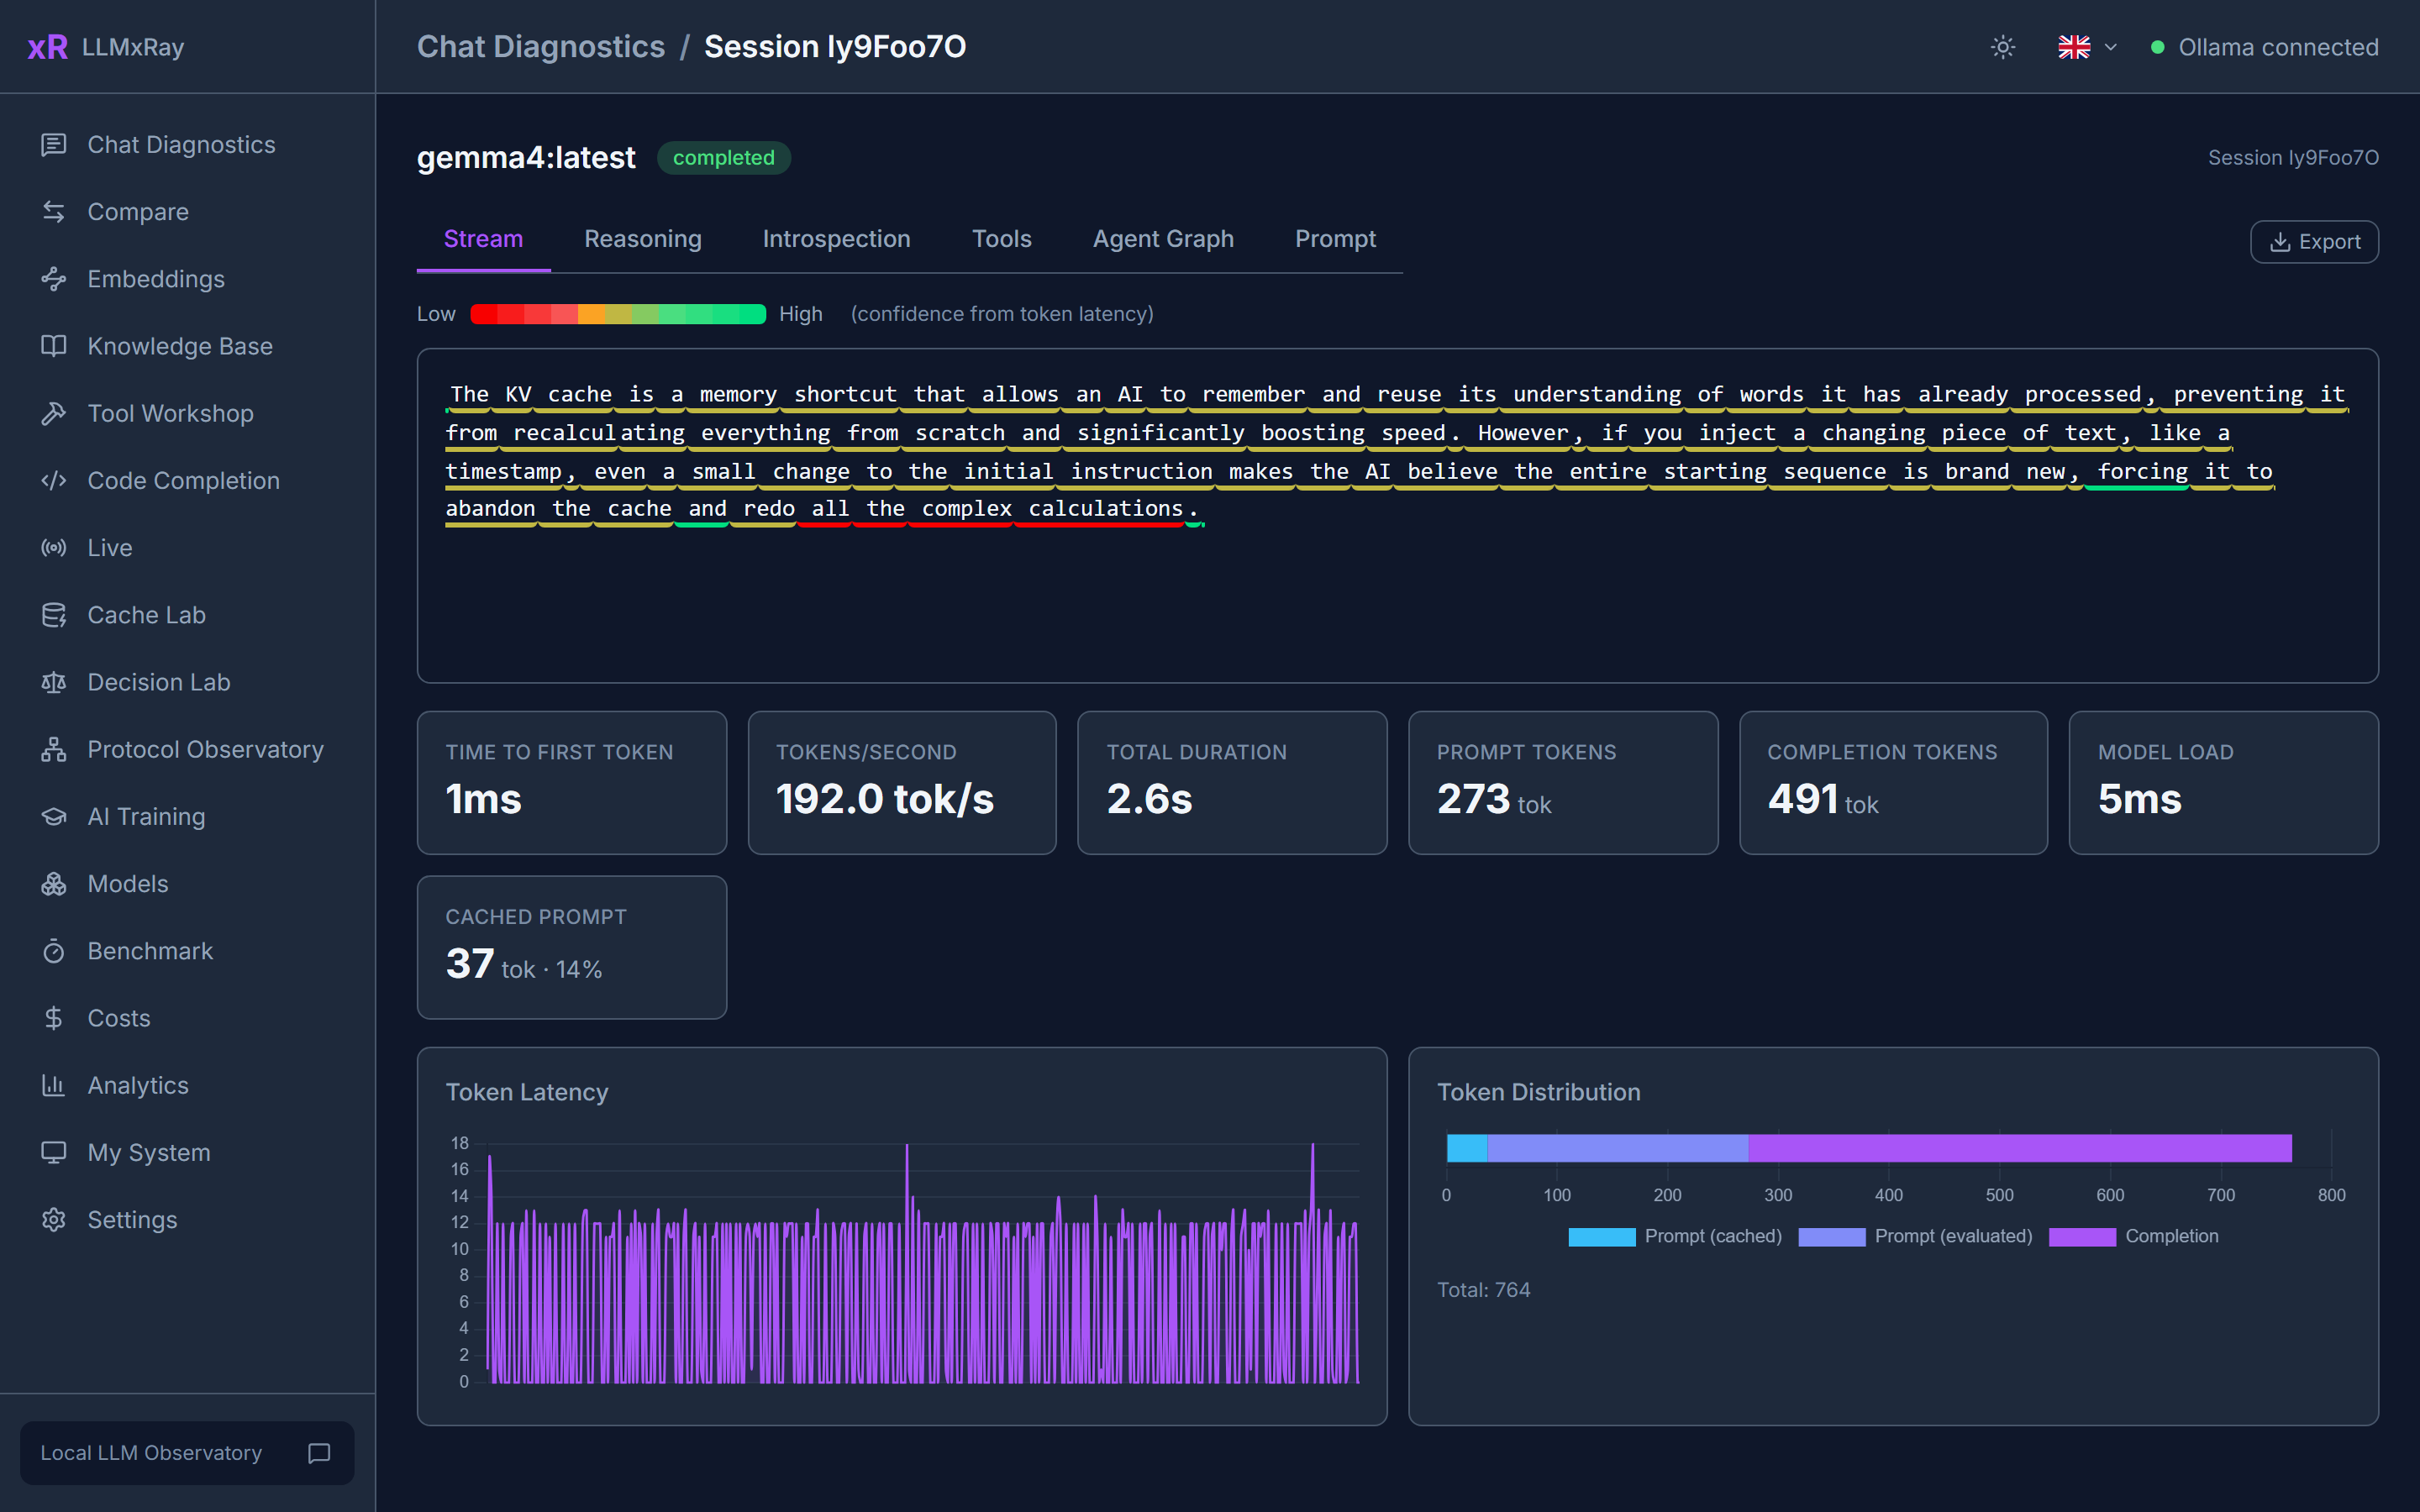
Chaque token est dessiné à son arrivée, coloré selon la probabilité que le modèle lui donne, d'après les logprobs d'Ollama. Vous voyez où le modèle a hésité et où il était sûr. Markdown, conversations multi-tours, pièces jointes et images, commandes slash, et un budget de réflexion pour les modèles à raisonnement (désactivé, au choix du modèle, ou low / medium / high / max).
Chaque réponse est aussi vérifiée à l'arrivée. Un badge n'apparaît que si quelque chose cloche : répétition, refus, charabia, réponse vide, ou réponse coupée à la limite de tokens.
Capture d'écran
Capture d'écran
Capture d'écran
Capture d'écran
Capture d'écran
Capture d'écran
|
|
|
Capture d'écran
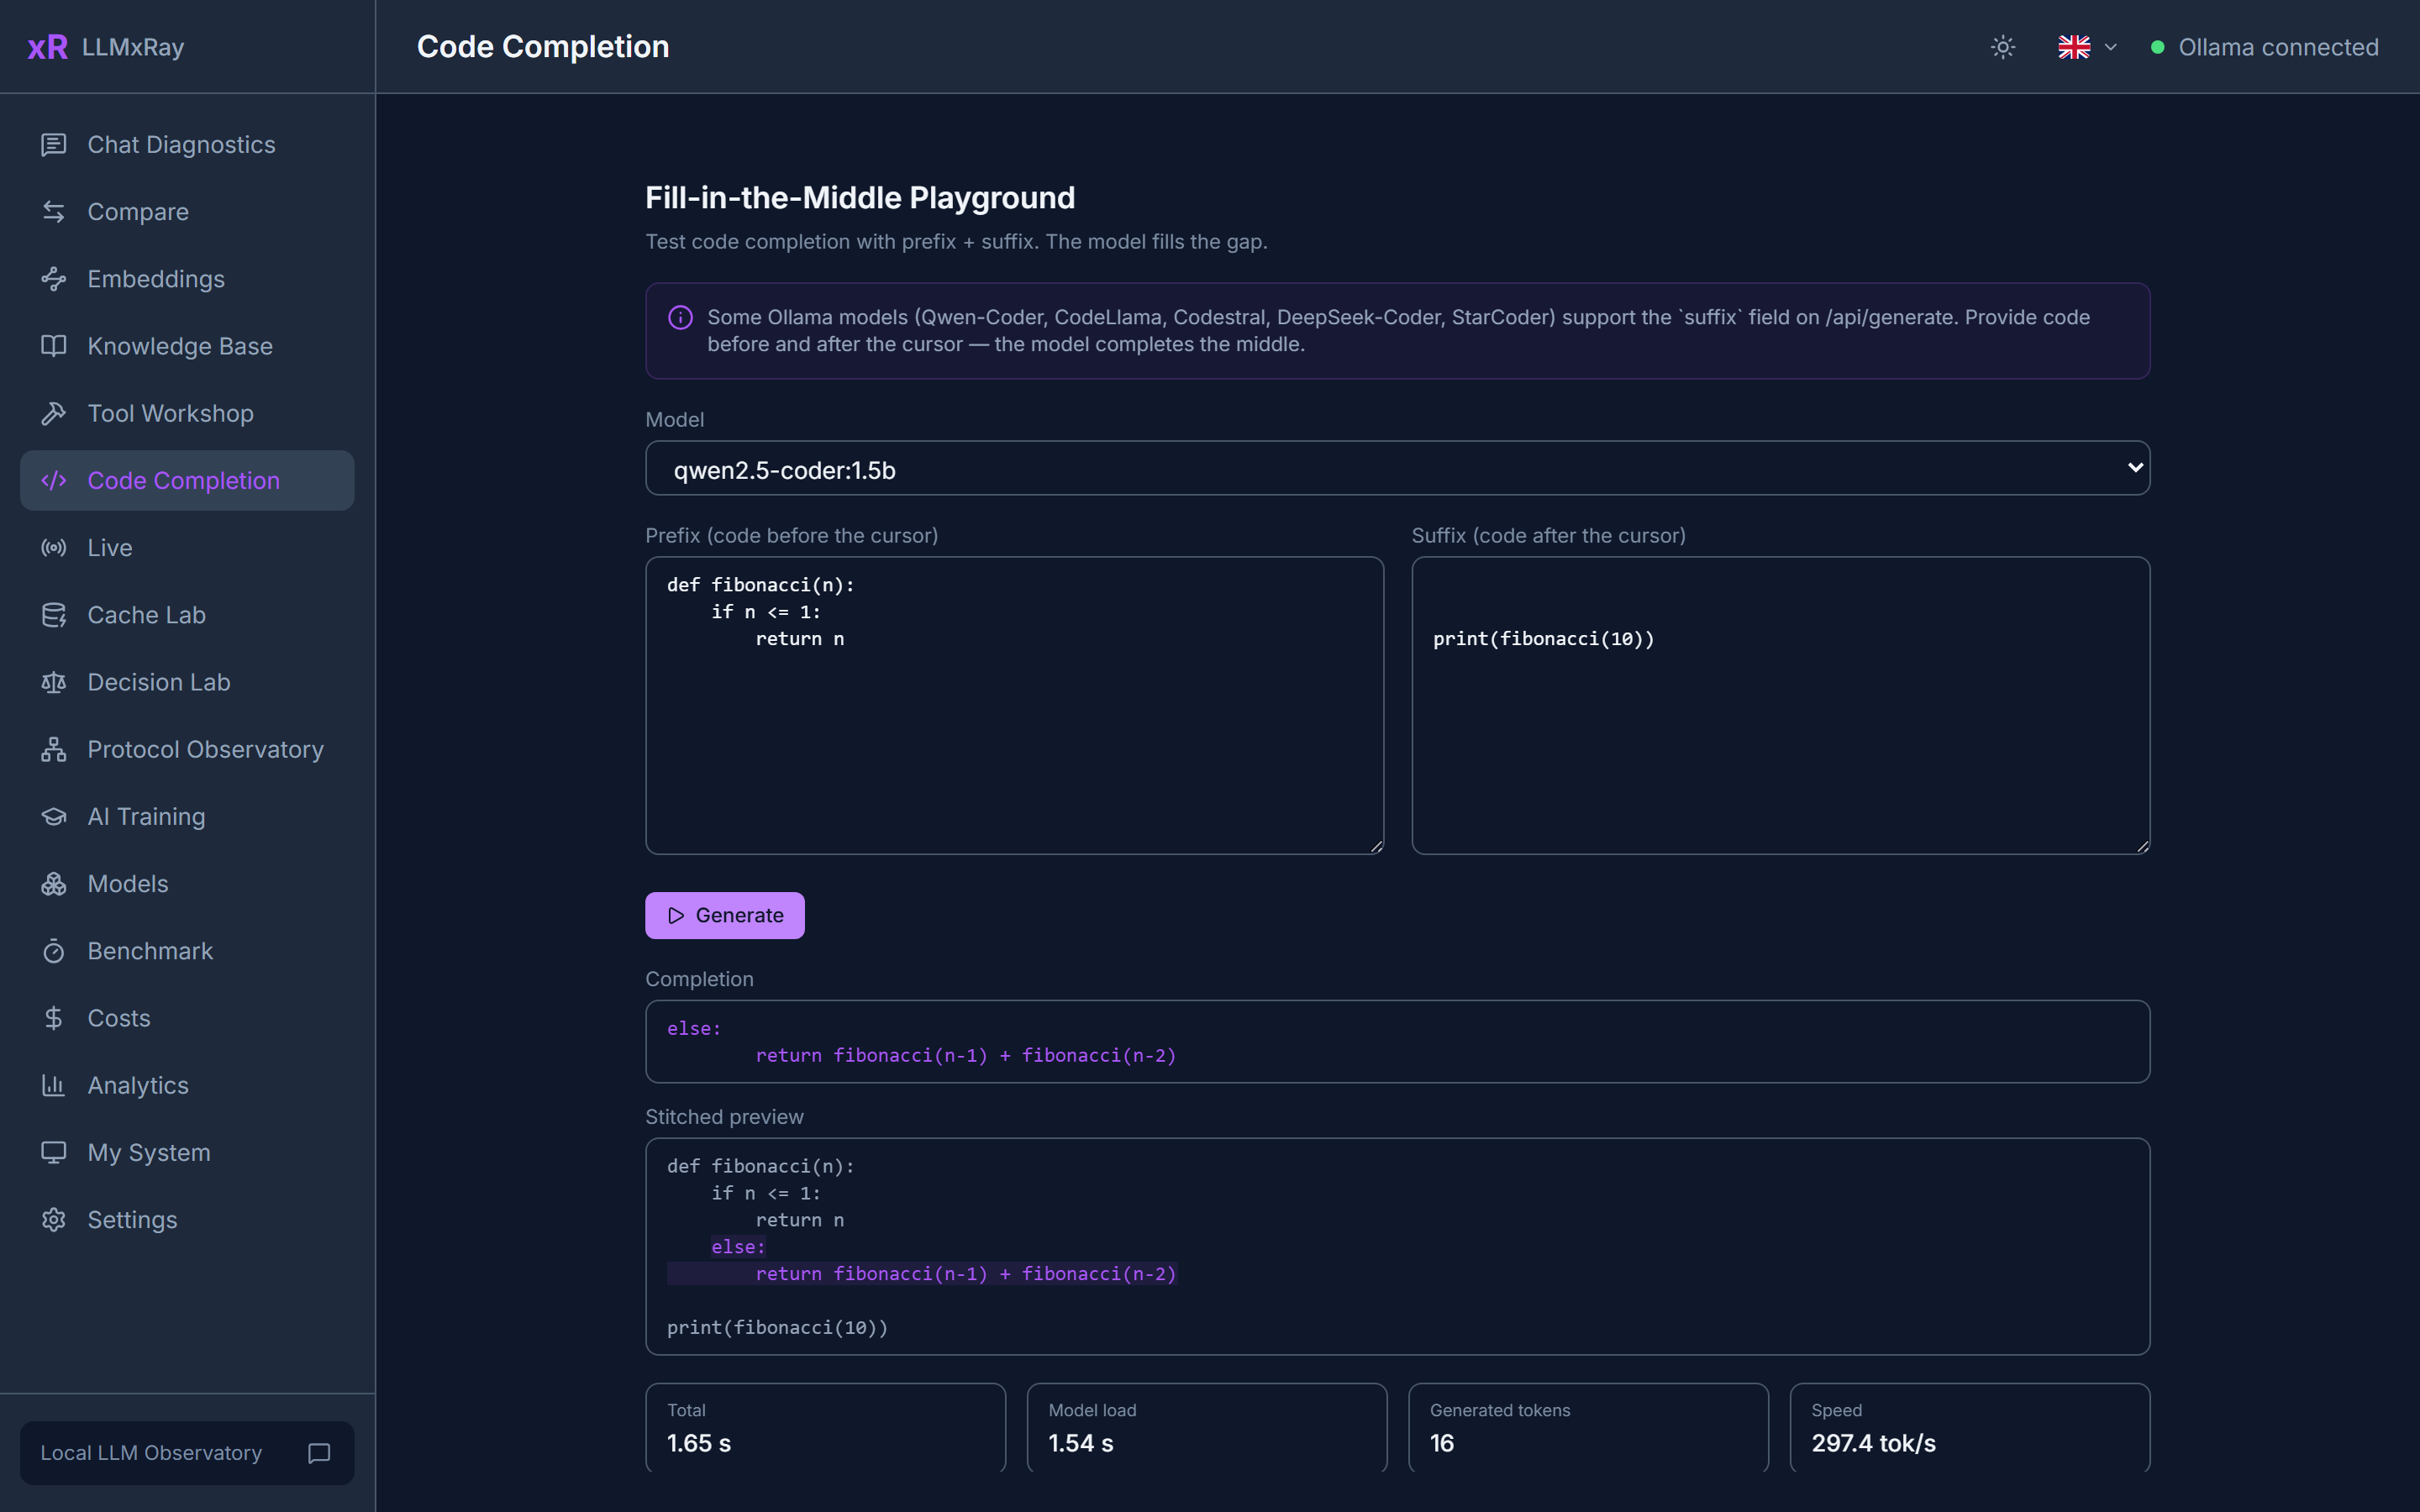
Capture d'écran
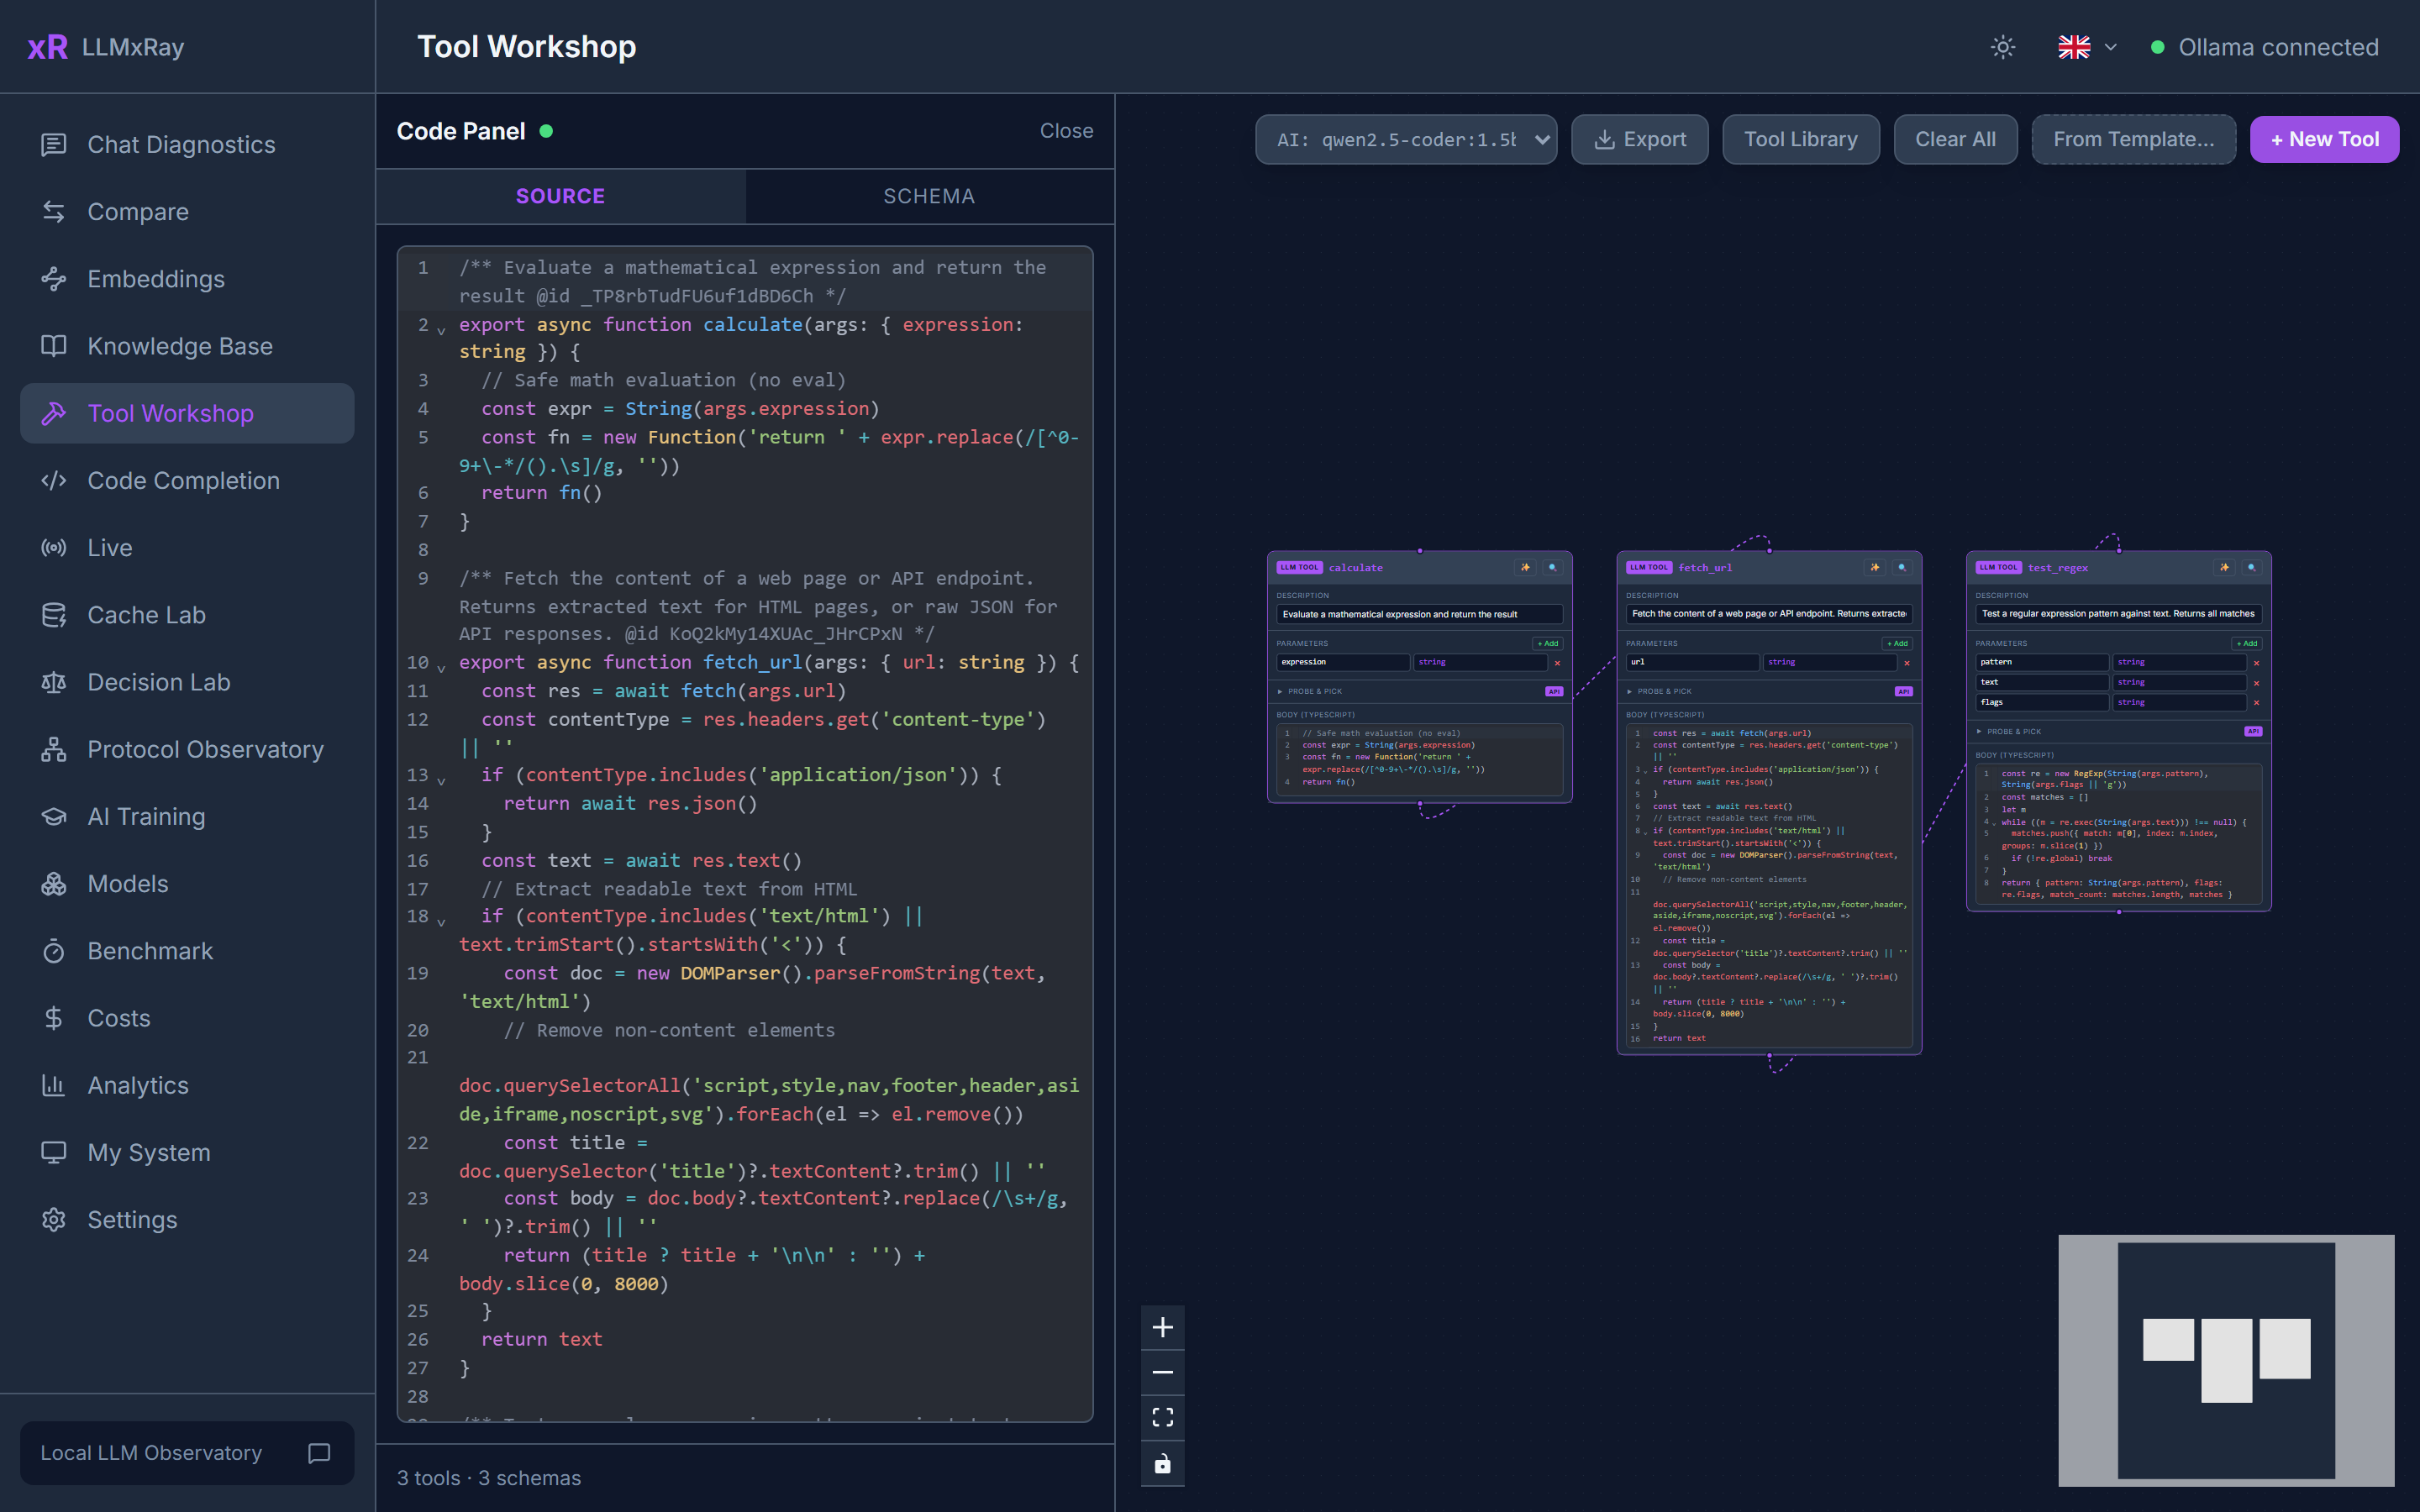
Capture d'écran
|
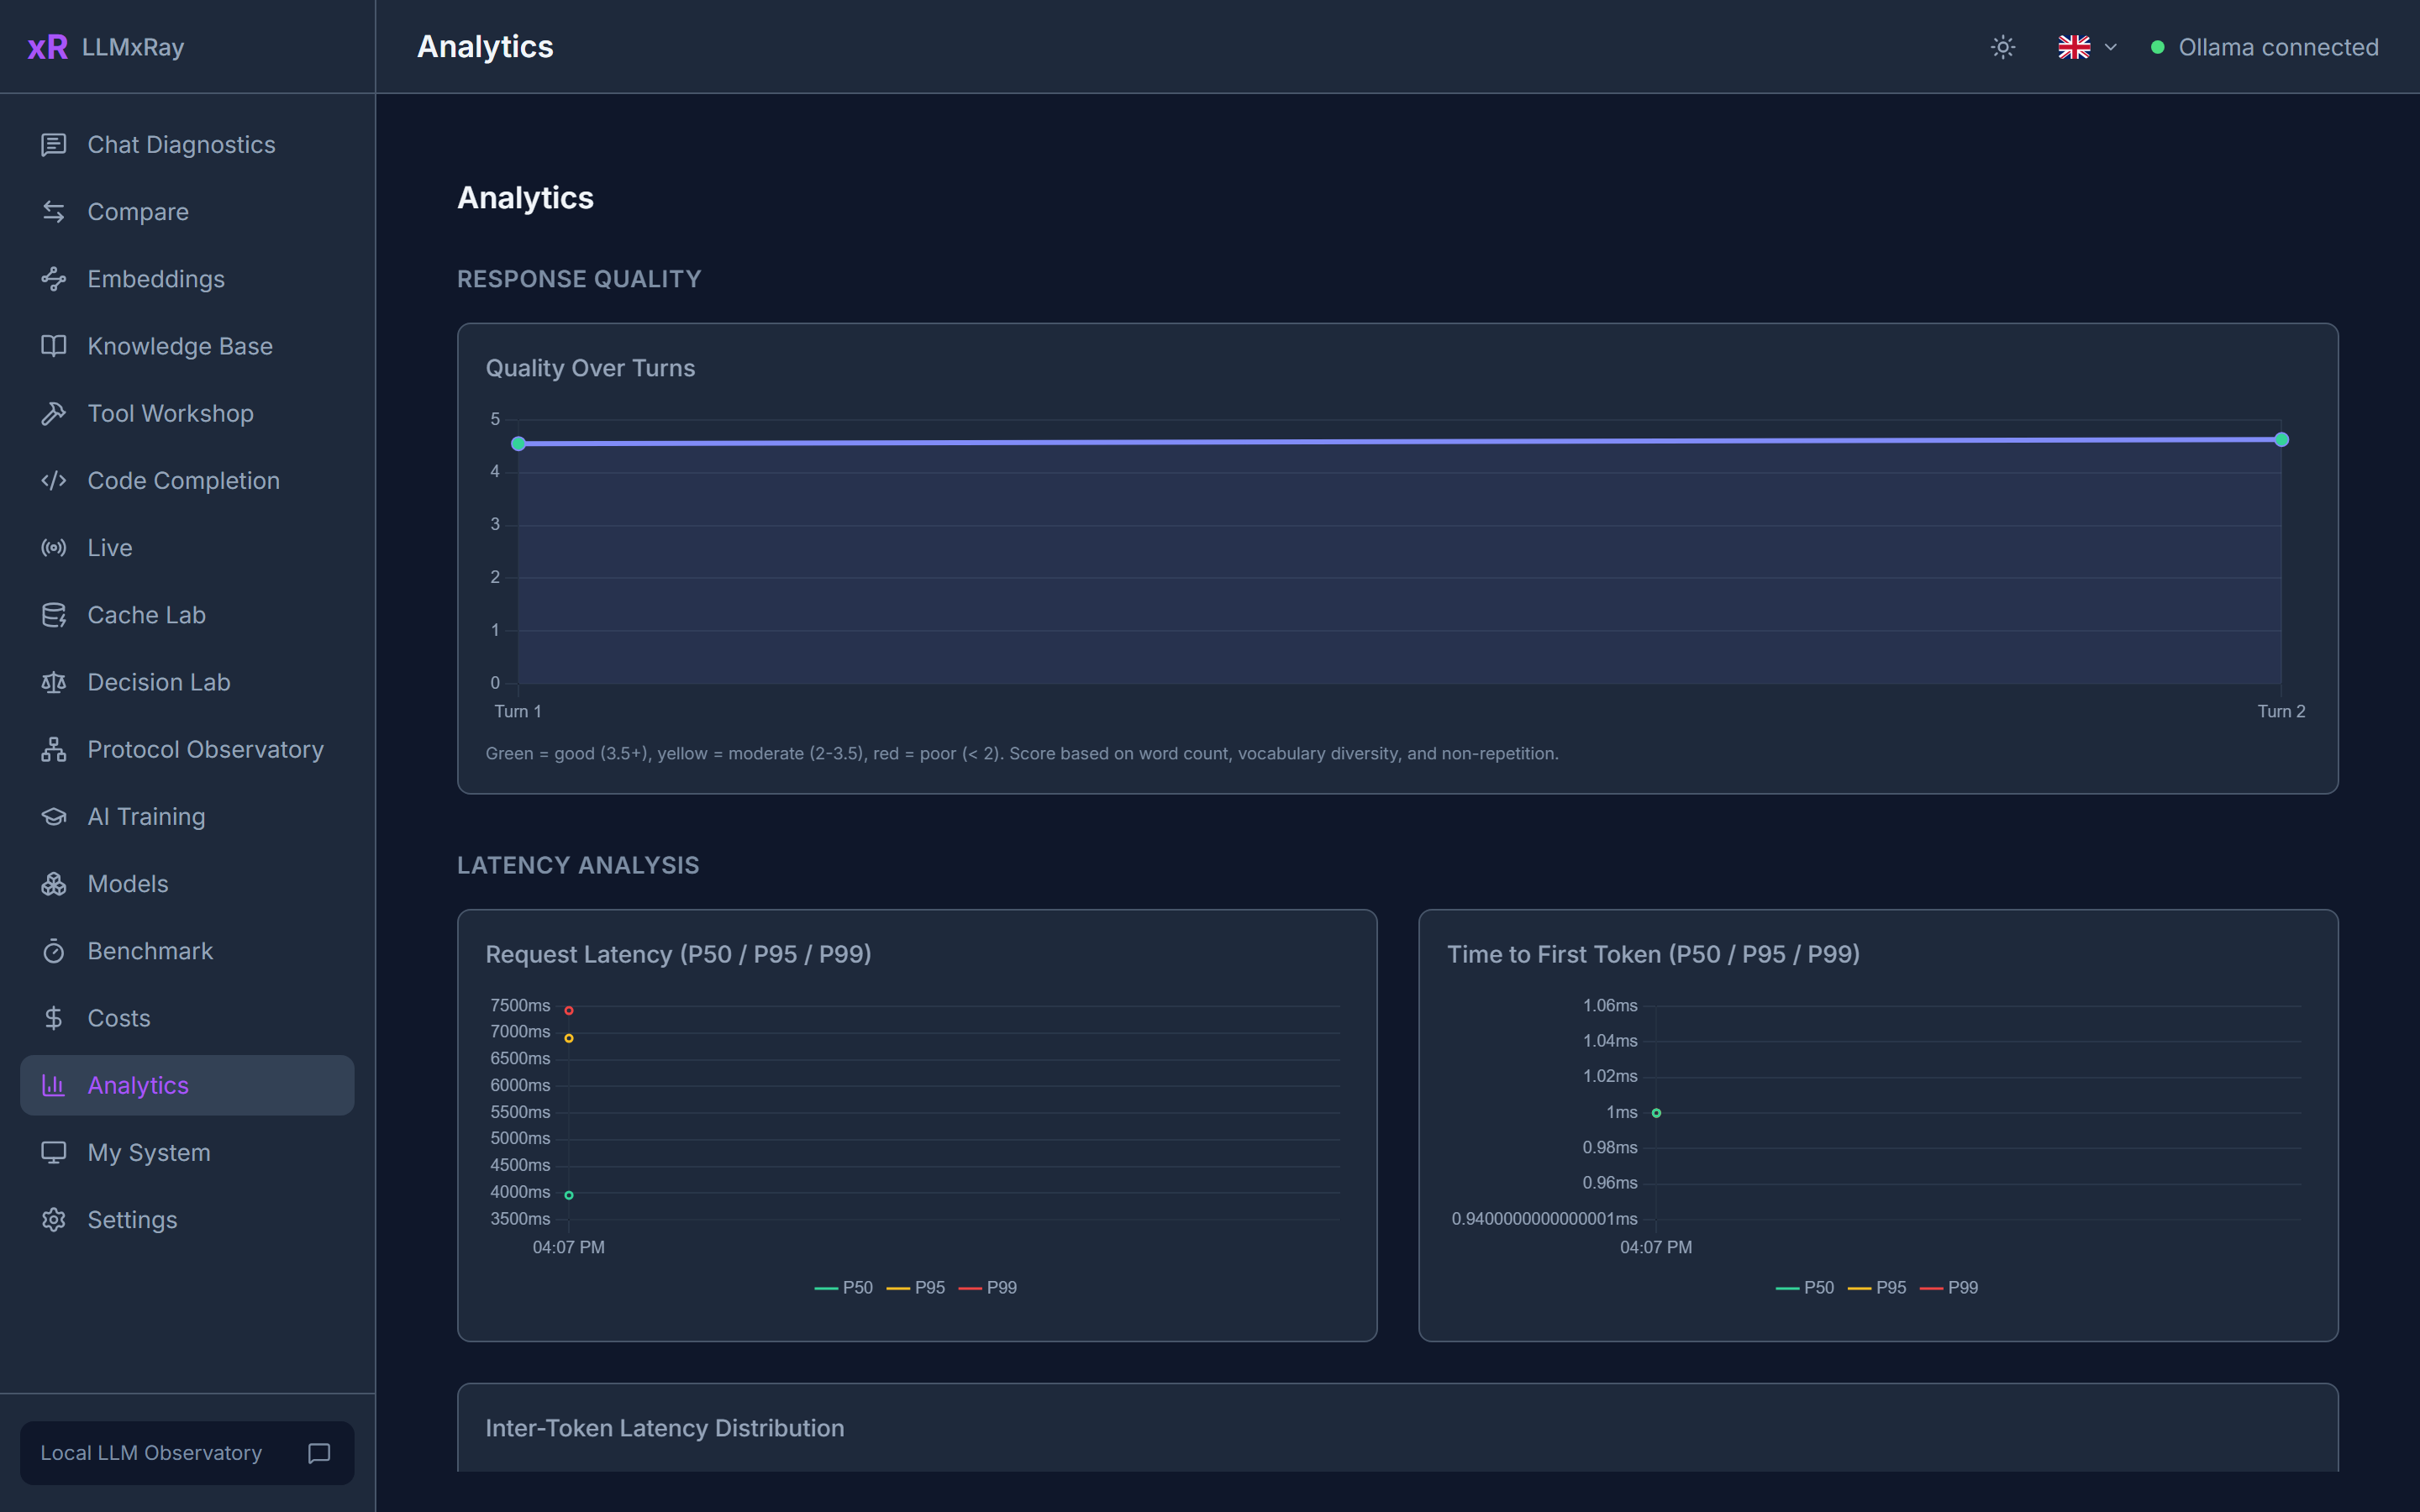
|
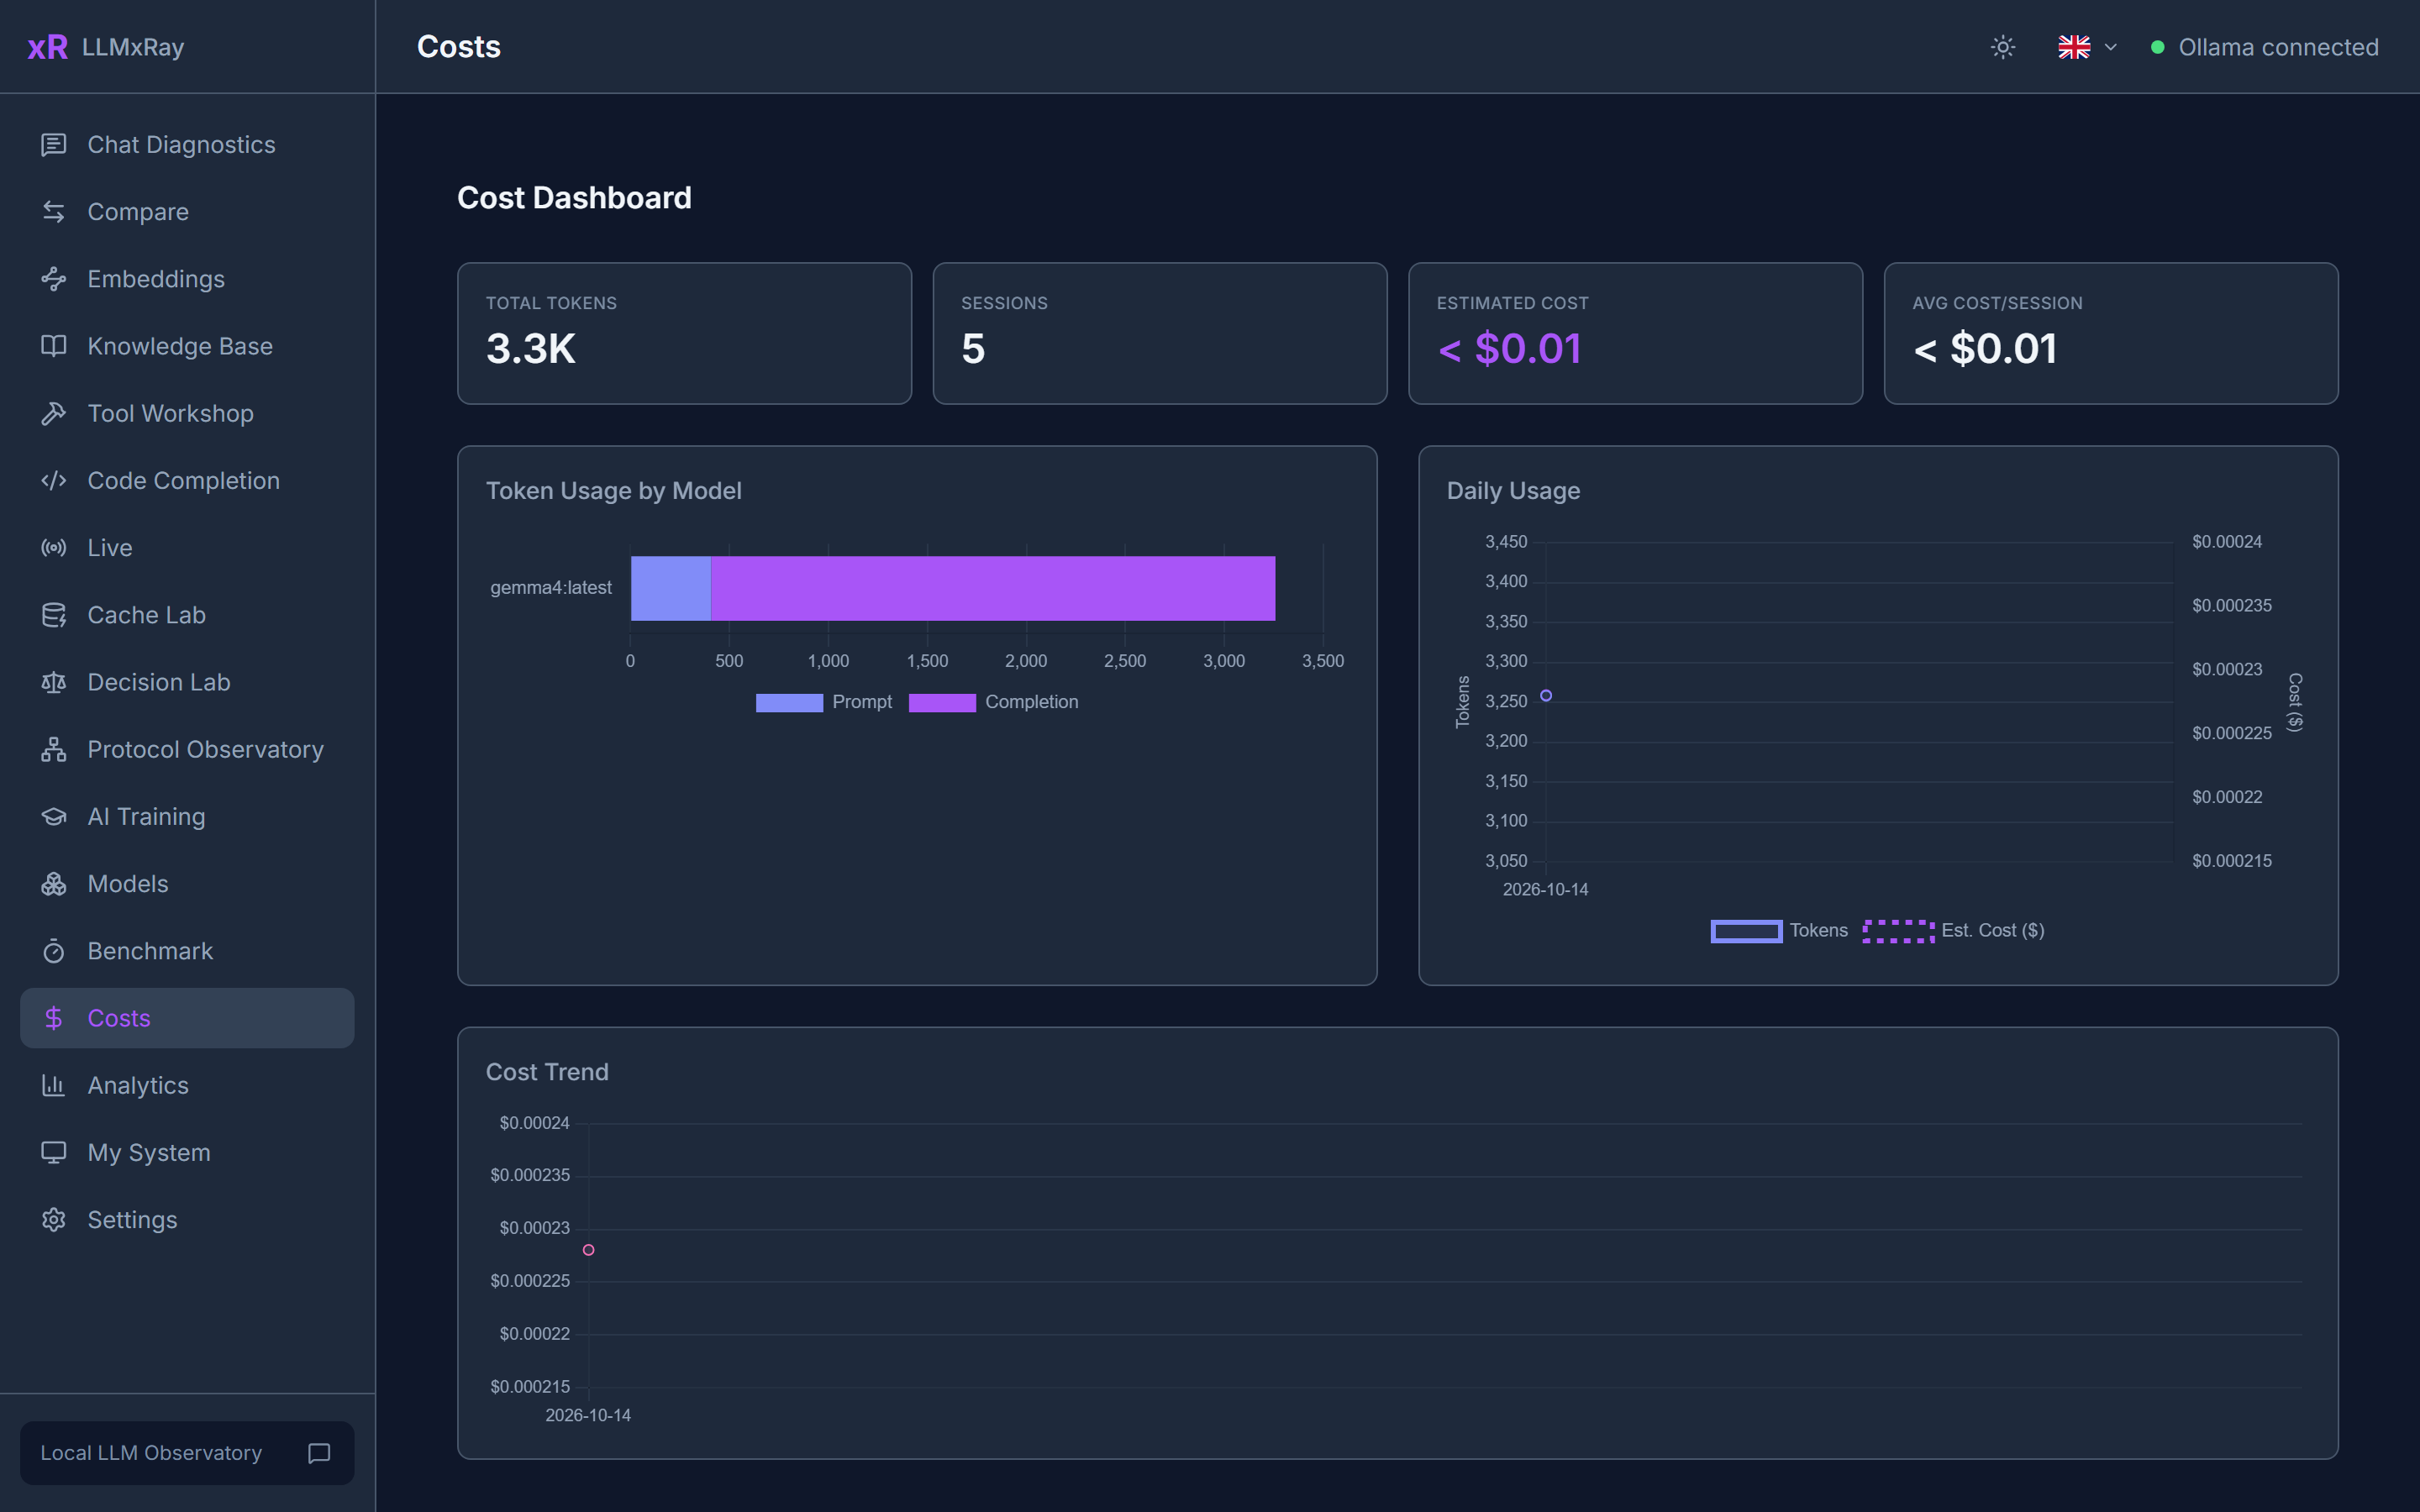
|
Capture d'écran
|
|
|
Si LLMxRay vous aide à mieux comprendre votre IA, pensez à lui donner une étoile.
Cela aide les autres à découvrir le projet.
