TeleMem: Building Long-Term and Multimodal Memory for Agentic AI


**如果这个开源项目对您有帮助,请给我们一个⭐️.**
_🤝 欢迎参与、合作! Feel free to open an issue or submit a pull request._
---
TeleMem是一个大模型智能体的长期记忆管理系统,面向**多轮对话、角色建模、长期信息存储与语义检索**的复杂场景深度优化,**仅改一行代码即可无缝替换[Mem0](https://mem0.ai/)**(`import telemem as mem0`)。
通过独特的上下文感知增强机制,TeleMem为对话式AI提供了**更高准确率、更快性能、更强角色记忆能力**的核心基础设施。
在此基础上,实现了**视频理解、多模态推理与视觉问答** 能力,通过视频帧提取、字幕生成、向量数据库构建的完整流水线,使 AI Agent 能够像处理文本记忆一样,轻松**存储、检索和推理视频内容**。
TeleMem的终极目标是令智能体 _积后见之明(hindsight)、致深谋远虑(foresight)_ 。
**TeleMem,使记忆持续、让智慧生长。**
### 为什么选择 TeleMem?
- 🎭 **真正的角色记忆** — 唯一自动为每个角色建立**独立记忆档案**的开源记忆系统,专为角色扮演、陪伴 AI、NPC 和多角色助手设计。
- 🎬 **视频记忆,而不止文本** — 完整的视频 → 帧 → 字幕 → 向量库流水线,支持 **ReAct 风格多步视频问答**。
- 🏠 **默认完全本地化** — 可在自有硬件上端到端运行(Qwen + FAISS);无云服务、无付费档位、数据不出本机。
- 🔌 **mem0 兼容 API** — `add()` / `search()` 接受相同参数并返回相同的 `{"results": [...]}` 结构,现有 Mem0 代码无需修改。
---
## 📢 最新动态
- **[2026-08-15] 🎉 TeleMem [v1.10.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.10.0) 新增对 [DeepSeek Harness](https://github.com/deepseek-ai/deepseek-harness) 的原生支持:通过可选的 Cordis/MCP 补丁使用 `uvx` 启动 TeleMem,将全部 8 个记忆工具注册为 `mcp__telemem__*`,并安全传递 provider 配置。详见 [MCP 服务器文档](docs/MCP.md#deepseek-harness)。**
- **[2026-08-06] 🎉 TeleMem [v1.9.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.9.0) 全面对齐最新 MCP 标准:迁移至官方 [MCP Python SDK v2](https://github.com/modelcontextprotocol/python-sdk)(2026-07-28 规范)——全部 8 个工具均声明标题、行为注解与结构化输出,同时保持对旧版 MCP 客户端的兼容。详见 [MCP 服务器文档](docs/MCP.md)。**
- **[2026-07-11] 🎉 TeleMem [v1.8.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.8.0) 发布——"承诺即契约"版本:修复角色记忆提取、完整支持 `infer=False`/`prompt`/`memory_type`、新增离线契约测试套件、默认关闭遥测,并附带[多 NPC 示例](examples/multi_npc.py)!**
- **[2026-06-12] 🎉 TeleMem [v1.7.1](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.7.1) 已登陆[官方 MCP 注册表](https://registry.modelcontextprotocol.io)——零安装运行记忆服务器:`uvx telemem`!同时新增[评测原则](https://teleai-uagi.github.io/telemem/evaluation/)与内置基线的 LongMemEval 评测工具。**
- **[2026-06-12] 🎉 TeleMem 已上线 PyPI:`pip install telemem` 新增 Ollama/DeepSeek/Kimi 配置、LangChain 与 LlamaIndex 示例,以及[文档站点](https://teleai-uagi.github.io/telemem/)。**
- **[2026-06-12] 🎉 TeleMem [v1.5.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.5.0) 版本发布:完整 mem0 兼容 API、轻量级核心安装与 CI!**
- **[2026-06-11] 🎉 TeleMem [v1.4.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.4.0) 版本发布,新增 [MCP 支持](docs/MCP.md)!**
- **[2026-01-28] 🎉 TeleMem [v1.3.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.3.0) 版本发布!**
- **[2026-01-22] 🎉 TeleMem [技术报告](https://arxiv.org/abs/2601.06037) 已经更新至第4版!**
- **[2026-01-13] 🎉 TeleMem [技术报告](https://arxiv.org/abs/2601.06037) 已经在arXiv上发布!**
- **[2026-01-09] 🎉 TeleMem [v1.2.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.2.0) 版本发布!**
- **[2025-12-31] 🎉 TeleMem [v1.1.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.1.0) 版本发布!**
- **[2025-12-05] 🎉 TeleMem [v1.0.0](https://github.com/TeleAI-UAGI/telemem/releases/tag/v1.0.0) 版本发布!**
---
## 🔥 研究亮点
* **记忆准度显著提升**:在 ZH-4O 中文长角色对话基准测试中,准确率较 Mem0 提升**19%**,达到 **86.33%**
* **速度性能翻倍提升**:高效缓冲区策略 + 批处理写入,实现毫秒级语义检索
* **Token成本大幅降低**:优化 Token 使用量,在相同性能下显著降低 LLM 开销
* **角色记忆精准保存**:自动为每个角色建立独立记忆档案,不再混淆
* **自动视频处理流水线**:从原始视频 → 帧提取 → 字幕生成 → 向量数据库,全自动完成
* **ReAct 风格视频问答**:多步推理 + 工具调用,实现精准的视频内容理解
---
## 📌 目录
* [项目介绍](#项目介绍)
* [TeleMem vs Mem0:核心优势](#telemem-vs-mem0核心优势)
* [实验结果](#实验结果)
* [快速使用](#快速使用)
* [项目结构](#项目结构)
* [核心功能](#核心功能)
* [多模态扩展](#多模态扩展)
* [MCP 服务器](#mcp-服务器)
* [框架集成](#框架集成)
* [数据存储](#数据存储)
* [遥测与隐私](#遥测与隐私)
* [开发与贡献](#开发与贡献)
* [致谢](#致谢)
* [引用](#-引用)
---
## 项目介绍
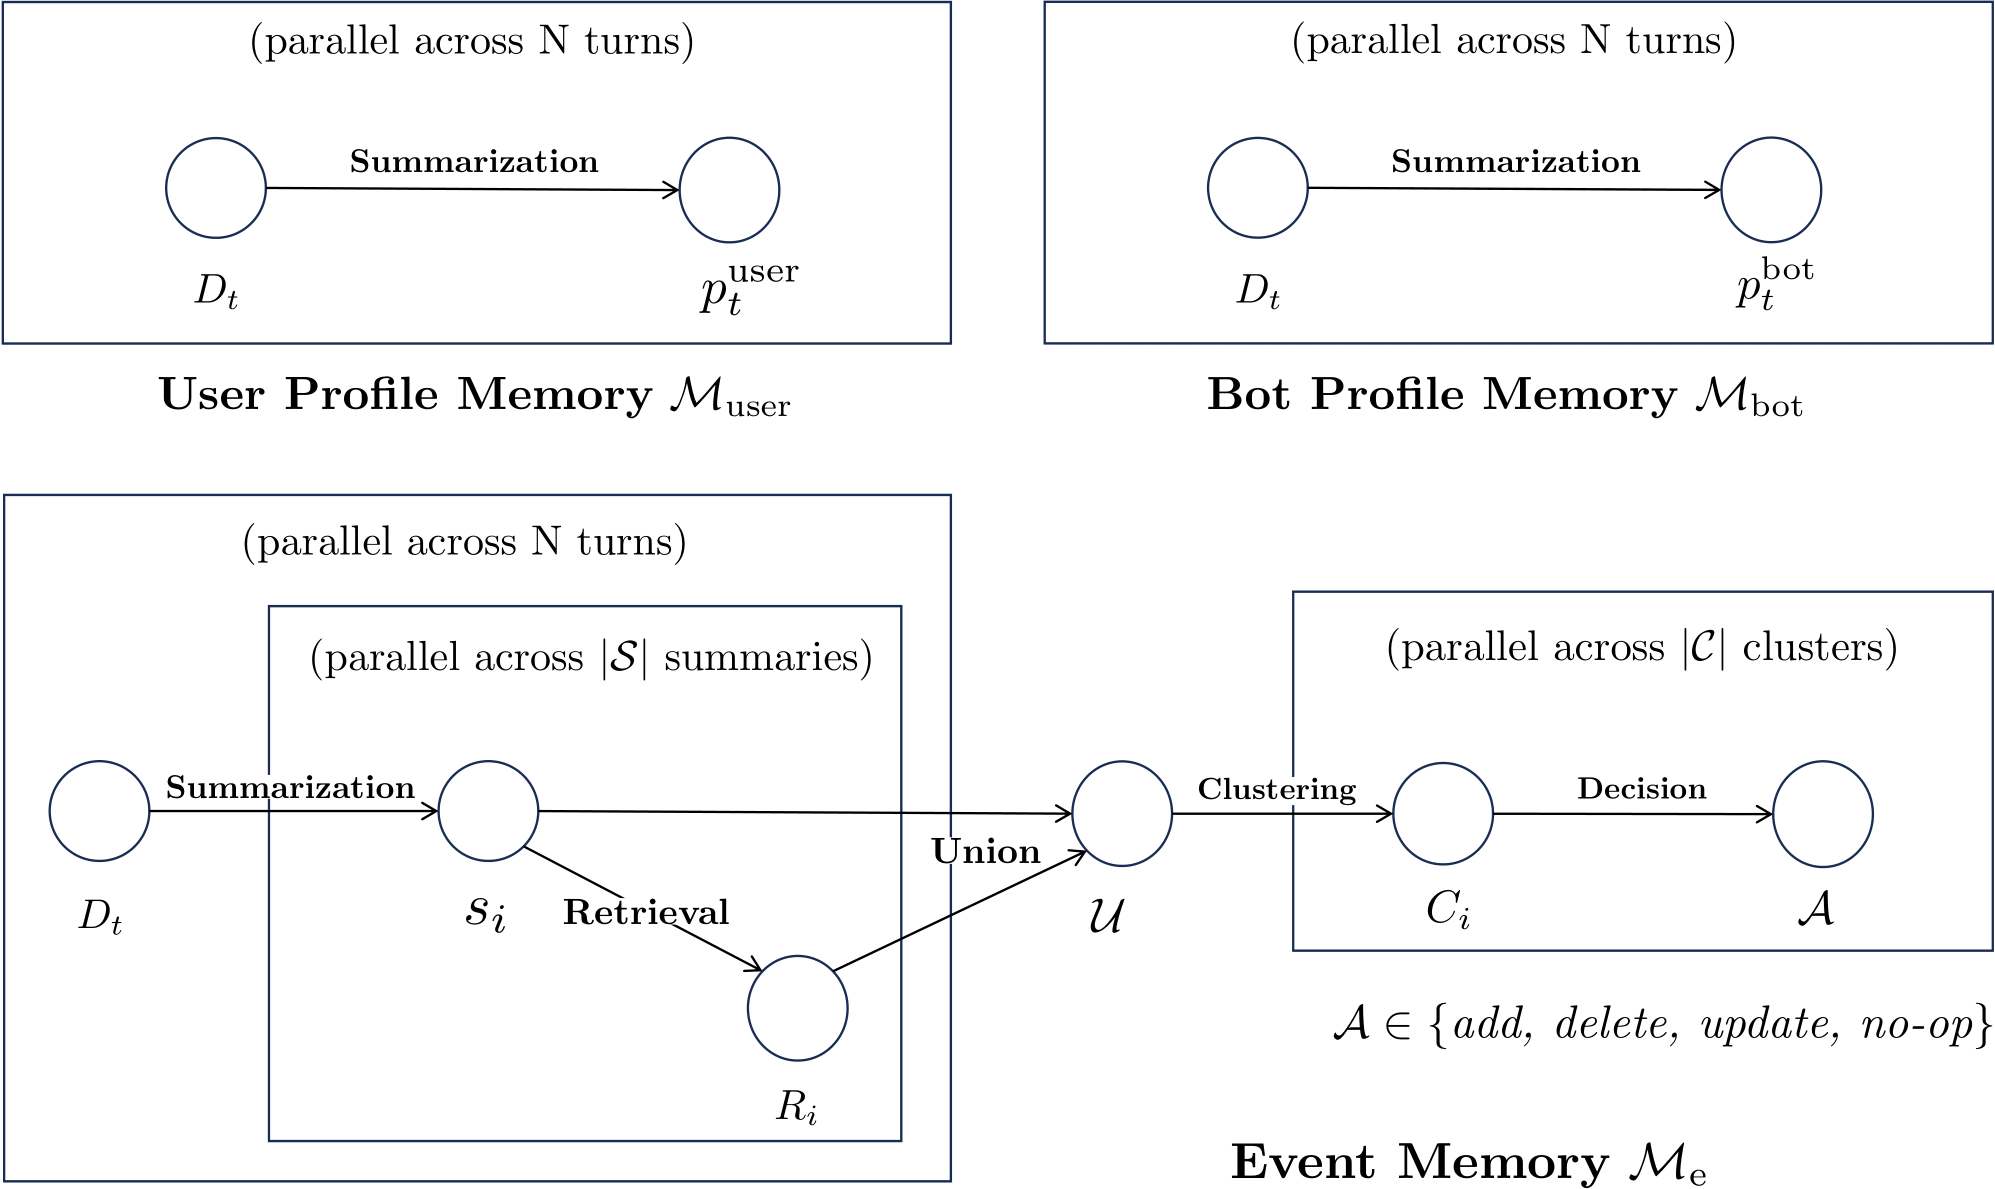
TeleMem 通过一套深度优化的**角色化摘要生成 → 语义聚类去重 → 高效存储 → 精准检索**的完整流程,使对话式 AI 在长周期交互中能够保持稳定、自然、连续的世界观与角色设定。
```mermaid
flowchart LR
A["对话消息"] --> B["角色感知摘要
(全局 + 各角色视角)"]
B --> C["向量化 +
相似记忆检索"]
C --> D["写入缓冲区
(批量刷新)"]
D --> E["LLM 语义聚类
与融合"]
E --> F[("FAISS 索引 +
JSON 元数据")]
Q["查询"] --> S["向量检索
+ 重排序"]
F --> S
S --> R["results"]
```
### 功能
* **自动记忆提取**:从对话中自动抽取关键记忆并进行结构化存储。
* **语义聚类去重**:使用 LLM 对高度相似记忆进行语义融合,减少冲突、提升一致性。
* **角色化档案管理**:为对话中不同角色建立独立记忆档案,实现记忆的精准隔离与专属管理。
* **高效异步写入**:采用缓冲区 + 批量写入机制,实现高性能持久化存储,兼顾速度与稳定性。
* **语义精准检索**:FAISS + JSON 双存储方式,召回记忆快速又可审计。
### 适用场景
* 多角色虚拟Agent系统
* 长期记忆型 AI 助手(客服、陪伴、创作辅助)
* 复杂虚拟剧情 / 世界观构建
* 强上下文依赖的对话交互场景
* 视频内容问答与推理
* 多模态 Agent 记忆管理
* 长视频理解与信息检索
---
## TeleMem vs Mem0:核心优势
TeleMem 相比于 Mem0 针对 **角色化、长期化、高性能** 核心需求完成深度重构,关键能力差异如下:
| 能力维度 | Mem0 | TeleMem |
| -------------- | --------------- | ------------------------------------------------------------------- |
| 多角色记忆分离 | ❌ 不支持 | ✅ 自动为对话中不同角色创建独立记忆档案,实现记忆精准隔离与专属管理 |
| 摘要质量 | 基础摘要 | ✅**上下文感知 + 角色聚焦** 双 prompt,覆盖关键名词、动作、时间 |
| 去重机制 | 向量相似度过滤 | ✅**LLM 聚类融合**:对相似记忆调用 LLM 进行语义级更新/去重 |
| 写入性能 | 单条流式写入 | ✅**缓冲区缓存 + 批量 Flush + 并发处理**,写入效率提升 2-3 倍 |
| 存储格式 | SQLite / 向量库 | ✅**FAISS + JSON 元数据双写**:兼顾高效检索与人类可读性 |
| 多模态能力 | 仅支持单张图像转文字 |✅**视频多模态记忆**:支持完整视频处理流水线 + ReAct 多步推理问答 |
---
## 实验结果
### 数据集
项目采用论文[MOOM: Maintenance, Organization and Optimization of Memory in Ultra-Long Role-Playing Dialogues](https://arxiv.org/abs/2509.11860)构建的 ZH-4O 中文长角色对话数据集:
* 平均对话轮次:600 轮 / 对话
* 覆盖场景:日常交互、剧情推进、角色关系演变
数据集的记忆能力评测采用问答形式,示例如下:
```json
{
"question": "赵齐对白羽岚的昵称是什么?A 小白 B 小羽 C 岚岚 D 羽羽",
"answer": "A"
},
{
"question": "赵齐和白羽岚是什么关系?A 同学 B 老师和学生 C 敌人 D 邻居",
"answer": "B"
}
```
### 实验配置
* 大语言模型:统一使用[ Qwen3-8B](https://huggingface.co/Qwen/Qwen3-8B),关闭thinking模式
* 嵌入模型:统一使用 [Qwen3-Embedding-8B](https://huggingface.co/Qwen/Qwen3-Embedding-8B)
* 评价指标:记忆问答准确率
| Method | Overall(%) |
|:--------------------------------------------------------- |:---------- |
| RAG | 62.45 |
| _[Mem0](https://github.com/mem0ai/mem0)_ | _70.20_ |
| [MOOM](https://github.com/cows21/MOOM-Roleplay-Dialogue) | 72.60 |
| [A-mem](https://github.com/agiresearch/A-mem) | 73.78 |
| [Memobase](https://github.com/memodb-io/memobase) | 76.78 |
| **[TeleMem](https://github.com/TeleAI-UAGI/TeleMem)** | **86.33** |
---
## 快速使用
### 安装
```shell
pip install telemem # 核心(文本记忆)
pip install "telemem[mcp]" # + MCP 服务器
pip install "telemem[video]" # + 视频/多模态流水线
pip install "telemem[all]" # 全部安装
```
### 开发环境
使用 [uv](https://docs.astral.sh/uv/)(推荐——基于已提交的 `uv.lock` 创建 `.venv`,环境可复现):
```shell
uv sync --all-extras # 以可编辑模式安装 TeleMem 及全部 extras(含 MCP)
uv run python examples/quickstart.py
```
或使用 conda + pip:
```shell
# 创建并激活虚拟环境
conda create -n telemem python=3.10
conda activate telemem
# 从源码安装(可编辑模式),按需选择 extras
pip install -e ".[all]"
```
### 示例
设置OpenAI API key
```shell
export OPENAI_API_KEY="your-openai-api-key"
```
```python
import telemem as mem0
memory = mem0.Memory()
messages = [
{"role": "user", "content": "Jordan, did you take the subway to work again today?"},
{"role": "assistant", "content": "Yes, James. The subway is much faster than driving. I leave at 7 o'clock and it's just not crowded."},
{"role": "user", "content": "Jordan, I want to try taking the subway too. Can you tell me which station is closest?"},
{"role": "assistant", "content": "Of course, James. You take Line 2 to Civic Center Station, exit from Exit A, and walk 5 minutes to the company."}
]
memory.add(messages=messages, user_id="Jordan")
results = memory.search("What transportation did Jordan use to go to work today?", user_id="Jordan")
for hit in results["results"]: # 与 mem0 相同的返回结构
print(hit["memory"])
```
`Memory()` 会使用 `mem0ai` 继承而来的默认 provider 配置。如果需要使用本仓库提供的本地 Qwen + FAISS 配置,请显式加载 `config/config.yaml`:
```python
from telemem.utils import load_config
import telemem as mem0
config = load_config("config/config.yaml")
memory = mem0.Memory(config=config)
```
可运行的 examples 也支持通过 `TELEMEM_CONFIG` 指定同一配置:
```shell
TELEMEM_CONFIG=config/config.yaml python examples/quickstart.py
```
### 更多 LLM Provider
TeleMem 支持**任何 OpenAI 兼容接口**。`config/` 目录内置了开箱即用的配置示例:
| Provider | 配置文件 | LLM | 向量化 | 说明 |
| -------- | -------- | --- | ------ | ---- |
| **Ollama**(完全本地) | [`config.ollama.yaml`](config/config.ollama.yaml) | 任意本地模型(如 `qwen3:8b`) | `nomic-embed-text`,本地 | **无需 API key、无需云服务**——全部在本机运行 |
| **DeepSeek** | [`config.deepseek.yaml`](config/config.deepseek.yaml) | `deepseek-chat` / `deepseek-reasoner` | 外部(如 OpenAI) | `DEEPSEEK_API_KEY` + `OPENAI_API_KEY` |
| **Moonshot(Kimi)** | [`config.moonshot.yaml`](config/config.moonshot.yaml) | `kimi-k2-0905-preview` | 外部(如 OpenAI) | 支持 `.cn` 与 `.ai` 两个端点 |
| **MiniMax** | [`config.minimax.yaml`](config/config.minimax.yaml) | `MiniMax-M3` | 外部(如 OpenAI) | 全球 `api.minimax.io` 与中国 `api.minimaxi.com` 端点;temperature 须在 (0.0, 1.0] |
```shell
TELEMEM_CONFIG=config/config.ollama.yaml python examples/quickstart.py # 100% 本地记忆
```
---
## 项目结构
展开/收起 目录结构
```
telemem/
├── assets/ # 文档资源与插图素材
├── baselines/ # 对比评测使用的基线方法实现
│ ├── RAG # Retrieval-Augmented Generation(检索增强生成)基线
│ ├── MemoBase # MemoBase 记忆管理系统
│ ├── MOOM # MOOM 双分支叙事记忆框架
│ ├── A-mem # A-mem 智能体记忆系统基线
│ └── Mem0 # Mem0 基线实现
├── config/
│ ├── config.yaml # TeleMem 默认配置
│ └── config.minimax.yaml # MiniMax provider 示例配置
├── data/ # 用于评测或演示的小规模示例数据集
├── examples/ # 示例代码与教程 Demo
│ ├── quickstart.py # 快速入门示例(文本记忆)
│ ├── quickstart_mm.py # 快速入门示例(多模态记忆)
│ ├── mcp_client.py # 快速入门示例(MCP stdio 客户端)
│ ├── mcp_config.json # Claude Desktop / Cursor 的 MCP 配置示例
│ └── deepseek-harness.cordis.yml # DeepSeek Harness 记忆补丁
├── docs/ # 项目文档
│ ├── MCP.md # MCP 服务器使用文档
│ └── TeleMem_Tech_Report.pdf
├── telemem/ # TeleMem 源码实现
│ └── mcp/ # Model Context Protocol 服务器
├── tests/ # TeleMem 测试
├── README.md # 项目说明文档(英文版)
├── README-ZH.md # 项目说明文档(中文版)
└── pyproject.toml # TeleMem 环境配置
```
---
## 核心功能
### 添加记忆(add)
add() 是 TeleMem 的核心方法,用于将一轮或多轮对话注入记忆系统。
```python
def add(
self,
messages,
*,
user_id: Optional[str] = None,
agent_id: Optional[str] = None,
run_id: Optional[str] = None,
metadata: Optional[Dict[str, Any]] = None,
infer: bool = True,
memory_type: Optional[str] = None,
prompt: Optional[str] = None,
batch: bool = False,
)
```
#### 🔎 参数说明
| 参数名 | 类型 | 是否必填 | 说明 |
| -------------------- | ----------------------------- | -------- | -------------------------------------------------------------------------- |
| messages | str 或 List[Dict[str, str]] | ✅ 是 | 单条文本,或对话消息列表(每条包含 role(user/assistant)和 content) |
| user\_id | Optional[str] | ❌ 否 | 记忆归属的角色/用户;TeleMem 会为每个 user\_id 维护**独立记忆档案**。省略则存为共享的会话事件记忆 |
| agent\_id / run\_id | Optional[str] | ❌ 否 | 其他 mem0 兼容作用域(如每个会话一个 run\_id) |
| metadata | Optional[Dict[str, Any]] | ❌ 否 | 随记忆存储的任意元数据 |
| infer | bool | ❌ 否 | 是否用 LLM 提取记忆摘要(默认 True);False 时直接原样存储消息内容,不调用 LLM |
| memory\_type | Optional[str] | ❌ 否 | 传 `"procedural_memory"` 走 mem0 的程序性记忆流水线;省略则为常规对话记忆 |
| prompt | Optional[str] | ❌ 否 | 自定义提取 Prompt(作为 system prompt 替换内置优化版 Prompt) |
| batch | bool | ❌ 否 | 走高吞吐批处理流水线(等价于 `add_batch`) |
**返回值**为 mem0 兼容结构:`{"results": [{"id": "...", "memory": "...", "event": "ADD"}, ...]}`
#### 🔁 add() 内部流程
1. **消息预处理**:合并连续同角色消息,标准化 user/assistant 轮次格式
2. **多维度摘要生成**:
* 全局事件摘要:描述本轮对话核心事件
* 角色 1 视角摘要:聚焦角色 1 的行为、偏好、关系
* 角色 2 视角摘要:聚焦角色 2 的行为、偏好、关系
3. **向量化与相似检索**:生成摘要向量,检索已有相似记忆
4. **批量处理**:达到缓冲区阈值后,调用 LLM 对相似记忆进行智能融合
5. **持久化存储**:同时写入 FAISS 向量库(检索)和 JSON 文件(元数据)
> 🎭 **多 NPC 示例**:[examples/multi_npc.py](examples/multi_npc.py) 让五个酒馆 NPC 经历同一幕剧情——
> 一次 `add_batch(scene, user_id=[...])` 调用即可为每个 NPC 建立私有记忆档案,并写入共享的
> `"events"` 世界状态,随后每个 NPC 都能从自己的视角回忆这段剧情。
---
### 搜索记忆(search)
基于语义向量检索相关记忆,支持精准的上下文召回。
```python
def search(
self,
query: str,
*,
user_id: Optional[str] = None,
agent_id: Optional[str] = None,
run_id: Optional[str] = None,
limit: int = 100,
filters: Optional[Dict[str, Any]] = None,
threshold: Optional[float] = None,
rerank: bool = True,
)
```
#### 🔎 参数说明
| 参数名 | 类型 | 是否必填 | 说明 |
| ------------------- | ----------------- | -------- | ----------------------------------------- |
| query | str | ✅ 是 | 检索查询文本(自然语言问题) |
| user\_id | Optional[str] | ❌ 否 | 要检索的角色/用户档案;共享事件记忆(伪用户 `"events"`)会被一并检索 |
| agent\_id / run\_id | Optional[str] | ❌ 否 | 其他 mem0 兼容作用域过滤 |
| limit | int | ❌ 否 | 返回记忆条数上限(默认 100 条) |
| threshold | Optional[float] | ❌ 否 | 相似度阈值(0-1,默认自动适配) |
| filters | Dict[str, Any] | ❌ 否 | 自定义过滤条件(如角色、时间范围) |
| rerank | bool | ❌ 否 | 是否对检索结果重排序(默认 True) |
**返回值**为 mem0 兼容结构:`{"results": [{"id": "...", "memory": "...", "score": ..., ...}, ...]}`
> 🔍 搜索基于 FAISS 向量检索,支持毫秒级响应。
---
## 多模态扩展
在文本记忆之外,TeleMem 进一步扩展了多模态能力。借鉴 [Deep Video Discovery](https://github.com/microsoft/DeepVideoDiscovery) 的 Agentic Search 与 Tool Use 思路,我们在 TeleMemory 类中实现了两个核心方法,支持视频内容的智能存储与语义检索。
| 方法 | 功能说明 |
|------|----------|
| `add_mm()` | 将视频处理为可检索的记忆(帧提取 → 字幕生成 → 向量数据库) |
| `search_mm()` | 使用自然语言查询视频内容,支持 ReAct 风格多步推理 |
### 添加多模态记忆 (add_mm)
```python
def add_mm(
self,
video_path: str,
output_dir: str,
clip_secs: int | None = None,
emb_dim: int | None = None,
subtitle_path: str | None = None,
)
```
#### 🔎 参数说明
| 参数名 | 类型 | 是否必填 | 说明 |
|--------|------|----------|------|
| video_path | str | ✅ 是 | 源视频文件路径,如 `"video/3EQLFHRHpag.mp4"` |
| output_dir | str | ✅ 是 | 输出根目录;产物会写入其下的 `frames/`、`captions/` 和 `vdb/` 子目录 |
| clip_secs | int | ❌ 否 | 预留参数;当前片段长度从 `config.vlm["CLIP_SECS"]` 读取 |
| emb_dim | int | ❌ 否 | Embedding 维度,默认从配置读取 |
| subtitle_path | str | ❌ 否 | 字幕文件路径(.srt),可选 |
#### 🔁 add_mm() 内部流程
1. **帧提取**:`decode_video_to_frames` - 按配置的 FPS 将视频解码为 JPEG 帧
2. **字幕生成**:`process_video` - 使用 VLM(如 Qwen3-Omni)为每个片段生成详细描述
3. **向量数据库构建**:`init_single_video_db` - 生成 Embedding 用于语义检索
> 💡 **智能缓存**:如果某一阶段的目标文件已存在,会自动跳过该阶段,节省计算资源。
#### 返回值示例
```python
{
"output_dir": "/abs/path/to/output_dir"
}
```
---
### 搜索多模态记忆 (search_mm)
```python
def search_mm(
self,
question: str,
output_dir: str,
max_iterations: int = 15,
)
```
#### 🔎 参数说明
| 参数名 | 类型 | 是否必填 | 说明 |
|--------|------|----------|------|
| question | str | ✅ 是 | 问题字符串(支持 A/B/C/D 多选题格式) |
| output_dir | str | ✅ 是 | 与 `add_mm` 相同的输出根目录;其中必须正好包含一个 `captions/*/captions.json` 和一个 `vdb/*/*_vdb.json` |
| max_iterations | int | ❌ 否 | MMCoreAgent 最大推理轮数(默认 15) |
#### 🛠️ ReAct 风格推理工具
`search_mm` 内部使用 `MMCoreAgent`,采用 THINK → ACTION → OBSERVATION 循环,配备三个专用工具:
| 工具名 | 功能 |
|--------|------|
| `global_browse_tool` | 获取视频事件和主题的全局概览 |
| `clip_search_tool` | 使用语义查询搜索特定内容 |
| `frame_inspect_tool` | 检查特定时间范围的帧细节 |
---
### 多模态示例
运行多模态演示:
```bash
python examples/quickstart_mm.py
```
首次运行会在指定的 `output_dir` 下生成帧、字幕和 VDB JSON。仓库中只附带了一个小型示例视频;除非本地已有这些中间产物,否则生成字幕和视频数据库仍需要配置可用的 VLM 与 embedding 服务。
完整代码示例:
```python
import telemem as mem0
from pathlib import Path
from telemem.mm_utils.core import extract_choice_from_msg
# 初始化模型
memory = mem0.Memory()
# 定义路径
repo_root = Path(__file__).resolve().parents[1]
video_path = repo_root / "data" / "samples" / "video" / "3EQLFHRHpag.mp4"
video_name = video_path.stem
output_dir = video_path.parent
# 第一步:写入记忆
vdb_json_path = output_dir / "vdb" / video_name / f"{video_name}_vdb.json"
if not vdb_json_path.exists():
result = memory.add_mm(
video_path=str(video_path),
output_dir=str(output_dir),
)
print(f"Video processing complete: {result}")
else:
print(f"VDB already exists: {vdb_json_path}")
# 第二步:定义查询问题
question = """The problems people encounter in the video are caused by what?
(A) Catastrophic weather.
(B) Global warming.
(C) Financial crisis.
(D) Oil crisis.
"""
# 第三步:检索记忆
messages = memory.search_mm(
question=question,
output_dir=str(output_dir),
max_iterations=15,
)
# 提取最终答案
answer = extract_choice_from_msg(messages)
print(f"Answer: ({answer})")
```
---
## MCP 服务器
[](https://mcpvault.io/servers/telemem/health?utm_source=external_badge&utm_medium=referral&utm_campaign=mcp_health_report)
TeleMem 内置 [Model Context Protocol](https://modelcontextprotocol.io)(MCP)服务器,任何兼容 MCP 的客户端——Claude Desktop、Claude Code、Cursor、自定义 Agent——都可以把 TeleMem 用作长期记忆。
```shell
pip install telemem
telemem-mcp # stdio(默认)
telemem-mcp --transport streamable-http # Streamable HTTP(端口 8421)
TELEMEM_CONFIG=config/config.yaml telemem-mcp # 自定义 TeleMem 配置
uvx telemem # 零安装运行(stdio)
```
服务器基于官方 MCP Python SDK v2 构建,实现当前 MCP 规范(2026-07-28),同时兼容旧版客户端;每个工具都声明了标题、行为注解(只读/破坏性提示)与结构化输出。
服务器提供八个工具:`add_memory`、`search_memories`、`get_memories`、`get_memory`、`update_memory`、`delete_memory`、`delete_all_memories` 和 `memory_history`。未显式指定作用域的调用默认使用 `TELEMEM_DEFAULT_USER_ID`(`telemem-mcp`);批量删除等破坏性操作必须显式指定作用域。
Claude Desktop / Cursor 配置示例([examples/mcp_config.json](examples/mcp_config.json)):
```json
{
"mcpServers": {
"telemem": {
"command": "telemem-mcp",
"env": {
"TELEMEM_CONFIG": "/absolute/path/to/config/config.yaml",
"OPENAI_API_KEY": "sk-..."
}
}
}
}
```
也可以通过 stdio 以编程方式调用——即用 MCP 工具调用复现快速入门流程:
```shell
python examples/mcp_client.py
```
完整的工具说明、传输方式与客户端配置见 [docs/MCP.md](docs/MCP.md)。
---
## 框架集成
TeleMem 只需两个调用即可接入任何 Agent 框架——回答前 `search()`,每轮对话后 `add()`:
| 框架 | 示例 | 安装 |
| ---- | ---- | ---- |
| **LangChain** | [examples/langchain_memory.py](examples/langchain_memory.py) | `pip install langchain-core langchain-openai` |
| **LlamaIndex** | [examples/llamaindex_memory.py](examples/llamaindex_memory.py) | `pip install llama-index-llms-openai` |
| **Claude Desktop / Cursor / 任何 MCP 客户端** | [MCP 服务器](#mcp-服务器) | `pip install "telemem[mcp]"` |
由于 TeleMem 与 mem0 API 兼容,任何为 Mem0 开源客户端编写的框架适配器同样适用——把实例换成 `telemem.Memory` 即可。
---
## 数据存储
### 文本记忆存储
TeleMem 自动在./faiss\_db/目录下生成结构化存储文件,按会话和角色维度分离:
```
faiss_db/
├── session_001_events.index
├── session_001_events_meta.json
├── session_001_person_1.index
├── session_001_person_1_meta.json
├── session_001_person_2.index
└── session_001_person_2_meta.json
```
### 📄 元数据示例(\_meta.json)
```json
{
"summary": "角色讨论了即将进行的行动计划。",
"sample_id": "session_001",
"round_index": 3,
"timestamp": "2024-01-01T00:00:00Z"
"user": "Jordon" //仅person_*.json 中存在
}
```
> 所有记忆均包含 摘要、轮次、时间戳、角色,便于审计与调试。
------
### 多模态记忆存储
TeleMem 在 `./data/samples/video/` 目录下生成视频相关的存储文件:
```
video/
├── frames/
│ └── /
│ └── frames/
│ ├── frame_000001_n0.00.jpg
│ ├── frame_000002_n0.50.jpg
│ └── ...
├── captions/
│ └── /
│ ├── captions.json # 片段描述 + 主体注册表
│ └── ckpt/ # 断点续传检查点
│ ├── 0_10.json
│ └── 10_20.json
└── vdb/
└── /
└── _vdb.json # 语义检索向量数据库
```
#### 📄 captions.json 结构
```json
{
"0_10": {
"caption": "旁白者讨论气候数据,展示融化的冰川..."
},
"10_20": {
"caption": "场景转向受海平面上升影响的沿海社区..."
},
"subject_registry": {
"narrator": {
"name": "narrator",
"appearance": ["professional attire"],
"identity": ["climate scientist"],
"first_seen": "00:00:00"
}
}
}
```
------
## 遥测与隐私
TeleMem 本身不收集任何遥测数据。底层依赖的 `mem0ai` 库自带匿名化的 PostHog
使用统计,TeleMem **默认将其关闭**(`import telemem` 时会设置
`MEM0_TELEMETRY=False`,除非你已显式设置该环境变量)。如需重新开启:
```bash
export MEM0_TELEMETRY=true
```
------
## 开发与贡献
* 欢迎提交 issue 和 pull request——参与方式见[贡献指南](CONTRIBUTING.md)。
* 版本变更记录见 [Changelog](CHANGELOG.md)。
* CI 会在 Python 3.10–3.12 上为每个 PR 运行离线测试套件(`uv run pytest tests/ -q`)。
* 英文文档:[README.md](README.md)
---
## 许可证
[Apache 2.0 License](LICENSE)
---
## 致谢
TeleMem 的研发与迭代离不开开源社区的宝贵成果与前沿研究的启发,在此向以下项目 / 研究团队致以诚挚的感谢:
- [**Mem0**](https://github.com/mem0ai/mem0)
- [**Memobase**](https://github.com/memodb-io/memobase)
- [**MOOM**](https://github.com/cows21/MOOM-Roleplay-Dialogue)
- [**DVD**](https://github.com/microsoft/DeepVideoDiscovery)
- [**Memento**](https://github.com/Agent-on-the-Fly/Memento)
---
## 📑 引用
如果 TeleMem 对您的研究或开发工作有帮助,请引用我们的 arXiv 论文:
> Chunliang Chen, Ming Guan, Xiao Lin, Jiaxu Li, Luxi Lin, Qiyi Wang, Xiangyu Chen, Jixiang Luo, Changzhi Sun, Dell Zhang, Xuelong Li. **TeleMem: Building Long-Term and Multimodal Memory for Agentic AI.** arXiv:2601.06037, 2026. https://arxiv.org/abs/2601.06037
```bibtex
@article{chen2026telemem,
title = {TeleMem: Building Long-Term and Multimodal Memory for Agentic AI},
author = {Chen, Chunliang and Guan, Ming and Lin, Xiao and Li, Jiaxu and Lin, Luxi and Wang, Qiyi and Chen, Xiangyu and Luo, Jixiang and Sun, Changzhi and Zhang, Dell and Li, Xuelong},
journal = {arXiv preprint arXiv:2601.06037},
year = {2026},
url = {https://arxiv.org/abs/2601.06037}
}
```
引用元数据另见 [CITATION.cff](CITATION.cff)(对应 GitHub 的 “Cite this repository” 按钮)。
---
**If you find this project helpful, please give us a ⭐️.**
Made with ❤️ by the Ubiquitous AGI team at TeleAI.