code-review-graph

本地代码知识图谱,通过 MCP 为 AI 编码工具提供精准的审查上下文。
English |
简体中文 |
日本語 |
한국어 |
हिन्दी




使用说明 ·
命令 ·
常见问题 ·
故障排查 ·
GitHub Action ·
复现基准测试 ·
路线图
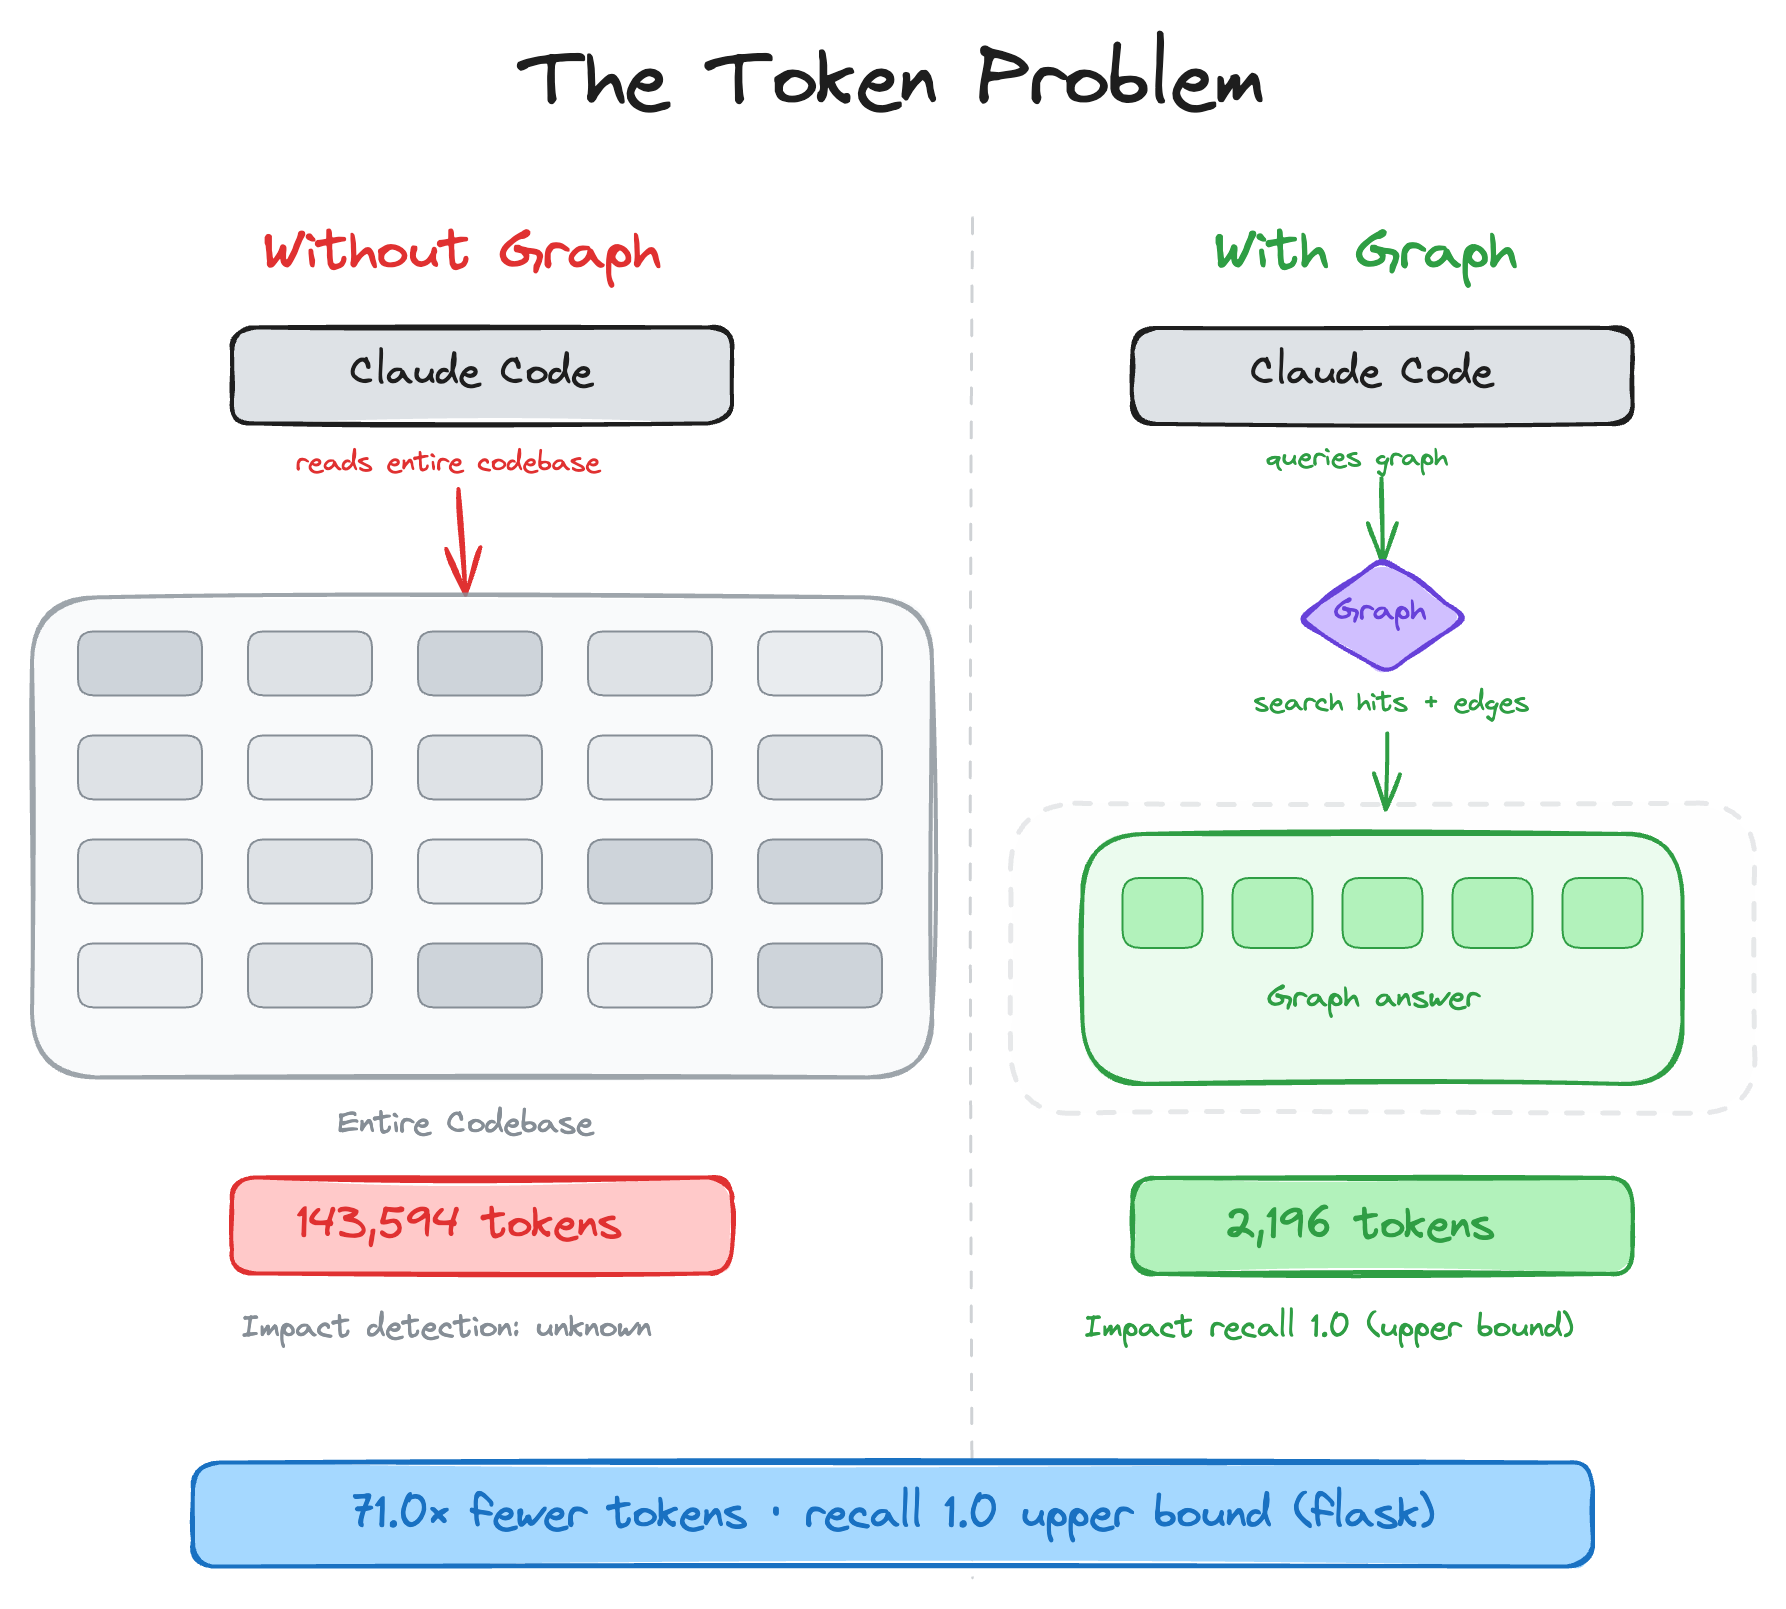
AI 编码工具为了审查一次改动,常常要重新读取代码库的大部分内容。`code-review-graph` 用 [Tree-sitter](https://tree-sitter.github.io/tree-sitter/) 构建代码的结构图,增量保持更新,并通过 [MCP](https://modelcontextprotocol.io/) 提供紧凑的上下文,让助手只读取改动涉及的文件。
---
## 快速开始
```bash
pip install code-review-graph # or: pipx install code-review-graph
code-review-graph install # detect installed AI coding tools and configure each one
code-review-graph build # parse the codebase
```
`install` 会检测你安装了哪些 AI 编码工具,为每个工具写入一条 MCP 服务器配置,在平台支持的地方安装钩子和技能,并把图谱说明加入平台的规则文件。在 Poetry 或 uv 项目环境中,MCP 配置使用 `poetry run` 或 `uv run`;当 PATH 上有 `uvx` 时使用 `uvx code-review-graph serve`;否则使用当前的 Python 解释器。安装后请重启编辑器或工具。
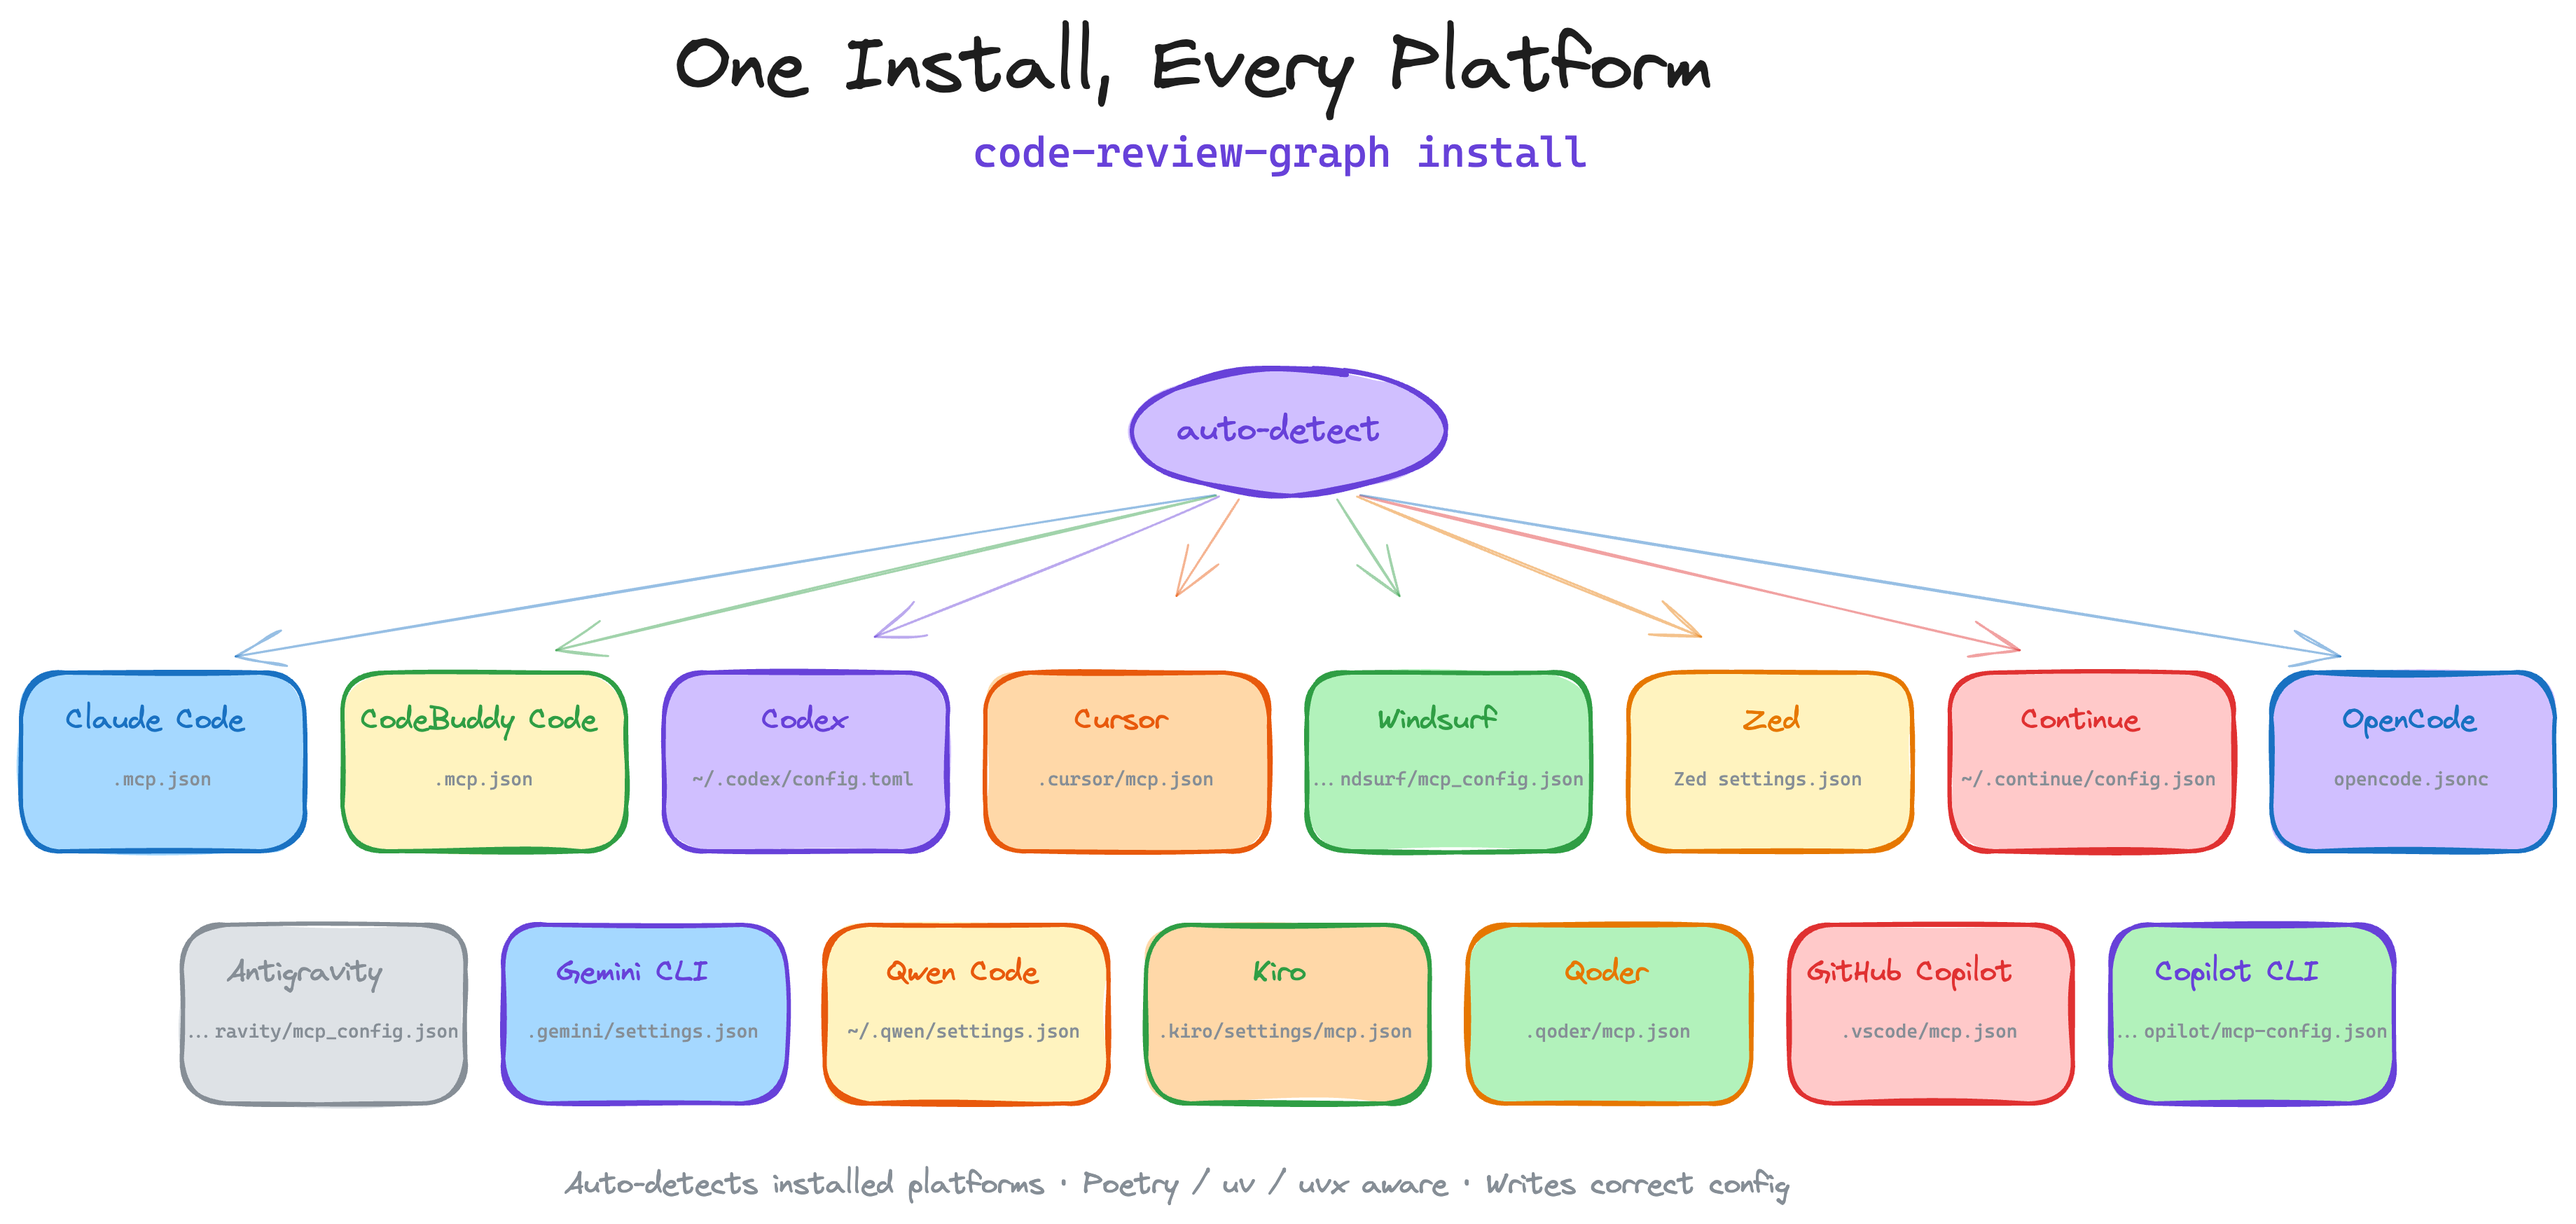
只配置一个平台时,给 `--platform` 传入 `codex`、`claude-code`、`cursor`、`windsurf`、`zed`、`continue`、`opencode`、`antigravity`、`gemini-cli`、`qwen`、`kiro`、`qoder`、`copilot`、`copilot-cli`、`codebuddy` 或 `hermes` 之一:
```bash
code-review-graph install --platform cursor
code-review-graph install --platform codebuddy
```
配置文件的位置列在 [docs/USAGE.md](docs/USAGE.md#supported-platforms) 中。需要 Python 3.10+。
`uninstall` 会从 Git 或 SVN 工作树中移除 CRG 自己写入的文件和配置项,不动其他 MCP 服务器、钩子、技能和 JSONC 注释。在工作树内的任意位置运行即可。共享配置文件采用原子替换,写入失败时原文件保持完整。
```bash
code-review-graph uninstall --dry-run # preview only
code-review-graph uninstall # preview, confirm, apply
code-review-graph uninstall --yes # apply without prompting
code-review-graph uninstall --all-repos # also clean every registered repository
code-review-graph uninstall --keep-data # remove integrations, keep graph databases
code-review-graph uninstall --keep-user-configs --repo . # this project only
```
然后打开项目,对助手说:
```
Build the code review graph for this project
```
构建时间随仓库规模增长;一个约 3,000 个文件的仓库冷构建约需 40 秒([实测](docs/REPRODUCING.md#incremental-update-latency))。之后由钩子和 watch 模式保持图谱更新。如果部分文件解析失败,结果状态为 `partial` 并在摘要中列出这些文件;CLI 还会在 stderr 上打印一行 `Warning:`,这些文件保留原有的图谱记录。
## 工作原理
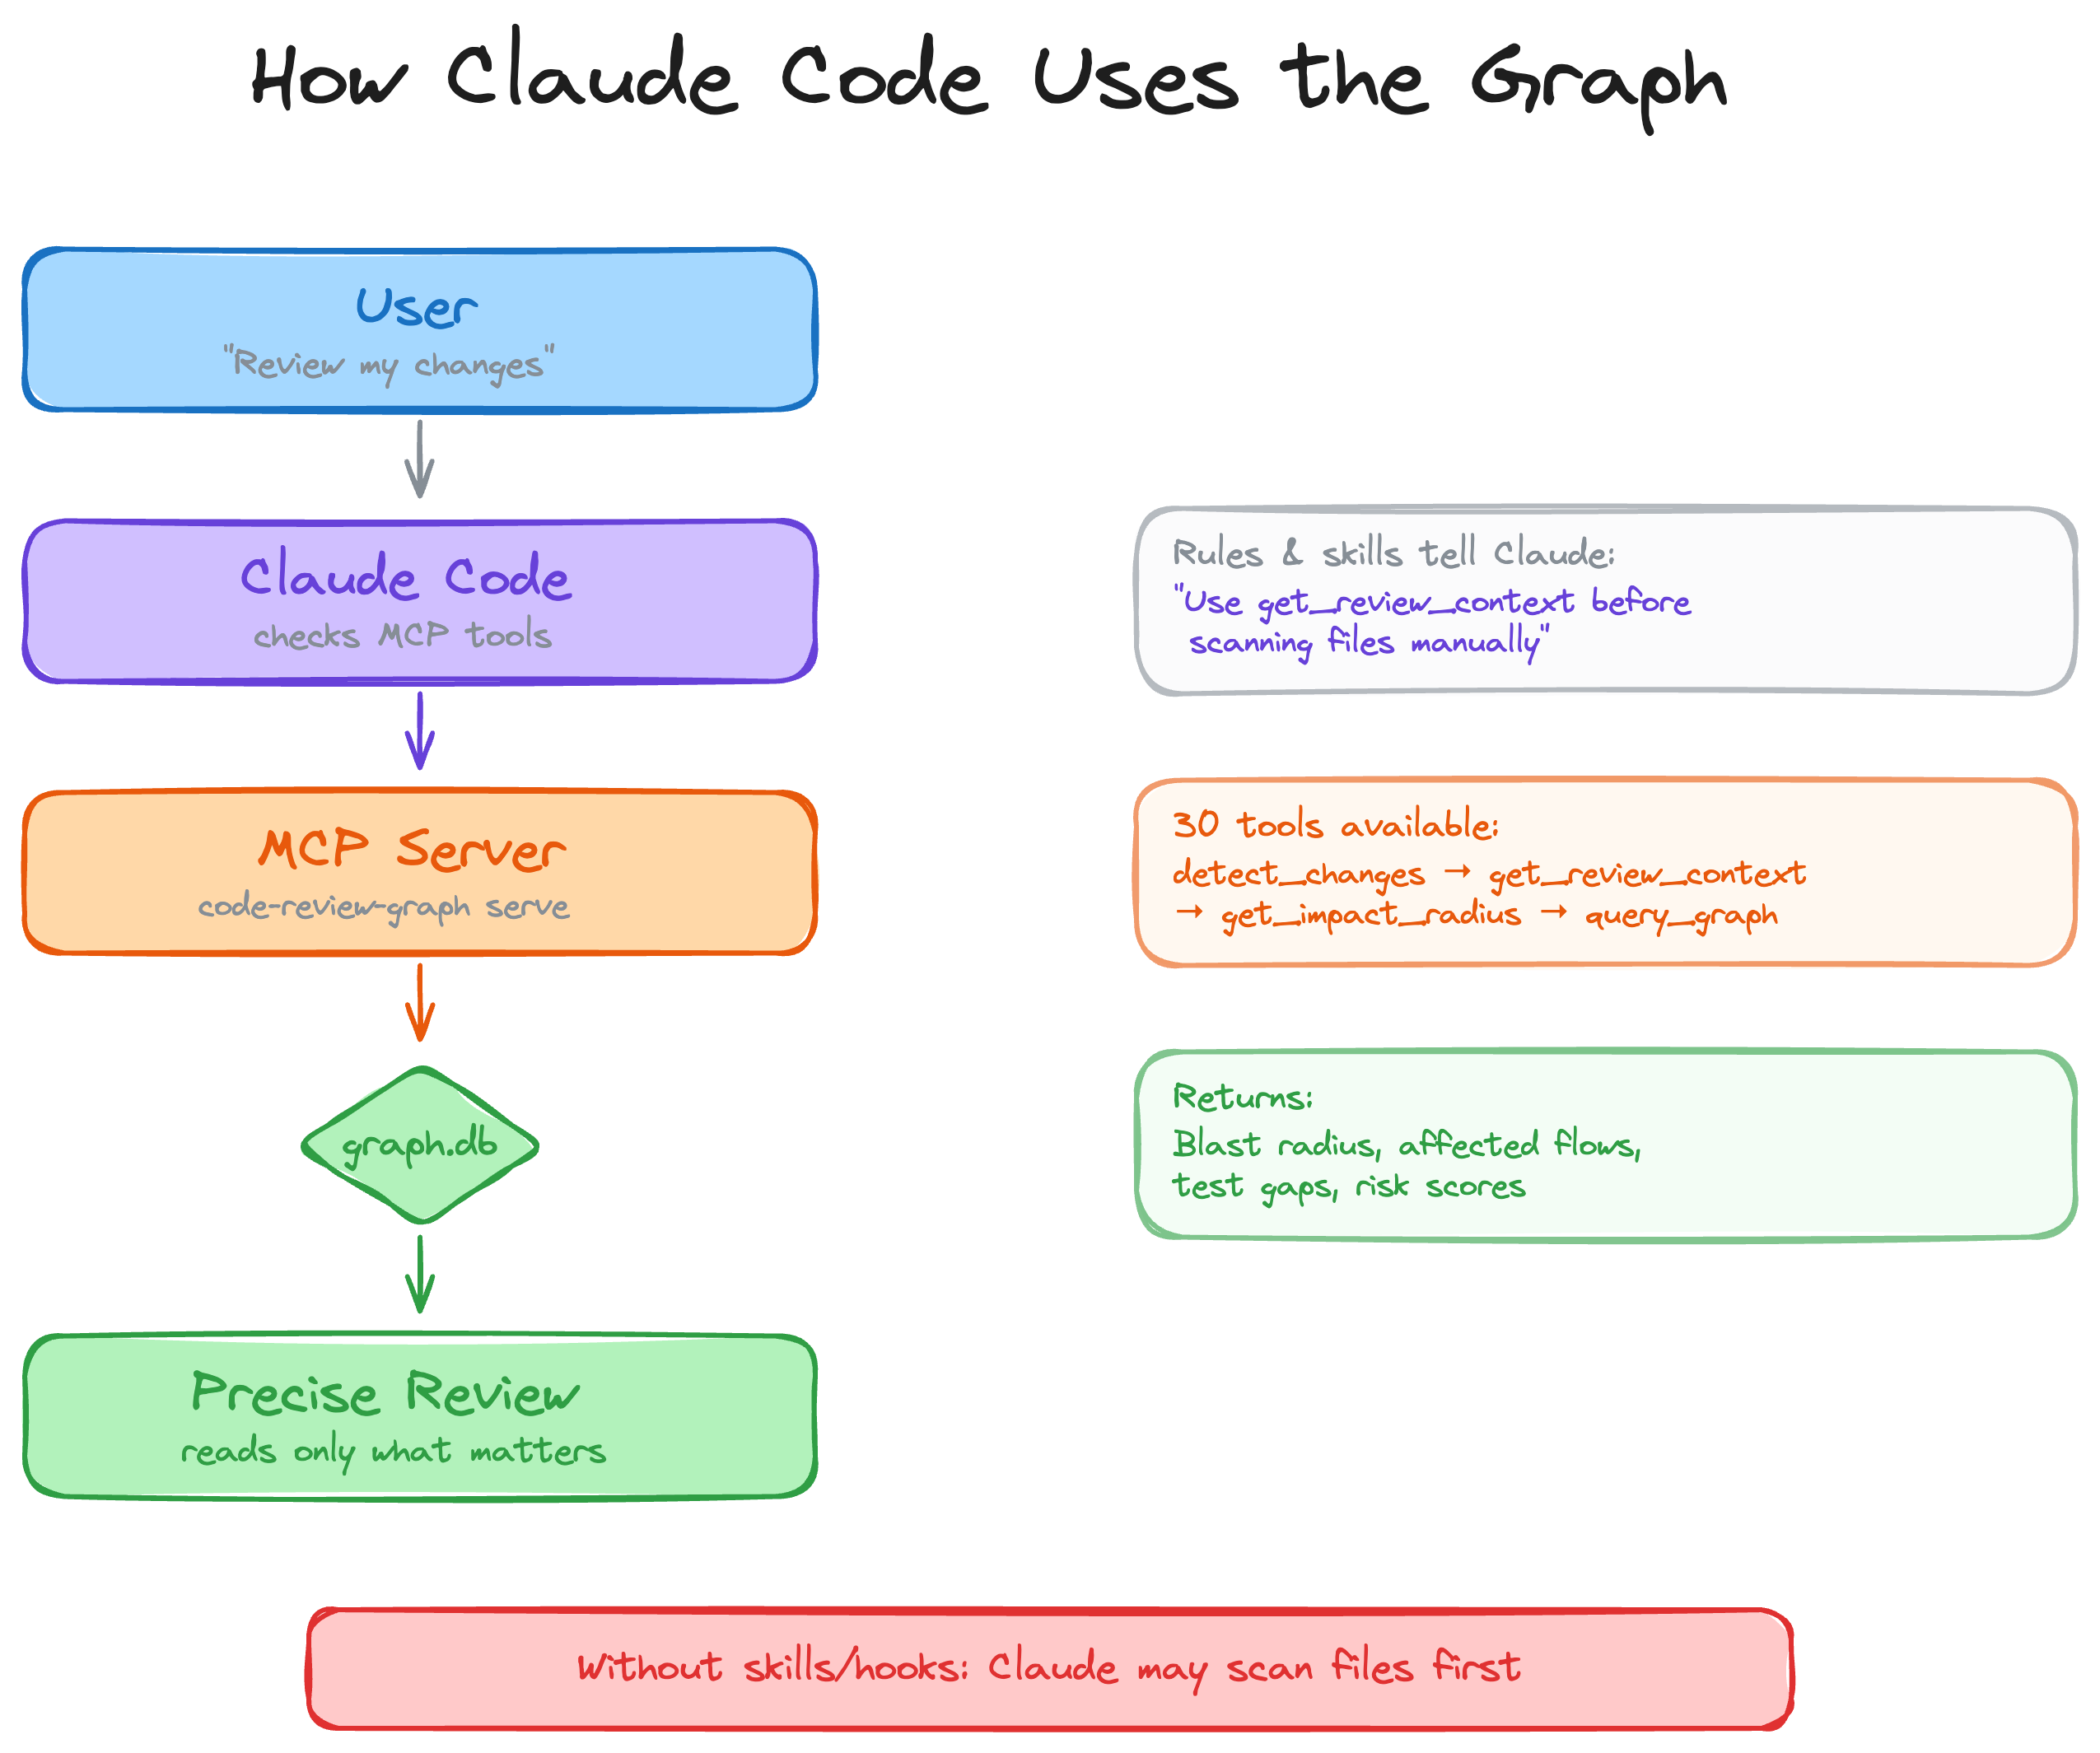
仓库通过 Tree-sitter 解析为 AST,并以节点(函数、类、导入)和边(调用、继承、测试覆盖)的形式存为图谱。审查时查询图谱,得到助手需要读取的最小文件集合。
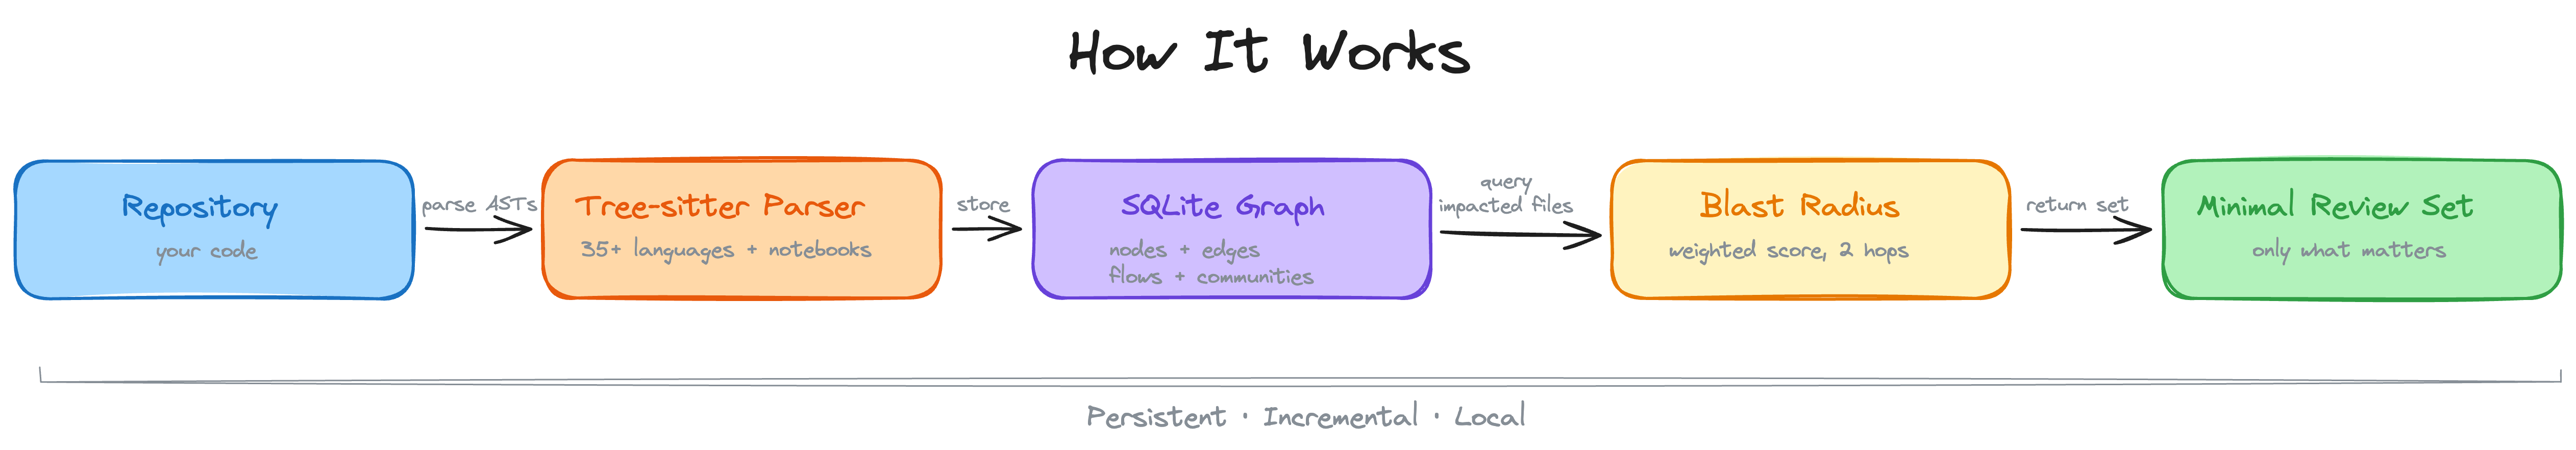
### 影响半径分析
文件变更时,图谱会追踪所有可能受影响的调用者、依赖方和测试。助手读取这些文件,而不是扫描整个项目。
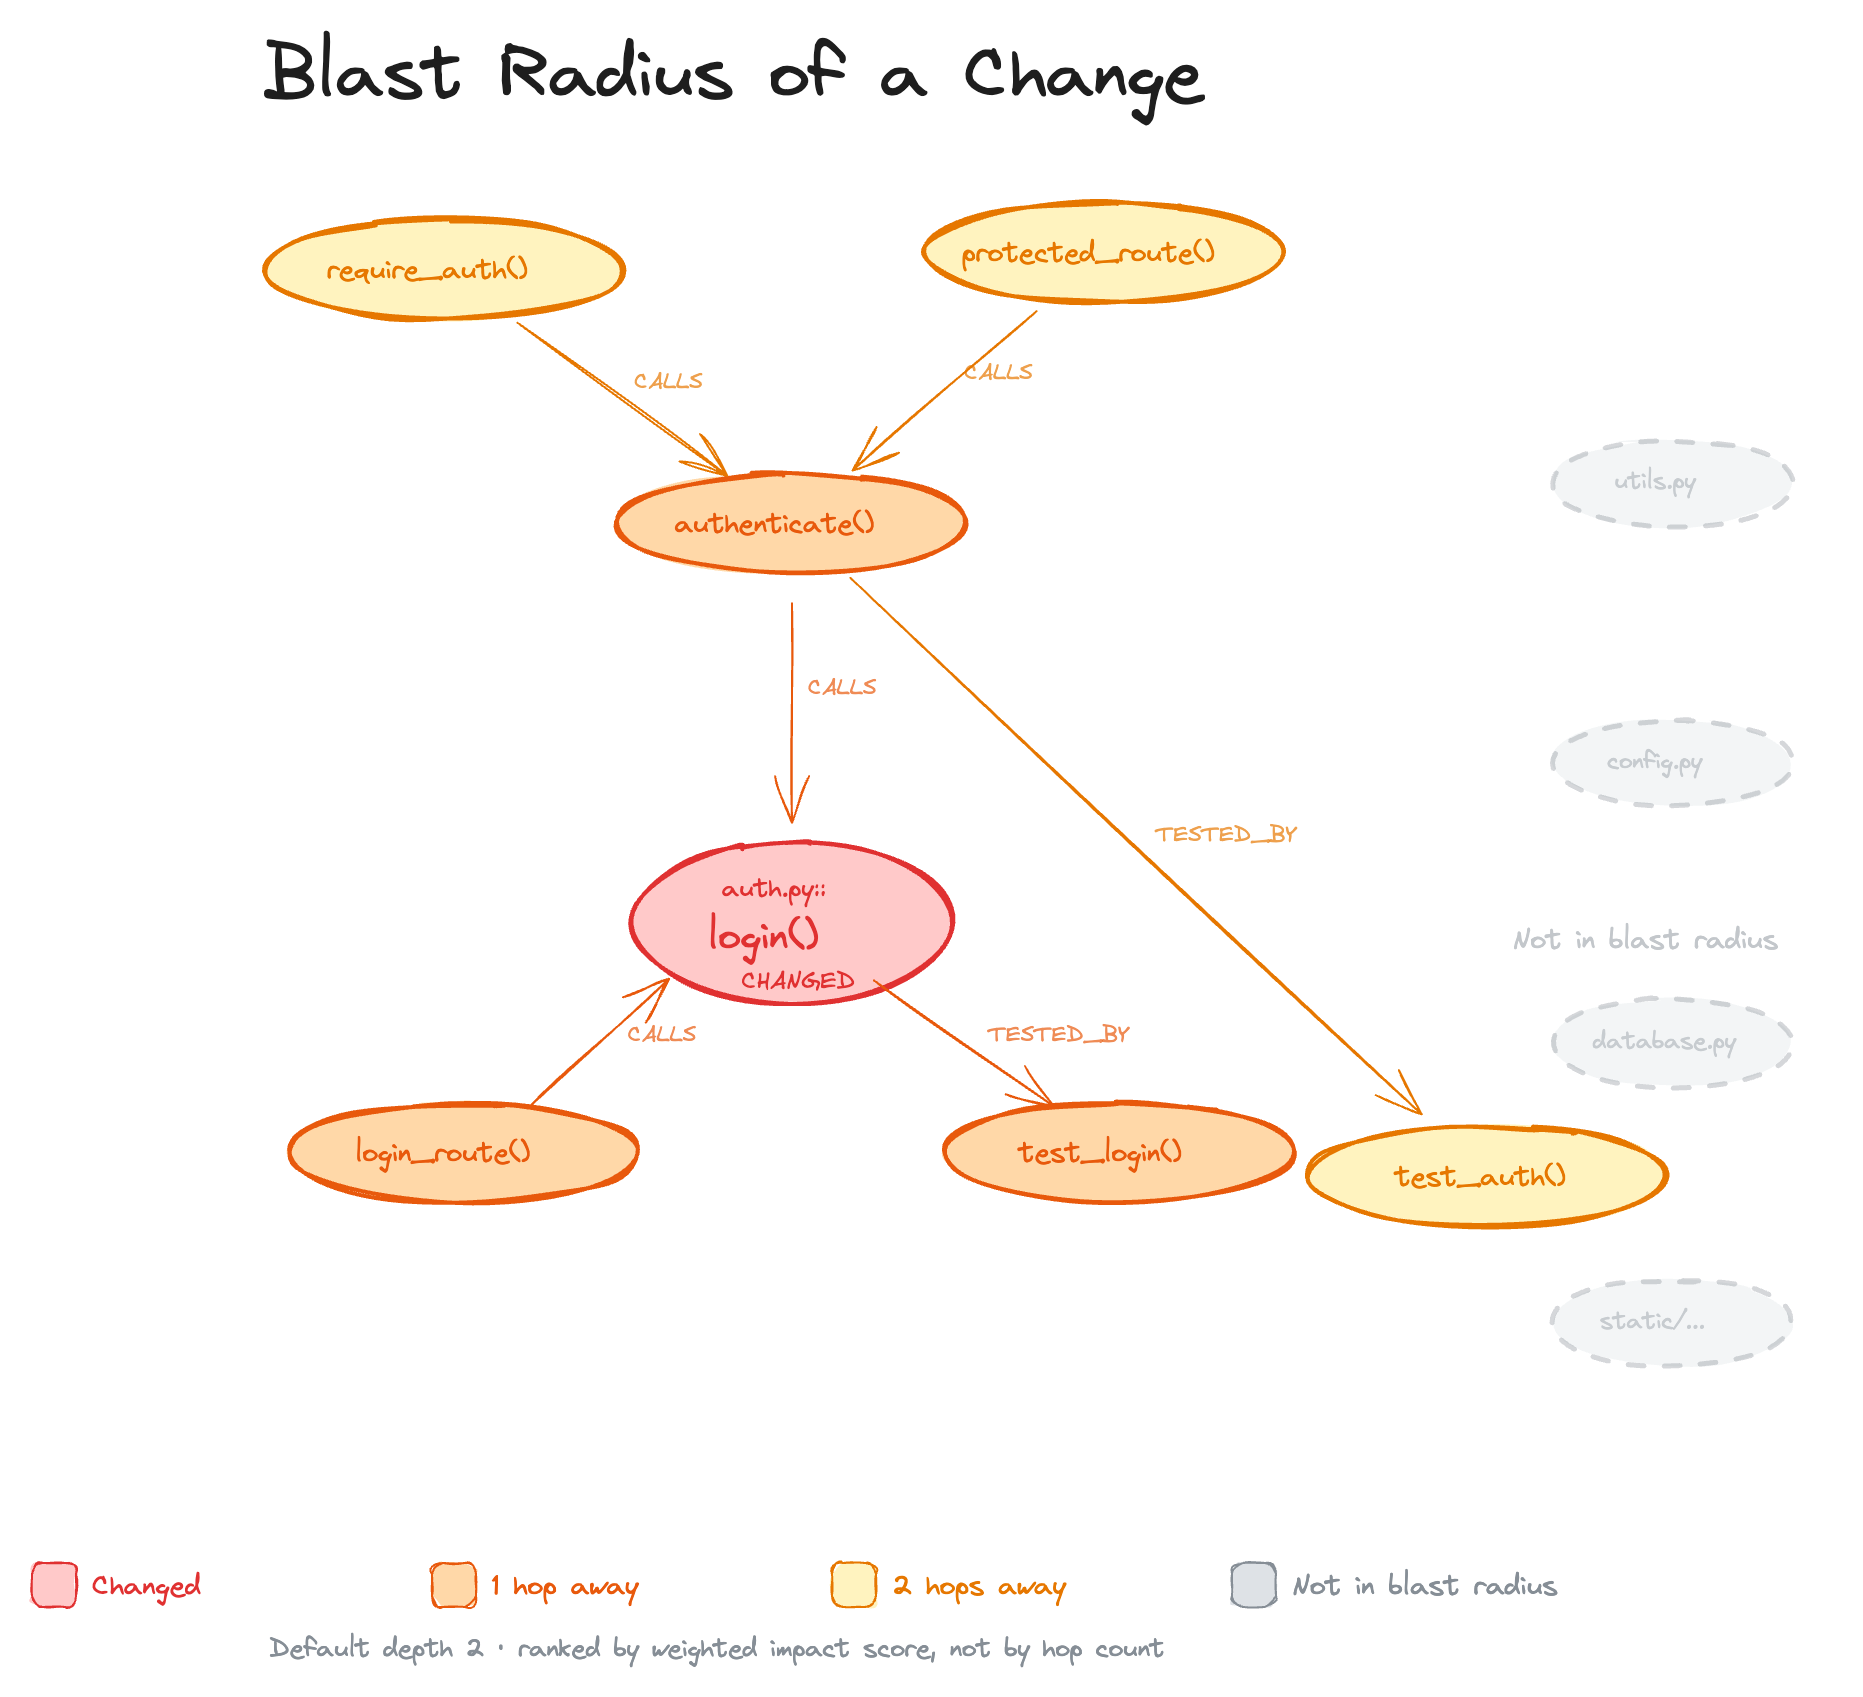
### 增量更新
钩子、pre-commit 钩子和 watch 模式都会触发增量更新。更新时对变更文件做 diff,沿图谱的导入边和调用边找出依赖方,并只重新解析 SHA-256 哈希发生变化的文件。在一个约 3,000 个文件的项目(django)上,修改两个文件后沿钩子路径重新索引约需 2.5 秒,其中约 1.4 秒是进程启动;空更新只花这段启动时间。参见[增量更新延迟](docs/REPRODUCING.md#incremental-update-latency)。
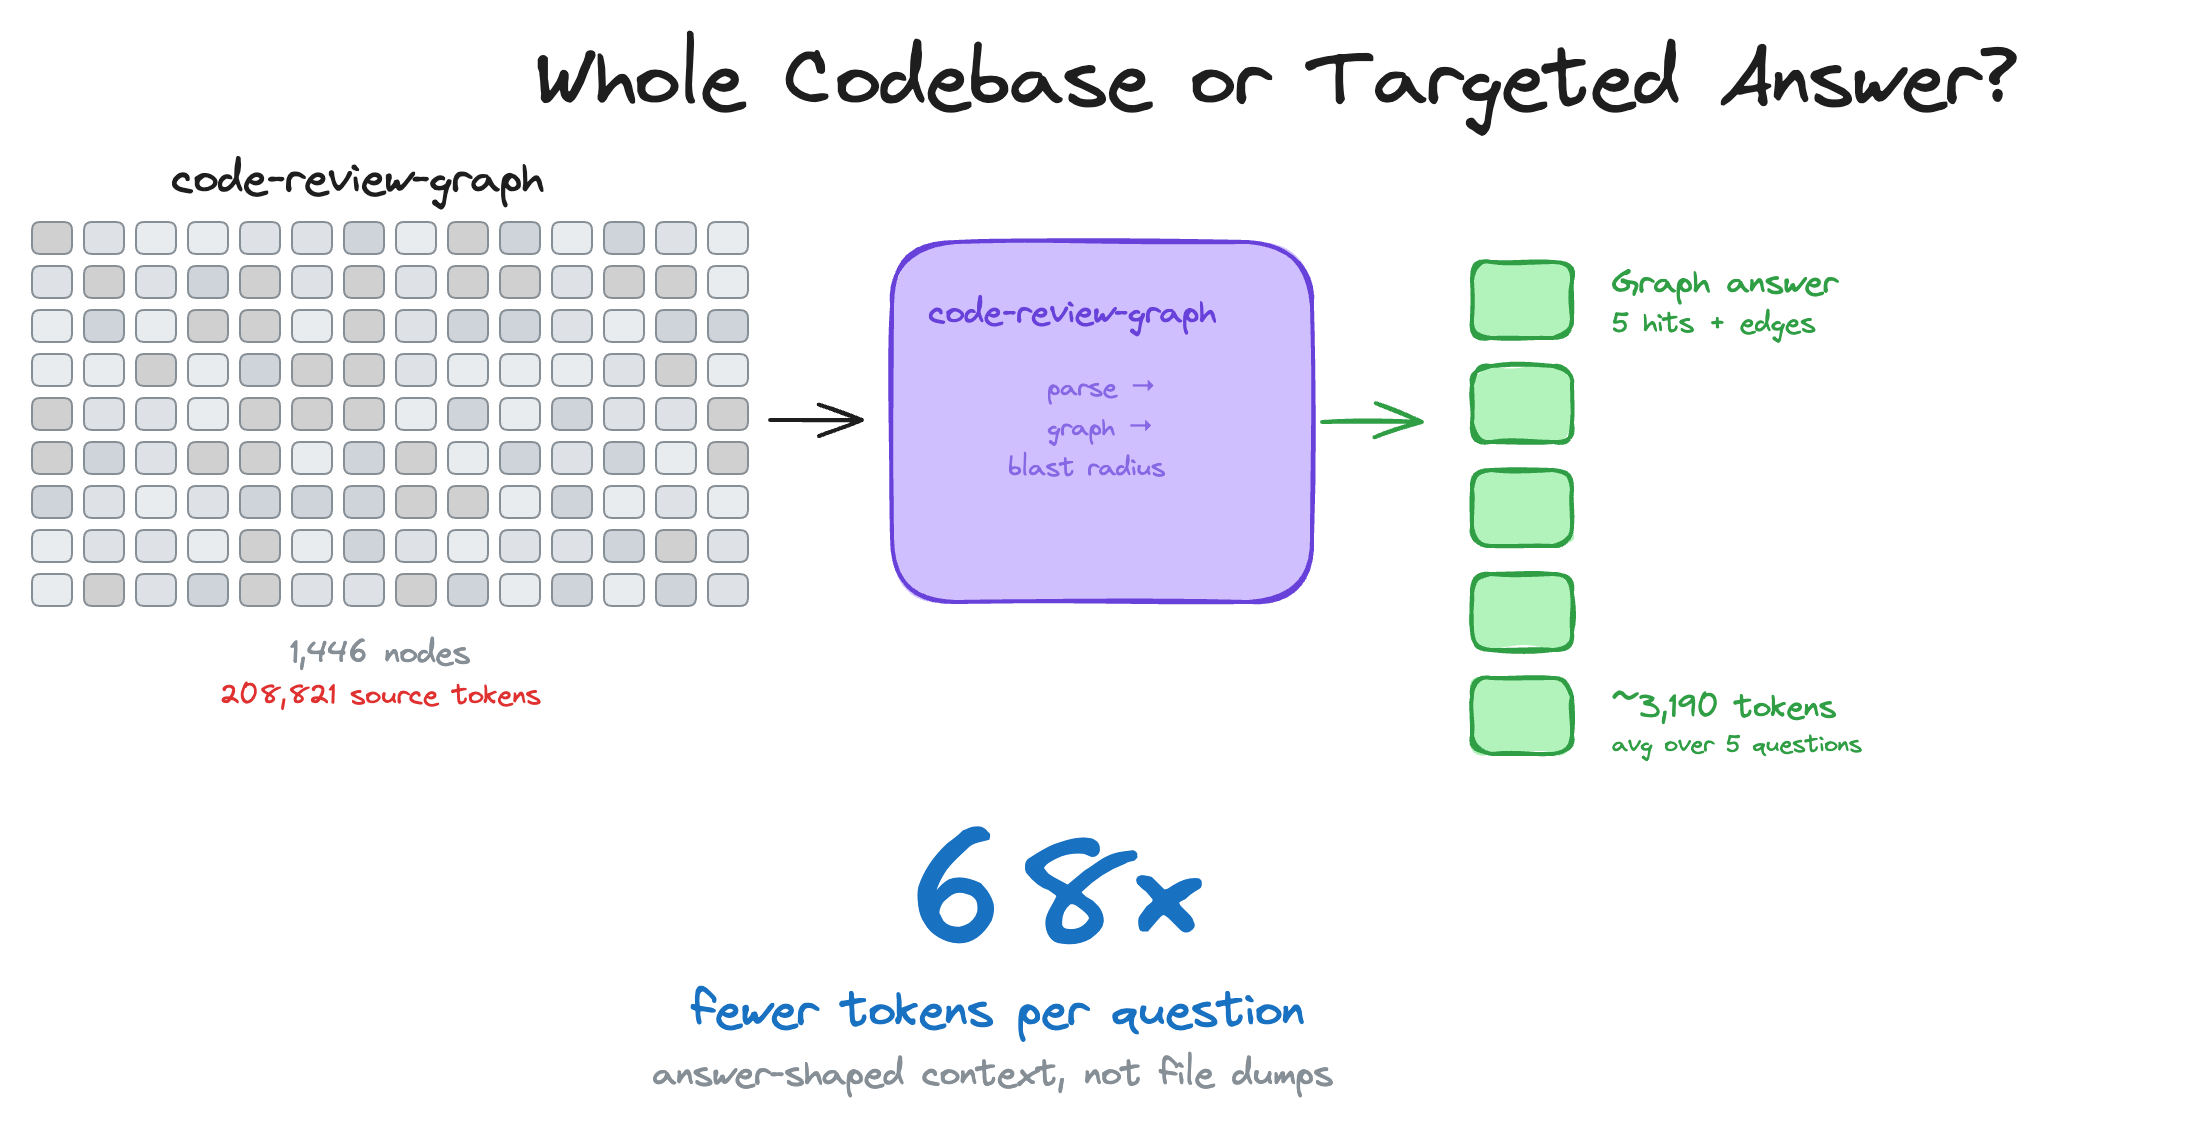
### 整个代码库,还是有的放矢的回答?
图谱不会把整个语料喂给模型,而是返回按问题裁剪的切片。在 2026-08-02 对本仓库 `84bde354` 的快照中,208,821 个源码 token 变成每个问题约 3,190 个 token。此后仓库增长了很多,所以今天这两个数字都更大。
### 语言覆盖与笔记本
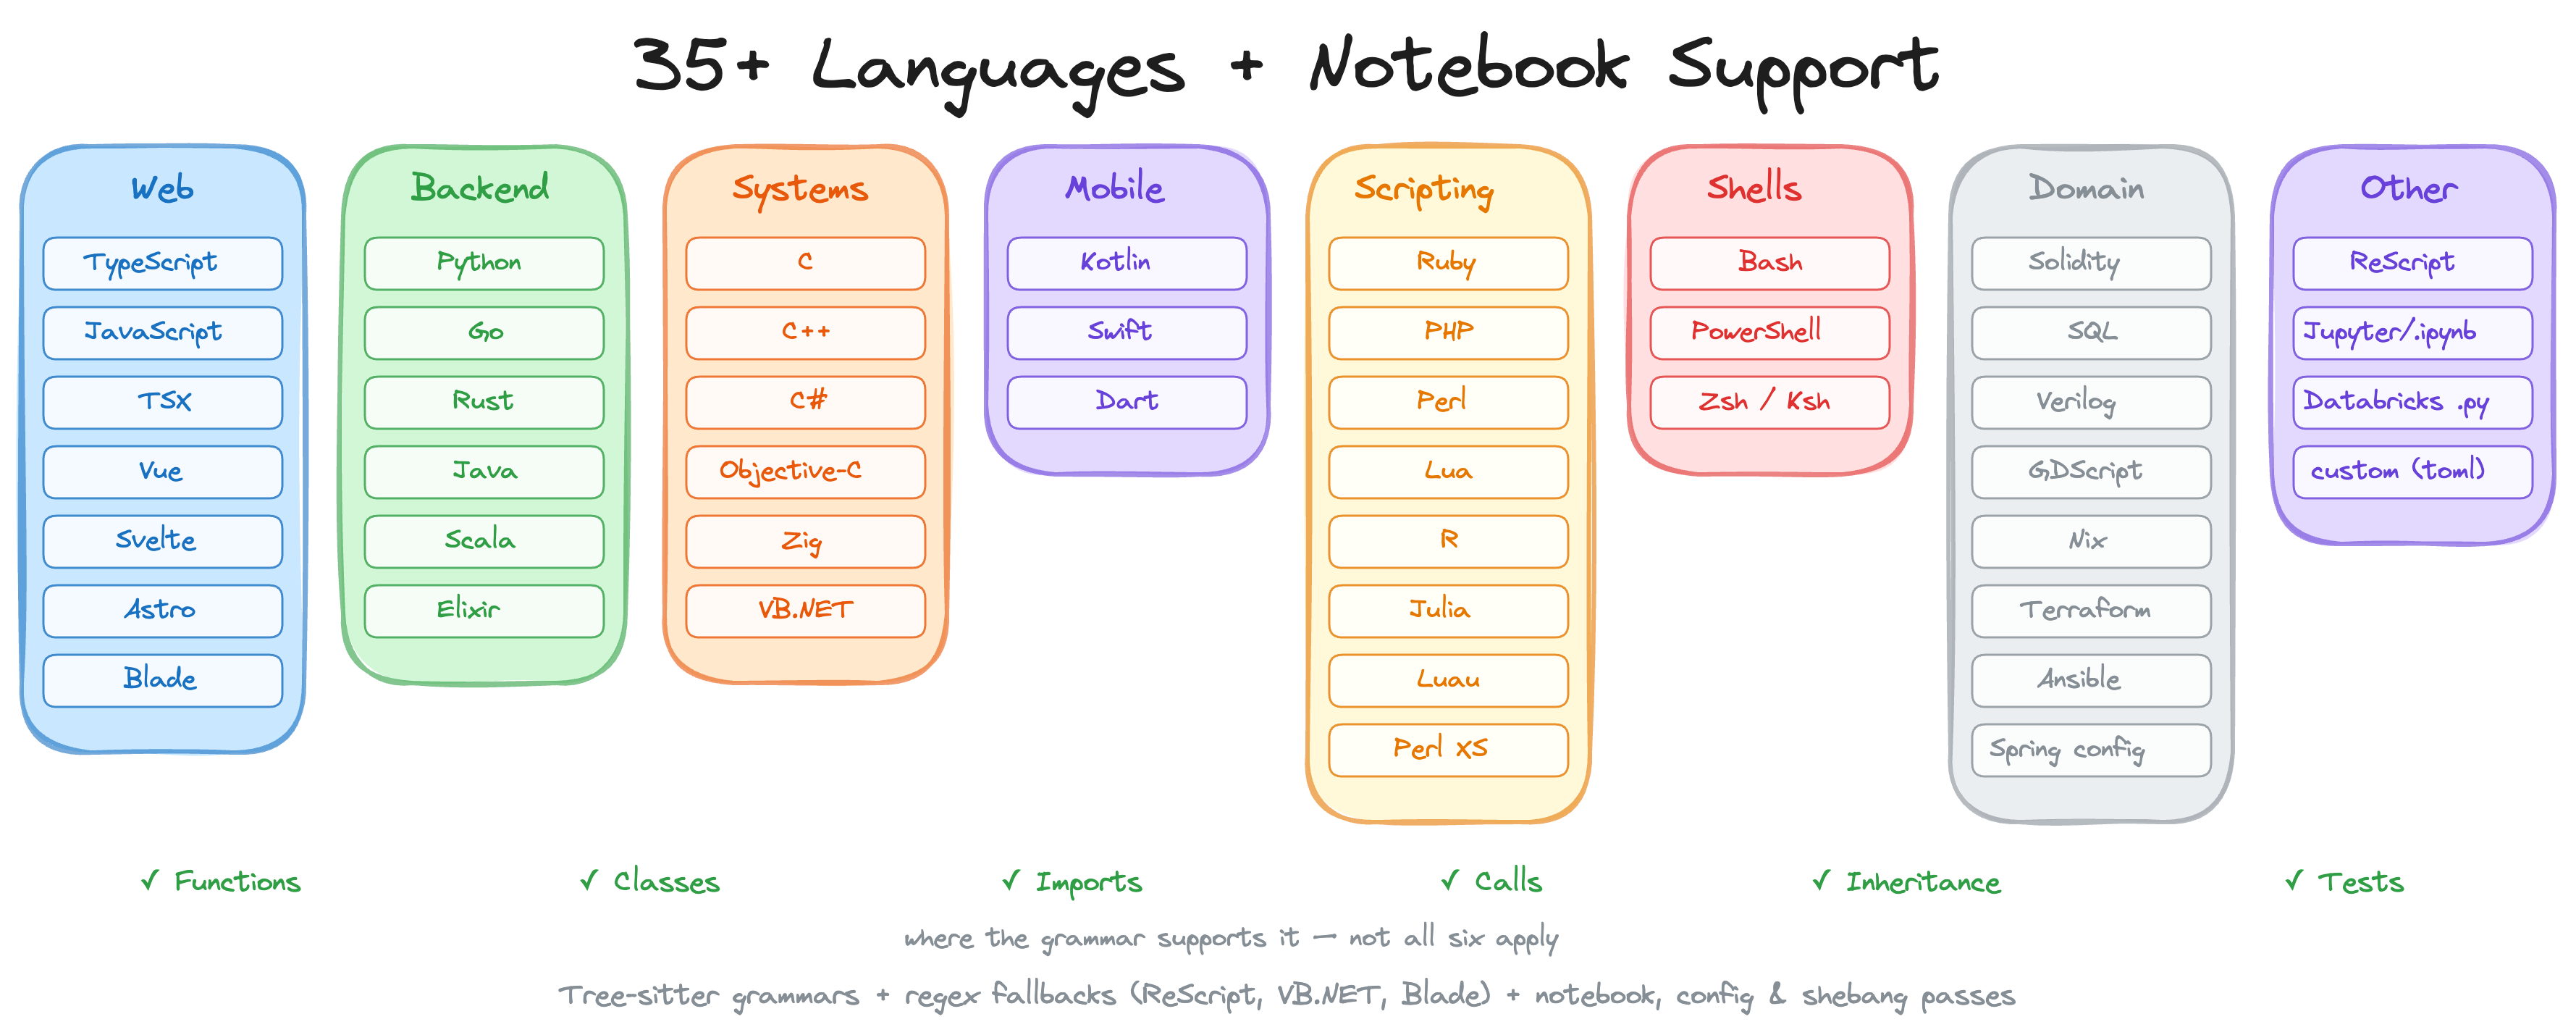
解析器提取函数、类、导入、调用点、继承和测试:有语法的地方用 Tree-sitter,其他地方用有针对性的回退解析。支持范围:Python、JavaScript/TypeScript/TSX、Go、Rust、Java、C/C++、C#、VB.NET、Ruby、Kotlin、Swift、PHP、Scala、Solidity、Dart、R、Perl、Lua/Luau、Objective-C、shell 脚本、Elixir、Zig、PowerShell、Julia、ReScript、GDScript、Nix、Verilog/SystemVerilog、SQL、Terraform/OpenTofu(`.tf`;其他 `.hcl` 文件只生成文件节点)、Ansible YAML(playbook、role、task)、Spring Boot 应用配置(`application.properties`、`application.yml`、`application.yaml` 及其 `application-` 变体;只记录键名和值的类型,绝不记录值)、Vue/Svelte 单文件组件、Astro 文件(用 TypeScript 语法解析)、Jupyter 和 Databricks 笔记本(`.ipynb`),以及 Perl XS 文件(`.xs`)。其他 YAML 和其他 `.properties` 文件不被当作源代码。
PHP 项目还会得到仓库范围内的 Composer PSR-4 解析、Blade 模板引用,以及在源码中出现明确的框架导入、模型继承和接收者证据时生成的 Laravel Route 与 Eloquent 边。
Java 项目会得到 Spring 依赖注入的调用解析、请求端点与 WebFlux 路由、定时触发器、应用事件的发布者到监听者的边,以及 Temporal 工作流与活动的边。每个解析器都在解析之后运行,并且需要被注入的字段、发布的事件或工作流 stub 在仓库中可见。
### 添加你自己的语言
如果你的仓库使用了解析器尚未覆盖的语言,在 `.code-review-graph/` 中添加一个 `languages.toml`,把文件扩展名映射到 `tree_sitter_language_pack` 中自带的任意语法,并给出函数、类、导入和调用的节点类型:
```toml
[languages.erlang]
extensions = [".erl"]
grammar = "erlang"
function_node_types = ["function_clause"]
class_node_types = ["record_decl"]
import_node_types = ["import_attribute"]
call_node_types = ["call"]
```
提取工作由通用的 tree-sitter 遍历器完成。内置语言不能被覆盖。schema、校验规则和完整示例见 [docs/CUSTOM_LANGUAGES.md](docs/CUSTOM_LANGUAGES.md)。
### 在 CI 中做风险评分的 PR 审查(GitHub Action)
同样的分析也以组合式 GitHub Action 的形式运行。图谱在你的 CI runner 上构建和查询,不会把源代码发送给外部服务。每个 pull request 上,该 action 会发布一条常驻评论,列出风险评分的函数、受影响的执行流和测试缺口,并在每次推送时就地更新。可选的 `fail-on-risk` 输入可以把它变成合并门禁。
```yaml
# .github/workflows/code-review-graph.yml
on:
pull_request:
permissions:
contents: read
pull-requests: write
jobs:
review:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v7
- uses: tirth8205/code-review-graph@v2.3.9
with:
github-token: ${{ secrets.GITHUB_TOKEN }}
```
输入参数、风险等级和缓存见 [docs/GITHUB_ACTION.md](docs/GITHUB_ACTION.md),本仓库自己运行的工作流见 [`.github/workflows/pr-review.yml`](.github/workflows/pr-review.yml)。
---
## 基准测试
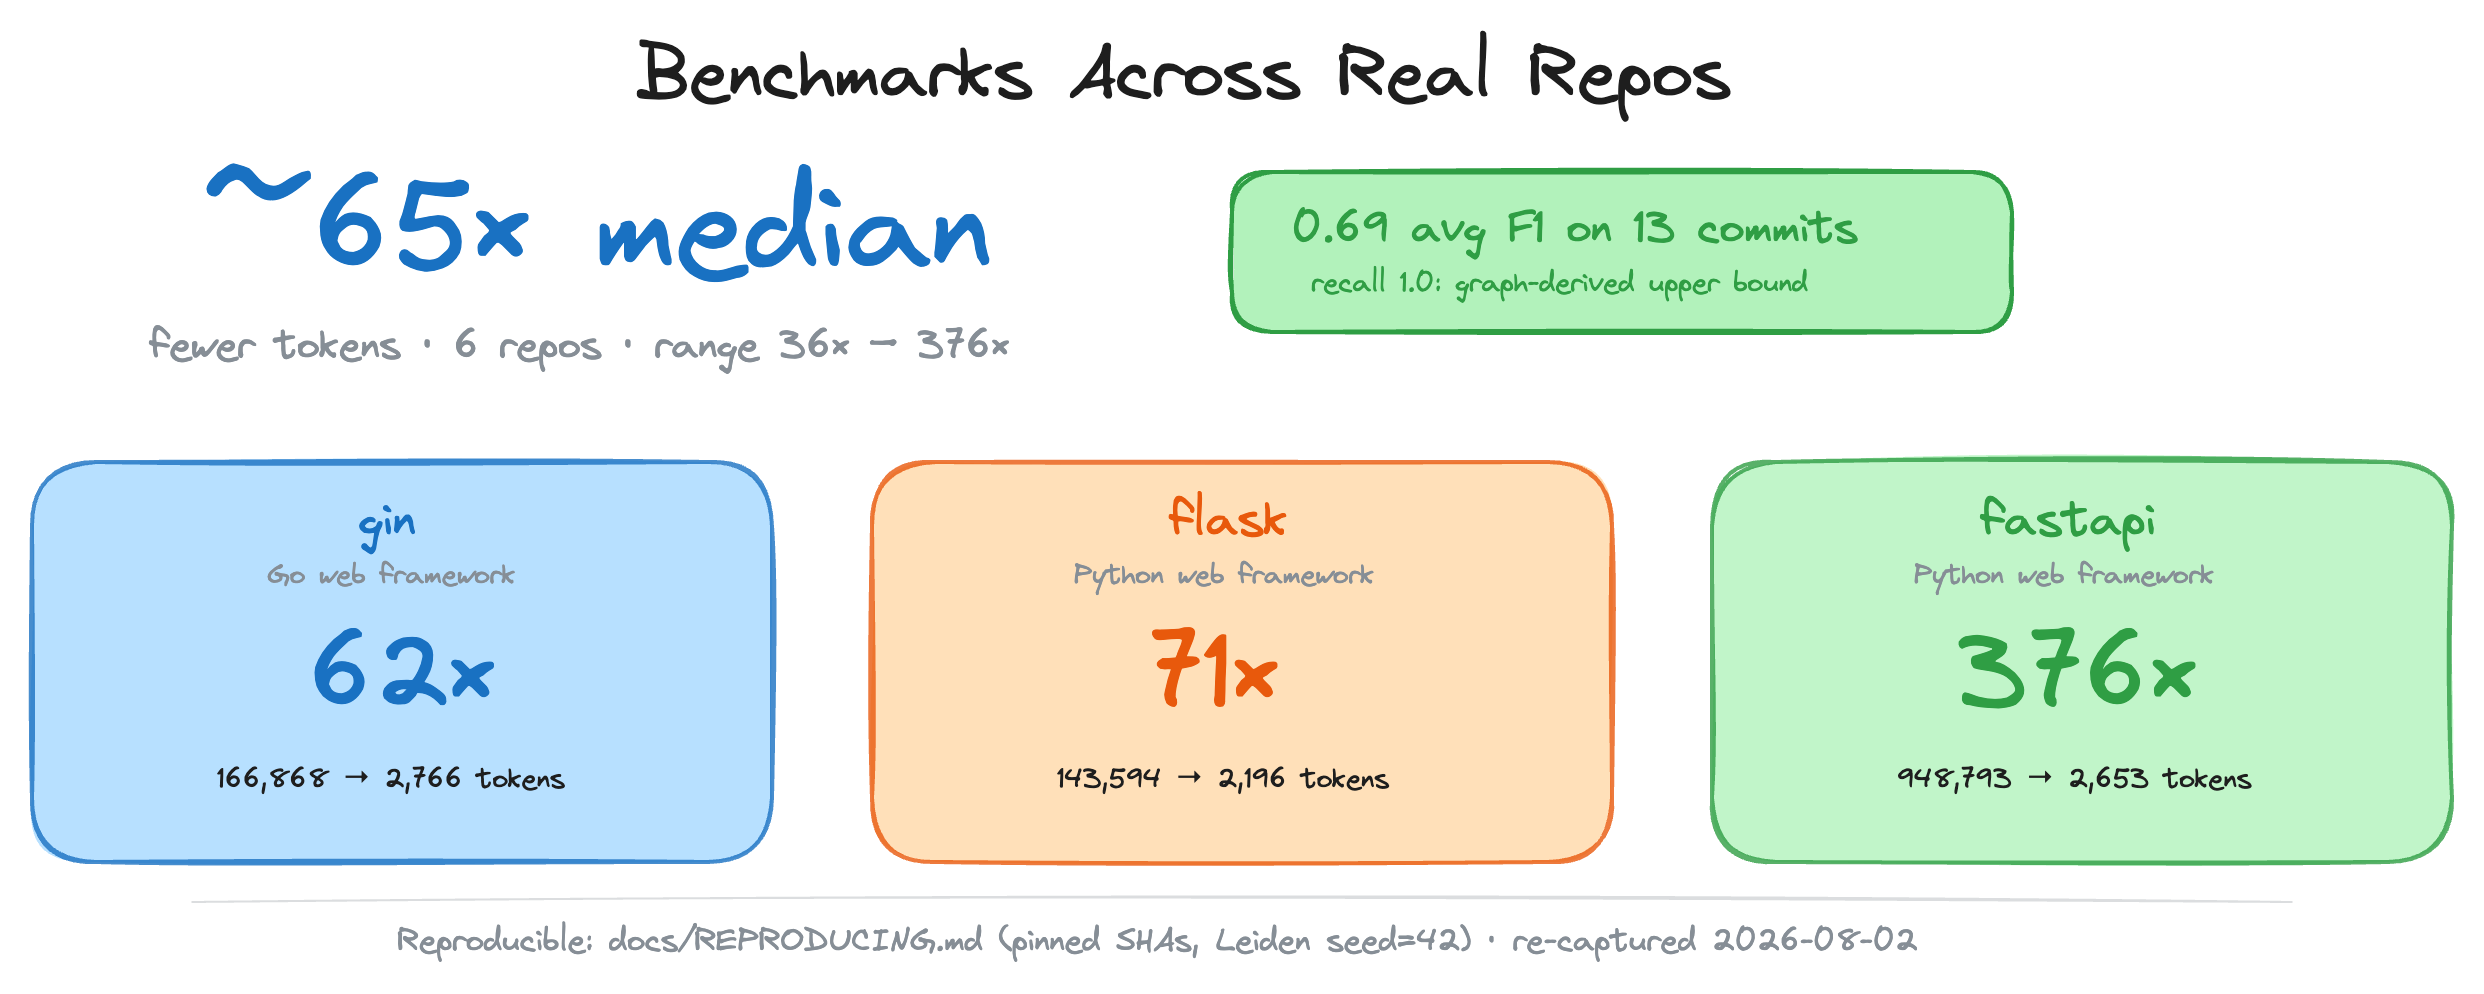
6 个仓库上每个问题的 token 减少中位数约为 **63 倍**(全语料基线对比图谱查询)。**358 倍**的最大值只属于一个仓库(fastapi,语料最大),不是典型结果。
所有数字都来自针对 6 个开源仓库(13 次提交)的评估运行器。每个配置都固定了上游 SHA,Leiden 使用固定随机种子,嵌入在 CPU 上是确定性的,因此不同机器上的两次运行得到相同的数字。复现步骤见 [`docs/REPRODUCING.md`](docs/REPRODUCING.md)。在两个最小配置上的每周只读运行位于 [`.github/workflows/eval.yml`](.github/workflows/eval.yml)。
Token 效率:每个问题减少中位数约 63 倍(范围 35 倍到 358 倍;全语料对比图谱查询)
对于典型的智能体问题(`"how does authentication work"`、`"what is the main entry point"` 等),图谱返回约 2,200 到 3,900 个 token 的搜索命中加邻接边,而不是每一个源文件。表格对 `code_review_graph/token_benchmark.py` 中定义的 5 个样例问题取平均。
| 仓库 | 快照 SHA | naive_corpus_tokens | avg graph_tokens | 减少倍数 |
|------|---|-----------------:|----------------:|----------:|
| fastapi | `22381558` | 948,793 | 2,653 | **357.6x** |
| flask | `a29f88ce` | 143,594 | 2,196 | **65.4x** |
| code-review-graph | `84bde354` | 208,821 | 3,190 | **65.5x** |
| gin | `5c00df8a` | 166,868 | 2,766 | **60.3x** |
| httpx | `b55d4635` | 142,356 | 2,661 | **53.5x** |
| express | `b4ab7d65` | 136,052 | 3,936 | **34.6x** |
> 2026-08-02 从固定 SHA 的干净克隆中采集(crg 2.3.7,本地 `all-MiniLM-L6-v2` 嵌入)。这些数字低于它们取代的 2026-05-25 采集:节点嵌入文本变得更丰富,因此每个仓库的 `avg graph_tokens` 都上升了。fastapi 按当前固定的 `22381558` 测量,而不是已退役的 `0227991a`。
>
> 减少倍数一列是 `naive_corpus_tokens / avg graph_tokens`,因此可以由旁边两列直接除出来。基准测试自己的 `average_reduction_ratio` 取的是五个问题各自比率的平均值,那个值总是更高;每个问题的数字见 [`docs/REPRODUCING.md`](docs/REPRODUCING.md#standalone-token-benchmark-code_review_graphtoken_benchmarkpy)。
>
> `code-review-graph` 这一行是快照,不是当前测量值。仓库自 `84bde354` 以来有所增长,其语料和图谱今天都大得多。
全语料基线是任何真实智能体都不会付出的上限;智能体会 grep 标识符并读取最匹配的文件。`agent_baseline` 评估基准测量的就是这种情况(纯 Python 对语料做 grep,按匹配数取前 3 个文件,再与图谱查询开销做 token 对比)。它写入 `evaluate/results/_agent_baseline_.csv`;目前还没有发布过权威采集结果。
正式的 `token_efficiency` 基准测量的是另一个场景:完整的 `get_review_context()` JSON 对比一次提交中仅变更文件的内容;对于小提交,它报告的比率低于 1,因为响应里带有影响半径的边和源码片段。这两个基准回答的是不同的问题,见 [`docs/REPRODUCING.md`](docs/REPRODUCING.md#which-benchmark-measures-what)。
审查和影响类工具会在响应中附带紧凑的 `context_savings` 估算。CLI 在 `Token Savings` 面板中显示同样的数字(见下文使用方式),`--verify` 会把它们与 OpenAI 的 `cl100k_base` 分词器做对比。在 222 个样本文件上的校准表明,总体估算与真实 token 的偏差约在 1% 以内([数据](docs/REPRODUCING.md#calibration-table))。
影响准确度:对图谱生成的基准答案平均 F1 为 0.69(召回率 1.0 是循环论证得出的上限)
在全部 13 次评估提交上,影响半径分析都找回了基准答案中的每一个文件。请把它读作上限,而不是"100% 召回":基准答案(变更文件加上有调用边或导入边指向它们的文件)来自预测器所遍历的同一张图谱。较低的精确率是有意为之;多标一个文件的代价小于漏掉一个被破坏的依赖。
| 仓库 | 提交数 | 平均 F1 | 平均精确率 | 召回率(图谱生成的上限) |
|------|--------:|-------:|--------------:|-------:|
| httpx | 2 | 0.863 | 0.785 | 1.0 |
| code-review-graph | 2 | 0.734 | 0.584 | 1.0 |
| fastapi | 2 | 0.697 | 0.539 | 1.0 |
| express | 2 | 0.667 | 0.500 | 1.0 |
| flask | 2 | 0.633 | 0.485 | 1.0 |
| gin | 3 | 0.609 | 0.439 | 1.0 |
| **平均** | **13** | **0.693** | **0.546** | **1.000** |
该基准还会运行一种**共变更模式**:给预测器一个变更文件作为种子,再用作者在同一次提交中改动的其他文件来评分,这是来自 git 历史而非图谱的证据。两种模式都出现在结果 CSV 中(`ground_truth_mode` 列)。在 2026-08-02 的采集中,共变更模式在每个被评分的提交上都返回 `predicted_files = 0`,因此它还不是可用的测量结果,也不引用任何共变更数字。
构建统计
来自上文固定 SHA 的同一次 2026-08-02 干净构建。嵌入数量低于节点数量,因为 File 节点不做嵌入。`code-review-graph` 这一行是那个快照,不是仓库现在的状态。
| 仓库 | 节点 | 边 | 嵌入 |
|------|------:|------:|-----------:|
| fastapi | 6,287 | 32,036 | 5,159 |
| express | 1,990 | 19,492 | 1,849 |
| gin | 1,589 | 17,237 | 1,491 |
| code-review-graph | 1,446 | 9,094 | 1,354 |
| flask | 1,415 | 8,259 | 1,329 |
| httpx | 1,263 | 8,236 | 1,193 |
### 局限
- **影响分析的"召回率 1.0"是循环论证。** 历史基准答案来自预测器所遍历的同一批图谱边,因此按构造它就是一个上限。共变更模式还不是可用的测量结果。
- **小的单文件改动。** 对于琐碎的编辑,图谱上下文可能比直接读文件还大。多出来的是让多文件分析成为可能的结构化元数据。
- **搜索排序。** 关键词搜索通常能把正确结果排在靠前位置,但排序还需要改进。由于模块模式的命名方式,针对 Express 的查询可能返回零命中。
- **执行流检测。** 入口点检测对 Python 和 PHP/Laravel 最强。JavaScript 和 Go 的流检测还需要改进。
- **精确率与召回率。** 影响分析偏保守。它会标出可能受影响的文件,这意味着在大型依赖图中会出现误报。
---
## 功能
| 功能 | 说明 |
|---------|---------|
| **增量更新** | 只重新解析哈希发生变化的文件。在一个约 3,000 个文件的仓库上,修改两个文件沿钩子路径约需 2.5 秒([实测](docs/REPRODUCING.md#incremental-update-latency))。 |
| **语言与笔记本支持** | 见上文[语言覆盖](#语言覆盖与笔记本)。 |
| **框架感知的 PHP 解析** | 仓库范围内的 Composer PSR-4 导入、Blade 模板引用、有证据支撑的 Laravel Route 到控制器以及 Eloquent 关系边 |
| **框架感知的 Java 解析** | Spring 依赖注入的调用解析、请求端点与 WebFlux 路由、定时触发器、应用事件的发布者到监听者的边、Temporal 工作流与活动的边,以及只索引键名不索引值的 Spring Boot 配置键 |
| **影响半径分析** | 一次改动可能影响哪些函数、类和文件 |
| **自动更新钩子** | 编辑器钩子、git pre-commit 钩子和 watch 模式在你工作时更新图谱 |
| **语义搜索** | 可选的向量嵌入,通过 sentence-transformers、Google Gemini、MiniMax、Voyage AI,或任何 OpenAI 兼容端点(OpenAI、Azure、new-api、LiteLLM、vLLM、LocalAI) |
| **交互式可视化** | D3.js 力导向图,支持搜索、社区图例开关和按度数缩放的节点 |
| **枢纽与桥接检测** | 连接最多的节点和瓶颈点(介数中心性) |
| **意外度评分** | 意外耦合:跨社区、跨语言、外围到枢纽的边 |
| **知识缺口分析** | 孤立节点、未测试的热点、稀薄的社区 |
| **建议问题** | 从桥接点、枢纽和意外耦合生成的审查问题 |
| **边置信度** | 两级置信度(EXTRACTED/INFERRED),边上带浮点分数 |
| **图谱遍历** | 从任意节点出发的 BFS/DFS,深度和 token 预算可配置 |
| **导出格式** | GraphML(Gephi/yEd)、Neo4j Cypher、Obsidian 知识库、JSON,以及 SVG(SVG 需要 `eval` 附加依赖中的 matplotlib) |
| **Token 基准测试** | `code_review_graph/token_benchmark.py` 按问题测量全语料 token 与图谱查询 token |
| **估算的上下文节省** | 在审查、影响、detect-changes 和架构响应上附带 `context_savings` 元数据(`estimated`、`saved_tokens`、`saved_percent`) |
| **社区自动拆分** | 占图谱 25% 以上的社区用 Leiden 递归拆分 |
| **执行流** | 从入口点出发的调用链,按加权关键度排序 |
| **社区检测** | Leiden 聚类,分辨率随图谱规模调整 |
| **架构概览** | 基于社区结构的架构图,附带耦合警告 |
| **风险评分审查** | `detect_changes` 把 diff 映射到受影响的函数、执行流和测试缺口 |
| **自定义语言** | 通过 `.code-review-graph/languages.toml` 添加新语言,无需 fork |
| **GitHub Action** | 在 CI 中发布常驻的风险评分 PR 审查评论,可选 `fail-on-risk` 合并门禁 |
| **重构工具** | 重命名预览、框架感知的死代码检测、基于社区的建议 |
| **Wiki 生成** | 从社区结构生成 Markdown Wiki |
| **多仓库注册表** | 注册多个仓库并跨仓库搜索 |
| **多仓库守护进程** | `crg-daemon` 以子进程方式监视多个仓库,带健康检查和重启 |
| **MCP 提示模板** | 5 个工作流模板:审查、架构、调试、入职、合并前检查 |
| **全文搜索** | FTS5 混合搜索,结合关键词与向量相似度 |
| **本地存储** | `.code-review-graph/` 中的一个 SQLite 文件;没有外部数据库或云服务 |
---
## 使用方式
技能
`install` 会为支持技能的平台(Claude Code、Gemini CLI、CodeBuddy Code、Hermes Agent 和 Qoder)写入以下四个技能。按名字调用即可。
| 技能 | 说明 |
|-------|-------------|
| `explore-codebase` | 使用知识图谱浏览并理解代码库结构 |
| `review-changes` | 用变更检测与影响分析做结构化的代码审查 |
| `debug-issue` | 借助图谱驱动的代码导航系统性地排查问题 |
| `refactor-safely` | 用依赖分析规划并执行安全的重构 |
Qoder 还会从本仓库的 `skills/` 目录得到 `build-graph`、`review-delta` 和 `review-pr`。
CLI 参考
```bash
code-review-graph install # Detect and configure all platforms
code-review-graph install --platform # One platform
code-review-graph uninstall --dry-run # Preview removal of installed artifacts
code-review-graph build # Parse the whole codebase
code-review-graph update # Incremental update (changed files only)
code-review-graph status # Graph statistics
code-review-graph watch # Update on file changes
code-review-graph forget # Drop already-parsed files from the graph
code-review-graph dead-code # Functions and classes with no callers or tests
code-review-graph visualize # Interactive HTML graph
code-review-graph visualize --format json # Export graph data as JSON
code-review-graph visualize --format graphml # Export as GraphML
code-review-graph visualize --format svg # Export as SVG (needs matplotlib)
code-review-graph visualize --format obsidian # Export as Obsidian vault
code-review-graph visualize --format cypher # Export as Neo4j Cypher
code-review-graph wiki # Markdown wiki from communities
code-review-graph detect-changes --brief # Risk panel + token savings (read-only)
code-review-graph detect-changes --brief --base main # Against the merge base of main and HEAD
code-review-graph update --brief # Refresh graph + same panel
code-review-graph detect-changes --brief --verify # Cross-check against tiktoken
code-review-graph register # Register repo in the multi-repo registry
code-review-graph unregister # Remove repo from the registry
code-review-graph repos # List registered repositories
code-review-graph daemon start # Start the multi-repo watch daemon
code-review-graph daemon stop # Stop the daemon
code-review-graph daemon status # Daemon status and repos
code-review-graph eval # Run evaluation benchmarks
code-review-graph serve # Start the MCP server (stdio)
code-review-graph serve --http # MCP over Streamable HTTP on localhost:5555
```
这是一份精选列表。`code-review-graph --help` 会列出全部命令,[docs/COMMANDS.md](docs/COMMANDS.md) 记录了它们的参数。
当 `detect-changes --base` 指定的是一个分支时,diff 会针对该分支与 HEAD 的合并基做。提交哈希和其他 revision 按原样使用。
`visualize --format svg` 需要 matplotlib,它随 `eval` 附加依赖提供(`pip install "code-review-graph[eval]"`)。其他导出格式无需额外安装。
JSON 导出写在本地图谱数据目录中,该目录默认被 Git 忽略。导出内容可能包含绝对路径和代码结构元数据,发布前请先检查。
Token Savings 面板:detect-changes --brief 对比 update --brief
两个命令打印同一个面板,显示相比把变更文件原样交给智能体,图谱节省了多少 token。它们只有一点不同:是否先刷新图谱。
```text
┌─────────────────────── Token Savings ────────────────────────┐
│ Full context would be: 12,921 tokens │
│ Graph context used: 762 tokens │
│ Saved: 12,159 tokens (~94%) │
│ Breakdown: Functions 244 · Tests 191 · Risk 244 · Other 83 │
└──────────────────────────────────────────────────────────────┘
```
| 命令 | 作用 | 何时使用 |
|---|---|---|
| `detect-changes --brief` | 只读。针对当前改动查询已有图谱并打印面板。 | 大多数时候;钩子或 `crg-daemon` 会保持图谱新鲜。 |
| `update --brief` | 先把变更文件重新解析进图谱,再打印同样的面板。 | rebase 之后、改动集很大时,或图谱可能已过期时。 |
给任一命令加上 `--verify`,可以把数字与 OpenAI 的 `cl100k_base` 分词器做对比(需要 `pip install tiktoken`)。总体估算与真实 token 的偏差约在 1% 以内;见 [`docs/REPRODUCING.md`](docs/REPRODUCING.md#calibration-table)。
同样的 `context_savings` 元数据也附在 `get_impact_radius`、`get_review_context`、`detect_changes` 和 `get_architecture_overview` 这几个 MCP 工具的 JSON 响应上。
多仓库守护进程
如果你的编辑器不支持钩子(例如 Cursor 或 OpenCode),或者你想在没有编辑器集成的情况下保持图谱新鲜,守护进程会监视你的仓库并更新它们的图谱。它随 `code-review-graph` 一起提供,无需单独安装。
```bash
# 1. Register the repos to watch
crg-daemon add ~/project-a --alias proj-a
crg-daemon add ~/project-b
# 2. Start the daemon (runs in the background)
crg-daemon start
# 3. Check on it
crg-daemon status # daemon and per-repo watcher status
crg-daemon logs --repo proj-a -f # tail logs for one repo
crg-daemon stop # stop the daemon and all watchers
```
也可以用 `code-review-graph daemon start|stop|status|...`。
`crg-daemon add` 写入 `~/.code-review-graph/watch.toml`,你也可以直接编辑该文件:
```toml
[[repos]]
path = "/home/user/project-a"
alias = "proj-a"
[[repos]]
path = "/home/user/project-b"
alias = "project-b"
```
守护进程会监视这个文件,并随着仓库的增删启动或停止 watcher 进程。每 30 秒一次的健康检查会重启已死的 watcher。
完整配置参考见 [docs/COMMANDS.md](docs/COMMANDS.md#standalone-daemon-cli-crg-daemon)。
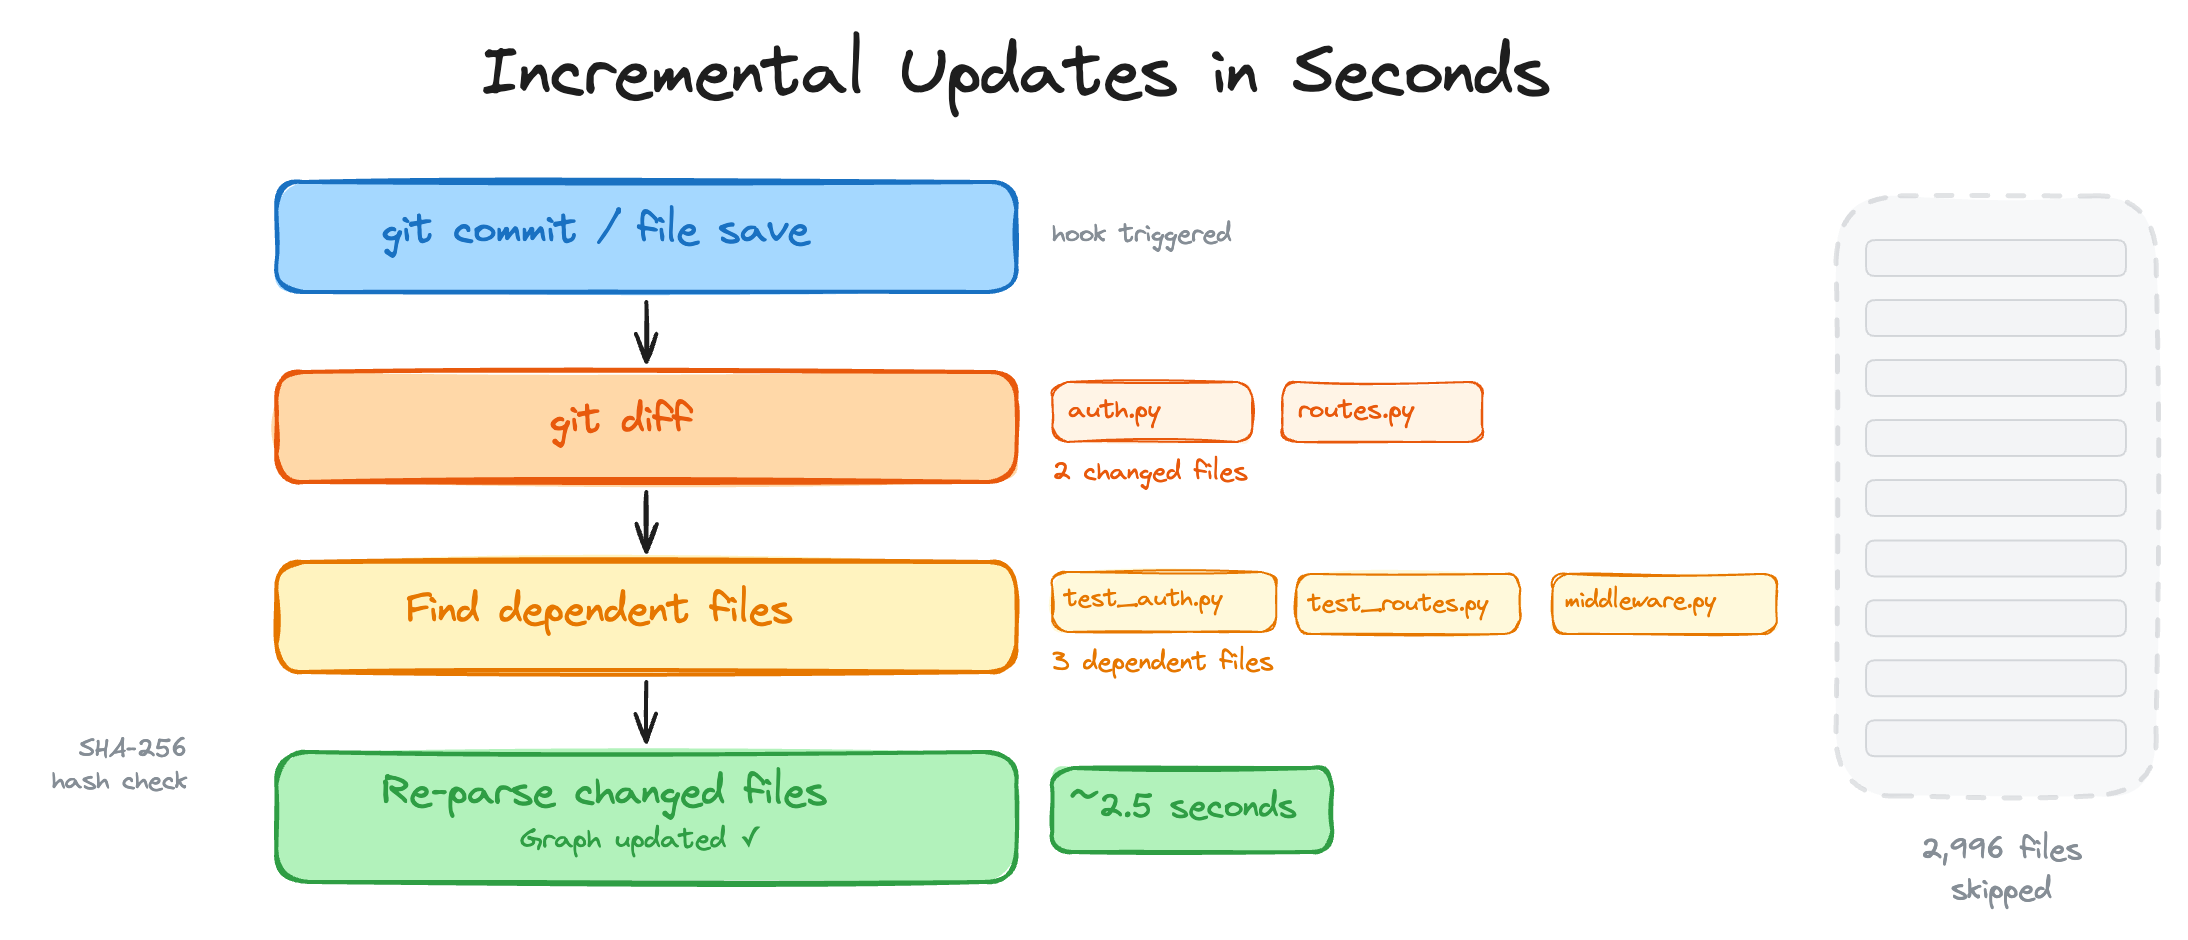
30 个 MCP 工具
图谱构建完成后,助手会使用这些工具。
| 工具 | 说明 |
|------|-------------|
| `build_or_update_graph_tool` | 构建或增量更新图谱 |
| `run_postprocess_tool` | 重新运行执行流检测、社区检测和 FTS 索引 |
| `get_minimal_context_tool` | 紧凑上下文(约 100 token);先调用这个 |
| `get_impact_radius_tool` | 变更文件的影响半径 |
| `get_review_context_tool` | 带结构摘要的审查上下文 |
| `query_graph_tool` | 调用者、被调用者、测试、导入、继承查询 |
| `traverse_graph_tool` | 从任意节点出发的 BFS/DFS 遍历,带 token 预算 |
| `semantic_search_nodes_tool` | 按名称或语义搜索代码实体 |
| `embed_graph_tool` | 计算用于语义搜索的向量嵌入 |
| `list_graph_stats_tool` | 图谱规模与健康状况 |
| `get_docs_section_tool` | 获取文档章节 |
| `find_large_functions_tool` | 超过行数阈值的函数、类或文件 |
| `list_flows_tool` | 按关键度排序的执行流 |
| `get_flow_tool` | 单个执行流 |
| `get_affected_flows_tool` | 受变更文件影响的执行流 |
| `list_communities_tool` | 检测到的代码社区 |
| `get_community_tool` | 单个社区 |
| `get_architecture_overview_tool` | 基于社区结构的架构概览 |
| `detect_changes_tool` | 风险评分的变更影响分析 |
| `get_hub_nodes_tool` | 连接最多的节点 |
| `get_bridge_nodes_tool` | 按介数中心性得出的瓶颈点 |
| `get_knowledge_gaps_tool` | 结构性弱点和未测试的热点 |
| `get_surprising_connections_tool` | 意外的跨社区耦合 |
| `get_suggested_questions_tool` | 由分析生成的审查问题 |
| `refactor_tool` | 重命名预览、死代码检测、建议 |
| `apply_refactor_tool` | 应用先前预览的重构 |
| `generate_wiki_tool` | 从社区生成 Markdown Wiki |
| `get_wiki_page_tool` | 单个 Wiki 页面 |
| `list_repos_tool` | 已注册的仓库 |
| `cross_repo_search_tool` | 搜索已注册的仓库;`repos` 可把搜索限定到一个子集 |
**MCP 提示模板**(5 个工作流模板):
`review_changes`、`architecture_map`、`debug_issue`、`onboard_developer`、`pre_merge_check`
配置
要把某些路径排除在索引之外,在仓库根目录创建 `.code-review-graphignore` 文件:
```
generated/**
*.generated.ts
vendor/**
node_modules/**
```
在 git 仓库中只索引被跟踪的文件(`git ls-files`),因此被 gitignore 的文件会跳过。用 `.code-review-graphignore` 来排除被跟踪的文件,或在没有 git 时使用。默认忽略列表见 [docs/USAGE.md](docs/USAGE.md#ignore-patterns)。
可选依赖组:
```bash
pip install "code-review-graph[embeddings]" # Local vector embeddings (sentence-transformers)
pip install "code-review-graph[google-embeddings]" # Google Gemini embeddings
pip install "code-review-graph[communities]" # Community detection (igraph)
pip install "code-review-graph[enrichment]" # Python call-resolution enrichment (Jedi)
pip install "code-review-graph[eval]" # Evaluation benchmarks and SVG export (matplotlib)
pip install "code-review-graph[wiki]" # ollama client (not used by the current wiki generator)
pip install "code-review-graph[all]" # All optional dependencies
```
### 环境变量
| 变量 | 说明 | 默认值 |
|----------|-------------|---------|
| `CRG_GIT_TIMEOUT` | Git 操作的超时秒数(build / update / watch) | `30` |
| `CRG_DISCOVERY_TIMEOUT` | 未显式给出文件清单时,用于识别变更的每个 Git 命令的超时秒数。超时会返回错误,而不会报告“没有变更” | `5`(显式设置 `CRG_GIT_TIMEOUT` 时取该值) |
| `CRG_DATA_DIR` | 存放图谱数据库和生成产物的目录 | - |
| `CRG_HOOK_WORKTREES` | 设为 `1` 时允许 pre-commit 钩子在链接的 git worktree 中运行 | - |
| `CRG_EMBEDDING_MODEL` | 本地向量嵌入的默认模型 | `all-MiniLM-L6-v2` |
| `CRG_ACCEPT_CLOUD_EMBEDDINGS` | 设为 `1` 可抑制云端嵌入的出网警告 | - |
| `CRG_ALLOW_REMOTE_CODE` | 允许需要 `trust_remote_code=True` 的 HuggingFace 模型 | `0` |
| `CRG_MAX_IMPACT_NODES` | 影响分析中的最大节点数 | `500` |
| `CRG_MAX_IMPACT_DEPTH` | 影响半径分析的搜索深度 | `2` |
| `CRG_MAX_BFS_DEPTH` | 图谱遍历的最大深度 | `15` |
| `CRG_MAX_CHANGED_FUNCS` | 单份变更报告中分析的最大变更函数数 | `500` |
| `CRG_MAX_TRANSITIVE_FRONTIER` | 传递性调用者/被调用者扩展的最大前沿规模 | `50` |
| `CRG_CALLER_TEST_ROUTE_DEPTH` | 为没有测试的变更符号向上回溯 `CALLS` 寻找已测试调用者的跳数。仅作为提示报告,不计为覆盖率 | `2` |
| `CRG_CALLER_TEST_ROUTE_MAX_CALLERS` | 寻找该已测试调用者时检查的调用者数量上限 | `500` |
| `CRG_TOOL_TIMEOUT` | 只读 MCP 工具的超时秒数(`0` 表示禁用)。不限制写入类工具:build、postprocess、embed、wiki 和 apply-refactor | `0` |
| `CRG_CHURN_WINDOW_DAYS` | `detect-changes --churn` 统计提交数的时间窗口 | `90` |
| `CRG_LEIDEN_SEED` | Leiden 社区检测的随机种子 | `42` |
| `CRG_RECURSE_SUBMODULES` | 设为 `1`、`true` 或 `yes` 时包含 git 子模块 | - |
| `CRG_TOOLS` | 提供服务时暴露的 MCP 工具白名单,逗号分隔 | - |
| `GOOGLE_API_KEY` | Google Gemini 嵌入的 API 密钥 | - |
| `MINIMAX_API_KEY` | MiniMax 嵌入的 API 密钥 | - |
| `VOYAGE_API_KEY` | Voyage 嵌入的 API 密钥 | - |
| `CRG_VOYAGE_MODEL` | Voyage 嵌入使用的模型 | `voyage-code-3` |
| `CRG_VOYAGE_OUTPUT_DIMENSION` | Voyage 嵌入的输出维度 | `1024` |
| `CRG_VOYAGE_OUTPUT_DTYPE` | Voyage 嵌入的输出 dtype | `float` |
| `CRG_VOYAGE_BASE_URL` | Voyage 嵌入端点 | `https://api.voyageai.com/v1` |
| `CRG_VOYAGE_BATCH_SIZE` | Voyage 请求的批大小 | `100` |
| `CRG_VOYAGE_MIN_INTERVAL_SEC` | Voyage 请求之间的最小间隔 | `0` |
| `CRG_OPENAI_BASE_URL` | OpenAI 兼容的嵌入端点 | - |
| `CRG_OPENAI_API_KEY` | OpenAI 兼容嵌入的 API 密钥 | - |
| `CRG_OPENAI_MODEL` | OpenAI 兼容嵌入使用的模型 | - |
| `CRG_OPENAI_DIMENSION` | 固定嵌入维度(v3 模型支持降维) | - |
| `CRG_OPENAI_BATCH_SIZE` | OpenAI 兼容请求的批大小 | `100` |
| `NO_COLOR` | 关闭终端中的 ANSI 颜色 | - |
| `CRG_SERIAL_PARSE` | 设为 `1` 可关闭并行解析(用于调试) | - |
OpenAI 兼容嵌入(OpenAI、Azure,或自建网关如 new-api、LiteLLM、vLLM、LocalAI,或 OpenAI 模式下的 Ollama)无需额外安装。设置变量并给 `embed_graph` 传入 `provider="openai"`:
```bash
export CRG_OPENAI_BASE_URL=http://127.0.0.1:3000/v1 # or https://api.openai.com/v1
export CRG_OPENAI_API_KEY=sk-...
export CRG_OPENAI_MODEL=text-embedding-3-small # whatever your gateway serves
# optional:
export CRG_OPENAI_DIMENSION=1536 # pin dim (v3 models support reduction)
export CRG_OPENAI_BATCH_SIZE=100 # lower for gateways with tight limits
# (e.g. Qwen text-embedding-v4 caps at 10)
```
当 base URL 指向 localhost(`127.0.0.1`、`localhost`、`0.0.0.0`、`::1`)时,会跳过云端出网警告。
Voyage 嵌入无需额外安装。设置 `VOYAGE_API_KEY` 并给 `embed_graph` 传入 `provider="voyage"`;默认模型是 `voyage-code-3`:
```bash
export VOYAGE_API_KEY=pa-...
export CRG_ACCEPT_CLOUD_EMBEDDINGS=1
code-review-graph embed --provider voyage --model voyage-code-3
```
> **模型选择。** 对于打算长期保留的索引,避免使用 `-preview`、`-beta` 或 `-exp` 结尾的模型 ID;预览模型可能更换权重(维度一变就要全量重新嵌入)或被下架。请优先选择正式发布的模型,例如 `text-embedding-3-small` / `text-embedding-3-large`(OpenAI)、`Qwen/Qwen3-Embedding-8B`(自建 vLLM 或 LocalAI),或 `gemini-embedding-001`(原生 Gemini 提供方,需要 `GOOGLE_API_KEY`)。
>
> 嵌入文本包含标识符、签名、结构上下文,以及有长度上限的首段 docstring 或文档注释摘要。函数体不会被发送。在文档提取功能加入之前创建的图谱,需要先完整执行一次 `code-review-graph build` 再重新嵌入。常规构建不会刷新嵌入;要在构建后刷新,请同时传入 `--embedding-provider` 和 `--embedding-model`。云端提供方会收到这些由源码派生的文本,并可能据此收费。
#### 工具过滤
CRG 默认暴露 30 个 MCP 工具。要把服务器限制到一个子集,使用 `--tools` 或 `CRG_TOOLS` 环境变量:
```bash
# CLI flag
code-review-graph serve --tools query_graph_tool,semantic_search_nodes_tool,detect_changes_tool
# Environment variable
CRG_TOOLS=query_graph_tool,semantic_search_nodes_tool code-review-graph serve
```
命令行参数优先于环境变量。两者都未设置时,所有工具都可用。在 MCP 客户端配置中:
```json
{
"mcpServers": {
"code-review-graph": {
"command": "code-review-graph",
"args": ["serve", "--tools", "query_graph_tool,semantic_search_nodes_tool,detect_changes_tool,get_review_context_tool"]
}
}
}
```
---
## 常见问题与对比
答案见 [docs/FAQ.md](docs/FAQ.md):
- [对比 LSP / 语言服务器](docs/FAQ.md#how-is-this-different-from-lsp-and-language-servers):一张持久的跨语言图谱,而不是每种语言一个守护进程;LSP 在单个符号上仍然更精确。
- [对比 RAG / 嵌入](docs/FAQ.md#isnt-this-just-rag):从 AST 解析出的结构化边,而不是相似度分块;嵌入是可选的,只辅助搜索。
- [对比 grep / 智能体搜索](docs/FAQ.md#why-not-just-grep):单跳查找 grep 更快;多跳问题(影响半径、调用者的调用者、tests-for、受影响的执行流)图谱更强。
- [对比 Serena、codegraph、claude-context、repomix](docs/FAQ.md#how-does-it-compare-to-serena-codegraph-claude-context-and-repomix):对比表格。
- [什么时候不要用它](docs/FAQ.md#when-should-i-not-use-it):小仓库、琐碎的单文件 diff、一次性问题。
- [它会回传数据吗?](docs/FAQ.md#does-it-phone-home):没有遥测;云端嵌入需要主动开启。
- [怎么确认它在工作?](docs/FAQ.md#how-do-i-verify-it-is-working):`status`、`detect-changes --brief`、`/mcp`。
## 故障排查
更多情况,包括 Windows/WSL,见 [docs/TROUBLESHOOTING.md](docs/TROUBLESHOOTING.md)。
### `pip` / `pipx` 无法下载 `hatchling`(或出现 `Errno 9` / `Bad file descriptor` 连 PyPI 的错误)
从源码树安装(例如 `pipx install .`)需要从 PyPI 取构建依赖。如果在一堆连接警告之后看到 `Could not find a version that satisfies the requirement hatchling`,那么该终端里的 Python 可能无法与 `pypi.org` 建立 HTTPS 连接。这在编辑器的集成终端里最常见,有时也与 VPN、防火墙或代理有关。
1. 改用 Terminal.app 或 iTerm 运行同一条命令,而不是编辑器的终端。
2. 用 [uv](https://docs.astral.sh/uv/) 从 checkout 安装,它使用不同的下载机制:
```bash
cd /path/to/code-review-graph
uv tool install . --force
```
3. 在克隆中做开发时,使用 `uv sync` 和 `uv run code-review-graph ...`。
诊断方法:`python3 scripts/diagnose_pypi_connectivity.py`。如果它打印 `FAILED`,问题出在网络环境,而不是包名。
### Windows:`Invalid JSON: EOF while parsing` 或 `MCP error -32000: Connection closed`
不要在 Claude Code 配置中使用 `cmd /c` 包装。让 `~/.claude.json` 直接指向 `.exe`,并通过配置设置 UTF-8:
```json
"code-review-graph": {
"command": "C:\\path\\to\\your\\venv\\Scripts\\code-review-graph.exe",
"args": ["serve", "--repo", "C:\\path\\to\\your\\project"],
"env": { "PYTHONUTF8": "1" }
}
```
## 参与贡献
```bash
git clone https://github.com/tirth8205/code-review-graph.git
cd code-review-graph
python3 -m venv .venv && source .venv/bin/activate
pip install -e ".[dev]"
pytest
```
Pull request 请提交到 `staging`(默认分支)。变更按
`staging` → `testing` → `main` 的顺序推进,版本从 `main` 打标签。完整流程见
[CONTRIBUTING.md](CONTRIBUTING.md#branching-and-promotion)。
要添加内置语言,编辑 `code_review_graph/parser.py`:把扩展名加入 `EXTENSION_TO_LANGUAGE`,并把节点类型映射加入 `_CLASS_TYPES`、`_FUNCTION_TYPES`、`_IMPORT_TYPES` 和 `_CALL_TYPES`。附上测试 fixture 并提交 PR。如果某种语言只在一个仓库里需要,请改用 [`languages.toml`](docs/CUSTOM_LANGUAGES.md)。
## 许可证
MIT。见 [LICENSE](LICENSE)。
code-review-graph.com
pip install code-review-graph && code-review-graph install