🌳 Yggdrasil
Arrêtez de réexpliquer votre projet à chaque nouvelle session IA.
Une seule mémoire locale pour Claude Code, Codex et tous les agents MCP — partagée entre les sessions, les outils et les projets. Zéro dépendance. Rien ne quitte votre machine.




Installation ·
Comment ça marche ·
Les chiffres ·
Comparatif ·
FAQ
Lire dans une autre langue : English · Русский · 简体中文 · Español · 日本語 · Deutsch
---
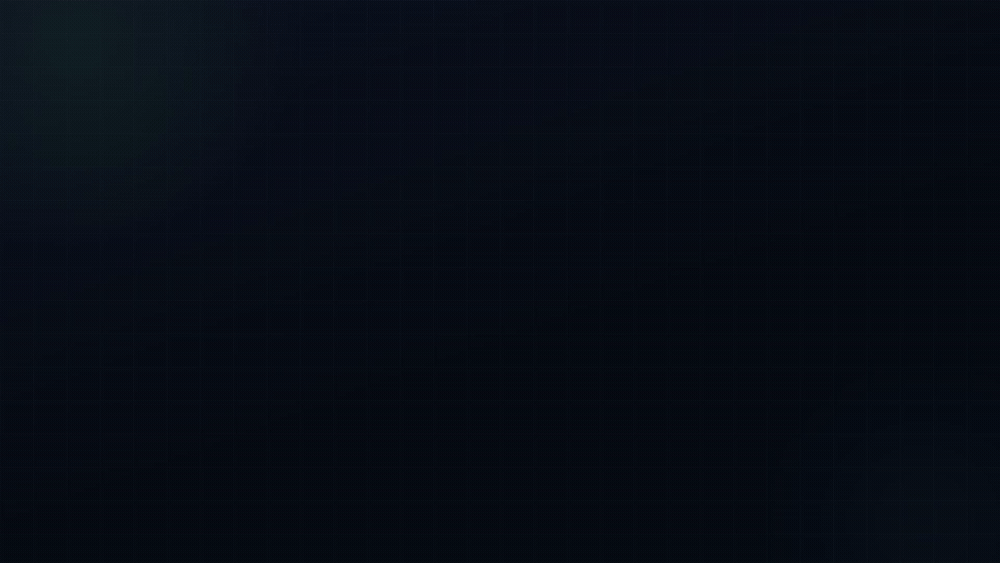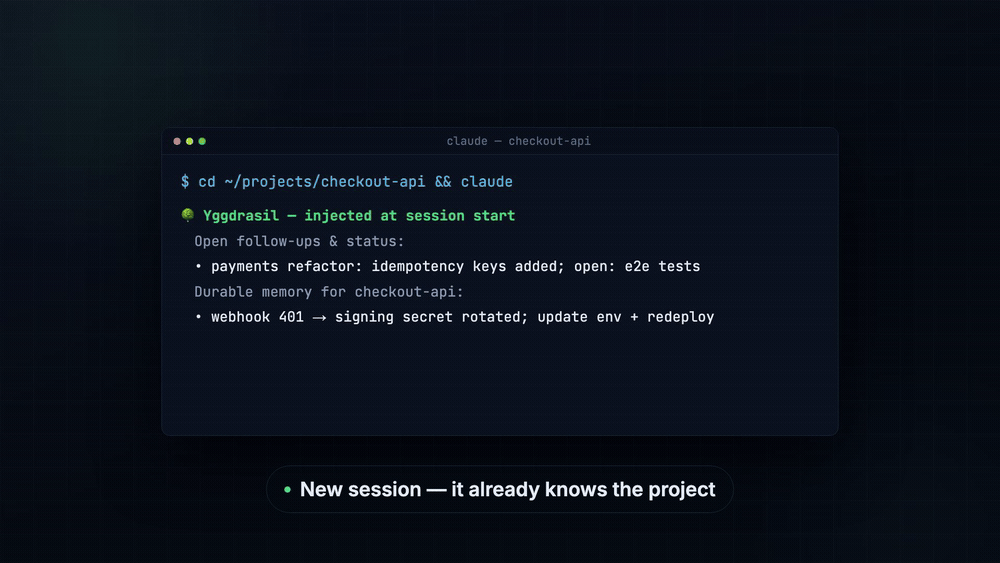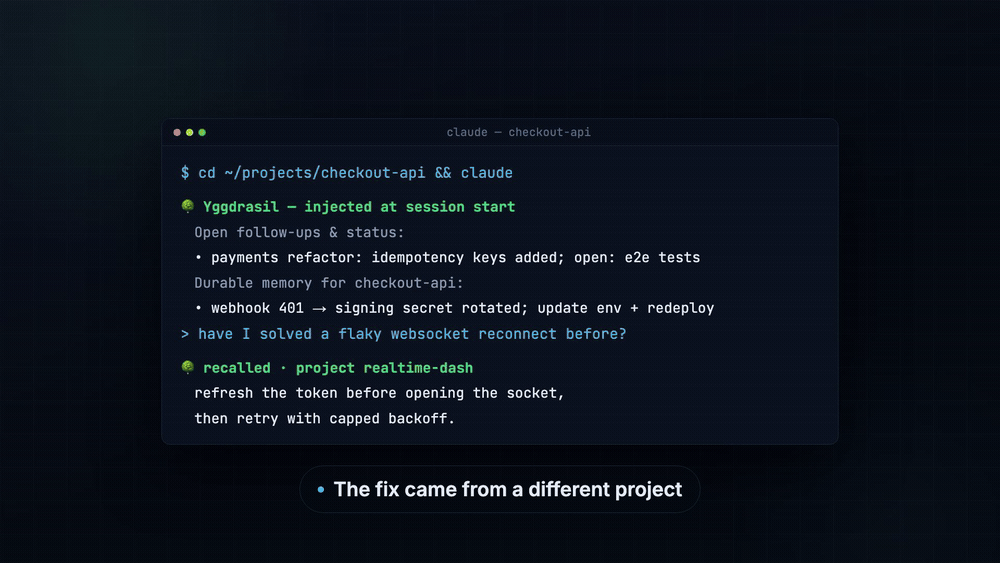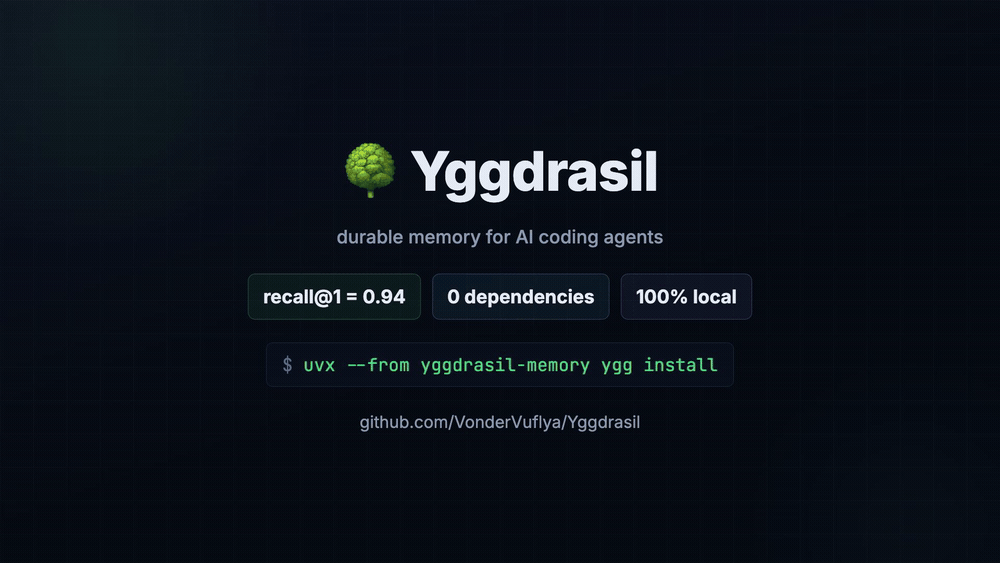
À chaque nouvelle conversation, votre IA oublie tout. Vous réexpliquez le projet, les décisions, les pièges — à chaque fois, dans chaque outil. **Yggdrasil est une petite mémoire toujours active à laquelle n'importe quel agent se branche.** Ouvrez une nouvelle session, dans n'importe quel projet, avec n'importe quelle IA : elle sait déjà ce que vous avez décidé, ce qui a cassé et ce qui reste ouvert.
```text
$ cd ~/projects/checkout-api && claude # a brand-new session
🌳 Yggdrasil (injected automatically at session start)
• [project_status] payments refactor: idempotency keys added; open: e2e tests
• [lesson] webhook 401 → signing secret rotated; update env + redeploy
> "have I solved a flaky websocket reconnect anywhere before?"
🌳 recall → found in project `realtime-dash`:
refresh the token *before* opening the socket, then retry with capped backoff.
```
Fini le « laissez-moi vous rappeler ce qu'on a fait hier ». C'est simplement là.
## 🚀 Installation
Deux commandes, directement dans **Claude Code** (le plugin se lance via [`uv`](https://docs.astral.sh/uv/)) :
```text
/plugin marketplace add VonderVuflya/Yggdrasil
/plugin install yggdrasil
```
Le moteur démarre paresseusement à la première utilisation et génère son propre jeton local — pas de clé d'API, pas de cloud, rien à configurer. Codex et Cursor utilisent le même flux.
Tous les autres canaux — daemon CLI, Homebrew, npm, Claude Desktop, depuis les sources…
| Hôte / outil | Commande |
| --- | --- |
| **uvx** _(CLI recommandée)_ | `uvx --from yggdrasil-memory ygg install` |
| **npm / npx** | `npx yggdrasil-memory install` |
| **pipx** | `pipx install yggdrasil-memory && ygg install` |
| **pip** | `pip install yggdrasil-memory && ygg install` |
| **Homebrew** _(macOS)_ | `brew install VonderVuflya/tap/yggdrasil && ygg install` |
| **Claude Desktop** _(application)_ | glissez le `.mcpb` depuis la [dernière release](https://github.com/VonderVuflya/Yggdrasil/releases/latest) dans Settings → Extensions, collez votre jeton (`ygg token`) — l'application de bureau partage alors la même mémoire que vos agents CLI ([guide](../packaging/mcpb/README.md)) |
| **depuis les sources** | `uvx --from git+https://github.com/VonderVuflya/yggdrasil.git ygg install` |
`ygg install` est une configuration guidée à effectuer une seule fois : elle installe un service d'arrière-plan toujours actif, enregistre les outils MCP auprès de chaque hôte d'agent qu'elle trouve — **Claude Code, Codex, OpenCode** — et, si votre matériel le permet, recommande des modèles locaux optionnels (ou choisissez `none` pour rester sans configuration).
OpenCode — rien à configurer
Installez [OpenCode](https://opencode.ai) d'abord, puis lancez `ygg install` (ou `ygg redeploy` si Yggdrasil est déjà configuré) — l'entrée est écrite pour vous et fusionnée dans tout `opencode.json` existant. Confirmez avec :
```bash
opencode mcp list # -> ✓ yggdrasil connected
```
Installé OpenCode *après* Yggdrasil ? Relancez simplement `ygg install`.
Si vous préférez l'écrire à la main, notez que le schéma d'OpenCode diffère de celui de Claude sur quatre points à la fois — les serveurs vivent sous `mcp` (pas `mcpServers`), `type` est obligatoire, `command` est un seul tableau (pas `command` + `args`), et l'environnement est `environment` (pas `env`), donc l'extrait de Claude ne se porte pas tel quel :
```jsonc
// ~/.config/opencode/opencode.json
{
"$schema": "https://opencode.ai/config.json",
"mcp": {
"yggdrasil": {
"type": "local",
"command": ["/path/to/python3", "~/.yggdrasil/scripts/ygg_mcp_server.py"],
"enabled": true,
"environment": { "YGG_ENGINE_URL": "http://127.0.0.1:42069" }
}
}
}
```
Aucun jeton dans la configuration — le moteur lit lui-même le `~/.yggdrasil/token` en 0600. Lancez `ygg doctor` si les outils n'apparaissent pas.
Il existe aussi une [skill `yggdrasil-memory`](../skills/) pour n'importe quelle surface Claude : MCP connecte les *outils*, la skill apprend à l'agent *quand* les utiliser. Utilisez les deux pour un comportement optimal.
Essayez-le sans rien installer, avec une base jetable : `uvx --from yggdrasil-memory ygg serve --reset --db /tmp/ygg.sqlite`.
Ensuite, travaillez, tout simplement : demandez à votre agent *« rappelle ce qu'on a décidé sur ce projet »*, dites-lui *« mémorise cette décision »* — à la session suivante, c'est déjà là. Vérifiez l'installation à tout moment avec `ygg doctor`.
**Vous avez déjà un historique ?** Amorcez la mémoire à partir de vos transcriptions Claude Code + Codex existantes, de vos coffres Obsidian et de vos dépôts `CLAUDE.md` — le tout distillé localement :
```bash
ygg seed --dry-run # see what it would import; drop the flag to distill for real
```
**Vous quittez un autre outil de mémoire ?** `ygg import --from mcp-memory --path memory.json` importe tout son stock dans Yggdrasil (dédupliqué, protégé contre les secrets) — vous pouvez ensuite le supprimer.
## Pourquoi
- 🧠 **Persistant** — décisions, leçons et statut de projet survivent d'une session à l'autre.
- 🔌 **Un seul cerveau, tous les outils** — Claude Code, Codex, OpenCode et n'importe quel hôte MCP partagent la même mémoire.
- 🌐 **Rappel inter-projets** — *« ça ressemble à ce que vous avez fait dans le projet B — le réutiliser ? »*
- 🧹 **Soignée, pas capturée** — votre agent n'enregistre que les quelques choses qui comptent ; la gouvernance déduplique et archive, sans jamais supprimer.
- 🌱 **Auto-entretenue** *(opt-in)* — un petit modèle local consolide la mémoire en arrière-plan. Zéro jeton d'API.
- 🪪 **Une seule identité partout** — un nom et une personnalité optionnels que chaque agent reprend, pour que Claude Code et Codex donnent l'impression d'être le même assistant.
- 🔒 **100 % local** — votre mémoire vit sur votre machine. Pas de cloud, pas de compte, pas de télémétrie.
## 🧠 Comment ça marche
Yggdrasil, c'est **mémoire + outils** — l'*intelligence*, c'est votre LLM. Il veille simplement à ce que la bonne mémoire soit devant le bon agent au bon moment.
- 🛎️ **Daemon toujours actif** — un petit service local (~21 Mo de RAM) que vos agents atteignent via les outils MCP (`ygg_search`, `ygg_recall`, `ygg_remember` …).
- 🪝 **Hooks** — le démarrage de session injecte automatiquement l'identité, l'état du projet et les suivis en cours (~300 jetons) ; un hook optionnel par prompt rappelle automatiquement la mémoire pertinente pour *chaque requête*.
- 📌 **Classement** — les mémoires épinglées et fréquemment rappelées remontent en premier.
- 🧹 **Gouvernance** — doublons et conflits sont mis en file pour relecture ; les modifications sont non destructives (archivage, jamais de suppression).
- 📓 **Obsidian** — chaque mémoire est aussi une note Markdown brute que vous pouvez lire, éditer et grep.
## 🎛️ Niveaux de mémoire — sans configuration par défaut
Dès le départ, Yggdrasil fonctionne sur **SQLite + FTS5 sans aucune dépendance** — recherche instantanée par mots-clés, aucun modèle, rien à télécharger. Des modèles **locaux** optionnels via [Ollama](https://ollama.com) ajoutent deux niveaux indépendants :
| Niveau | Ce que vous ajoutez | Ce que vous gagnez |
| --- | --- | --- |
| **0 · par défaut** | rien — SQLite + FTS5 | recherche par mots-clés, zéro dépendance, instantanée — recall@1 = **0.77** |
| **1 · sémantique** | un modèle d'**embedding** (`all-minilm` 45 MB · `paraphrase-multilingual` ~560 MB) | recherche par **sens**, entre les langues — recall@1 = **0.94**, recall@3 **1.00** |
| **2 · auto-entretenu** | un petit **LLM** (`qwen2.5:1.5b` ~1 GB) | dédup/fusion de la mémoire en arrière-plan (proposition seule) |
Ollama se contente de *calculer* les vecteurs et d'exécuter le modèle d'arrière-plan — chaque mémoire et chaque vecteur reste dans la même base SQLite locale. `ygg install` détecte votre matériel et recommande un modèle adapté (`ygg recommend` affiche le catalogue complet).
Menu complet des modèles
**Embeddings (recherche sémantique) :**
| Modèle | Taille | Idéal pour |
| --- | --- | --- |
| `all-minilm` | 45 MB | anglais, minuscule et rapide |
| `nomic-embed-text` | 274 MB | anglais, meilleure qualité (768d) |
| `mxbai-embed-large` | 670 MB | anglais, haute qualité (1024d) |
| `paraphrase-multilingual` | ~560 MB | multilingue (EN/RU + 50 langues, 768d) |
| `bge-m3` | 1.2 GB | multilingue, qualité maximale (plus lourd) |
**Backend d'embedding** — Ollama par défaut. Pour utiliser à la place un serveur `/v1/embeddings` compatible OpenAI (le `llama-server --embeddings` de llama.cpp, OpenRouter, LM Studio, vLLM), définissez `embed_backend` :
```bash
# local llama.cpp — no key needed
ygg config set embed_backend openai
ygg config set embed_url http://127.0.0.1:8080/v1
ygg config set embed_model bge-small-en-v1.5
ygg redeploy
# OpenRouter — free embeddings, no GPU needed
ygg config set embed_backend openai
ygg config set embed_url https://openrouter.ai/api/v1
ygg config set embed_model nvidia/llama-nemotron-embed-vl-1b-v2:free
ygg config set embed_api_key sk-or-... # or export YGG_EMBED_API_KEY
ygg redeploy
```
La clé est stockée dans `~/.yggdrasil/embed_api_key` (0600) plutôt que dans `config.json`, et atteint le daemon sous forme de **chemin de fichier** — elle n'apparaît donc jamais dans `ps`, le plist launchd ou l'unité systemd. `ygg config list` la masque.
Vérifiez que c'est pris en compte avec `ygg doctor` — dense doit nommer votre modèle :
```
✓ dense active (nvidia/llama-nemotron-embed-vl-1b-v2:free)
```
Vous branchez LM Studio ou OpenRouter à la main ? Les pièges (deux formes d'URL, identifiants de modèles, chargement JIT, clés d'inférence contre clés de provisioning, filtres de confidentialité) sont décrits dans [docs/model-backends.md](../docs/model-backends.md).
Rester en local continue de gagner en qualité *et* en confidentialité : sur le corpus
de 232 mémoires / 110 requêtes, le modèle local `paraphrase-multilingual` obtient un
recall@1 de **0.964** contre **0.946** pour le modèle hébergé gratuit — et vos
mémoires ne quittent jamais la machine. Tournez-vous vers un backend hébergé quand la
machine ne peut pas faire tourner Ollama, pas pour chasser la précision.
Des vecteurs plus grands **n'**achètent **pas** de précision ici — sur le même
corpus, `mxbai-embed-large` (1024d) obtient 0.809 et `nomic-embed-text` (768d) 0.818,
un écart que leurs intervalles de confiance avalent complètement. Ce qui fait
vraiment bouger le chiffre, c'est si le modèle gère *vos* langues : les deux sont
anglais uniquement et retombent à 0.40–0.45 sur les requêtes inter-langues, là où le
modèle multilingue par défaut tient 0.95.
**Consolidation en arrière-plan (petit LLM) :**
| Modèle | Taille | Idéal pour |
| --- | --- | --- |
| `qwen2.5:0.5b` | ~400 MB | minuscule, rapide sur CPU |
| `qwen2.5:1.5b` | ~1 GB | meilleur choix par défaut sur CPU |
| `llama3.2:3b` | ~2 GB | meilleure qualité, plus lent sur CPU |
Le moteur lui-même est interchangeable — n'importe quel service respectant le contrat `MemoryBackend` se branche directement (`YGG_ENGINE_URL`) ; voir [docs/backend-boundary.md](../docs/backend-boundary.md).
## 🔗 Une seule mémoire sur toutes vos machines
Vous travaillez sur un portable et sur une machine plus puissante ? Liez-les une fois, et elles cessent d'être deux cerveaux.
```text
# on the laptop
$ ygg link
🔗 pairing code valid 5 minutes · single use
ygg://192.168.3.152:42070/a4e0df489737#FOucjgJ1FrUB…
# on the other machine — paste it
$ ygg link ygg://192.168.3.152:42070/a4e0df489737#FOucjgJ1FrUB…
✓ linked with laptop https://192.168.3.152:42070
✓ laptop: fetch 84 · push 12 · delete 0 · tombstones 0
```
Voilà. Dès lors, une mémoire écrite sur une machine se retrouve sur l'autre en une seconde environ, `ygg delete` la supprime des **deux**, et chaque machine continue de fonctionner avec sa copie locale quand l'autre est en veille — les lectures n'attendent jamais le réseau. Quand une machine revient, les deux comparent leurs empreintes et rattrapent ce qui leur a échappé, sans que vous ayez rien à lancer.
Il n'y a **aucun polling**. Yggdrasil est sollicité quelques fois par jour : les écritures sont poussées au moment où elles se produisent, et une synchronisation est déclenchée par les lectures ; les machines inactives n'envoient rien.
**Ce que ce n'est pas :** un cloud. Il n'y a ni relais, ni compte, ni serveur à nous sur le chemin. Les machines se parlent directement via votre propre réseau, en TLS avec le certificat de chacune épinglé, à l'aide d'une paire de clés qui n'existe que sur ces deux machines. Le code d'appairage lui-même nomme le certificat de la machine émettrice, donc même la toute première connexion est vérifiée — si quelqu'un d'autre sur le réseau répond à sa place, il est refusé avant que le secret du code ne soit envoyé. Rien n'ouvre de port réseau tant que vous n'avez pas lancé `ygg link` — installer Yggdrasil le laisse sur loopback, comme avant.
```text
ygg link --list # what's linked, and whether writes are actually arriving
ygg link --sync # reconcile now, don't wait for a read
ygg unlink # revoke that machine's key here
```
Détails : ce qui voyage, ce qui reste, et quand utiliser ygg sync à la place
**Voyage :** les mémoires, leurs relations et les suppressions. **Reste sur place :** combien de fois *vous* avez ouvert une mémoire et sur quelle machine vous l'avez lue — c'est du classement local, pas du savoir. Les vecteurs d'embedding restent normalement locaux aussi, avec une exception : si les deux machines exécutent le même modèle d'embedding, le vecteur voyage avec, de sorte qu'une machine de calcul peut faire l'embedding pour le portable, et le portable n'exécute jamais de modèle.
**La modification la plus récente gagne.** Modifiez une mémoire sur les deux machines avant qu'elles ne se parlent, et la modification la plus récente est conservée sur les deux (une correction plus courte incluse).
**Les suppressions gagnent.** Si vous supprimez une mémoire sur une machine et la modifiez sur l'autre au même moment, la suppression l'emporte et la modification est perdue. C'est délibéré : « j'ai supprimé le jeton divulgué » doit rester vrai même lorsque deux horloges divergent. Quand vous voulez dire *j'ai changé d'avis*, archivez plutôt : rien n'est perdu, et `ygg unarchive` la restaure sur les deux machines (la décision la plus récente l'emporte).
**Un pare-feu est détecté à l'appairage.** La machine qui a affiché le code rappelle immédiatement l'autre ; si elle n'y arrive pas, `ygg link` le signale et affiche l'unique commande qui ouvre le port pour cette seule machine (ufw, firewalld, Windows). `ygg link --list` et `ygg doctor` continuent de vérifier ensuite : un pair n'affiche ✓ que lorsque les écritures sont confirmées livrées, sinon l'erreur et le nombre de modifications en attente. Une machine qui reçoit une nouvelle adresse par DHCP est retrouvée au prochain contact.
**`ygg sync` (git) est toujours là** et fait un autre travail : des machines qui ne se voient pas, un portable professionnel derrière un autre réseau, un dépôt nu sur une clé USB que vous transportez. Utilisez `ygg link` pour des machines sur un même réseau, `ygg sync` pour tout le reste. Les deux partagent les mêmes règles de fusion, vous pouvez donc utiliser les deux. Si les deux machines sont sur un tailnet Tailscale, `ygg link --tailscale` fonctionne aussi d'un réseau à l'autre.
**Si le code d'appairage affiche la mauvaise adresse** (il préfère l'Ethernet et le Wi-Fi réels aux ponts de VM et aux VPN, mais peut encore se tromper), épinglez-la : `ygg config set sync_host 192.168.3.152` — ou affichez le code sur l'autre machine : le côté qui le saisit utilise toujours l'adresse que suit réellement la route.
## 📊 Les chiffres
Mesuré par [`eval/ygg_eval.py`](../eval/ygg_eval.py) — 232 mémoires, 110 requêtes étiquetées, poids de classement ajustés uniquement sur le split *dev*, donc **le holdout est le chiffre non biaisé** (recall@1, avec le modèle `paraphrase-multilingual`) :
| Mode de recherche | holdout recall@1 | recall@3 | lexical zéro dépendance |
| --- | --- | --- | --- |
| **Au sein d'un projet** (le vrai chemin, pool ~11) | **0.94** | **1.00** | 0.76 |
| **Base entière** (sans filtre, pool 232) | 0.72 | **0.87** | 0.69 |
**Au sein d'un projet — le chemin que vous utilisez — la bonne mémoire est en position #1 dans 0.94 des requêtes et toujours dans le top 3 (recall@3 = 1.00).** Chercher dans toute la base sans filtre est plus difficile (recall@1 0.72, recall@3 0.87 sur les 232). Le mode lexical zéro dépendance résout déjà les requêtes par mots-clés et par identifiants de code (1.00) ; le modèle local ajoute le sens et le multilingue (crosslingual 0.25 → 0.95). Le [détail complet dans BENCHMARKS.md](../BENCHMARKS.md) présente les IC à 95 %, les tailles de pool et les scores par classe — et vous pouvez tout relancer en une minute : `python3 eval/ygg_eval.py --report`.
**La taille du corpus fait partie du chiffre.** Sur un vrai store de 4 799 mémoires, l'embedder multilingue par défaut retombe au niveau de la référence lexicale (recall@1 0.55) ; `bge-m3` tient 0.775 dans ce cas. Si votre store grandit jusqu'à des milliers d'entrées, choisissez `bge-m3` — détails dans [BENCHMARKS.md](../BENCHMARKS.md).
## 🆚 Yggdrasil face aux autres
Tous les autres capturent automatiquement les transcriptions ou vous vendent un cloud. Le pari d'Yggdrasil : garder les **quelques choses qui comptent**, soignées et dédupliquées, dans des enregistrements simples qui vous appartiennent — et les partager entre **tous** les outils et projets.
| | **Yggdrasil** | Mémoire intégrée (Claude Code · Codex) | [claude-mem](https://github.com/thedotmack/claude-mem) | [mem0](https://github.com/mem0ai/mem0) / OpenMemory | [basic-memory](https://github.com/basicmachines-co/basic-memory) |
| --- | --- | --- | --- | --- | --- |
| Décisions / leçons / statut soignés (pas des transcriptions) | ✅ | ⚠️ notes auto | ❌ capture tout | ⚠️ | ⚠️ notes libres |
| Une seule mémoire **entre les outils** | ✅ | ❌ cloisonnée par éditeur | ✅ | ✅ | ✅ |
| Rappel **inter-projets** (« résolu ça dans le projet B ») | ✅ | ❌ limité au dépôt | ⚠️ | ⚠️ | ⚠️ |
| **100 % local** par défaut | ✅ | ✅ | ⚠️ sync cloud en option | ❌ hébergé d'abord | ✅ |
| **Zéro dépendance** (stdlib + SQLite) | ✅ | — | ❌ Node + Bun + daemon worker | ❌ Docker + Qdrant + clé LLM | ❌ |
| Fonctionne **sans LLM ni clé d'API** | ✅ | ✅ | ❌ compresse par IA | ❌ | ✅ |
| **Recherche sémantique, 100 % locale** | ✅ Ollama opt-in | ❌ grep uniquement | ⚠️ Chroma en option | ⚠️ exige une clé d'API ou un stack Docker | ❌ |
| **Markdown brut qui vous appartient** (prêt pour Obsidian) | ✅ | ✅ | ❌ | ❌ | ✅ |
**Le voisin le plus proche — claude-mem :** une mémoire qui capture tout, enregistre chaque session et la compresse par IA (Node 20+ *et* Bun, un daemon worker persistant ; Chroma en option). Yggdrasil fait le pari inverse : un petit stock à fort signal plutôt qu'un déluge qui grossit. **mem0** est un SDK plus une plateforme hébergée pour construire des *applis* qui se souviennent de *leurs utilisateurs* — même auto-hébergé, il lui faut une clé d'API LLM. **Les mémoires intégrées** sont réellement utiles — et structurellement cloisonnées : un éditeur, un dépôt, une machine, du grep littéral. Yggdrasil est la couche au-dessus (et `ygg seed` peut s'amorcer à partir de ces mêmes transcriptions). Couche entièrement différente : [context-mode](https://github.com/mksglu/context-mode) (fenêtre de contexte vive) et [Context7](https://github.com/upstash/context7) (doc fraîche des bibliothèques) — les deux se marient très bien avec Yggdrasil.
## 🧰 Commandes
Les agents voient six outils MCP : `ygg_health`, `ygg_bootstrap`, `ygg_search`, `ygg_recall`, `ygg_remember`, `ygg_materialize` — enregistrés automatiquement par le plugin ou `ygg install`.
Référence complète de la CLI ygg
**Opérations de mémoire**
| Commande | Ce qu'elle fait |
| --- | --- |
| `ygg recall --query "…"` | Recherche **inter-projets** — « ai-je déjà fait ça quelque part ? » |
| `ygg search --project P --query "…"` | Recherche limitée au projet (`--type`, `--tag`, `--limit`, `--json`) |
| `ygg remember --project P --type lesson --content "…"` | Enregistrer une mémoire durable (protégée contre les secrets, dédupliquée) |
| `ygg bootstrap --project P` | Charger la mémoire d'un projet avant de commencer le travail |
| `ygg pin --id ID` · `ygg unpin --id ID` | Épingler une mémoire pour qu'elle remonte de façon fiable |
| `ygg supersede --id ID` | Archiver une mémoire obsolète qu'une plus récente remplace |
| `ygg unarchive --id ID` | Restaurer une mémoire archivée (y compris sur les machines liées) |
| `ygg materialize --id ID --project P` | Exporter une mémoire vers une note Obsidian |
| `ygg export-native --project P` | Écrire une synthèse triée dans `AGENTS.md`/`MEMORY.md` — alimenter la mémoire native de Claude Code et Codex |
| `ygg import --from TOOL --path P` | Migrer le stock d'un autre outil de mémoire vers Yggdrasil (`mcp-memory`, `basic-memory` ; `--dry-run` d'abord) |
| `ygg review [--apply]` | Traiter la file de gouvernance — consolider les doublons, signaler les mémoires obsolètes/en conflit (archivage uniquement, réversible) |
| `ygg delete --id ID` · `ygg reset …` | Supprimer définitivement une mémoire · annuler en masse un `ygg seed` raté (demande confirmation d'abord) |
**Démarrage à froid**
| Commande | Ce qu'elle fait |
| --- | --- |
| `ygg seed` | Distille les transcriptions Claude Code + Codex, les coffres Obsidian, les dépôts `CLAUDE.md` — incrémental, dédupliqué, entièrement local |
| `ygg seed --dry-run` · `--force` | Découverte + estimation uniquement · tout redistiller |
| `ygg link` · `ygg link ` | Lie deux de **vos** machines directement sur un même réseau — mémoire partagée en direct, TLS épinglé, sans relais |
| `ygg link --list` · `ygg unlink ` | Affiche les machines liées · révoque-en une |
| `ygg distill --source PATH` | Distiller un dossier/fichier en leçons |
| `ygg reindex` | Compléter les embeddings manquants (restaure le rappel dense) |
**Service et configuration**
| Commande | Ce qu'elle fait |
| --- | --- |
| `ygg install` · `ygg doctor` · `ygg update` | Configuration guidée · diagnostic avec corrections concrètes · mise à jour |
| `ygg config` | Afficher/définir les réglages persistants (`list` · `get` · `set` · `unset`) |
| `ygg status` · `start` · `stop` · `restart` · `logs` | Gérer le daemon toujours actif |
| `ygg hooks` · `unhooks` · `register` | Hook SessionStart on/off · (ré)enregistrer MCP |
| `ygg recommend` · `token` · `uninstall` | Catalogue de modèles · afficher le jeton d'authentification · tout supprimer |
Donnez-lui une personnalité — éditez `~/.yggdrasil/identity.json` :
```json
{ "name": "Jarvis", "persona": "concise, proactive, dry wit", "user_facts": ["prefers TypeScript", "ships small PRs"] }
```
Amorçage lourd, portable modeste ? Pointez la distillation vers *n'importe quelle* machine de votre réseau local — un poste avec Ollama, LM Studio, llama.cpp, **même un iPhone qui fait tourner une appli de serveur LLM local** : `ygg config set distill_url http://:11434`. Yggdrasil détecte automatiquement le dialecte d'API (Ollama ou compatible OpenAI) ; vos données ne quittent toujours jamais votre réseau — détails dans [docs/ygg-cli.md](../docs/ygg-cli.md).
## ❓ FAQ
Claude Code a déjà une mémoire intégrée — pourquoi Yggdrasil ?
Les mémoires intégrées sont propres à un éditeur, à un dépôt, à une machine, et récupérées par correspondance textuelle littérale. Yggdrasil est la couche au-dessus : la *même* mémoire dans Claude Code, Codex et n'importe quel hôte MCP, un rappel *entre* les projets, une recherche sémantique optionnelle — toujours 100 % local. Les deux se complètent : gardez la mémoire native, et laissez `ygg seed` distiller votre historique existant dans le cerveau partagé.
Envoie-t-il mon code ou ma mémoire dans le cloud ?
Non. Le moteur, la base de données et les modèles optionnels tournent tous localement. Pas de compte, pas de télémétrie. Le seul appel sortant est une vérification de version auprès de PyPI.
Si vous liez deux de vos propres machines avec `ygg link`, les mémoires voyagent **entre ces deux machines** via votre propre réseau — directement, en TLS avec certificat épinglé, sans relais ni serveur à nous sur le chemin. Tant que vous n'avez pas lancé cette commande, rien n'écoute au-delà du loopback.
Un dépôt malveillant peut-il glisser des instructions dans ma mémoire ?
Le contenu rappelé est injecté sous forme de *notes de référence, pas d'instructions*, clairement encadrées, avec l'origine de chaque note et un marqueur lorsqu'elle appartient à un autre projet — l'agent la traite donc comme une donnée et demande avant d'agir sur ce qu'elle contient. Les secrets sont masqués dans les transcriptions avant distillation et refusés à l'écriture. Malgré tout : une mémoire ne vaut que ce qui l'a écrite — relisez `ygg review` de temps en temps.
Mémorise-t-il automatiquement tout ?
Non — c'est voulu. La récupération est automatique ; l'*écriture* est délibérée (l'agent appelle `ygg_remember` pour les leçons durables). Tout capturer pollue la mémoire et brûle des jetons, donc on ne le fait pas. Le modèle d'arrière-plan optionnel consolide ce qui est déjà enregistré (proposition seule).
Ai-je besoin d'un GPU ou d'une clé d'API ?
Non. Par défaut, c'est de la recherche purement lexicale — zéro dépendance, instantanée. La recherche sémantique est opt-in et utilise un modèle *local* via Ollama. L'installateur en recommande un adapté à votre matériel.
Quelle est sa lourdeur, et combien de jetons coûte-t-il ?
Le moteur tourne au repos à **~21 Mo de RAM** (mode lexical par défaut) avec ~0 % de CPU ; le disque représente des dizaines de Ko par mémoire. Le démarrage de session injecte ~300 jetons ; chaque appel d'outil renvoie un petit extrait. Tout le gros travail (indexation, embeddings, consolidation) tourne hors LLM, sur votre machine.
Puis-je éditer ou supprimer des mémoires à la main ?
Oui. Les mémoires se matérialisent en notes Markdown dans un coffre Obsidian — lisez-les, éditez-les ou supprimez-les comme n'importe quel fichier. La gouvernance et la relecture ne suppriment jamais rien : elles archivent, ce qui est réversible. Vous seul pouvez supprimer définitivement, explicitement, avec `ygg delete` (et sur les machines liées, cette suppression atteint les deux).
## 🚦 Statut et feuille de route
**Alpha.** Le chemin nominal et la boucle de gouvernance sont couverts par des gates (`scripts/run_gates.sh`) ; pas encore durci pour le multi-utilisateur ni la production. macOS aujourd'hui ; les installateurs de service Linux/Windows sont prêts et en phase finale de tests sur appareil.
Livré récemment : 🔗 mémoire entre machines (`ygg link`) · graphe de relations (`ygg relate` : `solves` / `supersedes` / `contradicts`).
Ensuite : 🛰️ cross-surface (une seule mémoire entre CLI, web et téléphone — la façade HTTP est en place, voir [docs/cross-surface.md](../docs/cross-surface.md)) · 🐧 disponibilité générale Linux/Windows.
## 🤝 Contribuer
Issues et PR bienvenues. Lancez `scripts/run_gates.sh` et `python3 -m unittest discover -s tests` avant de soumettre — tous les gates doivent rester verts.
## 📜 Licence
**GNU AGPL v3.0** — voir [LICENSE](../LICENSE). Libre et open source : utilisez, modifiez, auto-hébergez, redistribuez. Si vous le modifiez ou le proposez en tant que service réseau, vous devez publier votre code source sous la même licence.