🌳 Yggdrasil
别再向每个新的 AI 会话重新解释你的项目。
一份本地记忆,供 Claude Code、Codex 以及所有 MCP 智能体共用——跨会话、跨工具、跨项目共享。零依赖。任何数据都不会离开你的机器。




安装 ·
工作原理 ·
关键数据 ·
对比 ·
常见问题
其他语言版本:English · Русский · Español · Français · 日本語 · Deutsch
---
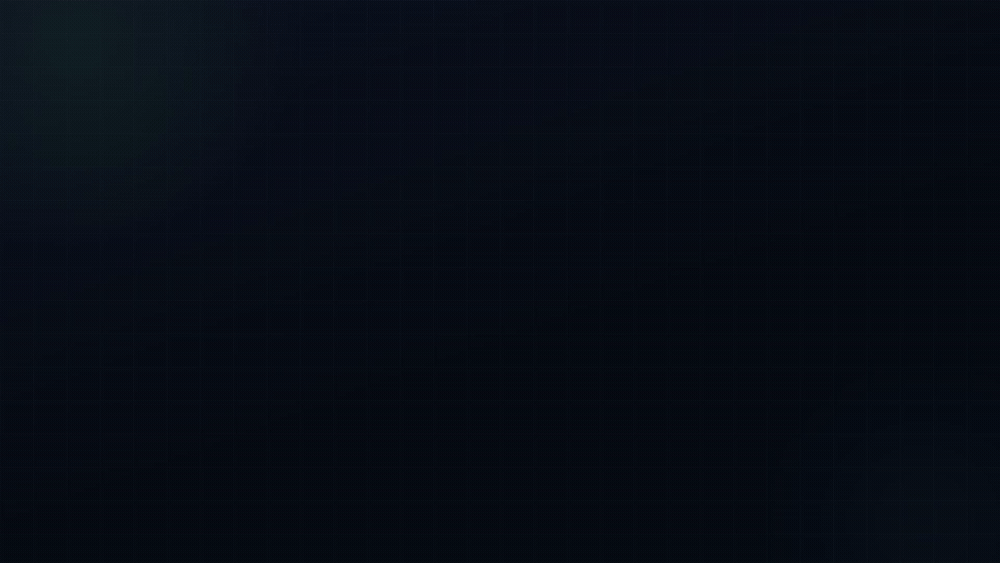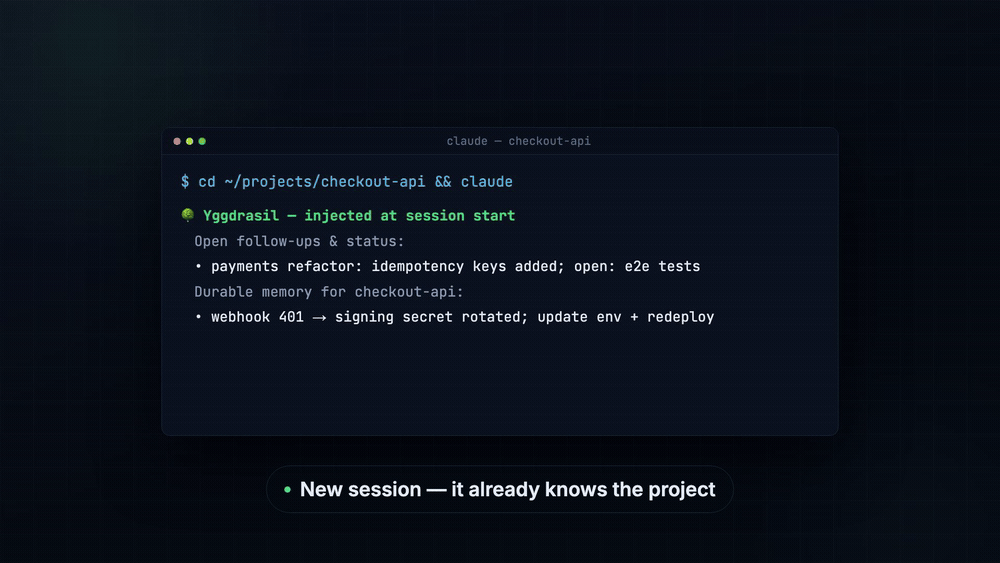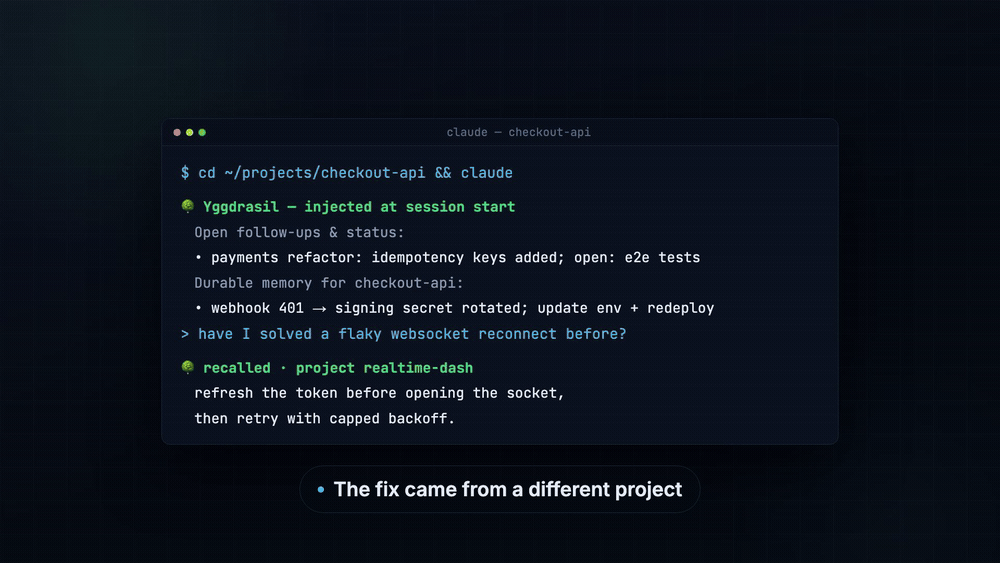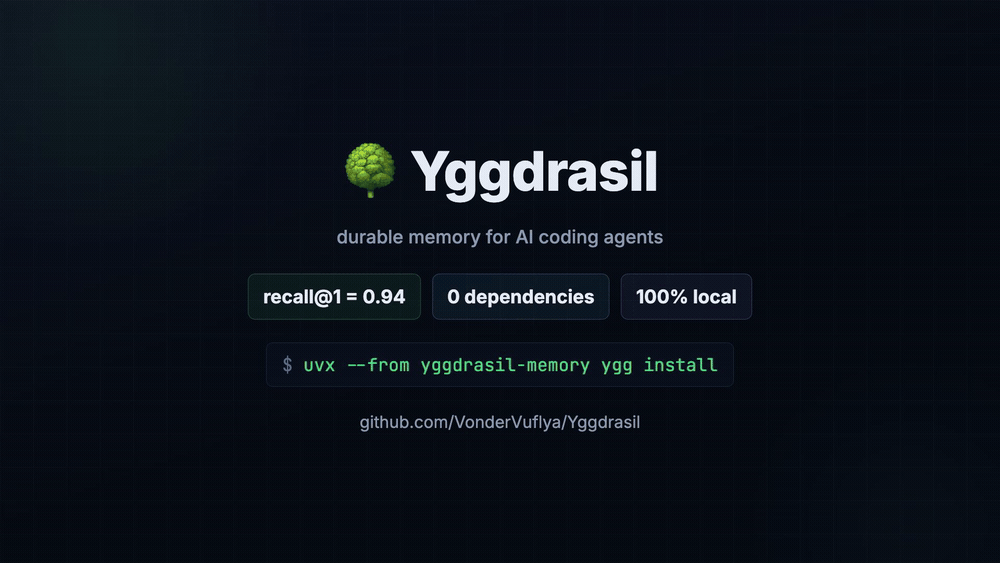
每开一个新对话,你的 AI 都会忘得一干二净。于是你只能一遍又一遍地重新解释项目、决策、那些坑——每次都讲,每个工具里都讲。**Yggdrasil 是一个小巧、常驻的记忆,任何智能体都能接入。** 在任何项目里、用任何 AI 开一个新会话,它已经知道你定过什么、出过什么问题、还有什么没解决。
```text
$ cd ~/projects/checkout-api && claude # a brand-new session
🌳 Yggdrasil (injected automatically at session start)
• [project_status] payments refactor: idempotency keys added; open: e2e tests
• [lesson] webhook 401 → signing secret rotated; update env + redeploy
> "have I solved a flaky websocket reconnect anywhere before?"
🌳 recall → found in project `realtime-dash`:
refresh the token *before* opening the socket, then retry with capped backoff.
```
不用再说“让我提醒你一下我们昨天做了什么”。它本来就在那儿。
## 🚀 安装
在 **Claude Code** 里敲两条命令即可(插件通过 [`uv`](https://docs.astral.sh/uv/) 启动):
```text
/plugin marketplace add VonderVuflya/Yggdrasil
/plugin install yggdrasil
```
引擎会在首次使用时惰性启动,并生成自己的本地 token——无需 API key,无需云端,无需任何配置。Codex 和 Cursor 使用同样的流程。
其他所有安装渠道——CLI 守护进程、Homebrew、npm、Claude Desktop、从源码……
| 宿主 / 工具 | 命令 |
| --- | --- |
| **uvx** _(推荐 CLI)_ | `uvx --from yggdrasil-memory ygg install` |
| **npm / npx** | `npx yggdrasil-memory install` |
| **pipx** | `pipx install yggdrasil-memory && ygg install` |
| **pip** | `pip install yggdrasil-memory && ygg install` |
| **Homebrew** _(macOS)_ | `brew install VonderVuflya/tap/yggdrasil && ygg install` |
| **Claude Desktop** _(应用)_ | 把 `.mcpb` 从[最新发布](https://github.com/VonderVuflya/Yggdrasil/releases/latest)拖到 Settings → Extensions,粘贴你的 token(`ygg token`)——桌面应用即可与你的 CLI 智能体共享同一份记忆([指南](../packaging/mcpb/README.md)) |
| **从源码** | `uvx --from git+https://github.com/VonderVuflya/yggdrasil.git ygg install` |
`ygg install` 是一次性的引导式设置:它会安装一个常驻的后台服务,把 MCP 工具注册到它找到的每一个智能体宿主——**Claude Code、Codex、OpenCode**——并在硬件允许时推荐可选的本地模型(也可以选 `none`,保持零配置)。
OpenCode——无需任何配置
先安装 [OpenCode](https://opencode.ai),再运行 `ygg install`(如果 Yggdrasil 已经装好,就运行 `ygg redeploy`)——配置项会自动写好,并合并进已有的 `opencode.json`。用下面的命令确认:
```bash
opencode mcp list # -> ✓ yggdrasil connected
```
在 Yggdrasil *之后*才装的 OpenCode?直接重新运行 `ygg install` 就行。
如果你更想手写配置,注意 OpenCode 的 schema 和 Claude 的同时有四处不同:服务器写在 `mcp` 下(不是 `mcpServers`),`type` 是必填项,`command` 是单个数组(不是 `command` + `args`),环境变量叫 `environment`(不是 `env`)——所以 Claude 的配置片段没法直接照搬:
```jsonc
// ~/.config/opencode/opencode.json
{
"$schema": "https://opencode.ai/config.json",
"mcp": {
"yggdrasil": {
"type": "local",
"command": ["/path/to/python3", "~/.yggdrasil/scripts/ygg_mcp_server.py"],
"enabled": true,
"environment": { "YGG_ENGINE_URL": "http://127.0.0.1:42069" }
}
}
}
```
配置里不需要放 token——引擎会自己读取那个权限为 0600 的 `~/.yggdrasil/token`。如果工具没出现,运行 `ygg doctor` 排查。
还有一个适用于任何 Claude 界面的 [`yggdrasil-memory` 技能](../skills/):MCP 连接的是*工具*,技能教会智能体*何时*使用它们。两者并用效果最佳。
什么都不装、用一个一次性数据库先试试:`uvx --from yggdrasil-memory ygg serve --reset --db /tmp/ygg.sqlite`。
然后就正常干活:让你的智能体*“回忆一下我们对这个项目定过什么”*,告诉它*“记住这个决策”*——下一个会话它就已经在那儿了。随时可以用 `ygg doctor` 验证安装。
**已经有历史积累?** 从你现有的 Claude Code + Codex 会话记录、Obsidian 库和 `CLAUDE.md` 仓库播种记忆——全部在本地提炼:
```bash
ygg seed --dry-run # see what it would import; drop the flag to distill for real
```
**正在放弃另一个记忆工具?** `ygg import --from mcp-memory --path memory.json` 会把它的整个存储导入 Yggdrasil(自动去重、有密钥防护)——之后你就可以删掉它了。
## 为什么
- 🧠 **持久**——决策、教训和项目状态跨会话留存。
- 🔌 **一个大脑,所有工具**——Claude Code、Codex、OpenCode 和任何 MCP 宿主共享同一份记忆。
- 🌐 **跨项目回忆**——*“这看起来跟你在项目 B 里做过的很像——要复用吗?”*
- 🧹 **精选,而非照单全收**——你的智能体只保存少数真正重要的东西;治理机制负责去重与归档,绝不删除。
- 🌱 **自我维护***(可选启用)*——一个小型本地模型在后台整合记忆。零 API token。
- 🪪 **处处同一个身份**——可选的名字和个性会被每个智能体继承,让 Claude Code 和 Codex 用起来像同一个助手。
- 🔒 **100% 本地**——你的记忆就在你自己的机器上。无云端、无账号、无遥测。
## 🧠 工作原理
Yggdrasil 是**记忆 + 工具**——*智能*来自你的 LLM。它只负责在恰当的时刻,把恰当的记忆摆到恰当的智能体面前。
- 🛎️ **常驻守护进程**——一个微小的本地服务(约 21 MB 内存),你的智能体通过 MCP 工具(`ygg_search`、`ygg_recall`、`ygg_remember` ……)访问它。
- 🪝 **钩子**——会话开始时自动注入身份、项目状态和待办的后续事项(约 300 token);一个可选的逐次提问钩子会自动为*每个请求*调用相关记忆。
- 📌 **排序**——置顶的和被频繁回忆的记忆优先浮现。
- 🧹 **治理**——重复和冲突的记忆会排队等你审查;所有改动都是非破坏性的(归档,绝不删除)。
- 📓 **Obsidian**——每一条记忆同时也是一份纯 Markdown 笔记,可读、可编辑、可 grep。
## 🎛️ 记忆层级——默认零配置
开箱即用,Yggdrasil 运行在 **SQLite + FTS5 之上,零依赖**——即时的关键词搜索,无需模型,无需下载任何东西。可选的**本地**模型(通过 [Ollama](https://ollama.com))可再添加两个相互独立的层级:
| 层级 | 你添加 | 你获得 |
| --- | --- | --- |
| **0 · 默认** | 无——SQLite + FTS5 | 关键词搜索,零依赖,即时——recall@1 = **0.77** |
| **1 · 语义** | 一个**嵌入**模型(`all-minilm` 45 MB · `paraphrase-multilingual` ~560 MB) | 按**含义**、跨语言搜索——recall@1 = **0.94**,recall@3 **1.00** |
| **2 · 自我维护** | 一个小型 **LLM**(`qwen2.5:1.5b` ~1 GB) | 后台对记忆去重/合并(仅提议) |
Ollama 只负责*计算*向量和运行后台模型——每一条记忆、每一个向量都留在同一个本地 SQLite 里。`ygg install` 会检测你的硬件并推荐合适的选择(`ygg recommend` 显示完整目录)。
完整模型菜单
**嵌入(语义搜索):**
| 模型 | 大小 | 适用场景 |
| --- | --- | --- |
| `all-minilm` | 45 MB | 英文,小巧快速 |
| `nomic-embed-text` | 274 MB | 英文,质量更好(768d) |
| `mxbai-embed-large` | 670 MB | 英文,高质量(1024d) |
| `paraphrase-multilingual` | ~560 MB | 多语言(EN/RU + 50 种语言,768d) |
| `bge-m3` | 1.2 GB | 多语言,顶级质量(更重) |
**嵌入后端**——默认是 Ollama。如果想改用兼容 OpenAI 的
`/v1/embeddings` 服务器(llama.cpp 的 `llama-server --embeddings`、
OpenRouter、LM Studio、vLLM),设置 `embed_backend`:
```bash
# local llama.cpp — no key needed
ygg config set embed_backend openai
ygg config set embed_url http://127.0.0.1:8080/v1
ygg config set embed_model bge-small-en-v1.5
ygg redeploy
# OpenRouter — free embeddings, no GPU needed
ygg config set embed_backend openai
ygg config set embed_url https://openrouter.ai/api/v1
ygg config set embed_model nvidia/llama-nemotron-embed-vl-1b-v2:free
ygg config set embed_api_key sk-or-... # or export YGG_EMBED_API_KEY
ygg redeploy
```
密钥保存在 `~/.yggdrasil/embed_api_key`(0600)而不是
`config.json` 里,并以**文件路径**的形式传给守护进程——因此它不会出现
在 `ps`、launchd 的 plist 或 systemd 的 unit 里。`ygg config list` 会把它遮蔽掉。
用 `ygg doctor` 确认是否生效——dense 应该会显示你的模型名:
```
✓ dense active (nvidia/llama-nemotron-embed-vl-1b-v2:free)
```
如需手动接入 LM Studio 或 OpenRouter,相关注意事项(两种 URL 格式、模型 ID、JIT 加载、推理密钥与配置密钥的区别、隐私过滤)见 [docs/model-backends.md](../docs/model-backends.md)。
保持本地,在质量*和*隐私上依然更胜一筹:在 232 条记忆 / 110 条查询的语料库上,
本地的 `paraphrase-multilingual` 拿到 recall@1 **0.964**,高于免费托管模型的
**0.946**——而且你的记忆完全不会离开这台机器。托管后端该用在机器跑不动 Ollama
的时候,而不是为了追求精度。
在这里,更大的向量**不会**换来更高的精度——同一语料库上 `mxbai-embed-large`
(1024d)的得分是 0.809,`nomic-embed-text`(768d)是 0.818,二者的差距完全被
置信区间吞掉。真正影响得分的是模型是否覆盖*你用的*语言:这两个模型都只支持英文,
跨语言查询时会掉到 0.40–0.45,而多语言的默认模型能保持在 0.95。
**后台整合(小型 LLM):**
| 模型 | 大小 | 适用场景 |
| --- | --- | --- |
| `qwen2.5:0.5b` | ~400 MB | 小巧,CPU 上很快 |
| `qwen2.5:1.5b` | ~1 GB | 最佳 CPU 默认选择 |
| `llama3.2:3b` | ~2 GB | 质量更好,CPU 上更慢 |
引擎本身是可替换的——任何满足 `MemoryBackend` 契约的服务都能直接接入(`YGG_ENGINE_URL`);参见 [docs/backend-boundary.md](../docs/backend-boundary.md)。
## 🔗 跨机器共享一份记忆
在笔记本和更强的主机之间工作?把它们链接一次,它们就不再是两个大脑了。
```text
# on the laptop
$ ygg link
🔗 pairing code valid 5 minutes · single use
ygg://192.168.3.152:42070/a4e0df489737#FOucjgJ1FrUB…
# on the other machine — paste it
$ ygg link ygg://192.168.3.152:42070/a4e0df489737#FOucjgJ1FrUB…
✓ linked with laptop https://192.168.3.152:42070
✓ laptop: fetch 84 · push 12 · delete 0 · tombstones 0
```
就这么简单。从那以后,在一台机器上写下的记忆大约一秒内就会出现在另一台上;在一台机器上执行 `ygg delete`,两台机器上都会删除它;而另一台机器睡着时,每台机器仍能用自己的本地副本正常工作——读取从不等待网络。机器重新上线后,两者会比对指纹,并修补它们错过的内容,无需你做任何操作。
系统**没有轮询**。Yggdrasil 每天只会被调用几次,因此写入会在发生时立即推送,同步由读取触发;空闲的机器什么都不发送。
**它不是什么:** 不是云。没有中继、没有账号,链路上也没有我们的任何服务器。机器之间直接通过你自己的网络通信,使用彼此固定(pinned)证书的 TLS,并使用只存在于这两台机器上的密钥对。配对码本身就包含签发机器的证书,所以即使是第一次连接也会被验证——如果网络上有别的东西冒充应答,会在配对密钥发送之前被拒绝。在你运行 `ygg link` 之前,不会绑定任何网络端口——安装 Yggdrasil 后它仍像以前一样只监听回环地址。
```text
ygg link --list # what's linked, and whether writes are actually arriving
ygg link --sync # reconcile now, don't wait for a read
ygg unlink # revoke that machine's key here
```
详情:什么会同步、什么留在本地,以及何时改用 ygg sync
**同步的内容:** 记忆、它们之间的关系,以及删除操作。**留在本地的:** 你打开某条记忆的次数,以及你在哪台机器上读取它——这属于本地排序,而不是知识。嵌入向量通常也留在本地,但有一个例外:如果两台机器运行相同的嵌入模型,向量会随之同步,因此计算机可以替笔记本完成嵌入,笔记本永远不需要运行模型。
**较新的编辑胜出。** 如果在两台机器通信之前,你在两台机器上都编辑了同一条记忆,那么较新的编辑会在两台机器上都保留下来(即使它更短,比如一次更正)。
**删除优先。** 如果你在一台机器上删除了某条记忆,同时在另一台机器上编辑了它,删除会胜出,编辑会丢失。这是有意为之的:“我删掉了泄露的 token”必须成立,即使两台机器的时钟不一致。如果你的意思是“我改主意了”,请改为归档——不会丢失任何东西,`ygg unarchive` 可以在两台机器上把它恢复(以较晚的决定为准)。
**防火墙会在配对时被发现。** 打印配对码的机器会立即回拨另一台;如果连不通,`ygg link` 会直接告诉你,并输出唯一一条只为该机器开放端口的命令(ufw、firewalld、Windows)。之后 `ygg link --list` 和 `ygg doctor` 会继续检查:只有确认写入已送达,对端才会显示 ✓;否则显示错误以及正在等待的更改数量。通过 DHCP 获得新地址的机器,会在下一次联系时被重新找到。
**`ygg sync`(git)依然存在**,它做的是另一件事:彼此看不见的机器、位于不同网络里的工作笔记本、你随身携带的 U 盘上的裸仓库。同一网络内的机器用 `ygg link`,其他情况用 `ygg sync`。两者共享相同的合并规则,因此可以同时使用。如果两台机器都在同一个 Tailscale tailnet 中,`ygg link --tailscale` 也能跨网络工作。
**如果配对码显示的地址不对**(它会优先选择真实的以太网和 Wi-Fi,而不是虚拟机网桥和 VPN,但仍可能猜错),请固定它:`ygg config set sync_host 192.168.3.152`——或者在另一台机器上打印配对码:输入配对码的一方总会使用实际路由所经过的地址。
## 📊 关键数据
由 [`eval/ygg_eval.py`](../eval/ygg_eval.py) 测得——232 条记忆、110 个带标注的查询,排序权重仅在 *dev* 划分上调优,所以 **holdout 才是无偏的数字**(使用 `paraphrase-multilingual` 模型):
| 搜索视图 | holdout recall@1 | recall@3 | 零依赖词法 |
| --- | --- | --- | --- |
| **在项目内**(真实路径,候选池 ~11) | **0.94** | **1.00** | 0.76 |
| **整个存储库**(无过滤,候选池 232) | 0.72 | **0.87** | 0.69 |
**在项目内——你实际使用的路径——正确的记忆在 0.94 的查询中排在第 1,并且每次都落在前 3 名里(recall@3 = 1.00)。** 不加过滤地搜索整个存储库更难(recall@1 0.72,recall@3 0.87,覆盖全部 232 条)。零依赖词法模式已经能解决关键词和代码标识符类查询(1.00);本地模型则补上了含义和跨语言能力(crosslingual 0.25 → 0.95)。[BENCHMARKS.md 中的完整拆解](../BENCHMARKS.md)给出了 95% 置信区间、候选池大小和分类得分——你也可以花一分钟左右自己重跑一遍:`python3 eval/ygg_eval.py --report`。
**语料库规模也是数字的一部分。** 在一个真实的 4,799 条记忆的存储上,默认的多语言嵌入模型会跌回词法基线(recall@1 0.55);`bge-m3` 在那里能保持 0.775。如果你的存储增长到数千条,就选 `bge-m3`——详情见 [BENCHMARKS.md](../BENCHMARKS.md)。
## 🆚 Yggdrasil 与同类方案对比
其他方案要么自动捕获会话记录,要么向你兜售云服务。Yggdrasil 押的是另一条路:只保留**少数真正重要的东西**,经过精选和去重,以你自己拥有的普通记录存储——并在**所有**工具和项目之间共享。
| | **Yggdrasil** | 内置记忆 (Claude Code · Codex) | [claude-mem](https://github.com/thedotmack/claude-mem) | [mem0](https://github.com/mem0ai/mem0) / OpenMemory | [basic-memory](https://github.com/basicmachines-co/basic-memory) |
| --- | --- | --- | --- | --- | --- |
| 精选的决策 / 教训 / 状态(而非会话记录) | ✅ | ⚠️ 自动笔记 | ❌ 捕获一切 | ⚠️ | ⚠️ 自由格式笔记 |
| 一份记忆**跨工具**共享 | ✅ | ❌ 厂商孤岛 | ✅ | ✅ | ✅ |
| **跨项目**回忆(“在项目 B 里解决过这个”) | ✅ | ❌ 仅限当前仓库 | ⚠️ | ⚠️ | ⚠️ |
| 默认 **100% 本地** | ✅ | ✅ | ⚠️ 云同步为附加组件 | ❌ 托管优先 | ✅ |
| **零依赖**(标准库 + SQLite) | ✅ | — | ❌ Node + Bun + 常驻 worker 守护进程 | ❌ Docker + Qdrant + LLM key | ❌ |
| **无需 LLM 和 API key** 也能用 | ✅ | ✅ | ❌ AI 压缩 | ❌ | ✅ |
| **完全本地的语义搜索** | ✅ 可选启用 Ollama | ❌ 仅 grep | ⚠️ 可选 Chroma | ⚠️ 需要 API key 或 Docker 全家桶 | ❌ |
| 你自己拥有的纯 **Markdown**(Obsidian 就绪) | ✅ | ✅ | ❌ | ❌ | ✅ |
**最接近的邻居——claude-mem:** 一款捕获一切的记忆系统,会记录并用 AI 压缩每一次会话(Node 20+ *加* Bun,外加一个常驻 worker 守护进程;Chroma 可选)。Yggdrasil 押的是相反的方向:一个小而高信噪比的存储,而不是不断膨胀的信息洪流。**mem0** 是一个 SDK 加托管平台,用于构建能记住*其用户*的*应用*——即使自托管也需要一个 LLM API key。**内置记忆**确实有用——但在结构上是孤岛:一个厂商、一个仓库、一台机器、字面文本 grep。Yggdrasil 是它们之上的一层(而且 `ygg seed` 还能用同样的会话记录来引导自己)。完全不同的另一层:[context-mode](https://github.com/mksglu/context-mode)(实时上下文窗口)和 [Context7](https://github.com/upstash/context7)(最新的库文档)——两者都能与 Yggdrasil 很好地搭配。
## 🧰 命令
智能体能看到六个 MCP 工具:`ygg_health`、`ygg_bootstrap`、`ygg_search`、`ygg_recall`、`ygg_remember`、`ygg_materialize`——由插件或 `ygg install` 自动注册。
完整的 ygg CLI 参考
**记忆操作**
| 命令 | 作用 |
| --- | --- |
| `ygg recall --query "…"` | **跨项目**搜索——“我在哪儿做过这件事吗?” |
| `ygg search --project P --query "…"` | 项目范围内的搜索(`--type`、`--tag`、`--limit`、`--json`) |
| `ygg remember --project P --type lesson --content "…"` | 保存一条持久记忆(有密钥防护,自动去重) |
| `ygg bootstrap --project P` | 开始工作前拉取某个项目的记忆 |
| `ygg pin --id ID` · `ygg unpin --id ID` | 置顶一条记忆,让它可靠地浮现 |
| `ygg supersede --id ID` | 归档一条已被新记忆替代的过期记忆 |
| `ygg unarchive --id ID` | 恢复一条已归档的记忆(在已链接的机器上同样生效) |
| `ygg materialize --id ID --project P` | 把一条记忆导出为 Obsidian 笔记 |
| `ygg export-native --project P` | 把精选摘要写入 `AGENTS.md`/`MEMORY.md`——供 Claude Code 与 Codex 的原生记忆使用 |
| `ygg import --from TOOL --path P` | 把另一个记忆工具的存储迁移到 Yggdrasil(`mcp-memory`、`basic-memory`;先用 `--dry-run`) |
| `ygg review [--apply]` | 处理治理队列——合并重复项、标记陈旧/冲突的记忆(仅归档,可逆) |
| `ygg delete --id ID` · `ygg reset …` | 彻底删除一条记忆 · 批量撤销一次糟糕的 `ygg seed`(先确认) |
**冷启动**
| 命令 | 作用 |
| --- | --- |
| `ygg seed` | 提炼 Claude Code + Codex 会话记录、Obsidian 库和 `CLAUDE.md` 仓库——增量、去重、完全本地 |
| `ygg seed --dry-run` · `--force` | 仅发现 + 估算 · 重新提炼所有内容 |
| `ygg link` · `ygg link ` | 在同一网络上直接链接**你自己的**两台机器——实时共享记忆、固定 TLS、无中继 |
| `ygg link --list` · `ygg unlink ` | 查看已链接的机器 · 撤销某一台 |
| `ygg distill --source PATH` | 把单个目录/文件提炼为教训 |
| `ygg reindex` | 补建缺失的嵌入(恢复稠密检索) |
**服务与设置**
| 命令 | 作用 |
| --- | --- |
| `ygg install` · `ygg doctor` · `ygg update` | 引导式设置 · 诊断并给出可执行的修复建议 · 升级 |
| `ygg config` | 显示/设置持久化配置(`list` · `get` · `set` · `unset`) |
| `ygg status` · `start` · `stop` · `restart` · `logs` | 管理常驻守护进程 |
| `ygg hooks` · `unhooks` · `register` | 开/关 SessionStart 钩子 ·(重新)注册 MCP |
| `ygg recommend` · `token` · `uninstall` | 模型目录 · 打印鉴权 token · 移除一切 |
给它设定个性——编辑 `~/.yggdrasil/identity.json`:
```json
{ "name": "Jarvis", "persona": "concise, proactive, dry wit", "user_facts": ["prefers TypeScript", "ships small PRs"] }
```
播种任务很重、笔记本很弱?把提炼工作指向你局域网里的*任意*一台机器——运行 Ollama、LM Studio、llama.cpp 的台式机,**甚至是运行本地 LLM 服务器应用的 iPhone**:`ygg config set distill_url http://:11434`。Yggdrasil 会自动识别 API 方言(Ollama 或 OpenAI 兼容接口);你的数据依然不会离开你的网络——详见 [docs/ygg-cli.md](../docs/ygg-cli.md)。
## ❓ 常见问题
Claude Code 已经有内置记忆了——为什么还要 Yggdrasil?
内置记忆按厂商、按仓库、按机器隔离,而且靠字面文本匹配来检索。Yggdrasil 是它们之上的一层:在 Claude Code、Codex 和任何 MCP 宿主里都是*同一份*记忆,能*跨*项目回忆,还有可选的语义搜索——依然 100% 本地。两者可以叠加:保留原生记忆,让 `ygg seed` 把你已有的历史提炼进这个共享大脑。
它会把我的代码或记忆发到云端吗?
不会。引擎、数据库以及可选的模型全都在本地运行。没有账号,没有遥测。唯一的对外请求是向 PyPI 检查版本。
如果你用 `ygg link` 把自己的两台机器链接起来,记忆会通过你自己的网络在**这两台机器之间**传输——直接连接,使用固定证书的 TLS,链路上没有中继,也没有我们的服务器。在你运行该命令之前,除回环地址外没有任何监听。
恶意仓库能在我的记忆里埋入指令吗?
召回的记忆会被注入为明确标注的*参考笔记,而非指令*,并附带每条笔记的来源;若其属于另一个项目,还会有标记。因此智能体把它当作数据对待,并在根据其中内容采取任何行动前先询问。转录内容中的密钥在提炼前会被脱敏,写入时也会被拒绝。尽管如此:记忆的可信度取决于写入它的内容——所以请时不时地运行 `ygg review` 审查一下。
它会自动记住所有东西吗?
不会——这是刻意的设计。检索是自动的;*写入*是慎重的(智能体会为值得长期保留的教训调用 `ygg_remember`)。捕获一切会污染记忆、烧掉 token,所以我们不这么做。可选的后台模型只整合已经保存下来的内容(仅提议)。
我需要 GPU 或 API key 吗?
不需要。默认是纯词法搜索——零依赖,即时可用。语义搜索是可选启用的,通过 Ollama 使用一个*本地*模型。安装程序会推荐一个适合你硬件的模型。
它有多占资源,要花多少 token?
引擎空闲时占用**约 21 MB 内存**(词法默认模式)、约 0% CPU;磁盘占用约为每条记忆几十 KB。会话开始时注入约 300 token;每次工具调用只返回一小段内容。所有繁重的工作(索引、嵌入、整合)都在你机器上、LLM 之外完成。
我可以手动编辑或删除记忆吗?
可以。记忆会物化为 Obsidian 库中的 Markdown 笔记——像对待任何文件一样读取、编辑或删除它们。治理与审查从不删除任何东西——它们只做归档,这是可逆的。只有你自己,通过 `ygg delete` 明确地执行硬删除(在已链接的机器上,该删除会同时作用于两端)。
## 🚦 状态与路线图
**Alpha 阶段。** 常规流程和治理闭环都有门禁测试覆盖(`scripts/run_gates.sh`);尚未针对多用户或生产环境做加固。目前支持 macOS;Linux/Windows 服务安装器已经构建完成,正在做最后的真机测试。
最近发布:🔗 机器之间的记忆同步(`ygg link`)· 关系图谱(`ygg relate`:`solves` / `supersedes` / `contradicts`)。
接下来:🛰️ 跨界面同步(一份记忆贯通 CLI、网页和手机——HTTP 接口已就绪,见 [docs/cross-surface.md](../docs/cross-surface.md))· 🐧 Linux/Windows 正式发布。
## 🤝 参与贡献
欢迎提交 Issue 和 PR。提交前请运行 `scripts/run_gates.sh` 和 `python3 -m unittest discover -s tests`——所有门禁都必须保持绿色。
## 📜 许可证
**GNU AGPL v3.0**——参见 [LICENSE](../LICENSE)。自由开源:可自由使用、修改、自托管、再分发。如果你修改它,或将其作为网络服务对外提供,就必须以相同的许可证公开你的源代码。