-windows-x86_64-cuda.zip` berisi `coli_cuda.dll`
(kartu dengan compute capability 8.0 ke atas) serta engine colibri, qwen36 dan
kimi_k3 yang memuatnya. Ekstrak di atas archive utama, dan proses penyiapan
memilih CUDA.
- **VRAM expert tier** menyimpan pakar yang paling sering digunakan di kartu,
dipilih berdasarkan routing yang terukur; cache miss dihitung di CPU pada saat
yang sama. Qwen3.6 pada dua kartu 8 GB (RTX 3070 dan Quadro RTX 4000)
menghasilkan 11.3 tok/s dengan riwayat yang warm
([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md)); GLM-5.2 pada enam RTX 5090
dengan semua pakar resident menghasilkan 9.0-9.2 tok/s
([benchmarks.md](docs/benchmarks.md)); DeepSeek V4 Flash pada RTX 5080
menghasilkan 1.5-1.6 tok/s dan prompt 3,324 token dalam 90 s
([deepseek-v4.md](docs/deepseek-v4.md)).
- **Baru untuk Qwen3.6: layer DeltaNet di kartu** (`Q36_DN_GPU=1`, opt-in).
Masing-masing dari 30 layer DeltaNet Qwen3.6 sebelumnya menyalin datanya antara
kartu dan CPU empat kali per token; sekarang satu token decode menjalankan
seluruh layer di kartu, dengan recurrent state tetap berada di VRAM. Pada RTX
3070 dengan layer dense di VRAM: 25.4 hingga 30.0 tok/s
([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md#the-deltanet-layer-on-the-card-q36_dn_gpu1)).
- **Kartu lama.** Jika CUDA toolkit tidak lagi dapat mengompilasi untuk kartu
Anda (CUDA 13 dan V100, dalam
[#1852](https://github.com/JustVugg/colibri/issues/1852)), proses penyiapan
mendeteksinya sebelum build dan menggunakan kartu melalui Vulkan sambil
menjelaskan alasannya; CUDA 12.x toolkit mengaktifkan kembali jalur CUDA.
CUDA tier DeepSeek V4 juga dapat di-build untuk Pascal dan Turing
(`CUDA_ARCH=portable-pre-ampere NO_TC=1`).
Selengkapnya: [docs/cuda.md](docs/cuda.md).
### Apple Silicon
Backend Metal menjalankan perhitungan pakar pada GPU unified-memory untuk
beberapa engine ([docs/metal.md](docs/metal.md)). Archive macOS dari rilis berisi
`colibri`, `inkling` dan `kimi_k3` yang di-build dengan Metal: `COLI_METAL=1`
(`K3_METAL=1` untuk Kimi K3) menyalakannya, dan tanpanya engine berjalan di CPU.
Dari source, build dengan `METAL=1`; proses penyiapan satu langkah membuat build
untuk CPU.
## System One: keputusan dengan probabilitas
Sebagian besar hal yang diminta orang dari sebuah model adalah pilihan, bukan
paragraf: antrean mana, keputusan mana, ya atau tidak. `POST /v1/systemone`
menerima sebuah state (teks atau JSON) dan pertanyaan bertipe, lalu menjawab
setiap pertanyaan dengan probabilitas untuk setiap opsi yang diizinkan beserta
confidence. Tidak ada teks yang dihasilkan, sehingga jawaban tidak mungkin
berada di luar daftar Anda, dan "model tidak yakin" menjadi angka yang dapat
Anda beri threshold.
```bash
curl -s http://127.0.0.1:8000/v1/systemone -H 'Content-Type: application/json' -d '{
"state": "340 lines, 8 files, no tests. CI is green but nothing covers that path.",
"questions": {
"review": {"type": "choice", "instructions": "What should the reviewer do?",
"criteria": {"merge": null, "request changes": null, "close": null}},
"risky": {"type": "noul", "instructions": "Is this change risky?"}}}'
```
Sebuah `choice` mengembalikan label yang dipilih, probabilitas untuk setiap
label, dan `confidence` dari 0 (merata) hingga 1 (pasti); sebuah `noul`
mengembalikan probabilitas untuk yes; sebuah `score` mengembalikan level yang
diharapkan.
Yang menjawab:
- **Model chat apa pun yang dapat dijalankan colibri**, melalui scoring: model
membaca probabilitas setiap opsi alih-alih menulis jawaban. Banyak pertanyaan
mengenai satu dokumen membaca dokumen tersebut satu kali: pada Qwen3.6,
empat pertanyaan mengenai satu dokumen selesai 5.7x lebih cepat daripada
menghasilkan jawaban yang sama pada mesin CPU yang sama.
- **Tiga model keputusan**, secara native, dalam satu forward pass dengan
kalibrasi yang disesuaikan oleh pembuatnya: [Laya](docs/laya.md)
(Convai Innovations), [GLiNER2.5-Decide](docs/gliner_decide.md) (fastino),
dan [Clef](docs/clef.md) (Cloudflare; model ini juga dapat chat). Ukuran dan
kecepatannya tersedia di
[tabel model keputusan](#which-model-for-my-machine).
**Beralih dari Jev.** Request dan reply menggunakan format API Jev dari TypeSafe,
sehingga client Jev dapat beralih ke colibri hanya dengan mengganti base URL,
tanpa perubahan lain:
`TYPESAFE_BASE_URL=http://127.0.0.1:8000` (key yang sudah dikirim client tetap
diterima oleh server yang dijalankan tanpa `COLI_API_KEY`). Kedua SDK resmi,
tanpa modifikasi, diuji terhadap `coli serve`.
Mode yang sama juga tersedia di terminal
(`/decide merge | request changes | close` dalam `coli chat`) dan pada halaman
System One di dashboard. Request dan reply lengkap, aturan scoring, serta kapan
mode ini tidak membantu dijelaskan di
[docs/systemone.md](docs/systemone.md).
## Dashboard
`coli web` membukanya, begitu juga proses penyiapan satu langkah: chat, halaman
System One, Brain, dan halaman Profiling, dalam tema terang atau gelap.
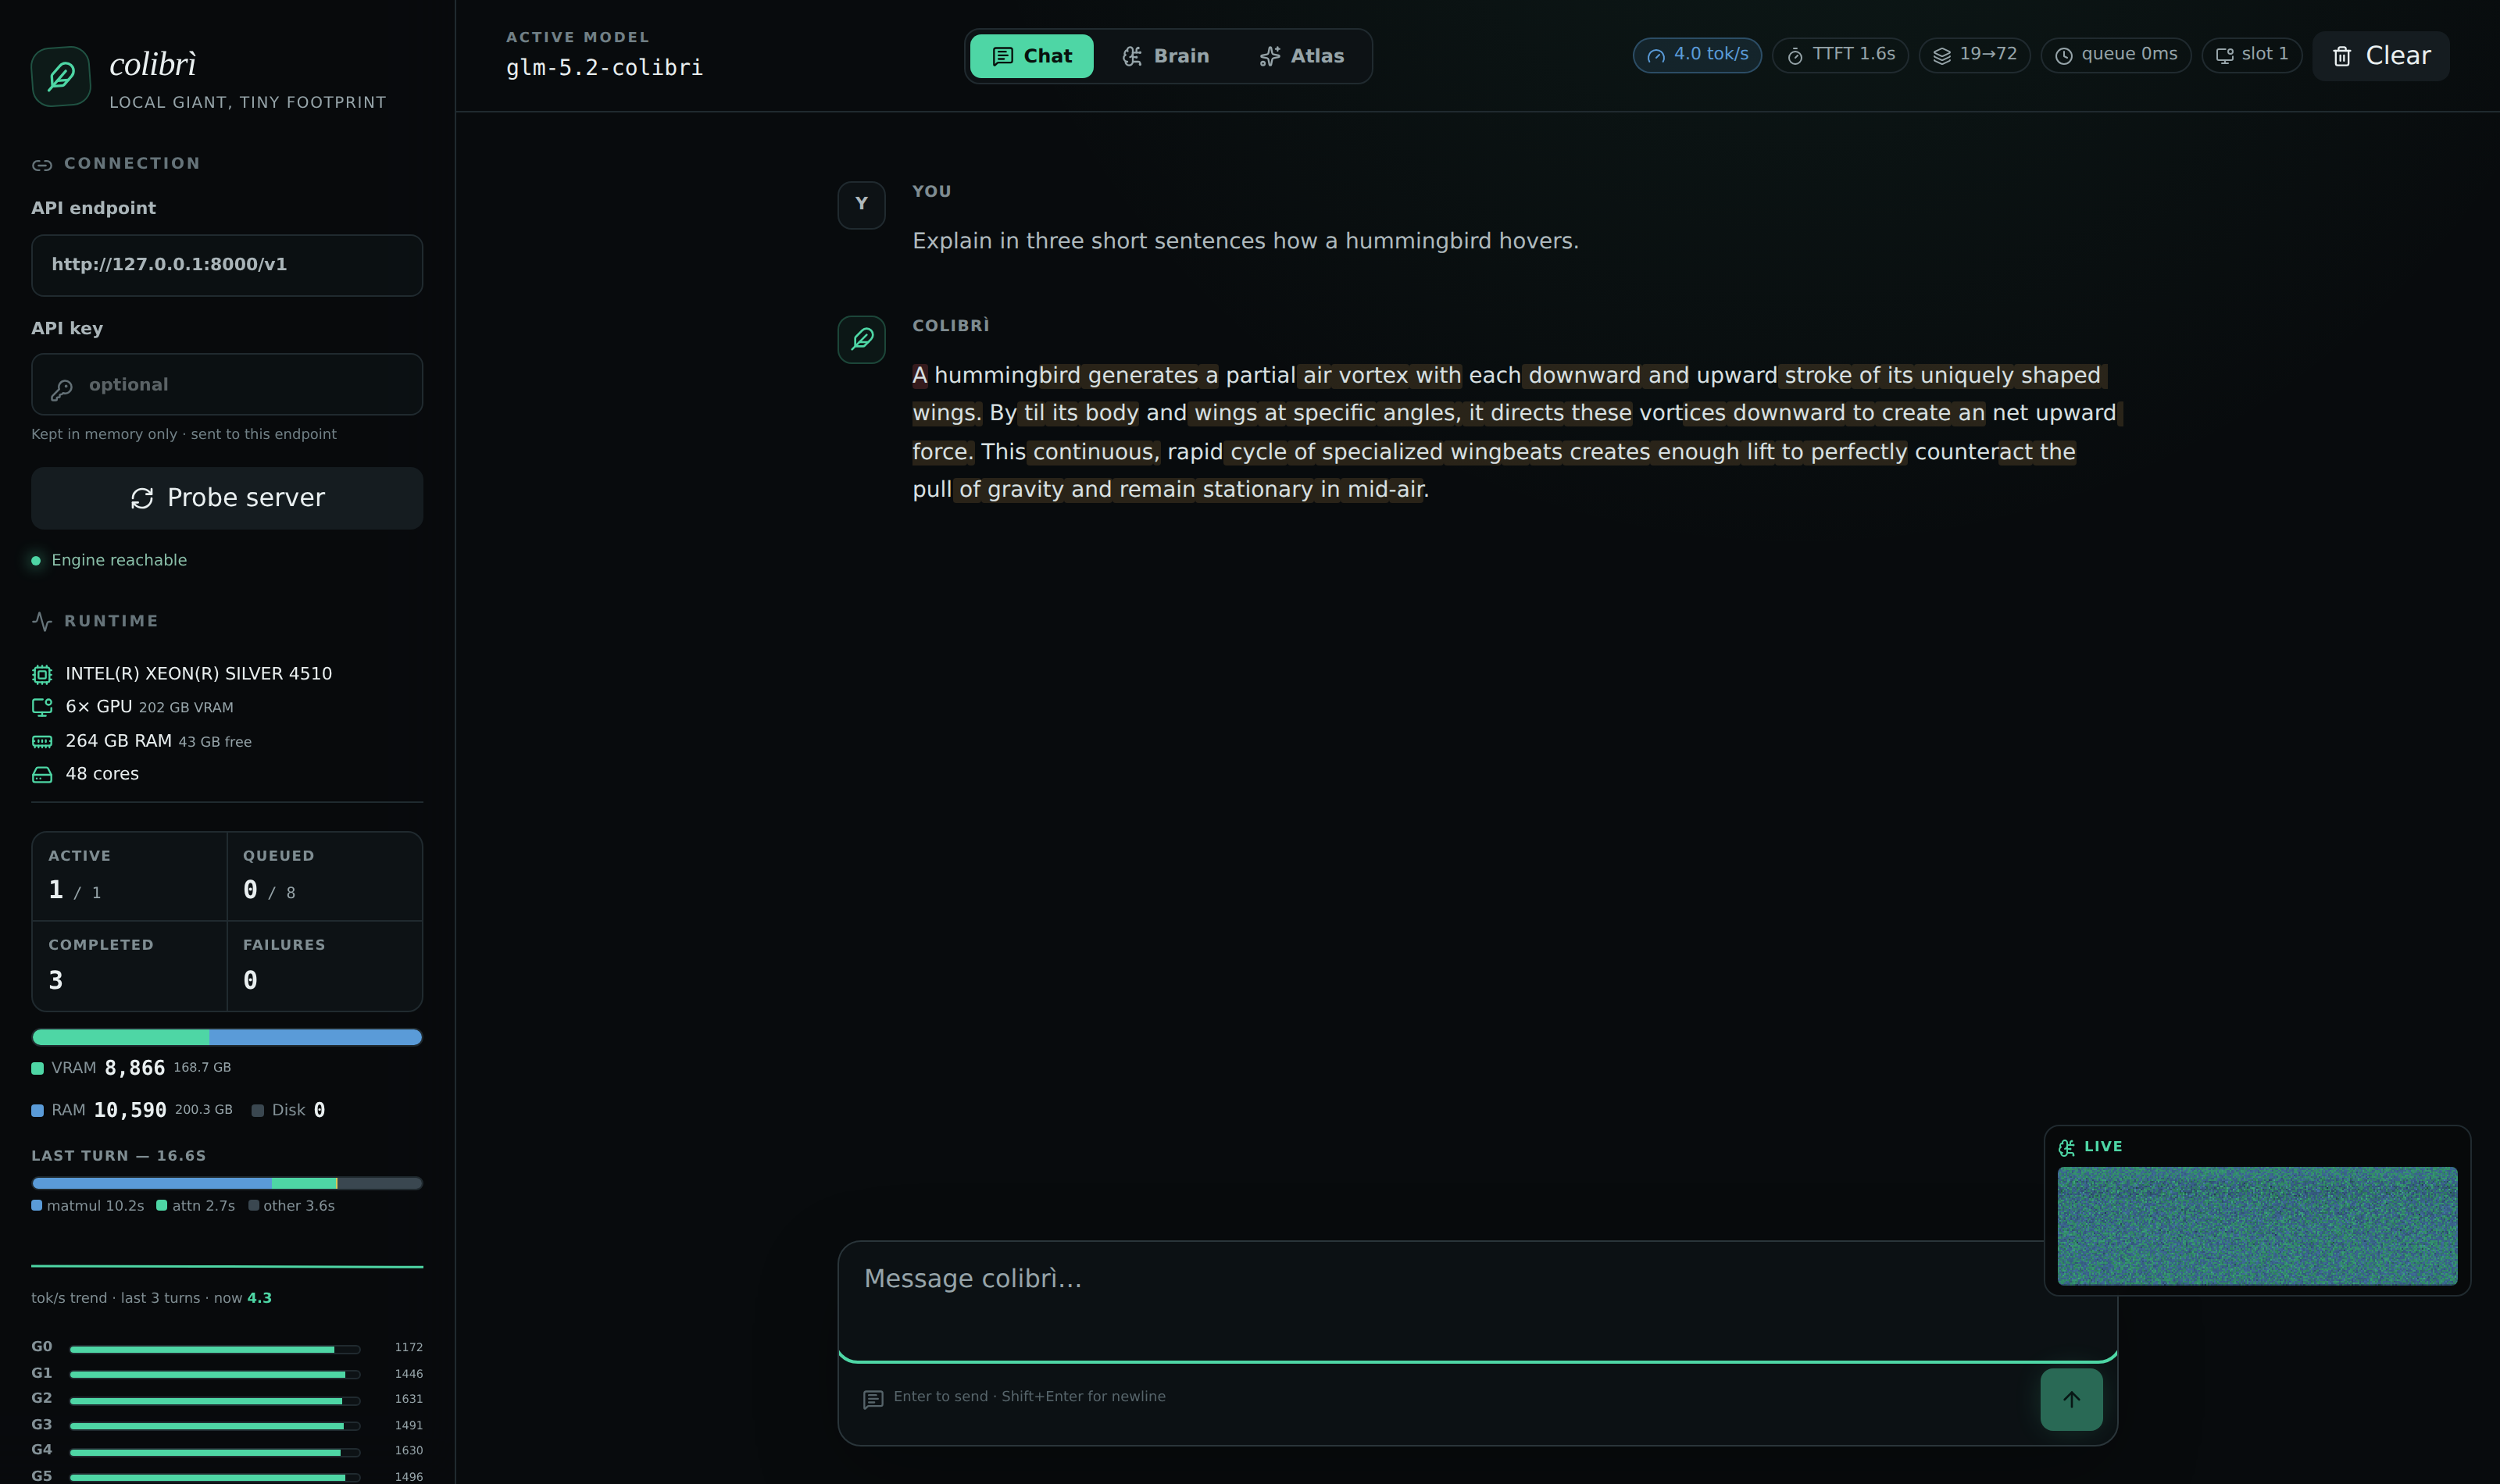
Qwen3.6 menjawab pada mesin CPU, dengan pakar yang di-streaming dari disk.
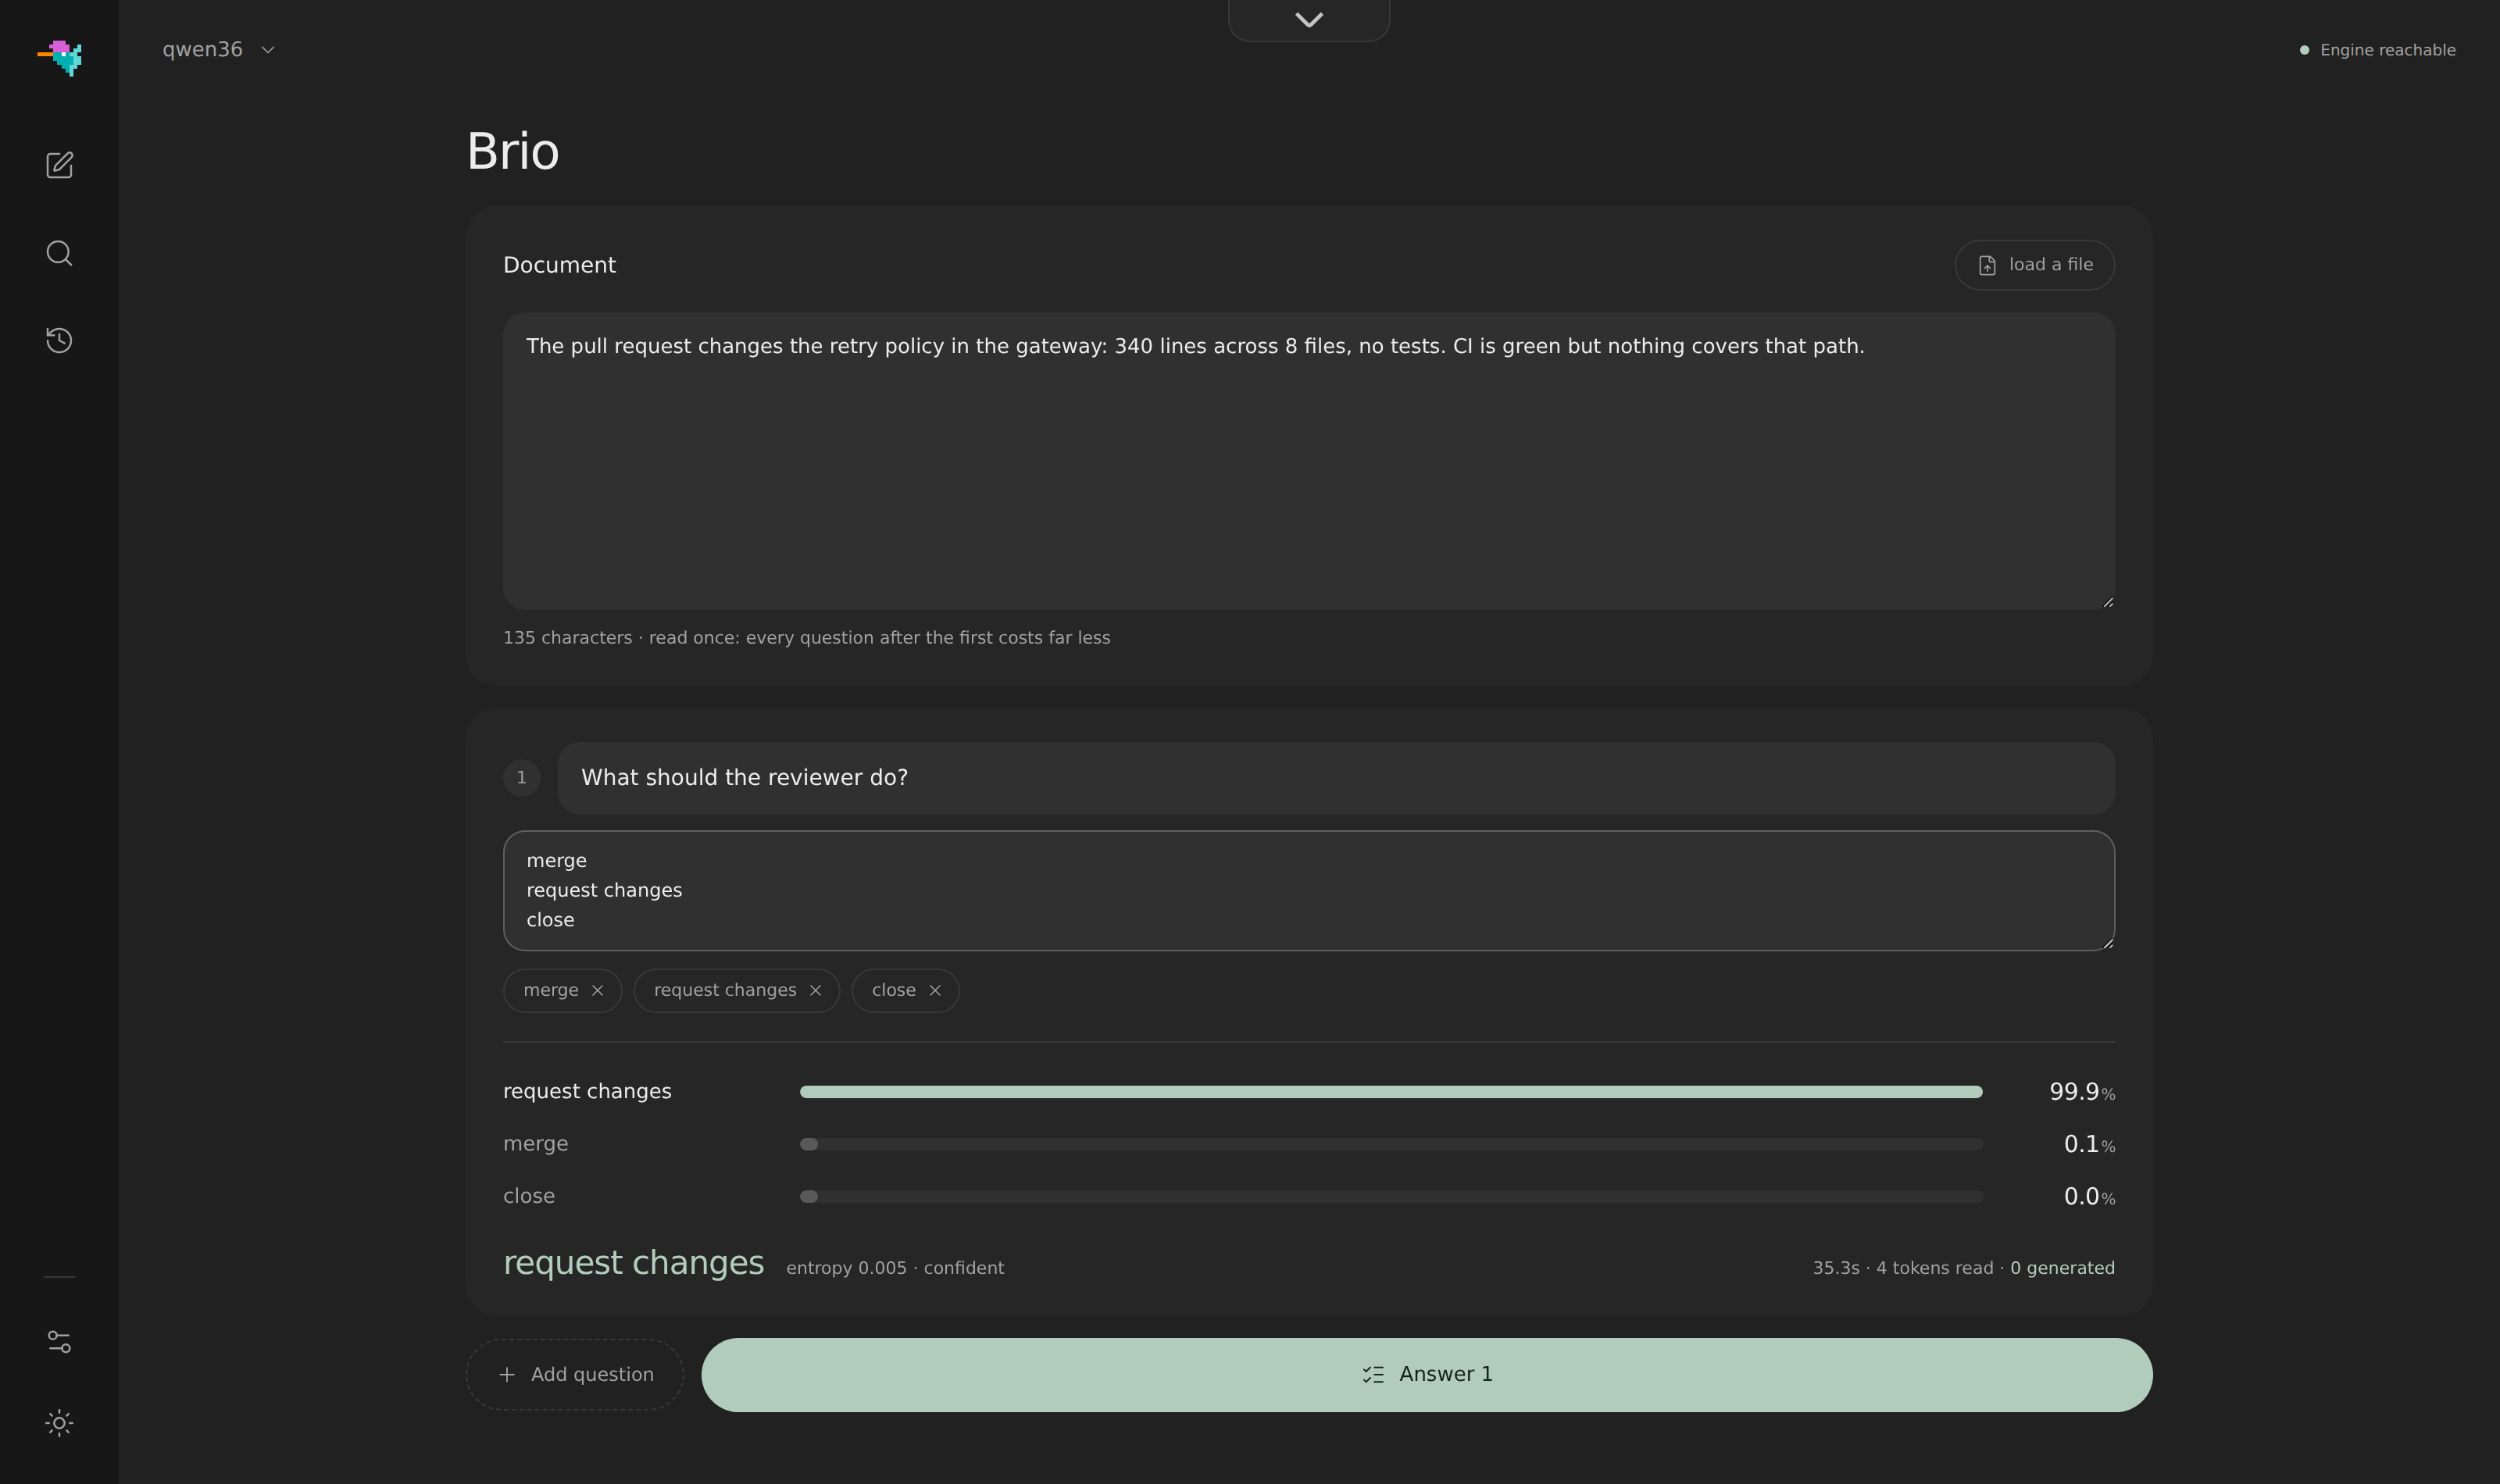
System One: berikan model sebuah dokumen dan hanya jawaban yang boleh dipilihnya. Di sini:
request changes pada 99.9%, entropy 0.005, 4 token dibaca, 0 dihasilkan.
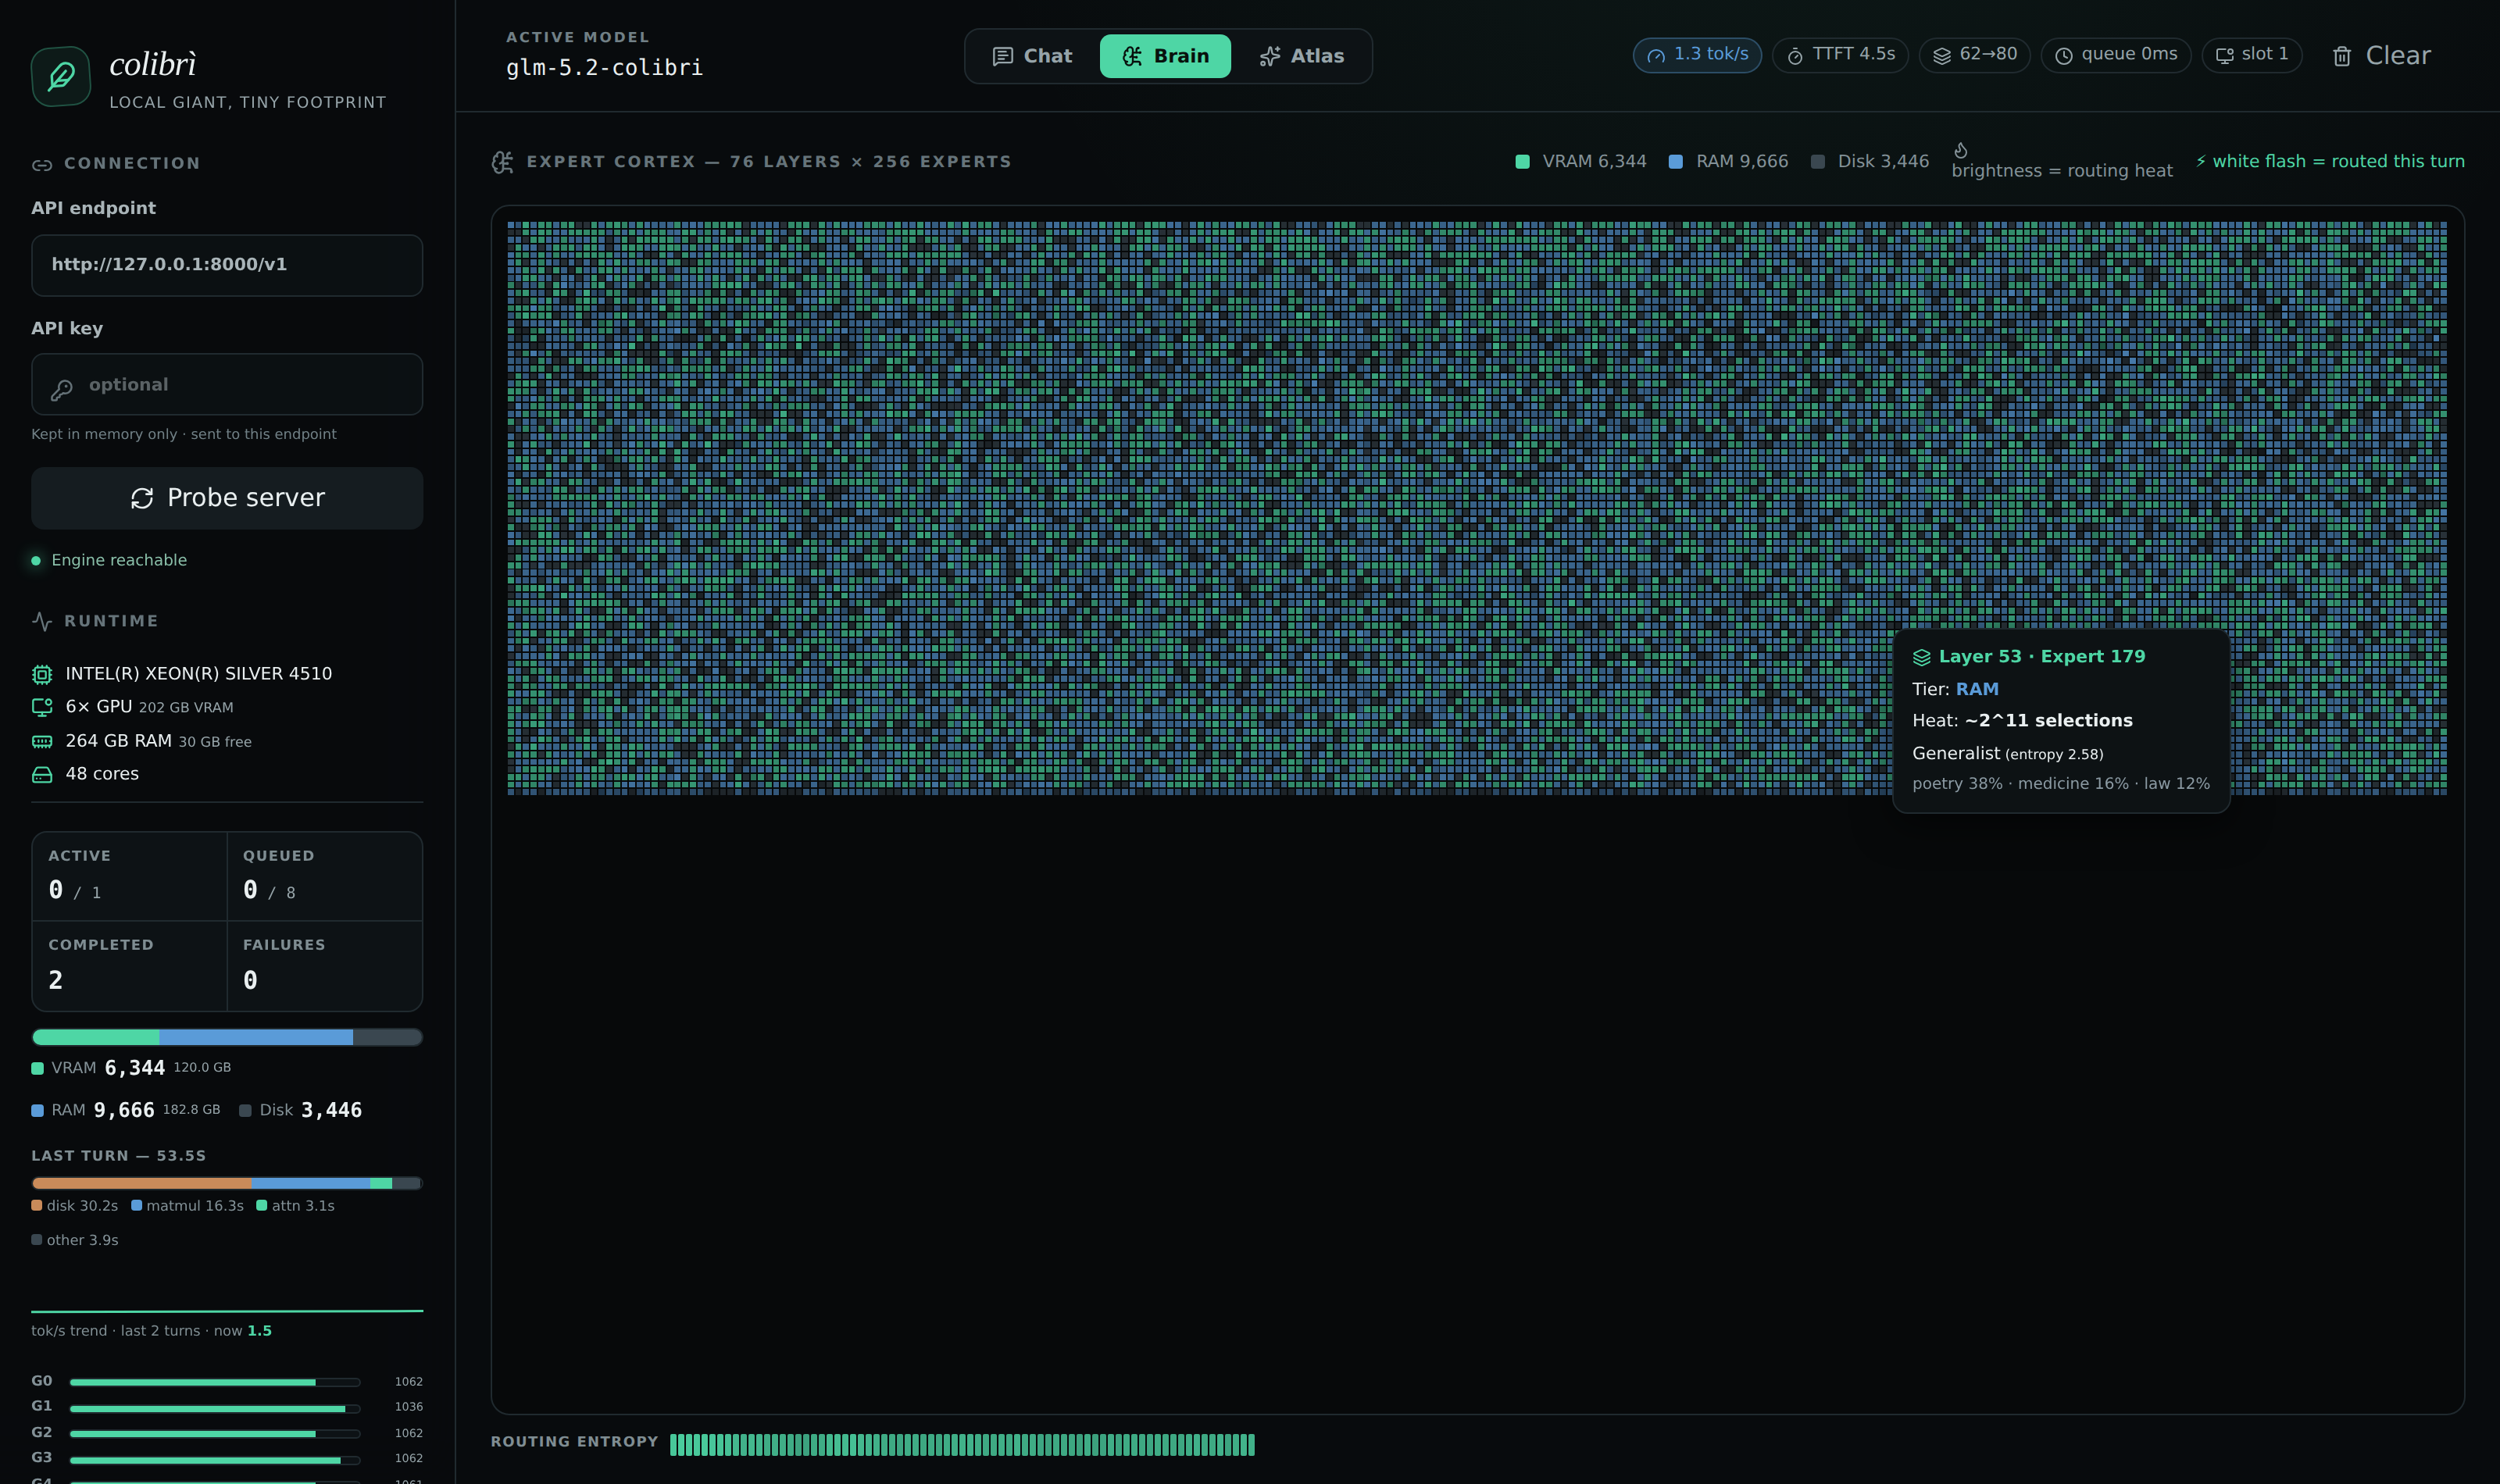
Brain: atlas pakar yang terukur dari GLM-5.2,
13,260 pakar yang telah dikarakterisasi dalam sepuluh wilayah (Python, SQL, matematika, puisi, hukum, bahasa Tionghoa...), ditempatkan berdasarkan
afinitas routing yang terukur. Live routing menampilkan model yang sedang berjalan: satu sel per pakar, diberi warna berdasarkan
storage tier, dan setiap pakar yang dirutekan dalam satu turn akan berkedip.
Halaman **Profiling** menunjukkan di mana waktu setiap turn digunakan, fase demi
fase, dengan 30 turn terakhir sebagai tren.
## Gunakan dari aplikasi lain
`coli serve` (yang dijalankan proses penyiapan untuk Anda) adalah satu server
dengan beberapa API:
- **kompatibel dengan OpenAI**: `/v1/chat/completions`, `/v1/completions`, dan
`/v1/models`, dengan streaming, reply JSON, stop sequences, dan logprobs;
- **kompatibel dengan Anthropic**: `/v1/messages`, sehingga Claude Code dan SDK
Anthropic dapat digunakan dengannya;
- **tool calling** pada setiap engine chat kecuali Inkling dan OLMoE, masing-masing
dalam format native modelnya
([tabel per-engine](docs/api.md#tool-calling-support));
- **input gambar** pada GLM-5.3-Flash, DeepSeek V4.1 Flash, MiMo-V2.6,
Qwen3.8-Flash-Next, dan Qwen3.8-27B: sebuah path dalam pesan `coli chat`,
attachment di `coli web`, atau bagian `image_url`;
- **output gambar** dengan Qwen-Image-2.1 pada `POST /v1/images/generations`,
dan digambar langsung di terminal oleh `coli chat`
([qwen-image.md](docs/qwen-image.md));
- **keputusan** pada `POST /v1/systemone`
([di atas](#system-one-a-decision-with-a-probability));
- **beberapa percakapan sekaligus** di setiap engine teks: `coli serve
--kv-slots N` menyimpan hingga 16, masing-masing dengan cache sendiri, dan
mendekode token berikutnya bersama-sama ([api.md](docs/api.md#isolated-kv-contexts)).
CLI coding dan editor terhubung seperti ke provider lain yang kompatibel dengan
OpenAI: base URL `http://127.0.0.1:8000/v1`, model id yang ditampilkan
`coli status`, dan key apa pun yang tidak kosong
([docs/api.md](docs/api.md#connect-a-coding-cli-or-editor)).
## Cara kerjanya
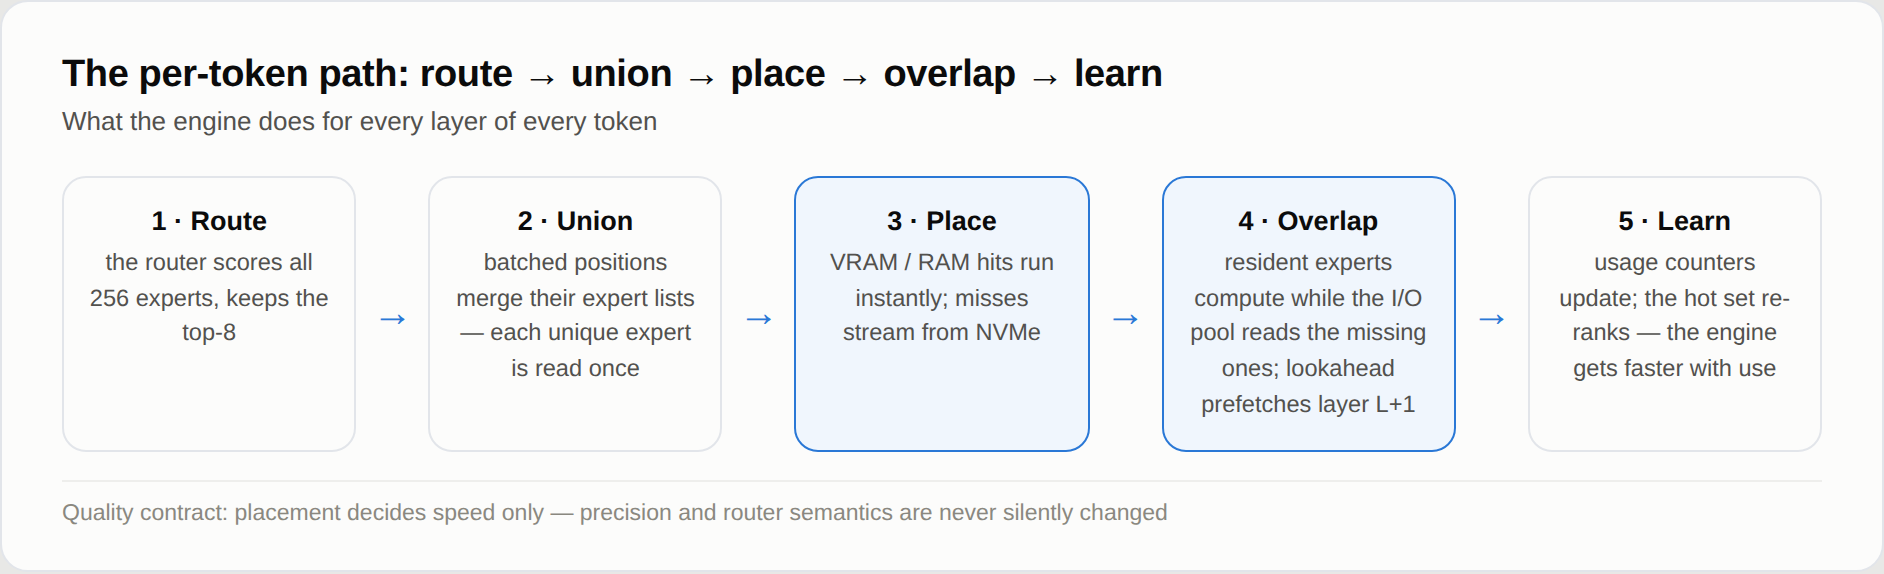
Setiap layer dari setiap token melewati lima langkah yang sama: route, union,
place, overlap, learn. Tujuan desainnya adalah agar **placement hanya menentukan
kecepatan**: keputusan router dan presisi bobot tetap sama, baik pakar menjawab
dari VRAM, RAM, maupun disk.
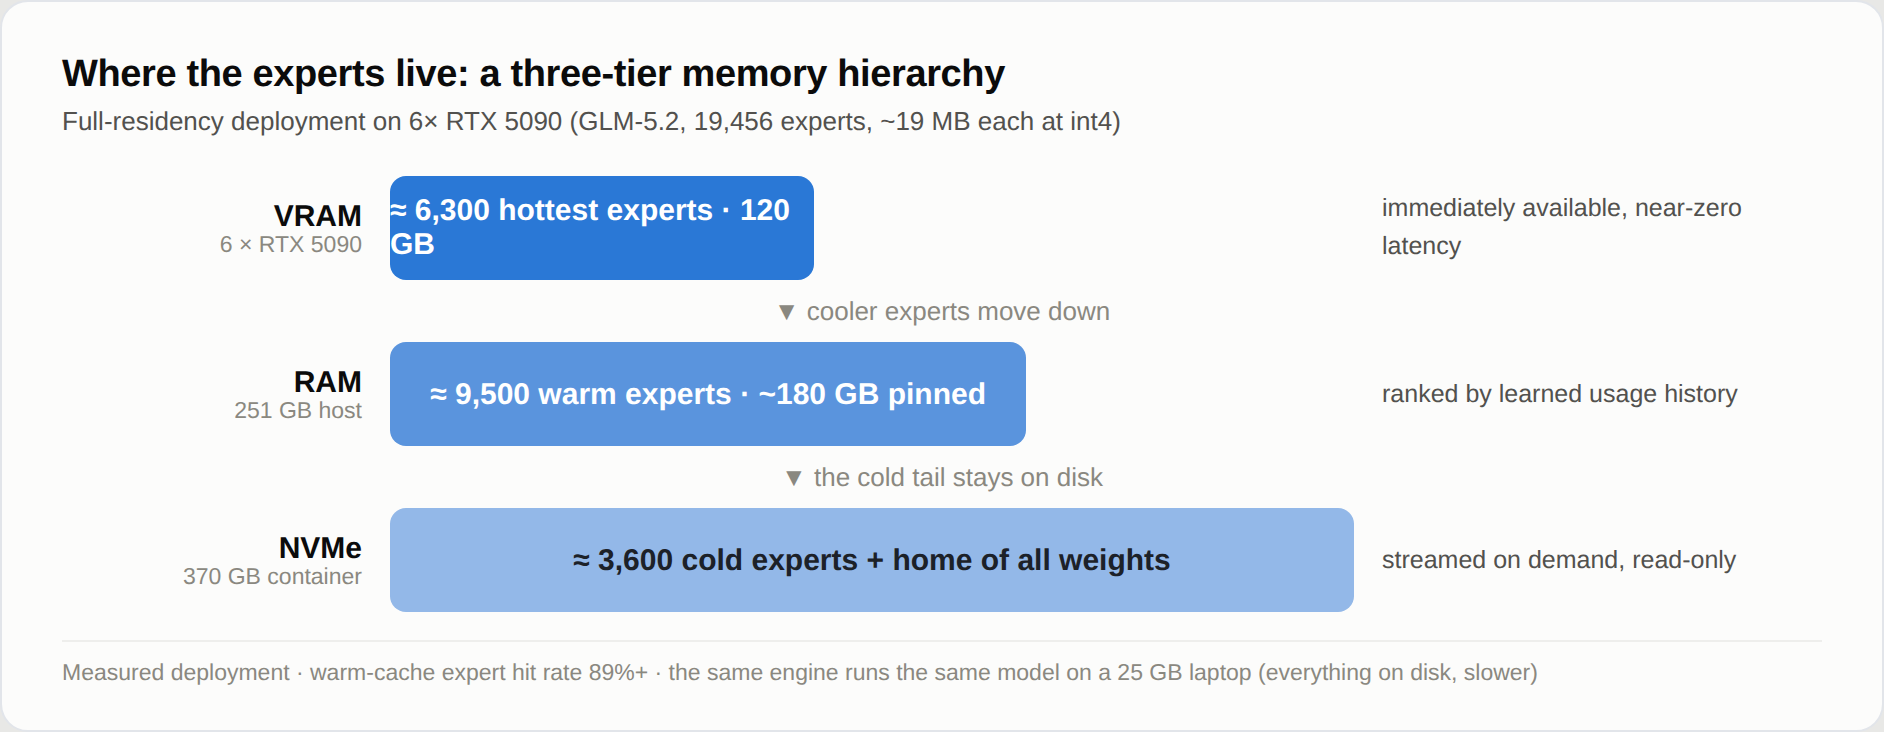
- **JIT untuk bobot.** Compiler JIT tidak pernah mengompilasi seluruh program:
ia mengamati bagian yang berjalan dan mengompilasi hot path. colibri membuat
taruhan yang sama pada bobot. Routing heat yang terukur menentukan pakar mana
yang layak berada di VRAM, RAM, atau disk: cache LRU per-layer, ditambah hot
set yang di-pin dan dipelajari dari percakapan Anda sendiri (`.coli_usage`,
diperbarui setiap turn). colibri menjadi lebih cepat semakin sering digunakan.
Hal ini bekerja karena routing memiliki struktur yang dapat diukur
([expert atlas](https://github.com/JustVugg/colibri/issues/175)).
- **Jangan menunggu disk dua kali.** Tiga matriks milik satu pakar dibaca dalam
satu `pread`; sekumpulan loader membaca pakar yang belum tersedia sementara
pakar resident melakukan komputasi; satu batch posisi membaca setiap pakar
sekali; thread router-lookahead dapat melakukan prefetch untuk layer berikutnya
(routing GLM-5.2 dapat diprediksi 71.6% satu layer ke depan). `DIRECT=1`
(O_DIRECT) sering memberikan peningkatan besar pada drive NVMe cepat dan netral
atau lebih buruk pada drive lain: ukur pada perangkat Anda
([tuning.md](docs/tuning.md)).
- **Lebih dari satu SSD.** `COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat --model /fast/glm52_i4`
membaca dari salinan pada drive kedua. Dua drive NVMe pada controller terpisah
menghasilkan peningkatan decode sebesar +37.5%; mirror parsial pada drive yang
lebih kecil juga dapat digunakan ([multidisk.md](docs/multidisk.md)).
- **Dari laptop hingga rack.** Pada laptop 25 GB, setiap pakar di-streaming dari
disk, lambat tetapi tetap benar; pada host besar, setiap pakar resident
(`CUDA_EXPERT_GB=auto PIN_GB=all`) dan disk tidak lagi terlibat dalam decoding.
`COLI_NUMA=1` menyebarkan bobot resident ke memory controller pada host
multi-socket, dan mode cluster lokal menjalankan pakar yang dirutekan pada
mesin lain ([cluster.md](docs/cluster.md)).
- **Model yang setia pada referensi.** Setiap engine diperiksa di CI terhadap
implementasi referensi modelnya menggunakan fixture kecil. MLA attention
GLM-5.2 menyimpan compressed KV state (576 float per token, bukan 32,768,
57x lebih kecil) yang bertahan setelah restart, sehingga percakapan dapat
dibuka kembali tanpa membaca ulang prompt.
- **Spekulasi yang sepadan dengan biayanya.** Int8 MTP head GLM-5.2 membuat draft
2.2-2.8 token per forward ketika menguntungkan; MTP head Qwen3.8-Flash-Next,
opt-in, menambah 12-14% dengan output yang sama. Jika drafting membutuhkan
biaya lebih besar daripada penghematannya (DeepSeek V4), fitur tersebut tetap
dimatikan ([tuning.md](docs/tuning.md#speculation-and-reproducibility)).
Engine menggunakan satu file C per keluarga model (`c/colibri.c` untuk GLM-5.2)
di atas header bersama, tanpa BLAS dan tanpa Python saat runtime: Python hanya
menjalankan proses penyiapan, launcher, converter, dan API gateway.
## Benchmark
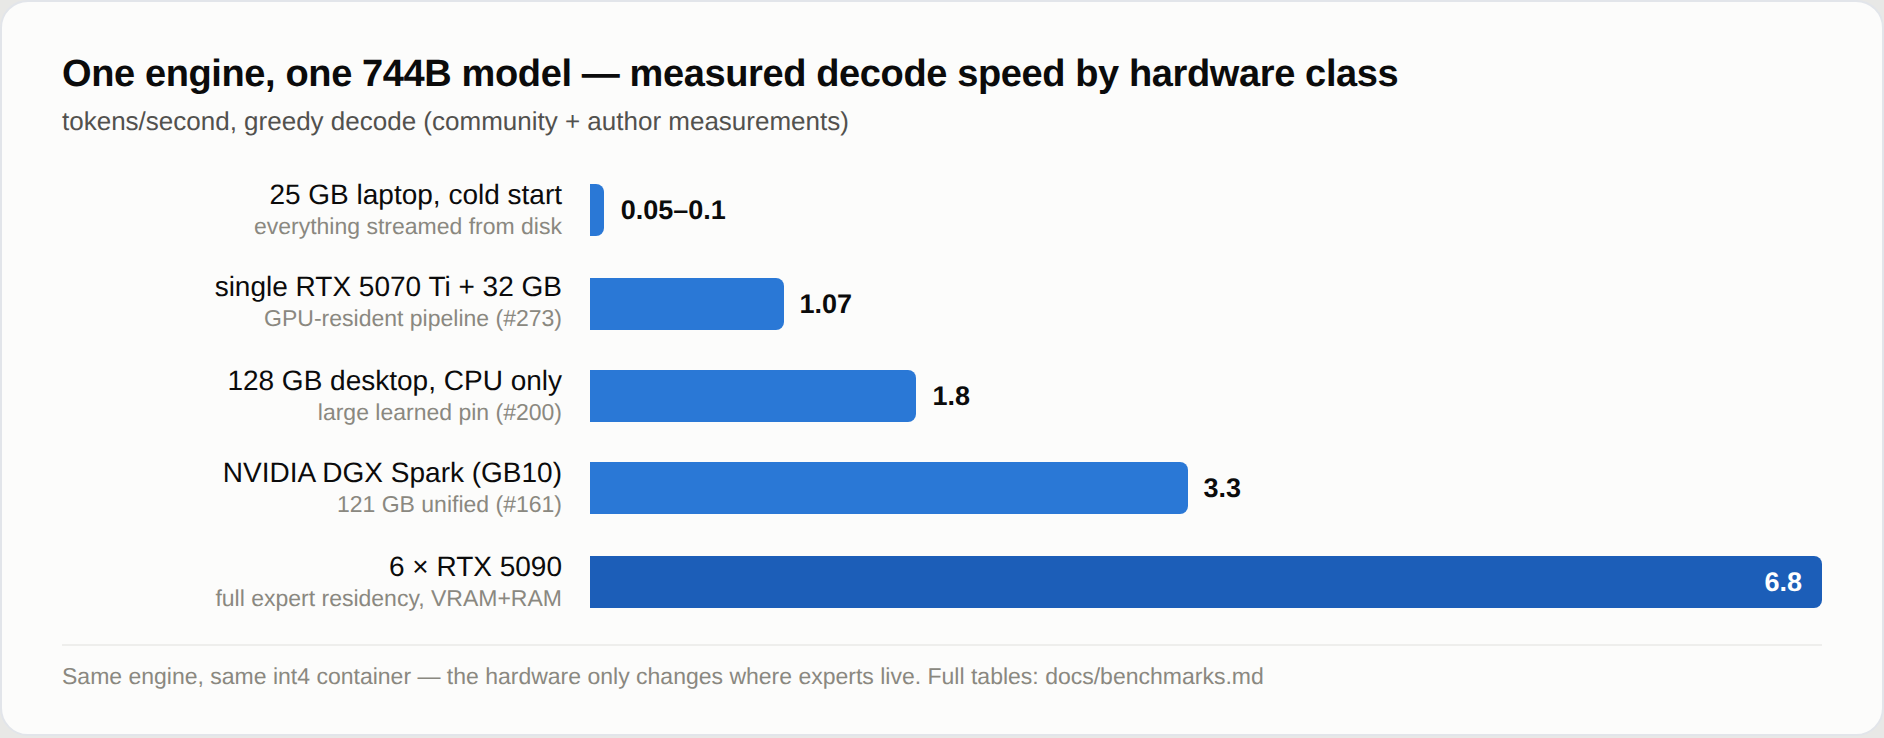
Engine yang sama dan container int4 yang sama: hardware hanya mengubah tempat
pakar berada. Decode GLM-5.2, dari [tabel lengkap](docs/benchmarks.md):
- **6x RTX 5090, semua pakar resident:** 5.8-6.8 tok/s, 9.0-9.2 dengan selective
NUMA interleave
([log eksperimen](docs/experiments/glm52-6x5090-2026-07-12.md));
- **128 GB, hanya CPU** (Ryzen AI Max+ 395): 1.83 tok/s warm
([#200](https://github.com/JustVugg/colibri/issues/200));
- **satu mesin kelas laptop RTX 5070 Ti:** 1.07 tok/s
([#273](https://github.com/JustVugg/colibri/issues/273));
- **laptop 25 GB tempat proyek ini bermula:** 0.05-0.1 tok/s cold, batas bawah
yang realistis.
Kualitas diukur, bukan diasumsikan: biaya container int4 dan ablation
quantization tersedia di
[benchmarks.md](docs/benchmarks.md#quality-benchmark). Untuk menambahkan mesin
Anda, ikuti [protokol benchmark](docs/benchmarking.md) dan buka issue dengan
hasil pengukurannya.
## Instal secara manual
**1. Programnya.** Ambil archive untuk platform Anda dari
[Releases](https://github.com/JustVugg/colibri/releases) (Linux x86_64, macOS,
Windows; tidak memerlukan compiler, hanya [Python 3](https://www.python.org/downloads/)
untuk launcher dan API), ekstrak, lalu jalankan `python3 coli info`. Engine
Linux dan Windows sudah berisi Vulkan, dengan `shaders/` di sampingnya, dan engine
macOS berisi Metal; untuk kartu NVIDIA di Windows tambahkan archive CUDA. Atau build
dari source menggunakan `gcc` (atau clang) dan OpenMP:
```bash
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh # checks gcc/OpenMP, builds, self-tests
make qwen36 VK=1 # one engine, here with Vulkan (CUDA=1 for CUDA)
```
**2. Model.** Gunakan unduhan apa pun dari
[tabel di atas](#which-model-for-my-machine): id milik proses penyiapan dipetakan
ke repository Hugging Face, dan halaman setiap model memiliki perintah unduhan
dan konversinya. Untuk GLM-5.2 gunakan container group-scaled (gs64) dengan int8
MTP head,
[`mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp`](https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp)
(429 GB), atau [`Justvugg/GLM-5.3-colibri-int4-g64`](https://huggingface.co/Justvugg/GLM-5.3-colibri-int4-g64)
untuk GLM-5.3 (419 GB, tanpa MTP head). Jangan gunakan mirror int4 per-row yang
lebih lama: hasil pengukurannya sekitar 9 poin lebih buruk dalam kualitas dan
menyebabkan jawaban berulang pada
[#455](https://github.com/JustVugg/colibri/issues/455). `./coli convert --model
/nvme/glm52_i4` membuat container yang sama dari rilis FP8, shard demi shard,
tanpa pernah memerlukan seluruh 756 GB berada di disk sekaligus. Cara memeriksa
MTP head dan bagian lainnya:
[quickstart.md](docs/quickstart.md#3-get-the-model).
**3. Jalankan.** Dari `c/` pada source checkout, atau dari rilis yang telah
diekstrak. Launcher membaca `config.json` milik model dan memilih engine serta
chat template-nya, sehingga perintahnya sama untuk setiap model:
```bash
./coli chat --model /nvme/qwen36 # chat in the terminal
./coli web --model /nvme/qwen36 # API + dashboard, opens a browser
./coli serve --model /nvme/qwen36 # API + dashboard, no browser
./coli plan --model /nvme/qwen36 # where the model will live: VRAM, RAM, disk
./coli doctor --model /nvme/qwen36 # read-only check: is everything ready?
./coli tune --model /nvme/qwen36 # measure and save this machine's fastest safe settings
```
Di Windows, archive rilis menyertakan `coli.cmd` (`coli.cmd chat --model
D:\qwen36`); dari source checkout gunakan `py -3 c\coli`. File `.exe` adalah
engine, bukan launcher. Semua opsi dan variabel:
[SETTINGS.md](docs/SETTINGS.md), [ENVIRONMENT.md](docs/ENVIRONMENT.md).
## Riset dan cara membantu
colibri ingin agar model frontier tidak terlalu bergantung pada hardware yang
langka dan lebih murah untuk dijalankan. Itu berarti mengubah cara bobot
disimpan dan dipindahkan, menentukan apa yang berada di VRAM, RAM, atau storage,
menumpangtindihkan pekerjaan CPU dan GPU, serta menguji cara baru untuk decode.
Tidak ada sesuatu yang dipertahankan hanya karena sudah menjadi kebiasaan, dan
tidak ada sesuatu yang diadopsi hanya karena microbenchmark terlihat cepat:
hasil yang menentukan adalah inference end-to-end pada mesin nyata, dengan
kualitas diukur bersama kecepatan. Pertanyaan terbukanya:
| hipotesis | bukti sejauh ini | eksperimen yang masih diperlukan |
|---|---|---|
| Riwayat routing dapat menempatkan pakar lebih baik daripada LRU biasa | learned pins meningkatkan workload berulang, tetapi dapat overfit pada sebuah prompt | A/B held-out lintas sesi pada workload coding, chat, multilingual, dan long-context |
| Beberapa SSD dapat mengubah bandwidth independen menjadi kecepatan decode | dua drive NVMe independen menghasilkan peningkatan decode +37.5%; drive ketiga yang lebih lambat netral setelah weighted striping ([pengukuran](docs/multidisk.md#what-has-been-measured)) | reproduksi pada berbagai kecepatan drive, layout controller, dan state cache |
| Planner yang memahami hardware dapat mendekati konfigurasi terbaik setiap mesin secara otomatis | budget RAM/VRAM dan beberapa backend sudah terdeteksi saat ini, dan proses penyiapan memilih build | bandingkan plan yang dihasilkan dengan controlled parameter sweep pada laptop, workstation, host NUMA, dan sistem multi-GPU |
| Representasi lossless atau dengan batas kualitas dapat mengurangi perpindahan bobot sampai cukup berarti | ablation format dan quantization sudah tersedia, dengan gate correctness/kualitas | reproduksi kualitas, byte yang dipindahkan, latency, dan biaya per token berguna secara bersamaan, bukan hanya compression ratio |
| Spekulasi yang mempertimbangkan routing dapat menguntungkan sebelum residensi hampir penuh | MTP dan grammar drafts bekerja, tetapi MTP juga pernah terukur mengalami penurunan 32% di sekitar expert hit 85% | petakan permukaan break-even terhadap acceptance, expert hit rate, batch union, dan draft depth |
| Overlap CPU/GPU dapat menyembunyikan transfer dan sinkronisasi alih-alih sekadar memindahkan bottleneck | peningkatan dari CUDA, Metal, dan Vulkan sudah ada, tetapi CPU cepat, GPU terintegrasi, dan residensi rendah dapat menghapusnya | profil per-stage dan A/B satu variabel pada PCIe, unified-memory, dan mesin full-resident, serta angka discrete-GPU pertama untuk Vulkan tier dan chain |
Ingin membantu? Pilih satu baris dan publikasikan juga hasil negatif. Catat
hardware, commit, model, perintah persis, prompt, state cache, throughput, time
to first token, expert hit rate, byte yang dibaca, dan pemeriksaan kualitas;
ubah satu variabel, ulangi, lalu lampirkan raw log. Mulailah dengan
[CONTRIBUTING.md](CONTRIBUTING.md) dan
[protokol benchmark](docs/benchmarking.md), lalu
[buka issue](https://github.com/JustVugg/colibri/issues/new). Kegagalan yang
dikontrol dengan baik lebih bernilai di sini daripada angka cepat tanpa
penjelasan.
## Dokumentasi
| topik | dokumen |
|---|---|
| Penyiapan satu langkah dan instalasi manual, untuk setiap platform | [quickstart.md](docs/quickstart.md) |
| Penyiapan melalui asisten AI, dan server MCP | [AI_SETUP.md](docs/AI_SETUP.md), [MCP_SERVER.md](docs/MCP_SERVER.md) |
| API: OpenAI, Anthropic, tools, KV slots, dashboard | [api.md](docs/api.md) |
| System One dan model keputusan | [systemone.md](docs/systemone.md), [laya.md](docs/laya.md), [gliner_decide.md](docs/gliner_decide.md), [clef.md](docs/clef.md) |
| Vulkan: expert tier, dense chain, kartu tanpa Resizable BAR | [vulkan.md](docs/vulkan.md) |
| CUDA, dan CUDA tier Qwen3.6 | [cuda.md](docs/cuda.md), [qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md) |
| Apple Silicon, Windows | [metal.md](docs/metal.md), [windows.md](docs/windows.md) |
| Tuning, learning cache, prefetch, speculation | [tuning.md](docs/tuning.md) |
| Beberapa SSD, beberapa mesin | [multidisk.md](docs/multidisk.md), [cluster.md](docs/cluster.md) |
| Benchmark dan cara melakukan pengukuran | [benchmarks.md](docs/benchmarks.md), [benchmarking.md](docs/benchmarking.md) |
| Setiap opsi dan environment variable | [SETTINGS.md](docs/SETTINGS.md), [ENVIRONMENT.md](docs/ENVIRONMENT.md) |
| Draft yang dipaksa grammar, dan ABI embedding eksperimental | [grammar-draft.md](docs/grammar-draft.md), [segment-runtime.md](docs/segment-runtime.md), [edge-runtime.md](docs/edge-runtime.md) |
## Struktur repository
```
start-here.sh, START-HERE.bat the one-step setup (Linux and macOS, Windows)
Makefile root build/check entry point
c/
├── colibri.c GLM-5.2/5.3 engine (make glm)
├── glm53.c GLM-5.3-Flash (make glm53)
├── inkling.c Inkling (make inkling)
├── kimi_k3.c Kimi K3 (make kimi_k3)
├── deepseek_v4.c DeepSeek V4 Flash (make deepseek-v4)
├── deepseek_v41.c DeepSeek V4.1 Flash (make deepseek_v41)
├── mimo.c MiMo-V2.6 Flash and Pro (make mimo)
├── qwen38.c Qwen3.8-Flash-Next (make qwen38)
├── qwen36.c Qwen3.6, Qwen3-Coder, Qwen3.8-27B, Clef (make qwen36)
├── olmoe.c OLMoE (make olmoe)
├── qwenimage.c Qwen-Image-2.1 (make qwenimage)
├── laya.c Laya (make laya)
├── gliner_decide.c GLiNER2.5-Decide (make gliner_decide)
│
├── st.h, quant.h, idot.h safetensors reads, container decoders, integer kernels
├── expert_ffn.h, expert_store.h routed-expert kernel and streaming expert cache
├── tok.h, json.h, compat.h tokenizer, JSON, Windows/macOS shims
├── route_trace.h, kv_prefix.h routing telemetry (.coli_usage), KV prefix reuse
├── decide_serve.h the decision engines' side of System One
│
├── backend_cuda.* optional CUDA tier (CUDA=1)
├── backend_metal.* optional Metal tier (METAL=1)
├── backend_vulkan.*, vk_tier.c, vk_chain.c optional Vulkan tier and dense chain (VK=1)
│
├── coli user-facing CLI
├── setup_*.py the one-step setup: hardware, catalog, downloads, flow
├── mcp_server.py the MCP server (coli mcp)
├── openai_server.py OpenAI- and Anthropic-compatible HTTP gateway
├── resource_plan.py RAM/VRAM planner behind coli plan and coli doctor
├── tools/ conversion, fixtures and benchmarks
└── tests/ dependency-free C and Python tests
web/ the dashboard (a pure API client)
desktop/ Tauri desktop shell around the dashboard
docker/ container images
docs/ reference docs, experiments, media
site/ the website
```
**Satu `.c` per keluarga model, menggunakan header tunggal bersama.** Sebuah
engine hanya memiliki arsitekturnya sendiri; apa pun yang dibutuhkan oleh dua
engine ditempatkan dalam header yang sama-sama mereka include, sehingga satu
perbaikan langsung menjangkau semuanya. Dari root repository, `make`,
`make check`, dan `make clean` meneruskan pekerjaan ke Makefile engine.
## Mendukung proyek
colibri bermula sebagai proyek satu orang pada laptop 12-core dengan RAM 25 GB;
sekarang angka-angkanya berasal dari komunitas dengan mesin nyata. Jika proyek
ini berguna bagi Anda:
- beri star pada repository dan bagikan;
- buka issue dengan angka benchmark dari hardware Anda: datapoint lebih
mendorong proyek ini daripada hal lainnya;
- bergabunglah dengan [komunitas Discord](https://discord.gg/RXV83nSZdk) untuk
membahas eksperimen, hasil hardware, dan arah riset;
- hubungi melalui GitHub issues untuk mensponsori pengembangan atau
menyumbangkan hardware.
## Mengapa "colibrì"
Burung kolibri hanya berbobot beberapa gram, dapat melayang di tempat, dan
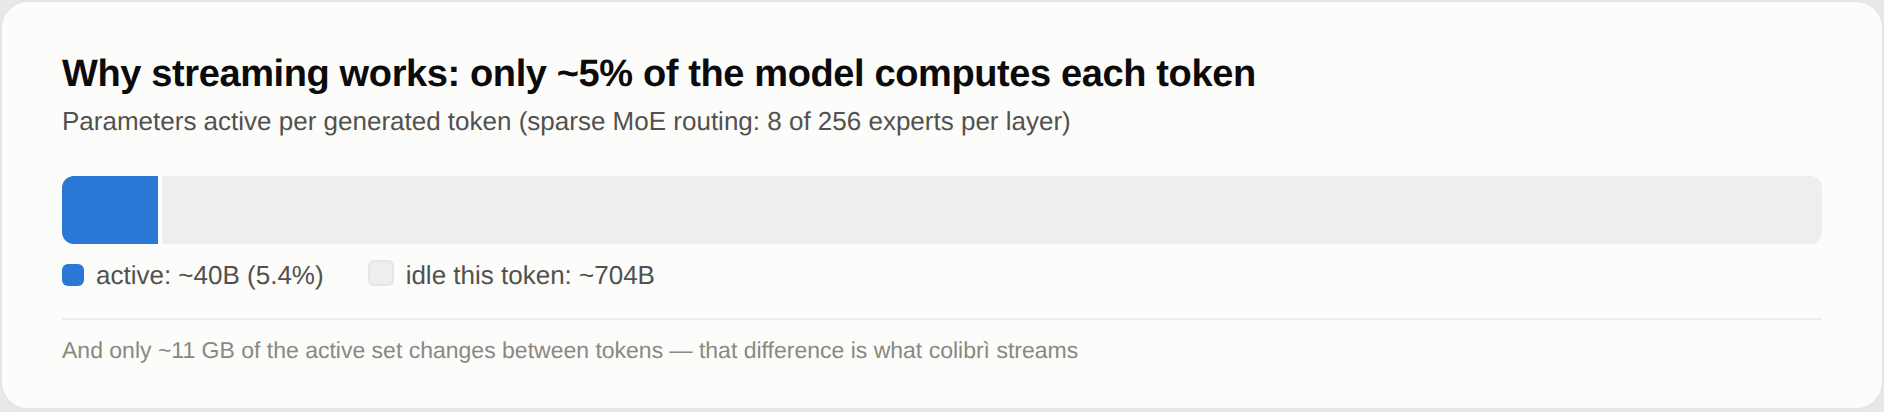
mengunjungi seribu bunga dalam sehari. Engine ini menjaga raksasa dengan 744
miliar parameter tetap hidup dengan jatah seekor kolibri: RAM 25 GB, dua belas
core CPU, dan banyak kesabaran menghadapi disk.
## Ucapan terima kasih
colibri adalah sebuah engine; kecerdasan yang dijalankannya merupakan hasil
karya banyak pihak. Terima kasih kepada tim yang merilis bobot model mereka
secara terbuka: **Z.ai** (GLM), **Moonshot AI** (Kimi), **Alibaba Qwen**,
**DeepSeek**, **Xiaomi** (MiMo), **Thinking Machines** (Inkling),
**Allen AI** (OLMoE), **Convai Innovations** (Laya), **fastino**
(GLiNER2.5-Decide), dan **Cloudflare** (Clef); kepada mereka yang menerbitkan
container hasil konversi; serta kepada setiap kontributor yang melakukan
benchmark, bisect, mereplikasi proses atlas, atau mengirim patch. Kode pihak
ketiga dalam repository ini beserta lisensinya:
[THIRD_PARTY_NOTICES.md](THIRD_PARTY_NOTICES.md).
Eksperimen penempatan pakar, kompresi, dan routing dalam proyek ini juga
dibangun di atas gagasan dan bukti dari riset terbuka serta karya sistem berikut:
- [REAP](https://github.com/CerebrasResearch/reap) dan
[EASY-EP](https://github.com/RUCAIBox/EASYEP) untuk tingkat kepentingan pakar
yang mempertimbangkan output dan domain.
- [SERE](https://github.com/JL-Cheng/SERE) untuk rerouting pakar berbasis
kemiripan, dan [ReMoE](https://github.com/BUAA-OSCAR/ReMoE) untuk fine-tuning
router yang mempertimbangkan cache locality.
- [MC-SMoE](https://github.com/UNITES-Lab/MC-SMoE) untuk penggabungan dan
kompresi pakar yang dipandu routing.
- [MoBE](https://github.com/inclusionAI/MoBE) dan
[D²-MoE](https://github.com/lliai/D2MoE) untuk basis pakar bersama dan delta
pakar low-rank.
- [HybriMoE](https://github.com/PKU-SEC-Lab/HybriMoE) untuk penjadwalan pakar
hybrid CPU/GPU, [ScMoE](https://arxiv.org/abs/2404.05019) untuk
menumpangtindihkan komunikasi pakar dengan komputasi, dan
[OD-MoE](https://arxiv.org/abs/2512.03927) untuk pemuatan pakar on-demand
terdistribusi.
- [vLLM](https://github.com/vllm-project/vllm),
[llama.cpp](https://github.com/ggml-org/llama.cpp), dan
[kTransformers](https://github.com/kvcache-ai/ktransformers) untuk sistem
inference terbuka dan karya expert-offload yang membuat perbandingan dapat
direproduksi.
Engine ini juga berdiri di atas karya engineering konkret, bukan hanya gagasan.
Setiap hal berikut digunakan atau diimplementasikan ulang dalam tree saat ini:
- [safetensors](https://github.com/huggingface/safetensors): container yang
dibaca setiap engine (`c/st.h`), termasuk dtype fp8 dan I64.
- [tiktoken](https://github.com/openai/tiktoken): `c/tok.h` mengimplementasikan
ulang `byte_pair_encode` secara persis, dengan menggabungkan pasangan
bersebelahan yang hasil konkatenasinya memiliki vocab id terendah, sehingga
vocabulary turunan tiktoken tidak memerlukan daftar merges.
- [llama.cpp](https://github.com/ggml-org/llama.cpp): subset grammar GBNF dalam
`c/grammar.h` mengikuti sintaks dan set-of-stacks PDA miliknya, dan jalur
Metal meminjam teknik residensi `newBufferWithBytesNoCopy`.
- [vLLM](https://github.com/vllm-project/vllm): referensi untuk semantik output
yang dicocokkan engine posisi demi posisi (misalnya posisi final norm relatif
terhadap LM head).
- [transformers](https://github.com/huggingface/transformers): oracle:
CI mereproduksi model random-init token demi token terhadapnya.
- [DietGPU](https://github.com/facebookresearch/dietgpu): codec ANS GPU di balik
experimental compressed expert tier (`COLI_ANS`).
- [rocWMMA](https://github.com/ROCm/rocWMMA): backend HIP memetakan API fragment/
mma_sync `nvcuda::wmma` milik CUDA ke dalamnya
(`c/backend_gpu_compat.h`), yang memungkinkan satu source .cu dikompilasi
untuk kedua vendor.
## Lisensi
Apache 2.0, Copyright 2026 Vincenzo Fornaro. Lihat [LICENSE](LICENSE) dan
[NOTICE](NOTICE). Setiap model tetap menggunakan lisensi yang diberikan oleh
pembuatnya (bobot GLM-5.2 dirilis oleh Z.ai di bawah MIT; Qwen-Image-2.1 hanya
untuk penggunaan nonkomersial).