💻 GitHub | 🤗 Hugging Face | 🤖 ModelScope | 📑 Blog | 📚 Paper
🚀 HF Space | 💬 Feishu (飞书) | 🫨 Discord | 📜 License
English | 中文


**从这里开始:** [在线体验](https://OpenMOSS.github.io/MOSS-VL-Demo/#/) · [快速上手](#-快速上手) · [实时推理](#实时推理) · [离线推理](#离线推理) · [模型下载](https://huggingface.co/collections/OpenMOSS-Team/moss-vl)
https://github.com/user-attachments/assets/678ec713-0e01-4792-a5b3-c72e483c4d5f
# MOSS-VL
**MOSS-VL** 是一个基于统一**交叉注意力**(Cross-Attention)架构、专注于长时、实时视频理解的开源模型系列,三个模型均为 11B、开放权重。
* **`MOSS-VL-Realtime`**:支持在持续视频流中进行**实时交互**,可随时打断、即问即答,并能自主判断何时开口回应、何时继续观察。
* **`MOSS-VL-Instruct`**:专为**离线场景**设计,尤其擅长复杂的长视频内容理解与深度对话。
* **`MOSS-VL-Base`**:开放的**预训练基座**,提供强大的视频-语言基础表征,便于社区进行继续预训练与下游微调。
区别于传统视频模型“先看完整段、再作答”的离线范式,**MOSS-VL-Realtime** 专为持续视频流上的实时交互而设计:它能在不断到来的视频流上并行执行多模态感知与文本生成,原生支持多轮实时对话与动态场景理解,可自主判断开口时机、实现细粒度的时间定位,并给出流式回应。
---
### 核心能力提升 (Key Enhancements)
* **随时应答 (Interruptible & Real-time)**: 突破离线处理限制。用户可在视频流任意时间戳提问,模型即刻基于当前已接收画面给出回应,流式交互延迟达到开源 SOTA。
* **主动沉默 (Proactive Silence)**: 具备动态判断能力。在上下文信息不足或无关键事件发生时,模型能自主保持沉默并持续观察。
* **及时纠正 (Dynamic Correction)**: 认知随画面动态更新。随着新画面帧的持续流入,模型能即刻捕捉状态变化并修正此前的输出。
### 核心架构设计 (Core Architecture)
架构层面,**MOSS-VL-Realtime** 采用以下核心设计:
- **交叉注意力架构**:视觉编码与语言推理解耦,显著降低动态视频流上的响应延迟,并原生支持图像、视频与文本的交错输入。
- **绝对时间戳**:每一采样帧通过专用特殊 token 锚定到精确的时间标记,模型据此推理节奏、时长与运动动态,并原生适配可变帧率。
- **XRoPE(交叉注意力旋转位置编码)**:将文本 token 与视频 patch 映射到统一的三维 (t, h, w) 坐标空间,实现全视频范围内 patch 级、瞬间级的定位。
---
## 🔥 新闻
- **2026/09/21**: 🌐 内置实时交互 Demo([`./third_party/realtime-demo/`](./third_party/realtime-demo/)):完整的前后端实现(浏览器前端 + 服务后端 + 内置记忆系统),结合 SGLang-Omni 推理后端构成从浏览器到 GPU 的完整实时链路;Demo 集成 ASR 与 TTS(本地部署或云端 API),支持通过语音提问、结合视频画面回答,并将回答播报出来。
- **2026/09/18**: ⚡ 内置特化的 SGLang-Omni 实时推理后端([`./third_party/sglang-omni/`](./third_party/sglang-omni/)):支持动态多会话调度与数据并行多副本,可同时服务多路视频流、吞吐大幅提升,需搭配 [MOSS-VL-Realtime-SGLANG](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Realtime-SGLANG) checkpoint 使用。
- **2026/08/31**: ⚖️ 发布 [MOSS-VL 量化教程](quantization/README_zh.md)([English](quantization/README.md)):包含 FP8-Dynamic 与 NF4 量化配方、KV Cache 量化,以及如何量化自己微调(如 SFT)后的 MOSS-VL checkpoint。
- **2026/08/28**: 📋 公开 MOSS-VL 训练使用的[开源数据集列表](docs/open_source_datasets.md)。
- **2026/08/21**: 🤝 MOSS-VL 已正式接入 [ms-swift](https://github.com/modelscope/ms-swift),现可通过 `swift infer` 进行图像/视频推理,并通过 `swift sft` 进行 LoRA 与全参数微调。详见 [PR #9944](https://github.com/modelscope/ms-swift/pull/9944)。
- **2026/08/15**: 📚 [MOSS-VL 技术报告](https://arxiv.org/abs/2608.15045)已在 arXiv 发布,系统介绍模型架构、训练课程、实时推理系统,以及完整的离线与流式评测结果。
- **2026/08/14**: 🤝 MOSS-VL 已接入 [LlamaFactory](https://github.com/hiyouga/LlamaFactory) 主线,LoRA 与全参数微调工作流现已开箱即用。详见[中文教程](https://blog.llamafactory.net/posts/moss_vl_finetuning/)或[英文教程](https://blog.llamafactory.net/en/posts/moss_vl_finetuning/),也可参阅[模思智能博客](https://mosi.cn/blog/moss-vl-llamafactory)。
- **2026/08/11**: ⚡ 发布 MOSS-VL 的 24 GiB 量化模型,Instruct-0708 与 Realtime 均提供 FP8 和 NF4 两种版本:**MOSS-VL-Instruct-0708-FP8**([Hugging Face](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Instruct-0708-FP8) | [ModelScope](https://modelscope.cn/models/openmoss/MOSS-VL-Instruct-0708-FP8))、**MOSS-VL-Instruct-0708-NF4**([Hugging Face](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Instruct-0708-NF4) | [ModelScope](https://www.modelscope.cn/models/openmoss/MOSS-VL-Instruct-0708-NF4))、**MOSS-VL-Realtime-FP8**([Hugging Face](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Realtime-FP8) | [ModelScope](https://www.modelscope.cn/models/openmoss/MOSS-VL-Realtime-FP8))和 **MOSS-VL-Realtime-NF4**([Hugging Face](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Realtime-NF4) | [ModelScope](https://modelscope.cn/models/openmoss/MOSS-VL-Realtime-NF4)),支持在单张 24 GB NVIDIA GPU 上高效推理。
- **2026/07/14**: 🏆 MOSS-VL-Realtime 在 **PA@OmniMMI** 上取得 **66.0**,并获 [OmniMMI 官方仓库](https://github.com/OmniMMI/OmniMMI)祝贺。
- **2026/07/14**: 🚀 发布 **[MOSS-VL-Realtime](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Realtime)**,面向持续视频流的实时视频理解;同时发布全新的 **[MOSS-VL-Instruct-0708](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Instruct-0708)** 与 **[MOSS-VL-Base-0708](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Base-0708)**。
- **2026/04/24**: 🚀 SGLang 官方已正式支持 MOSS-VL,详见 [sgl-project/sglang](https://github.com/sgl-project/sglang)。
- **2026/04/22**: 🚀 推出基于 SGLang 的 MOSS-VL 推理支持,详见 [`./third_party/sglang/`](./third_party/sglang/)。
- **2026/04/22**: 🤗 HuggingFace 推理代码更新至最新版本。
- **2026/04/08**: 🚀 [MOSS-VL-Base-0408](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Base-0408) 与 [MOSS-VL-Instruct-0408](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Instruct-0408) 正式开源。
---
## 📊 评测 (Performance)
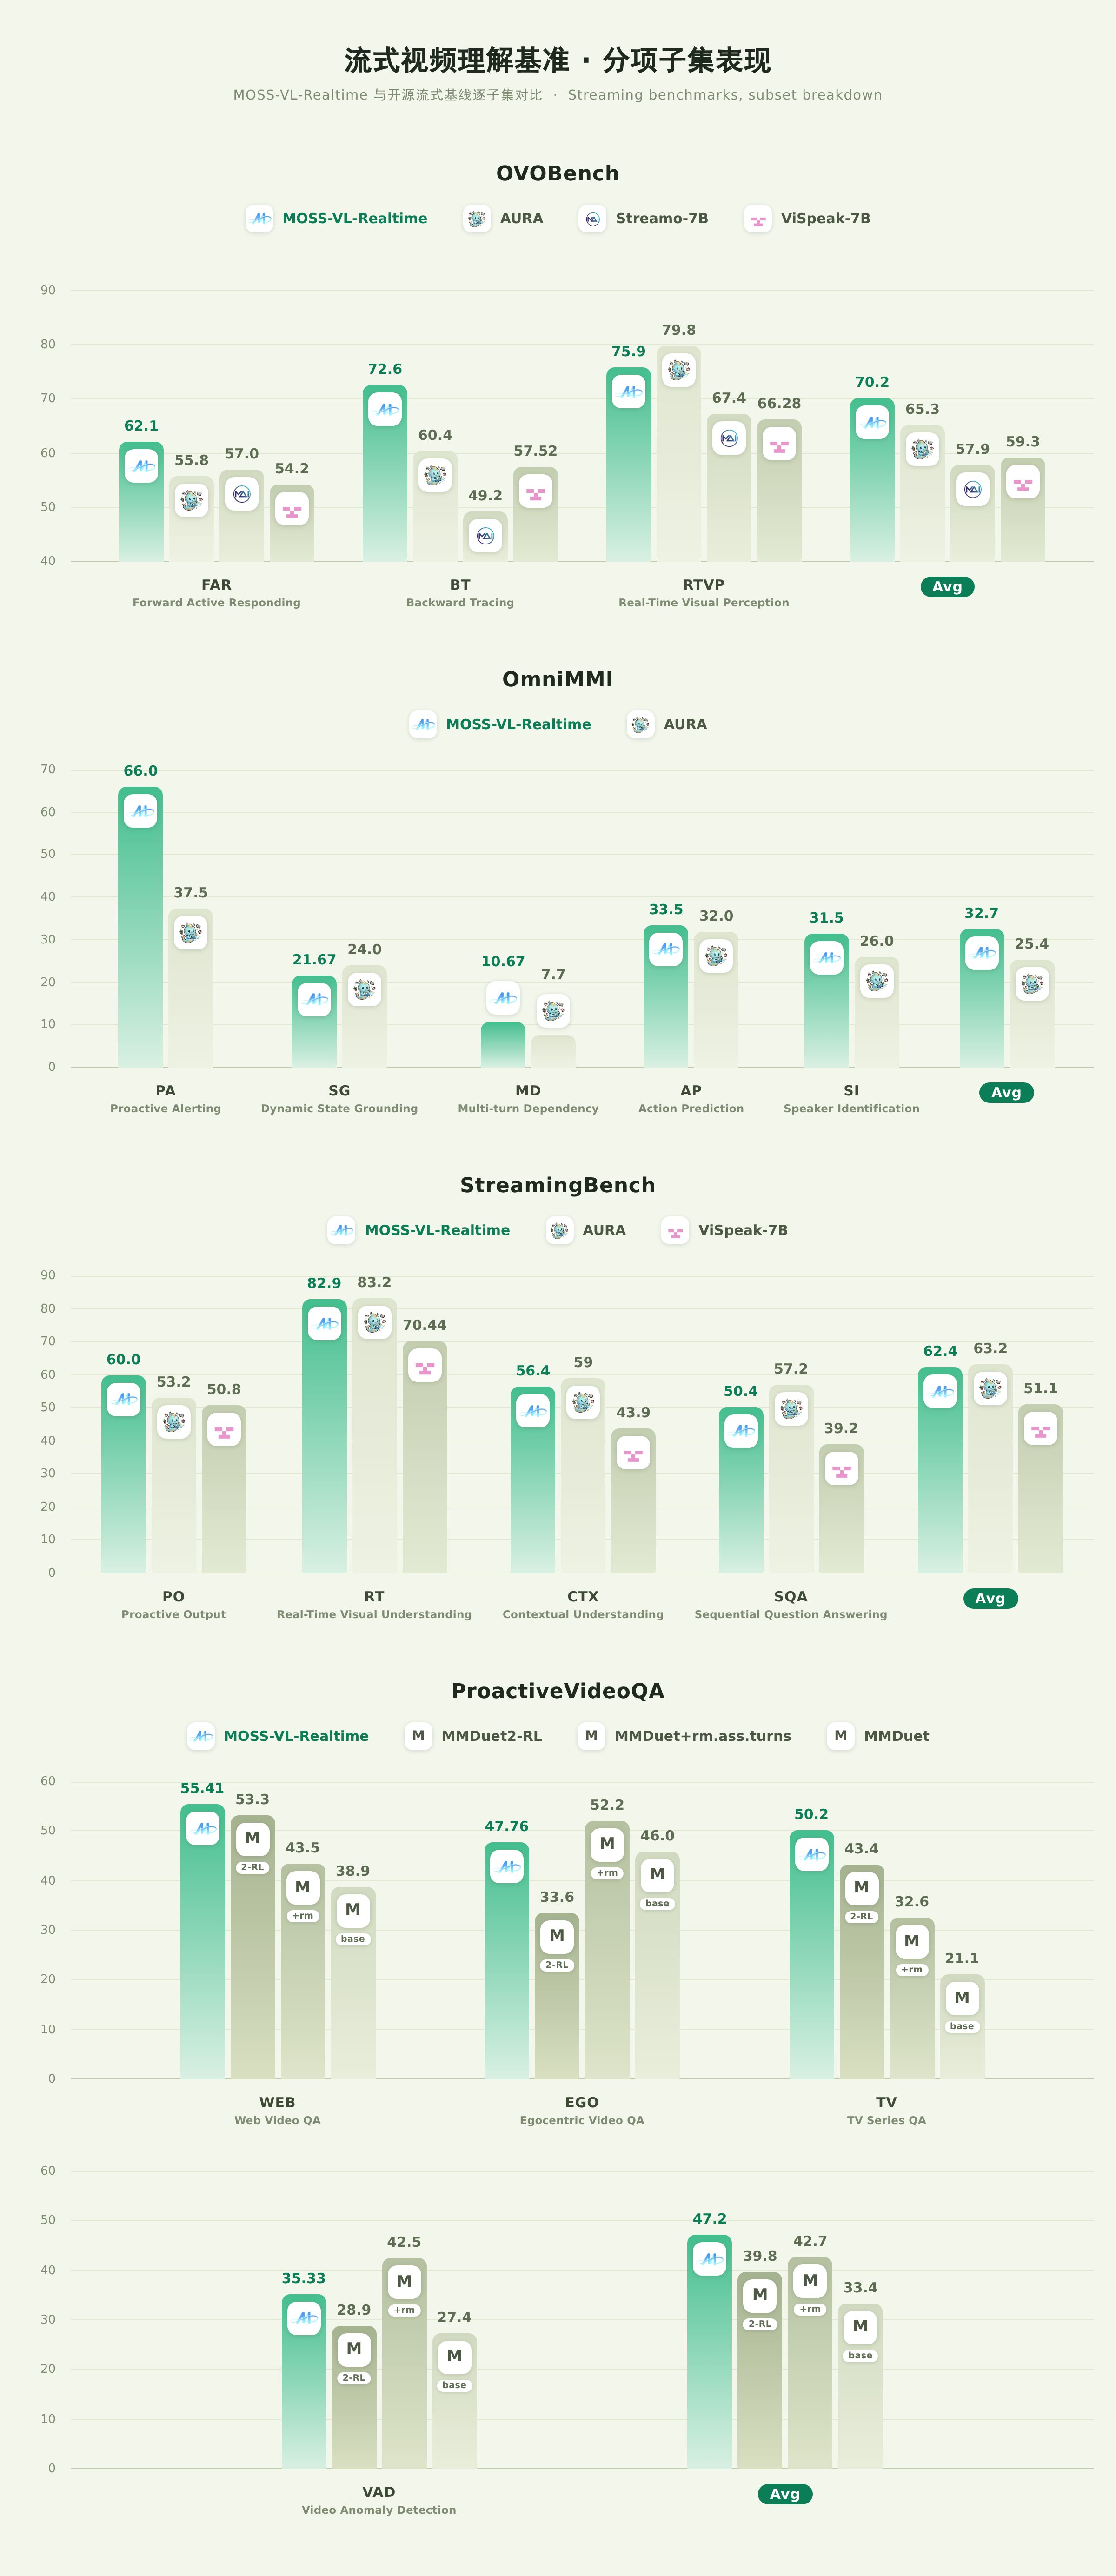
MOSS-VL-Realtime 的流式交互能力显著提升,在多项流式视频理解基准上达到开源 SOTA,其中「主动开口」能力尤为突出:在 OmniMMI 的 Proactive Alerting、StreamingBench 的 Proactive Output 以及 ProactiveVideoQA 三项主动性评测上均取得领先成绩。
### 流式交互评测 (Streaming Benchmark)
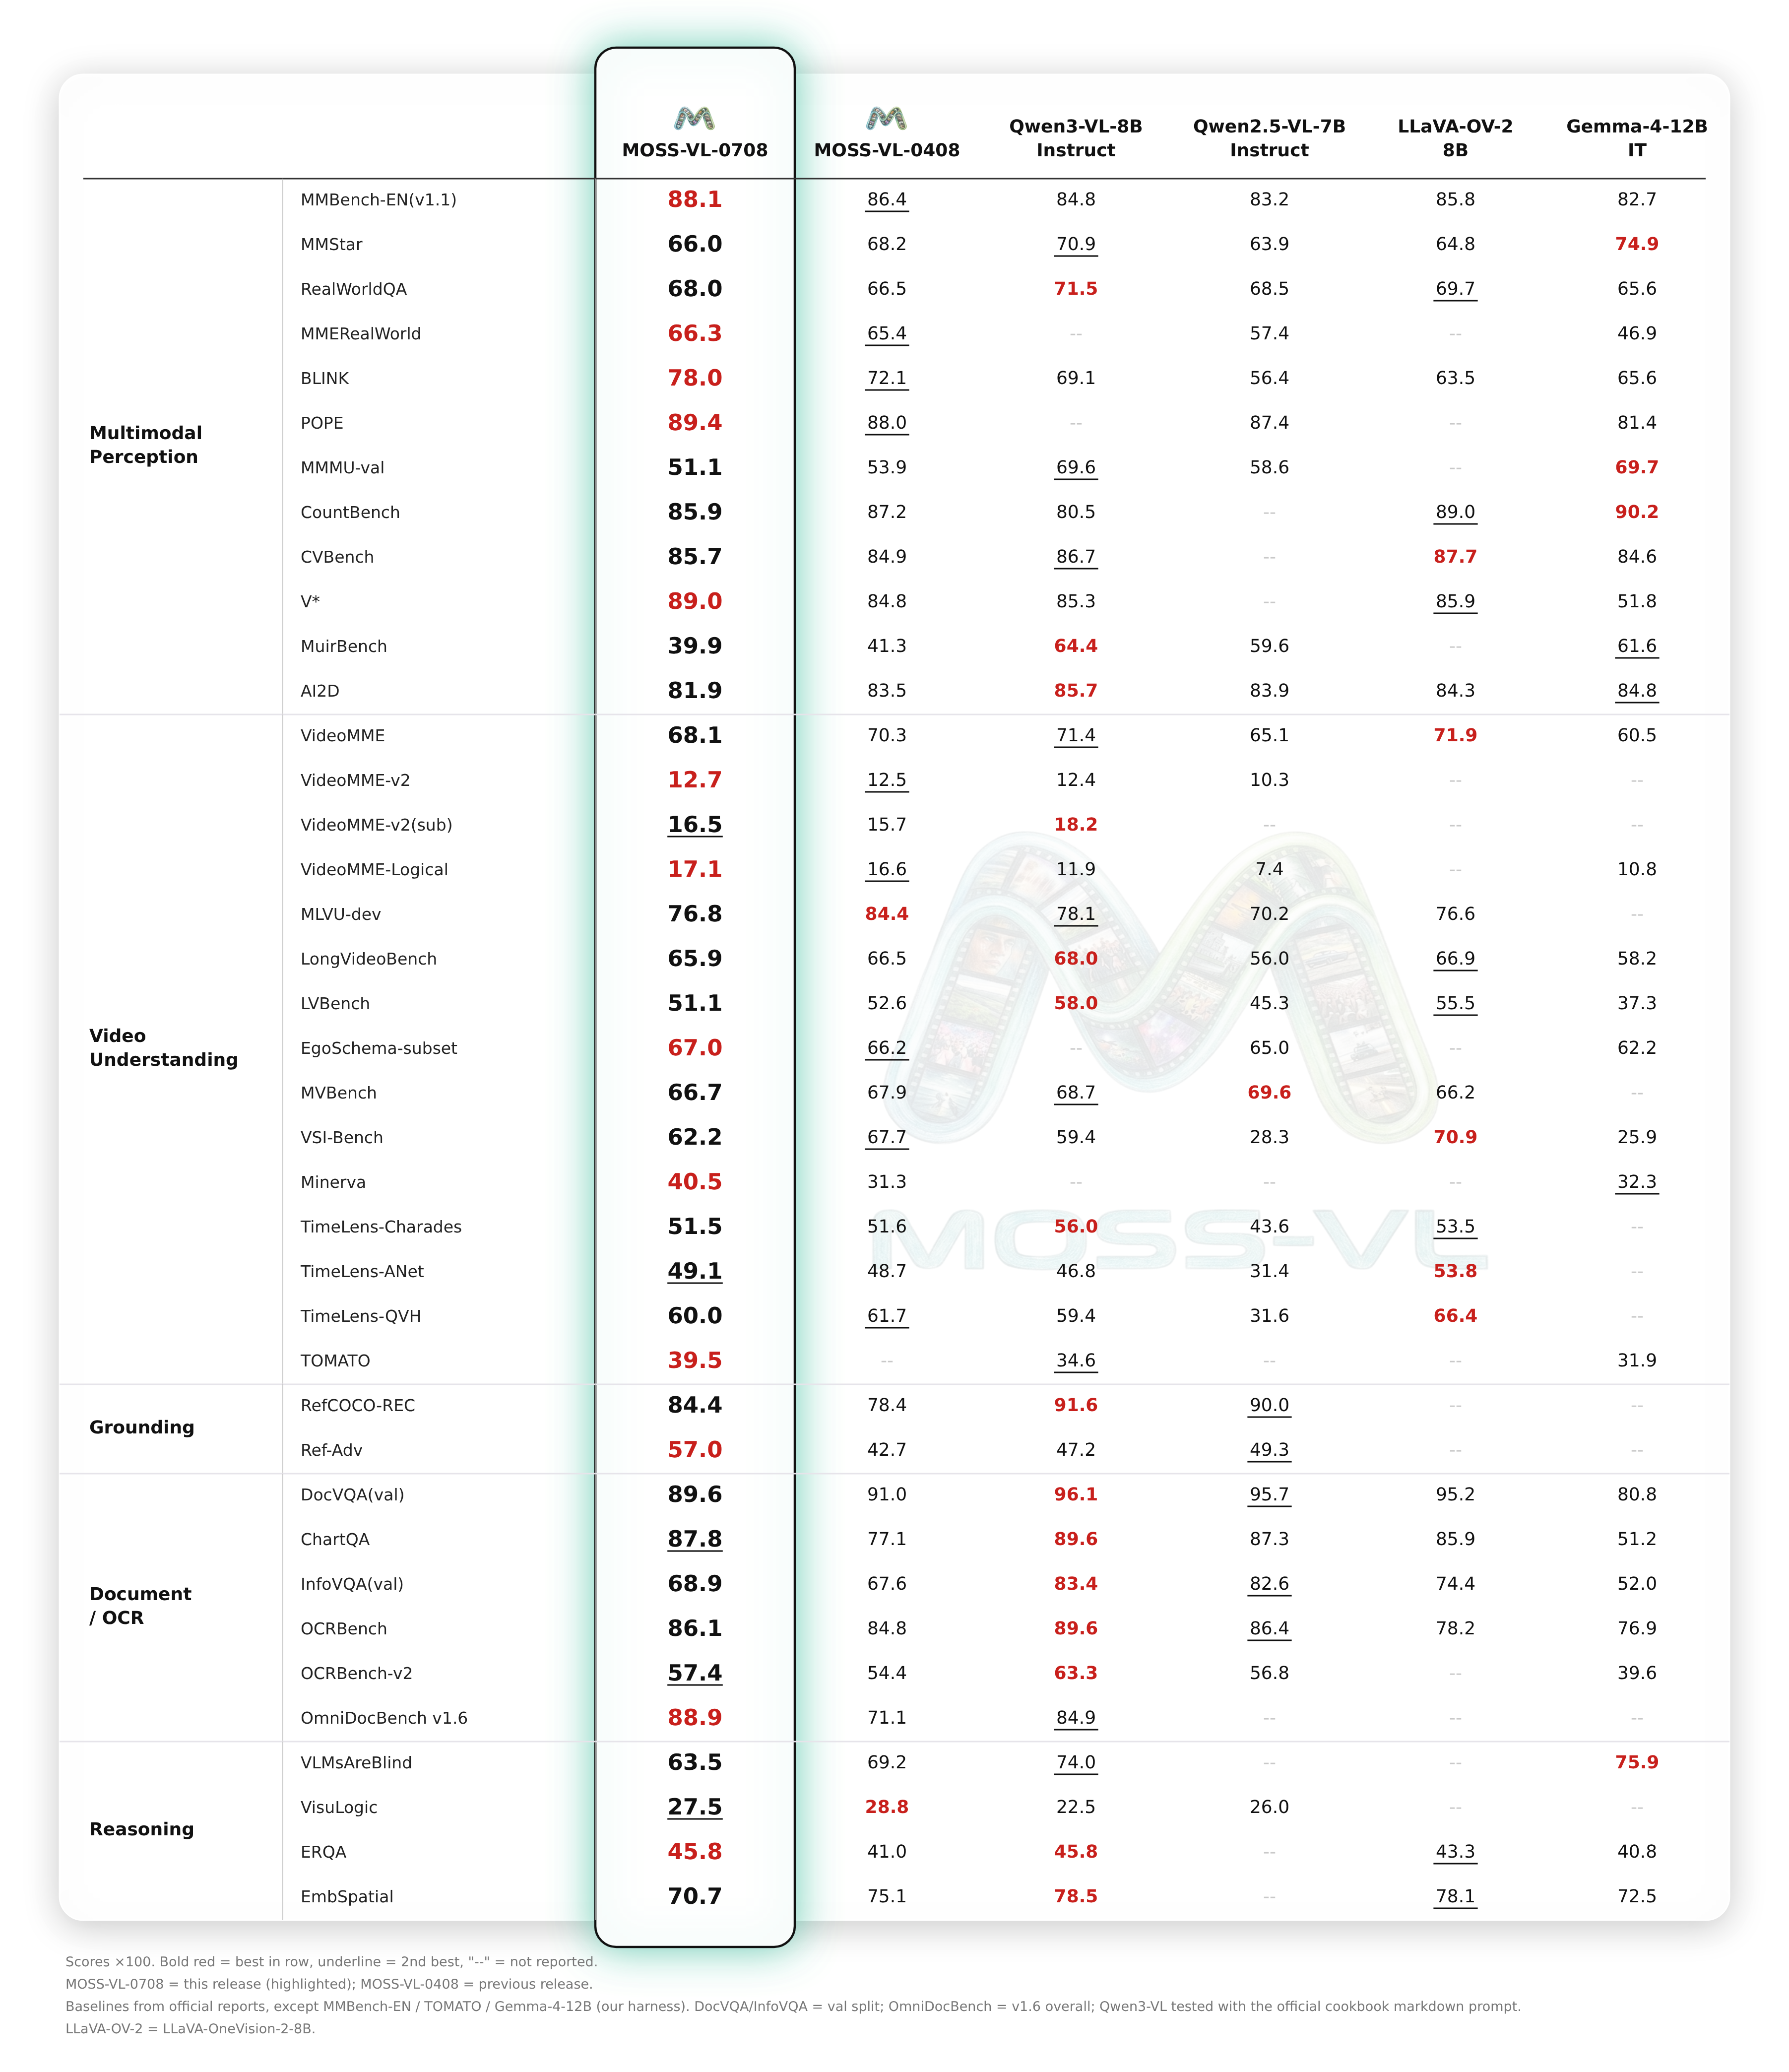
我们对数据体系进行了系统性重构与深度优化,使得模型的基础能力与指令交互体验得到了全面强化,在各项离线评估中保持了极高的稳定性。
离线基础评测 (Offline Multimodal Benchmark) —— 点击展开
> 完整的评测拆解、对比系统、以及所有客观指标的明细表格,请见我们的 [**技术博客**](https://openmoss.ai/MOSS-VL/index_zh.html)。
---
## 🚀 快速上手
### 环境配置
```bash
conda create -n moss_vl python=3.12 pip -y
conda activate moss_vl
pip install -i https://pypi.org/simple --no-build-isolation -r requirements.txt
```
### 实时推理
实时推理会增量接收带时间戳的视频帧,因此模型可以在持续感知视频流的同时作答,并随时接收新的问题。最快的本地视频回放方式是:
```bash
CUDA_VISIBLE_DEVICES=0 python inference/realtime/run_online_inference.py \
--checkpoint OpenMOSS-Team/MOSS-VL-Realtime \
--source video \
--video path/to/example.mp4 \
--sample-fps 1 \
--playback-speed 1 \
--max-frames 256
```
模型推理时请保持 `--playback-speed 1`,使视频帧按原始时间轴到达。运行时提供三种集成层级:
- `model.create_realtime_session(...)`:直接控制视频帧、动态问题和增量输出
- `model.online_generate(...)`:用于基于队列的推理工作线程
- `--serve`:启动 FastAPI WebSocket 服务,接收外部 JPEG/PNG 帧或回放服务端本地视频
此外还支持流式 JSONL 样例、摄像头、屏幕采集和合成视频源。完整 CLI、输入格式和 WebSocket 协议请参阅 [`inference/realtime/README.md`](./inference/realtime/README.md)。
生产环境多路实时推流推荐使用 [`third_party/sglang-omni/`](./third_party/sglang-omni/) 中的 SGLang-Omni 特化后端:支持动态多会话调度与数据并行多副本,实时推理吞吐大幅提升。配套的完整交互 Demo(前后端实现、内置记忆系统、ASR/TTS 语音输入输出)见 [`third_party/realtime-demo/`](./third_party/realtime-demo/)。
### 离线推理
离线推理支持全模态查询(图文/视频等),最快的调用方式是 `offline_batch_generate`:
```python
import torch
from transformers import AutoModelForCausalLM, AutoProcessor
checkpoint = "OpenMOSS-Team/MOSS-VL-Realtime"
processor = AutoProcessor.from_pretrained(checkpoint, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
checkpoint, trust_remote_code=True, device_map="auto", torch_dtype=torch.bfloat16
)
queries = [{
"messages": [{"role": "user", "content": [
{"type": "image", "image": "path/to/example.jpg"},
{"type": "text", "text": "描述这张图片。"}
]}],
"generate_kwargs": {"max_new_tokens": 256, "do_sample": False},
}]
with torch.no_grad():
result = model.offline_batch_generate(processor, queries)
print([item["text"] for item in result["results"]])
```
---
## 🛠️ 进阶资源与生态
### MOSS-VL 定制 FlashAttention-3 后端
[`third_party/flash-attention-src/`](./third_party/flash-attention-src/) 目录提供 MOSS-VL
交叉注意力使用的定制 FlashAttention-3 后端。该版本增加了
`cross_kv_boundary` 接口,用每个 query 对应的一个 `int32` 边界表示可见
KV 前缀,避免构造稠密注意力掩码。它是基于上游 FlashAttention 修改的
MOSS-VL 专用版本,并非通用 FlashAttention 发行版。具体掩码约定、支持范围、
构建方法、上游版本和许可证信息见
[`third_party/flash-attention-src/README.md`](./third_party/flash-attention-src/README.md)。
### 部署与推理引擎
本模型同时支持以下推理后端引擎进行高效部署:
- **SGLang**: 详见 [`third_party/sglang/README_zh.md`](./third_party/sglang/README_zh.md)
- **SGLang-Omni(实时推理)**: 支持动态多会话调度与数据并行多副本的特化实时推理后端,详见 [`third_party/sglang-omni/README_zh.md`](./third_party/sglang-omni/README_zh.md)
### 微调 (Fine-Tuning)
我们提供了一套基于 HuggingFace `transformers.Trainer` 的轻量级 SFT 微调框架,支持全参数训练与 LoRA,且可独立控制视觉编码器、语言模型和 LM Head 是否参与训练。
```bash
# 全参数 SFT(默认冻结视觉编码器)
bash finetune/scripts/run_sft.sh
# LoRA SFT
pip install -i https://pypi.org/simple peft
bash finetune/scripts/run_sft_lora.sh
```
详细文档请参阅 [`finetune/README.md`](finetune/README.md)。
MOSS-VL 也已适配主流微调框架 [LLaMA-Factory](https://github.com/hiyouga/LLaMA-Factory)([PR #10708](https://github.com/hiyouga/LLaMA-Factory/pull/10708))和 [ms-swift](https://github.com/modelscope/ms-swift)([PR #9944](https://github.com/modelscope/ms-swift/pull/9944)),LoRA 与全参数微调均开箱即用。
### 量化 (Quantization)
我们为 Instruct-0708 与 Realtime 提供 FP8 与 NF4 量化模型,并在 [`quantization/README_zh.md`](quantization/README_zh.md)([English](quantization/README.md))中公开了背后的免校准 PTQ 量化配方。教程涵盖语言层 Linear 的选择性量化范围、多模态敏感模块的 BF16 保留规则、Transformers 与 SGLang 的运行时 KV Cache 量化,以及可直接作用于你自己微调或 SFT 后 checkpoint 的复现脚本。
### 模型下载汇总
本代基于同一套重构数据交付三个模型:**MOSS-VL-Realtime** 面向持续视频流,**Instruct** 承接离线任务,**Base** 供继续预训练与微调。
| 模型 | 参数量 | 上下文 | 适用场景 | 🤗 HuggingFace | 🤖 ModelScope |
| :--- | :---: | :---: | :--- | :--- | :--- |
| **MOSS-VL-Realtime** | `11B` | `256K` | 持续视频流上的实时交互 | [链接](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Realtime) | [链接](https://www.modelscope.cn/models/openmoss/MOSS-VL-Realtime-0708) |
| **MOSS-VL-Instruct-0708** | `11B` | `256K` | 离线对话 / 推理 / 下游任务 | [链接](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Instruct-0708) | [链接](https://www.modelscope.cn/models/openmoss/MOSS-VL-Instruct-0708) |
| **MOSS-VL-Base-0708** | `11B` | `256K` | 继续预训练 / 微调 | [链接](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Base-0708) | [链接](https://www.modelscope.cn/models/openmoss/MOSS-VL-Base-0708) |
**上一代模型:**
| 模型 | 参数量 | 上下文 | 适用场景 | 🤗 HuggingFace | 🤖 ModelScope |
| :--- | :---: | :---: | :--- | :--- | :--- |
| **MOSS-VL-Base-0408** | `11B` | `256K` | 继续预训练 / 微调 | [链接](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Base-0408) | [链接](https://modelscope.cn/models/openmoss/MOSS-VL-Base-0408) |
| **MOSS-VL-Instruct-0408** | `11B` | `256K` | 对话 / 推理 / 下游任务 | [链接](https://huggingface.co/OpenMOSS-Team/MOSS-VL-Instruct-0408) | [链接](https://modelscope.cn/models/openmoss/MOSS-VL-Instruct-0408) |
---
## 📑 路线图与待办事项
### ✅ 已达成里程碑 (Milestones)
- [x] **核心架构:** 实现了交叉注意力旋转位置编码 (XRoPE)。
- [x] **高性能基础设施:** 集成了 Megatron-LM 与 CUDA Flash Attention 3。
- [x] **模型发布:** 已开源 `MOSS-VL-Base` 与 `MOSS-VL-Instruct` 模型。
- [x] **模型推理:** 已发布支持图像与视频理解的推理代码。
- [x] **实时能力:** 发布 **MOSS-VL-Realtime** —— 持续视频流上的实时视频理解。
### 🚀 即将到来 (Upcoming)
- [ ] **训练引擎:** MOSS-VL 的完整训练代码。
- [ ] **RL 后训练:** MOSS-VL 系列的强化学习后训练。
- [x] **技术报告:** 已发布 MOSS-VL 技术报告。
- [ ] **Cookbook:** 任务级可运行 notebook。
---
## 🤝 致谢
我们衷心感谢 **NVIDIA** 提供的 [Megatron-LM](https://github.com/NVIDIA/Megatron-LM) 框架,以及 **Qwen 团队** 提供的强大的 [Qwen](https://github.com/QwenLM/Qwen) 系列语言模型。这些优秀的开源工作为我们的训练基础设施和核心语言模型奠定了坚实基础。同时,我们也由衷感谢 **SGLang 团队** 提供的高性能 [SGLang](https://github.com/sgl-project/sglang) 推理服务框架,为 MOSS-VL 的高效部署提供了重要支持。
## 📜 引用
```bibtex
@misc{mossvl,
title = {MOSS-VL Technical Report},
author = {Wang, Pengyu and Tan, Chenkun and Zhou, Shaojun and Zhou, Qirui and Chen, Yanxin and He, Xingyang and Zeng, Huazheng and Cheng, Jijun and Wang, Chenghao and Qian, Xiaomeng and Wang, Pengfei and Huang, Zhan and Gao, Shanqing and Huang, Wei and Cao, Longjun and Ran, Wu and Liu, Jie and Zhu, Changtai and Wang, Hongkai and Tian, Yixian and Liu, Chenghao and Ye, Zhen and Wang, Xinghao and Jiang, Botian and Feng, Guoguo and Fei, Zhaoye and Li, Ruixiao and Chen, Mingshu and Gao, Yang and Cheng, Qinyuan and Li, Shimin and Qiu, Xipeng},
year = {2026},
eprint = {2608.15045},
archivePrefix = {arXiv},
primaryClass = {cs.CV},
url = {https://arxiv.org/abs/2608.15045}
}
@misc{mossvideopreview,
title = {{MOSS-Video-Preview: Toward Real-Time Video Understanding via Cross-Attention}},
author = {Pengyu Wang and Chenkun Tan and Shaojun Zhou and Wei Huang and Qirui Zhou and Zhan Huang and Zhen Ye and Jijun Cheng and Xiaomeng Qian and Yanxin Chen and Xingyang He and Huazheng Zeng and Chenghao Wang and Pengfei Wang and Hongkai Wang and Shanqing Gao and Yixian Tian and Chenghao Liu and Xinghao Wang and Botian Jiang and Xipeng Qiu},
year = {2026},
eprint = {2606.07639},
archivePrefix = {arXiv},
primaryClass = {cs.CV},
url = {https://arxiv.org/abs/2606.07639}
}
```
## 🌟 Star History

Built with ❤️ by the OpenMOSS Team