 # **Q**uestion and **A**nswer based on **Anything**


 ***NOTE:***
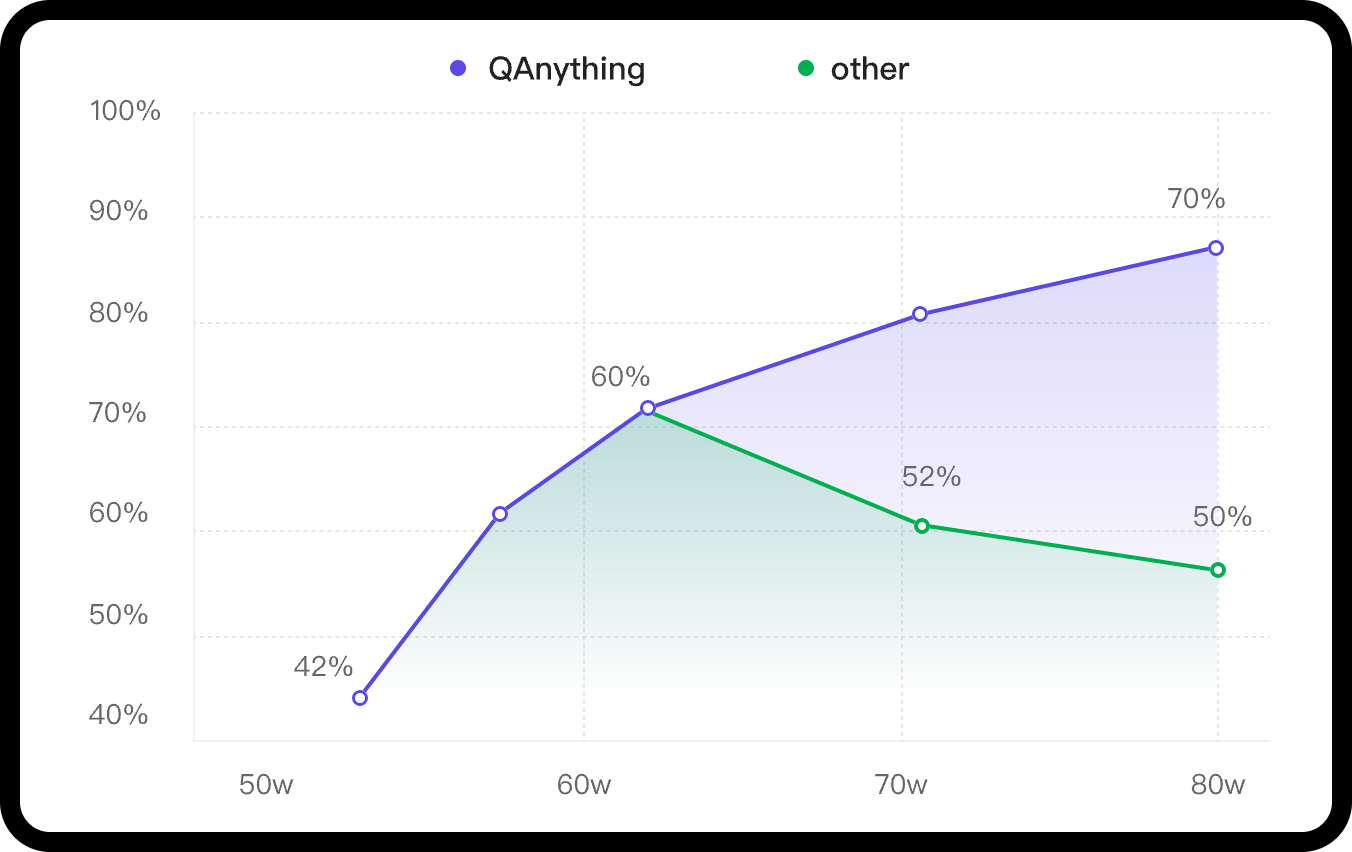
- 在WithoutReranker列中,我们的bce-embedding-base_v1模型优于所有其他embedding模型。
- 在固定embedding模型的情况下,我们的bce-reranker-base_v1模型达到了最佳表现。
- **bce-embedding-base_v1和bce-reranker-base_v1的组合是SOTA。**
- 如果想单独使用embedding和rerank请参阅:[BCEmbedding](https://github.com/netease-youdao/BCEmbedding)
### LLM
v2.0版本QAnything不再提供本地大模型,用户可自行接入OpenAI接口兼容的其他开源大模型服务,如ollama, DashScope等。
# 🚀 最近更新
- ***2024-08-23***: **支持快速开始、前端配置参数、在线预览和编辑chunk块,极大优化项目架构和启动方式,极大优化解析和检索效果。** - 详见👉 [v2.0.0](https://github.com/netease-youdao/QAnything/releases/tag/v2.0.0)
- ***2024-05-20***: **支持与OpenAI API兼容的其他LLM服务,并提供优化后的PDF解析器。** - 详见👉 [v1.4.1](https://github.com/netease-youdao/QAnything/releases/tag/v1.4.1)
- ***2024-04-26***: **支持联网检索、FAQ、自定义BOT、文件溯源等。** - 详见👉 [v1.4.0](https://github.com/netease-youdao/QAnything/releases/tag/v1.4.0-python)
- ***2024-04-03***: **支持在纯Python环境中安装;支持混合检索。** - 详见👉 [v1.3.0](https://github.com/netease-youdao/QAnything/releases/tag/v1.3.0)
- ***2024-01-29***: **支持自定义大模型,包括OpenAI API和其他开源大模型,GPU需求最低降至GTX 1050Ti,极大提升部署,调试等方面的用户体验** - 详见👉 [v1.2.0](https://github.com/netease-youdao/QAnything/releases/tag/v1.2.0)
- ***2024-01-23***: **默认开启rerank,修复在windows上启动时存在的各类问题** - 详见👉 [v1.1.1](https://github.com/netease-youdao/QAnything/releases/tag/v1.1.1)
- ***2024-01-18***: **支持一键启动,支持windows部署,提升pdf,xlsx,html解析效果** - 详见👉 [v1.1.0](https://github.com/netease-youdao/QAnything/releases/tag/v1.1.0)
# 开始之前
**在GitHub上加星,即可立即收到新版本的通知!**
* [🏄 在线试用QAnything](https://qanything.ai)
* [📚 在线试用有道速读](https://read.youdao.com)
* [🛠️ 想只使用BCEmbedding(embedding & rerank)](https://github.com/netease-youdao/BCEmbedding)
* [📖 FAQ](FAQ_zh.md)
* [👂️需求反馈 | 让我听见你的声音](https://qanything.canny.io/feature-requests)
# 开始
## 最新特性表
| 特性 | python (v1.4.2) | docker (v1.2.2) | 全新QAnything v2.0.0 | 说明 |
|---------------------------------|-----------------|-----------------| ---------------- |---------------------------------------------------------------------------|
| 详细安装文档 | ✅ | ✅ | ✅ | |
| API支持 | ✅ | ✅ | ✅ | |
| 生产环境(小型生产环境) | ❌ | ✅ | ✅ | |
| 离线使用 | ❌ | ✅ | ✅ | |
| 支持多并发 | ❌ | ✅ | ✅ | |
| 支持多卡推理 | ❌ | ✅ | ❌ | v2.0.0版本不再提供默认本地LLM,一律通过openai接口接入,用户可自行通过ollama等工具部署本地LLM |
| 支持Mac(M系列芯片) | ✅ | ❌ | ✅ | |
| 支持Linux | ✅ | ✅ | ✅ | python旧版本Linux下默认使用onnxruntime-gpu for cuda12,glibc<2.28时自动切换为onnxruntime |
| 支持windows (**无需WSL**) | ❌ | ❌ | ✅ | python和docker旧版本均要求WSL环境,v2.0.0可直接在非WSL环境下启动 |
| 支持纯CPU环境 | ✅ | ❌ | ✅ | v2.0.0版本Mac,Linux,Win统一不再使用GPU,完全迁移至CPU |
| 支持混合检索(BM25+embedding) | ❌ | ✅ | ✅ | |
| 支持联网检索(**需外网VPN**) | ✅ | ❌ | ✅ | |
| 支持FAQ问答 | ✅ | ❌ | ✅ | |
| 支持自定义机器人(可绑定知识库,可分享) | ✅ | ❌ | ✅ | |
| 支持文件溯源(数据来源可直接点击打开) | ✅ | ❌ | ✅ | |
| 支持问答日志检索 | ✅ | ❌ | ✅ | python和docker旧版本均只能通过API检索,v2.0.0可直接在前端检索 |
| 支持解析语音文件(依赖faster_whisper,解析速度慢) | ✅ | ❌ | ❌ | 依赖whisper,速度慢且占用资源大,暂时去除 |
| 支持OpenCloudOS | ✅ | ❌ | ✅ | |
| 支持与OpenAI接口兼容的其他开源大模型服务(包括ollama) | ✅ | ✅ | ✅ | python和docker旧版本需手动修改api_key,base_url,model等参数,v2.0.0版本均改为前端设置自动保存 |
| pdf(包含表格)解析效果+++ | ✅ | ❌ | ✅ | v1.4.2版本需手动设置,v2.0.0无需手动设置,pdf解析效果和性能均有提升 |
| 用户自定义embed,rerank配置(实验性:提升速度) | ✅ | ❌ | ✅ | v1.4.2需手动设置,v2.0.0默认使用最佳配置 |
| 其他文件类型解析效果+++ | ❌ | ❌ | ✅ | v2.0.0版本提升url,md,xlsx,docx等解析效果 |
| 支持独立服务调用 | ❌ | ❌ | ✅ | v2.0.0版本独立依赖服务,包括embed,rerank,ocr,pdf解析服务等,可独立调用(http) |
| 支持快速开始模式 | ❌ | ❌ | ✅ | 快速开始:无需创建知识库,支持文件即传即问,支持无文件问答 |
| 支持仅检索模式 | ❌ | ❌ | ✅ | 仅返回检索结果,不调用大模型进行问答 |
| 支持解析结果chunks内容可视化,手动编辑 | ❌ | ❌ | ✅ | v2.0.0版本支持手动编辑chunks内容,实时生效 |
| pdf解析支持图片,支持回答带图 | ❌ | ❌ | ✅ | |
## V2.0.0版本新增细节优化:
* 支持前端配置API_BASE,API_KEY,文本分片大小,输出token数量,上下文消息数量等参数
* 优化Bot角色设定的指令遵循效果,每个Bot可单独配置模型参数
* 支持创建多个对话窗口,同时保存多份历史问答记录
* 支持问答记录保存成图片
* 优化上传文件逻辑,解析文件与问答请求独立,上传文件不再影响问答
* 优化镜像大小,旧版本镜像压缩后大小为18.94GB->新版镜像压缩后大小为4.88GB,降为原有的1/4,提供完整Dockerfile
* 检索优化,chunks新增片段融合与排序,聚合单文档或双文档
* 检索阶段和问答阶段均嵌入metadata信息,提升检索和问答效果
### 各阶段数据展示:
* 知识库所有文件上传进度展示
* 知识库单个文件上传进度展示,上传各阶段耗时
* 问答信息统计,包含问答各阶段耗时,tokens消耗,模型信息等
* 用户信息统计,包含上传文件总数量,总耗时,问答历史记录等
### 问题修复
* xlsx表格支持多sheet解析
* 优化PDF表格漏识别问题
* 修复部分DOCX文件解析出错问题
* 优化FAQ匹配逻辑
* 支持非utf-8编码的txt文件
## 新旧解析效果对比
* 针对PDF文档:首先针对在文档中大段表格,尤其是跨页表格的解析方面,2.0版本进行了显著的改进,新版本解析逻辑能够分析表格的结构,包括行和列的布局,并且能够自动识别出表头,将其置于每个切片分割出的表格的顶部。这样的改进防止了在解析长表格时,由于逻辑上的切割而导致的意义上的中断
| 原图 | 旧版本解析效果 | 新版本解析效果 |
|:----:|:--------------------------------------------:|:---------------------------------------------------------------------------------------------:|
|  |  |  |
* 此外,2.0版本在处理文本分栏和跨页布局的情况下也做了优化。它能够识别文本的双栏或多栏布局,并根据人类的阅读习惯来正确划分文本块的顺序。同时,该版本还能够保存文档中的图片,确保在文件解析过程中内容的完整性不会丢失。如在下图中,正确的排列顺序应该为一次排列编号1,2,3的文本为一大段并进行切块,而不是将1,2,3分别切块。
* 在1.4版本解析结果中,跨页文本 “更高一些” 被分块到了下一文本块中,这对大模型语义理解是不利的,而在2.0版本解析结果中是正确划分的,并且也将穿插在文本段落中的图片解析到对应的chunk语句块中,非正文本文 “图1 鉴别与授权及其支持关系 37” 和 “Cover Story 封面专题” 也成功被过滤
| 原图 | 旧版本解析效果 | 新版本解析效果 |
|:----:|:--------------------------------------------:|:---------------------------------------------------------------------------------------------:|
|  | 
 欢迎加入QAnything [Discord](https://discord.gg/5uNpPsEJz8) 社区!
## 微信
欢迎关注微信公众号,获取最新QAnything信息
 欢迎扫码进入QAnything交流群
 ## 邮箱
如果你需要私信我们团队,请通过下面的邮箱联系我们:
AIcloud_Business@corp.youdao.com
## GitHub issues & discussions
有任何公开的问题,欢迎提交issues,或者在discussions区讨论
- [Github issues](https://github.com/netease-youdao/QAnything/issues)
- [Github discussions](https://github.com/netease-youdao/QAnything/discussions)