mu
μ · Only what's needed.
判定カーネルを持つコーディングエージェント。ベースは pi。




English · 简体中文 · 繁體中文 · 日本語 · 한국어
コーディングエージェントは 1 回のセッションで、コードとは関係のない判断を何百回も下します。何をコンテキストに残すか、このコマンドは安全か、この発見を別のエージェントに伝える価値があるか、作業は終わったか。大きなモデルに任せれば、トークンとレイテンシと注意力を消費します。固定のルールに任せれば、間違いが多すぎます。mu はこうした判断を**判定器**に任せます。判定器は小さくて速いモデルで、答えの範囲が決まった問いに一度に一つずつ答えます。判定ポイントは各ターンに 38 あります。大きなモデルは、注意力を本来の作業に使えます。
- **mu**:コマンドライン版です。pi にできることすべてに、判定カーネルが加わります。
- **mu デスクトップ**:mu とそのランタイムを内蔵したネイティブアプリです。ダウンロードしてモデルをつなげば、すぐに始められます。
- **Jev**:判定器です。Yes/No、選択、スコアの問いに答え、答えごとに確率を付け、すべての判定を台帳に残します。ローカルの判定器(Laya)や任意の LLM が、Jev の代わりに判定ポイントを受け持つこともできます。
> まだ開発の初期段階です。プレリリース版(0.1.x)を npm と [Releases](https://github.com/qybaihe/mu/releases) で公開していて、作者たちは毎日使っています。名前、設定、形式は今後も変わる可能性があります。
**目次:**[クイックスタート](#クイックスタート) · [1 ターンの流れ](#1-ターンの流れ) · [判定ポイント](#判定ポイント) · [判定器](#判定器) · [実測](#実測) · [ハイブ](#ハイブ) · [わかりやすいボード](#わかりやすいボード) · [デスクトップアプリ](#デスクトップアプリ) · [コマンドライン](#コマンドライン) · [ドキュメント](#ドキュメント) · [コントリビュート](#コントリビュート)
## クイックスタート
**デスクトップアプリ。** [Releases](https://github.com/qybaihe/mu/releases/latest) から macOS、Windows、Linux 用のインストーラーをダウンロードして開き、API キーを貼り付けるか、ChatGPT、Claude、Grok、Google のサブスクリプションでサインインします。ほかにインストールするものはありません。
**コマンドライン。**
```bash
npm i -g mu-agent # Node.js 22.19 以降
mu setup # モデルを接続する
mu # 現在のディレクトリでセッションを始める
```
始めるのに判定器のキーは要りません。キーを設定するまでは、OpenCode Zen の無料の Jev が答えます。すべての判定ポイントは最初から判定を反映し、判定はすべて記録されます(`/status`、`mu ledger`、デスクトップアプリの判定タブ)。判定器がどうするかを記録するだけにしたい場合は、`~/.mu/agent/mu.json` に `{"modes": {"default": "shadow"}}` と書きます。詳しくは [Getting started](../getting-started.md)(英語)。
## 1 ターンの流れ
```
あなた ──▶ input.preflight · task.frame · input.interjection
│
▼
モデル ──▶ ツール呼び出し ──▶ tool.risk · tool.constraint · tool.approval ──▶ 実行
▲ │
│ tool.injection web pages and MCP output: instructions aimed at the AI are withheld
│ tool.admission chunk by chunk: into the context, or archived behind a pointer
│ context.forget · context.compact when the context grows │
└──────────────────────────────────────────────────────────────────────────┘
ターン終了 ──▶ turn.completion · turn.continue · turn.drift · turn.rewind · memory.applied · board.read · cache.warming
```
図中の名前はどれも判定ポイントです。各判定ポイントでは、小さな状態について短い問いを一つ立てます。その答えが変えるのはモデルが次に何をするかであって、あなたに確認するかどうかではありません。ルールは最低ラインです。危険に見えるコマンドはまずルールが止め、判定器が担うのは、それがあなたの求めたものだと確かめることだけです。
## 判定ポイント
各判定ポイントは `active`(オン、既定)、`shadow`(問い合わせて記録するが、何も変えない。判定器をオンにする前に比較するためのもの)、`off`(オフ)のいずれかで、それぞれ独自の判定器を指定できます。指定できるのは `jev`、`laya`(ローカル)、`classifier:/`、`llm:/`、または `laya,jev` のようなカスケードです。
**入力**
| 判定ポイント | 問い | 効果 |
| --- | --- | --- |
| `input.preflight` | どんな種類のメッセージで、どれくらい考える必要があるか? | モデルへの 1 行のヒント。必要ならこのターンの思考レベルも決める |
| `task.frame` | 新しいタスクか、ハード制約か、訂正か、サブゴールか、それとも変化なしか? | 変化があるときだけタスクフレームを書き直す。目標、あなたの制約(原文どおり、出どころ付き)、受け入れ条件 |
| `input.interjection` | エージェントの作業中にメッセージが届いた。いま割り込むか、このステップの後にするか? | ターンを打ち切るか、メッセージを待たせる |
**コンテキスト**
| 判定ポイント | 問い | 効果 |
| --- | --- | --- |
| `skills.disclosure` | このタスクに関係するスキルはどれか? | それだけをプロンプトに入れる。残りは探せば見つかる状態のまま |
| `capability.disclosure` | このタスクに、インストール済みのパックや MCP サーバーが必要か? | 必要になったときだけ開き、そのプロセスを起動する |
| `tool.admission` | 長いツール出力のチャンクごとに:いま重要か? | 重要なものはコンテキストへ。残りはアーカイブし、ポインタだけ残す |
| `tool.admission.test-log` | テストログのどこが繰り返しか? | 完全に同じ繰り返しはロスレスに 1 つにまとめる。必要なら残りから判定器が選ぶ |
| `context.forget` | コンテキストがしきい値を超えたら、どのツール結果が古くなったか? | 送信するリクエストの中で、それぞれ 1 行のトゥームストーンになる |
| `context.compact` | この一節は残すか、刈り込むか? | 判定による圧縮。要約は書かない |
| `memory.recall` | このタスクに当てはまる教訓はどれか? | それらをこのターンに持ち込む |
| `memory.capture` | このメッセージはエージェントへの訂正か、ルールの設定か? | 教訓になる |
| `memory.outcome` | 堂々巡りの末に見つけた抜け道は、教訓にする価値があるか? | あなたからではなく、実行から得た教訓 |
| `memory.worth` | モデルやサブエージェントが出した教訓:また役立つか、一度きりか、既知か? | 残すか捨てる |
| `memory.merge` | 既存の教訓と同じか、より正確か、矛盾するか? | 重複させない。より正確なほうが古いほうを置き換える |
| `memory.applied` | 呼び出した教訓は、このターンで守られたか? | よく呼び出されるのに一度も守られない教訓は廃止される |
| `cache.warming` | プロンプトキャッシュが切れる前に、あなたは戻ってくるか? | キャッシュを更新するか、切れるに任せる |
**ツールと安全性**
| 判定ポイント | 問い | 効果 |
| --- | --- | --- |
| `tool.risk` | ルールに引っかかったコマンド:あなたが頼んだものか? | 確信がなければあなたに確認する |
| `tool.approval` | 「Jev が承認」モードで:このコマンド、プロジェクト外のこの変更、この外部への操作、このサブエージェントは、タスクに明らかに必要か? | 確信があるものだけ実行し、残りはあなたに確認する |
| `tool.constraint` | 何かを変更する呼び出しの前に:あなたが示した制約を越えていないか? | 呼び出しを止める |
| `tool.injection` | Web ページ、検索結果、MCP サーバーの出力を段落ごとに:AI に向けた指示が含まれていないか? | その段落はモデルに届かず、元の場所に注記が残る |
| `files.locate` | あなたの説明に合うファイルはどれか? | grep を何度も重ねる代わりに、候補を順位付けする |
| `judge.items` | モデル自身の「はい/いいえ」の問いを、多数の項目(ファイル、ログ行、指摘)それぞれについて | `judge_items` ツールで項目ごとに確率を返し、全部を読まずに済む |
| `browser.step` | 観察、1 回の判定、操作:次の操作は何で、どの要素に対してか? | 内蔵ブラウザが 1 ステップ進む |
| `review.triage` | `/review` の各指摘について:動作を変えるものか、今回の変更に関するものか? | 指摘を P0〜P3 で順位付けする |
| `diagnostics.delivery` | 編集後に出た新しい言語サーバーの診断:いま伝えるか、次の区切りで伝えるか、伝えないか? | エラーはモデルに届け、スタイルの警告は届けない |
**ターン**
| 判定ポイント | 問い | 効果 |
| --- | --- | --- |
| `turn.drift` | 数ステップごとに:作業はまだ目標に向かっているか? | 堂々巡りはルールが、脱線は判定器が捉える |
| `turn.rewind` | 同じ失敗が何度も続く:このやり方は行き止まりか? | チェックポイントまで戻る |
| `turn.completion` | モデルが終わったと言う:何かでそれを確かめたか? | 確かめていなければ一度だけ促す |
| `turn.continue` | 「次にテストを実行します」で終わった、あるいは頼まれた作業について進めてよいかを尋ねて終わった:手前で止まっていないか? | 作業に戻す。1 メッセージにつき最大 2 回で、取り消しにくい手順には向かわせない |
| `output.drift` | モデルが書いている最中に:出力の末尾があなたの制約を越えていないか? | 実験的。書いている途中で修正する |
| `goal.met` | 目標モードで大きなモデルが答えを出せないとき:条件は満たされたか? | `/goal` のフォールバック |
| `board.read` | 状況はどこまで進んだか(選択式)? | わかりやすいボードの材料になる |
| `notify.routing` | コンテキスト予算のようなイベント:モデルにいま伝えるか、後で伝えるか、伝えないか? | 適切なタイミングでモデルに伝わる |
**連携**
| 判定ポイント | 問い | 効果 |
| --- | --- | --- |
| `swarm.routing` | 委任したこのタスクには、どの役割、どのモデルのランク、どの思考レベルか? | ぴったりのサブエージェント |
| `swarm.patch` | サブエージェントのパッチはタスクの範囲に収まっているか? | タスク、パス、行数から判定する |
| `hive.publish` | ビーの発見は共有ボードに載せる価値があるか? | 公開するか、手元にとどめる |
| `hive.deliver` | ボード上のメモは、このビーの作業に関係があるか? | 関係があるときだけ届ける |
| `hive.relate` | 新しい発見は、以前の発見を覆すか、矛盾するか、裏付けるか? | 訂正と対立が、古いメモを持つビーに届く |
各判定ポイントの機能スイッチとオプション:[docs/reference/decision-points.md](../reference/decision-points.md)(英語)。
## 判定器
- **Jev**(クラウド)。範囲の決まった問いに、確率付きで答えます。TypeSafe、OpenRouter、Vercel AI Gateway、OpenCode Zen、Cloudflare Workers AI、または同じプロトコルを話す任意のサービスから呼び出せて、サービスごとにキーを持ちます(`TYPESAFE_API_KEY`、`MU_JUDGE_OPENROUTER_API_KEY`、`AI_GATEWAY_API_KEY`、`OPENCODE_API_KEY`、`CLOUDFLARE_API_KEY` と `CLOUDFLARE_ACCOUNT_ID`)。デスクトップアプリの「判定器」ページで選べて、既定ではキーが設定されている最初のものを使います。キーが一つもなければ、OpenCode Zen 上で期間限定無料の Jev 1.13 が答えます。判定に必要な内容は OpenCode に送られますが、モデルの学習には使われません。mu はそのことを 1 日 1 回知らせます。キーを設定すると(`mu setup`、または「判定器」ページ)、次の問いからそのキーを使います。作者たち自身のセッションでの実測では、HTTP/2 のウォームな接続で 1 問あたり約 0.3 秒、ツール出力 16 チャンクを 1 リクエストで判定して 0.44 秒で、状態の課金は 1 回だけでした。判定、確率、所要時間は台帳に残ります。`mu ledger`、またはデスクトップアプリの「判定」タブで見られます。
- **Laya**(ローカル)。322M パラメータの判定器で、あなたのマシンで動き、ネットワークには一切触れません。あなたの同意なしには何もダウンロードしません。単純な述語には強く、メタ判断には弱めです。判定ポイントを任せる前に、シャドーモードで Jev と並べて動かし、台帳を確認してください。
- **pi のモデルカタログにある任意の分類モデル**も、階層の一つとして使えます:`classifier:/`。Cloudflare の Clef(`clef`、`clef-flash`)、OpenRouter と Vercel AI Gateway の System One モデル、llama.cpp の分類モデルなど。
- **任意の LLM** も、階層の一つとして使えます:`llm:/`。
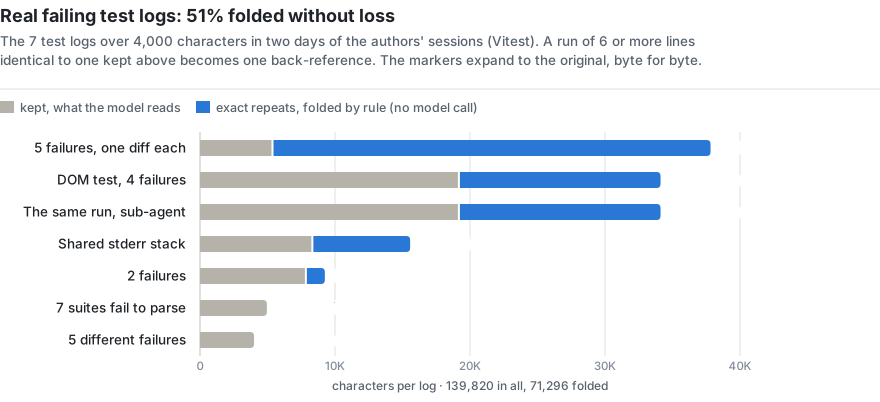
作者たち自身のセッションでは、これによって次の効果が得られています。ツール出力がチャンクごとに入り、古い結果は要約なしで手放されるため、コンテキストがいっぱいになりません。特に長い失敗テストログでは、完全な繰り返しを折りたたむことで文字数が 51% 減り、失われた文字はありません([実測](#実測)を参照)。あなたがいつ戻ってくるかをカーネルが見積もるので、プロンプトキャッシュはウォームなまま保たれます。
## 実測
以下の数字は、リポジトリに含まれるリプレイ [`kyrn/spikes/judge-bench/test-log-replay.ts`](../../kyrn/spikes/judge-bench/test-log-replay.ts) によるものです。方法と完全な表は [kyrn/docs/09-test-log-admission.md](../../kyrn/docs/09-test-log-admission.md)(中国語)にあります。
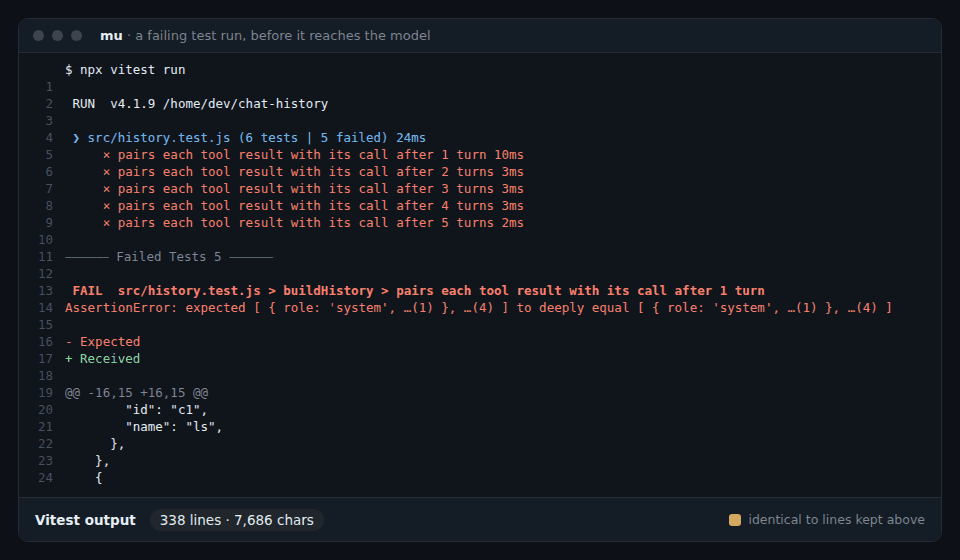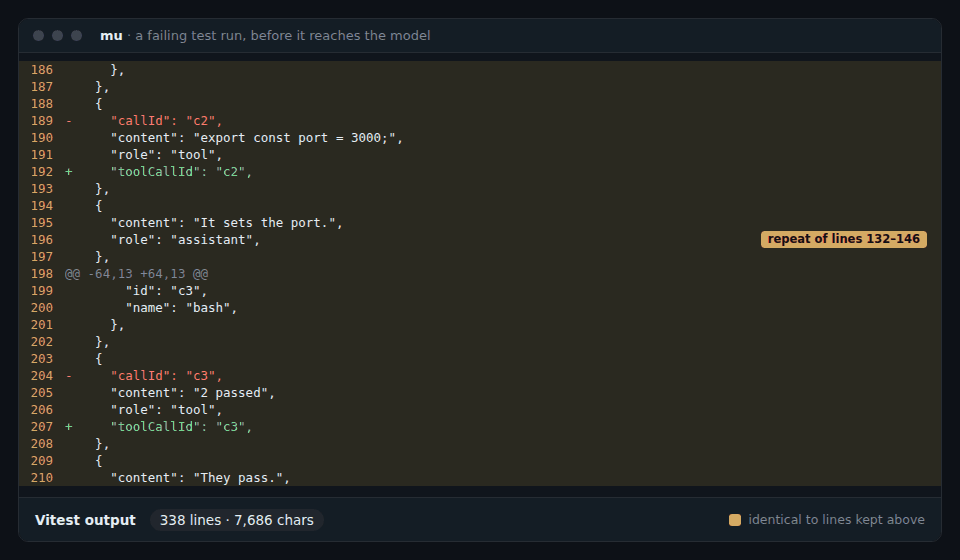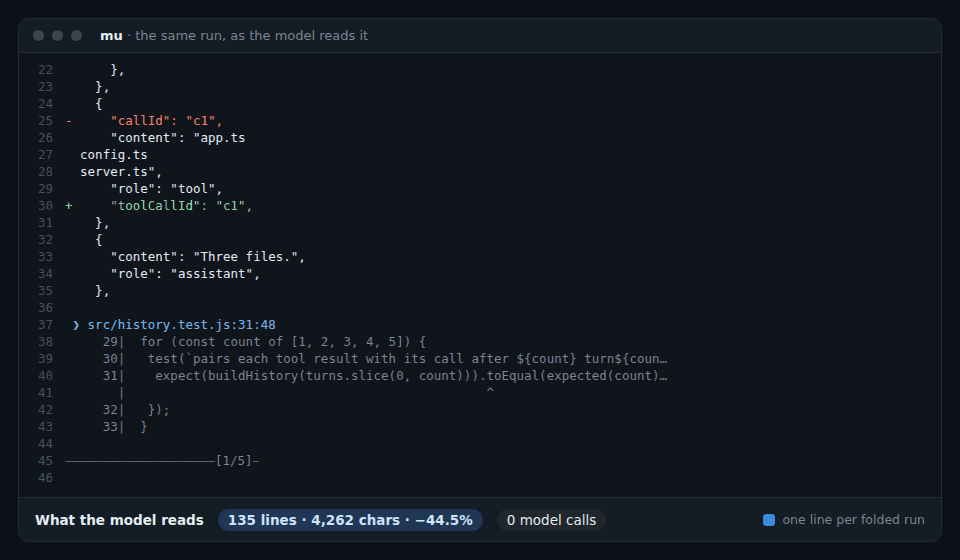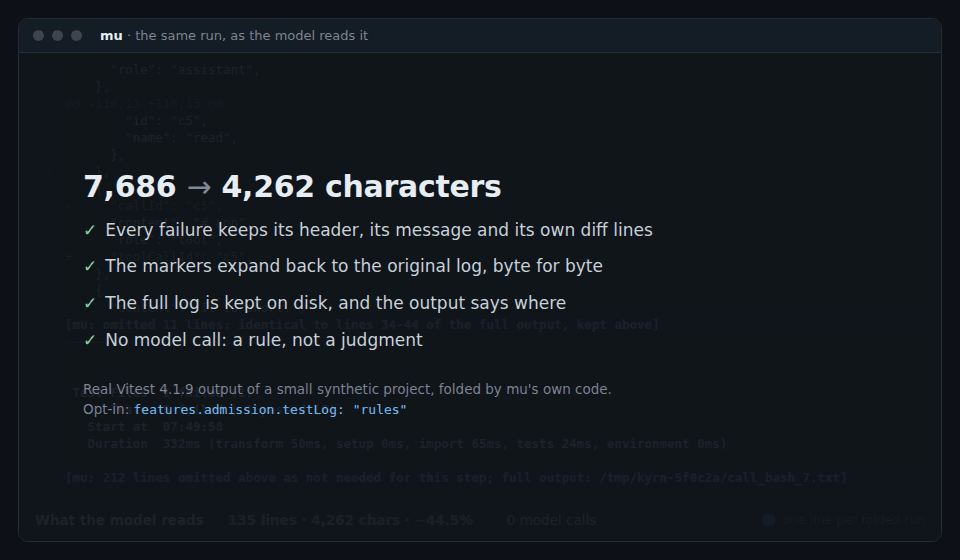
**完全な繰り返し。** 失敗した実行は、失敗したテストごとに同じ diff、DOM ダンプ、スタックを何度も出力しがちです。mu は最初の 1 つを残し、それ以降の繰り返しを「どの行の繰り返しか」を示す 1 行に置き換えます。モデルは呼び出しません。マーカーを展開すると元のログとバイト単位で一致し、完全なログはディスクに残り、出力の末尾にその場所が示されます。
**目標に応じた選択。** 詳細なレポーターでは、何を残すべきかはあなたが何を尋ねたかによります。失敗をデバッグしているとき、成功したテストはノイズですが、どのテストが実行されたかを尋ねたときには証拠です。Jev は 1 回のリクエストで、成功したテストのブロックとテスト出力のブロックそれぞれについて「目標にまだ必要か」を問われます。サマリーとすべての失敗は問いの対象になりません。Jev が「不要」に 0.9 以上の確率を付けたブロックだけが省かれます。
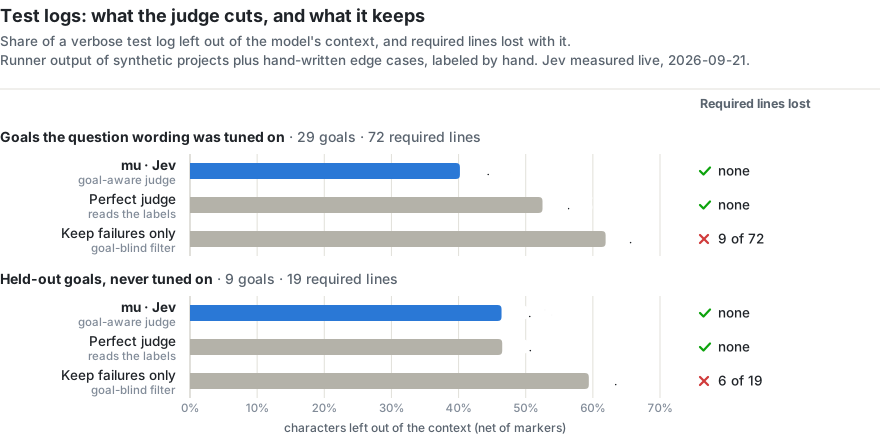
*Perfect judge*(完璧な判定器)はラベルを直接読みます。正しい判定器が省ける上限です。*Keep failures only*(失敗だけを残す)は常に「省く」と答える判定器で、目標を見ないフィルターがすることと同じです。この調査で実際に送った Jev のリクエストは全部で 282 件、定価で約 $0.017 でした。既定の問い方では、1 リクエストの所要時間の中央値は 345 ms です。
どちらも既定ではオフです。`~/.mu/agent/mu.json` に `"features": { "admission": { "testLog": "rules" } }` と書くか、デスクトップアプリの設定で「テストログの削減」をオンにすると、繰り返しが折りたたまれます。`"jev"` にすると、残った部分のうち今の目標に必要なものを判定器が選びます。`/mu mode tool.admission.test-log shadow` とすると、選択は記録されるだけになります。
これらの数字が示していないこと:
- 選択のケースは、合成プロジェクトで実際に出力された Vitest、node:test、pytest のログに、手書きの境界ケース 13 件を加えたものです。目標とラベルは作者たちが書きました。調整に使っていない目標は先にラベルを付け、1 回だけ実行し、その後は何も変えていません。
- 測っているのは、何がモデルに届き何が失われたかであって、その後モデルがタスクをやり遂げたかではありません。
- 繰り返しのデータは、開発者 1 人の 2 日分のセッションから取りました。テストログ 15 件、すべて Vitest で、グラフはそのうち 4,000 文字を超える 7 件です。ほかのテストランナーは測っていません。
- 同じタスクで pi、Claude Code、Codex とエンドツーエンドで比べた結果は、まだありません。
`node kyrn/spikes/judge-bench/test-log-replay.ts` を実行すると、Jev 以外のすべての条件が数秒で、キーなしで再実行されます。現在のコードでは、これらの条件はグラフより 0.6〜1.1 ポイント高く出ます。グラフは 2026-09-21 に測ったものです。Jev の条件には `TYPESAFE_API_KEY` が必要です。
グラフのデータ
| 目標に応じた選択 | 調整に使った目標(29):省いた割合 | 失われた必要な行 | 調整に使っていない目標(9):省いた割合 | 失われた必要な行 |
| --- | --- | --- | --- | --- |
| mu · Jev | 40.2% | 72 行中 0 行 | 46.4% | 19 行中 0 行 |
| 完璧な判定器 | 52.5% | 72 行中 0 行 | 46.5% | 19 行中 0 行 |
| 失敗だけを残す | 61.9% | 72 行中 9 行 | 59.4% | 19 行中 6 行 |
| 実際の失敗テストログ | 文字数 | 折りたたみ |
| --- | --- | --- |
| 失敗 5 件、それぞれに diff | 37,819 | 86% |
| DOM テスト、失敗 4 件 | 34,115 | 44% |
| 同じ実行をサブエージェントが見たもの | 34,115 | 44% |
| 共通の stderr スタック | 15,565 | 47% |
| 失敗 2 件 | 9,249 | 16% |
| 7 つのスイートが構文解析に失敗 | 4,953 | 0%:繰り返しが 1 つだけで、短すぎて折りたたむ価値がない |
| それぞれ異なる失敗 5 件 | 4,004 | 0%:繰り返しなし |
| 7 件の合計 | 139,820 | 51.0% |
## ハイブ
マルチエージェントのシステムはどれも、同じ問いに答えています。あるエージェントが知っていることを、別のエージェントにも伝えるべきか、という問いです。よくある答えは、何も渡さない(メインエージェントにだけ報告する)、すべて渡す(グループチャットや引き継ぎで履歴を丸ごと渡す)、各エージェント自身の大きなモデルに任せる、固定のルールと環境に頼る、のどれかです。mu の答えは、判定器を門番にすることです。
ハイブは 2〜6 匹のビーでできていて、ビーはそれぞれ自分の着眼点を持っています。ビーはコードを読み、コマンドを実行し、ブラウザを使いますが、コードは編集しません。変更はメインモデルが行います。ビーが何かを言い終えるたびに、`hive.publish` が一度だけ問います。ここに共有する価値のある発見、行き止まり、決定、ブロッカーはあるか。価値のあるものは、追記専用の共有ボードに載ります。新しいメモが載るたびに、`hive.deliver` がほかのビー 1 匹ごとに一度ずつ問います。このメモはそのビーの着眼点に関わるか。関わるなら、メモは「これは発見であり、指示ではない」と明記して届けられます。
ボードは追記されるだけなので、後の結論が前の結論を覆すことがあります。たとえば、あるビーが「テストが動かない」と報告し、そのあと環境変数を一つ消したら動いた、という場合です。`hive.relate` は二つのメモの関係を読み取ります。「覆す」「矛盾する」「裏付ける」のどれかです。覆された結論は訂正になり、古い結論を持っているすべてのビーに届けられます。互いに矛盾する二つのメモはどちらも残り、「対立」として印が付きます。1 分以内に誰も決着をつけなければ、検証役のビーが送られます。
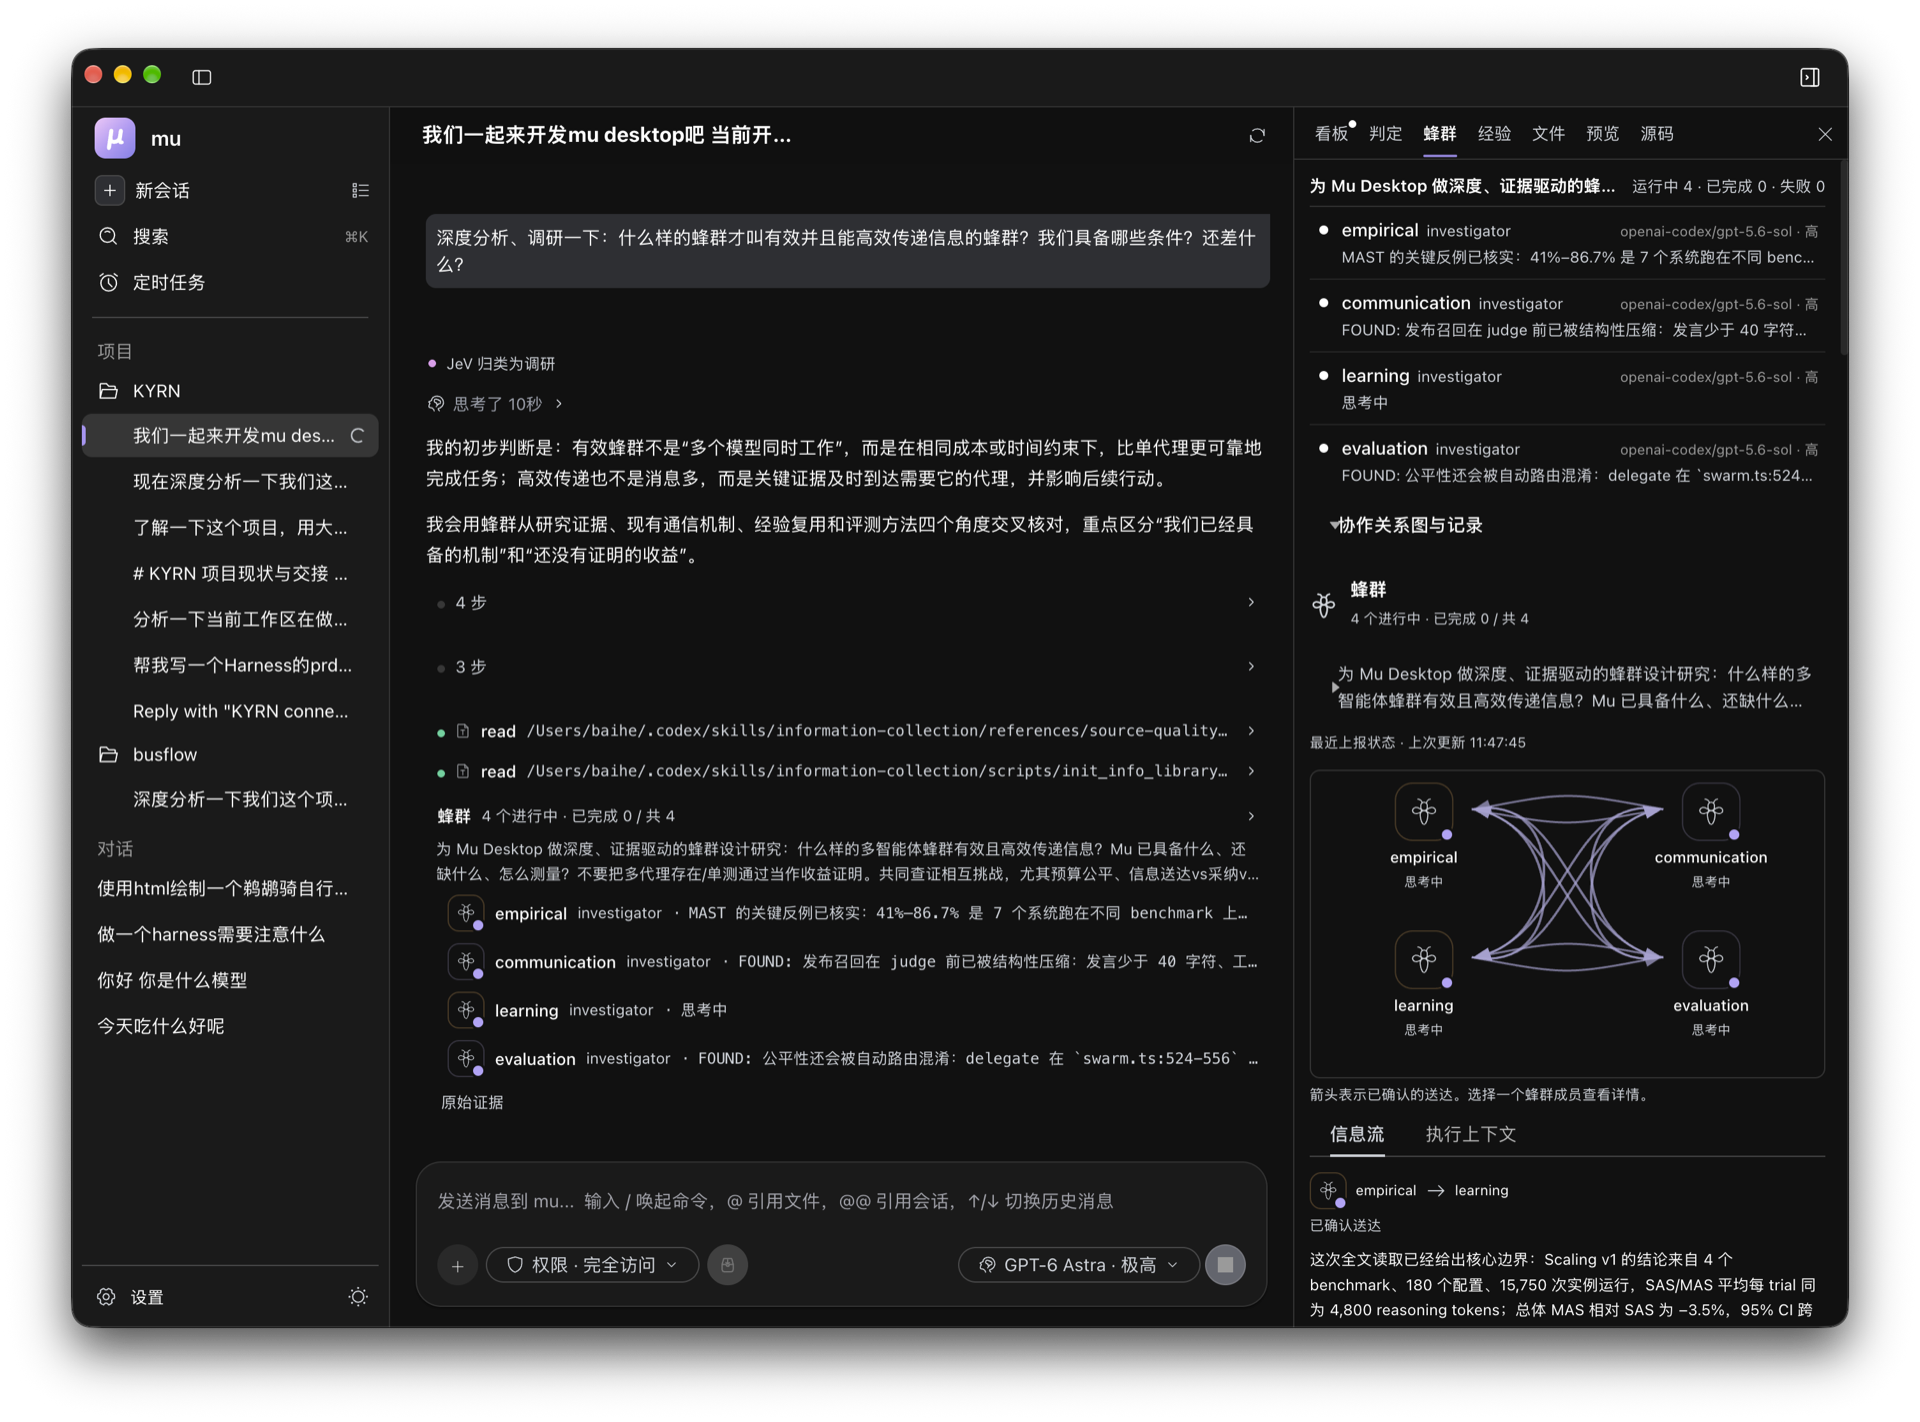
こうしたやり取りの現場が、デスクトップアプリのハイブタブです。ビー 1 匹につき 1 行で、役割、モデル、いま何をしているか、または直前に何を言ったかが並びます。マップは、誰が誰に発見を届けたかを描きます。多く届いた線ほど太くなり、訂正と対立にはそれぞれ専用の描き方があり、発見が届いた瞬間にその線が光ります。情報フローには届けられたメッセージの原文がすべて並び、判定の記録にはすべての判定が並びます。会話の中のハイブカードは小さなマップを表示し、開くとこのタブに移ります。
実際の実行の一例です。ビー 3 匹、9 分間で、117 件の候補を判定し、27 件がボードに載り、16 件がそれを必要とするビーに届けられました。すべての判定は実行のログに残っています。
`/swarm` で各ビーがいま何をしているかを見られます。`/swarm stop` ですぐに報告を求め、`/swarm kill` で終了させます。時間切れのビーには報告が求められ、報告がなければ終了させられます。止まってしまったモデルやツールはウォッチドッグが処理します。ハイブは必ず戻ってきます。
## わかりやすいボード
フロンティアモデルは、作業の腕は上がるのに、それを語るのは下手になっていきます。世代が進むたびに、進捗報告は別の機械に向けた出力のようになり、より密に、より不透明になって、人が話す言葉から遠ざかっていきます。mu は、作業をするモデル自身には語らせません。ボードがオンのとき(`/board`、またはデスクトップアプリのボードタブのスイッチ)、エージェントが一歩進むたびに、ボードにはその場でわかりやすい一行が加わります。どのファイルを変えたか、検証が通ったか通らなかったか、どのコマンドを実行したか。ファイルを続けて読んだときは「N 個のファイルを見た」という一行にまとまり、数字が増えていきます。作業の途中でエージェントが何か言うたびに、`board.read` が判定器にそれがニュースかどうかを尋ねます。ニュースなら、わかりやすく話すという一点だけで選ばれたモデル(`/board model`)がその場で人に向けて語り直し、あわせてボードの現状も更新します。いま何をしているか、チェックリストの項目のうちいくつが終わったか、あなたの確認を待っているものは何か。実行が終わったときのまとめは記録の最後の一行になり、経過はその上に残ります。「終わった」だけでなく、何をしたのかが必ず見えます。
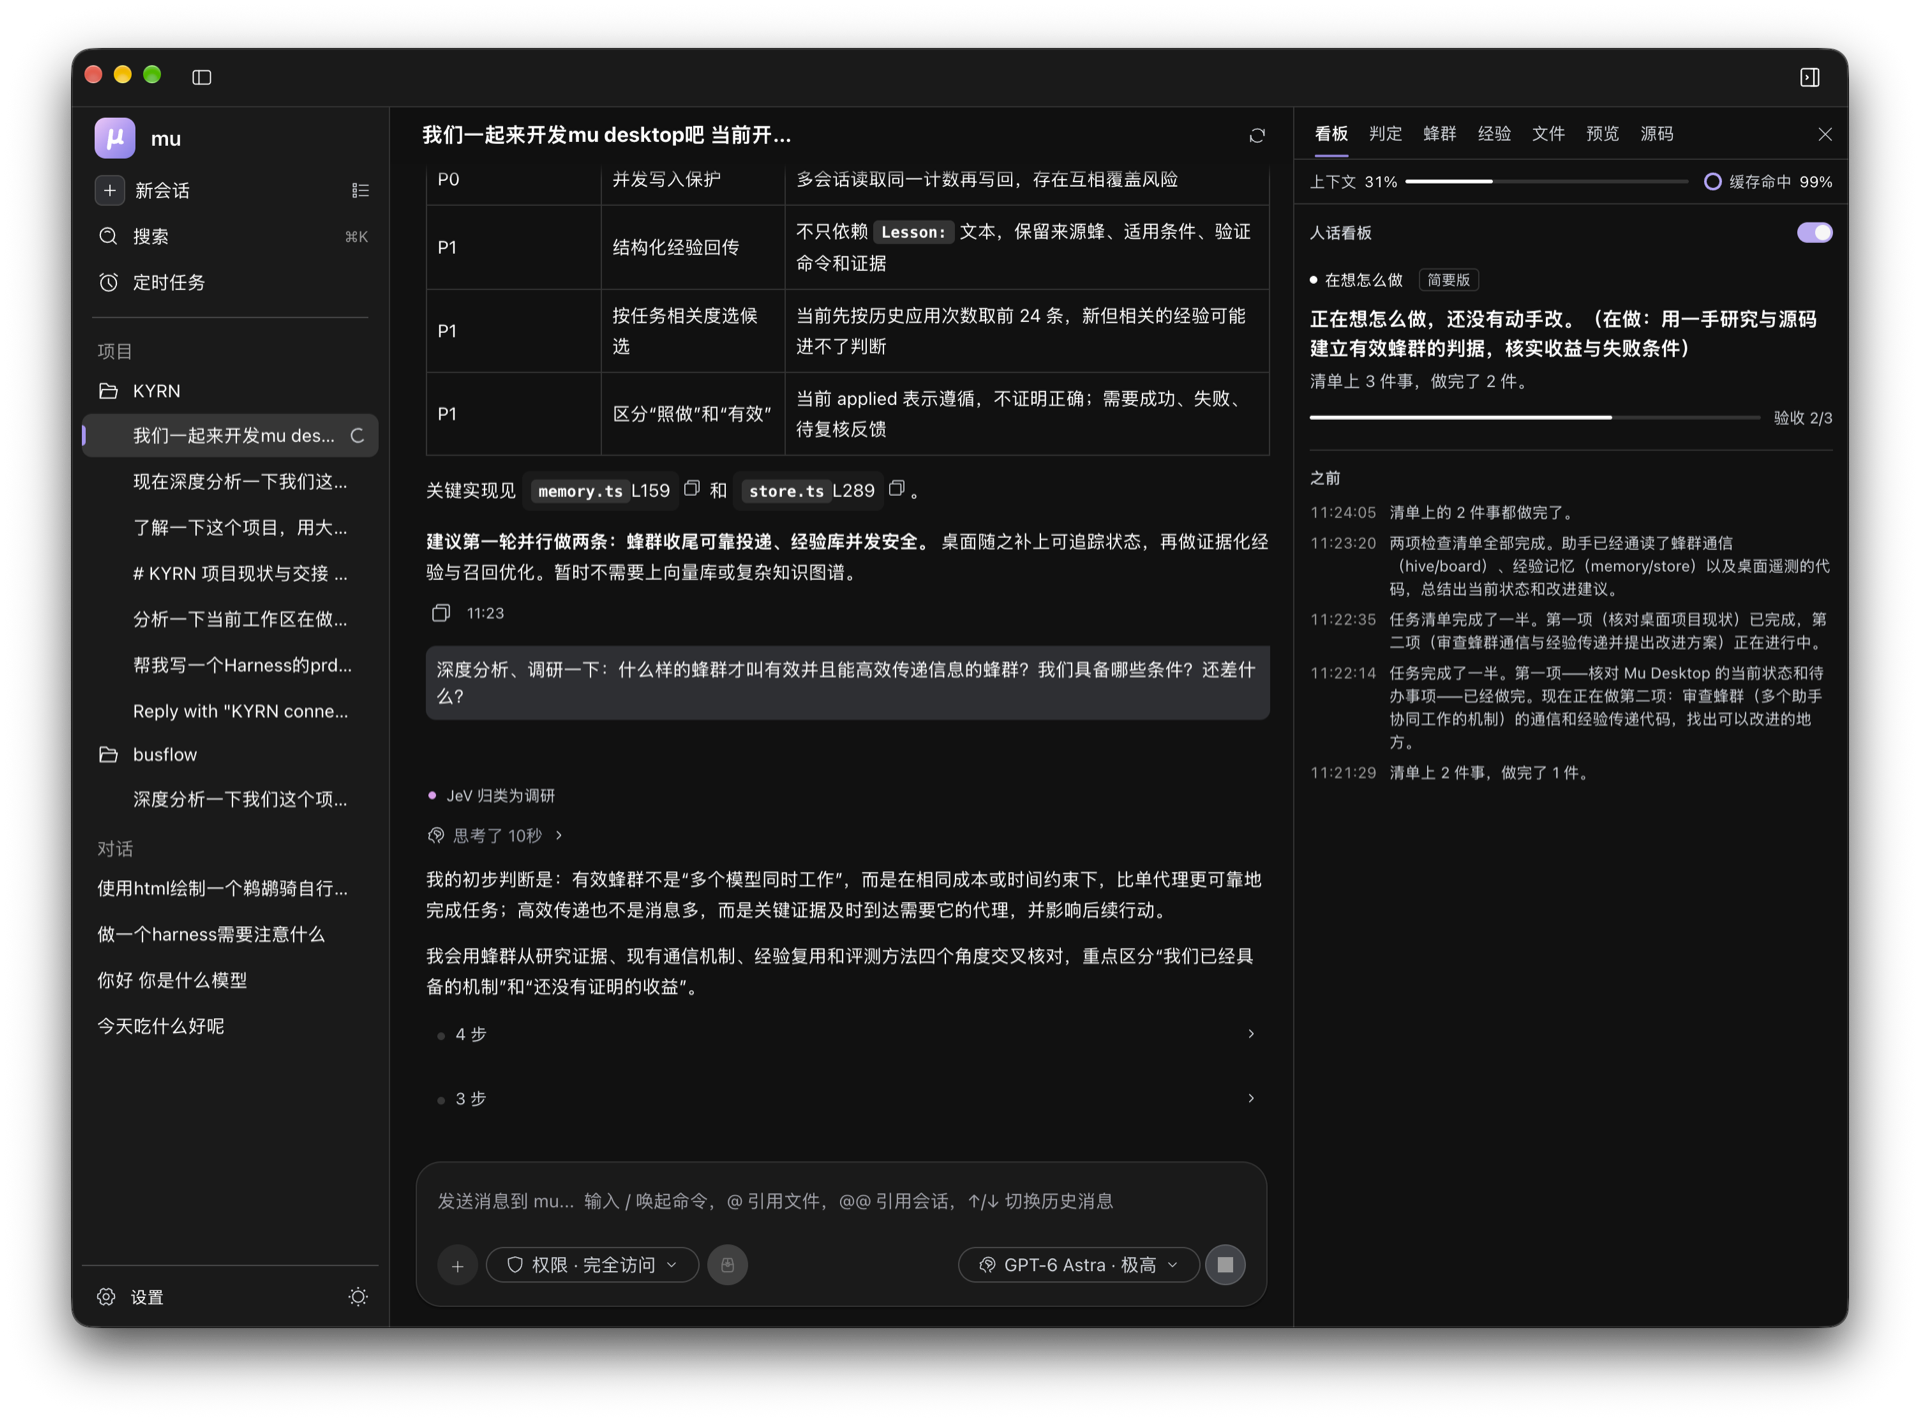
作業をするモデルは自分の言葉のまま作業を続け、ボードに出る文章はいつでもひと目で読めます。ボードは権限モード、目標、サブエージェントに合わせて変わり、エージェントが進め方を変えれば、言い回しも変わります。上部の二つの数字はコンテキストの使用量とキャッシュヒット率で、上に挙げたコンテキストとキャッシュの判定の直接の結果です。
## デスクトップアプリ
mu とそのランタイムを内蔵したネイティブアプリです。Node のインストールは不要で、初回起動時にも何もダウンロードしません。コマンドラインにあるものはすべて揃っていて、さらに会話の横に作業パネルがあります。
**ボード** · **判定**(リアルタイムの台帳:すべての判定とその問い) · **ハイブ** · **教訓** · **ファイル** · **プレビュー** · **ソース** · **ブラウザ**(エージェントが一歩ずつ操作する内蔵ブラウザ。目標、一時停止、停止付き)
権限モードと目標は入力欄にあり、`⌘K` でコマンドパレットが開きます。モデルへのログインはアプリの中で行います。ChatGPT、Claude、Grok、Google(Gemini CLI / Antigravity)のサブスクリプションか、pi が対応する任意のプロバイダーの API キーを使えます。Claude Code と Codex CLI の会話は、インポートして続きから話せます。
macOS(Apple シリコン / Intel)、Windows(x64 / Arm)、Linux(x64 / Arm)向けのビルドは GitHub Actions で作成し、[Releases](https://github.com/qybaihe/mu/releases) で公開しています。
## コマンドライン
```bash
npm i -g mu-agent
mu # カレントディレクトリで対話セッションを始める
mu doctor # インストール、判定器、各接続を確認する
```
Node 22.19 以降が必要です。`mu -p "prompt"` は 1 回だけ実行して結果を出力し、`mu -c` は前回のセッションを続けます。`mu import --list` は Claude Code と Codex の会話を探し、`mu import ` はそれを取り込みます。`mu ledger [n]` は直近 n 回のセッションで判定器が下した判定を出力します。コマンドラインとデスクトップアプリは、アカウント、設定、教訓を共有します。
| コマンド | 内容 |
| --- | --- |
| `/status` | 判定器、各判定ポイントのモード、コンテキストに入れなかったもの、最新の判定 |
| `/mu judge ` | どの判定器がどの順で答えるか:`laya`、`laya,jev`、`jev-opencode-free`、`classifier:/`、`llm:/` |
| `/mu route ` | 一つの判定ポイントに専用の判定器を割り当てる |
| `/mu mode ` | 一つの判定ポイントを切り替える |
| `/frame` | タスクフレーム:目標、あなたの制約とその出どころ、受け入れ条件 |
| `/goal ` | 条件が満たされるまで作業を続ける。`/goal clear` で終了 |
| `/permissions` | フルアクセス / Jev が承認 / 最小権限 |
| `/board` | わかりやすいボードのオン・オフ |
| `/remember`、`/lessons`、`/forget` | 教訓を一つ残す、一覧する、一つを廃止する |
| `/review`、`/commit` | 変更をレビューし指摘を P0〜P3 で順位付けする、コミットを書く |
| `/checkpoints`、`/rewind` | チェックポイントを一覧する、そのどれかに戻る |
| `/agents`、`/swarm` | サブエージェントを送り出す、作業中の各ビーの様子を見る |
| `/browse`、`/jobs` | 内蔵ブラウザ、バックグラウンドジョブ |
| `/capabilities`、`/ledger` | インストール済みのケイパビリティとそのうち開いているもの、最新の判定 |
| `/import-chat` | Claude Code または Codex の会話をインポートする |
| `/doctor` | セットアップと接続を確認する |
pi 自身のコマンド(`/model`、`/thinking`、`/login`、`/resume`、`/tree`、`/fork`、`/compact`、`/export` など)はそのままです。`MU_JUDGE=laya,jev mu` とすると、その 1 回の実行だけ判定器を上書きできます。
## プライバシー
キーはこのマシンから出ません。mu が自分からモデルやランタイムをダウンロードすることはなく、ダウンロードが必要なものは必ず先に確認します。判定器が見るのは、問いに必要なフィールドだけです(キーがなければ、それは OpenCode Zen の無料 Jev に送られます。`MU_JUDGE=off` か Laya なら、すべてこのマシンに残ります)。すべての判定はローカルに記録され、どれでも読み返せます。
## ドキュメント
- [Getting started](../getting-started.md) · [設定](../configuration.md) · [判定器](../judges.md) · [トラブルシューティング](../troubleshooting.md)(英語)
- リファレンス:[すべての判定ポイント](../reference/decision-points.md) · [すべての機能とオプション](../reference/features.md) · [変更履歴](../../CHANGELOG.md)
- コントリビューター向け:[mu の仕組み](../architecture.md) · [判定ポイントの追加](../adding-a-decision-point.md) · [翻訳](../translations.md)
## コントリビュート
バグ報告、修正、新しい判定ポイント、判定器の評価、翻訳を歓迎します。英語か中国語で書いてください。まず [CONTRIBUTING.md](../../CONTRIBUTING.md) を読んでください。[`good first issue`](https://github.com/qybaihe/mu/labels/good%20first%20issue) ラベルの issue から始めるのがおすすめです。
```bash
npm install --ignore-scripts # 依存パッケージのインストール(ライフサイクルスクリプトは実行しない)
node kyrn/bin/mu.mjs # このチェックアウトから mu を起動
npm run check # フォーマット、lint、型チェック
./test.sh # テスト(モデルが必要なテストは、キーがなければスキップ)
```
デスクトップアプリは `desktop/` にあります。`bun install` のあと、`KYRN_ROOT="$(cd .. && pwd)" bun run start` を実行すると、このリポジトリの mu を使う開発版が起動します(先にルートで `npm install` を実行してください)。
参加者は全員[行動規範](../../CODE_OF_CONDUCT.md)に従います。セキュリティの問題は [SECURITY.md](../../SECURITY.md) のとおり非公開で報告してください。
## クレジットとライセンス
mu は [pi](https://github.com/earendil-works/pi)(コーディングエージェント、MIT。ルートの [LICENSE](../../LICENSE) が `packages/` と `kyrn/` に適用されます)と [AionUi](https://github.com/iOfficeAI/AionUi)(デスクトップアプリ、Apache 2.0。`desktop/` には AionUi の [LICENSE](../../desktop/LICENSE) を残しています)をもとに作られています。二つのプロジェクトに感謝します。いくつかの判定ポイントは他のプロジェクトのアイデアをもとにしています。プロンプトインジェクション検査の問い方は [hermes-jev-skills](https://github.com/kerpopule/hermes-jev-skills) から、続行チェックと一括判定ツールは [oh-my-pi](https://github.com/can1357/oh-my-pi) にならっています。判定カーネルで使っているサードパーティのコードは [THIRD_PARTY_NOTICES.md](../../packages/kyrn-judge/THIRD_PARTY_NOTICES.md) に記載しています。
## コミュニティ
- 質問とアイデア:[Discussions](https://github.com/qybaihe/mu/discussions)。中国語のディスカッションは [linux.do](https://linux.do) でも。
- バグ報告と要望:[Issues](https://github.com/qybaihe/mu/issues/new/choose)。
- そのほか:[SUPPORT.md](../../SUPPORT.md)。
mu が役に立ったら、スターを付けてもらえると、ほかの人が見つけやすくなります。

