mu
μ · Only what's needed.
带判定内核的编码代理。基于 pi。




English · 简体中文 · 繁體中文 · 日本語 · 한국어
一个编码代理每次会话要做几百个和代码无关的决定:什么留在上下文里,一条命令安不安全,一个发现值不值得告诉另一个代理,活干完了没有。交给大模型,花的是 token、延迟和注意力;交给死规则,错得太多。mu 把它们交给一个**判定器**:一个小而快的模型,每次只回答一个有边界的问题,每一轮有 38 个判定点。大模型把注意力留给正事。
- **mu**:命令行。pi 的全部能力,加上判定内核。
- **mu 桌面端**:原生应用,自带 mu 和运行时。下载,接一个模型,开始。
- **Jev**:判定器。是非题、选择题、打分题,每个答案带概率,每一次判定都进流水。本地判定器(Laya)或任何一个大模型都可以接管某个判定点。
> 还在早期开发。预发布版(0.1.x)在 npm 和 [Releases](https://github.com/qybaihe/mu/releases) 上,作者每天在用。名字、设置和格式都可能变。
**目录:**[快速开始](#快速开始) · [一轮是怎么走的](#一轮是怎么走的) · [判定点](#判定点) · [判定器](#判定器) · [实测](#实测) · [蜂群](#蜂群) · [人话看板](#人话看板) · [桌面端](#桌面端) · [命令行](#命令行) · [文档](#文档) · [参与贡献](#参与贡献)
## 快速开始
**桌面端。** 从 [Releases](https://github.com/qybaihe/mu/releases/latest) 下载 macOS、Windows 或 Linux 安装包,打开后粘贴一个 API key,或用 ChatGPT、Claude、Grok、Google 订阅登录。不用再装别的。
**命令行。**
```bash
npm i -g mu-agent # Node.js 22.19 或更新
mu setup # 接入一个模型
mu # 在当前目录开一个会话
```
开始用不需要判定器的 key:没设置之前,由 OpenCode Zen 上免费的 Jev 回答。所有判定点一开始就生效,每次判定都会记录下来(`/status`、`mu ledger`、桌面端的判定页)。如果只想记录判定器会怎么做、不改变行为,在 `~/.mu/agent/mu.json` 里写 `{"modes": {"default": "shadow"}}`。更多见 [Getting started](../getting-started.md)(英文)。
## 一轮是怎么走的
```
你 ──▶ input.preflight · task.frame · input.interjection
│
▼
模型 ──▶ 工具调用 ──▶ tool.risk · tool.constraint · tool.approval ──▶ 执行
▲ │
│ tool.injection 网页和 MCP 输出:冲着 AI 来的指令被拦下
│ tool.admission 逐块判:进上下文,还是归档、留一个指针
│ context.forget · context.compact 上下文变长时 │
└──────────────────────────────────────────────────────────────────┘
一轮结束 ──▶ turn.completion · turn.continue · turn.drift · turn.rewind · memory.applied · board.read · cache.warming
```
每个名字都是一个判定点。每个判定点是一个关于一小段状态的短问题;答案改变模型接下来做什么,从不改变它要不要问你。规则是底线:看起来危险的命令先由规则拦下,判定器只负责确认这是你要的。
## 判定点
每个判定点可以是 `active`(生效,默认)、`shadow`(照常提问并记录,但不改变任何行为,用来在切换前比较判定器)或 `off`(关闭),并且可以指定自己的判定器:`jev`、`laya`(本地)、`classifier:<提供商>/<模型>`、`llm:<提供商>/<模型>`,或 `laya,jev` 这样的级联。
**输入**
| 判定点 | 问题 | 效果 |
| --- | --- | --- |
| `input.preflight` | 这条消息是什么类型,需要多深的思考? | 给模型一行提示;可选地设定这一轮的思考级别 |
| `task.frame` | 新任务、硬约束、纠正、子目标,还是没有变化? | 只有变化才重写任务帧:目标、你的约束原话及其出处、验收条件 |
| `input.interjection` | 代理正在干活时来了一条消息:现在打断,还是这一步之后? | 这一轮被截断,或消息等一等 |
**上下文**
| 判定点 | 问题 | 效果 |
| --- | --- | --- |
| `skills.disclosure` | 哪些技能和这个任务有关? | 只有它们进提示词;其余仍可查到 |
| `capability.disclosure` | 这个任务需要某个已安装的能力包或 MCP 服务器吗? | 需要时才打开、才启动它的进程 |
| `tool.admission` | 一段长工具输出的每一块:现在重要吗? | 重要的进上下文;其余归档,留一个指针 |
| `tool.admission.test-log` | 测试日志里哪些是重复? | 完全相同的重复只留一份,无损;可选地由判定器从剩下的里挑 |
| `context.forget` | 上下文超过阈值后,哪些工具结果已经过期? | 每一条在外发请求里变成一行墓碑 |
| `context.compact` | 这一段留还是删? | 按判定压缩;不写摘要 |
| `memory.recall` | 哪些经验适用于这个任务? | 带进这一轮 |
| `memory.capture` | 这条消息是在纠正代理,还是在立一条规矩? | 变成一条经验 |
| `memory.outcome` | 绕了圈子之后,最后走通的那条路值得记吗? | 从运行里学来的经验,不是你教的 |
| `memory.worth` | 模型或子代理提出的一条经验:以后还用得上、一次性的,还是早就知道? | 留下或丢掉 |
| `memory.merge` | 和已有的经验是同一条、更精确,还是矛盾? | 不重复记;更精确的替换旧的 |
| `memory.applied` | 这一轮召回的经验照做了吗? | 常被召回却从不照做的经验自动退役 |
| `cache.warming` | 提示缓存过期之前你会回来吗? | 续一次缓存,或任它过期 |
**工具与安全**
| 判定点 | 问题 | 效果 |
| --- | --- | --- |
| `tool.risk` | 一条被规则标记的命令:是你要的吗? | 拿不准就问你 |
| `tool.approval` | 在「Jev 审批」模式下:这条命令、这个项目外的改动、这个对外动作、这个子代理,任务明确需要吗? | 确定需要的直接过;其余问你 |
| `tool.constraint` | 在一个会改变东西的调用之前:它越过了你定下的约束吗? | 调用被拦下 |
| `tool.injection` | 网页、搜索结果或 MCP 服务器的输出,一段一段看:里面有没有冲着 AI 来的指令? | 这些段落不会到达模型,原处留一条说明 |
| `files.locate` | 哪些文件符合你的描述? | 给候选文件排序,代替一串 grep |
| `judge.items` | 模型自己提的一个是非题,对很多项逐项问:文件、日志行、审查发现 | 通过 `judge_items` 工具,每项得到一个概率,不用一项项读 |
| `browser.step` | 观察、判一次、动手:下一步操作是什么,作用在哪个元素上? | 内置浏览器走一步 |
| `review.triage` | `/review` 的每条发现:会改变程序行为吗,是关于这次改动的吗? | 按 P0 到 P3 分级 |
| `diagnostics.delivery` | 一次编辑后新的语言服务器诊断:现在说,下次停顿时说,还是不说? | 错误送到模型;风格警告不送 |
**回合**
| 判定点 | 问题 | 效果 |
| --- | --- | --- |
| `turn.drift` | 每隔几步:工作还在为目标服务吗? | 规则抓绕圈子,判定器抓跑偏 |
| `turn.rewind` | 同一个失败一次又一次:这条路是死路吗? | 退回到某个检查点 |
| `turn.completion` | 模型说做完了:有什么东西验证过吗? | 没有就提醒一次 |
| `turn.continue` | 一轮停在「接下来我跑一下测试」,或者在你已经要它做的事上问「要我动手吗」:是不是没做完就停了? | 让它接着做,每条消息最多两次;难以撤销的一步不会推它去做 |
| `output.drift` | 模型正在写的时候:输出的末尾越过了你的约束吗? | 实验性;边写边纠正 |
| `goal.met` | 目标模式下大模型给不出答案时:条件成立了吗? | `/goal` 的兜底 |
| `board.read` | 事情做到哪了,选择题? | 供人话看板使用 |
| `notify.routing` | 上下文预算之类的事件:现在告诉模型,晚点,还是不说? | 模型在合适的时候被告知 |
**协作**
| 判定点 | 问题 | 效果 |
| --- | --- | --- |
| `swarm.routing` | 这个委派出去的任务,用哪个角色、哪一档模型、多深的思考? | 合适的子代理 |
| `swarm.patch` | 子代理交回的补丁留在任务范围内吗? | 从任务、路径和行数来判 |
| `hive.publish` | 一只 bee 的发现值得上共享板吗? | 发布,或自己留着 |
| `hive.deliver` | 板上的一条笔记和这只 bee 的工作有关吗? | 有关才投递 |
| `hive.relate` | 一条新发现推翻、矛盾还是支持了早先的某一条? | 纠正和争议送到拿着旧笔记的 bee 那里 |
每个判定点对应的功能开关和选项:[docs/reference/decision-points.md](../reference/decision-points.md)(英文)。
## 判定器
- **Jev**(云端)。有边界的问题,答案带概率。可以经 TypeSafe、OpenRouter、Vercel AI Gateway、OpenCode Zen、Cloudflare Workers AI,或任何支持同一协议的服务调用,每个服务有自己的密钥(`TYPESAFE_API_KEY`、`MU_JUDGE_OPENROUTER_API_KEY`、`AI_GATEWAY_API_KEY`、`OPENCODE_API_KEY`、`CLOUDFLARE_API_KEY` 加 `CLOUDFLARE_ACCOUNT_ID`):在桌面端的「判定器」页选一个,默认用第一个设置了密钥的。一个密钥都没有时,默认由 OpenCode Zen 上限时免费的 Jev 1.13 回答:判定要读的内容会发给 OpenCode,它不拿来训练模型,mu 每天提示一次。配上密钥(`mu setup`,或「判定器」页)后,下一个问题起就用你的密钥。在作者自己的会话里实测:HTTP/2 上一个热连接的问题约 0.3 秒;16 块工具输出并成一个请求判完 0.44 秒,状态只计费一次。判定、概率和耗时都进流水:`mu ledger`,或桌面端的「判定」页。
- **Laya**(本地)。一个 3.22 亿参数的判定器,在你的机器上跑,不走网络。未经你同意不下载任何东西。简单谓词上可靠,元判断上偏弱:先让它以影子模式和 Jev 并行跑,看过流水再把判定点交给它。
- **pi 模型目录里的任何分类模型**,作为一级:`classifier:<提供商>/<模型>`。比如 Cloudflare 的 Clef(`clef`、`clef-flash`)、OpenRouter 和 Vercel AI Gateway 上的 System One 模型、llama.cpp 的分类模型。
- **任何大模型**,作为一级:`llm:<提供商>/<模型>`。
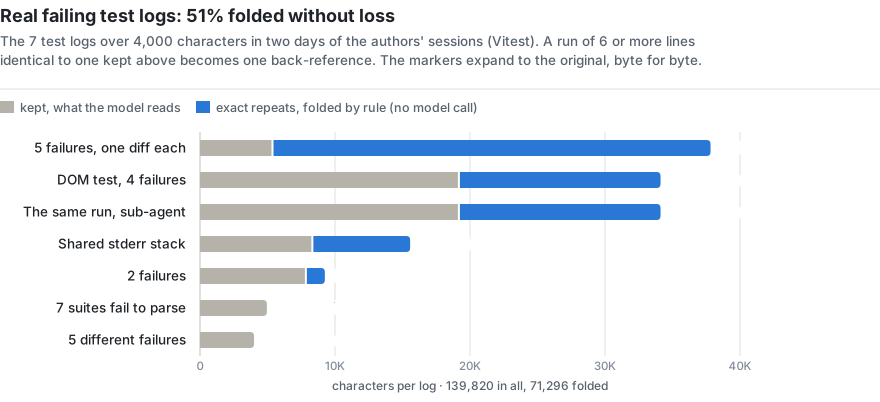
这换来什么,以作者自己的会话为准:上下文从不填满,因为工具输出逐块进入、过期结果不写摘要直接放下;最长的几份失败测试日志里,折叠完全相同的重复省下 51% 的字符,一个字符也没丢(见[实测](#实测));提示缓存保持热的,因为内核会猜你什么时候回来。
## 实测
下面的数字来自仓库自带的回放脚本 [`kyrn/spikes/judge-bench/test-log-replay.ts`](../../kyrn/spikes/judge-bench/test-log-replay.ts)。方法和完整表格见 [kyrn/docs/09-test-log-admission.md](../../kyrn/docs/09-test-log-admission.md)。
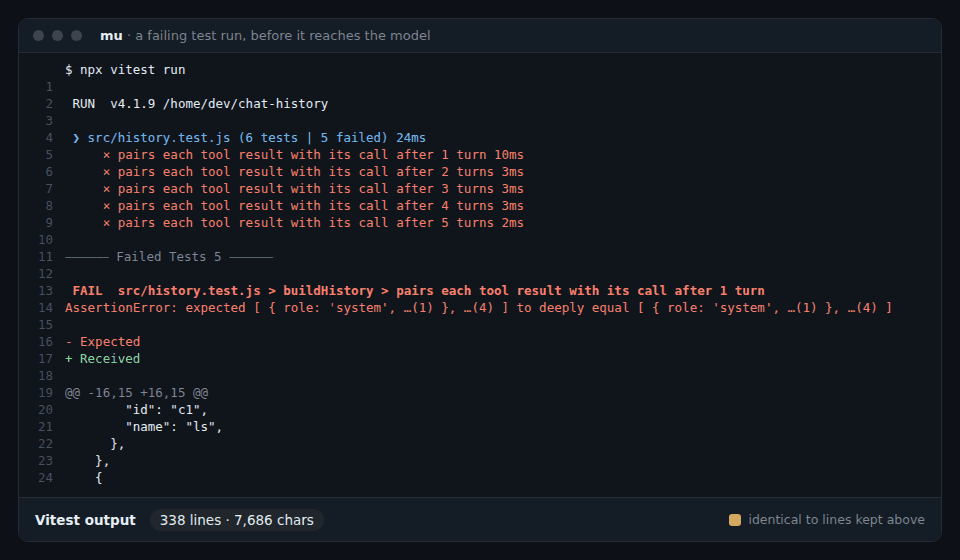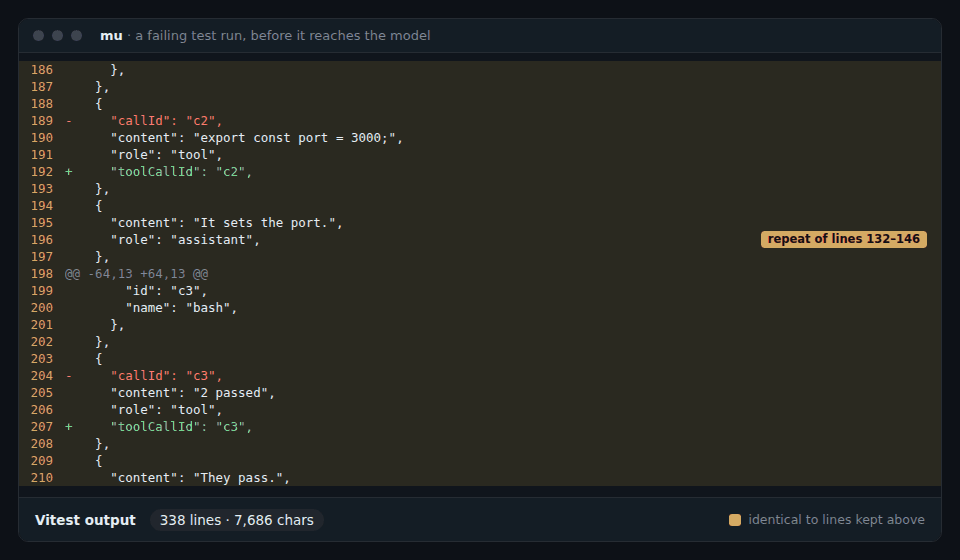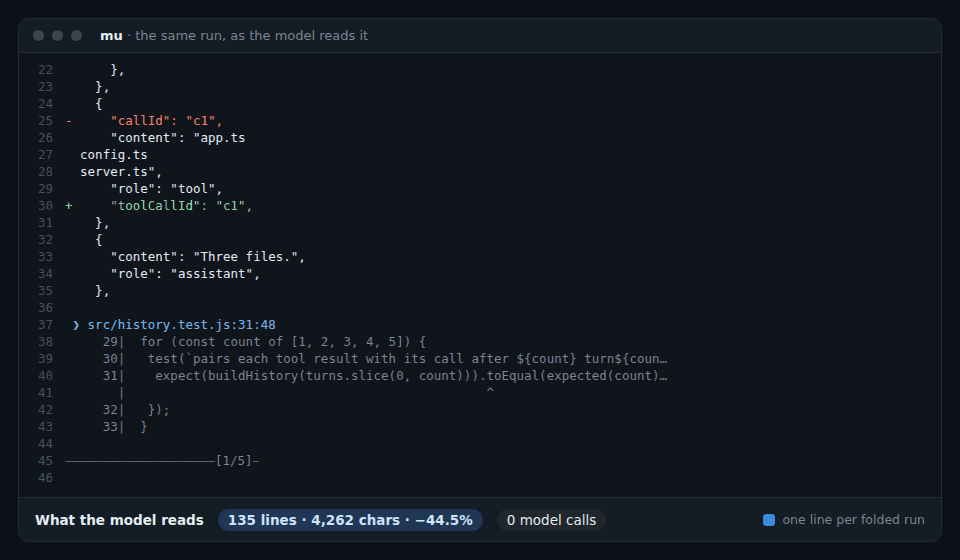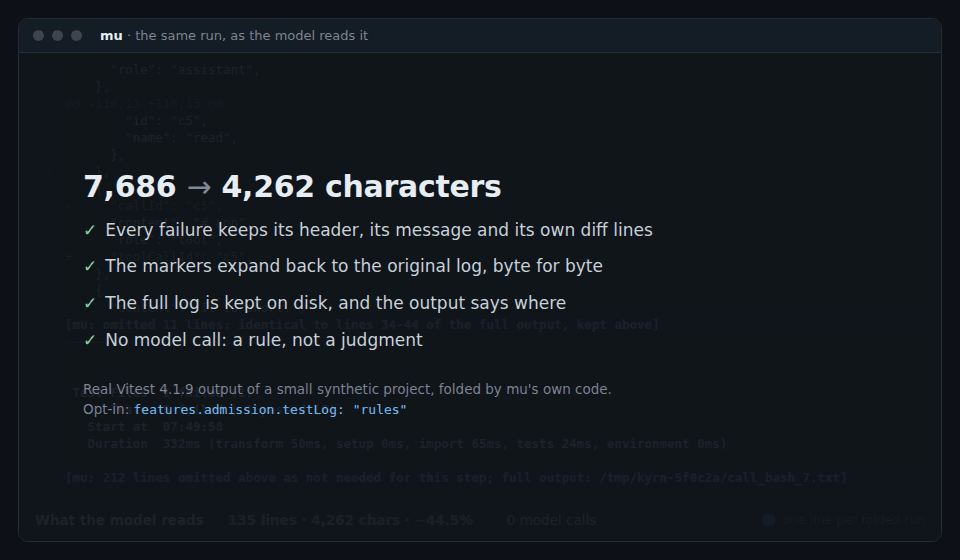
**完全重复。** 一次失败的运行,常常为每个失败的测试各打印一遍同样的 diff、DOM dump 或堆栈。mu 保留第一份,之后的每一份换成一行,写明它重复的是哪几行。不调用任何模型。标记展开后逐字节等于原文;完整日志留在磁盘上,输出末尾有一行指向它。
**按目标挑选。** 用详细 reporter 时,该留什么取决于你问的是什么:调试失败时,通过的测试是噪音;问哪些测试跑过时,它们就是证据。Jev 在一个请求里,对每一块通过记录、每一块测试输出各问一次:目标还需要它吗?汇总和每一个失败从不参与提问。只有 Jev 给"不需要"的概率达到 0.9 或以上,这一块才会省掉。
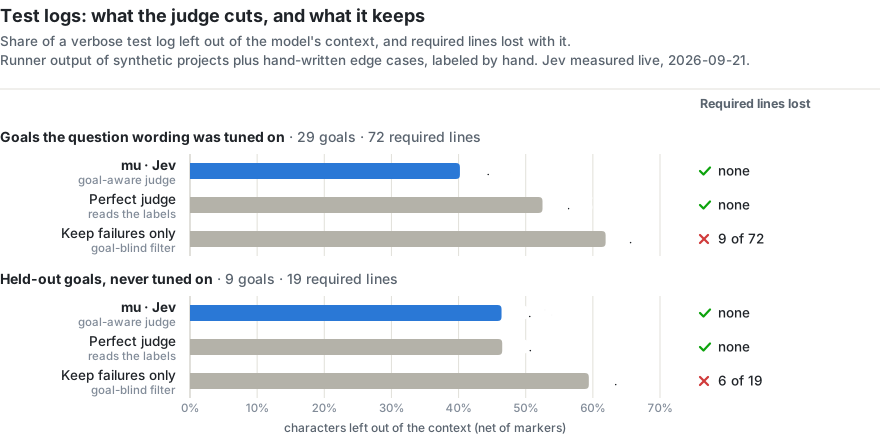
*完美判定器*(Perfect judge)直接读标注,代表一个全对的判定器最多能省多少。*只留失败*(Keep failures only)是一个永远回答"省掉"的判定器,也就是不看目标的过滤器会做的事。这次研究的全部 282 次真实 Jev 请求,按标价约 $0.017;用默认问法,单次请求的中位耗时 345 毫秒。
两者默认都关闭。在 `~/.mu/agent/mu.json` 里写 `"features": { "admission": { "testLog": "rules" } }`,或在桌面端设置里打开「测试日志精简」,就会折叠重复。`"jev"` 再让判定器挑出剩下的部分里当前目标用得上的;执行 `/mu mode tool.admission.test-log shadow` 则只记录挑选结果。
这些数字不代表什么:
- 挑选用的样本是合成项目上真实的 Vitest、node:test、pytest 输出,加 13 个手写的边界用例;目标和标注都是作者写的。留出集先标注、只跑一次,之后没有改任何东西。
- 它们度量的是什么进了模型、丢了什么,不是模型之后能不能把任务做完。
- 重复段来自一位开发者两天的会话:15 份测试日志,全部是 Vitest,图里是其中超过 4,000 字符的 7 份。其他运行器没有测过。
- 还没有在同一批任务上和 pi、Claude Code、Codex 做端到端对比。
`node kyrn/spikes/judge-bench/test-log-replay.ts` 几秒内离线重跑除 Jev 之外的所有组,不需要密钥;在当前代码上,这些组比图里高 0.6 到 1.1 个百分点,图是 2026-09-21 测的。Jev 那一组需要 `TYPESAFE_API_KEY`。
图中的数据
| 按目标挑选 | 调整用目标(29):省下 | 丢失的必要证据 | 留出目标(9):省下 | 丢失的必要证据 |
| --- | --- | --- | --- | --- |
| mu · Jev | 40.2% | 72 条中 0 条 | 46.4% | 19 条中 0 条 |
| 完美判定器 | 52.5% | 72 条中 0 条 | 46.5% | 19 条中 0 条 |
| 只留失败 | 61.9% | 72 条中 9 条 | 59.4% | 19 条中 6 条 |
| 真实的失败测试日志 | 字符 | 折叠 |
| --- | --- | --- |
| 5 个失败,各带一份 diff | 37,819 | 86% |
| DOM 测试,4 个失败 | 34,115 | 44% |
| 同一次运行,子代理看到的 | 34,115 | 44% |
| 共用的 stderr 堆栈 | 15,565 | 47% |
| 2 个失败 | 9,249 | 16% |
| 7 个套件解析失败 | 4,953 | 0%:一段重复,太短不值得折叠 |
| 5 个各不相同的失败 | 4,004 | 0%:没有重复 |
| 7 份合计 | 139,820 | 51.0% |
## 蜂群
多代理系统都要回答同一个问题:一个代理知道的,要不要告诉另一个?常见的答案是什么都不传(只向主代理汇报)、什么都传(群聊或交接时带上全部历史)、每个代理自己的大模型来定、或者靠固定规则和环境。mu 的答案:判定器当闸门。
一个蜂群是 2 到 6 只 bee,各有自己的关注点。bee 读代码、跑命令、开浏览器;从不改代码,改动由主模型来做。每只 bee 每说完一段,`hive.publish` 问一次:这里有没有值得共享的发现、死路、决定或阻塞?值得的上一块只增不删的共享板。板上每来一条新笔记,`hive.deliver` 对每一只别的 bee 各问一次:这和它的关注点有关吗?有关就投递过去,标明「这是发现,不是指令」。
因为板只增不删,后来的结论会推翻早先的:一只 bee 报告测试跑不起来,后来清掉一个环境变量就跑通了。`hive.relate` 读两条笔记之间的关系:*推翻*、*矛盾*或*支持*。被推翻的结论变成一条纠正,送给每一只拿着旧结论的 bee。互相矛盾的两条都留着,标成争议;一分钟内没人解决,就派一只核实 bee 去查。
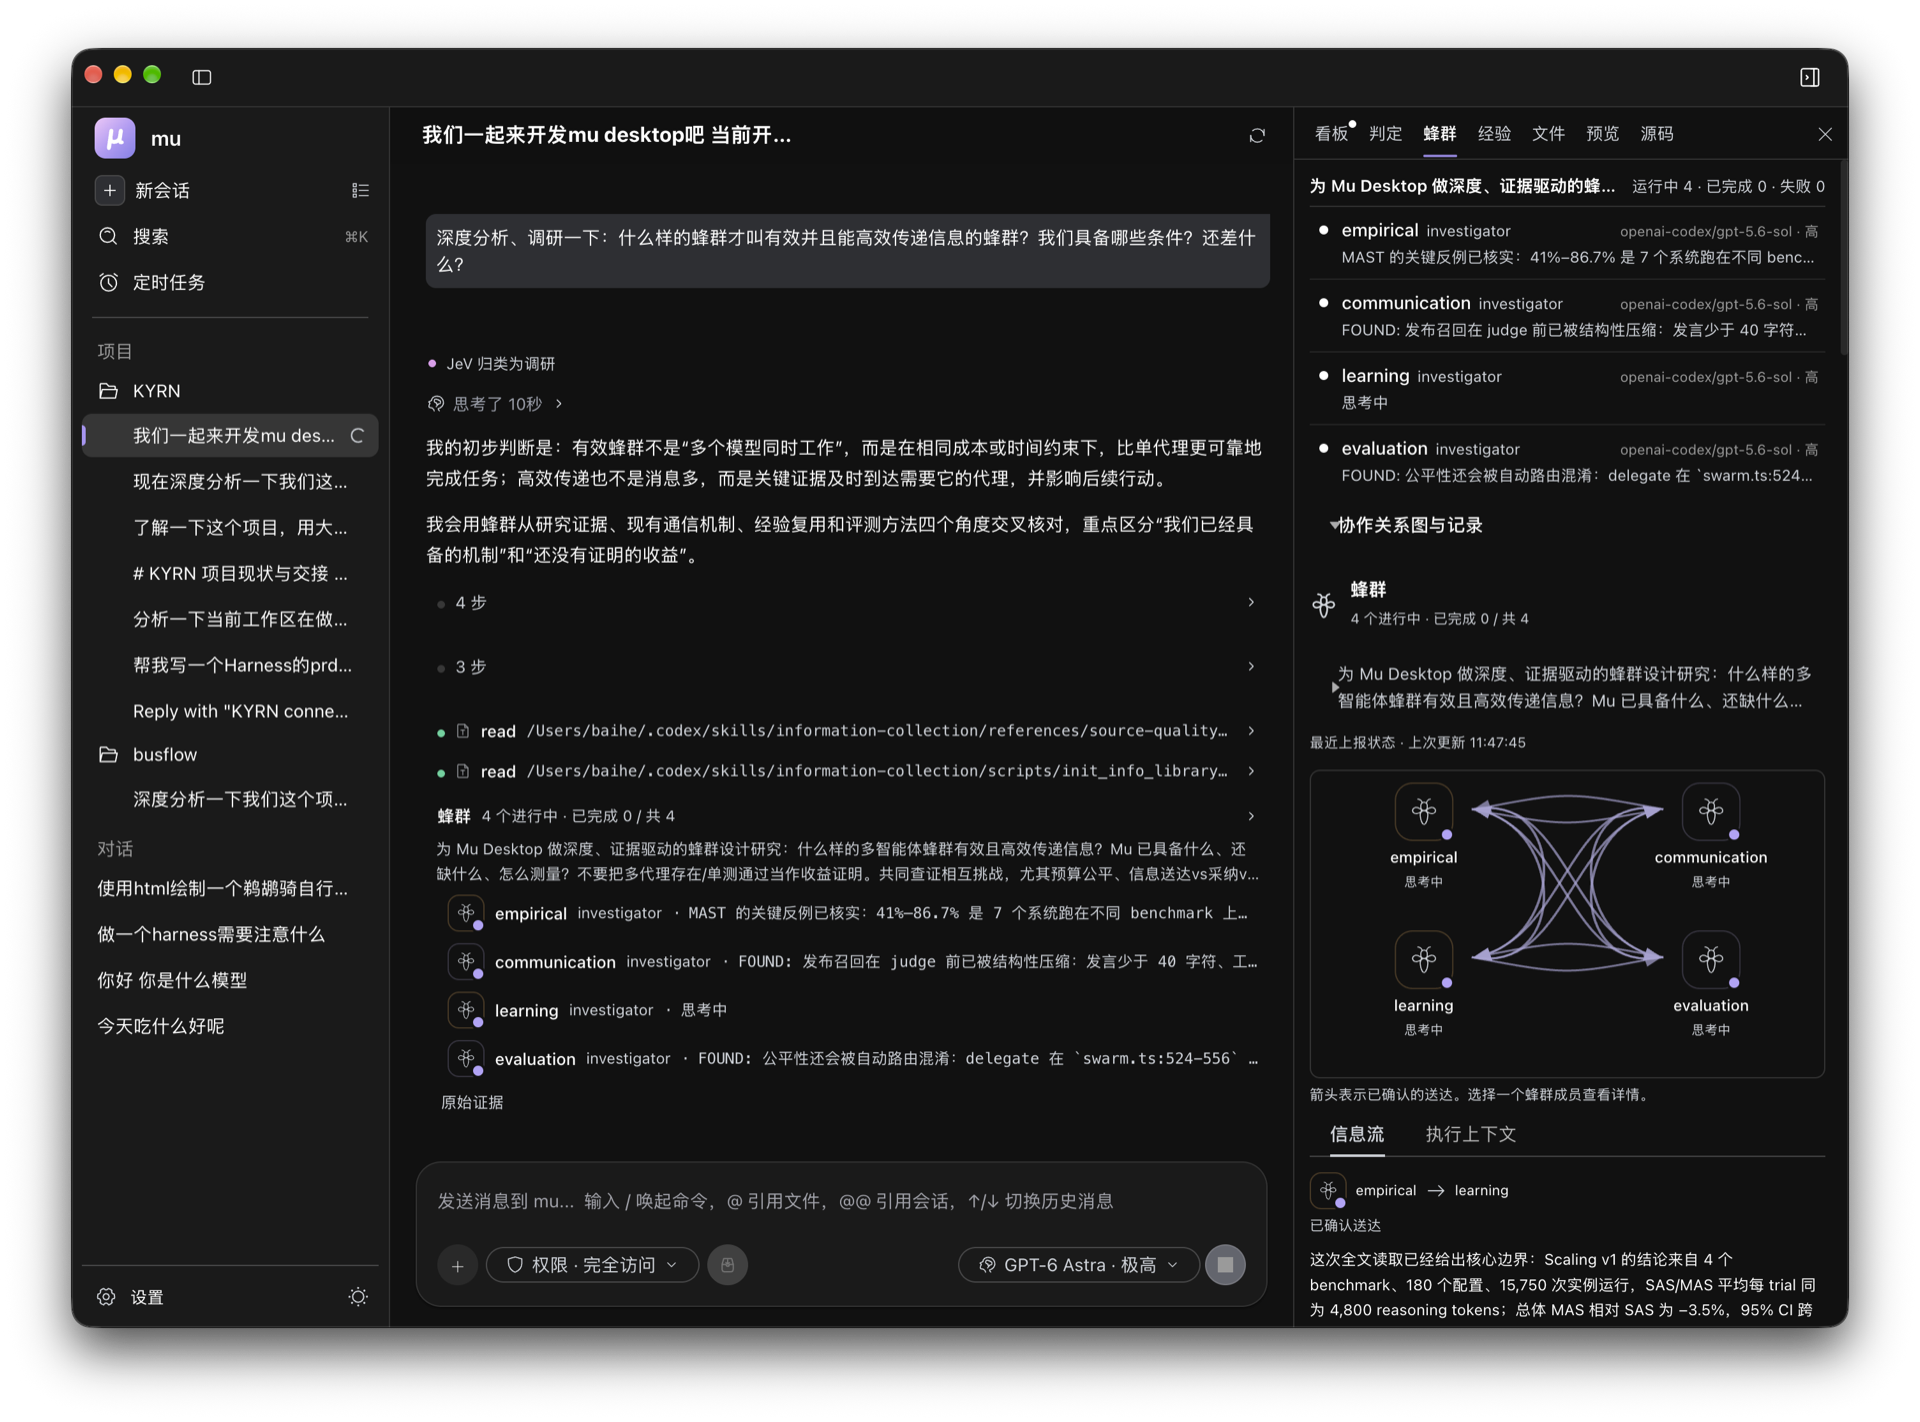
桌面端的「蜂群」页就是这一切的现场。每只 bee 一行:角色、模型、此刻在做什么或刚说了什么。连接图画出谁把发现送给了谁:线越粗送达越多,纠正和争议各有自己的画法,一条发现送到的那一刻会沿着线亮一下。信息流里是每一条送达的原文,判定记录里是每一次裁决。对话里的蜂群卡片带一张缩略图,点开就是这一页。
一次真实的运行:3 只 bee,9 分钟,评了 117 条候选,27 条上板,16 条投递到需要它的 bee 那里。每一次判定都在运行日志里。
`/swarm` 看每一只在做什么;`/swarm stop` 让它们现在交报告;`/swarm kill` 立刻结束。到时间的 bee 会被要求交报告,不交的会被结束;卡住的模型或工具由看门狗处理。蜂群永远会返回。
## 人话看板
大模型一代代迭代下来,干活越来越强,说话却越来越黑:汇报进展的话越写越像给机器看的,术语堆叠,越来越不说人话。mu 不让干活的模型自己汇报。打开看板(`/board`,或桌面端看板页上的开关)后,代理每做完一步,看板上立刻多一行人话:改了哪个文件、检查过没过、运行了什么命令,连着读文件就折成一行「看了 N 个文件」。代理干活中途每说一段话,`board.read` 都请判定器判一次这是不是新消息;是,就由一个只因为说人话而选出来的模型(`/board model` 可换)当场重讲给人听,并同时更新看板的现状:现在在做什么,清单上几件事做完了几件,有什么在等你。一次运行结束时的总结是流水的最后一行,过程留在上面,所以你看到的不只是「做完了」,还有它到底做了什么。
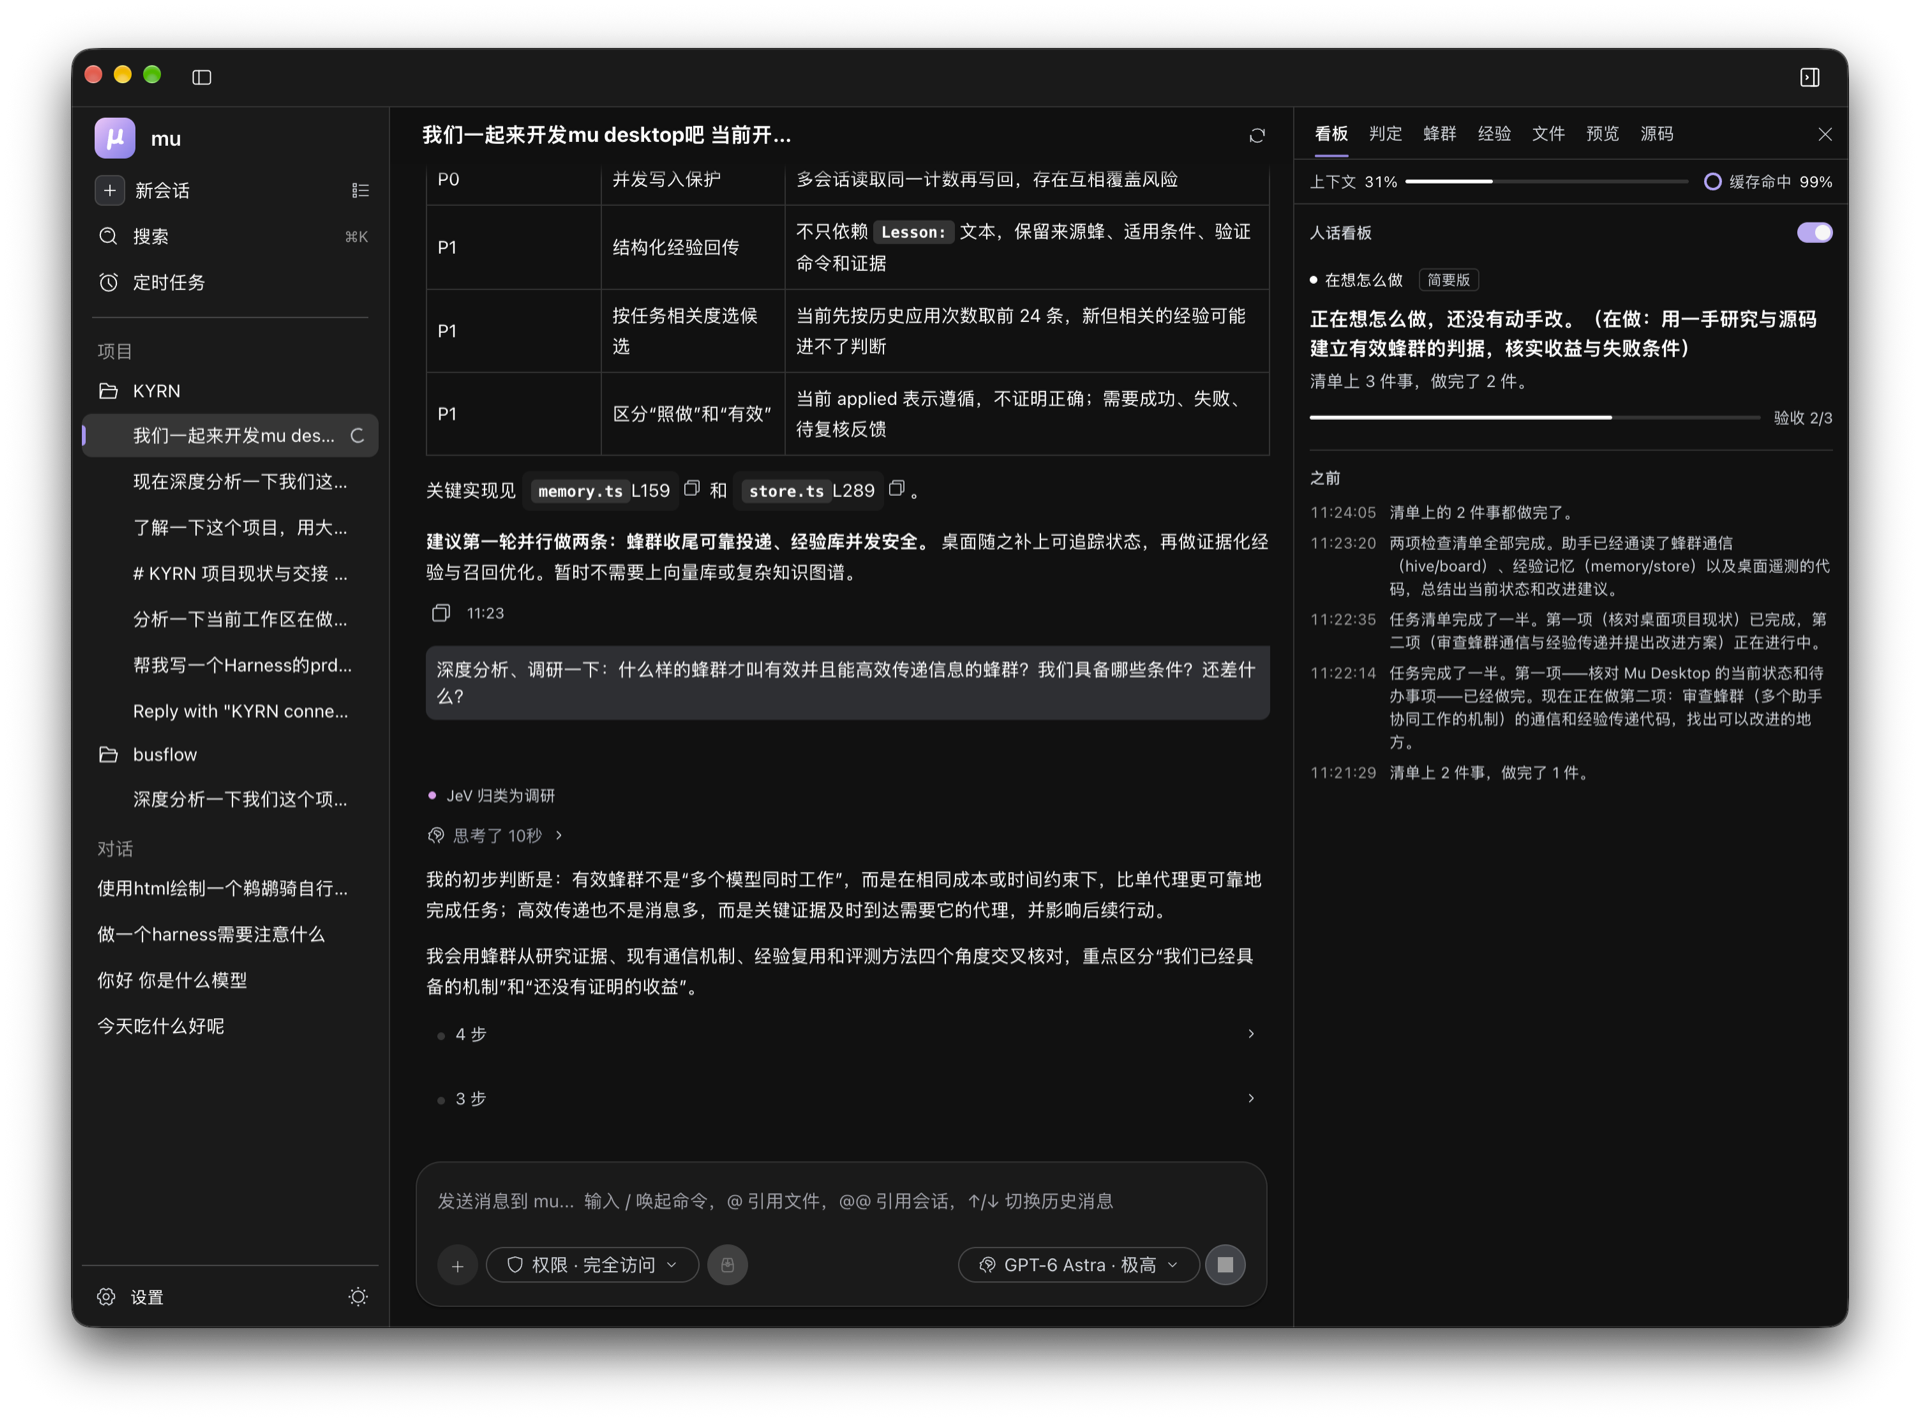
干活的模型照旧用它自己的语言干活,看板上出现的字始终是人一眼能读懂的。看板跟着权限模式、目标和子代理走,代理换了做法,看板也换一种说法。顶上两个数是上下文占用和缓存命中率,正是上面那些上下文和缓存判定的直接结果。
## 桌面端
原生应用,自带 mu 和运行时:不用装 Node,第一次启动不下载任何东西。命令行有的它都有,另加一块对话旁边的工作面板:
**看板** · **判定**(实时的流水:每一次判定和它的问题) · **蜂群** · **经验** · **文件** · **预览** · **源码** · **浏览器**(代理逐步操作的内置浏览器,带目标、暂停和停止)
权限模式和目标在发送框里;`⌘K` 打开命令面板。模型登录在应用内完成:ChatGPT、Claude、Grok 和 Google(Gemini CLI / Antigravity)订阅,或任何 pi 支持的提供商的 API 密钥。Claude Code 和 Codex CLI 的对话可以导入并接着聊。
macOS(Apple 芯片 / Intel)、Windows(x64 / Arm)、Linux(x64 / Arm)的安装包由 GitHub Actions 构建,发布在 [Releases](https://github.com/qybaihe/mu/releases)。
## 命令行
```bash
npm i -g mu-agent
mu # 在当前目录开一个交互会话
mu doctor # 检查安装、判定器和各项连接
```
需要 Node 22.19 或更新。`mu -p "提示"` 跑一次并打印;`mu -c` 接着上一个会话。`mu import --list` 找出你的 Claude Code 和 Codex 对话,`mu import <文件>` 导入。`mu ledger [n]` 打印最近 n 个会话里判定器的决定。命令行和桌面端共用账号、设置和经验。
| 命令 | 做什么 |
| --- | --- |
| `/status` | 判定器、各判定点的模式、没放进上下文的内容、最近的判定 |
| `/mu judge <判定器>` | 由哪些判定器回答、按什么顺序:`laya`、`laya,jev`、`jev-opencode-free`、`classifier:<提供商>/<模型>`、`llm:<提供商>/<模型>` |
| `/mu route <判定点> <判定器>` | 让某一个判定点用自己的判定器 |
| `/mu mode <判定点> ` | 切换某一个判定点 |
| `/frame` | 任务帧:目标、你的约束及其出处、验收条件 |
| `/goal <条件>` | 一直干到条件成立;`/goal clear` 结束 |
| `/permissions` | 全部放行 / Jev 审批 / 最小权限 |
| `/board` | 打开或关闭人话看板 |
| `/remember`、`/lessons`、`/forget` | 记一条经验、列出经验、让一条退役 |
| `/review`、`/commit` | 评审改动,发现按 P0 到 P3 分级;写提交 |
| `/checkpoints`、`/rewind` | 列出检查点;退回到某一个 |
| `/agents`、`/swarm` | 派子代理;看正在干活的每一只 |
| `/browse`、`/jobs` | 内置浏览器;后台命令 |
| `/capabilities`、`/ledger` | 装了哪些能力、打开了哪些;最近的判定 |
| `/import-chat` | 导入 Claude Code 或 Codex 的对话 |
| `/doctor` | 检查配置和连接 |
pi 自己的命令(`/model`、`/thinking`、`/login`、`/resume`、`/tree`、`/fork`、`/compact`、`/export` 等)原样保留。`MU_JUDGE=laya,jev mu` 只为这一次运行改判定器。
## 隐私
密钥只在本机。mu 不会自己下载任何模型或运行时;需要下载的东西都会先问你。判定器只看到一个问题所需的字段(没配密钥时,这些字段发给 OpenCode Zen 上免费的 Jev;用 `MU_JUDGE=off` 或 Laya 就全部留在本机);每一次判定都记录在本机,你都能翻到。
## 文档
- [Getting started](../getting-started.md) · [配置](../configuration.md) · [判定器](../judges.md) · [排错](../troubleshooting.md)(英文)
- 参考:[全部判定点](../reference/decision-points.md) · [全部功能和选项](../reference/features.md) · [更新日志](../../CHANGELOG.md)
- 给贡献者:[mu 是怎么工作的](../architecture.md) · [新增一个判定点](../adding-a-decision-point.md) · [翻译](../translations.md)
## 参与贡献
欢迎报 bug、修 bug、提新判定点、测判定器、做翻译,中文英文都可以。先看 [CONTRIBUTING.md](../../CONTRIBUTING.md);标了 [`good first issue`](https://github.com/qybaihe/mu/labels/good%20first%20issue) 的 issue 适合上手。
```bash
npm install --ignore-scripts # 安装依赖,不跑生命周期脚本
node kyrn/bin/mu.mjs # 从这份代码启动 mu
npm run check # 格式、静态检查、类型
./test.sh # 测试(没有密钥时跳过依赖模型的测试)
```
桌面端在 `desktop/`:`bun install`,然后 `KYRN_ROOT="$(cd .. && pwd)" bun run start` 起开发版,它从仓库里的 mu 启动(先在根目录 `npm install`)。
所有参与者遵守[行为准则](../../CODE_OF_CONDUCT.md)。安全问题请按 [SECURITY.md](../../SECURITY.md) 私下报告。
## 来源与协议
mu 基于 [pi](https://github.com/earendil-works/pi)(编码代理,MIT;根目录的 [LICENSE](../../LICENSE) 覆盖 `packages/` 和 `kyrn/`)和 [AionUi](https://github.com/iOfficeAI/AionUi)(桌面端,Apache 2.0;`desktop/` 保留它的 [LICENSE](../../desktop/LICENSE))改造,感谢两个项目。有几个判定点借鉴了别的项目:提示注入筛查的问法来自 [hermes-jev-skills](https://github.com/kerpopule/hermes-jev-skills),续跑检查和批量判定工具参考了 [oh-my-pi](https://github.com/can1357/oh-my-pi)。判定内核用到的第三方代码列在 [THIRD_PARTY_NOTICES.md](../../packages/kyrn-judge/THIRD_PARTY_NOTICES.md)。
## 社区支持
- 提问和想法:[Discussions](https://github.com/qybaihe/mu/discussions);中文讨论也可以去 [linux.do](https://linux.do)。
- bug 和需求:[Issues](https://github.com/qybaihe/mu/issues/new/choose)。
- 更多:[SUPPORT.md](../../SUPPORT.md)。
如果 mu 对你有用,点个 star 能让更多人看到它。

