mu
μ · Only what's needed.
帶判定核心的程式設計代理。以 pi 為基礎。




English · 简体中文 · 繁體中文 · 日本語 · 한국어
一個程式設計代理每個工作階段要做幾百個和程式碼無關的決定:什麼留在上下文裡,一條指令安不安全,一個發現值不值得告訴另一個代理,工作做完了沒有。交給大模型,花的是 token、延遲和注意力;交給寫死的規則,錯得太多。mu 把它們交給一個**判定器**:一個小而快的模型,每次只回答一個有邊界的問題,每一輪有 38 個判定點。大模型把注意力留給正事。
- **mu**:命令列。pi 的全部能力,加上判定核心。
- **mu 桌面版**:原生應用程式,內建 mu 和執行環境。下載,接上一個模型,開始。
- **Jev**:判定器。是非題、選擇題、評分題,每個答案帶機率,每一次判定都記進判定帳本。本機判定器(Laya)或任何一個大模型都可以接管某個判定點。
> 還在早期開發。預發布版(0.1.x)在 npm 和 [Releases](https://github.com/qybaihe/mu/releases) 上,作者每天都在用。名稱、設定和格式都可能改變。
**目錄:**[快速開始](#快速開始) · [一輪是怎麼走的](#一輪是怎麼走的) · [判定點](#判定點) · [判定器](#判定器) · [實測](#實測) · [蜂群](#蜂群) · [人話看板](#人話看板) · [桌面版](#桌面版) · [命令列](#命令列) · [文件](#文件) · [參與貢獻](#參與貢獻)
## 快速開始
**桌面版。** 從 [Releases](https://github.com/qybaihe/mu/releases/latest) 下載 macOS、Windows 或 Linux 安裝檔,開啟後貼上一組 API 金鑰,或用 ChatGPT、Claude、Grok、Google 訂閱登入。不需要再安裝其他東西。
**命令列。**
```bash
npm i -g mu-agent # Node.js 22.19 或更新版本
mu setup # 接上一個模型
mu # 在目前目錄開一個工作階段
```
開始使用不需要判定器的金鑰:設定之前,由 OpenCode Zen 上免費的 Jev 回答。所有判定點一開始就生效,每次判定都會記錄下來(`/status`、`mu ledger`、桌面版的判定分頁)。如果只想記錄判定器會怎麼做、不改變行為,在 `~/.mu/agent/mu.json` 寫入 `{"modes": {"default": "shadow"}}`。更多請見 [Getting started](../getting-started.md)(英文)。
## 一輪是怎麼走的
```
你 ──▶ input.preflight · task.frame · input.interjection
│
▼
模型 ──▶ 工具呼叫 ──▶ tool.risk · tool.constraint · tool.approval ──▶ 執行
▲ │
│ tool.injection web pages and MCP output: instructions aimed at the AI are withheld
│ tool.admission chunk by chunk: into the context, or archived behind a pointer
│ context.forget · context.compact when the context grows │
└───────────────────────────────────────────────────────────────────┘
一輪結束 ──▶ turn.completion · turn.continue · turn.drift · turn.rewind · memory.applied · board.read · cache.warming
```
每個名字都是一個判定點。每個判定點是一個關於一小段狀態的短問題;答案改變模型接下來做什麼,從不改變它要不要問你。規則是底線:看起來危險的指令先由規則攔下,判定器只負責確認這是你要的。
## 判定點
每個判定點可以是 `active`(生效,預設)、`shadow`(照常提問並記錄,但不改變任何行為,用來在開啟之前比較判定器)或 `off`(關閉),也可以指定自己的判定器:`jev`、`laya`(本機)、`classifier:/`、`llm:/`,或 `laya,jev` 這樣的串接。
**輸入**
| 判定點 | 問題 | 效果 |
| --- | --- | --- |
| `input.preflight` | 這則訊息是什麼類型,需要多深的思考? | 給模型一行提示;也可以設定這一輪的思考等級 |
| `task.frame` | 新任務、硬性約束、糾正、子目標,還是沒有變化? | 只有變化才重寫任務框架:目標、你的約束原話及其出處、驗收條件 |
| `input.interjection` | 代理正在工作時來了一則訊息:現在打斷,還是這一步之後? | 這一輪被中斷,或訊息先等一下 |
**上下文**
| 判定點 | 問題 | 效果 |
| --- | --- | --- |
| `skills.disclosure` | 哪些技能和這個任務有關? | 只有它們進提示詞;其餘仍查得到 |
| `capability.disclosure` | 這個任務需要某個已安裝的能力包或 MCP 伺服器嗎? | 需要時才開啟、才啟動它的行程 |
| `tool.admission` | 一段長工具輸出的每一塊:現在重要嗎? | 重要的進上下文;其餘封存,留一個指標 |
| `tool.admission.test-log` | 測試記錄裡哪些是重複? | 完全相同的重複只留一份,無損;也可以讓判定器從剩下的裡面挑 |
| `context.forget` | 上下文超過門檻後,哪些工具結果已經過期? | 每一條在送出的請求裡變成一行墓碑 |
| `context.compact` | 這一段留還是刪? | 依判定壓縮;不寫摘要 |
| `memory.recall` | 哪些經驗適用於這個任務? | 帶進這一輪 |
| `memory.capture` | 這則訊息是在糾正代理,還是在立一條規矩? | 變成一條經驗 |
| `memory.outcome` | 繞了圈子之後,最後走通的那條路值得記嗎? | 從執行中學來的經驗,不是你教的 |
| `memory.worth` | 模型或子代理提出的一條經驗:以後還用得上、一次性的,還是早就知道? | 留下或丟掉 |
| `memory.merge` | 和已有的經驗是同一條、更精確,還是矛盾? | 不重複記;更精確的取代舊的 |
| `memory.applied` | 這一輪召回的經驗照做了嗎? | 常被召回卻從不照做的經驗會自動退役 |
| `cache.warming` | 提示快取過期之前你會回來嗎? | 續一次快取,或任它過期 |
**工具與安全**
| 判定點 | 問題 | 效果 |
| --- | --- | --- |
| `tool.risk` | 一條被規則標記的指令:是你要的嗎? | 拿不準就問你 |
| `tool.approval` | 在「Jev 審批」模式下:這條指令、這個專案外的變更、這個對外動作、這個子代理,任務明確需要嗎? | 確定需要的直接放行;其餘問你 |
| `tool.constraint` | 在一個會改變東西的呼叫之前:它越過了你定下的約束嗎? | 呼叫被攔下 |
| `tool.injection` | 網頁、搜尋結果或 MCP 伺服器的輸出,一段一段看:裡面有沒有衝著 AI 來的指令? | 這些段落不會到達模型,原處留一條說明 |
| `files.locate` | 哪些檔案符合你的描述? | 為候選檔案排序,取代一連串 grep |
| `judge.items` | 模型自己提的一個是非題,對很多項逐項問:檔案、日誌行、審查發現 | 透過 `judge_items` 工具,每項得到一個機率,不用一項項讀 |
| `browser.step` | 觀察、判一次、動手:下一步操作是什麼,作用在哪個元素上? | 內建瀏覽器走一步 |
| `review.triage` | `/review` 的每條發現:會改變程式行為嗎,是關於這次變更的嗎? | 按 P0 到 P3 分級 |
| `diagnostics.delivery` | 一次編輯後新的語言伺服器診斷:現在說,下次停頓時說,還是不說? | 錯誤送到模型;風格警告不送 |
**回合**
| 判定點 | 問題 | 效果 |
| --- | --- | --- |
| `turn.drift` | 每隔幾步:工作還在為目標服務嗎? | 規則抓繞圈子,判定器抓偏離 |
| `turn.rewind` | 同一個失敗一次又一次:這條路是死路嗎? | 退回到某個檢查點 |
| `turn.completion` | 模型說做完了:有什麼東西驗證過嗎? | 沒有就提醒一次 |
| `turn.continue` | 一輪停在「接下來我跑一下測試」,或在你已經要它做的事上問「要我動手嗎」:是不是沒做完就停了? | 讓它接著做,每則訊息最多兩次;難以撤銷的一步不會推它去做 |
| `output.drift` | 模型正在寫的時候:輸出的末尾越過了你的約束嗎? | 實驗性;邊寫邊糾正 |
| `goal.met` | 目標模式下大模型給不出答案時:條件成立了嗎? | `/goal` 的備援 |
| `board.read` | 事情做到哪了,選擇題? | 供人話看板使用 |
| `notify.routing` | 上下文預算之類的事件:現在告訴模型,晚點,還是不說? | 模型在合適的時候被告知 |
**協作**
| 判定點 | 問題 | 效果 |
| --- | --- | --- |
| `swarm.routing` | 這個委派出去的任務,用哪個角色、哪一級模型、多深的思考? | 合適的子代理 |
| `swarm.patch` | 子代理交回的修補檔留在任務範圍內嗎? | 從任務、路徑和行數來判斷 |
| `hive.publish` | 一隻 bee 的發現值得上共享板嗎? | 發布,或自己留著 |
| `hive.deliver` | 板上的一條筆記和這隻 bee 的工作有關嗎? | 有關才投遞 |
| `hive.relate` | 一條新發現推翻、矛盾還是支持了早先的某一條? | 更正和爭議送到拿著舊筆記的 bee 那裡 |
每個判定點對應的功能開關和選項:[docs/reference/decision-points.md](../reference/decision-points.md)(英文)。
## 判定器
- **Jev**(雲端)。有邊界的問題,答案帶機率。可以經 TypeSafe、OpenRouter、Vercel AI Gateway、OpenCode Zen、Cloudflare Workers AI,或任何支援同一協定的服務呼叫,每個服務有自己的金鑰(`TYPESAFE_API_KEY`、`MU_JUDGE_OPENROUTER_API_KEY`、`AI_GATEWAY_API_KEY`、`OPENCODE_API_KEY`、`CLOUDFLARE_API_KEY` 加 `CLOUDFLARE_ACCOUNT_ID`):在桌面版的「判定器」頁選一個,預設用第一個設定了金鑰的。一把金鑰都沒有時,預設由 OpenCode Zen 上限時免費的 Jev 1.13 回答:判定要讀的內容會送到 OpenCode,它不拿來訓練模型,mu 每天提示一次。設定金鑰(`mu setup`,或「判定器」頁)後,下一個問題起就用你的金鑰。在作者自己的工作階段裡實測:HTTP/2 上一個熱連線的問題約 0.3 秒;16 塊工具輸出併成一個請求判完 0.44 秒,狀態只計費一次。判定、機率和耗時都進判定帳本:`mu ledger`,或桌面版的「判定」頁。
- **Laya**(本機)。一個 3.22 億參數的判定器,在你的機器上執行,不經過網路。未經你同意不下載任何東西。在簡單述詞上可靠,在後設判斷上偏弱:先讓它以影子模式和 Jev 並行執行,看過判定帳本再把判定點交給它。
- **pi 模型目錄裡的任何分類模型**,作為一個層級:`classifier:/`。例如 Cloudflare 的 Clef(`clef`、`clef-flash`)、OpenRouter 和 Vercel AI Gateway 上的 System One 模型、llama.cpp 的分類模型。
- **任何大模型**,作為一個層級:`llm:/`。
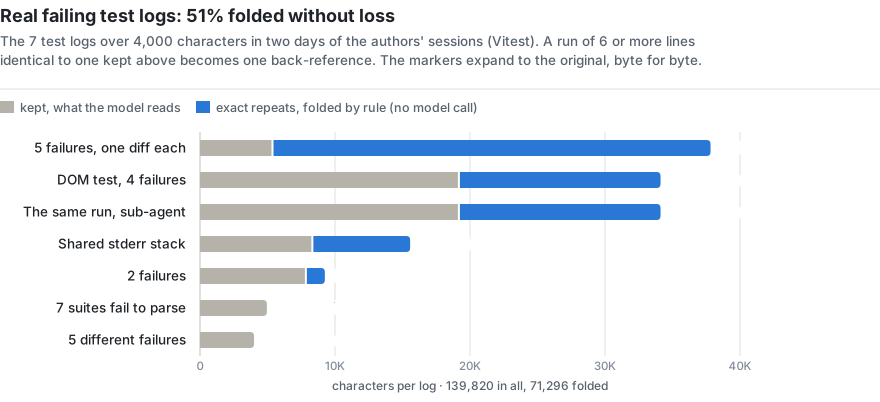
這換來什麼,以作者自己的工作階段為準:上下文從不填滿,因為工具輸出逐塊進入、過期結果不寫摘要直接放下;最長的幾份失敗測試記錄裡,折疊完全相同的重複省下 51% 的字元,一個字元也沒丟(見[實測](#實測));提示快取保持熱的,因為核心會猜你什麼時候回來。
## 實測
下面的數字來自儲存庫自帶的回放腳本 [`kyrn/spikes/judge-bench/test-log-replay.ts`](../../kyrn/spikes/judge-bench/test-log-replay.ts)。方法和完整表格見 [kyrn/docs/09-test-log-admission.md](../../kyrn/docs/09-test-log-admission.md)(簡體中文)。
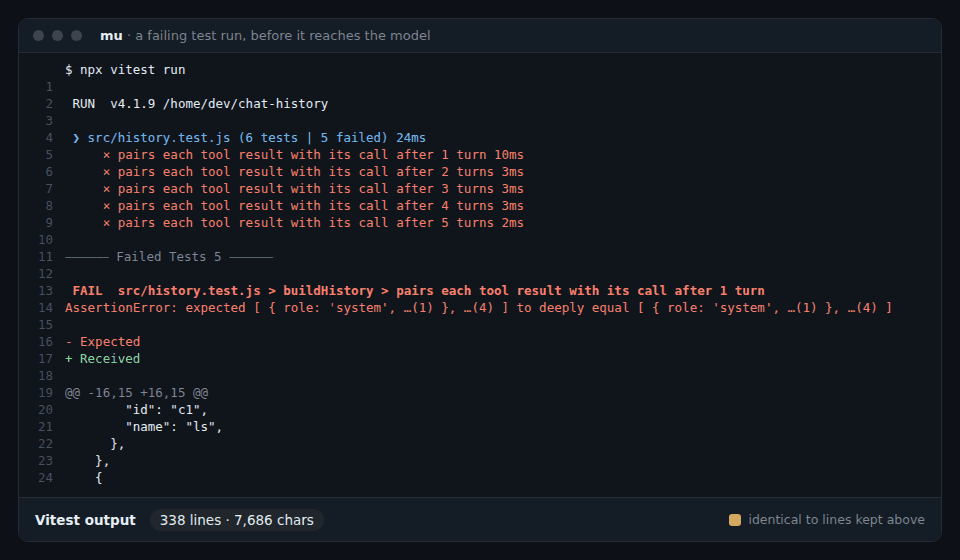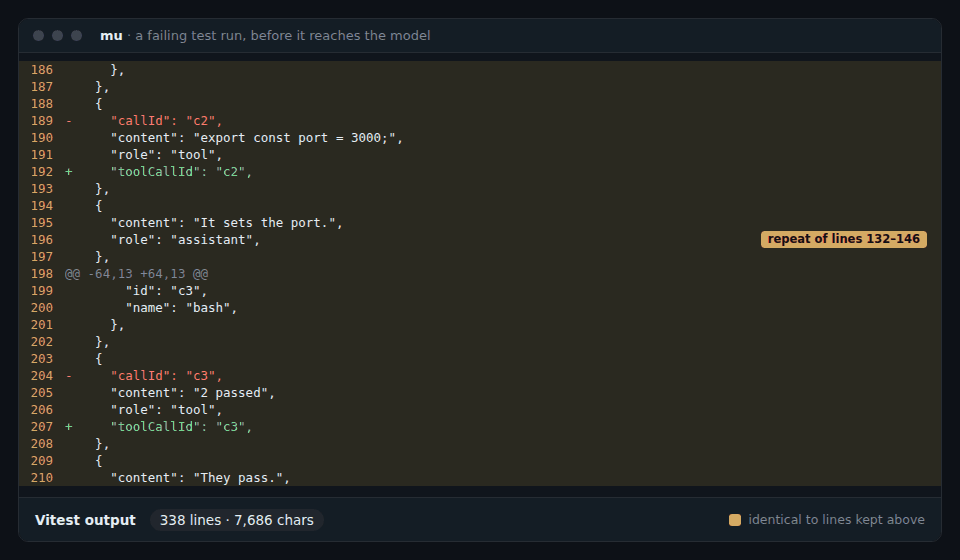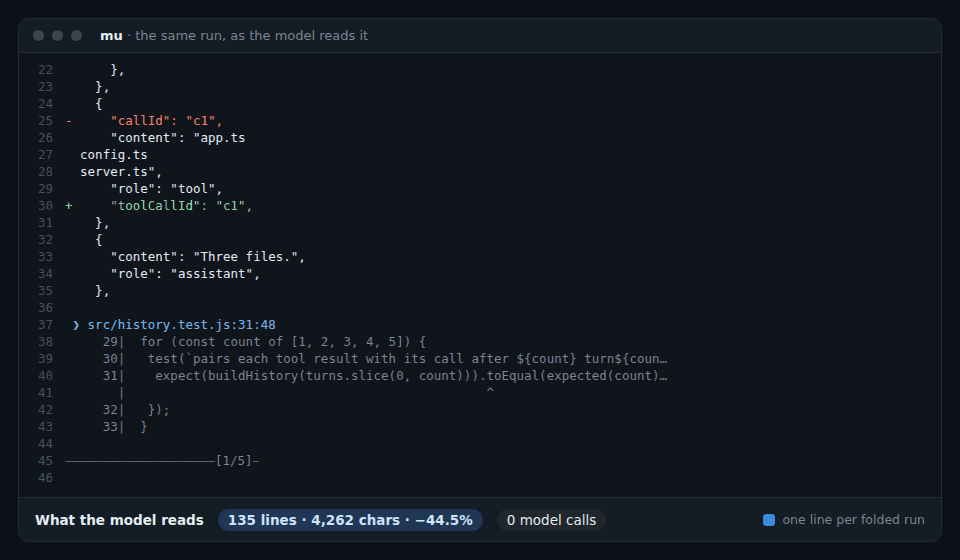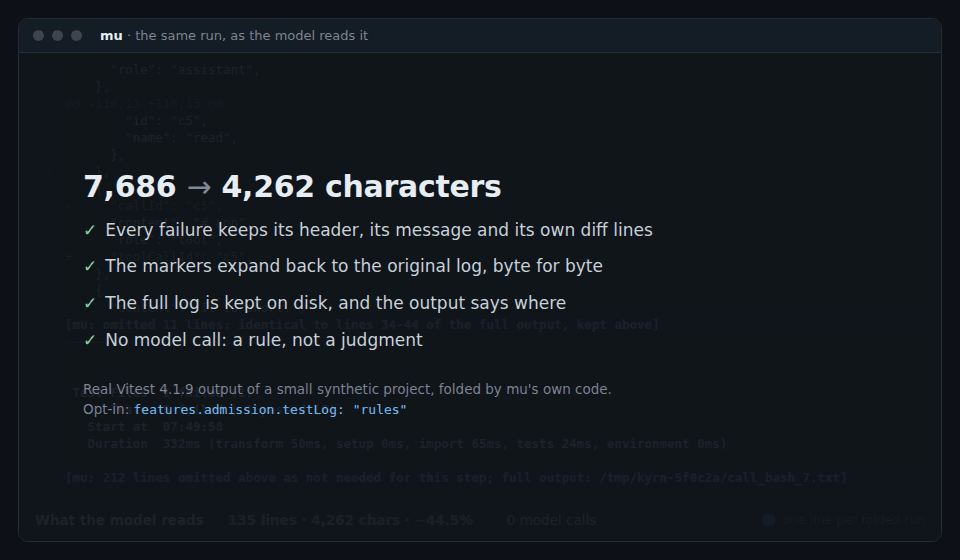
**完全重複。** 一次失敗的執行,常常為每個失敗的測試各印一遍同樣的 diff、DOM dump 或堆疊。mu 保留第一份,之後的每一份換成一行,寫明它重複的是哪幾行。不呼叫任何模型。標記展開後逐位元組等於原文;完整記錄留在磁碟上,輸出末尾有一行指向它。
**依目標挑選。** 使用詳細 reporter 時,該留什麼取決於你問的是什麼:除錯失敗時,通過的測試是雜訊;問哪些測試跑過時,它們就是證據。Jev 在一個請求裡,對每一塊通過記錄、每一塊測試輸出各問一次:目標還需要它嗎?摘要和每一個失敗從不參與提問。只有 Jev 給「不需要」的機率達到 0.9 以上,這一塊才會省掉。
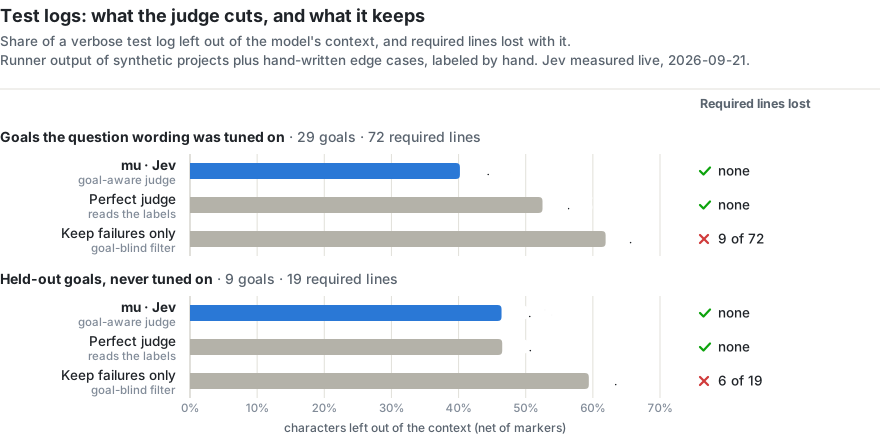
*完美判定器*(Perfect judge)直接讀標註,代表一個全對的判定器最多能省多少。*只留失敗*(Keep failures only)是一個永遠回答「省掉」的判定器,也就是不看目標的過濾器會做的事。這次研究的全部 282 次真實 Jev 請求,依牌價約 $0.017;用預設問法,單次請求的中位耗時 345 毫秒。
兩者預設都關閉。在 `~/.mu/agent/mu.json` 裡寫 `"features": { "admission": { "testLog": "rules" } }`,或在桌面版設定裡打開「測試日誌精簡」,就會折疊重複。`"jev"` 再讓判定器挑出剩下的部分裡目前目標用得上的;執行 `/mu mode tool.admission.test-log shadow` 則只記錄挑選結果。
這些數字不代表什麼:
- 挑選用的樣本是合成專案上真實的 Vitest、node:test、pytest 輸出,加上 13 個手寫的邊界案例;目標和標註都是作者寫的。保留集先標註、只跑一次,之後沒有改任何東西。
- 它們衡量的是什麼進了模型、丟了什麼,不是模型之後能不能把任務做完。
- 重複段來自一位開發者兩天的工作階段:15 份測試記錄,全部是 Vitest,圖裡是其中超過 4,000 字元的 7 份。其他執行器沒有測過。
- 還沒有在同一批任務上和 pi、Claude Code、Codex 做端到端比較。
`node kyrn/spikes/judge-bench/test-log-replay.ts` 幾秒內離線重跑 Jev 以外的所有組,不需要金鑰;在目前的程式碼上,這些組比圖裡高 0.6 到 1.1 個百分點,圖是 2026-09-21 測的。Jev 那一組需要 `TYPESAFE_API_KEY`。
圖中的數據
| 依目標挑選 | 調整用目標(29):省下 | 丟失的必要證據 | 保留目標(9):省下 | 丟失的必要證據 |
| --- | --- | --- | --- | --- |
| mu · Jev | 40.2% | 72 條中 0 條 | 46.4% | 19 條中 0 條 |
| 完美判定器 | 52.5% | 72 條中 0 條 | 46.5% | 19 條中 0 條 |
| 只留失敗 | 61.9% | 72 條中 9 條 | 59.4% | 19 條中 6 條 |
| 真實的失敗測試記錄 | 字元 | 折疊 |
| --- | --- | --- |
| 5 個失敗,各帶一份 diff | 37,819 | 86% |
| DOM 測試,4 個失敗 | 34,115 | 44% |
| 同一次執行,子代理看到的 | 34,115 | 44% |
| 共用的 stderr 堆疊 | 15,565 | 47% |
| 2 個失敗 | 9,249 | 16% |
| 7 個套件解析失敗 | 4,953 | 0%:一段重複,太短不值得折疊 |
| 5 個各不相同的失敗 | 4,004 | 0%:沒有重複 |
| 7 份合計 | 139,820 | 51.0% |
## 蜂群
多代理系統都要回答同一個問題:一個代理知道的,要不要告訴另一個?常見的答案是什麼都不傳(只向主代理回報)、什麼都傳(群組聊天或交接時帶上全部歷史)、讓每個代理自己的大模型來決定、或者靠固定規則和環境。mu 的答案:判定器當閘門。
一個蜂群是 2 到 6 隻 bee,各有自己的關注點。bee 讀程式碼、執行指令、開瀏覽器;從不改程式碼,改動由主模型來做。每隻 bee 每說完一段,`hive.publish` 問一次:這裡有沒有值得共享的發現、死路、決定或阻礙?值得的就放上一塊只增不刪的共享板。板上每來一條新筆記,`hive.deliver` 對每一隻別的 bee 各問一次:這和它的關注點有關嗎?有關就投遞過去,標明「這是發現,不是指令」。
因為板只增不刪,後來的結論會推翻早先的:一隻 bee 回報測試跑不起來,後來清掉一個環境變數就跑起來了。`hive.relate` 讀兩條筆記之間的關係:*推翻*、*矛盾*或*支持*。被推翻的結論變成一條更正,送給每一隻拿著舊結論的 bee。互相矛盾的兩條都留著,標成爭議;一分鐘內沒人解決,就派一隻核實 bee 去查。
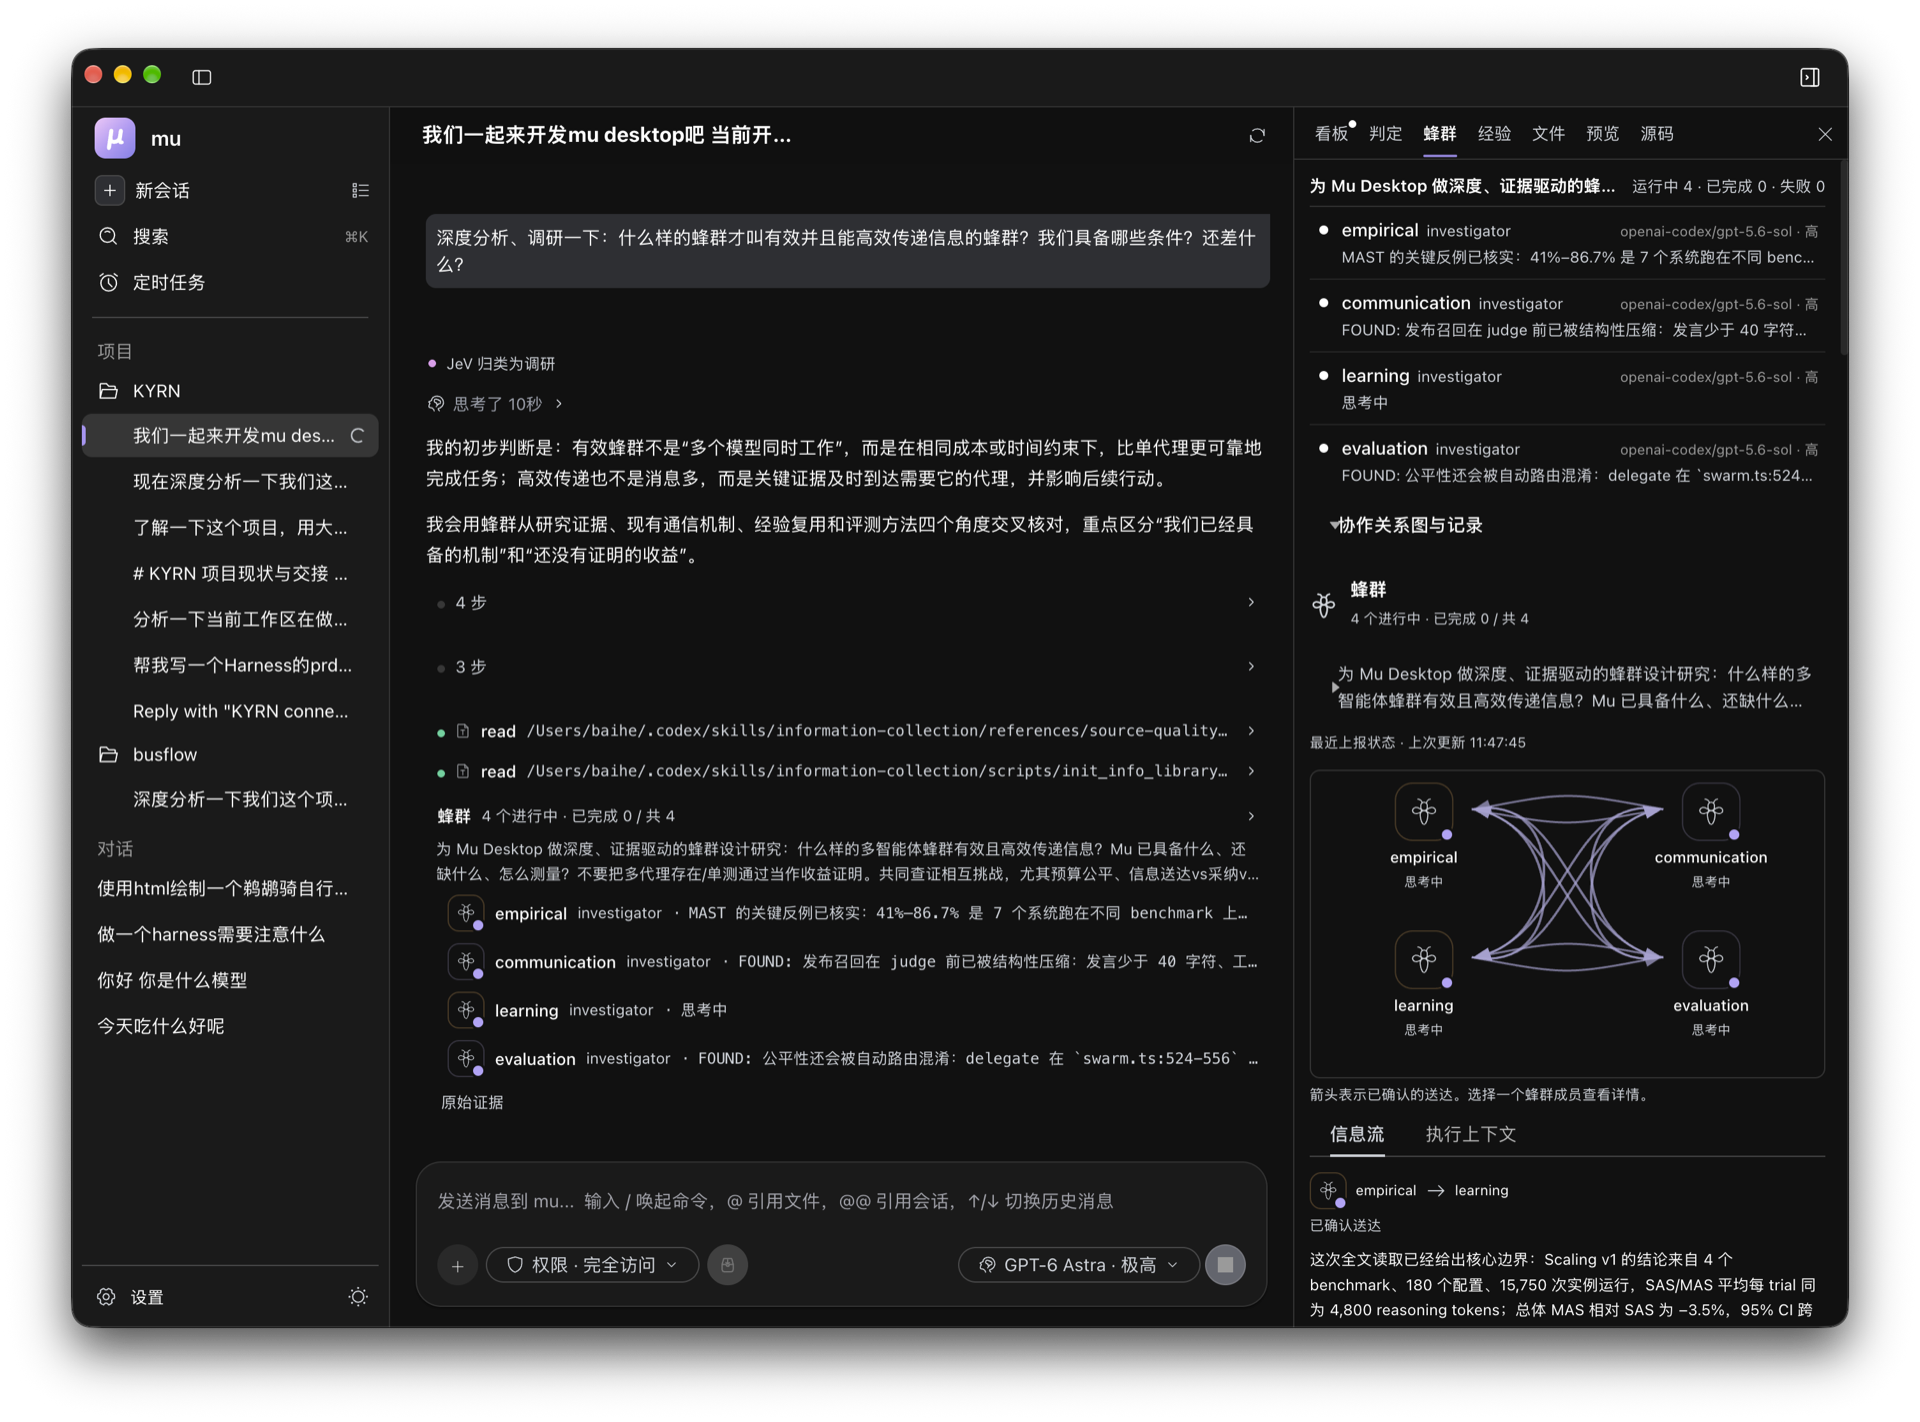
桌面版的「蜂群」頁就是這一切的現場。每隻 bee 一行:角色、模型、此刻在做什麼或剛說了什麼。連接圖畫出誰把發現送給了誰:線越粗代表送達越多,更正和爭議各有自己的畫法,一條發現送到的那一刻會沿著線亮一下。資訊流裡是每一條送達的原文,判定記錄裡是每一次裁決。對話裡的蜂群卡片帶一張縮圖,點開就是這一頁。
一次真實的執行:3 隻 bee,9 分鐘,評了 117 條候選,27 條上板,16 條投遞到需要它的 bee 那裡。每一次判定都在執行記錄裡。
`/swarm` 看每一隻在做什麼;`/swarm stop` 讓它們現在交報告;`/swarm kill` 立刻結束。時間到了的 bee 會被要求交報告,不交的會被結束;卡住的模型或工具由看門狗處理。蜂群一定會回來。
## 人話看板
前沿模型一代比一代會做事,卻一代比一代不會講自己做了什麼:回報進度的文字越寫越像給另一台機器讀的輸出,更密、更晦澀,越來越不像人在說話。mu 不讓做事的模型自己回報。開啟看板(`/board`,或桌面版看板頁上的開關)後,代理每做完一步,看板上立刻多一行人話:改了哪個檔案、檢查過沒過、執行了什麼命令,連著讀檔案就折成一行「看了 N 個檔案」。代理做事途中每說一段話,`board.read` 都請判定器判一次這是不是新消息;是,就由一個只因為會講人話而被選中的模型(`/board model` 可換)當場重講給人聽,並同時更新看板的現況:現在在做什麼,清單上幾件事做完了幾件,有什麼在等你。一次執行結束時的總結是流水的最後一行,過程留在上面,所以你看到的不只是「做完了」,還有它到底做了什麼。
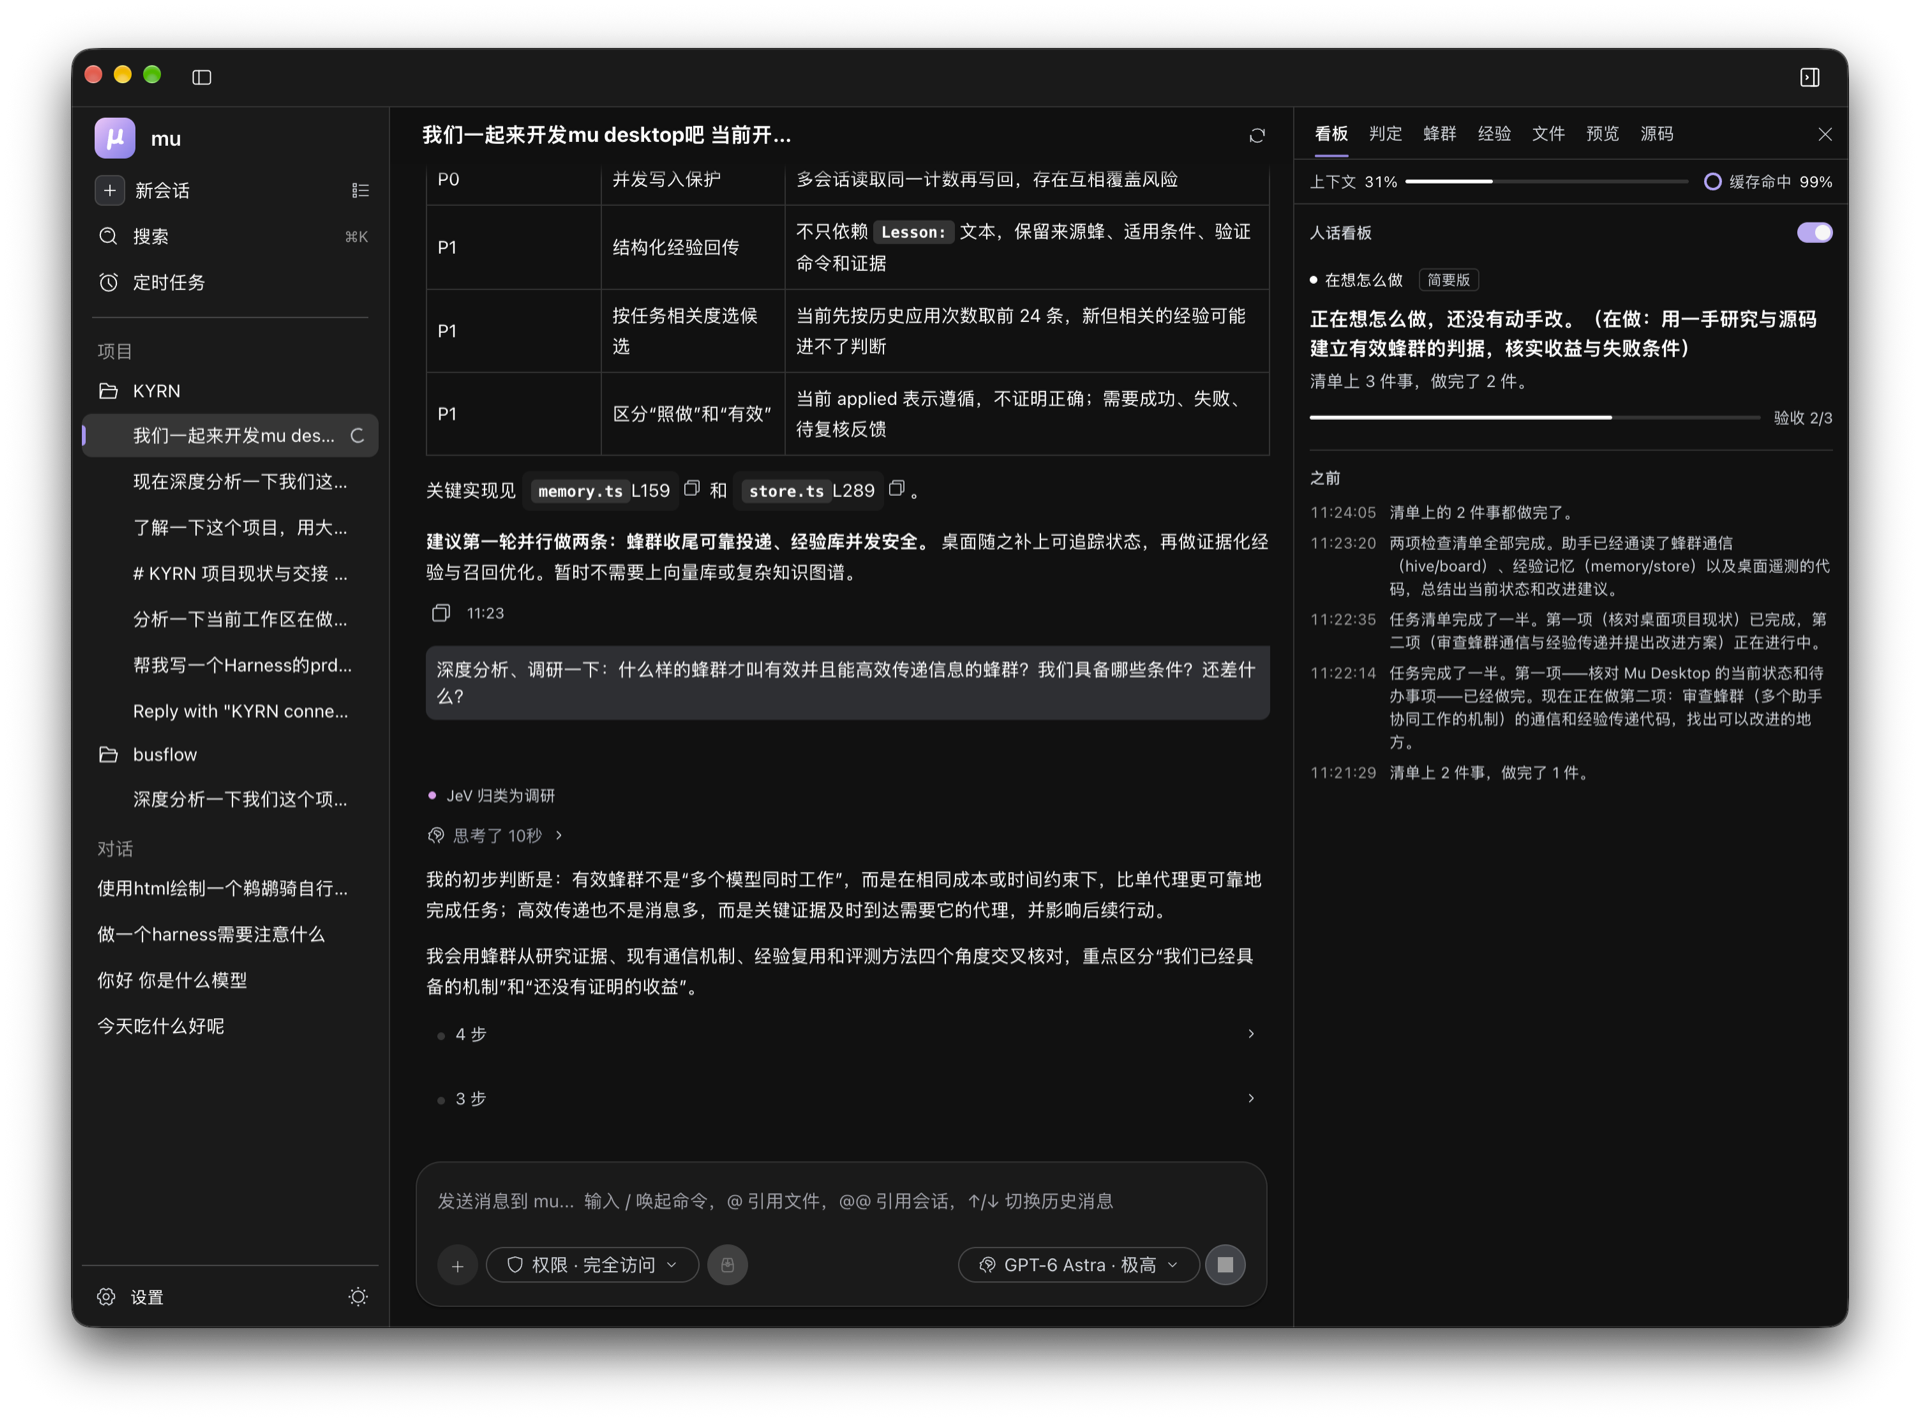
做事的模型照舊用自己的語言做事;看板上出現的字,始終一眼就讀得懂。看板跟著權限模式、目標和子代理走,代理換了做法,看板也換一種說法。頂端兩個數字是上下文用量和快取命中率,正是上面那些上下文和快取判定的直接結果。
## 桌面版
原生應用程式,內建 mu 和執行環境:不用安裝 Node,第一次啟動不下載任何東西。命令列有的它都有,另外在對話旁邊加了一塊工作面板:
**看板** · **判定**(即時的判定帳本:每一次判定和它的問題) · **蜂群** · **經驗** · **檔案** · **預覽** · **原始碼** · **瀏覽器**(代理一步步操作的內建瀏覽器,帶目標、暫停和停止)
權限模式和目標在傳送框裡;`⌘K` 開啟命令面板。模型登入在應用程式內完成:ChatGPT、Claude、Grok 和 Google(Gemini CLI / Antigravity)訂閱,或任何 pi 支援的供應商的 API 金鑰。Claude Code 和 Codex CLI 的對話可以匯入並接著聊。
macOS(Apple 晶片 / Intel)、Windows(x64 / Arm)、Linux(x64 / Arm)的安裝檔由 GitHub Actions 建置,發布在 [Releases](https://github.com/qybaihe/mu/releases)。
## 命令列
```bash
npm i -g mu-agent
mu # 在目前目錄開一個互動式工作階段
mu doctor # 檢查安裝、判定器和各項連線
```
需要 Node 22.19 或更新版本。`mu -p "prompt"` 執行一次並印出結果;`mu -c` 接續上一個工作階段。`mu import --list` 找出你的 Claude Code 和 Codex 對話,`mu import ` 把它們匯入。`mu ledger [n]` 印出最近 n 個工作階段裡判定器的決定。命令列和桌面版共用帳號、設定和經驗。
| 指令 | 做什麼 |
| --- | --- |
| `/status` | 判定器、各判定點的模式、沒放進上下文的內容、最近的判定 |
| `/mu judge ` | 由哪些判定器回答、按什麼順序:`laya`、`laya,jev`、`jev-opencode-free`、`classifier:/`、`llm:/` |
| `/mu route ` | 讓某一個判定點用自己的判定器 |
| `/mu mode ` | 切換某一個判定點 |
| `/frame` | 任務框架:目標、你的約束及其出處、驗收條件 |
| `/goal ` | 一直做到條件成立;`/goal clear` 結束 |
| `/permissions` | 全部放行 / Jev 審批 / 最小權限 |
| `/board` | 開啟或關閉人話看板 |
| `/remember`、`/lessons`、`/forget` | 記一條經驗、列出經驗、讓一條退役 |
| `/review`、`/commit` | 審查變更,發現按 P0 到 P3 分級;寫提交 |
| `/checkpoints`、`/rewind` | 列出檢查點;退回到某一個 |
| `/agents`、`/swarm` | 派子代理;看正在工作的每一隻 |
| `/browse`、`/jobs` | 內建瀏覽器;背景指令 |
| `/capabilities`、`/ledger` | 裝了哪些能力、開啟了哪些;最近的判定 |
| `/import-chat` | 匯入 Claude Code 或 Codex 的對話 |
| `/doctor` | 檢查設定和連線 |
pi 自己的指令(`/model`、`/thinking`、`/login`、`/resume`、`/tree`、`/fork`、`/compact`、`/export` 等)原樣保留。`MU_JUDGE=laya,jev mu` 只為這一次執行更換判定器。
## 隱私
金鑰只留在本機。mu 不會自己下載任何模型或執行環境;需要下載的東西都會先問你。判定器只看得到一個問題所需的欄位(沒設金鑰時,這些欄位送到 OpenCode Zen 上免費的 Jev;用 `MU_JUDGE=off` 或 Laya 就全部留在本機);每一次判定都記錄在本機,你全都看得到。
## 文件
- [Getting started](../getting-started.md) · [設定](../configuration.md) · [判定器](../judges.md) · [疑難排解](../troubleshooting.md)(英文)
- 參考:[所有判定點](../reference/decision-points.md) · [所有功能和選項](../reference/features.md) · [更新紀錄](../../CHANGELOG.md)
- 給貢獻者:[mu 如何運作](../architecture.md) · [新增一個判定點](../adding-a-decision-point.md) · [翻譯](../translations.md)
## 參與貢獻
歡迎回報 bug、修 bug、提出新的判定點、評測判定器、協助翻譯,中文或英文都可以。請先看 [CONTRIBUTING.md](../../CONTRIBUTING.md);標記 [`good first issue`](https://github.com/qybaihe/mu/labels/good%20first%20issue) 的 issue 適合入門。
```bash
npm install --ignore-scripts # 安裝相依套件,不執行生命週期指令碼
node kyrn/bin/mu.mjs # 從這份程式碼啟動 mu
npm run check # 格式、靜態檢查、型別
./test.sh # 測試(沒有金鑰時跳過需要模型的測試)
```
桌面版在 `desktop/`:`bun install`,然後 `KYRN_ROOT="$(cd .. && pwd)" bun run start` 啟動開發版,它會使用儲存庫裡的 mu(先在根目錄執行 `npm install`)。
所有參與者都遵守[行為準則](../../CODE_OF_CONDUCT.md)。安全問題請依 [SECURITY.md](../../SECURITY.md) 私下回報。
## 來源與授權
mu 以 [pi](https://github.com/earendil-works/pi)(程式設計代理,MIT;根目錄的 [LICENSE](../../LICENSE) 涵蓋 `packages/` 和 `kyrn/`)和 [AionUi](https://github.com/iOfficeAI/AionUi)(桌面版,Apache 2.0;`desktop/` 保留它的 [LICENSE](../../desktop/LICENSE))為基礎改造,感謝這兩個專案。有幾個判定點參考了其他專案:提示注入篩檢的問法來自 [hermes-jev-skills](https://github.com/kerpopule/hermes-jev-skills),續跑檢查和批次判定工具參考了 [oh-my-pi](https://github.com/can1357/oh-my-pi)。判定核心用到的第三方程式碼列在 [THIRD_PARTY_NOTICES.md](../../packages/kyrn-judge/THIRD_PARTY_NOTICES.md)。
## 社群支援
- 提問和想法:[Discussions](https://github.com/qybaihe/mu/discussions);中文討論(簡體中文)也可以到 [linux.do](https://linux.do)。
- bug 和需求:[Issues](https://github.com/qybaihe/mu/issues/new/choose)。
- 更多:[SUPPORT.md](../../SUPPORT.md)。
如果 mu 對你有幫助,給個 star 能讓更多人看到它。

