Memoria persistente tra sessioni e agenti di programmazione.
Memoria persistente per Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, Oh My Pi, DeepSeek Harness, OpenCode e qualsiasi client MCP.
Il gist estende il pattern LLM Wiki di Karpathy con punteggio di confidenza, ciclo di vita, grafi di conoscenza e ricerca ibrida: agentmemory è l'implementazione.
---
AgentMemory acquisisce le sessioni di programmazione e rende ricercabili decisioni, soluzioni e lezioni apprese. Condividi un unico archivio tra agenti, controlla ciò che viene salvato e scegli quanto contesto riceve il modello.
## Installazione
Requisiti:
- Node.js 20 o più recente con npm e npx (`node -v`, `npm -v` e `npx -v`).
- Su macOS/Linux, la configurazione automatica richiede anche `curl`, una shell POSIX `sh` e `tar`.
- Su Windows usa WSL2 oppure segui la [configurazione nativa](#windows).
Comando canonico per l'installazione da zero:
```bash
npx -y @agentmemory/agentmemory@latest
```
Scegli gli agenti e un provider, oppure la modalità senza chiave. La configurazione guidata scrive le impostazioni, avvia il server di memoria e propone l'installazione globale del comando `agentmemory`. `-y` accetta la richiesta di npm; `@latest` seleziona la versione corrente. La compressione tramite LLM è facoltativa e richiede un provider e `AGENTMEMORY_AUTO_COMPRESS=true`.
La modalità keyless disabilita gli embedding vettoriali. `memory_recall` (il percorso `mem::search`) usa BM25, mentre `memory_smart_search` può anche fondere corrispondenze strutturali del grafo quando i dati del grafo esistono già. Per il recall semantico gratuito on-device, imposta `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` e riavvia. La prima richiesta di embedding scarica `Xenova/all-MiniLM-L6-v2`; l'inferenza dopo quel primo download del modello viene eseguita localmente.
L'API è su `http://localhost:3111` e il visualizzatore su `http://localhost:3113`. Entrambi ascoltano su loopback per impostazione predefinita. La configurazione è in `~/.agentmemory/.env`; consulta [archiviazione dei dati](#data-storage) per percorsi e istanze separate.
Poi verifica che il recall funzioni e dai al tuo agente le sue skill:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
Le ricerche per parole chiave dovrebbero funzionare in modalità keyless predefinita tramite BM25. La query `database performance optimization` della demo è intenzionalmente semantica e può restituire zero risultati finché non è configurato un provider di embedding.
Preferisci far fare tutto a un agente di coding? Dagli un'unica istruzione:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
Collega un altro agente con `agentmemory connect `. Consulta le [integrazioni](#works-with-every-agent) e i [comandi quotidiani](#everyday-commands).
Installazione globale / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
Il comando npx sopra resta il percorso canonico per l'installazione da zero ed evita i problemi di permessi del prefisso globale.
npx serve una versione vecchia
npx mette in cache per versione. Forza l'ultima versione con `npx -y @agentmemory/agentmemory@latest`, oppure svuota la cache una volta con `rm -rf ~/.npm/_npx` (macOS/Linux; su Windows elimina `%LOCALAPPDATA%\npm-cache\_npx`).
---
agentmemory funziona con qualsiasi agente che supporti hook, MCP o API REST. Tutti gli agenti condividono lo stesso server di memoria.
Claude Code plugin nativo + 12 hook + MCP
Codex CLI plugin nativo + 6 hook + MCP
GitHub Copilot CLI MCP + hook/skill del plugin
Cursor plugin nativo + hook del ciclo di vita + MCP
OpenCode plugin di capture + MCP
Devin 6 hook + skill + MCP
OpenClaw plugin nativo + MCP
Hermes plugin nativo + MCP
pi ricerca nativa + acquisizione + skills
OpenHuman backend nativo del trait Memory
Gemini CLI server MCP
Antigravity MCP + hook
Claude Desktop server MCP
Warp connect + MCP + skill
Zed server MCP
Cline server MCP
Continue server MCP
Droid server MCP
Kiro server MCP
Qwen Code server MCP
DeepSeek Harness acquisizione nativa + MCP
Roo Code server MCP
Kilo Code server MCP
Goose server MCP
Aider API REST
Oh My Pi ricerca nativa + acquisizione + skills + MCP facoltativo
Funziona con qualsiasi agente che parli MCP o HTTP. Un solo server, memorie condivise tra tutti.
---
### Archiviazione dei dati
Per impostazione predefinita, i ricordi restano fuori dal repository:
| Piattaforma | Directory dei dati |
|---|---|
| macOS | `~/Library/Application Support/agentmemory` |
| Linux | `$XDG_DATA_HOME/agentmemory` / `~/.local/share/agentmemory` |
| Windows | `%APPDATA%\agentmemory` |
L'istanza 0 riutilizza un `./data/state_store.db` esistente. Scegli un altro percorso con `--data-dir ` o `AGENTMEMORY_DATA_DIR` e mantienilo durante riavvii e aggiornamenti. `--instance 1` usa la sottocartella `instance-1`, la porta API `3211` e il visualizzatore `3213`. La [guida ad archiviazione e backup](../docs/reliability/state-storage.md) descrive Redis e migrazioni.
```bash
agentmemory --data-dir ~/.agentmemory-projects/main
agentmemory --instance 1
```
Note sull'ultima release: [CHANGELOG.md](../CHANGELOG.md).
---
Risultati attuali del recupero, definizioni delle metriche e procedura di riproduzione:
[0.9.31 · 2026-10-28 · strict recall-all@5](../docs/benchmarks/2026-10-28-retrieval-evaluation.md) · [eval/README.md](../eval/README.md).
---
Confronto aggiornato dei prodotti e delle opzioni di distribuzione, con fonti:
[AgentMemory / Mem0 / Supermemory / Zep / Letta / Cognee / claude-mem](../benchmark/COMPARISON.md) · 2026-10-28.
---
### Provalo in 30 secondi
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` crea 3 sessioni realistiche (autenticazione JWT, fix di una query N+1, rate limiting) ed esegue ricerche su di esse. Le installazioni keyless disabilitano i vettori, quindi le query per parole chiave `mem::search` dovrebbero funzionare tramite BM25 mentre `database performance optimization` può restituire zero risultati. `smart-search` può inoltre restituire corrispondenze strutturali del grafo quando i dati del grafo esistono. Per far trovare alla query semantica il fix dell'N+1 tramite i vettori, imposta `EMBEDDING_PROVIDER=local`, riavvia e lascia completare il primo download del modello.
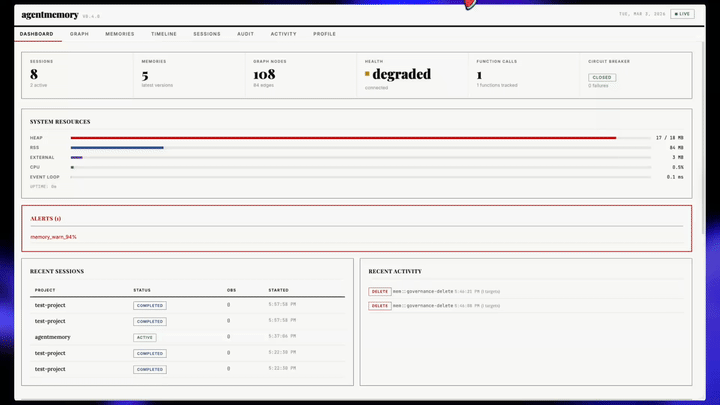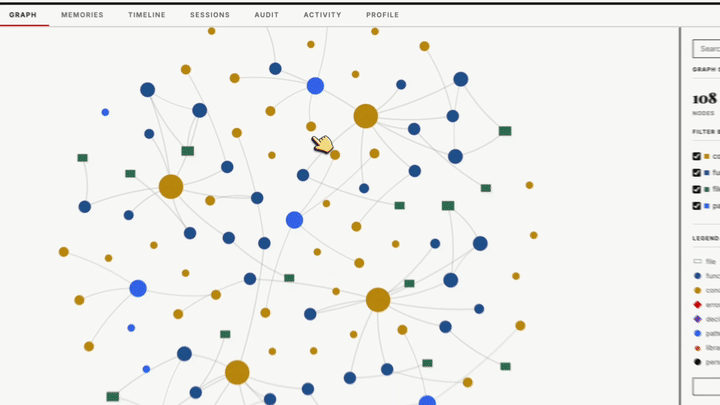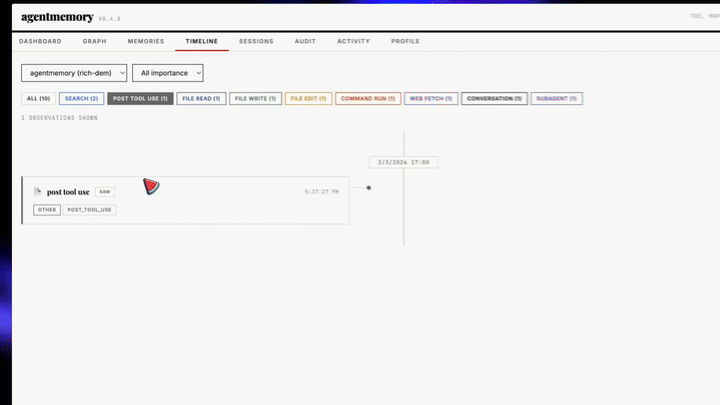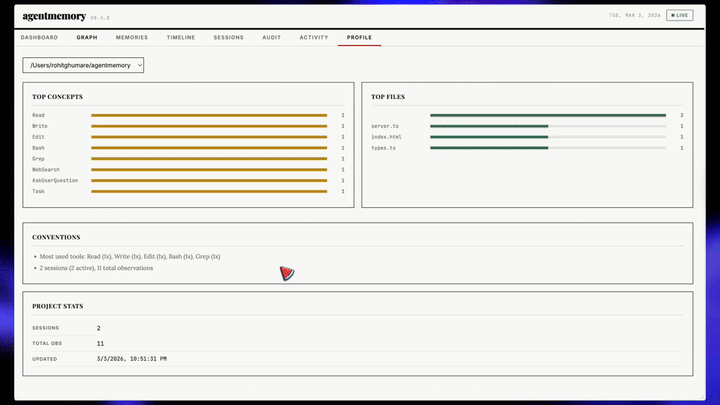
Apri `http://localhost:3113` per osservare la memoria costruirsi in tempo reale.
### Valida un'installazione nuova e la persistenza al riavvio
Con il server avviato, verifica salute, visualizzatore e stato:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
`status` mostra lo stato del server, i provider e gli embedding attivi. Salva un ricordo di prova e verifica la ricerca:
```bash
# Default generated local secret. For an explicit AGENTMEMORY_SECRET, use that value instead.
read -r AGENTMEMORY_SECRET < "$HOME/.agentmemory/secret"
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H "Authorization: Bearer $AGENTMEMORY_SECRET" \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H "Authorization: Bearer $AGENTMEMORY_SECRET" \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
Poi esegui `npx -y @agentmemory/agentmemory@latest stop`, riavvia il comando canonico nel Terminal 1, attendi `/agentmemory/livez` e ripeti la ricerca. La sonda deve essere ancora restituita. Se hai scelto un `--data-dir` personalizzato, passa la stessa directory al riavvio.
### Comandi quotidiani
Installazione e configurazione sono descritte in [Installazione](#install) sopra (la prima esecuzione ti guida passo passo). Quotidianamente:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### Replay delle sessioni
Ogni sessione registrata da agentmemory è riproducibile (replay). Apri il viewer, scegli la tab **Replay** e scorri la timeline: prompt, chiamate agli strumenti, risultati degli strumenti e risposte vengono renderizzati come eventi discreti con play/pause, controllo della velocità (da 0.5x a 4x) e scorciatoie da tastiera (spazio per attivare/disattivare, le freccie per avanzare passo passo).
Per importare transcript JSONL più vecchi di Claude Code:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
Le sessioni importate appaiono nel selettore Replay insieme a quelle native. Ogni transcript importato viene indicizzato per la ricerca, marcato con il canale di origine `import` ed elaborato per produrre un cristallo di sessione e delle lezioni.
> **Attenzione se usi `import-jsonl` come percorso di acquisizione principale:** `cleanupPeriodDays` di Claude Code (in `~/.claude/settings.json`, predefinito **30**) elimina automaticamente i transcript JSONL più vecchi di quella finestra da `~/.claude/projects/`. Se installi agentmemory su una cronologia di Claude Code vecchia di mesi, tutto ciò che ha più di 30 giorni è già sparito prima della prima importazione. Puoi eseguire `import-jsonl` tramite cron, aumentare `cleanupPeriodDays` a un valore più alto, oppure collegare gli hook di acquisizione automatica (il percorso di installazione predefinito del plugin) così che ogni turno finisca in agentmemory mentre la sessione è ancora attiva e la pulizia dei JSONL non sia più un problema.
### Aggiornamento / Manutenzione
Usa il comando di manutenzione quando vuoi intenzionalmente aggiornare il tuo runtime locale:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
Il comando aggiorna l'ambiente locale e può aggiornare le dipendenze JavaScript del workspace corrente. Esegui un backup e leggi la [guida all'aggiornamento](../docs/upgrades/iii-0.25.md) prima di procedere.
### Claude Code (un blocco, incollalo)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code senza l'installazione del plugin (percorso MCP standalone)
Se collegi il server MCP di agentmemory tramite `~/.claude.json` (percorso predefinito) direttamente invece di usare `/plugin install`, Claude Code non risolve mai `${CLAUDE_PLUGIN_ROOT}` e devi puntare gli script degli hook a percorsi assoluti in `~/.claude/settings.json` (percorso predefinito). Questi percorsi di solito incorporano la versione di agentmemory (ad es. `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`), quindi il prossimo aggiornamento rompe silenziosamente ogni hook.
Soluzione alternativa:
```bash
agentmemory connect claude-code --with-hooks
```
Questo comando configura il server MCP e unisce gli hook inclusi alla configurazione utente di Claude Code. Se `CLAUDE_CONFIG_DIR` non è impostata, è vuota o contiene solo spazi, usa `~/.claude.json` per MCP e `~/.claude/settings.json` per gli hook. Gli altri valori di directory vengono usati esattamente come forniti, inclusi gli spazi iniziali e finali. Per una directory personalizzata, imposta `CLAUDE_CONFIG_DIR` sullo stesso valore non vuoto sia per questo comando sia per Claude Code; i file saranno quindi rispettivamente `$CLAUDE_CONFIG_DIR/.claude.json` e `$CLAUDE_CONFIG_DIR/settings.json`. Claude Code deve ricevere questo valore nel proprio ambiente di avvio, anche se il connettore lo legge dal file `.env` di AgentMemory. Crea la directory personalizzata prima di eseguire questo comando; altrimenti il connettore ignora Claude Code perché non viene rilevato. Se il valore nella shell contiene solo spazi, rimuovi `CLAUDE_CONFIG_DIR` dall’ambiente prima di avviare Claude Code, in modo che usi anch’esso il profilo predefinito. Usa un percorso assoluto. I percorsi relativi vengono risolti dalla directory di lavoro, quindi entrambi i comandi devono essere eseguiti dalla stessa directory.
I comandi degli hook usano percorsi assoluti verso la directory `plugin/` inclusa nel pacchetto installato. Riesegui il comando dopo aver aggiornato agentmemory per aggiornare questi percorsi. Le voci utente nei file di configurazione vengono preservate; vengono sostituite solo le precedenti voci di agentmemory. L’uso di `/plugin install` rimane l’approccio consigliato.
Per deployment remoti o protetti, avvia Claude Code con `AGENTMEMORY_URL` e `AGENTMEMORY_SECRET` impostati. Il plugin passa entrambi i valori al suo server MCP incorporato; quando `AGENTMEMORY_URL` è vuoto, lo shim MCP usa `http://localhost:3111`.
### Codex CLI (piattaforma plugin di Codex)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
Il plugin Codex viene distribuito dalla stessa directory `plugin/` del plugin Claude Code. Registra:
- Un bridge MCP via stdio incorporato per il daemon in esecuzione, senza download npm né archivio di fallback. Consulta la [guida locale di Codex](../docs/plugins/codex-local.md) per testare una build non ancora rilasciata.
- 6 hook del ciclo di vita: `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop`
- 9 skill invocabili: `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, più 8 skill di riferimento che l'agente carica su richiesta (disciplina della memoria, strumenti MCP, API REST, configurazione, agenti, hook, architettura, e la guida alla scrittura delle skill)
Il motore degli hook di Codex inietta `CLAUDE_PLUGIN_ROOT` nei sottoprocessi degli hook (vedi [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)), quindi gli stessi script degli hook funzionano su entrambi gli host senza duplicazione. Gli eventi Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure sono esclusivi di Claude Code e non vengono registrati per Codex.
#### Fiducia e compatibilità degli hook di Codex
L'invio nativo degli hook del plugin è verificato con Codex CLI 0.150.1. Fidati degli hook del plugin prima di aspettarti l'acquisizione. Il comportamento su Desktop dipende dal suo runtime incorporato; controlla `/hooks` e conferma un evento acquisito prima di abilitare una soluzione alternativa.
Se il tuo host richiede hook globali, rispecchia i comandi in `~/.codex/hooks.json`. Quando l'MCP è già configurato, il connettore attuale richiede `--force` per raggiungere l'installazione degli hook:
```bash
agentmemory connect codex --with-hooks --force
```
Questo unisce gli hook globali e riscrive la voce MCP di agentmemory, preservando le voci non correlate. Rivedi eventuali impostazioni personalizzate dell'endpoint di agentmemory prima di usare `--force`. Riesegui dopo l'aggiornamento per aggiornare i percorsi degli script. Abilita gli hook nativi del plugin oppure le copie globali per evitare l'acquisizione duplicata.
### GitHub Copilot CLI
Per la modalità agente di VS Code, usa la [guida MCP e acquisizione automatica di Copilot](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions). Il connettore CLI non configura VS Code.
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` unisce `mcpServers.agentmemory` in `~/.copilot/mcp-config.json` (o `$COPILOT_HOME/mcp-config.json` quando `COPILOT_HOME` è impostato) e preserva i server esistenti. Su Windows nativo questo è l'unico adapter `connect` automatizzato; configura manualmente ogni altro agente Windows nativo. `connect` in WSL è adatto solo quando l'agente target è installato nel medesimo ambiente WSL. Copilot recepisce il server MCP al prossimo avvio o dopo `/mcp`. Installa anche il plugin quando vuoi l'esperienza completa di hook/skill.
### Cursor
```bash
agentmemory connect cursor
```
Aggiungi poi il plugin nativo da un checkout di AgentMemory tramite **Settings → Plugins → Add marketplace** e ricarica la finestra. Il plugin offre acquisizione del ciclo di vita, attribuzione al progetto, skills e MCP. Abilita i suoi hook oppure quelli manuali in `~/.cursor/hooks.json` per evitare acquisizioni duplicate. [Guida Cursor](../integrations/cursor/).
### Pi, Oh My Pi, DeepSeek Harness
```bash
agentmemory connect pi --with-mcp
agentmemory connect omp --with-mcp
agentmemory connect dsh --with-hooks
```
Scegli il comando per il tuo host. Pi e OMP installano ricerca, acquisizione, reinvio offline e 17 skills; `--with-mcp` aggiunge tutti gli strumenti. Esegui `/reload` in Pi oppure riavvia OMP, poi controlla `/agentmemory-status`. DSH installa MCP e il plugin di acquisizione incluso; riavvia DSH dopo la connessione.
Pi supporta anche il pacchetto installabile `@agentmemory/pi`. La [guida Pi](../integrations/pi/) descrive installazione locale e disponibilità su npm. Usa un solo metodo d'installazione per host.
[Pi](../integrations/pi/) · [Oh My Pi](../integrations/omp/) · [DSH](../docs/dsh.md)
OpenClaw (incolla questo prompt)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
Guida completa: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (incolla questo prompt)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from https://github.com/rohitg00/agentmemory to ~/.hermes/plugins/agentmemory.
```
Guida completa: [`integrations/hermes/`](../integrations/hermes/)
### Altri agenti
Avvia il server di memoria: `npx -y @agentmemory/agentmemory@latest`
#### Skill native tramite `npx skills add`
agentmemory distribuisce 17 skill nel formato `/SKILL.md` in stile Claude Code: 9 skill d'azione invocabili (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) e 8 skill di riferimento che l'agente carica su richiesta (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`). Le skill di riferimento portano tabelle di dati generate dalla fonte, quindi non diventano mai obsolete. La CLI [`skills`](https://npmjs.com/package/skills) di vercel-labs le installa automaticamente nella directory delle skill native dell'agente chiamante su 50+ agenti (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf, e altri):
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
Questo è **complementare** a `agentmemory connect `:
- `agentmemory connect ` normalmente scrive la configurazione MCP. Hermes, OpenClaw, Pi e Oh My Pi installano per impostazione predefinita la propria integrazione nativa e le skills incluse; MCP è facoltativo con `--with-mcp`.
- `npx skills add rohitg00/agentmemory` installa le skills per gli agenti che non le includono nativamente. Salta questo passaggio per Hermes, OpenClaw, Pi e Oh My Pi: i rispettivi connettori le installano già.
Per i pochi agenti che la CLI skills non copre ancora (Zed v1.3.x e versioni precedenti), copia tu stesso i 17 file SKILL.md nella directory delle skill native dell'agente; lo stesso formato funziona ovunque.
#### Blocco MCP standard
La voce agentmemory è lo **stesso blocco server MCP** su ogni host che usa la forma `mcpServers` (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw):
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**Unisci questa voce nell'oggetto `mcpServers` esistente** nel file di configurazione dell'host; non sostituire il file. Se il file ha già altri server, aggiungi `agentmemory` accanto a loro come un'altra chiave dentro `mcpServers`. Se `mcpServers` manca del tutto, incolla il blocco dentro `{ "mcpServers": { ... } }`. I placeholder `${VAR}` ereditano `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` dalla shell all'avvio del server MCP; le variabili non impostate passano stringhe vuote e lo shim ricade su `http://localhost:3111`. Una singola voce collegata copre sia i deployment locali che quelli remoti (k8s / dietro reverse-proxy).
| Agente | File di configurazione | Note |
|---|---|---|
| **Cursor (solo MCP)** | `~/.cursor/mcp.json` | Unisci in `mcpServers`, oppure `agentmemory connect cursor`. Disponibile anche un deeplink one-click sul sito web. |
| **Cursor (plugin completo)** | `.cursor-plugin/` | Aggiungi poi il plugin nativo da un checkout di AgentMemory tramite **Settings → Plugins → Add marketplace** e ricarica la finestra. Il plugin offre acquisizione del ciclo di vita, attribuzione al progetto, skills e MCP. Abilita i suoi hook oppure quelli manuali in `~/.cursor/hooks.json` per evitare acquisizioni duplicate. [Guida Cursor](../integrations/cursor/). |
| **Claude Desktop** | `claude_desktop_config.json` (Application Support) | Unisci in `mcpServers`. Riavvia Claude Desktop dopo la modifica. |
| **Cline / Roo Code / Kilo Code** | Impostazioni MCP di Cline (Settings UI → MCP Servers → Edit) | Stesso blocco `mcpServers`. |
| **Devin CLI (MCP + hook)** | `~/.config/devin/config.json` | `agentmemory connect devin` unisce la voce MCP; `--with-hooks` aggiunge sei hook nativi di acquisizione automatica (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) con i matcher di strumenti in minuscolo di Devin. Verifica con `devin mcp list` e `/hooks` dentro devin. |
| **Devin CLI (plugin completo)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` da un checkout registra tutte le 17 skill come slash command `/agentmemory:` più il server MCP. Gli hook del plugin di Devin non possono far scattare `SessionStart`/`SessionEnd`, quindi abbinalo a `connect devin --with-hooks` per una cattura completa della sessione. |
| **Devin (cloud)** | Settings → Connections → MCP servers | Aggiungi un MCP personalizzato (STDIO): comando `npx`, argomenti `-y @agentmemory/mcp@latest`, env `AGENTMEMORY_URL` che punta a un deployment agentmemory raggiungibile in rete più `AGENTMEMORY_SECRET` (le sessioni cloud non possono raggiungere localhost — vedi [`deploy/`](../deploy/)). Salva il secret in Devin Secrets, poi usa "Test listing tools" per verificare che tutti i 54 strumenti appaiano. |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (unisce automaticamente). |
| **GitHub Copilot CLI (solo MCP)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` unisce `mcpServers.agentmemory`; Copilot lo recepisce al prossimo avvio o con `/mcp`. |
| **GitHub Copilot CLI (plugin completo)** | Installazione plugin Copilot | `copilot plugin install rohitg00/agentmemory:plugin` per il plugin dalla sottodirectory GitHub. |
| **OpenClaw** | Configurazione MCP di OpenClaw | Stesso blocco `mcpServers`. Più in profondità: `openclaw plugins install ./integrations/openclaw` rivendica lo slot di memoria di OpenClaw (passa automaticamente da `memory-core`); imposta `plugins.entries.agentmemory.hooks.allowConversationAccess=true` altrimenti la cattura del turno viene bloccata silenziosamente. Vedi [`integrations/openclaw`](../integrations/openclaw/). |
| **Codex CLI (solo MCP)** | `.codex/config.toml` | Forma TOML: `codex mcp add agentmemory -- npx -y @agentmemory/mcp`, oppure aggiungi `[mcp_servers.agentmemory]` manualmente. |
| **Codex CLI (plugin completo)** | Marketplace plugin di Codex | `codex plugin marketplace add rohitg00/agentmemory` poi `codex plugin add agentmemory@agentmemory`. Registra MCP + 6 hook del ciclo di vita + 17 skill. Fidati degli hook e verifica l'acquisizione nel tuo host; consulta [configurazione e validazione di Codex](../docs/plugins/codex-local.md). |
| **OpenCode (solo MCP)** | `opencode.json` | Forma diversa: chiave di primo livello `mcp`, comando come array: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`. |
| **OpenCode (plugin completo)** | `plugin/opencode/` | 22 hook di acquisizione automatica che coprono il ciclo di vita della sessione, i messaggi, gli strumenti, gli errori. L'attribuzione del progetto è per sessione, quindi un singolo processo OpenCode che abbraccia più repository registra ogni sessione sotto il proprio progetto. Due slash command (`/recall`, `/remember`). Copia `plugin/opencode/` nel tuo workspace OpenCode e aggiungi la voce del plugin a `opencode.json`. Vedi [`plugin/opencode/README.md`](../plugin/opencode/README.md) per la tabella completa degli hook + l'analisi delle lacune. |
| **Pi / Oh My Pi** | `~/.pi/agent/` / `~/.omp/agent/` | ricerca nativa + acquisizione + skills. [Pi](../integrations/pi/) · [Oh My Pi](../integrations/omp/). |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` fornisce il provider di memoria a 6 hook (prefetch, cattura del turno, fine sessione, pre-compressione, mirroring di MEMORY.md, blocco del system prompt). Valida con `hermes plugins doctor` e `hermes memory status`. Vedi [`integrations/hermes`](../integrations/hermes/). |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` scrive il blocco standard `mcpServers`. Il payload degli hook è compatibile a livello di campi con Claude Code, quindi gli script esistenti dei 12 hook funzionano senza modifiche; collegali tramite la sezione `hooks` nello stesso `settings.json`. |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` installa l'MCP e gli hook di acquisizione nella directory di personalizzazione condivisa. Consulta [configurazione e limiti di Antigravity](../docs/plugins/antigravity.md). |
| **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` usa la stessa configurazione MCP e hook delle versioni IDE attuali. Le installazioni esistenti dovrebbero aggiornare con `--force`; consulta le [note di aggiornamento](../docs/plugins/antigravity.md). |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` scrive la configurazione a livello utente. Gli override per workspace vanno in `.kiro/settings/mcp.json` accanto al tuo codice. |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` scrive il blocco standard `mcpServers`. Warp rileva automaticamente anche le skill da `.claude/skills/`; una volta installato il plugin Claude Code, le 9 skill di agentmemory (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) appaiono nativamente nella palette slash-command di Warp. |
| **Cline (CLI)** | `~/.cline/data/settings/cline_mcp_settings.json` | `agentmemory connect cline` scrive il blocco standard `mcpServers`. Utenti dell'estensione VS Code: incolla lo stesso blocco tramite Cline Settings → MCP Servers → Edit JSON. |
| **Continue.dev** | `~/.continue/config.yaml` (preferito) o `config.json` (legacy) | `agentmemory connect continue` crea `config.yaml` se manca o modifica il `config.json` esistente. Se il file YAML esiste, mostra il blocco da aggiungere a `mcpServers:` per conservare commenti e ancore. Continue usa un array, non un oggetto. |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` scrive sotto `context_servers` (la chiave di Zed, NON `mcpServers`). I server MCP remoti possono essere collegati tramite `{"url": "..."}` invece. |
| **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` scrive il blocco standard `mcpServers`. Gli override a livello di progetto vanno in `/.factory/mcp.json`. Passa `--with-hooks` per l'acquisizione automatica nativa. |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` abilita gli strumenti MCP. Aggiungi `--with-hooks` per caricare il plugin nativo di acquisizione incluso in AgentMemory. Non serve un pacchetto aggiuntivo. [DSH](../docs/dsh.md). |
| **Goose** | UI delle impostazioni MCP di Goose | Stesso blocco `mcpServers`; usa `goose configure` → Add Extension → MCP. La modifica diretta del YAML in `~/.config/goose/config.yaml` è supportata ma lo schema usa `extensions:` + `cmd` (non `mcpServers:` + `command`). |
| **Aider** | n/d | Usa gli [esempi REST autenticati](#validate-a-fresh-install-and-restart-persistence) per salvare e cercare ricordi dagli script. |
| **Agenti supportati** | Solo skills | `npx skills add rohitg00/agentmemory`; scegli le skills e gli agenti in cui installarle. |
**Client MCP in sandbox** (Flatpak / Snap / container restrittivi) che non possono raggiungere il `localhost` dell'host: imposta anche `"AGENTMEMORY_FORCE_PROXY": "1"` nel blocco `env`, e punta `AGENTMEMORY_URL` verso una rotta che la sandbox possa effettivamente raggiungere (ad es. il tuo IP LAN).
### Accesso programmatico (Python / Rust / Node)
Usa l'[API REST](#api) da qualsiasi linguaggio o gli [strumenti MCP](#mcp-server) da un agente. REST usa JSON e autenticazione bearer; consulta l'[esempio di salvataggio e ricerca](#validate-a-fresh-install-and-restart-persistence). Gli [esempi Python](../examples/python/) coprono l'integrazione diretta con il runtime.
### Dal codice sorgente
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
`npm start` avvia lo stesso server locale della CLI installata. I prerequisiti sono in [Install](#install); API e visualizzatore ascoltano su `127.0.0.1`.
### Windows
agentmemory funziona su Windows 10/11. WSL2 segue il percorso Linux e può installare automaticamente l'engine fissato. Su Windows nativo, installare manualmente il binario iii-engine v0.25.1 fissato: scaricare l'archivio corrispondente dalla [pagina della release iii 0.25.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.25.1), verificarne il checksum e mettere `iii.exe` nel `PATH` (ad esempio `%USERPROFILE%\.local\bin\iii.exe`). La CLI non estrae automaticamente lo ZIP Windows.
La configurazione MCP automatica su Windows nativo supporta solo `agentmemory connect copilot-cli`. Per gli altri agenti Windows nativi, usare il blocco MCP manuale da [Altri agenti](#other-agents). Eseguire `connect` in WSL solo se l'agente di destinazione è installato nello stesso ambiente WSL.
**Solo MCP autonomo (senza engine).** Se servono soltanto gli strumenti MCP, senza API REST, visualizzatore o servizi runtime:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or
npx -y @agentmemory/mcp
```
Esegui `agentmemory doctor` o riavvia con `--verbose`. Usa `--port ` o `--instance ` se le porte sono occupate. Compatibilità e ripristino sono nella [guida all'aggiornamento](../docs/upgrades/iii-0.25.md).
---
Deploy
Ospita il servizio con Docker Compose o i modelli seguenti. Memoria e credenziali risiedono nel volume `/data`. Esegui il backup e riutilizza il volume durante gli aggiornamenti. La [guida al deployment](../deploy/README.md) copre autenticazione, rete, backup e migrazione.
Il pulsante di deploy one-click di Render richiede `render.yaml` nella radice del repository, che manteniamo deliberatamente puro. Usa il flusso Render Blueprint documentato in [`deploy/render/`](.././deploy/render/README.md) per puntare manualmente al blueprint nel repository.
I dettagli completi di configurazione (acquisizione HMAC, tunnel SSH per il viewer, rotazione, backup,
costi minimi) si trovano in [`deploy/`](.././deploy/README.md):
- [`deploy/fly`](.././deploy/fly/README.md): macchina singola con
`auto_stop_machines = "stop"`; il minimo costo a riposo.
- [`deploy/railway`](.././deploy/railway/README.md): tariffa fissa del piano Hobby,
volume nella dashboard.
- [`deploy/render`](.././deploy/render/README.md): flusso Blueprint,
snapshot automatici del disco sui piani a pagamento.
- [`deploy/coolify`](.././deploy/coolify/README.md): self-hosted sul tuo
VPS tramite [Coolify](https://coolify.io/self-hosted); stesso stack Docker
Compose, tu possiedi l'host e i dati.
REST usa la porta `3111`; il visualizzatore usa `3113`. Mantienili privati o proteggili con autenticazione e TLS. Consulta la guida al deployment per l'esposizione in rete e la [migrazione delle vecchie installazioni Docker](../deploy/README.md#migrating-from-the-legacy-cli-docker-mode).
---
Le conoscenze del progetto si disperdono tra chat e file di istruzioni. AgentMemory rende ricercabili decisioni, soluzioni e lezioni apprese dall’agente che stai usando.
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
Connected hooks capture supported tool events
Observations become searchable project history
Session 2: "Now add rate limiting"
Agent recalls:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Continues with the earlier decisions in context.
```
### vs la memoria integrata degli agenti
Ogni agente di coding AI ha una memoria integrata: Claude Code ha `MEMORY.md`, Cursor ha i notepad, Cline ha la memory bank. Funzionano come post-it. agentmemory è il database ricercabile dietro i post-it.
| | Integrata (CLAUDE.md) | agentmemory |
|---|---|---|
| Manutenzione | Istruzioni curate manualmente | Cronologia delle sessioni e ricordi indicizzati |
| Ricerca | Carica tutto nel contesto | BM25 + vettoriale + grafo (solo top-K) |
| Cross-agente | File per agente | MCP + REST (qualsiasi agente) |
| Coordinamento | Nessuno | Lease, segnali, azioni, routine |
| Osservabilità | Lettura manuale dei file | Viewer in tempo reale su :3113 |
---
### Pipeline della memoria
```text
PostToolUse hook fires
-> Stable event ID / durable capture inbox / offline spool
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if AGENTMEMORY_SLOTS=true and AGENTMEMORY_REFLECT=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject context when enabled by the integration
```
### Consolidamento della memoria a 4 livelli
Modellato su come i cervelli umani elaborano la memoria, incluso il consolidamento durante il sonno.
| Livello | Cosa | Analogia |
|------|------|---------|
| **Working** | Osservazioni grezze dall'uso degli strumenti | Memoria a breve termine |
| **Episodic** | Riassunti compressi delle sessioni | "Cosa è successo" |
| **Semantic** | Fatti e pattern estratti | "Cosa so" |
| **Procedural** | Flussi di lavoro e pattern decisionali | "Come farlo" |
Le memorie decadono nel tempo (curva di Ebbinghaus). Le memorie accedute frequentemente si rafforzano. Le memorie obsolete vengono eliminate automaticamente. Le contraddizioni vengono rilevate e risolte.
### Cosa viene catturato
Questa tabella descrive gli hook di Claude Code. Le altre integrazioni acquisiscono gli eventi forniti dal proprio host; consulta le relative guide. L'iniezione automatica del contesto tramite gli hook condivisi richiede `AGENTMEMORY_INJECT_CONTEXT=true`.
| Hook | Catture |
|------|----------|
| `SessionStart` | Percorso del progetto, ID sessione |
| `UserPromptSubmit` | Prompt dell'utente (filtrati per privacy) |
| `PreToolUse` | Pattern di accesso ai file + contesto arricchito |
| `PostToolUse` | Nome dello strumento, input, output |
| `PostToolUseFailure` | Contesto dell'errore |
| `PreCompact` | Reinietta la memoria prima della compattazione |
| `SubagentStart/Stop` | Ciclo di vita dei sub-agenti |
| `Stop` | Riassunto di fine sessione |
| `SessionEnd` | Marcatore di sessione completata |
### Capacità principali
| Capacità | Descrizione |
|---|---|
| **Acquisizione automatica** | Le integrazioni native registrano gli eventi di sessione e degli strumenti supportati |
| **Ricerca semantica** | BM25 + vettoriale + grafo di conoscenza con fusione RRF |
| **Evoluzione della memoria** | Versionamento, supersessione, grafi di relazioni |
| **Igiene del recall** | Le versioni superate della memoria escono dagli indici di ricerca; la catena delle versioni nel KV conserva la storia completa |
| **Suggerimenti di quasi-duplicati** | I salvataggi segnalano un match consultivo `similarTo` quando un nuovo contenuto assomiglia molto a una memoria esistente |
| **Scoping per agente** | `agentId` attraversa salvataggio e recall su REST, MCP e l'indice di ricerca, in modalità condivisa o isolata |
| **Provenienza al momento della scrittura** | Ogni osservazione e memoria porta un canale di origine immutabile (user, agent, tool, import o shared) impresso al momento della cattura, del salvataggio e dell'importazione |
| **Auto-oblio** | Scadenza TTL, rilevamento di contraddizioni, eliminazione per importanza |
| **Privacy prima di tutto** | Chiavi API, segreti, tag `` rimossi prima della memorizzazione |
| **Auto-guarigione** | Circuit breaker, catena di fallback dei provider, monitoraggio della salute |
| **Bridge Claude** | Sincronizzazione bidirezionale con MEMORY.md |
| **Grafo di conoscenza** | Estrazione di entità + attraversamento BFS |
| **Memoria di team** | Condivisa e privata con namespace tra i membri del team |
| **Provenienza delle citazioni** | Risali da qualsiasi memoria alle osservazioni di origine |
| **Snapshot Git** | Versiona, ripristina e confronta lo stato della memoria |
---
Recupero a triplo flusso che combina tre segnali:
| Flusso | Cosa fa | Quando |
|---|---|---|
| **BM25** | Corrispondenza di parole chiave con stemming ed espansione di sinonimi | Sempre attivo |
| **Vettoriale** | Similarità coseno su embedding densi | Provider di embedding configurato |
| **Grafo** | Attraversamento del grafo di conoscenza tramite corrispondenza di entità | Entità rilevate nella query |
Fuso con Reciprocal Rank Fusion (RRF, k=60) e diversificato per sessione (massimo 3 risultati per sessione).
Quando un indice vettoriale è popolato, `mem::search` (dietro `memory_recall`) usa il ranker ibrido BM25 + vettoriale. Senza embedding usa BM25. `smart-search` può inoltre fondere corrispondenze strutturali del grafo quando i dati del grafo esistono, anche in modalità keyless. Il recall delle lezioni funziona su un indice BM25 dedicato in memoria invece di scansionare l'intero corpus per ogni query. Le versioni superate della memoria sono escluse da ogni percorso di recall; la catena delle versioni conserva la loro storia.
[0.9.31: `AGENTMEMORY_VECTOR_BACKFILL=all` / `AGENTMEMORY_VECTOR_BACKFILL_MAX`](../docs/reliability/source-and-vector-recovery.md).
BM25 tokenizza nativamente greco, cirillico, ebraico, arabo e latino accentato. Per le memorie in cinese / giapponese / coreano, installa i segmentatori opzionali (`npm install @node-rs/jieba tiny-segmenter`) per dividere le sequenze CJK in token a livello di parola; senza di essi, agentmemory ricade in modo graduale sulla tokenizzazione dell'intera sequenza e stampa un suggerimento una tantum su stderr.
### Provider di embedding
Le installazioni keyless disabilitano gli embedding vettoriali: `mem::search` usa BM25, mentre `smart-search` può anche usare i dati strutturali esistenti del grafo. Per attivare gli embedding semantici gratuiti on-device, aggiungi questo a `~/.agentmemory/.env` e riavvia agentmemory:
```env
EMBEDDING_PROVIDER=local
```
L'installazione npm normale include il runtime opzionale `@huggingface/transformers`. La prima richiesta di embedding scarica `Xenova/all-MiniLM-L6-v2`, quindi serve l'accesso alla rete e può richiedere più tempo; l'inferenza successiva viene eseguita on-device. I provider remoti vengono rilevati automaticamente dalle loro chiavi a meno che `EMBEDDING_PROVIDER` non le sovrascriva.
| Provider | Modello | Costo | Note |
|---|---|---|---|
| **Locale (consigliato come opt-in)** | `all-MiniLM-L6-v2` | Gratuito | [`EMBEDDING_PROVIDER=local`](../README.md#embedding-providers) |
| Gemini | `gemini-embedding-001` | Livello gratuito | 100+ lingue, 768/1536/3072 dimensioni (MRL), input di 2048 token. Sostituisce `text-embedding-004` ([deprecato, spegnimento il 14 gennaio 2026](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | [OpenAI](https://openai.com/api/pricing/) | [text-embedding-3-small](https://platform.openai.com/docs/models/text-embedding-3-small) |
| Voyage AI | `voyage-code-3` | A pagamento | Ottimizzato per il codice |
| Cohere | `embed-english-v3.0` | Prova gratuita | Uso generale |
| OpenRouter | Qualsiasi modello | Variabile | Proxy multi-modello |
---
54 strumenti, 6 risorse, 3 prompt e 17 skill.
> **Shim MCP vs server completo:** il pacchetto pubblicato `@agentmemory/mcp` è uno shim leggero. Espone la superficie completa di 54 strumenti **solo quando può raggiungere un server agentmemory in esecuzione** tramite `AGENTMEMORY_URL` (modalità proxy). Senza un server raggiungibile, lo shim ricade su un set locale di 7 strumenti (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`). La variabile d'ambiente `AGENTMEMORY_TOOLS=core|all` è un flag *lato server*; impostarla nel blocco `env` dello shim non ha alcun effetto. Se vedi solo 7 strumenti in Cursor / OpenCode / Gemini CLI, avvia `npx -y @agentmemory/agentmemory@latest` (o lo stack Docker) e imposta `AGENTMEMORY_URL=http://localhost:3111`.
### 54 strumenti
Tre superfici di strumenti, dalla più piccola alla più grande: `AGENTMEMORY_TOOLS=core` riduce la visibilità a 8 strumenti essenziali (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`); il set base sotto è composto dai 14 strumenti fondamentali del registro; il predefinito (`AGENTMEMORY_TOOLS=all`) espone tutti i 54.
Strumenti base (14)
| Strumento | Descrizione |
|------|-------------|
| `memory_recall` | Cerca osservazioni passate |
| `memory_compress_file` | Comprime file markdown preservando la struttura |
| `memory_save` | Salva un'intuizione, una decisione o un pattern |
| `memory_file_history` | Osservazioni passate su file specifici |
| `memory_patterns` | Rileva pattern ricorrenti |
| `memory_sessions` | Elenca le sessioni recenti |
| `memory_smart_search` | Ricerca ibrida semantica + per parole chiave |
| `memory_vision_search` | Cerca osservazioni di immagini |
| `memory_timeline` | Osservazioni in ordine cronologico |
| `memory_profile` | Profilo del progetto (concetti, file, pattern) |
| `memory_export` | Esporta tutti i dati di memoria |
| `memory_relations` | Interroga il grafo delle relazioni |
| `memory_commit_lookup` | Sessioni dietro un commit git |
| `memory_commits` | Commit registrati per una sessione |
Strumenti estesi (54 totali, la superficie predefinita)
| Strumento | Descrizione |
|------|-------------|
| `memory_patterns` | Rileva pattern ricorrenti |
| `memory_timeline` | Osservazioni in ordine cronologico |
| `memory_relations` | Interroga il grafo delle relazioni |
| `memory_graph_query` | Attraversamento del grafo di conoscenza |
| `memory_consolidate` | Esegue il consolidamento a 4 livelli |
| `memory_claude_bridge_sync` | Sincronizza con MEMORY.md |
| `memory_team_share` | Condivide con i membri del team |
| `memory_team_feed` | Elementi condivisi recenti |
| `memory_audit` | Traccia di controllo delle operazioni |
| `memory_governance_delete` | Elimina con traccia di controllo |
| `memory_snapshot_create` | Snapshot versionato con Git |
| `memory_action_create` | Crea elementi di lavoro con dipendenze |
| `memory_action_update` | Aggiorna lo stato di un'azione |
| `memory_frontier` | Azioni non bloccate classificate per priorità |
| `memory_next` | La singola azione successiva più importante |
| `memory_lease` | Lease esclusivi per azioni (multi-agente) |
| `memory_routine_run` | Istanzia routine di workflow |
| `memory_signal_send` | Messaggistica tra agenti |
| `memory_signal_read` | Legge i messaggi con ricevute |
| `memory_checkpoint` | Gate su condizioni esterne |
| `memory_mesh_sync` | Sincronizzazione P2P tra istanze |
| `memory_sentinel_create` | Osservatori basati su eventi |
| `memory_sentinel_trigger` | Attiva i sentinel dall'esterno |
| `memory_sketch_create` | Grafi di azione effimeri |
| `memory_sketch_promote` | Promuove a permanente |
| `memory_crystallize` | Compatta catene di azioni |
| `memory_diagnose` | Controlli di salute |
| `memory_heal` | Auto-correzione di stati bloccati |
| `memory_facet_tag` | Tag dimensione:valore |
| `memory_facet_query` | Interroga per tag di facet |
| `memory_verify` | Traccia la provenienza |
### 6 risorse · 3 prompt · 17 skill
| Tipo | Nome | Descrizione |
|------|------|-------------|
| Risorsa | `agentmemory://status` | Salute, conteggio sessioni, conteggio memorie |
| Risorsa | `agentmemory://project/{name}/profile` | Intelligence per progetto |
| Risorsa | `agentmemory://project/{name}/recent` | Osservazioni recenti per un progetto |
| Risorsa | `agentmemory://memories/latest` | Ultime 10 memorie attive |
| Risorsa | `agentmemory://graph/stats` | Statistiche del grafo di conoscenza |
| Risorsa | `agentmemory://team/{id}/profile` | Profilo di team condiviso |
| Prompt | `recall_context` | Cerca e restituisce messaggi di contesto |
| Prompt | `session_handoff` | Dati di passaggio tra agenti |
| Prompt | `detect_patterns` | Analizza pattern ricorrenti |
| Skill | `/recall` | Cerca nella memoria |
| Skill | `/remember` | Salva nella memoria a lungo termine |
| Skill | `/session-history` | Riassunti delle sessioni recenti |
| Skill | `/forget` | Elimina osservazioni/sessioni |
La tabella mostra le quattro skill core. Il set completo è di 9 skill invocabili più 8 skill di riferimento; vedi la sezione Skill native sopra.
### MCP standalone
Eseguilo senza il server completo, per qualsiasi client MCP. Funziona uno dei due:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
Oppure aggiungi alla configurazione MCP del tuo agente:
La maggior parte degli agenti (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
Unisci la voce `agentmemory` nell'oggetto `mcpServers` esistente del tuo host invece di sostituire il file. Per i client in sandbox che non possono raggiungere il `localhost` dell'host, aggiungi `"AGENTMEMORY_FORCE_PROXY": "1"` al blocco env e imposta `AGENTMEMORY_URL` su una rotta che la sandbox possa raggiungere.
OpenCode (`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
Copia il file del plugin dal repository:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---
Il visualizzatore si avvia automaticamente sulla porta `3113`. Al collegamento carica uno snapshot (`GET /agentmemory/viewer/snapshot`), poi applica gli eventi live tramite SSE su `/agentmemory/viewer/events` nel worker REST: memorie, lezioni, osservazioni, voci di audit, modifiche al grafo e aggiornamenti health compaiono senza polling o ricaricamenti della pagina.
- **12 tab in quattro gruppi** con conteggi dal vivo, deep link (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), scorciatoie da tastiera e un menu mobile.
- **Memorie:** ricerca lato server, filtri per progetto, agente e tipo, un pannello di dettaglio con la catena delle versioni e un diff per parola, link di provenienza, pulsanti copia per l'id, la chiamata MCP e un comando curl, modifica (una nuova versione), dimentica con conferma, dimentica in blocco ed esportazione JSON.
- **Sessioni:** una timeline di osservazioni inline con input e output degli strumenti leggibili, filtri e paginazione, e le memorie e le lezioni prodotte da ogni sessione.
- **Grafo:** ricerca, dettaglio del nodo con relazioni e fonti, una legenda che non si basa solo sul colore, e controlli di zoom.
- **Salute:** la versione dal vivo di `GET /agentmemory/status`. Ogni problema arriva con la sua soluzione, oltre al backend di stato, lo stato di salvataggio dell'indice, l'avanzamento della compattazione della provenienza del grafo e una spiegazione del consolidamento con le soglie reali.
- Pagine **Audit, Attività, Profilo, Replay, Lezioni, Azioni e Cristalli**, ognuna con uno stato vuoto che spiega cosa è la sezione, perché è vuota e il comando che la popola, e un tooltip glossario `?` su ogni termine e numero.
```bash
open http://localhost:3113
```
Il server del viewer si collega a `127.0.0.1` per impostazione predefinita e aggiunge il secret del server quando inoltra le richieste all'API REST, quindi non richiede configurazione. L'endpoint `/agentmemory/viewer` servito via REST segue le normali regole del bearer-token e reindirizza i browser senza token alla porta del viewer. Gli header CSP usano un nonce dello script per risposta e disabilitano gli attributi di gestore inline (`script-src-attr 'none'`).
---
### Provider LLM
agentmemory rileva automaticamente i provider dal tuo ambiente. Un provider rende disponibili le operazioni basate su LLM, ma la sola configurazione del provider non attiva la compressione delle osservazioni scritta da un LLM. Quel percorso richiede sia un provider sia `AGENTMEMORY_AUTO_COMPRESS=true`.
| Provider | Configurazione | Note |
|----------|--------|-------|
| **No-op (predefinito)** | Nessuna configurazione necessaria | Compress/summarize basati su LLM disabilitati. La compressione sintetica e il recall BM25 funzionano comunque. Vedi `AGENTMEMORY_ALLOW_AGENT_SDK` sotto se facevi affidamento sul fallback dell'abbonamento Claude. |
| Anthropic API | `ANTHROPIC_API_KEY` | Fatturazione per token |
| MiniMax | `MINIMAX_API_KEY` | Compatibile con Anthropic |
| Gemini | `GEMINI_API_KEY` | Abilita anche gli embedding |
| OpenRouter | `OPENROUTER_API_KEY` | Qualsiasi modello |
| OpenAI API | `OPENAI_API_KEY` | Predefinito `gpt-5.6-luna`, sovrascrivi con `OPENAI_MODEL` |
| **Locale (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) oppure `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | Qualsiasi cosa compatibile con l'API OpenAI. Costo zero, funziona sul tuo hardware. Vedi [Modelli locali](#local-models-ollama--lm-studio--vllm) sotto. |
| Fallback abbonamento Claude | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | Solo opt-in. Avvia sessioni `@anthropic-ai/claude-agent-sdk`; in passato causava una ricorsione illimitata dell'hook Stop, quindi non è più il predefinito. |
### Modelli locali (Ollama / LM Studio / vLLM)
agentmemory parla con qualsiasi server compatibile con l'API OpenAI, quindi qualsiasi cosa esponga `/v1/chat/completions` funziona senza modifiche al codice. Nessuna chiave a pagamento, nessun cloud, nessun limite di rate; funziona interamente sul tuo hardware.
**Ollama** (porta predefinita `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio** (porta predefinita `1234`):
Apri LM Studio → tab Local Server → Start Server. Scegli qualsiasi modello di chat dal selettore (Qwen 3, gpt-oss, DeepSeek R1, ecc.).
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**: stessa forma. Punta `OPENAI_BASE_URL` all'URL esposto dal tuo server e imposta `OPENAI_MODEL` su un nome che il tuo server accetterà.
**Scelte di modello per il lavoro di memoria**: compressione e riassunto sono compiti brevi (<2K token in ingresso, <500 token in uscita) dove un modello instruct da 7B è più che sufficiente. Raccomandazioni:
| Modello | Dimensione | Perché |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | Default equilibrato su una macchina da 16 GB; forte nell'estrazione e nel testo a forma di strumento |
| `qwen3:4b` | ~2.6 GB | Opzione più piccola ragionevole; va bene per la compressione, più debole per l'estrazione del grafo |
| `qwen3-coder:30b` | ~19 GB | Migliore scelta locale per sessioni a forma di codice (30B MoE, 3.3B attivi) su hardware da 24-32 GB |
| `gpt-oss:20b` | ~14 GB | Modello generale forte che entra in 16 GB di RAM |
| `deepseek-r1:8b` | ~5.2 GB | Distillazione di reasoning; più lento ma estrazioni più pulite |
I modelli Qwen 3 "pensano" per default e possono bruciare tutto il budget di token nel reasoning prima di qualsiasi output. Imposta `AGENTMEMORY_LLM_NOTHINK=1` per aggiungere `/no_think` ai prompt di estrazione del grafo, e aumenta `MAX_TOKENS` (16384 funziona) se le estrazioni tornano vuote.
I modelli di classe reasoning (stile `o1` con blocchi ``) possono restituire un `content` vuoto con un campo `reasoning` che il tuo server locale potrebbe non esporre. Se le estrazioni tornano vuote, passa prima a un modello non-reasoning. La variabile d'ambiente `OPENAI_REASONING_EFFORT=none` può anche disabilitare il pensiero sui modelli di pensiero di Ollama Cloud che rispecchiano lo schema di reasoning di OpenAI.
Gli embedding locali sono distribuiti come dipendenza opzionale ma non sono abilitati per default. Imposta `EMBEDDING_PROVIDER=local` per attivare `Xenova/all-MiniLM-L6-v2` (384 dimensioni). La prima richiesta di embedding scarica il modello; l'inferenza è on-device in seguito. Senza quell'impostazione o una chiave di embedding remota, i vettori restano disabilitati, `mem::search` usa BM25, e `smart-search` può comunque aggiungere corrispondenze del grafo esistenti.
### Selezione del modello consapevole dei costi
Inizia senza chiave per acquisizione e ricerca per parole chiave. `EMBEDDING_PROVIDER=local` attiva la ricerca semantica locale dopo il primo download del modello. La compressione LLM richiede un provider e `AGENTMEMORY_AUTO_COMPRESS=true`; può inviare una richiesta per ogni osservazione. Controlla i prezzi attuali del provider prima di attivarla. Visualizzatore e `agentmemory status` mostrano i provider attivi.
### Memoria multi-agente (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
Nelle configurazioni multi-agente dove diversi ruoli condividono un server agentmemory (architetto / sviluppatore / revisore / ricercatore / agente di supporto), `AGENT_ID` etichetta ogni scrittura con il ruolo che l'ha fatta. `AGENTMEMORY_AGENT_SCOPE` controlla se il recall filtra per quella etichetta.
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
Due modalità:
| Modalità | Etichetta le scritture | Filtra il recall | Quando usarla |
|------|------------|---------------|-------------|
| `shared` (predefinita) | sì | no | Contesto cross-agente con traccia di controllo. L'architetto può vedere ciò che lo sviluppatore ha annotato, ma ogni riga registra chi lo ha detto. |
| `isolated` | sì | sì | Separazione stretta. L'architetto non vede mai le osservazioni/memorie/sessioni dello sviluppatore. |
Cosa viene etichettato quando `AGENT_ID` è impostato: `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId`. Il ruolo fluisce da `api::session::start` → `mem::observe` → `mem::compress` → KV.
Cosa viene filtrato in modalità isolata: `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions`. Ogni endpoint accetta `?agentId=` per sovrascrivere per-richiesta, e `?agentId=*` per disattivare completamente lo scope dell'ambiente. `/memories` accetta anche `?includeOrphans=true` per far emergere le memorie precedenti ad `AGENT_ID` il cui `agentId` è indefinito.
Override per-chiamata a livello di SDK / REST: ogni endpoint che muta (`/session/start`, `/remember`) accetta un campo `agentId` nel corpo della richiesta che vince sull'ambiente. Utile per i runtime che instradano molti ruoli attraverso un singolo processo server. Lo strumento MCP `memory_save` espone lo stesso campo `agentId`, il server stdio standalone trasmette sia `agentId` sia `project`, e le memorie salvate portano `agentId` nell'indice di ricerca, così la ricerca con ambito agente copre anche le memorie oltre alle osservazioni.
Quando `AGENT_ID` non è impostato, la memoria resta senza ambito (comportamento legacy, nessuna etichetta, nessun filtro).
### Porte
| Porta | Uso | Configurazione |
|---|---|---|
| `3111` | REST API, MCP HTTP, SSE | `III_REST_PORT` |
| `3113` | Viewer UI | `III_VIEWER_PORT` |
`--port ` imposta la porta API e, per impostazione predefinita, il visualizzatore su `N+2`. Usa `--instance N` per un'istanza separata. Le porte interne devono restare private; consulta la [guida al deployment](../deploy/README.md) prima di abilitare l'accesso remoto.
### Backend di archiviazione: file (predefinito) o Redis
L'archivio su file predefinito non richiede un servizio database separato. Redis è facoltativo con `AGENTMEMORY_STATE_BACKEND=redis` e `AGENTMEMORY_REDIS_URL`. Cambiare backend non copia i ricordi. La [guida ad archiviazione e backup](../docs/reliability/state-storage.md) descrive persistenza, limiti di Redis ed esportazione/importazione autenticata.
### File di configurazione
Inserire la configurazione runtime di agentmemory in `~/.agentmemory/.env` invece di esportare variabili in ogni shell. Se il visualizzatore mostra un suggerimento come `export ANTHROPIC_API_KEY=...`, copiarlo nel file senza il prefisso `export`, quindi riavviare agentmemory. Impostare `AGENTMEMORY_ENV_FILE` per usare un altro percorso del file env.
Le variabili d'ambiente del processo hanno precedenza sul file. Riavvia il server dopo aver modificato la configurazione.
Su Windows, lo stesso file risiede in `%USERPROFILE%\.agentmemory\.env`:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
Per testare con un abbonamento Claude Code Pro/Max invece di una chiave API, attiva l'opzione esplicitamente:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
La compressione delle osservazioni scritta da un LLM richiede entrambe le righe: accesso a un provider LLM (incluso questo fallback esplicito dell'abbonamento) e `AGENTMEMORY_AUTO_COMPRESS=true`. Un provider da solo lascia in vigore il percorso predefinito di compressione sintetica.
Il consolidamento (nodi del grafo, lezioni, cristalli) è attivo per default ogni volta che è configurato un provider LLM. Disattivalo esplicitamente con `CONSOLIDATION_ENABLED=false` se vuoi un funzionamento senza LLM. L'estrazione del grafo è un flag separato:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### Variabili d'ambiente
Opzioni comuni per `~/.agentmemory/.env`:
```env
EMBEDDING_PROVIDER=local
# AGENTMEMORY_INJECT_CONTEXT=true
# AGENTMEMORY_AUTO_COMPRESS=true
# AGENTMEMORY_TOOLS=core
# AUTO_FORGET_ENABLED=false
# LESSON_DECAY_ENABLED=false
# INSIGHT_DECAY_ENABLED=false
```
La documentazione completa è in [`.env.example`](../.env.example): credenziali, filtri, conservazione, archiviazione, ambito del team e opzioni. `AGENTMEMORY_ENV_FILE` seleziona un altro file. Non includere in git un `.env` compilato o un segreto bearer.
---
147 endpoint sulla porta `3111`. L'API REST si collega a `127.0.0.1` per impostazione predefinita. Gli endpoint protetti richiedono `Authorization: Bearer `, e gli endpoint di sincronizzazione mesh richiedono un `AGENTMEMORY_SECRET` impostato esplicitamente su entrambi i peer.
**L'autenticazione è attiva per default.** Se `AGENTMEMORY_SECRET` non è impostato nella shell o in `~/.agentmemory/.env`, al primo avvio la CLI genera un segreto casuale in `~/.agentmemory/secret` e ne conserva una copia chiamata `secret` nella directory dati selezionata, con permessi `0600`. Ogni client incluso lo legge da lì quando parla con un server locale: la CLI, il viewer, gli hook sotto `plugin/scripts`, il server MCP e lo shim `@agentmemory/mcp`, le configurazioni scritte da `agentmemory connect`, e le integrazioni incluse OpenCode, Pi, OpenClaw, Hermes e filesystem-watcher. Il secret memorizzato viene inviato solo a URL loopback (`localhost`, `127.0.0.0/8`, `::1`). Un `AGENTMEMORY_SECRET` esplicito vince sempre, e i client remoti devono comunque averlo impostato. Docker e gli entrypoint di `deploy/` generano ed esportano già il proprio secret. Per chiamare l'API a mano:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**Regole di richiesta per le scritture.** Le richieste `POST`, `PUT`, `PATCH` e `DELETE` all'API REST e al viewer devono inviare `Content-Type: application/json` (un parametro `charset` va bene) ogni volta che portano un corpo, e un header `Origin`, quando presente, deve essere un'origine loopback per la porta REST o viewer configurata oppure essere elencato in `VIEWER_ALLOWED_ORIGINS` (separato da virgole, ad es. `https://memory.example.com`). I client che non inviano nessun header `Origin` (CLI, hook, MCP, curl, server-to-server) non sono affetti. Il viewer accetta anche la propria origine.
**Percorsi dei file.** Gli endpoint che leggono o scrivono file (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`) accettano solo percorsi sotto `~/.agentmemory`, la directory dei dati dell'istanza, o una directory elencata in `AGENTMEMORY_IMPORT_ROOT` (separane diverse con `:`, o `;` su Windows). `/replay/import-jsonl` accetta anche il suo default `~/.claude/projects`. `/obsidian/export` resta dentro `AGENTMEMORY_EXPORT_ROOT` e `/migrate` dentro `~/.agentmemory`. I symlink vengono risolti prima di ogni controllo.
**Rimozione dei segreti.** Chiavi API, bearer token, blocchi di chiavi private PEM e credenziali incorporate negli URL (`scheme://user:password@host`) vengono oscurati prima che il testo venga memorizzato, su ogni percorso di scrittura: osservazioni, remember, evolve, slot, lezioni, azioni, sketch, segnali, checkpoint, import, replay jsonl, sincronizzazione mesh, condivisioni di team, output di compressione e riassunto, cristalli e nodi del grafo.
Endpoint principali
| Metodo | Percorso | Descrizione |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | Controllo di salute (sempre pubblico) |
| `GET` | `/agentmemory/status` | Cosa non va e come risolverlo (HTML per i browser, JSON altrimenti) |
| `GET` | `/agentmemory/viewer/snapshot` | Tutto ciò che il viewer mostra, in un'unica risposta |
| `POST` | `/agentmemory/session/start` | Avvia sessione + ottieni contesto |
| `POST` | `/agentmemory/session/end` | Termina sessione |
| `POST` | `/agentmemory/observe` | Cattura osservazione (vedi la consegna della cattura sotto) |
| `GET` | `/agentmemory/capture` | Inbox di cattura, dead letter e spool offline |
| `POST` | `/agentmemory/capture/retry` | Riprova le catture dead-letter |
| `POST` | `/agentmemory/capture/drain` | Invia ora lo spool offline locale |
| `POST` | `/agentmemory/smart-search` | Ricerca ibrida |
| `POST` | `/agentmemory/context` | Genera contesto |
| `POST` | `/agentmemory/remember` | Salva nella memoria a lungo termine |
| `POST` | `/agentmemory/forget` | Elimina osservazioni |
| `POST` | `/agentmemory/enrich` | Contesto del file + memorie + bug |
| `GET` | `/agentmemory/profile` | Profilo del progetto |
| `GET` | `/agentmemory/export` | Esporta tutti i dati |
| `POST` | `/agentmemory/import` | Importa da JSON |
| `POST` | `/agentmemory/graph/query` | Query sul grafo di conoscenza |
| `POST` | `/agentmemory/graph/compact` | Riduce la provenienza del grafo sovradimensionata |
| `POST` | `/agentmemory/team/share` | Condividi con il team |
| `GET` | `/agentmemory/audit` | Traccia di audit |
Elenco completo degli endpoint: [REST API](../plugin/skills/agentmemory-rest-api/REFERENCE.md)
**Consegna della cattura.** Gli hook inviano ogni osservazione una volta a `POST /agentmemory/observe` con un `eventId`. È l'id proprio dell'host per la chiamata quando il payload ne ha uno (per esempio il `tool_use_id` di Claude Code), altrimenti un hash della sessione, del tipo di hook, del nome dello strumento, dell'input, dell'output e del timestamp dell'host. Il server scrive l'evento in un inbox di cattura nello state store, memorizza l'osservazione, poi rimuove la voce dall'inbox. Il codice di stato dice cosa è successo:
| Stato | Campo `status` | Significato |
|---|---|---|
| `201` | `accepted` | Memorizzato. `observationId` è la nuova osservazione. |
| `202` | `accepted` (`state: "retrying"`) | Accettato, ma la memorizzazione è fallita. Il server lo riprova, anche dopo un riavvio. |
| `200` | `duplicate` | Questo `eventId` era già stato accettato. `observationId` è l'osservazione esistente; non viene memorizzato nulla di nuovo. |
| `400` / `422` | `rejected` | Payload non valido, oppure la memorizzazione è fallita definitivamente (l'evento viene conservato come dead letter). |
| `503` | `rejected` (`retryable: true`) | L'inbox è piena (`AGENTMEMORY_CAPTURE_INBOX_MAX`). Gli hook mettono l'evento in spool e lo inviano più tardi. |
Gli eventi falliti vengono ritentati ogni `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 s) con backoff che raddoppia, fino a `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5). Gli eventi che continuano a fallire restano nell'inbox come dead letter, sono elencati su `/agentmemory/status` e nella pagina Health del viewer, e possono essere ritentati con `POST /agentmemory/capture/retry` (`{"eventId": "..."}` oppure `{"all": true}`). Gli id degli eventi accettati vengono ricordati per `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 ore, al massimo `AGENTMEMORY_CAPTURE_EVENTS_MAX` id), quindi un hook rieseguito dopo un timeout o un riavvio viene memorizzato una volta, mentre due chiamate di strumento separate con i propri id host vengono memorizzate due volte anche quando il loro contenuto è identico. Quando un'osservazione viene eliminata (forget, eliminazione della sessione, eviction, auto-forget o un import che sostituisce lo store), il suo evento viene marcato come eliminato prima che l'osservazione venga rimossa, così una riesecuzione di quell'evento nella stessa finestra viene risposta come duplicato e non memorizza nulla. Lo state store scrive su disco ogni 2 secondi, quindi una risposta accettata può essere ancora solo in memoria per un istante. Per coprire questo, ogni risposta `2xx` porta anche il `bootId` del server (nuovo a ogni avvio), `acceptedAt` e `durableAfterMs` (l'intervallo di salvataggio più 1.5 s sullo store a file, 1.5 s su redis, dove la persistenza è un'impostazione dell'operatore). Gli hook mantengono l'evento nello spool locale finché quella finestra non è passata e lo eliminano a una chiamata successiva senza un'altra richiesta. Se il `bootId` è cambiato da allora, il server è stato riavviato, quindi l'hook invia di nuovo l'evento con lo stesso `eventId`; un evento che è arrivato sul disco non viene memorizzato due volte. Il server invia anche da sé tali eventi all'avvio e a ogni intervallo di retry, così un riavvio non perde nulla anche quando nessun hook viene eseguito in seguito. Gli hook più vecchi ignorano i campi extra, e i nuovi hook contro un server più vecchio scartano l'evento su `2xx` come prima.
Quando il server è spento, non risponde in tempo o restituisce un 5xx, l'hook aggiunge l'osservazione a un file di spool locale, `/capture-spool/-.jsonl` (sovrascrivi la cartella con `AGENTMEMORY_CAPTURE_SPOOL_DIR`). Il file è privato per il tuo utente (modalità 600), i segreti vengono oscurati allo stesso modo in cui li oscura il server, contiene al massimo `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 MiB) ed elimina le voci più vecchie di `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168). Quando è pieno, le nuove voci vengono scartate e contate, e `/agentmemory/status` lo segnala. L'hook esce comunque con 0 entro il suo limite di tempo e non aggiunge nessuna richiesta quando il server è sano. Lo spool viene inviato al prossimo avvio e dal primo hook che raggiunge di nuovo il server, in un processo in background così l'agente non aspetta. Gli id degli eventi rendono questo sicuro: un'osservazione che è arrivata prima di un timeout non viene memorizzata due volte. `npx @agentmemory/agentmemory capture` mostra lo spool e l'inbox del server, `--drain` invia subito lo spool, e `GET /agentmemory/capture` restituisce lo stesso come JSON. Imposta `AGENTMEMORY_CAPTURE_SPOOL=false` per disattivare lo spool.
**Compattazione della provenienza del grafo.** La compattazione dei dati di provenienza precedenti viene rinviata all’avvio perché legge interi scope precedenti. `/agentmemory/status` riporta `deferred`, oppure `off` con `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false`. Esegui la compattazione manuale seguente durante la manutenzione. La migrazione dell’indice di ricerca è separata: usa `agentmemory graph-index migrate --allow-legacy-scan` come descritto nella [guida alla manutenzione](../docs/reliability/graph-index-migration.md).
Per eseguirlo a mano, chiama `POST /agentmemory/graph/compact`. Percorre gli indici dei nomi e delle chiavi degli archi invece di elencare ogni nodo e arco, ed è sicuro da rieseguire. Quando riduce gli id scrive una voce di audit `graph_compact`.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Authorization: Bearer " -H "Content-Type: application/json" -d '{}'
```
Su uno store grande, o quando la chiamata restituisce 504, eseguilo a porzioni. Invia `scope` (`nodes`, `edges` o `history`), `offset` e `limit`, poi richiama con il `nextOffset` restituito finché non è `null`. Fallo per `nodes`, `edges` e `history`, e termina con un'unica chiamata `{"scope":"snapshot"}`, perché un'esecuzione a porzioni non toglie lo snapshot in cache.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Authorization: Bearer " -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Authorization: Bearer " -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---
```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 5,000+ tests
npm run test:integration # API tests (requires running services)
```
[Install](#install) · [CONTRIBUTING.md](../CONTRIBUTING.md)