Spotter:让具身模型主导,让视觉语言模型为它反思
如果我们的项目对你有帮助,欢迎在 GitHub 上点一个 star ⭐ 支持我们


| 📄 论文 | 🏠 项目主页 | 🤖 模型权重 | 🌐 仿真器 | 🚀 上手 |
|---|---|---|---|---|
| [arXiv](https://arxiv.org/abs/2609.36808) | [zqc3117.github.io/Spotter](https://zqc3117.github.io/Spotter/) | [pi0.5](https://huggingface.co/DAVIAN-Robotics/pi05-robocasa-H50) · [Cosmos Policy](https://huggingface.co/nvidia/Cosmos-Policy-RoboCasa-Predict2-2B)(RoboCasa)· [pi0.5](https://huggingface.co/motus-robotics/pi0.5_robotwin2)(RoboTwin 2.0) | [RoboCasa](https://robocasa.ai) · [RoboTwin 2.0](https://github.com/RoboTwin-Platform/RoboTwin) | [安装](#-环境配置) · [快速开始](#-用发布的权重评测) |
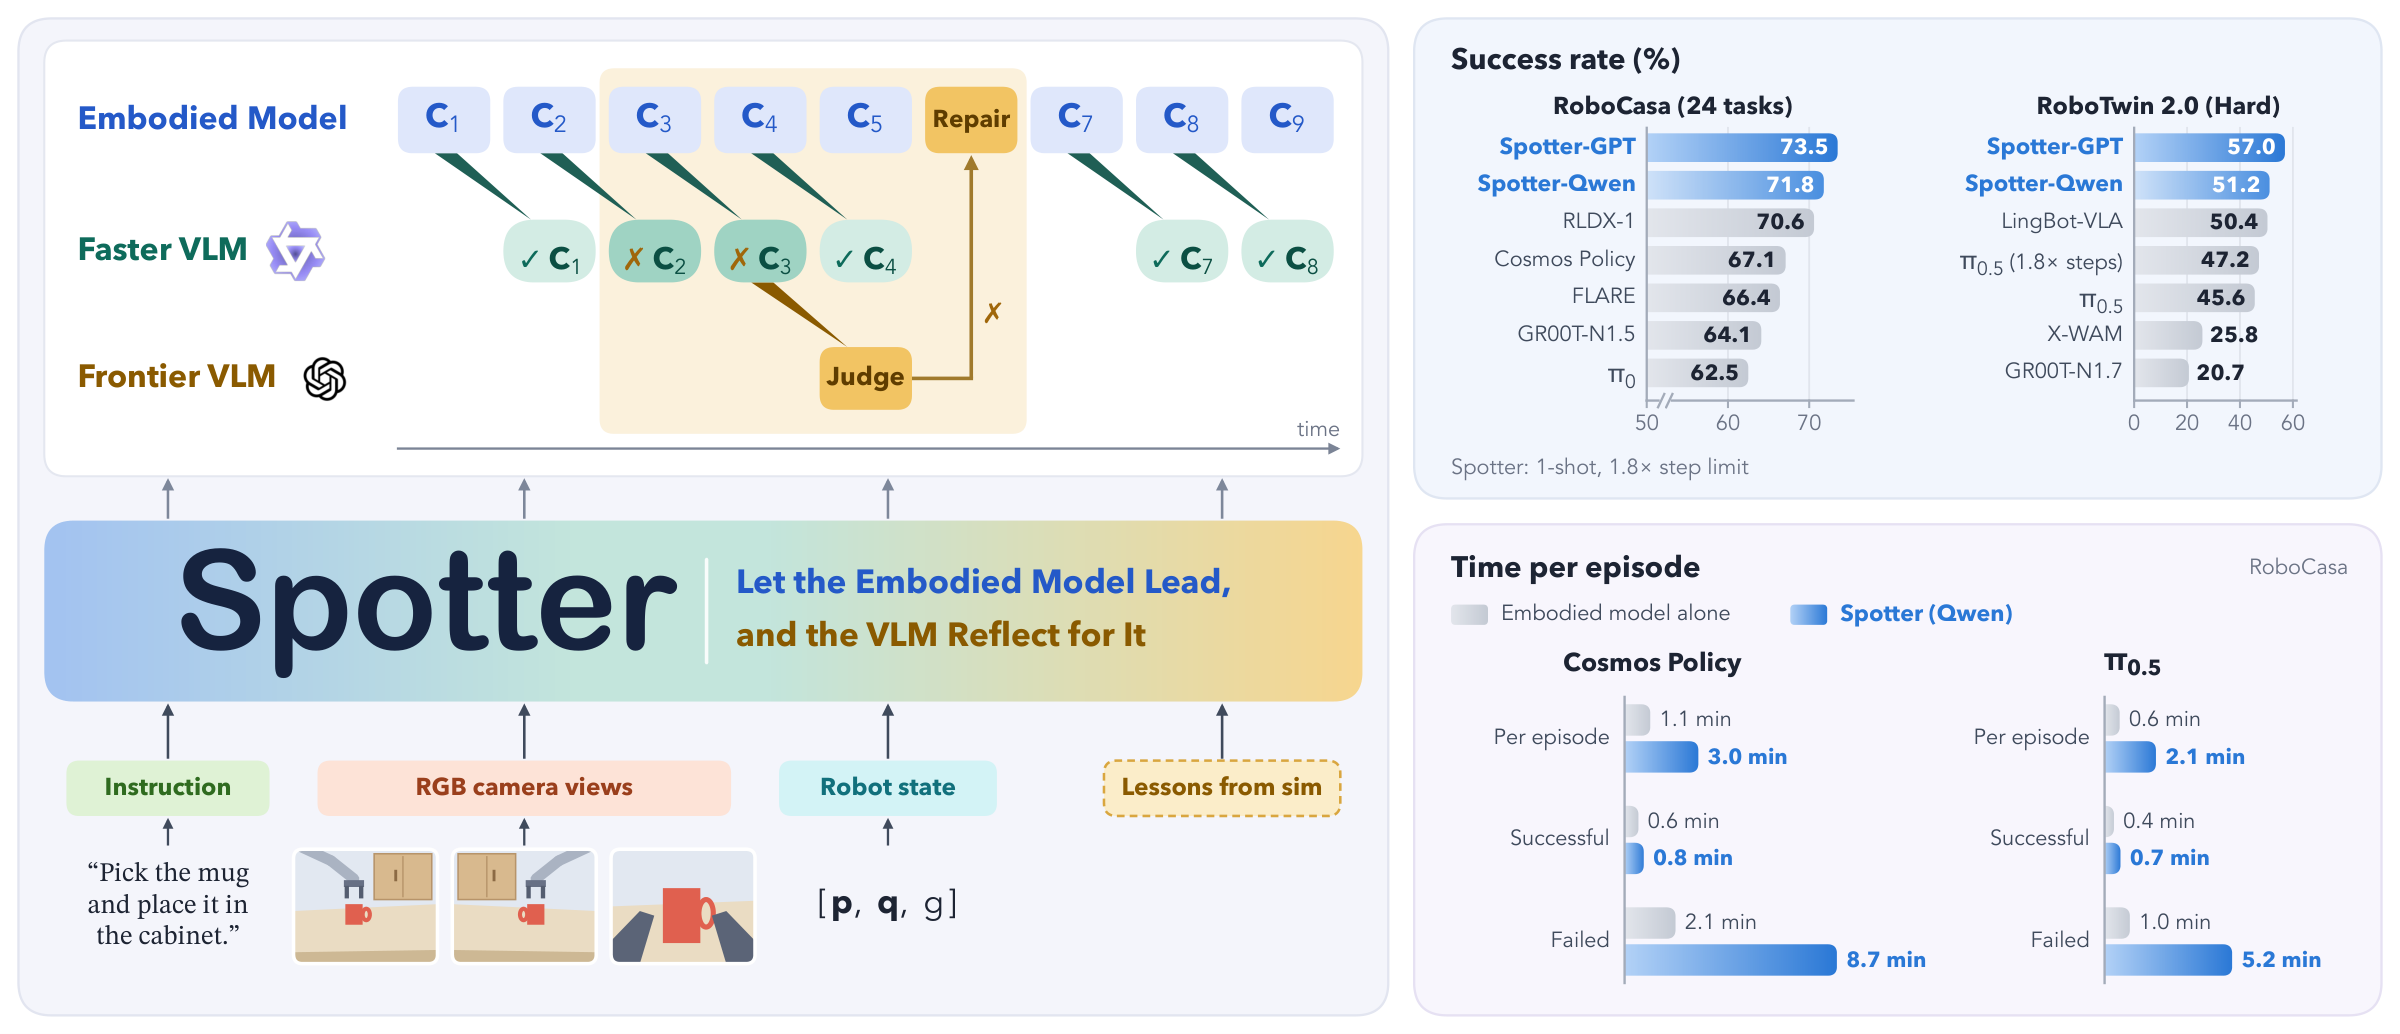
**Spotter** 在冻结的具身模型(System 1)和 VLM(System 2)之间加入了一个轻量的介入机制。
它不让 VLM 规划每一步,而是让具身模型主导并持续执行;本地筛子并行关注执行进展,只有确认出错时,VLM 才介入确认并纠正。
交给 VLM 的任务因此简单得多,整个框架**用本地部署的开源 Qwen、不借助任何特权信息**就能运行。
## 📰 最新动态
- [2026/10] 🔥 RoboCasa:发布在 1,200 集测试集上实际评测过的代码版本,加入黑帧 / 噪声帧的重渲染保护,以及基于腕部深度图的 `aim` 抓取步骤。见 [RoboCasa](#robocasa)。
- [2026/10] 🔥 Spotter 支持 **RoboTwin 2.0**(π0.5):一条命令评测(`bash robotwin_eval.sh`),提供 1-shot 示例库([fewshot_bank_robotwin.tar.gz](https://github.com/zqc3117/Spotter/releases/download/v1.0/fewshot_bank_robotwin.tar.gz)),完整日志已上传魔搭(ModelScope),含每一集的画面、判别器提示词和回复([150 集](https://www.modelscope.ai/datasets/seamoke/spotter-robotwin-150):仅策略、Spotter、VLM 主导的智能体,各配 Qwen 和 GPT;[50 个任务 × 10 集](https://www.modelscope.ai/datasets/seamoke/spotter-robotwin-50x10))。真机演示(Franka Research 3)和[项目主页](https://zqc3117.github.io/Spotter/)同步上线。见 [RoboTwin 2.0](#robotwin-20)。
- [2026/09] 🎉 论文发布在 [arXiv](https://arxiv.org/abs/2609.36808),代码同步开源,附 RoboCasa 示例库([fewshot_bank.tar.gz](https://github.com/zqc3117/Spotter/releases/download/v1.0/fewshot_bank.tar.gz))。
## 🎬 演示
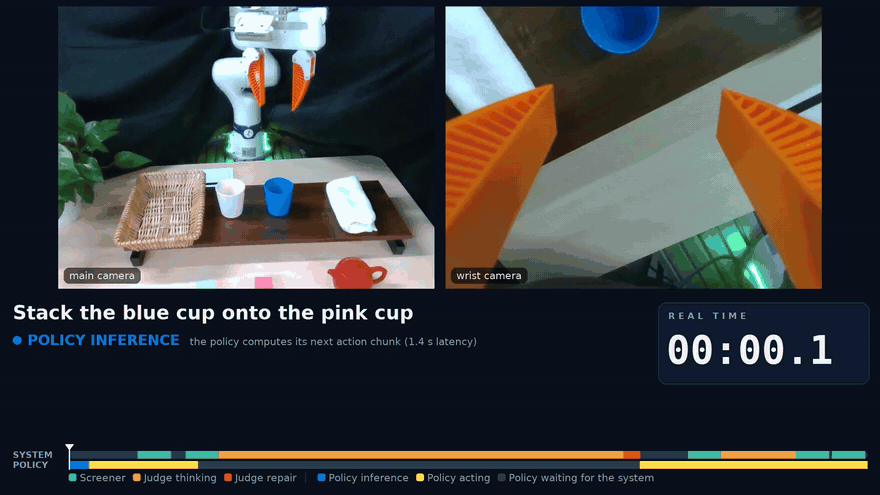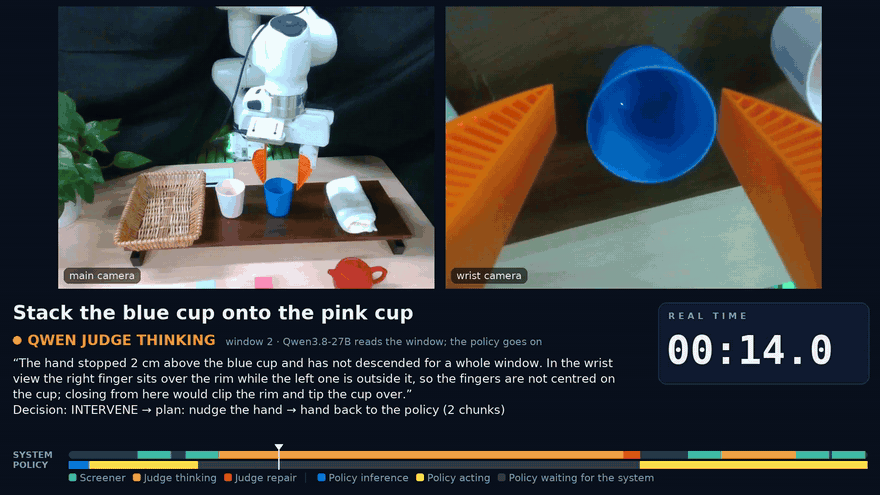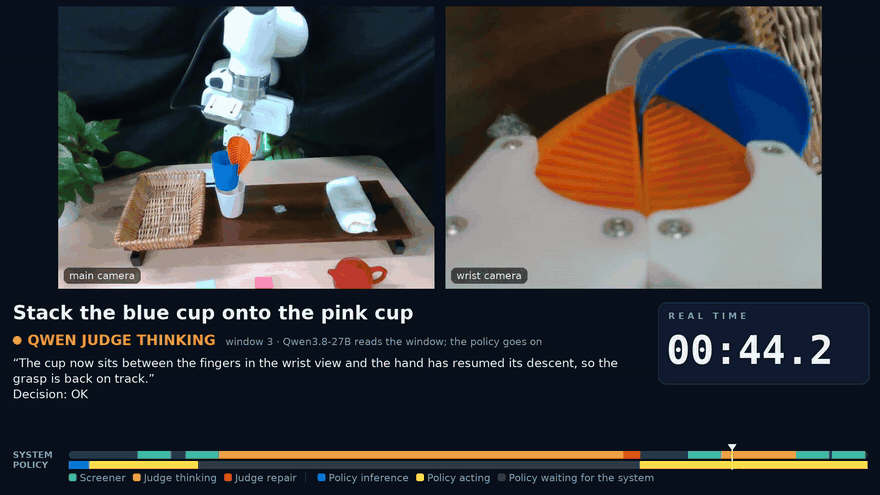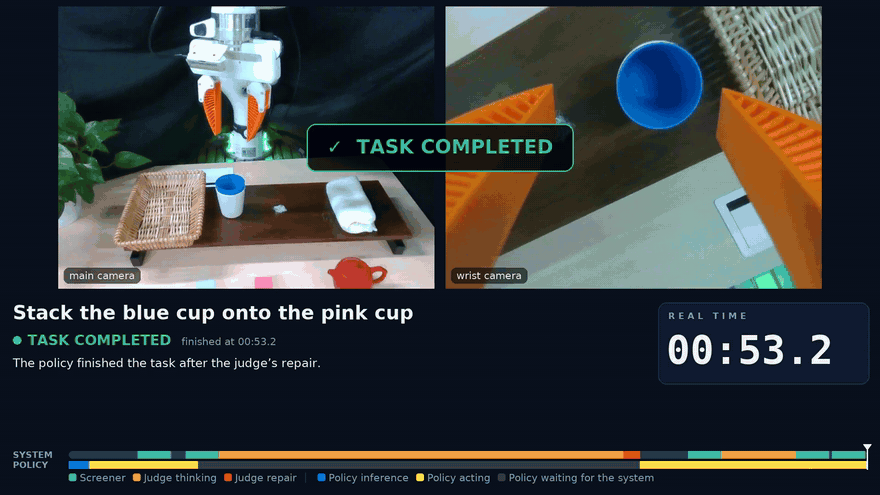
真机(Franka Research 3)把蓝杯叠到粉杯上。动图按 2 倍速播放,并缩短了判别器思考的时间;画面里的计时为真实时间。
在项目主页观看完整视频。
## 🔥 核心优势
- **轻量的介入机制。** 就像人做事时分出少量注意力关注进展,发现异常再集中精力处理:执行保持连贯,只在确认出错时才调用 VLM。
- **VLM 的任务更简单。** VLM 不再驱动机器人,只需发现失败、用几个运动原语组成的短计划修复,并检查修复是否奏效。
本地 Qwen 在看不到任务成功条件的情况下也能胜任。
- **执行不中断,开销低。** 常规执行时具身模型不需要等 VLM,成功的 episode 只比策略单独运行多 **13–16 秒**。
## 💡 为什么需要 Spotter
现有由 VLM 主导的 robot agent 通常是串行的:VLM 先规划一段动作,交给具身模型执行,执行完再由 VLM 判断下一步。这带来一个两难:
- **每次安排的动作太少**:需要频繁调用 VLM,任务再简单时延也高;
- **每次安排的动作太多**:执行中出现偏差时无法及时纠正,后续动作会持续出错。
Spotter 把串行监督改成并行监督,消除了这个两难。
| | VLM 主导的 agent | Spotter |
|---|---|---|
| 谁主导执行 | VLM 规划每一步 | 具身模型主导 |
| 何时调用 VLM | 每一步之前 | 仅在确认出错时 |
| 具身模型是否等待 VLM | 每一步都等 | 仅在修复期间 |
| 是否需要特权信息 | 通常需要(如任务成功信号) | 不需要 |
| 能否用本地 Qwen | 只有借助特权信息才行 | 可以 |
### 🎯 更弱的模型也能用,不需要特权信息
在 RoboCasa(1200 集)上,用同一个本地 Qwen、不给特权信息时,一种代表性的 VLM 主导 agent 成功率**跌到策略单独运行以下**
(Cosmos Policy 67.9 → 65.2,π0.5 64.3 → 60.5);Spotter 仍然能带来提升(分别到 71.7 和 68.4)。
### ⚡ 不出错时几乎零开销
用 Qwen 时,成功的 episode 平均调用判别器**不到 1 次**,只比策略单独运行多 **13–16 秒**;和用同一个 Qwen 的 VLM 主导方法相比,耗时少约 **70%**。
> **仿真器。** Spotter 同时支持 [RoboCasa](#robocasa) 和 [RoboTwin 2.0](#robotwin-20)。RoboTwin 2.0 可以一条命令
> `bash robotwin_eval.sh` 跑完整个评测(见[用发布的权重评测](#-用发布的权重评测))。
>
> **RoboTwin 2.0 的实验结果和完整记录**(每集的画面、提示词和回复):
> [50 个任务 × 10 集](https://www.modelscope.ai/datasets/seamoke/spotter-robotwin-50x10)(策略独跑 vs. Spotter-Qwen),
> 以及 [150 集](https://www.modelscope.ai/datasets/seamoke/spotter-robotwin-150)(策略独跑、Spotter 和 VLM 主导的智能体,
> 后两者各用 Qwen 和 GPT)。
## 📑 目录
- [文件结构](#-文件结构)
- [环境配置](#-环境配置)
- [模型准备](#-模型准备)
- [仿真资源与评测集](#-仿真资源与评测集)
- [用发布的权重评测](#-用发布的权重评测):[RoboCasa](#robocasa) · [RoboTwin 2.0](#robotwin-20)
- [复现论文结果](#-复现论文结果)
- [重建经验库与示例库](#-重建经验库与示例库)
- [接入你自己的具身模型](#-接入你自己的具身模型)
- [输出](#-输出) · [配置参考](#-配置参考)
- [致谢](#-致谢) · [许可证](#-许可证) · [联系方式](#-联系方式) · [引用](#-引用)
## 📂 文件结构
```text
Spotter/
├── spotter.sh # 统一入口:部署 Qwen / 策略服务、运行、汇总结果
├── robotwin_eval.sh # RoboTwin 2.0 一键评测(起服务 + Spotter 组 + 对照组 + 汇总)
├── recovery_explore/ # Spotter 本体
│ ├── judge_driver_v7.sh # 单个 lane 的监督循环:筛查 -> 判别 -> 修复 -> 验证
│ ├── env_service.py # RoboCasa 仿真服务(RPC),由 launch_svc.sh 启动
│ ├── env_service_robotwin.py # RoboTwin 2.0 仿真服务(同一套 RPC 接口,SAPIEN)
│ ├── robotwin_intervention.py # RoboTwin 修复原语(双臂);robodojo_intervention.py 是它的基类
│ ├── robotwin_policy_server.py # RoboTwin 的 pi0.5 策略服务(openpi websocket 协议)
│ ├── primitives.py # 判别器组合修复计划所用的运动原语
│ ├── grasp_aim.py # RoboCasa 的 `aim` 步骤:在腕部深度图里找到物体并规划抓取
│ ├── render_guard.py # RoboCasa:EGL 上下文泄漏导致黑帧/噪声帧时自动重新渲染
│ ├── JUDGE_BRIEF_V7.md # 判别器提示词;BRIEF_PNP.md / BRIEF_MECH.md / BRIEF_RT.md 是分任务类型的补充
│ ├── cli/ # 筛子、判别通道(Qwen / GPT)、harness、few-shot 工具
│ ├── memory_bank/ # 冻结的 77 条通用经验(RoboCasa)
│ ├── memory_bank_robotwin_noreset/ # RoboTwin 2.0 的经验
│ ├── episode_sets/ # sall500.txt(论文,1200 集)· s500q96.txt(96 集,调试用)· rt500.txt / rt150.txt(RoboTwin 2.0)
│ ├── fewshot_bank/ # (需下载)1-shot 设置用的示例;robotwin/ 子目录给 RoboTwin 2.0
│ └── runs__<策略>/ # (运行时生成)results.jsonl、各 lane 日志、给判别器看的画面
├── rpc/ # π0.5 策略服务、RPC 协议、RoboCasa rollout 与采集脚本
├── cf_bench/ # 纠错能力实验用的快照与重放工具
├── env/ # env.sh.example、requirements-robocasa.txt、requirements-pi05.txt
├── assets/ # logo
└── LICENSE · THIRD_PARTY_NOTICES.md · LICENSES/
```
## 🔧 环境配置
**Qwen 筛子和判别器。** vLLM 单独一个环境,再准备本地的 `env/env.sh`:
```bash
python3 -m venv .venvs/vllm && .venvs/vllm/bin/pip install vllm
cp env/env.sh.example env/env.sh && $EDITOR env/env.sh
```
**RoboCasa。** RoboCasa 用到三个 Python 环境:
| 环境 | Python | 运行什么 | 安装 |
|---|---|---|---|
| `robocasa` | 3.10 | 仿真服务、判别 driver、Cosmos 策略服务 | 按 [Cosmos Policy](https://github.com/NVlabs/cosmos-policy) 的 RoboCasa 说明安装,再装 `env/requirements-robocasa.txt` |
| `pi05` | 3.12 | π0.5 策略服务(LeRobot) | `env/requirements-pi05.txt` |
| `vllm` | 3.10+ | Qwen 筛子和判别器 | 见上面的 Qwen 步骤 |
```bash
# 1) RoboCasa + Cosmos Policy:按 https://github.com/NVlabs/cosmos-policy 的 RoboCasa 说明安装,然后
pip install -r env/requirements-robocasa.txt
# 2) π0.5
python3.12 -m venv .venvs/pi05 && .venvs/pi05/bin/pip install -r env/requirements-pi05.txt
```
> **注意**:无显示器的 MuJoCo 渲染需要支持 EGL 的 NVIDIA GPU(`MUJOCO_GL=egl`,已在 `env/env.sh` 中设置)。
**RoboTwin 2.0。** Spotter 可以跑在 [RoboTwin 2.0](https://github.com/RoboTwin-Platform/RoboTwin)
(aloha-agilex 双臂,SAPIEN 3,50 个任务,`demo_randomized` 场景)上,族名为 `robotwin`。
RoboTwin 的仿真器和规划器(SAPIEN 3、mplib、cuRobo)在它自己的 Python 3.10 环境里,以"便携运行时"的形式布局,
`env/env.sh` 指向它:
```text
/
├── .venv/ # python 3.10:sapien 3.0.0b1、mplib 0.2.1、toppra、与显卡匹配的 CUDA 版 torch
└── worktree/third_party/RoboTwin/ # RoboTwin 2.0 树
├── envs/curobo/src/ # cuRobo 源码(其 CUDA 内核需与 torch 匹配)
├── assets/{objects,background_texture,embodiments}/ # RoboTwin 2.0 资源(Hub 上的 TianxingChen/RoboTwin2.0)
└── policy/pi0/checkpoints/pi05_robotwin2_clean_randomized/robotwin2/40000/ # pi0.5 权重
```
按 RoboTwin 的 README 安装好本体和资源后,在 `env/env.sh` 里设置:
```bash
export ROBOTWIN_RUNTIME=/path/to/robotwin-runtime # 或 ROBOTWIN_ROOT + ROBOTWIN_PY
export ROBOTWIN_POLICY_PYTHON=/path/to/robotwin-policy-venv/bin/python # 满足 policy/pi05/requirements.txt 的 venv(openpi、lerobot < 0.3)
```
仿真用 SAPIEN 的光线追踪渲染(Vulkan,RTX 级显卡);RTX 5090 上默认用 `optix` 去噪器,因为官方的 `oidn` 在那上面会报错。
## 📦 模型准备
**1)Qwen 判别器和筛子。**
```bash
huggingface-cli download Qwen/Qwen3.8-27B-FP8 --local-dir checkpoints/Qwen3.8-27B-FP8
```
国内用户也可以从 [ModelScope](https://modelscope.cn/models/Qwen/Qwen3.8-27B-FP8) 下载。然后在 `env/env.sh` 中设置:
```bash
export QWEN_MODEL=$PWD/checkpoints/Qwen3.8-27B-FP8
export VLLM_VENV=$PWD/.venvs/vllm
```
**2)RoboCasa。** 下载 π0.5 和 Cosmos Policy:
```bash
huggingface-cli download DAVIAN-Robotics/pi05-robocasa-H50 --local-dir checkpoints/pi05-robocasa-H50
huggingface-cli download nvidia/Cosmos-Policy-RoboCasa-Predict2-2B --local-dir checkpoints/Cosmos-Policy-RoboCasa-Predict2-2B
```
下载后的目录:
```text
checkpoints/
├── pi05-robocasa-H50/ # model.safetensors、config.json、policy_*processor*、tokenizer/
├── Cosmos-Policy-RoboCasa-Predict2-2B/ # Cosmos-Policy-RoboCasa-Predict2-2B.pt、robocasa_t5_embeddings.pkl 等
└── Qwen3.8-27B-FP8/
```
然后在 `env/env.sh` 中设置:
```bash
export PI05_CHECKPOINT=$PWD/checkpoints/pi05-robocasa-H50
export COSMOS_CHECKPOINT=$PWD/checkpoints/Cosmos-Policy-RoboCasa-Predict2-2B/Cosmos-Policy-RoboCasa-Predict2-2B.pt
```
1-shot 设置需要 RoboCasa 示例库(151 MB):
```bash
curl -L https://github.com/zqc3117/Spotter/releases/download/v1.0/fewshot_bank.tar.gz | tar -xz -C recovery_explore
```
**3)RoboTwin 2.0。** 策略是 pi0.5 权重
[motus-robotics/pi0.5_robotwin2](https://huggingface.co/motus-robotics/pi0.5_robotwin2),放在 RoboTwin 树里的
`policy/pi0/checkpoints/pi05_robotwin2_clean_randomized/robotwin2/40000/`(见[环境配置](#-环境配置))。
1-shot 设置需要把 RoboTwin 示例库(33 MB)下载到 `recovery_explore/fewshot_bank/robotwin/`:
```bash
curl -L https://github.com/zqc3117/Spotter/releases/download/v1.0/fewshot_bank_robotwin.tar.gz | tar -xz -C recovery_explore
```
> **GPT 判别器(可选)**:设置 `ENGINE=api`,并配好 `OPENAI_RESPONSES_URL` 和 `OPENAI_API_TOKEN_FILE`;
> 判别器换成 GPT-6 Astra,筛子仍然是本地 Qwen。
## 🧭 仿真资源与评测集
**RoboCasa 资源**随上面 Cosmos Policy 的 RoboCasa 安装步骤一起装好。
**RoboTwin 2.0 资源**随 RoboTwin 本体一起安装(见[环境配置](#-环境配置))。
**评测集**随仓库提供,每行一个 `任务:种子:编号`:
| 文件 | 集数 | 用途 |
|---|---:|---|
| `episode_sets/sall500.txt` | 1,200 | 论文的 RoboCasa 评测:24 个任务 × 编号 0–49,seed 500 |
| `episode_sets/s500q96.txt` | 96 | RoboCasa 调试用子集,每个任务 4 集 |
| `episode_sets/rt50x10n.txt` | 500 | RoboTwin 2.0:50 个任务 × 10 集 |
| `episode_sets/rt500.txt` | 500 | 发布结果所用的 RoboTwin 2.0 评测集:在 `rt50x10n` 基础上,把当前仿真环境里无法开局的集替换为同任务下一个能开局的集 |
| `episode_sets/rt150.txt` | 150 | RoboTwin 2.0 上与 VLM 主导智能体的对比:50 个任务 × 3 集,是 `rt500` 的子集 |
RoboCasa 的经验和示例都是在 seed 195 上学到的,和测试用的 seed 不重叠。
## 🚀 用发布的权重评测
每个服务各开一个终端,先执行 `source env/env.sh`。
**1)部署 Qwen 筛子和判别器**(每张卡一个副本,端口 8301、8302……)。
```bash
bash spotter.sh judge --gpus 0,1,2,3
curl -s http://127.0.0.1:8301/v1/models # 检查
```
卡少时少写几张(如 `--gpus 0`),并在运行前 `export QWEN_PORTS=8301`。
### RoboCasa
**2)部署具身模型**:π0.5 用 8900 端口,Cosmos Policy 用 8800 端口。
```bash
bash spotter.sh policy pi05 --gpu 4 # 或:bash spotter.sh policy cosmos --gpu 4
curl -s http://127.0.0.1:8900/health # 检查
```
**3)冒烟测试:跑一集。** 仿真服务由 driver 自动启动。
```bash
bash spotter.sh run pi05 # 跑一集:同一场景下对照组和 Spotter 各跑一次
```
**4)在 `sall500` 上完整评测。**
```bash
bash spotter.sh run pi05 sall500 --lanes 8
bash spotter.sh summary
```
直接调用 driver
`spotter.sh run` 会为每个 lane 启动一个 driver。上面跑一集 pi0.5 的命令等价于:
```bash
mkdir -p recovery_explore/runs_smoke
printf 'PnPCabToCounter:195:0\n' > recovery_explore/runs_smoke/episodes_pi05.txt
ON_POD=1 RUN=smoke TARGET=1 NGPU=1 FAMILY_OVERRIDE=pi05 \
SIM_HOST=127.0.0.1 SIM_MANAGED=0 POLICY_URL=http://127.0.0.1:8900 \
ENGINE=qwen MODEL=qwen38 SCREEN=1 QWEN_KEEP_TURNS=20 \
STEP_BUDGET_SCALE=1.8 WINDOW=1 TEL_CHUNKS=10 COMPACT_AT=110000 MAX_INTERVENTIONS=8 \
ALLOW_RESET=0 MAX_RESETS=0 FEWSHOT=0 LEARN=0 CTRL_ONLY=0 SKIP_CONTROL=0 \
bash recovery_explore/judge_driver_v7.sh 0
```
driver 会自己在 `8450+lane` 端口启动和重启仿真服务。同一个 run 的所有 lane 从同一个队列领取 episode,结果数达到 `TARGET` 后各 lane 自动结束。
### RoboTwin 2.0
**一条命令。** `robotwin_eval.sh` 会在 Qwen 和 pi0.5 策略服务没起来时自动启动它们,然后在同一批 500 集(`rt500`)上
先跑 Spotter 组、再跑纯策略对照组,最后输出汇总。设置和发布结果一致:1.8 倍步数上限、1-shot、Qwen 只在修复回合思考,
`QWEN_THINK_BUDGET=5000`。
```bash
bash robotwin_eval.sh --judge-gpus 0,1,2,3 --policy-gpu 4 --lanes 12
```
加 `--dry-run` 只打印要执行的命令。每个 RoboTwin 仿真大约占 8 GB 显存,32 GB 的卡建议每张跑 3 条 lane。Spotter 组的耗时
主要在判别器思考上,多给 Qwen 几张卡(`--judge-gpus`)会更快。
分步运行
第 1 步的 Qwen 服务起来后:
```bash
bash spotter.sh policy robotwin --gpu 4 # RoboTwin 的 pi0.5,端口 9100(检查:curl http://127.0.0.1:9100/healthz)
bash spotter.sh run robotwin # 冒烟:adjust_bottle 第 35 集
bash spotter.sh run robotwin rt500 --lanes 12 --one-shot # 在 500 个评测集上跑 Spotter 组(1-shot)
bash spotter.sh run robotwin rt500 --lanes 12 --arm ctrl # 同一批集上的纯策略对照组
bash spotter.sh summary
```
**用这版代码的结果。** 我们用这版代码在 RoboTwin 2.0 上重跑了 Spotter 组,评测集是 `rt500` 的 500 集(1.8 倍步数上限、
1-shot);对照组是同样 500 集上的策略独跑:
| 组别 | 成功 |
|---|---:|
| 策略独跑(pi0.5) | 240 / 500(48.0%) |
| Spotter-Qwen,`QWEN_THINK_BUDGET=2000` | 252 / 500(50.4%) |
| Spotter-Qwen,`QWEN_THINK_BUDGET=5000`(默认) | 267 / 500(53.4%) |
由于每次运行都有随机因素,这些结果和论文略有差异。我们把逐集结果(每集的画面、判别器提示词和回复)上传到了 ModelScope:
[50 个任务 × 10 集](https://www.modelscope.ai/datasets/seamoke/spotter-robotwin-50x10)。
**与 VLM 主导智能体的对比(150 集)。** 在 `rt150`(50 个任务 × 3 集,是 `rt500` 的子集)上,用相同设置(1.8 倍步数上限、
1-shot、Qwen 只在修复轮思考、上限 5000 token),我们还跑了 GPT 版 Spotter,以及分别用两种模型的 VLM 主导智能体;
所有组都在同一批集上运行。VLM 主导的智能体逐轮驱动整个任务、把策略当作工具调用,它的代码不在本次发布中。
| 组 | 模型 | 成功 |
|---|---|---:|
| 策略独跑(pi0.5) | – | 72 / 150(48.0%) |
| Spotter | Qwen3.8-27B-FP8 | 79 / 150(52.7%) |
| Spotter | GPT-6-astra | 84 / 150(56.0%) |
| VLM 主导的智能体 | Qwen3.8-27B-FP8 | 63 / 150(42.0%) |
| VLM 主导的智能体 | GPT-6-astra | 84 / 150(56.0%) |
五个组的完整记录(每集的画面、提示词和回复)都在 ModelScope 上:
[150 集](https://www.modelscope.ai/datasets/seamoke/spotter-robotwin-150)。
### 运行选项
`bash spotter.sh run <策略族> [SET] [选项]`,两个仿真器通用:
| 选项 | 含义 |
|---|---|
| `SET` | `smoke`(1 集,默认);RoboCasa:`s500q96`、`sall500`;RoboTwin 2.0:`rt500`、`rt150`、`rt50x10n`;或每行一个 `任务:种子:编号` 的文件 |
| `--lanes N` | 并行跑的集数;lane `N` 在端口 `8450+N` 上运行自己的仿真服务 |
| `--sim-gpus N` | 仿真服务共用的卡,即 `0..N-1` 号卡(默认全部) |
| `--arm` | `both`(每集对照组和 Spotter 都跑,默认)、`treat`(只跑 Spotter)、`ctrl`(只跑策略) |
| `--one-shot` | 给判别器加一个示例(需要示例库) |
| `--run NAME` | run 名称(默认 `<策略>_<评测集>`);同名重跑会接着上次继续 |
| `--dry-run` | 只打印要执行的命令,不真正运行 |
同一个 episode 的两组使用相同的场景、指令和步数预算:
| 组别 | 说明 |
|---|---|
| **对照组(Control)** | 只有策略,不调用判别器。 |
| **实验组(Treatment)** | 策略加判别器,可按需干预。 |
`spotter.sh run <策略族>` 使用[配置参考](#-配置参考)里对应那一列的设置,每一项都可以用环境变量覆盖。
## 📊 复现论文结果
论文 Table 1(RoboCasa,1200 集)中 Spotter 的各行,都是在上面完整评测的基础上加以下设置;环境变量在 `spotter.sh run` 之前 export。
| Table 1 中的行 | 设置 |
|---|---|
| 具身模型,1.0× / 1.8× 步数上限 | `--arm ctrl`,配合 `STEP_BUDGET_SCALE=1.0` / `1.8` |
| Spotter (Qwen),full context | `spotter.sh` 默认值 |
| Spotter (Qwen),short context | `TEL_CHUNKS=3 QWEN_KEEP_TURNS=3 COMPACT_AT=22000 MAX_INTERVENTIONS=3 SCREEN_CONFIRM2=0`(π0.5 另加 `WINDOW=2`) |
| Spotter (Qwen),1-shot | `--one-shot` |
| Spotter (GPT),有 / 无筛子 | `ENGINE=api`,配合 `SCREEN=1` / `SCREEN=0` |
| Spotter (GPT),1-shot | `ENGINE=api` 加 `--one-shot` |
| Harness VLA | 用其自身代码运行:[RLinf/RPent](https://github.com/RLinf/RPent) |
Table 1 中"固定重试"的两行不包含在本次发布中。
**监督模式**:`spotter.sh` 运行的是同步监督循环(`ASYNC_SCREEN=0`)。如需 3.2 节的有界异步模式,设置 `ASYNC_SCREEN=2 ASYNC_K=2`:策略最多领先上一次检查两个监督窗口(Cosmos Policy 为 4 个 chunk,π0.5 为 2 个)。
**耗时**:`results.jsonl` 记录了每组的总耗时,以及判别器和筛子的调用耗时(见[输出](#-输出));本次发布不记录 token 数。
**3.1 节**:`rpc/run_remote_robocasa_cf_branch_collect.py` 采集失败后和正常状态下的候选动作,`cf_bench/` 负责重放这些候选并运行语言反馈实验。测试时打分器(Consistency-Consensus、GeoBoN、RCS)不包含在内。
## 🧠 重建经验库与示例库
仓库自带的经验库(`recovery_explore/memory_bank/global/` 中的 77 条通用经验)和示例库都是冻结的,论文所有结果都直接使用它们;只有在需要重建或覆盖新任务时才需要这一节。
**1)运行学习用的 episode**:只在 seed 195 上运行,不能用测试 seed。只有这一步允许判别器重置并重试;每集的经验会以草稿形式写到 `memory_bank/inbox//`。
```bash
ENGINE=api LEARN=1 ALLOW_RESET=1 MAX_RESETS=5 bash spotter.sh run cosmos --run learn_cosmos
```
**2)审阅草稿**,把其中通用的经验移到 `memory_bank/global/`,格式见 `recovery_explore/memory_bank/README.md`。去掉所有特权信息和只适用于特定任务的内容。
**3)构建示例库**,从学习 run 中挖掘 1-shot 设置所用的示例:
```bash
python3 recovery_explore/cli/fewshot_build.py --family cosmos --seed 195 --out recovery_explore/fewshot_bank
```
## 🔌 接入你自己的具身模型
Spotter 从不训练策略,所以接入新的具身模型只需要部署服务并注册:
1. **用相同的 RPC 接口提供服务**,参考 `rpc/policy_server_pi05.py`:`GET /health`,以及 `POST /v1/infer`,接收 `InferenceRequest`(任务描述、种子、观测图像和机器人状态),返回包含动作块的 `InferenceResponse`(见 `rpc/protocol.py`)。
2. **注册策略类型**,照着 `cosmos` 和 `pi05` 添加:动作维度和每块步数在 `recovery_explore/cosmos_call.py` 和 `env_service.py`,服务启动在 `launch_svc.sh`,端口和默认值在 `spotter.sh`。
3. **选择监督粒度**:`WINDOW`(每次筛查覆盖的 chunk 数)和 `TEL_CHUNKS`(给判别器看的遥测行数)。
4. **运行** `bash spotter.sh run <你的策略类型> ...`。
## 📈 输出
```text
recovery_explore/runs__<策略>/
├── results.jsonl # 每集一行
├── lane/driver.log # 各 lane 的进度日志
└── lane/jd-.../w/ # 第 k 个窗口给判别器看的画面
```
| 字段 | 含义 |
|---|---|
| `task`、`seed`、`episode` | 对应的 episode |
| `control_success` / `treatment_success` | 策略单独运行 / 加上 Spotter 是否成功 |
| `interventions`、`judge_calls`、`screened_windows` | 执行的修复次数、判别器调用次数、被筛子放行的窗口数 |
| `ctrl_s`、`treat_s` | 对照组和 Spotter 组的总耗时(秒;该组被跳过时为 `-1`) |
| `model_s`、`screen_s` | 判别器调用和筛子调用的累计耗时(秒) |
| `stale_steps`、`stale_ivs` | 仅异步模式:基于过时窗口做出的步数和修复次数 |
```bash
bash spotter.sh summary # 所有 run
bash spotter.sh summary pi05_sall500
bash spotter.sh summary robotwin_rt500
```
## 🧩 配置参考
| 设置 | RoboCasa · Cosmos | RoboCasa · pi0.5 | RoboTwin 2.0 · pi0.5 |
|---|---:|---:|---:|
| `FAMILY_OVERRIDE` | `cosmos` | `pi05` | `robotwin` |
| 每块步数 | 16 | 25 | 16 |
| `WINDOW`(判别窗口,单位:块) | 2 | 1 | 2 |
| `TEL_CHUNKS` / `RT_TEL_CHUNKS` | 40 | 10 | 10 |
| `MAX_INTERVENTIONS` | 8 | 8 | 5 |
| `QWEN_KEEP_TURNS` / `COMPACT_AT` | 20 / 110000 | 20 / 110000 | 10 / 40000 |
| 策略服务端口 | 8800 | 8900 | 9100 |
| 策略服务 | `python -m rpc.server`(上游 Cosmos Policy) | `python -m rpc.policy_server_pi05` | `recovery_explore/robotwin_policy_server.py` |
`spotter.sh run <策略族>` 使用对应那一列的取值,`robotwin_eval.sh` 使用 RoboTwin 2.0 那一列并加上 `--one-shot`,与发布结果一致;每一项都可以用环境变量覆盖。下表是共用参数,“论文取值”指 RoboCasa 的设置,上表的分策略族取值优先。
| 参数 | 论文取值 | 作用 |
|---|---:|---|
| `STEP_BUDGET_SCALE` | `1.8` | 步数预算倍率,对照组和实验组必须相同。 |
| `SCREEN` | `1` | 开启筛子;`0` 表示每个窗口都调用判别器。 |
| `SCREEN_CONFIRM2` | `1` | 连续两次标记才调用判别器;`0` 表示一次就调用。 |
| `MAX_INTERVENTIONS` | `8` | 每集最多干预次数。 |
| `ALLOW_RESET` / `MAX_RESETS` | `0` / `0` | 关闭回滚,保证各集可比。 |
| `ENGINE` / `MODEL` | `qwen` / `qwen38` | 使用本地 Qwen 判别器;`ENGINE=api` 换成 GPT-6 Astra。 |
| `COMPACT_AT` | `110000` | Qwen 对话压缩阈值(token)。 |
| `QWEN_KEEP_TURNS` | `20` | 完整保留的最近判别轮数。 |
| `FEWSHOT` | `0` | `1` 表示加一个示例(即 `--one-shot`),需要示例库。 |
Qwen 只在介入的修复回合里思考,每次最多 `QWEN_THINK_BUDGET`(默认 `5000`)个 token;筛子和窗口判别都不思考,`QWEN_REPAIR_THINK=0` 则全部不思考,与论文设置一致。
**思考预算怎么选。** `QWEN_THINK_BUDGET` 按你的 Qwen 服务能承受的程度来设。预算越大,修复计划想得越充分,但每个修复回合
越慢;预算越小越快,但思考没想完就会被截断。建议取能让修复回合在 `ACT_DEADLINE` 之内完成的最大预算(GPU 较慢、或每个
副本带的 lane 较多时,也把 `ACT_DEADLINE` 调大),跑完后检查一下大多数修复回合**没有**被截断。每次修复回复都存在该集文件夹
的 `act_w*_a*_r*.json` 里,思考撞到预算上限时会记 `think_budget_hit: true`:
```bash
python3 - <<'EOF'
import glob, json
files = glob.glob("recovery_explore/runs__/lane*/jd-*/act_w*.json")
hit = sum(bool(json.load(open(f)).get("think_budget_hit")) for f in files)
print(f"{hit}/{len(files)} repair turns hit the thinking budget")
EOF
```
如果超过一半被截断,就调大预算(或者加 Qwen 副本,让大预算也能跑得快)。在 RoboTwin 2.0 上,预算 2000 时大约 65% 的修复
回合思考被截断,5000 时大约 44%。
判别器的节奏另有几个开关,默认都是关闭或保守取值:
| 变量 | 默认值 | 作用 |
|---|---:|---|
| `ASYNC_SCREEN` | `0` | `1` 表示判别器思考时策略继续执行,之后从最新完成的窗口接着判。更快,但判别器看到的是已经过去的窗口,这部分代价在 `results.jsonl` 里记为 `stale_steps` 和 `stale_ivs`。`2` 还会把策略限制在上一次检查之后 `ASYNC_K` 个窗口之内。 |
| `MISS_GRACE` | `2` | 策略抓空之后,先给它自己重试的窗口数,之后判别器才可以接管。 |
| `FIRST_IV_FRAC` | `35` | 第一次干预要等到策略至少抓空过一次,或者已经用掉这个百分比的步数预算。`0` 表示不设这个门槛。 |
| `MONITOR_AFTER_BUDGET` | `1` | 干预次数用完后继续调用判别器,只做记录。`0` 表示不再调用。 |
| `LATE_IV_FRAC` | `45`(RoboCasa)、`0`(RoboTwin 2.0) | 步数预算用掉这个百分比之后,不再开始*第一次*干预;之后的干预不受影响。`0` 表示关闭。 |
| `PLAN_ROUNDS` | `5`(RoboCasa)、`3`(RoboTwin 2.0) | 一次干预里判别器最多可以发几段计划。 |
**RoboCasa 的修复步骤。** 除了运动原语,RoboCasa 的判别器还有一个 `aim` 步骤:机器人用腕部深度相机向下看,找到上次抓空位置附近
(或判别器指定位置附近)的物体,沿物体短边抓取,稍微抬起检查是否抓牢,然后报告 `held`、`closed_empty`、`slipped`、`no_object`、
`too_wide`、`blocked` 或 `step_cap`。抓牢后紧接着交还给策略时,夹爪会保持闭合(也可以显式写 `{"op": "policy", "hold": true}`)。
像素目标写成单张相机图像内 0–1000 归一化的 `[行, 列]`(`PIXEL_FRAME=1000`;设为 `512` 则按原始像素),并且每个相机单独作为一张图给
Qwen 用来指点(`QWEN_POINT_TILES=1`)。判别器用到的信息全部来自相机和机器人自身的关节、夹爪读数。
改动 `STEP_BUDGET_SCALE`、`WINDOW` 或策略种类都相当于换了实验。比较不同 run 时只在同一个评测集上比较;由于策略的运行不能逐比特复现,应比较总成功率,而不是单集结果。
## 🙏 致谢
- [RoboCasa](https://robocasa.ai):我们评测所用的仿真基准和场景资源。
- [Cosmos Policy](https://github.com/NVlabs/cosmos-policy):发布的 RoboCasa 权重及其策略服务。
- [π0.5](https://huggingface.co/DAVIAN-Robotics/pi05-robocasa-H50) 与 [LeRobot](https://github.com/huggingface/lerobot):RoboCasa 上的 π0.5 权重以及加载它的库。
- [RoboTwin 2.0](https://github.com/RoboTwin-Platform/RoboTwin) 与 [RoboTwin 2.0 的 pi0.5 权重](https://huggingface.co/motus-robotics/pi0.5_robotwin2):我们评测所用的双臂仿真基准和策略权重。
- [Qwen](https://huggingface.co/Qwen) 与 [vLLM](https://github.com/vllm-project/vllm):本地部署的筛子和判别器。
- [RPent](https://github.com/RLinf/RPent):`recovery_explore/` 中部分代码改编自它(Apache-2.0,见 `THIRD_PARTY_NOTICES.md`)。
## 📜 许可证
本项目以 [MIT 许可证](LICENSE) 发布。`recovery_explore/` 中有部分文件改编自 RPent,仍遵循 Apache License 2.0,详见 [THIRD_PARTY_NOTICES.md](THIRD_PARTY_NOTICES.md)。
## 📬 联系方式
有问题、想分享结果,或者想关注项目进展?欢迎加入交流群:
也可以在 [GitHub Discussions](https://github.com/zqc3117/Spotter/discussions) 提问和交流想法,在 [Issues](https://github.com/zqc3117/Spotter/issues) 反馈 bug,或发邮件联系 Qichao Zhao:[zhaoqc25@mails.tsinghua.edu.cn](mailto:zhaoqc25@mails.tsinghua.edu.cn)。
## 📖 引用
```bibtex
@article{li2026spotter,
title = {Spotter: Let the Embodied Model Lead, and the VLM Reflect for It},
author = {Li, Long and Zhao, Qichao and Yang, Yue and Xu, Fan and Wang, Zhe and Liew, Alan Wee-Chung and Qu, Chao and Shen, Heng Tao and Pan, Shirui},
journal = {arXiv preprint arXiv:2609.36808},
year = {2026}
}
```
|