Esta es una traducción; el README en inglés es la referencia y puede ser más reciente.
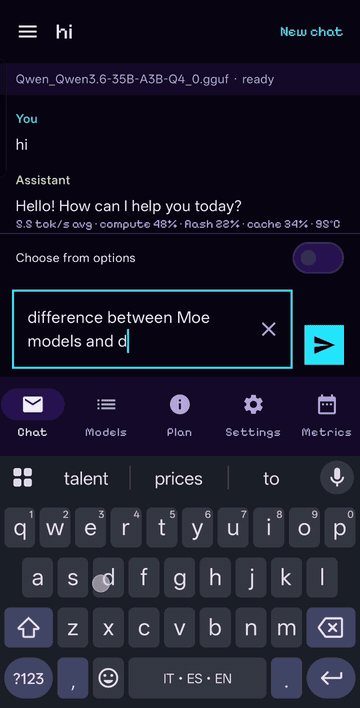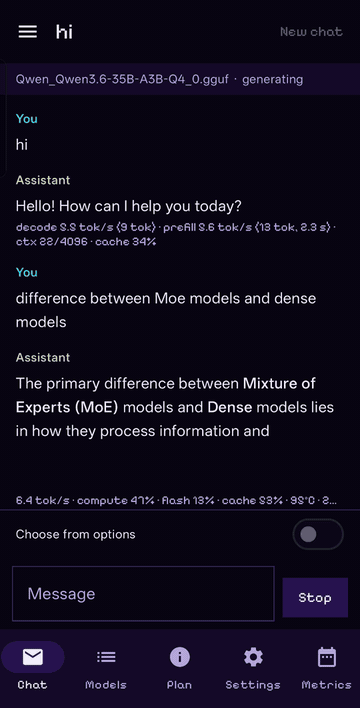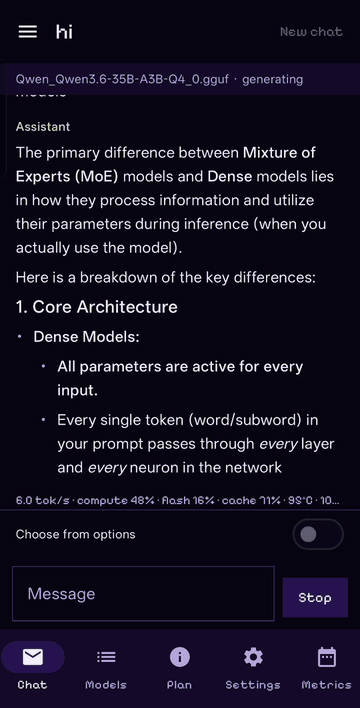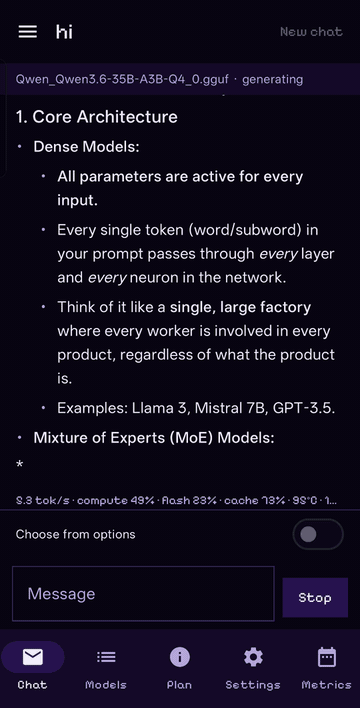
Ejecuta modelos Mixture-of-Experts más grandes que la memoria de tu dispositivo. Los expertos se leen de la
flash cuando el modelo los necesita. Android, iOS, macOS, Windows y Linux, construido sobre llama.cpp.
Teléfono Android de 12 GB
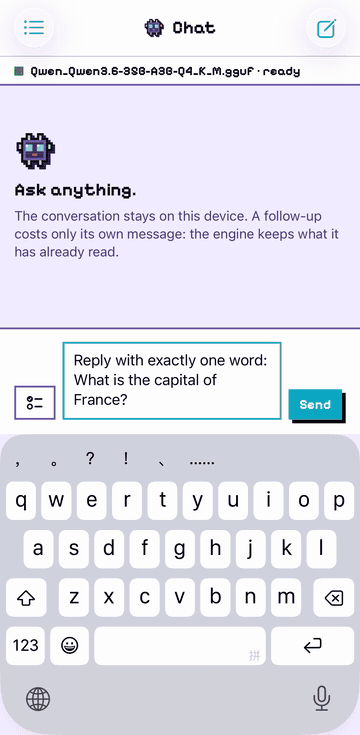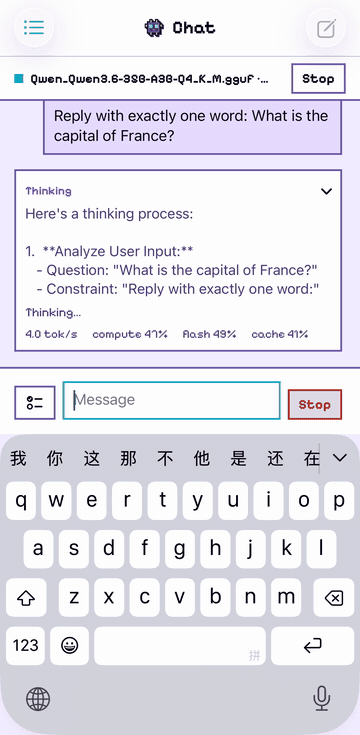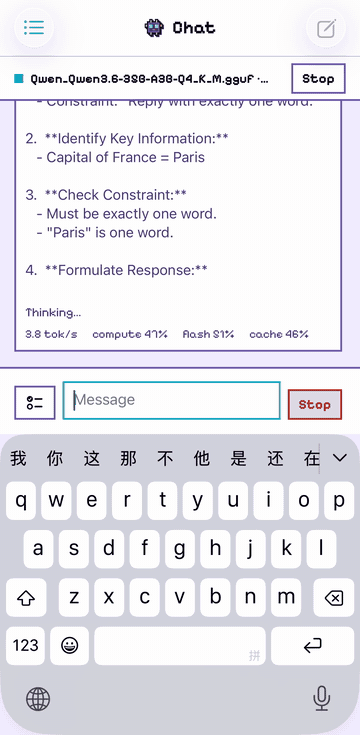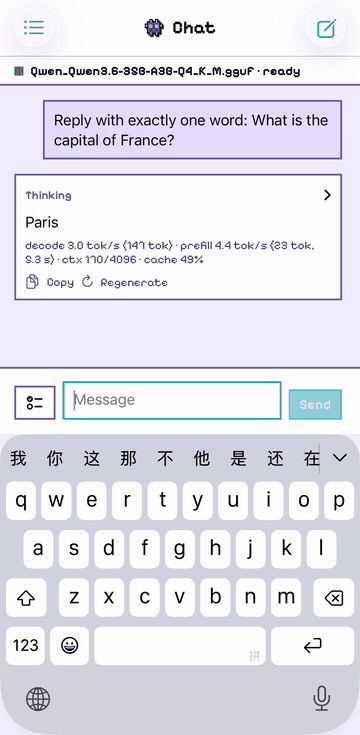
iPhone de 12 GB
Portátil Apple silicon de 16 GB
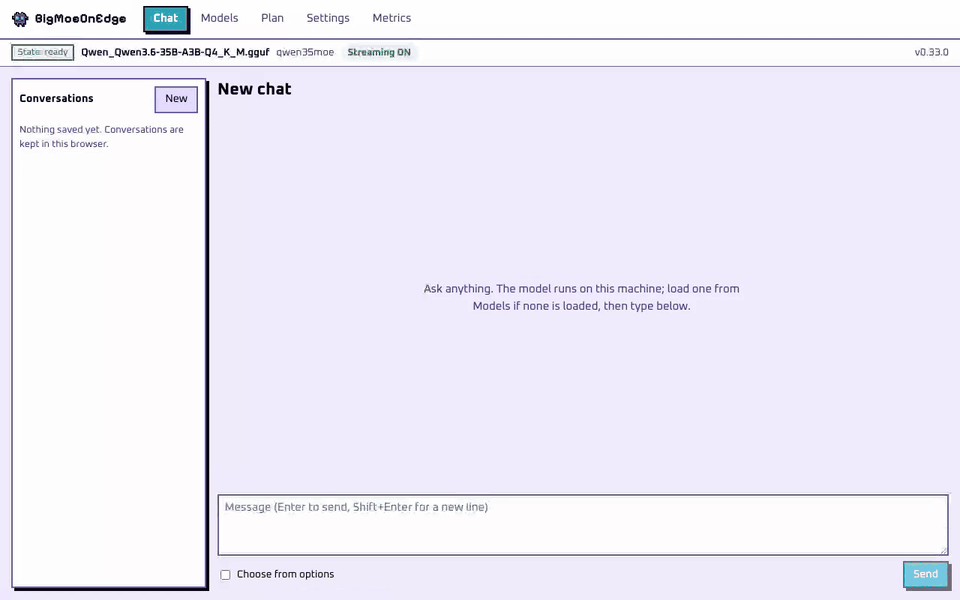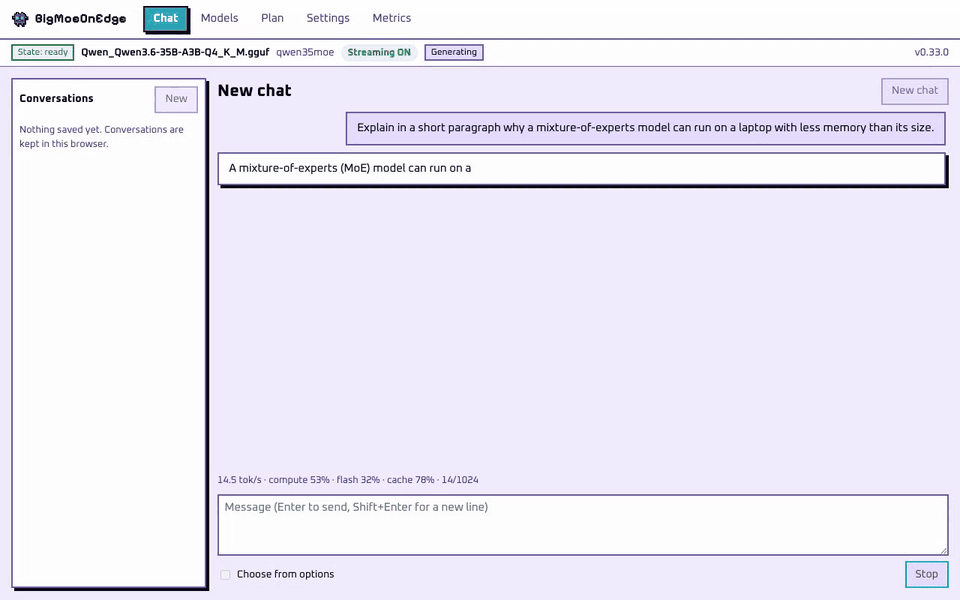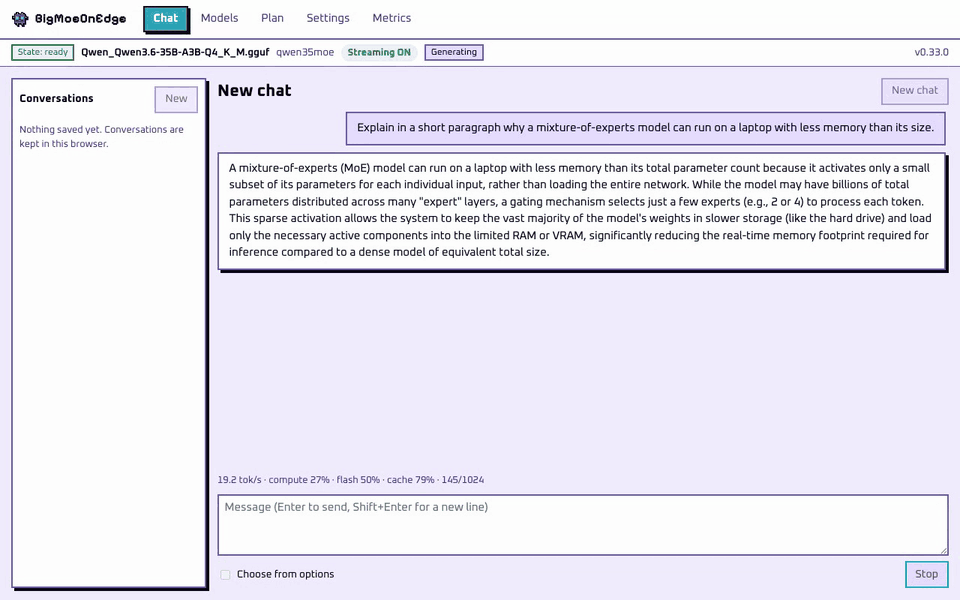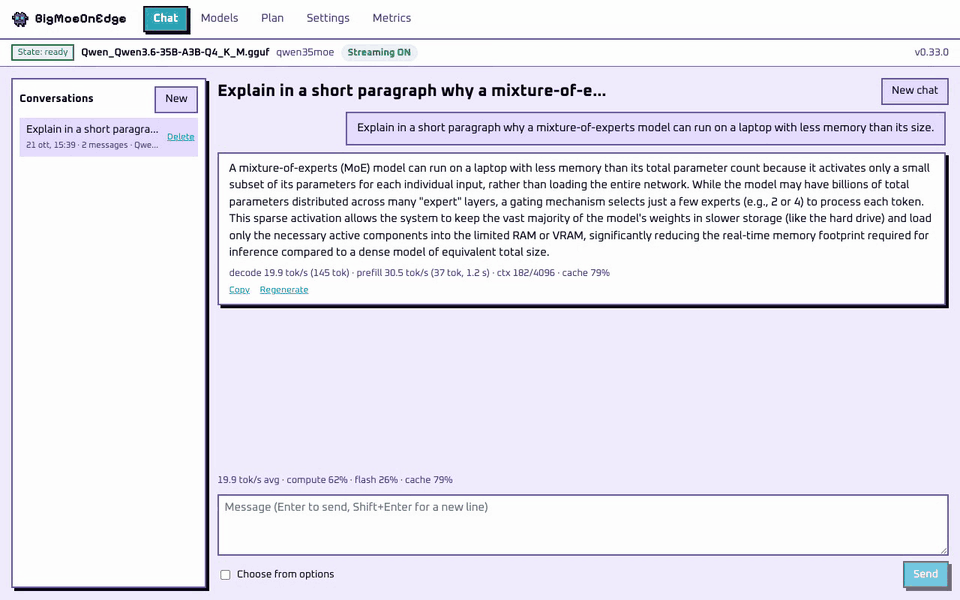
Qwen3.6-35B-A3B (21 GB) en tiempo real en cada dispositivo. El modelo es más grande que la memoria de cada
dispositivo.
## Qué hace
- **Ejecuta modelos que no caben.** Un modelo MoE usa unos pocos expertos por token. El motor mantiene en
memoria los pesos que necesita cada token y los expertos más usados, y lee el resto de la flash. La salida
es la misma que con el modelo entero en memoria; los tests lo comprueban.
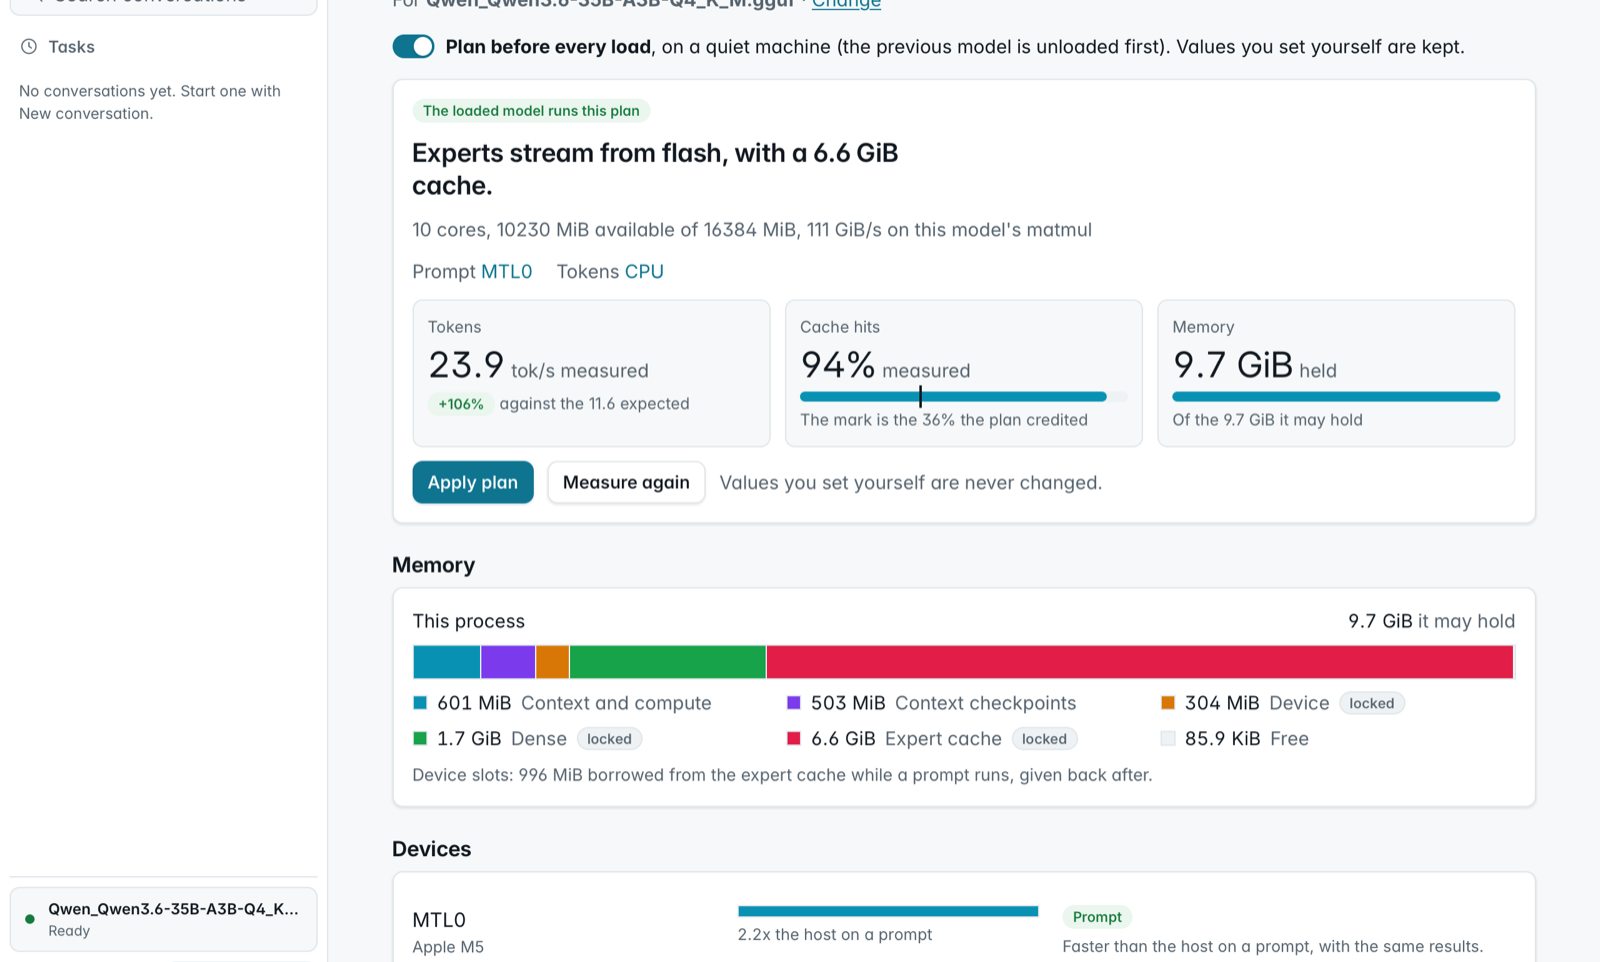
- **Se configura solo.** `--auto` mide la máquina y el modelo y elige el tamaño de la caché, los hilos y qué
dispositivo hace qué. La pantalla Plan muestra cada decisión y su motivo.
- **Cualquier GGUF MoE.** Todo lo que carga llama.cpp, en cualquier cuantización. Sin código por modelo.
- **Todos los backends.** CPU, Metal, CUDA, HIP, Vulkan, OpenCL y la Hexagon NPU. En una tarjeta gráfica,
los expertos más usados se quedan en su VRAM.
- **Apps y un servidor.** Una app de escritorio, apps para el teléfono y un servidor compatible con OpenAI y
Anthropic para agentes de programación.
## Rendimiento
| Hardware | Memoria | Modelo | En disco | Expertos desde | Decodificación tok/s |
|---|---|---|---:|---|---:|
| **Teléfono Android** | 12 GB | DeepSeek V4 Flash 284B | 91 GB | flash | 1 |
| | | Qwen3.8-Flash-Next 125B | 80 GB | flash | 2-4 |
| | | Qwen3.6-35B-A3B | 21 GB | flash | 5 |
| **iPhone** | 12 GB | Qwen3.6-35B-A3B | 21 GB | flash | 3 |
| **Portátil Apple silicon** | 16 GB | Qwen3.8-Flash-Next 125B | 76 GB | flash | 7-9 |
| | | Qwen3.6-35B-A3B | 21 GB | flash | 18-24 |
| **Portátil Windows** | 16 GB | Qwen3.6-35B-A3B | 21 GB | flash | 5 |
| **GPU de escritorio** (NVIDIA) | 16 GB + 32 GB RAM | Qwen3.8-Flash-Next 125B | 66 GB | flash, caché en GPU | 19-21 |
| **GPU de escritorio** (NVIDIA) | 24 GB + 96 GB RAM | Qwen3.8-Flash-Next 125B | 66 GB | RAM, caché en GPU | 70 |
| | | Qwen3.6-35B-A3B | 21 GB | GPU | 217 |
| **GPU de centro de datos** (AMD, ROCm) | 192 GB | Qwen3.8-Flash-Next 125B | 66 GB | GPU | 53 |
Un rango es la variación entre ejecuciones. Método y todas las ejecuciones:
[docs/benchmarks.md](docs/benchmarks.md). Para añadir tu máquina, ejecuta
`scripts/bench-report.sh model.gguf` y abre un
[informe de benchmark](https://github.com/Helldez/BigMoeOnEdge/issues/new?template=benchmark-report.yml).
## Instalación
Desde la [última versión](https://github.com/Helldez/BigMoeOnEdge/releases/latest):
- **macOS** (Apple silicon): abre el `.dmg` y arrastra la app a Aplicaciones. Aún no está notarizada; el
README.txt del dmg tiene el único paso para el primer arranque.
- **Windows**: ejecuta el `-setup.exe`. Sin derechos de administrador.
- **Linux**: haz ejecutable el `.AppImage` y ejecútalo. La ventana necesita WebKitGTK 4.1;
`--server` ejecuta solo el servidor.
- **Android**: instala `app-dev-release.apk`. Cada versión se instala sobre la anterior.
- **iOS**: compila la app con Xcode desde [examples/ios](examples/ios/README.md). Experimental.
Abre la app y elige un modelo en **Models**. Una tarjeta NVIDIA o AMD obtiene su backend desde
**Settings** ([docs/desktop-app.md](docs/desktop-app.md)).
Solo las herramientas de línea de comandos (`bmoe-cli`, `bmoe-server`):
```bash
curl -fsSL https://github.com/Helldez/BigMoeOnEdge/releases/latest/download/install.sh | sh
```
```powershell
irm https://github.com/Helldez/BigMoeOnEdge/releases/latest/download/install.ps1 | iex
```
## Uso
```bash
bmoe-cli -m model.gguf --auto -p "Explain MoE routing." # plan and run
bmoe-cli -m model.gguf --plan # print the plan
bmoe-server -m model.gguf -c 32768 # the server and its web UI, port 8765
```
El servidor habla la API de OpenAI (`/v1/chat/completions`, `/v1/responses`) y la de Anthropic
(`/v1/messages`), con streaming, llamadas a herramientas y razonamiento. Añade `--host 0.0.0.0 --api-key KEY`
para dar servicio a otras máquinas. Referencia: [docs/server-api.md](docs/server-api.md).
```python
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8765/v1", api_key="local")
reply = client.chat.completions.create(model="local", messages=[{"role": "user", "content": "Hello"}])
print(reply.choices[0].message.content)
```
**Los agentes de programación** necesitan un contexto grande: varias veces el tamaño de su primera petición.
32768 basta para opencode, 65536 para Claude Code
([dimensionar el contexto](docs/server-api.md#sizing-the-context-for-a-client)).
```bash
# Claude Code
export ANTHROPIC_BASE_URL=http://127.0.0.1:8765
export ANTHROPIC_API_KEY=local
export ANTHROPIC_MODEL=
export ANTHROPIC_DEFAULT_HAIKU_MODEL=$ANTHROPIC_MODEL
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=65536
claude
```
```toml
# Codex CLI, ~/.codex/config.toml
model = ""
model_provider = "bmoe"
[model_providers.bmoe]
name = "bmoe"
base_url = "http://127.0.0.1:8765/v1"
wire_api = "responses"
env_key = "BMOE_API_KEY" # export BMOE_API_KEY=local
```
Para opencode, añade el servidor como proveedor compatible con OpenAI en `http://127.0.0.1:8765/v1`. En
**Connect apps**, la app escribe la configuración de Codex CLI y opencode y muestra la de
Claude Code.
**El agente.** La app de escritorio tiene su propio agente: trabaja en una carpeta que eliges, lee y edita
archivos y ejecuta comandos, y pregunta antes de cambiar nada salvo que se lo permitas. Una conversación
también la puede llevar OpenCode, Claude Code, Codex o Pi. Consulta [docs/agent.md](docs/agent.md).
## Cómo funciona
Para cada token, el router de cada capa elige unos pocos expertos. El motor los busca en hasta tres
niveles, cada uno una caché del de abajo:
- **VRAM**, en una tarjeta gráfica: los pesos que lee cada token y los expertos más usados.
- **RAM**: una caché de expertos. Sin tarjeta gráfica, también los pesos que lee cada token.
- **Flash** (el disco): el modelo entero.
Un experto que falta en la VRAM se copia desde la RAM; uno que falta en la RAM se lee de la flash. En un
teléfono o un Mac con Apple silicon la GPU usa la misma RAM que la CPU, así que hay dos niveles. Un modelo
que cabe en la tarjeta se ejecuta entero en ella. El streaming solo lee, así que no desgasta el disco.
El motor usa la API pública de llama.cpp, así que sus cuantizaciones, tokenizadores y plantillas de chat
funcionan sin cambios, y una actualización es un bump del submódulo. Qué tensores son expertos se lee del
archivo ([docs/which-models-stream.md](docs/which-models-stream.md)). Diseño:
[docs/architecture.md](docs/architecture.md).
## El planificador
El planificador lee la cabecera del modelo y mide la máquina: memoria, velocidad del almacenamiento, cada
CPU, GPU y NPU. Sus reglas no nombran ningún dispositivo ni plataforma, así que un teléfono y un equipo de
escritorio reciben planes distintos del mismo código. Los valores que fijas tú se respetan. Consulta
[docs/hardware-planning.md](docs/hardware-planning.md).
## Plataformas
| | Android | macOS | Windows | Linux | iOS |
|---|---|---|---|---|---|
| Motor y CLI | arm64 | Apple silicon | x86_64, arm64 | x86_64, aarch64 | arm64 (dentro de la app) |
| App | app nativa | app de escritorio | app de escritorio | app de escritorio | app nativa, compilada desde el código fuente |
| Aceleradores | Hexagon NPU, Vulkan, OpenCL | Metal | Vulkan, CUDA, OpenCL (arm64), Hexagon NPU (arm64) | Vulkan, CUDA, HIP | Metal |
| Probado en | teléfono de 12 GB | portátil de 16 GB | portátil de 16 GB | tarjetas NVIDIA de 12-24 GB y AMD de 192 GB alquiladas | iPhone de 12 GB |
Detalles: [docs/platforms.md](docs/platforms.md).
## Cómo se compara
| | **BigMoeOnEdge** | Strata | ds4 | colibri | KTransformers |
|---|:---:|:---:|:---:|:---:|:---:|
| Teléfono Android (también NPU) | ✅ | ❌ | ❌ | ❌ | ❌ |
| iPhone | ✅ | ❌ | ❌ | ❌ | ❌ |
| Mac | ✅ | ✅ | ✅ | ✅ | ❌ |
| Windows / Linux, solo CPU | ✅ | ❌ | Linux, para depurar | ✅ | ❌ |
| NVIDIA | ✅ | ✅ | ✅ | ✅ | ✅ |
| AMD (ROCm) | ✅ (también MI300X) | Radeon RX y Strix Halo | Strix Halo y RDNA | Vulkan | ✅ |
| Cualquier modelo MoE en GGUF | ✅ | pocos modelos | pocos modelos | formato propio | pocos modelos |
| Se configura solo | ✅ `--auto` | elige el modelo según la memoria | presupuesto de la caché de expertos | `coli tune` | ❌ |
Cuando un modelo cabe en una GPU de gaming más la RAM, Strata es de dos a cuatro veces más rápido. Cuando se
lee desde la flash, todos los motores se quedan por debajo de diez tokens por segundo y es el disco quien
marca el ritmo. Velocidades y fuentes: [docs/comparison.md](docs/comparison.md).
## Compilar desde el código fuente
```bash
git clone --recursive https://github.com/Helldez/BigMoeOnEdge.git
cd BigMoeOnEdge
cd ui && npm ci && npm run build && cd ..
scripts/build-host.sh
build/bin/bmoe-server --open
```
Tests: `cd build && ctest --output-on-failure` (requiere `python3` con `gguf`). Android:
`scripts/build-android.ps1`, y luego el APK en [examples/android](examples/android). Más:
[CONTRIBUTING.md](CONTRIBUTING.md).
## Documentación
[docs/](docs/README.md). Empieza por [hardware-planning.md](docs/hardware-planning.md),
[settings.md](docs/settings.md), [server-api.md](docs/server-api.md) y
[limitations.md](docs/limitations.md).
## Trabajos previos
AirLLM, *LLM in a flash* de Apple, FlexGen, PowerInfer, EdgeMoE y
[flash-moe](https://github.com/danveloper/flash-moe), un motor Metal que lee en streaming un MoE de 397B
desde SSD en Apple silicon.
## Licencia
Apache-2.0 ([LICENSE](LICENSE)). Los binarios y las apps también incluyen llama.cpp, ggml y otras
bibliotecas bajo MIT, BSD, Apache-2.0 y SIL OFL 1.1: [THIRD_PARTY_LICENSES](THIRD_PARTY_LICENSES).