

English · 中文 · 日本語 · Español · Français · Italiano
> 本文为译文;以英文 README 为准,英文版可能更新。
运行比设备内存更大的混合专家(Mixture-of-Experts)模型。模型需要专家时,从闪存读取。
支持 Android、iOS、macOS、Windows 和 Linux,基于 llama.cpp 构建。
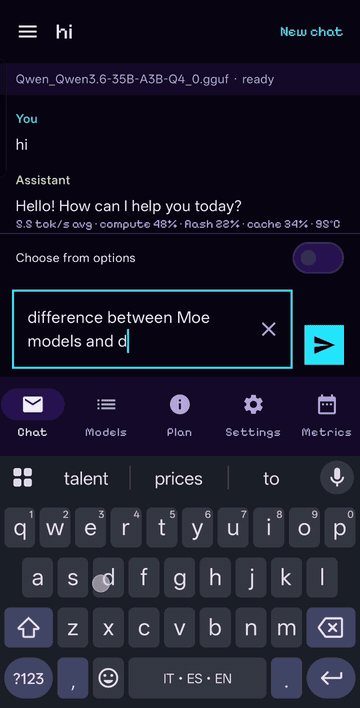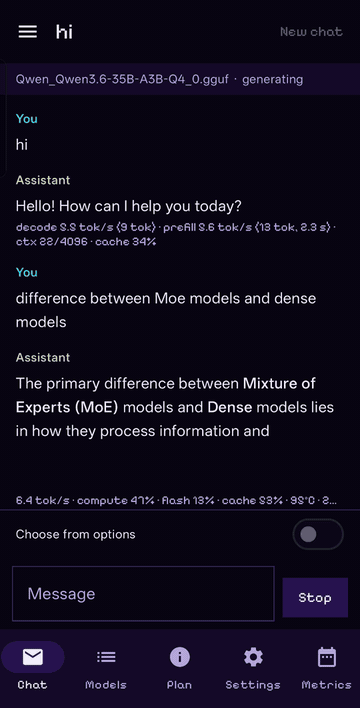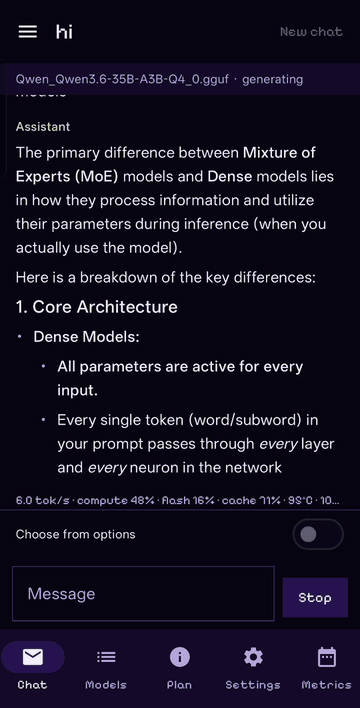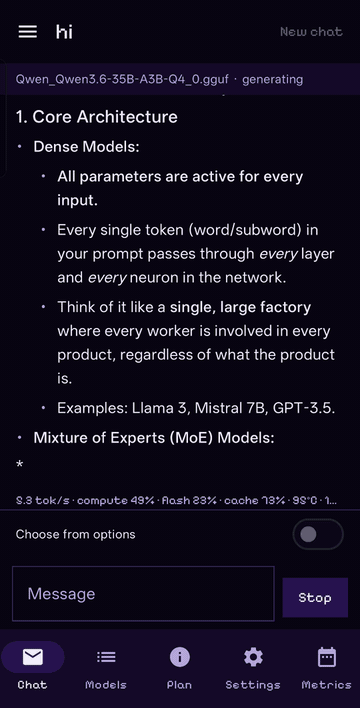 |
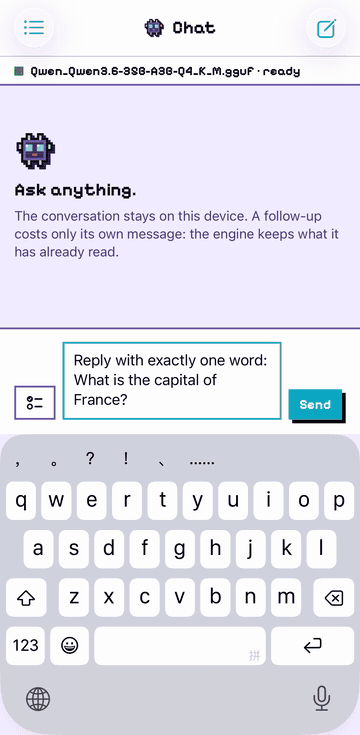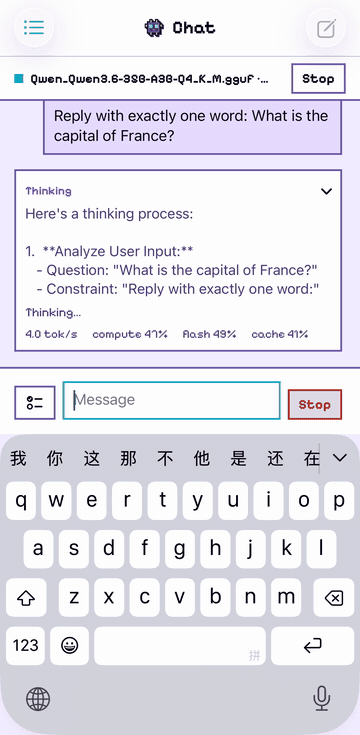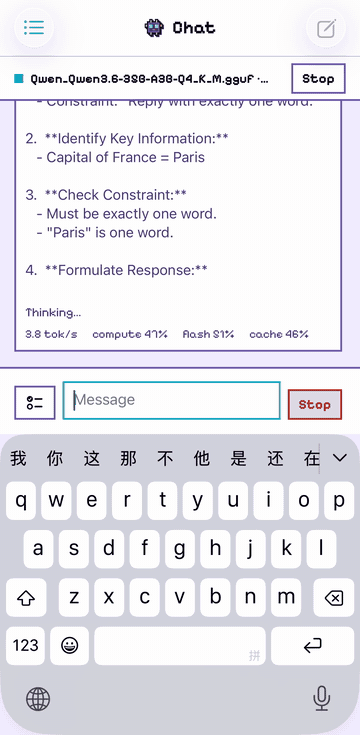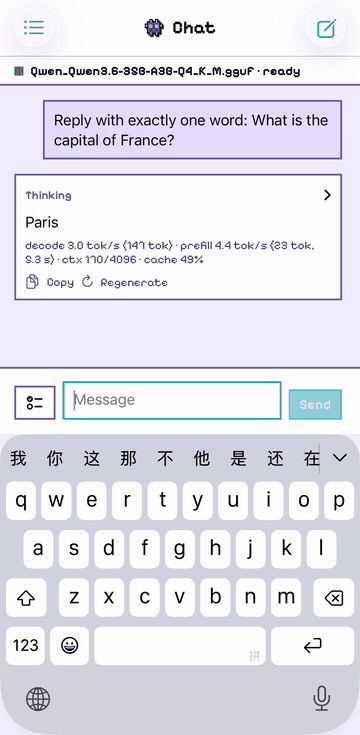 |
| 12 GB Android 手机 |
12 GB iPhone |
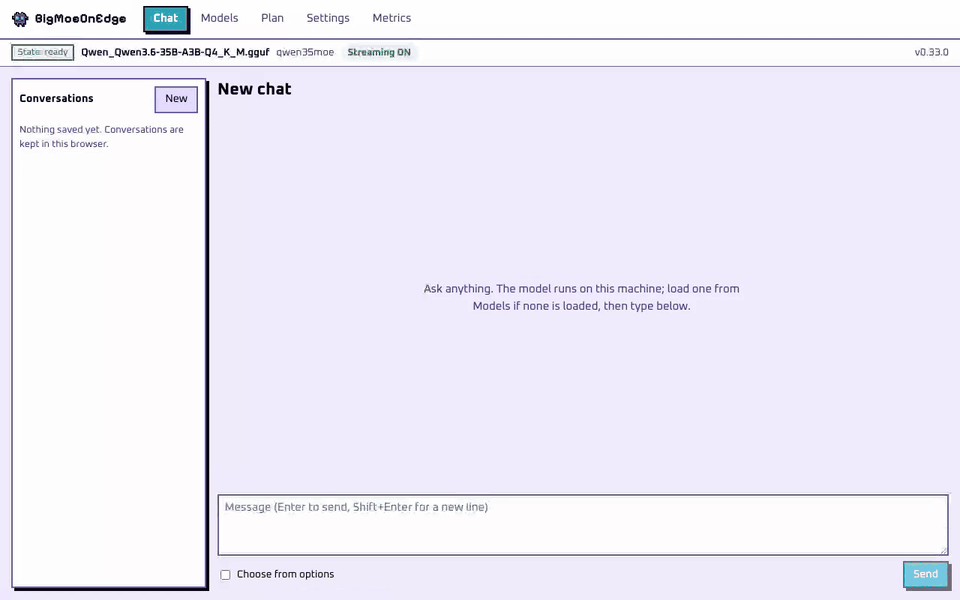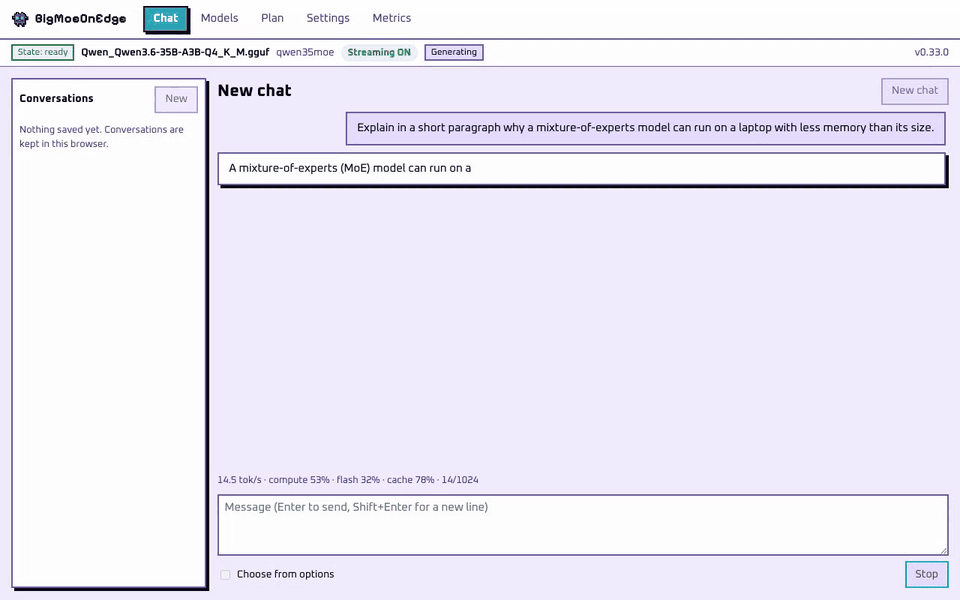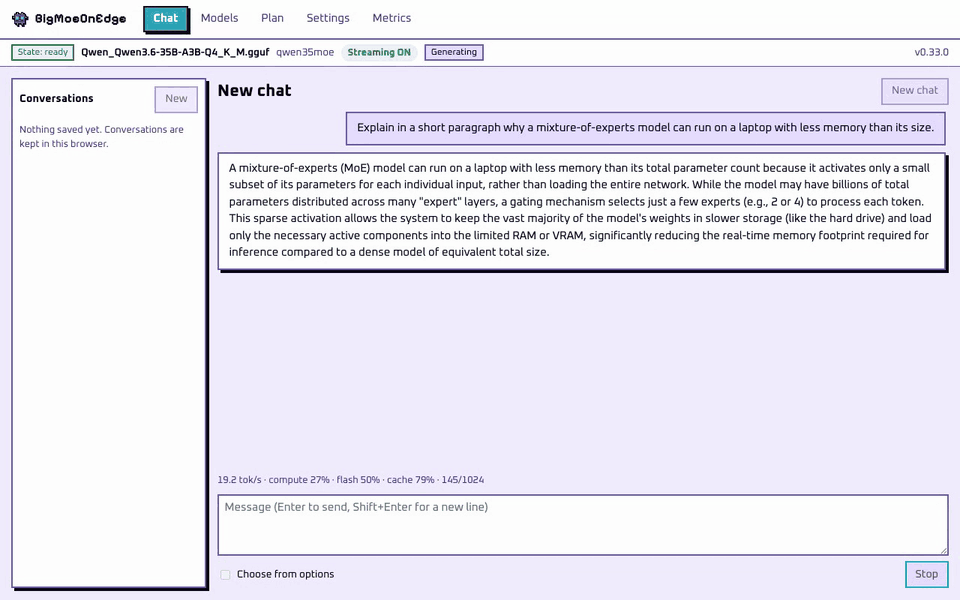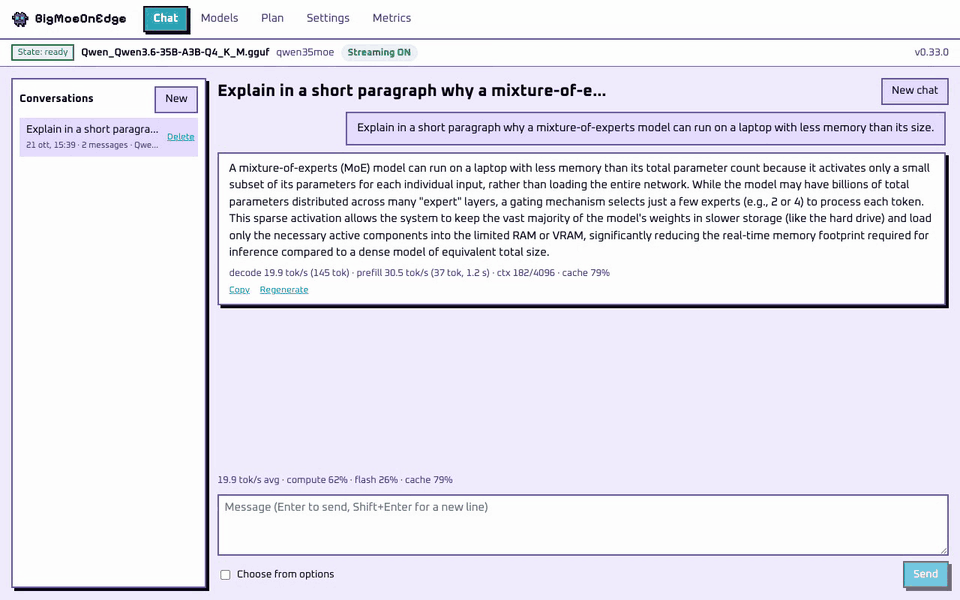 |
| 16 GB Apple silicon 笔记本 |
Qwen3.6-35B-A3B(21 GB)在各设备上实时运行。该模型大于每台设备的内存。
## 功能
- **运行装不下的模型。** MoE 模型每个 token 只使用少数几个专家。引擎将每个 token 都需要的权重和最常用的专家保留在内存中,其余从闪存读取。输出与将整个模型放在内存中时相同;测试会对此进行验证。
- **自动配置。** `--auto` 测量机器和模型,选择缓存大小、线程数以及由哪个设备做什么。Plan 界面展示每项选择及其原因。
- **任意 MoE GGUF。** llama.cpp 能加载的都可以,任意量化格式。没有针对单个模型的代码。
- **所有后端。** CPU、Metal、CUDA、HIP、Vulkan、OpenCL 和 Hexagon NPU。在显卡上,最常用的专家保留在 VRAM 中。
- **应用与服务器。** 桌面应用、手机应用,以及面向编程智能体的 OpenAI 和 Anthropic 兼容服务器。
## 性能
| 硬件 | 内存 | 模型 | 磁盘占用 | 专家读取自 | 解码 tok/s |
|---|---|---|---:|---|---:|
| **Android 手机** | 12 GB | DeepSeek V4 Flash 284B | 91 GB | 闪存 | 1 |
| | | Qwen3.8-Flash-Next 125B | 80 GB | 闪存 | 2-4 |
| | | Qwen3.6-35B-A3B | 21 GB | 闪存 | 5 |
| **iPhone** | 12 GB | Qwen3.6-35B-A3B | 21 GB | 闪存 | 3 |
| **Apple silicon 笔记本** | 16 GB | Qwen3.8-Flash-Next 125B | 76 GB | 闪存 | 7-9 |
| | | Qwen3.6-35B-A3B | 21 GB | 闪存 | 18-24 |
| **Windows 笔记本** | 16 GB | Qwen3.6-35B-A3B | 21 GB | 闪存 | 5 |
| **桌面 GPU**(NVIDIA) | 16 GB + 32 GB RAM | Qwen3.8-Flash-Next 125B | 66 GB | 闪存,GPU 缓存 | 19-21 |
| **桌面 GPU**(NVIDIA) | 24 GB + 96 GB RAM | Qwen3.8-Flash-Next 125B | 66 GB | RAM,GPU 缓存 | 70 |
| | | Qwen3.6-35B-A3B | 21 GB | GPU | 217 |
| **数据中心 GPU**(AMD,ROCm) | 192 GB | Qwen3.8-Flash-Next 125B | 66 GB | GPU | 53 |
范围表示多次运行之间的差异。方法与每次运行:
[docs/benchmarks.md](docs/benchmarks.md)。如需添加你的机器,请运行
`scripts/bench-report.sh model.gguf` 并提交一份
[基准测试报告](https://github.com/Helldez/BigMoeOnEdge/issues/new?template=benchmark-report.yml)。
## 安装
从[最新版本](https://github.com/Helldez/BigMoeOnEdge/releases/latest)获取:
- **macOS**(Apple 芯片):打开 `.dmg`,将应用拖到"应用程序"。尚未公证;首次启动所需的一个步骤写在
dmg 的 README.txt 中。
- **Windows**:运行 `-setup.exe`。无需管理员权限。
- **Linux**:为 `.AppImage` 添加可执行权限后运行。窗口需要 WebKitGTK 4.1;
`--server` 只运行服务器。
- **Android**:安装 `app-dev-release.apk`。每个版本都会覆盖安装在上一个版本之上。
- **iOS**:使用 Xcode 从 [examples/ios](examples/ios/README.md) 构建。实验性功能。
打开应用,在 **Models** 中选择一个模型。NVIDIA 或 AMD 显卡可从 **Settings** 获取其后端
([docs/desktop-app.md](docs/desktop-app.md))。
仅命令行工具(`bmoe-cli`、`bmoe-server`):
```bash
curl -fsSL https://github.com/Helldez/BigMoeOnEdge/releases/latest/download/install.sh | sh
```
```powershell
irm https://github.com/Helldez/BigMoeOnEdge/releases/latest/download/install.ps1 | iex
```
## 使用
```bash
bmoe-cli -m model.gguf --auto -p "Explain MoE routing." # plan and run
bmoe-cli -m model.gguf --plan # print the plan
bmoe-server -m model.gguf -c 32768 # the server and its web UI, port 8765
```
服务器支持 OpenAI API(`/v1/chat/completions`、`/v1/responses`)和 Anthropic API(`/v1/messages`),
包括流式输出、工具调用和推理。添加 `--host 0.0.0.0 --api-key KEY` 即可为其他机器提供服务。
参考:[docs/server-api.md](docs/server-api.md)。
```python
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8765/v1", api_key="local")
reply = client.chat.completions.create(model="local", messages=[{"role": "user", "content": "Hello"}])
print(reply.choices[0].message.content)
```
**编程智能体**需要较大的上下文:约为其首个请求的几倍。opencode 用 32768 足够,Claude Code 用 65536
([为客户端设定上下文大小](docs/server-api.md#sizing-the-context-for-a-client))。
```bash
# Claude Code
export ANTHROPIC_BASE_URL=http://127.0.0.1:8765
export ANTHROPIC_API_KEY=local
export ANTHROPIC_MODEL=
export ANTHROPIC_DEFAULT_HAIKU_MODEL=$ANTHROPIC_MODEL
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=65536
claude
```
```toml
# Codex CLI, ~/.codex/config.toml
model = ""
model_provider = "bmoe"
[model_providers.bmoe]
name = "bmoe"
base_url = "http://127.0.0.1:8765/v1"
wire_api = "responses"
env_key = "BMOE_API_KEY" # export BMOE_API_KEY=local
```
对于 opencode,将该服务器添加为 OpenAI 兼容的提供方,地址为 `http://127.0.0.1:8765/v1`。在
**Connect apps** 中,应用会写入 Codex CLI 和 opencode 的设置,并显示 Claude Code 所需的设置。
**智能体。** 桌面应用有自己的智能体:它在你选择的文件夹中工作,读取和编辑文件、运行命令;除非你允许,否则在做任何更改前都会先询问。
对话也可以交给 OpenCode、Claude Code、Codex 或 Pi 运行。参见 [docs/agent.md](docs/agent.md)。
## 工作原理
对每个 token,每一层的路由器选出几个专家。引擎最多在三个层级中查找它们,每一层都是下一层的缓存:
- **VRAM**(在显卡上):每个 token 都要读取的权重,以及最常用的专家。
- **RAM**:专家缓存。没有显卡时,也保存每个 token 都要读取的权重。
- **闪存**(硬盘):整个模型。
VRAM 缺少的专家从 RAM 复制;RAM 缺少的专家从闪存读取。在手机或 Apple silicon Mac 上,GPU 与 CPU 使用同一块
RAM,因此只有两个层级。能装进显卡的模型会完整地在显卡上运行。
流式读取只读不写,因此不会磨损硬盘。
引擎使用 llama.cpp 的公开 API,因此其量化格式、分词器和对话模板都可直接使用,升级只需更新子模块。
哪些张量是专家从文件中读取([docs/which-models-stream.md](docs/which-models-stream.md))。设计:
[docs/architecture.md](docs/architecture.md)。
## 规划器
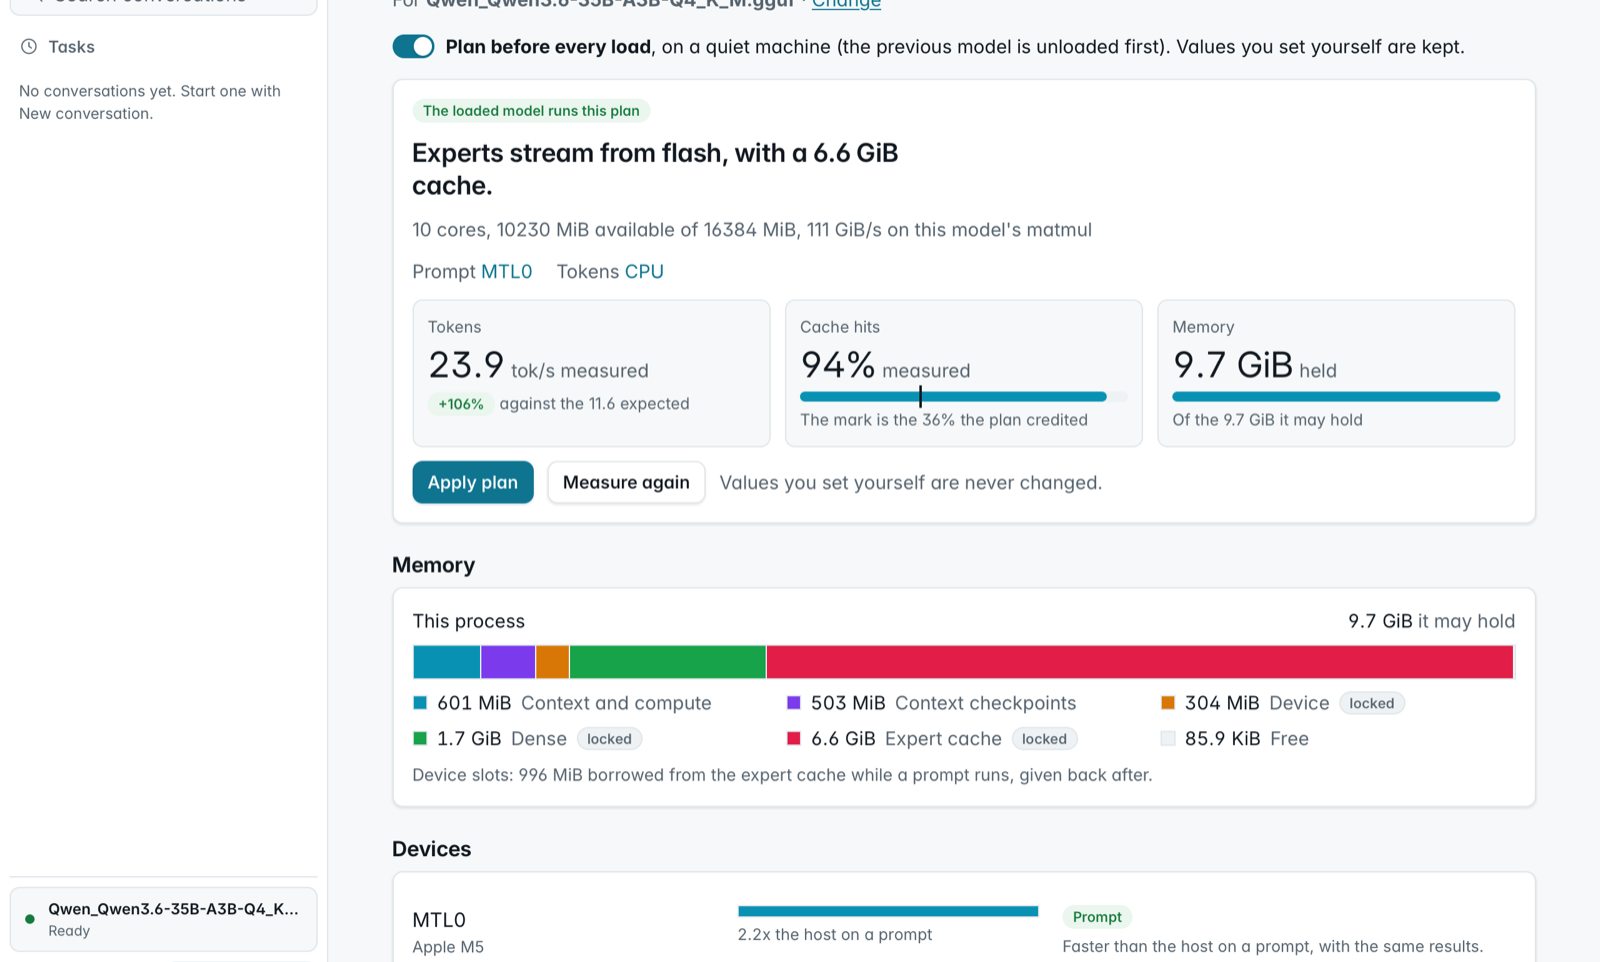
规划器读取模型的文件头并测量机器:内存、存储速度、每个 CPU、GPU 和 NPU。其规则不指定任何设备或平台,
因此同一份代码会为手机和台式机给出不同的方案。你自己设定的值会被保留。参见
[docs/hardware-planning.md](docs/hardware-planning.md)。
## 平台
| | Android | macOS | Windows | Linux | iOS |
|---|---|---|---|---|---|
| 引擎与 CLI | arm64 | Apple silicon | x86_64, arm64 | x86_64, aarch64 | arm64(内置于应用中) |
| 应用 | 原生应用 | 桌面应用 | 桌面应用 | 桌面应用 | 原生应用,从源码构建 |
| 加速器 | Hexagon NPU, Vulkan, OpenCL | Metal | Vulkan, CUDA, OpenCL (arm64), Hexagon NPU (arm64) | Vulkan, CUDA, HIP | Metal |
| 测试设备 | 12 GB 手机 | 16 GB 笔记本 | 16 GB 笔记本 | 租用的 12-24 GB NVIDIA 显卡和 192 GB AMD 显卡 | 12 GB iPhone |
详细信息:[docs/platforms.md](docs/platforms.md)。
## 与其他引擎的比较
| | **BigMoeOnEdge** | Strata | ds4 | colibri | KTransformers |
|---|:---:|:---:|:---:|:---:|:---:|
| Android 手机(含 NPU) | ✅ | ❌ | ❌ | ❌ | ❌ |
| iPhone | ✅ | ❌ | ❌ | ❌ | ❌ |
| Mac | ✅ | ✅ | ✅ | ✅ | ❌ |
| Windows / Linux(仅 CPU) | ✅ | ❌ | Linux,用于调试 | ✅ | ❌ |
| NVIDIA | ✅ | ✅ | ✅ | ✅ | ✅ |
| AMD(ROCm) | ✅(含 MI300X) | Radeon RX 和 Strix Halo | Strix Halo 和 RDNA | Vulkan | ✅ |
| 任意 GGUF 格式的 MoE 模型 | ✅ | 少数模型 | 少数模型 | 自有格式 | 少数模型 |
| 自动配置 | ✅ `--auto` | 按内存选择模型 | 专家缓存预算 | `coli tune` | ❌ |
当模型能放进游戏 GPU 加 RAM 时,Strata 快二到四倍。当模型需要从闪存流式读取时,所有引擎都低于每秒十个 token,
速度由硬盘决定。速度及出处:[docs/comparison.md](docs/comparison.md)。
## 从源码构建
```bash
git clone --recursive https://github.com/Helldez/BigMoeOnEdge.git
cd BigMoeOnEdge
cd ui && npm ci && npm run build && cd ..
scripts/build-host.sh
build/bin/bmoe-server --open
```
测试:`cd build && ctest --output-on-failure`(需要安装了 `gguf` 的 `python3`)。Android:
`scripts/build-android.ps1`,然后在 [examples/android](examples/android) 中构建 APK。更多:
[CONTRIBUTING.md](CONTRIBUTING.md)。
## 文档
[docs/](docs/README.md)。建议从 [hardware-planning.md](docs/hardware-planning.md)、
[settings.md](docs/settings.md)、[server-api.md](docs/server-api.md) 和
[limitations.md](docs/limitations.md) 开始。
## 相关工作
AirLLM、Apple 的 *LLM in a flash*、FlexGen、PowerInfer、EdgeMoE,以及
[flash-moe](https://github.com/danveloper/flash-moe):一个在 Apple silicon 上从 SSD 流式读取 397B MoE 的 Metal 引擎。
## 许可证
Apache-2.0([LICENSE](LICENSE))。二进制文件和应用还包含 llama.cpp、ggml 以及采用 MIT、BSD、Apache-2.0 和
SIL OFL 1.1 许可的其他库:[THIRD_PARTY_LICENSES](THIRD_PARTY_LICENSES)。
