Ceci est une traduction ; le README en anglais fait référence et peut être plus récent.
Exécutez des modèles Mixture-of-Experts plus grands que la mémoire de votre appareil. Les experts sont lus
depuis la flash quand le modèle en a besoin. Android, iOS, macOS, Windows et Linux, construit sur llama.cpp.
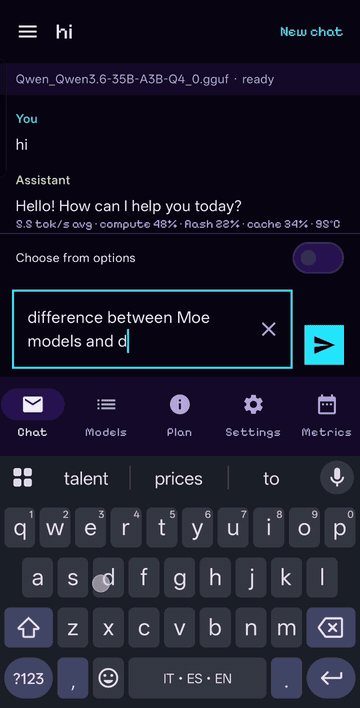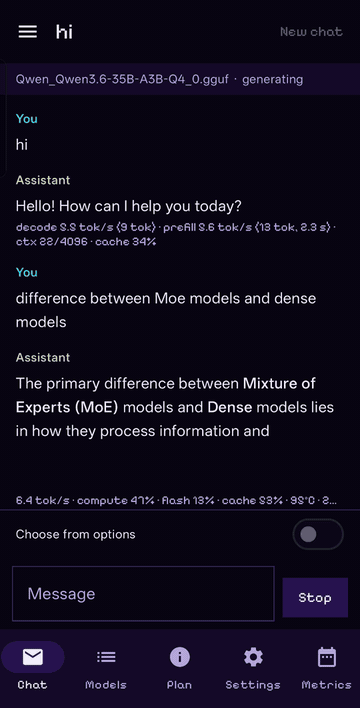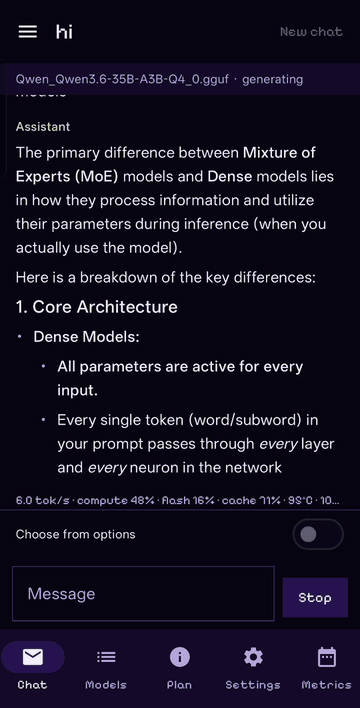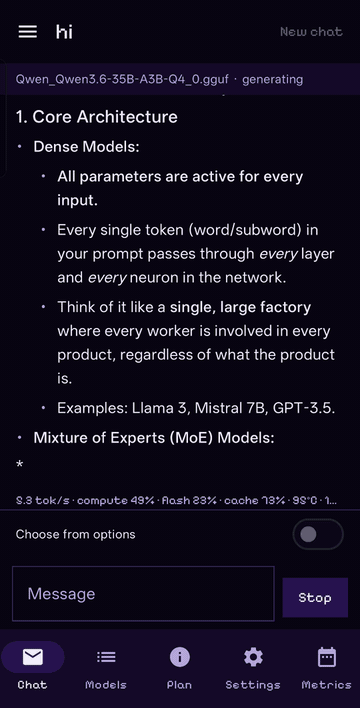
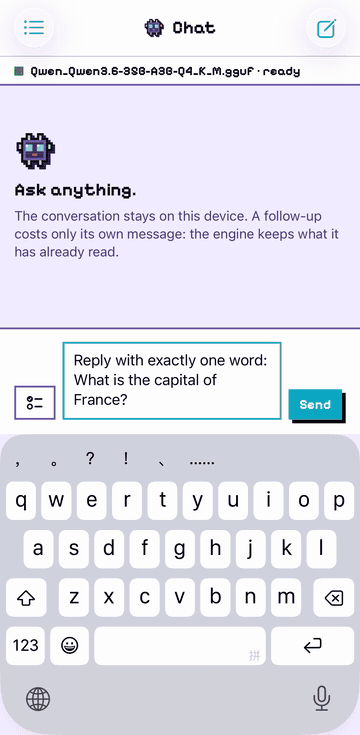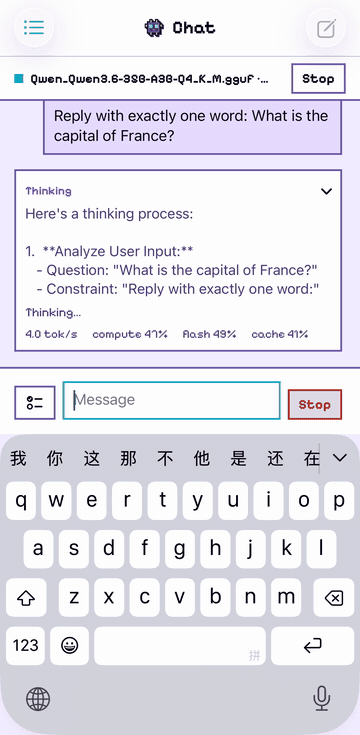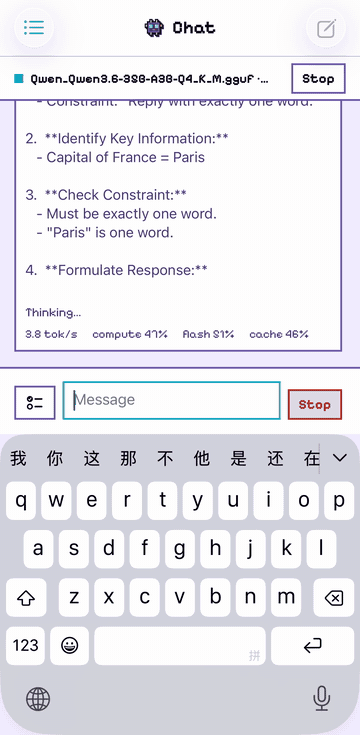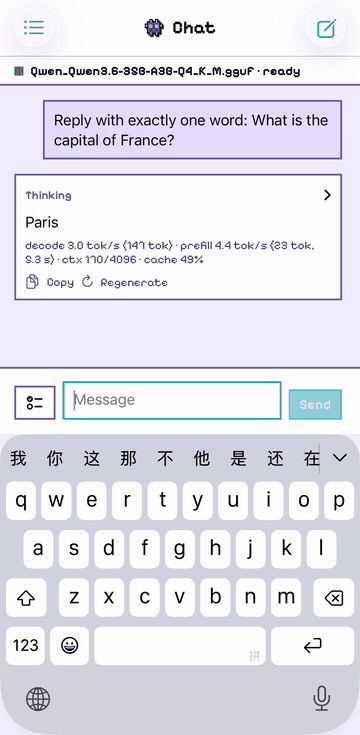
Téléphone Android de 12 GB
iPhone de 12 GB
Portable Apple silicon de 16 GB
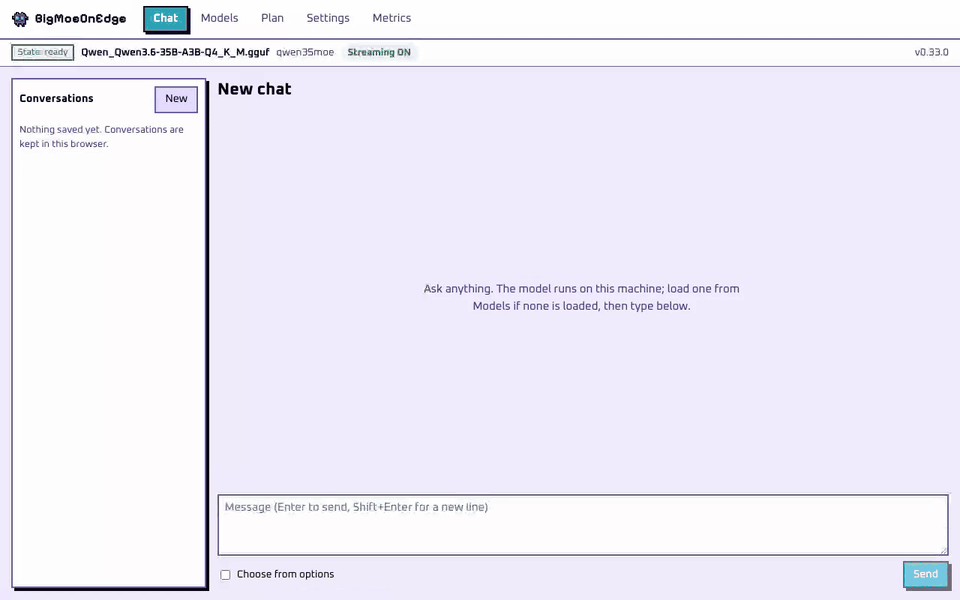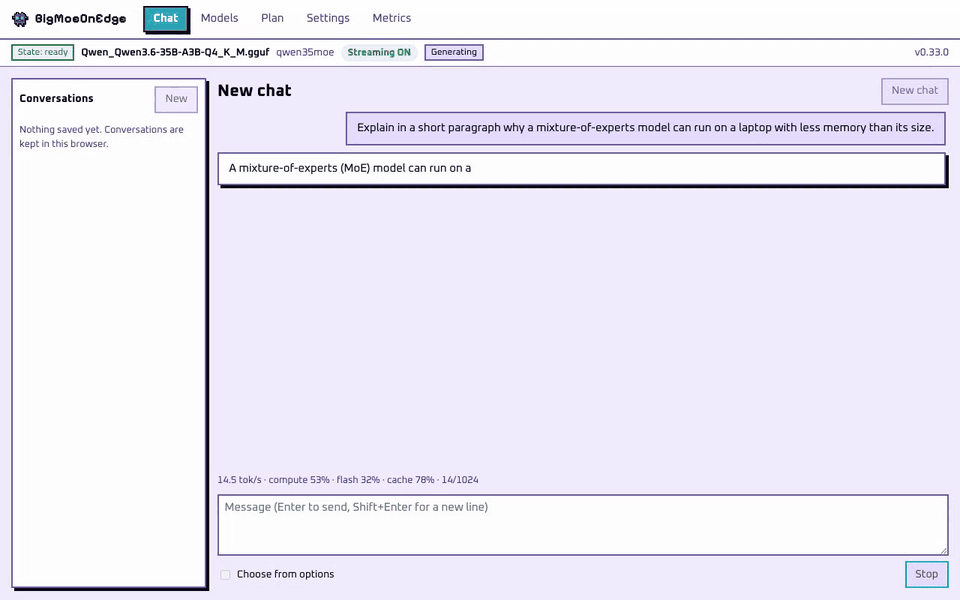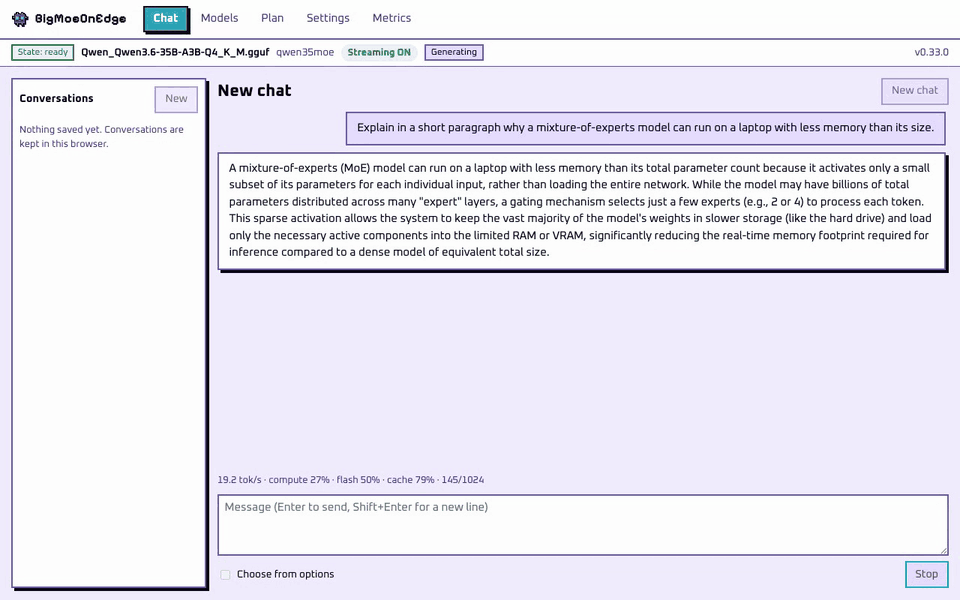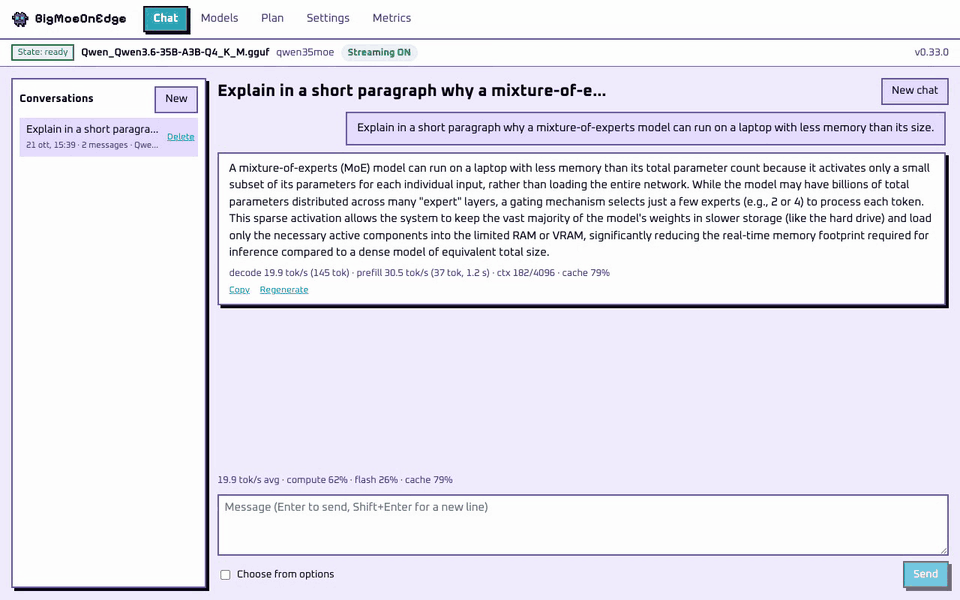
Qwen3.6-35B-A3B (21 GB) en temps réel sur chaque appareil. Le modèle est plus grand que la mémoire de chaque
appareil.
## Ce qu'il fait
- **Exécute des modèles qui ne tiennent pas en mémoire.** Un modèle MoE utilise quelques experts par token.
Le moteur garde en mémoire les poids dont chaque token a besoin et les experts les plus utilisés, et lit le
reste depuis la flash. La sortie est la même qu'avec le modèle entier en mémoire ; les tests le vérifient.
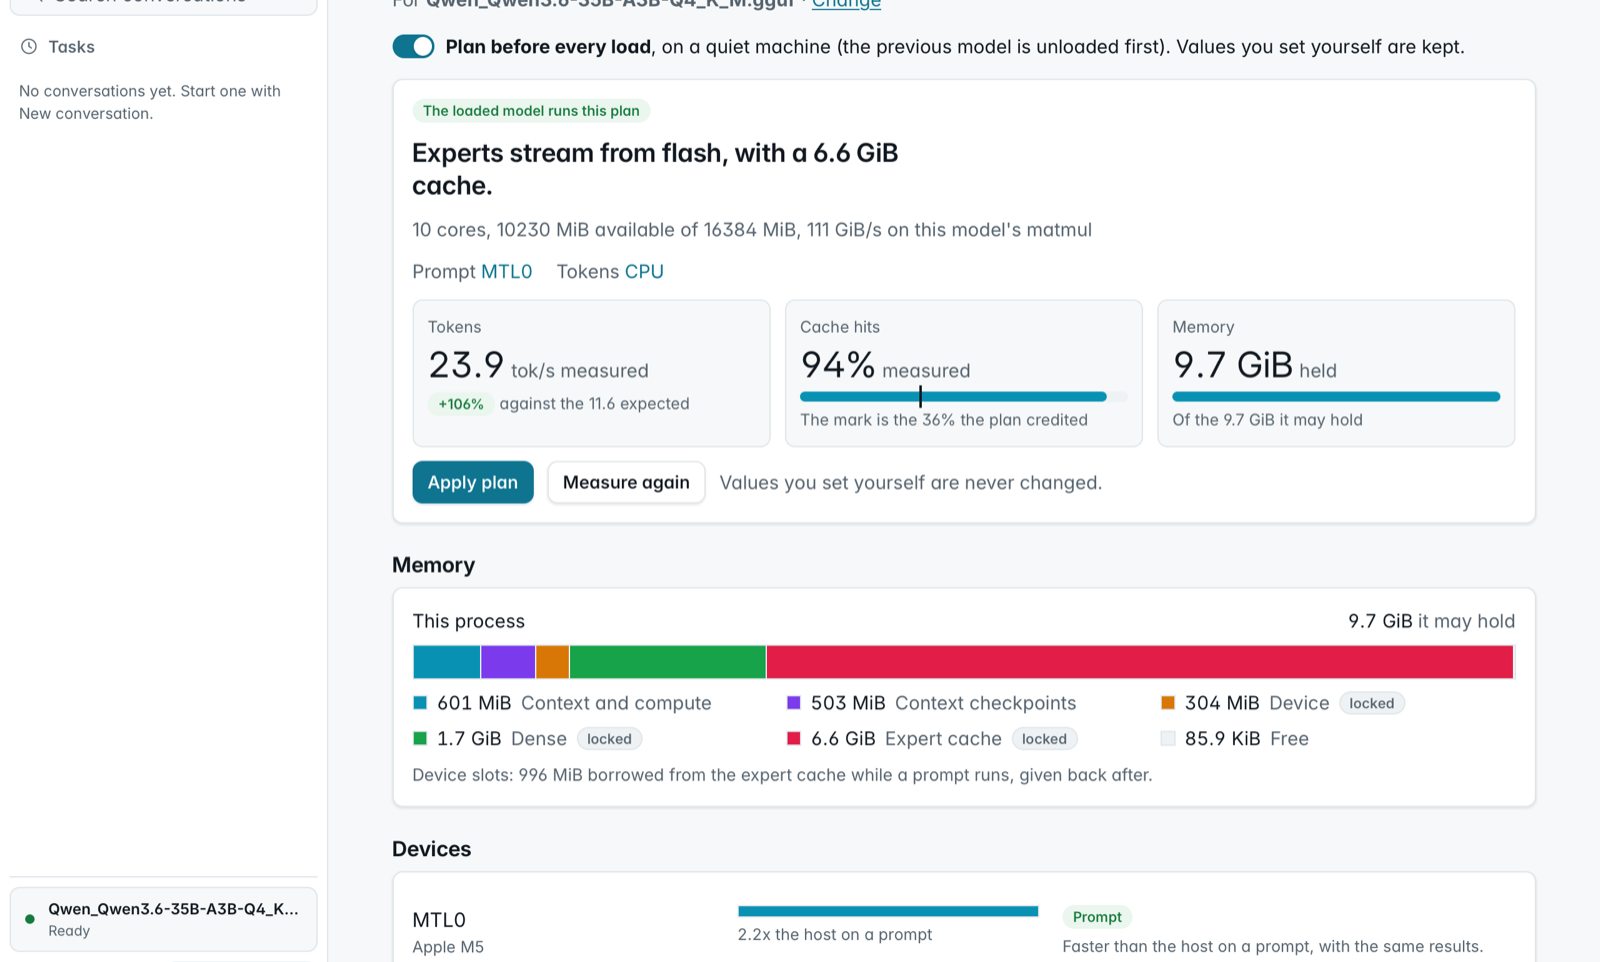
- **Se configure seul.** `--auto` mesure la machine et le modèle et choisit la taille du cache, les threads
et quel appareil fait quoi. L'écran Plan montre chaque choix et sa raison.
- **Tout GGUF MoE.** Tout ce que llama.cpp charge, dans n'importe quelle quantification. Aucun code par
modèle.
- **Tous les backends.** CPU, Metal, CUDA, HIP, Vulkan, OpenCL et le NPU Hexagon. Sur une carte graphique,
les experts les plus utilisés restent dans sa VRAM.
- **Applications et un serveur.** Une application de bureau, des applications pour téléphone et un serveur
compatible OpenAI et Anthropic pour les agents de code.
## Performances
| Matériel | Mémoire | Modèle | Sur disque | Experts depuis | Décodage tok/s |
|---|---|---|---:|---|---:|
| **Téléphone Android** | 12 GB | DeepSeek V4 Flash 284B | 91 GB | flash | 1 |
| | | Qwen3.8-Flash-Next 125B | 80 GB | flash | 2-4 |
| | | Qwen3.6-35B-A3B | 21 GB | flash | 5 |
| **iPhone** | 12 GB | Qwen3.6-35B-A3B | 21 GB | flash | 3 |
| **Portable Apple silicon** | 16 GB | Qwen3.8-Flash-Next 125B | 76 GB | flash | 7-9 |
| | | Qwen3.6-35B-A3B | 21 GB | flash | 18-24 |
| **Portable Windows** | 16 GB | Qwen3.6-35B-A3B | 21 GB | flash | 5 |
| **GPU de bureau** (NVIDIA) | 16 GB + 32 GB RAM | Qwen3.8-Flash-Next 125B | 66 GB | flash, cache GPU | 19-21 |
| **GPU de bureau** (NVIDIA) | 24 GB + 96 GB RAM | Qwen3.8-Flash-Next 125B | 66 GB | RAM, cache GPU | 70 |
| | | Qwen3.6-35B-A3B | 21 GB | GPU | 217 |
| **GPU de centre de données** (AMD, ROCm) | 192 GB | Qwen3.8-Flash-Next 125B | 66 GB | GPU | 53 |
Une plage est l'écart entre les exécutions. Méthode et toutes les exécutions :
[docs/benchmarks.md](docs/benchmarks.md). Pour ajouter votre machine, lancez
`scripts/bench-report.sh model.gguf` et ouvrez un
[rapport de benchmark](https://github.com/Helldez/BigMoeOnEdge/issues/new?template=benchmark-report.yml).
## Installation
Depuis la [dernière version](https://github.com/Helldez/BigMoeOnEdge/releases/latest) :
- **macOS** (Apple silicon) : ouvrez le `.dmg` et glissez l'application dans Applications. Elle n'est pas
encore notarisée ; le README.txt du dmg donne la seule étape du premier lancement.
- **Windows** : lancez le `-setup.exe`. Sans droits d'administrateur.
- **Linux** : rendez le `.AppImage` exécutable et lancez-le. La fenêtre a besoin de WebKitGTK 4.1 ;
`--server` lance le serveur seul.
- **Android** : installez `app-dev-release.apk`. Chaque version s'installe par-dessus la précédente.
- **iOS** : compilez l'application avec Xcode depuis [examples/ios](examples/ios/README.md). Expérimental.
Ouvrez l'application et choisissez un modèle sous **Models**. Une carte NVIDIA ou AMD reçoit son backend
depuis **Settings** ([docs/desktop-app.md](docs/desktop-app.md)).
Les outils en ligne de commande seuls (`bmoe-cli`, `bmoe-server`) :
```bash
curl -fsSL https://github.com/Helldez/BigMoeOnEdge/releases/latest/download/install.sh | sh
```
```powershell
irm https://github.com/Helldez/BigMoeOnEdge/releases/latest/download/install.ps1 | iex
```
## Utilisation
```bash
bmoe-cli -m model.gguf --auto -p "Explain MoE routing." # plan and run
bmoe-cli -m model.gguf --plan # print the plan
bmoe-server -m model.gguf -c 32768 # the server and its web UI, port 8765
```
Le serveur parle l'API OpenAI (`/v1/chat/completions`, `/v1/responses`) et celle d'Anthropic
(`/v1/messages`), avec streaming, appels d'outils et raisonnement. Ajoutez `--host 0.0.0.0 --api-key KEY`
pour servir d'autres machines. Référence : [docs/server-api.md](docs/server-api.md).
```python
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8765/v1", api_key="local")
reply = client.chat.completions.create(model="local", messages=[{"role": "user", "content": "Hello"}])
print(reply.choices[0].message.content)
```
**Les agents de code** ont besoin d'un grand contexte : quelques fois la taille de leur première requête.
32768 suffit pour opencode, 65536 pour Claude Code
([dimensionner le contexte](docs/server-api.md#sizing-the-context-for-a-client)).
```bash
# Claude Code
export ANTHROPIC_BASE_URL=http://127.0.0.1:8765
export ANTHROPIC_API_KEY=local
export ANTHROPIC_MODEL=
export ANTHROPIC_DEFAULT_HAIKU_MODEL=$ANTHROPIC_MODEL
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=65536
claude
```
```toml
# Codex CLI, ~/.codex/config.toml
model = ""
model_provider = "bmoe"
[model_providers.bmoe]
name = "bmoe"
base_url = "http://127.0.0.1:8765/v1"
wire_api = "responses"
env_key = "BMOE_API_KEY" # export BMOE_API_KEY=local
```
Pour opencode, ajoutez le serveur comme fournisseur compatible OpenAI à l'adresse `http://127.0.0.1:8765/v1`.
Sous **Connect apps**, l'application écrit les réglages pour Codex CLI et opencode et affiche ceux de
Claude Code.
**L'agent.** L'application de bureau a son propre agent : il travaille dans un dossier que vous choisissez,
lit et modifie des fichiers et lance des commandes, et demande avant de changer quoi que ce soit, sauf si
vous l'y autorisez. Une conversation peut aussi être menée par OpenCode, Claude Code, Codex ou Pi. Voir
[docs/agent.md](docs/agent.md).
## Fonctionnement
Pour chaque token, le routeur de chaque couche choisit quelques experts. Le moteur les cherche dans
jusqu'à trois niveaux, chacun un cache pour celui du dessous :
- **VRAM**, sur une carte graphique : les poids que lit chaque token et les experts les plus utilisés.
- **RAM** : un cache d'experts. Sans carte graphique, aussi les poids que lit chaque token.
- **Flash** (le disque) : le modèle entier.
Un expert absent de la VRAM est copié depuis la RAM ; un expert absent de la RAM est lu depuis la flash.
Sur un téléphone ou un Mac Apple silicon, le GPU utilise la même RAM que le CPU, il y a donc deux niveaux.
Un modèle qui tient dans la carte y tourne en entier. Le streaming ne fait que lire, il n'use donc pas le
disque.
Le moteur utilise l'API publique de llama.cpp, donc ses quantifications, tokenizers et modèles de chat
fonctionnent sans modification, et une mise à jour se résume à un bump du sous-module. Les tenseurs qui
sont des experts sont identifiés depuis le fichier ([docs/which-models-stream.md](docs/which-models-stream.md)).
Conception : [docs/architecture.md](docs/architecture.md).
## Le planificateur
Le planificateur lit l'en-tête du modèle et mesure la machine : mémoire, vitesse du stockage, chaque CPU,
GPU et NPU. Ses règles ne nomment aucun appareil ni aucune plateforme, donc un téléphone et un ordinateur de
bureau reçoivent des plans différents du même code. Les valeurs que vous fixez vous-même sont conservées.
Voir [docs/hardware-planning.md](docs/hardware-planning.md).
## Plateformes
| | Android | macOS | Windows | Linux | iOS |
|---|---|---|---|---|---|
| Moteur et CLI | arm64 | Apple silicon | x86_64, arm64 | x86_64, aarch64 | arm64 (dans l'application) |
| Application | application native | application de bureau | application de bureau | application de bureau | application native, compilée depuis les sources |
| Accélérateurs | Hexagon NPU, Vulkan, OpenCL | Metal | Vulkan, CUDA, OpenCL (arm64), Hexagon NPU (arm64) | Vulkan, CUDA, HIP | Metal |
| Testé sur | téléphone de 12 GB | portable de 16 GB | portable de 16 GB | cartes NVIDIA de 12-24 GB et AMD de 192 GB louées | iPhone de 12 GB |
Détails : [docs/platforms.md](docs/platforms.md).
## Comparaison
| | **BigMoeOnEdge** | Strata | ds4 | colibri | KTransformers |
|---|:---:|:---:|:---:|:---:|:---:|
| Téléphone Android (NPU aussi) | ✅ | ❌ | ❌ | ❌ | ❌ |
| iPhone | ✅ | ❌ | ❌ | ❌ | ❌ |
| Mac | ✅ | ✅ | ✅ | ✅ | ❌ |
| Windows / Linux, CPU seul | ✅ | ❌ | Linux, pour le débogage | ✅ | ❌ |
| NVIDIA | ✅ | ✅ | ✅ | ✅ | ✅ |
| AMD (ROCm) | ✅ (MI300X aussi) | Radeon RX et Strix Halo | Strix Halo et RDNA | Vulkan | ✅ |
| Tout modèle MoE en GGUF | ✅ | peu de modèles | peu de modèles | son propre format | peu de modèles |
| Se configure seul | ✅ `--auto` | choisit le modèle selon la mémoire | budget du cache d'experts | `coli tune` | ❌ |
Quand un modèle tient dans un GPU grand public plus la RAM, Strata est deux à quatre fois plus rapide. Quand
il est lu depuis la flash, tous les moteurs restent sous dix tokens par seconde et c'est le disque qui donne
le rythme. Vitesses et sources : [docs/comparison.md](docs/comparison.md).
## Compiler depuis les sources
```bash
git clone --recursive https://github.com/Helldez/BigMoeOnEdge.git
cd BigMoeOnEdge
cd ui && npm ci && npm run build && cd ..
scripts/build-host.sh
build/bin/bmoe-server --open
```
Tests : `cd build && ctest --output-on-failure` (nécessite `python3` avec `gguf`). Android :
`scripts/build-android.ps1`, puis l'APK dans [examples/android](examples/android). Plus :
[CONTRIBUTING.md](CONTRIBUTING.md).
## Documentation
[docs/](docs/README.md). Commencez par [hardware-planning.md](docs/hardware-planning.md),
[settings.md](docs/settings.md), [server-api.md](docs/server-api.md) et
[limitations.md](docs/limitations.md).
## Travaux antérieurs
AirLLM, *LLM in a flash* d'Apple, FlexGen, PowerInfer, EdgeMoE et
[flash-moe](https://github.com/danveloper/flash-moe), un moteur Metal qui lit en streaming un MoE de 397B
depuis un SSD sur Apple silicon.
## Licence
Apache-2.0 ([LICENSE](LICENSE)). Les binaires et les applications embarquent aussi llama.cpp, ggml et
d'autres bibliothèques sous MIT, BSD, Apache-2.0 et SIL OFL 1.1 : [THIRD_PARTY_LICENSES](THIRD_PARTY_LICENSES).