-windows-x86_64-cuda.zip` には `coli_cuda.dll`(compute capability 8.0 以上のカード)と、それを読み込む colibri、qwen36、kimi_k3 の各エンジン、DeepSeek V4 用の CUDA DLL が入っています。メインのアーカイブの上に展開すると、セットアップが CUDA を選びます。
- **すべてのレイヤーをカード上で**(Qwen3.6、Qwen3.8、OLMoE):密レイヤー、アテンション、カードが持つルーティングエキスパートを 1 本のチェーンとして実行し、カードにないエキスパートは CPU で実行します。RTX PRO 4000 では Qwen3.6-35B-A3B UD-Q4_K_M のデコードが 104.8 tok/s、プロンプト読み込みが 3,491、OLMoE は 354.6 と 10,418 です([表](#three-backends-on-one-machine))。
- **すべてのエンジンでカード上のエキスパートティア**(`cu_tier.h`)。DeepSeek V4、V4.1、Kimi K3、GLM-5.3、MiMo では密行列もカード上に置きます(`cu_dense.h`)。
- **GGUF のブロックをカード上で**(`cuda_bd.cuh`):32 重み以上のすべての ggml ブロック型を、ファイルの行のまま扱います。プロンプトはテンソルコアを通ります([gguf.md](docs/gguf.md))。
- **VRAM エキスパートティア** は、計測されたルーティングから選んだ最もホットなエキスパートをカード上に置きます。ミスしたエキスパートは同時に CPU で計算されます。8 GB のカード 2 枚(RTX 3070 と Quadro RTX 4000)での Qwen3.6 は、履歴が温まった状態で 11.3 tok/s でデコードしました([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md))。全エキスパートを常駐させた RTX 5090 6 枚での GLM-5.2 は 9.0-9.2 tok/s([benchmarks.md](docs/benchmarks.md))。RTX 5080 での DeepSeek V4 Flash は 1.5-1.6 tok/s で、3,324 トークンのプロンプトを 90 秒で処理しました([deepseek-v4.md](docs/deepseek-v4.md))。
- **Qwen3.6 の新機能:DeltaNet レイヤーをカード上で実行**(`Q36_DN_GPU=1`、オプトイン)。これまで Qwen3.6 の 30 個の DeltaNet レイヤーはそれぞれ、1 トークンごとに 4 回、カードと CPU の間でデータをコピーしていました。現在はデコード時の 1 トークンがレイヤー全体をカード上で実行し、そのリカレント状態は VRAM に保持されます。密レイヤーを VRAM に置いた RTX 3070 で:25.4 から 30.0 tok/s に向上しました([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md#the-deltanet-layer-on-the-card-q36_dn_gpu1))。
- **古いカード。** CUDA ツールキットがもうあなたのカード向けにコンパイルできない場合([#1852](https://github.com/JustVugg/colibri/issues/1852) の CUDA 13 と V100 の例)、セットアップはビルドの前にそれを見抜き、理由を示してカードを Vulkan 経由で使います。CUDA 12.x ツールキットがあれば CUDA の経路が戻ります。DeepSeek V4 の CUDA ティアは Pascal と Turing 向けにもビルドできます(`CUDA_ARCH=portable-pre-ampere NO_TC=1`)。
すべての詳細:[docs/cuda.md](docs/cuda.md)。
### Apple Silicon
いくつかのエンジンでは、Metal バックエンドがユニファイドメモリ GPU 上でエキスパートの演算を行います([docs/metal.md](docs/metal.md))。リリースの macOS アーカイブの `colibri`、`inkling`、`kimi_k3` は Metal 付きでビルドされています:`COLI_METAL=1`(Kimi K3 は `K3_METAL=1`)で有効になり、指定しなければ CPU で動きます。ソースからは `METAL=1` でビルドしてください。ワンステップのセットアップは CPU 向けにビルドします。
## System One:確率付きの判定
人がモデルに求めることの多くは、段落ではなく選択です:どのキューか、どの判定か、イエスかノーか。`POST /v1/systemone` は状態(テキストまたは JSON)と型付きの質問を受け取り、それぞれの質問に、許可された各選択肢の確率と確信度 (confidence) を付けて答えます。何も生成しないので、どの回答もリストの外に出ることはなく、「モデルに確信がない」ことが、閾値を設定できる数値になります。
```bash
curl -s http://127.0.0.1:8000/v1/systemone -H 'Content-Type: application/json' -d '{
"state": "340 lines, 8 files, no tests. CI is green but nothing covers that path.",
"questions": {
"review": {"type": "choice", "instructions": "What should the reviewer do?",
"criteria": {"merge": null, "request changes": null, "close": null}},
"risky": {"type": "noul", "instructions": "Is this change risky?"}}}'
```
`choice` は、選ばれたラベル、すべてのラベルの確率、そして 0(平坦)から 1(確実)までの `confidence` を返します。`noul` はイエスの確率を、`score` は期待されるレベルを返します。
答えるのは:
- **colibri が動かすすべてのチャットモデル**。スコアリングによって答えます:回答を書く代わりに、各選択肢の確率を読み取ります。1 つの文書についての複数の質問は、文書を 1 回だけ読みます:Qwen3.6 では、1 つの文書についての 4 つの質問が、同じ CPU マシンで同じ回答を生成する場合より 5.7 倍速く返ってきました。
- **3 つの判定モデル**。作者が調整した較正を使い、1 回のフォワードパスでネイティブに答えます:[Laya](docs/laya.md)(Convai Innovations)、[GLiNER2.5-Decide](docs/gliner_decide.md)(fastino)、[Clef](docs/clef.md)(Cloudflare。チャットも可能)。サイズと速度は[判定モデルの表](#which-model-for-my-machine)にあります。
**Jev からの切り替え。** リクエストとレスポンスは TypeSafe の Jev API と同じなので、Jev のクライアントは base URL を変えるだけで、ほかは何も変えずに colibri に切り替えられます:`TYPESAFE_BASE_URL=http://127.0.0.1:8000`(クライアントがすでに送っているキーは、`COLI_API_KEY` なしで起動したサーバーなら受け入れられます)。2 つの公式 SDK は、改変なしのまま `coli serve` に対してテストされています。
同じモードはターミナル(`coli chat` での `/decide merge | request changes | close`)と、ダッシュボードの System One ページにもあります。リクエストとレスポンスの全体、スコアリングのルール、そして役に立たない場面:[docs/systemone.md](docs/systemone.md)。
## ダッシュボード
`coli web` で開きます。ワンステップのセットアップでも開きます:チャット、System One ページ、Brain、Profiling ページがあり、ライトテーマとダークテーマに対応しています。
### 新しいチャット UI
`coli ui` は、実行中の `coli serve` の横で新しいチャットを開きます:推論は専用のブロックに、ビジョンタワーを持つモデルでは画像、Web 検索、エキスパートマップ、ライブモニター、そして colibri に向けて設定済みのコーディングエージェント。7 言語に対応。[ui/README.md](ui/README.md) を参照してください。
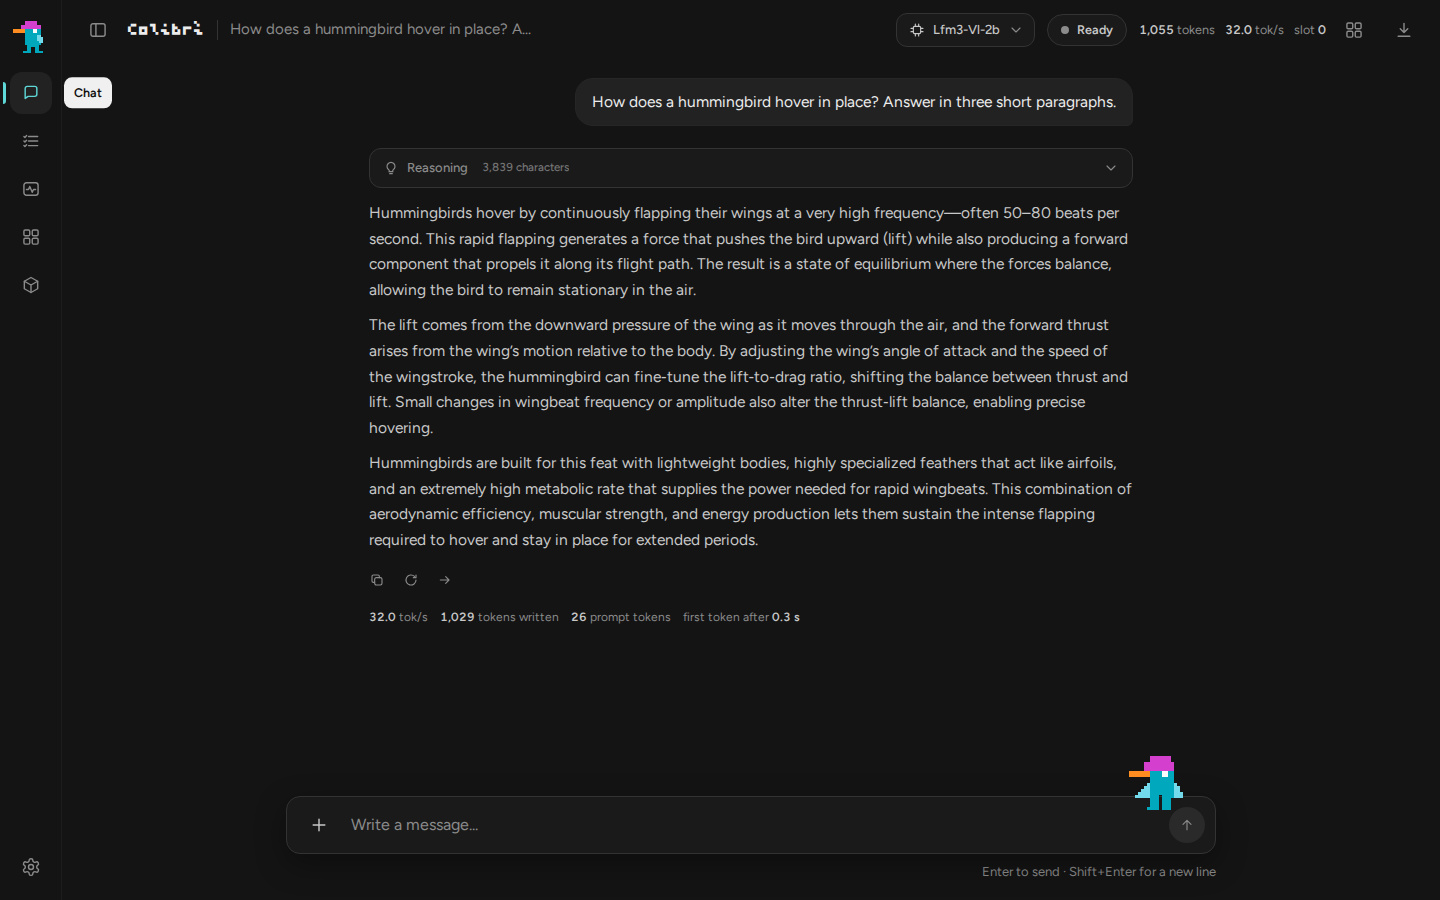
i5-13500 の CPU 上の LFM3-VL-2B、32 tok/s。
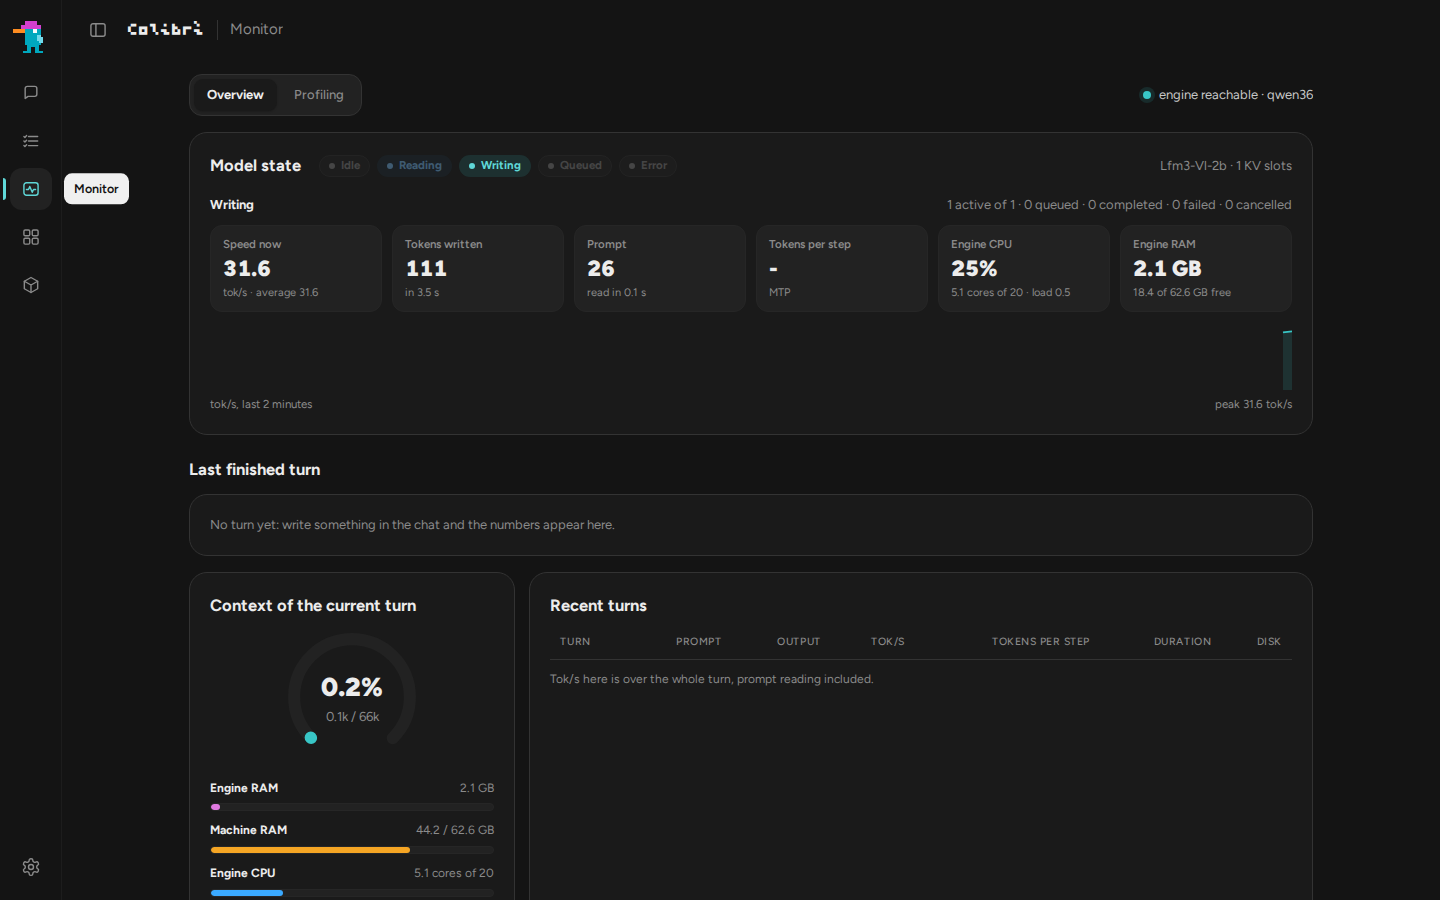
LFM3-VL-2B が書いている間のモニター:31.6 tok/s、プロンプトは 0.1 秒で読み取り、RAM 2.1 GB。
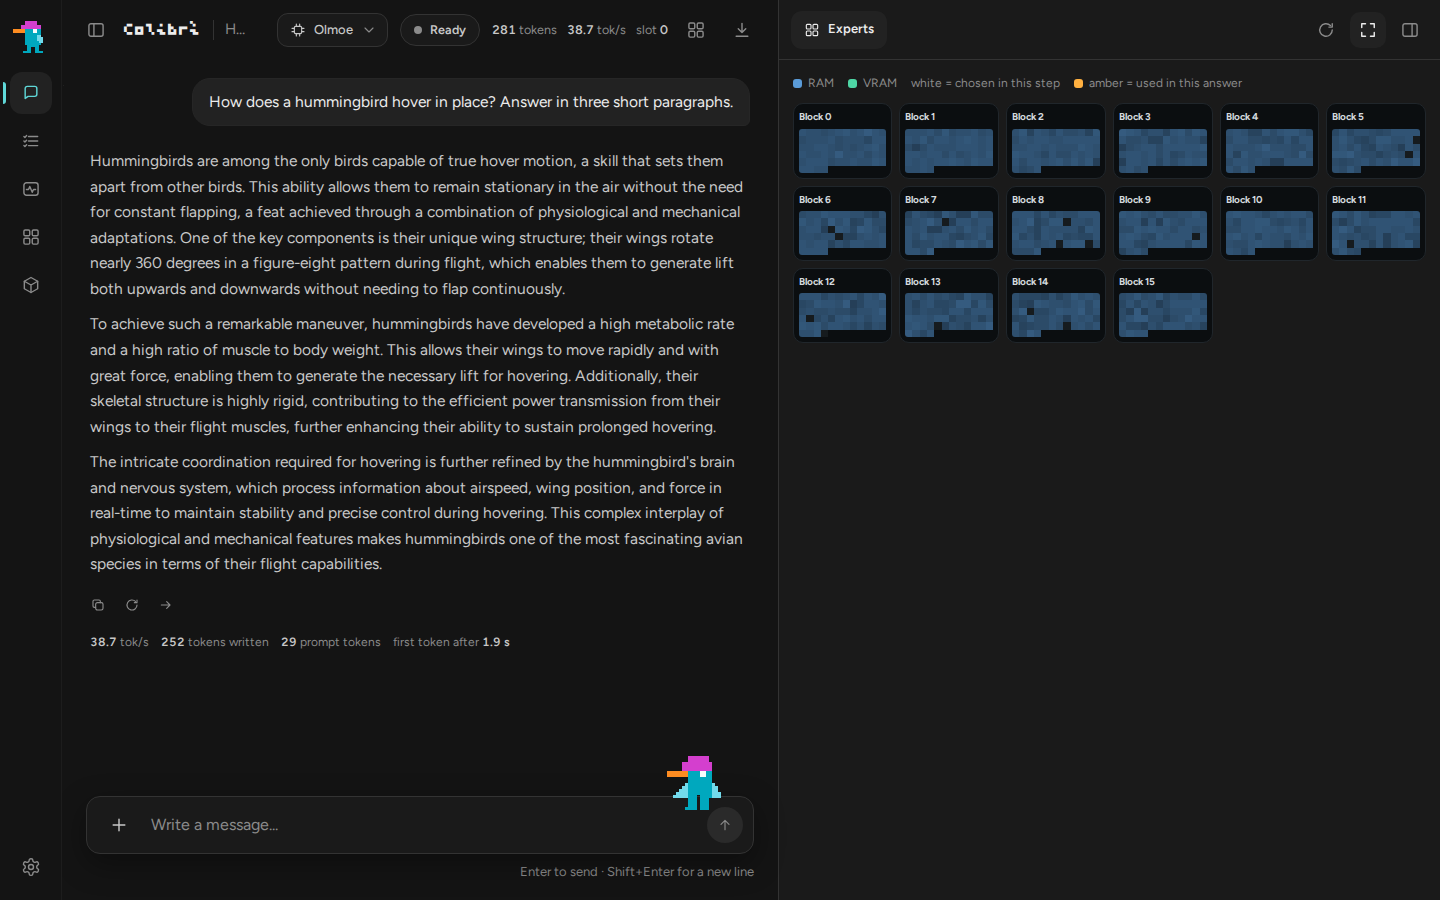
チャットの横にエキスパートマップを開いた OLMoE:ブロックごとにエキスパート 1 個につき 1 セル、このステップで選ばれたものは白、この回答で使われたものはアンバー。
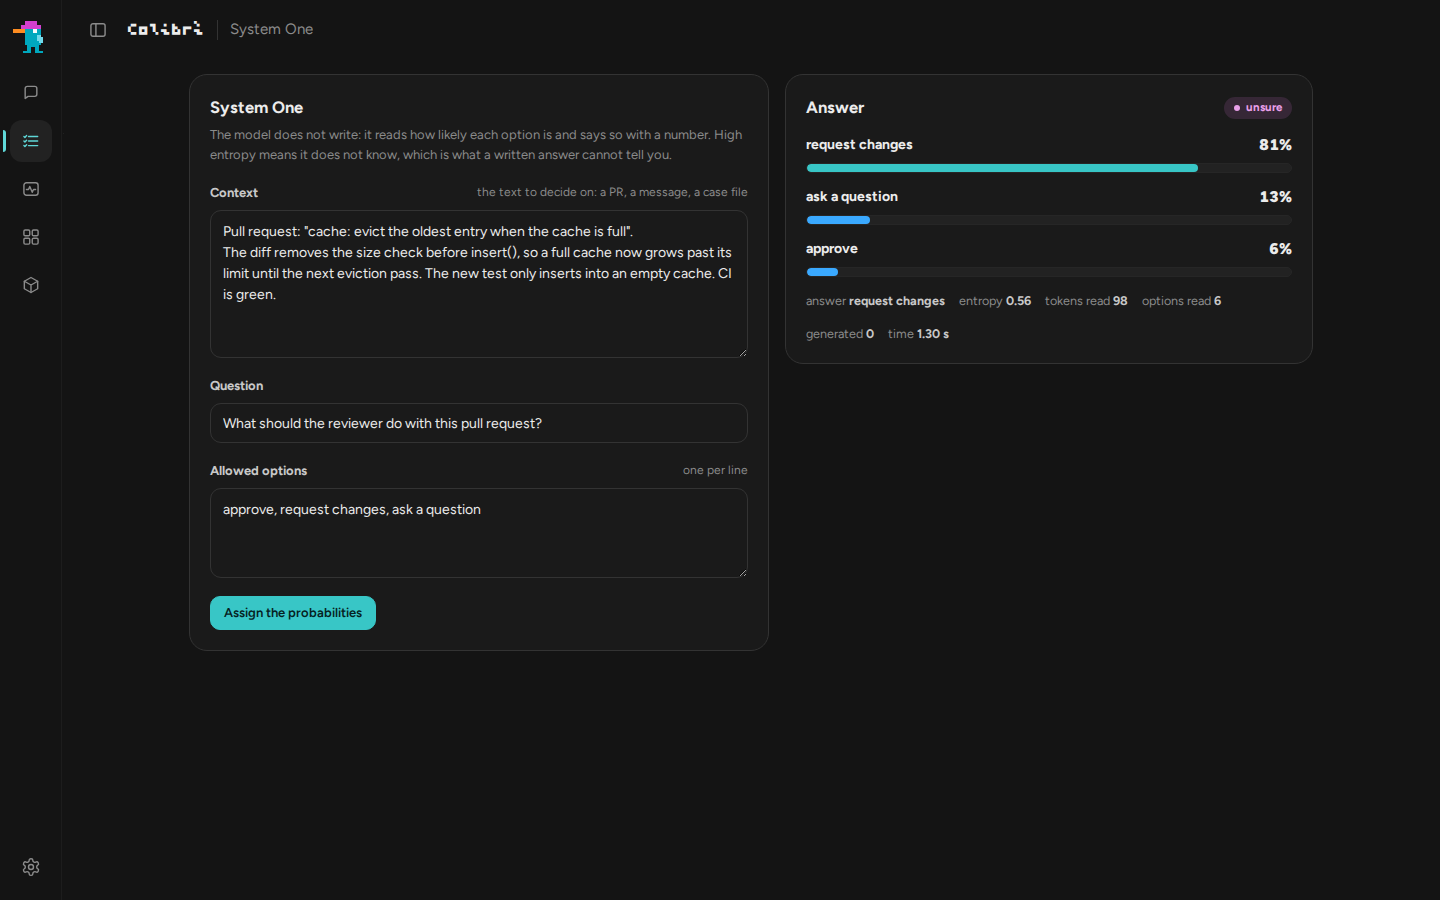
System One:モデルに文書と、選んでよい回答だけを渡します。ここでは RTX PRO 4000 上の Qwen3.6-35B が、キャッシュのサイズ上限を壊すプルリクエストを読みます:
request changes が 81%、エントロピー 0.56(不確か)、読み取り 98 トークン、生成 0 トークンです。
**Profiling** ページは、各ターンがどこで時間を使っているかをフェーズごとに示し、直近 30 ターンを推移として表示します。
## ほかのアプリから使う
`coli serve`(セットアップが起動してくれるもの)は、複数の API を備えた 1 つのサーバーです:
- **OpenAI 互換**:`/v1/chat/completions`、`/v1/completions`、`/v1/models`。ストリーミング、JSON での応答、停止シーケンス、logprobs に対応しています。
- **Anthropic 互換**:`/v1/messages`。Claude Code や Anthropic の SDK をそのまま接続できます。
- **ツール呼び出し**:Inkling と OLMoE を除くすべてのチャットエンジンで、それぞれのモデルのネイティブ形式で行います([エンジンごとの表](docs/api.md#tool-calling-support))。
- **画像入力**:GLM-5.3-Flash、DeepSeek V4.1 Flash、MiMo-V2.6、Qwen3.8-Flash-Next、Qwen3.8-27B、LFM3-VL、Mistral-Large-4(GGUF の場合は隣に `mmproj` ファイルを置く)で使えます。`coli chat` のメッセージ内のパス、`coli web` や `coli ui` での添付、または `image_url` パートで渡します。
- **画像出力**:Qwen-Image-2.1 で `POST /v1/images/generations` から生成します。`coli chat` ではターミナル内に描画されます([qwen-image.md](docs/qwen-image.md))。
- **判定**:`POST /v1/systemone` で行います([前述](#system-one-a-decision-with-a-probability))。
- **複数の会話を同時に**:すべてのテキストエンジンで、`coli serve --kv-slots N` が最大 16 の会話をそれぞれのキャッシュとともに保持し、次のトークンをまとめてデコードします([api.md](docs/api.md#isolated-kv-contexts))。
コーディング用の CLI やエディタは、ほかの OpenAI 互換プロバイダーと同じように接続できます:base URL は `http://127.0.0.1:8000/v1`、モデル ID は `coli status` が表示するもの、キーは空でなければ何でもかまいません([docs/api.md](docs/api.md#connect-a-coding-cli-or-editor))。
## 仕組み
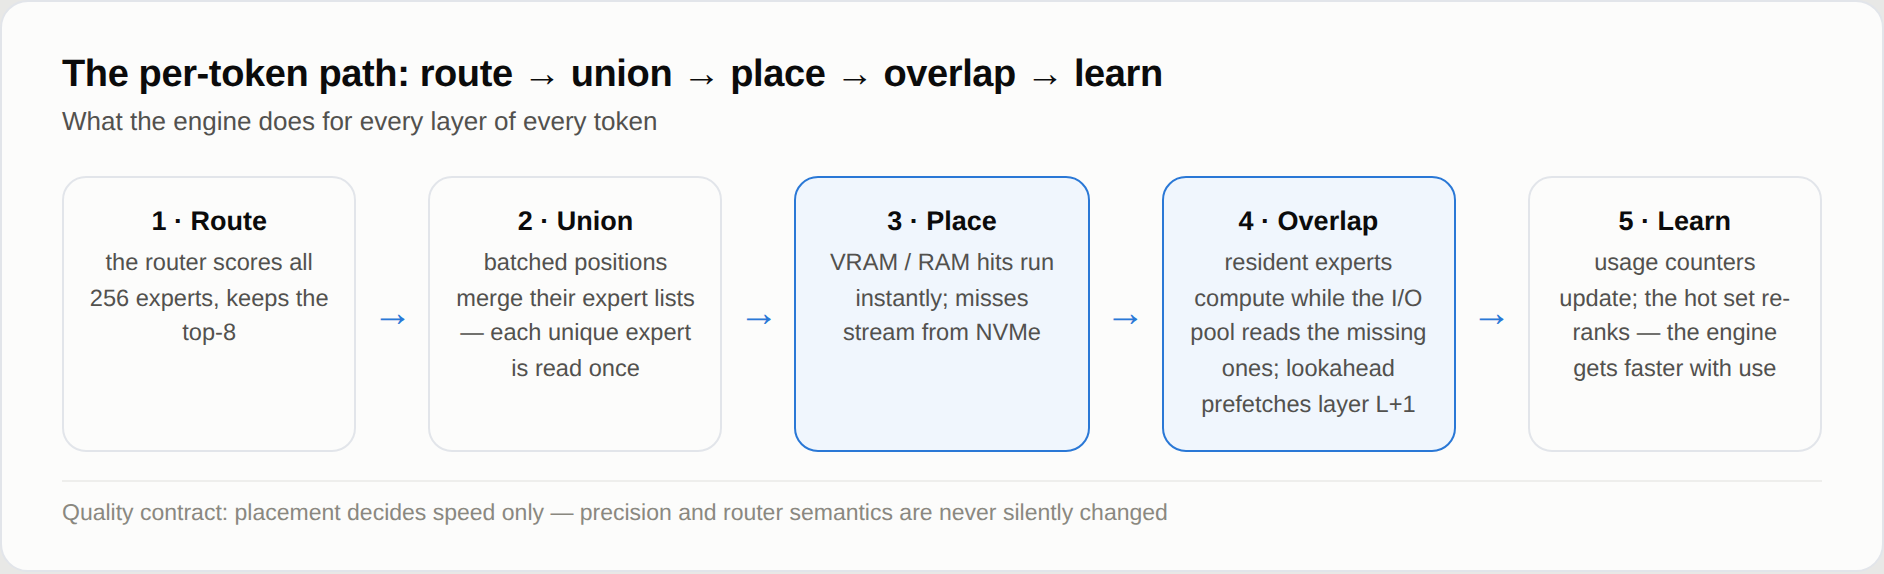
すべてのトークンのすべてのレイヤーが、同じ 5 つのステップをたどります:ルーティング、和集合、配置、オーバーラップ、学習。設計上の目標は、**配置が決めるのは常に速度だけ** ということです:エキスパートが VRAM から答えても、RAM から答えても、ディスクから答えても、ルーターの判断と重みの精度は同じです。
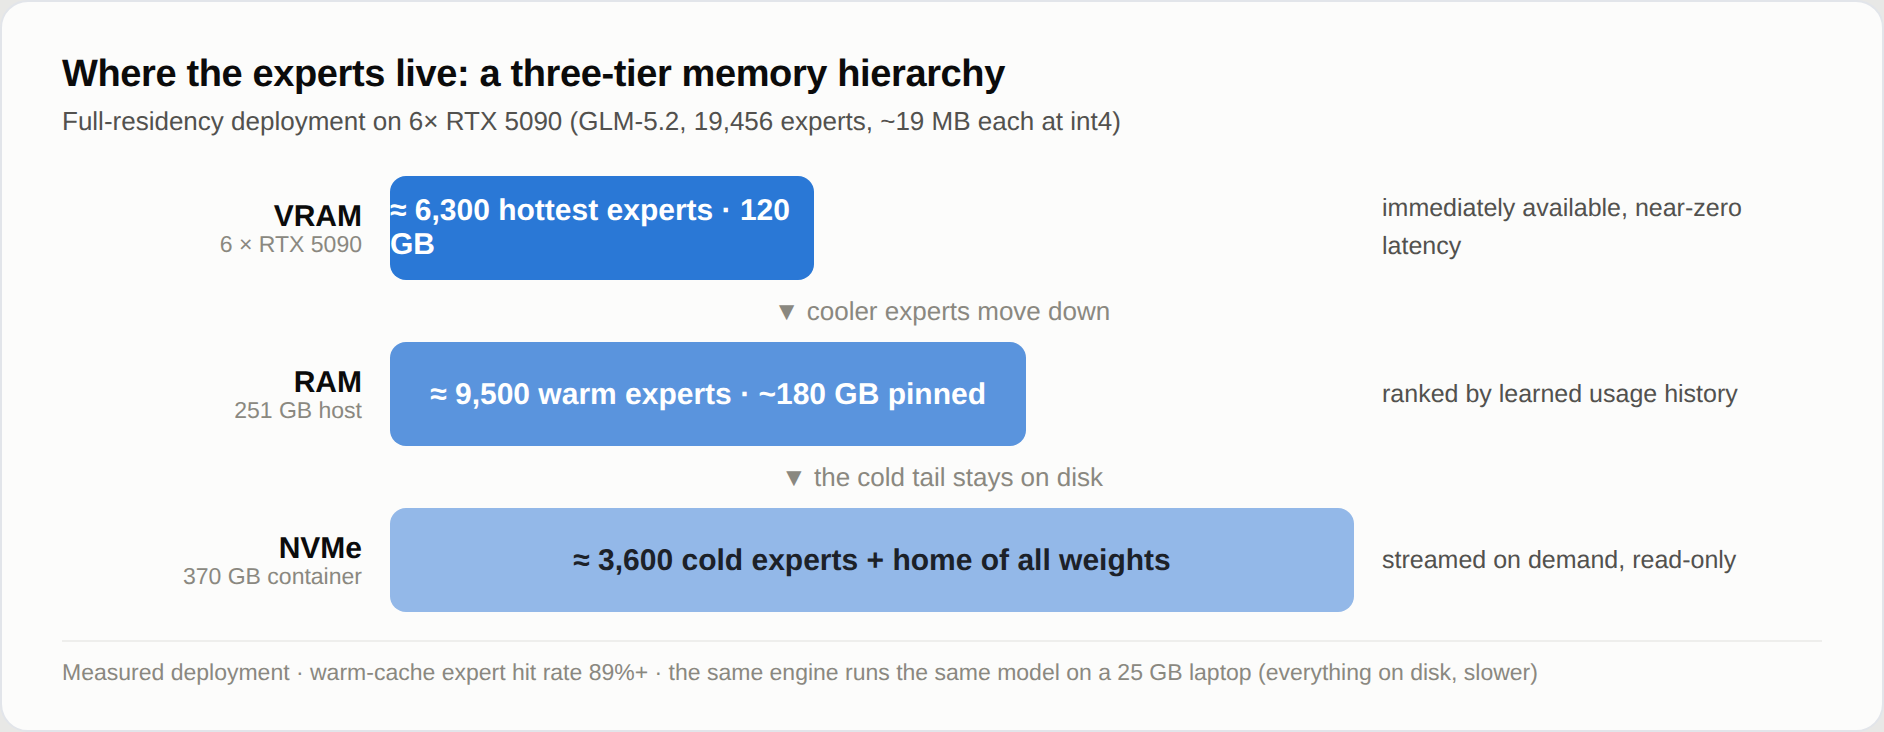
- **重みのための JIT。** コンパイラの JIT はプログラム全体をコンパイルすることはなく、実際に実行される部分を観察して、ホットパスをコンパイルします。colibri は重みについて同じ賭けをします。計測されたルーティングの熱量が、どのエキスパートに VRAM、RAM、ディスクのどれを割り当てるかを決めます:レイヤーごとの LRU キャッシュに加えて、あなた自身の会話から学習したピン留めのホットセット(`.coli_usage`、ターンごとに更新)があります。colibri は使えば使うほど速くなります。これが機能するのは、ルーティングに計測可能な構造があるからです([エキスパートアトラス](https://github.com/JustVugg/colibri/issues/175))。
- **ディスクを二度待たない。** エキスパートの 3 つの行列は 1 回の `pread` で読み込まれます。ローダーのプールが、常駐エキスパートが計算している間に、欠けているエキスパートを読み込みます。複数の位置をまとめたバッチでは、各エキスパートを 1 回だけ読みます。ルーター先読みスレッドが次のレイヤーをプリフェッチできます(GLM-5.2 のルーティングは 1 レイヤー先を 71.6% 予測できます)。`DIRECT=1`(O_DIRECT)は高速な NVMe ドライブでは大きな改善になることが多い一方、ほかのドライブでは効果がないか逆効果になります:自分のドライブで計測してください([tuning.md](docs/tuning.md))。
- **複数の SSD。** `COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat --model /fast/glm52_i4` は、2 台目のドライブにあるコピーから読み込みます。独立したコントローラに接続された NVMe ドライブ 2 台で、デコード +37.5% を計測しました。より小さなドライブ上の部分ミラーでも動作します([multidisk.md](docs/multidisk.md))。
- **ラップトップからラックまで。** 25 GB のラップトップでは、すべてのエキスパートがディスクからストリーミングされ、遅いながらも正しく動きます。大きなホストではすべてのエキスパートが常駐し(`CUDA_EXPERT_GB=auto PIN_GB=all`)、ディスクはデコードから外れます。`COLI_NUMA=1` はマルチソケットのホストで、常駐する重みを複数のメモリコントローラに分散させます。ローカルクラスタモードは、ルーティングされるエキスパートをほかのマシンで実行します([cluster.md](docs/cluster.md))。
- **忠実なモデル。** すべてのエンジンは、CI で小さなフィクスチャを使い、そのモデルのリファレンス実装と照合されています。GLM-5.2 の MLA アテンションは圧縮された KV 状態(1 トークンあたり 32,768 個ではなく 576 個の浮動小数点数で、57 分の 1)を保持し、それは再起動をまたいで残るため、会話はプロンプトを読み直すことなく再開できます。
- **元が取れるときだけの投機的デコード。** GLM-5.2 の int8 MTP ヘッドは、効果がある場合、フォワードあたり 2.2-2.8 トークンをドラフトします。Qwen3.8-Flash-Next の MTP ヘッドはデフォルトで有効で、同じ出力のまま速度を 16-20% 上げます。プロンプトルックアップはコード編集で 6-7% 上げます。Qwen3.6 のヘッド(`Q36_MTP=1`)は、デコードを CUDA で 99.7-104.5 から 115.8-120.1 tok/s に、Vulkan で 83.2-83.8 から 99.9-109.3 に上げます(RTX PRO 4000)。DeepSeek V4.1 の DSpark ヘッドは確信度が示す深さまでドラフトし、割に合わないドラフトはゲートが飛ばします。ドラフトのコストが節約を上回る場合(DeepSeek V4)はオフのままです([speculative.md](docs/speculative.md)、[tuning.md](docs/tuning.md#speculation-and-reproducibility))。
エンジンは、共有ヘッダの上に、モデルファミリーごとに C ファイルを 1 つ置いた構成です(GLM-5.2 なら `c/colibri.c`)。BLAS は使わず、実行時に Python も使いません:Python が動かすのは、セットアップ、ランチャー、変換ツール、API ゲートウェイだけです。
## ベンチマーク
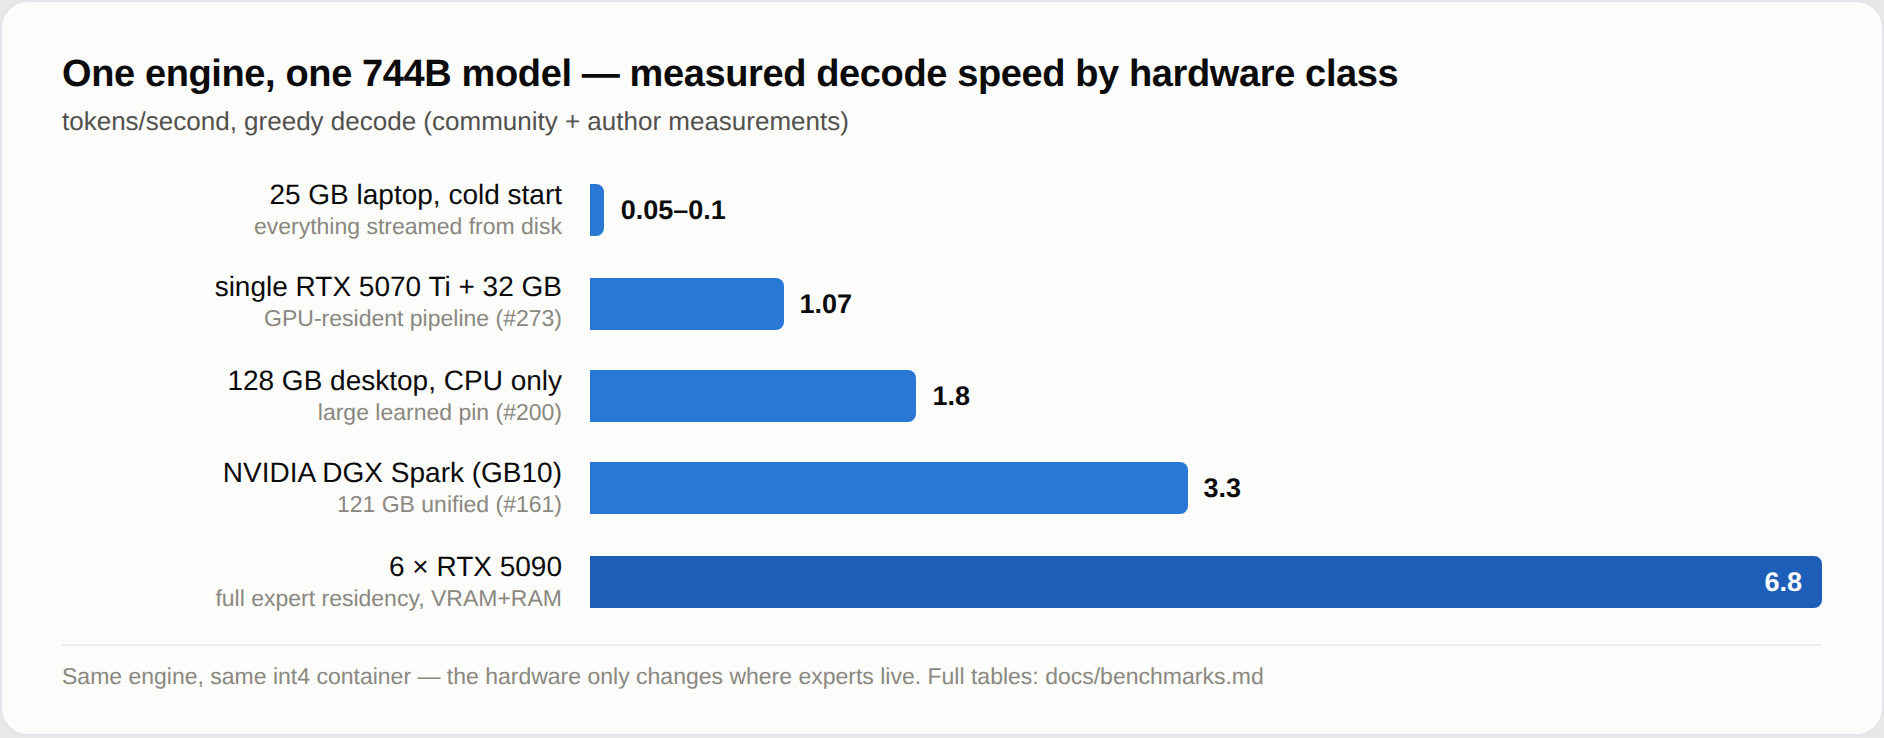
同じエンジン、同じ int4 コンテナです:ハードウェアが変えるのはエキスパートの置き場所だけです。GLM-5.2 のデコード速度を[完全な表](docs/benchmarks.md)から抜粋します:
- **6x RTX 5090、全エキスパート常駐:** 5.8-6.8 tok/s、選択的な NUMA インターリーブで 9.0-9.2([実験ログ](docs/experiments/glm52-6x5090-2026-07-12.md))。
- **128 GB、CPU のみ**(Ryzen AI Max+ 395):ウォーム時 1.83 tok/s([#200](https://github.com/JustVugg/colibri/issues/200))。
- **RTX 5070 Ti 1 枚のラップトップ級マシン:** 1.07 tok/s([#273](https://github.com/JustVugg/colibri/issues/273))。
- **このプロジェクトが始まった 25 GB のラップトップ:** コールド時 0.05-0.1 tok/s。偽りのない下限です。
### 1 台のマシンで 3 つのバックエンド
RAM 62 GB の i5-13500 と RTX PRO 4000 Blackwell SFF(24 GB、70 W)。各モデルを `coli serve` で提供し、新しい 450 トークンのプロンプトのあと 128 トークンの回答をストリーミングします。リクエストの HTTP を含み、2 回のうち良い方、tok/s。
| GGUF | CUDA プロンプト | CUDA デコード | Vulkan プロンプト | Vulkan デコード | CPU プロンプト | CPU デコード |
|---|---:|---:|---:|---:|---:|---:|
| Qwen3.6-35B-A3B UD-Q4_K_M | 3,491 | 104.8 | 2,076 | 92.9 | 122.6 | 13.9 |
| LFM3-VL-2B Q4_K_M | 12,317 | 235.1 | 8,174 | 214.1 | 286.5 | 34.5 |
| OLMoE-1B-7B-0125-Instruct Q4_K_M | 10,418 | 354.6 | 6,867 | 299.4 | 279.9 | 47.4 |
| LFM3-VL-2B F16 | 11,524 | 103.4 | 7,767 | 99.3 | 49.7 | 6.4 |
| Qwen3.8-Flash-Next IQ2_XS(68 GB:カードに載らないエキスパートは RAM に置く) | 217.1 | 51.4 | 214.3 | 50.6 | 38.3 | 9.3 |
### 同じマシンでの大きなモデル
再びマシン D で、各モデルを公開済みの GGUF から `coli serve` で動かしました。カードにも RAM にも載らない分は 2 台の NVMe から読みます。tok/s、各モデルのページより:
| GGUF | サイズ | バックエンド | プロンプト | デコード |
|---|---:|---|---:|---:|
| Inkling-Small UD-IQ2_XXS | 77 GB | Vulkan | 15.1-33.1 | 10.92-11.53 ([vulkan.md](docs/vulkan.md)) |
| MiMo-V2.6-Flash Q2_K_S | 106 GB | Vulkan | 8.2 | 7.8 ([gguf.md](docs/gguf.md)) |
| DeepSeek V4 Flash 0731 UD-IQ2_XXS | 85 GB | Vulkan | 19.7-20.4 | 6.18-6.25 ([vulkan.md](docs/vulkan.md)) |
| DeepSeek V4.1 Flash UD-IQ1_S | | Vulkan | 3,403 トークンで 31.8 | 5.01-5.29 ([deepseek-v41.md](docs/deepseek-v41.md)) |
| GLM-5.3-Flash UD-IQ2_XXS | 95 GB | Vulkan | 9.3 | 2.92-3.40 ([vulkan.md](docs/vulkan.md)) |
| Muse Spark Open UD-IQ1_S | 176 GB | Vulkan | 5.0-5.3 | 1.55-1.58 ([qwen36.md](docs/qwen36.md#muse-spark-open)) |
| Mistral-Large-4 UD-IQ1_S | 233 GB | CUDA | 240 トークンを 66-82 s | 1.34-1.36 ([mistral-large4.md](docs/mistral-large4.md)) |
| GLM-5.2 UD-IQ1_S | 202 GB | Vulkan | | 0.633-0.658 ([gguf.md](docs/gguf.md)) |
| Kimi K3 UD-IQ1_S | 594 GB | Vulkan | 31 トークンを 46.5 s | 0.349 ([gguf.md](docs/gguf.md)) |
### 長いコンテキストとエージェント
- **256k のコンテキストを 64k の速度で。** マシン D の CUDA チェーンで Qwen3.8-Flash-Next IQ2_XS、コンテキスト 262,144 トークン:プロンプト 15.6 -> 149 tok/s、デコード 9.6 -> 45.7(RAM の計画をプロンプト 1 セグメント分に、K/V はカード上で float16。65,536 では読み込み 188、デコード 48.4)([qwen38.md](docs/qwen38.md))。
- **エージェントのターンは新しい部分だけを読む。** 2 つのターンの間の短いリクエスト(会話のタイトルを尋ねるエージェント)は、会話の状態を奪わずに会話を退避させます。すべてのエンジンで有効です(`COLI_PARK`)。Qwen3.8-Flash-Next での Hermes Agent の 2 ターン目、14,810 トークン:86 s -> 4.9 s([qwen38.md](docs/qwen38.md#an-agents-turns))。
- **float16 の KV キャッシュ**:GLM-5.3 は 131,072 トークンで 23.9 GB ではなく 11.9 GB([CHANGELOG](CHANGELOG.md))。
品質は仮定ではなく計測されています:int4 コンテナのコストと量子化のアブレーションは [benchmarks.md](docs/benchmarks.md#quality-benchmark) にあります。あなたのマシンを追加するには、[ベンチマークプロトコル](docs/benchmarking.md)に従い、数値を添えて issue を作成してください。
## 手動でのインストール
**1. プログラム。** [Releases](https://github.com/JustVugg/colibri/releases) から自分のプラットフォーム用のアーカイブ(Linux x86_64、macOS、Windows。コンパイラは不要で、必要なのはランチャーと API のための [Python 3](https://www.python.org/downloads/) だけ)を取得して展開し、`python3 coli info` を実行します。Linux と Windows のエンジンには Vulkan が組み込まれ(`shaders/` が隣にあります)、macOS のエンジンには Metal が組み込まれています。Windows で NVIDIA のカードを使うなら、CUDA のアーカイブも追加してください。または、`gcc`(または clang)と OpenMP を使ってソースからビルドします:
```bash
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh # checks gcc/OpenMP, builds, self-tests
make qwen36 VK=1 # one engine, here with Vulkan (CUDA=1 for CUDA)
```
**2. モデル。** [上の表](#which-model-for-my-machine)にあるどのダウンロードでもかまいません:セットアップの ID は Hugging Face のリポジトリに対応しており、各モデルのページにダウンロードと変換のコマンドがあります。GLM-5.2 には、int8 MTP ヘッド付きのグループスケール(gs64)コンテナ [`mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp`](https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp)(429 GB)を、GLM-5.3 には [`Justvugg/GLM-5.3-colibri-int4-g64`](https://huggingface.co/Justvugg/GLM-5.3-colibri-int4-g64)(419 GB、MTP ヘッドなし)を使ってください。古い行単位 int4 のミラーは使わないでください:品質が約 9 ポイント劣ることが計測されており、[#455](https://github.com/JustVugg/colibri/issues/455) のループする回答の原因でした。`./coli convert --model /nvme/glm52_i4` は、FP8 リリースから同じコンテナをシャードごとに作成するので、756 GB 全体を一度にディスクに置く必要はありません。MTP ヘッドなどの確認方法:[quickstart.md](docs/quickstart.md#3-get-the-model)。手元にある GGUF は変換不要です:最初のファイルに `./coli import`([上記](#from-a-gguf))。
**3. 実行する。** ソースのチェックアウトなら `c/` から、リリースなら展開したフォルダーから実行します。ランチャーはモデルの `config.json` を読んでエンジンとそのチャットテンプレートを選ぶので、コマンドはどのモデルでも同じです:
```bash
./coli chat --model /nvme/qwen36 # chat in the terminal
./coli web --model /nvme/qwen36 # API + dashboard, opens a browser
./coli serve --model /nvme/qwen36 # API + dashboard, no browser
./coli plan --model /nvme/qwen36 # where the model will live: VRAM, RAM, disk
./coli doctor --model /nvme/qwen36 # read-only check: is everything ready?
./coli tune --model /nvme/qwen36 # measure and save this machine's fastest safe settings
./coli import /nvme/Flint-UD-Q4_K_XL.gguf # a GGUF: writes Flint-UD-Q4_K_XL.colibri next to it
./coli ui # the chat UI, next to a running coli serve
```
Windows では、リリースアーカイブに `coli.cmd` が同梱されています(`coli.cmd chat --model D:\qwen36`)。ソースのチェックアウトからは `py -3 c\coli` を使ってください。`.exe` ファイルはエンジンであり、ランチャーではありません。すべてのオプションと環境変数:[SETTINGS.md](docs/SETTINGS.md)、[ENVIRONMENT.md](docs/ENVIRONMENT.md)。
## 研究、そして協力の方法
colibri は、フロンティアモデルが希少なハードウェアに頼る度合いを減らし、より安く動かせるようにしたいと考えています。そのためには、重みの格納方法と移動方法を変え、何を VRAM、RAM、ストレージに置くかを決め、CPU と GPU の処理をオーバーラップさせ、新しいデコード方法を試すことになります。慣習的だからという理由で残されるものはなく、マイクロベンチマークで速く見えるという理由で採用されるものもありません:決め手となるのは実機でのエンドツーエンドの推論であり、速度と並んで品質も計測されます。未解決の問いは次のとおりです:
| 仮説 | これまでのエビデンス | まだ必要な実験 |
|---|---|---|
| ルーティング履歴は単純な LRU よりもうまくエキスパートを配置できる | 学習されたピンは繰り返しのワークロードを改善するが、プロンプトに過学習し得る | コーディング、チャット、多言語、長コンテキストのワークロードにわたる、ホールドアウトかつセッション横断の A/B |
| 複数の SSD は独立した帯域幅をデコード速度に変えられる | 独立した NVMe ドライブ 2 台でデコード +37.5% を計測。より遅い 3 台目のドライブは、重み付きストライピングの後では効果が中立だった([計測結果](docs/multidisk.md#what-has-been-measured)) | ドライブ速度、コントローラ構成、キャッシュ状態を変えて再現する |
| ハードウェアを考慮したプランナーは、各マシンの最適構成に自動で近づける | RAM/VRAM の予算といくつかのバックエンドは現在すでに検出され、セットアップがビルドを選ぶ | 生成されたプランを、ラップトップ、ワークステーション、NUMA ホスト、マルチ GPU システムにわたる制御されたパラメータスイープと比較する |
| ロスレスまたは品質上限付きの表現で、重みの移動を意味のあるほど減らせる | 正しさ/品質ゲート付きのフォーマットと量子化のアブレーションが存在する | 圧縮率だけでなく、品質、移動バイト数、レイテンシ、有用トークンあたりのコストを同時に再現する |
| ルーティングを考慮した投機的デコードは、ほぼ完全常駐に達する前でも元が取れる | MTP と文法ドラフトは動作するが、MTP はエキスパートヒット率約 85% 付近で 32% の損失も計測されている | 受理率、エキスパートヒット率、バッチの和集合、ドラフト深さにわたる損益分岐面をマッピングする |
| CPU/GPU のオーバーラップは、ボトルネックを移すだけでなく転送と同期を隠蔽できる | CUDA、Metal、Vulkan での改善はあるが、高速な CPU、内蔵 GPU、低い常駐率ではそれが打ち消され得る | PCIe、ユニファイドメモリ、完全常駐のマシンにわたる、ステージごとのプロファイルと 1 変数ずつの A/B、そして計測済みの 1 枚(RTX PRO 4000)以外のディスクリート GPU での Vulkan のティアとチェーンの数値 |
協力したいですか?いずれかの行を選び、ネガティブな結果も公開してください。ハードウェア、コミット、モデル、正確なコマンド、プロンプト、キャッシュ状態、スループット、最初のトークンまでの時間、エキスパートヒット率、読み込みバイト数、品質チェックを記録し、1 つの変数だけを変えて繰り返し、生のログを添付してください。まずは [CONTRIBUTING.md](CONTRIBUTING.md) と[ベンチマークプロトコル](docs/benchmarking.md)から始め、それから [issue を作成](https://github.com/JustVugg/colibri/issues/new)してください。ここでは、説明のつかない速い数値よりも、よく制御された失敗のほうが価値があります。
## ドキュメント
| トピック | ドキュメント |
|---|---|
| ワンステップのセットアップと手動インストール、全プラットフォーム | [quickstart.md](docs/quickstart.md) |
| AI アシスタントによるセットアップと MCP サーバー | [AI_SETUP.md](docs/AI_SETUP.md)、[MCP_SERVER.md](docs/MCP_SERVER.md) |
| API:OpenAI、Anthropic、ツール、KV スロット、ダッシュボード | [api.md](docs/api.md) |
| System One と判定モデル | [systemone.md](docs/systemone.md)、[laya.md](docs/laya.md)、[gliner_decide.md](docs/gliner_decide.md)、[clef.md](docs/clef.md) |
| GGUF ファイル:アーキテクチャ、2 つのモード、各エンジンがブロックをどう扱うか | [gguf.md](docs/gguf.md) |
| Qwen3.6 エンジン上のモデル(Flint、Muse Spark Open、LFM3-VL)と Mistral-Large-4 | [qwen36.md](docs/qwen36.md)、[mistral-large4.md](docs/mistral-large4.md) |
| チャット UI(`coli ui`) | [ui/README.md](ui/README.md) |
| Vulkan:エキスパートティア、密チェーン、Resizable BAR のないカード | [vulkan.md](docs/vulkan.md) |
| CUDA と、Qwen3.6 の CUDA ティア | [cuda.md](docs/cuda.md)、[qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md) |
| Apple Silicon、Windows | [metal.md](docs/metal.md)、[windows.md](docs/windows.md) |
| チューニング、学習キャッシュ、プリフェッチ、投機的デコード | [tuning.md](docs/tuning.md) |
| 投機的デコード:MTP ヘッド、プロンプトルックアップ、ゲート | [speculative.md](docs/speculative.md) |
| 複数の SSD、複数のマシン | [multidisk.md](docs/multidisk.md)、[cluster.md](docs/cluster.md) |
| ベンチマークと計測方法 | [benchmarks.md](docs/benchmarks.md)、[benchmarking.md](docs/benchmarking.md) |
| すべてのオプションと環境変数 | [SETTINGS.md](docs/SETTINGS.md)、[ENVIRONMENT.md](docs/ENVIRONMENT.md) |
| 文法強制ドラフトと、実験的な組み込み用 ABI | [grammar-draft.md](docs/grammar-draft.md)、[segment-runtime.md](docs/segment-runtime.md)、[edge-runtime.md](docs/edge-runtime.md) |
## リポジトリ構成
```
start-here.sh, START-HERE.bat the one-step setup (Linux and macOS, Windows)
Makefile root build/check entry point
c/
├── colibri.c GLM-5.2/5.3, Mistral-Large-4 (make glm)
├── glm53.c GLM-5.3-Flash (make glm53)
├── inkling.c Inkling (make inkling)
├── kimi_k3.c Kimi K3 (make kimi_k3)
├── deepseek_v4.c DeepSeek V4 Flash (make deepseek-v4)
├── deepseek_v41.c DeepSeek V4.1 Flash (make deepseek_v41)
├── mimo.c MiMo-V2.6 Flash and Pro (make mimo)
├── qwen38.c Qwen3.8-Flash-Next (make qwen38)
├── qwen36.c Qwen3.6, Qwen3-Coder, Qwen3.8-27B, Flint, Muse Spark,
│ LFM3-VL, Clef (make qwen36)
├── olmoe.c OLMoE (make olmoe)
├── qwenimage.c Qwen-Image-2.1 (make qwenimage)
├── laya.c Laya (make laya)
├── gliner_decide.c GLiNER2.5-Decide (make gliner_decide)
│
├── st.h, quant.h, idot.h safetensors reads, container decoders, integer kernels
├── expert_ffn.h, expert_store.h routed-expert kernel and streaming expert cache
├── tok.h, json.h, compat.h tokenizer, JSON, Windows/macOS shims
├── route_trace.h, kv_prefix.h routing telemetry (.coli_usage), KV prefix reuse
├── gguf.h, park.h GGUF reader, a conversation parked between an agent's turns
├── decide_serve.h the decision engines' side of System One
│
├── backend_cuda.*, cu_tier.h, cuda_chain.cu optional CUDA tier and chains (CUDA=1)
├── backend_metal.* optional Metal tier (METAL=1)
├── backend_vulkan.*, vk_tier.c, vk_chain.c optional Vulkan tier and dense chain (VK=1)
│
├── coli user-facing CLI
├── setup_*.py the one-step setup: hardware, catalog, downloads, flow
├── mcp_server.py the MCP server (coli mcp)
├── openai_server.py OpenAI- and Anthropic-compatible HTTP gateway
├── resource_plan.py RAM/VRAM planner behind coli plan and coli doctor
├── tools/ conversion, fixtures and benchmarks
└── tests/ dependency-free C and Python tests
ui/ the chat UI (coli ui)
web/ the dashboard (a pure API client)
desktop/ Tauri desktop shell around the dashboard
docker/ container images
docs/ reference docs, experiments, media
site/ the website
```
**モデルファミリーごとに `.c` を 1 つ、共有の単一ヘッダの上に。** エンジンが持つのは自身のアーキテクチャだけで、それ以外は持ちません。2 つのエンジンが共に必要とするものは、両者がインクルードするヘッダに置かれるため、修正は一度にすべてのエンジンに届きます。リポジトリのルートからは、`make`、`make check`、`make clean` がエンジンの Makefile に委譲されます。
## プロジェクトへの支援
colibri は、RAM 25 GB の 12 コアのラップトップ上で、1 人のプロジェクトとして始まりました。今ではその数値は、実機を持つコミュニティから集まっています。役に立ったと感じたら:
- リポジトリにスターを付けて、共有してください。
- あなたのハードウェアでのベンチマーク数値を添えて issue を作成してください:データポイントは何よりもこのプロジェクトを前進させます。
- [Discord コミュニティ](https://discord.gg/RXV83nSZdk)に参加して、実験、ハードウェアでの結果、研究の方向性について議論してください。
- 開発のスポンサーやハードウェアの寄贈については、GitHub の issue からご連絡ください。
## なぜ「colibrì」なのか
ハチドリは体重わずか数グラムで、空中の一点にとどまり、1 日に千もの花を訪れます。このエンジンは、744B パラメータの巨人をハチドリの食事量で生かし続けます:RAM 25 GB、CPU 12 コア、そしてディスクへのたっぷりの忍耐です。
## 謝辞
colibri はエンジンにすぎず、それが動かす知性は贈り物です。重みをオープンに公開しているチーム、**Z.ai**(GLM)、**Moonshot AI**(Kimi)、**Alibaba Qwen**、**DeepSeek**、**Xiaomi**(MiMo)、**Thinking Machines**(Inkling)、**Allen AI**(OLMoE)、**Convai Innovations**(Laya)、**fastino**(GLiNER2.5-Decide)、**Cloudflare**(Clef)に、変換済みコンテナを公開してくれる人々に、そしてベンチマークを取り、バイセクトし、アトラスの実行を再現し、パッチを送ってくれたすべてのコントリビューターに感謝します。このリポジトリに含まれるサードパーティのコードとそのライセンス:[THIRD_PARTY_NOTICES.md](THIRD_PARTY_NOTICES.md)。
このプロジェクトのエキスパート配置、圧縮、ルーティングの実験は、以下のオープンな研究と
システムのアイデアやエビデンスにも基づいています:
- 出力を考慮した、ドメイン固有のエキスパート重要度については
[REAP](https://github.com/CerebrasResearch/reap) と
[EASY-EP](https://github.com/RUCAIBox/EASYEP)。
- 類似度に基づくエキスパートの再ルーティングについては [SERE](https://github.com/JL-Cheng/SERE)、
キャッシュ局所性を考慮したルーターのファインチューニングについては
[ReMoE](https://github.com/BUAA-OSCAR/ReMoE)。
- ルーティングに導かれたエキスパートのマージと圧縮については
[MC-SMoE](https://github.com/UNITES-Lab/MC-SMoE)。
- 共有エキスパート基底と低ランクのエキスパート差分については
[MoBE](https://github.com/inclusionAI/MoBE) と
[D²-MoE](https://github.com/lliai/D2MoE)。
- CPU/GPU ハイブリッドのエキスパートスケジューリングについては
[HybriMoE](https://github.com/PKU-SEC-Lab/HybriMoE)、エキスパート通信と計算のオーバーラップについては
[ScMoE](https://arxiv.org/abs/2404.05019)、分散オンデマンドのエキスパートロードについては
[OD-MoE](https://arxiv.org/abs/2512.03927)。
- 比較を再現可能にしているオープンな推論システムとエキスパートオフロードの取り組みについては
[vLLM](https://github.com/vllm-project/vllm)、
[llama.cpp](https://github.com/ggml-org/llama.cpp)、
[kTransformers](https://github.com/kvcache-ai/ktransformers)。
エンジンはアイデアだけでなく、具体的なエンジニアリングの成果の上にも成り立っています。以下はいずれも
現在ツリー内で使われているか、再実装されています:
- [safetensors](https://github.com/huggingface/safetensors):すべてのエンジンが読むコンテナ
(`c/st.h`)。fp8 と I64 の dtype を含みます。
- [tiktoken](https://github.com/openai/tiktoken):`c/tok.h` はその `byte_pair_encode` を
正確に再実装しており、連結した結果の語彙 ID が最も小さい隣接ペアをマージするため、
tiktoken 由来の語彙にはマージリストが不要です。
- [llama.cpp](https://github.com/ggml-org/llama.cpp):`c/grammar.h` の GBNF 文法サブセットは
その構文とスタック集合による PDA に従っており、Metal の経路はその
`newBufferWithBytesNoCopy` による常駐テクニックを借用しています。
- [vLLM](https://github.com/vllm-project/vllm):エンジンが位置ごとに一致させている出力
セマンティクスのリファレンス(例: 最終ノルムが LM ヘッドに対してどこに入るか)。
- [transformers](https://github.com/huggingface/transformers):オラクル:
CI はランダム初期化モデルをこれに対してトークン単位で再現します。
- [DietGPU](https://github.com/facebookresearch/dietgpu):実験的な圧縮エキスパートティア
(`COLI_ANS`)の背後にある GPU ANS コーデック。
- [rocWMMA](https://github.com/ROCm/rocWMMA):HIP バックエンドは CUDA の
`nvcuda::wmma` の fragment/mma_sync API をこれにマッピングしており(`c/backend_gpu_compat.h`)、
それによって 1 つの .cu ソースを両ベンダー向けにコンパイルできます。
## ライセンス
Apache 2.0、Copyright 2026 Vincenzo Fornaro。[LICENSE](LICENSE) と [NOTICE](NOTICE) を参照してください。各モデルには、その作者が付けたライセンスがそのまま適用されます(GLM-5.2 の重みは Z.ai により MIT ライセンスで公開されています。Qwen-Image-2.1 は非商用利用に限られます)。