-windows-x86_64-cuda.zip` 包含 `coli_cuda.dll`(compute capability 8.0 及以上的显卡)以及加载它的 colibri、qwen36 和 kimi_k3 引擎,还有 DeepSeek V4 的 CUDA DLL。把它解压到主压缩包之上,安装程序就会选择 CUDA。
- **所有层都在显卡上**(Qwen3.6、Qwen3.8 和 OLMoE):稠密层、注意力以及显卡持有的路由专家作为一条链运行,显卡不持有的专家在 CPU 上运行。在 RTX PRO 4000 上,Qwen3.6-35B-A3B UD-Q4_K_M 的解码速度为 104.8 tok/s,读取提示词为 3,491,OLMoE 为 354.6 和 10,418([表格](#three-backends-on-one-machine))。
- **每个引擎都有显卡上的路由专家层级**(`cu_tier.h`),DeepSeek V4、V4.1、Kimi K3、GLM-5.3 和 MiMo 的稠密矩阵也放在显卡上(`cu_dense.h`)。
- **GGUF 的块在显卡上**(`cuda_bd.cuh`):每种 32 个权重及以上的 ggml 块类型,每一行都保持文件中的样子;提示词经过张量核心([gguf.md](docs/gguf.md))。
- **显存专家层级**把最热的专家放在显卡上,这些专家根据实测路由选出;未命中的专家同时在 CPU 上计算。Qwen3.6 在两张 8 GB 显卡(RTX 3070 和 Quadro RTX 4000)上、有热的路由历史时,解码速度为 11.3 tok/s([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md));GLM-5.2 在六张 RTX 5090 上、全部专家常驻时为 9.0-9.2 tok/s([benchmarks.md](docs/benchmarks.md));DeepSeek V4 Flash 在一张 RTX 5080 上为 1.5-1.6 tok/s,3,324 个 token 的提示词用时 90 秒([deepseek-v4.md](docs/deepseek-v4.md))。
- **Qwen3.6 新功能:DeltaNet 层放在显卡上**(`Q36_DN_GPU=1`,需手动开启)。以前,Qwen3.6 的 30 个 DeltaNet 层中,每一层对每个 token 都要在显卡和 CPU 之间复制四次数据;现在,解码一个 token 时整个层都在显卡上运行,其循环状态保留在显存中。在 RTX 3070 上、稠密层位于显存时:从 25.4 提升到 30.0 tok/s([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md#the-deltanet-layer-on-the-card-q36_dn_gpu1))。
- **较旧的显卡。** 如果 CUDA toolkit 已不再支持为你的显卡编译(例如 CUDA 13 与 V100,见 [#1852](https://github.com/JustVugg/colibri/issues/1852)),安装程序会在编译之前就发现这一点,并说明原因,转而通过 Vulkan 使用这张显卡;装上 CUDA 12.x toolkit 可以恢复 CUDA 路径。DeepSeek V4 的 CUDA 层级也可以为 Pascal 和 Turing 编译(`CUDA_ARCH=portable-pre-ampere NO_TC=1`)。
全部内容:[docs/cuda.md](docs/cuda.md)。
### Apple Silicon
Metal 后端为多个引擎在统一内存 GPU 上执行专家运算([docs/metal.md](docs/metal.md))。版本的 macOS 压缩包中,`colibri`、`inkling` 和 `kimi_k3` 已带 Metal 编译:`COLI_METAL=1`(Kimi K3 用 `K3_METAL=1`)开启它,不设置时在 CPU 上运行。从源码编译请用 `METAL=1`;一步安装程序编译的是 CPU 版本。
## System One:一个带概率的决策
人们向模型提出的请求,大多数是要它做一个选择,而不是写一段文字:哪个队列、哪个结论、是或否。`POST /v1/systemone` 接收一个状态(文本或 JSON)和若干带类型的问题,对每个问题给出每个允许选项的概率以及一个置信度。不生成任何内容,因此答案不可能落在你的列表之外,而“模型没有把握”就成了一个可以设阈值的数字。
```bash
curl -s http://127.0.0.1:8000/v1/systemone -H 'Content-Type: application/json' -d '{
"state": "340 lines, 8 files, no tests. CI is green but nothing covers that path.",
"questions": {
"review": {"type": "choice", "instructions": "What should the reviewer do?",
"criteria": {"merge": null, "request changes": null, "close": null}},
"risky": {"type": "noul", "instructions": "Is this change risky?"}}}'
```
`choice` 类型的问题返回所选的标签、每个标签的概率,以及一个从 0(毫无倾向)到 1(完全确定)的 `confidence`;`noul` 返回“是”的概率;`score` 返回期望等级。
由谁来回答:
- **colibri 运行的任何聊天模型**,通过打分:它读出每个选项的概率,而不是写出一个答案。关于同一文档的多个问题只读取文档一次:在 Qwen3.6 上,关于同一文档的四个问题,比在同一台 CPU 机器上生成同样的答案快 5.7 倍。
- **三个决策模型**,原生作答,一次前向传播完成,使用其作者拟合的校准:[Laya](docs/laya.md)(Convai Innovations)、[GLiNER2.5-Decide](docs/gliner_decide.md)(fastino)和 [Clef](docs/clef.md)(Cloudflare;它也能聊天)。它们的大小和速度见[决策模型表格](#which-model-for-my-machine)。
**从 Jev 切换过来。** 请求和回复与 TypeSafe 的 Jev API 相同,因此 Jev 客户端只需更改 base URL 即可切换到 colibri,其他什么都不用改:`TYPESAFE_BASE_URL=http://127.0.0.1:8000`(没有设置 `COLI_API_KEY` 就启动的服务器会接受客户端已经在发送的密钥)。两个官方 SDK 未经任何修改,已针对 `coli serve` 测试。
同样的模式也可以在终端中使用(`coli chat` 中的 `/decide merge | request changes | close`),也可以在仪表盘的 System One 页面使用。完整的请求与回复、打分规则,以及它在哪些情况下帮不上忙:[docs/systemone.md](docs/systemone.md)。
## 仪表盘
`coli web` 会打开它,一步安装程序也会:包括聊天、System One 页面、大脑(Brain)页面和性能剖析(Profiling)页面,支持浅色和深色主题。
### 新的聊天界面
`coli ui` 在正在运行的 `coli serve` 旁边打开新的聊天界面:推理有自己的区块,带视觉塔的模型可以看图片,还有网页搜索、专家地图、实时监视器,以及已经指向 colibri 的编程智能体。支持七种语言。参见 [ui/README.md](ui/README.md)。
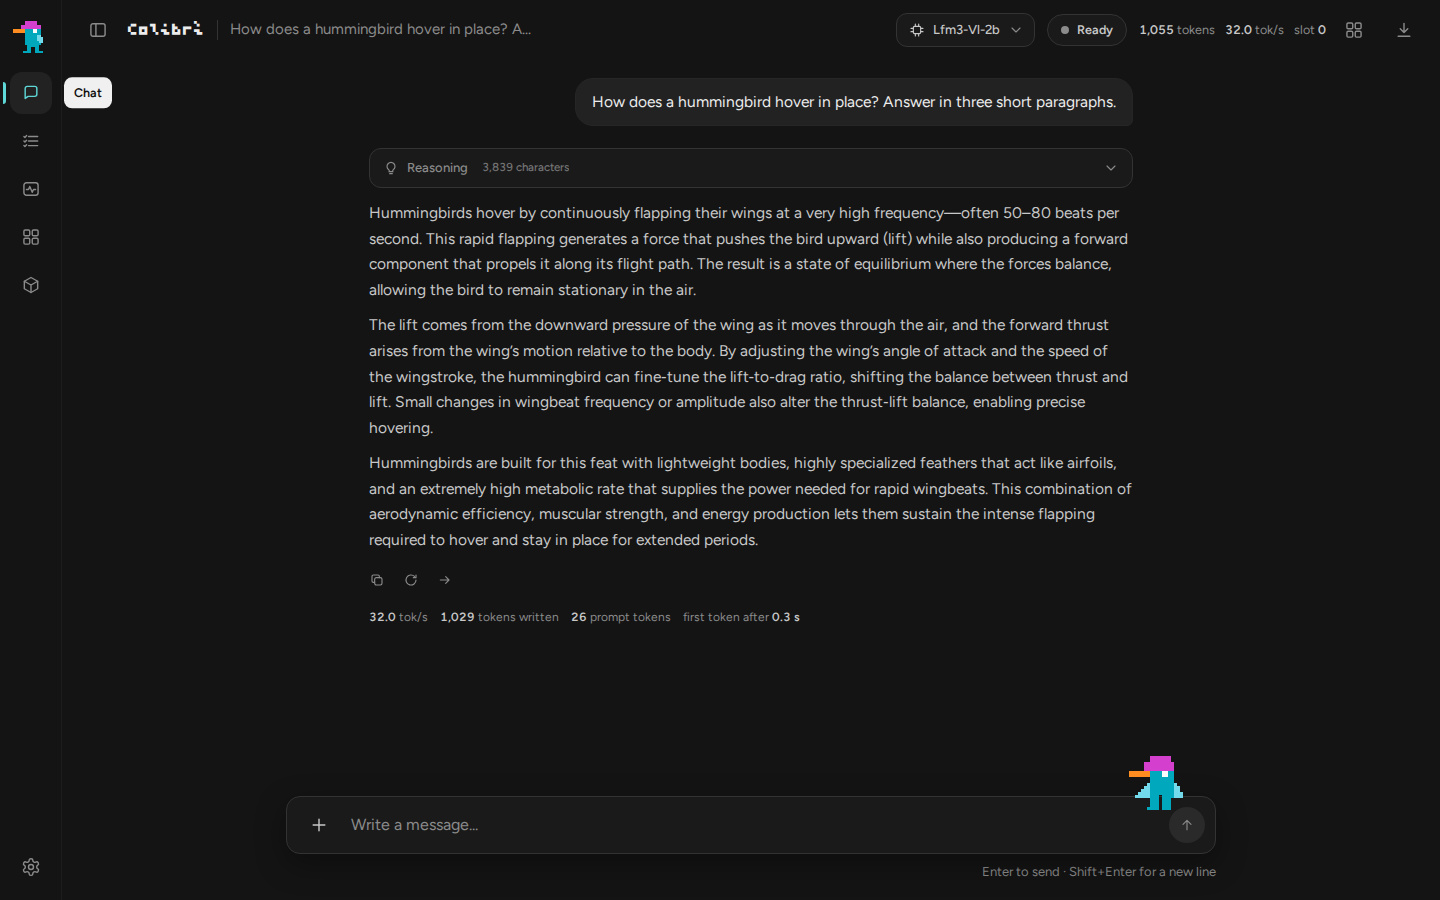
LFM3-VL-2B 在 i5-13500 的 CPU 上,32 tok/s。
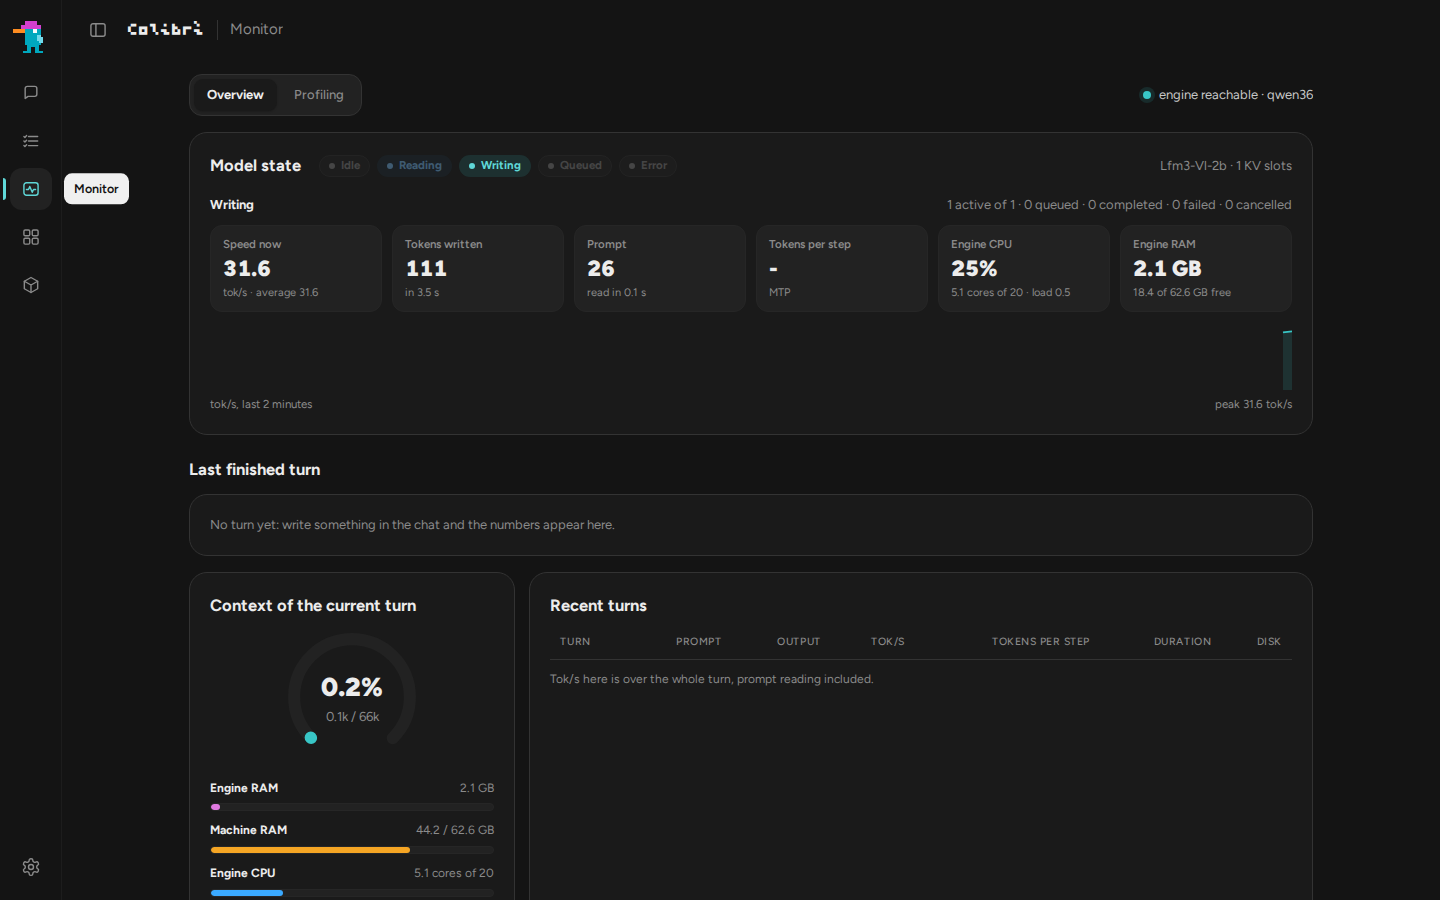
LFM3-VL-2B 写作时的监视器:31.6 tok/s,提示词 0.1 秒读完,内存 2.1 GB。
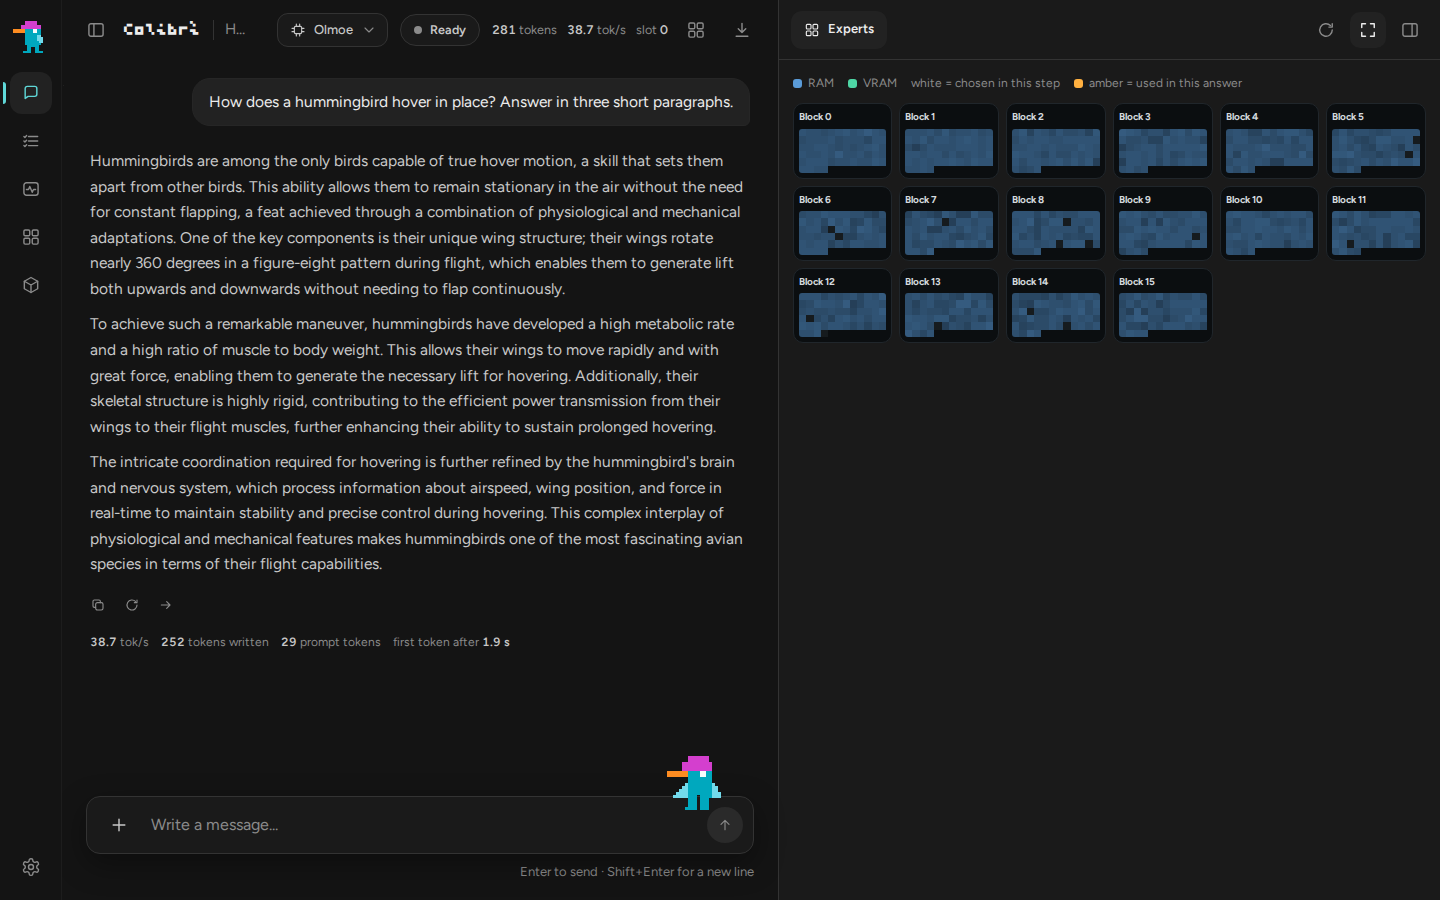
OLMoE 在聊天旁打开专家地图:每个区块中每个专家一格,本步选中的为白色,本次回答用到的为琥珀色。
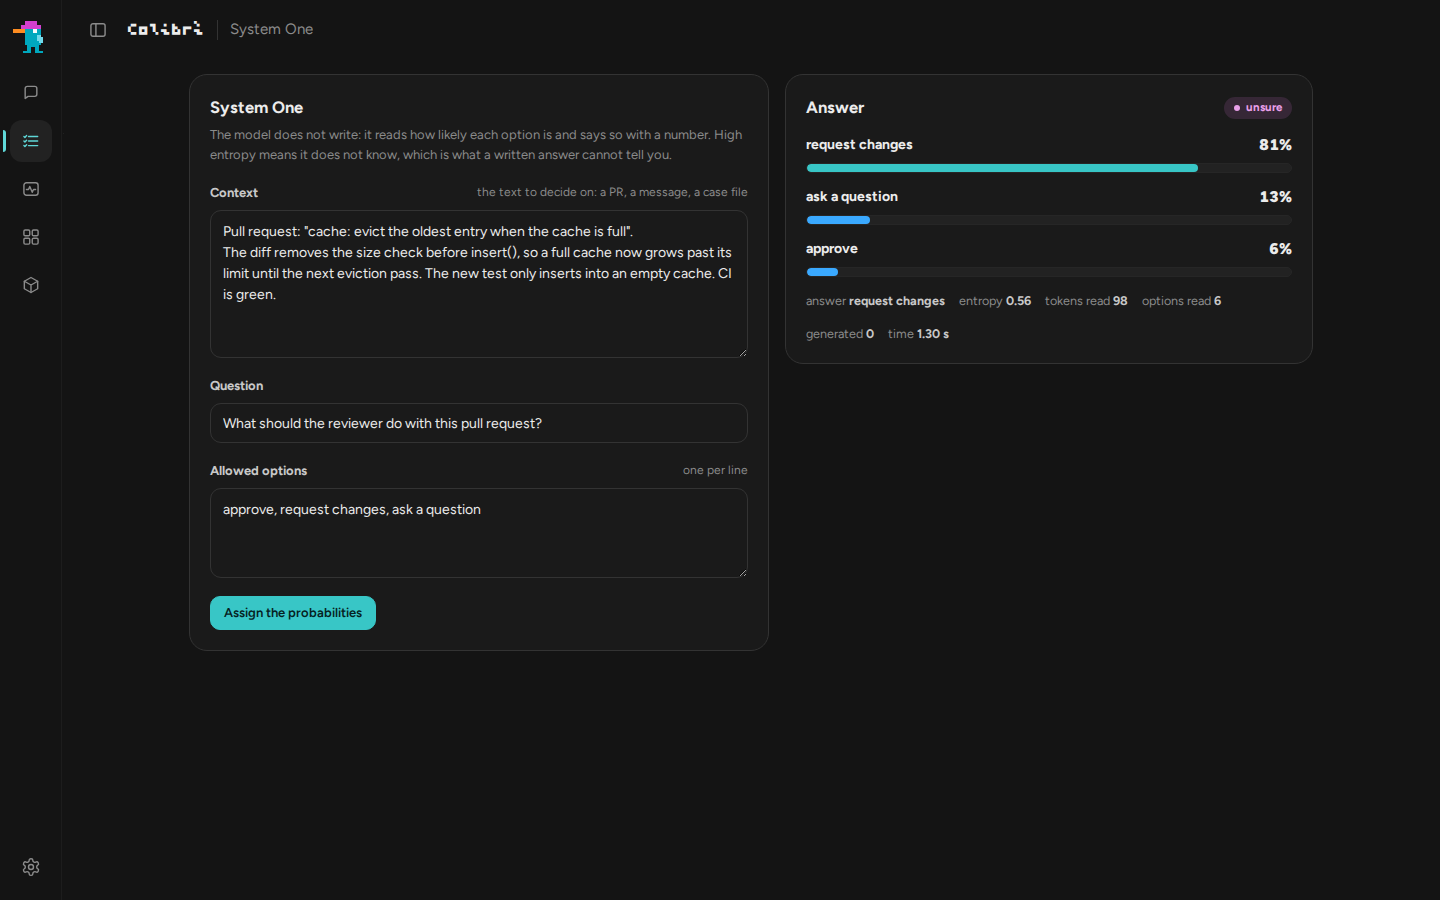
System One:给模型一份文档,以及它唯一可以选择的几个答案。图中 RTX PRO 4000 上的 Qwen3.6-35B 读取一个破坏了缓存大小上限的拉取请求:request changes 的概率为 81%,熵 0.56(不确定),读取 98 个 token,生成 0 个。
**性能剖析**(Profiling)页面按阶段显示每一轮的时间花在了哪里,并以最近 30 轮作为趋势。
## 在其他应用中使用
`coli serve`(安装程序会替你启动它)是一个同时提供多种 API 的服务器:
- **兼容 OpenAI**:`/v1/chat/completions`、`/v1/completions` 和 `/v1/models`,支持流式输出、JSON 回复、停止序列和 logprobs;
- **兼容 Anthropic**:`/v1/messages`,因此 Claude Code 和 Anthropic SDK 可以直接连接它;
- **工具调用**:除 Inkling 和 OLMoE 之外的每个聊天引擎都支持,各自使用其模型的原生格式([各引擎对照表](docs/api.md#tool-calling-support));
- **图像输入**:GLM-5.3-Flash、DeepSeek V4.1 Flash、MiMo-V2.6、Qwen3.8-Flash-Next、Qwen3.8-27B、LFM3-VL 和 Mistral-Large-4(来自 GGUF 时,把 `mmproj` 文件放在旁边)支持,方式可以是 `coli chat` 消息中的一个路径、`coli web` 或 `coli ui` 中的一个附件,或一个 `image_url` 部分;
- **图像输出**:Qwen-Image-2.1 通过 `POST /v1/images/generations` 提供,`coli chat` 还能直接在终端中显示图片([qwen-image.md](docs/qwen-image.md));
- **决策**:通过 `POST /v1/systemone`([见上文](#system-one-a-decision-with-a-probability))。
- **同时进行多个对话**:在每个文本引擎上,`coli serve --kv-slots N` 最多保留 16 个对话,每个都有自己的缓存,并把它们的下一个 token 一起解码([api.md](docs/api.md#isolated-kv-contexts))。
编程 CLI 和编辑器的连接方式与连接任何兼容 OpenAI 的服务商相同:base URL 为 `http://127.0.0.1:8000/v1`,模型 id 用 `coli status` 打印出的那个,密钥任意非空即可([docs/api.md](docs/api.md#connect-a-coding-cli-or-editor))。
## 工作原理
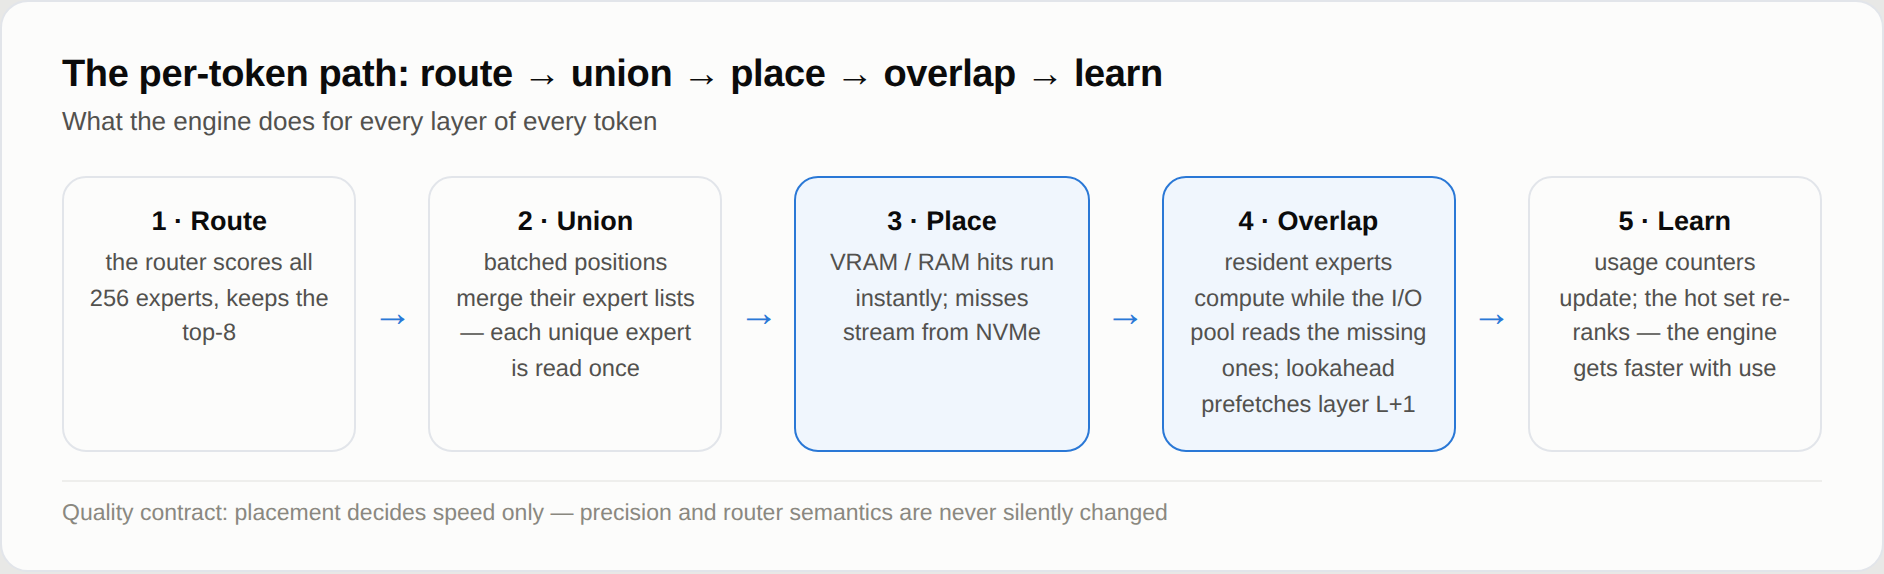
每个 token 的每一层都走相同的五个步骤:路由、并集、放置、重叠、学习。设计目标是**放置只决定速度**:无论专家是从显存、内存还是磁盘作答,路由器的决策和权重的精度都完全相同。
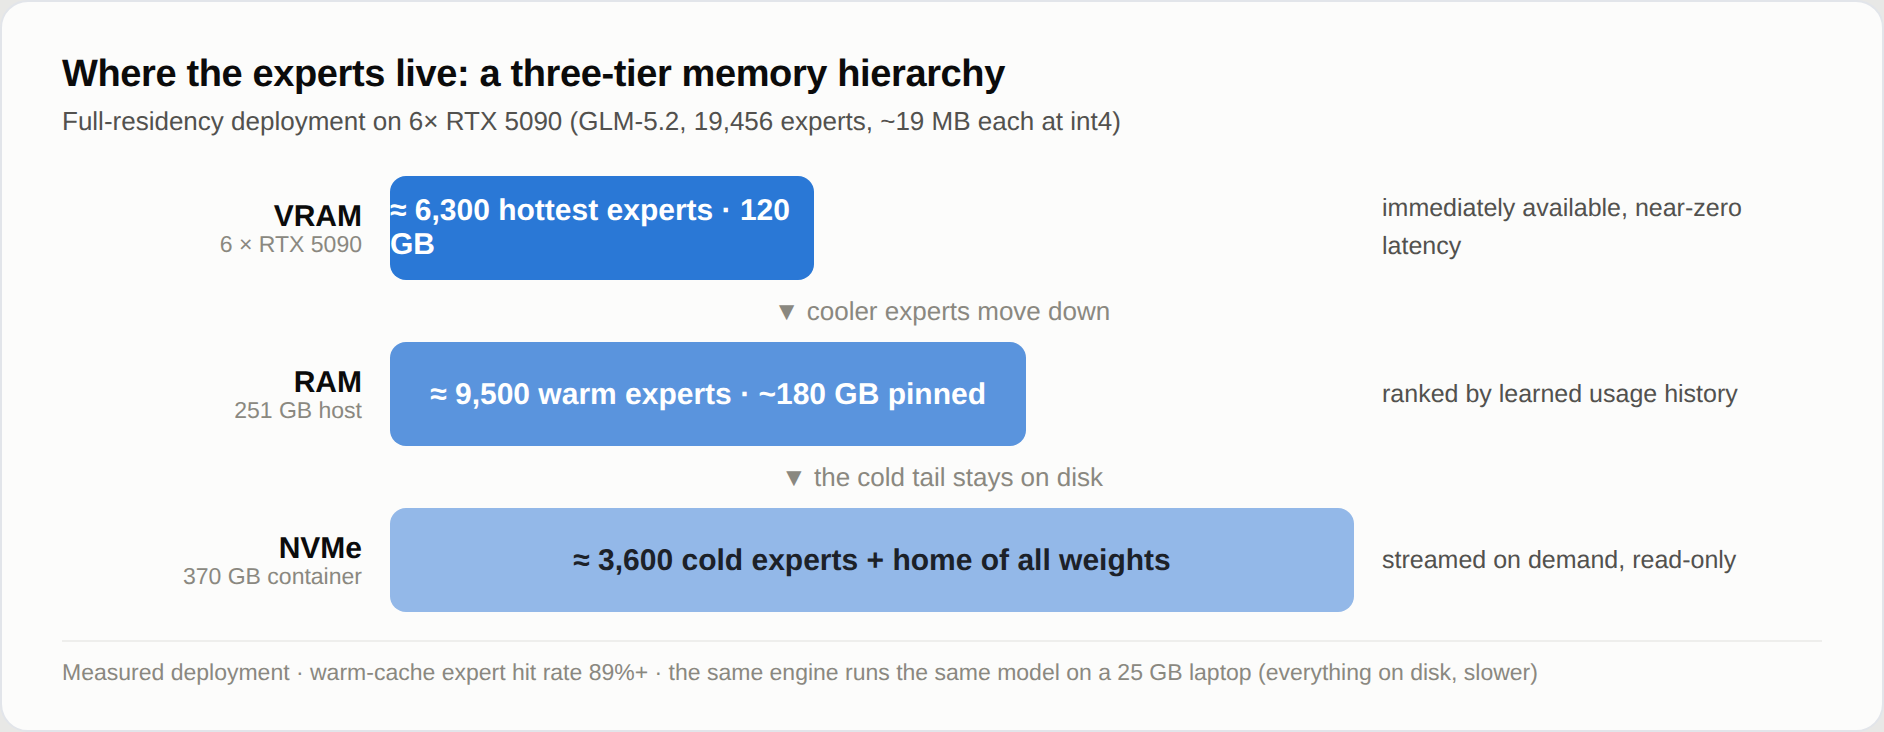
- **权重的 JIT。** 编译器的 JIT 从不编译整个程序:它观察实际运行的部分,只编译热点路径。colibri 对权重下了同样的赌注。实测的路由热度决定哪些专家配得上显存、内存或磁盘:一个逐层的 LRU 缓存,加上一个从你自己的对话中学到的固定热门集合(`.coli_usage`,每轮更新)。colibri 越用越快。之所以可行,是因为路由具有可测量的结构(见[专家图谱](https://github.com/JustVugg/colibri/issues/175))。
- **绝不为磁盘等待两次。** 一个专家的三个矩阵用一次 `pread` 读出;一组加载线程在常驻专家计算的同时读取缺失的专家;一批位置对每个专家只读取一次;路由前瞻线程可以预取下一层(GLM-5.2 的路由提前一层时有 71.6% 可预测)。`DIRECT=1`(O_DIRECT)在快速 NVMe 硬盘上往往收益很大,在其他硬盘上则持平甚至更差:请在你自己的硬盘上实测([tuning.md](docs/tuning.md))。
- **不止一块 SSD。** `COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat --model /fast/glm52_i4` 会同时从第二块硬盘上的副本读取。两块接在独立控制器上的 NVMe 硬盘实测解码速度 +37.5%;放在较小硬盘上的部分镜像也可以([multidisk.md](docs/multidisk.md))。
- **从笔记本到机架。** 在 25 GB 的笔记本上,所有专家都从磁盘流式读取,慢,但结果正确;在大型主机上,所有专家都常驻(`CUDA_EXPERT_GB=auto PIN_GB=all`),磁盘完全退出解码过程。`COLI_NUMA=1` 把常驻权重分布到多路主机的各个内存控制器上,本地集群模式则可以在其他机器上运行路由专家([cluster.md](docs/cluster.md))。
- **忠实的模型。** 每个引擎都在 CI 中用一个微型 fixture 与其模型的参考实现进行对照检查。GLM-5.2 的 MLA 注意力保存压缩后的 KV 状态(每个 token 576 个浮点数,而不是 32,768 个,缩小 57 倍),并且在重启后依然保留,因此重新打开对话时无需再次读取提示词。
- **物有所值的推测解码。** GLM-5.2 的 int8 MTP head 在划算时每次前向传播起草 2.2-2.8 个 token;Qwen3.8-Flash-Next 的 MTP head 默认开启,在输出不变的情况下提速 16-20%;提示词查找在代码编辑上提速 6-7%。Qwen3.6 的 head(`Q36_MTP=1`)把解码速度在 CUDA 上从 99.7-104.5 提高到 115.8-120.1 tok/s,在 Vulkan 上从 83.2-83.8 提高到 99.9-109.3(一张 RTX PRO 4000)。DeepSeek V4.1 的 DSpark head 按其置信度决定起草深度,并由一道关卡跳过无法回本的草稿。在起草成本高于节省的地方(DeepSeek V4),它保持关闭([speculative.md](docs/speculative.md)、[tuning.md](docs/tuning.md#speculation-and-reproducibility))。
引擎是每个模型家族一个 C 文件(GLM-5.2 是 `c/colibri.c`),建立在共享的头文件之上,运行时不需要 BLAS,也不需要 Python:Python 只用于安装程序、启动器、转换工具和 API gateway。
## 基准测试
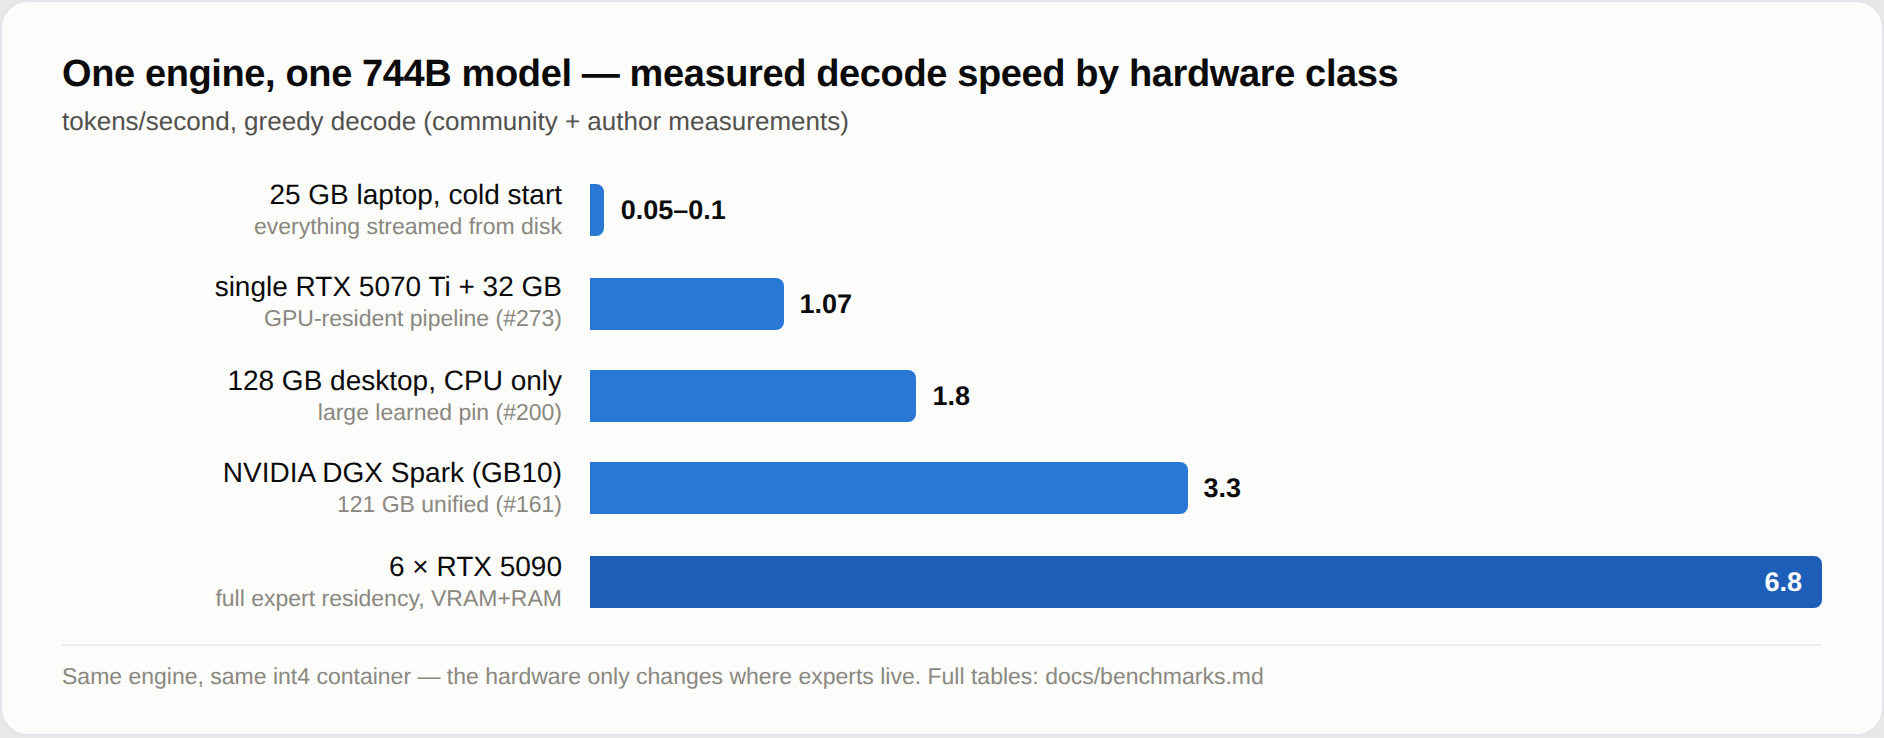
同一个引擎,同一个 int4 容器:硬件只改变专家存放的位置。GLM-5.2 的解码速度,摘自[完整表格](docs/benchmarks.md):
- **6x RTX 5090,全部专家常驻:** 5.8-6.8 tok/s,使用选择性 NUMA 交错时为 9.0-9.2([实验记录](docs/experiments/glm52-6x5090-2026-07-12.md));
- **128 GB,仅用 CPU**(Ryzen AI Max+ 395):热缓存时 1.83 tok/s([#200](https://github.com/JustVugg/colibri/issues/200));
- **一台配单张 RTX 5070 Ti 的笔记本级主机:** 1.07 tok/s([#273](https://github.com/JustVugg/colibri/issues/273));
- **项目起步时的那台 25 GB 笔记本:** 冷启动 0.05-0.1 tok/s,这是诚实的下限。
### 一台机器上的三种后端
一台 i5-13500,62 GB 内存,一张 RTX PRO 4000 Blackwell SFF(24 GB,70 W),每个模型由 `coli serve` 提供服务:一个新的 450 token 提示词,然后流式输出 128 token 的回答,包含请求的 HTTP;取两次运行中较好的一次,单位 tok/s。
| GGUF | CUDA 提示词 | CUDA 解码 | Vulkan 提示词 | Vulkan 解码 | CPU 提示词 | CPU 解码 |
|---|---:|---:|---:|---:|---:|---:|
| Qwen3.6-35B-A3B UD-Q4_K_M | 3,491 | 104.8 | 2,076 | 92.9 | 122.6 | 13.9 |
| LFM3-VL-2B Q4_K_M | 12,317 | 235.1 | 8,174 | 214.1 | 286.5 | 34.5 |
| OLMoE-1B-7B-0125-Instruct Q4_K_M | 10,418 | 354.6 | 6,867 | 299.4 | 279.9 | 47.4 |
| LFM3-VL-2B F16 | 11,524 | 103.4 | 7,767 | 99.3 | 49.7 | 6.4 |
| Qwen3.8-Flash-Next IQ2_XS(68 GB:显卡放不下的专家留在内存中) | 217.1 | 51.4 | 214.3 | 50.6 | 38.3 | 9.3 |
### 同一台机器上的大模型
仍是机器 D,每个模型都从已发布的 GGUF 通过 `coli serve` 运行:显卡和内存都放不下的部分来自两块 NVMe。单位为每秒 token 数,取自各模型的页面:
| GGUF | 大小 | 后端 | 提示词 | 解码 |
|---|---:|---|---:|---:|
| Inkling-Small UD-IQ2_XXS | 77 GB | Vulkan | 15.1-33.1 | 10.92-11.53 ([vulkan.md](docs/vulkan.md)) |
| MiMo-V2.6-Flash Q2_K_S | 106 GB | Vulkan | 8.2 | 7.8 ([gguf.md](docs/gguf.md)) |
| DeepSeek V4 Flash 0731 UD-IQ2_XXS | 85 GB | Vulkan | 19.7-20.4 | 6.18-6.25 ([vulkan.md](docs/vulkan.md)) |
| DeepSeek V4.1 Flash UD-IQ1_S | | Vulkan | 3,403 个 token 时 31.8 | 5.01-5.29 ([deepseek-v41.md](docs/deepseek-v41.md)) |
| GLM-5.3-Flash UD-IQ2_XXS | 95 GB | Vulkan | 9.3 | 2.92-3.40 ([vulkan.md](docs/vulkan.md)) |
| Muse Spark Open UD-IQ1_S | 176 GB | Vulkan | 5.0-5.3 | 1.55-1.58 ([qwen36.md](docs/qwen36.md#muse-spark-open)) |
| Mistral-Large-4 UD-IQ1_S | 233 GB | CUDA | 240 个 token 用时 66-82 秒 | 1.34-1.36 ([mistral-large4.md](docs/mistral-large4.md)) |
| GLM-5.2 UD-IQ1_S | 202 GB | Vulkan | | 0.633-0.658 ([gguf.md](docs/gguf.md)) |
| Kimi K3 UD-IQ1_S | 594 GB | Vulkan | 31 个 token 用时 46.5 秒 | 0.349 ([gguf.md](docs/gguf.md)) |
### 长上下文和智能体
- **以 64k 的速度运行 256k 上下文。** 机器 D 的 CUDA 链上运行 Qwen3.8-Flash-Next IQ2_XS,上下文 262,144 token:提示词 15.6 -> 149 tok/s,解码 9.6 -> 45.7(内存规划按一个提示词分段,K/V 在显卡上用 float16;在 65,536 时读取 188,解码 48.4)([qwen38.md](docs/qwen38.md))。
- **智能体的每一轮只读取新内容。** 两轮之间的短请求(智能体询问会话标题)会把会话暂存起来,而不是占用它的状态,所有引擎都如此(`COLI_PARK`)。Qwen3.8-Flash-Next 上 Hermes Agent 的第二轮,14,810 个 token:86 秒 -> 4.9 秒([qwen38.md](docs/qwen38.md#an-agents-turns))。
- **float16 的 KV 缓存**:GLM-5.3 在 131,072 个 token 时占用 11.9 GB,而不是 23.9 GB([CHANGELOG](CHANGELOG.md))。
质量靠测量,而不是靠假设:int4 容器的代价和量化消融实验见 [benchmarks.md](docs/benchmarks.md#quality-benchmark)。想加入你的机器,请按照[基准测试协议](docs/benchmarking.md)操作,并提交一个附有数据的 issue。
## 手动安装
**1. 程序。** 从 [Releases](https://github.com/JustVugg/colibri/releases) 下载对应平台的压缩包(Linux x86_64、macOS、Windows;不需要编译器,只需要供启动器和 API 使用的 [Python 3](https://www.python.org/downloads/))并解压,然后运行 `python3 coli info`。Linux 和 Windows 的引擎内置 Vulkan(`shaders/` 就在旁边),macOS 的引擎内置 Metal;在 Windows 上使用 NVIDIA 显卡时,再加上 CUDA 压缩包。或者用 `gcc`(或 clang)和 OpenMP 从源码编译:
```bash
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh # checks gcc/OpenMP, builds, self-tests
make qwen36 VK=1 # one engine, here with Vulkan (CUDA=1 for CUDA)
```
**2. 模型。** [上面表格](#which-model-for-my-machine)中的任何一个下载都可以:安装程序的 id 对应 Hugging Face 仓库,每个模型的页面都写有下载和转换命令。GLM-5.2 请使用带 int8 MTP head 的 group-scaled(gs64)容器 [`mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp`](https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp)(429 GB),GLM-5.3 则使用 [`Justvugg/GLM-5.3-colibri-int4-g64`](https://huggingface.co/Justvugg/GLM-5.3-colibri-int4-g64)(419 GB,没有 MTP head)。不要使用较旧的 per-row int4 镜像:它们的质量实测低约 9 个百分点,并导致了 [#455](https://github.com/JustVugg/colibri/issues/455) 中的循环回答。`./coli convert --model /nvme/glm52_i4` 会从 FP8 发布版逐个 shard 构建同样的容器,任何时候都不需要在磁盘上同时存放全部 756 GB。如何检查 MTP head 以及其他事项:[quickstart.md](docs/quickstart.md#3-get-the-model)。已有的 GGUF 无需转换:对它的第一个文件运行 `./coli import`([见上文](#from-a-gguf))。
**3. 运行。** 在源码 checkout 的 `c/` 目录中,或在解压后的发布包中运行。启动器会读取模型的 `config.json`,选出对应的引擎及其聊天模板,因此所有模型的命令都相同:
```bash
./coli chat --model /nvme/qwen36 # chat in the terminal
./coli web --model /nvme/qwen36 # API + dashboard, opens a browser
./coli serve --model /nvme/qwen36 # API + dashboard, no browser
./coli plan --model /nvme/qwen36 # where the model will live: VRAM, RAM, disk
./coli doctor --model /nvme/qwen36 # read-only check: is everything ready?
./coli tune --model /nvme/qwen36 # measure and save this machine's fastest safe settings
./coli import /nvme/Flint-UD-Q4_K_XL.gguf # a GGUF: writes Flint-UD-Q4_K_XL.colibri next to it
./coli ui # the chat UI, next to a running coli serve
```
在 Windows 上,发布包附带 `coli.cmd`(`coli.cmd chat --model D:\qwen36`);在源码 checkout 中请使用 `py -3 c\coli`。`.exe` 文件是引擎,而不是启动器。所有选项和变量:[SETTINGS.md](docs/SETTINGS.md)、[ENVIRONMENT.md](docs/ENVIRONMENT.md)。
## 研究,以及如何参与
colibri 希望前沿模型更少依赖稀缺硬件,运行成本更低。这意味着改变权重的存储和移动方式,决定哪些内容放在显存、内存或存储中,让 CPU 和 GPU 的工作相互重叠,并测试新的解码方法。没有什么会因为是惯例就被保留,也没有什么会因为微基准测试看起来快就被采用:起决定作用的是真实机器上的端到端推理,并且质量与速度一起测量。当前的开放问题:
| 假设 | 目前的证据 | 仍需完成的实验 |
|---|---|---|
| 路由历史能比普通 LRU 更好地放置专家 | 学习到的固定集合能改善重复负载,但可能对某个提示词过拟合 | 在编程、聊天、多语言和长上下文负载上做留出集、跨会话的 A/B |
| 多块 SSD 能把独立的带宽转化为解码速度 | 两块独立的 NVMe 硬盘实测解码 +37.5%;经加权条带化后,较慢的第三块硬盘影响持平([测量数据](docs/multidisk.md#what-has-been-measured)) | 在不同的硬盘速度、控制器布局和缓存状态下复现 |
| 硬件感知的规划器能自动接近每台机器的最佳配置 | 目前已能检测内存/显存预算和多个后端,安装程序也会选择构建版本 | 在笔记本、工作站、NUMA 主机和多 GPU 系统上,把生成的方案与受控的参数扫描进行对比 |
| 无损或质量受控的表示能把权重搬运量减少到有意义的程度 | 已有格式和量化消融实验,并设有正确性/质量门槛 | 同时复现质量、搬运的字节数、延迟和每个有效 token 的成本,而不只看压缩率 |
| 感知路由的推测解码能在接近全驻留之前就带来收益 | MTP 和语法草稿可用,但 MTP 在专家命中率约 85% 时也实测过 32% 的损失 | 绘制接受率、专家命中率、批次并集和草稿深度之间的盈亏平衡面 |
| CPU/GPU 重叠能隐藏传输和同步开销,而不只是转移瓶颈 | CUDA、Metal 和 Vulkan 都有收益数据,但快速 CPU、集成显卡和低驻留率可能把收益抹平 | 在 PCIe、统一内存和全驻留机器上做逐阶段 profile 和单变量 A/B,并在已测的那一张(RTX PRO 4000)之外取得更多独立显卡上 Vulkan 层级和稠密链的数据 |
想参与?任选一行,负面结果也请公开。记录硬件、commit、模型、完整命令、提示词、缓存状态、吞吐量、首 token 延迟、专家命中率、读取的字节数,以及一项质量检查;每次只改变一个变量,重复运行,并附上原始日志。先从 [CONTRIBUTING.md](CONTRIBUTING.md) 和[基准测试协议](docs/benchmarking.md)开始,然后[提交一个 issue](https://github.com/JustVugg/colibri/issues/new)。在这里,一个控制良好的失败比一个无法解释的高速数字更有价值。
## 文档
| 主题 | 文档 |
|---|---|
| 一步安装与手动安装,所有平台 | [quickstart.md](docs/quickstart.md) |
| 通过 AI 助手安装,以及 MCP 服务器 | [AI_SETUP.md](docs/AI_SETUP.md)、[MCP_SERVER.md](docs/MCP_SERVER.md) |
| API:OpenAI、Anthropic、工具调用、KV slot、仪表盘 | [api.md](docs/api.md) |
| System One 与决策模型 | [systemone.md](docs/systemone.md)、[laya.md](docs/laya.md)、[gliner_decide.md](docs/gliner_decide.md)、[clef.md](docs/clef.md) |
| GGUF 文件:支持的架构、两种模式、各引擎如何处理这些块 | [gguf.md](docs/gguf.md) |
| Qwen3.6 引擎上的模型(Flint、Muse Spark Open、LFM3-VL)和 Mistral-Large-4 | [qwen36.md](docs/qwen36.md)、[mistral-large4.md](docs/mistral-large4.md) |
| 聊天界面(`coli ui`) | [ui/README.md](ui/README.md) |
| Vulkan:专家层级、稠密链、没有 Resizable BAR 的显卡 | [vulkan.md](docs/vulkan.md) |
| CUDA,以及 Qwen3.6 的 CUDA 层级 | [cuda.md](docs/cuda.md)、[qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md) |
| Apple Silicon、Windows | [metal.md](docs/metal.md)、[windows.md](docs/windows.md) |
| 调优、学习型缓存、预取、推测解码 | [tuning.md](docs/tuning.md) |
| 推测解码:MTP head、提示词查找、关卡 | [speculative.md](docs/speculative.md) |
| 多块 SSD、多台机器 | [multidisk.md](docs/multidisk.md)、[cluster.md](docs/cluster.md) |
| 基准测试以及如何测量 | [benchmarks.md](docs/benchmarks.md)、[benchmarking.md](docs/benchmarking.md) |
| 所有选项和环境变量 | [SETTINGS.md](docs/SETTINGS.md)、[ENVIRONMENT.md](docs/ENVIRONMENT.md) |
| 语法强制草稿,以及实验性的嵌入 ABI | [grammar-draft.md](docs/grammar-draft.md)、[segment-runtime.md](docs/segment-runtime.md)、[edge-runtime.md](docs/edge-runtime.md) |
## 仓库结构
```
start-here.sh, START-HERE.bat the one-step setup (Linux and macOS, Windows)
Makefile root build/check entry point
c/
├── colibri.c GLM-5.2/5.3, Mistral-Large-4 (make glm)
├── glm53.c GLM-5.3-Flash (make glm53)
├── inkling.c Inkling (make inkling)
├── kimi_k3.c Kimi K3 (make kimi_k3)
├── deepseek_v4.c DeepSeek V4 Flash (make deepseek-v4)
├── deepseek_v41.c DeepSeek V4.1 Flash (make deepseek_v41)
├── mimo.c MiMo-V2.6 Flash and Pro (make mimo)
├── qwen38.c Qwen3.8-Flash-Next (make qwen38)
├── qwen36.c Qwen3.6, Qwen3-Coder, Qwen3.8-27B, Flint, Muse Spark,
│ LFM3-VL, Clef (make qwen36)
├── olmoe.c OLMoE (make olmoe)
├── qwenimage.c Qwen-Image-2.1 (make qwenimage)
├── laya.c Laya (make laya)
├── gliner_decide.c GLiNER2.5-Decide (make gliner_decide)
│
├── st.h, quant.h, idot.h safetensors reads, container decoders, integer kernels
├── expert_ffn.h, expert_store.h routed-expert kernel and streaming expert cache
├── tok.h, json.h, compat.h tokenizer, JSON, Windows/macOS shims
├── route_trace.h, kv_prefix.h routing telemetry (.coli_usage), KV prefix reuse
├── gguf.h, park.h GGUF reader, a conversation parked between an agent's turns
├── decide_serve.h the decision engines' side of System One
│
├── backend_cuda.*, cu_tier.h, cuda_chain.cu optional CUDA tier and chains (CUDA=1)
├── backend_metal.* optional Metal tier (METAL=1)
├── backend_vulkan.*, vk_tier.c, vk_chain.c optional Vulkan tier and dense chain (VK=1)
│
├── coli user-facing CLI
├── setup_*.py the one-step setup: hardware, catalog, downloads, flow
├── mcp_server.py the MCP server (coli mcp)
├── openai_server.py OpenAI- and Anthropic-compatible HTTP gateway
├── resource_plan.py RAM/VRAM planner behind coli plan and coli doctor
├── tools/ conversion, fixtures and benchmarks
└── tests/ dependency-free C and Python tests
ui/ the chat UI (coli ui)
web/ the dashboard (a pure API client)
desktop/ Tauri desktop shell around the dashboard
docker/ container images
docs/ reference docs, experiments, media
site/ the website
```
**每个模型家族一个 `.c`,建立在共享的单头文件之上。** 一个引擎只负责自己的架构,其他一概不管;两个引擎都需要的东西放在它们共同包含的头文件里,这样一个修复能同时覆盖所有引擎。在仓库根目录下,`make`、`make check` 和 `make clean` 都会转交给引擎的 Makefile。
## 支持项目
colibri 最初是一个人在一台 12 核心、25 GB 内存的笔记本上开发的项目;如今它的数据来自社区中的各种真实机器。如果它对你有用:
- 为仓库加星并分享它;
- 提交附有你的硬件基准测试数据的 issue:数据点比任何其他东西都更能推动这个项目;
- 加入 [Discord 社区](https://discord.gg/RXV83nSZdk),讨论实验、硬件结果和研究方向;
- 如果想赞助开发或捐赠硬件,请通过 GitHub issues 联系。
## 为什么叫“colibrì”
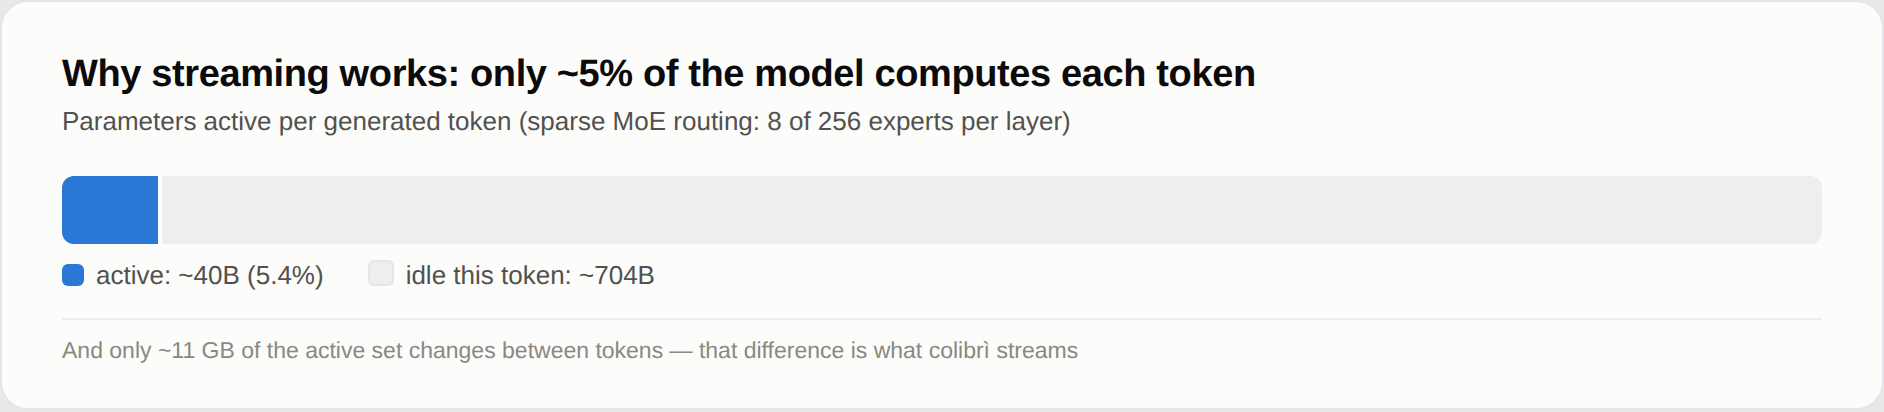
蜂鸟只有几克重,能在原地悬停,一天要造访上千朵花。这个引擎靠蜂鸟般的口粮让一个 744B 参数的巨人运转起来:25 GB 内存、十二个 CPU 核心,以及对磁盘的大量耐心。
## 致谢
colibri 只是一个引擎;它运行的智慧是一份馈赠。感谢以开放方式发布权重的团队:**Z.ai**(GLM)、**Moonshot AI**(Kimi)、**Alibaba Qwen**、**DeepSeek**、**Xiaomi**(MiMo)、**Thinking Machines**(Inkling)、**Allen AI**(OLMoE)、**Convai Innovations**(Laya)、**fastino**(GLiNER2.5-Decide)和 **Cloudflare**(Clef);感谢发布转换后容器的人;也感谢每一位做过基准测试、二分定位问题、复现图谱运行或提交补丁的贡献者。本仓库中的第三方代码及其许可证:[THIRD_PARTY_NOTICES.md](THIRD_PARTY_NOTICES.md)。
本项目在专家放置、压缩与路由方面的实验,也建立在以下开放研究与系统工作的思路和证据之上:
- [REAP](https://github.com/CerebrasResearch/reap) 与
[EASY-EP](https://github.com/RUCAIBox/EASYEP):输出感知的与特定领域的专家重要性。
- [SERE](https://github.com/JL-Cheng/SERE):基于相似度的专家重路由;
[ReMoE](https://github.com/BUAA-OSCAR/ReMoE):感知缓存局部性的路由器微调。
- [MC-SMoE](https://github.com/UNITES-Lab/MC-SMoE):路由引导的专家合并与压缩。
- [MoBE](https://github.com/inclusionAI/MoBE) 与
[D²-MoE](https://github.com/lliai/D2MoE):共享专家基与低秩专家增量。
- [HybriMoE](https://github.com/PKU-SEC-Lab/HybriMoE):CPU/GPU 混合专家调度;
[ScMoE](https://arxiv.org/abs/2404.05019):专家通信与计算的重叠;
[OD-MoE](https://arxiv.org/abs/2512.03927):分布式按需专家加载。
- [vLLM](https://github.com/vllm-project/vllm)、
[llama.cpp](https://github.com/ggml-org/llama.cpp) 与
[kTransformers](https://github.com/kvcache-ai/ktransformers):开放的推理系统与专家卸载工作,
使对比得以复现。
引擎也建立在具体的工程成果之上,而不只是思路。以下每一项如今都在代码树中被使用或重新实现:
- [safetensors](https://github.com/huggingface/safetensors):每个引擎读取的容器格式
(`c/st.h`),包括其 fp8 与 I64 数据类型。
- [tiktoken](https://github.com/openai/tiktoken):`c/tok.h` 精确地重新实现了它的
`byte_pair_encode`,合并拼接后词表 id 最小的相邻对,因此源自 tiktoken 的词表不需要 merges 列表。
- [llama.cpp](https://github.com/ggml-org/llama.cpp):`c/grammar.h` 中的 GBNF 语法子集遵循它的
语法与 set-of-stacks PDA,Metal 路径也借用了它的 `newBufferWithBytesNoCopy` 常驻技巧。
- [vLLM](https://github.com/vllm-project/vllm):引擎逐位置对齐的输出语义参考(例如最终 norm
相对于 LM head 的位置)。
- [transformers](https://github.com/huggingface/transformers):oracle;CI 以它为基准逐 token
复现一个随机初始化的模型。
- [DietGPU](https://github.com/facebookresearch/dietgpu):实验性压缩专家层级(`COLI_ANS`)背后的
GPU ANS 编解码器。
- [rocWMMA](https://github.com/ROCm/rocWMMA):HIP 后端把 CUDA 的 `nvcuda::wmma`
fragment/mma_sync API 映射到它之上(`c/backend_gpu_compat.h`),这让同一份 .cu 源码可以为
两家厂商编译。
## 许可证
Apache 2.0,Copyright 2026 Vincenzo Fornaro。详见 [LICENSE](LICENSE) 与 [NOTICE](NOTICE)。每个模型保留其作者给出的许可证(GLM-5.2 权重由 Z.ai 以 MIT 许可发布;Qwen-Image-2.1 仅限非商业用途)。