-windows-x86_64-cuda.zip` 包含 `coli_cuda.dll`(compute capability 8.0 以上的顯示卡)以及載入它的 colibri、qwen36 與 kimi_k3 引擎,還有 DeepSeek V4 的 CUDA DLL。把它解壓到主壓縮檔之上,安裝程式就會選擇 CUDA。
- **所有層都在顯示卡上**(Qwen3.6、Qwen3.8 與 OLMoE):稠密層、注意力以及顯示卡持有的路由專家作為一條鏈執行,顯示卡不持有的專家在 CPU 上執行。在 RTX PRO 4000 上,Qwen3.6-35B-A3B UD-Q4_K_M 的解碼速度為 104.8 tok/s,讀取提示詞為 3,491,OLMoE 為 354.6 與 10,418([表格](#three-backends-on-one-machine))。
- **每個引擎都有顯示卡上的路由專家層級**(`cu_tier.h`),DeepSeek V4、V4.1、Kimi K3、GLM-5.3 與 MiMo 的稠密矩陣也放在顯示卡上(`cu_dense.h`)。
- **GGUF 的區塊在顯示卡上**(`cuda_bd.cuh`):每種 32 個權重以上的 ggml 區塊類型,每一列都保持檔案中的樣子;提示詞經過張量核心([gguf.md](docs/gguf.md))。
- **VRAM 專家層級**把最熱門的專家放在顯示卡上,依據實測的路由挑選;
未命中的專家則同時在 CPU 上計算。Qwen3.6 在兩張
8 GB 顯示卡(RTX 3070 與 Quadro RTX 4000)上,使用已預熱的路由歷史時解碼 11.3 tok/s
([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md));GLM-5.2 在六張
RTX 5090 上、所有專家常駐時為 9.0-9.2 tok/s
([benchmarks.md](docs/benchmarks.md));DeepSeek V4 Flash 在一張 RTX 5080 上為
1.5-1.6 tok/s,3,324 個 token 的提示在 90 秒內處理完
([deepseek-v4.md](docs/deepseek-v4.md))。
- **Qwen3.6 新功能:DeltaNet 層放在顯示卡上**(`Q36_DN_GPU=1`,
需手動開啟)。過去 Qwen3.6 的 30 個 DeltaNet 層,每一層在每個 token 都要在顯示卡和
CPU 之間複製四次資料;現在解碼時,一個 token 會在顯示卡上執行整個層,
其循環狀態保留在 VRAM 中。在稠密層位於 VRAM 的 RTX 3070 上:
從 25.4 提升到 30.0 tok/s
([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md#the-deltanet-layer-on-the-card-q36_dn_gpu1))。
- **較舊的顯示卡**。如果 CUDA toolkit 已不再支援為你的顯示卡編譯(例如
[#1852](https://github.com/JustVugg/colibri/issues/1852) 中的 CUDA 13 與 V100),
安裝程式會在建置之前就先發現,並說明原因,轉而透過 Vulkan 使用這張顯示卡;
安裝 CUDA 12.x toolkit 可以讓 CUDA 路徑恢復。
DeepSeek V4 的 CUDA 層級也可以為 Pascal 與 Turing 建置
(`CUDA_ARCH=portable-pre-ampere NO_TC=1`)。
完整說明:[docs/cuda.md](docs/cuda.md)。
### Apple Silicon
Metal 後端會為多個引擎在統一記憶體 GPU 上執行專家運算([docs/metal.md](docs/metal.md))。
版本的 macOS 壓縮檔中,`colibri`、`inkling` 與 `kimi_k3` 已用 Metal 建置:
`COLI_METAL=1`(Kimi K3 用 `K3_METAL=1`)開啟它,不設定時在 CPU 上執行。
從原始碼建置請用 `METAL=1`;一步安裝會建置 CPU 版本。
## System One:附帶機率的決策
人們要求模型做的事,大多是一次選擇,而不是一段文字:哪個佇列、哪個結論、是或否。
`POST /v1/systemone` 接收一個狀態(文字或 JSON)與帶型別的問題,
並為每個問題回答每個允許選項的機率以及一個信心值。整個過程不生成任何內容,
所以答案不可能落在你的清單之外,而「模型沒有把握」就成了一個可以設定門檻的數字。
```bash
curl -s http://127.0.0.1:8000/v1/systemone -H 'Content-Type: application/json' -d '{
"state": "340 lines, 8 files, no tests. CI is green but nothing covers that path.",
"questions": {
"review": {"type": "choice", "instructions": "What should the reviewer do?",
"criteria": {"merge": null, "request changes": null, "close": null}},
"risky": {"type": "noul", "instructions": "Is this change risky?"}}}'
```
`choice` 會傳回所選的標籤、每個標籤的機率,以及從 0(完全平均)到 1(完全確定)的
`confidence`;`noul` 傳回「是」的機率;
`score` 傳回期望等級。
由誰回答:
- **colibri 能執行的任何聊天模型**,透過評分:它讀出每個選項的機率,
而不是寫出一個答案。針對同一份文件的多個問題只會讀取文件一次:在 Qwen3.6 上,
針對同一份文件的四個問題,比在同一台 CPU 機器上生成相同答案快 5.7 倍。
- **三個決策模型**,原生支援,一次前向傳遞即可完成,並使用其作者擬合的校準:
[Laya](docs/laya.md)(Convai Innovations)、
[GLiNER2.5-Decide](docs/gliner_decide.md)(fastino)與 [Clef](docs/clef.md)
(Cloudflare;它也能聊天)。它們的大小與速度,
列在[決策模型表格](#which-model-for-my-machine)中。
**從 Jev 切換過來**。請求與回覆格式與 TypeSafe 的 Jev API 相同,
所以 Jev 用戶端只需要更改 base URL,其他什麼都不用改,就能切換到 colibri:
`TYPESAFE_BASE_URL=http://127.0.0.1:8000`(未設定 `COLI_API_KEY` 而啟動的伺服器,
會接受它原本就會傳送的金鑰)。兩個官方 SDK 在未經修改的情況下,
都已針對 `coli serve` 測試過。
同樣的模式也可以在終端機中使用(`coli chat` 中的 `/decide merge | request changes | close`),
以及儀表板的 System One 頁面。完整的請求與回覆格式、評分規則,以及它幫不上忙的情況:
[docs/systemone.md](docs/systemone.md)。
## 儀表板
`coli web` 會開啟它,一步安裝也會:包含聊天、System One 頁面、
大腦(Brain)與效能剖析(Profiling)頁面,提供淺色與深色主題。
### 新的聊天介面
`coli ui` 會在執行中的 `coli serve` 旁開啟新的聊天介面:推理有自己的區塊,具備視覺塔的模型可以看圖片,還有網頁搜尋、專家地圖、即時監視器,以及已指向 colibri 的程式設計代理。支援七種語言。請見 [ui/README.md](ui/README.md)。
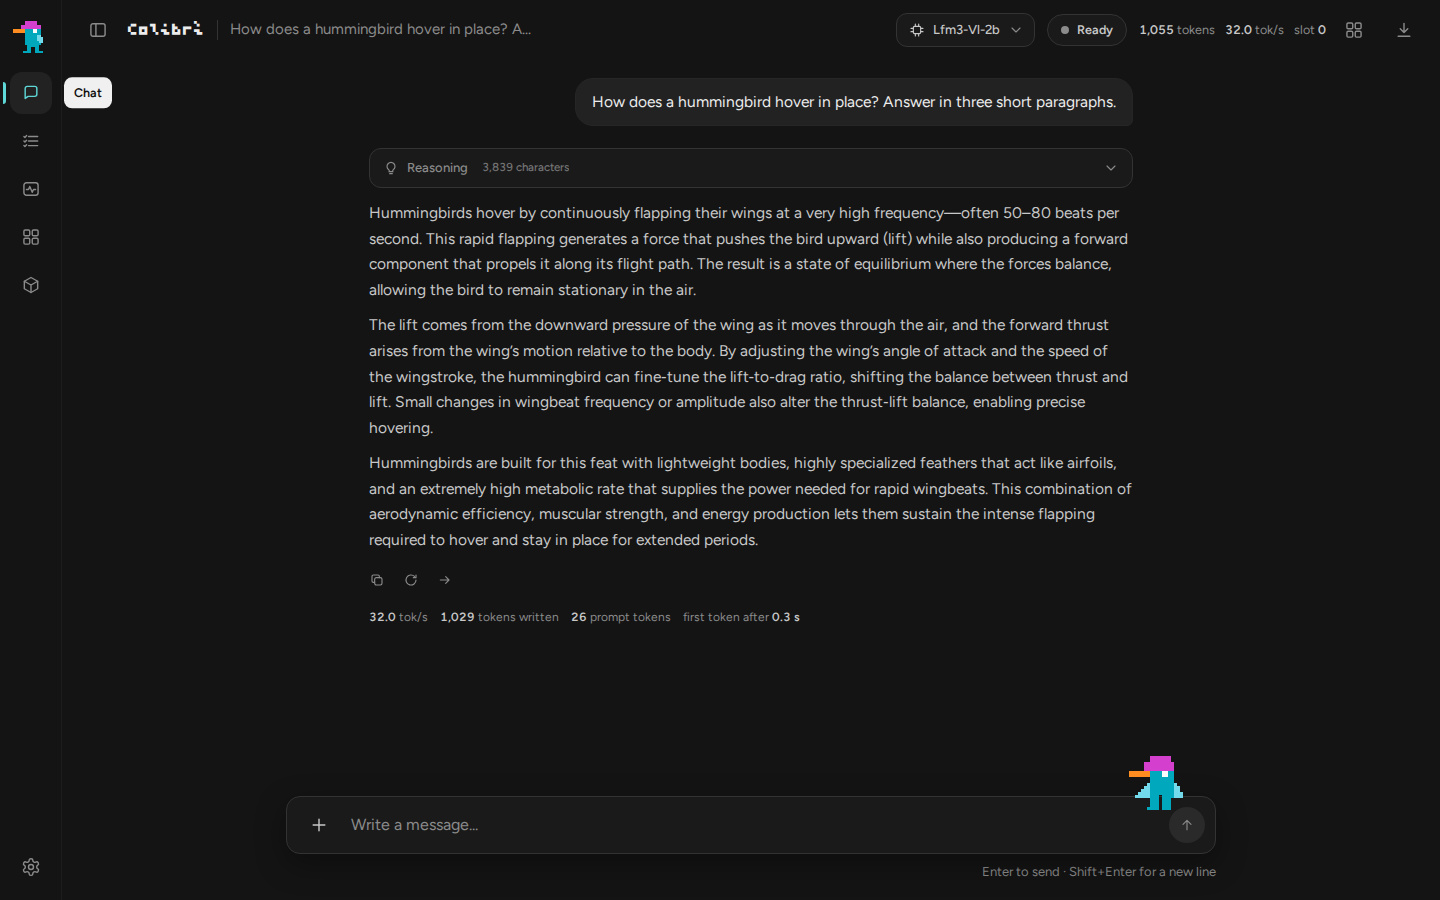
LFM3-VL-2B 在 i5-13500 的 CPU 上,32 tok/s。
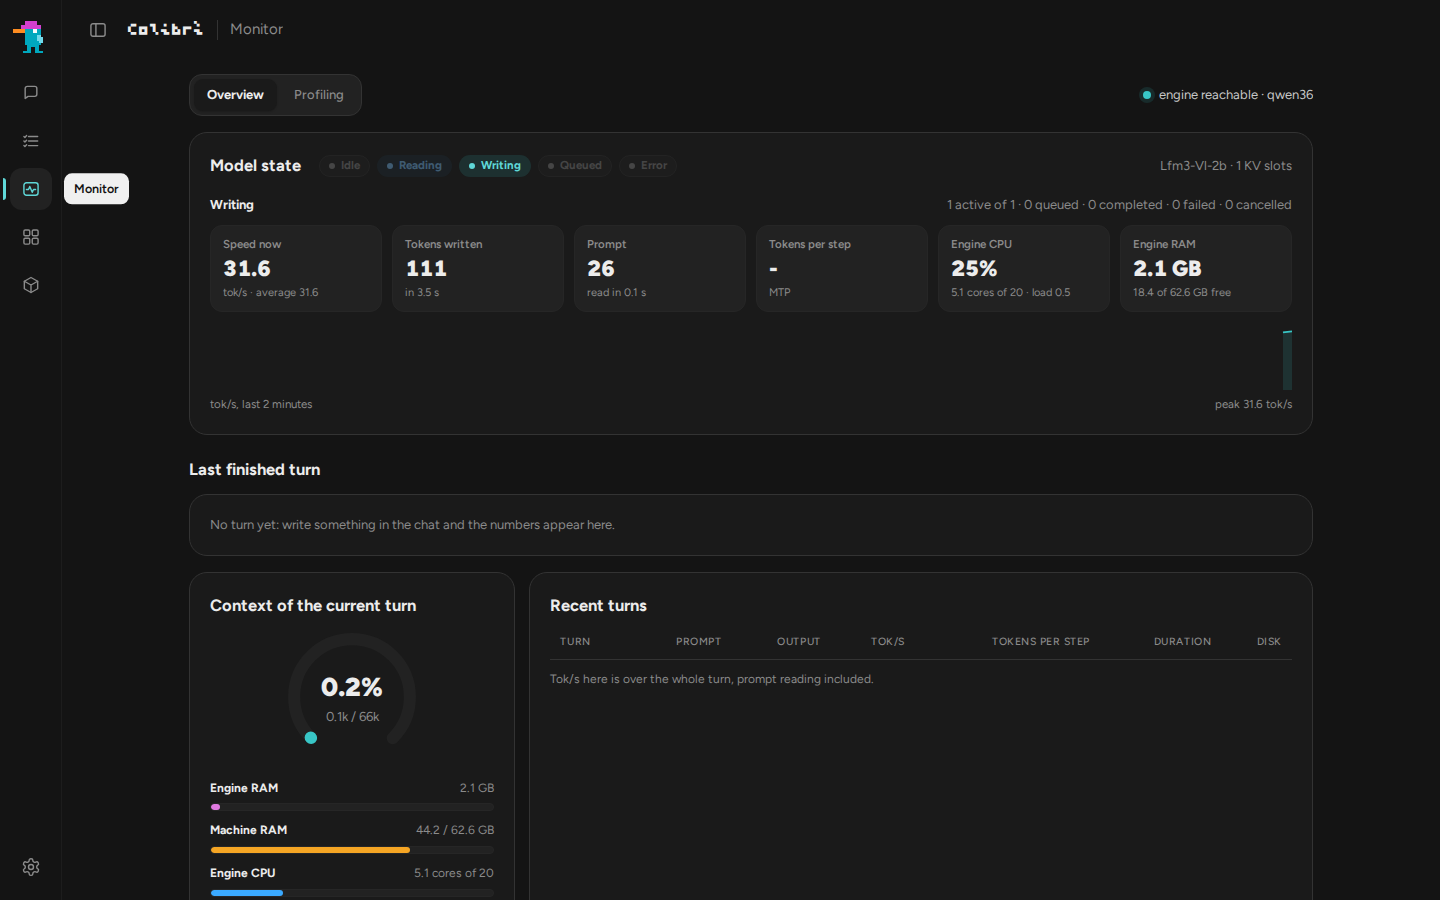
LFM3-VL-2B 寫作時的監視器:31.6 tok/s,提示詞 0.1 秒讀完,記憶體 2.1 GB。
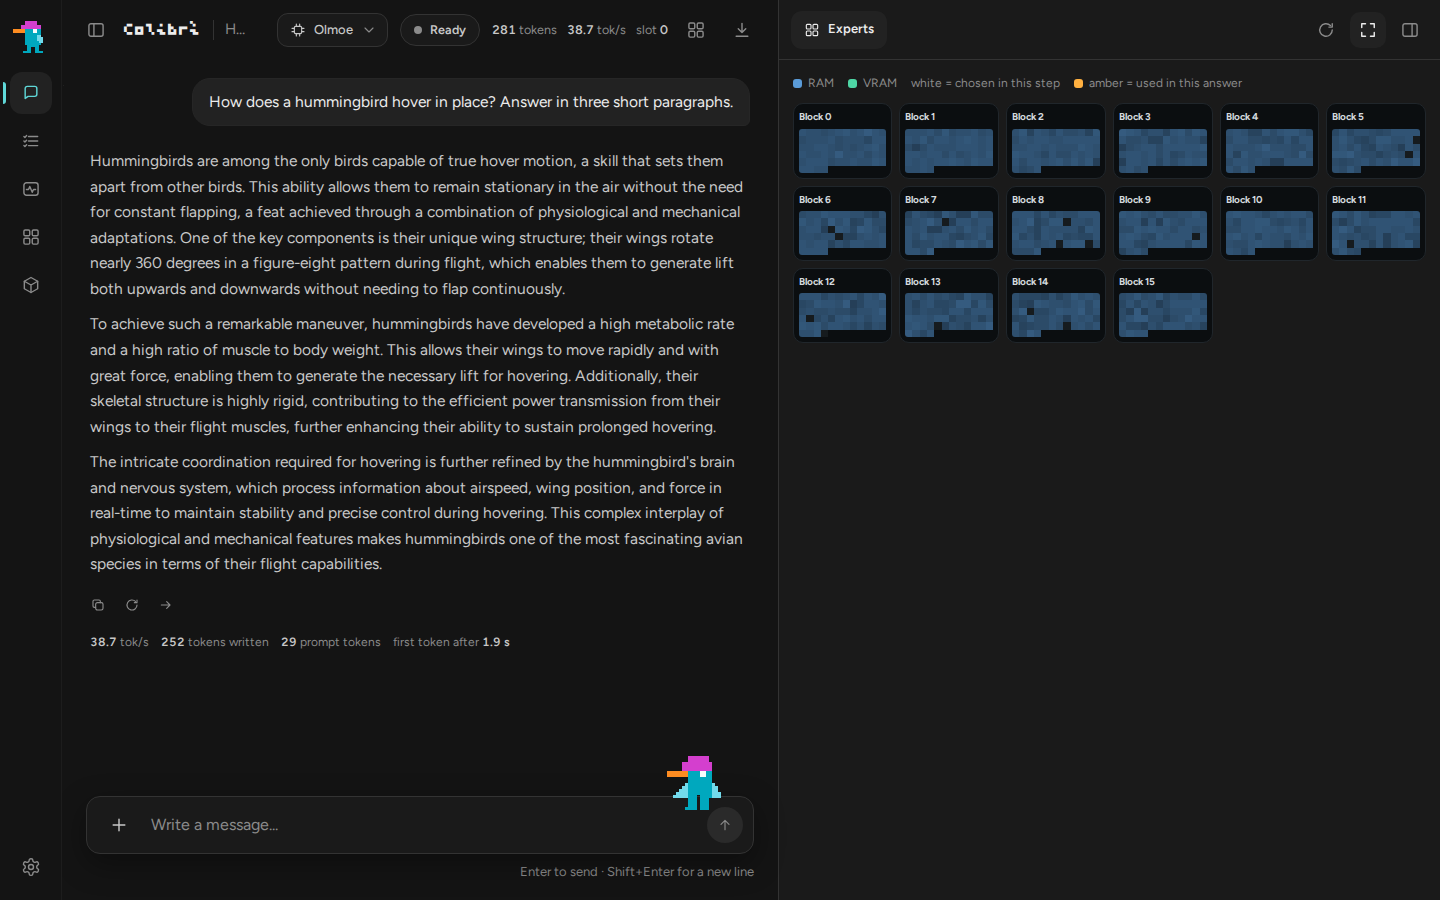
OLMoE 在聊天旁開啟專家地圖:每個區塊中每個專家一格,本步選中的為白色,本次回答用到的為琥珀色。
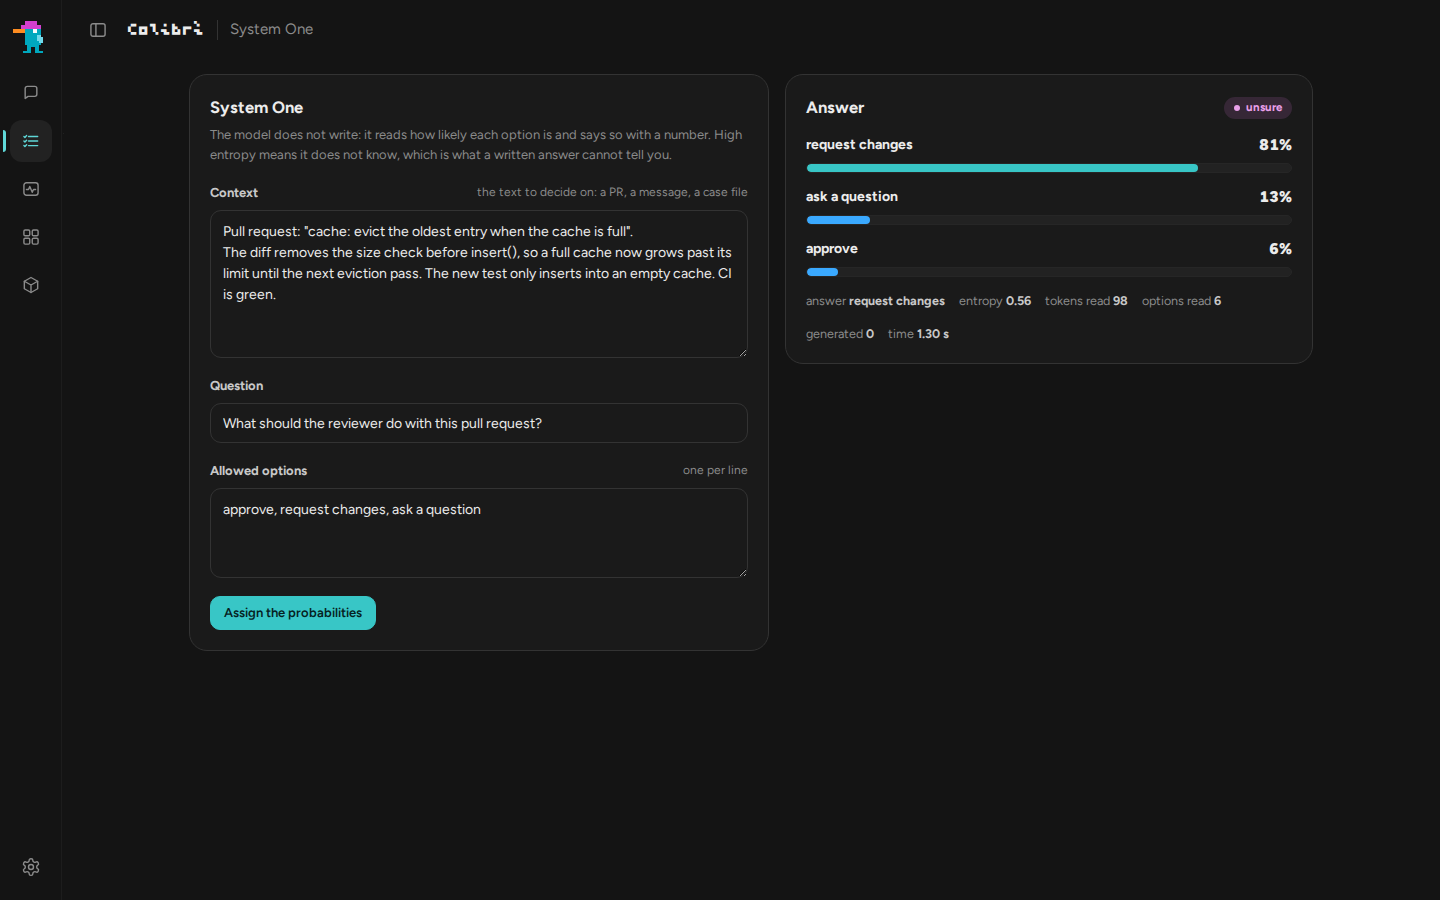
System One:給模型一份文件,以及它唯一可以選擇的幾個答案。圖中 RTX PRO 4000 上的 Qwen3.6-35B 讀取一個破壞快取大小上限的拉取請求:
request changes 為 81%,熵 0.56(不確定),讀取 98 個 token,生成 0 個。
**效能剖析**(Profiling)頁面顯示每一輪的時間花在哪裡,逐階段劃分,
並以最近 30 輪呈現趨勢。
## 從其他應用程式使用
`coli serve`(安裝程式會替你啟動它)是一個同時提供多種 API 的伺服器:
- **相容 OpenAI**:`/v1/chat/completions`、`/v1/completions` 與
`/v1/models`,支援串流、JSON 回覆、停止序列與 logprobs;
- **相容 Anthropic**:`/v1/messages`,因此 Claude Code 與 Anthropic
SDK 都能直接連上它;
- **工具呼叫**:除了 Inkling 與 OLMoE 之外的所有聊天引擎都支援,各自使用其模型的原生格式
([各引擎對照表](docs/api.md#tool-calling-support));
- **圖片輸入**:支援 GLM-5.3-Flash、DeepSeek V4.1 Flash、MiMo-V2.6、
Qwen3.8-Flash-Next、Qwen3.8-27B、LFM3-VL 與 Mistral-Large-4(來自 GGUF 時,
把 `mmproj` 檔案放在旁邊),可以是 `coli chat` 訊息中的路徑、`coli web` 或
`coli ui` 中的附件,或是一個 `image_url` 部分;
- **圖片輸出**:使用 Qwen-Image-2.1,透過 `POST /v1/images/generations` 提供,
`coli chat` 也會直接在終端機中繪出圖片
([qwen-image.md](docs/qwen-image.md));
- **決策**:透過 `POST /v1/systemone` 提供([見上文](#system-one-a-decision-with-a-probability))。
- **同時進行多個對話**:在每個文字引擎上,`coli serve --kv-slots N` 最多保留 16 個對話,
每個都有自己的快取,並把它們的下一個 token 一起解碼([api.md](docs/api.md#isolated-kv-contexts))。
程式設計 CLI 與編輯器的連線方式,就和連接任何相容 OpenAI 的服務供應商一樣:base URL 設為
`http://127.0.0.1:8000/v1`,模型 id 使用 `coli status` 印出的值,金鑰可填任何非空字串
([docs/api.md](docs/api.md#connect-a-coding-cli-or-editor))。
## 運作原理
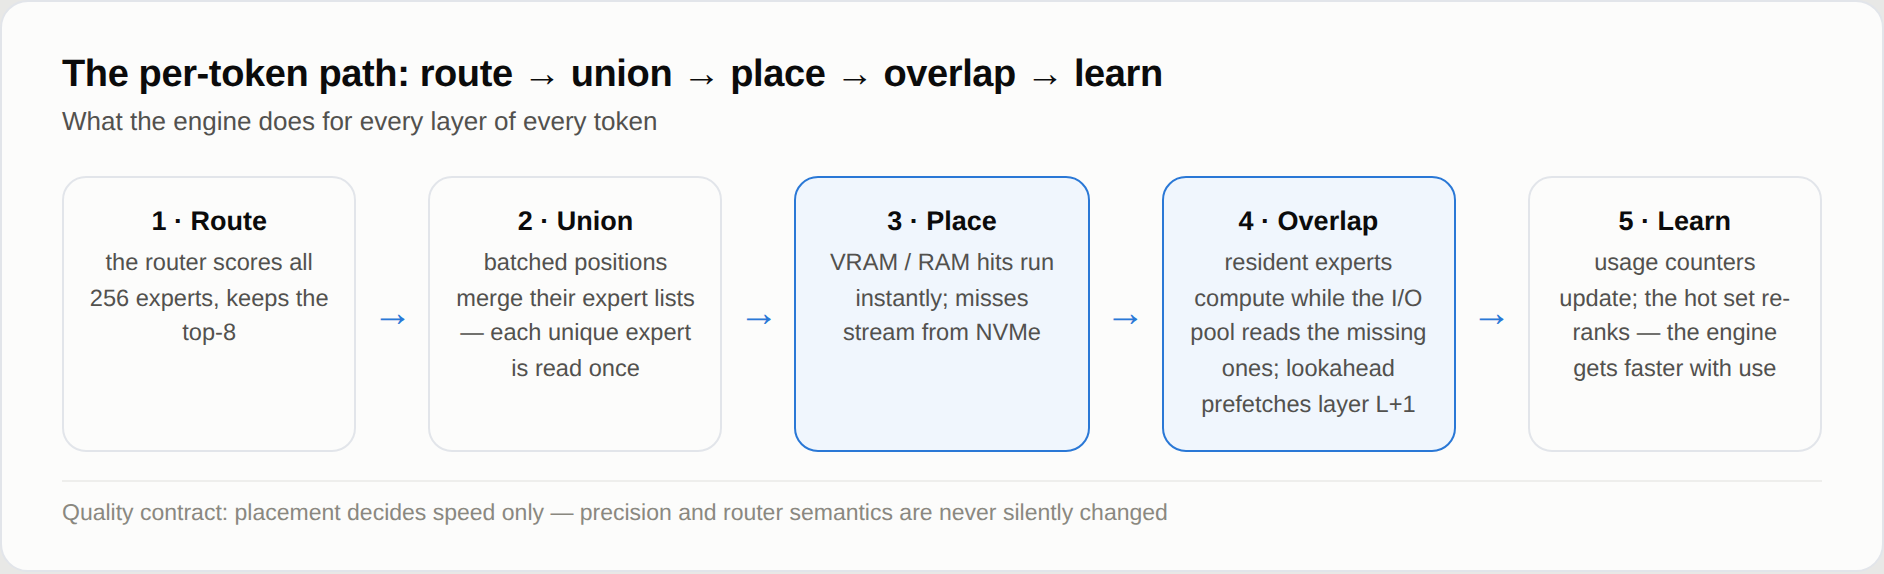
每個 token 的每一層都走過相同的五個步驟:路由、聯集、配置、重疊、學習。
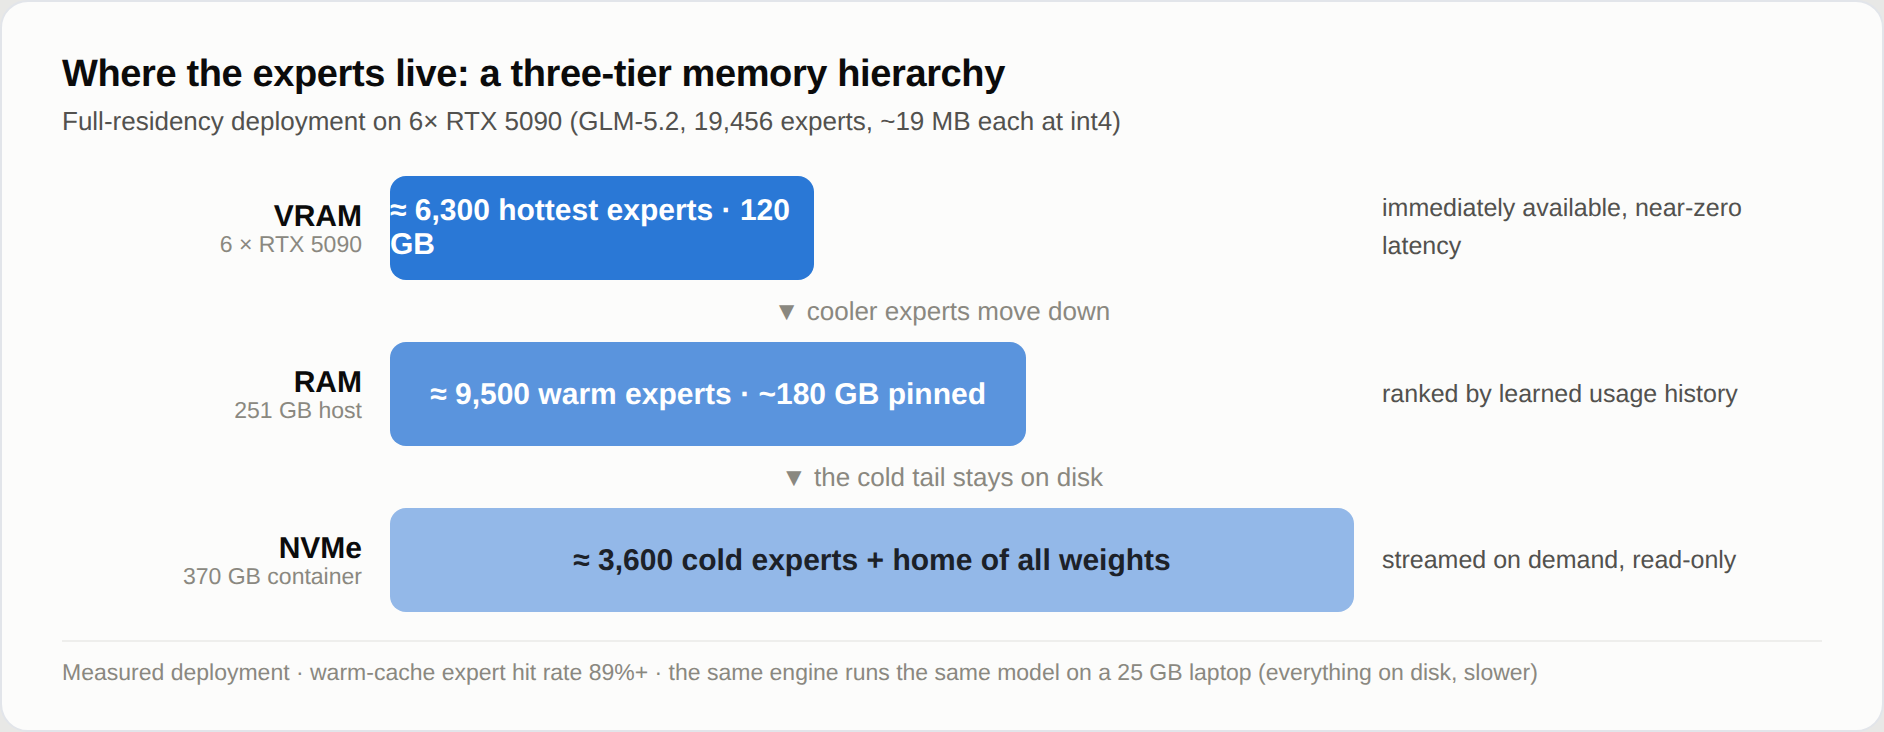
設計目標是讓**配置只決定速度**:
無論專家是從 VRAM、RAM 還是硬碟回應,路由器的決策與權重的精度都完全相同。
- **權重的 JIT**。編譯器的 JIT 從不編譯整個程式:
它觀察實際執行的部分,只編譯熱點路徑。colibri 對權重下了同樣的賭注。
實測的路由熱度決定哪些專家能放進 VRAM、RAM,或是留在硬碟:
一個逐層的 LRU 快取,加上一組從你自己的對話中學到的固定熱門專家
(`.coli_usage`,每一輪都會更新)。colibri 越用越快。
之所以可行,是因為路由具有可測量的結構
([專家圖譜](https://github.com/JustVugg/colibri/issues/175))。
- **絕不為硬碟等待兩次**。一個專家的三個矩陣以一次
`pread` 讀取;一組載入器在常駐專家運算的同時讀取缺少的專家;
一批位置對每個專家只讀取一次;路由前瞻執行緒可以預先載入下一層
(GLM-5.2 的路由在提前一層時有 71.6% 可預測)。`DIRECT=1`(O_DIRECT)在快速的 NVMe 硬碟上往往有很大的收益,
在其他硬碟上則沒有差別甚至更慢:請在你自己的硬碟上實測([tuning.md](docs/tuning.md))。
- **不只一顆 SSD**。`COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat --model /fast/glm52_i4`
會同時從第二顆硬碟上的副本讀取。兩顆位於獨立控制器上的
NVMe 硬碟實測解碼 +37.5%;放在較小硬碟上的部分鏡像也可以使用
([multidisk.md](docs/multidisk.md))。
- **從筆電到機架**。在 25 GB 的筆電上,每個專家都從硬碟串流讀取,
慢但正確;在大型主機上,所有專家都常駐
(`CUDA_EXPERT_GB=auto PIN_GB=all`),硬碟完全退出解碼過程。
`COLI_NUMA=1` 會把常駐權重分散到多插槽主機的各個記憶體控制器上,
而本機叢集模式則可以在其他機器上執行路由專家([cluster.md](docs/cluster.md))。
- **忠實的模型**。每個引擎都會在 CI 中,以一個微型 fixture 與其模型的參考實作對照檢查。
GLM-5.2 的 MLA 注意力保存壓縮後的 KV 狀態
(每個 token 576 個浮點數,而非 32,768 個,小 57 倍),而且重新啟動後依然保留,
因此重新開啟對話時,不需要再讀一次提示。
- **值得才啟用的推測解碼**。GLM-5.2 的 int8 MTP head 在划算時,
每次前向傳遞可起草 2.2-2.8 個 token;Qwen3.8-Flash-Next 的 MTP head 預設開啟,
在輸出完全相同的情況下提升 16-20%;提示詞查找在程式碼編輯上提升 6-7%。Qwen3.6 的 head
(`Q36_MTP=1`)把解碼速度在 CUDA 上從 99.7-104.5 提高到 115.8-120.1 tok/s,在 Vulkan 上從
83.2-83.8 提高到 99.9-109.3(一張 RTX PRO 4000)。DeepSeek V4.1 的 DSpark head 依其信心
決定起草深度,並由一道關卡略過無法回本的草稿。在起草的成本高於節省的地方(DeepSeek V4),
它保持關閉([speculative.md](docs/speculative.md)、[tuning.md](docs/tuning.md#speculation-and-reproducibility))。
引擎由每個模型家族各一個 C 檔案組成(GLM-5.2 為 `c/colibri.c`),
建立在共用的標頭檔之上,執行階段不需要 BLAS,也不需要 Python:
Python 只用於安裝程式、啟動器、轉換工具與 API gateway。
## 基準測試
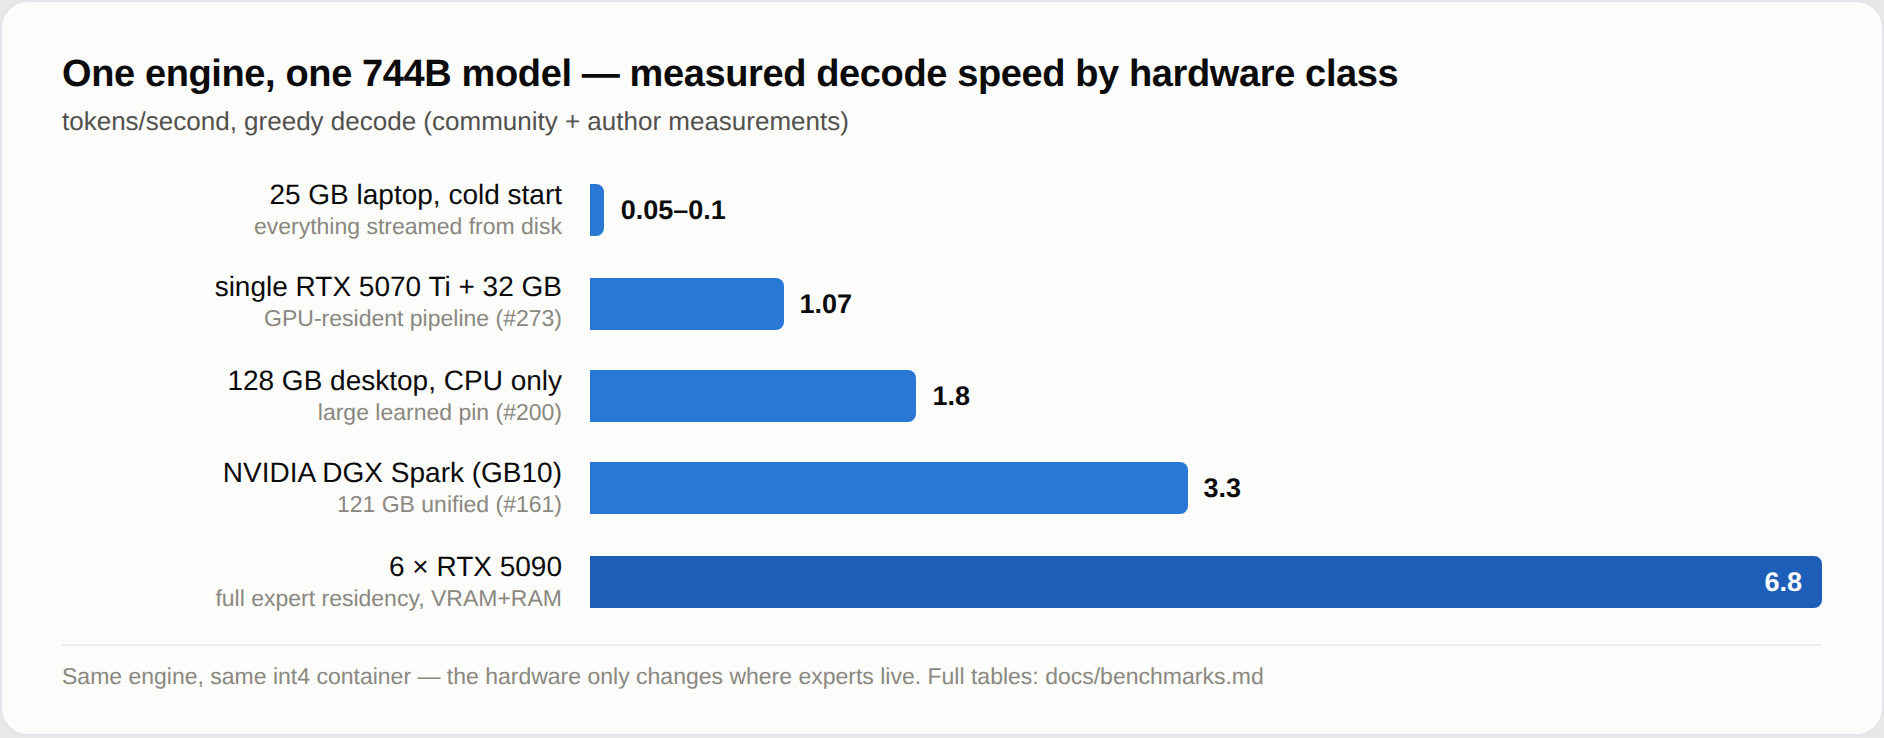
同一套引擎、同一個 int4 容器:硬體只會改變專家存放的位置。
GLM-5.2 的解碼速度,取自[完整表格](docs/benchmarks.md):
- **6x RTX 5090,所有專家常駐**:5.8-6.8 tok/s,使用選擇性
NUMA 交錯時為 9.0-9.2([實驗紀錄](docs/experiments/glm52-6x5090-2026-07-12.md));
- **128 GB,僅用 CPU**(Ryzen AI Max+ 395):暖機後 1.83 tok/s
([#200](https://github.com/JustVugg/colibri/issues/200));
- **一台搭載單張 RTX 5070 Ti 的筆電級電腦**:1.07 tok/s
([#273](https://github.com/JustVugg/colibri/issues/273));
- **這個專案起步時的那台 25 GB 筆電**:冷啟動 0.05-0.1 tok/s,
這是如實呈現的下限。
### 一台機器上的三種後端
一台 i5-13500,62 GB 記憶體,一張 RTX PRO 4000 Blackwell SFF(24 GB,70 W),每個模型由 `coli serve` 提供服務:一個新的 450 token 提示詞,然後串流輸出 128 token 的回答,包含請求的 HTTP;取兩次執行中較好的一次,單位 tok/s。
| GGUF | CUDA 提示詞 | CUDA 解碼 | Vulkan 提示詞 | Vulkan 解碼 | CPU 提示詞 | CPU 解碼 |
|---|---:|---:|---:|---:|---:|---:|
| Qwen3.6-35B-A3B UD-Q4_K_M | 3,491 | 104.8 | 2,076 | 92.9 | 122.6 | 13.9 |
| LFM3-VL-2B Q4_K_M | 12,317 | 235.1 | 8,174 | 214.1 | 286.5 | 34.5 |
| OLMoE-1B-7B-0125-Instruct Q4_K_M | 10,418 | 354.6 | 6,867 | 299.4 | 279.9 | 47.4 |
| LFM3-VL-2B F16 | 11,524 | 103.4 | 7,767 | 99.3 | 49.7 | 6.4 |
| Qwen3.8-Flash-Next IQ2_XS(68 GB:顯示卡放不下的專家留在記憶體中) | 217.1 | 51.4 | 214.3 | 50.6 | 38.3 | 9.3 |
### 同一台機器上的大模型
仍是機器 D,每個模型都從已發布的 GGUF 透過 `coli serve` 執行:顯示卡與記憶體都放不下的部分來自兩顆 NVMe。單位為每秒 token 數,取自各模型的頁面:
| GGUF | 大小 | 後端 | 提示詞 | 解碼 |
|---|---:|---|---:|---:|
| Inkling-Small UD-IQ2_XXS | 77 GB | Vulkan | 15.1-33.1 | 10.92-11.53 ([vulkan.md](docs/vulkan.md)) |
| MiMo-V2.6-Flash Q2_K_S | 106 GB | Vulkan | 8.2 | 7.8 ([gguf.md](docs/gguf.md)) |
| DeepSeek V4 Flash 0731 UD-IQ2_XXS | 85 GB | Vulkan | 19.7-20.4 | 6.18-6.25 ([vulkan.md](docs/vulkan.md)) |
| DeepSeek V4.1 Flash UD-IQ1_S | | Vulkan | 3,403 個 token 時 31.8 | 5.01-5.29 ([deepseek-v41.md](docs/deepseek-v41.md)) |
| GLM-5.3-Flash UD-IQ2_XXS | 95 GB | Vulkan | 9.3 | 2.92-3.40 ([vulkan.md](docs/vulkan.md)) |
| Muse Spark Open UD-IQ1_S | 176 GB | Vulkan | 5.0-5.3 | 1.55-1.58 ([qwen36.md](docs/qwen36.md#muse-spark-open)) |
| Mistral-Large-4 UD-IQ1_S | 233 GB | CUDA | 240 個 token 耗時 66-82 秒 | 1.34-1.36 ([mistral-large4.md](docs/mistral-large4.md)) |
| GLM-5.2 UD-IQ1_S | 202 GB | Vulkan | | 0.633-0.658 ([gguf.md](docs/gguf.md)) |
| Kimi K3 UD-IQ1_S | 594 GB | Vulkan | 31 個 token 耗時 46.5 秒 | 0.349 ([gguf.md](docs/gguf.md)) |
### 長上下文與智慧代理
- **以 64k 的速度執行 256k 上下文。** 機器 D 的 CUDA 鏈上執行 Qwen3.8-Flash-Next IQ2_XS,上下文 262,144 token:提示詞 15.6 -> 149 tok/s,解碼 9.6 -> 45.7(記憶體規劃按一個提示詞分段,K/V 在顯示卡上用 float16;在 65,536 時讀取 188,解碼 48.4)([qwen38.md](docs/qwen38.md))。
- **智慧代理的每一輪只讀取新內容。** 兩輪之間的短請求(代理詢問對話標題)會把對話暫存起來,而不是佔用它的狀態,所有引擎都如此(`COLI_PARK`)。Qwen3.8-Flash-Next 上 Hermes Agent 的第二輪,14,810 個 token:86 秒 -> 4.9 秒([qwen38.md](docs/qwen38.md#an-agents-turns))。
- **float16 的 KV 快取**:GLM-5.3 在 131,072 個 token 時佔用 11.9 GB,而不是 23.9 GB([CHANGELOG](CHANGELOG.md))。
品質是測量出來的,而不是假設的:int4 容器的代價與量化消融實驗收錄在
[benchmarks.md](docs/benchmarks.md#quality-benchmark) 中。若要加入你的機器,
請依照[基準測試規範](docs/benchmarking.md),並開一個附上數據的 issue。
## 手動安裝
**1. 程式**。從 [Releases](https://github.com/JustVugg/colibri/releases)
下載適用你平台的壓縮檔(Linux x86_64、macOS、Windows;不需要編譯器,
只需要供啟動器與 API 使用的 [Python 3](https://www.python.org/downloads/)),
解壓縮後執行 `python3 coli info`。Linux 與 Windows 的引擎內建 Vulkan(`shaders/` 就在旁邊),
macOS 的引擎內建 Metal;在 Windows 上使用 NVIDIA 顯示卡時,再加上 CUDA 壓縮檔。或者使用 `gcc`(或 clang)與 OpenMP 從原始碼建置:
```bash
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh # checks gcc/OpenMP, builds, self-tests
make qwen36 VK=1 # one engine, here with Vulkan (CUDA=1 for CUDA)
```
**2. 模型**。[上方表格](#which-model-for-my-machine)中的任何一個下載皆可:
安裝程式的 id 對應到 Hugging Face 儲存庫,每個模型的頁面都有下載與轉換指令。
GLM-5.2 請使用帶 int8 MTP head 的 group-scaled(gs64)容器
[`mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp`](https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp)
(429 GB),GLM-5.3 則使用 [`Justvugg/GLM-5.3-colibri-int4-g64`](https://huggingface.co/Justvugg/GLM-5.3-colibri-int4-g64)
(419 GB,不含 MTP head)。不要使用較舊的 per-row int4 鏡像:
它們的品質實測差了約 9 個百分點,而且正是
[#455](https://github.com/JustVugg/colibri/issues/455) 中回答不斷循環的原因。
`./coli convert --model /nvme/glm52_i4` 會從 FP8 發布版本逐 shard 建置相同的容器,
任何時候都不需要在硬碟上同時存放完整的 756 GB。如何檢查 MTP head 及其他項目:
[quickstart.md](docs/quickstart.md#3-get-the-model)。已有的 GGUF 不需要轉換:對它的第一個檔案執行 `./coli import`([見上文](#from-a-gguf))。
**3. 執行**。在原始碼 checkout 的 `c/` 目錄中,或在解壓縮後的發布版本中執行。
啟動器會讀取模型的 `config.json`,選出對應的引擎及其聊天範本,
因此每個模型的指令都相同:
```bash
./coli chat --model /nvme/qwen36 # chat in the terminal
./coli web --model /nvme/qwen36 # API + dashboard, opens a browser
./coli serve --model /nvme/qwen36 # API + dashboard, no browser
./coli plan --model /nvme/qwen36 # where the model will live: VRAM, RAM, disk
./coli doctor --model /nvme/qwen36 # read-only check: is everything ready?
./coli tune --model /nvme/qwen36 # measure and save this machine's fastest safe settings
./coli import /nvme/Flint-UD-Q4_K_XL.gguf # a GGUF: writes Flint-UD-Q4_K_XL.colibri next to it
./coli ui # the chat UI, next to a running coli serve
```
在 Windows 上,發布壓縮檔附有 `coli.cmd`(`coli.cmd chat --model D:\qwen36`);
在原始碼 checkout 中請使用 `py -3 c\coli`。`.exe` 檔案是引擎,不是啟動器。
所有選項與變數:
[SETTINGS.md](docs/SETTINGS.md)、[ENVIRONMENT.md](docs/ENVIRONMENT.md)。
## 研究,以及如何幫忙
colibri 希望讓前沿模型減少對稀缺硬體的依賴,並降低執行成本。
這代表要改變權重的儲存與搬移方式、決定哪些內容放在 VRAM、RAM 或儲存裝置、
讓 CPU 與 GPU 的工作重疊,並測試新的解碼方法。沒有任何做法會因為是慣例就被保留,
也沒有任何做法會因為微基準測試看起來很快就被採用:決定性的結果是真實機器上的端到端推論,
並且同時測量品質與速度。目前的開放問題:
| 假設 | 目前的證據 | 仍需要的實驗 |
|---|---|---|
| 路由歷史能比單純的 LRU 更好地配置專家 | 學習得來的固定專家能改善重複性的工作負載,但可能對某個提示過度擬合 | 在程式設計、聊天、多語言與長上下文工作負載上,進行留出資料、跨工作階段的 A/B |
| 多顆 SSD 能把獨立的頻寬轉化為解碼速度 | 兩顆獨立的 NVMe 硬碟實測解碼 +37.5%;經過加權條帶化後,較慢的第三顆硬碟沒有帶來差異([測量數據](docs/multidisk.md#what-has-been-measured)) | 在不同的硬碟速度、控制器配置與快取狀態下重現 |
| 感知硬體的規劃器能自動接近每台機器的最佳配置 | 目前已能偵測 RAM/VRAM 預算與多種後端,並由安裝程式選擇建置方式 | 在筆電、工作站、NUMA 主機與多 GPU 系統上,將產生的方案與受控的參數掃描進行比較 |
| 無損或品質受控的表示法能減少權重搬移,而且減少得足以產生實際差異 | 已有格式與量化的消融實驗,並設有正確性/品質門檻 | 同時重現品質、搬移的位元組數、延遲與每個有效 token 的成本,而不只看壓縮率 |
| 感知路由的推測解碼能在接近完全常駐之前就帶來收益 | MTP 與文法草稿可以運作,但 MTP 也曾在專家命中率約 85% 時實測出 32% 的損失 | 繪製接受率、專家命中率、批次聯集與草稿深度之間的損益平衡面 |
| CPU/GPU 重疊能隱藏傳輸與同步的成本,而不只是轉移瓶頸 | CUDA、Metal 與 Vulkan 都有成功的數據,但快速的 CPU、內建顯示晶片與低常駐率可能抵消這些收益 | 在 PCIe、統一記憶體與完全常駐的機器上進行逐階段剖析與單一變數 A/B,以及在已測的那一張(RTX PRO 4000)之外取得更多獨立顯示卡上 Vulkan 層級與稠密鏈的數據 |
想幫忙嗎?挑選其中一列,負面結果也請一併公開。請記錄硬體、commit、模型、
確切的指令、提示、快取狀態、吞吐量、首個 token 的時間、專家命中率、
讀取的位元組數與一項品質檢查;每次只改變一個變數,重複執行,並附上原始日誌。
請先閱讀 [CONTRIBUTING.md](CONTRIBUTING.md) 與[基準測試規範](docs/benchmarking.md),
然後[開一個 issue](https://github.com/JustVugg/colibri/issues/new)。
在這裡,一個控制良好的失敗,比一個無法解釋的快速數字更有價值。
## 文件
| 主題 | 文件 |
|---|---|
| 一步安裝與手動安裝,涵蓋所有平台 | [quickstart.md](docs/quickstart.md) |
| 透過 AI 助手安裝,以及 MCP 伺服器 | [AI_SETUP.md](docs/AI_SETUP.md)、[MCP_SERVER.md](docs/MCP_SERVER.md) |
| API:OpenAI、Anthropic、工具、KV slots、儀表板 | [api.md](docs/api.md) |
| System One 與決策模型 | [systemone.md](docs/systemone.md)、[laya.md](docs/laya.md)、[gliner_decide.md](docs/gliner_decide.md)、[clef.md](docs/clef.md) |
| GGUF 檔案:支援的架構、兩種模式、各引擎如何處理這些區塊 | [gguf.md](docs/gguf.md) |
| Qwen3.6 引擎上的模型(Flint、Muse Spark Open、LFM3-VL)與 Mistral-Large-4 | [qwen36.md](docs/qwen36.md)、[mistral-large4.md](docs/mistral-large4.md) |
| 聊天介面(`coli ui`) | [ui/README.md](ui/README.md) |
| Vulkan:專家層級、稠密鏈、沒有 Resizable BAR 的顯示卡 | [vulkan.md](docs/vulkan.md) |
| CUDA,以及 Qwen3.6 的 CUDA 層級 | [cuda.md](docs/cuda.md)、[qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md) |
| Apple Silicon、Windows | [metal.md](docs/metal.md)、[windows.md](docs/windows.md) |
| 調校、學習型快取、預先載入、推測解碼 | [tuning.md](docs/tuning.md) |
| 推測解碼:MTP head、提示詞查找、關卡 | [speculative.md](docs/speculative.md) |
| 多顆 SSD、多台機器 | [multidisk.md](docs/multidisk.md)、[cluster.md](docs/cluster.md) |
| 基準測試與測量方法 | [benchmarks.md](docs/benchmarks.md)、[benchmarking.md](docs/benchmarking.md) |
| 所有選項與環境變數 | [SETTINGS.md](docs/SETTINGS.md)、[ENVIRONMENT.md](docs/ENVIRONMENT.md) |
| 文法強制草稿,以及供其他程式嵌入引擎的實驗性 ABI | [grammar-draft.md](docs/grammar-draft.md)、[segment-runtime.md](docs/segment-runtime.md)、[edge-runtime.md](docs/edge-runtime.md) |
## 儲存庫結構
```
start-here.sh, START-HERE.bat the one-step setup (Linux and macOS, Windows)
Makefile root build/check entry point
c/
├── colibri.c GLM-5.2/5.3, Mistral-Large-4 (make glm)
├── glm53.c GLM-5.3-Flash (make glm53)
├── inkling.c Inkling (make inkling)
├── kimi_k3.c Kimi K3 (make kimi_k3)
├── deepseek_v4.c DeepSeek V4 Flash (make deepseek-v4)
├── deepseek_v41.c DeepSeek V4.1 Flash (make deepseek_v41)
├── mimo.c MiMo-V2.6 Flash and Pro (make mimo)
├── qwen38.c Qwen3.8-Flash-Next (make qwen38)
├── qwen36.c Qwen3.6, Qwen3-Coder, Qwen3.8-27B, Flint, Muse Spark,
│ LFM3-VL, Clef (make qwen36)
├── olmoe.c OLMoE (make olmoe)
├── qwenimage.c Qwen-Image-2.1 (make qwenimage)
├── laya.c Laya (make laya)
├── gliner_decide.c GLiNER2.5-Decide (make gliner_decide)
│
├── st.h, quant.h, idot.h safetensors reads, container decoders, integer kernels
├── expert_ffn.h, expert_store.h routed-expert kernel and streaming expert cache
├── tok.h, json.h, compat.h tokenizer, JSON, Windows/macOS shims
├── route_trace.h, kv_prefix.h routing telemetry (.coli_usage), KV prefix reuse
├── gguf.h, park.h GGUF reader, a conversation parked between an agent's turns
├── decide_serve.h the decision engines' side of System One
│
├── backend_cuda.*, cu_tier.h, cuda_chain.cu optional CUDA tier and chains (CUDA=1)
├── backend_metal.* optional Metal tier (METAL=1)
├── backend_vulkan.*, vk_tier.c, vk_chain.c optional Vulkan tier and dense chain (VK=1)
│
├── coli user-facing CLI
├── setup_*.py the one-step setup: hardware, catalog, downloads, flow
├── mcp_server.py the MCP server (coli mcp)
├── openai_server.py OpenAI- and Anthropic-compatible HTTP gateway
├── resource_plan.py RAM/VRAM planner behind coli plan and coli doctor
├── tools/ conversion, fixtures and benchmarks
└── tests/ dependency-free C and Python tests
ui/ the chat UI (coli ui)
web/ the dashboard (a pure API client)
desktop/ Tauri desktop shell around the dashboard
docker/ container images
docs/ reference docs, experiments, media
site/ the website
```
**每個模型家族一個 `.c`,建立在共用的單一標頭檔之上**。一個引擎只負責自己的架構,
其他一概不管;兩個引擎都需要的東西,都放在它們共同引入的標頭檔中,
因此一個修正能同時涵蓋所有引擎。在儲存庫根目錄執行
`make`、`make check` 與 `make clean`,都會轉交給引擎的 Makefile。
## 支持專案
colibri 最初是一個人在一台 12 核心、25 GB RAM 的筆電上開始的專案;
如今它的數據來自社群中的各種真實機器。如果它對你有用:
- 為儲存庫加星並分享出去;
- 開 issue 提交你硬體上的基準測試數據:
實測數據點比其他任何事都更能推動這個專案;
- 加入 [Discord 社群](https://discord.gg/RXV83nSZdk),討論實驗、
硬體結果與研究方向;
- 若想贊助開發或捐贈硬體,請透過 GitHub issues 聯絡。
## 為什麼叫做「colibrì」
蜂鳥只有幾公克重,能在原地懸停,一天造訪上千朵花。
這套引擎只靠蜂鳥般的口糧,就讓一個 744B 參數的巨人持續運轉:
25 GB RAM、十二個 CPU 核心,以及對硬碟的大量耐心。
## 致謝
colibri 只是一個引擎;它所執行的智慧是一份饋贈。感謝以開放方式發布權重的團隊:
**Z.ai**(GLM)、**Moonshot AI**(Kimi)、**Alibaba Qwen**、**DeepSeek**、
**Xiaomi**(MiMo)、**Thinking Machines**(Inkling)、**Allen AI**(OLMoE)、
**Convai Innovations**(Laya)、**fastino**(GLiNER2.5-Decide)與
**Cloudflare**(Clef);感謝發布轉換後容器的人;
也感謝每一位做過基準測試、二分定位問題、重現圖譜執行或提交修補的貢獻者。
本儲存庫中的第三方程式碼及其授權條款:[THIRD_PARTY_NOTICES.md](THIRD_PARTY_NOTICES.md)。
本專案在專家配置、壓縮與路由方面的實驗,也建立在以下開放研究與系統工作的構想和證據之上:
- [REAP](https://github.com/CerebrasResearch/reap) 與
[EASY-EP](https://github.com/RUCAIBox/EASYEP):輸出感知的與特定領域的專家重要性。
- [SERE](https://github.com/JL-Cheng/SERE):基於相似度的專家重新路由;
[ReMoE](https://github.com/BUAA-OSCAR/ReMoE):感知快取區域性的路由器微調。
- [MC-SMoE](https://github.com/UNITES-Lab/MC-SMoE):路由引導的專家合併與壓縮。
- [MoBE](https://github.com/inclusionAI/MoBE) 與
[D²-MoE](https://github.com/lliai/D2MoE):共享專家基底與低秩專家增量。
- [HybriMoE](https://github.com/PKU-SEC-Lab/HybriMoE):CPU/GPU 混合專家排程;
[ScMoE](https://arxiv.org/abs/2404.05019):專家通訊與運算的重疊;
[OD-MoE](https://arxiv.org/abs/2512.03927):分散式隨需專家載入。
- [vLLM](https://github.com/vllm-project/vllm)、
[llama.cpp](https://github.com/ggml-org/llama.cpp) 與
[kTransformers](https://github.com/kvcache-ai/ktransformers):開放的推論系統與專家卸載工作,
讓比較得以重現。
引擎也建立在具體的工程成果之上,而不只是構想。以下每一項如今都在程式碼樹中被使用或重新實作:
- [safetensors](https://github.com/huggingface/safetensors):每個引擎讀取的容器格式
(`c/st.h`),包括其 fp8 與 I64 資料型別。
- [tiktoken](https://github.com/openai/tiktoken):`c/tok.h` 精確地重新實作了它的
`byte_pair_encode`,合併串接後詞彙 id 最小的相鄰對,因此源自 tiktoken 的詞彙表不需要 merges 清單。
- [llama.cpp](https://github.com/ggml-org/llama.cpp):`c/grammar.h` 中的 GBNF 文法子集遵循它的
語法與 set-of-stacks PDA,Metal 路徑也借用了它的 `newBufferWithBytesNoCopy` 常駐技巧。
- [vLLM](https://github.com/vllm-project/vllm):引擎逐位置對齊的輸出語意參考(例如最終 norm
相對於 LM head 的位置)。
- [transformers](https://github.com/huggingface/transformers):oracle;CI 以它為基準逐 token
重現一個隨機初始化的模型。
- [DietGPU](https://github.com/facebookresearch/dietgpu):實驗性壓縮專家層級(`COLI_ANS`)背後的
GPU ANS 編解碼器。
- [rocWMMA](https://github.com/ROCm/rocWMMA):HIP 後端把 CUDA 的 `nvcuda::wmma`
fragment/mma_sync API 對應到它之上(`c/backend_gpu_compat.h`),這讓同一份 .cu 原始碼可以為
兩家廠商編譯。
## 授權條款
Apache 2.0,Copyright 2026 Vincenzo Fornaro。詳見 [LICENSE](LICENSE) 與 [NOTICE](NOTICE)。每個模型都保留其作者賦予的授權條款(GLM-5.2 權重由 Z.ai 以 MIT 授權發布;Qwen-Image-2.1 僅限非商業用途)。