-windows-x86_64-cuda.zip` tem a `coli_cuda.dll` (placas de
compute capability 8.0 ou mais nova) e os motores colibri, qwen36 e kimi_k3 que
a carregam, com as DLLs CUDA do DeepSeek V4. Descompacte por cima do arquivo
principal e o setup escolhe CUDA.
- **Todas as camadas na placa** para Qwen3.6, Qwen3.8 e OLMoE: as camadas
densas, a atenção e os especialistas que a placa guarda rodam como uma só
cadeia, e os que ela não guarda rodam na CPU. Numa RTX PRO 4000 o
Qwen3.6-35B-A3B UD-Q4_K_M decodifica a 104,8 tok/s e lê um prompt a 3491, o
OLMoE a 354,6 e 10418 ([a tabela](#three-backends-on-one-machine)).
- **Um tier de especialistas na placa para todo motor** (`cu_tier.h`), e as
matrizes densas nela para DeepSeek V4, V4.1, Kimi K3, GLM-5.3 e MiMo
(`cu_dense.h`).
- **Os blocos de um GGUF na placa** (`cuda_bd.cuh`): todo tipo de bloco ggml de
32 pesos ou mais, cada linha como o arquivo a guarda; um prompt passa pelos
tensor cores ([gguf.md](docs/gguf.md)).
- **O tier de especialistas em VRAM** mantém na placa os especialistas mais
quentes, escolhidos a partir do roteamento medido; os que faltam calculam na CPU
ao mesmo tempo. O Qwen3.6 em duas placas de 8 GB (RTX 3070 e Quadro RTX 4000)
decodificou 11,3 tok/s com histórico a quente
([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md)); o GLM-5.2 em seis RTX 5090 com
todos os especialistas residentes, 9,0-9,2 tok/s
([benchmarks.md](docs/benchmarks.md)); o DeepSeek V4 Flash numa RTX 5080, 1,5-1,6
tok/s e um prompt de 3.324 tokens em 90 s
([deepseek-v4.md](docs/deepseek-v4.md)).
- **Novidade no Qwen3.6: as camadas DeltaNet na placa** (`Q36_DN_GPU=1`,
opcional). Cada uma das 30 camadas DeltaNet do Qwen3.6 copiava seus dados entre
a placa e a CPU quatro vezes por token; agora um token de decodificação roda a
camada inteira na placa, com o estado recorrente guardado na VRAM. Numa RTX 3070
com as camadas densas na VRAM: 25,4 a 30,0 tok/s
([qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md#the-deltanet-layer-on-the-card-q36_dn_gpu1)).
- **Placas mais antigas.** Se o kit CUDA não compila mais para a sua placa (CUDA
13 e uma V100, em [#1852](https://github.com/JustVugg/colibri/issues/1852)), a
configuração percebe isso antes de compilar e usa a placa via Vulkan, dizendo o
motivo; um kit CUDA 12.x traz o caminho CUDA de volta. O tier CUDA do DeepSeek V4
também compila para Pascal e Turing
(`CUDA_ARCH=portable-pre-ampere NO_TC=1`).
Tudo isso: [docs/cuda.md](docs/cuda.md).
### Apple Silicon
Um backend Metal faz a matemática dos especialistas na GPU de memória unificada
para vários motores ([docs/metal.md](docs/metal.md)). O arquivo macOS da versão
traz `colibri`, `inkling` e `kimi_k3` compilados com ele: `COLI_METAL=1`
(`K3_METAL=1` para o Kimi K3) o liga, e sem isso eles rodam na CPU. A partir do
código, compile com `METAL=1`; a configuração de um passo compila para a CPU.
## System One: uma decisão com uma probabilidade
A maior parte do que as pessoas pedem a um modelo é uma escolha, não um parágrafo:
qual fila, qual veredito, sim ou não. O `POST /v1/systemone` recebe um estado
(texto ou JSON) e perguntas tipadas, e responde cada uma com a probabilidade de
cada opção permitida e uma confiança. Nada é gerado, então nenhuma resposta pode
cair fora da sua lista, e "o modelo não tem certeza" é um número no qual você pode
aplicar um limiar.
```bash
curl -s http://127.0.0.1:8000/v1/systemone -H 'Content-Type: application/json' -d '{
"state": "340 lines, 8 files, no tests. CI is green but nothing covers that path.",
"questions": {
"review": {"type": "choice", "instructions": "What should the reviewer do?",
"criteria": {"merge": null, "request changes": null, "close": null}},
"risky": {"type": "noul", "instructions": "Is this change risky?"}}}'
```
Um `choice` volta com o rótulo escolhido, uma probabilidade para cada rótulo e uma
`confidence` de 0 (plana) a 1 (certa); um `noul` com a probabilidade de sim; um
`score` com o nível esperado.
Quem responde:
- **Qualquer modelo de chat que o colibri roda**, por pontuação: ele lê a
probabilidade de cada opção em vez de escrever uma resposta. Muitas perguntas
sobre um documento leem o documento uma vez só: no Qwen3.6, quatro perguntas
sobre um documento voltaram 5,7× mais rápido do que gerar as mesmas respostas na
mesma máquina com CPU.
- **Três modelos de decisão**, nativamente, numa única passada direta com a
calibração que os autores ajustaram: [Laya](docs/laya.md) (Convai Innovations),
[GLiNER2.5-Decide](docs/gliner_decide.md) (fastino) e [Clef](docs/clef.md)
(Cloudflare; também conversa). Os tamanhos e as velocidades estão na
[tabela dos modelos de decisão](#which-model-for-my-machine).
**Migrar do Jev.** A requisição e a resposta são as da API Jev da TypeSafe, então
um cliente Jev migra para o colibri mudando só a URL base e nada mais:
`TYPESAFE_BASE_URL=http://127.0.0.1:8000` (a chave que ele já envia é aceita por um
servidor iniciado sem `COLI_API_KEY`). Os dois SDKs oficiais, sem modificação, são
testados contra o `coli serve`.
O mesmo modo está no terminal (`/decide merge | request changes | close` no
`coli chat`) e na página System One do painel. A requisição e a resposta por
inteiro, as regras de pontuação e onde isso não ajuda:
[docs/systemone.md](docs/systemone.md).
## O painel
O `coli web` o abre, e a configuração de um passo também: o chat, a página do
System One, a página do Brain e a página de Profiling, em tema claro ou escuro.
### O novo chat
O `coli ui` abre o novo chat ao lado de um `coli serve` em execução: o raciocínio no seu próprio bloco,
imagens para os modelos com torre de visão, busca na web, o mapa de especialistas, um monitor ao vivo e os
agentes de programação já apontados para o colibri. Sete idiomas. Veja [ui/README.md](ui/README.md).
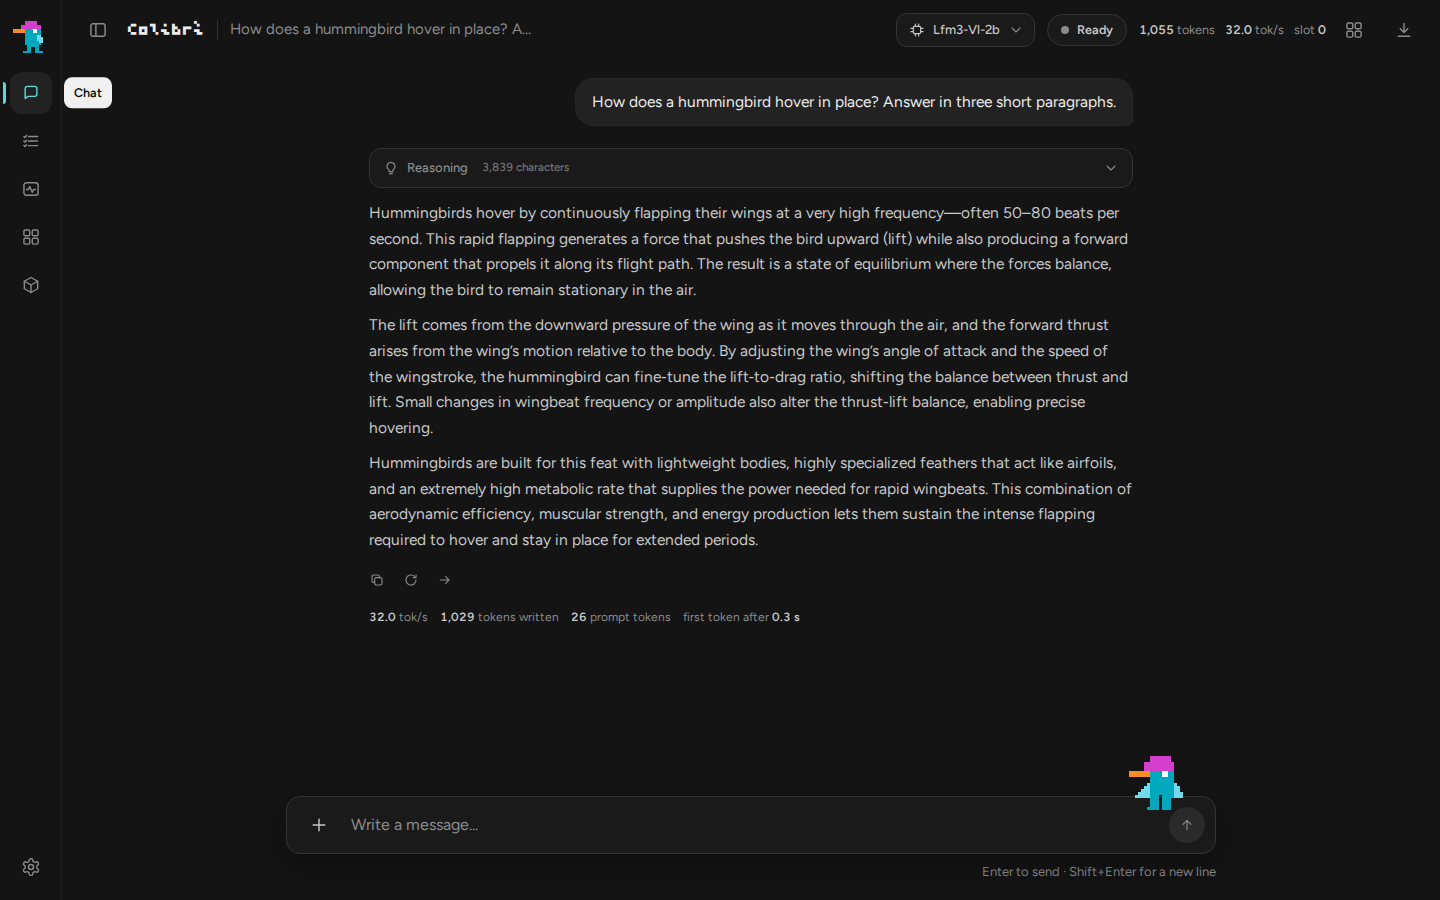
LFM3-VL-2B na CPU de um i5-13500, 32 tok/s.
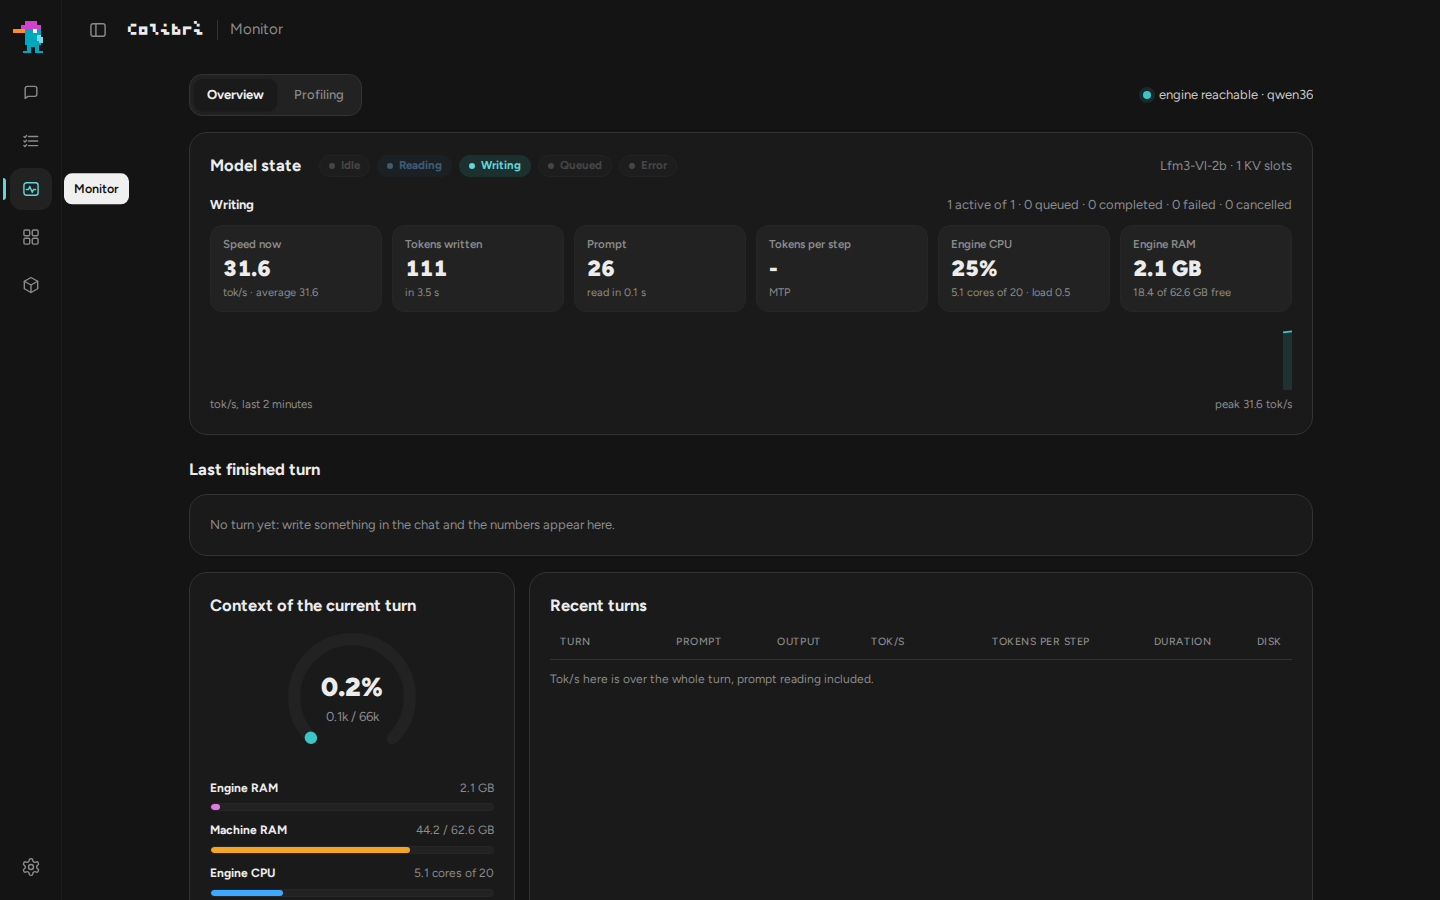
O monitor enquanto o LFM3-VL-2B escreve: 31,6 tok/s, o prompt lido em 0,1 s, 2,1 GB de RAM.
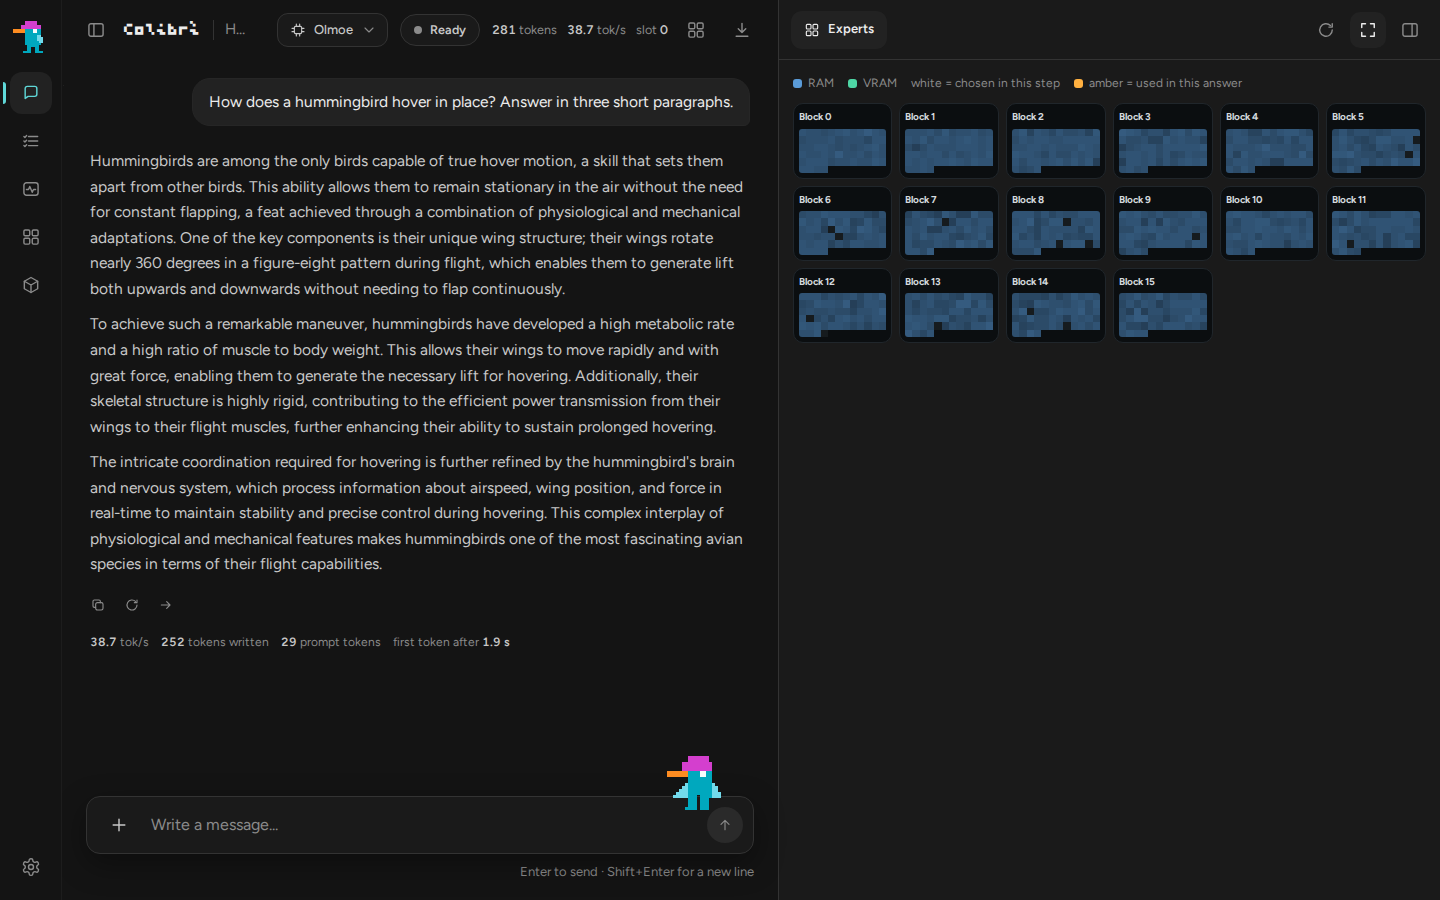
O OLMoE com o mapa de especialistas aberto ao lado do chat: uma célula por especialista em cada bloco, branca quando
escolhido neste passo, âmbar quando usado nesta resposta.
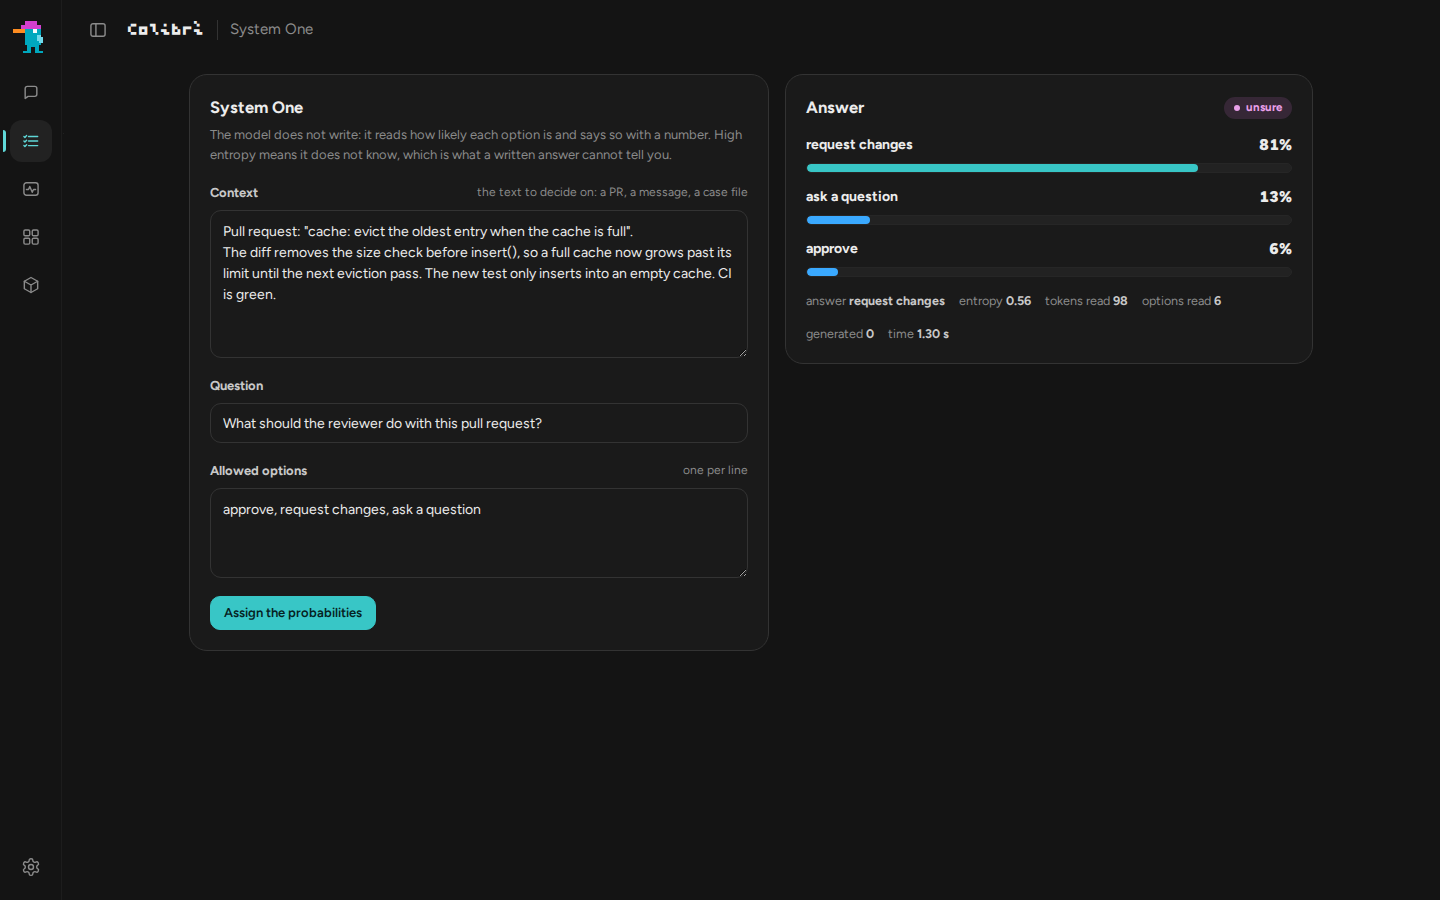
System One: dê ao modelo um documento e as únicas respostas que ele pode escolher. Aqui o Qwen3.6-35B numa RTX PRO 4000
lê um pull request que quebra o limite de tamanho de um cache: request changes a 81%, entropia 0,56 (incerto), 98 tokens lidos, 0 gerados.
A página **Profiling** mostra onde cada turno gasta o seu tempo, fase por fase,
com os últimos 30 turnos como tendência.
## Use-o a partir de outras aplicações
O `coli serve` (que a configuração inicia para você) é um servidor com várias APIs:
- **Compatível com OpenAI**: `/v1/chat/completions`, `/v1/completions` e
`/v1/models`, com streaming, respostas em JSON, sequências de parada e logprobs;
- **Compatível com Anthropic**: `/v1/messages`, de modo que o Claude Code e os SDKs
da Anthropic funcionam contra ele;
- **tool calling** em todo motor de chat exceto Inkling e OLMoE, cada um no
formato nativo do seu modelo ([the per-engine table](docs/api.md#tool-calling-support));
- **imagens de entrada** no GLM-5.3-Flash, DeepSeek V4.1 Flash, MiMo-V2.6,
Qwen3.8-Flash-Next, Qwen3.8-27B, LFM3-VL e Mistral-Large-4 (de um GGUF, com o
arquivo `mmproj` ao lado): um caminho numa mensagem do `coli chat`, um anexo no
`coli web` ou no `coli ui`, ou uma parte `image_url`;
- **figuras de saída** com o Qwen-Image-2.1 em `POST /v1/images/generations`,
e desenhadas dentro do terminal pelo `coli chat`
([qwen-image.md](docs/qwen-image.md));
- **decisões** em `POST /v1/systemone` ([acima](#system-one-a-decision-with-a-probability));
- **várias conversas ao mesmo tempo** em todo motor de texto: `coli serve
--kv-slots N` mantém até 16, cada uma com o seu próprio cache, e decodifica os
próximos tokens delas juntos ([api.md](docs/api.md#isolated-kv-contexts)).
CLIs de código e editores se conectam como a qualquer provedor compatível com
OpenAI: URL base `http://127.0.0.1:8000/v1`, o id do modelo que `coli status`
imprime, qualquer chave não vazia
([docs/api.md](docs/api.md#connect-a-coding-cli-or-editor)).
## Como funciona
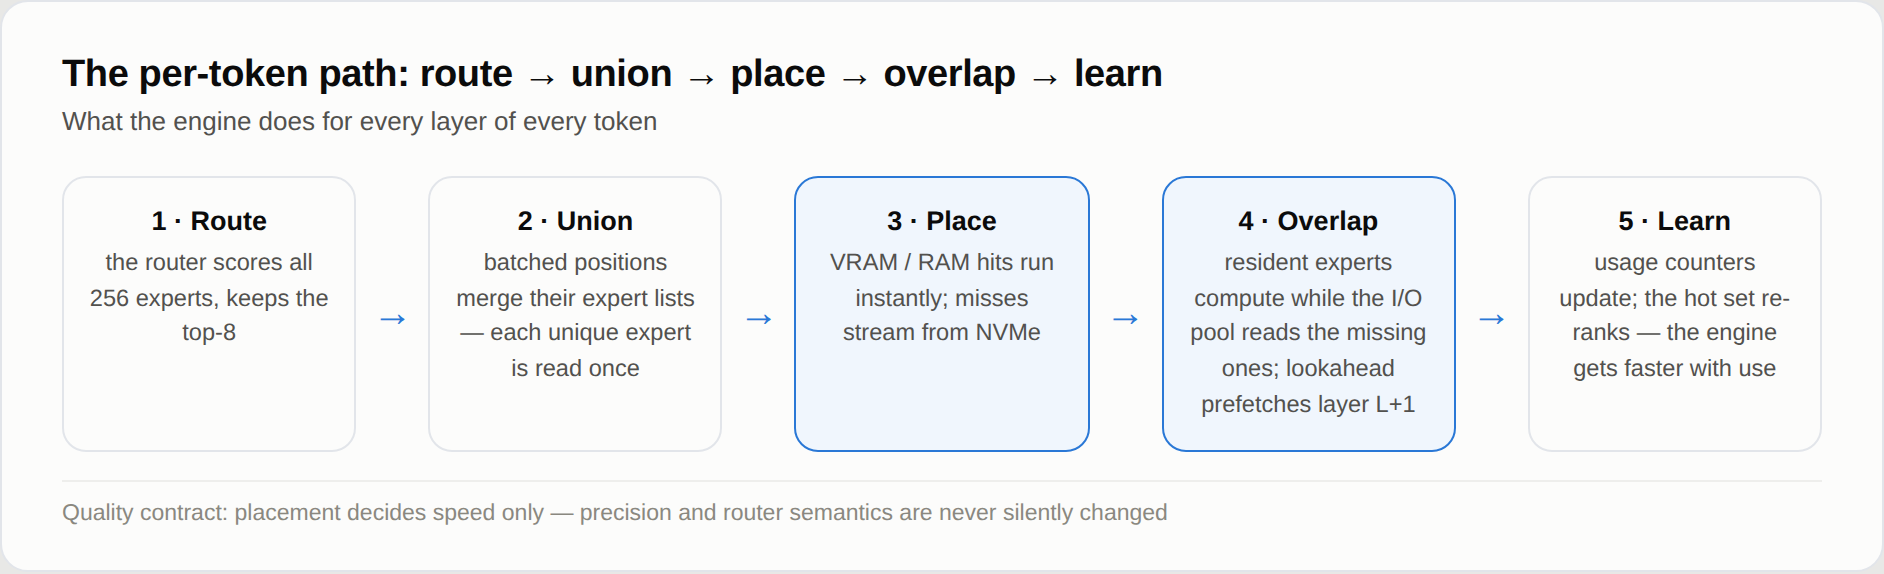
Cada camada de cada token percorre os mesmos cinco passos: rotear, unir,
posicionar, sobrepor, aprender. O objetivo do projeto é que **o posicionamento
decida apenas a velocidade**: as decisões do roteador e a precisão dos pesos são
as mesmas se um especialista respondeu da VRAM, da RAM ou do disco.
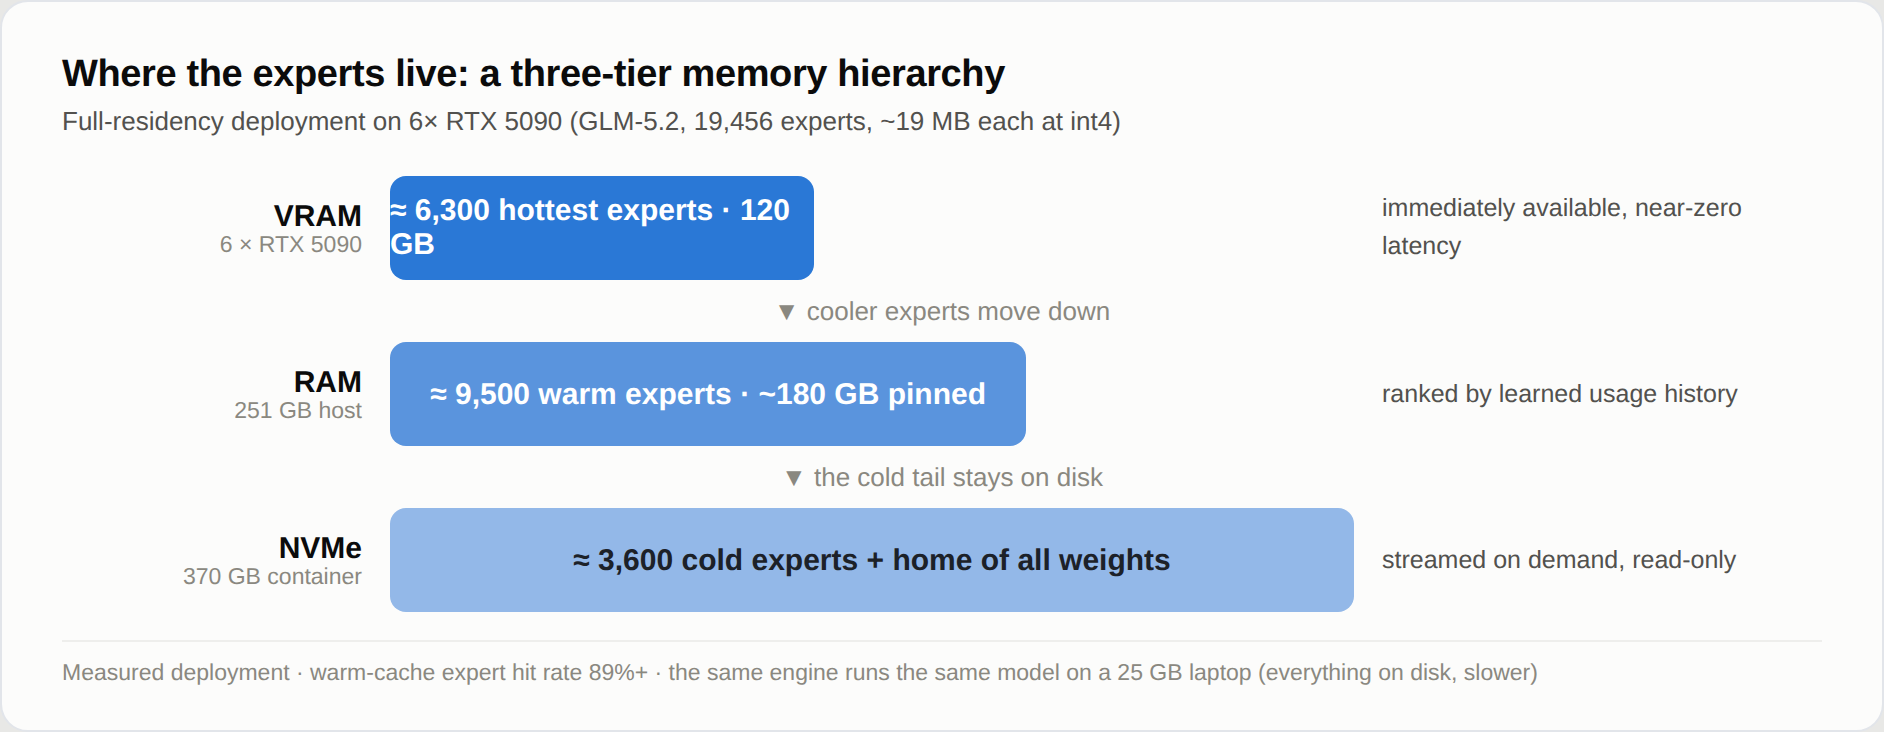
- **Um JIT para os pesos.** Um compilador JIT nunca compila o programa inteiro:
ele observa o que roda e compila os caminhos quentes. O colibri faz a mesma
aposta com os pesos. O calor de roteamento medido decide quais especialistas
ganham VRAM, RAM ou disco: um cache LRU por camada, mais um conjunto fixado de
especialistas quentes aprendido das suas próprias conversas (`.coli_usage`,
atualizado a cada turno). O colibri fica mais rápido quanto mais você o usa.
Funciona porque o roteamento tem estrutura mensurável (o
[atlas de especialistas](https://github.com/JustVugg/colibri/issues/175)).
- **Nunca esperar pelo disco duas vezes.** As três matrizes de um especialista são
lidas num único `pread`; um pool de carregadores lê os especialistas que faltam
enquanto os residentes calculam; um lote de posições lê cada especialista uma
vez; uma thread de lookahead do roteador pode pré-buscar a próxima camada (o
roteamento do GLM-5.2 é 71,6% previsível uma camada à frente). `DIRECT=1`
(O_DIRECT) costuma render muito em NVMe rápido e é neutro ou pior nos outros:
meça no seu ([tuning.md](docs/tuning.md)).
- **Mais de um SSD.** `COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat --model /fast/glm52_i4`
lê de uma cópia num segundo disco. Dois NVMe em controladores independentes
mediram +37,5% na decodificação; um espelho parcial num disco menor também
funciona ([multidisk.md](docs/multidisk.md)).
- **De um laptop a um rack.** Num laptop de 25 GB, todo especialista é transmitido
do disco, lentamente e corretamente; num host grande, todo especialista fica
residente (`CUDA_EXPERT_GB=auto PIN_GB=all`) e o disco sai da conta da
decodificação. `COLI_NUMA=1` espalha os pesos residentes pelos controladores de
memória de um host com vários sockets, e um modo de cluster local roda
especialistas roteados em outras máquinas ([cluster.md](docs/cluster.md)).
- **Um modelo fiel.** Todo motor é verificado na CI contra a implementação de
referência do seu modelo, num fixture pequeno. A atenção MLA do GLM-5.2 mantém
um estado KV comprimido (576 floats por token em vez de 32.768, 57× menor) que
sobrevive a reinicializações, então uma conversa reabre sem prompt para ler de
novo.
- **Especulação que se paga.** O cabeçote MTP int8 do GLM-5.2 rascunha 2,2-2,8
tokens por forward quando compensa; o cabeçote MTP do Qwen3.8-Flash-Next, ligado
por padrão, acrescenta 16-20% com a mesma saída, e o prompt lookup, 6-7% em
edições de código. O cabeçote do Qwen3.6 (`Q36_MTP=1`) leva o decode de
99,7-104,5 a 115,8-120,1 tok/s com CUDA e de 83,2-83,8 a 99,9-109,3 com Vulkan
(uma RTX PRO 4000). O cabeçote DSpark do DeepSeek V4.1 rascunha tão fundo
quanto a sua confiança diz, e uma verificação pula os rascunhos que não podem
compensar. Onde rascunhar custa mais do que economiza (DeepSeek V4), ele fica
desligado ([speculative.md](docs/speculative.md),
[tuning.md](docs/tuning.md#speculation-and-reproducibility)).
O motor é um arquivo C por família de modelos (`c/colibri.c` para o GLM-5.2) sobre
cabeçalhos compartilhados, sem BLAS e sem Python em tempo de execução: o Python
roda apenas a configuração, o launcher, os conversores e o gateway da API.
## Benchmarks
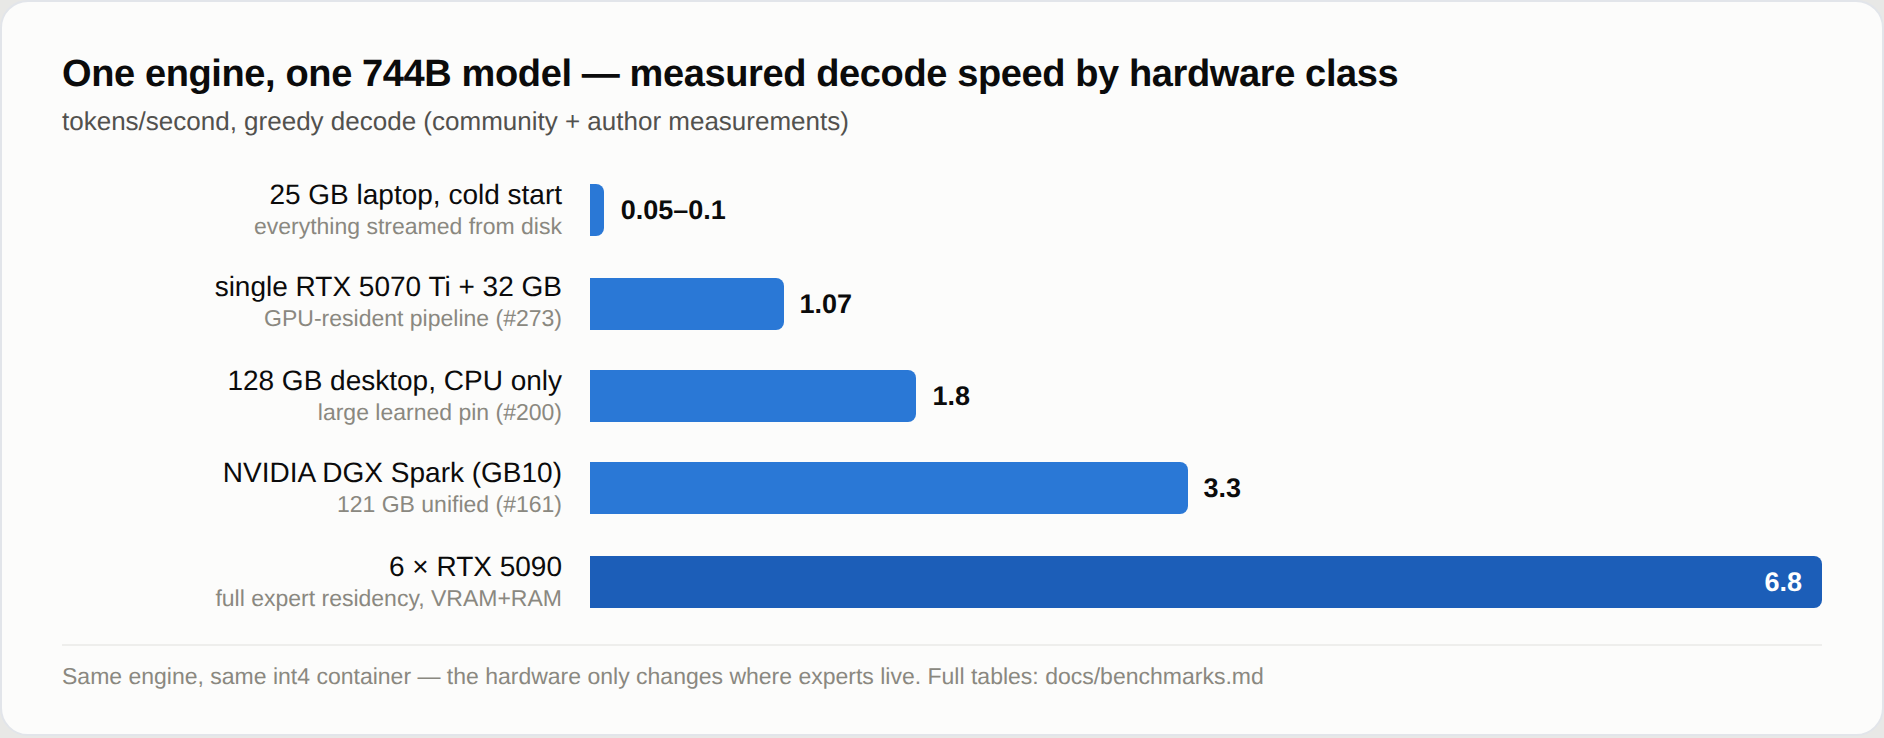
O mesmo motor e o mesmo contêiner int4: o hardware só muda onde os especialistas
vivem. Decodificação do GLM-5.2, a partir de
[the full tables](docs/benchmarks.md):
- **6x RTX 5090, todos os especialistas residentes:** 5,8-6,8 tok/s, 9,0-9,2 com
intercalação NUMA seletiva
([registro do experimento](docs/experiments/glm52-6x5090-2026-07-12.md));
- **128 GB, só CPU** (Ryzen AI Max+ 395): 1,83 tok/s a quente
([#200](https://github.com/JustVugg/colibri/issues/200));
- **uma única máquina classe laptop com RTX 5070 Ti:** 1,07 tok/s
([#273](https://github.com/JustVugg/colibri/issues/273));
- **o laptop de 25 GB onde isto começou:** 0,05-0,1 tok/s a frio, o piso honesto.
### Três backends numa máquina
Um i5-13500 com 62 GB de RAM e uma RTX PRO 4000 Blackwell SFF (24 GB, 70 W),
cada modelo servido pelo `coli serve`: um prompt novo de 450 tokens, depois uma
resposta de 128 tokens em streaming, o HTTP da requisição incluído; a melhor de
duas execuções, tok/s.
| GGUF | CUDA prompt | CUDA decode | Vulkan prompt | Vulkan decode | CPU prompt | CPU decode |
|---|---:|---:|---:|---:|---:|---:|
| Qwen3.6-35B-A3B UD-Q4_K_M | 3491 | 104,8 | 2076 | 92,9 | 122,6 | 13,9 |
| LFM3-VL-2B Q4_K_M | 12317 | 235,1 | 8174 | 214,1 | 286,5 | 34,5 |
| OLMoE-1B-7B-0125-Instruct Q4_K_M | 10418 | 354,6 | 6867 | 299,4 | 279,9 | 47,4 |
| LFM3-VL-2B F16 | 11524 | 103,4 | 7767 | 99,3 | 49,7 | 6,4 |
| Qwen3.8-Flash-Next IQ2_XS (68 GB: os especialistas que a placa não comporta ficam na RAM) | 217,1 | 51,4 | 214,3 | 50,6 | 38,3 | 9,3 |
### Modelos grandes na mesma máquina
A máquina D de novo, cada modelo a partir do seu GGUF publicado pelo `coli serve`:
o que nem a placa nem a RAM guardam vem dos dois NVMe. Tokens por segundo, da
página de cada modelo:
| GGUF | tamanho | backend | prompt | decode |
|---|---:|---|---:|---:|
| Inkling-Small UD-IQ2_XXS | 77 GB | Vulkan | 15,1-33,1 | 10,92-11,53 ([vulkan.md](docs/vulkan.md)) |
| MiMo-V2.6-Flash Q2_K_S | 106 GB | Vulkan | 8,2 | 7,8 ([gguf.md](docs/gguf.md)) |
| DeepSeek V4 Flash 0731 UD-IQ2_XXS | 85 GB | Vulkan | 19,7-20,4 | 6,18-6,25 ([vulkan.md](docs/vulkan.md)) |
| DeepSeek V4.1 Flash UD-IQ1_S | | Vulkan | 31,8 sobre 3403 tokens | 5,01-5,29 ([deepseek-v41.md](docs/deepseek-v41.md)) |
| GLM-5.3-Flash UD-IQ2_XXS | 95 GB | Vulkan | 9,3 | 2,92-3,40 ([vulkan.md](docs/vulkan.md)) |
| Muse Spark Open UD-IQ1_S | 176 GB | Vulkan | 5,0-5,3 | 1,55-1,58 ([qwen36.md](docs/qwen36.md#muse-spark-open)) |
| Mistral-Large-4 UD-IQ1_S | 233 GB | CUDA | 240 tokens em 66-82 s | 1,34-1,36 ([mistral-large4.md](docs/mistral-large4.md)) |
| GLM-5.2 UD-IQ1_S | 202 GB | Vulkan | | 0,633-0,658 ([gguf.md](docs/gguf.md)) |
| Kimi K3 UD-IQ1_S | 594 GB | Vulkan | 31 tokens em 46,5 s | 0,349 ([gguf.md](docs/gguf.md)) |
### Contextos longos e agentes
- **Um contexto de 256k na velocidade de 64k.** Qwen3.8-Flash-Next IQ2_XS na
cadeia CUDA da máquina D, com um contexto de 262144 tokens: prompt de 15,6 a
149 tok/s, decode de 9,6 a 45,7 (o plano da RAM a um segmento do prompt, K/V
em float16 na placa; a 65536 lê a 188 e decodifica a 48,4)
([qwen38.md](docs/qwen38.md)).
- **Os turnos de um agente leem só o que é novo.** Uma requisição curta entre dois
turnos (um agente pedindo o título da conversa) estaciona a conversa em vez de
tomar o seu estado, em todo motor (`COLI_PARK`). O segundo turno do Hermes
Agent no Qwen3.8-Flash-Next, 14810 tokens: de 86 s a 4,9 s
([qwen38.md](docs/qwen38.md#an-agents-turns)).
- **Caches KV em float16**: o GLM-5.3 a 131072 tokens ocupa 11,9 GB em vez de
23,9 ([CHANGELOG](CHANGELOG.md)).
A qualidade é medida, não presumida: o custo do contêiner int4 e as ablações de
quantização estão em
[benchmarks.md](docs/benchmarks.md#quality-benchmark). Para acrescentar a sua
máquina, siga [the benchmark protocol](docs/benchmarking.md) e abra uma issue com
os números.
## Instalar manualmente
**1. O programa.** Pegue o arquivo da sua plataforma em
[Releases](https://github.com/JustVugg/colibri/releases) (Linux x86_64, macOS,
Windows; não é preciso compilador, apenas [Python 3](https://www.python.org/downloads/)
para o launcher e a API) e descompacte, depois `python3 coli info`. Os motores de
Linux e Windows já vêm com Vulkan embutido, com os seus `shaders/` ao lado, e os
de macOS com Metal; para uma placa NVIDIA no Windows, acrescente o arquivo CUDA.
Ou compile a partir do código com `gcc` (ou clang) e OpenMP:
```bash
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh # checks gcc/OpenMP, builds, self-tests
make qwen36 VK=1 # one engine, here with Vulkan (CUDA=1 for CUDA)
```
**2. Um modelo.** Qualquer download de
[the tables above](#which-model-for-my-machine): os ids da configuração
correspondem a repositórios do Hugging Face, e a página de cada modelo tem o
comando de download e de conversão. Para o GLM-5.2 use o contêiner com escalas por
grupo (gs64) com o cabeçote MTP int8,
[`mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp`](https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp)
(429 GB), ou [`Justvugg/GLM-5.3-colibri-int4-g64`](https://huggingface.co/Justvugg/GLM-5.3-colibri-int4-g64)
para o GLM-5.3 (419 GB, sem cabeçote MTP). Não use os espelhos int4 por linha mais
antigos: eles medem cerca de 9 pontos pior em qualidade e causaram as respostas em
laço da [#455](https://github.com/JustVugg/colibri/issues/455).
`./coli convert --model /nvme/glm52_i4` monta o mesmo contêiner a partir da versão
FP8, shard a shard, sem nunca precisar dos seus 756 GB no disco de uma vez. Como
conferir o cabeçote MTP e o resto:
[quickstart.md](docs/quickstart.md#3-get-the-model). Um GGUF que você já tem não precisa de conversão: `./coli import` no seu primeiro
arquivo ([acima](#from-a-gguf)).
**3. Rode.** A partir de `c/` num checkout do código, ou do arquivo da versão
descompactado. O launcher lê o `config.json` do modelo e escolhe o motor e o
template de chat dele, então os comandos são os mesmos para todo modelo:
```bash
./coli chat --model /nvme/qwen36 # chat in the terminal
./coli web --model /nvme/qwen36 # API + dashboard, opens a browser
./coli serve --model /nvme/qwen36 # API + dashboard, no browser
./coli plan --model /nvme/qwen36 # where the model will live: VRAM, RAM, disk
./coli doctor --model /nvme/qwen36 # read-only check: is everything ready?
./coli tune --model /nvme/qwen36 # measure and save this machine's fastest safe settings
./coli import /nvme/Flint-UD-Q4_K_XL.gguf # a GGUF: writes Flint-UD-Q4_K_XL.colibri next to it
./coli ui # the chat UI, next to a running coli serve
```
No Windows, o arquivo de uma versão traz `coli.cmd` (`coli.cmd chat --model
D:\qwen36`); a partir de um checkout do código, use `py -3 c\coli`. Os arquivos
`.exe` são os motores, não o launcher. Toda opção e variável:
[SETTINGS.md](docs/SETTINGS.md), [ENVIRONMENT.md](docs/ENVIRONMENT.md).
## Pesquisa, e como ajudar
O colibri quer que modelos de fronteira dependam menos de hardware escasso e
custem menos para rodar. Isso significa mudar como os pesos são guardados e
movidos, decidir o que vive na VRAM, na RAM ou no armazenamento, sobrepor o
trabalho de CPU e GPU, e testar novas formas de decodificar. Nada é mantido por
ser convencional, e nada é adotado por um microbenchmark parecer rápido: o
resultado que decide é a inferência ponta a ponta em máquinas reais, com a
qualidade medida ao lado da velocidade. As questões em aberto:
| hipótese | evidência até agora | experimento ainda necessário |
|---|---|---|
| O histórico de roteamento posiciona especialistas melhor que um LRU simples | os pins aprendidos melhoram cargas de trabalho repetidas, mas podem sobreajustar a um prompt | A/Bs entre sessões, em dados reservados, cobrindo código, chat, multilíngue e contextos longos |
| Vários SSDs transformam largura de banda independente em velocidade de decodificação | dois NVMe independentes mediram +37,5% na decodificação; um terceiro disco mais lento foi neutro após striping ponderado ([measurements](docs/multidisk.md#what-has-been-measured)) | reproduzir em diferentes velocidades de disco, layouts de controlador e estados de cache |
| Um planejador ciente do hardware chega automaticamente perto da melhor configuração de cada máquina | os orçamentos de RAM/VRAM e vários backends são detectados hoje, e a configuração escolhe a compilação | comparar o plano gerado com uma varredura controlada de parâmetros em laptops, workstations, hosts NUMA e sistemas multi-GPU |
| Representações sem perda ou com qualidade limitada reduzem o movimento de pesos o bastante para importar | existem ablações de formato e quantização, com portões de correção e de qualidade | reproduzir qualidade, bytes movidos, latência e custo por token útil em conjunto, não só a taxa de compressão |
| Especulação ciente do roteamento compensa antes da residência quase total | os rascunhos por MTP e por gramática funcionam, mas o MTP também mediu 32% de perda perto de 85% de acerto de especialistas | mapear a superfície de equilíbrio entre aceitação, taxa de acerto de especialistas, união do lote e profundidade do rascunho |
| A sobreposição CPU/GPU esconde transferência e sincronização em vez de apenas mover o gargalo | há ganhos com CUDA, Metal e Vulkan, mas CPUs rápidas, GPUs integradas e baixa residência podem anulá-los | perfis por etapa e A/Bs de uma variável em PCIe, memória unificada e máquinas totalmente residentes, e mais placas dedicadas, para o tier e a cadeia Vulkan, do que a medida (uma RTX PRO 4000) |
Quer ajudar? Escolha uma linha e publique também os resultados negativos.
Registre o hardware, o commit, o modelo, o comando exato, o prompt, o estado do
cache, a vazão, o tempo até o primeiro token, a taxa de acerto de especialistas, os
bytes lidos e uma verificação de qualidade; mude uma variável, repita, e anexe os
logs brutos. Comece por [CONTRIBUTING.md](CONTRIBUTING.md) e
[the benchmark protocol](docs/benchmarking.md), depois
[abra uma issue](https://github.com/JustVugg/colibri/issues/new). Uma falha bem
controlada vale mais aqui do que um número rápido sem explicação.
## Documentação
| tópico | doc |
|---|---|
| A configuração de um passo e a instalação manual, em todas as plataformas | [quickstart.md](docs/quickstart.md) |
| Configurar por um assistente de IA, e o servidor MCP | [AI_SETUP.md](docs/AI_SETUP.md), [MCP_SERVER.md](docs/MCP_SERVER.md) |
| A API: OpenAI, Anthropic, ferramentas, slots de KV, painel | [api.md](docs/api.md) |
| O System One e os modelos de decisão | [systemone.md](docs/systemone.md), [laya.md](docs/laya.md), [gliner_decide.md](docs/gliner_decide.md), [clef.md](docs/clef.md) |
| Arquivos GGUF: as arquiteturas, os dois modos, o que cada motor faz com os blocos | [gguf.md](docs/gguf.md) |
| Os modelos no motor Qwen3.6 (Flint, Muse Spark Open, LFM3-VL) e o Mistral-Large-4 | [qwen36.md](docs/qwen36.md), [mistral-large4.md](docs/mistral-large4.md) |
| A interface de chat (`coli ui`) | [ui/README.md](ui/README.md) |
| Vulkan: o tier de especialistas, a cadeia densa, placas sem Resizable BAR | [vulkan.md](docs/vulkan.md) |
| CUDA, e o tier CUDA do Qwen3.6 | [cuda.md](docs/cuda.md), [qwen36-cuda-tier.md](docs/qwen36-cuda-tier.md) |
| Apple Silicon, Windows | [metal.md](docs/metal.md), [windows.md](docs/windows.md) |
| Ajuste, o cache que aprende, prefetch, especulação | [tuning.md](docs/tuning.md) |
| Decodificação especulativa: os cabeçotes MTP, o prompt lookup, a verificação | [speculative.md](docs/speculative.md) |
| Vários SSDs, várias máquinas | [multidisk.md](docs/multidisk.md), [cluster.md](docs/cluster.md) |
| Benchmarks e como medir | [benchmarks.md](docs/benchmarks.md), [benchmarking.md](docs/benchmarking.md) |
| Toda opção e variável de ambiente | [SETTINGS.md](docs/SETTINGS.md), [ENVIRONMENT.md](docs/ENVIRONMENT.md) |
| Rascunhos forçados por gramática, e os ABIs experimentais de embeddings | [grammar-draft.md](docs/grammar-draft.md), [segment-runtime.md](docs/segment-runtime.md), [edge-runtime.md](docs/edge-runtime.md) |
## Estrutura do repositório
```
start-here.sh, START-HERE.bat the one-step setup (Linux and macOS, Windows)
Makefile root build/check entry point
c/
├── colibri.c GLM-5.2/5.3, Mistral-Large-4 (make glm)
├── glm53.c GLM-5.3-Flash (make glm53)
├── inkling.c Inkling (make inkling)
├── kimi_k3.c Kimi K3 (make kimi_k3)
├── deepseek_v4.c DeepSeek V4 Flash (make deepseek-v4)
├── deepseek_v41.c DeepSeek V4.1 Flash (make deepseek_v41)
├── mimo.c MiMo-V2.6 Flash and Pro (make mimo)
├── qwen38.c Qwen3.8-Flash-Next (make qwen38)
├── qwen36.c Qwen3.6, Qwen3-Coder, Qwen3.8-27B, Flint, Muse Spark,
│ LFM3-VL, Clef (make qwen36)
├── olmoe.c OLMoE (make olmoe)
├── qwenimage.c Qwen-Image-2.1 (make qwenimage)
├── laya.c Laya (make laya)
├── gliner_decide.c GLiNER2.5-Decide (make gliner_decide)
│
├── st.h, quant.h, idot.h safetensors reads, container decoders, integer kernels
├── expert_ffn.h, expert_store.h routed-expert kernel and streaming expert cache
├── tok.h, json.h, compat.h tokenizer, JSON, Windows/macOS shims
├── route_trace.h, kv_prefix.h routing telemetry (.coli_usage), KV prefix reuse
├── gguf.h, park.h GGUF reader, a conversation parked between an agent's turns
├── decide_serve.h the decision engines' side of System One
│
├── backend_cuda.*, cu_tier.h, cuda_chain.cu optional CUDA tier and chains (CUDA=1)
├── backend_metal.* optional Metal tier (METAL=1)
├── backend_vulkan.*, vk_tier.c, vk_chain.c optional Vulkan tier and dense chain (VK=1)
│
├── coli user-facing CLI
├── setup_*.py the one-step setup: hardware, catalog, downloads, flow
├── mcp_server.py the MCP server (coli mcp)
├── openai_server.py OpenAI- and Anthropic-compatible HTTP gateway
├── resource_plan.py RAM/VRAM planner behind coli plan and coli doctor
├── tools/ conversion, fixtures and benchmarks
└── tests/ dependency-free C and Python tests
ui/ the chat UI (coli ui)
web/ the dashboard (a pure API client)
desktop/ Tauri desktop shell around the dashboard
docker/ container images
docs/ reference docs, experiments, media
site/ the website
```
**Um `.c` por família de modelos, sobre cabeçalhos únicos compartilhados.** Um
motor é dono da sua arquitetura e de nada mais; o que dois motores precisam junto
vive num cabeçalho que ambos incluem, então uma correção alcança todos de uma vez.
Da raiz do repositório, `make`, `make check` e `make clean` delegam ao Makefile do
motor.
## Apoiando o projeto
O colibri começou como um projeto de uma pessoa só, num laptop de 12 núcleos com
25 GB de RAM; hoje os seus números vêm de uma comunidade de máquinas reais. Se ele
lhe for útil:
- dê uma estrela no repositório e compartilhe-o;
- abra issues com números de benchmark do seu hardware: dados movem este projeto
mais do que qualquer outra coisa;
- junte-se à [comunidade no Discord](https://discord.gg/RXV83nSZdk) para discutir
experimentos, resultados de hardware e direções de pesquisa;
- fale com a gente pelas issues do GitHub para patrocinar o desenvolvimento ou
doar hardware.
## Por que "colibrì"
O beija-flor pesa alguns gramas, fica pairando no mesmo lugar e visita mil flores
por dia. Este motor mantém vivo um gigante de 744 bilhões de parâmetros com ração
de beija-flor: 25 GB de RAM, doze núcleos de CPU e muita paciência de disco.
## Agradecimentos
O colibri é um motor; as mentes que ele roda são um presente. Obrigado às equipes
que liberam os seus pesos aberta e publicamente: **Z.ai** (GLM), **Moonshot AI**
(Kimi), **Alibaba Qwen**, **DeepSeek**, **Xiaomi** (MiMo), **Thinking Machines**
(Inkling), **Allen AI** (OLMoE), **Convai Innovations** (Laya), **fastino**
(GLiNER2.5-Decide) e **Cloudflare** (Clef); às pessoas que publicam contêineres
convertidos; e a todo colaborador que mediu, bissectou, replicou uma execução do
atlas ou enviou um patch. Código de terceiros neste repositório e as suas licenças:
[THIRD_PARTY_NOTICES.md](THIRD_PARTY_NOTICES.md).
Os experimentos de posicionamento, compressão e roteamento de especialistas do
projeto também se apoiam em ideias e evidências dos seguintes trabalhos abertos de
pesquisa e de sistemas:
- [REAP](https://github.com/CerebrasResearch/reap) e
[EASY-EP](https://github.com/RUCAIBox/EASYEP) para importância de especialistas
ciente da saída e específica por domínio.
- [SERE](https://github.com/JL-Cheng/SERE) para re-roteamento de especialistas por
similaridade, e [ReMoE](https://github.com/BUAA-OSCAR/ReMoE) para ajuste fino do
roteador ciente da localidade de cache.
- [MC-SMoE](https://github.com/UNITES-Lab/MC-SMoE) para fusão e compressão de
especialistas guiada por roteamento.
- [MoBE](https://github.com/inclusionAI/MoBE) e
[D²-MoE](https://github.com/lliai/D2MoE) para bases de especialistas
compartilhadas e deltas de especialistas de posto baixo.
- [HybriMoE](https://github.com/PKU-SEC-Lab/HybriMoE) para escalonamento híbrido de
especialistas entre CPU e GPU, [ScMoE](https://arxiv.org/abs/2404.05019) para
sobrepor a comunicação dos especialistas à computação, e
[OD-MoE](https://arxiv.org/abs/2512.03927) para carregamento distribuído de
especialistas sob demanda.
- [vLLM](https://github.com/vllm-project/vllm),
[llama.cpp](https://github.com/ggml-org/llama.cpp) e
[kTransformers](https://github.com/kvcache-ai/ktransformers) pelos sistemas
abertos de inferência e pelo trabalho de offload de especialistas que tornam as
comparações reproduzíveis.
O motor também se apoia em trabalho de engenharia concreto, não só em ideias. Cada
um destes é usado ou reimplementado na árvore hoje:
- [safetensors](https://github.com/huggingface/safetensors): o contêiner que todo
motor lê (`c/st.h`), incluindo os seus tipos fp8 e I64.
- [tiktoken](https://github.com/openai/tiktoken): o `c/tok.h` reimplementa o seu
`byte_pair_encode` exatamente, unindo o par adjacente cuja concatenação tem o
menor id de vocabulário, então um vocabulário derivado do tiktoken não precisa de
lista de merges.
- [llama.cpp](https://github.com/ggml-org/llama.cpp): o subconjunto de gramática
GBNF em `c/grammar.h` segue a sintaxe dele e o seu PDA de conjunto de pilhas, e o
caminho Metal toma emprestado o truque de residência `newBufferWithBytesNoCopy`.
- [vLLM](https://github.com/vllm-project/vllm): a referência para a semântica de
saída que o motor reproduz posição a posição (por exemplo, onde a norma final cai
em relação ao cabeçote LM).
- [transformers](https://github.com/huggingface/transformers): o oráculo: a CI
reproduz um modelo de inicialização aleatória token a token contra ele.
- [DietGPU](https://github.com/facebookresearch/dietgpu): o codec ANS de GPU por
trás do tier experimental de especialistas comprimidos (`COLI_ANS`).
- [rocWMMA](https://github.com/ROCm/rocWMMA): o backend HIP mapeia a API de
fragmento/mma_sync `nvcuda::wmma` do CUDA para ele
(`c/backend_gpu_compat.h`), e é isso que permite que um único fonte .cu compile
para os dois fabricantes.
## Licença
Apache 2.0, Copyright 2026 Vincenzo Fornaro. Veja [LICENSE](LICENSE) e
[NOTICE](NOTICE). Cada modelo mantém a licença que os seus autores lhe deram (os
pesos do GLM-5.2 são publicados pela Z.ai sob MIT; o Qwen-Image-2.1 é apenas para
uso não comercial).