Ejecuta un modelo de última generación en tu propio PC gaming
Compatible con NVIDIA, AMD, Intel · Windows, Linux, Mac · libre y de código abierto
Un jardín con una pagoda de vóxeles, hecho con un solo prompt en una RTX 5070 con Strata (IQ3_S, contexto de 128K) ·
vídeo completo (49 s)
Strata ejecuta **[Qwen3.8-Flash-Next](https://huggingface.co/Qwen/Qwen3.8-Flash-Next)**, un modelo de 125 mil millones
de parámetros que normalmente necesita un servidor, en un PC normal. Conversa, escribe código, lee imágenes y funciona
con tus aplicaciones y tus agentes de programación. Tus chats y tus archivos se quedan en tu PC.
**¿Eres nuevo?** Mira [lo que necesitas](#lo-que-necesitas) y luego [instala la aplicación](#opción-a-la-aplicación-strata).
- **Funciona en un PC gaming.** Con 32 GB entre RAM y memoria gráfica ya puedes empezar.
- **Funciona con tus herramientas.** Habla las API de OpenAI y de Anthropic, así que Claude Code, Codex CLI, OpenCode y otros agentes se conectan a él.
- **Lee imágenes.** Viene activado por defecto.
- **Gratis.** Licencia MIT, sin cuenta, sin nube.
- **Privado.** Sin telemetría. Lo que Strata descarga, cuándo usa internet y cómo comprueba las descargas está en [docs/SAFETY.md](docs/SAFETY.md).
Versión 0.2.1 · motor 0.1.46
## Lo que necesitas
**Necesitas al menos 32 GB entre RAM y memoria gráfica (VRAM).** En un Mac o un Ryzen AI Max, es la memoria unificada.
Con más memoria puedes usar un modelo más grande o más rápido.
- Un PC de 32 GB con una tarjeta de 12 a 16 GB ejecuta el Coder.
- Con 64 GB de RAM funcionan todos los tamaños.
| Tu ordenador | Detalles |
| --- | --- |
| **NVIDIA** GeForce RTX serie 20, 30, 40, 50 (12 GB o más) | Instala la aplicación o la Terminal. |
| **AMD** Radeon RX 6800 y posteriores, Radeon AI PRO R9700 (12 GB o más) | [Tarjetas AMD](docs/AMD_HIP.md) |
| **Intel** Arc | [Intel Arc](docs/INTEL_ARC.md), [motor Intel](docs/INTEL.md) |
| **Mac con Apple Silicon** (M1 o posterior, macOS 15 o posterior) | [Mac](docs/MAC.md) |
| **AMD Ryzen AI Max (Strix Halo)** y otros sistemas con memoria unificada | [Strix Halo](docs/STRIX_HALO.md) |
| Tarjetas y procesadores antiguos | [GPU antiguas](docs/OLDER_GPUS.md), [CPU antiguas](docs/INSTALL.md#older-cpus-experimental) |
También hace falta:
- unos 80 GB de disco libre (con un SSD el primer arranque es mucho más rápido)
- Windows 10 / 11, Linux o macOS
- un controlador gráfico actual
Dos o tres tarjetas de la misma marca pueden compartir un modelo ([multi-GPU](docs/MULTI_GPU.md)). Strata nunca reparte un
modelo entre tarjetas NVIDIA y AMD. Lista completa: [docs/INSTALL.md](docs/INSTALL.md#what-you-need).
## Instalación
Elige una opción. Todas arrancan el mismo motor y usan los mismos modelos.
### Opción A: la aplicación Strata
La forma más fácil. La aplicación lleva el motor dentro: la instalas, eliges un modelo y chateas. Descarga el archivo para
tu sistema y tu tarjeta gráfica desde la [página de versiones](https://github.com/Niko1221/Strata/releases/latest). ¿No
sabes cuál elegir? Mira el párrafo que hay debajo de la tabla.
| Sistema | Tu tarjeta gráfica | Archivo que descargar |
| --- | --- | --- |
| **Windows 10 / 11** | NVIDIA RTX, controlador 580 o posterior | [`Strata-0.2.1-windows-cuda13.exe`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-windows-cuda13.exe) |
| | NVIDIA, tarjeta más antigua o controlador anterior a 580 | [`Strata-0.2.1-windows-cuda12.exe`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-windows-cuda12.exe) |
| | AMD Radeon serie RX 9000 o Radeon AI PRO R9700 | [`Strata-0.2.1-windows-hip.exe`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-windows-hip.exe) |
| | AMD Radeon serie RX 7000 o Ryzen AI Max (Strix Halo) | [`Strata-0.2.1-windows-hip-rdna3.exe`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-windows-hip-rdna3.exe) |
| **Linux** | NVIDIA RTX, controlador 580 o posterior | [`Strata-0.2.1-linux-nvidia-cuda13.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-nvidia-cuda13.AppImage) |
| | NVIDIA, tarjeta más antigua o controlador anterior a 580 | [`Strata-0.2.1-linux-nvidia-cuda12.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-nvidia-cuda12.AppImage) |
| | AMD Radeon serie RX 9000 o Radeon AI PRO R9700 | [`Strata-0.2.1-linux-amd-rx9070.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-amd-rx9070.AppImage) |
| | AMD Radeon serie RX 7000 | [`Strata-0.2.1-linux-amd-rx7900.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-amd-rx7900.AppImage) |
| | AMD Ryzen AI Max (Strix Halo) | [`Strata-0.2.1-linux-amd-strixhalo.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-amd-strixhalo.AppImage) |
| **Mac** (Apple Silicon, macOS 15 o posterior) | integrada | [`Strata-0.2.1-mac.dmg`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-mac.dmg) |
**Si no estás seguro:** con NVIDIA, elige `cuda13` si la versión de tu controlador es la 580 o posterior, y `cuda12` en caso
contrario. `cuda12` es para tarjetas y controladores más antiguos. Los archivos `hip` y `amd` son para tarjetas AMD. Las
demás tarjetas AMD (RX 6000) todavía no tienen una aplicación ya preparada: mira
[Tarjetas AMD](docs/AMD_HIP.md).
Después:
- **Windows:** ejecuta el `.exe`. Se instala para tu usuario y no necesita permisos de administrador. Si Windows muestra
"Windows protegió tu PC", elige **Más información** y luego **Ejecutar de todas formas** (el instalador todavía no está
firmado).
- **Linux:** haz el archivo ejecutable (`chmod +x`) y lánzalo. Necesita FUSE 2: `sudo apt install libfuse2` (Ubuntu 22.04)
o `libfuse2t64` (Ubuntu 24.04 y posteriores).
- **Mac:** abre el `.dmg` y arrastra Strata a Aplicaciones.
En la primera pantalla, la aplicación analiza tu PC y recomienda un modelo adecuado. Pulsa Instalar. El modelo es una
descarga grande (unos 40 a 70 GB) y, si se interrumpe, continúa donde se quedó. Al cerrar la ventana, Strata y el motor se
detienen.
### Opción B: la Terminal (una línea)
La Terminal es el comando `strata`, pensado para scripts, servidores y agentes de IA.
Linux y Mac:
```sh
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh | sh
```
Windows (PowerShell):
```powershell
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
```
El script analiza tu PC, descarga la Terminal, verifica su SHA-256 y la descomprime en tu carpeta personal. No necesita
permisos de administrador. En Windows, abre una ventana de terminal nueva después. Luego arranca Strata:
```sh
strata launch
```
Te hace una pregunta cada vez: modelo, contexto, imágenes, quién puede conectarse. Después descarga el motor para tu tarjeta
gráfica (firmado y arrancado como prueba antes de usarlo) y el modelo, y empieza a servir. Para scripts y agentes de IA, usa
opciones:
```sh
strata launch --model q2_0 --yes --no-tui
```
Si quieres leer el script de instalación antes de ejecutarlo, descárgalo primero con `curl -fsSL -o install.sh`,
léelo y luego ejecuta `sh install.sh`. Todas las pantallas y opciones: [docs/TERMINAL_LAUNCH.md](docs/TERMINAL_LAUNCH.md).
### Opción C: que lo instale tu IA
Pega esto en Claude Code, Cursor, Codex, GitHub Copilot u otro asistente de programación:
```text
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.
```
El asistente revisa tu tarjeta gráfica, tu RAM y tu disco, elige el modelo adecuado, lo instala y lo arranca, y te explica
cómo conectar tus aplicaciones. Las herramientas de IA también pueden instalar, arrancar y detener Strata mediante su
[servidor MCP](docs/MCP_SERVER.md).
¿Prefieres compilarlo tú? Mira [Compilar desde el código fuente](#compilar-desde-el-código-fuente).
## Modelos
La aplicación y `strata launch` recomiendan un modelo según tu memoria. Es un solo modelo en varios tamaños, más o menos
comprimido. Los tamaños pequeños son más rápidos. Los grandes son algo más inteligentes.
### ¿Poca memoria? Prueba Gyro
[Gyro](https://huggingface.co/agentionai/Qwen3.8-Flash-Next-Gyro-GGUF) (de agentionai) es la forma más pequeña de ejecutar este modelo.
| Tamaño | Memoria que necesita (RAM + VRAM) | Descarga | Qué es |
| --- | ---: | ---: | --- |
| **Gyro-S** | 27,6 GB | 58,5 GB | Para PC donde no cabe nada más. La calidad es menor que la de IQ2_XS. |
| **Gyro-M** | 35 GB | 92,0 GB | Calidad parecida a IQ3_XXS con un 20 % menos de memoria de GPU. Escribe las respuestas un 17-21 % más despacio que Q2_0 en una tarjeta de 12 GB y en una R9700. |
Gyro funciona en tarjetas NVIDIA y AMD (en AMD es experimental), no en Intel Arc ni en el Mac. Detalles y mediciones:
[docs/GYRO.md](docs/GYRO.md). Arráncalo con `strata launch --model gyro-s`.
### Los demás tamaños
| Tu memoria (RAM + VRAM) | Elige | Notas |
| --- | --- | --- |
| **32 GB** | **Gyro-S**, o el **[Coder](docs/MODELS.md#coder)** para código | El Coder necesita 32 GB de RAM y conserva la mitad de los expertos, así que es más flojo fuera del código |
| **40 GB** | **[Swift 1.5](docs/MODELS.md#swift-15)** IQ2_XS (39,2 GB), o **Gyro-M** (35 GB) | Swift piensa menos tiempo antes de responder. Gyro-M se acerca a la calidad de IQ3_XXS, pero escribe las respuestas un 17-21 % más despacio que Q2_0 |
| **48 GB** | **IQ3_XXS** (47,0 GB) | Más lento, mejor |
| **64 GB** | **IQ3_S** (54,8 GB), el original o Swift 1.5 | El más lento, el mejor. Iguala al modelo completo en las pruebas publicadas |
| **96 GB o más** | **UD-IQ4_XS** de Unsloth (unos 72 GB de RAM) hasta **Q8_0** (unos 136 GB), de 4 a 8 bits | Más cerca del modelo completo. Con menos RAM, Strata lee una parte desde el SSD, que es mucho más lento |
Con menos RAM de la que indica una fila también puede funcionar: Strata pasa solo a su
[modo de poca RAM](docs/MODELS.md#a-big-graphics-card-and-little-ram). Espera que sea más lento, y mucho más lento con una
tarjeta gráfica pequeña.
Más opciones:
- **[Swift 1.5](docs/MODELS.md#swift-15)** es un ajuste fino que piensa menos tiempo antes de responder, con una calidad y un uso de RAM casi iguales.
- **[NVFP4](docs/NVFP4.md)** es la versión de 4 bits de NVIDIA para tarjetas NVIDIA. Necesita unos 80 GB de RAM para tener todos los expertos en RAM.
- **[Qwen3.6-35B-A3B](docs/QWEN36.md)** es un modelo más pequeño y distinto que lee imágenes y puede atender varias peticiones a la vez.
- **[El Uncensored IQ3_XXS de OrcaRouter](docs/MODELS.md#orcarouter-uncensored-iq3_xxs)** se configura a mano.
Todos los tamaños, descargas y lo que cabe en cada equipo: [docs/MODELS.md](docs/MODELS.md).
## ¿Qué velocidad tiene?
Medido con una tarjeta gráfica de 12 GB (RTX 5070, Ryzen 5 7600, 64 GB de RAM). Resultados con otras tarjetas:
[velocidad de cada tamaño](docs/MODELS.md#how-fast-is-each-size), [resultados de la comunidad](docs/COMMUNITY_BENCHMARKS.md).
| Modelo | Las respuestas aparecen a | Lee tu prompt a |
| --- | --- | --- |
| **Q2_0** | `████████████` 94 tokens/s | `████████████` 2.650 tokens/s |
| **IQ2_XS** | `██████████░░` 79 tokens/s | `█████████░░░` 2.090 tokens/s |
| **IQ3_XXS** | `████████░░░░` 62 tokens/s | `████████░░░░` 1.750 tokens/s |
| **IQ3_S** | `███████░░░░░` 53 tokens/s | `███████░░░░░` 1.620 tokens/s |
| **Coder** | `███████░░░░░` 55 tokens/s | `██████████░░` 2.180 tokens/s |
Un token equivale a unos ¾ de palabra, así que 60 tokens por segundo es más rápido de lo que puedes leer. "Lee tu prompt"
es lo rápido que Strata procesa un documento largo, código o un historial de chat.
Medido con una tarjeta AMD de 16 GB (RX 9070 XT, Ryzen 9 3900X, 47 GB de RAM):
| Modelo | Las respuestas aparecen a | Lee tu prompt a |
| --- | --- | --- |
| **Q2_0** | `████████░░░░` 60 tokens/s | `█████░░░░░░░` 1.160 tokens/s |
| **IQ2_XS** | `███████░░░░░` 52 tokens/s | `█████░░░░░░░` 1.110 tokens/s |
| **Coder** | `██████░░░░░░` 44 tokens/s | `██████░░░░░░` 1.420 tokens/s |
Las barras usan la misma escala en las dos tablas. Una tarjeta con más VRAM es más rápida. Una RTX 3090 (24 GB) debería
escribir unos 100-140 tokens por segundo. La versión del motor detrás de cada cifra está en [DETAILS.md](docs/DETAILS.md#speed-measured).
## Uso
### En la aplicación
La aplicación tiene un **Chat**, un **Monitor** del modelo y de tu GPU, CPU y RAM, una página de **Modelos** y los
**Ajustes**. El chat puede trabajar en una carpeta de tu PC. En modo **Manual** pregunta antes de cambiar un archivo o
ejecutar un comando. Escribe `/loop 10m ` para repetir un mensaje cada 10 minutos mientras el chat esté abierto.
El chat puede buscar en la web con DuckDuckGo (o Bing), sin cuenta. Puedes añadir una clave de búsqueda en **Ajustes,
Herramientas**. La búsqueda es la única función que envía algo fuera de tu PC (las palabras que buscas).
Para ejecutar dos modelos, activa **Ejecutar varios modelos** y dale a cada modelo su propia tarjeta de la misma marca.
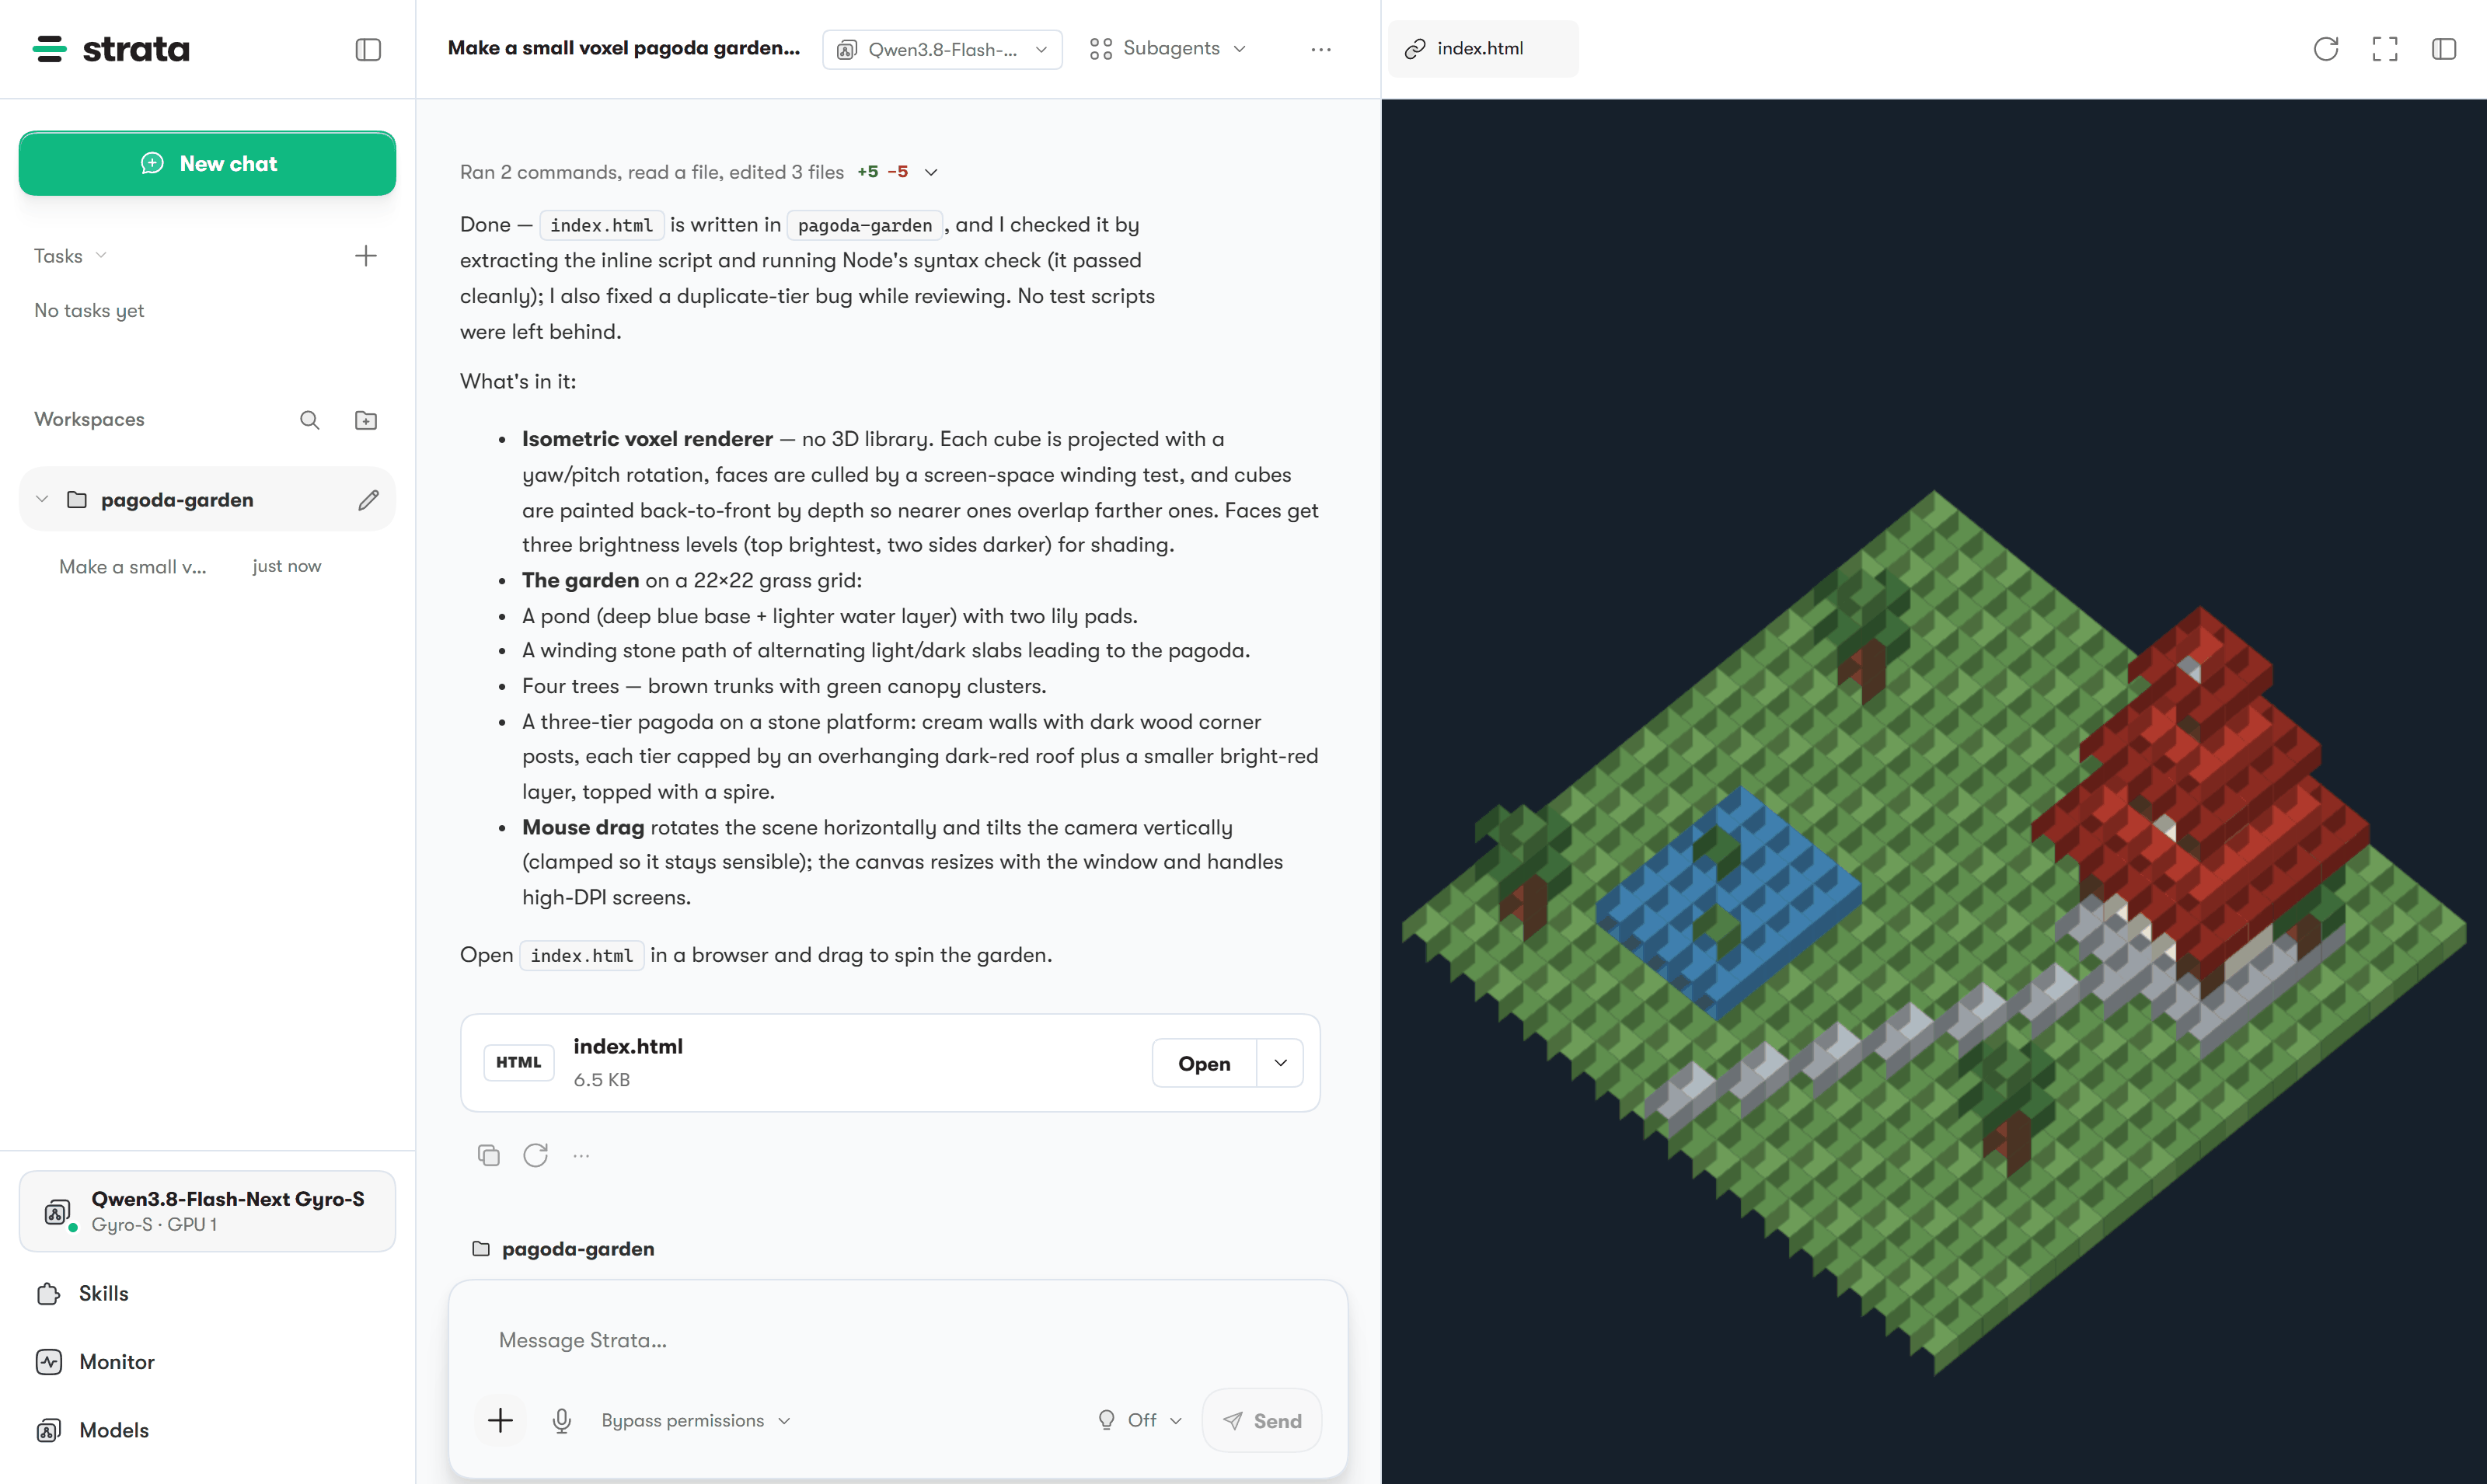
Un chat en la app de Strata: el agente escribió un pequeño jardín de pagoda de vóxeles en un solo archivo HTML, y la página se abre en la vista previa junto a la conversación
### En la Terminal
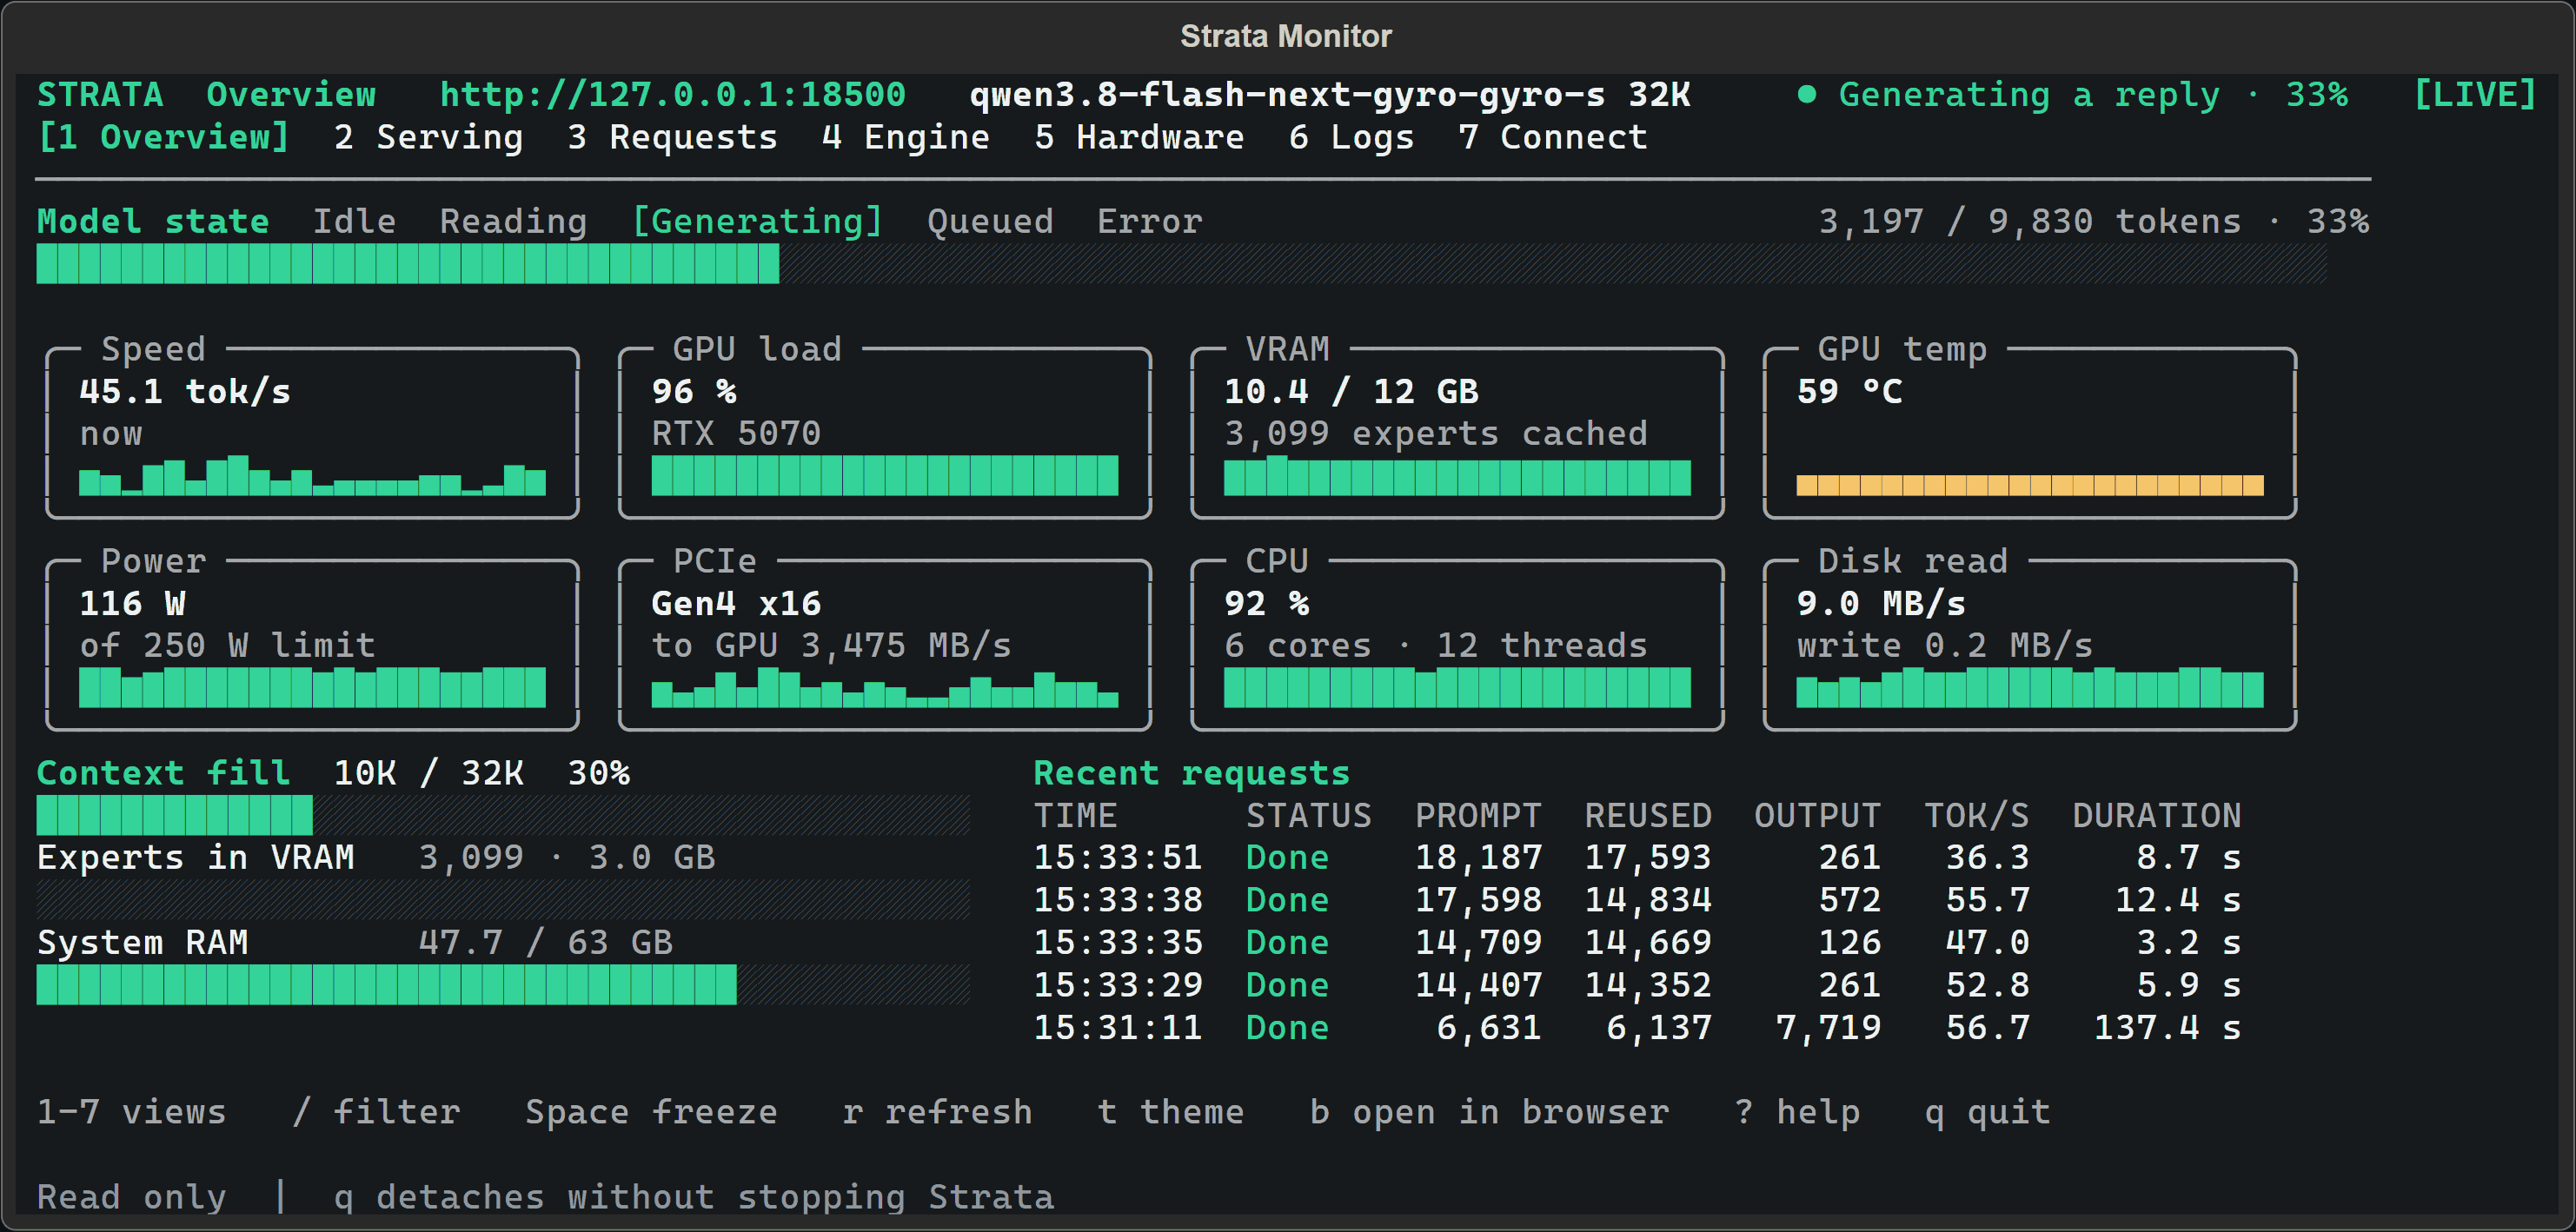
strata monitor mientras el modelo responde: velocidad, GPU, memoria y las últimas solicitudes
```sh
strata launch # guided screens: model, context, pictures, access, then serve
strata launch --model q2_0 --yes --no-tui # no questions: serve, print the address, return
strata launch --plan --model q2_0 # show what would happen; nothing changes
strata launch --status # what is being served now
strata launch --stop # stop it
strata monitor --url http://127.0.0.1:8080 # watch speed, GPU, memory and requests
strata update --check # is there a new engine? (strata update installs it)
strata doctor # check the installed engine files
```
`strata --help` lo lista todo. Arrancar y servir no descargan nada. Solo lo hacen la instalación, `strata launch` (cuando
eliges un modelo) y `strata update`. Para llegar a Strata desde tu móvil u otro PC, usa `strata launch --access lan`. Crea
una clave de API y no arranca en una red sin ella. No se abre ningún navegador salvo que añadas `--open`. Guía:
[docs/TERMINAL_LAUNCH.md](docs/TERMINAL_LAUNCH.md). El cliente completo: [docs/TERMINAL.md](docs/TERMINAL.md).
### Con agentes de IA
Un agente instala Strata con el comando de una línea de la opción B y ejecuta
`strata launch --model NAME --yes --no-tui`. Los pasos, las opciones y los códigos de salida están en [docs/AI_SETUP.md](docs/AI_SETUP.md),
y las reglas del repositorio en [AGENTS.md](AGENTS.md).
### Conecta tus otras aplicaciones
| Tipo de aplicación | URL base |
| --- | --- |
| Compatible con OpenAI (la mayoría de aplicaciones y agentes) | `http://127.0.0.1:8080/v1` (cualquier clave de API, cualquier nombre de modelo) |
| API de Anthropic (Claude Code y otros) | `http://127.0.0.1:8080`, sin `/v1`. Estas aplicaciones añaden `/v1/messages` por su cuenta. Claude Code: `ANTHROPIC_BASE_URL=http://127.0.0.1:8080` |
| API OpenAI Responses (Codex CLI) | `http://127.0.0.1:8080/v1/responses` ([configuración](docs/DETAILS.md#the-responses-api-and-codex-cli)) |
`strata connect` muestra los ajustes exactos para OpenCode, Codex CLI, Claude Code, oh-my-pi, pi, Hermes Agent y OpenClaw.
`strata connect opencode --write` escribe el archivo después de preguntar y guarda una copia de seguridad.
### Imágenes
Las imágenes vienen activadas por defecto en los modelos que pueden leerlas. Adjunta o pega una imagen en el chat, o envíala
desde tu aplicación. El lector de imágenes funciona en el procesador cuando tu tarjeta gráfica tiene menos de 24 GB (unos
segundos por imagen, sin quitar memoria a la tarjeta) y en la tarjeta gráfica a partir de 24 GB. La regla es la misma para
NVIDIA y AMD. Puedes desactivar las imágenes por modelo, o elegir el lector con `--vision off`, `--vision gpu` o
`--vision cpu`.
Las cifras detrás de la regla: en una Radeon AI PRO R9700, el lector de la tarjeta tardó 57 ms en una imagen de 260 tokens y
el del procesador 3,1 s. En tarjetas de 16 GB (Tesla P100 y RTX A4000, Linux), el lector de la tarjeta costó un 3-5 % de
velocidad en texto, porque ocupa unos 1,4 GB que de otro modo usaría el modelo. En un Mac lee la GPU, tenga la memoria que tenga (0,45 s para una imagen de 260 tokens en un M4 de 32 GB, unos 1,2 GB de la memoria compartida);
el procesador tarda unos 50 s por imagen, así que solo lee con `--vision cpu`.
### Conviene saber
- Elige el nivel de razonamiento (**desactivado, bajo, medio o alto**) en el menú del chat o en "reasoning effort" de tu aplicación. Desactivado es lo más rápido.
- Strata responde a una petición a la vez por defecto. Para varias a la vez, usa `--parallel N` en `strata launch` o
`"parallel": 2` en la configuración ([BATCHING.md](docs/BATCHING.md)). En una tarjeta de 12 GB, esto hace más lenta cada respuesta.
- Strata lee entero el primer mensaje de un chat, unos 1 minuto por cada 30.000 tokens. Los mensajes siguientes empiezan en segundos.
- Dónde se guardan tus chats y la API completa: [docs/INSTALL.md](docs/INSTALL.md#where-things-are-stored), [docs/DETAILS.md](docs/DETAILS.md#using-it).
## Compilar desde el código fuente
Windows, Linux y Mac desde el repositorio
[Descarga Strata](https://github.com/Niko1221/Strata/archive/refs/heads/main.zip) y descomprímelo, o haz `git clone`.
**Windows:** haz doble clic en `START-HERE.bat`. **Linux:** ejecuta `./setup.sh` en la carpeta de Strata.
**Mac (Apple Silicon, macOS 15 o posterior):** instala una vez las Command Line Tools de Apple con `xcode-select --install`
(no hace falta Xcode). Abre la Terminal en la carpeta de Strata y ejecuta `./setup.sh`. El script compila el motor para Mac
en tu Mac (unos 7 minutos), hace las mismas preguntas, descarga el modelo y lo arranca. La próxima vez, `./setup.sh` lo
arranca enseguida. Qué tamaño cabe en tu Mac: [docs/MAC.md](docs/MAC.md).
El instalador detecta tu tarjeta y prepara el motor adecuado. Pregunta qué modelo y qué tamaño quieres, cuánto contexto
(cuánto texto mantiene el modelo en mente) y si debe leer imágenes. Pulsa Enter para aceptar la respuesta recomendada.
Luego descarga el modelo (unos 70 GB) y lo arranca. Si la descarga se detiene, vuelve a ejecutar el script y continúa. Tu
navegador abre la página de Strata en `http://127.0.0.1:8080`.
> Mientras el modelo arranca, tu PC puede ir lento o dejar de responder durante 1-3 minutos (más tiempo la primera vez).
> Strata carga 35-55 GB en tu RAM y bloquea una parte para la tarjeta gráfica. Espera y no cierres la ventana.
La próxima vez, ejecuta de nuevo `START-HERE.bat` (o `./setup.sh`). Arranca enseguida y no descarga nada dos veces. Cierra
su ventana para detener el modelo. `UPDATE.bat` (`./update.sh`) actualiza Strata sin arrancarlo. Actualización, Docker,
varias tarjetas, dónde van los archivos y todas las opciones: [docs/INSTALL.md](docs/INSTALL.md).
Para medir tu PC, ejecuta `BENCH.bat` (`./bench.sh`). Tarda 5-10 minutos y escribe un informe que puedes compartir
([cómo](docs/COMMUNITY_BENCHMARKS.md#run-the-benchmark)).
**Opcional: más velocidad en una tarjeta cuando todo el modelo cabe en la RAM.** Dos ajustes que se activan a mano, de
RubenTorney (#1904, #1905). Ayudan cuando usas una sola tarjeta gráfica y tu RAM guarda todos los expertos, por ejemplo con
Q2_0 o IQ3_XXS en un PC de 64 GB. Abre `strata-.json` en la carpeta de datos de Strata ([dónde](docs/INSTALL.md#where-things-are-stored)) y añade:
- `"--adapt-async", "1"` a la lista `"args"`. Así la caché de expertos se actualiza en un hilo auxiliar en vez de detener la
respuesta. Medido en una RTX 5070 (Windows, Q2_0): +4-5 % en decodificación, +7-10 % en código y documentos largos. Las
respuestas pueden diferir un poco de las del ajuste por defecto y son iguales de una ejecución a otra.
- `"STRATA_PIN_BY_NEED": "1"` en el bloque `"env"` (Windows). Windows solo puede bloquear aproximadamente la mitad de la RAM
para la tarjeta gráfica, y este ajuste bloquea primero los expertos que la tarjeta necesita antes. Medido en la RTX 5070: +4,4 % en lectura del prompt.
```json
"args": [ ..., "--adapt-async", "1" ],
"env": { "STRATA_PIN_BY_NEED": "1" }
```
Reinicia Strata después del cambio. Para deshacerlo, quita las dos entradas.
## ¿Cómo funciona?
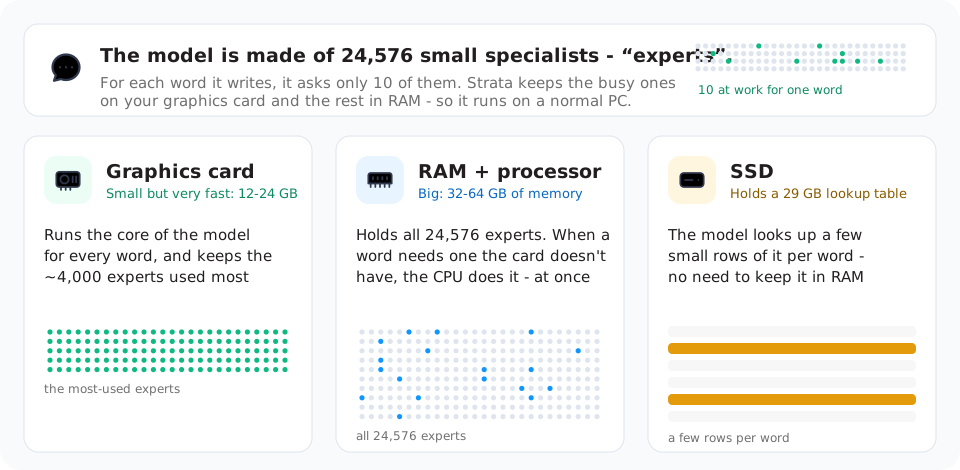
Los modelos como este suelen ejecutarse en servidores con cientos de gigabytes de memoria gráfica. Tu tarjeta gráfica tiene
12-24 GB. Strata hace que el modelo quepa repartiendo el trabajo por todo tu PC. Imagina una biblioteca.
- El modelo es un equipo de 24.576 pequeños especialistas ("expertos"), como 24.576 libros de consulta. Cada palabra necesita solo 10 de ellos.
- **Tu tarjeta gráfica es el escritorio.** Es pequeño y rápido. Los unos 4.000 libros que más se usan están abiertos encima.
- **Tu RAM son las estanterías de la sala de lectura.** Los 24.576 libros están ahí. Cuando una palabra necesita un libro que
no está en el escritorio, tu procesador lo coge enseguida de la estantería mientras la tarjeta sigue trabajando.
- **Tu SSD es el archivo.** Guarda una tabla de consulta de 29 GB. El modelo lee unas pocas filas por palabra, así que no
hace falta que esté en la RAM.
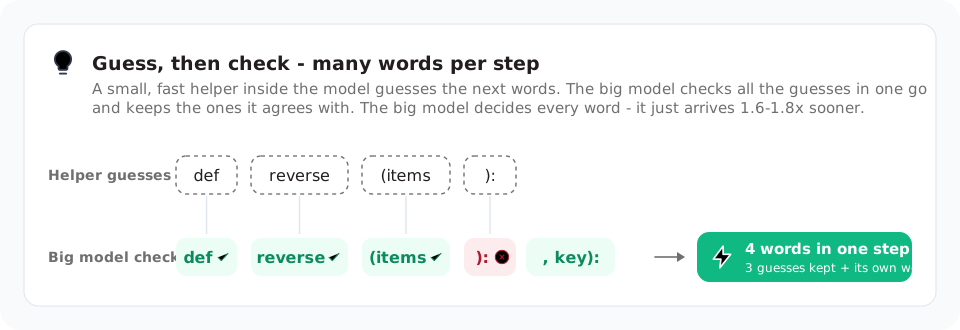
Un pequeño ayudante también adivina las siguientes palabras. El modelo grande las comprueba todas a la vez y se queda con
las correctas. Obtienes la misma respuesta, entre 1,6 y 1,8 veces antes. Los textos largos se leen en trozos grandes, de
hasta 8.192 tokens a la vez, a más de 1.000 tokens por segundo.
La explicación más larga: [docs/HOW_IT_WORKS.md](docs/HOW_IT_WORKS.md). Cada parte con sus cifras:
[los detalles](docs/DETAILS.md#how-it-works) y el [artículo](docs/paper/Strata-Paper.pdf).
## ¿Algo ha ido mal?
- **Mi PC se congeló la primera vez que arrancó Strata.** Carga el modelo en la RAM. Espera y no cierres la ventana. ¿Sigue
congelado después de 10 minutos? Reinicia el PC, cierra otros programas e inténtalo de nuevo, o elige un tamaño más pequeño.
- **Se detuvo durante la descarga o la instalación.** Abre de nuevo la aplicación o `strata launch`, o vuelve a ejecutar
`START-HERE.bat` (o `./setup.sh`). Continúa donde se quedó.
- **Va muy lento, la luz del disco parpadea sin parar, o dice "the engine stopped unexpectedly".** Tu PC no tiene bastante
RAM libre. Cierra otros programas (los navegadores gastan mucha) o elige un tamaño más pequeño, como Q2_0 o IQ2_XS.
- **Dice que no hay motor para este PC.** En la aplicación, abre **Ajustes, Motor** y pulsa **Actualizar motor**. En la
Terminal, ejecuta `strata update`. `strata doctor` muestra qué archivos del motor están instalados.
- **Dice que el puerto 8080 ya está en uso.** Strata ya se está ejecutando. Busca su ventana.
Más problemas y soluciones: [docs/TROUBLESHOOTING.md](docs/TROUBLESHOOTING.md). ¿Sigues atascado? Abre una
[incidencia](https://github.com/Niko1221/Strata/issues). En la aplicación, adjunta el archivo de **Ajustes, Motor,
Diagnóstico, Ver registros, Guardar registros**. En la Terminal, pega la salida de `strata doctor`. Si lo ejecutas desde el
código fuente, adjunta `strata-.log` de la carpeta de Strata. Para un problema de seguridad, avísanos en privado:
[SECURITY.md](SECURITY.md).
## Créditos y licencia
El modelo es [Qwen3.8-Flash-Next](https://huggingface.co/Qwen/Qwen3.8-Flash-Next), del equipo de Qwen. Lo comprimieron
[ISTA-DASLab](https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF), UkisAI (Swift 1.5), agentionai (Gyro)
y Unsloth. Strata usa partes de [llama.cpp / ggml](https://github.com/ggml-org/llama.cpp). Todos los créditos:
[docs/HOW_IT_WORKS.md](docs/HOW_IT_WORKS.md#credits). Strata es de código abierto con la [licencia MIT](LICENSE). Algunas
partes y todos los modelos tienen sus propias licencias ([cuáles](docs/HOW_IT_WORKS.md#license)).
## Contribuir
¿Has encontrado un error, o quieres enviar un cambio o un benchmark? Lee primero [CONTRIBUTING.md](CONTRIBUTING.md). Explica
qué incluir para que otros puedan comprobar tu trabajo.
## Apoya Strata
Strata es gratis y tiene licencia MIT. Lo construyo y lo pruebo en el hardware que consigo. Si te funciona bien en tu PC, un café me ayuda
a seguir probando tarjetas nuevas y a arreglar lo que nos cuentas. Sin presión. Usarlo y contar lo que encuentras ayuda igual de mucho.
¿Te interesa patrocinar Strata? Escríbeme a través de [GitHub](https://github.com/Niko1221).


 ¿Te interesa patrocinar Strata? Escríbeme a través de [GitHub](https://github.com/Niko1221).