English · 简体中文 · 日本語 · Deutsch · Français · Español · Português
在你自己的游戏电脑上运行最先进的模型
支持 NVIDIA、AMD、Intel · Windows、Linux、Mac · 免费开源


一座体素宝塔花园,由一条提示词一次生成,在装有 RTX 5070 的电脑上用 Strata 运行(IQ3_S,128K 上下文) ·
完整视频(49 秒)
Strata 运行 **[Qwen3.8-Flash-Next](https://huggingface.co/Qwen/Qwen3.8-Flash-Next)**。这是一个 1250 亿参数的模型,
通常需要服务器才能跑,现在用普通电脑就行。它能聊天、写代码、看图片,也能配合你的应用和编程智能体使用。
你的聊天记录和文件都留在你自己的电脑上。
**第一次用?** 先看[硬件要求](#硬件要求),再[安装应用](#方式-astrata-应用)。
- **游戏电脑就能跑。** 内存和显存加起来有 32 GB 就可以开始。
- **能接入你的工具。** 支持 OpenAI 和 Anthropic 的 API,Claude Code、Codex CLI、OpenCode 等智能体都能连上。
- **能看图片。** 默认开启。
- **免费。** MIT 许可证,不用注册账号,不走云端。
- **隐私。** 没有遥测。Strata 下载什么、什么时候联网、如何校验下载内容,都写在 [docs/SAFETY.md](docs/SAFETY.md)。
版本 0.2.1 · 引擎 0.1.46
## 硬件要求
**内存和显存(VRAM)加起来至少要有 32 GB。** Mac 和 Ryzen AI Max 上指的是统一内存。内存越大,能跑的模型越大,
或者速度越快。
- 32 GB 内存加一张 12-16 GB 显存的显卡,可以跑 Coder。
- 64 GB 内存可以跑所有尺寸。
| 你的电脑 | 说明 |
| --- | --- |
| **NVIDIA** GeForce RTX 20、30、40、50 系列(12 GB 及以上) | 安装应用或终端版即可。 |
| **AMD** Radeon RX 6800 及更新型号、Radeon AI PRO R9700(12 GB 及以上) | [AMD 显卡](docs/AMD_HIP.md) |
| **Intel** Arc | [Intel Arc](docs/INTEL_ARC.md)、[Intel 引擎](docs/INTEL.md) |
| **Apple 芯片 Mac**(M1 及更新,macOS 15 及以上) | [Mac](docs/MAC.md) |
| **AMD Ryzen AI Max(Strix Halo)** 及其他统一内存系统 | [Strix Halo](docs/STRIX_HALO.md) |
| 较旧的显卡和处理器 | [旧显卡](docs/OLDER_GPUS.md)、[旧处理器](docs/INSTALL.md#older-cpus-experimental) |
另外还需要:
- 约 80 GB 的可用磁盘空间(用固态硬盘,首次启动会快很多)
- Windows 10 / 11、Linux 或 macOS
- 较新的显卡驱动
同一品牌的两三张显卡可以共同运行一个模型([多显卡](docs/MULTI_GPU.md))。Strata 不会把一个模型拆到 NVIDIA 和 AMD
显卡上。完整列表见 [docs/INSTALL.md](docs/INSTALL.md#what-you-need)。
## 安装
三种方式任选一种。它们启动的是同一个引擎,用的是同样的模型。
### 方式 A:Strata 应用
最简单的方式。应用内置引擎:安装、选模型、开始聊天。请根据你的系统和显卡,从
[发布页](https://github.com/Niko1221/Strata/releases/latest)下载对应的文件。不确定选哪个?看表格下面那一段。
| 系统 | 你的显卡 | 要下载的文件 |
| --- | --- | --- |
| **Windows 10 / 11** | NVIDIA RTX,驱动 580 或更新 | [`Strata-0.2.1-windows-cuda13.exe`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-windows-cuda13.exe) |
| | NVIDIA,较旧的显卡,或驱动低于 580 | [`Strata-0.2.1-windows-cuda12.exe`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-windows-cuda12.exe) |
| | AMD Radeon RX 9000 系列或 Radeon AI PRO R9700 | [`Strata-0.2.1-windows-hip.exe`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-windows-hip.exe) |
| | AMD Radeon RX 7000 系列或 Ryzen AI Max (Strix Halo) | [`Strata-0.2.1-windows-hip-rdna3.exe`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-windows-hip-rdna3.exe) |
| **Linux** | NVIDIA RTX,驱动 580 或更新 | [`Strata-0.2.1-linux-nvidia-cuda13.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-nvidia-cuda13.AppImage) |
| | NVIDIA,较旧的显卡,或驱动低于 580 | [`Strata-0.2.1-linux-nvidia-cuda12.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-nvidia-cuda12.AppImage) |
| | AMD Radeon RX 9000 系列或 Radeon AI PRO R9700 | [`Strata-0.2.1-linux-amd-rx9070.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-amd-rx9070.AppImage) |
| | AMD Radeon RX 7000 系列 | [`Strata-0.2.1-linux-amd-rx7900.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-amd-rx7900.AppImage) |
| | AMD Ryzen AI Max (Strix Halo) | [`Strata-0.2.1-linux-amd-strixhalo.AppImage`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-linux-amd-strixhalo.AppImage) |
| **Mac**(Apple 芯片,macOS 15 及以上) | 内置 | [`Strata-0.2.1-mac.dmg`](https://github.com/Niko1221/Strata/releases/latest/download/Strata-0.2.1-mac.dmg) |
**不确定时:** NVIDIA 显卡的驱动版本在 580 及以上就选 `cuda13`,否则选 `cuda12`。`cuda12` 适用于较旧的显卡和驱动。
`hip` 和 `amd` 的文件是给 AMD 显卡用的。其他 AMD 显卡(RX 6000)目前还没有现成的应用,
请看 [AMD 显卡](docs/AMD_HIP.md)。
然后:
- **Windows:** 运行 `.exe`。它只为当前用户安装,不需要管理员权限。如果 Windows 提示“Windows 已保护你的电脑”,
点击**更多信息**,再点**仍要运行**(安装程序还没有代码签名)。
- **Linux:** 给文件加上可执行权限(`chmod +x`),然后启动。需要 FUSE 2:`sudo apt install libfuse2`(Ubuntu 22.04),
或 `libfuse2t64`(Ubuntu 24.04 及更新)。
- **Mac:** 打开 `.dmg`,把 Strata 拖到“应用程序”。
第一个界面里,应用会检测你的电脑,并推荐合适的模型。点击安装即可。模型很大,要下载约 40-70 GB,中断后会从断点继续。
关闭窗口会同时停止 Strata 和引擎。
### 方式 B:终端(一行命令)
终端版就是 `strata` 命令,适合脚本、服务器和 AI 智能体。
Linux 和 Mac:
```sh
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh | sh
```
Windows(PowerShell):
```powershell
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
```
脚本会检查你的电脑,下载终端版,校验 SHA-256,然后解压到你的用户目录。不需要管理员权限。在 Windows 上,装完后请
打开一个新的终端窗口。然后启动 Strata:
```sh
strata launch
```
它会一次问一个问题:模型、上下文、图片、允许谁连接。接着为你的显卡下载引擎(已签名,使用前会先试启动),再下载
模型,并开始提供服务。在脚本和 AI 智能体里,请使用参数:
```sh
strata launch --model q2_0 --yes --no-tui
```
如果想在运行前先看看安装脚本,先用 `curl -fsSL -o install.sh` 下载,读完后再用 `sh install.sh` 运行。
所有界面和参数见 [docs/TERMINAL_LAUNCH.md](docs/TERMINAL_LAUNCH.md)。
### 方式 C:让你的 AI 来安装
把下面这段话粘贴到 Claude Code、Cursor、Codex、GitHub Copilot 或其他编程助手里:
```text
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.
```
它会检查你的显卡、内存和磁盘,选出合适的模型,完成安装和启动,并告诉你怎么连接你的应用。AI 工具也可以通过 Strata 的
[MCP 服务器](docs/MCP_SERVER.md)安装、启动和停止 Strata。
想自己动手编译?请看[从源码构建](#从源码构建)。
## 模型
应用和 `strata launch` 会按你的内存推荐模型。它是同一个模型的几种尺寸,压缩程度不同。尺寸小的更快,尺寸大的稍微更聪明一点。
### 内存不够?试试 Gyro
[Gyro](https://huggingface.co/agentionai/Qwen3.8-Flash-Next-Gyro-GGUF)(作者 agentionai)是运行这个模型占用最小的方式。
| 尺寸 | 所需内存(RAM + VRAM) | 下载大小 | 说明 |
| --- | ---: | ---: | --- |
| **Gyro-S** | 27.6 GB | 58.5 GB | 给其他尺寸都放不下的电脑。质量低于 IQ2_XS。 |
| **Gyro-M** | 35 GB | 92.0 GB | 质量约相当于 IQ3_XXS,显存占用少约 20%。在 12 GB 显卡和 R9700 上,输出回答比 Q2_0 慢 17-21%。 |
Gyro 可在 NVIDIA 和 AMD 显卡上运行(AMD 为实验性支持),不支持 Intel Arc 和 Mac。详情和测试数据:
[docs/GYRO.md](docs/GYRO.md)。用 `strata launch --model gyro-s` 启动。
### 其他尺寸
| 你的内存(RAM + VRAM) | 选择 | 备注 |
| --- | --- | --- |
| **32 GB** | **Gyro-S**,写代码可选 **[Coder](docs/MODELS.md#coder)** | Coder 需要 32 GB 内存,只保留一半的专家,所以代码以外的能力较弱 |
| **40 GB** | **[Swift 1.5](docs/MODELS.md#swift-15)** IQ2_XS(39.2 GB),或 **Gyro-M**(35 GB) | Swift 回答前思考的时间更短。Gyro-M 的质量接近 IQ3_XXS,但输出回答比 Q2_0 慢 17-21% |
| **48 GB** | **IQ3_XXS**(47.0 GB) | 更慢,更好 |
| **64 GB** | **IQ3_S**(54.8 GB),原版或 Swift 1.5 | 最慢,最好:在公开测试中与完整模型持平 |
| **96 GB 及以上** | Unsloth 的 **UD-IQ4_XS**(约 72 GB 内存)到 **Q8_0**(约 136 GB),4 到 8 位 | 更接近完整模型。内存不足时,Strata 会从固态硬盘读取一部分,速度会慢很多 |
内存比这一行写的少,也可能能用:Strata 会自动切换到[低内存模式](docs/MODELS.md#a-big-graphics-card-and-little-ram)。
速度会变慢,显卡较小时会慢得多。
更多选择:
- **[Swift 1.5](docs/MODELS.md#swift-15)** 是微调版本,回答前思考的时间更短,质量和内存占用大致相同。
- **[NVFP4](docs/NVFP4.md)** 是 NVIDIA 为 NVIDIA 显卡提供的 4 位版本。要把所有专家放进内存,需要约 80 GB 内存。
- **[Qwen3.6-35B-A3B](docs/QWEN36.md)** 是另一个更小的模型,能看图片,还能同时回答多个请求。
- **[OrcaRouter 的 Uncensored IQ3_XXS](docs/MODELS.md#orcarouter-uncensored-iq3_xxs)** 需要手动设置。
所有尺寸、下载大小,以及各种配置能跑什么:[docs/MODELS.md](docs/MODELS.md)。
## 速度如何?
以下数据基于 12 GB 显卡(RTX 5070、Ryzen 5 7600、64 GB 内存)。其他显卡的结果见:
[各模型的速度](docs/MODELS.md#how-fast-is-each-size)、[社区测试结果](docs/COMMUNITY_BENCHMARKS.md)。
| 模型 | 回答输出速度 | 读取提示词速度 |
| --- | --- | --- |
| **Q2_0** | `████████████` 94 tokens/s | `████████████` 2,650 tokens/s |
| **IQ2_XS** | `██████████░░` 79 tokens/s | `█████████░░░` 2,090 tokens/s |
| **IQ3_XXS** | `████████░░░░` 62 tokens/s | `████████░░░░` 1,750 tokens/s |
| **IQ3_S** | `███████░░░░░` 53 tokens/s | `███████░░░░░` 1,620 tokens/s |
| **Coder** | `███████░░░░░` 55 tokens/s | `██████████░░` 2,180 tokens/s |
一个 token 约等于 ¾ 个英文单词,所以每秒 60 个 token 比你阅读的速度还快。“读取提示词”指 Strata 吸收长文档、代码或聊天历史的速度。
在 16 GB 的 AMD 显卡上测得的结果(RX 9070 XT、Ryzen 9 3900X、47 GB 内存):
| 模型 | 回答输出速度 | 读取提示词速度 |
| --- | --- | --- |
| **Q2_0** | `████████░░░░` 60 tokens/s | `█████░░░░░░░` 1,160 tokens/s |
| **IQ2_XS** | `███████░░░░░` 52 tokens/s | `█████░░░░░░░` 1,110 tokens/s |
| **Coder** | `██████░░░░░░` 44 tokens/s | `██████░░░░░░` 1,420 tokens/s |
两张表的进度条使用同一个比例。显存更大的显卡更快:RTX 3090(24 GB)每秒大约能输出 100-140 个 token。每个数字对应的引擎版本见
[DETAILS.md](docs/DETAILS.md#speed-measured)。
## 使用方法
### 在应用里
应用包含**聊天**、显示模型以及 GPU、CPU 和内存状态的**监控**、**模型**页面和**设置**。聊天可以在你电脑上的某个文件夹里工作。
在**手动**模式下,修改文件或运行命令之前它会先询问你。输入 `/loop 10m <要做的事>`,在聊天保持打开期间每 10 分钟重复发送一次消息。
聊天可以用 DuckDuckGo(或 Bing)搜索网页,不需要账号。你也可以在**设置,工具**里添加搜索密钥。搜索是唯一会把内容发出电脑的功能,
发出的就是搜索词。
要同时运行两个模型,请打开**运行多个模型**,并为每个模型分配同一品牌的单独一张显卡。
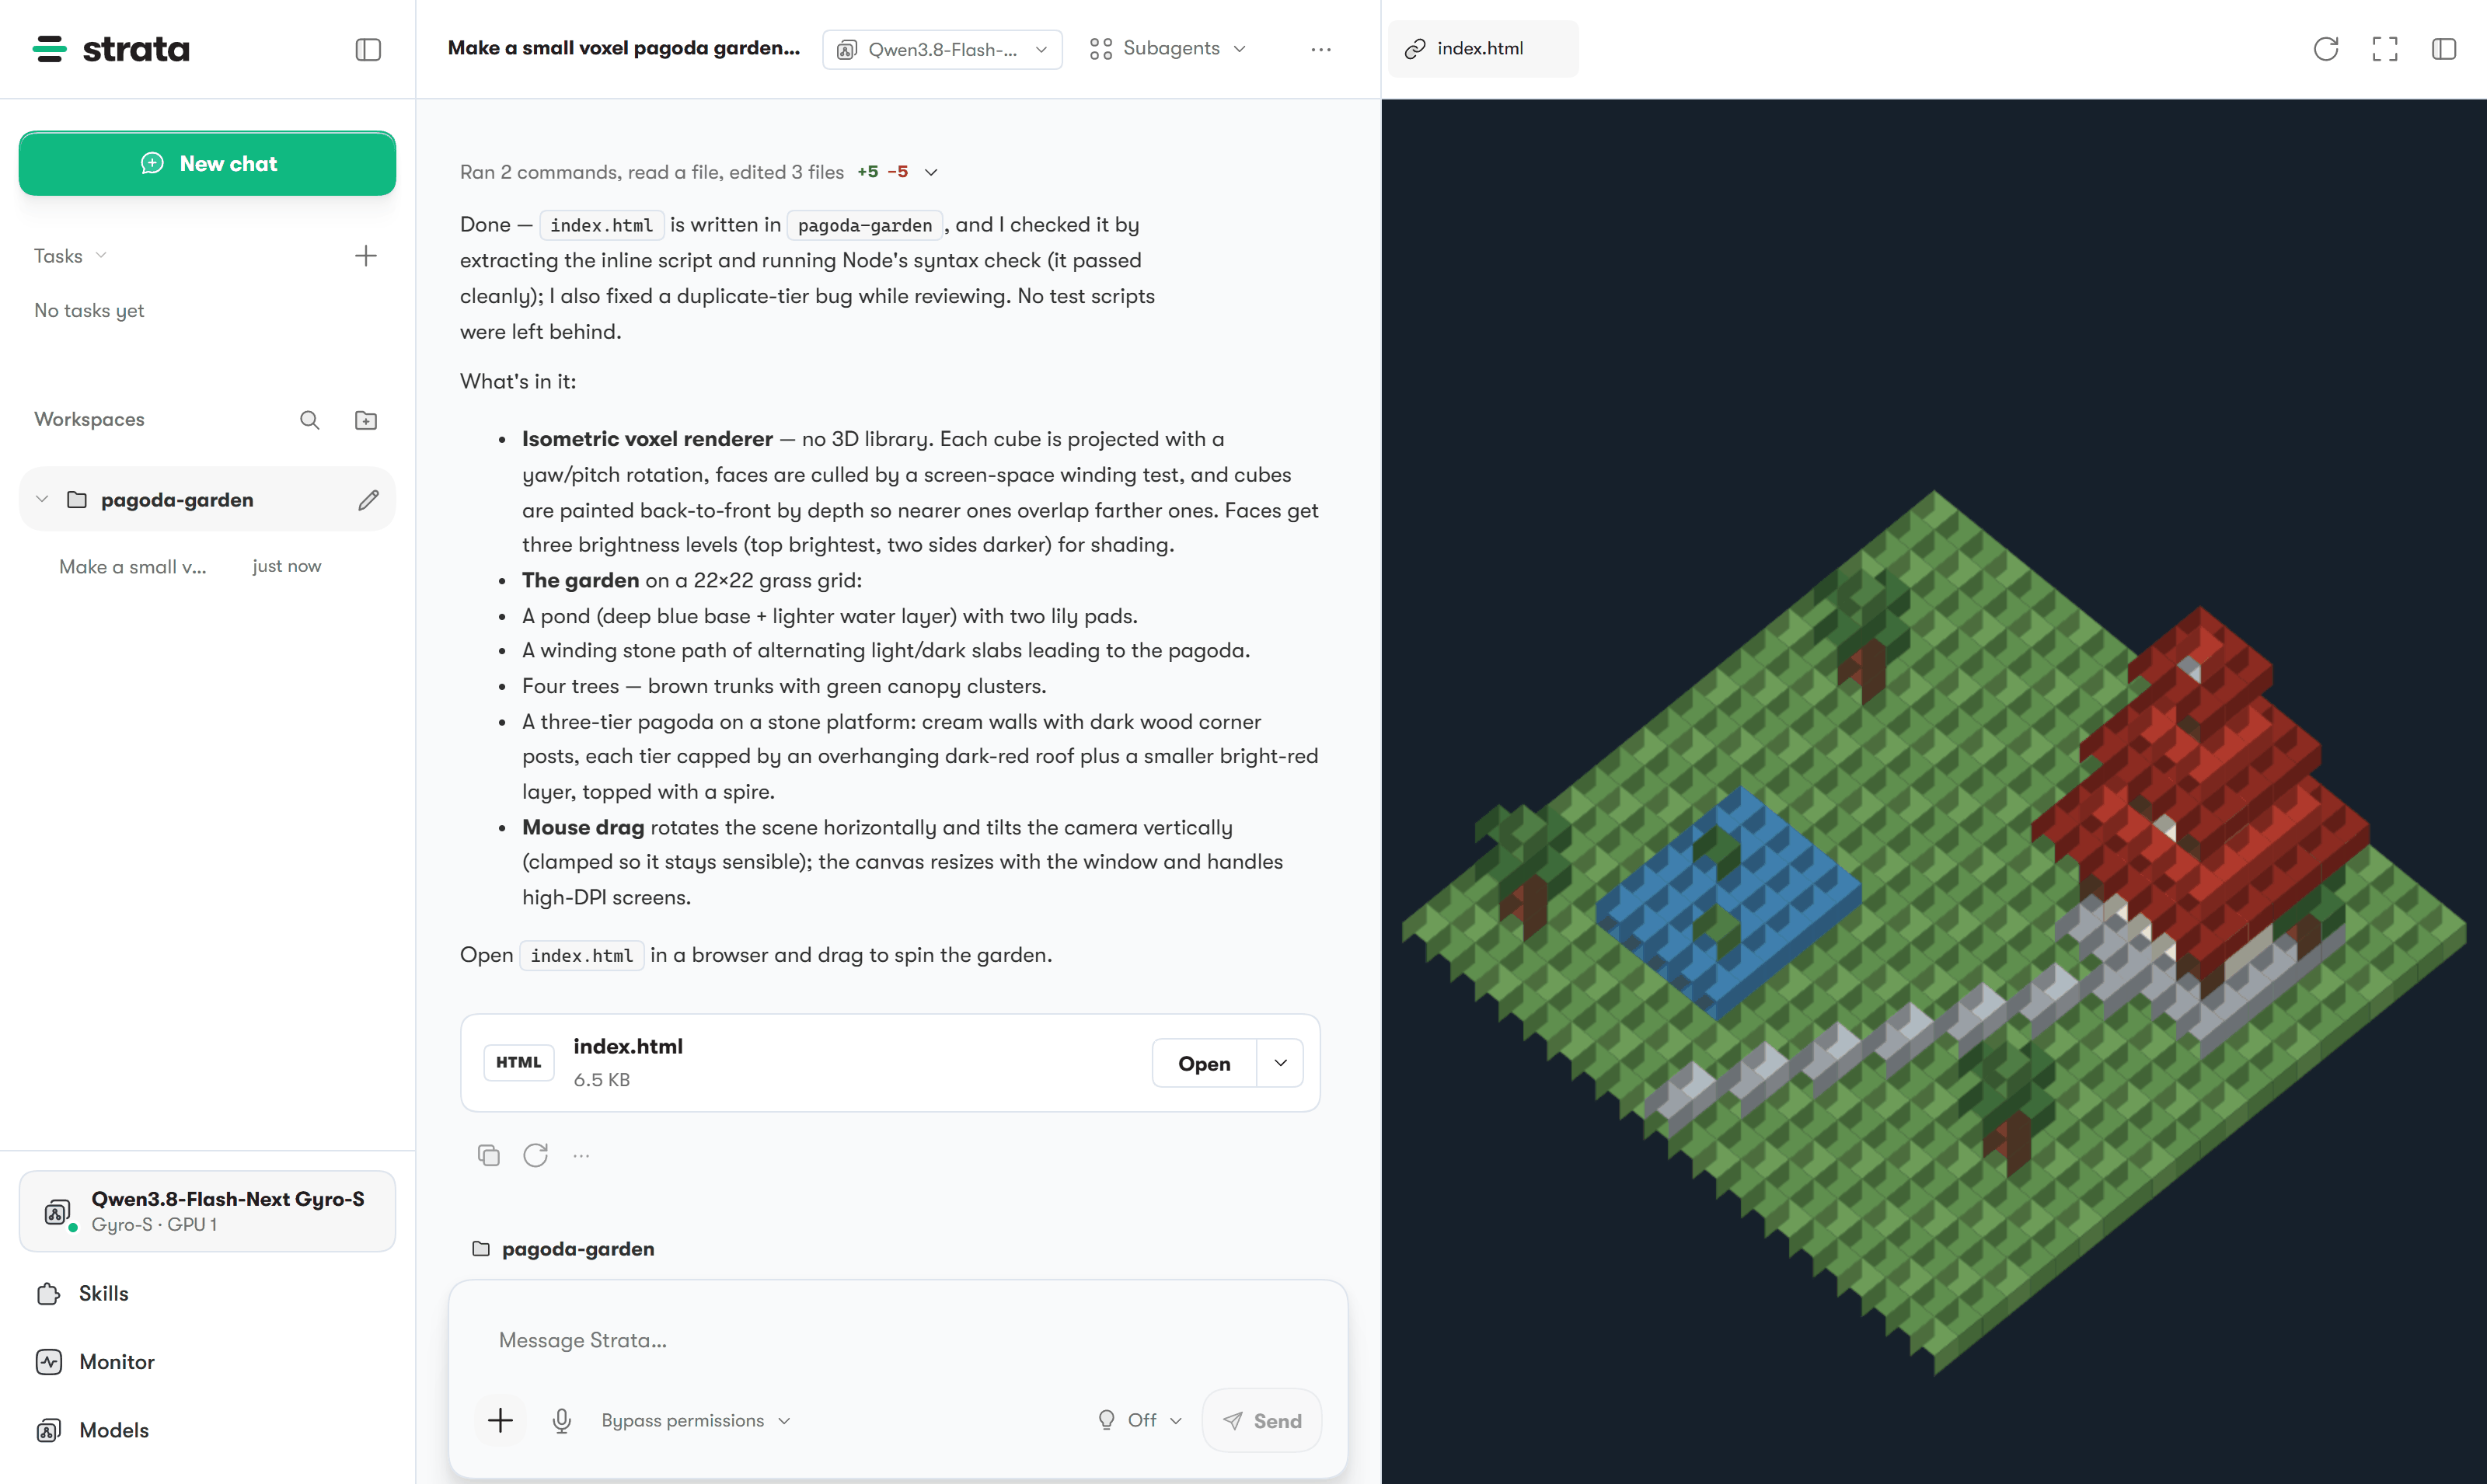
Strata 应用中的一次对话:智能体用一个 HTML 文件写出了一个小型体素宝塔花园,页面在对话旁的预览中打开
### 在终端里
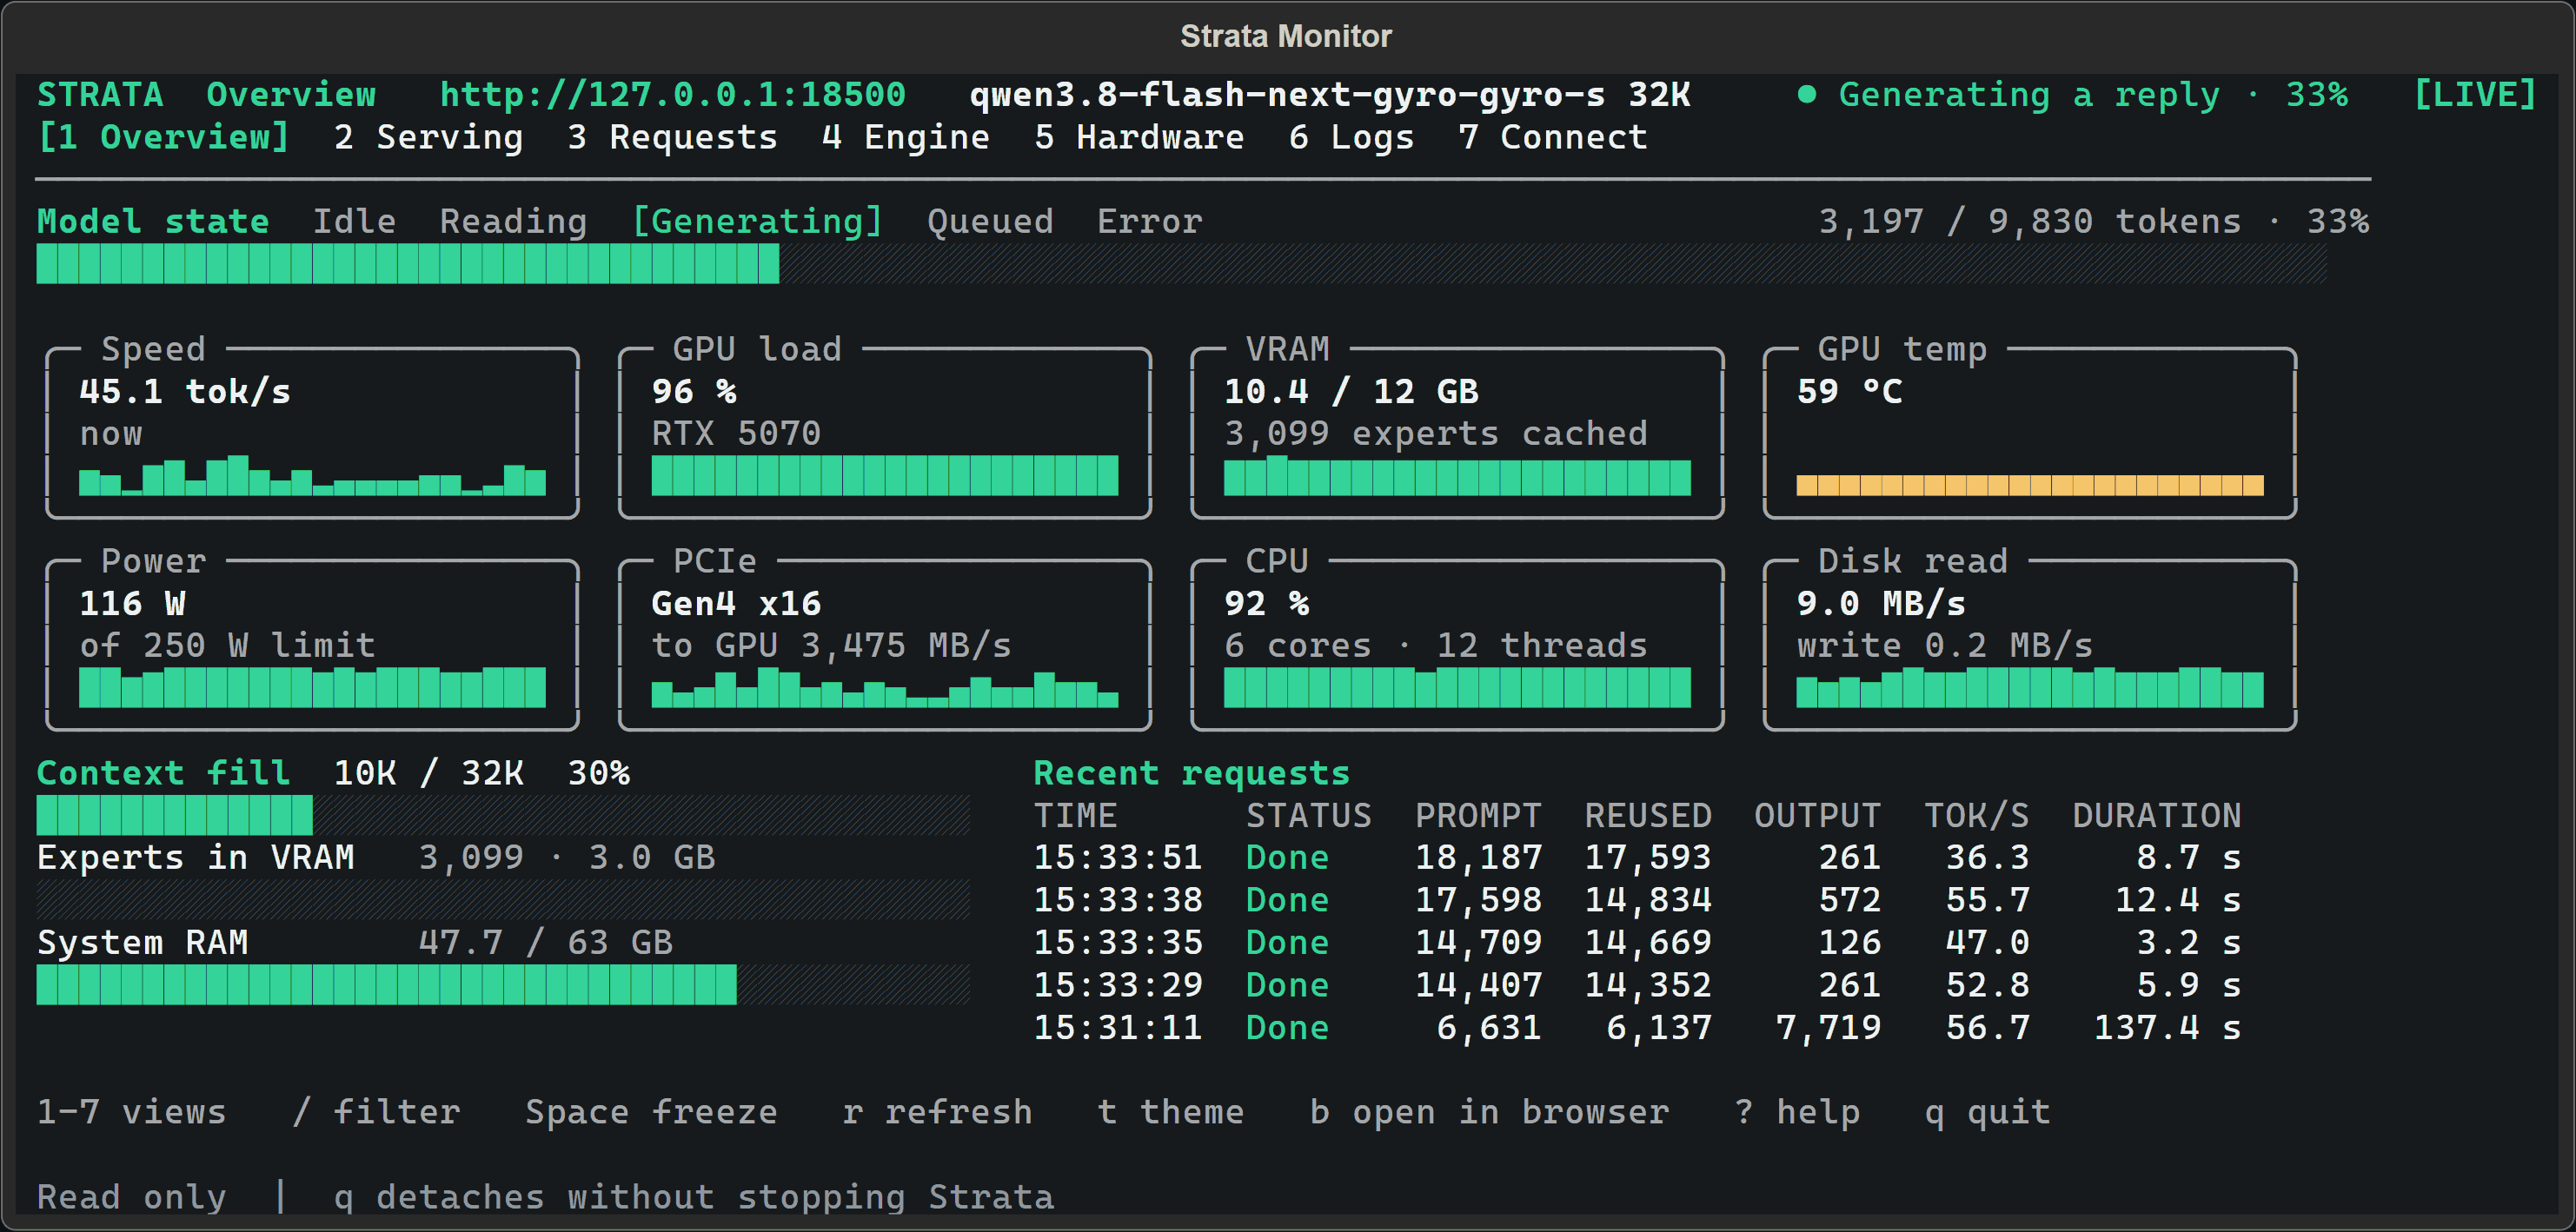
模型回复时的 strata monitor:速度、GPU、内存和最近的请求
```sh
strata launch # 引导界面:模型、上下文、图片、访问方式,然后开始服务
strata launch --model q2_0 --yes --no-tui # 不提问:开始服务,打印地址,然后返回
strata launch --plan --model q2_0 # 显示将要执行的操作;不做任何更改
strata launch --status # 当前正在提供什么服务
strata launch --stop # 停止服务
strata monitor --url http://127.0.0.1:8080 # 查看速度、GPU、内存和请求
strata update --check # 有新引擎吗?(strata update 会安装它)
strata doctor # 检查已安装的引擎文件
```
`strata --help` 会列出所有命令。启动和提供服务时不会下载任何东西。只有安装、`strata launch`(在你选择模型时)和
`strata update` 会下载。要从手机或另一台电脑访问 Strata,请使用 `strata launch --access lan`。它会生成一个 API 密钥,
没有密钥就不会在网络上启动。除非你加上 `--open`,否则不会打开浏览器。指南:[docs/TERMINAL_LAUNCH.md](docs/TERMINAL_LAUNCH.md)。
完整的客户端说明:[docs/TERMINAL.md](docs/TERMINAL.md)。
### 配合 AI 智能体
智能体用方式 B 中的一行命令安装 Strata,然后运行 `strata launch --model NAME --yes --no-tui`。步骤、参数和退出码见
[docs/AI_SETUP.md](docs/AI_SETUP.md),仓库规则见 [AGENTS.md](AGENTS.md)。
### 连接你的其他应用
| 应用类型 | 基础 URL |
| --- | --- |
| 兼容 OpenAI(大多数应用和智能体) | `http://127.0.0.1:8080/v1`(API 密钥和模型名称随便填) |
| Anthropic API(Claude Code 等) | `http://127.0.0.1:8080`,不带 `/v1`。这些应用会自己加上 `/v1/messages`。Claude Code:`ANTHROPIC_BASE_URL=http://127.0.0.1:8080` |
| OpenAI Responses API(Codex CLI) | `http://127.0.0.1:8080/v1/responses`([设置方法](docs/DETAILS.md#the-responses-api-and-codex-cli)) |
`strata connect` 会打印 OpenCode、Codex CLI、Claude Code、oh-my-pi、pi、Hermes Agent 和 OpenClaw 的具体设置。
`strata connect opencode --write` 会在询问后写入配置文件,并保留备份。
### 图片
能看图片的模型默认开启图片功能。在聊天里附加或粘贴图片,或者从你的应用发送图片。显卡的显存小于 24 GB 时,读图由处理器完成
(每张图片几秒钟,不占用显卡的显存);显存达到 24 GB 时,由显卡完成。NVIDIA 和 AMD 的规则相同。你可以按模型关闭图片功能,
也可以用 `--vision off`、`--vision gpu` 或 `--vision cpu` 选择读图方式。
这条规则背后的数据:在 Radeon AI PRO R9700 上,显卡读一张 260 token 的图片用了 57 ms,处理器用了 3.1 秒。在 16 GB 的显卡
(Tesla P100 和 RTX A4000,Linux)上,用显卡读图会让文字速度下降 3-5%,因为它占用约 1.4 GB 显存,否则这部分会被模型使用。
在 Mac 上,无论内存多大,都由 GPU 读图(32 GB 的 M4 上读一张 260 token 的图片用 0.45 秒,占用约 1.2 GB 共享内存);处理器读一张约需 50 秒,所以只有指定 `--vision cpu` 时才用。
### 使用须知
- 在聊天菜单或你的应用的“reasoning effort”里选择思考级别(**off、low、medium 或 high**)。off 最快。
- Strata 默认一次回答一个请求。要同时处理多个,请在 `strata launch` 中使用 `--parallel N`,或在配置里写
`"parallel": 2`([BATCHING.md](docs/BATCHING.md))。在 12 GB 显卡上,这会让每个回答变慢。
- Strata 会完整读取聊天的第一条消息,每 30,000 个 token 约需 1 分钟。之后的消息几秒钟就开始。
- 聊天记录存放的位置和完整的 API:[docs/INSTALL.md](docs/INSTALL.md#where-things-are-stored)、[docs/DETAILS.md](docs/DETAILS.md#using-it)。
## 从源码构建
从仓库构建 Windows、Linux 和 Mac 版本
[下载 Strata](https://github.com/Niko1221/Strata/archive/refs/heads/main.zip)并解压,或者用 `git clone` 获取。
**Windows:** 双击 `START-HERE.bat`。**Linux:** 在 Strata 文件夹里运行 `./setup.sh`。
**Mac(Apple 芯片,macOS 15 及以上):** 先用 `xcode-select --install` 安装一次 Apple 的命令行工具(不需要完整的 Xcode)。
在 Strata 文件夹里打开终端,运行 `./setup.sh`。它会在你的 Mac 上构建 Mac 引擎(约 7 分钟),问同样的问题,下载模型并启动。
下次运行 `./setup.sh` 会直接启动。你的 Mac 适合哪个尺寸:[docs/MAC.md](docs/MAC.md)。
安装程序会找到你的显卡,并设置合适的引擎。它会问你用哪个模型和尺寸、上下文多长(模型能记住多少文字),以及是否要读取图片。
直接按回车就是推荐的选择。然后它会下载模型(约 70 GB)并启动。如果下载中断,再运行一次就会继续。浏览器会打开
`http://127.0.0.1:8080` 上的 Strata 页面。
> 模型启动期间,你的电脑可能会变慢,或者在 1-3 分钟内没有响应(第一次最久)。Strata 会把 35-55 GB 加载到内存里,并锁定其中一部分
> 给显卡使用。请等待,不要关闭窗口。
下次再运行 `START-HERE.bat`(或 `./setup.sh`)会立即启动,不会重复下载。关闭它的窗口就能停止模型。`UPDATE.bat`
(`./update.sh`)只更新 Strata,不启动。更新、Docker、多显卡、文件存放位置和所有选项:[docs/INSTALL.md](docs/INSTALL.md)。
要测试你的电脑,运行 `BENCH.bat`(`./bench.sh`)。需要 5-10 分钟,并生成一份可以分享的报告
([方法](docs/COMMUNITY_BENCHMARKS.md#run-the-benchmark))。
**可选:整个模型都放得进内存时,让单卡更快。** 这是 RubenTorney 提供的两个需要手动开启的设置(#1904、#1905)。
当你只用一张显卡,并且内存装得下所有专家时,它们会有帮助,例如在 64 GB 的电脑上跑 Q2_0 或 IQ3_XXS。打开 Strata 数据文件夹里的
`strata-.json`([位置](docs/INSTALL.md#where-things-are-stored)),然后添加:
- 在 `"args"` 列表中加入 `"--adapt-async", "1"`。这样专家缓存会在辅助线程上更新,不会让回答暂停。在 RTX 5070
(Windows,Q2_0)上测得:解码快 4-5%,代码和长文档快 7-10%。回答可能与默认设置略有不同,但每次运行的结果保持一致。
- 在 `"env"` 块中加入 `"STRATA_PIN_BY_NEED": "1"`(Windows)。Windows 只能为显卡锁定大约一半的内存,
这个设置会优先锁定显卡最先需要的专家。在 RTX 5070 上测得:读取提示词快 4.4%。
```json
"args": [ ..., "--adapt-async", "1" ],
"env": { "STRATA_PIN_BY_NEED": "1" }
```
修改后请重启 Strata。要撤销,删除这两项即可。
## 工作原理
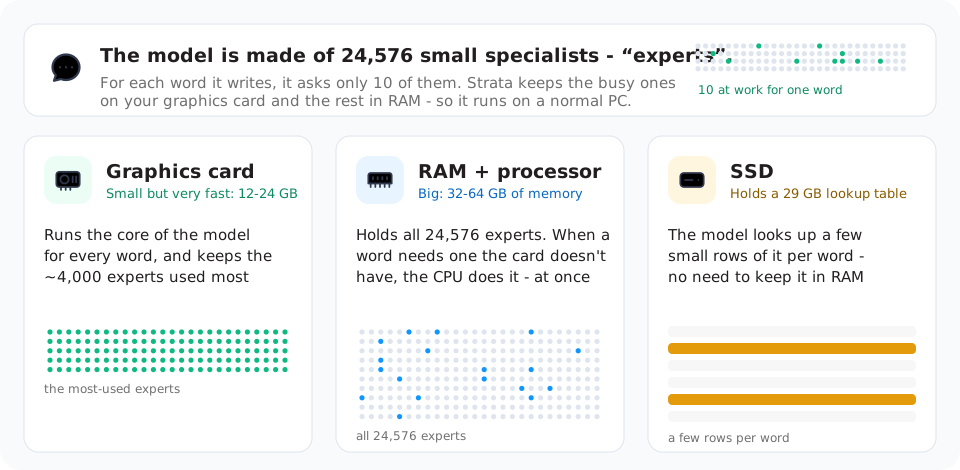
这类模型通常运行在有几百 GB 显存的服务器上。你的显卡只有 12-24 GB。Strata 把工作分给整台电脑,让模型装得下。
可以把它想成一座图书馆。
- 模型是一个由 24,576 位小专家(“experts”)组成的团队,好比 24,576 本参考书。每个词只需要其中 10 本。
- **你的显卡是书桌。** 它小而快。最常用的大约 4,000 本书摊开放在上面。
- **你的内存是阅览室的书架。** 24,576 本书都在这里。某个词需要一本不在书桌上的书时,处理器会立刻从书架上取来读,显卡则继续工作。
- **你的固态硬盘是档案室。** 里面存着一张 29 GB 的查找表。模型每个词只读其中几行,所以不用常驻内存。
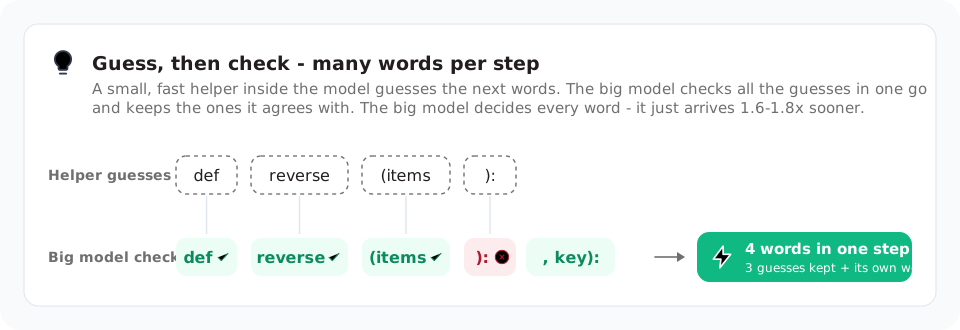
另外有一个小助手会猜接下来的几个词。大模型一次检查所有猜测,保留正确的部分。得到的答案不变,但快了 1.6-1.8 倍。
长文本按大块读取,一次最多 8,192 个 token,速度超过每秒 1,000 个 token。
更详细的解释:[docs/HOW_IT_WORKS.md](docs/HOW_IT_WORKS.md)。每个部分和它的数据:
[详细说明](docs/DETAILS.md#how-it-works)和[论文](docs/paper/Strata-Paper.pdf)。
## 出问题了?
- **第一次启动 Strata 时我的电脑卡住了。** 它在把模型加载到内存。请等待,不要关闭窗口。10 分钟后还是卡住?重启电脑,
关闭其他程序后再试,或者选一个更小的尺寸。
- **下载或安装时中断了。** 重新启动应用或 `strata launch`,或者再运行一次 `START-HERE.bat`(或 `./setup.sh`)。
它会从中断的地方继续。
- **非常慢、硬盘灯一直闪,或者提示“引擎意外停止”。** 你的电脑可用内存不够。关闭其他程序(浏览器很占内存),
或者选一个更小的尺寸,比如 Q2_0 或 IQ2_XS。
- **提示这台电脑没有可用的引擎。** 在应用里打开**设置,引擎**,点击**更新引擎**。在终端里运行 `strata update`。
`strata doctor` 会显示已安装哪些引擎文件。
- **提示 8080 端口已被占用。** Strata 已经在运行了。找一下它的窗口。
更多问题和解决办法:[docs/TROUBLESHOOTING.md](docs/TROUBLESHOOTING.md)。还是解决不了?请提交
[issue](https://github.com/Niko1221/Strata/issues)。在应用里,附上**设置,引擎,诊断,查看日志,保存日志**得到的文件。
在终端里,粘贴 `strata doctor` 的输出。从源码运行时,附上 Strata 文件夹里的 `strata-.log`。
如果是安全问题,请私下报告:[SECURITY.md](SECURITY.md)。
## 致谢与许可证
模型是 Qwen 团队的 [Qwen3.8-Flash-Next](https://huggingface.co/Qwen/Qwen3.8-Flash-Next)。压缩工作由
[ISTA-DASLab](https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF)、UkisAI(Swift 1.5)、agentionai(Gyro)
和 Unsloth 完成。Strata 使用了 [llama.cpp / ggml](https://github.com/ggml-org/llama.cpp) 的部分代码。全部致谢:
[docs/HOW_IT_WORKS.md](docs/HOW_IT_WORKS.md#credits)。Strata 以 [MIT 许可证](LICENSE)开源。少数部分和所有模型有各自的许可证
([具体是哪些](docs/HOW_IT_WORKS.md#license))。
## 参与贡献
发现了 bug,或者想提交修改或基准测试结果?请先阅读 [CONTRIBUTING.md](CONTRIBUTING.md)。其中说明了需要附上哪些内容,
方便其他人核实你的工作。
## 支持 Strata
Strata 免费,采用 MIT 许可证。我在能拿到的各种硬件上开发和测试它。如果它在你的电脑上跑得不错,请我喝杯咖啡,能帮我继续测试新显卡、
修复你们反馈的问题。不用有压力。使用它并反馈你的发现,同样很有帮助。
 有兴趣赞助 Strata?请通过 [GitHub](https://github.com/Niko1221) 联系我。
