
LibreDB Studio
El editor de bases de datos que se despliega junto a tus datos, no dentro de tu laptop.
English ·
简体中文 ·
日本語 ·
Español ·
اردو ·
हिन्दी
Listado por el proyecto PostgreSQL:
News
·
PostgreSQL Clients
·
Software Catalogue
·
Community Guide to GUI Tools
Listado también en la documentación oficial de
Redis,
ClickHouse,
MariaDB,
Trino,
Apache Cloudberry,
YugabyteDB,
DragonflyDB
y
OpenSearch
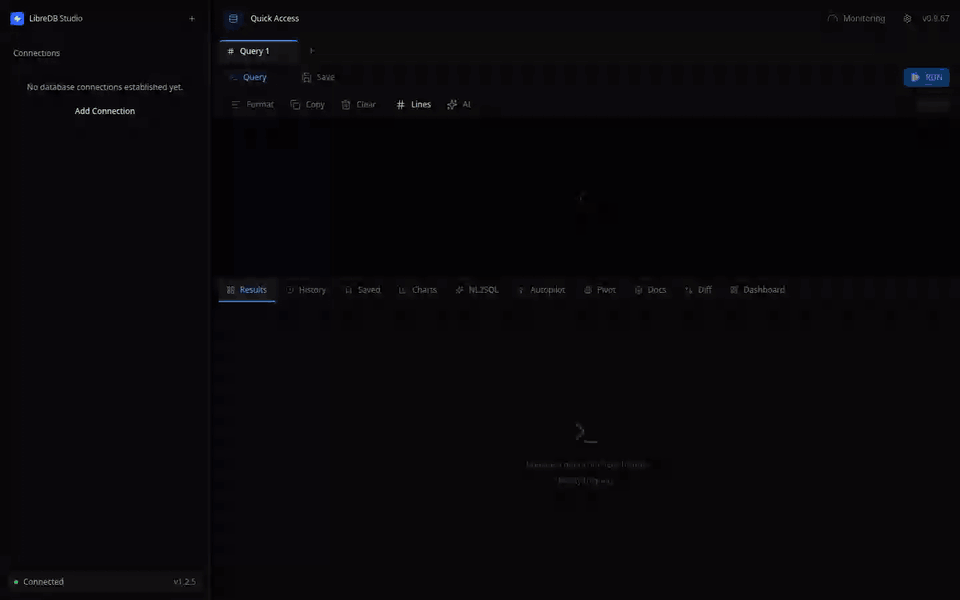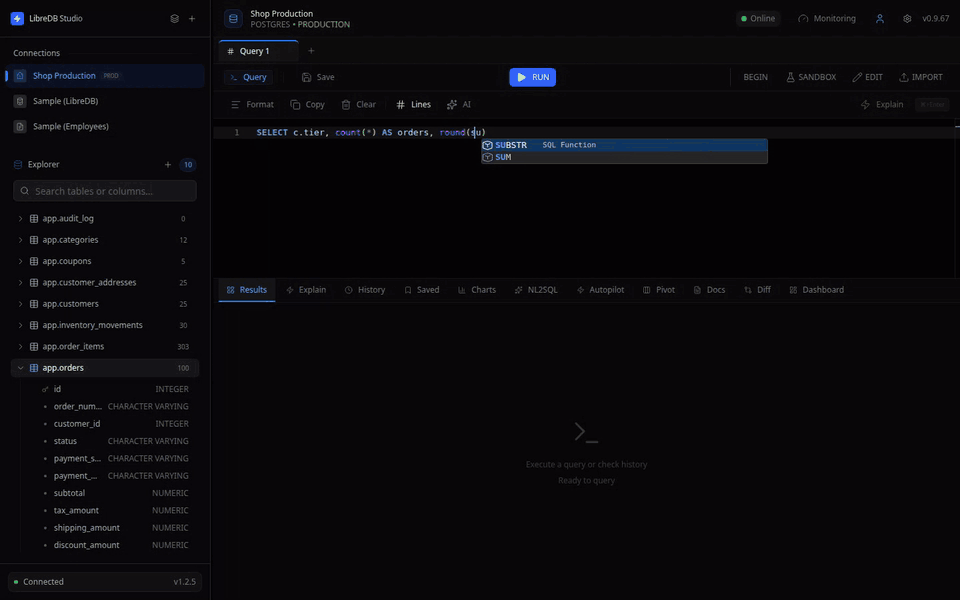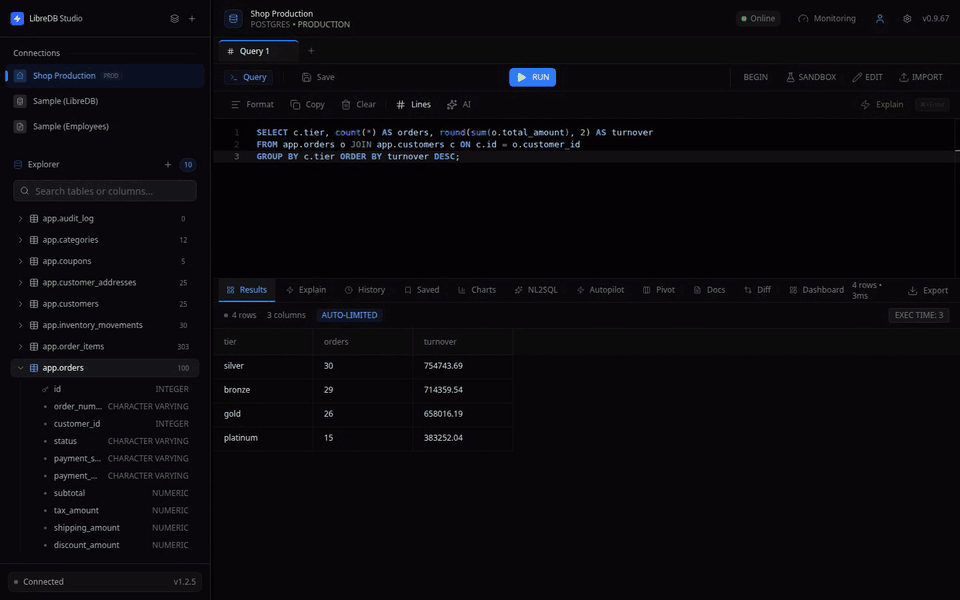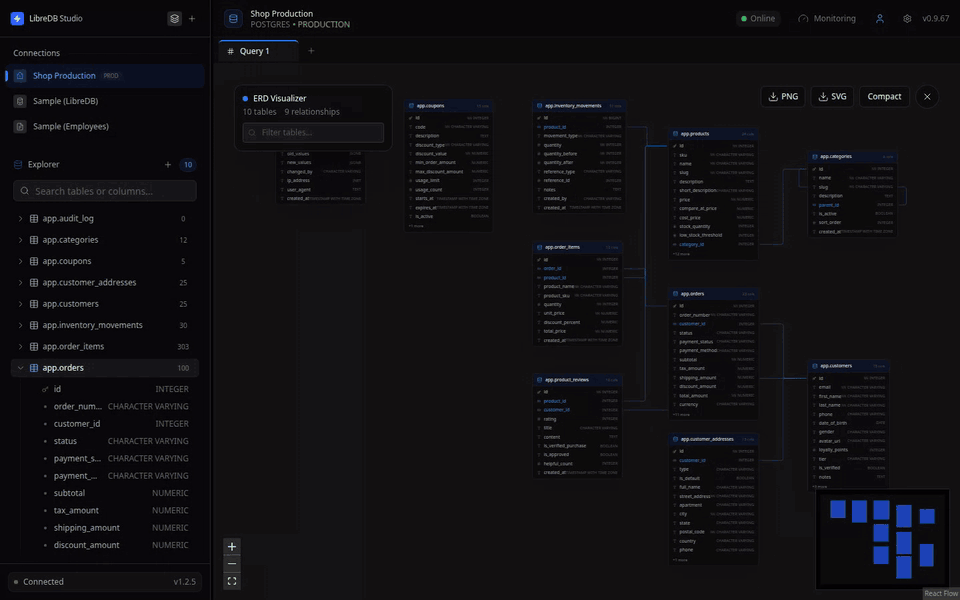


> Este README en español es una traducción de la comunidad y puede ir por detrás del inglés. Si difieren, manda la [versión en inglés](README.md).
## Inicio rápido
Un IDE SQL completo con un solo comando: sin clonar, sin compilar.
```bash
# Docker (recomendado)
docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest
# o con Node.js 24+ (sin Docker)
npx @libredb/studio
```
Luego abrí **http://localhost:3000**. En el primer arranque la contraseña de administrador se imprime en el log, sin ningún archivo de configuración.
> Si el navegador no entra por localhost ni por HTTPS (por ejemplo `http://192.168.x.x:3000` en la red local), hay que agregar `AUTH_COOKIE_SECURE=false`. Si no, el health check pasa sin problemas pero el login falla en silencio y vuelve a la pantalla de inicio de sesión una y otra vez.
¿Necesitás Helm, Homebrew, Snap, winget o deb/rpm? Ver [Instalación](#instalación) más abajo.
## Por qué otra herramienta de bases de datos
Creás un Postgres en una plataforma administrada y está listo en cuarenta segundos.
Después querés ver qué hay adentro. Entonces exponés un puerto a internet, o instalás un cliente de escritorio y cavás un túnel SSH, o te rendís y volvés a la línea de comandos. La base de datos tardó cuarenta segundos; abrirle una ventana te costó la tarde.
Ahora multiplicá eso por escala. La aplicación usa Postgres, los documentos van en Mongo, el caché en Redis, los eventos en ClickHouse. Cuatro bases, cuatro clientes, cuatro juegos de credenciales. El lunes entra alguien nuevo y, antes de escribir su primera línea de código, tiene que averiguar qué dato vive dónde, buscar cadenas de conexión en la wiki y en tres chats privados, esperar el acceso a la VPN, e instalar una herramienta distinta por cada motor.
**Las bases de datos ya se mudaron.** Se fueron a Kubernetes, a nubes administradas, a VPC de clientes a las que solo se llega cruzando un bastión. **Pero las herramientas para leerlas no se mudaron con ellas.** Siguen siendo aplicaciones de escritorio: pesadas, con licencia por asiento, que hay que instalar antes de usar, y que asumen que tenés una sola base, una sola laptop y una persona que nunca cambia de equipo.
LibreDB Studio va por el otro camino: **la herramienta va hacia los datos, en lugar de traer los datos hacia la herramienta.**
Tomada en serio, esa frase deja de ser una preferencia y se vuelve una especificación.
- El editor tiene que correr en el navegador, porque los datos no están en tu máquina y tus compañeros tampoco.
- Tiene que abrirse en el teléfono, porque la falla que necesita una consulta no espera a que enciendas la laptop.
- Tiene que desplegarse como infraestructura (contenedor, Helm chart, Operator, plantilla de un clic), porque así se instala todo lo que vive junto a una base de datos.
- Tiene que poder incrustarse, porque el lugar más útil para un editor es dentro del producto que creó la base.
- No puede reservarse nada. No podés meter una herramienta con licencia por asiento y funciones escalonadas en cada entorno que administrás. **Si el inicio de sesión único cuesta extra, la herramienta deja de ser desplegable por defecto.**
> MIT no es generosidad acá: es un requisito duro de esta arquitectura.
## Capacidades principales
### Dieciséis motores, una sola interfaz
PostgreSQL · MySQL · Oracle · SQL Server · SQLite · libSQL · DuckDB · MongoDB · Redis · Couchbase · ClickHouse · Apache Druid · Elasticsearch · OpenSearch · Apache Trino · Apache Cassandra
Todos los motores SQL comparten el mismo explorador de esquemas, los diagramas ER, la comparación de esquemas y los paneles de monitoreo. MongoDB y Redis no son motores SQL: no tienen diagrama ER ni comparación de esquemas. Druid, Elasticsearch, OpenSearch y Trino son doblemente excepcionales: sus interfaces SQL sobre HTTP no tienen una forma de URI que este build sepa interpretar, así que se configuran por host y puerto, y las migraciones que se generan explican la limitación en lugar de inventar DDL para un motor cuyo SQL no tiene sentencias de cambio de columna. Lo mismo pasa con las colecciones sin esquema de Couchbase. El diagrama ER de los clústeres de búsqueda tiene cajas pero no líneas: los índices no declaran claves foráneas, y en el modelo del motor no hay ninguna que declarar.
| Base de datos | Driver | Capacidades |
| :--- | :--- | :--- |
| **PostgreSQL** | `pg` | IDE SQL completo, planes de ejecución EXPLAIN, transacciones, cancelación de consultas (`pg_cancel_backend`) |
| **MySQL** | `mysql2` | IDE SQL completo, EXPLAIN, transacciones, cancelación de consultas (`KILL QUERY`) |
| **Oracle** | `oracledb` (modo Thin) | IDE SQL completo, paginación con `FETCH FIRST N ROWS`, vistas de monitoreo `V$`, `ANALYZE TABLE`, `ALTER INDEX REBUILD`, transacciones |
| **SQL Server** | `mssql` (tedious) | IDE SQL completo, paginación con `TOP N` / `OFFSET FETCH`, DMV `sys.dm_*`, `UPDATE STATISTICS`, `DBCC CHECKDB`, transacciones, detección automática de Azure SQL |
| **SQLite** | `bun:sqlite` / `node:sqlite` (según el runtime) | IDE SQL completo, sobre archivo o en memoria |
| **libSQL** | Sin driver, HTTP puro (protocolo Hrana, `POST /v2/pipeline`, puerto 8080) | IDE SQL completo. El mismo type-id conecta tanto a un servidor libSQL propio (`sqld`) como a Turso Cloud. Es el dialecto de SQLite a través de la red, y con `dbstat` da el tamaño real en bytes de tablas e índices. La credencial es un auth token, no una contraseña. Solo hay dos operaciones de mantenimiento, Reindex y verificación de integridad: `VACUUM`, `ANALYZE` y `PRAGMA optimize` los rechaza el servidor |
| **DuckDB** | `@duckdb/node-api` (complemento nativo N-API, unos 68 MB por plataforma) | IDE SQL completo sobre archivos DuckDB locales o `:memory:`, ejecutando en el mismo servidor que la aplicación. Árbol de plan físico con `EXPLAIN (FORMAT JSON)`, introspección del catálogo `duckdb_*`, tamaño real por tabla a partir de la asignación de bloques de `pragma_storage_info`, y cancelación de consultas mediante el `interrupt()` del propio driver. Tres operaciones de mantenimiento: `VACUUM`, `ANALYZE` y `CHECKPOINT`. Acá `REINDEX` es un error de sintaxis, y `PRAGMA integrity_check` y `PRAGMA optimize` no existen, así que no se ofrecen. No hay log de consultas lentas ni lista de sesiones: DuckDB no expone ninguna de las dos, así que esos paneles lo dicen en lugar de mostrar 0. Un archivo de base solo admite un proceso del sistema operativo (incluso en modo lectura), así que una segunda instancia de Studio no puede abrir el archivo que ya tiene abierto la primera |
| **MongoDB** | `mongodb` | Editor de consultas JSON y operaciones sobre colecciones (find, aggregate, insert, update, delete) |
| **Couchbase** | Sin driver, HTTP puro (REST de Query y de administración) | IDE SQL++ completo, EXPLAIN, explorador de buckets, scopes y colecciones, inferencia de campos con `INFER` |
| **ClickHouse** | Sin driver, HTTP puro (interfaz SQL, puerto 8123) | IDE SQL completo, árbol EXPLAIN en JSON, introspección de esquemas por tablas de sistema, `OPTIMIZE TABLE` |
| **Apache Druid** | Sin driver, HTTP puro (`POST /druid/v2/sql`) | IDE SQL de solo lectura, árbol EXPLAIN de la consulta nativa, introspección por `INFORMATION_SCHEMA`, monitoreo con `sys.*` |
| **Elasticsearch** | Sin driver, HTTP puro (`POST /_sql?format=json`, puerto 9200) | IDE SQL de solo lectura, explorador de índices y campos basado en el mapping, salud del clúster y cantidad de documentos y tamaño por índice. Sin EXPLAIN, sin operaciones de mantenimiento y sin paneles de consultas lentas ni sesiones. El SQL de Elasticsearch tampoco tiene `OFFSET`, así que no se puede pedir la segunda página de resultados |
| **OpenSearch** | Sin driver, HTTP puro (`POST /_plugins/_sql`, puerto 9200) | El mismo módulo de proveedor que Elasticsearch, con el mismo IDE de solo lectura y el mismo explorador. Acá sí funciona `LIMIT n OFFSET m`, así que la paginación está disponible |
| **Apache Trino** | Sin driver, HTTP puro (protocolo de cliente, `POST /v1/statement`, puerto 8080) | IDE SQL completo sobre todos los catálogos configurados, árbol de esquemas por el `information_schema` del catálogo fijado en la conexión, monitoreo con `system.runtime` y `jmx`, conteos reales de filas vía `SHOW STATS`, cancelación de consultas y mantenimiento con `kill_query`. Trino es un motor de consultas y no almacena datos, así que no declara claves primarias, foráneas ni índices en ningún lado: el diagrama ER tiene cajas sin líneas, la edición en línea está desactivada, y el panel de capacidad lista catálogos en vez de inventar un tamaño. Las sentencias que fallan también vuelven con HTTP 200; y aunque el clúster tenga la autenticación desactivada, una contraseña sobre HTTP en texto plano se sigue rechazando |
| **Apache Cassandra** | `cassandra-driver` (JavaScript puro, sin módulos nativos) | IDE de CQL sobre el protocolo nativo (puerto 9042), explorador de keyspaces con las claves de partición y de agrupamiento marcadas, resumen desde `system_views`, tiempo de actividad y sentencias en ejecución. La conexión **exige `localDataCenter`**: sin eso el driver se niega a conectar. No hay EXPLAIN (la gramática de CQL directamente no tiene esa palabra clave), no hay cancelación de consultas (el protocolo no tiene un frame de cancelación) y no hay operaciones de mantenimiento (compaction, repair y flush son operaciones JMX de `nodetool`). Y **no muestra ninguna cantidad de filas ni tamaño**: lo único que Cassandra puede dar es una estimación de particiones a partir de los archivos ya escritos a disco (una tabla de 500 filas se leyó como 143) y enteros en MiB (una tabla de 19.476 bytes se lee como `1 MiB`), así que preferimos no mostrar nada antes que mostrar un número equivocado |
| **Redis** | `ioredis` | Editor de comandos, explorador de claves, monitoreo basado en INFO |
> **La seguridad del transporte es transversal, no depende del motor.** El túnel SSH se establece antes de que el proveedor abra la conexión, y la conexión se reescribe hacia el extremo local: por eso no depende del motor, y aplica a cualquier conexión configurada con host y puerto. Las conexiones que se llenan con una cadena de conexión (MongoDB, Couchbase y ClickHouse lo permiten) no tienen host ni puerto, así que no pasan por el túnel; SQLite y DuckDB tampoco tienen ninguno de los dos. El panel de SSL/TLS hoy tiene efecto en PostgreSQL, MySQL, SQL Server, Couchbase, ClickHouse, Druid, Elasticsearch, OpenSearch y Trino; en Trino no es opcional, porque el coordinador rechaza contraseñas sobre HTTP en texto plano. Oracle, MongoDB y Redis ignoran esta opción, así que si el tráfico de esos tres va cifrado depende de cómo esté escrita la cadena de conexión, no de lo que se elija en el diálogo.
> Que Redis entre en una interfaz pensada para SQL se sostiene sobre una convención. `getSchema()` agrupa prefijos de claves en "tablas" usando `SCAN`, que no bloquea (**nunca `KEYS *`**); la salud y las métricas salen de `INFO`; las consultas lentas y las sesiones, de `SLOWLOG GET` y `CLIENT LIST`.
### Editor SQL profesional
- **Motor Monaco**: el mismo núcleo que usa VS Code.
- **Autocompletado con conocimiento del esquema**: tablas, columnas y palabras clave.
- **Espacio de trabajo con pestañas**: cada pestaña con su propio estado de ejecución.
- **EXPLAIN visual**: planes de ejecución gráficos para encontrar cuellos de botella.
- **Diagramas ER interactivos**: grafo del esquema con aristas de claves foráneas reales, etiquetas de cardinalidad, minimapa, búsqueda y filtrado de tablas, modo compacto y exportación a PNG y SVG. El layout jerárquico automático lo hace ELK.js.
- **Comparación de esquemas y migraciones**: compara instantáneas o esquemas de conexiones distintas lado a lado. Vista de diferencias con colores (agregado, eliminado, modificado) y generación automática del SQL de migración para PostgreSQL, MySQL, SQLite, Oracle y SQL Server, más los cambios de columna de ClickHouse.
- **Línea de tiempo de instantáneas**: una línea horizontal con las instantáneas del esquema. Se eligen dos puntos y se comparan al instante, para seguir cómo evolucionó el esquema.
### El agente de base de datos (solo lectura)
La superficie principal de IA es un **panel de agente** al lado del editor. Se plantea un objetivo — *"¿qué departamento tiene más empleados?"*, *"¿por qué esta consulta va lenta?"* — y se presiona Start. La ejecución redacta SQL contra la base conectada, lee los resultados y escribe un informe cuyas afirmaciones citan esos resultados.
### Otras funciones con modelo (opcional, con tu propio modelo)
- **Compatible con cualquier LLM**: por defecto usa Gemini, y funciona con OpenAI, Ollama y cualquier endpoint compatible con OpenAI (LM Studio, LiteLLM, vLLM).
- **Análisis de seguridad de consultas**: evaluación de riesgo previa a la ejecución para sentencias destructivas (DELETE, DROP, TRUNCATE).
- **Explicación de consultas**: planes EXPLAIN traducidos a lenguaje llano, con sugerencias de optimización.
- **Conocimiento del esquema**: el esquema de la base conectada se envía como contexto, así que la explicación nombra tus propias tablas y columnas.
- **Resumen del perfilador de datos**: las estadísticas por columna del perfilador, redactadas en prosa. Ese contexto incluye el `min` y el `max` de cada columna, que son valores reales de tus datos; ver [Agent Data Flow](docs/AGENT_DATA_FLOW.md).
### Gestión de datos
- **Grilla universal**: renderizado virtualizado (TanStack) para millones de filas.
- **Edición en línea**: doble clic para actualizar valores directamente en la grilla, en los motores cuyo SQL tiene actualización de fila sobre una sola tabla (en el resto el control no aparece).
- **Filtros por columna**: filtros de texto sobre los resultados, para explorar sin reescribir la consulta.
- **Tabla dinámica interactiva**: pivoteo del lado del cliente con cinco funciones de agregación (COUNT, SUM, AVG, MIN, MAX) y generación del SQL equivalente.
- **Exportación**: CSV y JSON al instante.
- **Ocho tipos de gráficos**: barras, líneas, torta, área, dispersión, histograma, barras apiladas y área apilada, con Recharts. Agrupación por hora, día, semana, mes o año, y configuraciones de gráfico que se guardan y se recargan.
### Herramientas de análisis y desarrollo
- **Perfilador de datos**: perfilado de tablas en un clic, con estadísticas por columna (porcentaje de nulos, cardinalidad, mínimo y máximo, valores de muestra) y resúmenes narrativos generados por el modelo.
- **Generador de código ORM**: interfaces de TypeScript, esquemas de Zod, modelos de Prisma, structs de Go, dataclasses de Python y POJOs de Java a partir del esquema real de las tablas.
- **Generador de datos de prueba**: datos falsos con conocimiento del esquema y más de 30 inferencias semánticas de columna (email, teléfono, nombre, dirección y otras). Produce sentencias INSERT o JSON para `insertMany` de MongoDB.
- **Documentación de la base**: diccionario de datos generado y buscable, a partir del esquema real, con documentación asistida por modelo y exportación a Markdown.
### Autenticación y SSO: todo en la versión MIT
- **Dos modos de autenticación**: usuario y contraseña locales, o inicio de sesión único por OpenID Connect (OIDC), conmutables con una variable de entorno.
- **OIDC agnóstico del proveedor**: funciona con cualquier proveedor que cumpla OIDC — Auth0, Keycloak, Okta, Azure AD, Zitadel, Google y otros.
- **Seguridad PKCE**: Authorization Code Flow con Proof Key for Code Exchange (S256).
- **Mapeo automático de roles**: mapeo por claims configurable, con notación de punto para claims anidados (por ejemplo `realm_access.roles`).
- **Cierre de sesión en el proveedor**: al salir se cierra tanto la sesión JWT local como la del proveedor de identidad.
### Herramientas de mantenimiento para DBA (solo admin)
- **Panel de monitoreo en vivo**: siete pestañas — resumen, rendimiento, consultas, sesiones, tablas, almacenamiento y pool de conexiones.
- **Gráficos de tendencia**: métricas en tiempo real (conexiones, tasa de aciertos de caché, buffer pool, deadlocks) con historial en buffer circular y refresco automático configurable entre 5 y 60 segundos.
- **Alertas por umbral**: indicadores de salud con colores (sano, advertencia, crítico) para la tasa de aciertos de caché, el uso de conexiones, los deadlocks y el uso del buffer pool.
- **Mantenimiento en un clic**: `VACUUM`, `ANALYZE`, `REINDEX`, `UPDATE STATISTICS`, `DBCC CHECKDB` y `ALTER INDEX REBUILD`, según el motor.
- **Registro de auditoría**: historial completo de cada consulta ejecutada en la organización.
## Instalación
| Método | Comando |
| :--- | :--- |
| **Docker** | `docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest` |
| **npx** | `npx @libredb/studio` |
| **Helm** | `helm install libredb oci://ghcr.io/libredb/charts/libredb-studio` |
| **Homebrew** | `brew trust libredb/tap && brew install libredb/tap/libredb-studio` |
| **Snap** | `sudo snap install libredb-studio` |
| **winget** | `winget install LibreDB.Studio` |
| **deb / rpm** (servidor, con servicio systemd) | [Página de releases](https://github.com/libredb/libredb-studio/releases/latest) |
| **Aplicación de escritorio** (AppImage / deb) | [Página de releases](https://github.com/libredb/libredb-studio/releases/latest). Ventana nativa, con el servidor corriendo como sidecar local y sin pantalla de login. **No es el paquete de servidor de la fila anterior.** |
| **Aplicación de escritorio** (Flatpak, en sandbox) | `flatpak --user remote-add --if-not-exists flatpark https://dl.flatpark.org/flatpark.flatpakrepo`
`flatpak --user install flatpark org.libredb.Studio` |
`brew trust` se ejecuta una sola vez (requiere Homebrew 6+; si dice que el comando no existe, correr `brew update` primero). Docker, Helm y Snap no necesitan configuración: la contraseña de administrador del primer arranque se imprime en el log del contenedor, en el log del pod y en `sudo snap logs libredb-studio`, respectivamente. Las instrucciones completas de cada canal (comandos, configuración, uso con systemd, modelo de etiquetas de las imágenes Docker) están en [`docs/DISTRIBUTION.md`](docs/DISTRIBUTION.md).
Plantillas de despliegue en un clic: Railway, Dokploy, CapRover, Sealos, Kubero, Cosmos, DigitalOcean Marketplace, Unraid Community Apps, Render Blueprint, Fly.io y Koyeb. La lista completa está en [`docs/CHANNELS.md`](docs/CHANNELS.md).
Para Kubernetes también hay un bundle de Operator para OpenShift y OLM.
### Integrarlo en tu propio producto
```bash
npm i @libredb/studio
```
Studio también se publica como paquete de npm, así que se puede incrustar directamente en tu aplicación. Si tu producto crea bases de datos para sus usuarios, ese es el lugar donde el editor más sirve.
## Dónde está la línea del cobro
Studio es MIT porque tiene que poder ir a cualquier parte. Lo que se cobra es libredb-platform, y lo que vende es que otro se encargue de operarlo: hosting, multi-tenancy, facturación y soporte. No es una función movida detrás de un muro.
**Ninguna capacidad se corrió al otro lado de esa línea para fabricar un motivo de upgrade.** El inicio de sesión único, el RBAC, la auditoría de consultas, los diagramas ER, las funciones de IA y todos los motores NoSQL están en la versión MIT.
## Pruebas y calidad
- Siete capas de pruebas: unitarias, de API, de integración, de hooks, de seguridad, de evaluaciones y de componentes, más las end-to-end
- **Cobertura de líneas del 100%**, y es una barrera dura en CI. Si la cobertura baja, el merge se bloquea
- Quality gate de SonarCloud
- Pruebas de humo en Node 24 y 26 en cada release
```bash
bun run test # todas las pruebas
bun run test:e2e # Playwright (requiere compilar antes)
bun run test:coverage # reporte de cobertura
```
## Documentación
El material en profundidad está por ahora solo en inglés:
- [Arquitectura](docs/ARCHITECTURE.md) · [Proveedores de bases de datos](docs/DATABASE_PROVIDERS.md) · [Referencia por motor](docs/providers/README.md)
- [Documentación de la API](docs/API_DOCS.md) · [Configuración de OIDC](docs/OIDC.md) · [Capa de almacenamiento](docs/STORAGE.md)
- [Helm Chart](docs/HELM_CHART.md) · [Canales de distribución](docs/CHANNELS.md) · [Agregar una base de datos](docs/ADDING_A_PROVIDER.md)
## Contribuir
Los issues y los pull requests son bienvenidos, y podés escribirlos en español sin problema. Empezá por [CONTRIBUTING.md](CONTRIBUTING.md).
Para agregar un motor de base de datos, ver [`docs/ADDING_A_PROVIDER.md`](docs/ADDING_A_PROVIDER.md). El código, la documentación y las pruebas viajan juntos en el mismo pull request.
## Licencia
[MIT](LICENSE). Sin CLA, sin edición empresarial, sin nada reservado.