
LibreDB Studio
डेटाबेस एडिटर जो आपके laptop पर नहीं, आपके डेटा के क़रीब deploy होता है।
English ·
简体中文 ·
日本語 ·
Español ·
اردو ·
हिन्दी
PostgreSQL प्रोजेक्ट में सूचीबद्ध:
News
·
PostgreSQL Clients
·
Software Catalogue
·
Community Guide to GUI Tools
साथ ही
Redis,
ClickHouse,
MariaDB,
Trino,
Apache Cloudberry
और
OpenSearch
के आधिकारिक docs में भी सूचीबद्ध
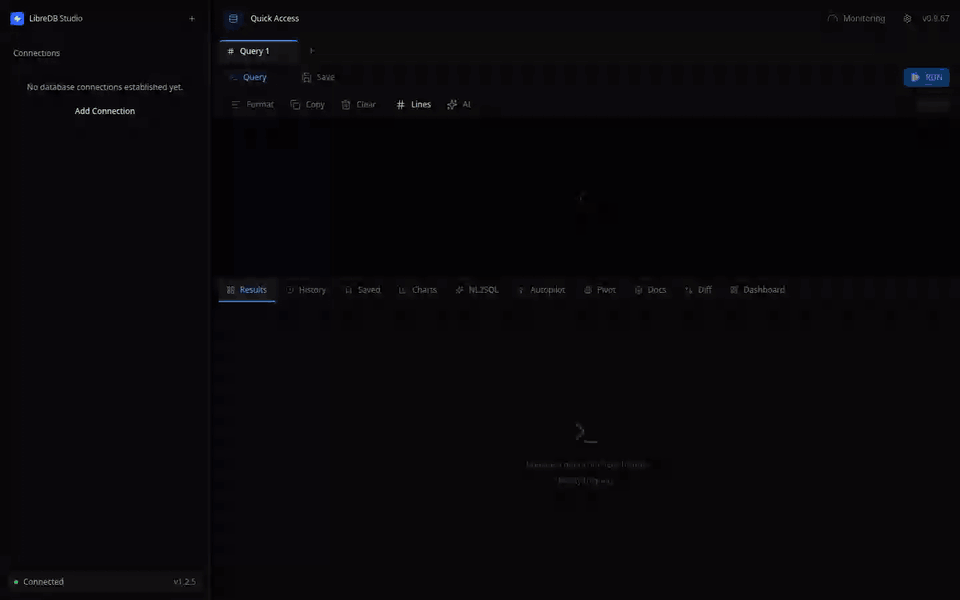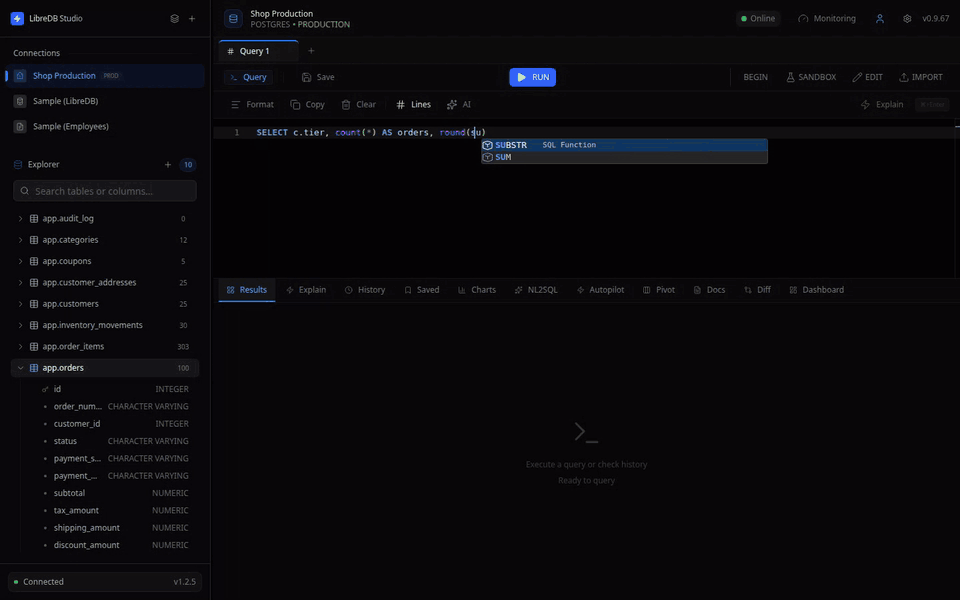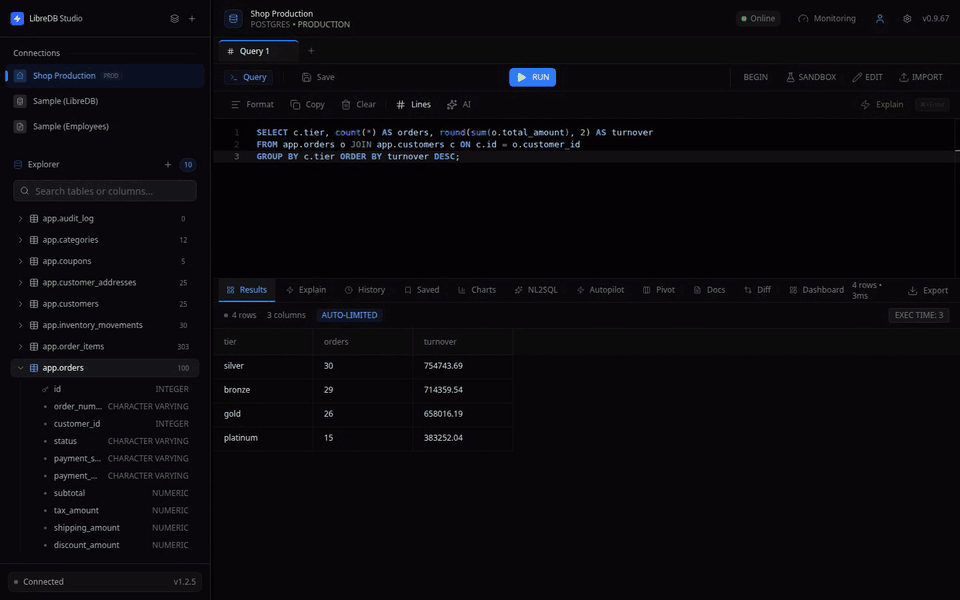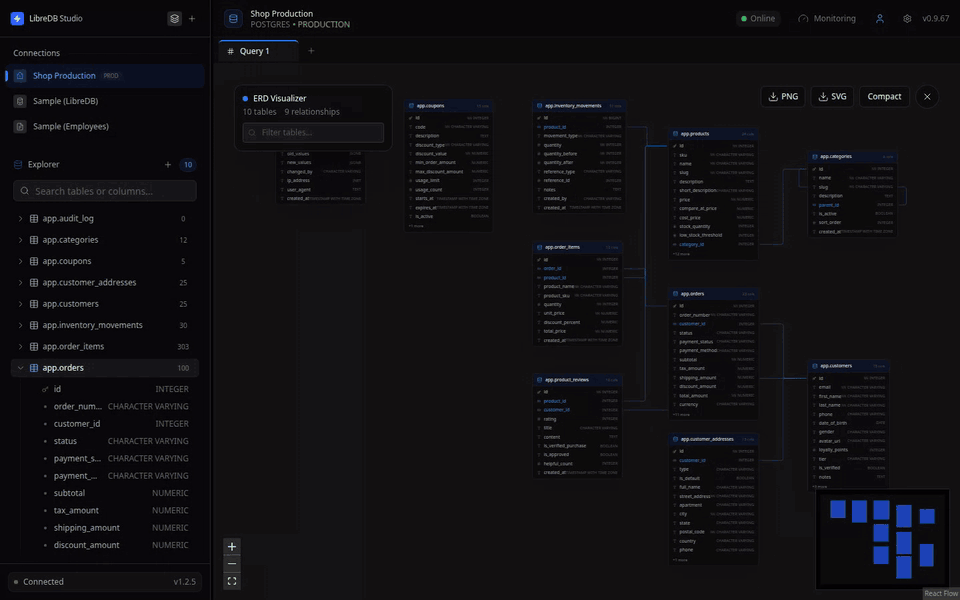


> यह हिन्दी README समुदाय द्वारा किया गया अनुवाद है और अंग्रेज़ी से पीछे हो सकता है। अंतर होने पर [अंग्रेज़ी संस्करण](README.md) मान्य है।
## जल्दी शुरू करें
एक ही command से पूरा SQL IDE चालू करें। न clone करना है, न build:
```bash
# Docker (सुझाया गया तरीका)
docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest
# या Node.js 24+ के साथ (Docker के बिना)
npx @libredb/studio
```
फिर **http://localhost:3000** खोलें। पहली बार चालू होने पर Studio admin password को log में print करता है। किसी config file की ज़रूरत नहीं है।
> अगर browser Studio को localhost या HTTPS के बजाय किसी और पते से खोलता है (जैसे LAN पर `http://192.168.x.x:3000`), तो `AUTH_COOKIE_SECURE=false` भी set करें। वरना health check ठीक दिखेगा, पर login चुपचाप fail होगा और आप बार-बार login page पर लौटते रहेंगे।
Helm, Homebrew, Snap, winget या deb/rpm चाहिए? नीचे [इंस्टॉल करने के तरीके](#इंस्टॉल-करने-के-तरीके) देखें।
## एक और डेटाबेस टूल क्यों
आप किसी managed platform पर चालीस सेकंड के अंदर Postgres बना सकते हैं।
फिर आप देखना चाहते हैं कि उसके अंदर क्या है। तो आप port को public internet पर खोलते हैं, SSH tunnel बनाते हैं, या हर उस machine पर desktop client install करते हैं जिसे उसकी ज़रूरत है। डेटाबेस को चालीस सेकंड लगे, पर उसमें झाँकने की खिड़की बनाने में आपकी पूरी दोपहर चली गई।
अब इसे बड़े पैमाने पर सोचिए। App के लिए Postgres, documents के लिए Mongo, cache के लिए Redis, events के लिए ClickHouse। चार डेटाबेस, चार clients, चार तरह के credentials। सोमवार को एक नया साथी join करता है। पहली line का code लिखने से पहले उसे पता करना पड़ता है कि कौन सा डेटा कहाँ है, wiki और तीन private chats में connection strings ढूँढनी पड़ती हैं, VPN access का इंतज़ार करना पड़ता है, और हर engine के लिए अलग tool install करना पड़ता है।
**डेटाबेस अपनी जगह बदल चुके हैं।** वे Kubernetes में, managed cloud में, और ग्राहक के ऐसे VPC में पहुँच गए हैं जहाँ jump host से होकर ही जाया जा सकता है। **पर उन्हें पढ़ने वाले tools वहीं के वहीं रह गए।** वे आज भी desktop apps हैं: भारी, हर seat का पैसा लेने वाले, पहले install होने वाले, और यह मानकर चलने वाले कि एक ही डेटाबेस है, एक ही laptop है, और एक ही इंसान है जो कभी device नहीं बदलता।
LibreDB Studio दूसरा रास्ता चुनता है: **tool डेटा के पास जाता है, डेटा tool के पास नहीं आता।**
इस बात को गंभीरता से लें, तो यह पसंद-नापसंद नहीं रह जाती। यह एक specification बन जाती है।
- एडिटर browser में चलना चाहिए, क्योंकि डेटा आपकी machine पर नहीं है, और आपके साथी भी नहीं।
- यह phone पर खुलना चाहिए, क्योंकि जिस incident में एक query चलानी है, वह आपके laptop खोलने का इंतज़ार नहीं करता।
- इसे infrastructure की तरह deploy होना चाहिए (container, Helm chart, Operator, one-click template), क्योंकि डेटाबेस के पास की हर चीज़ ऐसे ही install होती है।
- इसे embed किया जा सकना चाहिए, क्योंकि एडिटर की सबसे काम की जगह उसी product के अंदर है जिसने डेटाबेस बनाया।
- इसमें कुछ भी छिपा या बंद नहीं होना चाहिए। Seat-based licence और feature tiers वाला tool आप अपने हर environment में नहीं रख सकते। **जिस पल SSO के लिए अलग पैसे लगते हैं, वह tool default रूप से deploy करने लायक नहीं रहता।**
> MIT कोई उदारता नहीं है। यह इस architecture की अनिवार्य शर्त है।
## मुख्य क्षमताएँ
### सोलह engines, एक interface
PostgreSQL · MySQL · Oracle · SQL Server · SQLite · libSQL · DuckDB · MongoDB · Redis · Couchbase · ClickHouse · Apache Druid · Elasticsearch · OpenSearch · Apache Trino · Apache Cassandra
सभी SQL engines एक ही schema browser, ER diagram, schema diff और monitoring dashboard इस्तेमाल करते हैं। MongoDB और Redis SQL engines नहीं हैं, इसलिए उनमें ER diagram और schema diff नहीं है। Druid, Elasticsearch, OpenSearch और Trino दोहरे अपवाद हैं: उनके HTTP SQL interface का कोई ऐसा URI रूप नहीं है जिसे यह build पढ़ सके, इसलिए उन्हें सिर्फ़ host/port से configure किया जाता है। साथ ही, generated migration सीधे अपनी सीमा बताता है, बजाय ऐसे engine के लिए DDL बनाने के जिसकी SQL में column बदलने का कोई statement ही नहीं है। Couchbase के schemaless collections पर भी यही लागू है। Search clusters के ER diagram में सिर्फ़ boxes होते हैं, कोई line नहीं: indexes foreign keys declare नहीं करते, और engine के model में declare करने के लिए foreign key होती ही नहीं।
| डेटाबेस | Driver | क्षमताएँ |
| :--- | :--- | :--- |
| **PostgreSQL** | `pg` | पूरा SQL IDE, EXPLAIN plans, transactions, query cancel (`pg_cancel_backend`) |
| **MySQL** | `mysql2` | पूरा SQL IDE, EXPLAIN, transactions, query cancel (`KILL QUERY`) |
| **Oracle** | `oracledb` (Thin mode) | पूरा SQL IDE, `FETCH FIRST N ROWS` pagination, `V$` monitoring views, `ANALYZE TABLE`, `ALTER INDEX REBUILD`, transactions |
| **SQL Server** | `mssql` (tedious) | पूरा SQL IDE, `TOP N` / `OFFSET FETCH` pagination, `sys.dm_*` DMVs, `UPDATE STATISTICS`, `DBCC CHECKDB`, transactions, Azure SQL की अपने-आप पहचान |
| **SQLite** | `bun:sqlite` / `node:sqlite` (runtime पर चुना जाता है) | पूरा SQL IDE, file-based या in-memory डेटाबेस |
| **libSQL** | कोई driver नहीं, सिर्फ़ HTTP (Hrana protocol, `POST /v2/pipeline`, port 8080) | पूरा SQL IDE। एक ही type-id self-hosted libSQL server (`sqld`) और Turso Cloud दोनों से जुड़ता है। यह network पर चलने वाली SQLite dialect है, और `dbstat` से tables और indexes का असली byte size पढ़ता है। Credential password नहीं, auth token है। Maintenance में सिर्फ़ Reindex और integrity check हैं: `VACUUM`, `ANALYZE` और `PRAGMA optimize` server मना कर देता है |
| **DuckDB** | `@duckdb/node-api` (native N-API addon, हर platform पर लगभग 68 MB bindings) | Local DuckDB file या `:memory:` के लिए पूरा SQL IDE, जो app वाले server पर ही चलता है। `EXPLAIN (FORMAT JSON)` physical plan tree, `duckdb_*` catalog introspection, `pragma_storage_info` block allocation से हर table का असली byte size, और driver के अपने `interrupt()` से query cancel। तीन maintenance operations: `VACUUM`, `ANALYZE` और `CHECKPOINT`। यहाँ `REINDEX` syntax error है, और `PRAGMA integrity_check` व `PRAGMA optimize` मौजूद ही नहीं, इसलिए उनके लिए कोई बटन नहीं है। न slow query log है, न session list: DuckDB दोनों में से कुछ नहीं देता, इसलिए ये panels 0 दिखाने के बजाय साफ़ यही बताते हैं। Database file को एक समय में सिर्फ़ एक OS process खोल सकता है (read-only mode में भी), इसलिए दूसरा Studio instance वह file नहीं खोल सकता जो यह instance पहले से खोले हुए है |
| **MongoDB** | `mongodb` | JSON query editor, collection operations (find, aggregate, insert, update, delete) |
| **Couchbase** | कोई driver नहीं, सिर्फ़ HTTP (Query + management REST) | पूरा SQL++ IDE, EXPLAIN, bucket/scope/collection browser, `INFER` से field inference |
| **ClickHouse** | कोई driver नहीं, सिर्फ़ HTTP (SQL interface, port 8123) | पूरा SQL IDE, JSON EXPLAIN tree, system tables से schema introspection, `OPTIMIZE TABLE` |
| **Apache Druid** | कोई driver नहीं, सिर्फ़ HTTP (`POST /druid/v2/sql`) | Read-only SQL IDE, native query EXPLAIN tree, `INFORMATION_SCHEMA` introspection, `sys.*` monitoring |
| **Elasticsearch** | कोई driver नहीं, सिर्फ़ HTTP (`POST /_sql?format=json`, port 9200) | Read-only SQL IDE, mapping पर आधारित index/field browser, cluster health और हर index के document count व storage size। न EXPLAIN, न maintenance, न slow query या session panels। Elasticsearch SQL में `OFFSET` भी नहीं है, इसलिए results का दूसरा page नहीं माँगा जा सकता |
| **OpenSearch** | कोई driver नहीं, सिर्फ़ HTTP (`POST /_plugins/_sql`, port 9200) | Elasticsearch वाला ही provider module, वही read-only SQL IDE और browser। यहाँ `LIMIT n OFFSET m` काम करता है, इसलिए pagination भी काम करता है |
| **Apache Trino** | कोई driver नहीं, सिर्फ़ HTTP (client protocol, `POST /v1/statement`, port 8080) | सभी configured catalogs पर पूरा SQL IDE, connection के fixed catalog की `information_schema` schema tree, `system.runtime` और `jmx` monitoring, `SHOW STATS` से असली row counts, query cancel और `kill_query` maintenance। Trino query engine है और ख़ुद डेटा store नहीं करता, इसलिए कहीं भी primary key, foreign key या index declare नहीं होते: ER diagram में सिर्फ़ boxes हैं, inline editing बंद है, और capacity panel मनगढ़ंत usage के बजाय catalogs की सूची दिखाता है। Fail हुए statements भी HTTP 200 के साथ लौटते हैं। Cluster पर authentication बंद हो तब भी plain HTTP पर password मना कर दिया जाता है |
| **Apache Cassandra** | `cassandra-driver` (pure JavaScript, कोई native module नहीं) | Native protocol (port 9042) पर CQL IDE, partition key और clustering key चिह्नित करने वाला keyspace browser, `system_views` से overview, uptime और चल रहे statements। Connection में **`localDataCenter` भरना ज़रूरी है**: इसके बिना driver connect करने से मना कर देता है। न EXPLAIN (CQL grammar में यह keyword ही नहीं है), न query cancel (protocol में cancel frame नहीं है), न maintenance (compaction, repair और flush सब `nodetool` के JMX operations हैं)। और **कोई row count या size नहीं दिखाया जाता**: Cassandra सिर्फ़ flush हो चुकी files पर आधारित partition अनुमान (500 rows वाली clustered table 143 पढ़ी गई) और पूरे MiB (19,476 bytes की table `1 MiB` पढ़ी गई) दे सकता है, इसलिए ग़लत संख्या दिखाने से बेहतर है कुछ न दिखाना |
| **Redis** | `ioredis` | Command editor, key browser, INFO पर आधारित monitoring |
> **Transport security हर engine की अलग सुविधा नहीं, सब पर लागू होने वाली क्षमता है।** SSH tunnel provider के connect होने से पहले ही बन जाता है और connection को local endpoint पर मोड़ देता है, इसलिए यह engine पर निर्भर नहीं: जिस connection में host और port हो, उस पर यह लागू होता है। Connection string से भरे गए connections (MongoDB, Couchbase और ClickHouse में यह तरीका है) में host/port नहीं होता, इसलिए वे tunnel से नहीं जाते। SQLite और DuckDB में भी दोनों नहीं होते। SSL/TLS panel अभी PostgreSQL, MySQL, SQL Server, Couchbase, ClickHouse, Druid, Elasticsearch, OpenSearch और Trino पर काम करता है। Trino पर यह वैकल्पिक नहीं है, क्योंकि coordinator plain HTTP पर password मना कर देता है। Oracle, MongoDB और Redis इस setting को नज़रअंदाज़ करते हैं, इसलिए इन तीनों में encryption इस पर निर्भर है कि connection string में क्या लिखा है, dialog में क्या चुना है इस पर नहीं।
> Redis इस SQL-oriented interface में एक convention की वजह से फ़िट होता है। `getSchema()` non-blocking `SCAN` से (**कभी भी `KEYS *` से नहीं**) key prefixes को "tables" में बाँटता है, health और metrics `INFO` से आते हैं, और slow queries व sessions `SLOWLOG GET` / `CLIENT LIST` से।
### Professional SQL एडिटर
- **Monaco engine**: वही जो VS Code में है।
- **Schema-aware autocomplete**: table names, column names, keywords।
- **Multi-tab workspace**: हर tab की अपनी execution state।
- **Visual EXPLAIN**: graphical execution plan, ताकि performance की रुकावट दिखे।
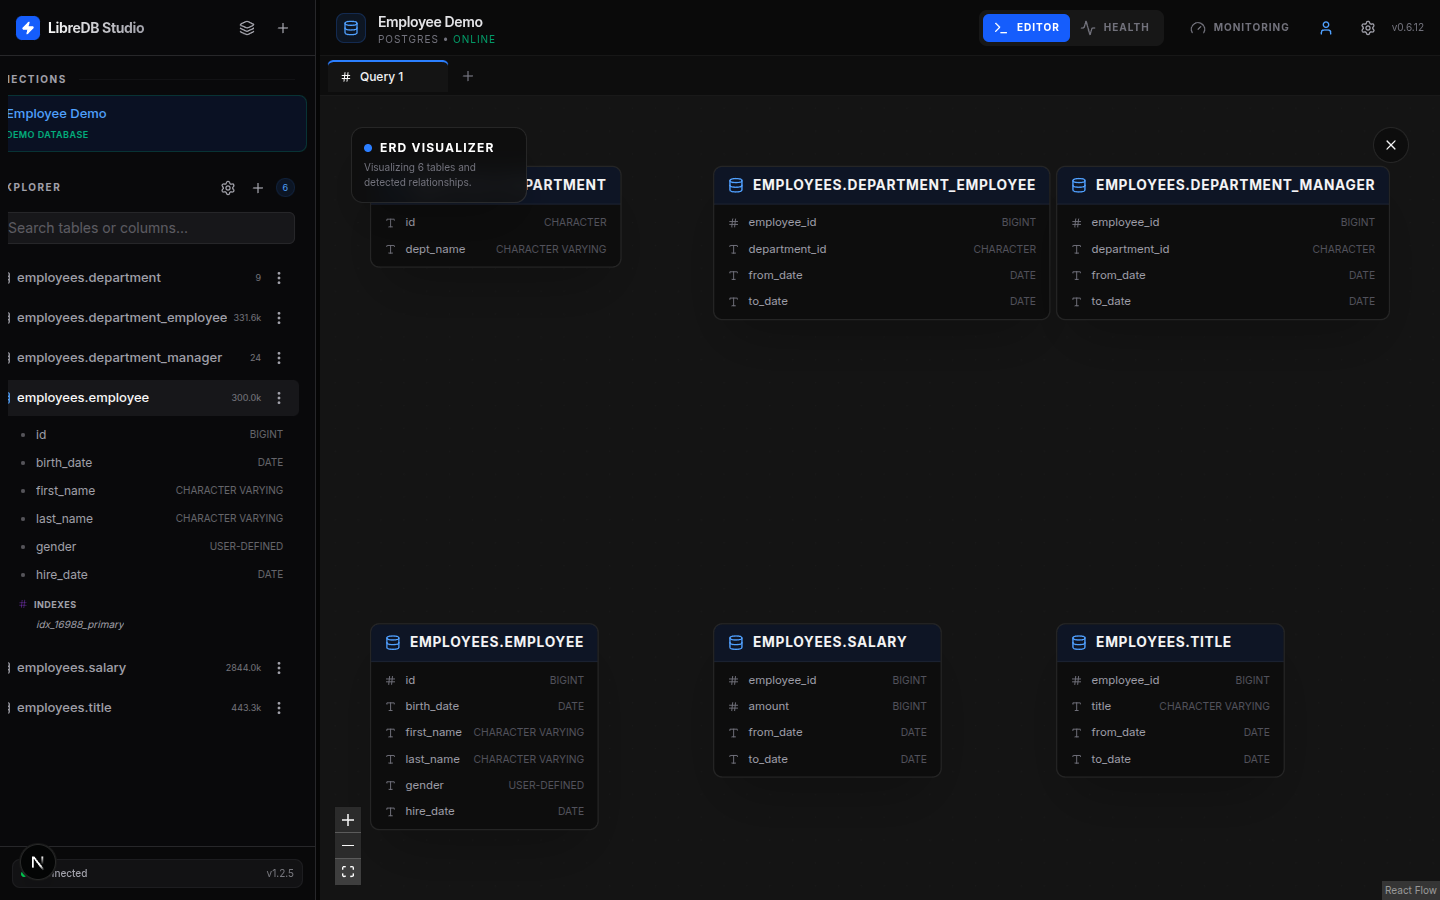
- **Interactive ER diagram**: असली foreign key lines, cardinality labels, MiniMap, table search, PNG/SVG export, ELK.js से अपने-आप layered layout।
- **Schema diff और migration**: दो connections या दो snapshots की तुलना, जोड़े/हटाए/बदले गए हिस्से अलग रंगों में, और अपने-आप बना migration SQL (PostgreSQL, MySQL, SQLite, Oracle, SQL Server, और ClickHouse के column changes)।
- **Snapshot timeline**: horizontal timeline। कोई भी दो बिंदु चुनें और schema का बदलाव देखें।
### Database Agent (read-only)
एडिटर के बगल वाला Agent panel Studio का मुख्य AI interface है (नीचे दी गई model-assisted features के अलावा)।
आप एक लक्ष्य लिखते हैं ("किस department में सबसे ज़्यादा लोग हैं?", "यह query धीमी क्यों है?") और Start दबाते हैं।
यह run connected डेटाबेस के लिए SQL लिखता है, results पढ़ता है, और अंत में एक report देता है, जिसका हर निष्कर्ष
उस read का हवाला देता है जिस पर वह टिका है।
- **Read-only, और यह गारंटी डेटाबेस ख़ुद देता है**: Agent का हर statement **Agent की अपनी audited pipeline** से गुज़रता है।
Driver तक पहुँचने से पहले policy decision, audit event और budget accounting होती है (`executeAuditedOperation`,
`src/lib/db/operations/execution.ts:129`)। साथ में read-only execution profile लगता है: PostgreSQL पर read-only
transaction, SQLite पर हर statement के साथ दोबारा `PRAGMA query_only`, और DuckDB पर `READ_ONLY` engine handle के ऊपर
एक SQL guard, क्योंकि सिर्फ़ वह flag `COPY … TO`, `EXPORT DATABASE` और local files पढ़ने वाले table functions को नहीं रोकता।
SQL Server पर किसी भी तरह का read-only transaction होता ही नहीं, इसलिए वहाँ चार परतें हैं: connection खुलते समय यह जाँचा जाता है
कि session का principal लिख ही नहीं सकता, फिर optimizer हर statement को चलाए बिना सिर्फ़ compile करके admit करता है,
rows की सीमा server पर ही लगती है, और statement एक ऐसे transaction के अंदर चलता है जिसे हमेशा rollback किया जाता है।
Writes और DDL डेटाबेस तक पहुँचने से पहले ही मना कर दिए जाते हैं। `EXPLAIN ANALYZE` statement को सच में चलाता है,
इसलिए default रूप से बंद है। यह pipeline सिर्फ़ Agent के लिए है: एडिटर में आप जो statements ख़ुद चलाते हैं वे सीधे
provider को जाते हैं (`src/app/api/db/query/route.ts:44`), यहाँ की policy से नहीं गुज़रते, और ऐसा audit record नहीं बनाते।
- **Agent mode सिर्फ़ PostgreSQL, SQLite, DuckDB और SQL Server पर**: read-only profile डेटाबेस के native तरीक़े से लागू होता है,
इसलिए यह सिर्फ़ उन providers पर है जिन्होंने इसे implement किया है: `postgres.ts`, `sqlite.ts`, `duckdb/index.ts` और `mssql.ts`
का `queryReadOnly`, और कोई नहीं। बाक़ी engines पर, statements भेजने वाला Agent-mode workflow शुरू होते ही मना कर दिया जाता है,
run बनने से पहले; और जो अनुरोध provider factory तक पहुँच जाए वह `engine-unsupported` के साथ ख़त्म होता है।
**Plan** mode हर connection पर खुलता है: वहाँ का model कोई tool इस्तेमाल नहीं करता, आपका कोई statement नहीं चलाता, कुछ लिखता नहीं,
और सिर्फ़ एक statement का मसौदा देता है जिसे आप ख़ुद चलाते हैं। उसकी GROUNDING हर engine तक पहुँचती है: PostgreSQL और SQLite पर
server ख़ुद catalog statements बनाता है, और बाक़ी हर connection पर उसी connection के provider से schema का ब्यौरा माँगा जाता है,
यानी वही read जो sidebar पहले से करता है, जिसके लिए read-only statement path चाहिए ही नहीं। इसलिए दोनों सीमाएँ अलग हैं:
Agent mode यही चार engines हैं, GROUNDING सारे engines, और जिस run की reading नाकाम रहे वह tables गढ़ने के बजाय यह साफ़ कह देता है।
- **तीन workflows**: **Investigate** (सवाल का जवाब), **Optimize** (अनुमानित execution plans की तुलना, index या rewrite का सुझाव),
**Assess** (table profiling: सिर्फ़ counts, कभी भी असली values नहीं)।
- **अपने-आप कुछ नहीं करता**: Agent आपकी जगह run शुरू नहीं करता, एडिटर में नहीं लिखता, और अपने सुझाए statements नहीं चलाता।
क्या अपनाना है, यह आपका click तय करता है।
- **सबूत के बिना कोई निष्कर्ष नहीं**: बिना हवाले का निष्कर्ष दर्ज नहीं हो सकता। Run के अंत में साफ़ "Run answered" या
"Run did not answer" लिखा आता है।
- **सीमाएँ तय हैं, और screen पर दिखती हैं**: हर run में 20 statements, 60 सेकंड database time, एक read में 200 rows, और पूरे run के लिए 5 मिनट।
- **अपना model इस्तेमाल करें**: Gemini (default), OpenAI, Ollama, या कोई भी OpenAI-compatible endpoint। **Agent** mode के लिए ऐसा
model चाहिए जो सच में tool calling करता हो। Ollama पर यह vendor docs से नहीं, एक असली probe से पक्का किया जाता है। **Plan** mode को
tools नहीं चाहिए और वह कभी probe नहीं करता (`src/lib/agent/capability-gate.ts:74`), इसलिए Agent mode में मना किया गया model
Plan mode में चल सकता है, और panel आपको यही सुझाव देता है।
- **Model configure नहीं, तो AI नहीं**: जब कोई `LLM_*` configuration नहीं होता, तो panel दिखता ही नहीं और कोई डेटा आपके network से बाहर नहीं जाता।
ध्यान दें कि switch key नहीं है: Ollama और custom endpoints बिना key के भी configured model गिने जाते हैं, और तब AI चालू होता है।
बाहर क्या-क्या जाता है, यह [`docs/AGENT_DATA_FLOW.md`](docs/AGENT_DATA_FLOW.md) में है।
सिर्फ़ standalone deployment में: embedded `@libredb/studio` package में कोई Agent interface नहीं है।
Guide: [`docs/AGENT_GUIDE.md`](docs/AGENT_GUIDE.md) ·
डेटा बाहर जाने की जानकारी: [`docs/AGENT_DATA_FLOW.md`](docs/AGENT_DATA_FLOW.md) ·
व्यवहार और सीमाएँ: [`docs/AGENT.md`](docs/AGENT.md)
### दूसरी AI features (वैकल्पिक, अपने model के साथ)
- **किसी vendor से बँधा नहीं**: default Gemini 2.5 Flash, साथ में OpenAI, या **local / OpenAI-compatible endpoints** (Ollama, LM Studio, LiteLLM)।
- **Query safety analysis**: चलाने से पहले DELETE, DROP, TRUNCATE जैसे destructive statements के risk का आकलन।
- **Execution plan की व्याख्या**: EXPLAIN को आसान भाषा में समझाना और optimization के सुझाव देना।
- **Data profile summary**: हर column के statistics को text में समझाना। इस context में हर column का `min` / `max` होता है, यानी आपके
डेटा की असली values। विवरण [`docs/AGENT_DATA_FLOW.md`](docs/AGENT_DATA_FLOW.md) में है।
**Model configure नहीं, तो AI कोई call नहीं करता**: जब कोई `LLM_*` configuration नहीं है (default स्थिति), तो कोई डेटा आपके network से बाहर नहीं जाता।
### डेटा के साथ काम
- **Virtualized grid** (TanStack): लाखों rows तक smooth rendering।
- **Inline editing**: value बदलने के लिए double-click करें (सिर्फ़ उन engines पर जिनकी SQL single-table row update support करती है)।
- **Pivot table**: client-side pivot, 5 aggregation functions, और उसी का SQL बनाने का विकल्प।
- **8 तरह के charts**: bar, line, pie, area, scatter, histogram, stacked bar, stacked area (Recharts)। Chart configuration save करके दोबारा इस्तेमाल करें।
- **Export**: CSV, JSON।
### Analysis और development tools
- **AI data profiling**: एक click में column statistics (null rate, cardinality, min/max, sample values) और लिखित summary।
- **ORM code generation**: live schema से TypeScript interfaces, Zod schemas, Prisma models, Go structs, Python dataclasses, Java POJOs।
- **Test data generation**: 30+ semantic column types की पहचान (email, phone, name, address आदि), output INSERT statements या MongoDB insertMany JSON।
- **Database documentation**: live schema से searchable data dictionary, Markdown export के साथ।
### Authentication और SSO: सब कुछ MIT version में
- **दो modes**: local email/password, या OIDC SSO। Environment variable से बदलें।
- **किसी provider पर निर्भर नहीं**: Auth0, Keycloak, Okta, Azure AD, Zitadel, Google, या कोई भी OIDC-compliant provider।
- **PKCE**: Authorization Code Flow + S256।
- **Role mapping**: claim के आधार पर configure करें, `realm_access.roles` जैसे nested paths के साथ।
### DBA operations tools (सिर्फ़ admin)
7 tabs वाला monitoring dashboard (overview, performance, queries, sessions, tables, storage, connection pool), time-series trend charts, 5-60 सेकंड का adjustable auto-refresh, threshold alerts के रंग, और एक click में `VACUUM` / `ANALYZE` / `REINDEX` / `UPDATE STATISTICS` / `DBCC CHECKDB` / `ALTER INDEX REBUILD`। पूरे organization का query audit log भी साथ में।
## इंस्टॉल करने के तरीके
| तरीका | Command |
| :--- | :--- |
| **Docker** | `docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest` |
| **npx** | `npx @libredb/studio` |
| **Helm** | `helm install libredb oci://ghcr.io/libredb/charts/libredb-studio` |
| **Homebrew** | `brew trust libredb/tap && brew install libredb/tap/libredb-studio` |
| **Snap** | `sudo snap install libredb-studio` |
| **winget** | `winget install LibreDB.Studio` |
| **deb / rpm** (server, systemd service के साथ) | [Releases page](https://github.com/libredb/libredb-studio/releases/latest) |
| **Desktop app** (AppImage / deb) | [Releases page](https://github.com/libredb/libredb-studio/releases/latest)। Native window, server local sidecar के रूप में चलता है, कोई login page नहीं। **यह ऊपर वाला server package नहीं है।** |
| **Desktop app** (Flatpak, sandboxed) | `flatpak --user remote-add --if-not-exists flatpark https://dl.flatpark.org/flatpark.flatpakrepo`
`flatpak --user install flatpark org.libredb.Studio` |
`brew trust` सिर्फ़ एक बार चलाना है (Homebrew 6+ चाहिए। अगर unknown command की error आए, तो पहले `brew update` चलाएँ)। Docker, Helm और Snap बिना किसी configuration के चलते हैं: पहली बार बना admin password क्रमशः container log, Pod log और `sudo snap logs libredb-studio` में print होता है। हर channel की पूरी जानकारी (commands, configuration, systemd इस्तेमाल, Docker image tag model) [`docs/DISTRIBUTION.md`](docs/DISTRIBUTION.md) में है।
One-click deploy templates: Railway, Dokploy, CapRover, Sealos, Kubero, Cosmos, DigitalOcean Marketplace, Unraid Community Apps, Render Blueprint, Fly.io, Koyeb। पूरी सूची [`docs/CHANNELS.md`](docs/CHANNELS.md) में है।
Kubernetes users के लिए एक OpenShift / OLM Operator bundle भी है।
### अपने product में embed करें
```bash
npm i @libredb/studio
```
Studio एक npm package के रूप में भी publish होता है, जिसे आप सीधे अपने app में embed कर सकते हैं। अगर आपका product users के लिए डेटाबेस बनाता है, तो एडिटर की सबसे सही जगह यही है।
**Studio के security headers अपनी Next.js config में दोबारा इस्तेमाल करें।** `@libredb/studio/security` subpath पूरी policy को plain data के रूप में publish करता है: `securityHeaders()` एक सामान्य `Record` लौटाता है, और उसका module कुछ भी import नहीं करता। इसलिए इसे सीधे `next.config.ts` में load किया जा सकता है, जहाँ अभी न path aliases हैं, न Studio runtime।
```ts
// next.config.ts
import { securityHeaders } from "@libredb/studio/security";
export default {
async headers() {
return [
{
source: "/:path*",
headers: Object.entries(securityHeaders()).map(([key, value]) => ({ key, value })),
},
];
},
};
```
विकल्प: `reportOnly` लागू होने वाले header की जगह `Content-Security-Policy-Report-Only` भेजता है। `hsts: false` HSTS बंद करता है (object देने पर custom)। `allowEval` `'unsafe-eval'` जोड़ता है, जो React के **development** build को चाहिए। `monacoVsPath` Monaco के assets अलग origin पर हों तो वह origin जोड़ता है। `extra` हर directive में आपके अपने sources मिलाता है। साथ में `studioCspDirectives()` और `HSTS_MAX_AGE_SECONDS` भी export होते हैं, उन configs के लिए जो policy सीधे भेजने के बजाय ख़ुद जोड़ना चाहती हैं।
अपनाने से पहले policy एक बार पढ़ लें: CSP inline scripts की अनुमति देती है, क्योंकि हर document route statically prerender होता है और hydration scripts में nonce नहीं होता। इसलिए यह इस पर रोक लगाती है कि inject हुई script डेटा **कहाँ भेज** सकती है, इस पर नहीं कि वह चल सकती है या नहीं। यह trade-off, और Next.js app के ये headers भेजने के दो रास्ते, [`docs/SECURITY.md`](docs/SECURITY.md) में लिखे हैं।
## पैसे वाली रेखा कहाँ है
Studio MIT है, क्योंकि इसे हर जगह जा सकना चाहिए। पैसे libredb-platform के लगते हैं, जो "कोई और आपके लिए इसे चलाए" बेचता है: hosting, multi-tenancy, billing और support। Paywall के पीछे खिसकाई गई कोई feature नहीं।
**Upgrade का बहाना बनाने के लिए कोई भी क्षमता इस रेखा के उस पार नहीं भेजी गई।** SSO, RBAC, query audit, ER diagram, AI features, और सभी NoSQL engines MIT build में हैं।
## Testing और quality
- Unit, API, integration, hooks, component और E2E: छह layers के tests
- **100% line coverage**, और यह CI का सख़्त gate है। Coverage गिरे, तो merge रुक जाता है
- SonarCloud quality gate
- हर release पर Node 24 / 26 पर smoke tests
```bash
bun run test # सभी tests
bun run test:e2e # Playwright (पहले build ज़रूरी)
bun run test:coverage # coverage report
```
## Documentation
विस्तृत docs अभी सिर्फ़ अंग्रेज़ी में हैं:
- [Architecture](docs/ARCHITECTURE.md) · [Database providers](docs/DATABASE_PROVIDERS.md) · [हर engine का reference](docs/providers/README.md)
- [API docs](docs/API_DOCS.md) · [OIDC setup](docs/OIDC.md) · [Storage layer](docs/STORAGE.md)
- [Helm Chart](docs/HELM_CHART.md) · [Distribution channels](docs/CHANNELS.md) · [नया डेटाबेस जोड़ना](docs/ADDING_A_PROVIDER.md)
## योगदान करें
Issues और PRs का स्वागत है, और बातचीत हिन्दी में करना बिल्कुल ठीक है। शुरू करने से पहले [CONTRIBUTING.md](CONTRIBUTING.md) पढ़ें।
नया database engine जोड़ने के लिए [`docs/ADDING_A_PROVIDER.md`](docs/ADDING_A_PROVIDER.md) देखें। Code, docs और tests तीनों एक ही PR में साथ-साथ बदलने चाहिए।
## License
[MIT](LICENSE)। न CLA, न enterprise edition, न कुछ छिपाकर रखा गया।