
LibreDB Studio
ڈیٹا بیس ایڈیٹر جو آپ کے ڈیٹا کے ساتھ deploy ہوتا ہے، آپ کے laptop کے اندر نہیں۔
English ·
简体中文 ·
日本語 ·
Español ·
اردو ·
हिन्दी
PostgreSQL project میں درج شدہ:
News
·
PostgreSQL Clients
·
Software Catalogue
·
Community Guide to GUI Tools
اس کے علاوہ
Redis،
ClickHouse،
MariaDB،
Trino،
Apache Cloudberry،
YugabyteDB،
DragonflyDB
اور
OpenSearch
کی سرکاری دستاویزات میں بھی درج ہے
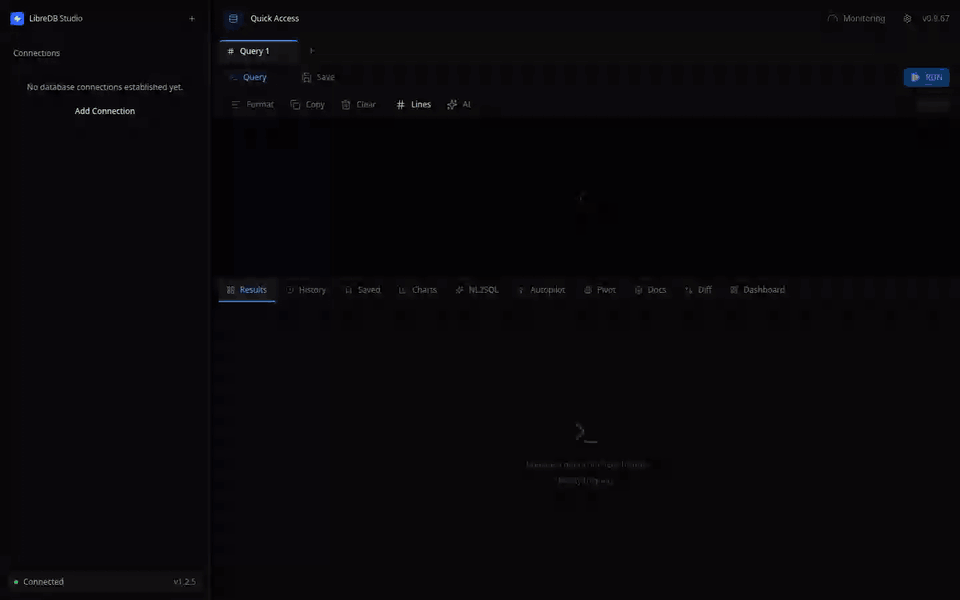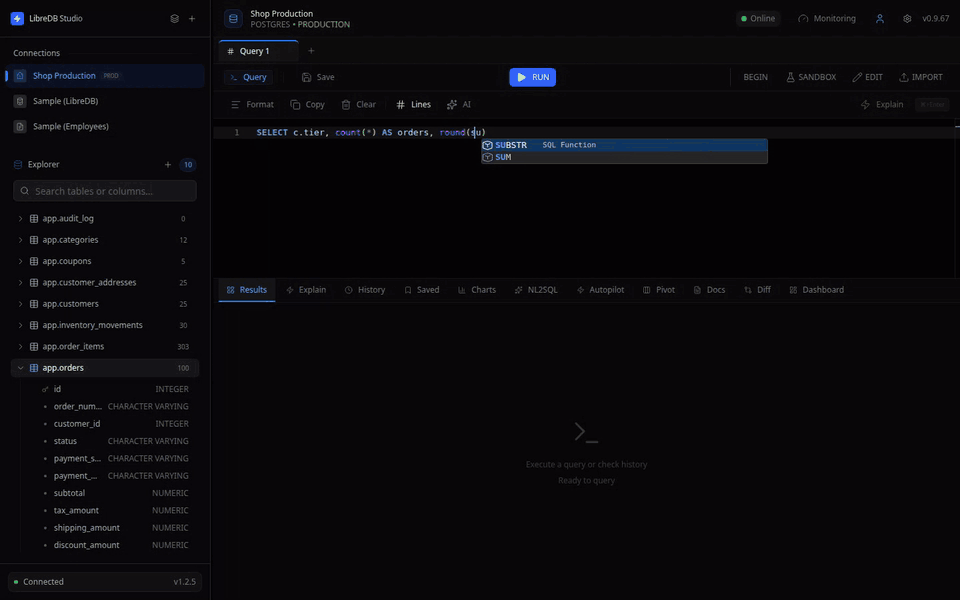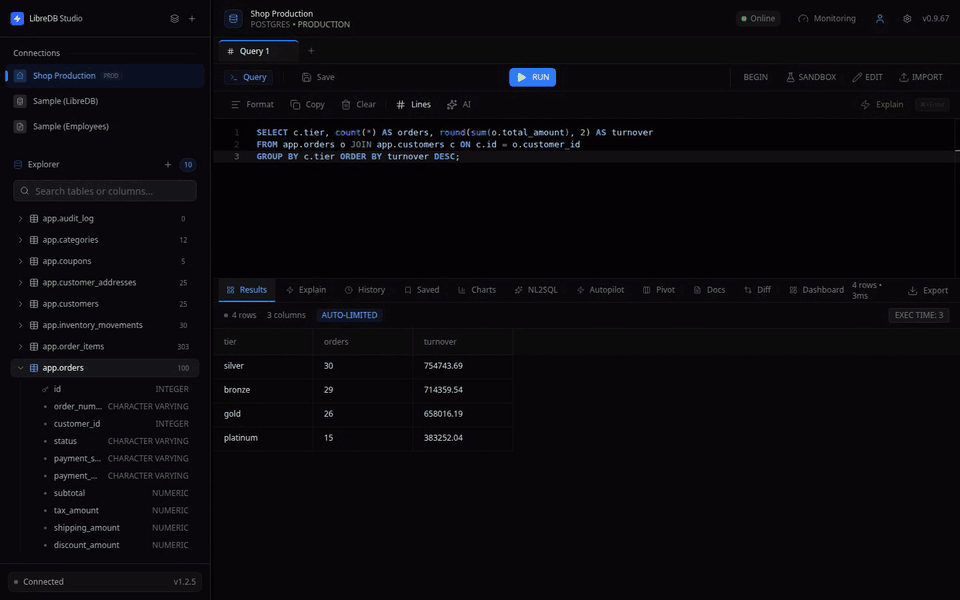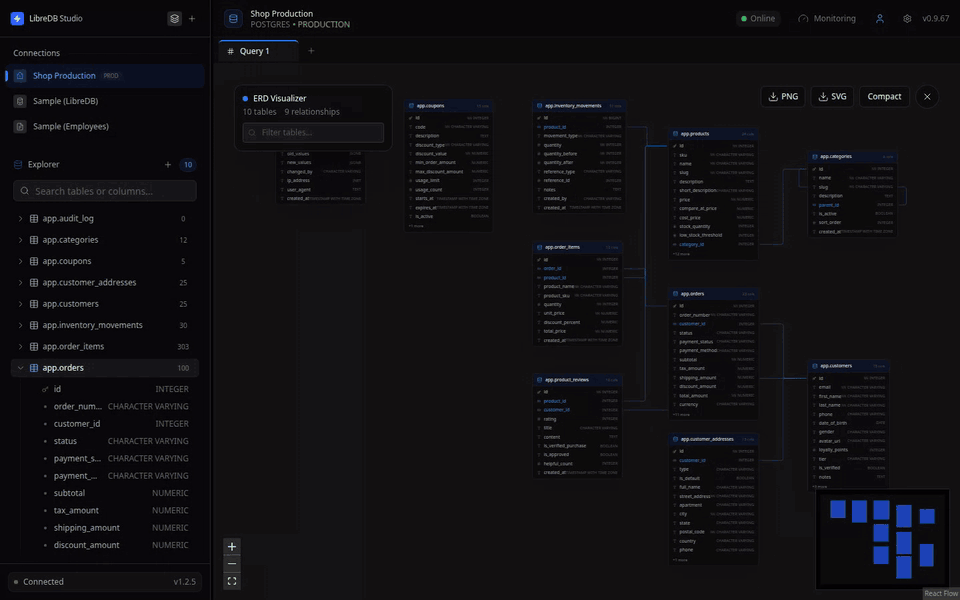


> یہ اردو README کمیونٹی کا ترجمہ ہے اور انگریزی نسخے سے پیچھے ہو سکتا ہے۔ فرق کی صورت میں [انگریزی نسخہ](README.md) معتبر ہے۔
## فوری شروعات
صرف ایک کمانڈ سے مکمل SQL IDE: نہ clone کرنے کی ضرورت، نہ build کرنے کی۔
```bash
# Docker (recommended)
docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest
# or with Node.js 24+ (without Docker)
npx @libredb/studio
```
پھر **http://localhost:3000** کھولیں۔ پہلی بار چلنے پر administrator کا password کسی configuration file کے بغیر log میں پرنٹ ہو جاتا ہے۔
>
اگر browser localhost یا HTTPS سے نہیں کھلتا (مثلاً مقامی network پر `http://192.168.x.x:3000`)، تو `AUTH_COOKIE_SECURE=false` شامل کرنا ہوگا۔ ورنہ health check تو کامیاب ہو جاتا ہے، لیکن login خاموشی سے ناکام ہو کر بار بار login screen پر واپس لے آتا ہے۔
کیا آپ کو Helm، Homebrew، Snap، winget یا deb/rpm چاہیے؟ نیچے [تنصیب](#تنصیب) ملاحظہ کریں۔
##
ایک اور database tool کیوں؟
آپ managed platform پر Postgres بناتے ہیں اور وہ چالیس سیکنڈ میں تیار ہو جاتا ہے۔
پھر آپ دیکھنا چاہتے ہیں کہ اس کے اندر کیا ہے۔ اس کے لیے یا تو آپ internet پر ایک port کھولتے ہیں، یا desktop client نصب کر کے SSH tunnel بناتے ہیں، یا ہار مان کر command line پر واپس آ جاتے ہیں۔ database کو چالیس سیکنڈ لگے؛ اس میں جھانکنے کا راستہ بنانے میں پوری شام گزر گئی۔
اب اسے scale پر تصور کریں۔ application Postgres استعمال کرتی ہے، documents Mongo میں ہیں، cache Redis میں ہے، اور events ClickHouse میں ہیں۔ چار databases، چار clients، اور credentials کے چار مجموعے۔ پیر کو کوئی نیا شخص آتا ہے تو اپنی پہلی code line لکھنے سے پہلے اسے معلوم کرنا پڑتا ہے کہ کون سا data کہاں ہے، wiki اور تین private chats میں connection strings ڈھونڈنی پڑتی ہیں، VPN access کا انتظار کرنا پڑتا ہے، اور ہر engine کے لیے الگ tool نصب کرنا پڑتا ہے۔
**Databases پہلے ہی منتقل ہو چکے ہیں۔** وہ Kubernetes، managed clouds اور customer VPCs میں چلے گئے ہیں جن تک bastion کے ذریعے ہی پہنچا جا سکتا ہے۔ **لیکن انہیں پڑھنے کے tools ان کے ساتھ منتقل نہیں ہوئے۔** وہ اب بھی desktop applications ہیں: بھاری، per-seat license والے، استعمال سے پہلے install ہونے والے، اور اس مفروضے پر بنے ہوئے کہ آپ کے پاس صرف ایک database، ایک laptop اور ایک ایسا شخص ہے جو کبھی device تبدیل نہیں کرتا۔
LibreDB Studio اس کے برعکس راستہ اختیار کرتا ہے: **tool کو data کے پاس لے جایا جاتا ہے، data کو tool کے پاس نہیں۔**
اس جملے کو سنجیدگی سے لیں تو یہ محض ترجیح نہیں رہتا، بلکہ ایک specification بن جاتا ہے۔
- Editor کو browser میں چلنا چاہیے، کیونکہ data آپ کی machine میں نہیں ہے اور آپ کے teammates بھی نہیں۔
- اسے phone پر بھی کھلنا چاہیے، کیونکہ جس incident کو query کی ضرورت ہو وہ آپ کے laptop کے آن ہونے کا انتظار نہیں کرتا۔
- اسے infrastructure کے طور پر deploy ہونا چاہیے (container، Helm chart، Operator، one-click template)، کیونکہ database کے ساتھ رہنے والی ہر چیز اسی طرح install ہوتی ہے۔
- اسے embed کیا جا سکنا چاہیے، کیونکہ editor کے لیے سب سے مفید جگہ اسی product کے اندر ہے جس نے database بنایا ہے۔
- کسی چیز کو reserve نہیں کیا جا سکتا۔ آپ ہر اس environment میں per-seat licensed، tiered-features والا tool نہیں ڈال سکتے جسے آپ manage کرتے ہیں۔ اگر single sign-on کی الگ قیمت ہو، تو tool default طور پر deploy کیے جانے کے قابل نہیں رہتا۔
>
یہاں MIT سخاوت نہیں: یہ architecture کی سخت شرط ہے۔
##
بنیادی صلاحیتیں
###
سولہ engines، ایک interface
PostgreSQL · MySQL · Oracle · SQL Server · SQLite · libSQL · DuckDB · MongoDB · Redis · Couchbase · ClickHouse · Apache Druid · Elasticsearch · OpenSearch · Apache Trino · Apache Cassandra
تمام SQL engines ایک ہی schema explorer، ER diagrams، schema comparison اور monitoring panels استعمال کرتے ہیں۔ MongoDB اور Redis SQL engines نہیں ہیں: ان میں ER diagram یا schema comparison نہیں ہوتا۔ Druid، Elasticsearch، OpenSearch اور Trino کے ساتھ دو الگ مسائل ہیں۔ ان کے SQL interfaces HTTP پر چلتے ہیں، مگر ان میں ایسا URI format نہیں جسے یہ build سمجھ سکے، اس لیے انہیں host اور port سے configure کیا جاتا ہے۔ مزید یہ کہ ان کے SQL میں column تبدیل کرنے کی statements موجود نہیں، لہٰذا پیدا ہونے والی migrations اس limitation کو بیان کرتی ہیں؛ کسی غیر موجود DDL کو گھڑنے کی کوشش نہیں کرتیں۔ Couchbase کی schema-less collections کے ساتھ بھی یہی صورت ہے۔ Search clusters کے ER diagram میں boxes تو ہوتے ہیں مگر lines نہیں: indexes foreign keys declare نہیں کرتے، اور engine model میں declare کرنے کے لیے کوئی موجود بھی نہیں۔
| ڈیٹا بیس | Driver | صلاحیتیں |
| :--- | :--- | :--- |
| **PostgreSQL** | `pg` | مکمل SQL IDE، EXPLAIN execution plans، transactions، query cancellation (`pg_cancel_backend`) |
| **MySQL** | `mysql2` | مکمل SQL IDE، EXPLAIN، transactions، query cancellation (`KILL QUERY`) |
| **Oracle** | `oracledb` (Thin موڈ) | مکمل SQL IDE، `FETCH FIRST N ROWS` کے ساتھ pagination، `V$` monitoring views، `ANALYZE TABLE`، `ALTER INDEX REBUILD`، transactions |
| **SQL Server** | `mssql` (tedious) | مکمل SQL IDE، `TOP N` / `OFFSET FETCH` کے ساتھ pagination، `sys.dm_*` DMV، `UPDATE STATISTICS`، `DBCC CHECKDB`، transactions، Azure SQL کی خودکار شناخت |
| **SQLite** | `bun:sqlite` / `node:sqlite` (runtime کے مطابق) | file یا memory میں مکمل SQL IDE |
| **libSQL** | کوئی مخصوص driver نہیں؛ براہِ راست HTTP (Hrana protocol، `POST /v2/pipeline`، port 8080) | مکمل SQL IDE۔ یہی type-id آپ کے اپنے libSQL server (`sqld`) اور Turso Cloud، دونوں سے connect کرتا ہے۔ یہ network پر SQLite dialect ہے، اور `dbstat` کے ساتھ tables اور indexes کا اصل size bytes میں دیتا ہے۔ credential password نہیں بلکہ auth token ہے۔ صرف دو maintenance operations ہیں، Reindex اور integrity check: server `VACUUM`، `ANALYZE` اور `PRAGMA optimize` کو رد کرتا ہے |
| **DuckDB** | `@duckdb/node-api` (مقامی N-API addon، ہر platform کے لیے تقریباً 68 MB) | مقامی DuckDB files یا `:memory:` پر مکمل SQL IDE، جو application کے اسی server پر چلتا ہے۔ `EXPLAIN (FORMAT JSON)` کے ساتھ physical plan tree، `duckdb_*` catalog introspection، `pragma_storage_info` کی block allocation سے table کا اصل size، اور خود driver کے `interrupt()` سے query cancellation۔ تین maintenance operations: `VACUUM`، `ANALYZE` اور `CHECKPOINT`۔ یہاں `REINDEX` syntax error ہے، جبکہ `PRAGMA integrity_check` اور `PRAGMA optimize` موجود نہیں، اس لیے پیش نہیں کیے جاتے۔ slow-query log یا sessions list نہیں: DuckDB ان میں سے کوئی بھی ظاہر نہیں کرتا، اس لیے panels 0 دکھانے کے بجائے یہ بات بتاتے ہیں۔ ایک database file کو operating system کا صرف ایک process کھول سکتا ہے (read-only mode میں بھی)، اس لیے Studio کی دوسری instance اس file کو نہیں کھول سکتی جو پہلی instance نے کھولی ہوئی ہے |
| **MongoDB** | `mongodb` | JSON query editor اور collections پر operations (find, aggregate, insert, update, delete) |
| **Couchbase** | کوئی مخصوص driver نہیں؛ براہِ راست HTTP (Query اور انتظامی REST) | مکمل SQL++ IDE، EXPLAIN، buckets، scopes اور collections explorer، `INFER` کے ذریعے field inference |
| **ClickHouse** | کوئی مخصوص driver نہیں؛ براہِ راست HTTP (SQL انٹرفیس، port 8123) | مکمل SQL IDE، JSON میں EXPLAIN tree، system tables کے ذریعے schema introspection، `OPTIMIZE TABLE` |
| **Apache Druid** | کوئی مخصوص driver نہیں؛ براہِ راست HTTP (`POST /druid/v2/sql`) | read-only SQL IDE، native query کا EXPLAIN tree، `INFORMATION_SCHEMA` سے introspection، `sys.*` کے ساتھ monitoring |
| **Elasticsearch** | کوئی مخصوص driver نہیں؛ براہِ راست HTTP (`POST /_sql?format=json`، port 9200) | read-only SQL IDE، mapping پر مبنی indexes اور fields explorer، cluster health، اور ہر index کے لیے document count اور size۔ EXPLAIN نہیں، maintenance operations نہیں، اور slow queries یا sessions panels بھی نہیں۔ Elasticsearch SQL میں `OFFSET` بھی نہیں، اس لیے results کا دوسرا page نہیں مانگا جا سکتا |
| **OpenSearch** | کوئی مخصوص driver نہیں؛ براہِ راست HTTP (`POST /_plugins/_sql`، port 9200) | Elasticsearch والا ہی provider module، وہی read-only IDE اور وہی explorer۔ یہاں `LIMIT n OFFSET m` کام کرتا ہے، اس لیے pagination دستیاب ہے |
| **Apache Trino** | کوئی مخصوص driver نہیں؛ براہِ راست HTTP (client protocol، `POST /v1/statement`، port 8080) | تمام configured catalogs پر مکمل SQL IDE، connection میں مقرر catalog کے `information_schema` کے ذریعے schema tree، `system.runtime` اور `jmx` سے monitoring، `SHOW STATS` سے اصل row counts، query cancellation اور `kill_query` کے ساتھ maintenance۔ Trino query engine ہے اور data store نہیں کرتا، اس لیے کہیں بھی primary keys، foreign keys یا indexes declare نہیں کرتا: ER diagram میں lines کے بغیر boxes ہوتے ہیں، inline editing بند رہتی ہے، اور capacity panel مصنوعی size بنانے کے بجائے catalogs دکھاتا ہے۔ ناکام statements بھی HTTP 200 کے ساتھ واپس آتی ہیں؛ اور cluster میں authentication بند ہو تب بھی plain HTTP پر password رد کر دیا جاتا ہے |
| **Apache Cassandra** | `cassandra-driver` (خالص JavaScript، native modules کے بغیر) | native protocol (port 9042) پر CQL IDE، partition اور clustering keys نشان زد keyspaces explorer، `system_views` سے summary، uptime اور چلتی ہوئی statements۔ Connection کے لیے **`localDataCenter` لازمی ہے**: اس کے بغیر driver connect کرنے سے انکار کر دیتا ہے۔ EXPLAIN نہیں (CQL grammar میں یہ keyword موجود ہی نہیں)، query cancellation نہیں (protocol میں cancel frame نہیں) اور maintenance operations نہیں (compaction، repair اور flush، `nodetool` کے JMX operations ہیں)۔ اور **یہ کوئی row count یا size نہیں دکھاتا**: Cassandra صرف disk پر پہلے سے لکھی files سے partitions کا تخمینہ (500 rows کی table کو 143 پڑھا گیا) اور MiB میں integers (19,476 bytes کی table کو `1 MiB` پڑھا جاتا ہے) دے سکتا ہے، اس لیے غلط number دکھانے کے بجائے ہم کچھ نہیں دکھاتے |
| **Redis** | `ioredis` | command editor، keys explorer، INFO پر مبنی monitoring |
>
**Transport security cross-cutting ہے، engine پر منحصر نہیں۔** SSH tunnel provider کے connection کھولنے سے پہلے قائم ہوتا ہے، اور connection کو local endpoint کی طرف rewrite کر دیتا ہے: اسی لیے یہ engine پر منحصر نہیں اور host اور port کے ساتھ configured ہر connection پر لاگو ہوتا ہے۔ Connection string سے بھری جانے والی connections (MongoDB، Couchbase اور ClickHouse میں ممکن) میں host یا port نہیں ہوتا، اس لیے وہ tunnel سے نہیں گزرتیں؛ SQLite اور DuckDB میں بھی دونوں نہیں ہوتے۔ SSL/TLS panel فی الحال PostgreSQL، MySQL، SQL Server، Couchbase، ClickHouse، Druid، Elasticsearch، OpenSearch اور Trino پر اثر انداز ہوتا ہے؛ Trino میں یہ اختیاری نہیں کیونکہ coordinator plain HTTP پر passwords رد کرتا ہے۔ Oracle، MongoDB اور Redis اس option کو نظر انداز کرتے ہیں، اس لیے ان تینوں کا traffic encrypted ہو گا یا نہیں، اس کا انحصار connection string پر ہے، dialog کے انتخاب پر نہیں۔
>
SQL کے لیے بنے interface میں Redis کو لانے کی بنیاد ایک convention ہے۔ `getSchema()` `SCAN` سے key prefixes کو "tables" میں گروپ کرتا ہے، جو block نہیں کرتا (**کبھی بھی `KEYS *` نہیں**)؛ health اور metrics `INFO` سے، جبکہ slow queries اور sessions `SLOWLOG GET` اور `CLIENT LIST` سے آتی ہیں۔
###
پیشہ ورانہ SQL editor
- Monaco engine: وہی core جو VS Code استعمال کرتا ہے۔
- Schema-aware autocomplete: tables، columns اور keywords۔
- Tabbed workspace: ہر tab کی اپنی execution state۔
- Visual EXPLAIN: bottlenecks ڈھونڈنے کے لیے graphical execution plans۔
- Interactive ER diagrams: اصلی foreign-key edges، cardinality labels، minimap، table search اور filtering، compact mode، اور PNG اور SVG export کے ساتھ schema graph۔ خودکار hierarchical layout ELK.js کرتا ہے۔
- Schema comparison اور migrations: ایک ہی یا مختلف connections کے schemas کے snapshots کو ساتھ ساتھ compare کریں۔ رنگوں کے ساتھ differences view (added، removed، modified) اور PostgreSQL، MySQL، SQLite، Oracle اور SQL Server کے لیے migration SQL کی خودکار generation، نیز ClickHouse column changes۔
- Snapshots timeline: schema snapshots کے ساتھ ایک افقی timeline۔ دو points منتخب کریں اور فوراً compare کریں، تاکہ schema کی تبدیلی کا ارتقا دیکھا جا سکے۔
###
Database agent (read-only)
AI کی بنیادی سطح editor کے ساتھ موجود ایک **agent panel** ہے۔ کوئی مقصد دیا جاتا ہے — *"کس department میں سب سے زیادہ employees ہیں؟"*، *"یہ query اتنی slow کیوں ہے؟"* — اور Start دبایا جاتا ہے۔ Execution connected database کے لیے SQL تیار کرتی ہے، results پڑھتی ہے، اور ایک report لکھتی ہے جس کے دعوے ان results کا حوالہ دیتے ہیں۔
###
دیگر model-based خصوصیات (اختیاری، اپنے model کے ساتھ)
- کسی بھی LLM کے ساتھ مطابقت: default طور پر Gemini استعمال کرتا ہے، اور OpenAI، Ollama اور OpenAI-compatible endpoint (LM Studio، LiteLLM، vLLM) کے ساتھ کام کرتا ہے۔
- Query security analysis: destructive statements (DELETE، DROP، TRUNCATE) کے لیے execution سے پہلے risk evaluation۔
- Query explanation: EXPLAIN plans کو سادہ زبان میں، optimization suggestions کے ساتھ۔
- Schema knowledge: connected database کا schema context کے طور پر بھیجا جاتا ہے، اس لیے explanation آپ کی اپنی tables اور columns کے نام لیتی ہے۔
- Data profiler summary: profiler کی فی-column statistics کی summary۔ اس context میں ہر column کے
min اور max شامل ہیں، جو آپ کے data کی حقیقی values ہیں؛ Agent Data Flow ملاحظہ کریں۔
###
Data management
- Universal grid: لاکھوں rows کے لیے virtualized rendering (TanStack)۔
- Inline editing: grid میں براہِ راست values update کرنے کے لیے double-click، ان engines میں جن کے SQL میں ایک table پر row update موجود ہے (باقی میں control ظاہر نہیں ہوتا)۔
- Column filters: query دوبارہ لکھے بغیر explore کرنے کے لیے results پر text filters۔
- Interactive pivot table: client-side pivoting، پانچ aggregate functions (COUNT، SUM، AVG، MIN، MAX) اور متعلقہ SQL کی generation۔
- Export: فوری CSV اور JSON۔
- آٹھ chart types: Recharts کے ساتھ bar، line، pie، area، scatter، histogram، stacked bar اور stacked area۔ hour، day، week، month یا year کے لحاظ سے grouping، اور محفوظ ہو کر دوبارہ load ہونے والی chart configurations۔
###
تجزیہ اور development tools
- Data profiler: ایک click میں table profiling، column statistics (null percentage، cardinality، minimum اور maximum، sample values) اور model سے تیار ہونے والے narrative summaries کے ساتھ۔
- ORM code generator: tables کے اصل schema سے TypeScript interfaces، Zod schemas، Prisma models، Go structs، Python dataclasses اور Java POJOs۔
- Test-data generator: schema-aware fake data اور 30 سے زائد semantic column inferences (email، phone، name، address اور مزید)۔ MongoDB کے
insertMany کے لیے INSERT statements یا JSON پیدا کرتا ہے۔
- Database documentation: اصل schema سے تیار، searchable data dictionary، model-assisted documentation اور Markdown export کے ساتھ۔
###
Authentication اور SSO: MIT version میں مکمل
- Authentication کے دو modes: local username/password، یا OpenID Connect (OIDC) کے ذریعے single sign-on، environment variable سے قابلِ تبدیلی۔
- Provider-agnostic OIDC: ہر OIDC-compliant provider کے ساتھ کام کرتا ہے — Auth0، Keycloak، Okta، Azure AD، Zitadel، Google اور دیگر۔
- PKCE security: Proof Key for Code Exchange (S256) کے ساتھ Authorization Code Flow۔
- Automatic role mapping: configurable claim mapping، nested claims کے لیے dot notation کے ساتھ (مثلاً
realm_access.roles)۔
- Provider logout: sign out پر مقامی JWT session اور identity provider، دونوں کی session بند ہو جاتی ہے۔
###
DBA کے لیے maintenance tools (صرف admin)
- Live monitoring dashboard: سات tabs — overview، performance، queries، sessions، tables، storage اور connection pool۔
- Trend charts: real-time metrics (connections، cache hit rate، buffer pool، deadlocks) circular-buffer history کے ساتھ، اور 5 سے 60 seconds کے درمیان configurable automatic refresh۔
- Threshold alerts: cache hit rate، connection usage، deadlocks اور buffer-pool usage کے لیے رنگ دار health indicators (healthy، warning، critical)۔
- One-click maintenance: engine کے مطابق
VACUUM، ANALYZE، REINDEX، UPDATE STATISTICS، DBCC CHECKDB اور ALTER INDEX REBUILD۔
- Audit log: organization میں چلنے والی ہر query کی مکمل history۔
##
تنصیب
`flatpak --user install flatpark org.libredb.Studio` |
`brew trust` صرف ایک بار چلتا ہے (Homebrew 6+ درکار ہے؛ اگر command موجود نہ ہونے کا پیغام آئے تو پہلے `brew update` چلائیں)۔ Docker، Helm اور Snap کو configuration کی ضرورت نہیں: پہلی بار چلنے پر administrator کا password بالترتیب container log، pod log اور `sudo snap logs libredb-studio` میں پرنٹ ہوتا ہے۔ ہر channel کی مکمل ہدایات (commands، configuration، systemd کے ساتھ استعمال، Docker images کا tagging model) [`docs/DISTRIBUTION.md`](docs/DISTRIBUTION.md) میں موجود ہیں۔
One-click deployment templates: Railway، Dokploy، CapRover، Sealos، Kubero، Cosmos، DigitalOcean Marketplace، Unraid Community Apps، Render Blueprint، Fly.io اور Koyeb۔ مکمل فہرست [`docs/CHANNELS.md`](docs/CHANNELS.md) میں موجود ہے۔
Kubernetes کے لیے OpenShift اور OLM کا Operator bundle بھی دستیاب ہے۔
### اپنے product میں شامل کریں
```bash
npm i @libredb/studio
```
Studio npm package کے طور پر بھی شائع ہوتا ہے، اس لیے اسے براہِ راست آپ کی application میں embed کیا جا سکتا ہے۔ اگر آپ کا product اپنے users کے لیے databases بناتا ہے تو editor کے لیے یہی سب سے مفید جگہ ہے۔
##
کیا مفت ہے اور کیا بامعاوضہ ہے؟
Studio MIT ہے کیونکہ اسے ہر جگہ جانے کے قابل ہونا چاہیے۔ جس چیز کی قیمت لی جاتی ہے وہ libredb-platform ہے، اور اس میں دوسرا فریق اسے operate کرنے کی ذمہ داری لیتا ہے: hosting، multi-tenancy، billing اور support۔ یہ کوئی feature نہیں جسے دیوار کے پیچھے منتقل کر دیا گیا ہو۔
**Upgrade کی وجہ بنانے کے لیے کسی صلاحیت کو اس لکیر کے دوسری طرف نہیں لے جایا گیا۔** Single sign-on، RBAC، query auditing، ER diagrams، AI features اور تمام NoSQL engines MIT version میں موجود ہیں۔
##
Tests اور quality
- Tests کی سات layers: unit، API، integration، hooks، security، evals اور components، اس کے علاوہ end-to-end
- 100% line coverage، اور CI میں یہ سخت شرط ہے۔ coverage کم ہوئی تو merge رک جاتا ہے
- SonarCloud quality gate
- ہر release میں Node 24 اور 26 پر smoke tests
```bash
bun run test # all tests
bun run test:e2e # Playwright (requires compiling beforehand)
bun run test:coverage # coverage report
```
##
دستاویزات
ابھی تفصیلی مواد صرف English میں دستیاب ہے:
##
تعاون
Issues اور pull requests خوش آئند ہیں۔ آغاز [CONTRIBUTING.md](CONTRIBUTING.md) سے کریں۔
Database engine شامل کرنے کے لیے [`docs/ADDING_A_PROVIDER.md`](docs/ADDING_A_PROVIDER.md) ملاحظہ کریں۔ Code، documentation اور tests ایک ہی pull request میں ساتھ چلتے ہیں۔
##
لائسنس
[MIT](LICENSE)۔ کوئی CLA نہیں، کوئی enterprise edition نہیں، اور کچھ بھی reserved نہیں۔