
LibreDB Studio
把数据库编辑器部署在数据旁边,而不是装在你的笔记本上。
English ·
简体中文 ·
日本語 ·
Español ·
اردو ·
हिन्दी
已列入 PostgreSQL 项目:
News
·
PostgreSQL Clients
·
Software Catalogue
·
Community Guide to GUI Tools
同时列入
Redis、
ClickHouse、
MariaDB、
Trino、
Apache Cloudberry、
YugabyteDB、
DragonflyDB
和
OpenSearch
官方文档
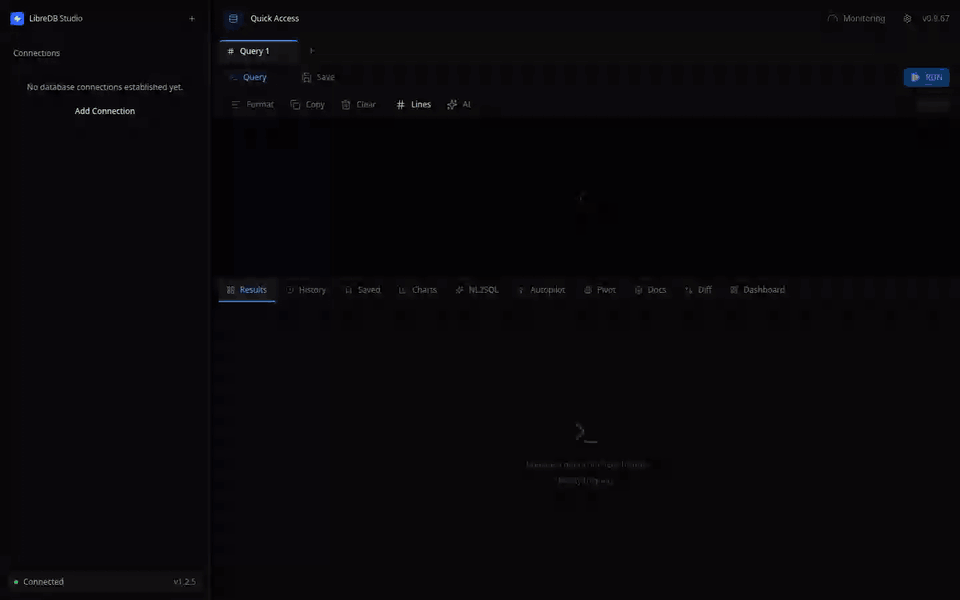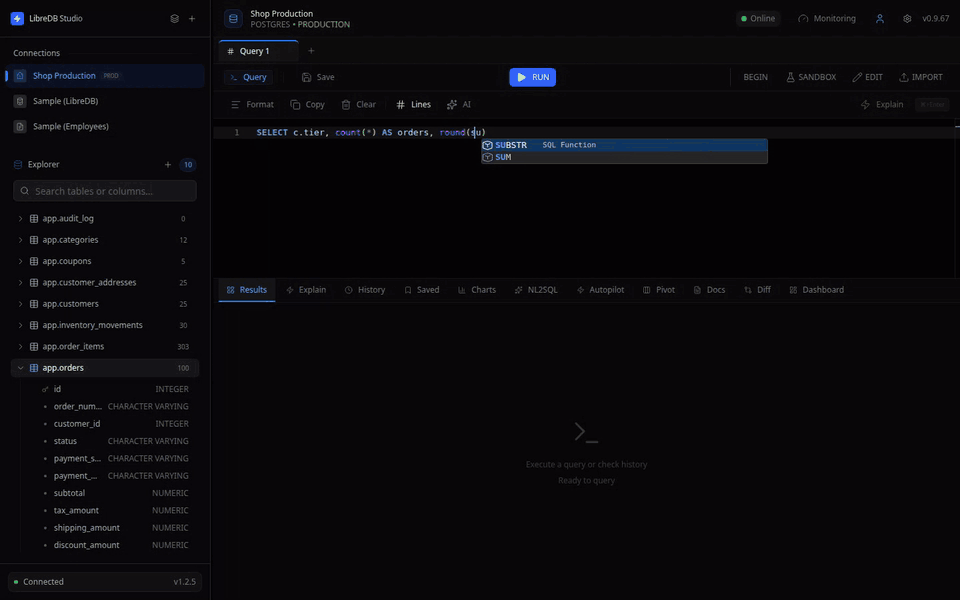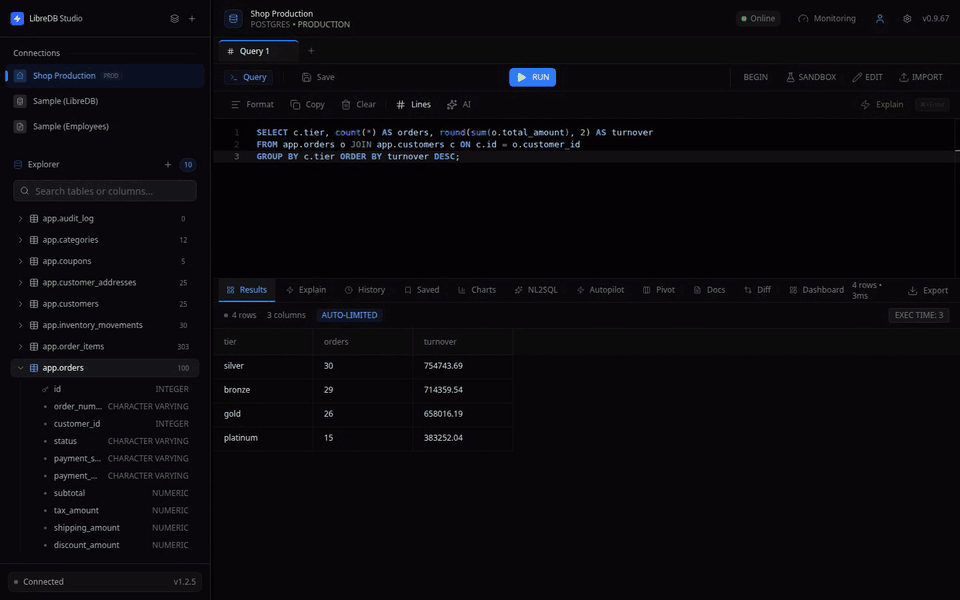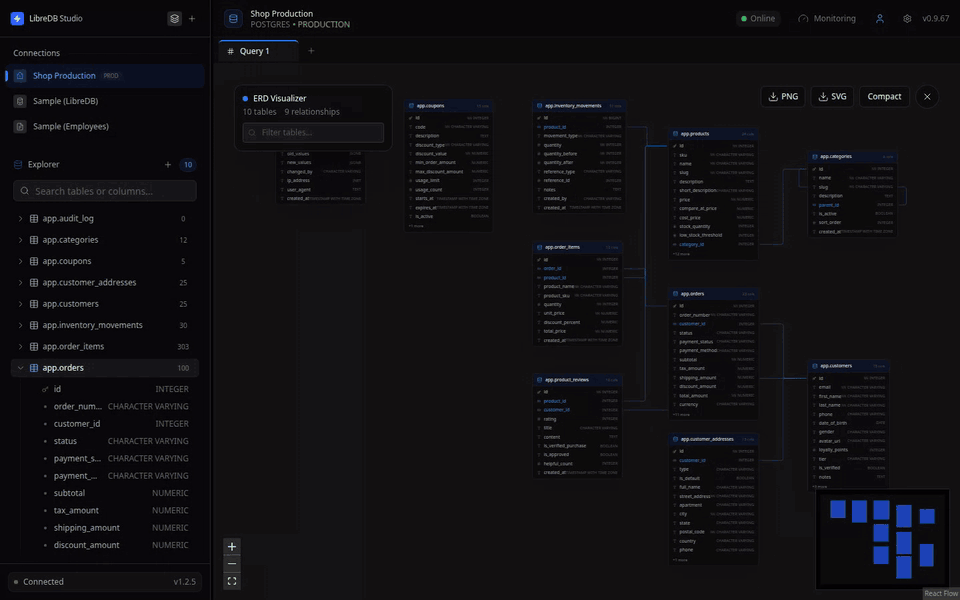


> 这份中文 README 由社区翻译,可能落后于英文版。两者有出入时,以[英文版](README.md)为准。


快速开始 •
在线演示 •
安装方式 •
部署你自己的实例
## 快速开始
一条命令启动完整的数据库编辑器,不用克隆,不用构建:
```bash
# Docker(推荐)
docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest
# 或者用 Node.js 24+(不装 Docker)
npx @libredb/studio
```
然后打开 **http://localhost:3000**。首次启动时,管理员密码会打印到日志里(零配置)。
> 如果浏览器不是通过 localhost 或 HTTPS 访问 Studio(例如局域网里的 `http://192.168.x.x:3000`),还需要设置 `AUTH_COOKIE_SECURE=false`。否则健康检查一切正常,登录却会静默失败,把你送回登录页。
> 需要 Helm、Homebrew、Snap、winget 或 deb/rpm?见[全部安装方式](#安装方式)。
## 为什么要再做一个数据库工具
你在托管平台上开一个 Postgres,四十秒就绪。
然后你想看看里面有什么。于是你把端口暴露到公网,或者装一个桌面客户端再挖一条 SSH 隧道,或者干脆放弃、退回到命令行。数据库花了四十秒,而给它开一扇窗花掉了你一个下午。
再乘上规模。应用用 Postgres,文档用 Mongo,缓存用 Redis,事件用 ClickHouse。四个数据库,四个客户端,四套凭据。周一来了个新人,在写下第一行代码之前,他要先搞清楚哪些数据在哪里,在 wiki 和三个私聊里翻连接串,等 VPN 权限,再给每种引擎装一个不同的工具。
**数据库已经搬走了。** 它们搬进了 Kubernetes,搬进了托管云,搬进了要穿过跳板机才能到达的客户 VPC。**但读它们的工具没有跟着搬。** 它们仍然是桌面应用:笨重、按席位收费、必须先安装,并且假设你只有一个数据库、一台笔记本,以及一个永远不换设备的人。
LibreDB Studio 走另一条路:**工具去找数据,而不是把数据搬来找工具。**
认真对待这句话,它就不再是一种偏好,而是一份规格说明。
- 编辑器必须跑在浏览器里,因为数据不在你的机器上,你的同事也不在。
- 它必须能在手机上打开,因为需要执行一条查询的故障,不会等你先开笔记本。
- 它必须像基础设施那样部署(容器、Helm chart、Operator、一键模板),因为数据库旁边的东西都是这么装的。
- 它必须可嵌入,因为编辑器最有用的位置,是在那个创建了数据库的产品内部。
- 它必须毫无保留。你没法把一个按席位授权、功能分级的工具放进你拥有的每一个环境。**单点登录一旦要加钱,这个工具就不再是默认可部署的了。**
> MIT 不是慷慨,而是这套架构的硬性要求。
## 在线试用
> **不用安装,立刻试用 LibreDB Studio!**
| 试用方式 | URL | 凭据 |
|------|-----|-------------|
| **OIDC 公开试用** | [app.libredb.org](https://app.libredb.org) | SSO |
| **JWT 公开试用** | [trial.libredb.org](https://trial.libredb.org) | admin@libredb.org / Admin!2026 user@libredb.org / User!2026 |
试用实例通过[种子连接](#种子连接预配置数据库)预置了一个 PostgreSQL 数据库,无需任何配置。
## 概览
LibreDB Studio 走的是另一条路。它部署在数据旁边:一个容器、一个 Helm chart、一个 operator、一份 PaaS 一键模板,或者用 `npm i @libredb/studio` 嵌进你自己的产品。没有任何东西需要朝外暴露。
十六种引擎共用一个界面,PostgreSQL、MySQL、Oracle、SQL Server、SQLite、libSQL、DuckDB、MongoDB、Redis、Couchbase、ClickHouse、Druid、Elasticsearch、OpenSearch、Apache Trino 和 Apache Cassandra,处处是同一套浏览器,凡是引擎有东西可报的地方都有 ER 图、schema 对比和监控。十六种里有三种是只读的,因为它们自己的 SQL 就是只读的:Druid、Elasticsearch 和 OpenSearch 的文法里根本没有 `UPDATE`,也没有 `CREATE TABLE`,所以那些控件被如实报告为不支持,而不是等到用的时候才失败。Cassandra 是其中最新的一个,也是刻意报告得最少的一个:它给出的任何行数和容量都不真实,所以对象浏览器索性两者都不显示,而不是显示一个错的数字;它确实会发布的分区估算来自已刷盘的文件,实测一张 500 行的表被读作 143。Trino 是另一个异类:它是查询引擎而不是数据库,所以不声明任何主键和索引,报告的字节数属于它背后那些连接器所在的系统。
而且没有任何东西被留在门后。单点登录、ER 图、AI 功能和全部 NoSQL 引擎都在 MIT 构建里。MIT 在这里不是慷慨,而是这套架构的要求:你没法把一个按席位授权、功能分级的工具,放进你拥有的每一个环境。
### 为什么选择 LibreDB Studio?
- **部署在数据旁边**:容器、Helm chart、Rancher、OpenShift operator、PaaS 一键模板,或用 npm 嵌入。
- **十六种引擎,一个界面**:PostgreSQL、MySQL、Oracle、SQL Server、SQLite、libSQL、DuckDB、MongoDB、Redis、Couchbase、ClickHouse、Druid、Elasticsearch、OpenSearch、Trino、Cassandra。
- **你人在哪它就在哪跑**:浏览器、手机、Windows、MacOS、Linux 桌面。
- **一个只读的 Agent,配你自己的模型**:说一个问题,这次运行就会起草 SQL、读取结果,并写出一份每条结论都引用来源的报告。Gemini、OpenAI,或者跑开源模型的本地 Ollama。
- **没有东西被锁在墙后**:RBAC、OIDC 单点登录、查询审计日志和 ER 图,全部以 MIT 发布。
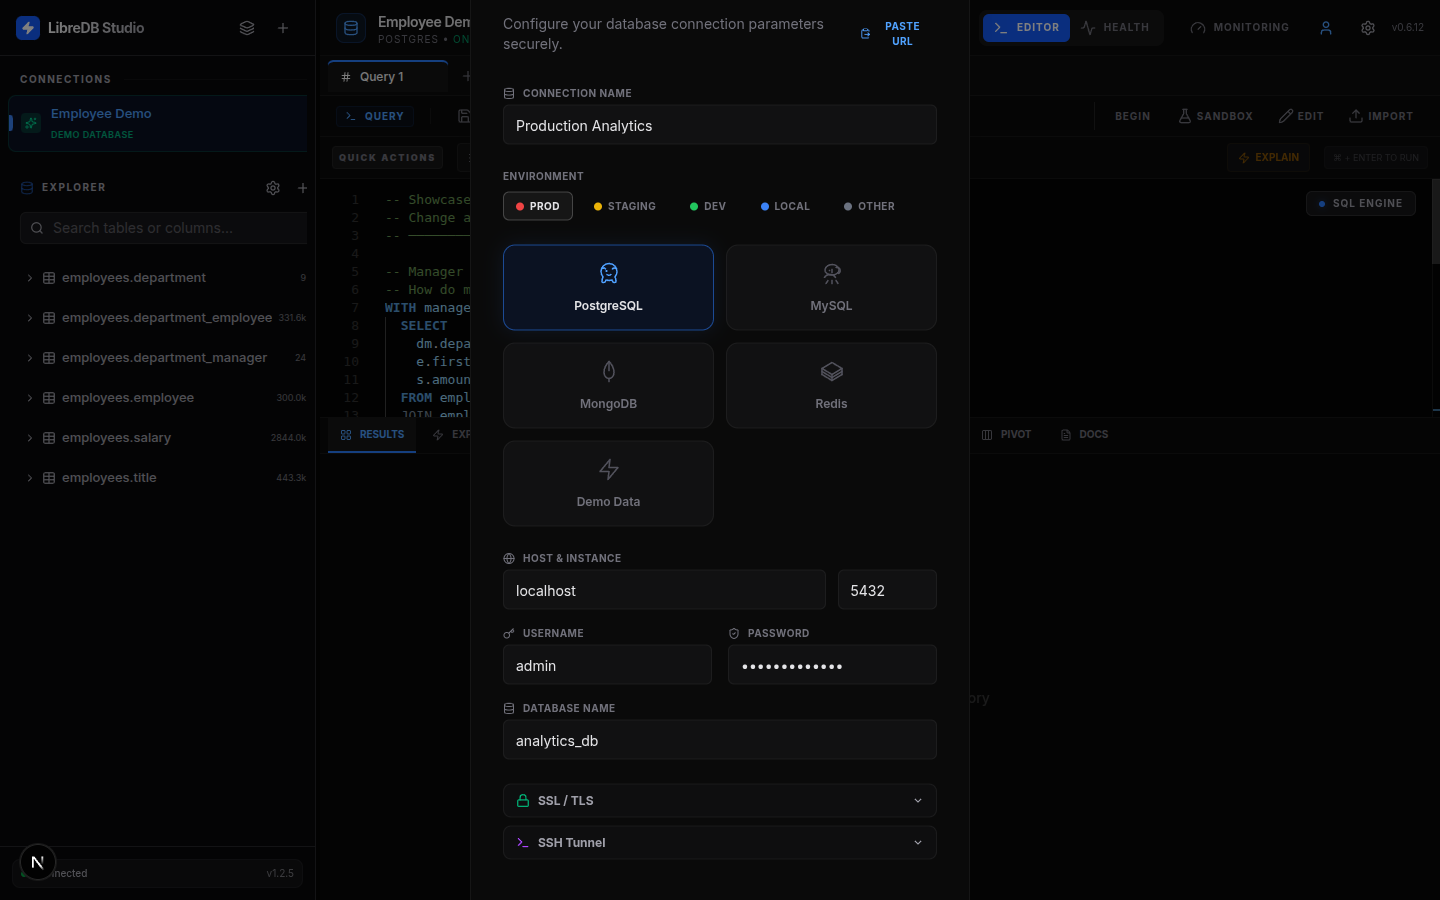
连接 PostgreSQL、MySQL、Oracle、SQL Server、MongoDB、Couchbase、ClickHouse、Druid、Elasticsearch、OpenSearch、Trino、Cassandra、Redis、SQLite、DuckDB 或 libSQL,支持 SSL/TLS 与 SSH 隧道。
[](https://deepwiki.com/libredb/libredb-studio)
## 核心能力
### 专业 SQL 编辑器
- **Monaco 引擎**:与 VS Code 同源。
- **智能补全**:感知 schema,提示表名、列名和 SQL 关键字。
- **命令面板**:用 `Cmd/Ctrl+K` 快速跳转到表、连接、已保存的查询和各类操作。
- **多标签工作区**:并行处理多个任务,每个标签有独立的执行状态。
- **已保存查询的备份**:把整个已保存查询库导出为 JSON。导入时会校验文件、保留查询元数据并合并新条目,遇到重复 ID 会报告,同时保持已有查询不变。
- **复制连接**:在连接编辑器里为一个可编辑的已保存连接打开一份独立的 `(copy)`,调整设置后保存。取消不会改动已保存的连接;管理员管理的连接不能复制。
- **可视化 EXPLAIN**:图形化执行计划,用于定位性能瓶颈。
- **交互式 ER 图**:可视化 schema 图,带真实外键连线、基数标注、MiniMap 导航、表搜索/过滤、紧凑模式和 PNG/SVG 导出。由 ELK.js 提供自动分层布局。
- **Schema 对比与迁移**:并排比较 schema 快照或跨连接的 schema。按颜色区分新增/删除/修改,并自动生成迁移 SQL,覆盖 PostgreSQL、MySQL、SQLite、Oracle 和 SQL Server,以及 ClickHouse 的列变更。
- **快照时间线**:以横向时间轴展示 schema 快照。点任意两点即可立即对比,追踪 schema 随时间的演化。
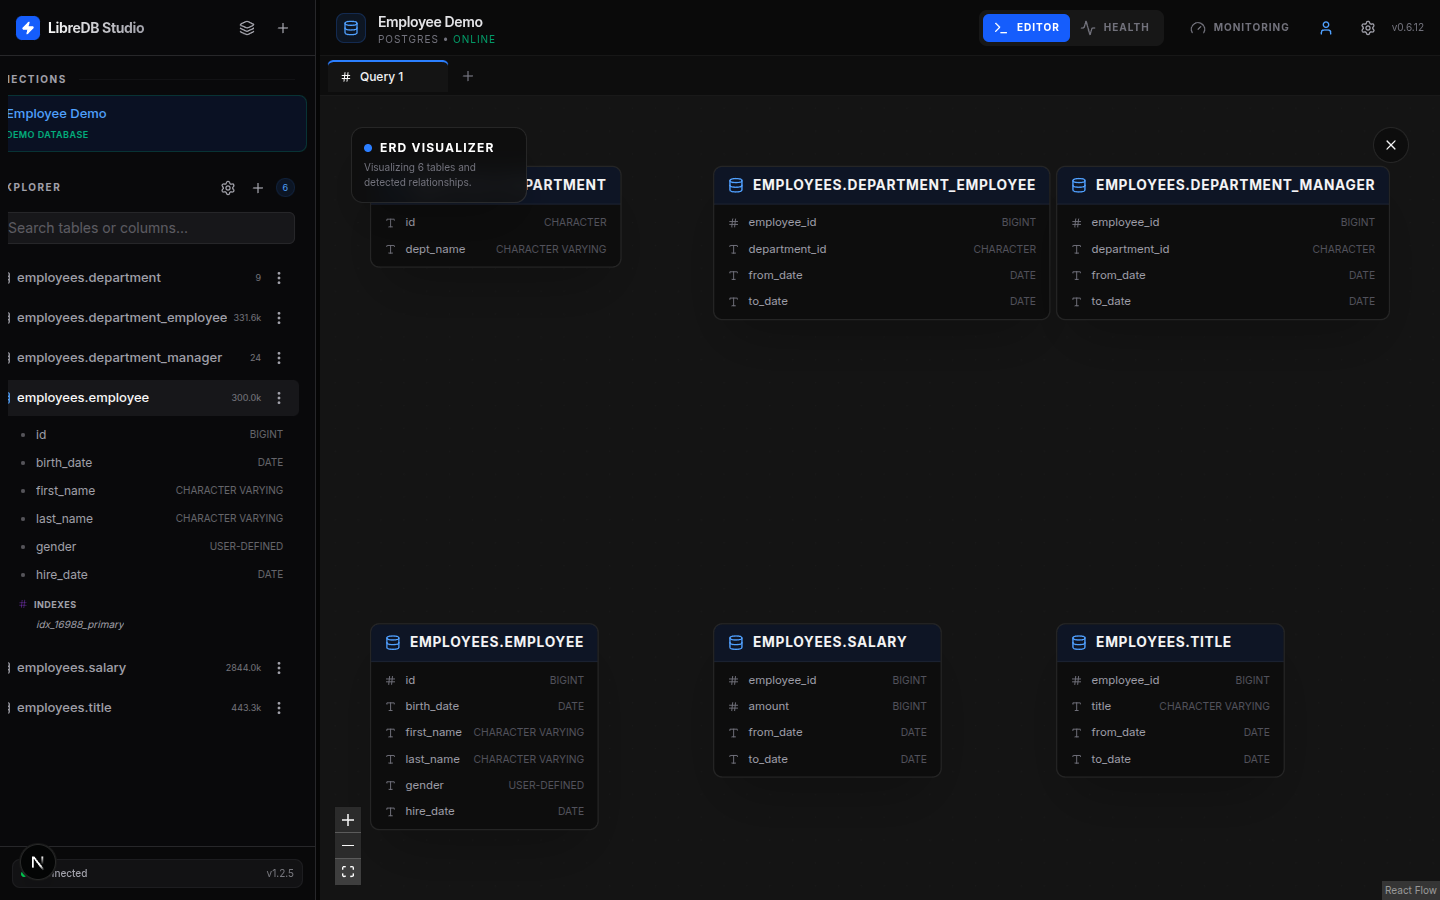
由 ReactFlow 驱动的可视化 schema 浏览器与交互式 ER 图。
### 数据库 Agent
Studio 最主要的 AI 界面是编辑器旁边的 **Agent 侧栏**,下面列出的模型辅助功能是其余部分。你说出一个目标:*“哪个部门人最多?”*、*“这条查询为什么慢?”*,然后按下 Start。这次运行会针对已连接的数据库起草 SQL、读取返回结果,最后写出一份报告,其中每一条结论都引用它所依据的那次读取。
- **只读,由数据库本身来保证,而不是靠解析器。** Agent 执行的每条语句都走 Agent 自己的受审计管线,在碰到驱动之前先做策略判定、记录审计事件、核算预算(`executeAuditedOperation`,`src/lib/db/operations/execution.ts:129`),并使用只读执行配置:PostgreSQL 上是只读事务,SQLite 上每条语句都重新声明 `PRAGMA query_only`,DuckDB 上是 `READ_ONLY` 引擎句柄外加一层 SQL 守卫,因为仅靠该标志仍然放行 `COPY … TO`、`EXPORT DATABASE` 和读取本地文件的表函数;SQL Server 上没有任何形式的只读事务,因此改由四层保证:开启连接时先核验会话主体确实无法写入,再由优化器在不执行的前提下编译放行每条语句,并在服务端限定返回行数,最后把语句放进一个总是回滚的事务里。写入和 DDL 在到达数据库之前就被拒绝,`EXPLAIN ANALYZE` 因为会真正执行语句而默认禁止。这条管线只属于 Agent:你自己在编辑器里执行的语句是直接调用 provider 的(`src/app/api/db/query/route.ts:44`),不会经过这里的策略判定,也不会产生这类审计记录。
- **Agent 模式只读取 PostgreSQL、SQLite、DuckDB 和 SQL Server。** 只读配置由数据库原生保证,因此只在实现了它的 provider 上存在,也就是 `postgres.ts`、`sqlite.ts`、`duckdb/index.ts` 和 `mssql.ts` 上的 `queryReadOnly`,别无其他。在其他引擎上,只要某个 Agent 模式工作流会发送语句,它就会在启动时被拒绝,此时运行尚未开启;万一有请求走到 provider 工厂,也会以 `engine-unsupported` 结束。**Plan** 模式对所有连接都可用,那里的模型不使用任何工具,不执行你的任何语句,不做任何写入,只为你起草一条由你自己去执行的语句。它的 GROUNDING 覆盖全部引擎:PostgreSQL 和 SQLite 上由服务端自己组装目录查询,其他连接则请该连接自己的 provider 描述其 schema,也就是侧边栏本来就在做的那次读取,这不需要只读语句通道。所以两条限制是分开的:Agent 模式是这四种引擎,GROUNDING 是全部引擎,而读取失败的运行会直接说明,不会凭空编造表名。
- **三种工作流**:**Investigate**(回答问题)、**Optimize**(比较预估执行计划,提出索引或改写)、**Assess**(做表画像,只有计数,永远不含具体值)。
- **不会自行执行。** Agent 不会替你开始运行,不会写入编辑器,也不会执行它建议的语句。是否采用由你点击决定。
- **有证据才有结论。** 没有引用的结论无法被写出,运行结束时会给出自己的判定,*“Run answered”* 或 *“Run did not answer”*,并与结束方式并列显示。
- **有上限,而且界面上就能看到**:根据工作流类型,每次运行 18 到 45 条语句、整轮时限 360 到 900 秒,单次读取 200 行。各工作流的具体数值见 [docs/AGENT.md](docs/AGENT.md)。
- **用你自己的模型。** Gemini(默认)、OpenAI、Ollama,或任何兼容 OpenAI 的端点。**Agent** 模式需要一个能调用工具的模型,在 Ollama 上这要靠一次真实探测来确认,而不是照抄厂商文档,指南里写了怎么跑这次探测。**Plan** 模式不需要工具,也从不做探测(`src/lib/agent/capability-gate.ts:74`),所以被 Agent 模式拒绝的模型仍然可以用在 Plan 模式里,这也正是侧栏会向你提议的做法。
- **不配置模型就没有 AI。** 完全没有 `LLM_*` 配置时,侧栏根本不会渲染,也不会有任何数据离开你的网络。注意,密钥并不是开关:Ollama 和自定义端点无需密钥也算配置了模型,此时 AI 就是启用的。Agent 会外发什么内容见 [`docs/AGENT_DATA_FLOW.md`](docs/AGENT_DATA_FLOW.md)。
仅限独立应用:嵌入式 `@libredb/studio` 包不包含任何 Agent 界面。
**指南:**[`docs/AGENT_GUIDE.md`](docs/AGENT_GUIDE.md) · **什么东西会离开本机:**
[`docs/AGENT_DATA_FLOW.md`](docs/AGENT_DATA_FLOW.md) · **行为与限制:**
[`docs/AGENT.md`](docs/AGENT.md) · **该跑哪个本地模型:**
[`docs/llms/`](docs/llms/README.md)
### 模型辅助功能
- **通用 LLM 支持**:默认使用 Gemini,同时支持 OpenAI、Ollama 以及任何兼容 OpenAI 的端点(LM Studio、LiteLLM、vLLM)。
- **查询安全分析**:对破坏性查询(DELETE、DROP、TRUNCATE)做 AI 驱动的执行前风险评估。没有配置任何 provider 时,确认对话框依然会出现,只是附一条普通查询警告。只设了 `LLM_PROVIDER` 却没配它的凭据属于没配完,所以那个错误会保持可见,其他配置错误和服务错误同样如此。
- **AI 查询解释器**:把 EXPLAIN 计划翻译成通俗语言,并给出优化建议。
- **感知 schema**:已连接数据库的 schema 会作为上下文一起发送,所以解释里会点名你自己的表和列。
- **数据画像摘要**:把 profiler 的逐列统计写成文字说明。该上下文包含每列的 `min` 和 `max`,也就是你数据里的真实值;见 [Agent 数据流](docs/AGENT_DATA_FLOW.md)。
### 专业数据管理
- **通用数据网格**:虚拟化渲染(TanStack),可承载百万行。
- **行内编辑**:双击即可直接在网格里改值,仅在 SQL 支持单表行更新的引擎上出现(其他引擎上该控件会被隐藏)。
- **列过滤**:在查询结果上按列做文本过滤,用于即时探索数据。
- **交互式透视表**:客户端透视,5 种聚合函数(COUNT、SUM、AVG、MIN、MAX),并可生成 SQL。
- **专家级导出**:即时导出 CSV 和 JSON 用于出报表。CSV 导入和结果导出都提供逗号(默认)、分号和制表符分隔符。导出菜单里每一种能写成文件的格式,也都能直接复制到剪贴板。
### 高级数据可视化
- **8 种图表**:柱状图、折线图、饼图、面积图、散点图、直方图、堆叠柱状图和堆叠面积图,由 Recharts 驱动。
- **数据聚合**:按 SUM、AVG、COUNT、MIN、MAX 聚合函数分组。日期可按小时、天、周、月或年分组。
- **图表持久化**:保存图表配置并随时重新载入。管理一个已保存图表的库。
- **图表看板**:以网格视图展示所有已保存的图表,在底部面板里一眼总览数据。
### 显示脱敏(预览)
- **客户端显示层**:在浏览器界面里遮蔽敏感值,适用于屏幕共享、演示,以及减少屏幕上意外泄露。**不是服务端强制**;查询 API 的响应里,已认证用户拿到的仍然是完整值。
- **列名模式匹配**:10 个内置模式(邮箱、电话、信用卡、SSN、密码、IP、日期、财务信息等)按正则匹配**结果列的表头**。当输出名本身匹配时生效(例如 `SELECT salary`)。别名(`salary AS x`)和聚合(`SUM(salary)`)目前不会被脱敏。
- **可配置规则**:管理员面板可以新增、编辑、启用/停用脱敏模式。邮箱、电话、信用卡和 SSN 预设会预填“新增模式”表单,方便在保存前调整列模式。自定义模式支持正则。设置按浏览器存放在 localStorage 里。
- **RBAC 界面控制**:user 角色在界面上不能切换或揭示被遮蔽的单元格。admin 角色可以切换脱敏,并临时揭示单个单元格(10 秒后自动隐藏)。
- **导出与剪贴板**:CSV、JSON 和 SQL INSERT 导出,无论存成文件还是复制到剪贴板,在界面里脱敏生效时都会使用遮蔽后的显示值。这并不能阻止通过 API、浏览器 DevTools 或管理员揭示来获取原始数据。
- **界面覆盖范围**:网格、移动端的卡片/表格视图、行详情面板和剪贴板复制,都会遵循当前生效的显示脱敏。
### 分析师与开发者工具
- **AI 数据画像**:一键为表做画像,给出列统计(空值率、基数、最大最小值、样本值)和 AI 驱动的叙述式总结。
- **ORM 代码生成器**:从实时表 schema 生成 TypeScript interface、Zod schema、Prisma model、Go struct、Python dataclass 和 Java POJO。
- **测试数据生成器**:感知 schema 的假数据生成,带 30+ 种语义列推断(邮箱、电话、姓名、地址等)。输出 INSERT 语句或 MongoDB insertMany JSON。
- **数据库文档**:从实时 schema 自动生成可搜索的数据字典,带 AI 驱动的文档说明,并支持 Markdown 导出。
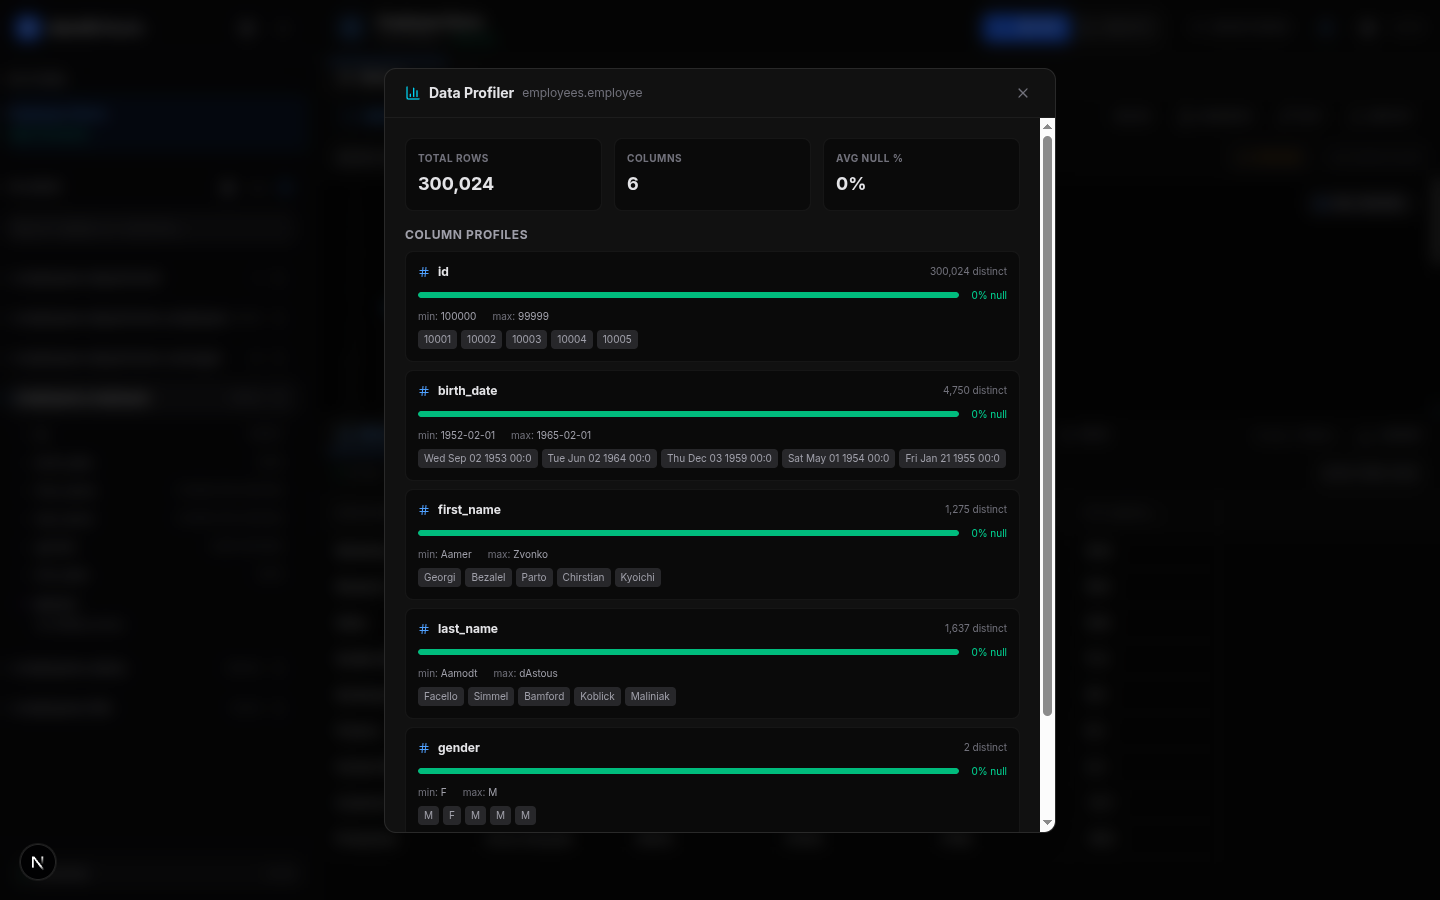
一键列画像:30 万行以上数据的空值率、基数、最大最小值和样本值。
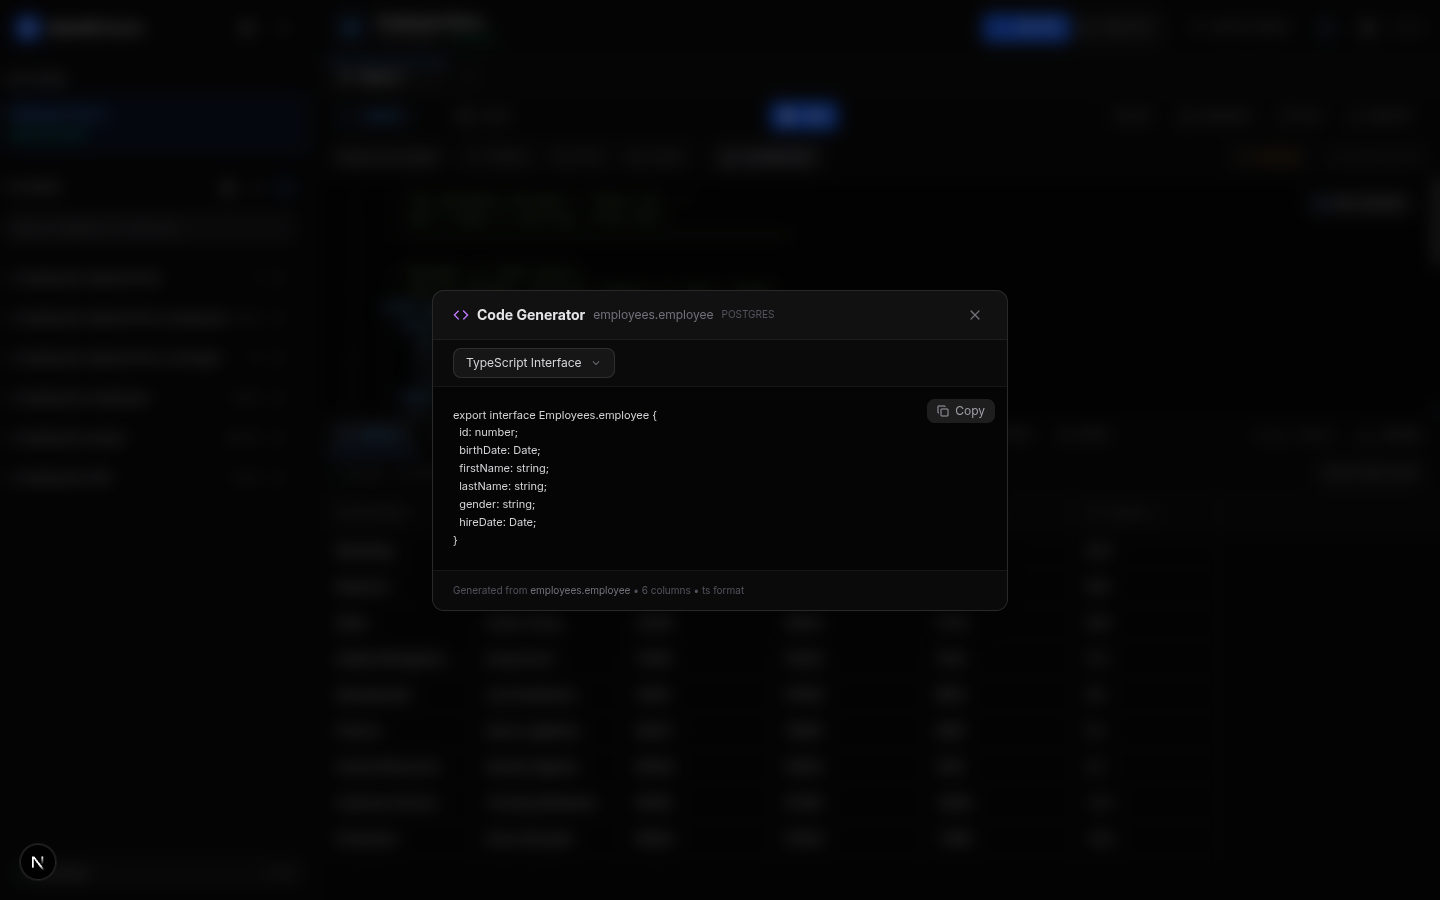
从实时 schema 生成 TypeScript interface、Prisma model、Go struct 等。
### 认证与 SSO
- **两种认证模式**:本地邮箱/密码登录,或 OpenID Connect(OIDC)单点登录,通过环境变量切换。
- **不绑定厂商的 OIDC**:适用于任何符合 OIDC 规范的提供方,包括 Auth0、Keycloak、Okta、Azure AD、Zitadel、Google 等。
- **一条命令的 SSO 演示**:`docker compose -f docker-compose.oidc-demo.yml up` 会启动一个预配置好 Keycloak 的 Studio,让你在本地试用 SSO 和角色映射([操作步骤](docs/OIDC.md#try-it-locally-with-keycloak))。
- **PKCE 安全**:Authorization Code Flow 配合 Proof Key for Code Exchange(S256),保证认证安全。
- **自动角色映射**:可配置的、基于 claim 的角色映射,用点号表示嵌套 claim(例如 `realm_access.roles`)。
- **提供方登出**:登出会同时清除本地 JWT 会话和身份提供方的会话。
### DBA 运维工具(仅管理员)
- **实时监控面板**:7 个标签页的监控,包括概览、性能、查询、会话、表、存储和连接池视图。
- **时序趋势图**:实时指标趋势(连接数、缓存命中率、缓冲池、死锁),带自动刷新的环形缓冲区历史。
- **可配置自动刷新**:轮询间隔从 5 秒到 60 秒,带播放/暂停控制。
- **阈值告警**:缓存命中率、连接使用率、死锁和缓冲池利用率都带按颜色区分的健康指示(健康/警告/严重)。
- **连接池统计**:实时的总数/活跃/空闲/等待连接池指标,带利用率进度条。
- **一键维护**:按数据库引擎触发 `VACUUM`、`ANALYZE`、`REINDEX`、`UPDATE STATISTICS`、`DBCC CHECKDB` 和 `ALTER INDEX REBUILD`。
- **审计日志**:全组织执行过的每一条查询的完整历史。管理员审计标签页可以把已加载的操作和查询历史导出为 CSV 或 JSON,并遵循当前过滤条件。
## 支持的数据库
| 数据库 | 驱动 | 功能 |
| :--- | :--- | :--- |
| **PostgreSQL** | `pg` | 完整 SQL IDE、EXPLAIN 计划、事务、查询取消(`pg_cancel_backend`) |
| **MySQL** | `mysql2` | 完整 SQL IDE、EXPLAIN 计划、事务、查询取消(`KILL QUERY`) |
| **Oracle** | `oracledb`(Thin 模式) | 完整 SQL IDE、`FETCH FIRST N ROWS` 分页、`V$` 监控视图、`ANALYZE TABLE`、`ALTER INDEX REBUILD`、事务 |
| **SQL Server** | `mssql`(tedious) | 完整 SQL IDE、`TOP N` / `OFFSET FETCH` 分页、`sys.dm_*` DMV、`UPDATE STATISTICS`、`DBCC CHECKDB`、事务、自动识别 Azure SQL |
| **SQLite** | `bun:sqlite` / `node:sqlite`(运行时自选) | 完整 SQL IDE,文件型或内存型数据库(文件在服务端本地) |
| **libSQL** | 无驱动,纯 HTTP(Hrana 协议,`POST /v2/pipeline`,8080 端口) | 针对 libSQL 服务器或 Turso Cloud 的完整 SQL IDE,也就是上一行那种 SQLite 方言,只是隔着网络访问而不是读磁盘。`EXPLAIN QUERY PLAN`、`sqlite_master` 与 `pragma_*` 自省,以及 `dbstat` 给出的真实单表字节数,这些是上一行那个文件型驱动读不到的。凭据是 auth token 而不是密码。维护操作只有两个,`REINDEX` 和 `PRAGMA integrity_check`:服务端会直接拒绝 `VACUUM`、`ANALYZE`、`PRAGMA optimize` 和 `PRAGMA wal_checkpoint`,所以不为它们提供任何控件 |
| **DuckDB** | `@duckdb/node-api`(原生 N-API 插件,约 68 MB 平台绑定) | 针对本地 DuckDB 文件或 `:memory:` 的完整 SQL IDE,运行在应用所在的服务器上。`EXPLAIN (FORMAT JSON)` 物理计划树、`duckdb_*` 目录自省、来自 `pragma_storage_info` 块分配的真实单表字节数,以及通过驱动自身 `interrupt()` 实现的查询取消。三项维护操作,`VACUUM`、`ANALYZE` 和 `CHECKPOINT`:这里 `REINDEX` 是解析错误,`PRAGMA integrity_check` 与 `PRAGMA optimize` 都不存在,所以不为它们提供任何控件。没有慢查询日志,也没有会话列表:DuckDB 两者都不发布,所以这两个面板会如实说明,而不是显示 0。这个文件只允许一个操作系统进程打开,只读模式下同样被拒绝,因此第二个 Studio 实例无法打开本实例已持有的数据库 |
| **MongoDB** | `mongodb` | JSON 查询编辑器,集合操作(find、aggregate、insert、update、delete) |
| **Couchbase** | 无驱动,纯 HTTP(Query + 管理 REST) | 完整 SQL++ IDE、EXPLAIN 计划、bucket/scope/collection 浏览器、`INFER` 列推断、读己之写一致性、`UPDATE STATISTICS` / `BUILD INDEX` / 请求终止 |
| **ClickHouse** | 无驱动,纯 HTTP(SQL 接口,8123 端口) | 完整 SQL IDE、JSON EXPLAIN 计划树、系统表 schema 自省、`OPTIMIZE TABLE` / 表统计 / 查询终止等维护操作 |
| **Apache Druid** | 无驱动,纯 HTTP(`POST /druid/v2/sql`,Router 端口 8888 或 Broker 8082) | 只读 SQL IDE、原生查询 EXPLAIN 计划树、`INFORMATION_SCHEMA` 数据源自省、`sys.*` 监控(segment、server、摄取任务)。Druid SQL 没有 `UPDATE`、没有 `DELETE`、也没有 `CREATE TABLE`,它能做的事没有一件算维护操作:数据源靠摄取变化,而不是从编辑器改 |
| **Elasticsearch** | 无驱动,纯 HTTP(`POST /_sql?format=json`,9200 端口) | 只读 SQL IDE、基于 mapping 的索引/字段浏览器、集群健康,以及每个索引的文档数和存储大小。没有 EXPLAIN、没有维护操作、没有慢查询或会话面板:它们存在于日志文件和统计 API 里,SQL 这层接口够不到。Elasticsearch SQL 也没有 `OFFSET`,所以无法请求第二页结果,只能收窄语句或调高上限 |
| **OpenSearch** | 无驱动,纯 HTTP(`POST /_plugins/_sql`,9200 端口) | 与 Elasticsearch 同一个 provider 模块,同样的只读 SQL IDE 与浏览器。这里 `LIMIT n OFFSET m` 确实可用,所以分页也可用 |
| **Apache Trino** | 无驱动,纯 HTTP(客户端协议,`POST /v1/statement`,8080 端口) | 面向全部已配置 catalog 的完整 SQL IDE、`EXPLAIN (FORMAT JSON)` 计划树、连接所固定 catalog 的 `information_schema` schema 树、`system.runtime` + `jmx` 监控、`SHOW STATS` 给出的真实行数、查询取消与 `kill_query` 维护。Trino 是查询引擎,不存储任何东西,因此在任何地方都不声明主键、外键和索引:ER 图只画方框不画连线,行内编辑被关闭,容量面板列出的是 catalog 而不是臆造的占用量。失败的语句会以 HTTP 200 返回,而且即使在关闭了认证的集群上,明文 HTTP 上的密码也会被拒绝 |
| **Apache Cassandra** | `cassandra-driver`(纯 JavaScript,无原生模块) | 基于原生协议(9042 端口)的 CQL IDE、标注分区键与聚簇键的 keyspace 浏览器、`system_views` 概览、运行时长与正在执行的语句。没有 EXPLAIN(CQL 里没有这个关键字)、没有取消(协议里没有)、没有维护(每个操作都是 `nodetool` 动作),而且**不显示任何行数与容量**:Cassandra 发布的唯一数字只有来自已刷盘文件的分区估算和整数 mebibyte,所以两者宁可不显示,也不显示错的 |
| **Redis** | `ioredis` | 命令编辑器、键浏览器、基于 INFO 的监控 |
> **另有二十六种引擎没有自己的驱动。** 上面十六种是这个构建自带的驱动。另有二十六种引擎使用其中某一种线协议,通过已有驱动原样接入,所以十六个驱动一共覆盖四十二个具名引擎。它们是 MariaDB、Percona Server for MySQL、TiDB、Vitess、StarRocks、Apache Doris、OceanBase、SingleStore、Databend、Citus、Percona Distribution for PostgreSQL、ParadeDB、OrioleDB、TimescaleDB、YugabyteDB、AlloyDB Omni、Apache Cloudberry(孵化中)、CockroachDB、Materialize 和 RisingWave(按 PostgreSQL 或 MySQL 接入),Valkey、DragonflyDB、KeyDB 和 Garnet(按 Redis 接入),FerretDB(按 MongoDB 接入),以及 ScyllaDB(按 Cassandra 接入)。每一种都对着一个真实实例测过,而产品能用的部分因引擎而异。MariaDB、两个 Percona 发行版、TiDB、Vitess、AlloyDB Omni、Citus、TimescaleDB、YugabyteDB、ParadeDB、OrioleDB、Valkey、DragonflyDB、KeyDB 和 FerretDB 的表现与它们所借驱动自身的引擎一致,不过其中三种会报告不该信任的统计值:Citus 的分布式表和 TimescaleDB 的 hypertable 报告的行数与容量是错的而不是缺的,YugabyteDB 则在你跑 `ANALYZE` 之前一直报 0。Vitess 不属于那三种,它的行数与容量精确到字节,但在那里无法取消正在运行的查询:vtgate 拒绝 `KILL QUERY`,语句会一直跑到结束。AlloyDB Omni 也不属于那三种,2000 行就报 2000 行、270336 字节就报 270336 字节,但那里有两件事出人意料:`version()` 在任何地方都不提 AlloyDB,所以版本面板与一个原生 PostgreSQL 17 无法区分;而 AlloyDB 自己的八个 `google_ml` 表会出现在对象浏览器里,任何能连上的角色也都能读它们。StarRocks 自称 MySQL 5.1,并失去了概览、健康和会话面板,它的监控面板只渲染出六个,其中会话面板带着引擎自己的拒绝理由;Apache Doris 是 StarRocks 所 fork 的引擎,只失去概览和健康面板,原因是一种它的文法拒绝的语句形式,而在真正要紧的地方它比 StarRocks 更可信:一张确实有那么多数据的表,它报 2000 行和 10187 字节,而 StarRocks 起初也读作零(它自己的后台统计收集器更慢,实测 4.5 分钟对 3.3.22,而 Doris 大约一分钟),并且在 2026-09-16 的一次修复之前,单就容量而言此后会永远读作零,因为 StarRocks 的 `INDEX_LENGTH` 是 NULL 而不是 Doris 那样的真实 0,把 provider 在 SQL 里算的那个和值毒化了;索引从不被报告,外键会被接受、被 `SHOW CONSTRAINTS` 列出、对 ER 图不可见且不被强制执行;Cloudberry 失去监控面板及其表和索引统计,三者都源于同一条 MPP 计划器限制,并且会把外键读成似乎被强制执行的样子,实际并没有,尽管它的行数是正确的;CockroachDB 失去对象浏览器和容量面板;OceanBase 能应答十五个界面中的十四个,但只有十二个有用,健康面板直接失败,因为它的租户根本没有 `performance_schema` 库,而每一处容量都读作 0 B,不过一旦跑过 `ANALYZE TABLE`,它的行数就是正确的;SingleStore 失去五个界面,原因在我们这边而不在它那边,provider 把每条语句都走预处理语句协议,而 SingleStore 对四个面板所需的 `SHOW` 和 `EXPLAIN` 语句拒绝该协议,这五个里现在已有四个恢复,未恢复的是它的 Explain 面板,因为那里的文法要 `EXPLAIN JSON`,而该语句在两种协议下都失败;它的数字仍然是缺的而不是错的,一张 2000 行的表读作 0 行和 0 B,且任何 `ANALYZE` 都改不了;ScyllaDB 失去五个界面,连 Test Connection 一起,六个全都源于同一个缺失的 keyspace,概览、健康、性能指标、活动会话和监控面板都读 Cassandra 的 `system_views` 虚拟表,而 ScyllaDB 根本没有 `system_views` keyspace,这五个现在降级为空而不是抛错,于是 Test Connection 能通过、对话框能保存连接,而在那次改动之前它完全做不到,同时编辑器与对象浏览器完好可用,18 种 CQL 类型每一种读回来的字节都与同一轮里探测的 Cassandra 5.0.9 一致;ParadeDB 和 OrioleDB 都是完整的,代价却正好相反:ParadeDB 的九个扩展为 2 张用户表在对象浏览器里放进 41 个对象,并让全新安装上的 Agent Plan 模式失效,而 OrioleDB 的浏览器很干净,但它自己的存储对 PostgreSQL 的容量函数不可见,所以每个索引都读作 0 字节,缓存命中率读作 N/A。Materialize、RisingWave 和 Databend 只有查询编辑器可用,其中 Databend 是三者里直接问它时 catalog 应答得很好的那一个,对象浏览器为空是因为我们的参数化读取用的是它没有实现的预处理协议。Garnet 的表现与 Redis 一致,并且是这里三个近亲之一(另外两个是 Valkey 和 DragonflyDB),它们的 `INFO` 里会在 Redis 兼容级别旁边带上自己的版本,概览现在把后者标在前面,即 `Garnet 2.1.5 (Redis 7.4.3)`,而它有两处读数是以数值面目出现的空缺:每处容量都显示 0 B,因为它不发布 `used_memory`,缓存命中率显示 100%,因为它不发布 keyspace 计数器。每个引擎的细节,连同探测所用的确切版本,都在 [`docs/providers/README.md`](docs/providers/README.md#wire-compatible-engines) 里:我们只有在连上某个引擎之后才会写出它的名字,所以那里没有的名字是尚未测试,而不是不受支持。
> **传输层安全是横跨各引擎的能力,而不是逐引擎的。** SSH 隧道在 provider 建连之前就已建立,连接会被改写到本地端点,因此与具体引擎无关:只要连接配置了 host 和 port 就适用。改用连接串填写的连接(MongoDB、Couchbase、ClickHouse 和 libSQL 支持这种方式)没有 host/port,因此不会走隧道;SQLite 和 DuckDB 同样两者都没有。SSL/TLS 面板在每个会显示它的引擎上都生效,也就是除 SQLite、DuckDB 和嵌入式 LibreDB 这三个文件型引擎之外的全部引擎:它们没有需要保护的传输通道,因此不提供这个面板。在 Trino 上它不是可选项,而是关键一环,因为 coordinator 会拒绝明文 HTTP 上的密码。Oracle 是唯一一个映射需要提前说明的引擎:它的 Thin 驱动始终校验证书链,所以当服务器证书是自签名时,`require` 需要一并提供该服务器的 CA;而整段粘贴的连接串会保留它自己声明的协议。
> 所有 SQL 数据库共有:schema 浏览器、ER 图、schema 对比与迁移、显示脱敏(预览)、监控面板和连接串导入。Druid、Elasticsearch、OpenSearch 和 Trino 每一个都是双重例外:它们的 HTTP SQL API 没有本构建能解析的 URI 约定,所以只能按 host 和 port 配置;而生成的迁移会说明该限制,而不是对一个 SQL 里根本没有列变更语句的引擎输出列变更 DDL,对 Couchbase 的无 schema 集合也是如此。搜索集群上的 ER 图只画方框不画连线:索引不声明外键,引擎的模型里也没有外键可声明,provider 会以 `declaresForeignKeys: false` 说明这一点,而不是留给空列表去猜。
> **Provider 参考文档:** 每个数据库都有一份深入参考(设计、连接、查询格式、监控、限制),位于 [`docs/providers/`](docs/providers/README.md)。provider 架构见 [`docs/DATABASE_PROVIDERS.md`](docs/DATABASE_PROVIDERS.md),新增数据库见 [`docs/ADDING_A_PROVIDER.md`](docs/ADDING_A_PROVIDER.md)。
## 技术栈
| 组件 | 技术 | 目标平台 |
| :--- | :--- | :--- |
| **框架** | Next.js 16(App Router)、React 19 | Web、移动端 |
| **UI 引擎** | Tailwind CSS 4、Radix UI、[shadcn/ui](https://ui.shadcn.com/) | Web、移动端 |
| **主题** | CSS 变量 + `@theme inline`([指南](docs/ui/theming.md)) | Web、移动端 |
| **编辑器** | Monaco Editor(VS Code 内核) | Web |
| **AI** | 多模型(Gemini、OpenAI、Ollama、自定义) | Web、移动端 |
| **认证** | JWT(`jose`)+ OIDC(`openid-client`)、PKCE、角色映射 | Web、移动端 |
| **数据库** | PostgreSQL、MySQL、Oracle、SQL Server、SQLite、libSQL、DuckDB、MongoDB、Couchbase、ClickHouse、Apache Druid、Elasticsearch、OpenSearch、Apache Trino、Apache Cassandra、Redis | Web、移动端 |
| **图表** | Recharts(柱状图、折线图、饼图、面积图、散点图、直方图、堆叠图) | Web、移动端 |
| **ERD** | React Flow、ELK.js(自动布局) | Web |
| **状态与表格** | TanStack Table 与 Virtual | Web、移动端 |
| **部署** | Docker、Kubernetes | Web |
## 安装方式
### 安装
| 安装渠道 | 命令 | 说明 |
| :--- | :--- | :--- |
| **Docker** | `docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest` | 零配置:首次启动时管理员密码会打印到日志 |
| **Helm(Kubernetes)** | `helm install libredb oci://ghcr.io/libredb/charts/libredb-studio` | 零配置:首次启动的管理员凭据会打印到 Pod 日志 |
| **npx** | `npx @libredb/studio` | 支持 Linux/macOS/Windows,需要 Node 24+(24 LTS 是参考运行时);会下载 release 中的服务端归档 |
| **Homebrew** | `brew trust libredb/tap && brew install libredb/tap/libredb-studio` | 需要执行一次 `brew trust`(Homebrew 6+;若提示未知命令,先 `brew update`) |
| **deb / rpm** | `sudo dpkg -i libredb-studio__amd64.deb` | 随每个 GitHub release 附带;内含 systemd 服务 |
| **Snap** | `sudo snap install libredb-studio` | 零配置:首次运行时管理员密码会打印到 `sudo snap logs libredb-studio`([Snap Store 页面](https://snapcraft.io/libredb-studio)) |
| **winget(Windows)** | `winget install LibreDB.Studio` | 自带 Node.js 运行时的免安装 zip;执行 `libredb-studio` 启动([已收录在 winget 社区仓库](https://github.com/microsoft/winget-pkgs/tree/master/manifests/l/LibreDB/Studio)) |
| **Chocolatey(Windows)** | `choco install libredb-studio` | 同一个独立 zip 包,[已收录在 Chocolatey 社区仓库](https://community.chocolatey.org/packages/libredb-studio);首次提交(0.9.59)于 2026-08-24 通过审核,此后每个 release 都会自动发布([#114](https://github.com/libredb/libredb-studio/issues/114)) |
| **免安装 zip(Windows)** | `.\libredb-studio.exe` | 从 [GitHub Releases](https://github.com/libredb/libredb-studio/releases) 下载;自带 Node 运行时,无需任何包管理器 |
| **桌面应用(Linux,AppImage)** | `chmod +x libredb-studio-desktop--linux-x64.AppImage && ./libredb-studio-desktop--linux-x64.AppImage` | 原生窗口,不开浏览器标签页、不弹登录页;服务端作为本地 sidecar 运行。想要沙箱化构建,请用下面的 Flatpak 一行([#232](https://github.com/libredb/libredb-studio/issues/232)) |
| **桌面应用(Debian/Ubuntu)** | `sudo apt install ./libredb-studio-desktop-_amd64.deb` | 同一个桌面应用,装进菜单;不依赖 FUSE,WebKitGTK 取自发行版。注意这不是服务端软件包,服务端是 `libredb-studio__.deb` |
| **桌面应用(Flatpak)** | `flatpak --user remote-add --if-not-exists flatpark https://dl.flatpark.org/flatpark.flatpakrepo`
`flatpak --user install flatpark org.libredb.Studio` | 来自 [FlatPark](https://flatpark.org/) 远程仓库的沙箱化桌面应用,完全没有文件系统访问权限;数据库通过 TCP 访问。开发者认可的收录([#241](https://github.com/libredb/libredb-studio/issues/241)) |
> Homebrew、deb/rpm、Snap、Windows 免安装 zip、winget/Chocolatey、桌面版 AppImage 与 Debian 包,以及 npx 启动器,使用的都是随每个 GitHub release 附带的独立产物。各渠道的完整指南(命令、配置、systemd 用法以及 Docker 镜像的 tag 模型)见 [`docs/DISTRIBUTION.md`](docs/DISTRIBUTION.md)。渠道覆盖记分卡(按平台和类别列出已上线/待完成)见 [`docs/CHANNELS.md`](docs/CHANNELS.md)。
### 快速开始(Docker)
一条命令跑起 LibreDB Studio,不用克隆,不用安装,不用构建:
```bash
docker run \
--name libredb-studio \
-p 3000:3000 \
-e ADMIN_EMAIL=admin@libredb.org \
ghcr.io/libredb/libredb-studio:latest
```
> **镜像仓库**:`ghcr.io/libredb/libredb-studio` 是主镜像(没有拉取速率限制,Kubernetes/CI 场景优先用它)。同一个镜像也同步到了 Docker Hub 的 [`libredb/libredb-studio`](https://hub.docker.com/r/libredb/libredb-studio?tag=latest),方便使用。
> **镜像变体**:每个 tag 同时提供 Alpine 版本。`:latest-alpine` 是同一产品跑在 musl 基础镜像上,操作系统攻击面小得多;`:latest-alpine-slim` 更小,代价是去掉 DuckDB 驱动。默认 tag 仍是 Debian,也是唯一能叠加 Oracle Thick 模式的版本,表格见 [`docs/DISTRIBUTION.md`](docs/DISTRIBUTION.md#image-tag-model)。
> **IPv6**:容器在启动时自己选择绑定地址,并优先用 `::`,一个 socket 同时服务 IPv4 和 IPv6,所以纯 IPv6 主机不需要任何额外参数。若命名空间里没有可用的 IPv6,它会退回 `0.0.0.0`,并把选择结果写进日志。加 `-e HOSTNAME=0.0.0.0` 可固定为 IPv4;细节以及 Kubernetes 下的对应做法见 [`docs/DISTRIBUTION.md`](docs/DISTRIBUTION.md#network-exposure-bind-address)。
打开 [http://localhost:3000](http://localhost:3000)。上面的命令没有设置密码,所以首次启动会生成一个并打印到容器日志里,用 `docker logs libredb-studio` 查看;以 `admin@libredb.org` 和它打印的密码登录,或者自己设置 `ADMIN_PASSWORD`。
> **认证环境变量(local provider):** 只有 `AUTH_BOOTSTRAP=off` 时,`ADMIN_PASSWORD` 和 `JWT_SECRET` 才是必填的;否则两者都在首次启动时生成(见下文[零配置首次启动](#零配置首次启动))。`USER_EMAIL` / `USER_PASSWORD` 可选;不填就只跑管理员账号(永远不会假定一个默认的用户密码)。`ADMIN_EMAIL` 默认为 `admin@libredb.org`。用 OIDC(`NEXT_PUBLIC_AUTH_PROVIDER=oidc`)?这些都不需要。
> **提示**:加上 `-e LLM_PROVIDER=gemini -e LLM_API_KEY=your_key -e LLM_MODEL=gemini-2.5-flash` 即可启用 AI 功能。
### 零配置首次启动
不设置 `JWT_SECRET` / `ADMIN_PASSWORD` 也能直接启动:
缺失的值会在首次启动时生成,存放在 `<数据目录>/auth-bootstrap.json`
(文件权限 0600),管理员密码只打印一次到服务端日志。显式设置的环境变量
始终优先。设置 `AUTH_BOOTSTRAP=off` 可以改为要求显式配置(生产部署推荐这样做)。
自己设置的 `JWT_SECRET` 必须至少 32 个字符。更短的值会在启动时报硬错误:
服务端会打印出问题所在并以退出码 1 退出,而不是启动到一个健康检查报正常、
但每次登录都返回 503 的状态。想让它自动生成强密钥,就不要设置这个变量。
### Linux 软件包(.deb / .rpm)
面向 Debian/Ubuntu 和 RHEL/Fedora 的原生软件包(amd64 与 arm64)随每个
[GitHub release](https://github.com/libredb/libredb-studio/releases) 附带。它们把独立服务端
与一个私有 Node.js 运行时打包在一起(无需再装其他东西),并注册 systemd 服务:
```bash
# Debian / Ubuntu
sudo dpkg -i libredb-studio__amd64.deb
# RHEL / Fedora / Rocky
sudo rpm -i libredb-studio-.x86_64.rpm
# 启动服务(首次运行会把生成的管理员密码打印到 journal)
sudo systemctl enable --now libredb-studio
journalctl -u libredb-studio
```
配置放在 `/etc/libredb-studio/env`(由 unit 加载;那里装有一份带注释的模板),
状态(SQLite 存储与生成的凭据)放在 `/var/lib/libredb-studio`。
`libredb-studio` 命令也可以不经过 systemd 直接运行。这里以及所有其他渠道的完整说明:
[`docs/DISTRIBUTION.md`](docs/DISTRIBUTION.md)。
### 前置条件
- [Bun](https://bun.sh/)(推荐)或 Node.js 24+
- 一个可查询的目标数据库(PostgreSQL、MySQL、Oracle、SQL Server、SQLite、libSQL、DuckDB、MongoDB、Couchbase、ClickHouse、Apache Druid、Elasticsearch、OpenSearch、Apache Trino、Apache Cassandra 或 Redis)
### 快速开始(本地)
1. **克隆并安装**
```bash
git clone https://github.com/libredb/libredb-studio.git
cd libredb-studio
bun install
```
2. **配置环境**
创建 `.env.local` 文件:
```env
# 认证(邮箱 / 密码)
ADMIN_EMAIL=admin@libredb.org
USER_EMAIL=user@libredb.org
JWT_SECRET=your_32_character_random_string
# 可选:OIDC 单点登录(Auth0、Keycloak、Okta、Azure AD 等)
# NEXT_PUBLIC_AUTH_PROVIDER=oidc
# OIDC_ISSUER=https://your-provider.com
# OIDC_CLIENT_ID=your_client_id
# OIDC_CLIENT_SECRET=your_client_secret
# LLM 配置
LLM_PROVIDER=gemini # 可选:gemini、openai、ollama、custom
LLM_API_KEY=your_api_key
LLM_MODEL=gemini-2.5-flash
LLM_API_URL=http://localhost:11434/v1 # 本地 LLM(Ollama)可选
```
3. **启动**
```bash
bun dev
```
打开 [http://localhost:3000](http://localhost:3000)
### 中国大陆网络下的拉取加速
在部分国内网络下,从 GHCR 拉取镜像会很慢或超时。镜像只有一份,`ghcr.io/libredb/libredb-studio`,下面只是换一个拉取域名:
```bash
# 南京大学镜像:把 ghcr.io 换成 ghcr.nju.edu.cn
docker pull ghcr.nju.edu.cn/libredb/libredb-studio:latest
# DaoCloud 镜像:在完整镜像名前加 m.daocloud.io/
docker pull m.daocloud.io/ghcr.io/libredb/libredb-studio:latest
# npx / npm:使用 npmmirror 源
npx --registry=https://registry.npmmirror.com @libredb/studio
```
镜像站会变动(上海交通大学镜像已于 2026 年 6 月停止服务),以上只是当前可用的例子。拉取失败时,请到 [dongyubin/DockerHub](https://github.com/dongyubin/DockerHub) 查看仍在服务的镜像列表。
### 嵌入到你自己的应用中(`@libredb/studio`)
Studio 既作为服务端发布,也作为 npm 包发布,所以编辑器可以活在你自己的产品里:
```bash
npm i @libredb/studio
```
**在你的 Next.js 配置里沿用 Studio 的安全响应头。** `@libredb/studio/security`
子路径把响应头策略作为纯数据发布:`securityHeaders()` 返回一个普通的
`Record`,而且它所在的模块不导入任何东西,所以在还没有路径别名、
也还没有 Studio 运行时的 `next.config.ts` 里加载它是安全的:
```ts
// next.config.ts
import { securityHeaders } from "@libredb/studio/security";
export default {
async headers() {
return [
{
source: "/:path*",
headers: Object.entries(securityHeaders()).map(([key, value]) => ({ key, value })),
},
];
},
};
```
选项:`reportOnly` 改为输出 `Content-Security-Policy-Report-Only` 而不是强制执行的响应头;
`hsts: false` 关闭 HSTS(也可以传一个对象来定制);`allowEval` 加入 `'unsafe-eval'`,
React 的*开发*构建需要它;`monacoVsPath` 在 Monaco 的 bundle 不是同源时补上提供它的
来源;`extra` 按指令合并你自己的来源。`studioCspDirectives()` 和
`HSTS_MAX_AGE_SECONDS` 也有导出,供需要组合策略而不是直接发送它的配置使用。
继承之前先读一读这份策略:CSP 允许内联脚本,因为每个文档路由都是静态预渲染的,
带的是没有 nonce 的水合脚本,所以它约束的是注入的脚本能把数据*发往*哪里,
而不是脚本能不能运行。这一权衡,以及 Next.js 应用交付这些响应头的两条路径,
在 [`docs/SECURITY.md`](docs/SECURITY.md) 里有论证。
## 关于收费的那条线
Studio 是 MIT,因为它必须能去任何地方。付费的是 libredb-platform,它卖的是“别人替你运维”:托管、多租户、计费和支持,而不是某个被挪到付费墙后面的功能。
**没有任何能力为了制造升级理由而被移到这条线的另一边。** 单点登录、RBAC、查询审计、ER 图、AI 功能、全部 NoSQL 引擎,都在 MIT 构建里。
## 开发用数据库
需要数据库来测试?我们为所有支持的引擎提供了开箱即用的容器:
```bash
# 启动所有默认 profile 的数据库(PostgreSQL、MySQL、MongoDB、SQL Server、Oracle 等)
docker compose -f database-compose.yml up -d
# 或者只启动某一个数据库
docker compose -f database-compose.yml up -d postgres
docker compose -f database-compose.yml up -d mssql
docker compose -f database-compose.yml up -d oracle
# Apache Druid 由 profile 控制,所以裸跑 `up -d` 不会启动它。Druid 是分布式系统,
# 没有单容器模式:五个 Druid 进程加 ZooKeeper 再加它自己的元数据库,是能回答
# 一条 SQL 查询的最小组合,所以七个服务全都带 `profiles: [druid]`,而不是把默认
# 栈的规模翻倍。连接 Router 的 8888 端口(或 Broker 的 8082,同一个入口,配置
# 没有区别)。
docker compose -f database-compose.yml --profile druid up -d
# 启动带电商示例数据的 PostgreSQL
docker compose -f docker/postgres.yml up -d
# 停止(保留数据)
docker compose -f database-compose.yml down
# 停止并删除所有数据
docker compose -f database-compose.yml down -v
# Druid 的容器在这里也需要 profile 参数:不加的话 `down` 会把它们留在运行中
docker compose -f database-compose.yml --profile druid down -v
```
### 连接信息
| 数据库 | 主机 | 端口 | 用户 | 密码 | 数据库/服务 |
|----------|------|------|------|----------|-----------------|
| **PostgreSQL** | localhost | 5432 | postgres | postgres | postgres |
| **MySQL** | localhost | 3306 | root | root | mysql |
| **SQL Server** | localhost | 1433 | sa | Password123! | master |
| **Oracle** | localhost | 1521 | system | Password123! | freepdb1 |
| **MongoDB** | localhost | 27017 | admin | admin | 无 |
| **Apache Druid** | localhost | 8888(Router)或 8082(Broker) | 无 | 无 | 无(只有一个 catalog,始终是 `druid`) |
| **Apache Trino** | localhost | 8080 | 无 | 无 | `tpch`(是一个 *catalog*;`tpcds`、`memory`、`system` 和 `jmx` 也已配置) |
### PostgreSQL 示例数据
`docker/postgres.yml` 这套配置包含一个预置的电商 schema:
| 特性 | 说明 |
|---------|-------------|
| **PostgreSQL 18** | 带 `pg_stat_statements` 的官方镜像 |
| **pg_stat_statements** | 已预先启用,用于查询监控 |
| **示例 schema** | 电商数据库(app schema) |
| **示例数据** | 25 个客户、30 个商品、100 笔订单 |
| **视图** | 订单汇总、商品销售、客户 LTV |
示例表:`app.customers`、`app.products`、`app.orders`、`app.order_items`、`app.product_reviews`、`app.categories`、`app.coupons`、`app.audit_log`
> 这套配置非常适合用真实的 `pg_stat_statements` 数据测试**监控面板**功能。
## 测试
LibreDB Studio 有一套完整的测试:549 个测试文件、17,692 个测试,覆盖七个层次,另有 79 个浏览器测试,并由 CI 强制要求 **100% 行覆盖率**(`bun run coverage:check`)。
### 常用命令
```bash
# 所有测试文件,每个都跑在自己的 bun 进程里
bun run test
# 按层次运行
bun run test:unit # 纯函数测试(328 个文件)
bun run test:api # API 路由处理函数测试(35 个文件)
bun run test:integration # 数据库 provider 测试(24 个文件)
bun run test:hooks # React hook 测试(21 个文件)
bun run test:security # 安全态势测试(21 个文件)
bun run test:evals # LLM 提示词评估测试(13 个文件)
bun run test:components # 组件测试(107 个文件:tests/components 与 tests/isolated)
# 任意子集,以及查看 runner 会跑什么
bun tests/run-tests.ts tests/integration/db/duckdb-provider.test.ts
bun tests/run-tests.ts --list
bun tests/run-tests.ts --jobs=4 # 限制并发数
# E2E 测试(需要先构建)
bun run test:e2e # Playwright 浏览器测试(79 个用例,覆盖 chromium 与 webkit)
# 覆盖率报告(lcov)
bun run test:coverage
```
### 测试架构
| 层次 | 目录 | 文件数 | 测试数 | 覆盖内容 |
|-------|-----------|-------|-------|----------------|
| **Unit** | `tests/unit/` | 328 | 9,645 | 纯函数:SQL 解析器、连接串、数据脱敏、查询限流、schema 对比、错误类、数据库图标、showcase 查询,以及打包与 chart 清单 |
| **API** | `tests/api/` | 35 | 602 | 路由处理函数:认证、查询、事务、维护、AI 端点、中间件 |
| **Integration** | `tests/integration/` | 24 | 2,768 | 数据库 provider:PG、MySQL、SQLite、MongoDB、Couchbase、Redis、Oracle、MSSQL、ClickHouse、Druid、Elasticsearch、OpenSearch、Trino |
| **Hooks** | `tests/hooks/` | 21 | 566 | React hook:认证、连接、标签页、查询执行、事务、行内编辑、监控 |
| **Security** | `tests/security/` | 21 | 322 | `docs/SECURITY.md` 所声称的安全态势:路由暴露、响应头、审计通道、凭据处理 |
| **Evals** | `tests/evals/` | 13 | 198 | LLM 提示词行为,对照录制好的模型 |
| **Components** | `tests/components/`、`tests/isolated/` | 107 | 3,376 | 用 `happy-dom` 测试的 UI 组件:Studio、Sidebar、QueryEditor、ResultsGrid、Admin Dashboard、图表、ERD |
| **E2E** | `e2e/` | 18 | 79 | 完整浏览器流程:登录、连接、查询执行、标签页、导出、管理后台 |
「文件数」一列是 2026-09-15 用 `bun tests/run-tests.ts --list` 统计前七行、用 `playwright test --list` 统计最后一行的结果。
「测试数」一列来自当天更早的一次完整运行,覆盖的是当时仓库里的 542 个文件,所以逐层数字比上面的 17,692 略低:它们还没有算上这个分支以及从 main 合并进来的七个 `tests/unit/` 下的测试文件,也没有算上这个分支给 runner 自身测试文件新增的用例。
`e2e/` 里的第十九个 spec `base-path.spec.ts` 不在这 18 个之中:它需要自己的服务端配置,通过 `bun run test:e2e:base-path` 单独运行。
### 关键细节
- **测试 runner**:[`tests/run-tests.ts`](tests/run-tests.ts) 基于 `bun:test`。它会发现 `tests/` 下所有 `*.test.ts` 和 `*.test.tsx` 文件,`tests/live/` 除外,所以新增测试文件一落地就会被跑到;它让每个文件跑在自己的 bun 进程里,同时跑好几个(默认每 CPU 一个,用 `--jobs=N` 调整)。
- **为什么每个文件一个进程**:bun 的 `mock.module()` 是进程级且无法撤销的,而整模块 mock 是 `tests/api/` 里的标准写法,所以共享进程的文件会互相污染。在 20 核的 Linux 上用 bun 1.4.2,整套测试一次跑一个文件耗时 211 秒,一次 4 个 61 秒,一次 20 个 36 秒,测量时间是 2026-09-15,覆盖当时仓库里的 538 个文件;`docs/BACKLOG.md` D86 记着同样这三个数字和同样的口径。
- **到哪都是同一条命令**:runner 用 TypeScript 而不是 shell 写,这样告诉贡献者的命令在 Linux、macOS 和 Windows 各自的 shell 里都能用。它替掉的那些 bash 脚本做不到:其中一个用了 `mapfile`,那是 bash 4 的内建命令,macOS 的 bash 3.2 没有。
- **E2E**:Playwright 在 Chromium 上跑全套,在 WebKit 上跑 `security-headers` 这个 spec(`webkit-security`),都是针对生产构建(`bun run build && bun start`)
- **CI**:GitHub Actions 跑 lint + typecheck + build、ubuntu 上必过的 `Unit & Integration Tests` 任务(先 `bun run test:coverage` 再 `bun run coverage:check`)、windows-latest 与 macos-latest 上非必过的 `Cross-platform Tests` 任务、E2E 测试,以及 SonarCloud 分析
- **覆盖率**:`bun run test:coverage` 就是同一个 runner 加 `--coverage`,每个测试文件写一份 lcov;`scripts/merge-lcov.mjs` 把它们合并成 `coverage/lcov.info`,供门禁和 SonarCloud 使用
> **重要**:始终用 `bun run test`,不要对整个目录裸跑 `bun test`。`bun test tests/api` 会把所有文件塞进一个进程,于是一个文件的模块 mock 就成了所有文件的。要跑单个文件,把它交给 runner:`bun tests/run-tests.ts tests/api/proxy.test.ts`。
## 一键部署
在 DigitalOcean、Koyeb、Render、Railway、Sealos、CapRover 或 Dokploy 上单击一下,即可部署你自己的 LibreDB Studio 实例:
[](https://app.koyeb.com/deploy?name=libredb-studio&type=docker&image=ghcr.io%2Flibredb%2Flibredb-studio%3Alatest&instance_type=free®ions=fra&instances_min=0&autoscaling_sleep_idle_delay=3900&env%5BADMIN_EMAIL%5D=admin%40libredb.org&env%5BJWT_SECRET%5D=set_a_real_secret&env%5BLLM_API_KEY%5D=your_GEMINI_API_KEY&env%5BLLM_MODEL%5D=gemini-2.5-flash&env%5BLLM_PROVIDER%5D=gemini&env%5BNEXT_PUBLIC_AUTH_PROVIDER%5D=local&env%5BSTORAGE_PROVIDER%5D=local&ports=3000%3Bhttp%3B%2F&hc_protocol%5B3000%5D=tcp&hc_grace_period%5B3000%5D=5&hc_interval%5B3000%5D=30&hc_restart_limit%5B3000%5D=3&hc_timeout%5B3000%5D=5&hc_path%5B3000%5D=%2F&hc_method%5B3000%5D=get)
[](https://render.com/deploy?repo=https://github.com/libredb/libredb-studio)
[](https://railway.com/deploy/libredb-studio?referralCode=libredb&utm_medium=integration&utm_source=template&utm_campaign=generic)
[](https://sealos.io/products/app-store/libredb-studio)
[](https://marketplace.digitalocean.com/apps/libredb-studio)
[](https://github.com/caprover/one-click-apps/blob/master/public/v4/apps/libredb-studio.yml)
[](docs/FLY.md)
[](https://templates.dokploy.com)
> **DigitalOcean:** [Marketplace 收录页](https://marketplace.digitalocean.com/apps/libredb-studio)会创建一台预配置好的 Droplet。首次启动时会生成专属的管理员凭据;欢迎信息(MOTD)会说明在哪里能找到它们。
>
> **CapRover:** 打开你的 CapRover 面板 → **Apps → One-Click Apps/Databases**,搜索 **LibreDB Studio**,然后部署。
>
> **Koyeb:** 部署前先设置一个强 `JWT_SECRET`(至少 32 个字符,用 `openssl rand -base64 32` 生成)和各项凭据(Koyeb 无法自动生成密钥)。预填的值是刻意不可用的:那个密钥比 32 字符下限还短,所以应用会在启动时停下并说明原因,而不是用一个印在本文件里的密钥运行。按钮用的是 `STORAGE_PROVIDER=local`,连接元数据留在浏览器里,这适合 Koyeb 的临时文件系统。要让连接在重新部署后仍然存在,改成 `STORAGE_PROVIDER=postgres`,并把 `STORAGE_POSTGRES_URL` 指向 Koyeb 托管 Postgres 或 Neon 数据库。按钮也会填好 `LLM_PROVIDER`/`LLM_MODEL`/`LLM_API_KEY`,但 Agent 模式需要一份服务端持有的连接,所以在 `STORAGE_PROVIDER` 为 `sqlite` 或 `postgres` 之前,它的 Start 按钮一直是禁用的(见 [docs/AGENT.md](docs/AGENT.md#turning-it-on))。详见 [`deploy/koyeb/`](deploy/koyeb/)。
>
> **Fly.io:** 仓库里已经带了一份可用的 [`fly.toml`](fly.toml),完整步骤(应用名、volume、secrets)见 [`docs/FLY.md`](docs/FLY.md)。
>
> **Cosmos:** 在 [Cosmos](https://cosmos-cloud.io) Marketplace 里一键安装,搜索 **LibreDB Studio**。Cosmos 会自动生成密钥、准备一个持久化的 SQLite volume,并在它的 SmartShield 反向代理后面提供服务。详见 [`deploy/cosmos/`](deploy/cosmos/)。
>
> **Dokploy:** 从 [Dokploy 模板目录](https://templates.dokploy.com)一键安装,在你的 Dokploy 面板里 **Create Service → Template**,搜索 **LibreDB Studio**,然后部署。Dokploy 会自动生成 `ADMIN_PASSWORD`、`USER_PASSWORD` 和 `JWT_SECRET`,并把连接持久化在 Traefik 后面的 SQLite volume 上。详见 [`deploy/dokploy/`](deploy/dokploy/)。
### 环境变量
| 变量 | 必填 | 说明 |
|----------|----------|-------------|
| `ADMIN_EMAIL` | 否 | 管理员邮箱(默认:`admin@libredb.org`) |
| `ADMIN_PASSWORD` | 是(自动生成) | 管理员密码;除非 `AUTH_BOOTSTRAP=off`,否则首次运行时自动生成 |
| `USER_EMAIL` | 否 | 可选的普通用户账号邮箱(默认:`user@libredb.org`) |
| `USER_PASSWORD` | 否 | 可选;只有设置了这个,低权限用户账号才会存在 |
| `JWT_SECRET` | 是(自动生成) | JWT 密钥(至少 32 字符);除非 `AUTH_BOOTSTRAP=off`,否则首次运行时自动生成。更短的值是致命错误:服务端会拒绝启动,而不是提供一个每次登录都失败的部署 |
| `AUTH_BOOTSTRAP` | 否 | `off` 关闭零配置生成(严格模式;生产环境推荐) |
| `AUTH_COOKIE_SECURE` | 否 | `false` 会去掉认证 cookie 上的 `Secure` 标志;仅在浏览器通过明文 HTTP 访问应用时需要(局域网/家用服务器);入口处终止 TLS 的情况不需要 |
| `NEXT_PUBLIC_AUTH_PROVIDER` | 否 | `local`(默认)或 `oidc`(SSO) |
| `OIDC_ISSUER` | 否 | OIDC issuer URL(`oidc` 时必填) |
| `OIDC_CLIENT_ID` | 否 | OIDC client ID(`oidc` 时必填) |
| `OIDC_CLIENT_SECRET` | 否 | OIDC client secret(`oidc` 时必填) |
| `OIDC_ADMIN_ROLES` | 否 | 逗号分隔的管理员角色值(默认:`admin`) |
| `OIDC_ROLE_CLAIM` | 否 | 角色的 claim 路径(例如 `realm_access.roles`) |
| `OIDC_SCOPE` | 否 | OIDC scope(默认:`openid profile email`) |
| `LLM_PROVIDER` | 否 | AI:`gemini`、`openai`、`ollama`、`custom`(自托管、兼容 OpenAI 的端点) |
| `LLM_API_KEY` | 否 | AI 功能的 API key |
| `LLM_MODEL` | 否 | 模型名(例如 `gemini-2.5-flash`) |
| `LLM_API_URL` | 否 | `ollama` 和 `custom` 的 API URL;`custom` 必填,`ollama` 默认为 `http://localhost:11434/v1` |
| `STORAGE_PROVIDER` | 否 | 存储 provider:`local`(默认)、`sqlite` 或 `postgres` |
| `STORAGE_SQLITE_PATH` | 否 | SQLite 文件路径(例如 `/app/data/libredb-storage.db`) |
| `STORAGE_POSTGRES_URL` | 否 | PostgreSQL 连接 URL(`STORAGE_PROVIDER=postgres` 时必填) |
| `SEED_CONFIG_PATH` | 否 | 种子连接 YAML 配置的路径(见[种子连接](#种子连接预配置数据库)) |
| `SEED_CACHE_TTL_MS` | 否 | 种子配置缓存 TTL,单位毫秒(默认:`60000`) |
> **提示**:本地开发时,把 `.env.example` 复制成 `.env.local`。
## 部署(DevOps)
要部署在反向代理的子路径(例如 `/tools/libredb`)下,请带 `BASE_PATH` 构建,并遵循
[子路径部署指南](docs/SUBPATH.md)。预构建镜像使用根路径。
> 维护者须知:每个分发渠道都登记在
> [`distribution/channels.yaml`](distribution/channels.yaml) 里;`bun run distribution:check`
> 会报告所有渠道之间的版本漂移(见
> [docs/DISTRIBUTION.md](docs/DISTRIBUTION.md#channel-inventory-and-drift-check))。
### Koyeb
1. 用[一键部署](#一键部署)里的 **Deploy to Koyeb** 按钮,运行预构建的 `ghcr.io/libredb/libredb-studio:latest` 镜像。
2. 启动前在部署表单里设置一个强 `JWT_SECRET`(32 个字符以上)。Koyeb 无法自动生成密钥,而预填的那个故意比 32 字符下限更短,所以照原样部署会在启动时停下并说明原因。没有预填任何密码:把 `ADMIN_PASSWORD` 留空,应用会在首次运行时生成一个并打印到 Koyeb 运行时日志里,或者你自己设一个。`USER_PASSWORD` 不会被生成;不设置它,低权限账号就完全不存在,这对公网 URL 是更安全的默认值。
3. 要让连接在重新部署后仍然存在,把 `STORAGE_PROVIDER=postgres`,并把 `STORAGE_POSTGRES_URL` 设成 Koyeb 托管 Postgres 或 Neon 的连接串。按钮默认是 `STORAGE_PROVIDER=local`,连接元数据留在浏览器里。
完整配置与存储选项见 [`deploy/koyeb/`](deploy/koyeb/)。
### Railway
LibreDB Studio 提供了可一键使用的 [Railway](https://railway.com) 模板。
模板定义、安装说明和发布清单见 [`deploy/railway/`](deploy/railway/)。
该模板运行预构建的 `ghcr.io/libredb/libredb-studio` 镜像,并把 SQLite
持久化在 Railway volume 上。注意:Docker 镜像模板每次发版都需要手动升版本号
(与 CapRover 相同)。
### CapRover
LibreDB Studio 已发布在官方 [CapRover One-Click Apps](https://github.com/caprover/one-click-apps/blob/master/public/v4/apps/libredb-studio.yml) 目录中:
1. **打开你的 CapRover 面板** → **Apps → One-Click Apps/Databases**
2. **搜索** **LibreDB Studio**
3. **填写变量**(管理员/用户凭据、`JWT_SECRET`,以及可选的 AI/存储设置)
4. **部署!**
应用运行预构建的 `ghcr.io/libredb/libredb-studio` 镜像。与 Railway 一样,Docker 镜像模板每次发版都需要手动升版本号。
### Kubero
LibreDB Studio 已列入官方
[Kubero 模板目录](https://www.kubero.dev/templates)(一个自托管的
"Kubernetes 版 Heroku 替代品")。在你的 Kubero 面板里浏览
**Templates**,搜索 **LibreDB Studio**,填写凭据 / `JWT_SECRET`,
然后部署。该模板运行预构建的 `ghcr.io/libredb/libredb-studio` 镜像,
并把 SQLite 持久化在 `/app/data` 上的 5Gi volume 里。安装与安装后说明见
[`deploy/kubero/`](deploy/kubero/)。与 Railway 和 CapRover 一样,Docker 镜像模板
每次发版都需要手动升版本号。
### Cosmos
LibreDB Studio 已列入官方
[Cosmos servapp 市场](https://github.com/azukaar/cosmos-servapps-official)
([Cosmos](https://cosmos-cloud.io) 是一个自托管的服务器管理器与安全
反向代理)。在你的 Cosmos 面板里打开 **Marketplace**,搜索
**LibreDB Studio**,然后安装。Cosmos 会自动生成凭据和
`JWT_SECRET`,准备一个位于 `/app/data` 的持久化 SQLite volume,并在
SmartShield 保护的路径后面提供服务。安装与安装后说明见
[`deploy/cosmos/`](deploy/cosmos/)。与 Railway、CapRover 和 Kubero 一样,
Docker 镜像模板每次发版都需要手动升版本号。
### Render(云端部署推荐)
LibreDB Studio 带了一份用于一键部署的 `render.yaml` Blueprint:
1. **Fork 本仓库**
2. **连接到 Render**:[dashboard.render.com](https://dashboard.render.com) → New → Blueprint
3. **选择你 fork 出来的仓库**,Render 会自动识别 `render.yaml`
4. **在 Render 面板里设置环境变量**
5. **部署!**
### Docker Compose(自托管)
用现成的 [`docker-compose.example.yml`](docker-compose.example.yml),它拉取已发布的镜像(`ghcr.io/libredb/libredb-studio:latest`),所以不需要从源码构建。它记录了所有支持的环境变量(认证、OIDC、存储、LLM、种子连接),较少用到的那些以注释形式给出。
```bash
# 1. 复制现成的 compose 文件
cp docker-compose.example.yml docker-compose.yml
# 2. 创建你的 .env(至少设置 JWT_SECRET / ADMIN_PASSWORD / USER_PASSWORD)
cp .env.example .env
# 3. 启动
docker compose up -d # → http://localhost:3000
```
这个文件与平台无关,可用于那些消费普通 `docker-compose.yml` 的 PaaS 工具(Dokploy、Coolify、Portainer 等),把它们指向这个文件,把密钥作为环境变量设置好。
> 仓库默认的 `docker-compose.yml` 会从源码构建镜像(`build: .`),面向本地开发。
### Kubernetes(Helm Chart)
```bash
helm repo add libredb https://libredb.org/libredb-studio/
helm install libredb libredb/libredb-studio
# 从 Pod 日志里取出生成的管理员凭据
kubectl logs deployment/libredb-libredb-studio | grep -A 4 "generated admin credentials"
```
或者通过 OCI registry:
```bash
helm install libredb oci://ghcr.io/libredb/charts/libredb-studio
```
生产环境请提供你自己的密钥,而不要依赖生成的:
```bash
helm install libredb libredb/libredb-studio \
--set secrets.jwtSecret=$(openssl rand -base64 32) \
--set secrets.adminPassword=MyAdmin123
```
特性:PostgreSQL 子 chart、Ingress/TLS、HPA、PDB、NetworkPolicy、ExternalSecrets 支持。完整文档见 [charts/libredb-studio/README.md](charts/libredb-studio/README.md)。
### 种子连接(预配置数据库)
通过一个 YAML 配置文件预置数据库连接,让用户登录后立刻就能看到。适合平台/SaaS 部署,由管理员为团队准备数据库。
**特性:**
- 基于角色的访问控制(`admin`、`user`、`*` 通配符)
- 混合模式:`managed: true`(只读,由管理员控制)或 `managed: false`(给用户一份可编辑的副本)
- 凭据通过 `${ENV_VAR}` 语法注入,绝不存放在配置文件里
- 热重载:配置改动 60 秒内生效,无需重启
- 适用于 Docker、docker-compose 和 Kubernetes(Helm)
**1. 创建配置文件**(`seed-connections.yaml`):
```yaml
version: "1"
defaults:
managed: true
environment: production
connections:
- id: "prod-analytics"
name: "Production Analytics"
type: postgres
host: analytics-db.internal
port: 5432
database: analytics
user: "readonly_user"
password: "${ANALYTICS_DB_PASSWORD}"
roles: ["admin"]
color: "#10B981"
- id: "dev-sandbox"
name: "Dev Sandbox"
type: mysql
host: dev-mysql.internal
port: 3306
database: sandbox
user: "dev_user"
password: "${DEV_DB_PASSWORD}"
roles: ["*"]
managed: false
```
**2. 挂载并配置:**
Docker
```bash
docker run -v ./seed-connections.yaml:/app/config/seed-connections.yaml:ro \
-e SEED_CONFIG_PATH=/app/config/seed-connections.yaml \
-e ANALYTICS_DB_PASSWORD=secret \
-e DEV_DB_PASSWORD=devsecret \
ghcr.io/libredb/libredb-studio:latest
```
Docker Compose
```yaml
services:
app:
image: ghcr.io/libredb/libredb-studio:latest
volumes:
- ./seed-connections.yaml:/app/config/seed-connections.yaml:ro
environment:
SEED_CONFIG_PATH: /app/config/seed-connections.yaml
ANALYTICS_DB_PASSWORD: ${ANALYTICS_DB_PASSWORD}
DEV_DB_PASSWORD: ${DEV_DB_PASSWORD}
```
Kubernetes (Helm)
```yaml
# values.yaml
seedConnections:
enabled: true
config:
version: "1"
connections:
- id: "prod-analytics"
name: "Production Analytics"
type: postgres
host: analytics-db.internal
password: "${ANALYTICS_DB_PASSWORD}"
roles: ["admin"]
# 凭据通过 K8s Secret 提供:
extraEnvFrom:
- secretRef:
name: seed-db-credentials
```
**配置参考:**
| 字段 | 必填 | 说明 |
|-------|----------|-------------|
| `version` | 是 | 必须是 `"1"` |
| `defaults` | 否 | 合并进所有连接的默认值 |
| `connections[].id` | 是 | 唯一 slug(`[a-z0-9-]+`,最多 64 字符) |
| `connections[].name` | 是 | UI 中显示的名称 |
| `connections[].type` | 是 | `postgres`、`mysql`、`sqlite`、`mongodb`、`redis`、`oracle`、`mssql`、`libredb`、`couchbase`、`clickhouse`、`druid`、`elasticsearch`、`opensearch`、`trino` |
| `connections[].roles` | 是 | `["*"]`(所有人)、`["admin"]`、`["user"]` 或 `["admin", "user"]` |
| `connections[].managed` | 否 | `true` = 只读(默认),`false` = 给用户一份可编辑的副本 |
| `connections[].password` | 否 | 密钥请用 `${ENV_VAR}` 语法 |
| `connections[].environment` | 否 | `production`、`staging`、`development`、`local`、`other` |
| `connections[].group` | 否 | 侧边栏里的分组标签 |
| `connections[].color` | 否 | 徽标的十六进制颜色(例如 `#10B981`) |
**环境变量:**
| 变量 | 默认值 | 说明 |
|----------|---------|-------------|
| `SEED_CONFIG_PATH` | `/app/config/seed-connections.yaml` | 配置文件路径 |
| `SEED_CACHE_TTL_MS` | `60000` | 缓存 TTL,单位毫秒(热重载间隔) |
### 一条命令跑 Vault 演示
[`docker-compose.vault-demo.yml`](docker-compose.vault-demo.yml) 会启动 Studio、PostgreSQL 和一个 dev 模式的 HashiCorp Vault,外加一个一次性的 init 容器,它把数据库密码写进 Vault,把种子文件写进 Studio 挂载的 volume。它拉取已发布的镜像,所以没有东西需要构建;它定义的连接通过 `${vault:secret/data/prod/postgres#password}` 引用从 Vault 取密码,而不是从环境变量取。
```bash
docker compose -f docker-compose.vault-demo.yml up
```
打开 **http://localhost:3000**,用首次运行打印到 Studio 日志里的管理员凭据登录,与[快速开始](#快速开始)相同。侧边栏里有一个 **Postgres (password from Vault)** 连接,打开它并运行任意语句,它就会用 Vault 持有的密码连接。想看一次轮换,就在 Vault 和 PostgreSQL 里都改掉密码,等过该文件设置的 10 秒缓存,再打开这个连接:它会用新值认证,且没有任何容器重启。
> 那个文件里的 Vault 是 dev 模式(内存存储、root token、无 TLS、无策略),所以只用于演示。引用语法、`VAULT_*` 变量、轮换窗口以及两条轮换命令都在 [`docs/SEED_CONNECTIONS.md`](docs/SEED_CONNECTIONS.md#vault-references) 里;真实部署请从 HashiCorp 的[生产加固指南](https://developer.hashicorp.com/vault/tutorials/operations/production-hardening)开始。
## 路线图
- [x] **阶段 1**:Monaco SQL 编辑器与多标签页支持。
- [x] **阶段 2**:多模型 AI(Gemini、OpenAI、Ollama、Custom)集成。
- [x] **阶段 3**:专业数据表格与虚拟化。
- [x] **阶段 4**:多数据库支持(PostgreSQL、MySQL、SQLite、MongoDB、Redis)。
- [x] **阶段 5**:交互式 ER 图(可视化 schema 图)。
- [x] **阶段 6**:企业级基础(连接测试、SSL/TLS、SSH 隧道、事务控制、查询取消)。
- [x] **阶段 7**:AI 智能(查询安全分析、AI 查询解释器、AI 生成的 schema 描述)。
- [x] **阶段 8**:分析师与开发者工具(数据剖析、代码生成器、测试数据生成器、透视表、列筛选、数据库文档)。
- [x] **阶段 9**:显示脱敏(预览):列名模式匹配、可配置规则、RBAC UI 控件、客户端导出/剪贴板脱敏)。
- [x] **阶段 10**:高级 ERD(真实外键连线、ELK.js 自动布局、MiniMap、PNG/SVG 导出、紧凑模式、表搜索)。
- [x] **阶段 11**:Schema 对比与迁移(快照时间线、跨连接对比、为 PostgreSQL、MySQL、SQLite、Oracle 和 SQL Server 生成迁移 SQL,外加 ClickHouse 的列修改)。
- [x] **阶段 12**:高级图表(散点图、直方图、堆叠图、聚合、日期分组、图表保存/加载、图表仪表盘)。
- [x] **阶段 13**:监控增强(时间序列趋势、阈值告警、连接池统计、可配置轮询)。
- [x] **阶段 14**:企业级数据库支持(通过 oracledb Thin 模式支持 Oracle Database,通过 mssql/tedious 支持 Microsoft SQL Server)。
- [x] **阶段 15**:SSO 集成:与厂商无关的 OIDC 认证(Auth0、Keycloak、Okta、Azure AD、Zitadel),支持 PKCE、角色映射和 provider 登出。
- [ ] **阶段 16**:DBA 与监控(锁依赖图、Vacuum 调度器、Prometheus 导出)。
- [ ] **阶段 17**:企业协作(用户身份、共享工作区、SAML 2.0)。
- [ ] **阶段 18**:服务端强制数据脱敏(SQL 输出血缘、部署级全局策略、fail-closed 的 API 脱敏、别名/聚合覆盖)。
- [x] **阶段 19**:免驱动 provider:Couchbase(通过 Query REST API 的 SQL++),第一个不引入任何运行时依赖的 provider。这套模式记录在[新增 provider](docs/ADDING_A_PROVIDER.md) 中。
- [x] **阶段 20**:分析型数据库:ClickHouse([#264](https://github.com/libredb/libredb-studio/issues/264))与 Apache Druid([#265](https://github.com/libredb/libredb-studio/issues/265)),两者都通过 HTTP 且免驱动。Druid 天生只读(没有 `UPDATE`、没有 `DELETE`、没有 `CREATE TABLE`),所以它同时展示了一个诚实报告自身能力缺失的 provider:它不会给出那些注定失败的操作入口。
- [x] **阶段 21**:联邦查询:Apache Trino([#424](https://github.com/libredb/libredb-studio/issues/424),阶段 2),通过 Trino 自己的客户端协议实现且免驱动。一直挡住它的那个产品问题有了答案:一个连接固定**一个 catalog**,正如一个 PostgreSQL 连接固定一个数据库,而树保持两层:把 `information_schema` 铺开到每个 catalog 是无界的,因为仅 `jmx.current` 就为每个 MBean 发布一张表。跨 catalog 查询在编辑器里仍然可用,只要把名字完整限定。PrestoDB 将是另一个未来的 type-id;传输层已经从方言前缀构建响应头,所以那只是一个描述符,不是重写。
## 社区与质量
| 资源 | 说明 |
|----------|-------------|
| [DeepWiki](https://deepwiki.com/libredb/libredb-studio) | AI 驱动的文档,始终与代码库保持同步 |
| [SonarCloud](https://sonarcloud.io/project/overview?id=libredb_libredb-studio) | 代码质量、安全分析与技术债跟踪 |
| [API 文档](docs/API_DOCS.md) | 完整的 REST API 参考 |
| [Agent 指南](docs/AGENT_GUIDE.md) | 使用 Agent:一次运行、三种工作流、"已回答"的含义、预算表以及 Ollama 路径 |
| [Agent 数据流向](docs/AGENT_DATA_FLOW.md) | 什么数据会离开本机、什么时候离开、发往哪个模型 provider,按调用点撰写 |
| [本地模型](docs/llms/README.md) | 哪个本地模型真能驱动一次 Agent 运行,跨三种工作流实测,每个模型一页 |
| [Agent 运行时](docs/AGENT.md) | Agent 的行为、边界、部署方式与已知限制 |
| [OIDC SSO](docs/OIDC.md) | SSO 配置(Auth0、Keycloak、Okta、Azure AD、Zitadel、Google)以及子系统内部实现与安全模型 |
| [双因素认证](docs/MFA.md) | local provider 上的 TOTP:生成密钥、为应用注册、Docker/Helm 接线,以及它没有覆盖的部分 |
| [主题指南](docs/ui/theming.md) | CSS 主题、深色模式与样式定制 |
| [登录页](docs/ui/login-page.md) | 登录页布局、OIDC/local 模式与设计系统 |
| [编辑器文档](docs/editor/) | SQL 编辑器内部实现:补全、性能、查询优化 |
| [架构](docs/ARCHITECTURE.md) | 系统架构与设计模式 |
| [新增 provider](docs/ADDING_A_PROVIDER.md) | 逐步添加一个数据库,以及如何判断它到底需不需要驱动 |
| [待办清单](docs/BACKLOG.md) | 已知缺陷以及尚未登记为 issue 的延期工作 |
### 跨浏览器测试
这个产品是浏览器应用,所以浏览器 bug 就是产品 bug。CI 在桌面 Chromium 上跑完整的 Playwright
测试套件,并在 WebKit 上跑 `security-headers` 这个 spec(`webkit-security`)。除了这一个
WebKit spec 之外,Safari 与旧版 WebKit 的回归问题、移动端布局,以及 Linux 桌面版背后的
WebKitGTK 引擎,都需要真机。本项目使用 BrowserStack 进行测试。
## 支持
libredb-studio 是免费且开源的。如果它帮到了你或你的团队,欢迎
[赞助这个项目](https://github.com/sponsors/libredb),你的支持
为维护、缺陷修复、新的数据库 provider,以及开源版的持续
开发提供资金。
[](https://github.com/sponsors/libredb)
## 赞助商
_成为第一个赞助 libredb-studio 的人!_
## 支持者
与上面的赞助商不同:这些是为项目承担某项运行成本的开源计划。这个位置买不到,
列在这里也不代表被点名的公司为 libredb-studio 背书。完整名单、每家承担了什么
以及需要回馈何种署名,见
[libredb.org/supporters](https://libredb.org/supporters/)。
- **[Docker](https://www.docker.com/community/open-source/)**:Docker-Sponsored
Open Source 计划支撑着 Docker Hub 上的 `libredb` 命名空间,它为所有拉取这个公开
镜像的人免去了拉取速率限制。主镜像仍然是 GHCR;这个计划让 Hub 上的镜像镜像无需
账号即可使用。自 2026-09-01 起。
- **[BrowserStack](https://www.browserstack.com/opensource)**:BrowserStack
Open Source 计划支撑着跨浏览器测试,即在桌面 Chromium 上跑完整的 Playwright
测试套件,并在 WebKit 上跑 `security-headers` 这个 spec(`webkit-security`)。
除了那一个 WebKit spec 之外,Safari 与旧版 WebKit 的回归问题、移动端布局,以及
Linux 桌面版背后的 WebKitGTK 引擎,都需要真机。自 2026-08-31 起。
- **[Tailscale](https://tailscale.com/opensource)**:GitHub 上的 Community
计划,支撑着维护者访问数据库探针主机所用的私有网络,这样针对真实引擎做测试
就不必把数据库端口暴露到公网。自 2026-08-30 起。
## 文档
深入内容目前只有英文版本:
- [架构](docs/ARCHITECTURE.md) · [数据库提供方](docs/DATABASE_PROVIDERS.md) · [各引擎参考](docs/providers/README.md)
- [API 文档](docs/API_DOCS.md) · [OIDC 配置](docs/OIDC.md) · [存储层](docs/STORAGE.md)
- [Helm Chart](docs/HELM_CHART.md) · [分发渠道](docs/CHANNELS.md) · [新增一个数据库](docs/ADDING_A_PROVIDER.md)
## 贡献
欢迎 issue 和 PR,中文提交完全没问题。请先读 [CONTRIBUTING.md](CONTRIBUTING.md)。
我们欢迎社区贡献!无论是修 bug、加新功能,还是改进文档:
1. Fork 本项目。
2. 创建你的功能分支(`git checkout -b feature/AmazingFeature`)。
3. 提交你的改动(`git commit -m 'Add some AmazingFeature'`)。
4. 把分支推上去(`git push origin feature/AmazingFeature`)。
5. 发起一个 Pull Request。
这里的每一项改动都和它的测试在同一个 Pull Request 里落地,并受 100% 行覆盖率
硬门禁约束。达到这条线是有价值的,所以做到过的人都被列在
[`CONTRIBUTORS.md`](CONTRIBUTORS.md) 里,并附上他们所做改动的链接。那个页面上
什么都不计数(没有合并总数,没有行数),原因写在
[`CONTRIBUTING.md`](CONTRIBUTING.md#the-contributor-ladder) 里。可以从一个
[`good first issue`](https://github.com/libredb/libredb-studio/labels/good%20first%20issue) 开始:
每个 issue 都会用一条你能自己运行的命令说明"做完"是什么样。
## 许可证
以 MIT 许可证分发。详见 `LICENSE`。有一个直接依赖 `elkjs` 采用互惠的 EPL-2.0;
见 [`docs/THIRD_PARTY_LICENSES.md`](docs/THIRD_PARTY_LICENSES.md)。
为 DBA 与开发者而做。