


---

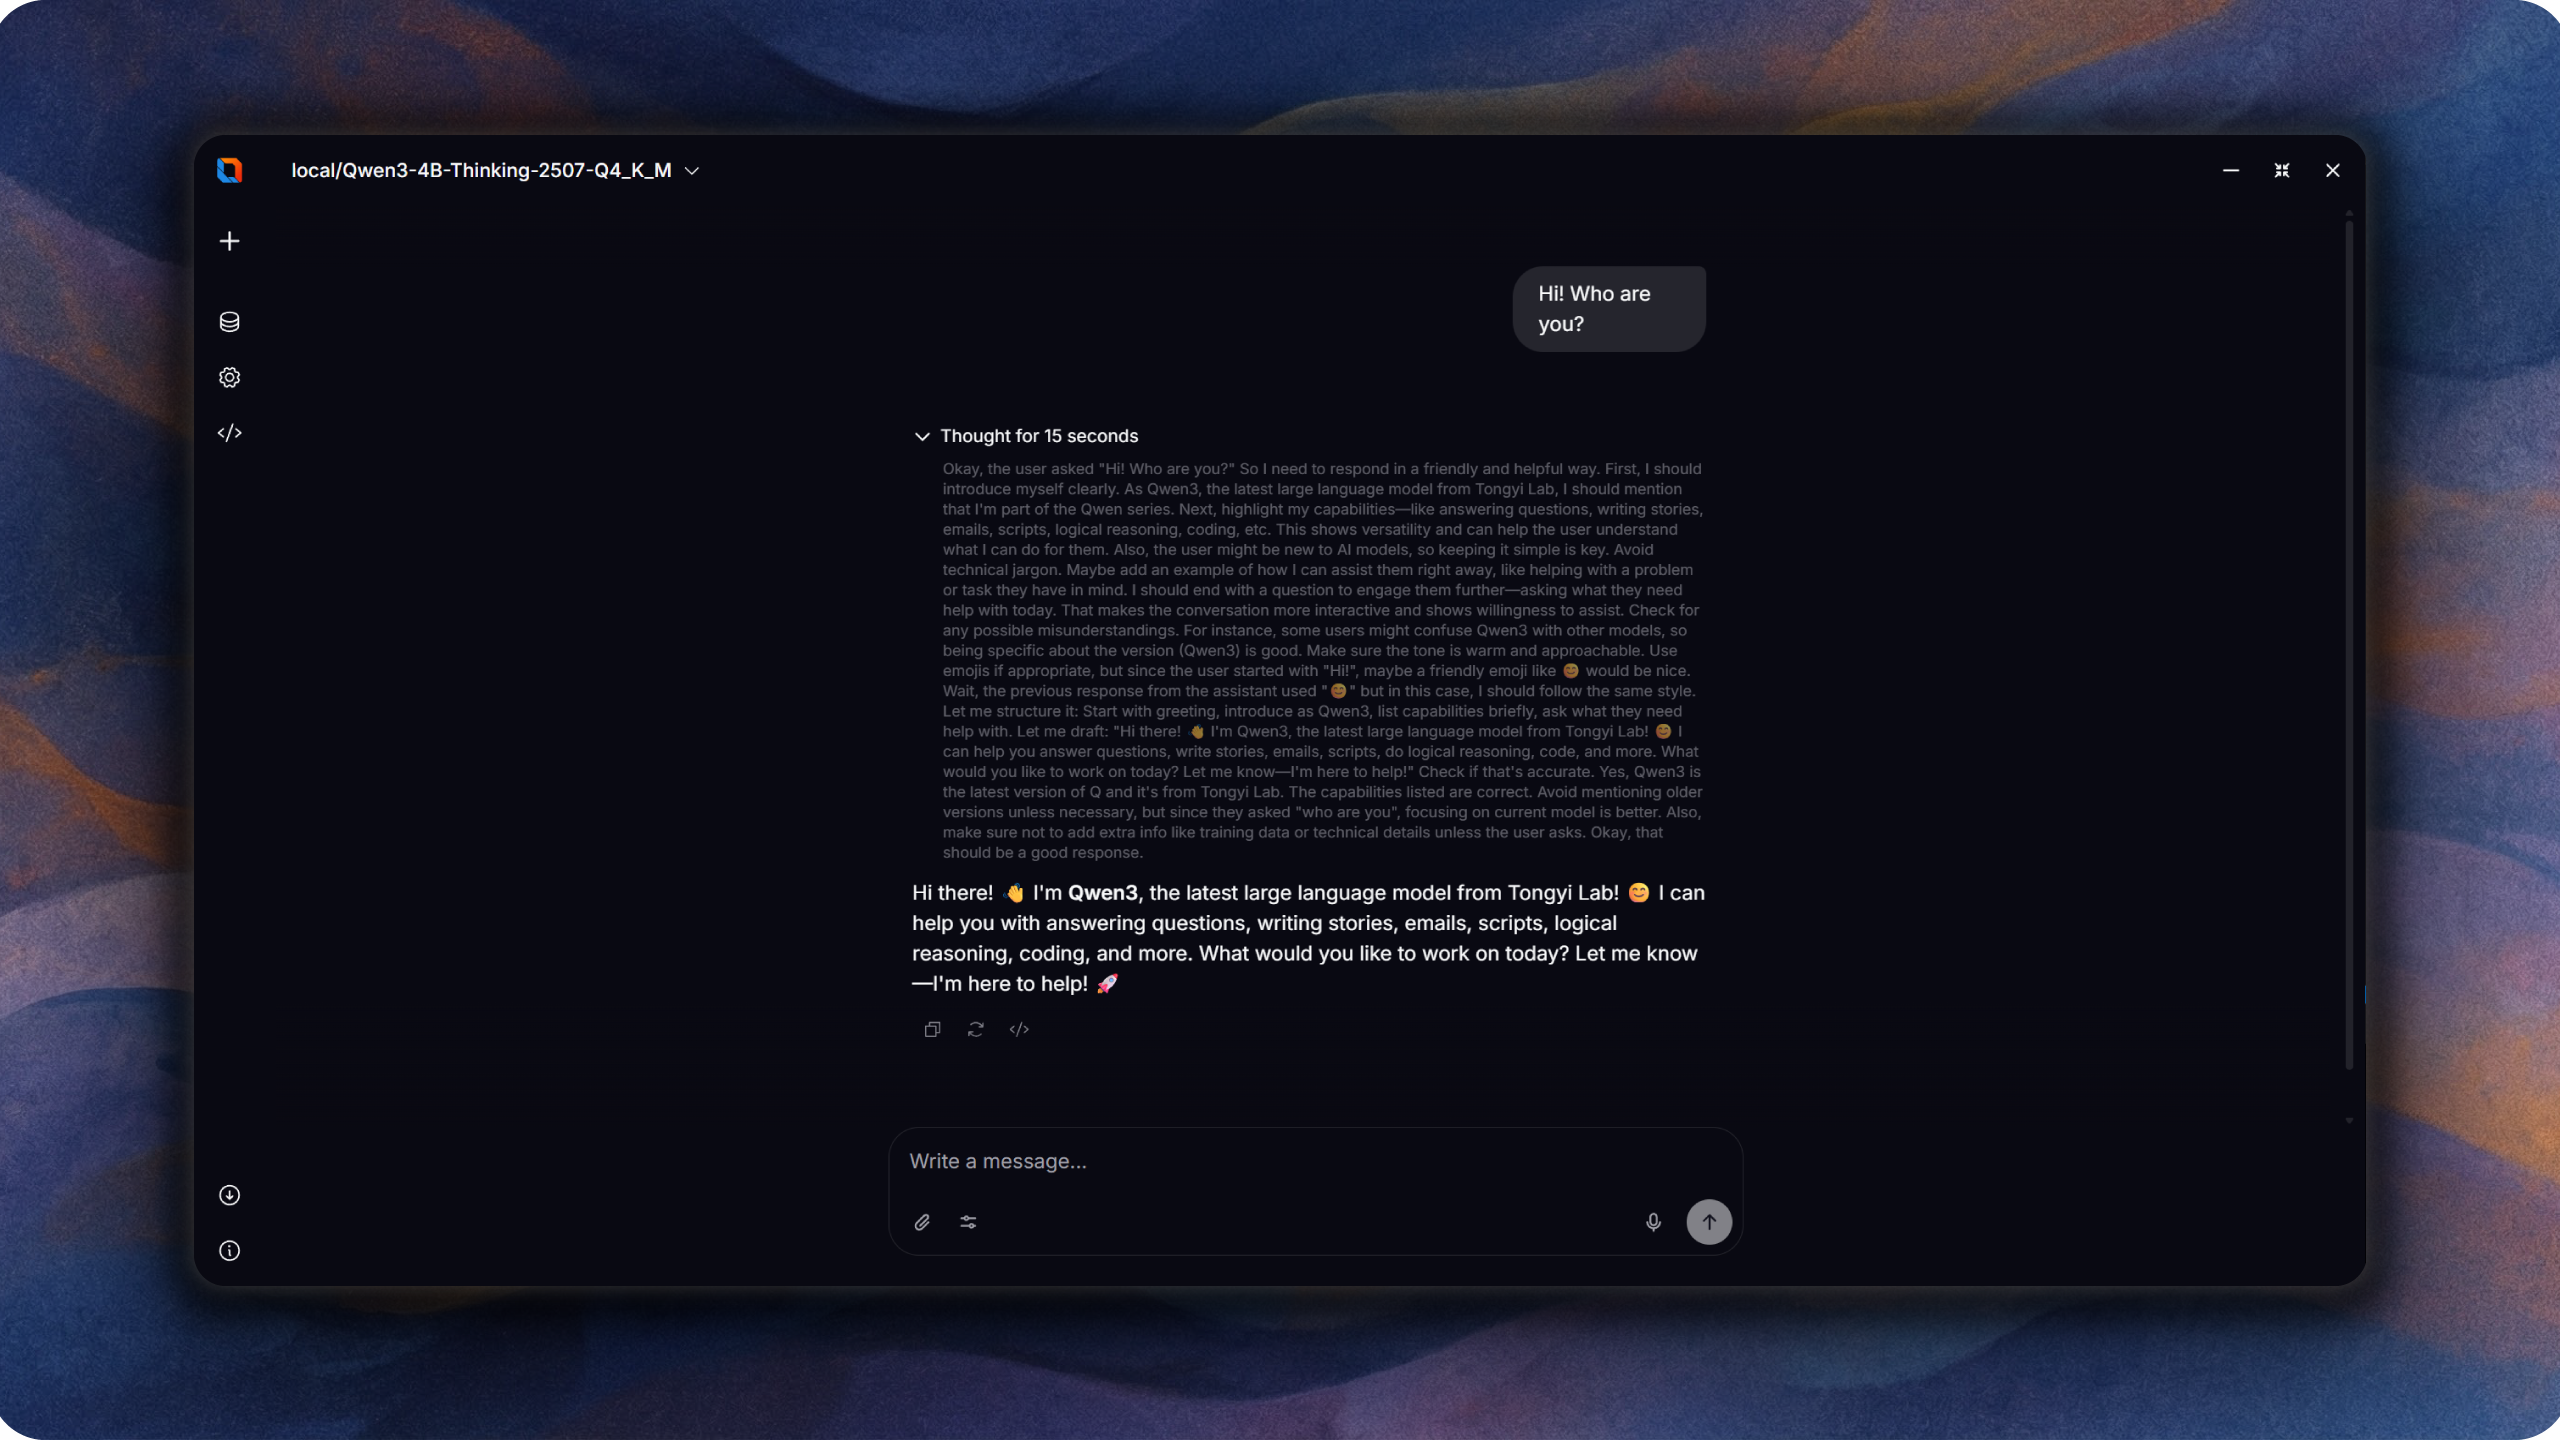
Aplicativo desktop privado de chat com IA com suporte a LLMs locais.
Toda a inferência acontece na sua máquina — sem nuvem, sem compartilhamento de dados.


## 📚 Índice
- [O que é isso?](#-o-que-é-isso)
- [Demo](#-demo)
- [Principais Recursos](#-principais-recursos)
- [Instalação e Configuração](#️-instalação-e-configuração)
- [Como Começar a Usar](#-como-começar-a-usar)
- [Requisitos do Sistema](#️-requisitos-do-sistema)
- [Modelos Suportados](#-modelos-suportados)
- [Privacidade e Segurança](#️-privacidade-e-segurança)
- [Agradecimentos](#-agradecimentos)
- [Licença](#-licença)
## ✨ O que é isso?
Oxide Lab é um aplicativo desktop nativo para executar modelos de linguagem grandes localmente. Construído com Rust e Tauri v2, oferece uma interface de chat rápida e privada sem necessidade de conexão com a internet ou serviços de API externos.
## 🎬 Demo
https://github.com/user-attachments/assets/0b9c8ff9-7793-4108-8b62-b0800cbd855e
https://github.com/user-attachments/assets/27c1f544-69e0-4a91-8fa5-4c21d67cb7c7
https://github.com/user-attachments/assets/ce5337d5-3e63-4263-b6a7-56e6847bbc71
## 🚀 Principais Recursos
- Inferência 100% local — seus dados nunca saem da sua máquina
- Suporte a múltiplas arquiteturas: Llama, Qwen2, Qwen2.5, Qwen3, Qwen3 MoE, Mistral, Mixtral, DeepSeek, Yi, SmolLM2
- Formatos de modelo GGUF e SafeTensors
- Aceleração de hardware: CPU, CUDA (NVIDIA), Metal (Apple Silicon), Intel MKL, Apple Accelerate
- Geração de texto em streaming
- Interface multilíngue: inglês, russo, português brasileiro
- Interface moderna construída com Svelte 5 e Tailwind CSS
## 🛠️ Instalação e Configuração
### Pré-requisitos
- Node.js (para build do frontend)
- Rust toolchain (para o backend)
- Para CUDA: GPU NVIDIA com CUDA toolkit
- Para Metal: macOS com Apple Silicon
### Desenvolvimento
```bash
# Instalar dependências
npm install
# Executar com backend CPU
npm run tauri:dev:cpu
# Executar com backend CUDA (GPU NVIDIA)
npm run tauri:dev:cuda
# Desenvolvimento com detecção de plataforma
npm run app:dev
```
### Build
```bash
# Build com backend CPU
npm run tauri:build:cpu
# Build com backend CUDA
npm run tauri:build:cuda
```
### Verificações de Qualidade
```bash
npm run lint # ESLint
npm run lint:fix # ESLint com correção automática
npm run check # Verificação de tipos Svelte
npm run format # Formatação Prettier
npm run test # Testes Vitest
```
### Comandos específicos do Rust (a partir de src-tauri/)
```bash
cargo clippy # Linting
cargo test # Testes unitários
cargo audit # Auditoria de segurança
```
## 📖 Como Começar a Usar
1. Compile ou baixe o aplicativo
2. Baixe um modelo compatível em formato GGUF ou SafeTensors (por exemplo, do Hugging Face)
3. Inicie o Oxide Lab
4. Carregue seu modelo através da interface
5. Comece a conversar
## 🖥️ Requisitos do Sistema
- Windows, macOS ou Linux
- Mínimo 4 GB de RAM (8+ GB recomendado para modelos maiores)
- Para aceleração GPU:
- NVIDIA: GPU compatível com CUDA
- Apple: chip M1/M2/M3 (Metal)
## 🤖 Modelos Suportados
Arquiteturas com suporte completo:
- Llama (1, 2, 3), Mistral, Mixtral, DeepSeek, Yi, SmolLM2, CodeLlama
- Qwen2/2.5, Qwen2.5/2 MoE
- Qwen3, Qwen3 MoE
Formatos:
- GGUF (modelos quantizados)
- SafeTensors
## 🛡️ Privacidade e Segurança
- Todo o processamento acontece localmente no seu dispositivo
- Sem telemetria ou coleta de dados
- Conexão com a internet não é necessária para inferência
- Content Security Policy (CSP) aplicada
## 🙏 Agradecimentos
Este projeto é construído sobre excelentes trabalhos open-source:
- [Candle](https://github.com/huggingface/candle) — Framework ML para Rust (HuggingFace)
- [Tauri](https://tauri.app/) — Framework para aplicativos desktop
- [Svelte](https://svelte.dev/) — Framework frontend
- [Tokenizers](https://github.com/huggingface/tokenizers) — Tokenização rápida (HuggingFace)
Veja [THIRD_PARTY_LICENSES.md](THIRD_PARTY_LICENSES.md) para atribuição completa de dependências.
## 📄 Licença
Apache-2.0 — veja [LICENSE](LICENSE)
Copyright (c) 2025 FerrisMind
---
*Tradução: Talita Maia Sousa*