


---

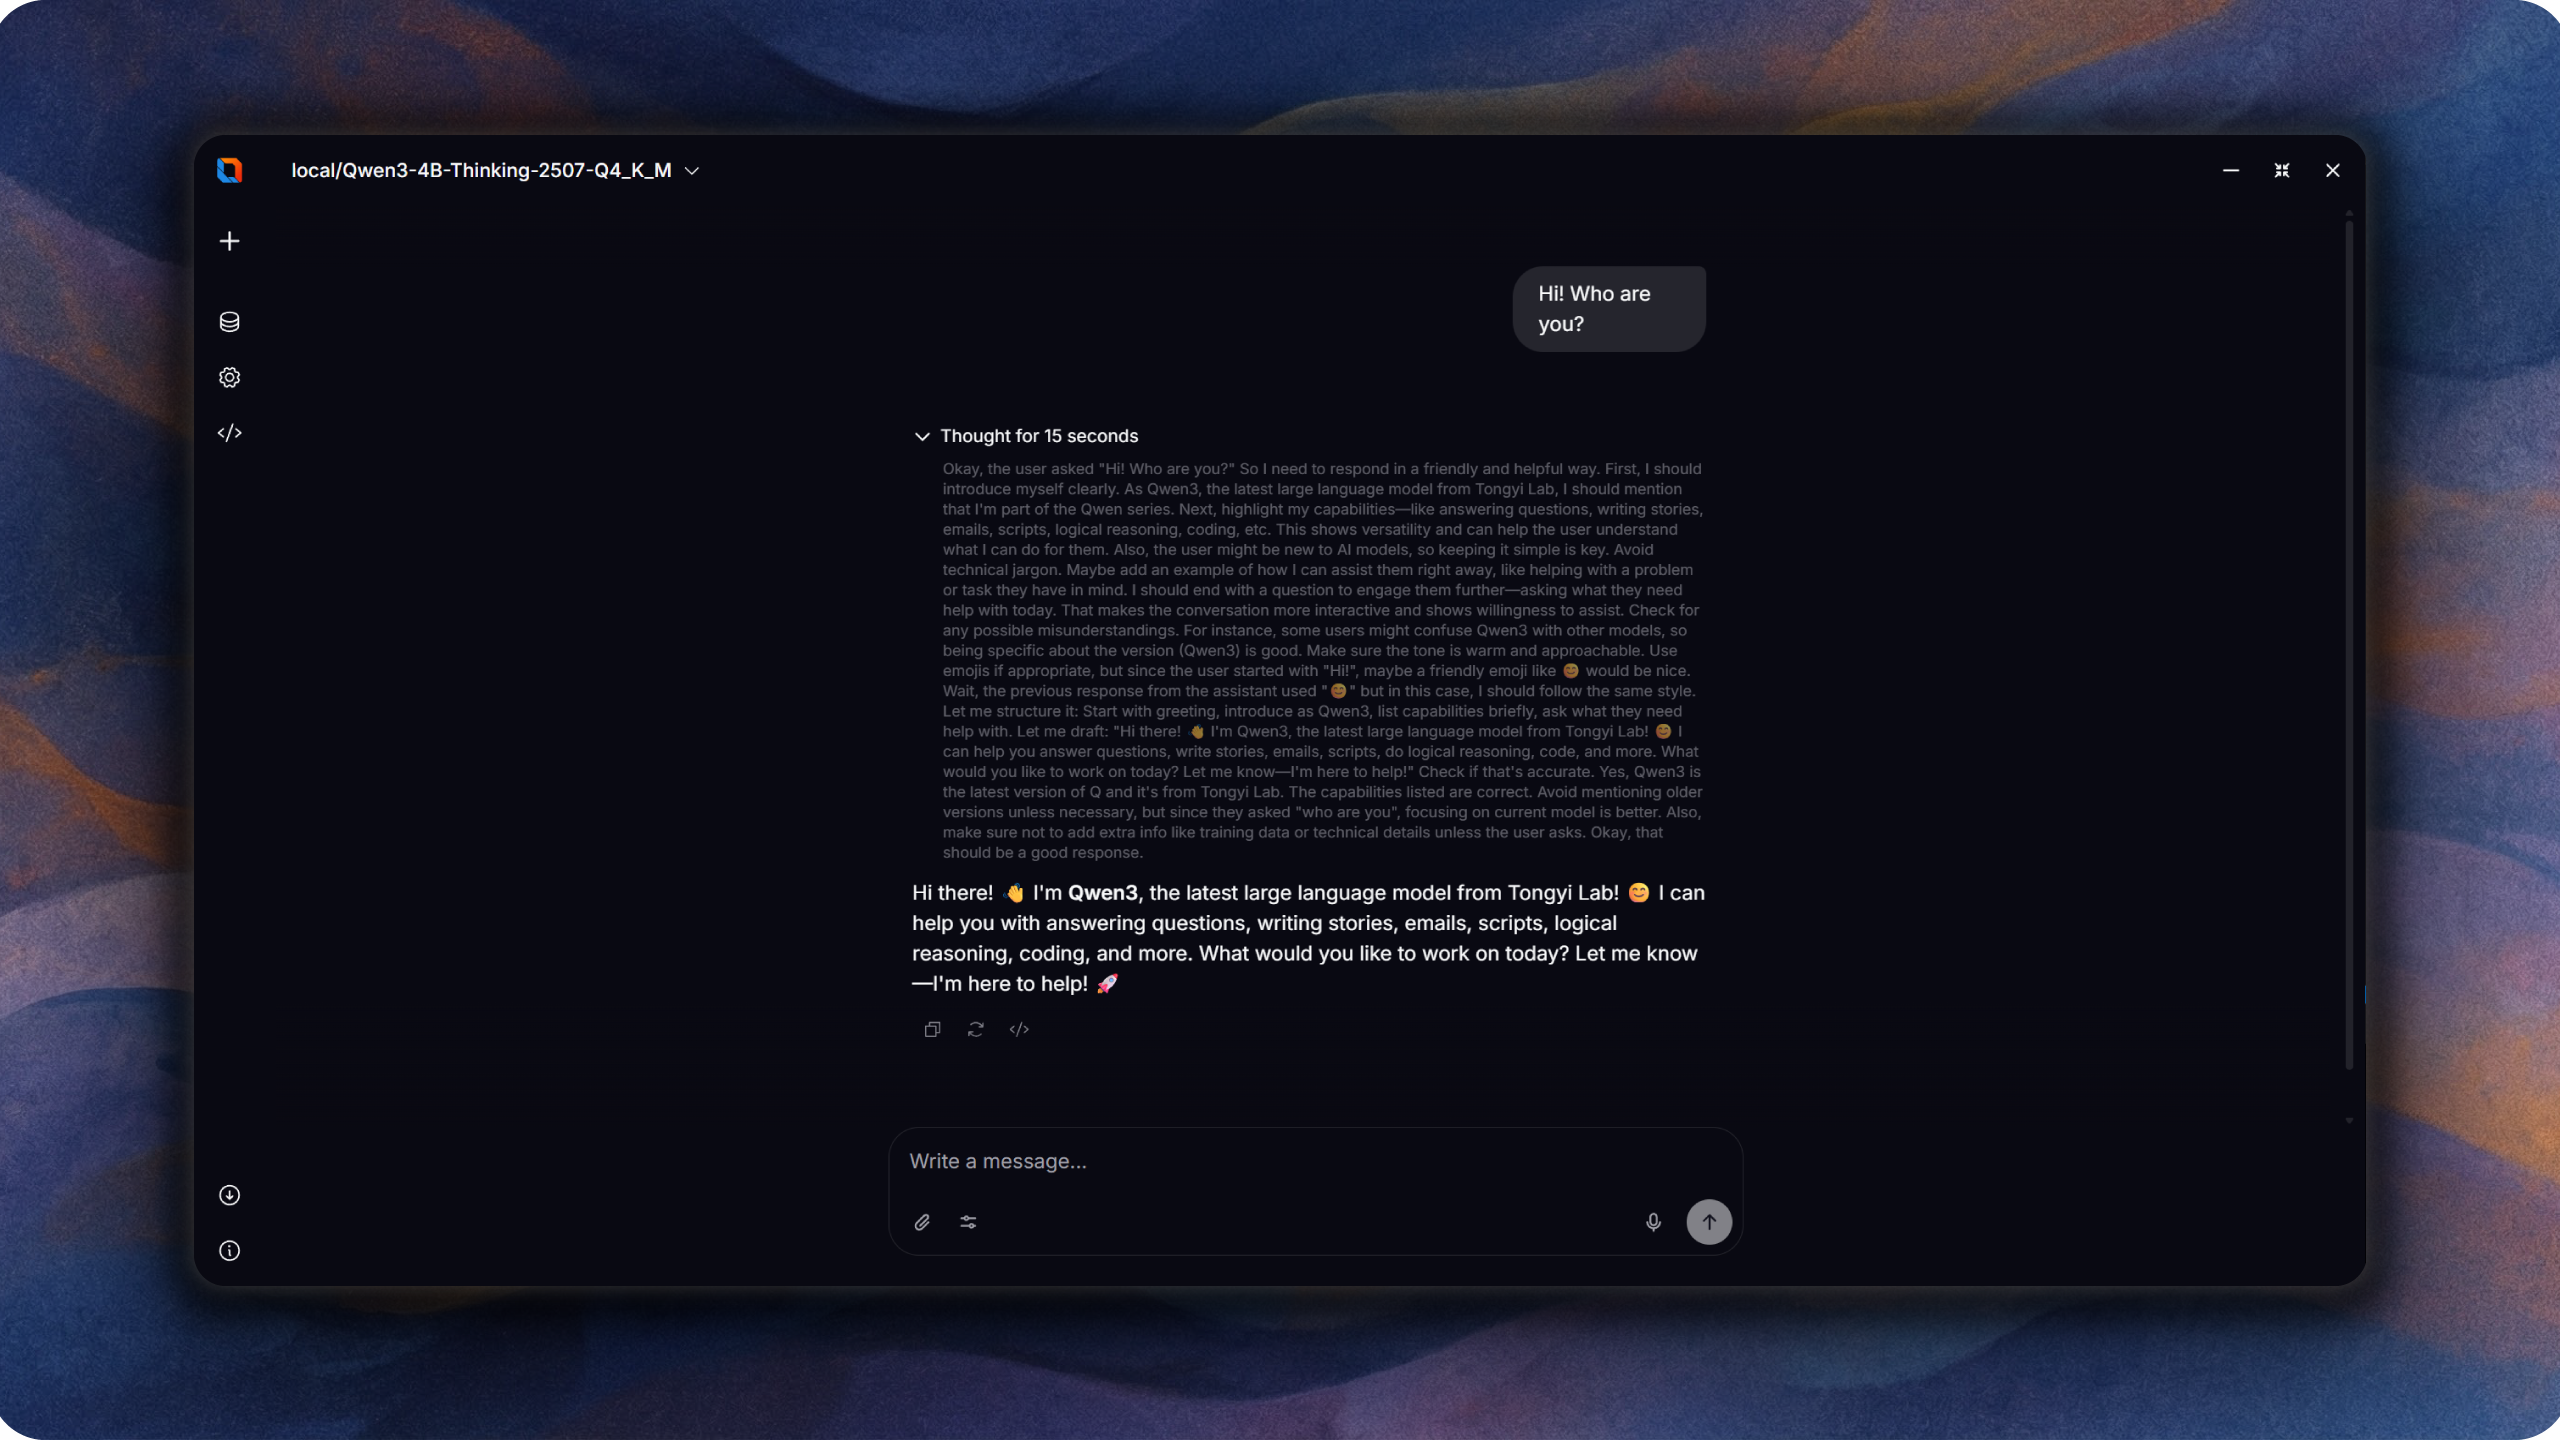
Приватное десктопное приложение для AI-чата с поддержкой локальных LLM.
Весь инференс происходит на вашем компьютере — без облака, без передачи данных.


## 📚 Содержание
- [Что это?](#-что-это)
- [Демо](#-демо)
- [Ключевые возможности](#-ключевые-возможности)
- [Установка и настройка](#️-установка-и-настройка)
- [Как начать использовать](#-как-начать-использовать)
- [Системные требования](#️-системные-требования)
- [Поддерживаемые модели](#-поддерживаемые-модели)
- [Приватность и безопасность](#️-приватность-и-безопасность)
- [Благодарности](#-благодарности)
- [Лицензия](#-лицензия)
## ✨ Что это?
Oxide Lab — нативное десктопное приложение для запуска больших языковых моделей локально. Построено на Rust и Tauri v2, обеспечивает быстрый приватный чат-интерфейс без необходимости подключения к интернету или внешним API-сервисам.
## 🎬 Демо
https://github.com/user-attachments/assets/0b9c8ff9-7793-4108-8b62-b0800cbd855e
https://github.com/user-attachments/assets/27c1f544-69e0-4a91-8fa5-4c21d67cb7c7
https://github.com/user-attachments/assets/ce5337d5-3e63-4263-b6a7-56e6847bbc71
## 🚀 Ключевые возможности
- 100% локальный инференс — ваши данные никогда не покидают компьютер
- Поддержка множества архитектур: Llama, Qwen2, Qwen2.5, Qwen3, Qwen3 MoE, Mistral, Mixtral, DeepSeek, Yi, SmolLM2
- Форматы моделей GGUF и SafeTensors
- Аппаратное ускорение: CPU, CUDA (NVIDIA), Metal (Apple Silicon), Intel MKL, Apple Accelerate
- Потоковая генерация текста
- Многоязычный интерфейс: английский, русский, бразильский португальский
- Современный интерфейс на Svelte 5 и Tailwind CSS
## 🛠️ Установка и настройка
### Требования
- Node.js (для сборки фронтенда)
- Rust toolchain (для бэкенда)
- Для CUDA: видеокарта NVIDIA с CUDA toolkit
- Для Metal: macOS с Apple Silicon
### Разработка
```bash
# Установка зависимостей
npm install
# Запуск с CPU бэкендом
npm run tauri:dev:cpu
# Запуск с CUDA бэкендом (NVIDIA GPU)
npm run tauri:dev:cuda
# Платформо-зависимая разработка
npm run app:dev
```
### Сборка
```bash
# Сборка с CPU бэкендом
npm run tauri:build:cpu
# Сборка с CUDA бэкендом
npm run tauri:build:cuda
```
### Проверка качества
```bash
npm run lint # ESLint
npm run lint:fix # ESLint с автоисправлением
npm run check # Проверка типов Svelte
npm run format # Форматирование Prettier
npm run test # Тесты Vitest
```
### Rust-специфичные команды (из src-tauri/)
```bash
cargo clippy # Линтинг
cargo test # Юнит-тесты
cargo audit # Аудит безопасности
```
## 📖 Как начать использовать
1. Соберите или скачайте приложение
2. Скачайте совместимую модель в формате GGUF или SafeTensors (например, с Hugging Face)
3. Запустите Oxide Lab
4. Загрузите модель через интерфейс
5. Начните общение
## 🖥️ Системные требования
- Windows, macOS или Linux
- Минимум 4 ГБ RAM (рекомендуется 8+ ГБ для больших моделей)
- Для GPU-ускорения:
- NVIDIA: GPU с поддержкой CUDA
- Apple: чип M1/M2/M3 (Metal)
## 🤖 Поддерживаемые модели
Архитектуры с полной поддержкой:
- Llama (1, 2, 3), Mistral, Mixtral, DeepSeek, Yi, SmolLM2, CodeLlama
- Qwen2/2.5, Qwen2.5/2 MoE
- Qwen3, Qwen3 MoE
Форматы:
- GGUF (квантованные модели)
- SafeTensors
## 🛡️ Приватность и безопасность
- Вся обработка происходит локально на вашем устройстве
- Никакой телеметрии или сбора данных
- Интернет-соединение не требуется для инференса
- Применяется Content Security Policy (CSP)
## 🙏 Благодарности
Проект построен на отличных open-source решениях:
- [Candle](https://github.com/huggingface/candle) — ML-фреймворк для Rust (HuggingFace)
- [Tauri](https://tauri.app/) — фреймворк для десктопных приложений
- [Svelte](https://svelte.dev/) — фронтенд-фреймворк
- [Tokenizers](https://github.com/huggingface/tokenizers) — быстрая токенизация (HuggingFace)
Полный список зависимостей см. в [THIRD_PARTY_LICENSES.md](THIRD_PARTY_LICENSES.md).
## 📄 Лицензия
Apache-2.0 — см. [LICENSE](LICENSE)
Copyright (c) 2025 FerrisMind