Esta es una traducción; el README en inglés es la referencia y puede ser más reciente.
Ejecuta modelos Mixture-of-Experts más grandes que la memoria del dispositivo haciendo streaming de los expertos desde la flash.
Construido sobre la API pública de llama.cpp; Android, iOS, macOS, Windows y Linux; un servidor local
compatible con OpenAI en cada uno.
Teléfono Android de 12 GB
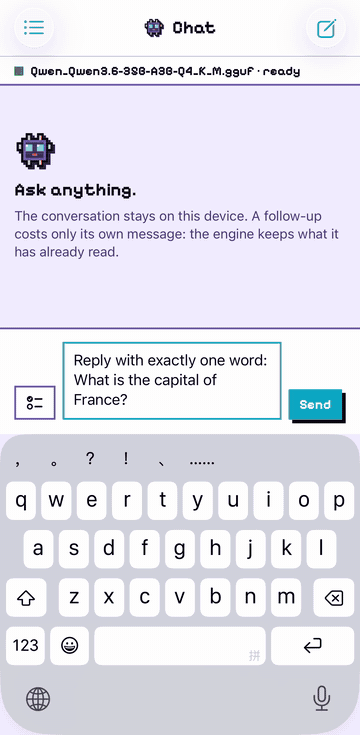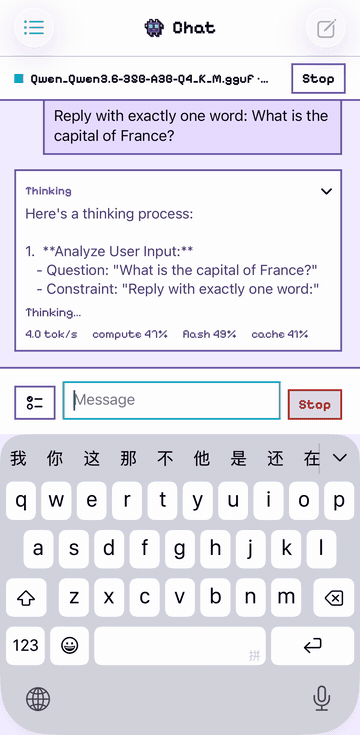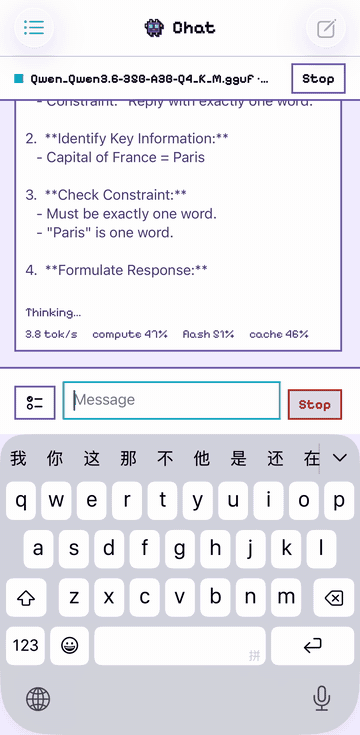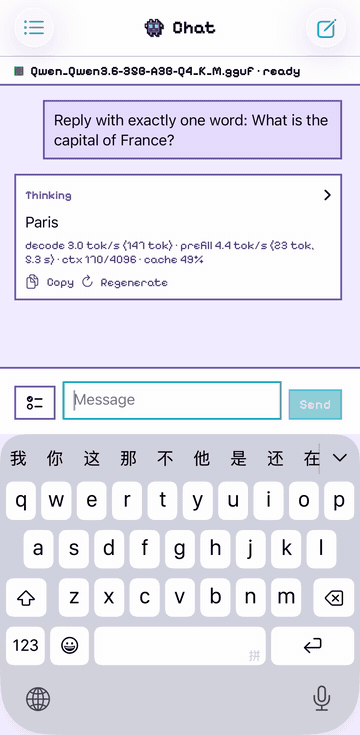
iPhone de 12 GB
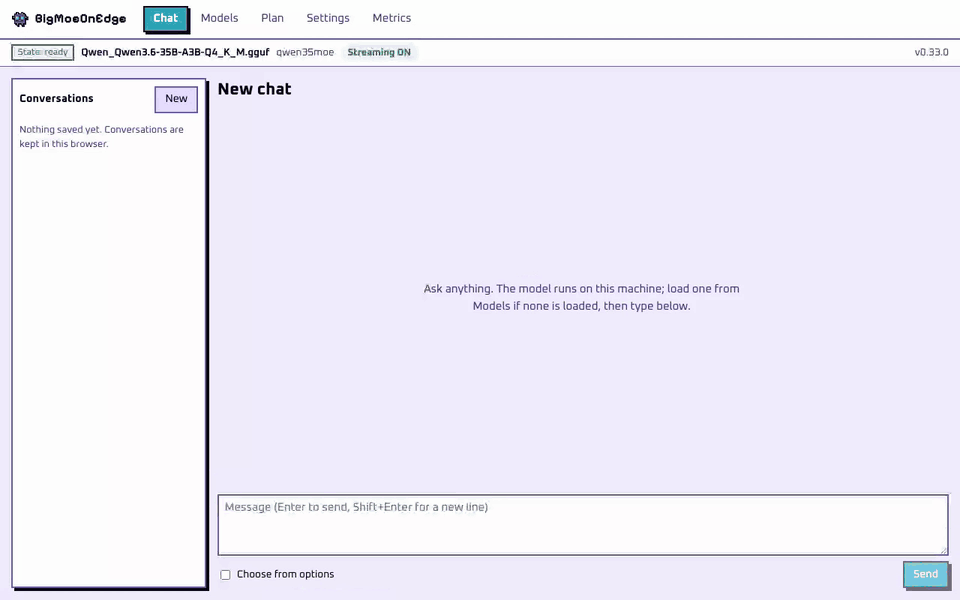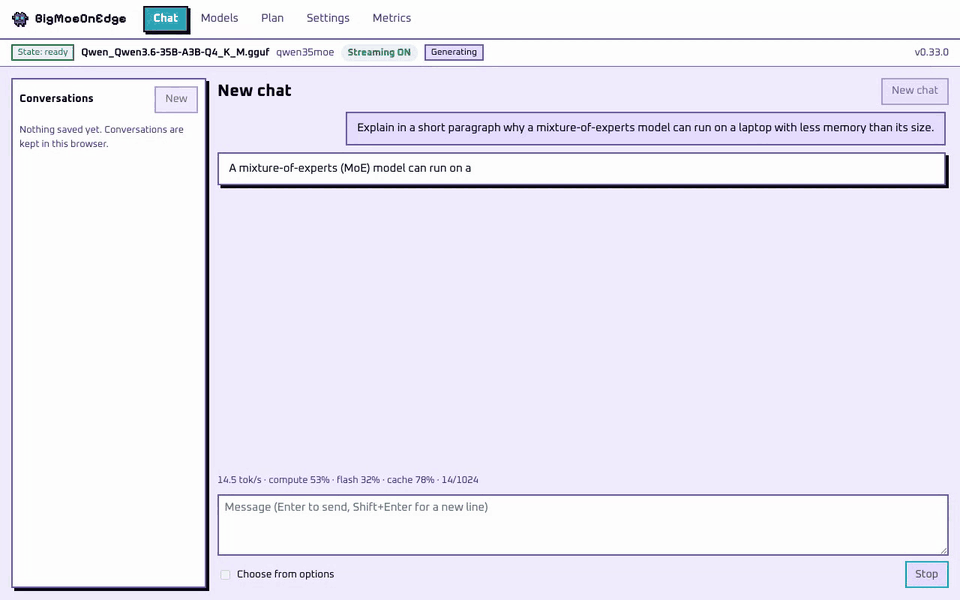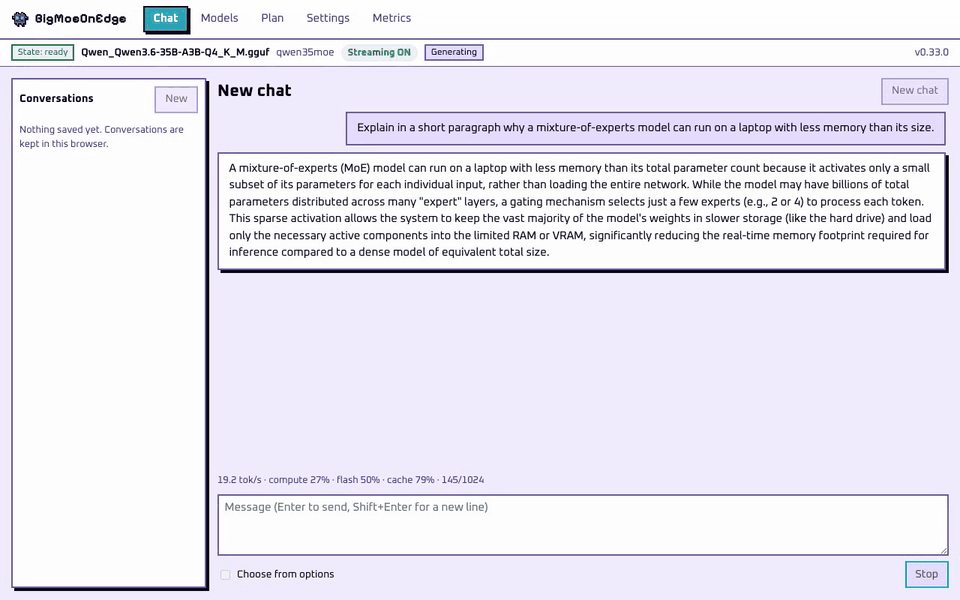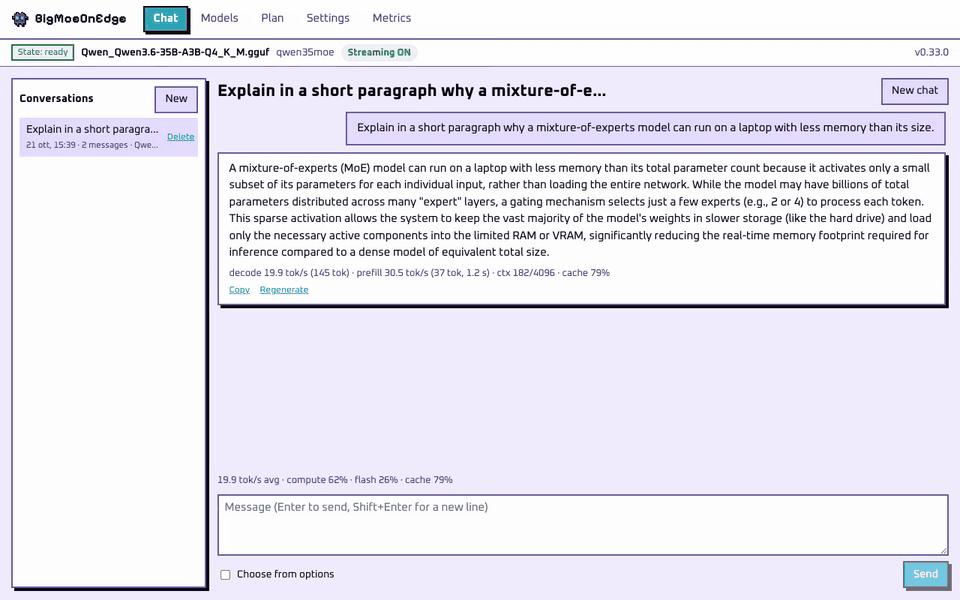
Portátil Apple silicon de 16 GB
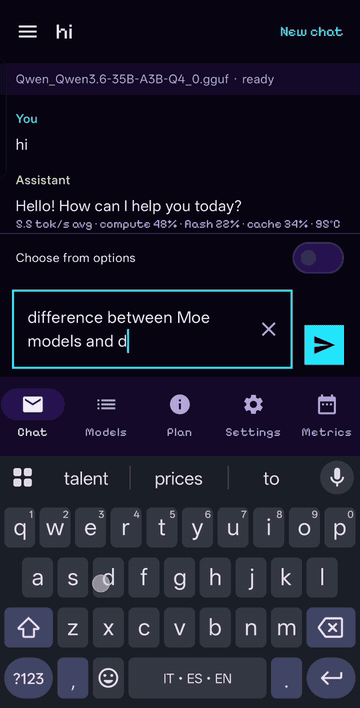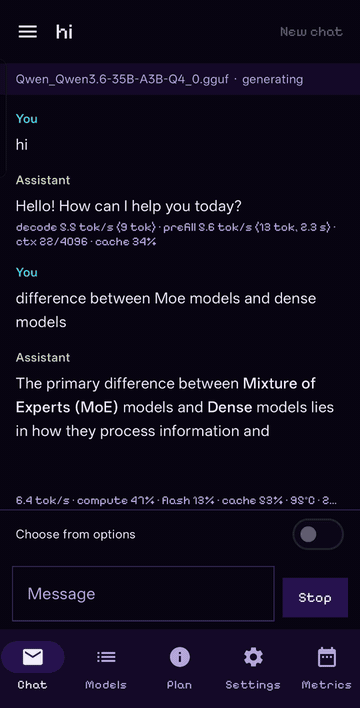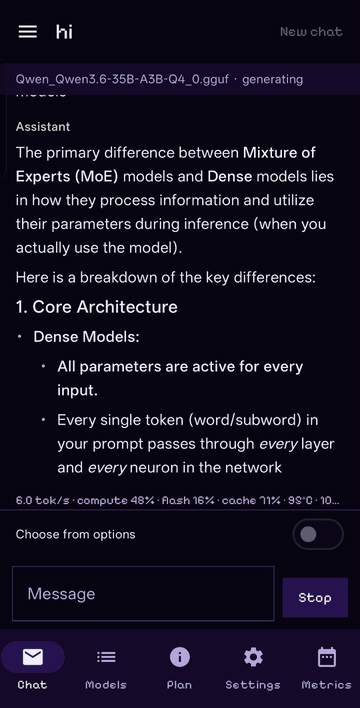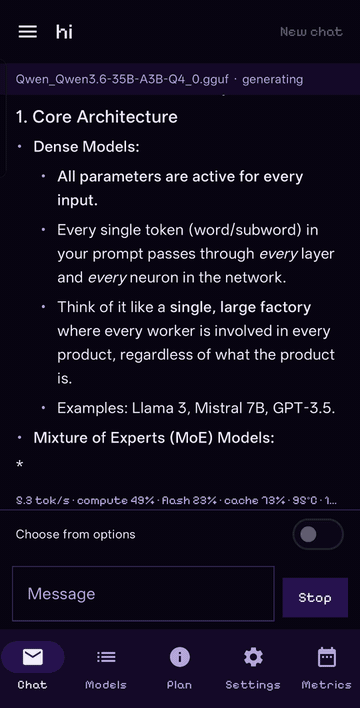
Qwen3.6-35B-A3B generando en cada dispositivo, en tiempo real, en las apps publicadas. El modelo es más grande
que la memoria de cada dispositivo.
## Descripción
Un modelo Mixture-of-Experts usa unos pocos de sus expertos para cada token. BigMoeOnEdge mantiene en memoria
los pesos que necesita cada token y una caché de los expertos usados recientemente, y lee los demás expertos de
la flash cuando el router los solicita. La salida es idéntica a ejecutar el modelo completamente en memoria;
los tests lo comprueban.
- **Planificador.** `--auto` mide la máquina (memoria disponible, velocidad del almacenamiento, cada CPU, GPU y
NPU) y la cabecera del modelo, y luego fija el tamaño de la caché, qué permanece residente y qué dispositivo ejecuta
el prompt y cuál la respuesta. Sus reglas no nombran ninguna plataforma ni dispositivo. Los ajustes indicados a mano se
respetan.
- **Modelos.** Cualquier gguf MoE que cargue llama.cpp, en cualquier cuantización. Los tensores de expertos se localizan a partir del
archivo, así que una arquitectura nueva no necesita código aquí.
- **Backends.** CPU, Metal, Vulkan, OpenCL y Hexagon NPU, cargados como módulos; los módulos CUDA, HIP y SYCL
compilados con sus propias toolchains se cargan de la misma forma.
- **Apps y servidor.** Apps nativas en Android e iOS, una app web en el escritorio y un
servidor compatible con OpenAI en todos ellos.
## Rendimiento
Velocidad de decodificación, medida en los dispositivos siguientes. El motor se dimensiona según la máquina, así que un hardware
más potente funciona más rápido.
| Modelo | En disco | Dispositivo | Modelo / RAM | Decodificación |
|---|---:|---|---:|---:|
| DeepSeek V4 Flash 284B | 91 GB | Teléfono Android de 12 GB | 7.6× | 0.94 tok/s |
| Qwen3.8-Flash-Next 125B | 80 GB | Teléfono Android de 12 GB | 6.7× | 2.2-3.5 tok/s |
| gpt-oss-120b | 60 GB | Teléfono Android de 12 GB | 5× | 1.3 tok/s |
| Qwen3.6-35B-A3B | 21 GB | Teléfono Android de 12 GB | 1.9× | 4.8-5.0 tok/s |
| Qwen3.6-35B-A3B | 21 GB | iPhone de 12 GB | 1.9× | 2.6-3.0 tok/s |
| Qwen3-30B-A3B | 18.5 GB | Teléfono Android de 12 GB | 1.5× | 5.2 tok/s |
| Gemma-4-26B-A4B | 17 GB | Teléfono Android de 12 GB | 1.4× | 4.1 tok/s |
| Qwen3.8-Flash-Next 125B | 76 GB | Portátil Apple silicon de 16 GB | 4.8× | 6.5-9 tok/s |
| Qwen3.6-35B-A3B | 21 GB | Portátil Apple silicon de 16 GB | 1.3× | 18-24 tok/s |
| Qwen3-Coder-30B-A3B | 18.6 GB | Portátil Apple silicon de 16 GB | 1.2× | 23 tok/s; 7-9 dentro de opencode |
| Qwen3.6-35B-A3B | 21 GB | Portátil Windows de 16 GB | 1.3× | 4.8 tok/s |
Configuraciones y método: [docs/benchmarks.md](docs/benchmarks.md). Para añadir una máquina, ejecuta
`scripts/bench-report.sh /path/to/model.gguf` y pega la tabla en un
[informe de benchmark](https://github.com/Helldez/BigMoeOnEdge/issues/new?template=benchmark-report.yml).
## Inicio rápido
**Android.** Instala el APK desde la [última versión](https://github.com/Helldez/BigMoeOnEdge/releases/latest)
y elige un modelo en **Models**. **Settings → Serve on the network** lo comparte, con una clave.
**iOS.** Compila la app con Xcode desde [examples/ios](examples/ios/README.md). Experimental.
**Escritorio (macOS, Windows, Linux).** Descarga el archivo `bmoe-desktop` de la misma versión y ejecuta
`bmoe-server --open`; la app se abre en `http://127.0.0.1:8765/`.
**Línea de comandos.**
```bash
bmoe-cli -m model.gguf --auto -p "Explain MoE routing." # measure, plan, run
bmoe-cli -m model.gguf --plan # print the plan and exit
```
## Servidor compatible con OpenAI
```python
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8765/v1", api_key="local")
reply = client.chat.completions.create(
model="local",
messages=[{"role": "user", "content": "Write a haiku about experts on flash."}],
)
print(reply.choices[0].message.content)
```
Se admiten streaming, llamadas a herramientas y razonamiento. Para opencode, añade el servidor como
proveedor compatible con OpenAI con `baseURL` igual a `http://127.0.0.1:8765/v1`. Para dar servicio a otras máquinas,
inicia el servidor con `--host` y `--api-key`. Referencia de la API: [docs/server-api.md](docs/server-api.md).
## Cómo funciona
El motor usa la API pública de llama.cpp: toda cuantización, tokenizador y plantilla de chat que llama.cpp
admite funciona sin cambios, y actualizar llama.cpp es un bump del submódulo. Los expertos enrutados se leen
según la disposición de tensores del archivo ([docs/which-models-stream.md](docs/which-models-stream.md)).
`ctest` comprueba que la salida en streaming es igual a la salida totalmente residente a través de la caché, los desalojos,
el solapamiento, las sesiones y los modelos divididos ([docs/architecture.md](docs/architecture.md)).
## El planificador
El planificador lee la forma del modelo desde su cabecera y mide la máquina. Las mismas reglas dan a un
teléfono y a un portátil planes distintos. La pantalla Plan muestra el resultado: adónde va la memoria, qué hace
cada dispositivo y el motivo de cada decisión.
[docs/hardware-planning.md](docs/hardware-planning.md).
## Plataformas
| | Android | macOS | Windows | Linux | iOS |
|---|---|---|---|---|---|
| Motor y CLI | arm64 | Apple silicon | x86_64 | x86_64, aarch64 | arm64 (dentro de la app) |
| App y servidor | app nativa | app web | app web | app web | app nativa, compilada desde el código fuente |
| Aceleradores | Hexagon NPU, Vulkan, OpenCL | Metal | Vulkan | Vulkan | Metal |
| Ejecutado en hardware | teléfono de 12 GB | portátil de 16 GB | portátil de 16 GB | CI, comunidad | iPhone de 12 GB ([#235](https://github.com/Helldez/BigMoeOnEdge/issues/235)) |
Detalles y qué se midió dónde: [docs/platforms.md](docs/platforms.md).
## Compilar desde el código fuente
```bash
git clone --recursive https://github.com/Helldez/BigMoeOnEdge.git
cd BigMoeOnEdge
cd ui && npm ci && npm run build && cd ..
scripts/build-host.sh
build/bin/bmoe-server --open
```
Tests: `cd build && ctest --output-on-failure` (requiere `python3` con el paquete `gguf`). Android:
`scripts/build-android.ps1`, y luego el APK en [`examples/android`](examples/android).
[CONTRIBUTING.md](CONTRIBUTING.md).
## Documentación
[docs/](docs/README.md), indexada por tarea. Empieza por [hardware-planning.md](docs/hardware-planning.md),
[settings.md](docs/settings.md), [server-api.md](docs/server-api.md),
[platforms.md](docs/platforms.md) y [limitations.md](docs/limitations.md).
## Trabajos previos
AirLLM, *LLM in a flash* de Apple, FlexGen, PowerInfer y EdgeMoE. El trabajo reciente más cercano es
[flash-moe](https://github.com/danveloper/flash-moe), un motor Metal que lee en streaming un MoE de 397B desde SSD
en Apple silicon; BigMoeOnEdge usa la API pública de llama.cpp en distintas arquitecturas y plataformas.
## Licencia
Apache-2.0. Consulta [LICENSE](LICENSE).