Questa è una traduzione; il README in inglese è il riferimento e potrebbe essere più aggiornato.
Esegui modelli Mixture-of-Experts più grandi della memoria del dispositivo leggendo gli esperti in streaming dalla flash.
Costruito sull'API pubblica di llama.cpp; Android, iOS, macOS, Windows e Linux; un server locale
compatibile OpenAI su ciascuno.
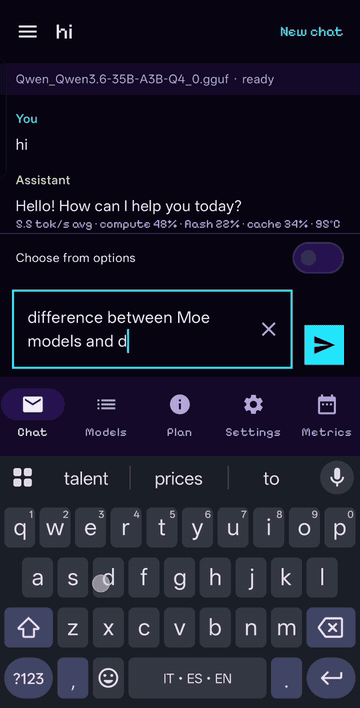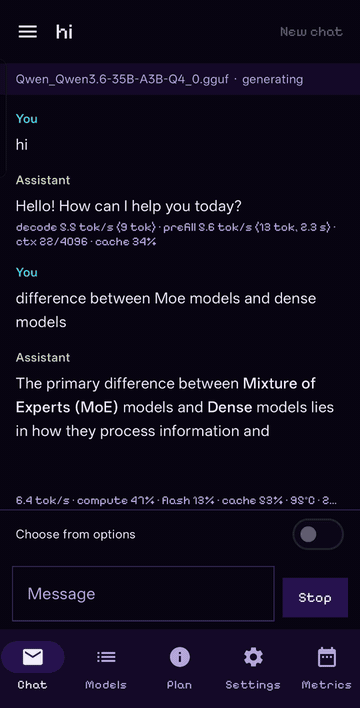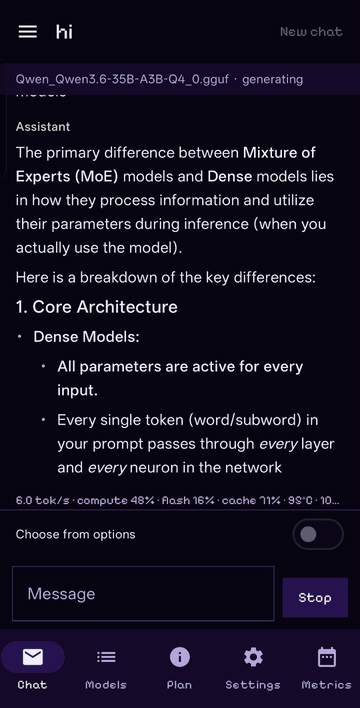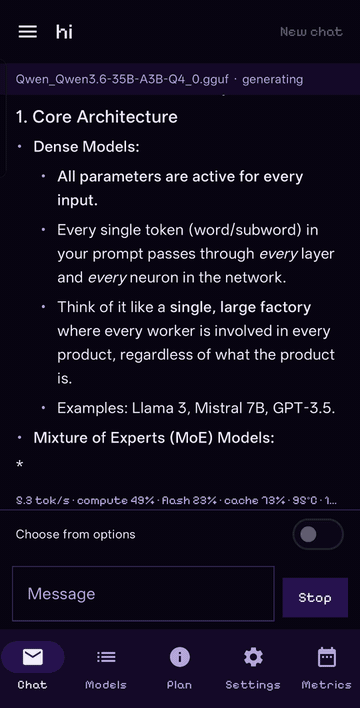
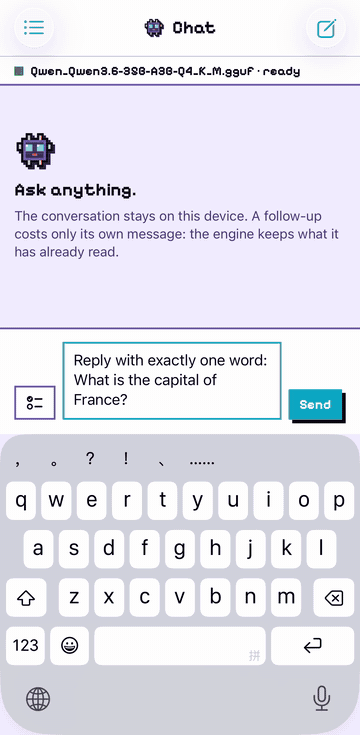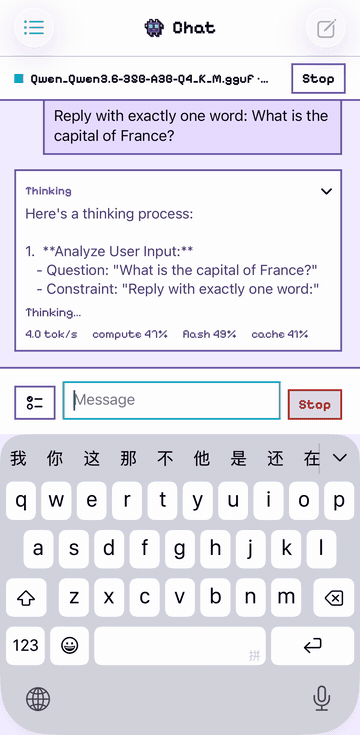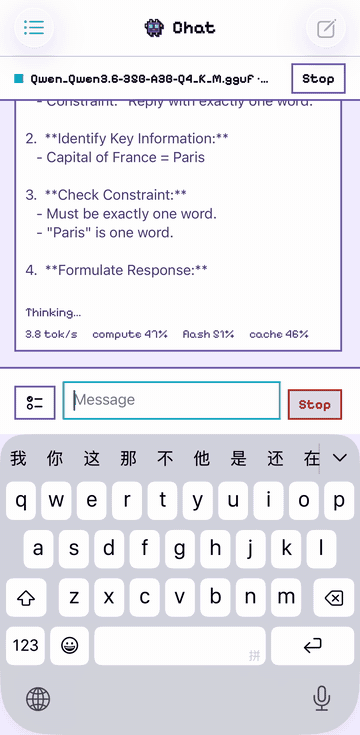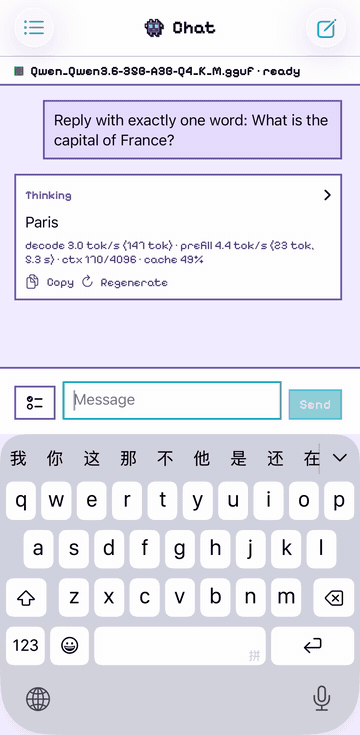
Telefono Android da 12 GB
iPhone da 12 GB
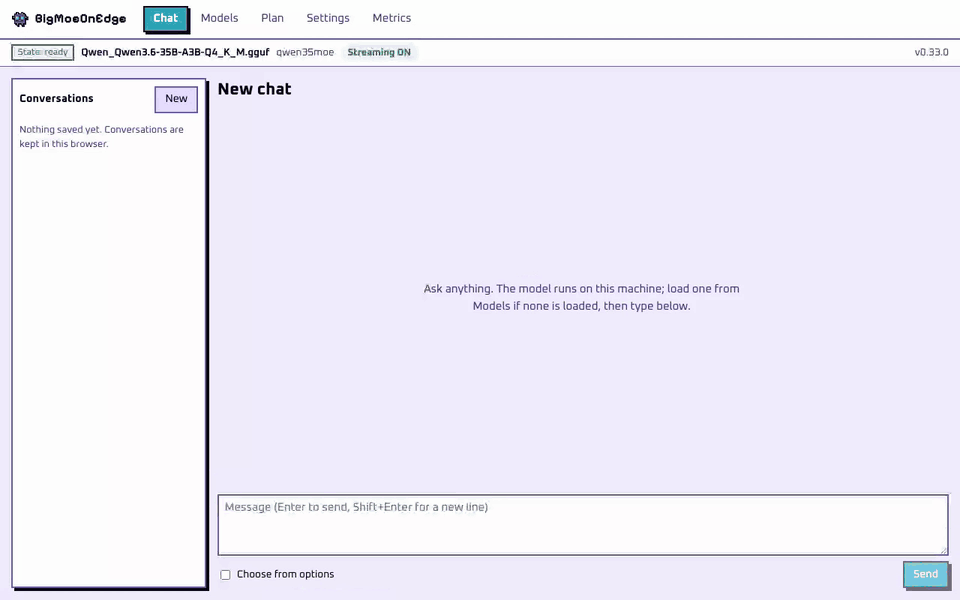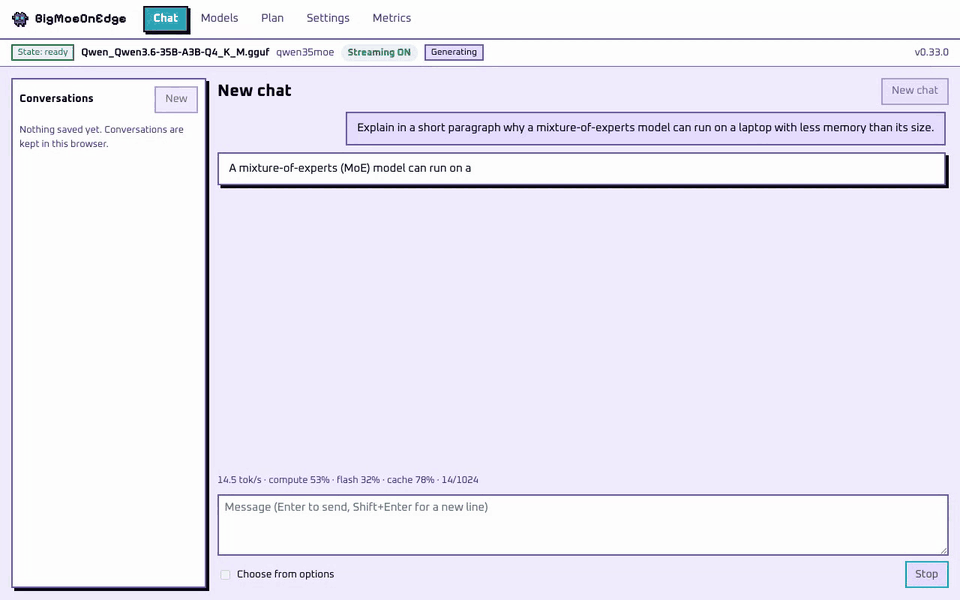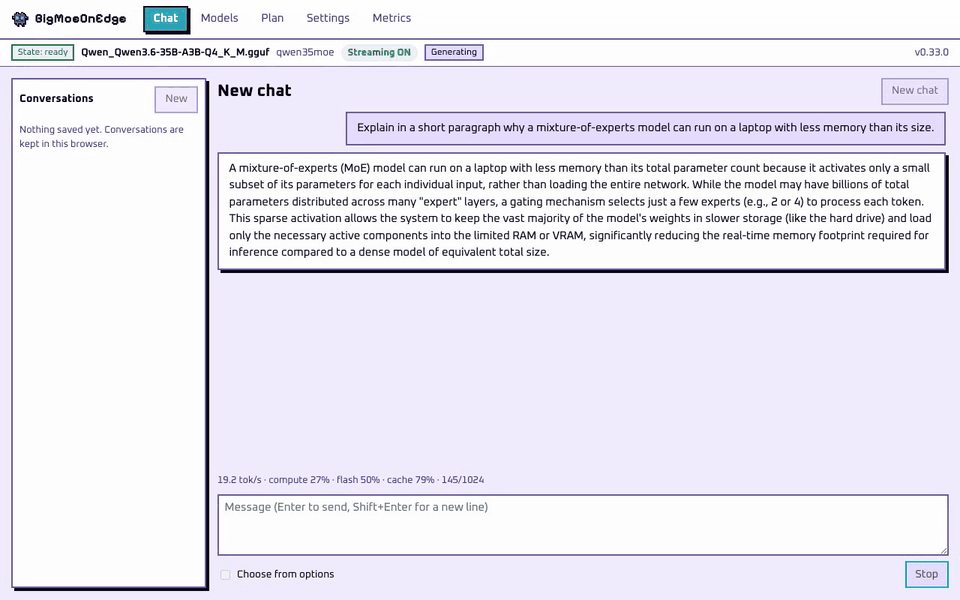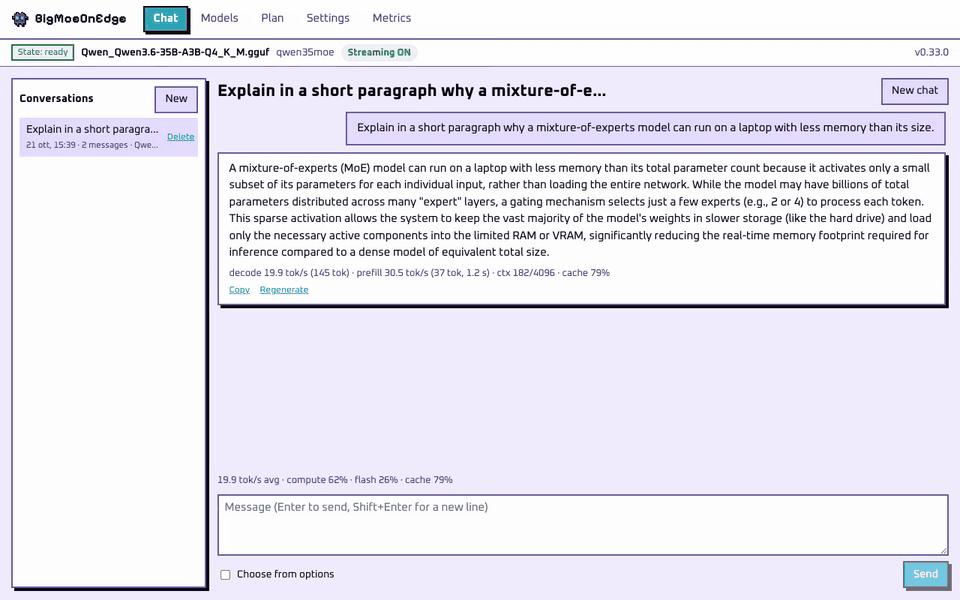
Portatile Apple silicon da 16 GB
Qwen3.6-35B-A3B in generazione su ciascun dispositivo, in tempo reale, nelle app distribuite. Il modello è più grande
della memoria di ciascun dispositivo.
## Descrizione
Un modello Mixture-of-Experts usa pochi dei suoi esperti per ogni token. BigMoeOnEdge tiene in memoria
i pesi che servono a ogni token e una cache degli esperti usati di recente, e legge gli altri esperti dalla
flash quando il router li richiede. L'output è identico a quello del modello eseguito interamente in memoria;
i test lo verificano.
- **Planner.** `--auto` misura la macchina (memoria disponibile, velocità dello storage, ogni CPU, GPU e
NPU) e l'header del modello, poi imposta la dimensione della cache, cosa resta residente, e quale dispositivo esegue
il prompt e quale la risposta. Le sue regole non nominano alcuna piattaforma o dispositivo. Le impostazioni date a mano
vengono mantenute.
- **Modelli.** Qualsiasi gguf MoE che llama.cpp carica, in qualsiasi quantizzazione. I tensori degli esperti vengono individuati dal
file, quindi una nuova architettura non richiede codice qui.
- **Backend.** CPU, Metal, Vulkan, OpenCL e Hexagon NPU, caricati come moduli; i moduli CUDA, HIP e SYCL
compilati con le rispettive toolchain si caricano allo stesso modo.
- **App e server.** App native su Android e iOS, una web app sul desktop, e un
server compatibile OpenAI su tutti.
## Prestazioni
Velocità di decodifica, misurata sui dispositivi qui sotto. Il motore si dimensiona sulla macchina, quindi un hardware
più potente va più veloce.
| Modello | Su disco | Dispositivo | Modello / RAM | Decodifica |
|---|---:|---|---:|---:|
| DeepSeek V4 Flash 284B | 91 GB | Telefono Android da 12 GB | 7.6× | 0.94 tok/s |
| Qwen3.8-Flash-Next 125B | 80 GB | Telefono Android da 12 GB | 6.7× | 2.2-3.5 tok/s |
| gpt-oss-120b | 60 GB | Telefono Android da 12 GB | 5× | 1.3 tok/s |
| Qwen3.6-35B-A3B | 21 GB | Telefono Android da 12 GB | 1.9× | 4.8-5.0 tok/s |
| Qwen3.6-35B-A3B | 21 GB | iPhone da 12 GB | 1.9× | 2.6-3.0 tok/s |
| Qwen3-30B-A3B | 18.5 GB | Telefono Android da 12 GB | 1.5× | 5.2 tok/s |
| Gemma-4-26B-A4B | 17 GB | Telefono Android da 12 GB | 1.4× | 4.1 tok/s |
| Qwen3.8-Flash-Next 125B | 76 GB | Portatile Apple silicon da 16 GB | 4.8× | 6.5-9 tok/s |
| Qwen3.6-35B-A3B | 21 GB | Portatile Apple silicon da 16 GB | 1.3× | 18-24 tok/s |
| Qwen3-Coder-30B-A3B | 18.6 GB | Portatile Apple silicon da 16 GB | 1.2× | 23 tok/s; 7-9 dentro opencode |
| Qwen3.6-35B-A3B | 21 GB | Portatile Windows da 16 GB | 1.3× | 4.8 tok/s |
Configurazioni e metodo: [docs/benchmarks.md](docs/benchmarks.md). Per aggiungere una macchina, esegui
`scripts/bench-report.sh /path/to/model.gguf` e incolla la tabella in un
[benchmark report](https://github.com/Helldez/BigMoeOnEdge/issues/new?template=benchmark-report.yml).
## Avvio rapido
**Android.** Installa l'APK dall'[ultima release](https://github.com/Helldez/BigMoeOnEdge/releases/latest)
e scegli un modello in **Models**. **Settings → Serve on the network** lo condivide, con una chiave.
**iOS.** Compila l'app con Xcode da [examples/ios](examples/ios/README.md). Sperimentale.
**Desktop (macOS, Windows, Linux).** Scarica l'archivio `bmoe-desktop` dalla stessa release ed esegui
`bmoe-server --open`; l'app si apre su `http://127.0.0.1:8765/`.
**Riga di comando.**
```bash
bmoe-cli -m model.gguf --auto -p "Explain MoE routing." # measure, plan, run
bmoe-cli -m model.gguf --plan # print the plan and exit
```
## Server compatibile OpenAI
```python
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8765/v1", api_key="local")
reply = client.chat.completions.create(
model="local",
messages=[{"role": "user", "content": "Write a haiku about experts on flash."}],
)
print(reply.choices[0].message.content)
```
Streaming, chiamate a strumenti e reasoning sono supportati. Per opencode, aggiungi il server come
provider compatibile OpenAI con `baseURL` impostato a `http://127.0.0.1:8765/v1`. Per servire altre macchine,
avvia il server con `--host` e `--api-key`. Riferimento API: [docs/server-api.md](docs/server-api.md).
## Come funziona
Il motore usa l'API pubblica di llama.cpp: ogni quantizzazione, tokenizer e chat template supportato da llama.cpp
funziona senza modifiche, e un aggiornamento di llama.cpp è un bump del submodule. Gli esperti instradati vengono letti
secondo il layout dei tensori del file ([docs/which-models-stream.md](docs/which-models-stream.md)).
`ctest` verifica che l'output in streaming sia uguale all'output interamente residente attraverso cache, evizioni,
overlap, sessioni e modelli suddivisi ([docs/architecture.md](docs/architecture.md)).
## Il planner
Il planner legge la forma del modello dal suo header e misura la macchina. Le stesse regole danno a un
telefono e a un portatile piani diversi. La schermata Plan mostra il risultato: dove va la memoria, cosa fa
ciascun dispositivo, e il motivo di ogni decisione.
[docs/hardware-planning.md](docs/hardware-planning.md).
## Piattaforme
| | Android | macOS | Windows | Linux | iOS |
|---|---|---|---|---|---|
| Motore e CLI | arm64 | Apple silicon | x86_64 | x86_64, aarch64 | arm64 (nell'app) |
| App e server | app nativa | web app | web app | web app | app nativa, compilata dai sorgenti |
| Acceleratori | Hexagon NPU, Vulkan, OpenCL | Metal | Vulkan | Vulkan | Metal |
| Eseguito su hardware | telefono da 12 GB | portatile da 16 GB | portatile da 16 GB | CI, community | iPhone da 12 GB ([#235](https://github.com/Helldez/BigMoeOnEdge/issues/235)) |
Dettagli e cosa è stato misurato dove: [docs/platforms.md](docs/platforms.md).
## Compilare dai sorgenti
```bash
git clone --recursive https://github.com/Helldez/BigMoeOnEdge.git
cd BigMoeOnEdge
cd ui && npm ci && npm run build && cd ..
scripts/build-host.sh
build/bin/bmoe-server --open
```
Test: `cd build && ctest --output-on-failure` (richiede `python3` con il pacchetto `gguf`). Android:
`scripts/build-android.ps1`, poi l'APK in [`examples/android`](examples/android).
[CONTRIBUTING.md](CONTRIBUTING.md).
## Documentazione
[docs/](docs/README.md), indicizzata per attività. Inizia da [hardware-planning.md](docs/hardware-planning.md),
[settings.md](docs/settings.md), [server-api.md](docs/server-api.md),
[platforms.md](docs/platforms.md) e [limitations.md](docs/limitations.md).
## Lavori precedenti
AirLLM, *LLM in a flash* di Apple, FlexGen, PowerInfer ed EdgeMoE. Il lavoro recente più vicino è
[flash-moe](https://github.com/danveloper/flash-moe), un motore Metal che legge in streaming un MoE da 397B da SSD
su Apple silicon; BigMoeOnEdge usa l'API pubblica di llama.cpp su più architetture e piattaforme.
## Licenza
Apache-2.0. Vedi [LICENSE](LICENSE).