

English · 中文 · 日本語 · Español · Français · Italiano
> これは翻訳です。英語版 README が正であり、そちらの方が新しい場合があります。 エキスパートをフラッシュストレージからストリーミングすることで、デバイスのメモリより大きな Mixture-of-Experts モデルを実行します。 llama.cpp の公開 API の上に構築されており、Android、iOS、macOS、Windows、Linux に対応し、それぞれでローカルの OpenAI 互換サーバーを提供します。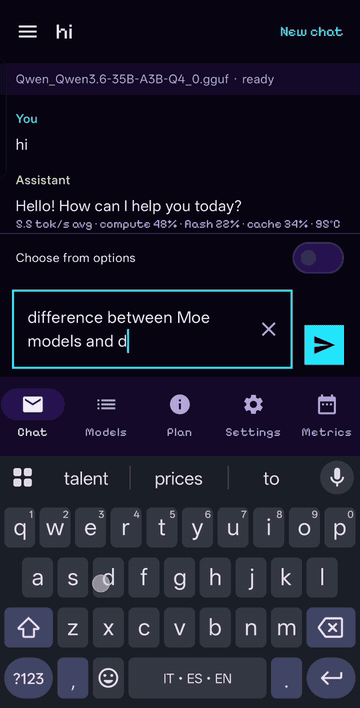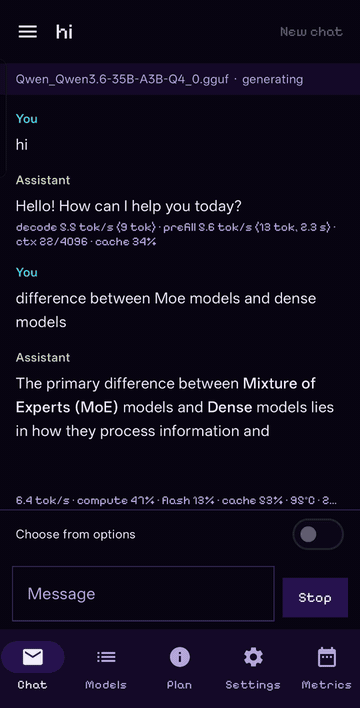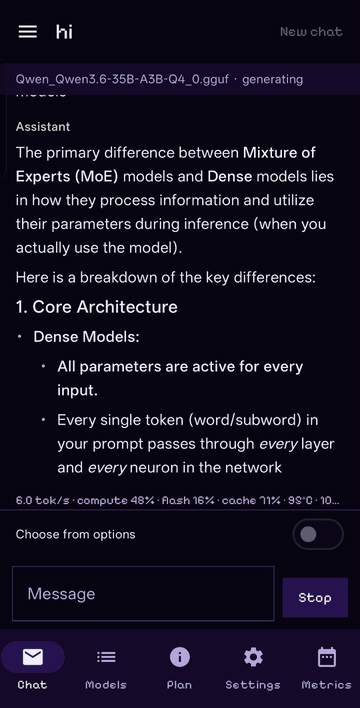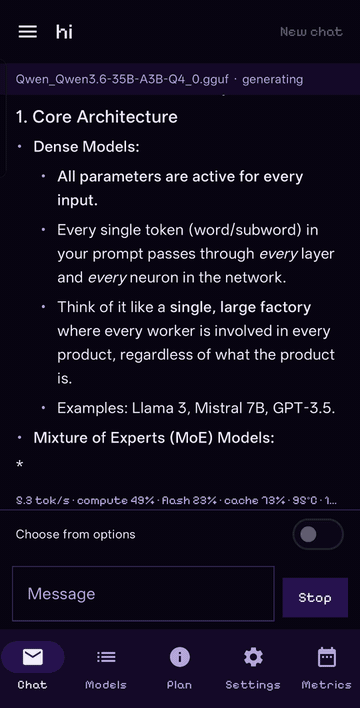 |
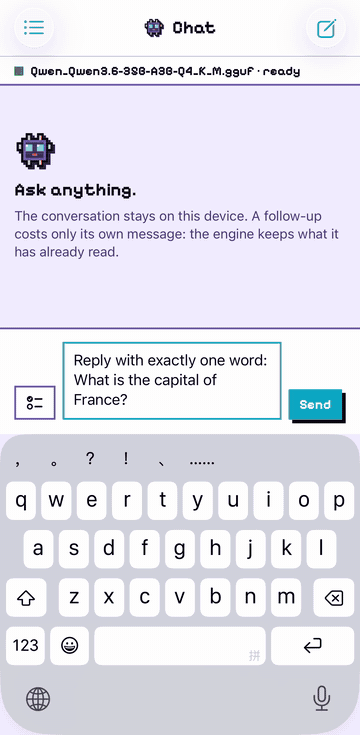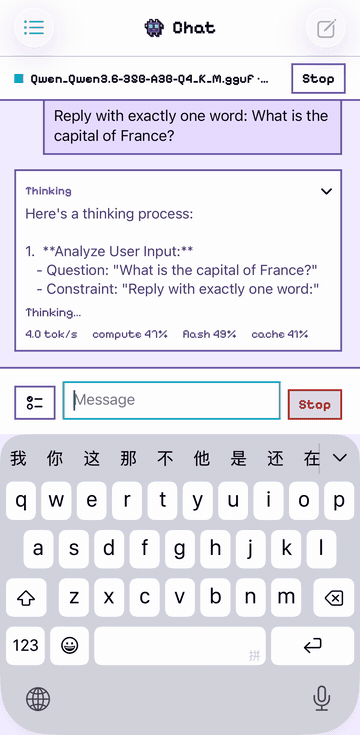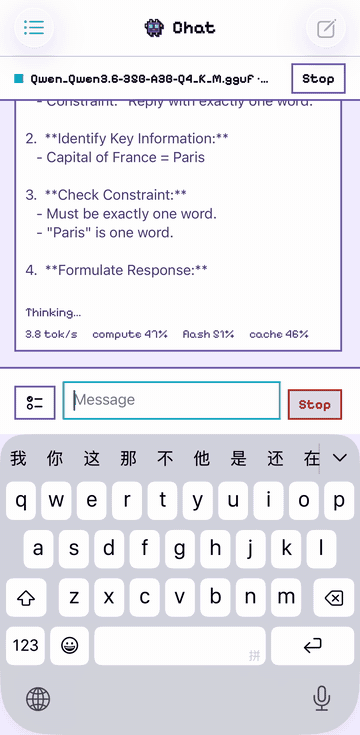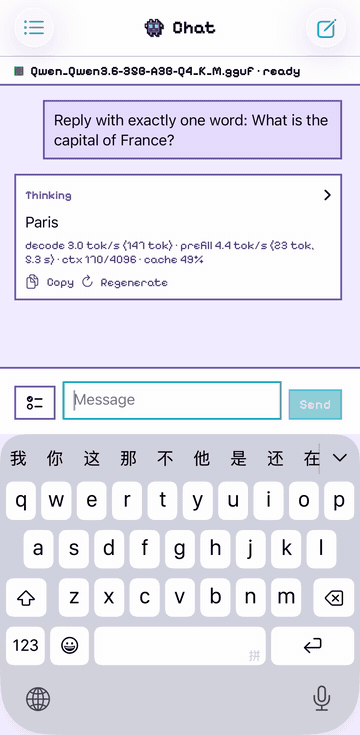 |
| 12 GB Android スマートフォン | 12 GB iPhone |
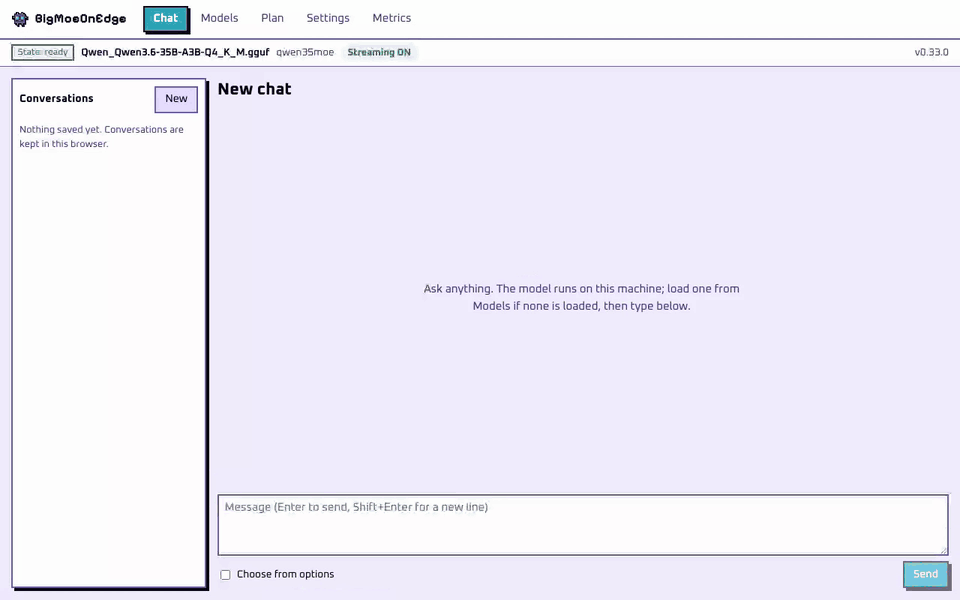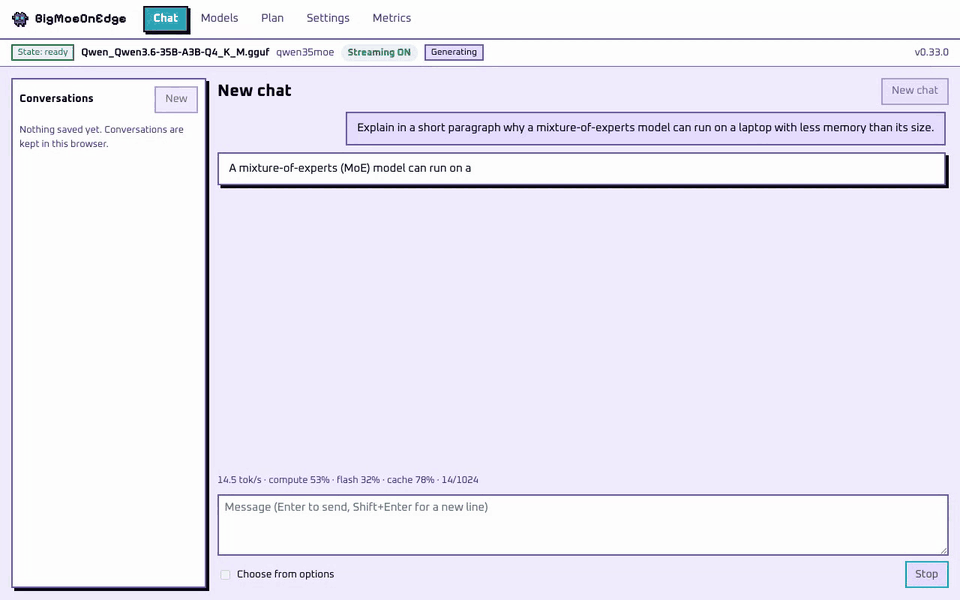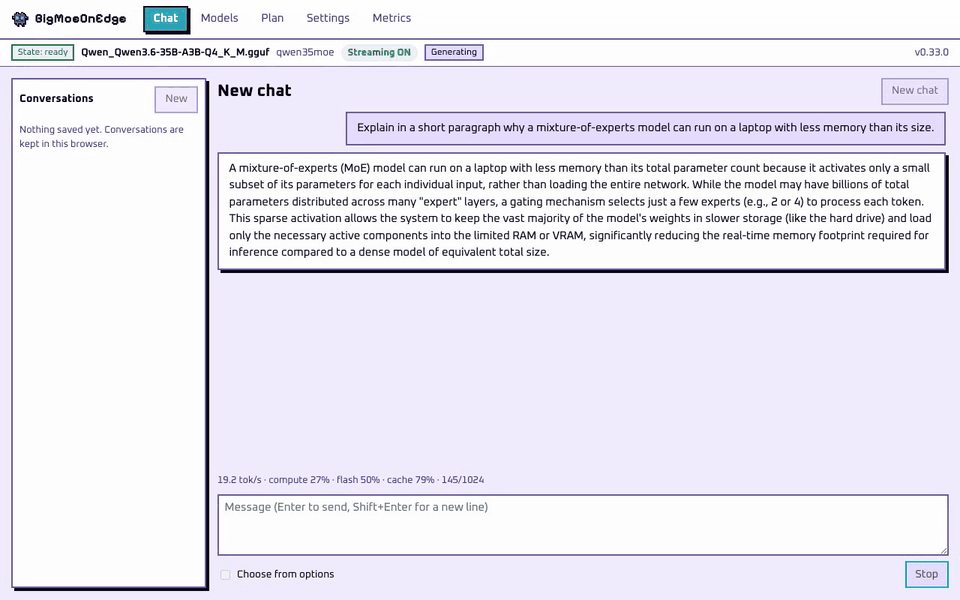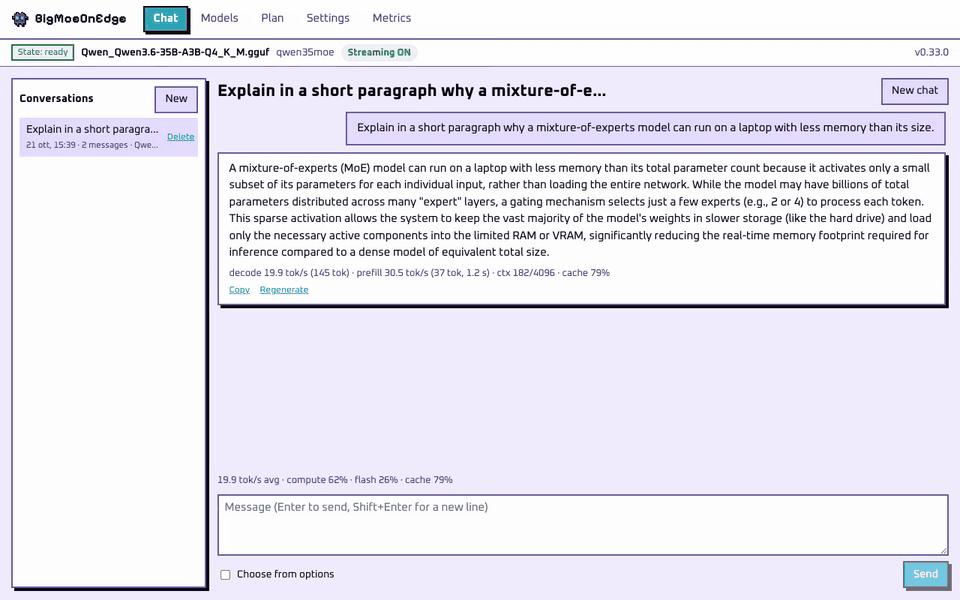 |
|
| 16 GB Apple silicon ノート PC | |


