Ceci est une traduction ; le README en anglais fait référence et peut être plus récent.
Exécutez des modèles Mixture-of-Experts plus grands que la mémoire de l'appareil en lisant les experts en streaming depuis la flash.
Construit sur l'API publique de llama.cpp ; Android, iOS, macOS, Windows et Linux ; un serveur local
compatible OpenAI sur chacun.
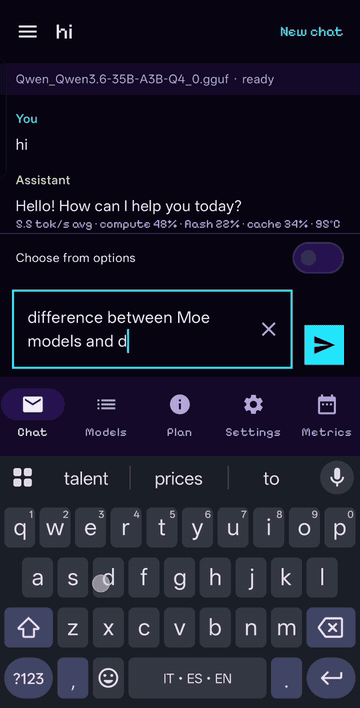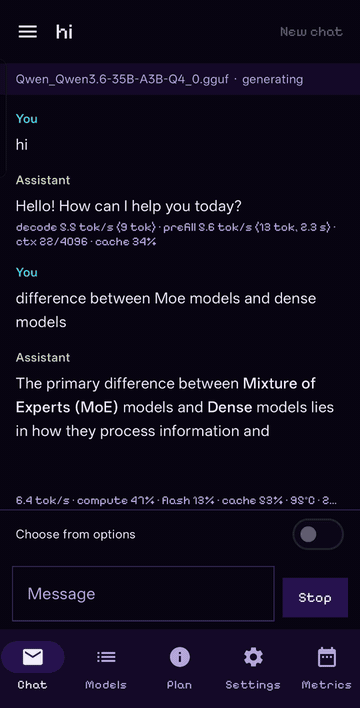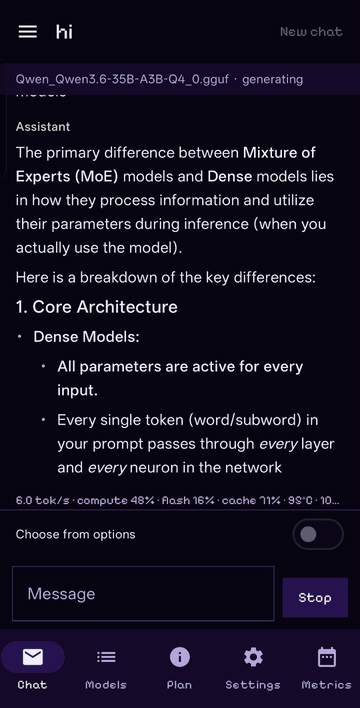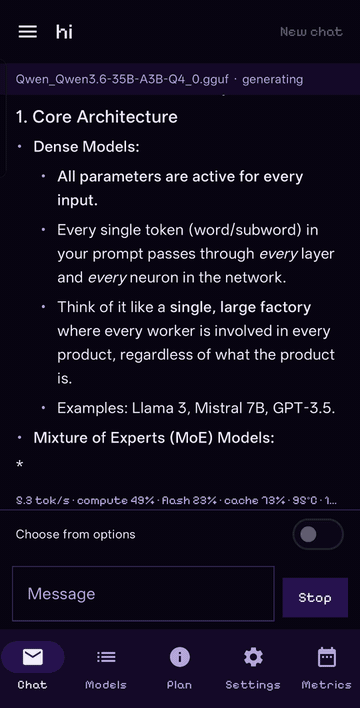
Téléphone Android de 12 GB
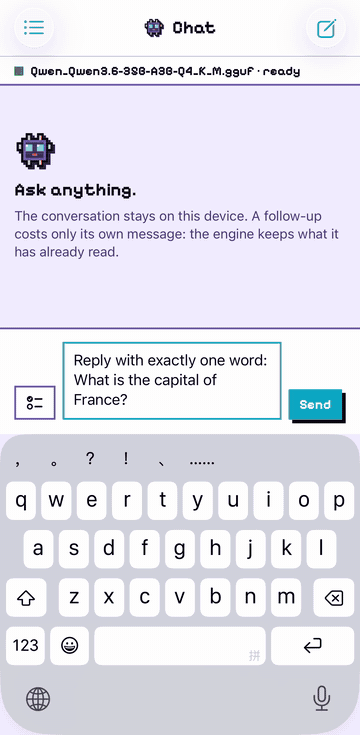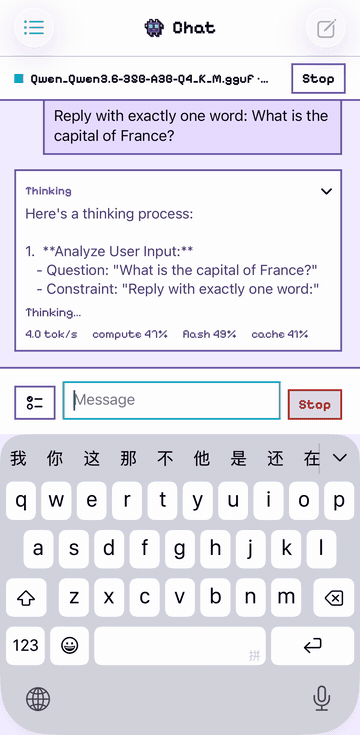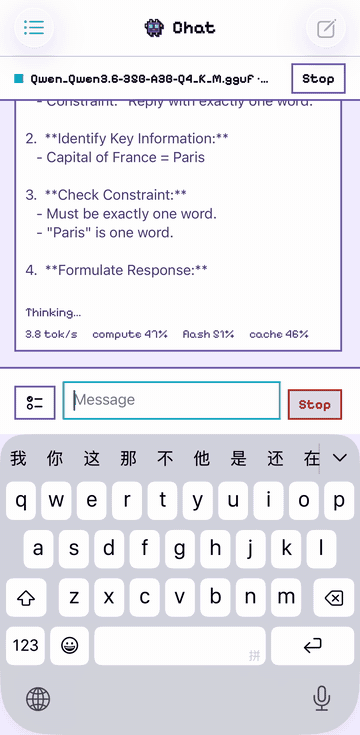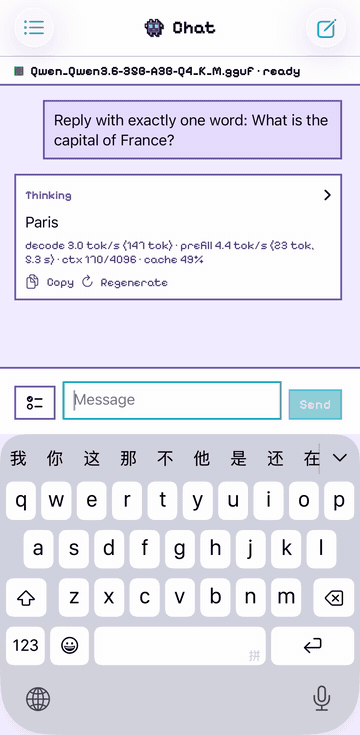
iPhone de 12 GB
Portable Apple silicon de 16 GB
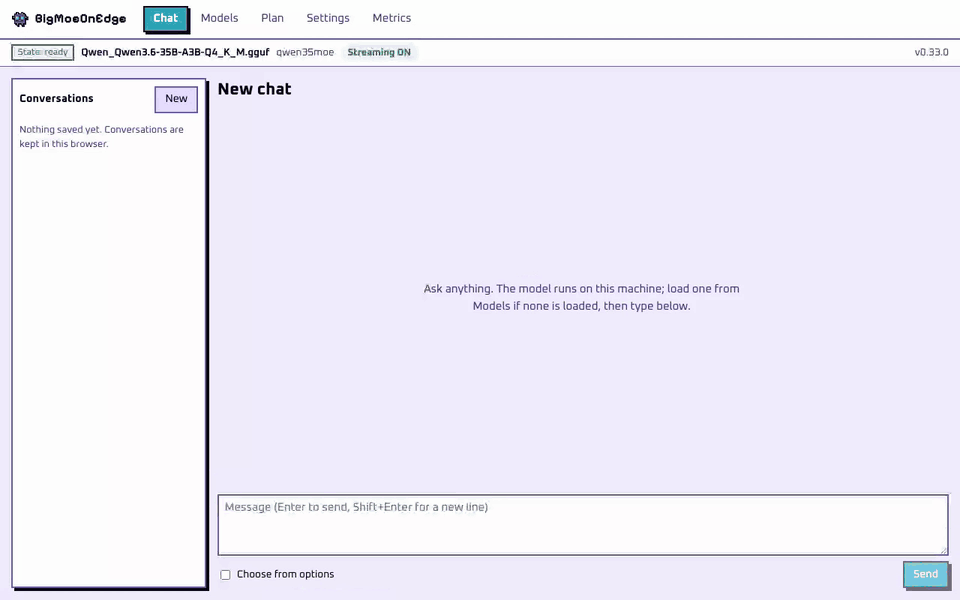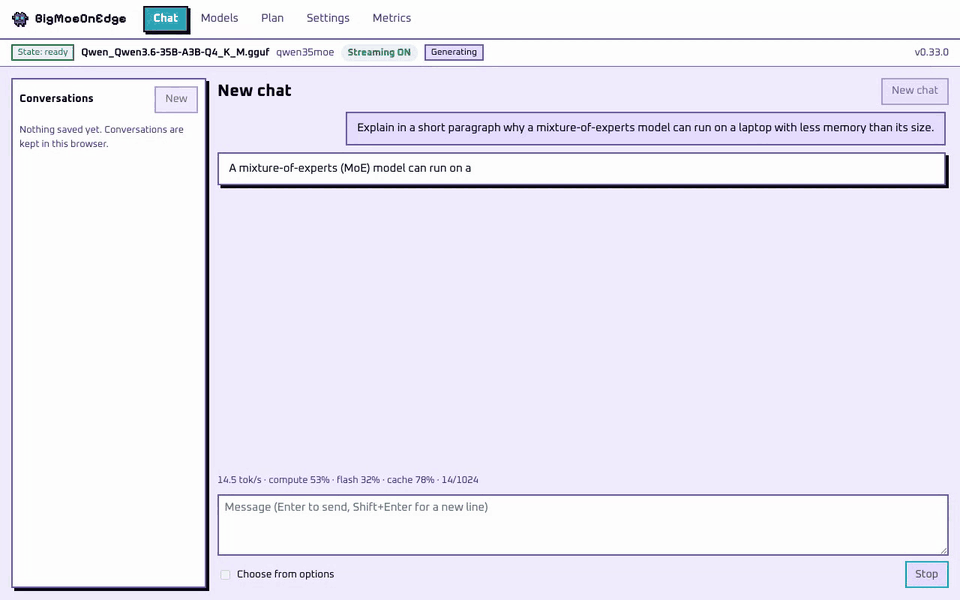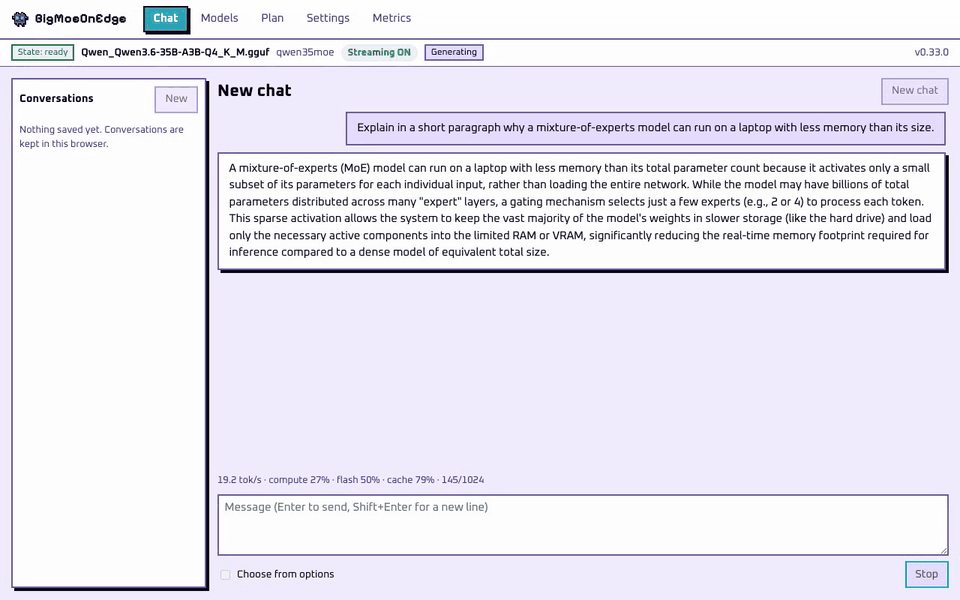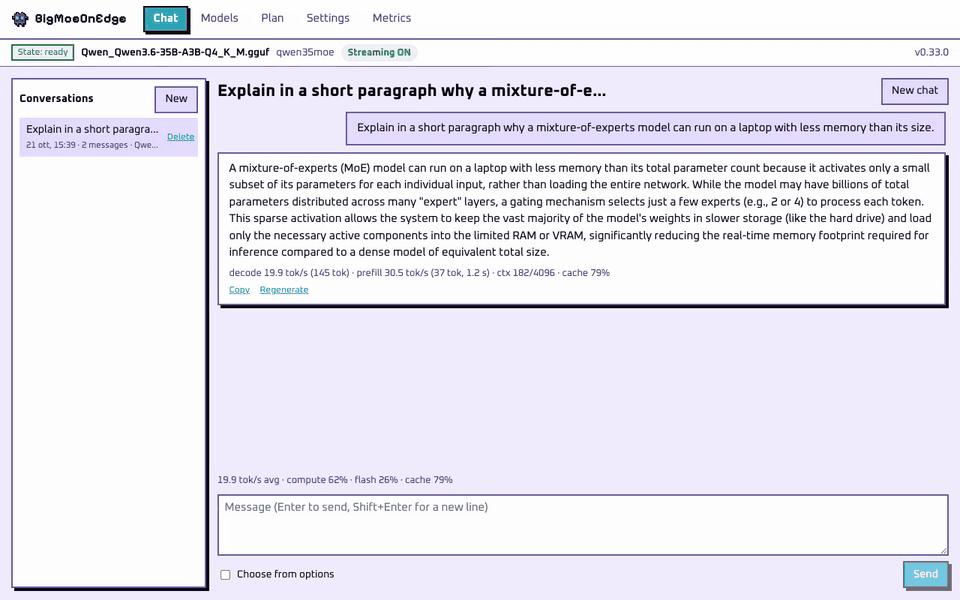
Qwen3.6-35B-A3B en génération sur chaque appareil, en temps réel, dans les applications publiées. Le modèle est plus grand
que la mémoire de chaque appareil.
## Description
Un modèle Mixture-of-Experts utilise quelques-uns de ses experts pour chaque token. BigMoeOnEdge garde en mémoire
les poids dont chaque token a besoin et un cache des experts récemment utilisés, et lit les autres experts depuis
la flash quand le routeur les demande. La sortie est identique à celle du modèle exécuté entièrement en mémoire ;
les tests le vérifient.
- **Planificateur.** `--auto` mesure la machine (mémoire disponible, vitesse du stockage, chaque CPU, GPU et
NPU) et l'en-tête du modèle, puis fixe la taille du cache, ce qui reste résident, et quel appareil exécute
le prompt et lequel la réponse. Ses règles ne nomment aucune plateforme ni aucun appareil. Les réglages donnés à la main sont
conservés.
- **Modèles.** Tout gguf MoE que llama.cpp charge, dans n'importe quelle quantification. Les tenseurs d'experts sont trouvés à partir du
fichier, donc une nouvelle architecture ne demande aucun code ici.
- **Backends.** CPU, Metal, Vulkan, OpenCL et Hexagon NPU, chargés comme modules ; les modules CUDA, HIP et SYCL
compilés avec leurs propres toolchains se chargent de la même façon.
- **Applications et serveur.** Applications natives sur Android et iOS, une application web sur le bureau, et un
serveur compatible OpenAI sur tous.
## Performances
Vitesse de décodage, mesurée sur les appareils ci-dessous. Le moteur se dimensionne selon la machine, donc un matériel
plus puissant va plus vite.
| Modèle | Sur disque | Appareil | Modèle / RAM | Décodage |
|---|---:|---|---:|---:|
| DeepSeek V4 Flash 284B | 91 GB | Téléphone Android de 12 GB | 7.6× | 0.94 tok/s |
| Qwen3.8-Flash-Next 125B | 80 GB | Téléphone Android de 12 GB | 6.7× | 2.2-3.5 tok/s |
| gpt-oss-120b | 60 GB | Téléphone Android de 12 GB | 5× | 1.3 tok/s |
| Qwen3.6-35B-A3B | 21 GB | Téléphone Android de 12 GB | 1.9× | 4.8-5.0 tok/s |
| Qwen3.6-35B-A3B | 21 GB | iPhone de 12 GB | 1.9× | 2.6-3.0 tok/s |
| Qwen3-30B-A3B | 18.5 GB | Téléphone Android de 12 GB | 1.5× | 5.2 tok/s |
| Gemma-4-26B-A4B | 17 GB | Téléphone Android de 12 GB | 1.4× | 4.1 tok/s |
| Qwen3.8-Flash-Next 125B | 76 GB | Portable Apple silicon de 16 GB | 4.8× | 6.5-9 tok/s |
| Qwen3.6-35B-A3B | 21 GB | Portable Apple silicon de 16 GB | 1.3× | 18-24 tok/s |
| Qwen3-Coder-30B-A3B | 18.6 GB | Portable Apple silicon de 16 GB | 1.2× | 23 tok/s ; 7-9 dans opencode |
| Qwen3.6-35B-A3B | 21 GB | Portable Windows de 16 GB | 1.3× | 4.8 tok/s |
Configurations et méthode : [docs/benchmarks.md](docs/benchmarks.md). Pour ajouter une machine, lancez
`scripts/bench-report.sh /path/to/model.gguf` et collez le tableau dans un
[rapport de benchmark](https://github.com/Helldez/BigMoeOnEdge/issues/new?template=benchmark-report.yml).
## Démarrage rapide
**Android.** Installez l'APK depuis la [dernière version](https://github.com/Helldez/BigMoeOnEdge/releases/latest)
et choisissez un modèle sous **Models**. **Settings → Serve on the network** le partage, avec une clé.
**iOS.** Compilez l'application avec Xcode depuis [examples/ios](examples/ios/README.md). Expérimental.
**Bureau (macOS, Windows, Linux).** Téléchargez l'archive `bmoe-desktop` de la même version et lancez
`bmoe-server --open` ; l'application s'ouvre sur `http://127.0.0.1:8765/`.
**Ligne de commande.**
```bash
bmoe-cli -m model.gguf --auto -p "Explain MoE routing." # measure, plan, run
bmoe-cli -m model.gguf --plan # print the plan and exit
```
## Serveur compatible OpenAI
```python
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8765/v1", api_key="local")
reply = client.chat.completions.create(
model="local",
messages=[{"role": "user", "content": "Write a haiku about experts on flash."}],
)
print(reply.choices[0].message.content)
```
Le streaming, les appels d'outils et le raisonnement sont pris en charge. Pour opencode, ajoutez le serveur comme
fournisseur compatible OpenAI avec `baseURL` défini sur `http://127.0.0.1:8765/v1`. Pour servir d'autres machines,
démarrez le serveur avec `--host` et `--api-key`. Référence de l'API : [docs/server-api.md](docs/server-api.md).
## Fonctionnement
Le moteur utilise l'API publique de llama.cpp : chaque quantification, tokenizer et modèle de chat que llama.cpp
prend en charge fonctionne sans modification, et une mise à jour de llama.cpp se résume à un bump du sous-module. Les experts routés sont lus
d'après la disposition des tenseurs du fichier ([docs/which-models-stream.md](docs/which-models-stream.md)).
`ctest` vérifie que la sortie en streaming est égale à la sortie entièrement résidente à travers le cache, les évictions,
le recouvrement, les sessions et les modèles découpés ([docs/architecture.md](docs/architecture.md)).
## Le planificateur
Le planificateur lit la forme du modèle dans son en-tête et mesure la machine. Les mêmes règles donnent à un
téléphone et à un portable des plans différents. L'écran Plan affiche le résultat : où va la mémoire, ce que fait
chaque appareil, et la raison de chaque décision.
[docs/hardware-planning.md](docs/hardware-planning.md).
## Plateformes
| | Android | macOS | Windows | Linux | iOS |
|---|---|---|---|---|---|
| Moteur et CLI | arm64 | Apple silicon | x86_64 | x86_64, aarch64 | arm64 (dans l'application) |
| Application et serveur | application native | application web | application web | application web | application native, compilée depuis les sources |
| Accélérateurs | Hexagon NPU, Vulkan, OpenCL | Metal | Vulkan | Vulkan | Metal |
| Exécuté sur du matériel | téléphone de 12 GB | portable de 16 GB | portable de 16 GB | CI, communauté | iPhone de 12 GB ([#235](https://github.com/Helldez/BigMoeOnEdge/issues/235)) |
Détails et ce qui a été mesuré où : [docs/platforms.md](docs/platforms.md).
## Compiler depuis les sources
```bash
git clone --recursive https://github.com/Helldez/BigMoeOnEdge.git
cd BigMoeOnEdge
cd ui && npm ci && npm run build && cd ..
scripts/build-host.sh
build/bin/bmoe-server --open
```
Tests : `cd build && ctest --output-on-failure` (nécessite `python3` avec le paquet `gguf`). Android :
`scripts/build-android.ps1`, puis l'APK dans [`examples/android`](examples/android).
[CONTRIBUTING.md](CONTRIBUTING.md).
## Documentation
[docs/](docs/README.md), indexée par tâche. Commencez par [hardware-planning.md](docs/hardware-planning.md),
[settings.md](docs/settings.md), [server-api.md](docs/server-api.md),
[platforms.md](docs/platforms.md) et [limitations.md](docs/limitations.md).
## Travaux antérieurs
AirLLM, *LLM in a flash* d'Apple, FlexGen, PowerInfer et EdgeMoE. Le travail récent le plus proche est
[flash-moe](https://github.com/danveloper/flash-moe), un moteur Metal qui lit en streaming un MoE de 397B depuis un SSD
sur Apple silicon ; BigMoeOnEdge utilise l'API publique de llama.cpp sur plusieurs architectures et plateformes.
## Licence
Apache-2.0. Voir [LICENSE](LICENSE).