Deep Researcher Agent
24/7 全自主深度学习实验 Agent
一个能 24/7 自主运行深度学习实验的 AI Agent 框架。
你睡觉,它炼丹。
English |
中文 |
日本語 |
한국어


---
> **第一次来?别慌。** 你不用读完整个README,只需要做一件事:
>
> 1. 打开 [`AI_GUIDE.md`](../AI_GUIDE.md),丢给 **Claude / ChatGPT / Codex**
> 2. AI 会一步步带你装好、配好、跑起第一个实验
> 3. 就这样。不焦虑,我们慢慢来。
>
> *想先了解原理?继续往下看。*
---
## 💛 写在最前:我们造它的初衷,以及希望大家怎么用它
> **我们的愿望很朴素:让学术保持纯粹,让人始终留在循环里。**
我们做这个框架,只有一个目的——把跑深度学习实验里那些**机械、重复**的环节(起任务、看 GPU、读日志、扫超参)从研究者身上拿掉,让大家把省下来的时间,留给**真正重要的事:思考**。
如果你来到这里,是因为想少花点时间盯训练,多花点时间读论文、想 idea、追自己的研究方向——欢迎你。这个工具就是为你做的。
**有一件事,想轻轻地拜托每一位使用者:**
Agent 很乐意替你把实验跑完,但请把 *idea*、*结果的解读* 和 *科学判断* 留给自己。我们不觉得"自动化"和"学术诚信"是对立的——恰恰相反,这个工具帮你省下来的时间,本意是让你**投入到更深的思考里**,而不是让你跳过思考本身。
所以我们想善意地请求大家:不要用这个项目去伪造结果、不要用它去"生成"完全没有人类参与的所谓研究、也不要用它去绕开那些真正需要一个人去理解、去判断的科研环节。那不是我们想帮忙建造的未来,我们也相信,那同样不是大多数你们想要的未来。
> **学术应当保持纯粹。Agent 可以替你跑实验,但 idea、判断与责任,请留给人来承担。**
>
> **Science should stay pure.** The agent can run the experiments — but the ideas, the interpretation, and the responsibility belong to the human. We genuinely hope every user will keep a **human in the loop for thinking**, and make their own real contribution in their own research direction.
>
> **科学は純粋であるべきです。** Agent は実験を走らせることができますが、アイデア・解釈・責任は、どうか人間の手に残してください。
我们相信每一个愿意拿起这个工具的人,都会认真对待这件事——也正是因为相信你们当中的大多数本来就是这样的人,我们才愿意把它开源出来。谢谢你成为其中之一。💛
---
## 痛点
现有的 AI 研究工具帮你**写论文**。Deep Researcher Agent 帮你**做实验**。
| 现有工具 | DAWN |
|:-:|:-:|
| 帮你写论文 | **自主运行实验** |
| 整理你的笔记 | **分析结果并迭代** |
| 帮你搜论文 | **形成假设并验证** |
| 你问它才动 | **24/7 不间断工作** |
```
你睡 8 小时 → DAWN 跑了 3 轮实验
你出去度假 → DAWN 探索了 50+ 组超参配置
你在写论文 → DAWN 已经把 results table 准备好了
```
### 实战验证的成果
> 这不是 benchmark,是真实项目中数月 24/7 自主运行的成果。
| 指标 | 数据 |
|------|------|
| 自主完成的实验循环 | 500+ 轮 |
| 单项目最佳指标提升 | 比基线提升 52%(200+ 次自动实验)|
| 同时管理的项目数 | 4 个项目,4 台 GPU 服务器 |
| 最长连续运行时间 | 30+ 天无需人工干预 |
| 24 小时平均 LLM 成本 | ~¥0.55 |
---
## 核心创新:零成本监控
24/7 跑 LLM Agent 很贵?DAWN 不会:
```
LLM 活跃 零成本 LLM 活跃
┌──────────┐ ┌──────────────┐ ┌──────────┐
│ THINK │ │ 训练 & 监控 │ │ REFLECT │
│ (5-10分) │ │ (数小时/天) │ │ (5-10分) │
│ │ │ │ │ │
│ • 分析 │ │ • 进程活着? │ │ • 解析 │
│ • 规划 │ │ • GPU利用率? │ │ 日志 │
│ • 写代码 │ │ • 读日志尾部 │ │ • 对比 │
│ │ │ │ │ • 决策 │
│ ¥0.35 │ │ ¥0.00 │ │ ¥0.20 │
└──────────┘ └──────────────┘ └──────────┘
↑
零 LLM API 调用
只做文件读取 +
进程存活检查
```
**训练 8 小时的一个完整周期,LLM 成本约 ¥0.55,而不是 ¥350+。**
---
## 架构设计
### THINK → EXECUTE → REFLECT 循环
```
┌──────────────────────────────────────────────┐
│ ┌──────────┐ ┌──────────┐ ┌──────────┐ │
│ │ THINK │→ │ EXECUTE │→ │ REFLECT │─┐ │
│ │ │ │ │ │ │ │ │
│ │ 分析现状 │ │ Dry-run │ │ 评估结果 │ │ │
│ │ 制定计划 │ │ 启动训练 │ │ 对比基线 │ │ │
│ │ 做出决策 │ │ 零成本监控│ │ 更新记忆 │ │ │
│ └──────────┘ └──────────┘ └──────────┘ │ │
│ ↑ │ │
│ └────────────────────────────────────┘ │
│ ↻ 24/7 循环 │
└──────────────────────────────────────────────┘
```
### Leader-Worker Agent 架构
```
┌───────────────┐
│ Leader │ 周期内保持对话历史
│ (决策者) │ 跨周期清空
└───┬───┬───┬───┘
│ │ │
┌───────┘ │ └───────┐
↓ ↓ ↓
┌──────────┐ ┌──────────┐ ┌──────────┐
│ Idea │ │ Code │ │ Writing │
│ Agent │ │ Agent │ │ Agent │
│ (5工具) │ │ (7工具) │ │ (4工具) │
└──────────┘ └──────────┘ └──────────┘
同一时间只有一个 Worker 活跃
其他 Worker 零 token 消耗
```
### v2.0 新增能力(2026-06-01)
- **仓库理解工具**:`search_code`(正则全仓搜索)、`list_tree`(递归目录树)、`read_file` 行区间读取(大文件不再被硬截断)。
- **文献工具**:`get_paper`(论文详情 + 引用/被引滚雪球)、`search_arxiv`(最新预印本)。
- **自治层(追加式、默认不改变行为)**:实验账本 `experiments.jsonl` · 停滞检测 · DEAD_ENDS/INSIGHTS 日志 · 违规扫描 · 阶段门 · 防烧钱限流(`max_cycles_per_hour`)。
- 所有信号注入到 THINK/REFLECT 规划上下文;本地与 SSH 行为一致;无需 GPU/联网即可跑全部单测。
### 两层记忆系统(恒定大小)
```
┌─────────────────────────────────────┐
│ 第一层: PROJECT_BRIEF.md │
│ • 冻结的项目参考(Agent 不可修改) │
│ • 上限 3,000 字符 │
├─────────────────────────────────────┤
│ 第二层: MEMORY_LOG.md │
│ • 关键成果(自动压缩到 1,200 字符)│
│ • 最近决策(只保留最近 15 条) │
│ • 上限 2,000 字符 │
├─────────────────────────────────────┤
│ 总计: ~5,000 字符 (~1,500 tokens) │
│ 无论运行多久,内存大小恒定不变 │
└─────────────────────────────────────┘
```
---
## 手把手教程(从零开始)
> **完全不会?** 跟着下面每一步走,10分钟从零到跑起来。
>
> **想让AI带你装?** 把 [`AI_GUIDE.md`](../AI_GUIDE.md) 丢给 Claude / ChatGPT / Codex,AI会交互式地一步步教你。
### 第 0 步:检查环境
| 需要什么 | 怎么检查 |
|---------|---------|
| Python 3.10+ | `python3 --version` |
| [Claude Code](https://claude.ai/claude-code) | `claude --version` |
| NVIDIA GPU (至少1块) | `nvidia-smi` |
| Anthropic API Key | `echo $ANTHROPIC_API_KEY` |
没有 API Key?去 [console.anthropic.com](https://console.anthropic.com/) 注册获取,然后设置:
```bash
export ANTHROPIC_API_KEY="sk-ant-xxxxx"
# 加到 ~/.bashrc 或 ~/.zshrc 里永久生效
```
### 第 1 步:安装
```bash
# 克隆仓库
git clone https://github.com/Xiangyue-Zhang/auto-deep-researcher-24x7.git
cd auto-deep-researcher-24x7
# 安装依赖
pip install -r requirements.txt
# 安装 7 个 Claude Code 斜杠命令
python install.py
# 验证
python -m core.loop --check
```
你会看到:
```
✓ /auto-experiment
✓ /experiment-status
✓ /gpu-monitor
✓ /daily-papers
✓ /paper-analyze
✓ /conf-search
✓ /progress-report
Done! 7 skills installed.
```
### 第 2 步:创建你的第一个项目
假设你想在 CIFAR-100 上训练 ResNet。先建一个项目文件夹:
```bash
mkdir ~/my-first-experiment
cd ~/my-first-experiment
```
然后写 `PROJECT_BRIEF.md` —— **这是最重要的文件**,告诉 Agent 你想干嘛:
```bash
cat > PROJECT_BRIEF.md << 'EOF'
# 目标
在 CIFAR-100 上训练 ResNet-50,测试准确率 >80%。
# 代码
Agent 从零开始写 PyTorch 训练代码。
- 用 torchvision 加载数据集(自动下载)
- 模型存到 ./checkpoints/
- 日志写到 ./logs/
# 尝试方向
- 先试基础 ResNet-50,lr=0.1,SGD,100 epochs
- 如果准确率 <75%,加 cosine annealing + warmup
- 如果 75-80%,加 mixup 或 cutout 数据增强
- 如果 >80%,目标达成
# 约束
- 只用 GPU 0
- 每次最多 100 epochs
- Batch size 128
# 当前状态
还没跑过任何实验,从零开始。
EOF
```
**写好 Brief 的技巧:**
- 目标要具体(指标 + 目标值)
- 说清楚代码/数据在哪(或者"从零写")
- 列出约束(哪块GPU、最多多少epochs)
- 给决策树("如果X,就试Y")—— 像指导研究生一样指导它
### 第 3 步:启动 Agent
**方法 A:在 Claude Code 里(推荐)**
打开 Claude Code 输入:
```
/auto-experiment --project ~/my-first-experiment --gpu 0
```
**方法 B:命令行**
```bash
python -m core.loop \
--project ~/my-first-experiment \
--gpu 0 \
--max-cycles 5 # 跑5轮就停(去掉则无限跑)
```
### 第 4 步:看它干活
Agent 现在全自动了。每一轮大概是这样的:
```
=== 第 1 轮 ===
[THINK] 读取 PROJECT_BRIEF.md...
目标:ResNet-50 CIFAR-100,>80%
没有历史实验,从 baseline 开始
计划:ResNet-50, lr=0.1, SGD + momentum, 100 epochs
[EXECUTE] 创建 train.py...
创建 config.yaml...
Dry-run (跑2步验证)... ✓ 没报错
启动训练:nohup python train.py --config config.yaml
PID: 12345,日志: logs/exp001.log
[MONITOR] 训练中...(零 LLM 成本)
15:00 — 进程活着,GPU 98%,Epoch 12/100,loss=2.34
15:15 — 进程活着,GPU 97%,Epoch 25/100,loss=1.87
...
18:00 — 进程结束,训练完成
[REFLECT] 解析日志... 测试准确率 = 76.3%
76.3% < 80% 目标
Brief 说 75-80% 应该加数据增强
决策:下一轮加 mixup (alpha=0.2) + cosine annealing
记录里程碑:"Exp001: ResNet-50 baseline, 76.3%"
=== 第 2 轮 ===
[THINK] 当前最佳:76.3%(Exp001)
计划:加 mixup + cosine annealing
...
```
### 第 5 步:随时查看进度
Agent 跑着的时候,你可以随时看:
```bash
# 在 Claude Code 里:
/experiment-status --project ~/my-first-experiment
# 或者看 GPU:
/gpu-monitor
```
会看到:
```
# 实验状态 — my-first-experiment
## 目标
## Human-in-the-Loop 实操指南
不要把 Agent 当成替代研究者的按钮,而要把它当成你来掌舵的实验操作员。
```text
人来决定:
- 目标
- 约束
- 禁止方向
- 什么时候转向
Agent 来执行:
- 改代码
- 跑实验
- 做监控
- 写总结
```
把稳定规则写进 `PROJECT_BRIEF.md`,把临时指令写进 `HUMAN_DIRECTIVE.md`。
```md
# HUMAN_DIRECTIVE.md
- 不要改数据集。
- 先试 label smoothing 0.1,再考虑换 backbone。
- 如果连续 3 次增益低于 0.3 个点,就停止这个方向。
- 和上一个可信 baseline 对比,不要只和最近一次结果对比。
```
Case 1:做干净 ablation
```md
- 只允许改 augmentation。
- 模型、优化器、训练预算保持不变。
- 每轮结束后输出一张干净的对比表。
```
Case 2:有意识地转方向
```md
- 当前 ResNet 路线已经接近平台期。
- 只有最近 3 次都没有明显提升,才切到 ViT-B/16。
- 切换前先写一段简短理由。
```
Case 3:结果可疑时
```md
- 这次准确率提升异常大。
- 用相同 seed 重跑一次,再换一个新 seed 再跑一次。
- 两次都复现之前,不要宣称改进成立。
```
一句话:重复劳动交给 Agent,方向、解释和责任留给人。
---
ResNet-50 on CIFAR-100 → 80%+
## 进度
- 已完成轮数:3
- 当前最佳:79.1%(Exp003: ResNet-50 + mixup + cosine)
- 状态:训练中(PID 12389, GPU 0, 已跑 1.5h)
## 关键结果
[04-07 15:00] Exp001: ResNet-50 baseline, 76.3%
[04-07 18:30] Exp002: + cosine annealing, 77.8%
[04-07 22:00] Exp003: + mixup α=0.2, 79.1% ← 最佳
```
### 第 6 步:随时介入
想换方向?三种方式:
```bash
# 方式 1:放一个文件(Agent 下一轮自动读取)
echo "别试 ResNet 了,换 ViT-B/16,lr=1e-3" \
> ~/my-first-experiment/workspace/HUMAN_DIRECTIVE.md
# 方式 2:命令行
python -m core.loop --project ~/my-first-experiment \
--directive "加 label smoothing 0.1"
# 方式 3:直接改记忆文件
vim ~/my-first-experiment/workspace/MEMORY_LOG.md
```
### 第 7 步:手机上看(可选)
装 [Happy Coder](https://happy.engineering/) ([iOS](https://apps.apple.com/us/app/happy-codex-claude-code-app/id6748571505) / [Android](https://play.google.com/store/apps/details?id=com.ex3ndr.happy)),在手机上监控 Agent:
```bash
# 装 CLI(一次性)
npm install -g happy-coder
# 用 happy 代替 claude 启动会话
happy
# 在会话里启动实验:
/auto-experiment --project ~/my-first-experiment --gpu 0
```
手机上你可以:
- **推送通知**:实验跑完或需要你决策时立刻通知
- **查看结果**:地铁上看最新指标
- **下指令**:告诉 Agent 换方向
- **无缝切换**:手机 ↔ 电脑一键切
### PROJECT_BRIEF.md 示例
Brief 是你最主要的控制方式。不同场景的写法:
示例:微调预训练模型
```markdown
# 目标
用 ImageNet-21K 预训练的 ViT-B/16 在 Flowers-102 上微调。
目标:测试准确率 >95%。
# 代码
- finetune.py(已有)
- 配置:configs/vit_flowers.yaml
- 数据:/data/flowers102/(已下载)
- 预训练权重:/models/vit-b16-21k.pth
# 尝试方向
1. 先冻结backbone,只训 classifier head(10 epochs, lr=1e-2)
2. 然后全部解冻微调(30 epochs, lr=1e-4)
3. 如果低于 93%:试 layer-wise lr decay (0.65)
4. 如果高于 94%:试 test-time augmentation
# 约束
- GPU 0,batch size 64
- 按 val accuracy 保存最佳 checkpoint
```
示例:超参搜索
```markdown
# 目标
给 GAN 找最佳超参,在 CelebA-HQ 256x256 上。
目标:FID < 15。
# 代码
- train_gan.py, configs/celeba_gan.yaml
- 数据:/data/celeba_hq_256/
- 评估:eval_fid.py --real_dir /data/celeba_hq_256/val
# 搜索空间
- Learning rate: [1e-4, 2e-4, 5e-4]
- Beta1: [0.0, 0.5]
- D steps / G step: [1, 2, 5]
- Spectral norm: [是, 否]
# 策略
从 lr=2e-4, beta1=0.0, d_steps=1, spectral_norm=是 开始。
每次只改一个变量。每组跑 50K steps。
# 约束
- GPU 0-1
- 每次最多 50K steps(约4小时)
```
示例:排查训练问题
```markdown
# 目标
排查 transformer 模型为什么 epoch 20 后 loss 爆炸。
现状:loss 在 epoch 20-25 从 0.5 飙到 NaN。
# 代码
- train_transformer.py, model/transformer.py
- configs/base.yaml
- 失败日志:logs/failed_run_001.log
# 排查方向
1. 查梯度 — 加 gradient clipping (max_norm=1.0)
2. 降学习率(现在 1e-3,试 1e-4, 5e-5)
3. 查具体哪层 — 加逐层梯度日志
4. 加 warmup (1000 steps)
5. 查数据 — 有没有 NaN/Inf
# 约束
- GPU 0,每次跑 30 epochs 就够
- 每 100 steps 记录梯度范数
```
### 常见问题
Q:跑一天花多少钱?
大约 $0.08(¥0.55)。秘密:训练期间零 LLM 调用。只有 THINK 和 REFLECT 阶段(各 ~10 分钟)才花钱。
Q:它能改我的代码吗?
能。Code Agent 可以读、写、修改项目里的任何文件。它会改完之后先 dry-run 验证,没问题再启动训练。不会动受保护的文件(PROJECT_BRIEF.md、MEMORY_LOG.md)。
Q:Agent 跑偏了怎么办?
放一个指令文件:`echo "停下。回到 ResNet 方案" > workspace/HUMAN_DIRECTIVE.md`。Agent 下一轮以最高优先级读取。
Q:能同时跑多个项目吗?
能。在不同终端/tmux session 里启动多个 Agent 实例,每个指向不同项目和 GPU。
Q:训练崩了怎么办?
Monitor 检测到进程挂了,会抓取错误日志交给 REFLECT。Agent 会分析崩溃原因、修复代码、重试。
Q:支持 PyTorch / TensorFlow / JAX 吗?
都支持。Agent 本质上是启动 shell 命令 + 读日志文件,不关心你用什么框架。
---
## 一键安装(Claude Code Skills)
所有功能打包为 Claude Code 斜杠命令,**一行安装:**
```bash
python install.py
```
安装后获得 **7 个斜杠命令**:
### 核心技能
| 命令 | 功能 |
|------|------|
| `/auto-experiment` | 启动 24/7 自主 THINK→EXECUTE→REFLECT 实验循环 |
| `/experiment-status` | 查看实验进度:指标、周期数、GPU 状态 |
| `/gpu-monitor` | GPU 快速检查:空闲/占用、显存、利用率 |
### 研究技能
| 命令 | 功能 |
|------|------|
| `/daily-papers` | arXiv 每日推荐,自动去重 |
| `/paper-analyze ` | 深度论文分析 + 从 arXiv 源码提取原图 |
| `/conf-search --venue CVPR2025` | 搜索 CVPR/NeurIPS/ICML/ICLR/AAAI... |
| `/progress-report` | 生成结构化实验进度报告 |
### 使用示例
```bash
# 安装(一次性)
python install.py
# 在 Claude Code 中启动实验循环
/auto-experiment --project /path/to/project --gpu 0
# 查看实验进度
/experiment-status
# 查看 GPU 状态
/gpu-monitor
# Agent 训练的时候你看论文
/daily-papers --topics "vision transformer"
```
### 卸载
```bash
python install.py --uninstall
```
---
## 与其他工具对比
| | Deep Researcher Agent | [Claude Scholar](https://github.com/Galaxy-Dawn/claude-scholar) | [AI Scientist](https://github.com/SakanaAI/AI-Scientist) | [OpenHands](https://github.com/All-Hands-AI/OpenHands) | [SWE-Agent](https://github.com/princeton-nlp/SWE-agent) |
|--|:--:|:--:|:--:|:--:|:--:|
| **自主运行实验** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **零成本训练监控** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **GPU 管理** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **24/7 持续运行** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **恒定大小记忆** | ✅ | ❌ | ❌ | ❌ | ❌ |
| 论文写作 | 基础 | ✅ | ✅ | ❌ | ❌ |
| 知识管理 | 基础 | ✅ | ❌ | ❌ | ❌ |
| 通用编程 | ❌ | ❌ | ❌ | ✅ | ✅ |
**唯一一个为"跑"深度学习实验而设计的框架,不是为"写"。**
---
## 引用
```bibtex
@software{auto_deep_researcher_24x7,
title={Deep Researcher Agent: Autonomous Deep Learning Experiment Framework},
author={Xiangyue Zhang},
year={2026},
url={https://github.com/Xiangyue-Zhang/auto-deep-researcher-24x7}
}
```
## Star History
[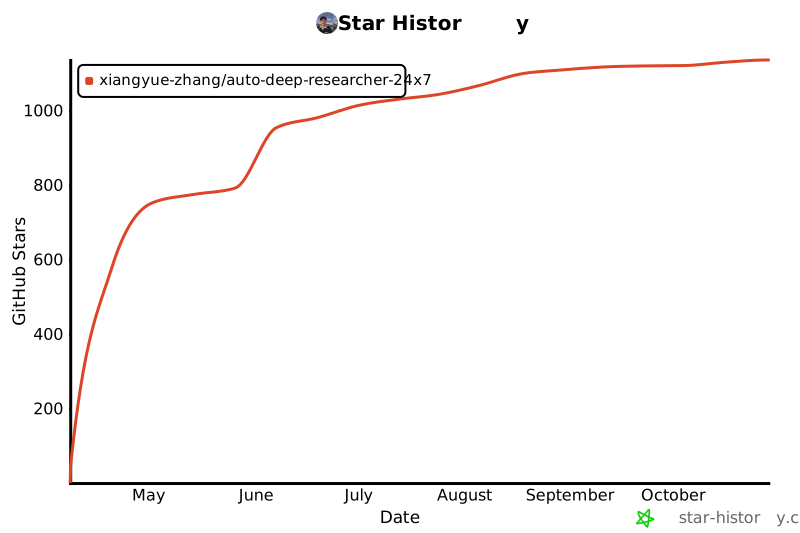](https://www.star-history.com/#Xiangyue-Zhang/auto-deep-researcher-24x7&Date)
## 协议
Apache 2.0 — 详见 [LICENSE](../LICENSE)
---
"实验通宵运行,结果黎明到来。"