Deep Researcher Agent
24/7 自律型深層学習実験エージェント
深層学習の実験を24時間365日自律的に実行するAIエージェントフレームワーク。
あなたが寝ている間に、実験が進む。
English |
中文 |
日本語 |
한국어


---
> **初めての方?ご安心ください。** READMEを全部読む必要はありません。やることは1つだけ:
>
> 1. [`AI_GUIDE.md`](../AI_GUIDE.md) を開いて **Claude / ChatGPT / Codex** に貼り付ける
> 2. AIが一歩ずつ案内してくれます — インストール、設定、初めての実験まで
> 3. 焦らず、一緒にやっていきましょう。
>
> *仕組みを先に知りたい? 下をお読みください。*
---
## 💛 私たちがこれを作った理由、そしてどのように使ってほしいか
> **私たちの願いはシンプルです — 科学は純粋であってほしい、そして人間がループの中に居続けてほしい。**
このフレームワークを作った理由はただ一つ — 深層学習実験における**反復的で機械的な作業**(ジョブの起動、GPU の見守り、ログの解析、ハイパーパラメータの探索)を研究者から取り除き、皆さんの時間をもっと **本当に大切なこと:思考** に注げるようにするためです。
トレーニングを見守る時間を減らして、論文を読んだり、考えたり、自分自身のアイデアを追いかける時間を増やしたい — そう思ってここに来てくださったのなら、ようこそ。まさにそういう方のために作りました。
**すべての使用者にそっとお願いしたいこと:**
Agent は喜んで実験を走らせます。でも、*アイデア*、*結果の解釈*、そして *科学的判断* は、どうかあなた自身のものとして残しておいてください。私たちは「自動化」と「学術的誠実性」が対立するものだとは思っていません — むしろ逆で、このツールが取り戻してくれる時間は、思考を**より深めるため**に使われるべきものであって、思考を**省略するため**のものではありません。
だからどうかお願いします — このプロジェクトを、結果の捏造や、人間の関与のない"研究"の生成、そして人間が本当に理解し判断する必要のある科学のプロセスを近道するために使わないでください。それは私たちが手伝って作りたい未来ではありませんし、おそらく多くの方々が望んでいる未来でもないと思っています。
> **科学は純粋であるべきです。Agent は実験を走らせることができますが、アイデア・解釈・責任は、どうか人間の手に残してください。**
>
> **Science should stay pure.** The agent can run the experiments — but the ideas, the interpretation, and the responsibility belong to the human. We genuinely hope every user will keep a **human in the loop for thinking**.
>
> **学术应当保持纯粹。** Agent 可以替你跑实验,但 idea、判断与责任,请留给人来承担。我们真心希望每一位使用者都能 **human in the loop 地去思考**。
このツールを手に取ってくださる方々が、このことを真剣に受け止めてくださると私たちは信じています — そして、皆さんの多くがすでにそういう方々であると信じているからこそ、このプロジェクトをオープンソースにしました。その一人でいてくださって、ありがとうございます。💛
---
## 課題
既存のAI研究ツールは論文を**書く**手助けをします。Deep Researcher Agentは実験を**実行**します。
| 既存ツール | DAWN |
|:-:|:-:|
| 論文執筆の支援 | **実験を自律的に実行** |
| ノートの整理 | **結果を分析して改善** |
| 論文検索 | **仮説を立てて検証** |
| 指示されてから動く | **24時間365日自動稼働** |
```
あなたが8時間寝ている間 → エージェントは3サイクルの実験を実行
あなたが休暇中 → エージェントは50以上のハイパーパラメータを探索
あなたが論文を書いている → エージェントは既に結果テーブルを準備済み
```
### 実戦で検証済みの成果
> ベンチマークではありません。数ヶ月間の24時間自律運用による実際の成果です。
| 指標 | 結果 |
|------|------|
| 自律実験サイクル完了数 | 500+ |
| 単一プロジェクト最良改善 | ベースラインから52%改善(200+自動実験)|
| 同時管理プロジェクト数 | 4サーバーで4プロジェクト |
| 最長連続稼働 | 30日以上(人の介入なし)|
| 24時間あたりLLMコスト | ~$0.08 |
---
## コアイノベーション:ゼロコストモニタリング
24時間LLMエージェントを動かすとコストが心配?DAWNなら大丈夫:
```
LLM稼働 ゼロコスト LLM稼働
┌──────────┐ ┌──────────────┐ ┌──────────┐
│ THINK │ │ 訓練&監視 │ │ REFLECT │
│ (5-10分) │ │ (数時間/日) │ │ (5-10分) │
│ │ │ │ │ │
│ • 分析 │ │ • プロセス? │ │ • ログ │
│ • 計画 │ │ • GPU使用率? │ │ 解析 │
│ • コード │ │ • ログ末尾 │ │ • 比較 │
│ │ │ │ │ • 判断 │
│ ~$0.05 │ │ $0.00 │ │ ~$0.03 │
└──────────┘ └──────────────┘ └──────────┘
↑
LLM API呼び出しゼロ
ファイル読み取りと
プロセス確認のみ
```
---
## アーキテクチャ
### THINK → EXECUTE → REFLECT ループ
```
┌───────────────────────────────────────────┐
│ ┌────────┐ ┌─────────┐ ┌────────┐ │
│ │ THINK │→ │ EXECUTE │→ │REFLECT │──┐ │
│ │ │ │ │ │ │ │ │
│ │ 分析 │ │ Dry-run │ │ 評価 │ │ │
│ │ 計画 │ │ 訓練開始│ │ 比較 │ │ │
│ │ 決定 │ │ 監視 │ │ 更新 │ │ │
│ └────────┘ └─────────┘ └────────┘ │ │
│ ↑ │ │
│ └────────────────────────────────┘ │
│ ↻ 24/7 ループ │
└───────────────────────────────────────────┘
```
### Leader-Worker エージェントシステム
- **Leader**: 中央の意思決定者(サイクル内で会話履歴を保持)
- **Idea Agent**: 文献調査・仮説形成(5ツール)
- **Code Agent**: 実験実装・実行(7ツール)
- **Writing Agent**: レポート・論文執筆(4ツール)
同時に稼働するWorkerは1つだけ。他はゼロトークンコスト。
### v2.0 新機能(2026-06-01)
- **コード理解ツール**: `search_code`(正規表現でワークスペース全体を検索)、`list_tree`(再帰的なディレクトリツリー)、`read_file` の行範囲読み取り(大きなファイルが切り捨てられない)。
- **文献ツール**: `get_paper`(論文詳細+参照/被引用のスノーボール)、`search_arxiv`(最新プレプリント)。
- **自律レイヤー(追加的・デフォルト動作を変えない)**: 実験台帳 `experiments.jsonl`・停滞検出・DEAD_ENDS/INSIGHTS ジャーナル・違反スキャン・フェーズゲート・バーンアウト防止のレート制限(`max_cycles_per_hour`)。
- すべての信号は THINK/REFLECT の計画コンテキストに注入。ローカルと SSH で同一動作。GPU/ネットワーク不要でユニットテスト可能。
### 二層メモリシステム(定数サイズ)
| 層 | 内容 | サイズ上限 |
|----|------|-----------|
| Tier 1 | PROJECT_BRIEF.md(凍結、自動変更不可)| 3,000文字 |
| Tier 2 | MEMORY_LOG.md(自動圧縮付きローリング)| 2,000文字 |
| **合計** | **実行期間に関係なく一定** | **~5,000文字** |
---
## ステップバイステップ(ゼロから始める)
> **初めて?** 以下の手順に従えば、10分でゼロから実験エージェントが動きます。
>
> **AIガイド付きセットアップ:** [`AI_GUIDE.md`](../AI_GUIDE.md) をClaude / ChatGPT / Codexに読ませれば、対話的にセットアップを案内してくれます。
### ステップ 0:環境確認
| 必要なもの | 確認方法 |
|-----------|---------|
| Python 3.10+ | `python3 --version` |
| [Claude Code](https://claude.ai/claude-code) | `claude --version` |
| NVIDIA GPU (1枚以上) | `nvidia-smi` |
| Anthropic API Key | `echo $ANTHROPIC_API_KEY` |
API Keyがない場合は [console.anthropic.com](https://console.anthropic.com/) で取得:
```bash
export ANTHROPIC_API_KEY="sk-ant-xxxxx"
```
### ステップ 1:インストール
```bash
git clone https://github.com/Xiangyue-Zhang/auto-deep-researcher-24x7.git
cd auto-deep-researcher-24x7
pip install -r requirements.txt
python install.py # 7つのスラッシュコマンドをインストール
python -m core.loop --check # 確認
```
### ステップ 2:プロジェクト作成
`PROJECT_BRIEF.md` を書く — **最も重要なファイル**:
```bash
mkdir ~/my-first-experiment && cd ~/my-first-experiment
cat > PROJECT_BRIEF.md << 'EOF'
# Goal
CIFAR-100でResNet-50を訓練、テスト精度80%以上。
# Codebase
PyTorchでゼロから訓練コードを作成。
- torchvisionでデータセット自動ダウンロード
- チェックポイント: ./checkpoints/
- ログ: ./logs/
# What to Try
- まずResNet-50 baseline: lr=0.1, SGD, 100 epochs
- 精度<75%: cosine annealing + warmup追加
- 精度75-80%: mixupまたはcutout追加
- 精度>80%: 目標達成
# Constraints
- GPU 0のみ、最大100 epochs、batch size 128
EOF
```
### ステップ 3:エージェント起動
```
/auto-experiment --project ~/my-first-experiment --gpu 0
```
### ステップ 4:自動で動く様子
```
=== サイクル 1 ===
[THINK] PROJECT_BRIEF.md読込...
目標:ResNet-50, CIFAR-100, >80%
過去の実験なし。ベースラインから開始。
[EXECUTE] train.py作成... config.yaml作成...
Dry-run (2ステップ検証)... ✓ エラーなし
訓練開始: PID 12345
[MONITOR] 訓練中...(LLMコストゼロ)
15:00 — Epoch 12/100, loss=2.34
15:30 — Epoch 38/100, loss=1.54
18:00 — 訓練完了
[REFLECT] テスト精度 = 76.3%
76.3% < 80% → mixup追加を決定
記録: "Exp001: ResNet-50 baseline, 76.3%"
=== サイクル 2 ===
...
```
### ステップ 5:進捗確認
```bash
/experiment-status --project ~/my-first-experiment
/gpu-monitor
```
### ステップ 6:介入(3つの方法)
```bash
# 方法1: 指示ファイルをドロップ
echo "ResNetをやめてViT-B/16に切替" > workspace/HUMAN_DIRECTIVE.md
# 方法2: コマンドライン
python -m core.loop --project . --directive "label smoothing 0.1を試す"
# 方法3: メモリ直接編集
vim workspace/MEMORY_LOG.md
```
### ステップ 7:モバイル監視(オプション)
[Happy Coder](https://happy.engineering/) ([iOS](https://apps.apple.com/us/app/happy-codex-claude-code-app/id6748571505) / [Android](https://play.google.com/store/apps/details?id=com.ex3ndr.happy)) でスマホから監視・操作:
```bash
npm install -g happy-coder
happy
/auto-experiment --project ~/my-first-experiment --gpu 0
```
- **プッシュ通知** — 実験完了時に即座に通知
- **結果確認** — 電車の中でメトリクスをチェック
- **指示送信** — スマホからエージェントに方向転換を指示
- **E2E暗号化** — 完全にプライベート
### FAQ
Q:1日のコストは?
約$0.08(約12円)。訓練中はLLM呼び出しゼロ。THINKとREFLECT(各10分)だけ課金。
Q:既存コードを修正できる?
はい。Code Agentはファイルの読み書き・修正が可能。dry-runで検証してから訓練開始。
Q:エージェントが間違った方向に行ったら?
指示ファイル:`echo "止まれ。ResNetに戻る" > workspace/HUMAN_DIRECTIVE.md`
Q:PyTorch / TensorFlow / JAX対応?
すべて対応。シェルコマンド実行+ログ読み取りなので、フレームワーク依存なし。
---
## ワンクリックインストール(Claude Code Skills)
## Human-in-the-Loop 実践ガイド
Agent は研究者の代わりではなく、あなたが舵を取る実験オペレーターとして使ってください。
```text
人が決めること:
- 目標
- 制約
- 禁止事項
- 方向転換のタイミング
Agent が実行すること:
- コード修正
- 実験実行
- 監視
- 要約
```
固定ルールは `PROJECT_BRIEF.md` に、一時的な指示は `HUMAN_DIRECTIVE.md` に書きます。
```md
# HUMAN_DIRECTIVE.md
- データセットは変更しない。
- backbone を変える前に label smoothing 0.1 を試す。
- 3回連続で改善が 0.3 ポイント未満ならこの方向は止める。
- 直近の run ではなく、最後に信頼できる baseline と比較する。
```
Case 1: きれいな ablation
```md
- augmentation だけ変更する。
- モデル、optimizer、計算予算は固定する。
- 各 run 後に比較表を出す。
```
Case 2: 意図的な方向転換
```md
- 現在の ResNet 系は頭打ち。
- 直近3 run が停滞した時だけ ViT-B/16 に切り替える。
- 切り替え前に短い根拠を書く。
```
Case 3: 怪しい結果
```md
- 精度が急に上がった。
- 同じ seed で再実行し、さらに別 seed でも1回試す。
- 両方再現するまで改善と見なさない。
```
要点は1つです。反復作業は Agent に任せても、方向、解釈、責任は人が持つことです。
---
すべての機能をClaude Codeスラッシュコマンドとして提供。**一行でインストール:**
```bash
python install.py
```
**7つのコマンド**が利用可能になります:
### コアスキル
| コマンド | 機能 |
|---------|------|
| `/auto-experiment` | 24/7自律THINK→EXECUTE→REFLECT実験ループを起動 |
| `/experiment-status` | 実験進捗確認:メトリクス、サイクル数、GPU状態 |
| `/gpu-monitor` | GPU状態:空き/使用中、メモリ、使用率 |
### リサーチスキル
| コマンド | 機能 |
|---------|------|
| `/daily-papers` | arXiv日次推薦(重複排除付き)|
| `/paper-analyze ` | 詳細論文分析 + arXivソースから図表抽出 |
| `/conf-search --venue CVPR2025` | CVPR/NeurIPS/ICML/ICLR/AAAI検索 |
| `/progress-report` | 構造化進捗レポート生成 |
### アンインストール
```bash
python install.py --uninstall
```
---
## 他ツールとの比較
| | Deep Researcher Agent | [Claude Scholar](https://github.com/Galaxy-Dawn/claude-scholar) | [AI Scientist](https://github.com/SakanaAI/AI-Scientist) | [OpenHands](https://github.com/All-Hands-AI/OpenHands) | [SWE-Agent](https://github.com/princeton-nlp/SWE-agent) |
|--|:--:|:--:|:--:|:--:|:--:|
| **自律的実験実行** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **ゼロコスト監視** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **GPU管理** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **24/7連続稼働** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **定数サイズメモリ** | ✅ | ❌ | ❌ | ❌ | ❌ |
| 論文執筆 | 基本 | ✅ | ✅ | ❌ | ❌ |
| ナレッジ管理 | 基本 | ✅ | ❌ | ❌ | ❌ |
| 汎用コーディング | ❌ | ❌ | ❌ | ✅ | ✅ |
---
## 引用
```bibtex
@software{auto_deep_researcher_24x7,
title={Deep Researcher Agent: Autonomous Deep Learning Experiment Framework},
author={Xiangyue Zhang},
year={2026},
url={https://github.com/Xiangyue-Zhang/auto-deep-researcher-24x7}
}
```
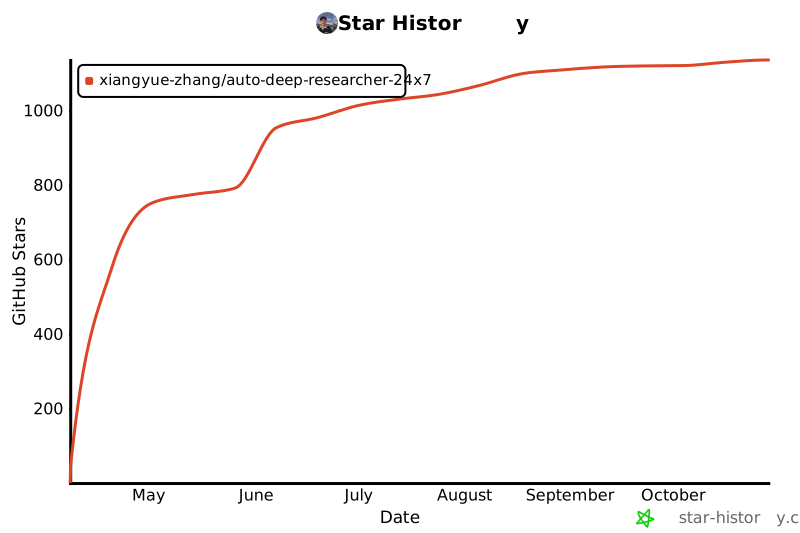
## Star History
[](https://www.star-history.com/#Xiangyue-Zhang/auto-deep-researcher-24x7&Date)
## ライセンス
Apache 2.0 — [LICENSE](../LICENSE) を参照
---
「実験は夜通し走り、結果は夜明けに届く。」