Deep Researcher Agent
24/7 자율형 딥러닝 실험 에이전트
딥러닝 실험을 24시간 365일 자율적으로 실행하는 AI 에이전트 프레임워크.
당신이 자는 동안에도, 실험은 계속 돌아갑니다.
English |
中文 |
日本語 |
한국어



---
> **처음 오셨나요? 걱정 마세요.** README를 전부 읽으실 필요는 없습니다. 딱 한 가지만 하시면 됩니다:
>
> 1. [`AI_GUIDE.md`](../AI_GUIDE.md) 파일을 열어서 **Claude / ChatGPT / Codex** 에 붙여넣으세요
> 2. AI가 한 단계씩 안내해 드립니다 — 설치, 설정, 첫 실험까지
> 3. 조급해하지 마시고, 천천히 함께 가요.
>
> *원리부터 알고 싶으시다면? 아래로 계속 읽어주세요.*
---
## 💛 우리가 이걸 만든 이유, 그리고 어떻게 써주셨으면 하는지
> **우리의 바람은 단순합니다 — 학문은 순수하게, 사람은 루프 안에 머물러 주시기를.**
이 프레임워크를 만든 이유는 단 하나입니다 — 딥러닝 실험에서 **반복적이고 기계적인 작업**(잡 실행, GPU 지켜보기, 로그 파싱, 하이퍼파라미터 스윕)을 연구자에게서 덜어내어, 여러분의 시간을 **정말 중요한 것: 사고하기** 에 더 많이 쓸 수 있도록 하기 위해서입니다.
학습 과정을 지켜보는 시간을 줄이고, 논문을 읽고, 고민하고, 자신만의 아이디어를 좇는 시간을 늘리고 싶어서 여기 오신 거라면 — 환영합니다. 바로 그런 분을 위해 만들었습니다.
**모든 사용자에게 조용히 부탁드리고 싶은 한 가지:**
에이전트는 기꺼이 실험을 돌려드립니다. 하지만 *아이디어*, *결과의 해석*, 그리고 *과학적 판단* 은 부디 여러분 자신의 것으로 남겨주세요. 우리는 "자동화"와 "학문적 성실성"이 서로 대립한다고 생각하지 않습니다 — 오히려 정반대로, 이 도구가 되돌려주는 시간은 사고를 **더 깊이 하기 위해** 쓰여야 하는 것이지, 사고를 **건너뛰기 위한 것** 이 아닙니다.
그래서 한 가지 부탁드립니다 — 이 프로젝트를, 결과를 조작하거나, 사람의 개입 없이 "연구"를 생성하거나, 사람이 진정으로 이해하고 판단해야 하는 과학의 과정을 우회하는 데 사용하지 말아주세요. 그것은 우리가 함께 만들고 싶은 미래가 아니며, 아마 여러분 대부분이 원하는 미래도 아닐 것이라고 믿습니다.
> **학문은 순수하게 유지되어야 합니다. 에이전트는 실험을 돌릴 수 있지만, 아이디어와 해석과 책임은 부디 사람의 손에 남겨주세요.**
>
> **Science should stay pure.** The agent can run the experiments — but the ideas, the interpretation, and the responsibility belong to the human. We genuinely hope every user will keep a **human in the loop for thinking**.
>
> **学术应当保持纯粹。** Agent 可以替你跑实验,但 idea、判断与责任,请留给人来承担。
>
> **科学は純粋であるべきです。** Agent は実験を走らせることができますが、アイデア・解釈・責任は、どうか人間の手に残してください。
이 도구를 손에 쥐어주시는 분들이 이 점을 진지하게 받아들여 주실 것이라 믿습니다 — 그리고 여러분 대부분이 이미 그런 분들이라고 믿기에, 우리는 이 프로젝트를 오픈소스로 공개했습니다. 그 한 분이 되어주셔서 감사합니다. 💛
---
## 문제
기존의 AI 연구 도구들은 논문을 **쓰는** 것을 도와줍니다. Deep Researcher Agent는 실험을 **실행** 합니다.
| 기존 도구 | DAWN |
|:-:|:-:|
| 논문 작성 지원 | **실험을 자율적으로 실행** |
| 노트 정리 | **결과 분석 및 개선** |
| 논문 검색 | **가설 수립 및 검증** |
| 지시받아야 동작 | **24시간 365일 자동 가동** |
```
당신이 8시간 자는 동안 → 에이전트는 3사이클의 실험을 실행
당신이 휴가 중일 때 → 에이전트는 50개 이상의 하이퍼파라미터 탐색
당신이 논문을 쓰는 동안 → 에이전트는 이미 results table을 준비 완료
```
### 실전에서 검증된 성과
> 벤치마크가 아닙니다. 수개월간의 24시간 자율 운용에서 나온 실제 결과입니다.
| 지표 | 결과 |
|------|------|
| 자율 실험 사이클 완료 수 | 500+ |
| 단일 프로젝트 최고 개선 | 베이스라인 대비 52% 개선 (200+ 자동 실험) |
| 동시 관리 프로젝트 수 | 4개 서버에서 4개 프로젝트 |
| 최장 연속 가동 | 30일 이상 (사람의 개입 없이) |
| 24시간당 LLM 비용 | ~$0.08 |
---
## 핵심 혁신: 제로 코스트 모니터링
24시간 LLM 에이전트를 돌리는 게 너무 비싸지 않을까 걱정되시나요? DAWN이라면 괜찮습니다:
```
LLM 가동 제로 코스트 LLM 가동
┌──────────┐ ┌──────────────┐ ┌──────────┐
│ THINK │ │ 학습 & 모니터 │ │ REFLECT │
│ (5-10분) │ │ (시간/일 단위)│ │ (5-10분) │
│ │ │ │ │ │
│ • 분석 │ │ • 프로세스? │ │ • 로그 │
│ • 계획 │ │ • GPU 사용률? │ │ 파싱 │
│ • 코드 │ │ • 로그 마지막 │ │ • 비교 │
│ │ │ │ │ • 판단 │
│ ~$0.05 │ │ $0.00 │ │ ~$0.03 │
└──────────┘ └──────────────┘ └──────────┘
↑
LLM API 호출 0회
파일 읽기와
프로세스 확인만
```
---
## 아키텍처
### THINK → EXECUTE → REFLECT 루프
```
┌───────────────────────────────────────────┐
│ ┌────────┐ ┌─────────┐ ┌────────┐ │
│ │ THINK │→ │ EXECUTE │→ │REFLECT │──┐ │
│ │ │ │ │ │ │ │ │
│ │ 분석 │ │ Dry-run │ │ 평가 │ │ │
│ │ 계획 │ │ 학습 시작│ │ 비교 │ │ │
│ │ 결정 │ │ 모니터 │ │ 갱신 │ │ │
│ └────────┘ └─────────┘ └────────┘ │ │
│ ↑ │ │
│ └────────────────────────────────┘ │
│ ↻ 24/7 루프 │
└───────────────────────────────────────────┘
```
### Leader-Worker 에이전트 시스템
- **Leader**: 중앙 의사결정자 (사이클 내에서 대화 이력 유지)
- **Idea Agent**: 문헌 조사 · 가설 수립 (5 tools)
- **Code Agent**: 실험 구현 · 실행 (7 tools)
- **Writing Agent**: 리포트 · 논문 작성 (4 tools)
동시에 가동되는 Worker는 단 하나뿐. 나머지는 토큰 비용 0.
### v2.0 새 기능 (2026-06-01)
- **코드 이해 도구**: `search_code`(정규식 전체 검색), `list_tree`(재귀 디렉터리 트리), `read_file` 줄 범위 읽기(큰 파일이 잘리지 않음).
- **문헌 도구**: `get_paper`(논문 상세 + 인용/피인용 스노우볼), `search_arxiv`(최신 프리프린트).
- **자율 레이어(추가적 · 기본 동작 불변)**: 실험 원장 `experiments.jsonl` · 정체 감지 · DEAD_ENDS/INSIGHTS 저널 · 위반 스캔 · 페이즈 게이트 · 번아웃 방지 레이트 제한(`max_cycles_per_hour`).
- 모든 신호는 THINK/REFLECT 계획 컨텍스트에 주입. 로컬과 SSH 동일 동작. GPU/네트워크 없이 단위 테스트 가능.
### 2계층 메모리 시스템 (상수 크기)
| 계층 | 내용 | 크기 상한 |
|------|------|-----------|
| Tier 1 | PROJECT_BRIEF.md (고정, 자동 변경 불가) | 3,000자 |
| Tier 2 | MEMORY_LOG.md (자동 압축 롤링) | 2,000자 |
| **합계** | **실행 기간과 무관하게 일정** | **~5,000자** |
---
## 단계별 가이드 (제로부터 시작하기)
> **처음이신가요?** 아래 단계를 따라가시면 10분 안에 실험 에이전트를 돌리실 수 있습니다.
>
> **AI 가이드 셋업:** [`AI_GUIDE.md`](../AI_GUIDE.md) 를 Claude / ChatGPT / Codex 에게 읽혀주시면, 대화형으로 셋업을 안내해 드립니다.
### Step 0: 환경 확인
| 필요한 것 | 확인 방법 |
|-----------|-----------|
| Python 3.10+ | `python3 --version` |
| [Claude Code](https://claude.ai/claude-code) | `claude --version` |
| NVIDIA GPU (1장 이상) | `nvidia-smi` |
| Anthropic API Key | `echo $ANTHROPIC_API_KEY` |
API Key가 없으시다면 [console.anthropic.com](https://console.anthropic.com/) 에서 발급받으세요:
```bash
export ANTHROPIC_API_KEY="sk-ant-xxxxx"
```
### Step 1: 설치
```bash
git clone https://github.com/Xiangyue-Zhang/auto-deep-researcher-24x7.git
cd auto-deep-researcher-24x7
pip install -r requirements.txt
python install.py # 7개의 슬래시 커맨드 설치
python -m core.loop --check # 동작 확인
```
### Step 2: 프로젝트 생성
`PROJECT_BRIEF.md` 작성하기 — **가장 중요한 파일**:
```bash
mkdir ~/my-first-experiment && cd ~/my-first-experiment
cat > PROJECT_BRIEF.md << 'EOF'
# Goal
CIFAR-100에서 ResNet-50을 학습, 테스트 정확도 80% 이상.
# Codebase
PyTorch로 처음부터 학습 코드를 작성.
- torchvision으로 데이터셋 자동 다운로드
- 체크포인트: ./checkpoints/
- 로그: ./logs/
# What to Try
- 먼저 ResNet-50 baseline: lr=0.1, SGD, 100 epochs
- 정확도 < 75%: cosine annealing + warmup 추가
- 정확도 75-80%: mixup 또는 cutout 추가
- 정확도 > 80%: 목표 달성
# Constraints
- GPU 0번만, 최대 100 epochs, batch size 128
EOF
```
### Step 3: 에이전트 기동
```
/auto-experiment --project ~/my-first-experiment --gpu 0
```
### Step 4: 자동으로 돌아가는 모습
```
=== 사이클 1 ===
[THINK] PROJECT_BRIEF.md 읽는 중...
목표: ResNet-50, CIFAR-100, >80%
과거 실험 없음. 베이스라인부터 시작.
[EXECUTE] train.py 생성... config.yaml 생성...
Dry-run (2 step 검증)... ✓ 에러 없음
학습 시작: PID 12345
[MONITOR] 학습 중...(LLM 비용 0)
15:00 — Epoch 12/100, loss=2.34
15:30 — Epoch 38/100, loss=1.54
18:00 — 학습 완료
[REFLECT] 테스트 정확도 = 76.3%
76.3% < 80% → mixup 추가 결정
기록: "Exp001: ResNet-50 baseline, 76.3%"
=== 사이클 2 ===
...
```
### Step 5: 진행 상황 확인
```bash
/experiment-status --project ~/my-first-experiment
/gpu-monitor
```
### Step 6: 개입 (3가지 방법)
```bash
# 방법 1: 지시 파일 떨어뜨리기
echo "ResNet 그만, ViT-B/16으로 전환" > workspace/HUMAN_DIRECTIVE.md
# 방법 2: 커맨드라인
python -m core.loop --project . --directive "label smoothing 0.1 시도해봐"
# 방법 3: 메모리 직접 편집
vim workspace/MEMORY_LOG.md
```
### Step 7: 모바일 모니터링 (선택사항)
[Happy Coder](https://happy.engineering/) ([iOS](https://apps.apple.com/us/app/happy-codex-claude-code-app/id6748571505) / [Android](https://play.google.com/store/apps/details?id=com.ex3ndr.happy)) 로 스마트폰에서 모니터링 · 조작:
```bash
npm install -g happy-coder
happy
/auto-experiment --project ~/my-first-experiment --gpu 0
```
- **푸시 알림** — 실험 완료 시 즉시 알림
- **결과 확인** — 지하철에서 메트릭 확인
- **지시 전송** — 스마트폰에서 에이전트에게 방향 전환 지시
- **E2E 암호화** — 완전히 프라이빗
### FAQ
Q: 하루 비용은 얼마인가요?
약 $0.08 (약 110원). 학습 중에는 LLM 호출이 0회입니다. THINK와 REFLECT (각 10분)에서만 과금됩니다.
Q: 기존 코드를 수정할 수 있나요?
네. Code Agent는 파일 읽기 · 쓰기 · 수정이 가능합니다. dry-run으로 검증한 뒤 학습을 시작합니다.
Q: 에이전트가 잘못된 방향으로 가면요?
지시 파일: `echo "멈춰. ResNet으로 돌아가" > workspace/HUMAN_DIRECTIVE.md`
Q: PyTorch / TensorFlow / JAX 모두 지원하나요?
모두 지원합니다. 셸 커맨드 실행 + 로그 읽기 방식이라 프레임워크에 종속되지 않습니다.
---
## 원클릭 설치 (Claude Code Skills)
## Human-in-the-Loop 운영 가이드
에이전트는 연구자를 대체하는 버튼이 아니라, 당신이 방향을 잡아 주는 실험 운영자입니다.
```text
사람이 결정:
- 목표
- 제약
- 금지 방향
- 언제 전환할지
에이전트가 실행:
- 코드 수정
- 실험 실행
- 모니터링
- 요약
```
고정 규칙은 `PROJECT_BRIEF.md` 에, 임시 지시는 `HUMAN_DIRECTIVE.md` 에 적으세요.
```md
# HUMAN_DIRECTIVE.md
- 데이터셋은 바꾸지 마라.
- backbone 을 바꾸기 전에 label smoothing 0.1부터 시도하라.
- 3번 연속 향상이 0.3포인트 미만이면 이 방향은 중단하라.
- 가장 최근 결과가 아니라 마지막으로 신뢰한 baseline 과 비교하라.
```
Case 1: 깔끔한 ablation
```md
- augmentation 만 바꿔라.
- 모델, optimizer, 계산 예산은 고정하라.
- 매 run 뒤 비교표를 출력하라.
```
Case 2: 의도적인 방향 전환
```md
- 현재 ResNet 라인은 포화 상태다.
- 최근 3번이 정체일 때만 ViT-B/16으로 전환하라.
- 전환 전 짧은 근거를 먼저 써라.
```
Case 3: 수상한 결과
```md
- 정확도가 비정상적으로 많이 올랐다.
- 같은 seed 로 한 번, 새 seed 로 한 번 더 재실행하라.
- 둘 다 재현되기 전에는 개선으로 결론 내리지 마라.
```
핵심은 하나입니다. 반복 작업은 에이전트에게 맡겨도, 방향과 해석과 책임은 사람에게 남겨 두는 것입니다.
---
모든 기능을 Claude Code 슬래시 커맨드로 제공합니다. **한 줄로 설치:**
```bash
python install.py
```
**7개의 커맨드** 가 사용 가능해집니다:
### 코어 스킬
| 커맨드 | 기능 |
|--------|------|
| `/auto-experiment` | 24/7 자율 THINK→EXECUTE→REFLECT 실험 루프 기동 |
| `/experiment-status` | 실험 진행 확인: 메트릭, 사이클 수, GPU 상태 |
| `/gpu-monitor` | GPU 상태: 빈/사용중, 메모리, 사용률 |
### 리서치 스킬
| 커맨드 | 기능 |
|--------|------|
| `/daily-papers` | arXiv 일일 추천 (중복 제거 포함) |
| `/paper-analyze ` | 상세 논문 분석 + arXiv 소스에서 figure 추출 |
| `/conf-search --venue CVPR2025` | CVPR/NeurIPS/ICML/ICLR/AAAI 검색 |
| `/progress-report` | 구조화된 진행 리포트 생성 |
### 제거
```bash
python install.py --uninstall
```
---
## 다른 도구들과의 비교
| | Deep Researcher Agent | [Claude Scholar](https://github.com/Galaxy-Dawn/claude-scholar) | [AI Scientist](https://github.com/SakanaAI/AI-Scientist) | [OpenHands](https://github.com/All-Hands-AI/OpenHands) | [SWE-Agent](https://github.com/princeton-nlp/SWE-agent) |
|--|:--:|:--:|:--:|:--:|:--:|
| **자율 실험 실행** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **제로 코스트 모니터링** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **GPU 관리** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **24/7 연속 가동** | ✅ | ❌ | ❌ | ❌ | ❌ |
| **상수 크기 메모리** | ✅ | ❌ | ❌ | ❌ | ❌ |
| 논문 작성 | 기본 | ✅ | ✅ | ❌ | ❌ |
| 지식 관리 | 기본 | ✅ | ❌ | ❌ | ❌ |
| 범용 코딩 | ❌ | ❌ | ❌ | ✅ | ✅ |
---
## 인용
```bibtex
@software{auto_deep_researcher_24x7,
title={Deep Researcher Agent: Autonomous Deep Learning Experiment Framework},
author={Xiangyue Zhang},
year={2026},
url={https://github.com/Xiangyue-Zhang/auto-deep-researcher-24x7}
}
```
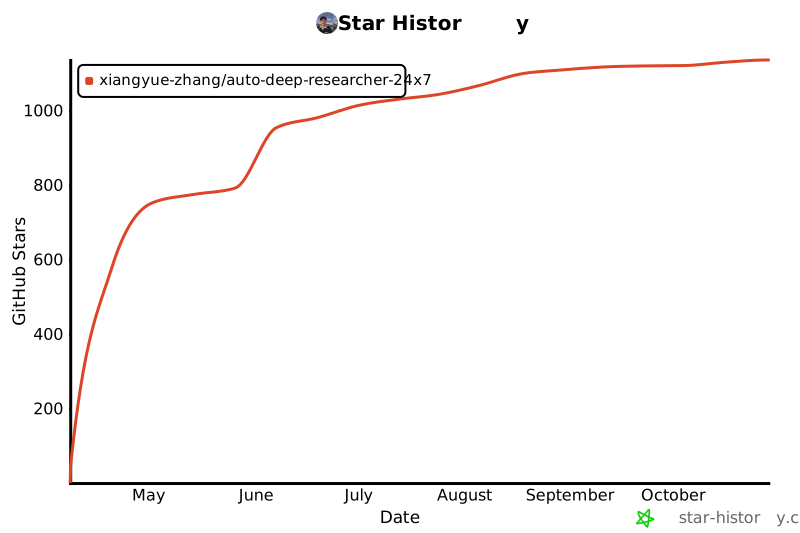
## Star History
[](https://www.star-history.com/#Xiangyue-Zhang/auto-deep-researcher-24x7&Date)
## 라이선스
Apache 2.0 — [LICENSE](../LICENSE) 참조
---
"실험은 밤새 돌고, 결과는 새벽에 도착한다."