optim-agent permite que Claude Code / Codex / OpenCode ajusten parámetros reales de sistemas
leyendo tu código, proponiendo trials y registrando resultados objetivos medidos.
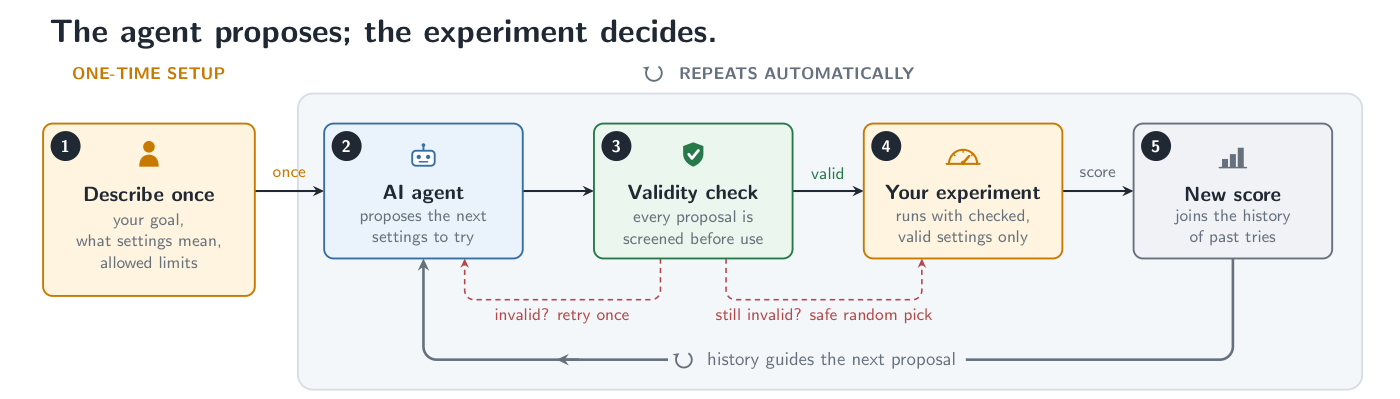
Úsalo cuando el sistema expone parámetros configurables y un objetivo medible. Combina lo que cada
parámetro *significa* con lo que el historial de trials *muestra*, y propone la siguiente configuración
a evaluar. Las evaluaciones del objetivo siguen siendo la autoridad: optim-agent propone valores,
los valida contra el espacio declarado, registra resultados y vuelve a muestreo seguro si la respuesta
del agente no es válida.
| Modelos | Sistemas | Investigación |
|---|---|---|
| Entrenamiento, arquitectura y experimentos RL | Inferencia, latencia, coste, control y reglas de decisión | Señales cuantitativas, simulaciones y flujos científicos |
## Por qué optim-agent
- **Propuestas semánticas** - los agentes de programación razonan sobre el significado de los parámetros, el contexto y los resultados observados en lugar de tratar cada dimensión como una coordenada anónima.
- **Aprovechamiento con poco presupuesto** - útil cuando las evaluaciones son caras y los surrogates clásicos todavía tienen pocos datos.
- **Mejora por Agent CLI** - la calidad de las propuestas puede mejorar a medida que mejoran los agentes de programación subyacentes, por ejemplo de GPT-5.5 a GPT-5.6, sin cambiar el código de optimización.
- **Decisiones auditables** - los studies JSON/SQLite conservan configuraciones, resultados, estados, contexto y rationale opcional del agente.
- **Ejecución acotada** - el agente solo propone valores; optim-agent los valida contra el espacio declarado y vuelve a muestreo seguro ante salidas inválidas.
## Instalación
Instala el Codex skill:
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Instala el plugin de Claude Code:
```bash
claude plugin marketplace add Optim-Agent/optim-agent && claude plugin install optim-agent@optim-agent
```
Instala el paquete Python:
```bash
# Versión estable de PyPI
python -m pip install optim-agent
# Código más reciente de GitHub
python -m pip install "optim-agent @ git+https://github.com/Optim-Agent/optim-agent.git"
```
Requiere un agent CLI autenticado en `PATH`:
[claude](https://docs.anthropic.com/en/docs/claude-code),
[codex](https://github.com/openai/codex) u
[OpenCode](https://github.com/sst/opencode).
## Inicio rápido
```python
import optim_agent as oa
def objective(trial):
threshold = trial.suggest_float(
"threshold", 0.05, 0.95,
context="decision threshold; higher values trade recall for precision",
)
budget = trial.suggest_int(
"budget", 10, 200, log=True,
context="compute or operating budget; larger values may improve quality",
)
return evaluate_system(threshold=threshold, budget=budget) # domain code
study = oa.create_study(
direction="maximize",
sampler=oa.AgentSampler(
backend="claude", # or "codex" / "opencode"
effort="high",
context="maximize system quality under a strict operating-cost budget",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
),
storage="study.json", # optional: persist and resume
summarize=True, # optional: agent-written result summary after the last trial
)
study.optimize(objective, n_trials=20)
print(study.best_value, study.best_params)
print(study.summary) # the summary agent's narration of the finished study
```
El `context` opcional aporta significado de dominio al study y a los parámetros. Puedes pasarlo
en `AgentSampler(context=...)`, en `suggest_*(..., context=...)`, o en ambos.
También puedes ejecutar [`examples/quickstart.py`](../../examples/quickstart.py) o seguir
[`tutorials/quickstart.ipynb`](../../tutorials/quickstart.ipynb).
## Ámbitos de aplicación
| Área | Parámetros que optim-agent puede ajustar | Objetivo de ejemplo |
|---|---|---|
| **Entrenamiento de modelos** | learning rates, arquitecturas, augmentación, regularización | calidad de validación, cómputo, robustez |
| **Inferencia y serving** | cuantización, batching, decodificación, caching, routing | calidad, latencia, throughput, coste |
| **Investigación cuantitativa** | ventanas de señal, umbrales, reglas de rebalanceo, controles de riesgo | retorno walk-forward, drawdown, turnover |
| **RL y decisiones** | pesos de objetivo, calendarios de exploración, ajustes de entorno, umbrales de política | retorno, seguridad, eficiencia de muestras |
| **Flujos científicos** | entradas de simulación, ajustes de solver, controles experimentales | ajuste, error, tiempo, uso de recursos |
| **Sistemas caja negra** | cualquier configuración categórica, entera o continua acotada | puntuación objetiva escalar |
Más ejemplos: [`examples/sklearn_tuning.py`](../../examples/sklearn_tuning.py) y
[`examples/inference_tuning.py`](../../examples/inference_tuning.py).
Para reinforcement learning, optim-agent ajusta el sistema alrededor del bucle de aprendizaje;
no sustituye al algoritmo que aprende la política.
## Trayectoria de optimización
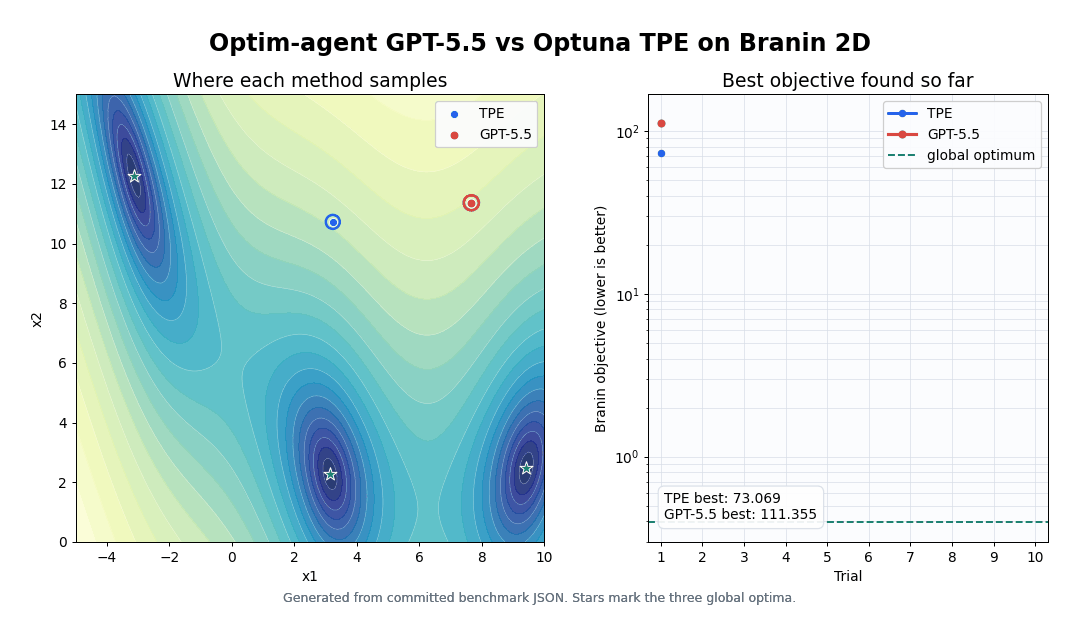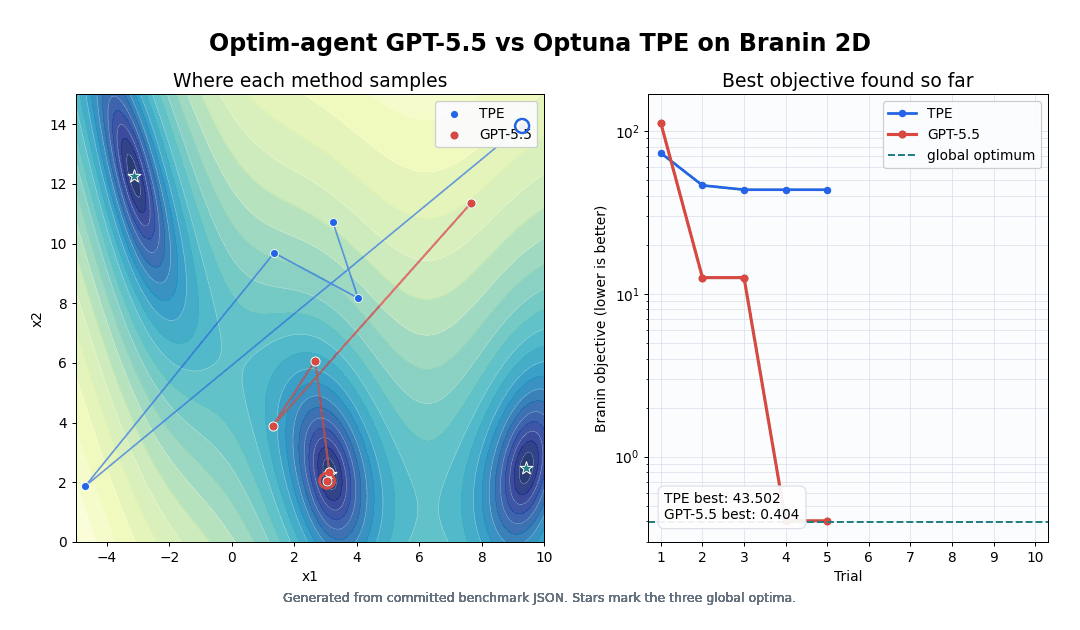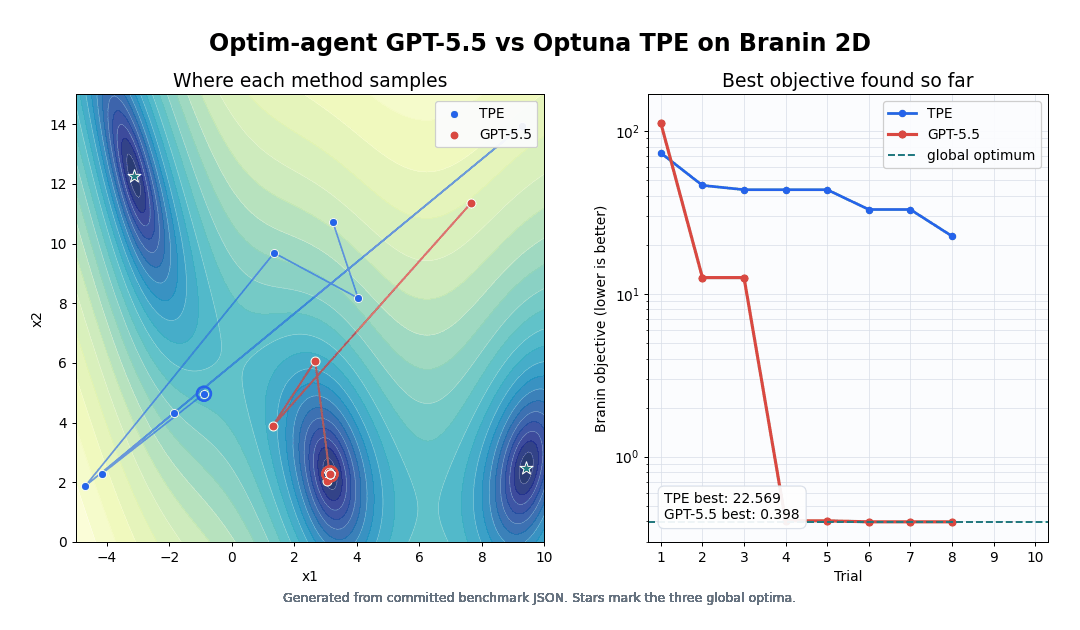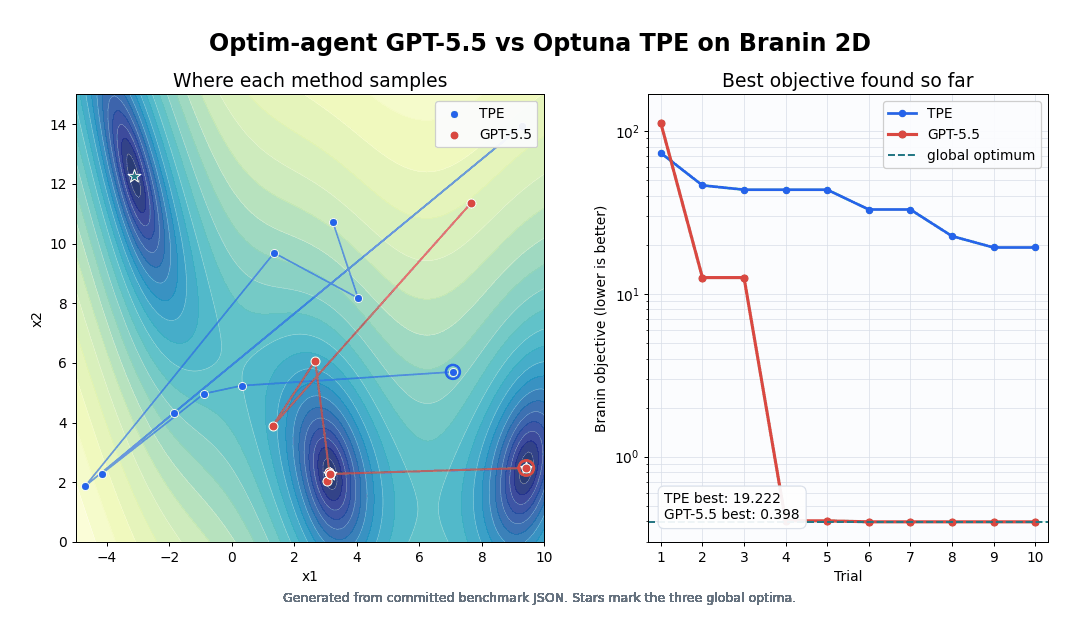
Esta traza Branin seed-0 compara TPE y GPT-5.5 con el mismo presupuesto de 10 trials,
mostrando el objetivo incumbent después de cada trial. Es una ilustración de trayectoria;
los resultados agregados y comandos de reproducción siguen abajo.
### Optimización de funciones matemáticas sin contexto: Branin-2D y Ackley-5D
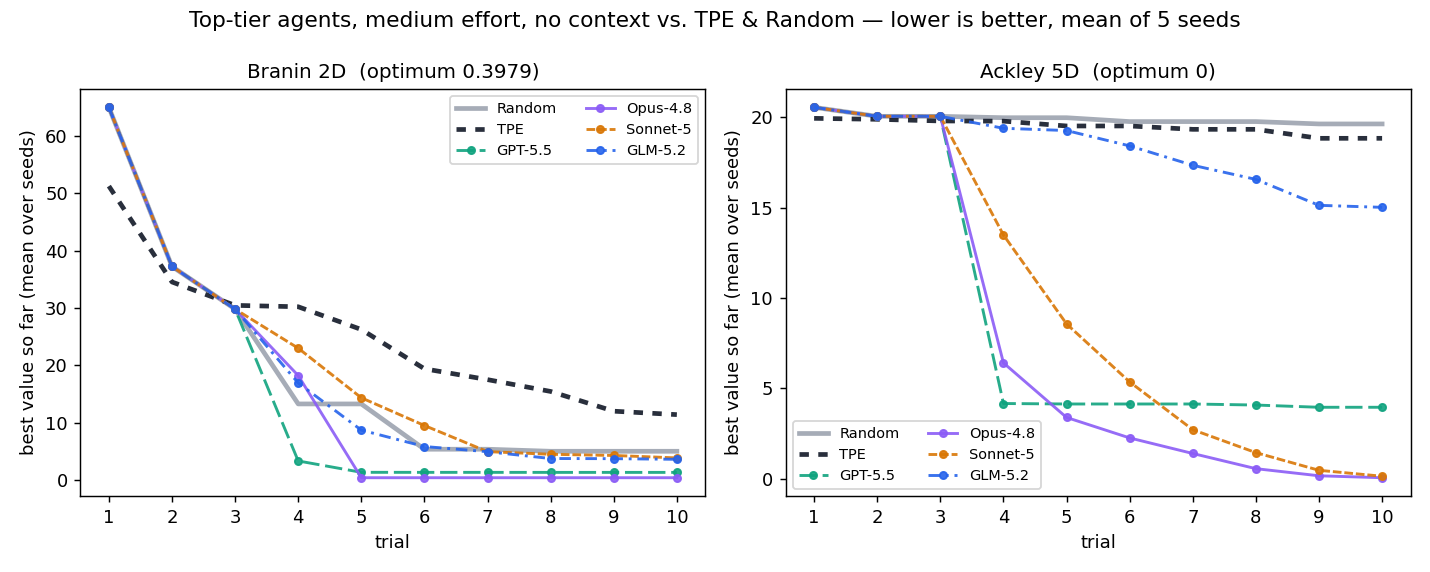
Los agentes de funciones difíciles no reciben **ningún contexto de tarea**: solo nombres genéricos
`x1...x5`, límites numéricos e historial de trials. Las ejecuciones usan 10 trials en cinco seeds;
Random y TPE son baselines sin cambios.
#### Agentes de primer nivel
| método | mejor Branin medio ↓ | mejor Ackley-5D medio ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| GPT-5.5 | 1.326 | 3.960 |
| **Opus-4.8** | **0.398** | **0.061** |
| Sonnet-5 | 3.850 | 0.143 |
| Kimi-K3 | 2.082 | 0.907 |
| Minimax-M3 | 0.970 | 0.574 |
| GLM-5.2 | 3.609 | 15.023 |
Los modelos fijados son `gpt-5.5`, `claude-opus-4-8`, `claude-sonnet-5`,
`kimi-k3`, `MiniMax-M3` y `glm-5.2`.
Opus-4.8 alcanza el óptimo de Branin de media y tiene la media Ackley de cinco seeds más fuerte.
#### Agentes OpenCode (gratis)
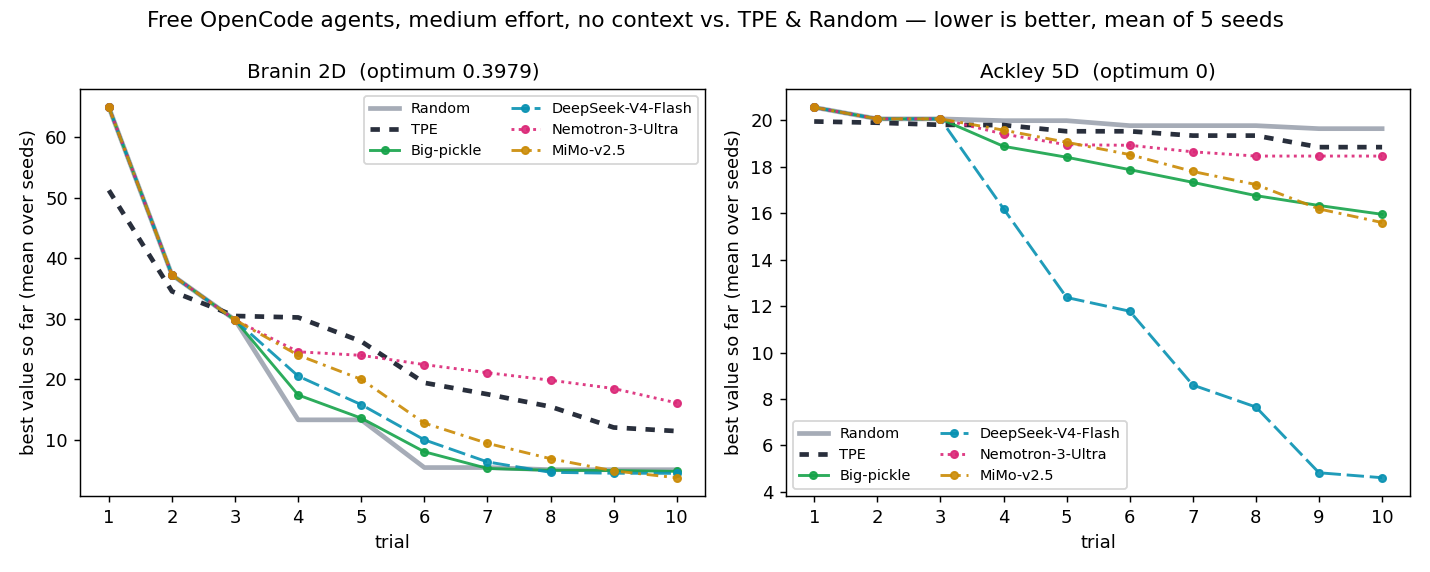
| método | mejor Branin medio ↓ | mejor Ackley-5D medio ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| Big-pickle | 4.734 | 15.951 |
| **DeepSeek-V4-Flash** | 4.410 | **4.608** |
| Nemotron-3-Ultra | 16.051 | 18.459 |
| **MiMo-v2.5** | **3.682** | 15.597 |
Los modelos alojados por OpenCode no requieren API de modelo de pago. El pool gratuito rota;
este refresh fija `opencode/big-pickle`, `opencode/deepseek-v4-flash-free`,
`opencode/nemotron-3-ultra-free` y `opencode/mimo-v2.5-free`. DeepSeek V4 Flash tiene la mejor
media Ackley entre modelos gratis, mientras MiMo-v2.5 tiene la mejor media Branin.
### Ajuste de clasificadores de imagen basados en ResNet: MNIST y CIFAR-10
El benchmark de clasificación compara **Random**, Optuna **TPE**, **GPT-5.5 w/ context**
y **GPT-5.5 w/o context** en cinco seeds (`0..4`) y 10 trials. La condición con contexto recibe
descripciones en lenguaje natural del study y los parámetros; la condición sin contexto solo recibe límites e historial.
La métrica principal enfatiza la mejora rápida:
```text
cumulative_best_so_far_error = sum(best_test_error_so_far_at_i for i in 1..10)
```
Menor es mejor.
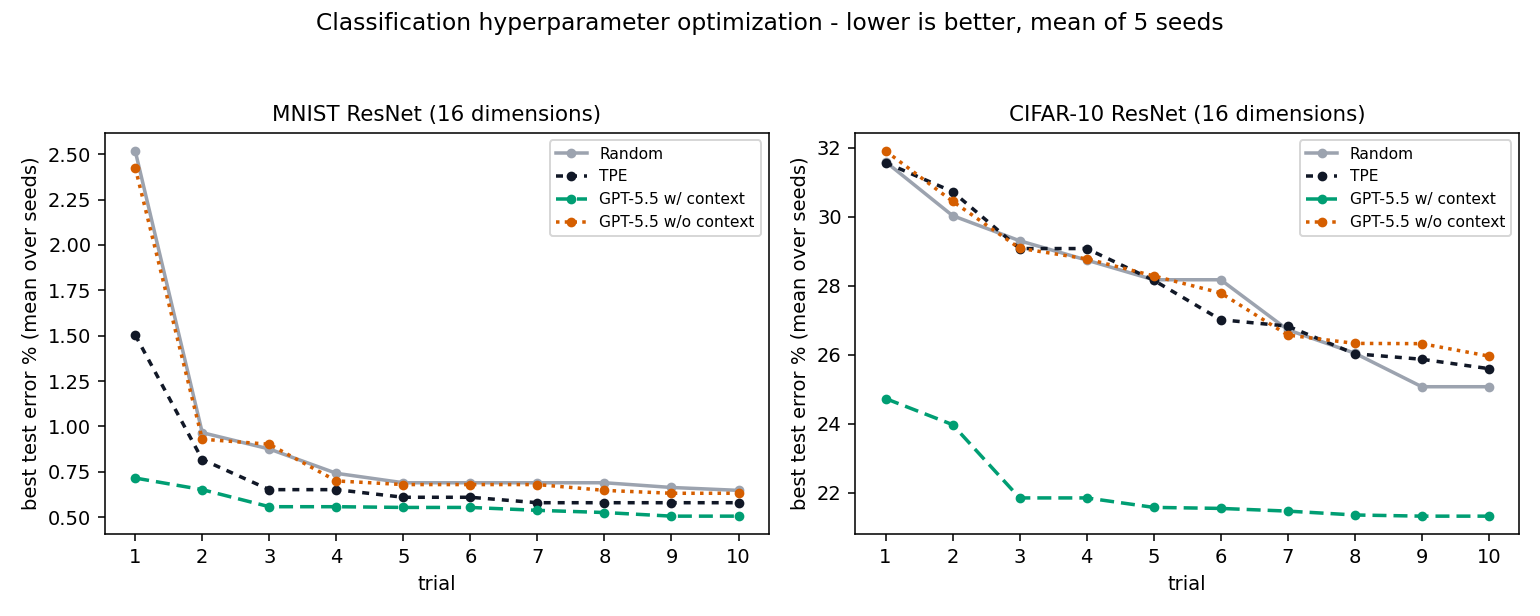
| método | error acumulado MNIST ↓ | error final MNIST ↓ | error acumulado CIFAR-10 ↓ | error final CIFAR-10 ↓ |
|---|---:|---:|---:|---:|
| Random | 9.174 | 0.648% | 278.920 | 25.072% |
| TPE | 7.166 | 0.580% | 279.936 | 25.596% |
| **GPT-5.5 w/ context** | **5.668** | **0.506%** | **220.994** | **21.322%** |
| GPT-5.5 w/o context | 8.910 | 0.632% | 281.466 | 25.960% |
GPT-5.5 w/ context reduce el error cumulative best-so-far un **20.9%** frente a TPE en MNIST
y un **20.8%** frente a Random en CIFAR-10. Sin contexto, es 24.3% peor que TPE en MNIST
y 0.9% peor que Random en CIFAR-10.
[`examples/mnist.py`](../../examples/mnist.py) y [`examples/cifar10.py`](../../examples/cifar10.py)
ajustan learning rate, batch size, weight decay, label smoothing, tres anchos de stage,
tres profundidades de stage y cuatro controles dropout. MNIST añade translation y rotation;
CIFAR-10 usa crop padding y flip probability.
### Ajuste de controladores Q-learning: Acrobot-v1 y LunarLander-v3
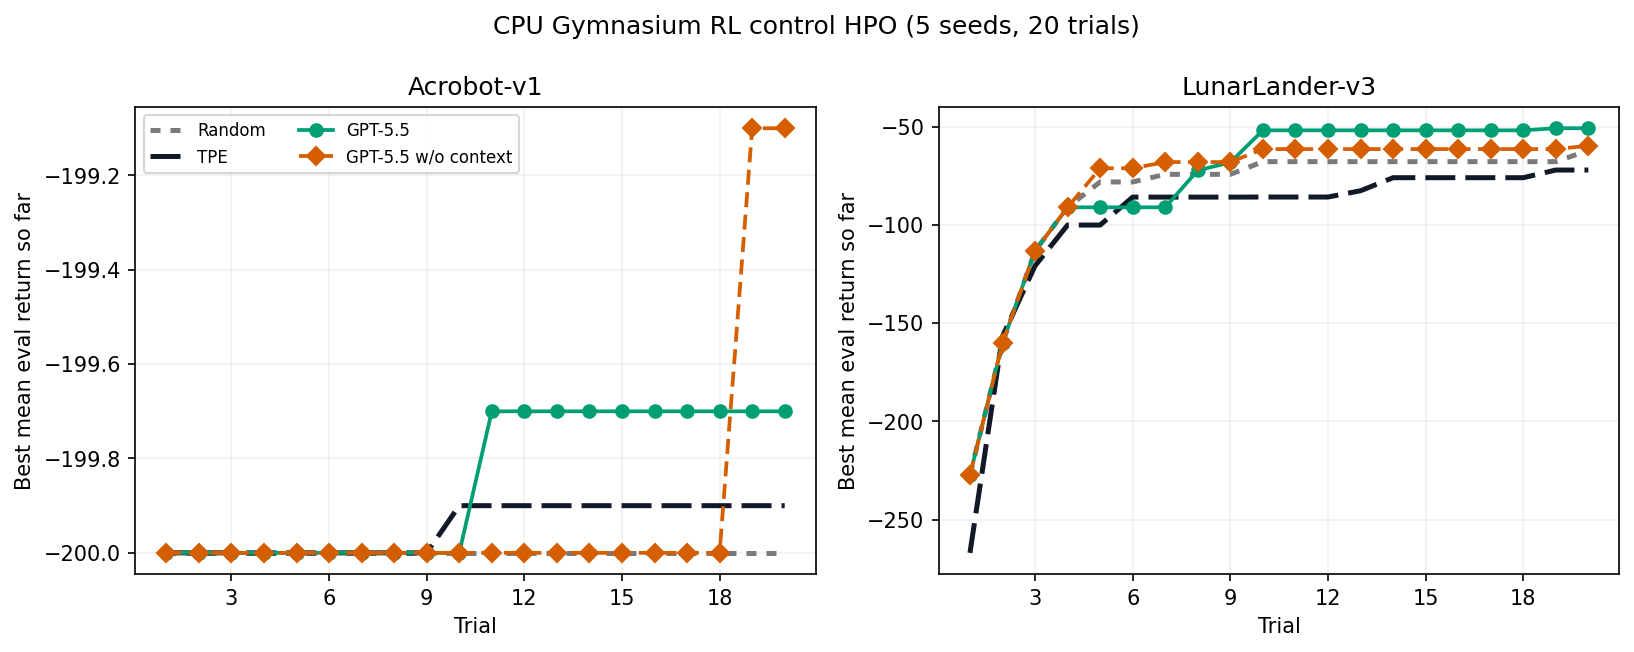
Este benchmark CPU-only de Gymnasium ajusta un controlador Q-learning discretizado para Acrobot-v1 y LunarLander-v3.
Cada método ejecuta 20 trials sobre cinco seeds (`0..4`); el objetivo es el retorno medio de evaluación,
por lo que más alto es mejor. El runner paraleliza entre seeds y dentro de cada study HPO con `--workers`.
Los brazos GPT-5.5 usan high modeling effort y los últimos 5 trials de historial.
| método | retorno Acrobot-v1 ↑ | retorno LunarLander-v3 ↑ |
|---|---:|---:|
| Random | -200.000 | -62.139 |
| TPE | -199.900 | -72.088 |
| **GPT-5.5 w/ context** | **-199.700** | **-50.825** |
| GPT-5.5 w/o context | -199.100 | -59.751 |
Con 20 trials y cinco trials de historial en el prompt, GPT-5.5 w/ context logra el mejor retorno medio
en ambos entornos: 0.2 por encima de TPE en Acrobot-v1 y 11.3 por encima de Random en LunarLander-v3.
Tómalo como un stress test CPU HPO, no como una clasificación universal.
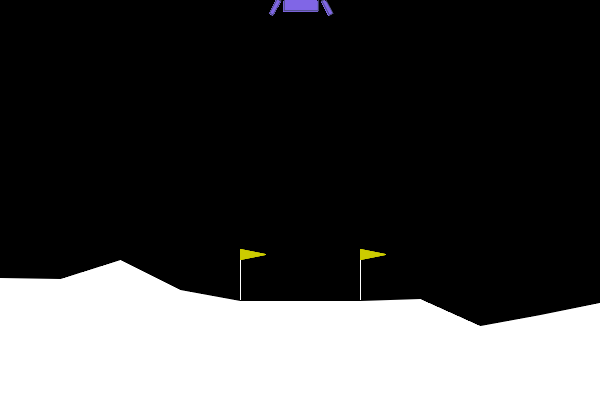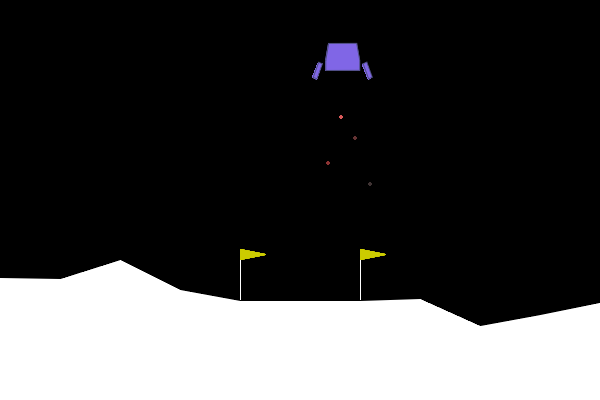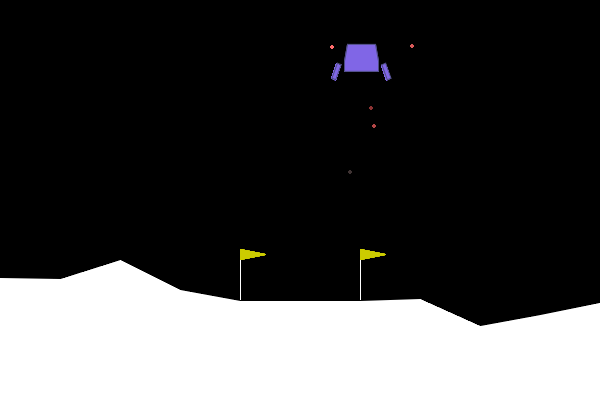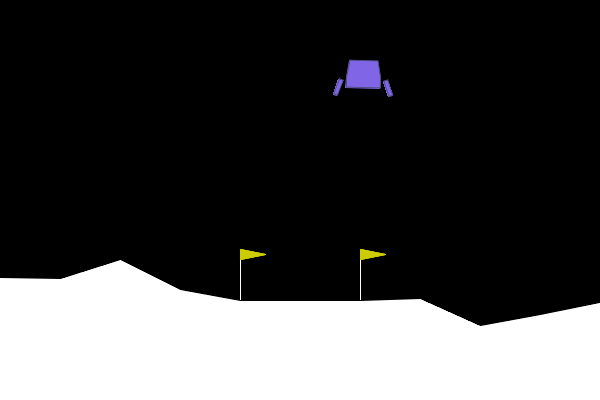
Para la animación, optim-agent ajusta siete ganancias de un controlador determinista LunarLander con un seed HPO.
Cada trial usa los mismos 20 seeds de rollout, priorizando el número de aterrizajes exitosos y luego el retorno medio.
El trial elegido aterrizó en los 20 rollouts; el GIF muestra su rollout de mayor retorno.
### Ajuste de clasificador gradient boosting: probabilidades de impago crediticio
Este benchmark CPU-only ajusta ocho parámetros de entrenamiento de un `HistGradientBoostingClassifier` sobre UCI
[Default of Credit Card Clients](https://archive.ics.uci.edu/dataset/350/default+of+credit+card+clients):
30.000 filas, 23 variables y objetivo de impago del mes siguiente. El archivo oficial está fijado por SHA-256,
licenciado CC BY 4.0 y dividido una sola vez en 60% train, 20% validation y 20% untouched test data.
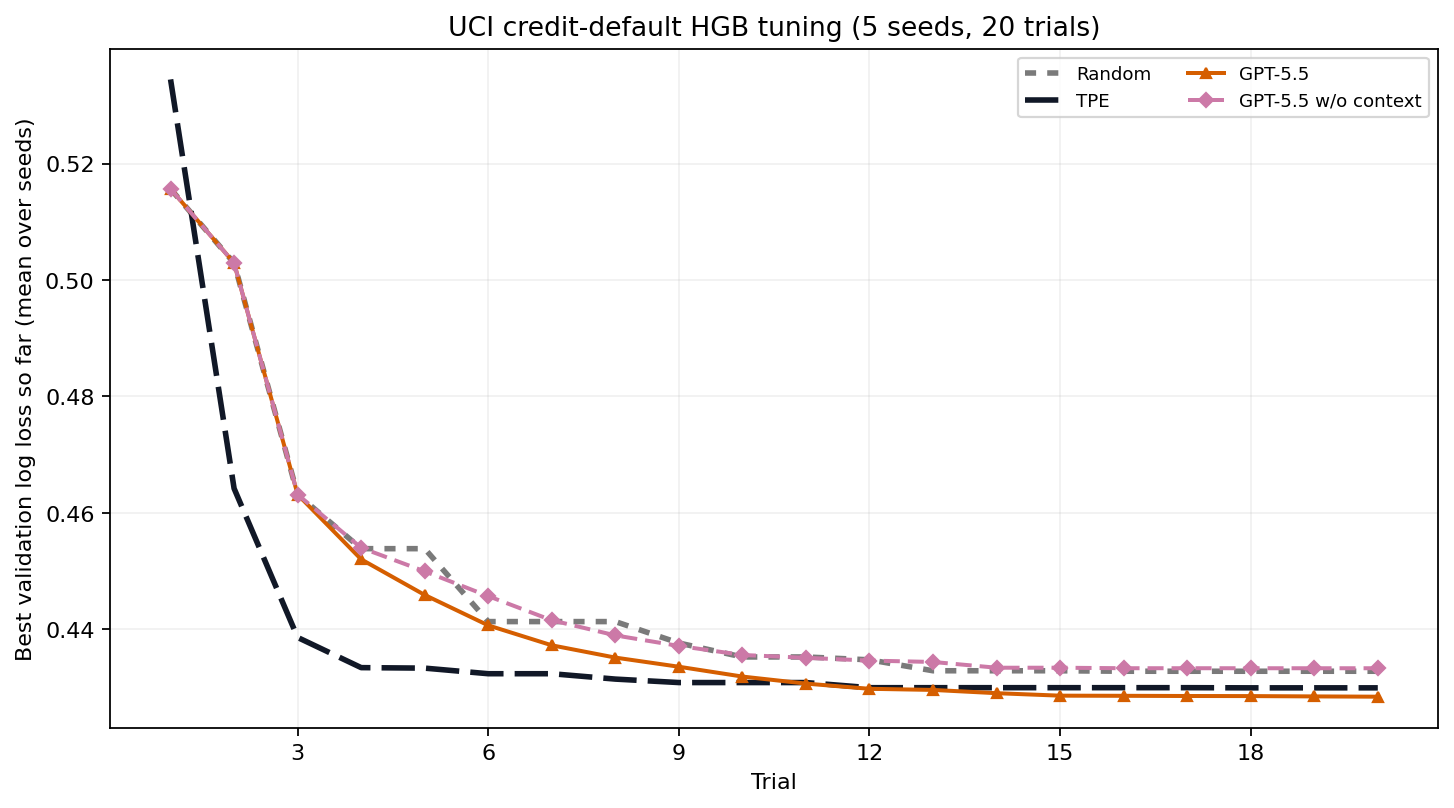
Todos los métodos usan la misma partición, 20 trials y seeds `0..4`. Ambos brazos GPT-5.5 usan
high modeling effort, 20 trials de prompt history, explicit reasoning y qualitative notes.
| método | log loss validación final ↓ | log loss test retenido ↓ |
|---|---:|---:|
| Random | 0.433 | 0.425 |
| TPE | 0.430 | 0.422 |
| GP-BO | 0.430 | 0.423 |
| **GPT-5.5 w/ context** | **0.428** | **0.422** |
| GPT-5.5 w/o context | 0.433 | 0.427 |
El contexto reduce el log loss final de validación un 1.13% y el log loss de test un 1.23%
frente al control no-context. GPT-5.5 también tiene menor pérdida media de validación y test que Random, TPE y GP-BO.
Como la configuración retenida se eligió usando validación y test, el resultado de test es una comparación benchmark,
no una estimación intocada de generalización.
Es un benchmark metodológico, no un sistema de decisión crediticia en producción. Desplegarlo requeriría revisión de equidad,
calibración, drift, gobernanza y legal.
Reproducir los artefactos benchmark:
```bash
pip install -e ".[examples]"
# Classification
python scripts/verify_classification_cumulative_error.py run-no-context
python scripts/verify_classification_cumulative_error.py
# Hard functions
python examples/hard_functions.py distributed \
--agents Random TPE GPT-5.5 Opus-4.8 Sonnet-5 GLM-5.2 Big-pickle \
DeepSeek-V4-Flash Nemotron-3-Ultra MiMo-v2.5 \
--trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-kimi.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Kimi-K3 --trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-minimax.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Minimax-M3 --trials 10 --seeds 0 1 2 3 4
python examples/hard_functions.py plot
# Credit-card HGB
pip install -e ".[ml,examples]"
python examples/credit_card.py download
python examples/credit_card.py preflight
python examples/credit_card.py run
python examples/credit_card.py selfcheck
python examples/credit_card.py summary
python examples/credit_card.py plot
# RL control
pip install -e ".[rl,examples]"
python examples/rl_control.py preflight
python examples/rl_control.py run --seeds 0 1 2 3 4 --workers 10
python examples/rl_control.py selfcheck
python examples/rl_control.py summary
python examples/rl_control.py plot
python examples/rl_control.py gif
```
## Guía de uso
### Controles del prompt del sampler
`effort` se reenvía al flag reasoning-effort del backend CLI. El prompt del harness se controla por separado:
```python
oa.AgentSampler(
backend="codex",
effort="medium",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
)
```
Usa `history=None` para mostrar todos los trials completados/pruned. Usa
`explicit_reasoning=False` o `qualitative_notes=False` para respuestas más cortas del agente.
### Registro de trials
`study.optimize(..., verbose=...)` controla la salida por trial:
- `verbose=True` (por defecto) muestra una tabla en un terminal interactivo: una fila por
trial con las columnas `trial`, `value`, `best`, `state`, más una columna por parámetro
del espacio de búsqueda en orden de primera aparición. Las filas largas se truncan con
una elipsis para ajustarse al ancho del terminal; los valores ausentes (p. ej. trials
fallidos) se muestran como `-`.
- Cuando stdout no es un TTY (salida redirigida, logs de CI), `verbose=True` / `"table"`
recurre automáticamente al formato de una línea, apto para grep
(`[optim-agent] trial 3: value=0.91 state=complete best=0.91`).
- `verbose="line"` usa siempre el formato de una línea, incluso en un TTY.
- `verbose="table"` usa la tabla en un TTY y el formato de una línea al redirigir.
- `verbose=False` silencia la salida por trial.
Con espacios define-by-run, un trial que introduce una nueva clave de parámetro reimprime
el encabezado con el superconjunto de columnas.
### Agente de resumen
Pasa `summarize=True` a `create_study` para que el agente narre el study terminado una
vez, después del último trial:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.json",
summarize=True,
)
study.optimize(objective, n_trials=20)
print(study.summary) # también se persiste en el almacenamiento JSON / SQLite
```
El resumen se estructura en cuatro secciones: mejor configuración, hallazgos del espacio
de búsqueda, aspectos destacados de la trayectoria y siguientes pasos sugeridos. Se
imprime en el terminal y se persiste en `study.summary` (clave aditiva en el
almacenamiento JSON y en la tabla `meta` de SQLite; los studies antiguos se cargan con
`summary=None`).
Resolución del backend: un `summary_backend=` explícito tiene prioridad; si no, se
reutiliza el backend del sampler cuando el sampler es un `AgentSampler`. Con cualquier
otro sampler, pasa `summary_backend=` o `create_study` lanzará un `ValueError` que indica
la solución. `summary_model=` / `summary_effort=` sobrescriben el model/effort del
sampler para el resumen. Las respuestas del agente que no se puedan parsear en las cuatro
secciones recurren a imprimir el texto en bruto: un resumen nunca hace fallar el study, y
los studies sin trials completados lo omiten con un aviso de una línea. `backend="mock"`
también funciona para el summarizer, de modo que demos y tests se ejecutan sin un CLI de
agente real.
### Pruning
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="codex"),
pruner=oa.AgentPruner(
backend="codex", level="medium", effort="medium",
), # level: loose | medium | tight
)
def objective(trial):
lr = trial.suggest_float("lr", 1e-5, 1e-1, log=True,
context="learning rate for training an image classifier")
for epoch in range(20):
loss = train_one_epoch(lr)
trial.report(loss, epoch)
if trial.should_prune():
raise oa.TrialPruned()
return loss
```
El pruner agent compara la curva de aprendizaje actual con trials completados y responde prune/keep;
`loose` solo poda runs claramente inferiores, mientras `tight` poda de forma más agresiva.
Los errores del agente nunca podan un trial.
### Concurrencia y studies distribuidos
Configura `max_concurrency` (por defecto `1`) para evaluar varios trials a la vez, y usa un archivo SQLite
`storage` (`.db` / `.sqlite`) como historial compartido seguro para concurrencia:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.db", # SQLite -> safe for many workers; .json stays single-writer
max_concurrency=8, # up to 8 objectives run at once
)
study.optimize(objective, n_trials=100)
```
- **Dentro de un proceso**, `max_concurrency` ejecuta objectives en un thread pool. Las consultas de agent sampling
se encolan y serializan para que cada propuesta vea el historial del proceso; solo las llamadas objective corren en paralelo.
- **Entre procesos / máquinas**, todos apuntan al mismo `storage` SQLite. La base de datos es el canal de comunicación:
WAL permite que cada worker añada resultados y lea historial sin conflictos de escritura.
Limitaciones: los threads comparten el GIL, así que objectives CPU-bound en Python puro van mejor en procesos separados con SQLite compartido.
Los workers concurrentes no ven los puntos in-flight de los demás y pueden explorar regiones cercanas.
### Modo skill (el agente lee el código del proyecto)
El paquete pip trata el objective como una caja negra. El [skill optim-agent](../../SKILL.md) va más allá:
cargado en una sesión de agente de programación, el agente primero lee el proyecto para entender el papel de cada parámetro,
y luego conduce el mismo study loop con `study.ask(params)` / `study.tell(trial, value)`, usando el JSON del study como historial.
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Plugin Claude Code:
```bash
claude plugin marketplace add Optim-Agent/optim-agent
claude plugin install optim-agent@optim-agent
```
Plugin Codex:
```bash
codex plugin marketplace add Optim-Agent/optim-agent
codex plugin add optim-agent@optim-agent
```
```python
trial = study.ask({"threshold": 0.72, "budget": 80})
study.tell(trial, evaluate_system(**trial.params))
```
### Pruebas offline
`AgentSampler(backend="mock")` es un sustituto sin tokens que hace hill climbing alrededor del mejor punto,
útil para probar integraciones antes de llamadas a agentes.
## Solución de problemas
- **`claude` devuelve 401 dentro de una sesión de agente** - las sesiones anidadas heredan `ANTHROPIC_API_KEY`;
ejecuta con `env -u ANTHROPIC_API_KEY` o desde una shell limpia.
- **Una llamada backend expira o emite salida inválida** - el sampler avisa y vuelve a un punto aleatorio para ese trial; el study continúa.
- **OpenCode con studies distribuidos** - OpenCode currently does not support distributed computing
in optim-agent; usa el flujo de un solo proceso u otro backend.
## Contribuir
Desarrollo local:
```bash
pip install -e ".[examples]"
pytest # runs tests/test_optim_agent.py
```
Abre un issue para discutir cambios grandes antes de enviar un PR. Añadir un nuevo backend de agente normalmente implica
una pequeña función en [`optim_agent/agent.py`](../../optim_agent/agent.py).
El [`README.md`](../../README.md) en inglés sigue siendo la fuente de autoridad para versiones, cifras benchmark y backends.
## Agradecimientos
- [Optuna](https://github.com/optuna/optuna) por popularizar la interfaz Study/Trial, proporcionar la baseline TPE usada
en ejemplos y benchmarks, y fijar un alto estándar para herramientas prácticas de optimización.
- [OpenCode](https://github.com/sst/opencode) por dar acceso a los modelos gratuitos evaluados en los benchmarks de funciones difíciles.
## Licencia
[MIT](../../LICENSE)