Агентная оптимизация систем с помощью coding agents.
Автоматизирует итеративную настройку параметров, которой обычно занимается алгоритмический инженер.
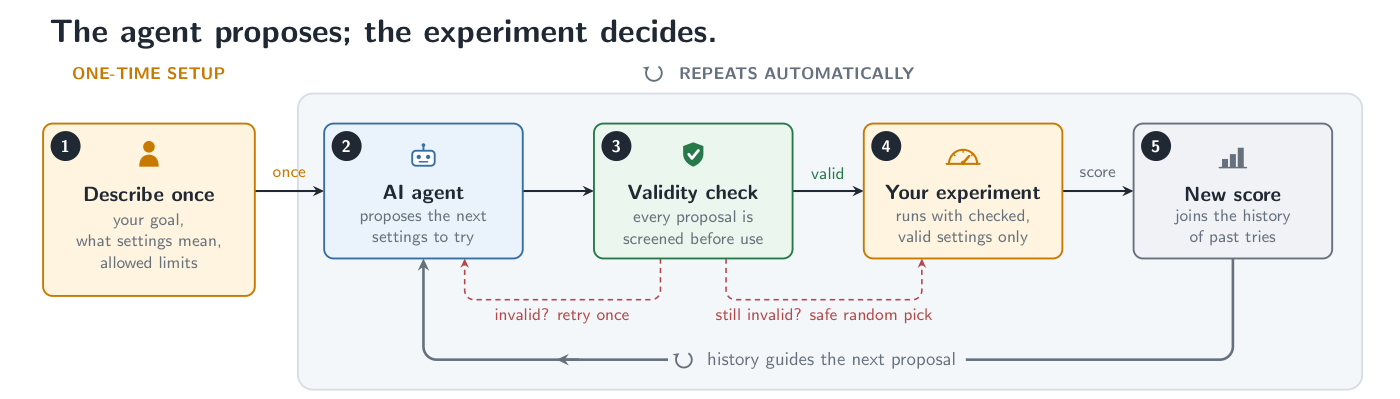
optim-agent позволяет Claude Code / Codex / OpenCode настраивать реальные параметры системы:
читать код, предлагать trials и записывать измеренные objective-результаты. Используйте его,
когда система имеет настраиваемые параметры и измеримый objective. Он сочетает смысл каждого
параметра с сигналами из истории trials, а затем предлагает следующую конфигурацию для оценки.
Оценка objective остается главным источником истины: optim-agent предлагает значения, валидирует
их по объявленному пространству, записывает результаты и возвращается к безопасному sampling,
если ответ агента невалиден.
| Модели | Системы | Исследования |
|---|---|---|
| Обучение, архитектуры и RL-эксперименты | Инференс, latency, cost, control и decision rules | Quant-сигналы, симуляции и научные workflows |
## Зачем нужен optim-agent
- **Семантические предложения** - coding agents учитывают смысл параметров, контекст и наблюдаемые результаты, а не считают каждую размерность безымянной координатой.
- **Польза при малом бюджете** - полезно, когда оценки дорогие, а классическим surrogate-моделям еще не хватает данных.
- **Рост вместе с Agent CLI** - качество предложений может улучшаться по мере развития базовых coding agents, например от GPT-5.5 к GPT-5.6, без изменения оптимизационного кода.
- **Аудируемые решения** - JSON/SQLite studies сохраняют конфигурации, результаты, состояния, контекст и опциональное обоснование агента.
- **Ограниченное исполнение** - агент только предлагает значения; optim-agent валидирует их по объявленному пространству, а невалидный вывод заменяет безопасным sampling.
## Установка
Установить Codex skill:
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Установить Claude Code plugin:
```bash
claude plugin marketplace add Optim-Agent/optim-agent && claude plugin install optim-agent@optim-agent
```
Установить Python package:
```bash
# Стабильная версия из PyPI
python -m pip install optim-agent
# Свежий исходный код с GitHub
python -m pip install "optim-agent @ git+https://github.com/Optim-Agent/optim-agent.git"
```
Нужен как минимум один аутентифицированный agent CLI в `PATH`:
[claude](https://docs.anthropic.com/en/docs/claude-code),
[codex](https://github.com/openai/codex) или
[OpenCode](https://github.com/sst/opencode).
## Быстрый старт
```python
import optim_agent as oa
def objective(trial):
threshold = trial.suggest_float(
"threshold", 0.05, 0.95,
context="decision threshold; higher values trade recall for precision",
)
budget = trial.suggest_int(
"budget", 10, 200, log=True,
context="compute or operating budget; larger values may improve quality",
)
return evaluate_system(threshold=threshold, budget=budget) # domain code
study = oa.create_study(
direction="maximize",
sampler=oa.AgentSampler(
backend="claude", # or "codex" / "opencode"
effort="high",
context="maximize system quality under a strict operating-cost budget",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
),
storage="study.json", # optional: persist and resume
summarize=True, # optional: agent-written result summary after the last trial
)
study.optimize(objective, n_trials=20)
print(study.best_value, study.best_params)
print(study.summary) # the summary agent's narration of the finished study
```
Опциональный `context` дает study и параметрам доменный смысл. Его можно задать на уровне
`AgentSampler(context=...)`, на уровне параметра через `suggest_*(..., context=...)` или в обоих местах.
Можно также запустить [`examples/quickstart.py`](../../examples/quickstart.py) или пройти
[`tutorials/quickstart.ipynb`](../../tutorials/quickstart.ipynb).
## Области применения
| Область | Параметры, которые может настраивать optim-agent | Пример objective |
|---|---|---|
| **Обучение моделей** | learning rates, архитектуры, augmentation, regularization | validation quality, compute, robustness |
| **Inference и serving** | quantization, batching, decoding, caching, routing | quality, latency, throughput, cost |
| **Quantitative research** | signal windows, thresholds, rebalance rules, risk controls | walk-forward return, drawdown, turnover |
| **RL и решения** | objective weights, exploration schedules, environment settings, policy thresholds | return, safety, sample efficiency |
| **Научные workflows** | simulation inputs, solver settings, experimental controls | fit, error, runtime, resource use |
| **Black-box systems** | любая ограниченная categorical, integer или continuous configuration | scalar objective score |
Дополнительные примеры: [`examples/sklearn_tuning.py`](../../examples/sklearn_tuning.py) и
[`examples/inference_tuning.py`](../../examples/inference_tuning.py).
Для reinforcement learning optim-agent настраивает систему вокруг learning loop; он не заменяет policy-learning algorithm.
## Траектория оптимизации
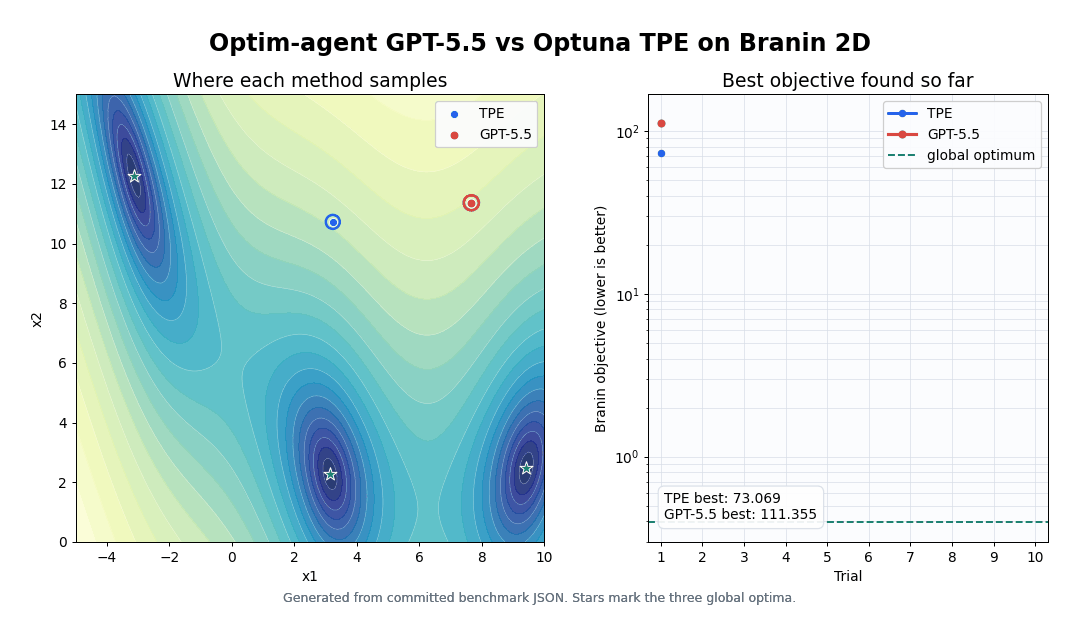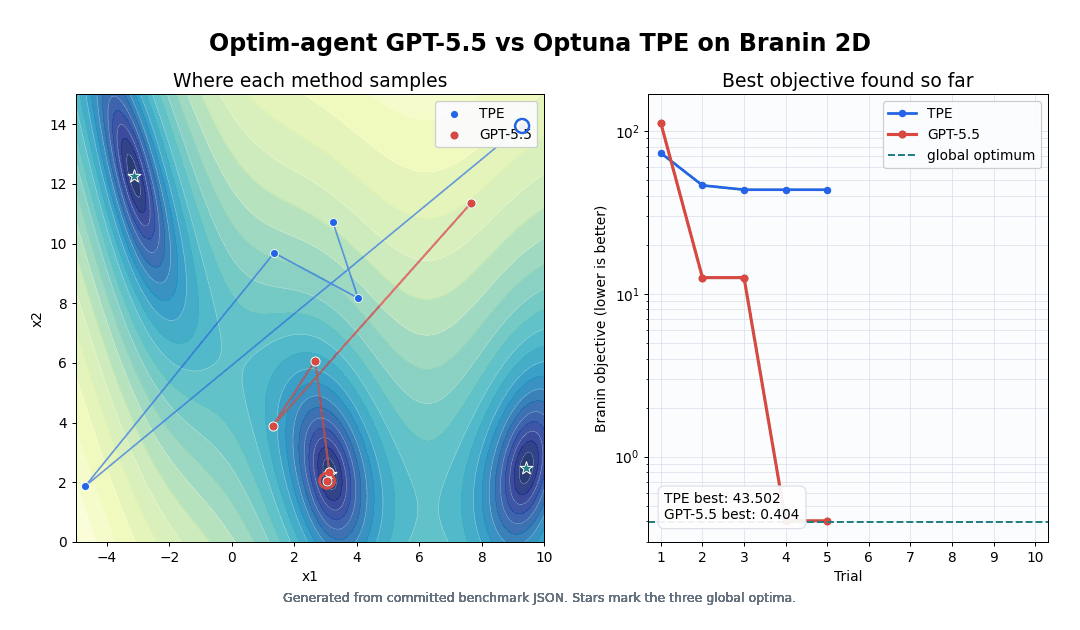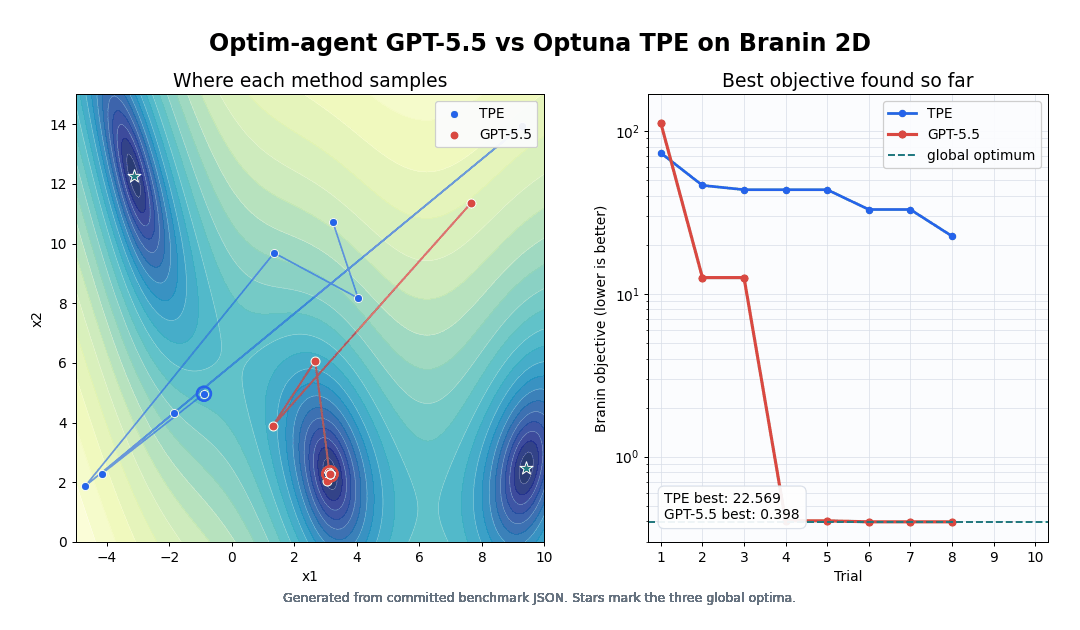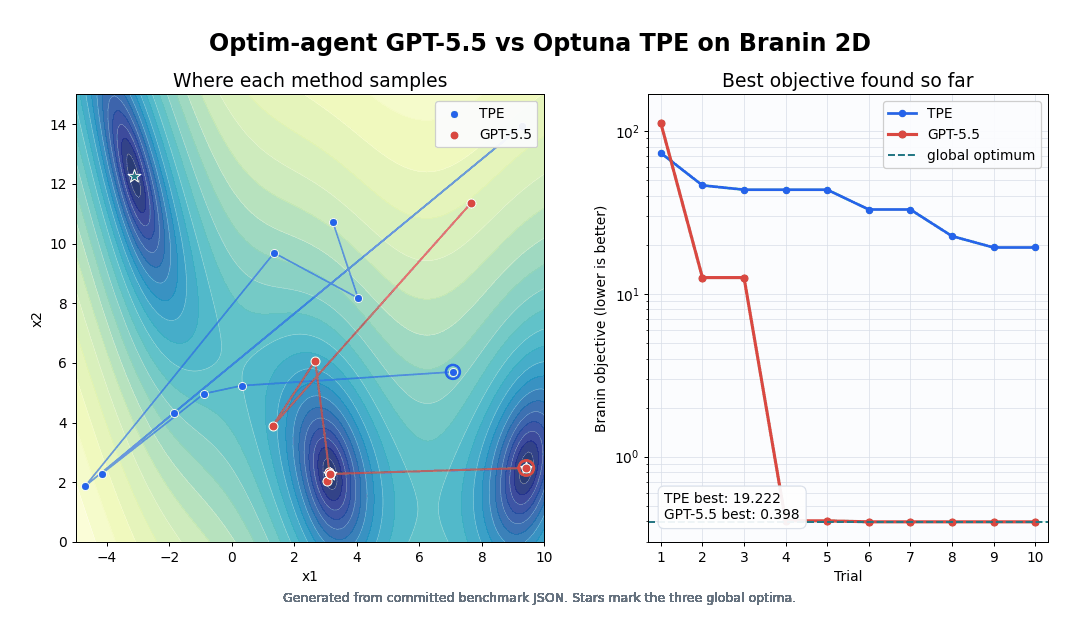
Этот seed-0 Branin trace сравнивает TPE и GPT-5.5 при одинаковом бюджете в 10 trials
и показывает incumbent objective после каждого trial. Это иллюстрация траектории;
агрегированные benchmark-результаты и команды воспроизведения ниже.
### Оптимизация математических функций без контекста: Branin-2D и Ackley-5D
Hard-function agents **не получают task context**: только общие имена `x1...x5`, численные границы
и историю trials. Runs используют 10 trials по пяти seeds; Random и TPE остаются неизменными baselines.
#### Топовые агенты
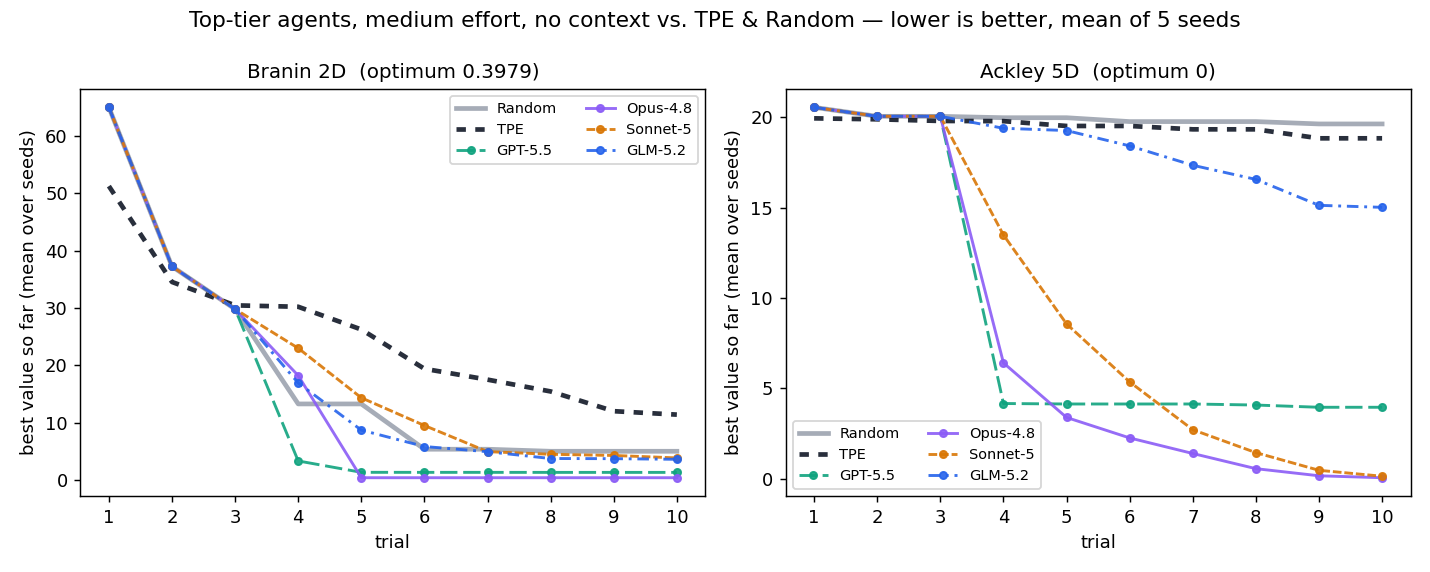
| метод | mean best Branin ↓ | mean best Ackley-5D ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| GPT-5.5 | 1.326 | 3.960 |
| **Opus-4.8** | **0.398** | **0.061** |
| Sonnet-5 | 3.850 | 0.143 |
| Kimi-K3 | 2.082 | 0.907 |
| Minimax-M3 | 0.970 | 0.574 |
| GLM-5.2 | 3.609 | 15.023 |
Зафиксированные модели: `gpt-5.5`, `claude-opus-4-8`, `claude-sonnet-5`,
`kimi-k3`, `MiniMax-M3` и `glm-5.2`.
Opus-4.8 в среднем достигает optimum на Branin и имеет лучший five-seed Ackley mean.
#### Агенты OpenCode (бесплатные)
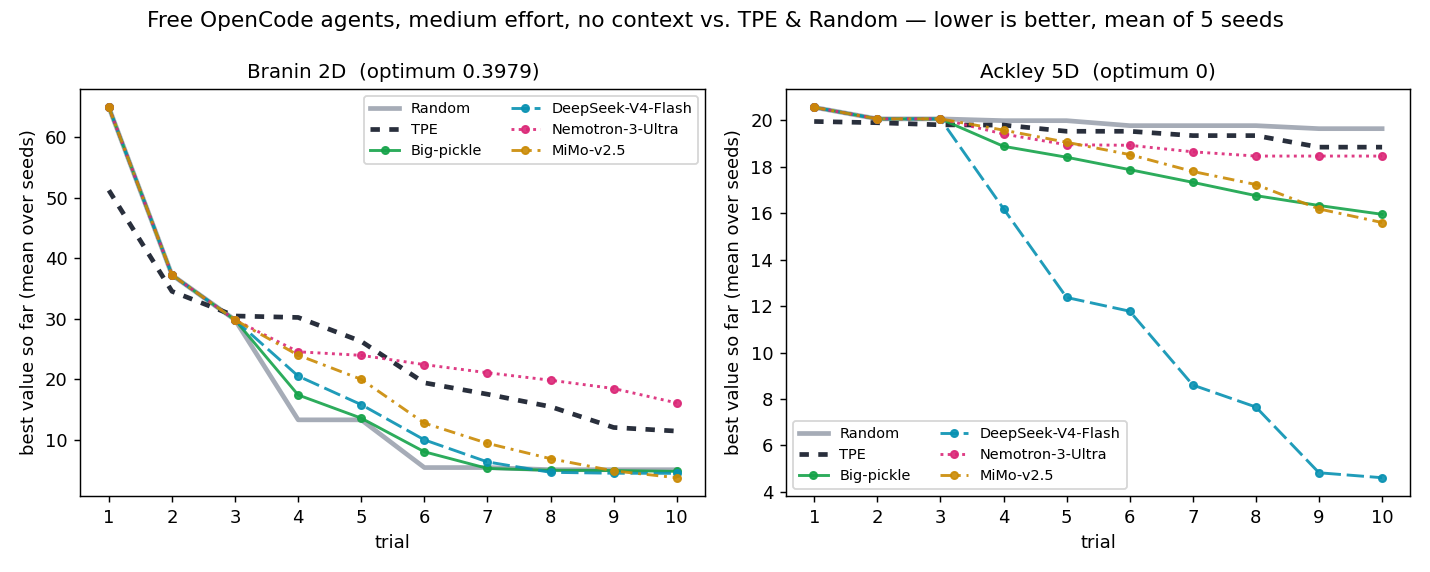
| метод | mean best Branin ↓ | mean best Ackley-5D ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| Big-pickle | 4.734 | 15.951 |
| **DeepSeek-V4-Flash** | 4.410 | **4.608** |
| Nemotron-3-Ultra | 16.051 | 18.459 |
| **MiMo-v2.5** | **3.682** | 15.597 |
Модели, размещенные в OpenCode, не требуют платного model API. Бесплатный pool меняется;
это обновление фиксирует `opencode/big-pickle`, `opencode/deepseek-v4-flash-free`,
`opencode/nemotron-3-ultra-free` и `opencode/mimo-v2.5-free`. DeepSeek V4 Flash показывает
лучший free-model Ackley mean, а MiMo-v2.5 - лучший free-model Branin mean.
### Настройка ResNet-классификаторов изображений: MNIST и CIFAR-10
Классификационный benchmark сравнивает **Random**, Optuna **TPE**, **GPT-5.5 w/ context**
и **GPT-5.5 w/o context** на пяти seeds (`0..4`) и 10 trials. Условие с context получает
естественно-языковые описания study и параметров; no-context получает только bounds и историю trials.
Главная метрика подчеркивает быстрое улучшение:
```text
cumulative_best_so_far_error = sum(best_test_error_so_far_at_i for i in 1..10)
```
Меньше значит лучше.
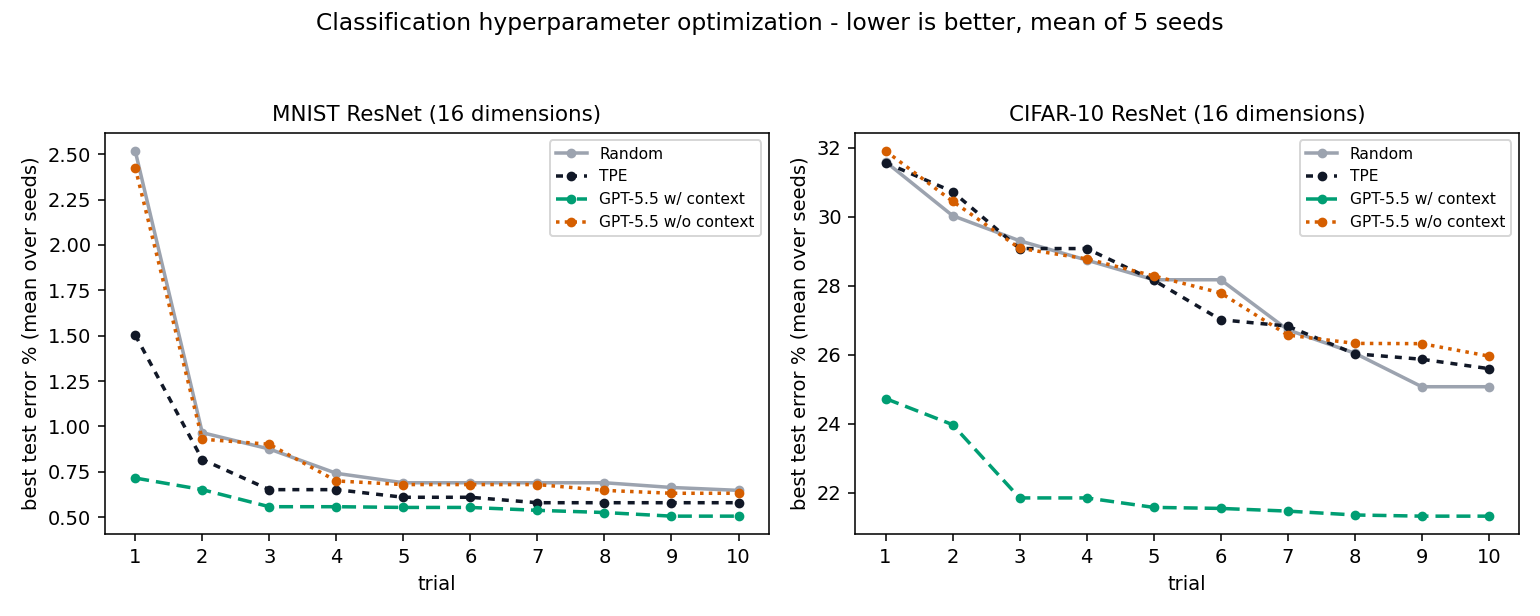
| метод | MNIST cumulative error ↓ | MNIST final error ↓ | CIFAR-10 cumulative error ↓ | CIFAR-10 final error ↓ |
|---|---:|---:|---:|---:|
| Random | 9.174 | 0.648% | 278.920 | 25.072% |
| TPE | 7.166 | 0.580% | 279.936 | 25.596% |
| **GPT-5.5 w/ context** | **5.668** | **0.506%** | **220.994** | **21.322%** |
| GPT-5.5 w/o context | 8.910 | 0.632% | 281.466 | 25.960% |
GPT-5.5 w/ context снижает cumulative best-so-far error на **20.9%** относительно TPE на MNIST
и на **20.8%** относительно Random на CIFAR-10. Без context он на 24.3% хуже TPE на MNIST
и на 0.9% хуже Random на CIFAR-10.
[`examples/mnist.py`](../../examples/mnist.py) и [`examples/cifar10.py`](../../examples/cifar10.py)
настраивают learning rate, batch size, weight decay, label smoothing, три stage widths,
три stage depths и четыре dropout controls. MNIST добавляет translation и rotation;
CIFAR-10 использует crop padding и flip probability.
### Настройка Q-learning контроллеров: Acrobot-v1 и LunarLander-v3
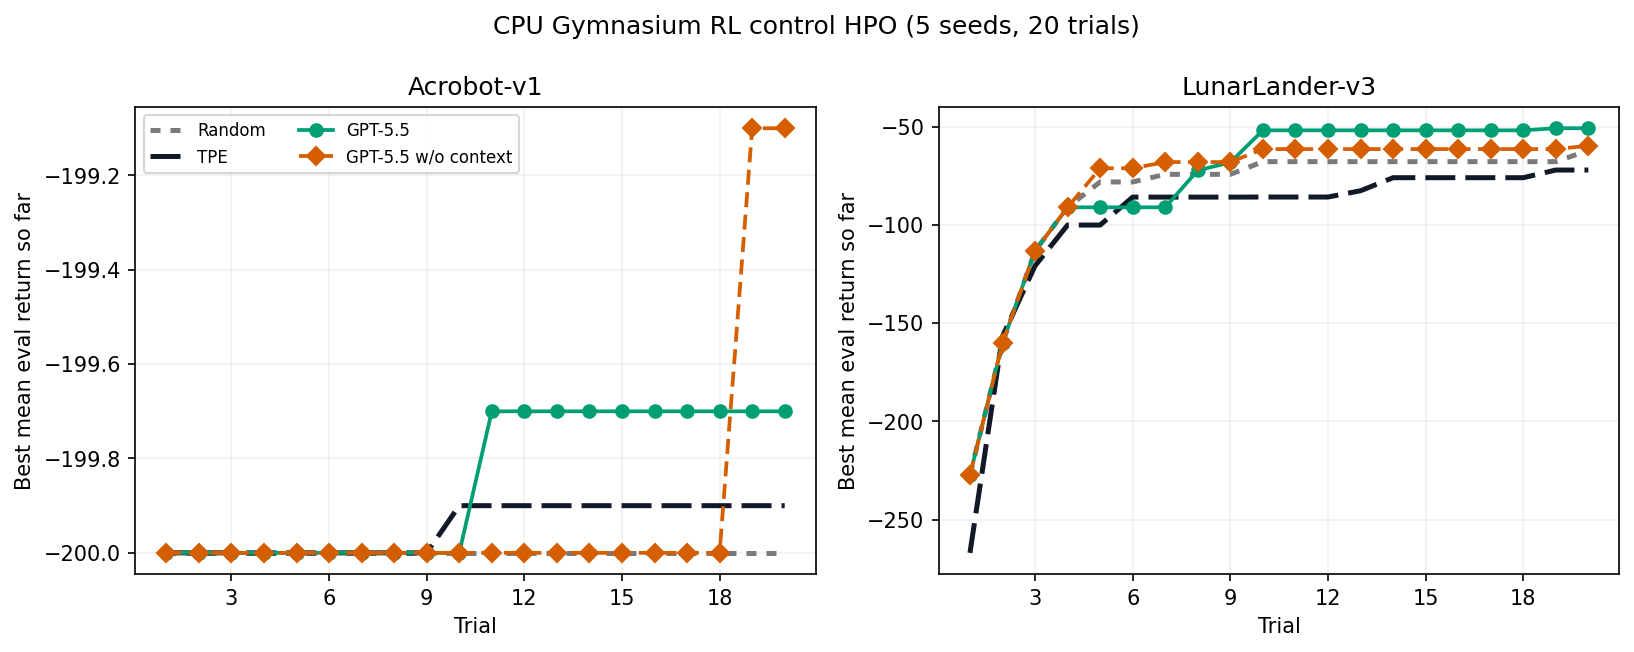
Этот CPU-only Gymnasium benchmark настраивает дискретизированный Q-learning controller для
Acrobot-v1 и LunarLander-v3. Каждый метод выполняет 20 trials на пяти seeds (`0..4`);
objective - средний evaluation return, поэтому больше лучше. Runner параллелит по seeds
и внутри каждой HPO study через `--workers`. GPT-5.5 arms используют high modeling effort
и последние 5 trials history.
| метод | Acrobot-v1 return ↑ | LunarLander-v3 return ↑ |
|---|---:|---:|
| Random | -200.000 | -62.139 |
| TPE | -199.900 | -72.088 |
| **GPT-5.5 w/ context** | **-199.700** | **-50.825** |
| GPT-5.5 w/o context | -199.100 | -59.751 |
При 20 trials и five-trial prompt history GPT-5.5 w/ context имеет лучший mean return
в обеих средах: на 0.2 выше TPE в Acrobot-v1 и на 11.3 выше Random в LunarLander-v3.
Считайте это CPU HPO stress test, а не универсальным рейтингом.
Для анимации optim-agent настраивает семь gains детерминированного LunarLander controller с одним HPO seed.
Каждый trial использует те же 20 rollout seeds, сначала максимизируя число успешных посадок, затем mean return.
Выбранный trial приземлился во всех 20 rollouts; GIF показывает rollout с максимальным return.
### Настройка gradient boosting classifier: вероятности кредитного дефолта
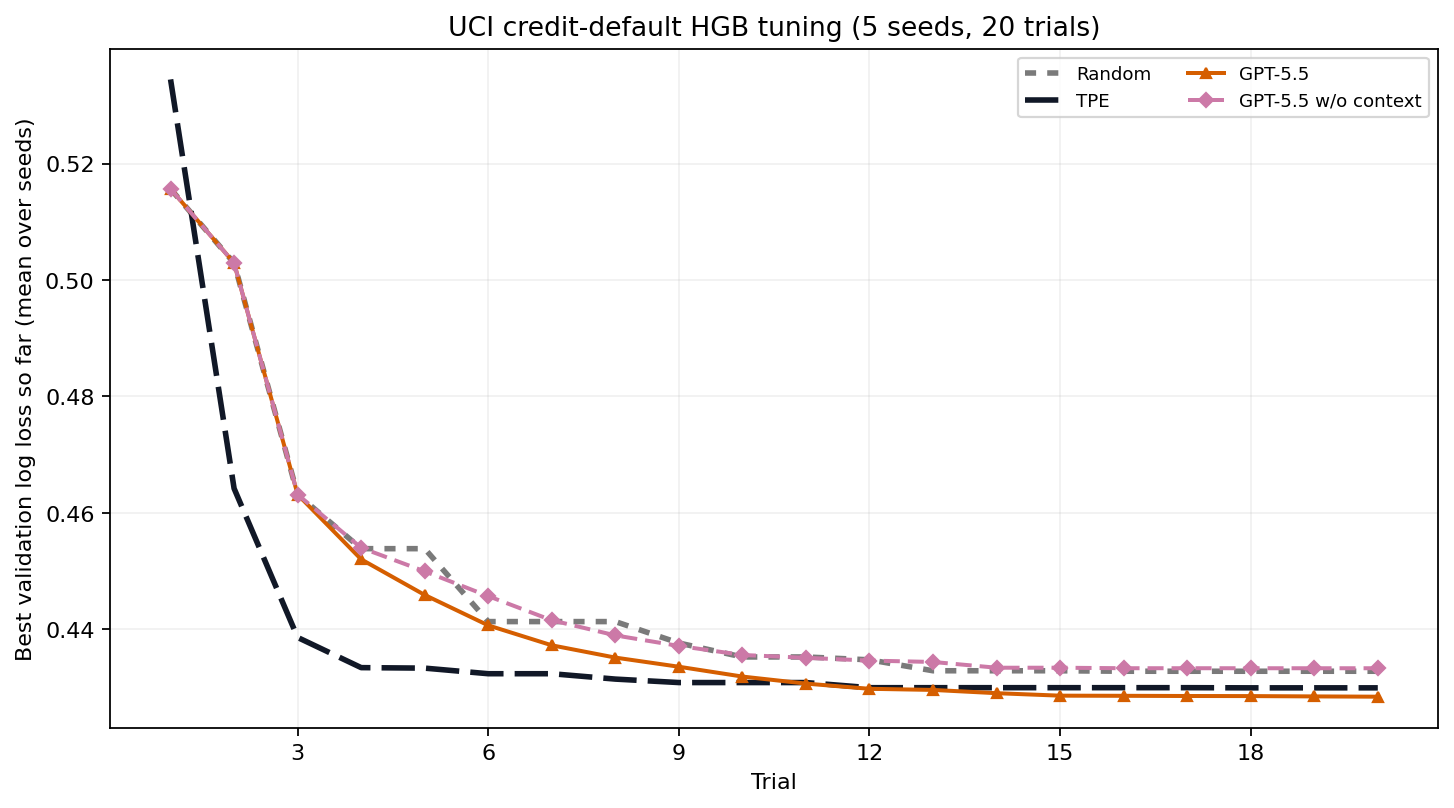
Этот CPU-only benchmark настраивает восемь training parameters `HistGradientBoostingClassifier` на UCI
[Default of Credit Card Clients](https://archive.ics.uci.edu/dataset/350/default+of+credit+card+clients):
30 000 строк, 23 признака и target дефолта следующего месяца. Официальный архив зафиксирован SHA-256,
лицензирован CC BY 4.0 и один раз разделен на 60% train, 20% validation и 20% untouched test data.
Все методы используют одно и то же разбиение, 20 trials и seeds `0..4`. Оба GPT-5.5 arms используют
high modeling effort, 20 trials prompt history, explicit reasoning и qualitative notes.
| метод | final validation log loss ↓ | held-out test log loss ↓ |
|---|---:|---:|
| Random | 0.433 | 0.425 |
| TPE | 0.430 | 0.422 |
| GP-BO | 0.430 | 0.423 |
| **GPT-5.5 w/ context** | **0.428** | **0.422** |
| GPT-5.5 w/o context | 0.433 | 0.427 |
Context снижает final validation log loss на 1.13% и test log loss на 1.23%
относительно matched no-context control. GPT-5.5 также имеет lower mean validation/test loss,
чем Random, TPE и GP-BO. Поскольку сохраненная configuration выбиралась с использованием validation
и test loss, test result является benchmark comparison, а не untouched estimate of generalization.
Это методологический benchmark, не production credit-decision system. Для deployment нужны fairness,
calibration, drift, governance и legal review.
Воспроизвести benchmark artifacts:
```bash
pip install -e ".[examples]"
# Classification
python scripts/verify_classification_cumulative_error.py run-no-context
python scripts/verify_classification_cumulative_error.py
# Hard functions
python examples/hard_functions.py distributed \
--agents Random TPE GPT-5.5 Opus-4.8 Sonnet-5 GLM-5.2 Big-pickle \
DeepSeek-V4-Flash Nemotron-3-Ultra MiMo-v2.5 \
--trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-kimi.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Kimi-K3 --trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-minimax.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Minimax-M3 --trials 10 --seeds 0 1 2 3 4
python examples/hard_functions.py plot
# Credit-card HGB
pip install -e ".[ml,examples]"
python examples/credit_card.py download
python examples/credit_card.py preflight
python examples/credit_card.py run
python examples/credit_card.py selfcheck
python examples/credit_card.py summary
python examples/credit_card.py plot
# RL control
pip install -e ".[rl,examples]"
python examples/rl_control.py preflight
python examples/rl_control.py run --seeds 0 1 2 3 4 --workers 10
python examples/rl_control.py selfcheck
python examples/rl_control.py summary
python examples/rl_control.py plot
python examples/rl_control.py gif
```
## Руководство по использованию
### Sampler Prompt Controls
`effort` передается во flag reasoning-effort backend CLI. Prompt harness управляется отдельно:
```python
oa.AgentSampler(
backend="codex",
effort="medium",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
)
```
Задайте `history=None`, чтобы показать все completed/pruned trials. Используйте
`explicit_reasoning=False` или `qualitative_notes=False` для более коротких ответов агента.
### Логирование trials
`study.optimize(..., verbose=...)` управляет выводом по каждому trial:
- `verbose=True` (по умолчанию) отображает таблицу в интерактивном терминале: одна строка
на trial с колонками `trial`, `value`, `best`, `state` плюс по колонке на каждый
параметр пространства поиска в порядке первого появления. Длинные строки обрезаются
многоточием под ширину терминала; отсутствующие значения (например, у failed trials)
отображаются как `-`.
- Когда stdout не является TTY (перенаправленный вывод, логи CI), `verbose=True` / `"table"`
автоматически переключается на однострочный формат, удобный для grep
(`[optim-agent] trial 3: value=0.91 state=complete best=0.91`).
- `verbose="line"` всегда использует однострочный формат, даже на TTY.
- `verbose="table"` использует таблицу на TTY и однострочный формат при перенаправлении.
- `verbose=False` отключает вывод по trials.
В define-by-run пространствах trial, вводящий новый ключ параметра, повторно печатает
заголовок с надмножеством колонок.
### Агент-суммаризатор
Передайте `summarize=True` в `create_study`, чтобы агент один раз описал завершенную
study после последнего trial:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.json",
summarize=True,
)
study.optimize(objective, n_trials=20)
print(study.summary) # также сохраняется в JSON / SQLite хранилище
```
Сводка структурирована в четыре раздела — лучшая конфигурация, выводы о пространстве
поиска, основные моменты траектории и предлагаемые следующие шаги. Она печатается в
терминал и сохраняется в `study.summary` (аддитивный ключ в JSON-хранилище и в таблице
`meta` SQLite; старые сохраненные studies загружаются с `summary=None`).
Разрешение backend: явный `summary_backend=` имеет приоритет; иначе используется backend
sampler'а, если sampler является `AgentSampler`. С любым другим sampler передайте
`summary_backend=`, иначе `create_study` выбросит `ValueError` с указанием решения.
`summary_model=` / `summary_effort=` переопределяют model/effort sampler'а для сводки.
Ответы агента, которые не удается распарсить во все четыре раздела, откатываются к выводу
сырого текста — сводка никогда не приводит к сбою study, а studies без завершенных trials
пропускают ее с однострочным уведомлением. `backend="mock"` также работает для
суммаризатора, поэтому демо и тесты запускаются без реального agent CLI.
### Pruning
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="codex"),
pruner=oa.AgentPruner(
backend="codex", level="medium", effort="medium",
), # level: loose | medium | tight
)
def objective(trial):
lr = trial.suggest_float("lr", 1e-5, 1e-1, log=True,
context="learning rate for training an image classifier")
for epoch in range(20):
loss = train_one_epoch(lr)
trial.report(loss, epoch)
if trial.should_prune():
raise oa.TrialPruned()
return loss
```
Pruner agent сравнивает текущую learning curve с завершенными trials и отвечает prune/keep;
`loose` pruning только явно слабые runs, а `tight` pruning агрессивнее. Ошибки агента никогда не prune trial.
### Concurrency & Distributed Studies
Установите `max_concurrency` (по умолчанию `1`), чтобы оценивать несколько trials одновременно,
и используйте SQLite `storage` file (`.db` / `.sqlite`) как concurrency-safe shared history:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.db", # SQLite -> safe for many workers; .json stays single-writer
max_concurrency=8, # up to 8 objectives run at once
)
study.optimize(objective, n_trials=100)
```
- **Внутри процесса** `max_concurrency` запускает objectives в thread pool. Agent sampling queries
ставятся в очередь и сериализуются, чтобы каждое предложение видело in-process history; параллельны только objective calls.
- **Между процессами / машинами** направьте всех workers на один SQLite `storage`. Database становится communication channel:
WAL mode позволяет каждому worker добавлять результаты и читать history без write conflicts.
Ограничения: threads делят GIL, поэтому pure-Python CPU-bound objectives лучше запускать в отдельных процессах с общей SQLite storage.
Concurrent workers не видят чужие in-flight points и иногда могут исследовать близкие области.
### Режим skill (агент читает код проекта)
Pip package рассматривает objective как black box. [optim-agent skill](../../SKILL.md) идет дальше:
в сессии coding-agent агент сначала читает проект, чтобы понять роль каждого параметра, затем ведет тот же
study loop через `study.ask(params)` / `study.tell(trial, value)`, а study JSON хранит историю между sessions.
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Claude Code plugin:
```bash
claude plugin marketplace add Optim-Agent/optim-agent
claude plugin install optim-agent@optim-agent
```
Codex plugin:
```bash
codex plugin marketplace add Optim-Agent/optim-agent
codex plugin add optim-agent@optim-agent
```
```python
trial = study.ask({"threshold": 0.72, "budget": 80})
study.tell(trial, evaluate_system(**trial.params))
```
### Offline Testing
`AgentSampler(backend="mock")` - token-free stand-in, который делает hill climbing вокруг лучшей точки,
чтобы тестировать интеграции до реальных agent calls.
## Устранение неполадок
- **`claude` возвращает 401 внутри agent session** - nested sessions наследуют `ANTHROPIC_API_KEY`;
запускайте с `env -u ANTHROPIC_API_KEY` или из чистого shell.
- **Backend call истекает по timeout или дает invalid output** - sampler предупреждает и использует random point для этого trial; study продолжается.
- **OpenCode with distributed studies** - OpenCode currently does not support distributed computing
in optim-agent; используйте single-process workflow или другой backend.
## Участие в разработке
Локальная разработка:
```bash
pip install -e ".[examples]"
pytest # runs tests/test_optim_agent.py
```
Крупные изменения лучше сначала обсудить в issue. Добавить новый agent backend обычно означает
одну небольшую функцию в [`optim_agent/agent.py`](../../optim_agent/agent.py).
Английский [`README.md`](../../README.md) остается источником истины для versions, benchmark values и backend list.
## Благодарности
- [Optuna](https://github.com/optuna/optuna) за популяризацию интерфейса Study/Trial, TPE baseline
в examples и benchmarks и высокий стандарт практичных optimization tools.
- [OpenCode](https://github.com/sst/opencode) за доступ к free models, оцененным в hard-function benchmarks.
## Лицензия
[MIT](../../LICENSE)