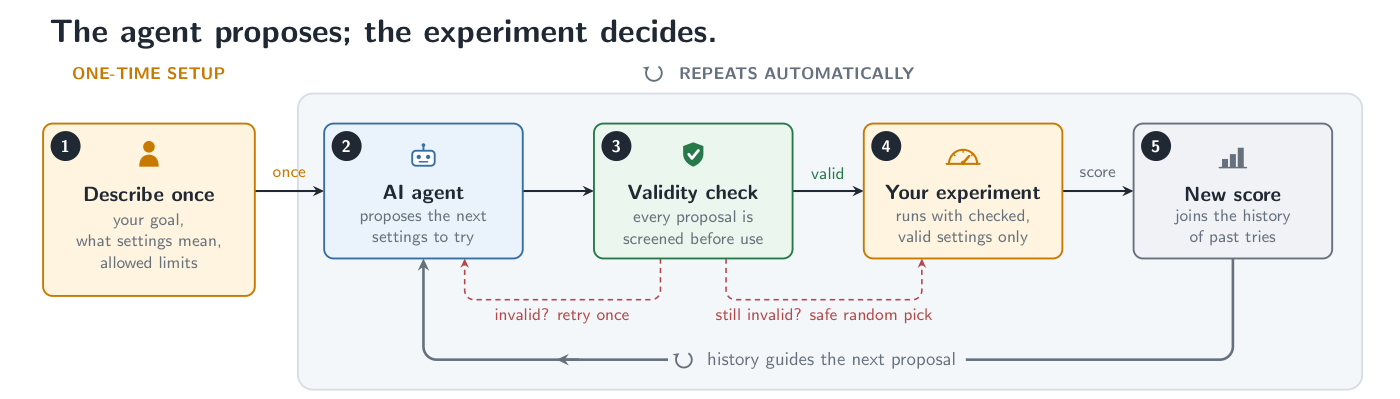
optim-agent permet à Claude Code / Codex / OpenCode de régler de vrais paramètres système
en lisant votre code, en proposant des trials et en enregistrant les résultats objectifs mesurés.
Utilisez-le quand votre système expose des paramètres configurables et un objectif mesurable.
Il combine ce que chaque paramètre *signifie* avec ce que l'historique des trials *montre*,
puis propose la configuration suivante à évaluer. Les évaluations objectives restent l'autorité :
optim-agent propose des valeurs, les valide contre l'espace déclaré, enregistre les résultats
et revient à un échantillonnage sûr quand une réponse d'agent est invalide.
| Modèles | Systèmes | Recherche |
|---|---|---|
| Entraînement, architectures et expériences RL | Inférence, latence, coût, contrôle et règles de décision | Signaux quantitatifs, simulations et workflows scientifiques |
## Pourquoi optim-agent
- **Propositions sémantiques** - les agents de code raisonnent sur le sens des paramètres, le contexte et les résultats observés au lieu de traiter chaque dimension comme une coordonnée anonyme.
- **Effet de levier avec petit budget** - utile quand les évaluations sont coûteuses et que les surrogates classiques manquent encore de données.
- **Potentiel des Agent CLI** - la qualité des propositions peut progresser avec les agents de code sous-jacents, par exemple de GPT-5.5 à GPT-5.6, sans changer le code d'optimisation.
- **Décisions auditables** - les studies JSON/SQLite conservent configurations, résultats, états, contexte et justification optionnelle de l'agent.
- **Exécution bornée** - l'agent ne propose que des valeurs ; optim-agent les valide contre l'espace déclaré et revient à un échantillonnage sûr si la sortie est invalide.
## Installation
Installer le Codex skill :
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Installer le plugin Claude Code :
```bash
claude plugin marketplace add Optim-Agent/optim-agent && claude plugin install optim-agent@optim-agent
```
Installer le package Python :
```bash
# Version stable sur PyPI
python -m pip install optim-agent
# Dernière version source sur GitHub
python -m pip install "optim-agent @ git+https://github.com/Optim-Agent/optim-agent.git"
```
Nécessite un agent CLI authentifié dans `PATH` :
[claude](https://docs.anthropic.com/en/docs/claude-code),
[codex](https://github.com/openai/codex) ou
[OpenCode](https://github.com/sst/opencode).
## Démarrage rapide
```python
import optim_agent as oa
def objective(trial):
threshold = trial.suggest_float(
"threshold", 0.05, 0.95,
context="decision threshold; higher values trade recall for precision",
)
budget = trial.suggest_int(
"budget", 10, 200, log=True,
context="compute or operating budget; larger values may improve quality",
)
return evaluate_system(threshold=threshold, budget=budget) # domain code
study = oa.create_study(
direction="maximize",
sampler=oa.AgentSampler(
backend="claude", # or "codex" / "opencode"
effort="high",
context="maximize system quality under a strict operating-cost budget",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
),
storage="study.json", # optional: persist and resume
summarize=True, # optional: agent-written result summary after the last trial
)
study.optimize(objective, n_trials=20)
print(study.best_value, study.best_params)
print(study.summary) # the summary agent's narration of the finished study
```
Le `context` optionnel donne un sens métier à la study et aux paramètres. Fournissez-le
au niveau study avec `AgentSampler(context=...)`, au niveau paramètre avec
`suggest_*(..., context=...)`, ou les deux.
Vous pouvez aussi lancer [`examples/quickstart.py`](../../examples/quickstart.py) ou suivre
[`tutorials/quickstart.ipynb`](../../tutorials/quickstart.ipynb).
## Domaines d'application
| Domaine | Paramètres que optim-agent peut régler | Objectif exemple |
|---|---|---|
| **Entraînement de modèles** | taux d'apprentissage, architectures, augmentation, régularisation | qualité de validation, calcul, robustesse |
| **Inférence et serving** | quantification, batching, décodage, cache, routage | qualité, latence, débit, coût |
| **Recherche quantitative** | fenêtres de signal, seuils, règles de rééquilibrage, contrôles de risque | rendement walk-forward, drawdown, turnover |
| **RL et décisions** | poids d'objectif, calendriers d'exploration, paramètres d'environnement, seuils de politique | retour, sûreté, efficacité échantillon |
| **Workflows scientifiques** | entrées de simulation, paramètres solveur, contrôles expérimentaux | ajustement, erreur, temps, ressources |
| **Systèmes boîte noire** | toute configuration catégorielle, entière ou continue bornée | score objectif scalaire |
Voir aussi [`examples/sklearn_tuning.py`](../../examples/sklearn_tuning.py) et
[`examples/inference_tuning.py`](../../examples/inference_tuning.py).
Pour le reinforcement learning, optim-agent règle le système autour de la boucle d'apprentissage ;
il ne remplace pas l'algorithme d'apprentissage de politique.
## Trajectoire d'optimisation
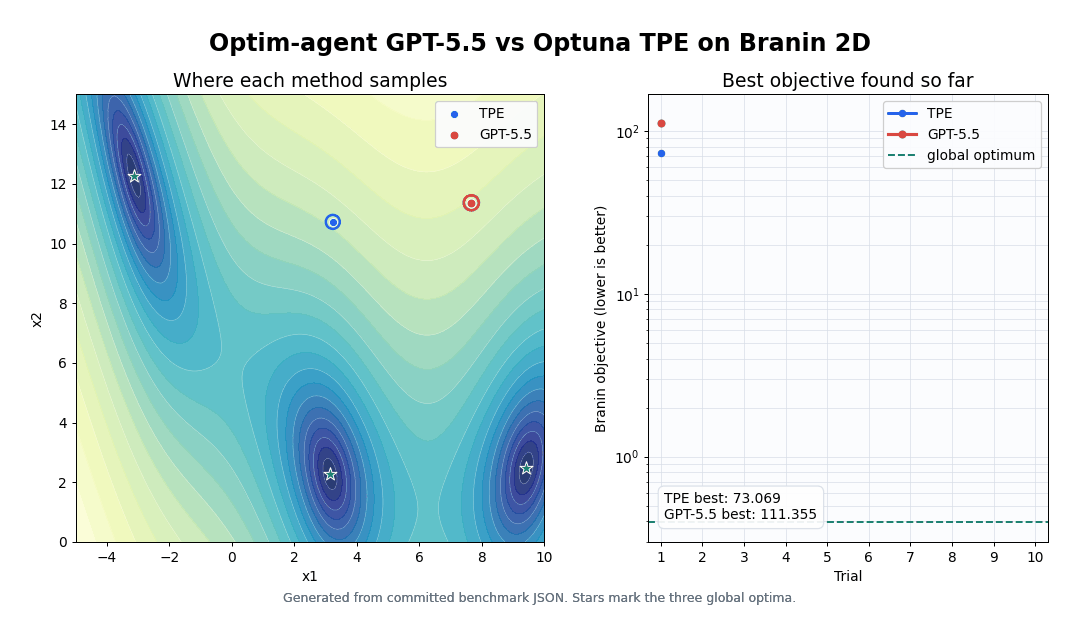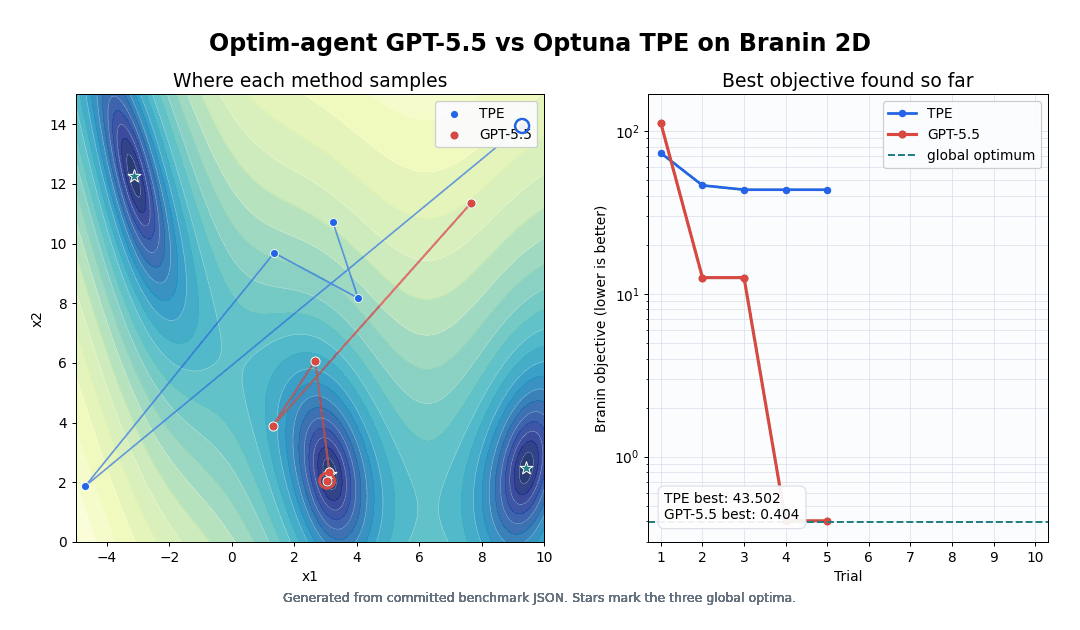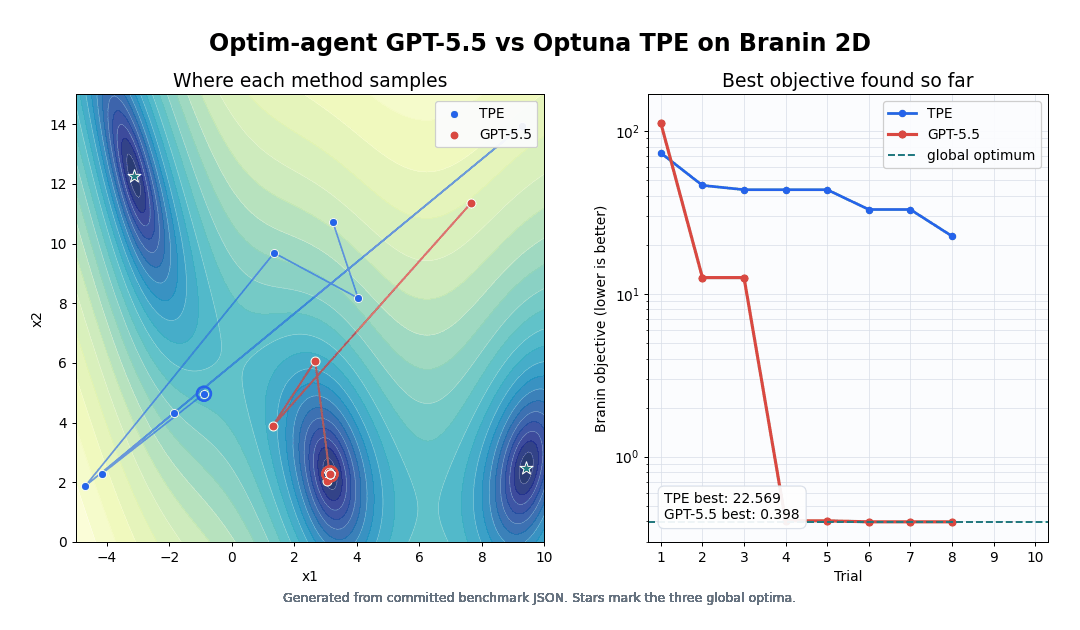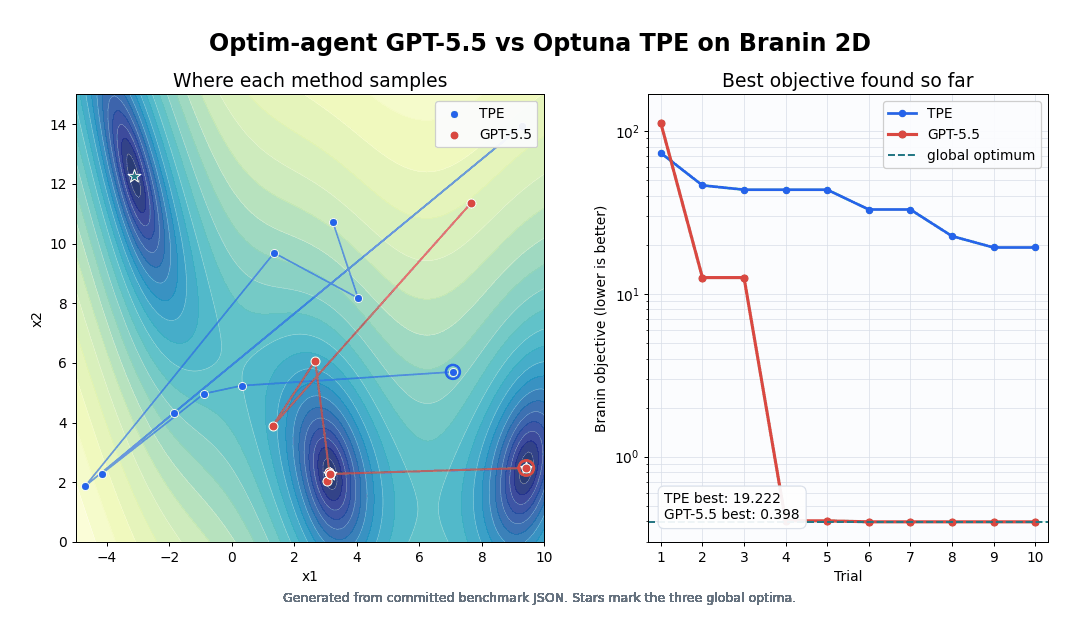
Cette trace Branin seed-0 compare TPE et GPT-5.5 avec le même budget de 10 trials,
en montrant la valeur objective incumbent après chaque trial. C'est une illustration de trajectoire ;
les résultats agrégés et les commandes de reproduction suivent.
### Optimisation de fonctions mathématiques sans contexte : Branin-2D et Ackley-5D
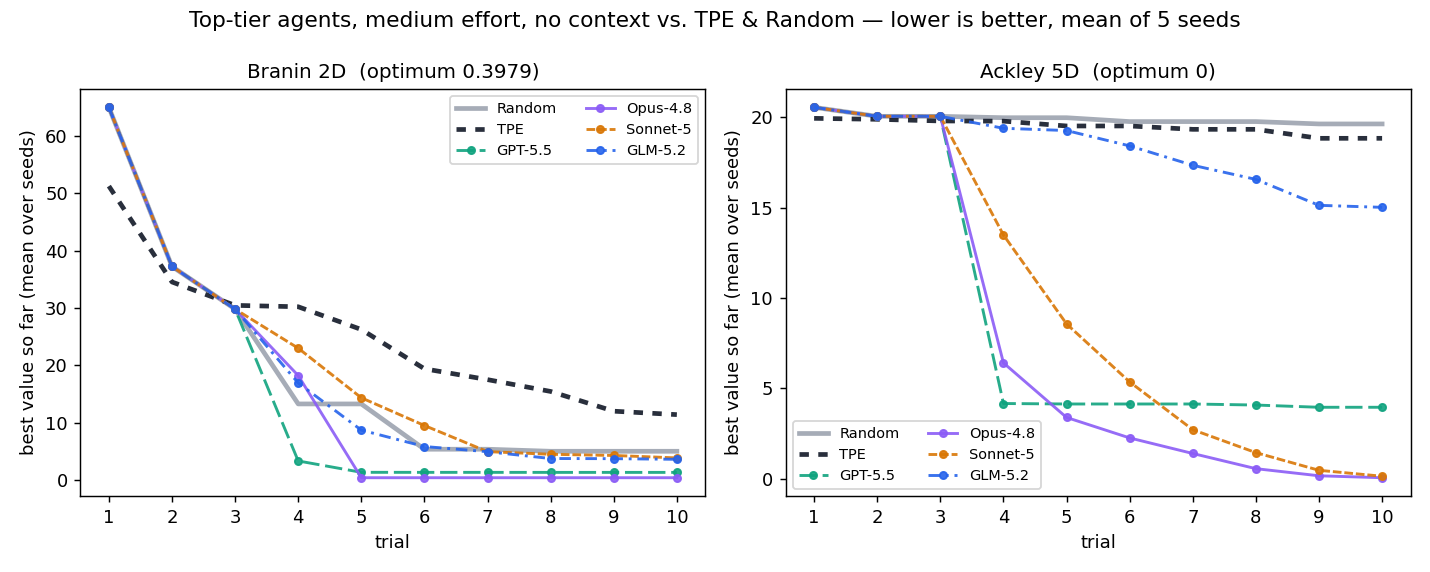
Les agents de fonctions difficiles ne reçoivent **aucun contexte de tâche fourni** : seulement les noms
génériques `x1...x5`, les bornes numériques et l'historique des trials. Les runs utilisent 10 trials
sur cinq seeds ; Random et TPE sont des baselines inchangées.
#### Agents haut de gamme
| méthode | meilleur Branin moyen ↓ | meilleur Ackley-5D moyen ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| GPT-5.5 | 1.326 | 3.960 |
| **Opus-4.8** | **0.398** | **0.061** |
| Sonnet-5 | 3.850 | 0.143 |
| Kimi-K3 | 2.082 | 0.907 |
| Minimax-M3 | 0.970 | 0.574 |
| GLM-5.2 | 3.609 | 15.023 |
Les modèles épinglés sont `gpt-5.5`, `claude-opus-4-8`, `claude-sonnet-5`,
`kimi-k3`, `MiniMax-M3` et `glm-5.2`.
Opus-4.8 atteint l'optimum Branin en moyenne et obtient la meilleure moyenne Ackley sur cinq seeds.
#### Agents OpenCode (gratuits)
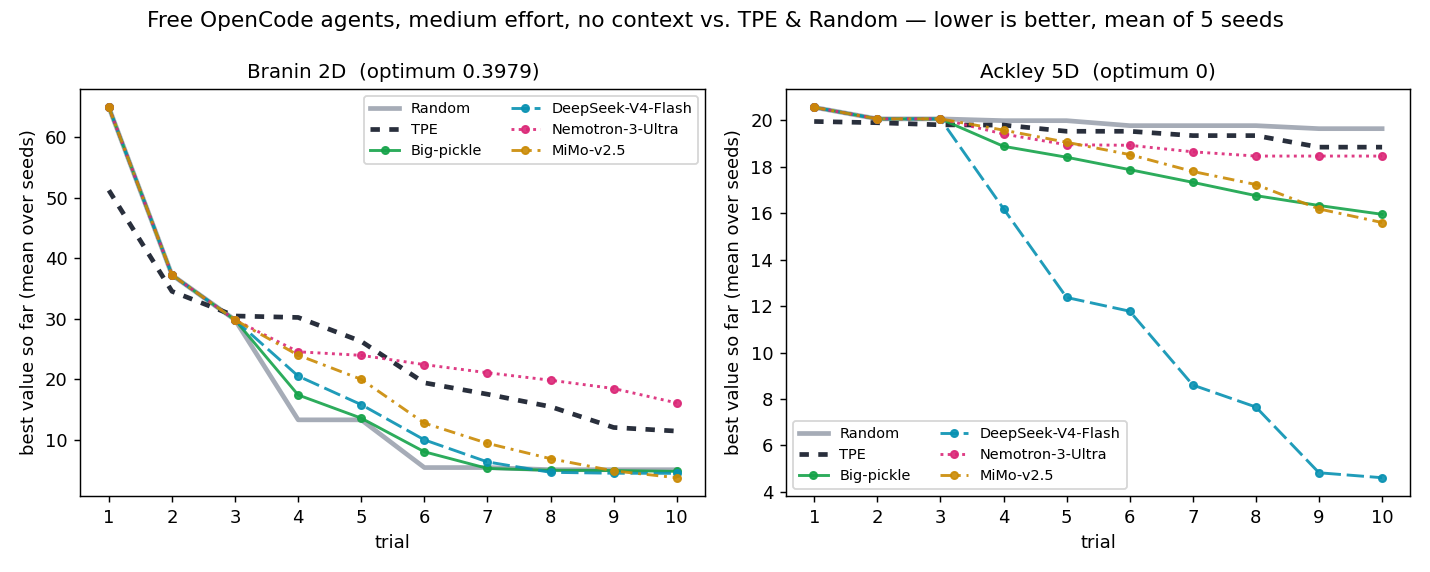
| méthode | meilleur Branin moyen ↓ | meilleur Ackley-5D moyen ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| Big-pickle | 4.734 | 15.951 |
| **DeepSeek-V4-Flash** | 4.410 | **4.608** |
| Nemotron-3-Ultra | 16.051 | 18.459 |
| **MiMo-v2.5** | **3.682** | 15.597 |
Les modèles hébergés par OpenCode ne demandent pas d'API de modèle payante. Le pool gratuit tourne ;
cette mise à jour épingle `opencode/big-pickle`, `opencode/deepseek-v4-flash-free`,
`opencode/nemotron-3-ultra-free` et `opencode/mimo-v2.5-free`. DeepSeek V4 Flash a la meilleure
moyenne Ackley gratuite, tandis que MiMo-v2.5 a la meilleure moyenne Branin gratuite.
### Réglage de classificateurs d'images ResNet : MNIST et CIFAR-10
Le benchmark de classification compare **Random**, Optuna **TPE**, **GPT-5.5 w/ context**
et **GPT-5.5 w/o context** sur cinq seeds (`0..4`) et 10 trials. La condition avec contexte reçoit
des descriptions naturelles de la study et des paramètres ; la condition sans contexte ne reçoit que les bornes et l'historique.
La métrique principale favorise l'amélioration rapide :
```text
cumulative_best_so_far_error = sum(best_test_error_so_far_at_i for i in 1..10)
```
Plus bas est meilleur.
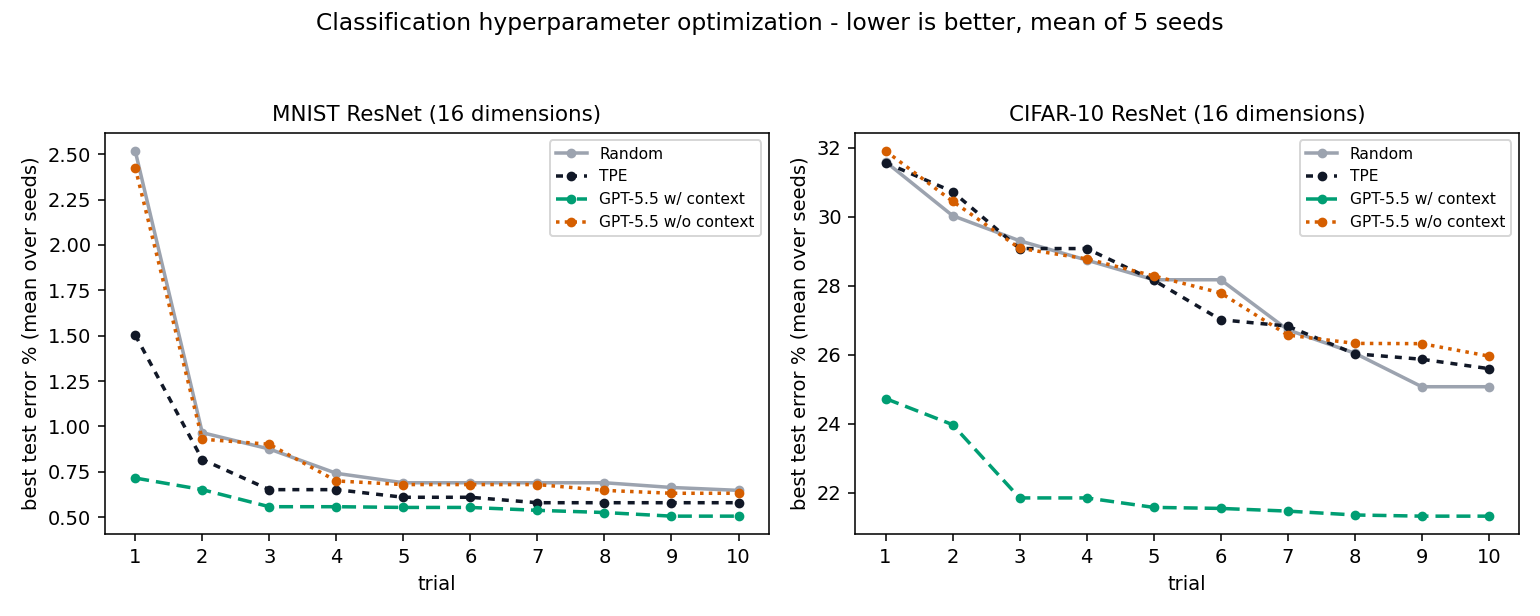
| méthode | erreur cumulative MNIST ↓ | erreur finale MNIST ↓ | erreur cumulative CIFAR-10 ↓ | erreur finale CIFAR-10 ↓ |
|---|---:|---:|---:|---:|
| Random | 9.174 | 0.648% | 278.920 | 25.072% |
| TPE | 7.166 | 0.580% | 279.936 | 25.596% |
| **GPT-5.5 w/ context** | **5.668** | **0.506%** | **220.994** | **21.322%** |
| GPT-5.5 w/o context | 8.910 | 0.632% | 281.466 | 25.960% |
GPT-5.5 w/ context réduit l'erreur cumulative best-so-far de **20.9%** par rapport à TPE sur MNIST
et de **20.8%** par rapport à Random sur CIFAR-10. Sans contexte, il est 24.3% pire que TPE sur MNIST
et 0.9% pire que Random sur CIFAR-10.
[`examples/mnist.py`](../../examples/mnist.py) et [`examples/cifar10.py`](../../examples/cifar10.py)
règlent le learning rate, la batch size, le weight decay, le label smoothing, trois largeurs de stage,
trois profondeurs de stage et quatre contrôles de dropout. MNIST ajoute translation et rotation ;
CIFAR-10 utilise crop padding et flip probability.
### Réglage de contrôleurs Q-learning : Acrobot-v1 et LunarLander-v3
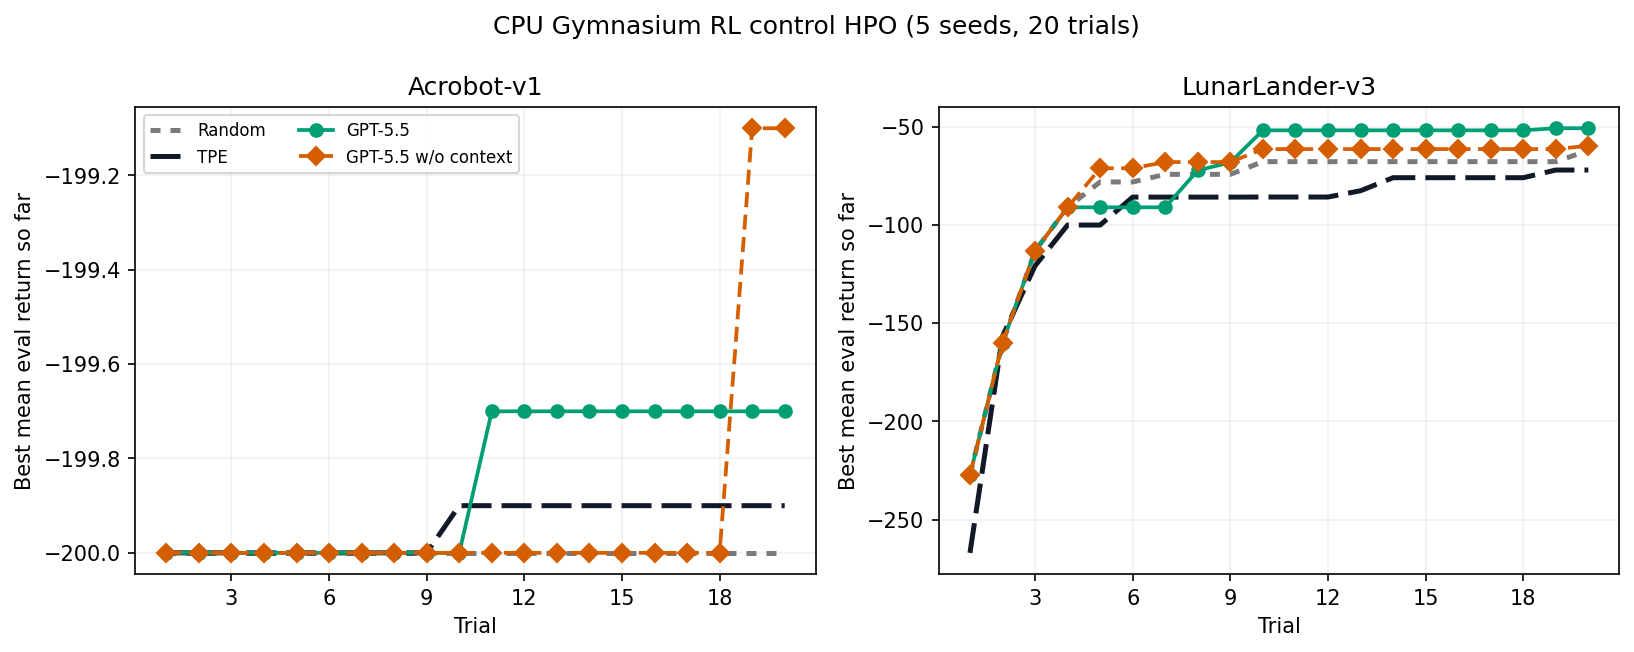
Ce benchmark CPU-only Gymnasium règle un contrôleur Q-learning discrétisé pour Acrobot-v1 et LunarLander-v3.
Chaque méthode exécute 20 trials sur cinq seeds (`0..4`) ; l'objectif est le retour d'évaluation moyen,
donc plus haut est meilleur. Le runner parallélise entre seeds et dans chaque study HPO via `--workers`.
Les bras GPT-5.5 utilisent high modeling effort et les 5 derniers trials d'historique.
| méthode | retour Acrobot-v1 ↑ | retour LunarLander-v3 ↑ |
|---|---:|---:|
| Random | -200.000 | -62.139 |
| TPE | -199.900 | -72.088 |
| **GPT-5.5 w/ context** | **-199.700** | **-50.825** |
| GPT-5.5 w/o context | -199.100 | -59.751 |
Avec 20 trials et cinq trials d'historique de prompt, GPT-5.5 w/ context a le meilleur retour moyen
sur les deux environnements : 0.2 au-dessus de TPE sur Acrobot-v1 et 11.3 au-dessus de Random sur LunarLander-v3.
Considérez cela comme un stress test CPU HPO, pas comme un classement universel.
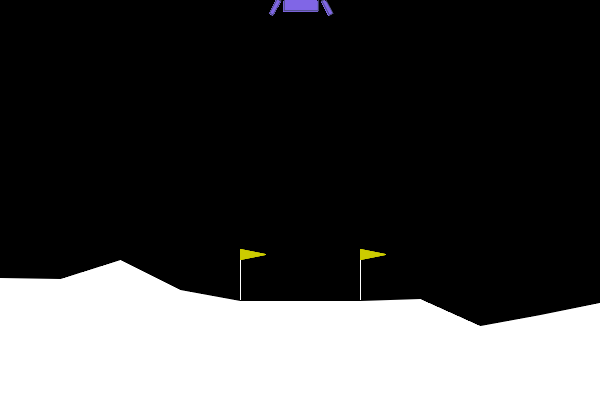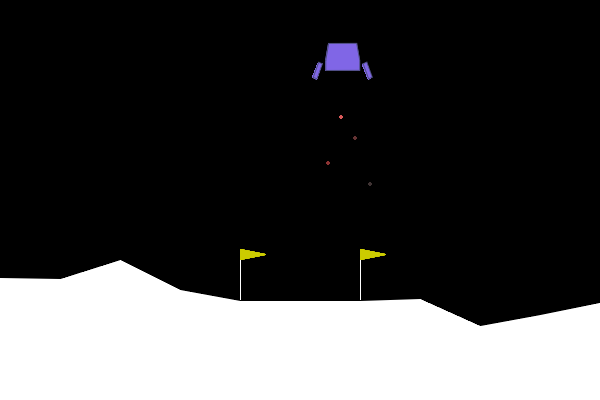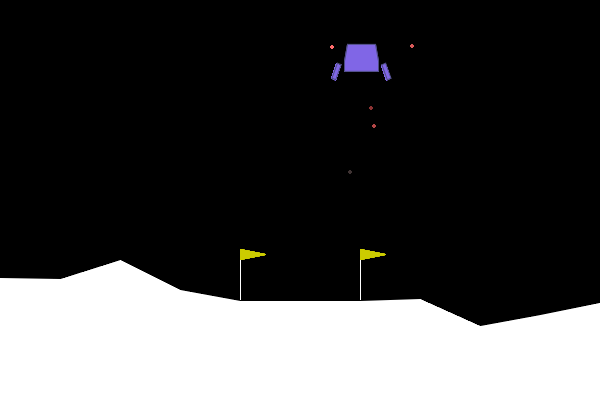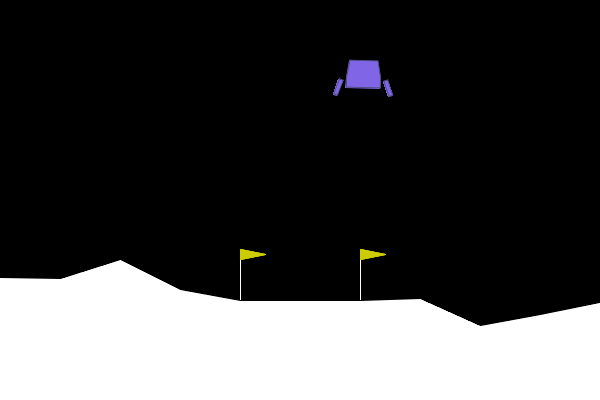
Pour l'animation, optim-agent règle sept gains d'un contrôleur LunarLander déterministe avec un seed HPO.
Chaque trial utilise les mêmes 20 seeds de rollout, en priorisant le nombre d'atterrissages réussis puis le retour moyen.
Le trial retenu atterrit dans les 20 rollouts ; le GIF montre son rollout au meilleur retour.
### Réglage d'un classificateur gradient boosting : probabilités de défaut de crédit
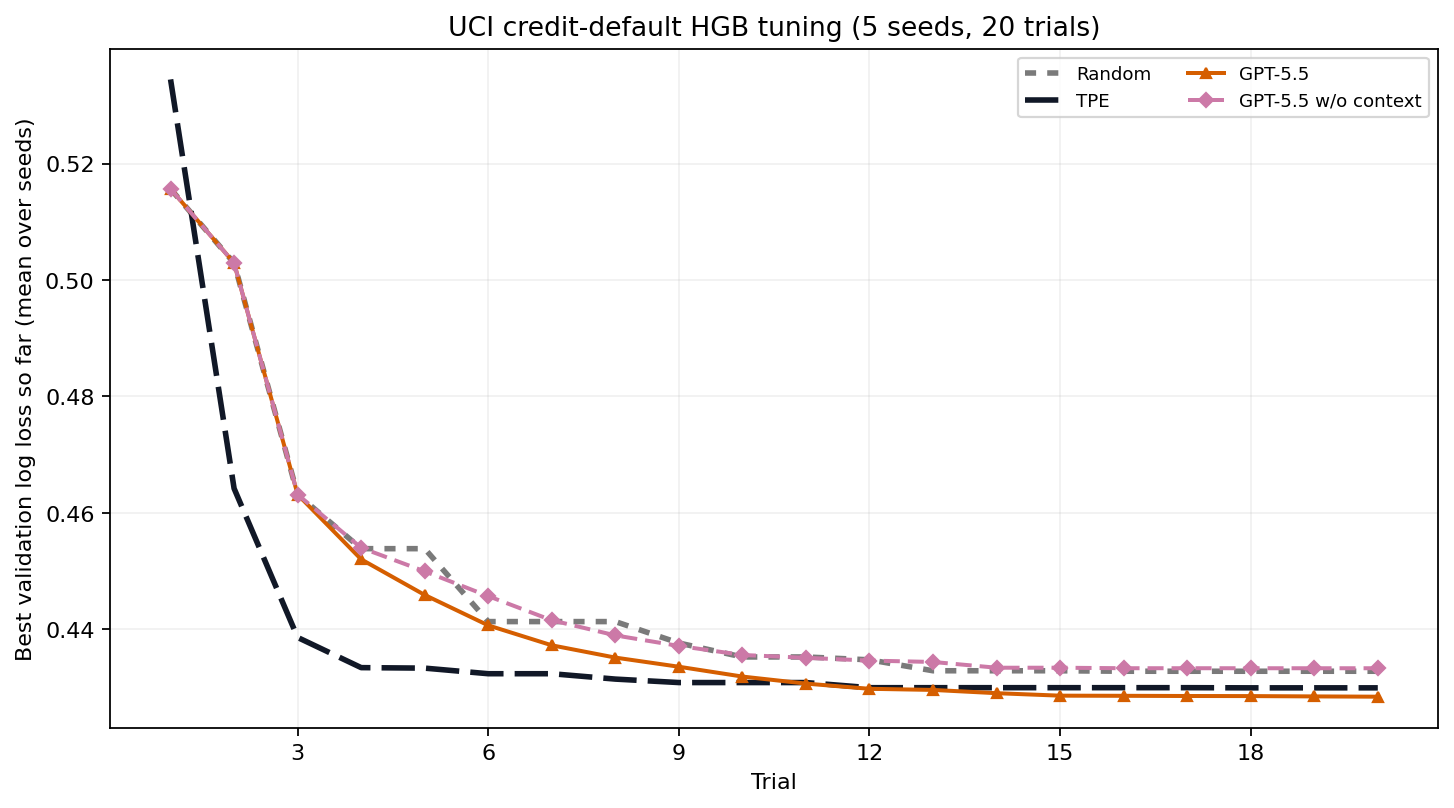
Ce benchmark CPU-only règle huit paramètres d'entraînement d'un `HistGradientBoostingClassifier` sur le jeu UCI
[Default of Credit Card Clients](https://archive.ics.uci.edu/dataset/350/default+of+credit+card+clients) :
30 000 lignes, 23 variables et une cible de défaut le mois suivant. L'archive officielle est épinglée par SHA-256,
licenciée CC BY 4.0, et divisée une seule fois en 60% train, 20% validation et 20% test intact.
Toutes les méthodes utilisent la même partition, 20 trials et les seeds `0..4`. Les deux bras GPT-5.5 utilisent
high modeling effort, 20 trials d'historique de prompt, explicit reasoning et qualitative notes.
| méthode | log loss validation finale ↓ | log loss test retenu ↓ |
|---|---:|---:|
| Random | 0.433 | 0.425 |
| TPE | 0.430 | 0.422 |
| GP-BO | 0.430 | 0.423 |
| **GPT-5.5 w/ context** | **0.428** | **0.422** |
| GPT-5.5 w/o context | 0.433 | 0.427 |
Le contexte réduit la log loss validation finale de 1.13% et la log loss test de 1.23% par rapport au contrôle no-context.
GPT-5.5 a aussi une perte moyenne validation et test inférieure à Random, TPE et GP-BO. Comme la configuration retenue
a été choisie avec la validation et le test, le résultat test est une comparaison benchmark et non une estimation intacte de généralisation.
C'est un benchmark méthodologique, pas un système de décision de crédit en production. Le déploiement demanderait équité,
calibration, dérive, gouvernance et revue juridique.
Reproduire les artefacts benchmark :
```bash
pip install -e ".[examples]"
# Classification
python scripts/verify_classification_cumulative_error.py run-no-context
python scripts/verify_classification_cumulative_error.py
# Hard functions
python examples/hard_functions.py distributed \
--agents Random TPE GPT-5.5 Opus-4.8 Sonnet-5 GLM-5.2 Big-pickle \
DeepSeek-V4-Flash Nemotron-3-Ultra MiMo-v2.5 \
--trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-kimi.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Kimi-K3 --trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-minimax.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Minimax-M3 --trials 10 --seeds 0 1 2 3 4
python examples/hard_functions.py plot
# Credit-card HGB
pip install -e ".[ml,examples]"
python examples/credit_card.py download
python examples/credit_card.py preflight
python examples/credit_card.py run
python examples/credit_card.py selfcheck
python examples/credit_card.py summary
python examples/credit_card.py plot
# RL control
pip install -e ".[rl,examples]"
python examples/rl_control.py preflight
python examples/rl_control.py run --seeds 0 1 2 3 4 --workers 10
python examples/rl_control.py selfcheck
python examples/rl_control.py summary
python examples/rl_control.py plot
python examples/rl_control.py gif
```
## Guide d'utilisation
### Contrôles du prompt sampler
`effort` est transmis au flag reasoning-effort du backend CLI. Le prompt du harness est contrôlé séparément :
```python
oa.AgentSampler(
backend="codex",
effort="medium",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
)
```
Définissez `history=None` pour montrer tous les trials complétés/pruned. Utilisez
`explicit_reasoning=False` ou `qualitative_notes=False` pour raccourcir les réponses de l'agent.
### Journalisation des trials
`study.optimize(..., verbose=...)` contrôle la sortie par trial :
- `verbose=True` (défaut) affiche un tableau sur un terminal interactif : une ligne par
trial avec les colonnes `trial`, `value`, `best`, `state`, plus une colonne par
paramètre de l'espace de recherche dans l'ordre de première apparition. Les lignes
longues sont tronquées avec une ellipse pour tenir dans la largeur du terminal ; les
valeurs manquantes (p. ex. trials échoués) s'affichent comme `-`.
- Quand stdout n'est pas un TTY (sortie redirigée, logs CI), `verbose=True` / `"table"`
bascule automatiquement vers le format une ligne, compatible grep
(`[optim-agent] trial 3: value=0.91 state=complete best=0.91`).
- `verbose="line"` utilise toujours le format une ligne, même sur un TTY.
- `verbose="table"` utilise le tableau sur un TTY et le format une ligne en redirection.
- `verbose=False` désactive la sortie par trial.
Avec les espaces define-by-run, un trial qui introduit une nouvelle clé de paramètre
réimprime l'en-tête avec le sur-ensemble de colonnes.
### Agent de résumé
Passez `summarize=True` à `create_study` pour que l'agent narre la study terminée une
fois, après le dernier trial :
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.json",
summarize=True,
)
study.optimize(objective, n_trials=20)
print(study.summary) # également persisté dans le stockage JSON / SQLite
```
Le résumé est structuré en quatre sections — meilleure configuration, enseignements sur
l'espace de recherche, points saillants de la trajectoire et prochaines étapes suggérées.
Il est imprimé dans le terminal et persisté sur `study.summary` (clé additive dans le
stockage JSON et dans la table `meta` SQLite ; les anciennes studies se chargent avec
`summary=None`).
Résolution du backend : un `summary_backend=` explicite l'emporte ; sinon le backend du
sampler est réutilisé quand le sampler est un `AgentSampler`. Avec tout autre sampler,
passez `summary_backend=` ou `create_study` lève un `ValueError` qui nomme la solution.
`summary_model=` / `summary_effort=` remplacent le model/effort du sampler pour le
résumé. Les réponses de l'agent impossibles à parser en quatre sections retombent sur
l'impression du texte brut — un résumé ne fait jamais échouer la study, et les studies
sans trial complété l'ignorent avec une notice d'une ligne. `backend="mock"` fonctionne
aussi pour le summarizer, donc les démos et tests tournent sans CLI d'agent réel.
### Pruning
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="codex"),
pruner=oa.AgentPruner(
backend="codex", level="medium", effort="medium",
), # level: loose | medium | tight
)
def objective(trial):
lr = trial.suggest_float("lr", 1e-5, 1e-1, log=True,
context="learning rate for training an image classifier")
for epoch in range(20):
loss = train_one_epoch(lr)
trial.report(loss, epoch)
if trial.should_prune():
raise oa.TrialPruned()
return loss
```
L'agent pruner compare la courbe courante aux trials terminés et répond prune/keep ;
`loose` ne prune que les runs clairement faibles, tandis que `tight` prune plus agressivement.
Les erreurs d'agent ne prunent jamais un trial.
### Concurrence et studies distribuées
Définissez `max_concurrency` (défaut `1`) pour évaluer plusieurs trials à la fois, et utilisez un fichier
SQLite `storage` (`.db` / `.sqlite`) comme historique partagé sûr en concurrence :
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.db", # SQLite -> safe for many workers; .json stays single-writer
max_concurrency=8, # up to 8 objectives run at once
)
study.optimize(objective, n_trials=100)
```
- **Dans un processus**, `max_concurrency` lance les objectifs dans un pool de threads. Les requêtes de sampling agent
sont mises en file et sérialisées pour que chaque proposition voie l'historique du processus ; seuls les appels objectif sont parallèles.
- **Entre processus / machines**, pointez tous les workers vers le même `storage` SQLite. La base est le canal de communication :
le mode WAL laisse chaque worker ajouter des résultats et lire l'historique sans conflit d'écriture.
Limites : les threads partagent le GIL, donc les objectifs pure-Python CPU-bound fonctionnent mieux dans des processus séparés avec SQLite partagé.
Les workers concurrents ne voient pas les points in-flight des autres et peuvent parfois explorer des régions proches.
### Mode skill (l'agent lit le code du projet)
Le package pip traite l'objectif comme une boîte noire. Le [skill optim-agent](../../SKILL.md) va plus loin :
chargé dans une session d'agent de code, l'agent lit d'abord le projet pour comprendre le rôle de chaque paramètre,
puis pilote la même boucle study via `study.ask(params)` / `study.tell(trial, value)`, avec le JSON de study comme historique.
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Plugin Claude Code :
```bash
claude plugin marketplace add Optim-Agent/optim-agent
claude plugin install optim-agent@optim-agent
```
Plugin Codex :
```bash
codex plugin marketplace add Optim-Agent/optim-agent
codex plugin add optim-agent@optim-agent
```
```python
trial = study.ask({"threshold": 0.72, "budget": 80})
study.tell(trial, evaluate_system(**trial.params))
```
### Tests hors ligne
`AgentSampler(backend="mock")` est un substitut sans tokens qui fait un hill climbing autour du meilleur point,
utile pour tester les intégrations avant les appels agent.
## Dépannage
- **`claude` renvoie 401 dans une session agent** - les sessions imbriquées héritent de `ANTHROPIC_API_KEY` ;
lancez avec `env -u ANTHROPIC_API_KEY` ou depuis un shell propre.
- **Un appel backend expire ou émet une sortie invalide** - le sampler avertit et revient à un point aléatoire pour ce trial ; la study continue.
- **OpenCode avec studies distribuées** - OpenCode currently does not support distributed computing
in optim-agent ; utilisez le flux mono-processus ou un autre backend.
## Contribution
Développement local :
```bash
pip install -e ".[examples]"
pytest # runs tests/test_optim_agent.py
```
Ouvrez une issue pour discuter des changements importants avant un PR. Ajouter un nouveau backend agent signifie généralement
une petite fonction dans [`optim_agent/agent.py`](../../optim_agent/agent.py).
Le [`README.md`](../../README.md) anglais reste la source d'autorité pour les versions, valeurs benchmark et backends.
## Remerciements
- [Optuna](https://github.com/optuna/optuna) pour avoir popularisé l'interface Study/Trial, fourni la baseline TPE utilisée
dans les exemples et benchmarks, et fixé un haut niveau pour les outils d'optimisation pratiques.
- [OpenCode](https://github.com/sst/opencode) pour l'accès aux modèles gratuits évalués dans les benchmarks de fonctions difficiles.
## Licence
[MIT](../../LICENSE)