optim-agent
コーディングエージェントによるエージェント型システム最適化。
アルゴリズムエンジニアの反復的なパラメータ調整を自動化します。



English |
简体中文 |
日本語 |
한국어 |
Français |
Deutsch |
Español |
Português |
Русский
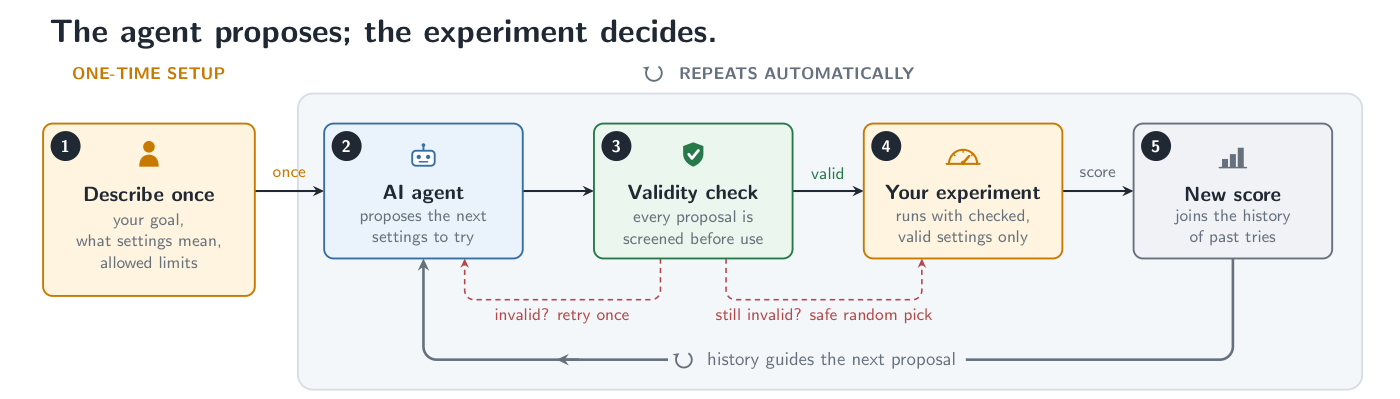
optim-agent は Claude Code / Codex / OpenCode に実システムのパラメータを調整させます。
コードを読み、trial を提案し、実測された目的値を記録します。設定可能なパラメータと
測定可能な目的関数を持つシステムで使えます。各パラメータの意味と trial 履歴から見える
信号を合わせて、次に評価する設定を提案します。目的関数の評価が常に正です。
optim-agent は値を提案し、宣言済み探索空間で検証し、結果を記録し、エージェント応答が
無効な場合は安全なサンプリングに戻ります。
| モデル | システム | 研究 |
|---|---|---|
| 学習、アーキテクチャ、RL 実験 | 推論、レイテンシ、コスト、制御、意思決定ルール | 定量シグナル、シミュレーション、科学ワークフロー |
## 特長
- **意味を使った提案** - コーディングエージェントは各次元を匿名座標として扱わず、パラメータの意味、文脈、観測結果を読んで提案します。
- **小さな予算で効く** - 評価が高価で、古典的 surrogate がまだデータ不足な場面に向いています。
- **Agent CLI の伸びしろ** - GPT-5.5 から GPT-5.6 へのような基盤エージェント改善を、最適化コードを変えずに受けられます。
- **監査可能な判断** - JSON/SQLite study に設定、結果、状態、文脈、任意のエージェント理由を残します。
- **境界のある実行** - エージェントは値だけを提案し、optim-agent が探索空間で検証します。無効な出力は安全なサンプリングへ戻ります。
## インストール
Codex skill をインストール:
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Claude Code plugin をインストール:
```bash
claude plugin marketplace add Optim-Agent/optim-agent && claude plugin install optim-agent@optim-agent
```
Python パッケージをインストール:
```bash
# PyPI の安定版
python -m pip install optim-agent
# GitHub の最新ソース
python -m pip install "optim-agent @ git+https://github.com/Optim-Agent/optim-agent.git"
```
`PATH` 上で認証済みの agent CLI が 1 つ必要です:
[claude](https://docs.anthropic.com/en/docs/claude-code)、
[codex](https://github.com/openai/codex)、または
[OpenCode](https://github.com/sst/opencode)。
## クイックスタート
```python
import optim_agent as oa
def objective(trial):
threshold = trial.suggest_float(
"threshold", 0.05, 0.95,
context="decision threshold; higher values trade recall for precision",
)
budget = trial.suggest_int(
"budget", 10, 200, log=True,
context="compute or operating budget; larger values may improve quality",
)
return evaluate_system(threshold=threshold, budget=budget) # domain code
study = oa.create_study(
direction="maximize",
sampler=oa.AgentSampler(
backend="claude", # or "codex" / "opencode"
effort="high",
context="maximize system quality under a strict operating-cost budget",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
),
storage="study.json", # optional: persist and resume
summarize=True, # optional: agent-written result summary after the last trial
)
study.optimize(objective, n_trials=20)
print(study.best_value, study.best_params)
print(study.summary) # the summary agent's narration of the finished study
```
任意の `context` は study とパラメータにドメイン上の意味を与えます。
`AgentSampler(context=...)`、`suggest_*(..., context=...)`、またはその両方で指定できます。
[`examples/quickstart.py`](../../examples/quickstart.py) を直接実行するか、
[`tutorials/quickstart.ipynb`](../../tutorials/quickstart.ipynb) でも試せます。
## 適用範囲
| 領域 | optim-agent が調整できるパラメータ | 目的関数の例 |
|---|---|---|
| **モデル学習** | 学習率、アーキテクチャ、augmentation、正則化 | 検証品質、計算量、堅牢性 |
| **推論とサービング** | 量子化、batching、decoding、cache、routing | 品質、レイテンシ、スループット、コスト |
| **定量研究** | シグナル窓、閾値、リバランス規則、リスク制御 | walk-forward return、drawdown、turnover |
| **強化学習と意思決定** | 目的重み、探索スケジュール、環境設定、方策閾値 | return、安全性、sample efficiency |
| **科学ワークフロー** | シミュレーション入力、solver 設定、実験制御 | fit、error、runtime、resource use |
| **ブラックボックスシステム** | 有界なカテゴリ・整数・連続設定 | scalar objective score |
追加例は [`examples/sklearn_tuning.py`](../../examples/sklearn_tuning.py) と
[`examples/inference_tuning.py`](../../examples/inference_tuning.py) を参照してください。
強化学習では、optim-agent は学習ループ周辺のシステムを調整します。方策学習アルゴリズムそのものは置き換えません。
## 最適化軌跡
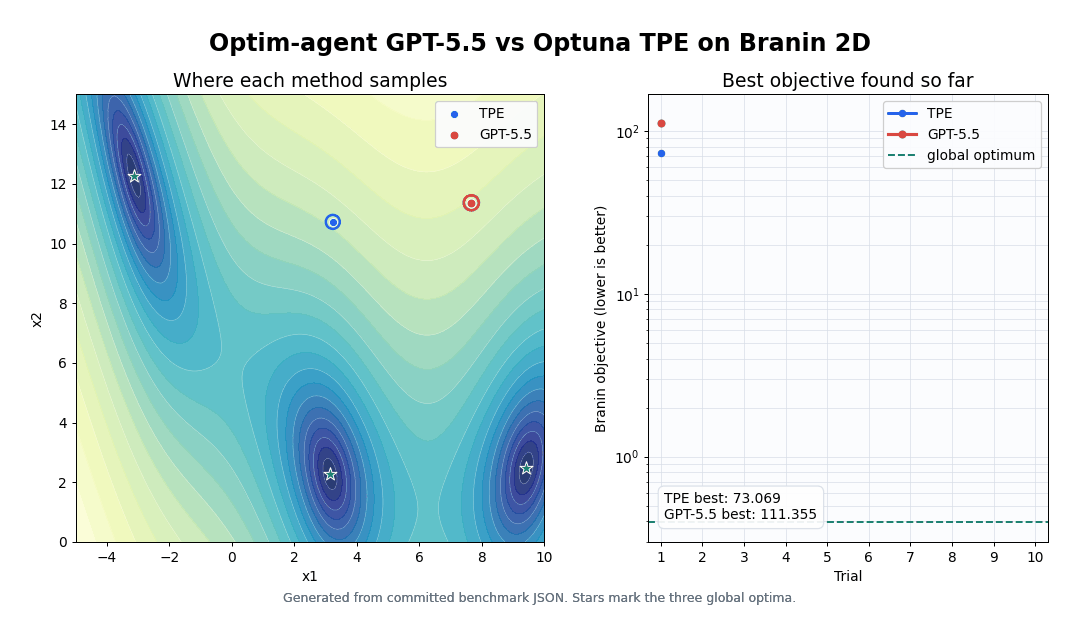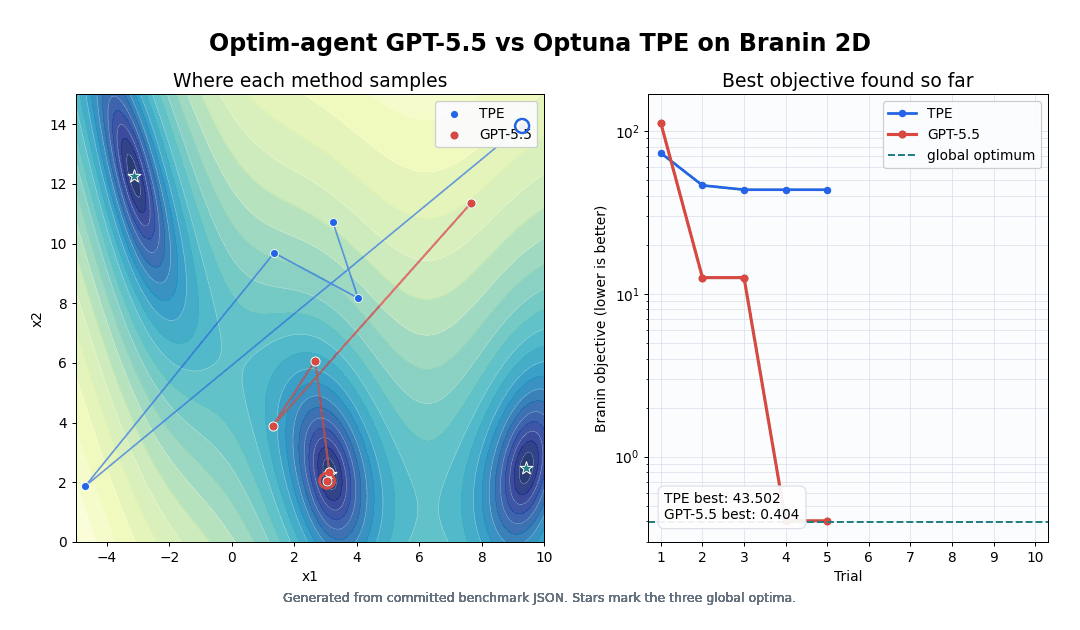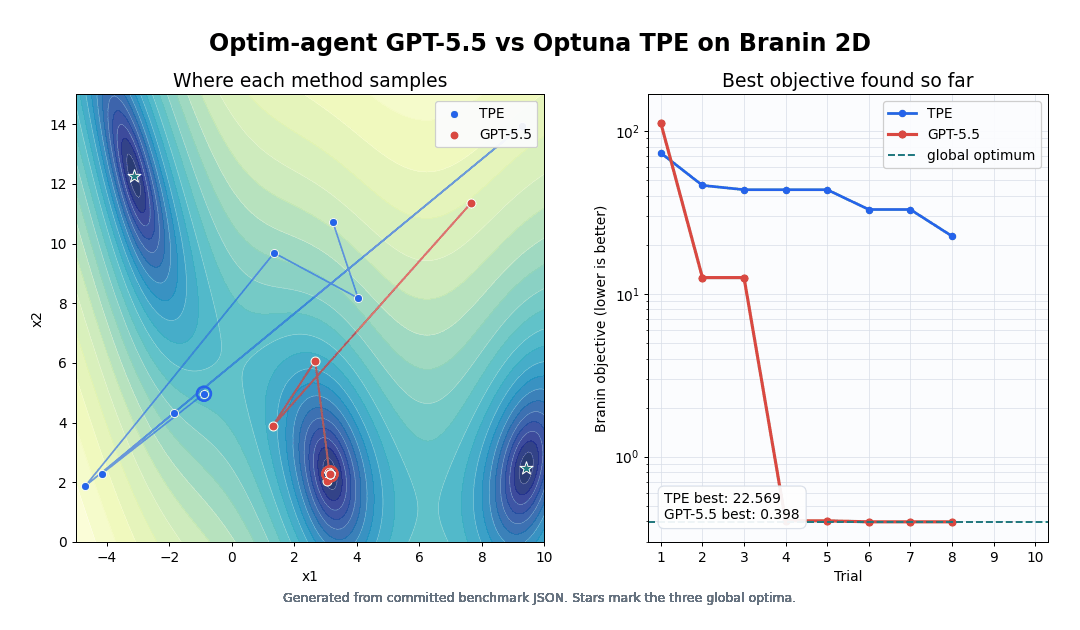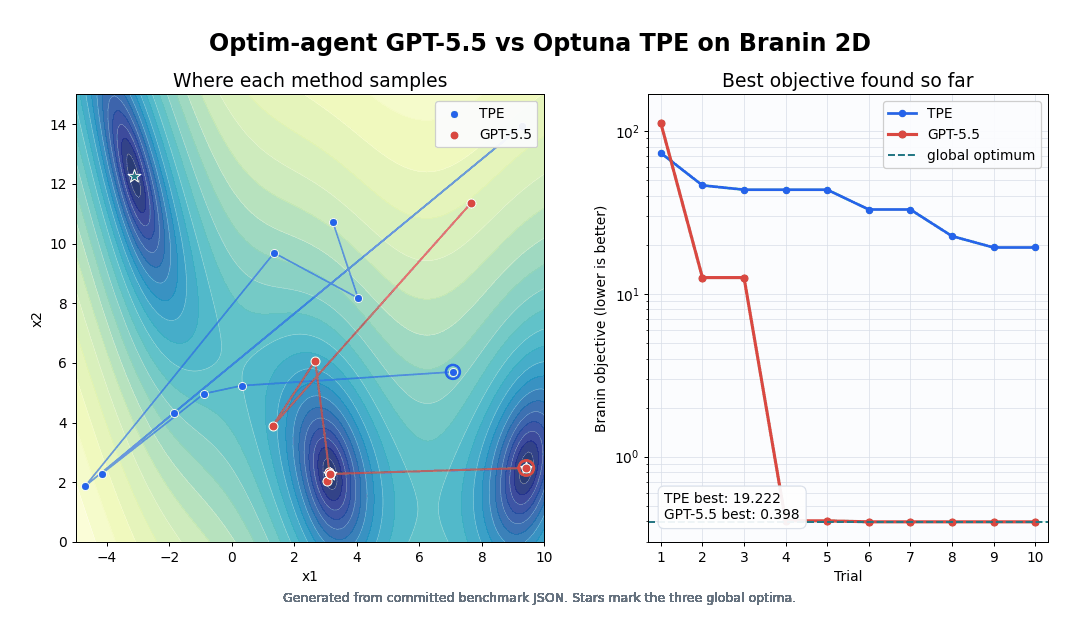
この seed-0 Branin トレースは、同じ 10 trial 予算で TPE と GPT-5.5 を比較し、
各 trial 後の incumbent objective を示します。これは軌跡の説明用です。
集計ベンチマーク結果と再現コマンドは下にあります。
### 文脈なしで数理関数を最適化: Branin-2D と Ackley-5D
難関関数のエージェントには**タスク文脈を与えません**。汎用名 `x1...x5`、数値境界、
trial 履歴だけを与えます。10 trial、5 seed で実行し、Random と TPE は固定ベースラインです。
#### 上位エージェント
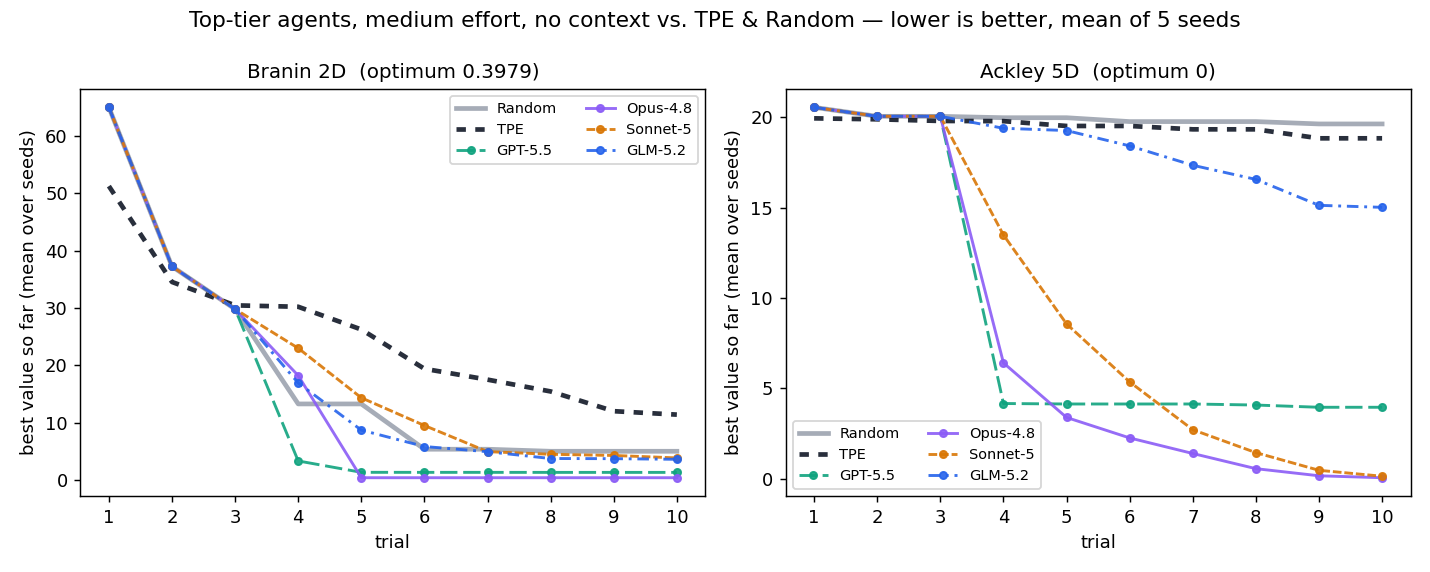
| 手法 | 平均 best Branin ↓ | 平均 best Ackley-5D ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| GPT-5.5 | 1.326 | 3.960 |
| **Opus-4.8** | **0.398** | **0.061** |
| Sonnet-5 | 3.850 | 0.143 |
| Kimi-K3 | 2.082 | 0.907 |
| Minimax-M3 | 0.970 | 0.574 |
| GLM-5.2 | 3.609 | 15.023 |
固定モデルは `gpt-5.5`、`claude-opus-4-8`、`claude-sonnet-5`、`kimi-k3`、
`MiniMax-M3`、`glm-5.2` です。
Opus-4.8 は Branin で平均的に最適近くまで到達し、5 seed Ackley 平均でも最強です。
#### OpenCode エージェント(無料)
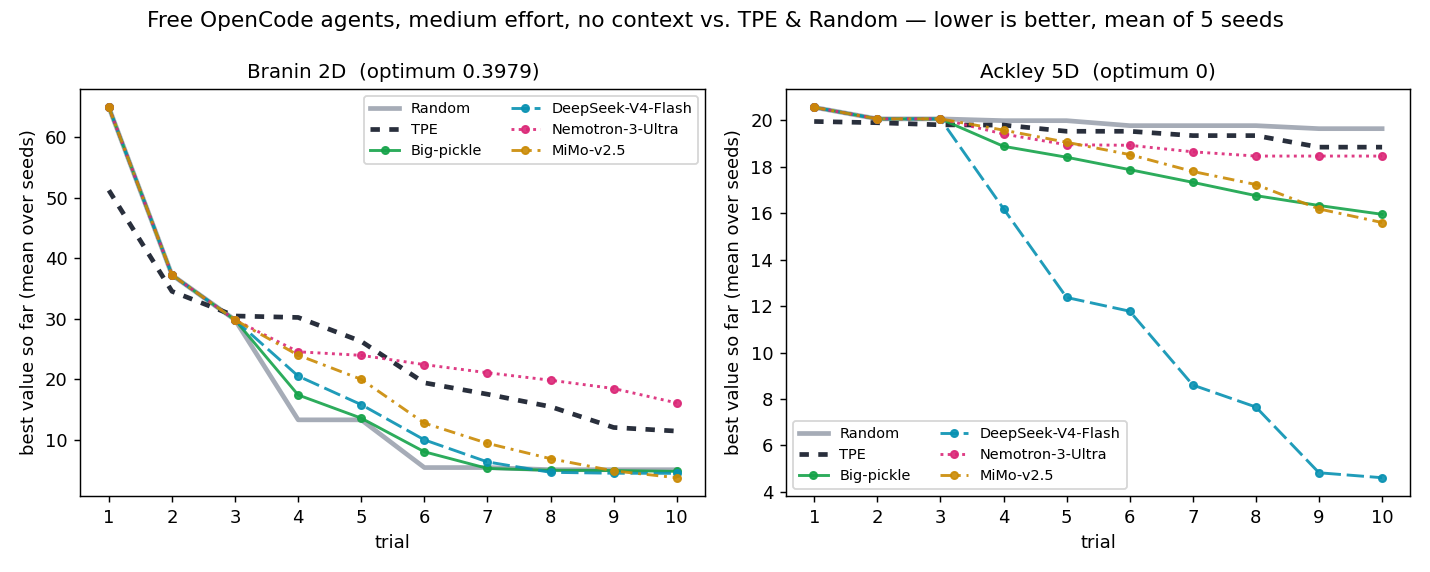
| 手法 | 平均 best Branin ↓ | 平均 best Ackley-5D ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| Big-pickle | 4.734 | 15.951 |
| **DeepSeek-V4-Flash** | 4.410 | **4.608** |
| Nemotron-3-Ultra | 16.051 | 18.459 |
| **MiMo-v2.5** | **3.682** | 15.597 |
OpenCode ホストのモデルは有料モデル API を必要としません。無料プールは変わるため、
この更新では `opencode/big-pickle`、`opencode/deepseek-v4-flash-free`、
`opencode/nemotron-3-ultra-free`、`opencode/mimo-v2.5-free` を固定しています。
DeepSeek V4 Flash は無料モデルの Ackley 平均が最強で、MiMo-v2.5 は Branin 平均が最強です。
### ResNet ベース画像分類器の調整: MNIST と CIFAR-10
分類ベンチマークは **Random**、Optuna **TPE**、**GPT-5.5 w/ context**、
**GPT-5.5 w/o context** を 5 seed(`0..4`)と 10 trial で比較します。
context 条件は study とパラメータの自然言語説明を受け取り、no-context 条件は境界と trial 履歴だけを受け取ります。
主指標は早い改善を重視します:
```text
cumulative_best_so_far_error = sum(best_test_error_so_far_at_i for i in 1..10)
```
低いほど良い値です。
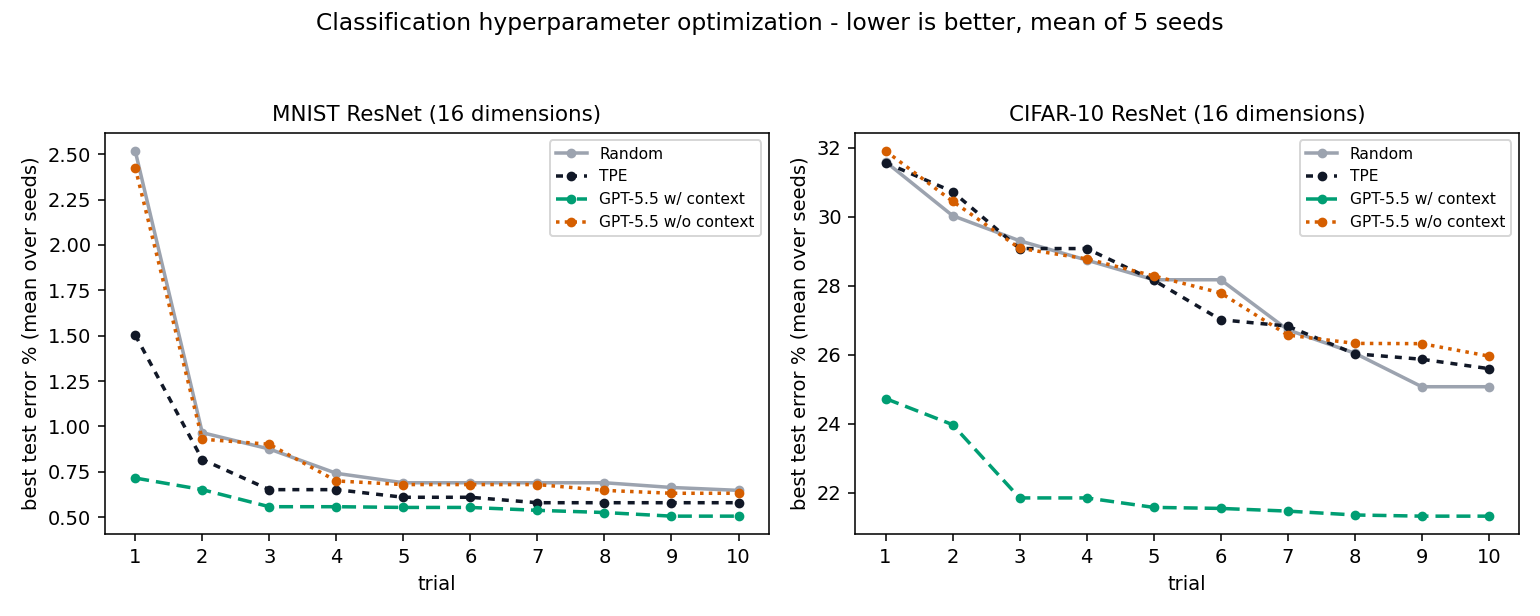
| 手法 | MNIST cumulative error ↓ | MNIST final error ↓ | CIFAR-10 cumulative error ↓ | CIFAR-10 final error ↓ |
|---|---:|---:|---:|---:|
| Random | 9.174 | 0.648% | 278.920 | 25.072% |
| TPE | 7.166 | 0.580% | 279.936 | 25.596% |
| **GPT-5.5 w/ context** | **5.668** | **0.506%** | **220.994** | **21.322%** |
| GPT-5.5 w/o context | 8.910 | 0.632% | 281.466 | 25.960% |
GPT-5.5 w/ context は、MNIST では TPE に対して cumulative best-so-far error を
**20.9%**、CIFAR-10 では Random に対して **20.8%** 下げました。context なしでは
MNIST で TPE より 24.3% 悪く、CIFAR-10 で Random より 0.9% 悪い結果です。
[`examples/mnist.py`](../../examples/mnist.py) と [`examples/cifar10.py`](../../examples/cifar10.py)
は、学習率、batch size、weight decay、label smoothing、3 段の幅、3 段の深さ、
4 つの dropout control を調整します。MNIST は translation と rotation を追加し、
CIFAR-10 は crop padding と flip probability を使います。
### Q-learning コントローラの調整: Acrobot-v1 と LunarLander-v3
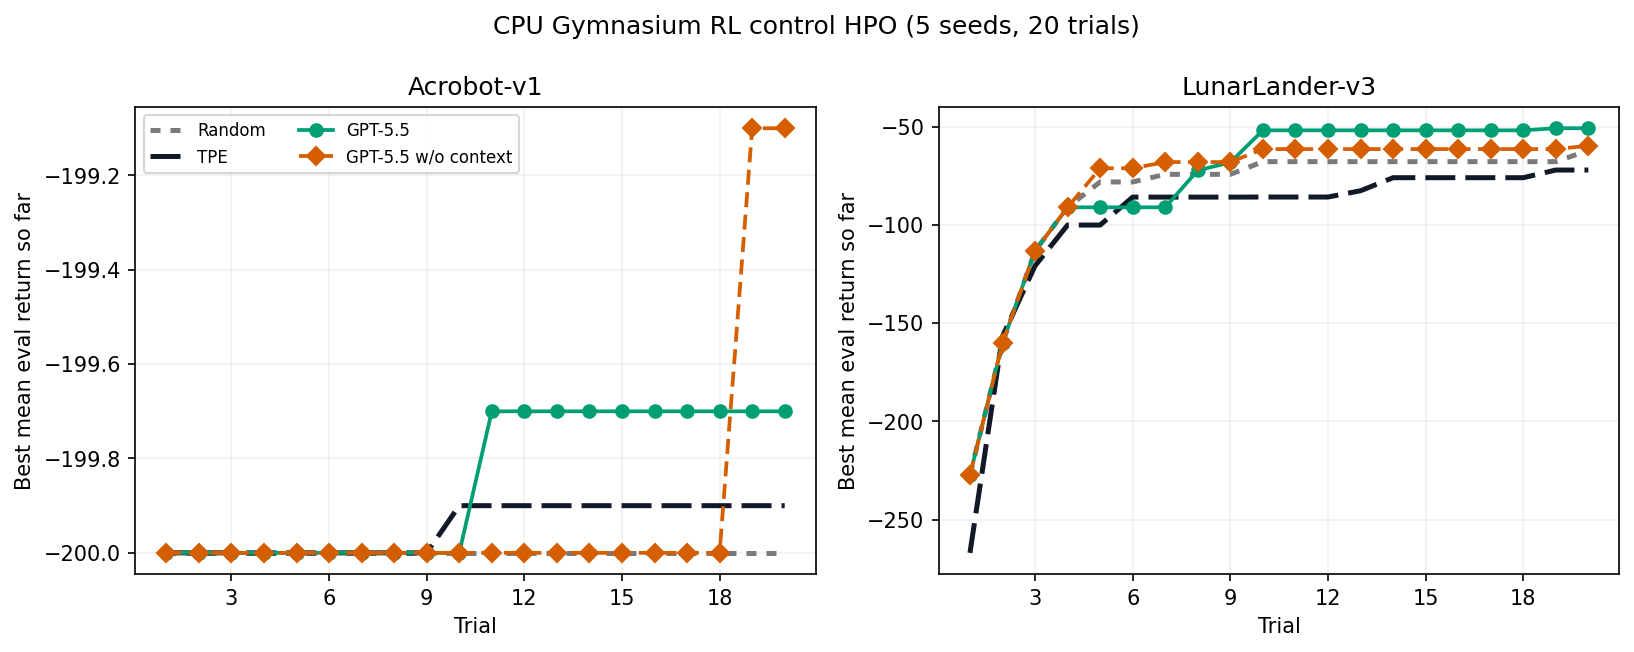
この CPU-only Gymnasium ベンチマークは、Acrobot-v1 と LunarLander-v3 の離散化
Q-learning コントローラを調整します。各手法は 20 trial、5 seed(`0..4`)で実行されます。
目的は平均評価 return なので、高いほど良い値です。runner は seed 間と各 HPO study 内を
`--workers` で並列化します。GPT-5.5 アームは high modeling effort と直近 5 trial の履歴を使います。
| 手法 | Acrobot-v1 return ↑ | LunarLander-v3 return ↑ |
|---|---:|---:|
| Random | -200.000 | -62.139 |
| TPE | -199.900 | -72.088 |
| **GPT-5.5 w/ context** | **-199.700** | **-50.825** |
| GPT-5.5 w/o context | -199.100 | -59.751 |
20 trial と 5 trial の prompt history では、GPT-5.5 w/ context が両環境で最強の平均 return を出しました。
Acrobot-v1 では TPE より 0.2、LunarLander-v3 では Random より 11.3 高い値です。
これは CPU HPO ストレステストであり、普遍的な順位ではありません。
アニメーションでは、optim-agent が 1 つの HPO seed で決定的 LunarLander コントローラの
7 つの gain を調整しています。各 trial は同じ 20 rollout seed を使い、成功着陸数を優先し、
次に平均 return で選びます。選ばれた trial は 20 rollout すべてで着陸に成功しました。
### Gradient Boosting 分類器の調整: クレジットデフォルト確率
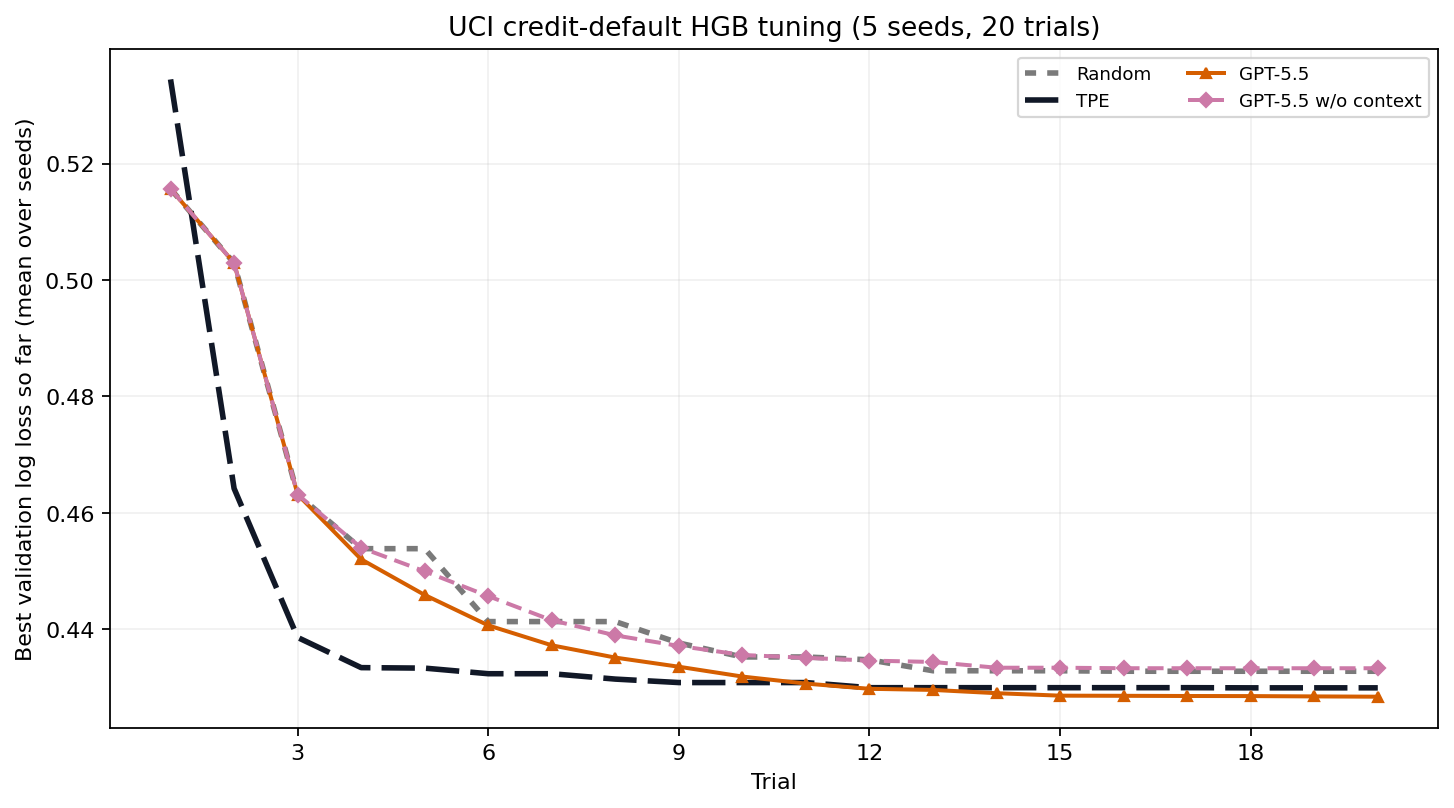
この CPU-only ベンチマークは、UCI
[Default of Credit Card Clients](https://archive.ics.uci.edu/dataset/350/default+of+credit+card+clients)
データセットで `HistGradientBoostingClassifier` の 8 個の学習パラメータを調整します。
データは 30,000 行、23 特徴、翌月デフォルト target です。公式アーカイブは SHA-256 で固定され、
CC BY 4.0 ライセンスで、60% train、20% validation、20% untouched test に一度だけ分割されます。
全手法は同じ分割、20 trial、seed `0..4` を使います。両 GPT-5.5 アームは high modeling effort、
20 trial の prompt history、explicit reasoning、qualitative notes を使います。
| 手法 | final validation log loss ↓ | held-out test log loss ↓ |
|---|---:|---:|
| Random | 0.433 | 0.425 |
| TPE | 0.430 | 0.422 |
| GP-BO | 0.430 | 0.423 |
| **GPT-5.5 w/ context** | **0.428** | **0.422** |
| GPT-5.5 w/o context | 0.433 | 0.427 |
context は、対応する no-context 条件に対して final validation log loss を 1.13%、
test log loss を 1.23% 下げました。GPT-5.5 は Random、TPE、GP-BO よりも平均 validation/test loss が低い結果です。
保持する設定の選択に validation と test loss の両方を使っているため、test 結果は未使用データ上の汎化推定ではなく、
ベンチマーク比較です。
これは方法論ベンチマークであり、本番の信用判断システムではありません。デプロイには公平性、校正、ドリフト、ガバナンス、法務レビューが必要です。
ベンチマーク成果物を再現:
```bash
pip install -e ".[examples]"
# Classification
python scripts/verify_classification_cumulative_error.py run-no-context
python scripts/verify_classification_cumulative_error.py
# Hard functions
python examples/hard_functions.py distributed \
--agents Random TPE GPT-5.5 Opus-4.8 Sonnet-5 GLM-5.2 Big-pickle \
DeepSeek-V4-Flash Nemotron-3-Ultra MiMo-v2.5 \
--trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-kimi.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Kimi-K3 --trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-minimax.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Minimax-M3 --trials 10 --seeds 0 1 2 3 4
python examples/hard_functions.py plot
# Credit-card HGB
pip install -e ".[ml,examples]"
python examples/credit_card.py download
python examples/credit_card.py preflight
python examples/credit_card.py run
python examples/credit_card.py selfcheck
python examples/credit_card.py summary
python examples/credit_card.py plot
# RL control
pip install -e ".[rl,examples]"
python examples/rl_control.py preflight
python examples/rl_control.py run --seeds 0 1 2 3 4 --workers 10
python examples/rl_control.py selfcheck
python examples/rl_control.py summary
python examples/rl_control.py plot
python examples/rl_control.py gif
```
## 使用ガイド
### Sampler Prompt Controls
`effort` は backend CLI の reasoning-effort フラグに渡されます。harness prompt は別に制御します:
```python
oa.AgentSampler(
backend="codex",
effort="medium",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
)
```
`history=None` で完了/剪定済み trial をすべて表示します。
`explicit_reasoning=False` または `qualitative_notes=False` で応答を短くできます。
### Trial ロギング
`study.optimize(..., verbose=...)` で trial ごとの出力を制御します:
- `verbose=True`(デフォルト)は対話ターミナルで表を表示します: trial ごとに 1 行で、
列は `trial`、`value`、`best`、`state` に加え、探索空間の各パラメータが初出順に
1 列ずつ並びます。長い行はターミナル幅に収まるよう省略記号で切り詰められ、
欠損値(失敗した trial など)は `-` と表示されます。
- stdout が TTY でない場合(パイプ出力や CI ログ)、`verbose=True` / `"table"` は
自動的に grep しやすい 1 行形式にフォールバックします
(`[optim-agent] trial 3: value=0.91 state=complete best=0.91`)。
- `verbose="line"` は TTY でも常に 1 行形式を使います。
- `verbose="table"` は TTY では表、パイプ時は 1 行形式を使います。
- `verbose=False` は trial ごとの出力を無効にします。
define-by-run の探索空間では、新しいパラメータキーを持つ trial が現れると、
列の上位集合でヘッダー行が再表示されます。
### Summary Agent
`create_study` に `summarize=True` を渡すと、最後の trial の完了後にエージェントが
終了した study を一度だけ物語ります:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.json",
summarize=True,
)
study.optimize(objective, n_trials=20)
print(study.summary) # JSON / SQLite ストレージにも永続化されます
```
サマリーは 4 つのセクション(最良構成、探索空間の洞察、軌跡のハイライト、推奨される
次のステップ)に構造化されます。ターミナルに表示され、`study.summary` に永続化されます
(JSON ストレージでは追加キー、SQLite では `meta` テーブル。古い保存済み study は
`summary=None` として読み込まれます)。
バックエンド解決: 明示的な `summary_backend=` が優先され、それ以外では sampler が
`AgentSampler` の場合にその backend が再利用されます。それ以外の sampler では
`summary_backend=` を渡してください。渡さないと `create_study` が修正方法を示す
`ValueError` を送出します。`summary_model=` / `summary_effort=` はサマリー用に
sampler の model/effort を上書きします。4 セクションすべてにパースできない
エージェント応答は生テキストの表示にフォールバックします。サマリーが study を
失敗させることはなく、完了 trial がゼロの study では 1 行の通知とともにスキップされます。
`backend="mock"` は summarizer でも使えるため、デモやテストは実際の agent CLI なしで
実行できます。
### Pruning
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="codex"),
pruner=oa.AgentPruner(
backend="codex", level="medium", effort="medium",
), # level: loose | medium | tight
)
def objective(trial):
lr = trial.suggest_float("lr", 1e-5, 1e-1, log=True,
context="learning rate for training an image classifier")
for epoch in range(20):
loss = train_one_epoch(lr)
trial.report(loss, epoch)
if trial.should_prune():
raise oa.TrialPruned()
return loss
```
pruner agent は現在の学習曲線を完了済み trial と比較し、prune/keep を返します。
`loose` は明らかに悪い run だけを剪定し、`tight` はより積極的です。agent エラーで trial が剪定されることはありません。
### 並行・分散 Study
`max_concurrency`(既定 `1`)で複数 trial を同時評価できます。SQLite `storage`
ファイル(`.db` / `.sqlite`)を使うと、並行安全な共有履歴になります:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.db", # SQLite -> safe for many workers; .json stays single-writer
max_concurrency=8, # up to 8 objectives run at once
)
study.optimize(objective, n_trials=100)
```
- **1 プロセス内**では、`max_concurrency` が thread pool で目的関数を実行します。
agent sampling はキューで直列化され、各提案がプロセス内履歴を見ます。並列なのは目的関数呼び出しだけです。
- **プロセス/マシンをまたぐ場合**は、全 worker が同じ SQLite `storage` を指します。
データベースが通信チャネルになり、WAL mode で結果追加と履歴読み取りを両立します。
制約: thread は GIL を共有するため、純 Python の CPU-bound 目的関数は共有 SQLite storage と別プロセスが向いています。
並行 worker は互いの in-flight point を見ないため、近い領域を探索することがあります。
### スキルモード(Agent がプロジェクトコードを読む)
pip パッケージは目的関数をブラックボックスとして扱います。
[optim-agent skill](../../SKILL.md) はさらに、コーディングエージェントセッション内で
まず**プロジェクトを読み**、各パラメータの役割を理解してから
`study.ask(params)` / `study.tell(trial, value)` で同じ study loop を進めます。
study JSON がセッション間の履歴を保持します。
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Claude Code plugin:
```bash
claude plugin marketplace add Optim-Agent/optim-agent
claude plugin install optim-agent@optim-agent
```
Codex plugin:
```bash
codex plugin marketplace add Optim-Agent/optim-agent
codex plugin add optim-agent@optim-agent
```
```python
trial = study.ask({"threshold": 0.72, "budget": 80})
study.tell(trial, evaluate_system(**trial.params))
```
### オフラインテスト
`AgentSampler(backend="mock")` は token-free の代替で、best point の周りを hill climbing します。
agent 呼び出し前の統合テストに使えます。
## トラブルシューティング
- **agent セッション内で `claude` が 401 を返す** - nested session は `ANTHROPIC_API_KEY` を継承します。
`env -u ANTHROPIC_API_KEY` または clean shell で実行してください。
- **backend call が timeout または invalid output を返す** - sampler は警告し、その trial を random point に戻します。study は継続します。
- **OpenCode with distributed studies** - OpenCode currently does not support distributed computing
in optim-agent; single-process workflow か別 backend を使ってください。
## 貢献
ローカル開発:
```bash
pip install -e ".[examples]"
pytest # runs tests/test_optim_agent.py
```
大きな変更は PR の前に issue で相談してください。新しい agent backend の追加は通常
[`optim_agent/agent.py`](../../optim_agent/agent.py) に小さな関数を 1 つ加えるだけです。
英語の [`README.md`](../../README.md) がバージョン、ベンチマーク値、backend リストの正本です。
## 謝辞
- [Optuna](https://github.com/optuna/optuna) は Study/Trial インターフェースを広め、
examples と benchmarks 全体で使う TPE baseline を提供し、実用最適化ツールの高い基準を示しました。
- [OpenCode](https://github.com/sst/opencode) は hard-function benchmarks で評価した無料モデルへのアクセスを提供しました。
## ライセンス
[MIT](../../LICENSE)