optim-agent
借助编程智能体进行智能体式系统优化。
自动化算法工程师的迭代式参数调优工作。



English |
简体中文 |
日本語 |
한국어 |
Français |
Deutsch |
Español |
Português |
Русский
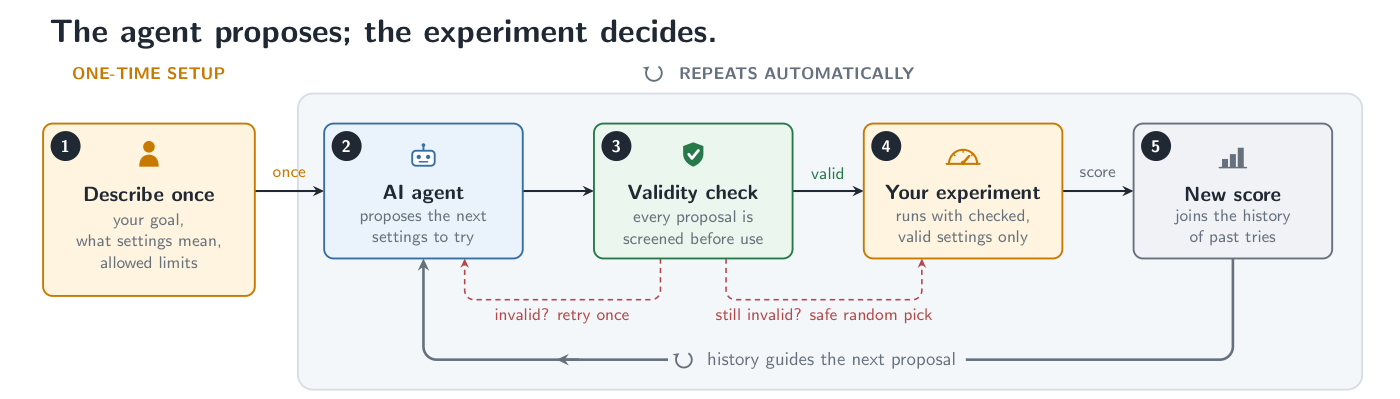
optim-agent 让 Claude Code / Codex / OpenCode 通过阅读代码、提出试验并记录
实测目标结果来调优真实系统参数。适用于系统暴露可配置参数且目标可测量的场景。
它把每个参数的含义与试验历史展示出的信号结合起来,再提出下一组要评估的配置。
目标函数评估始终是权威结果:optim-agent 只提出参数值、按声明的搜索空间校验、
记录结果,并在智能体回复无效时回退到安全采样。
| 模型 | 系统 | 研究 |
|---|---|---|
| 训练、架构和强化学习实验 | 推理、延迟、成本、控制和决策规则 | 量化信号、仿真和科学工作流 |
## 为什么使用 optim-agent
- **语义化提案** - 编程智能体会理解参数含义、上下文和已观测结果,而不是把每个维度都当成匿名坐标。
- **小预算杠杆** - 适合评估成本高、经典代理模型仍缺数据的场景。
- **Agent CLI 增益** - 底层编程智能体升级时,提案质量可随之提升,例如从 GPT-5.5 到 GPT-5.6,而无需修改优化代码。
- **可审计决策** - JSON/SQLite study 保留配置、结果、状态、上下文和可选的智能体理由。
- **有边界的执行** - 智能体只提出值;optim-agent 按声明空间校验,无效输出会回退到安全采样。
## 安装
安装 Codex skill:
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
安装 Claude Code plugin:
```bash
claude plugin marketplace add Optim-Agent/optim-agent && claude plugin install optim-agent@optim-agent
```
安装 Python 包:
```bash
# PyPI 稳定版本
python -m pip install optim-agent
# GitHub 最新源码
python -m pip install "optim-agent @ git+https://github.com/Optim-Agent/optim-agent.git"
```
需要至少一个已登录且在 `PATH` 上的 agent CLI:
[claude](https://docs.anthropic.com/en/docs/claude-code)、
[codex](https://github.com/openai/codex) 或
[OpenCode](https://github.com/sst/opencode)。
## 快速开始
```python
import optim_agent as oa
def objective(trial):
threshold = trial.suggest_float(
"threshold", 0.05, 0.95,
context="decision threshold; higher values trade recall for precision",
)
budget = trial.suggest_int(
"budget", 10, 200, log=True,
context="compute or operating budget; larger values may improve quality",
)
return evaluate_system(threshold=threshold, budget=budget) # domain code
study = oa.create_study(
direction="maximize",
sampler=oa.AgentSampler(
backend="claude", # or "codex" / "opencode"
effort="high",
context="maximize system quality under a strict operating-cost budget",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
),
storage="study.json", # optional: persist and resume
summarize=True, # optional: agent-written result summary after the last trial
)
study.optimize(objective, n_trials=20)
print(study.best_value, study.best_params)
print(study.summary) # the summary agent's narration of the finished study
```
可选的 `context` 为 study 和参数提供领域含义。可以在
`AgentSampler(context=...)` 提供 study 级上下文,也可以在
`suggest_*(..., context=...)` 提供参数级上下文,或两者同时使用。
也可以直接运行 [`examples/quickstart.py`](../../examples/quickstart.py),或在
[`tutorials/quickstart.ipynb`](../../tutorials/quickstart.ipynb) 中逐步体验。
## 适用场景
| 领域 | optim-agent 可调参数 | 示例目标 |
|---|---|---|
| **模型训练** | 学习率、架构、数据增强、正则化 | 验证质量、计算量、鲁棒性 |
| **推理和服务** | 量化、批处理、解码、缓存、路由 | 质量、延迟、吞吐、成本 |
| **量化研究** | 信号窗口、阈值、再平衡规则、风险控制 | 滚动收益、回撤、换手 |
| **强化学习和决策** | 目标权重、探索计划、环境设置、策略阈值 | 回报、安全性、样本效率 |
| **科学工作流** | 仿真输入、求解器设置、实验控制 | 拟合度、误差、运行时间、资源使用 |
| **黑盒系统** | 任意有界的类别、整数或连续配置 | 标量目标分数 |
更多示例见 [`examples/sklearn_tuning.py`](../../examples/sklearn_tuning.py) 和
[`examples/inference_tuning.py`](../../examples/inference_tuning.py)。
强化学习场景中,optim-agent 调优学习循环周围的系统参数;它不替代策略学习算法。
## 优化轨迹
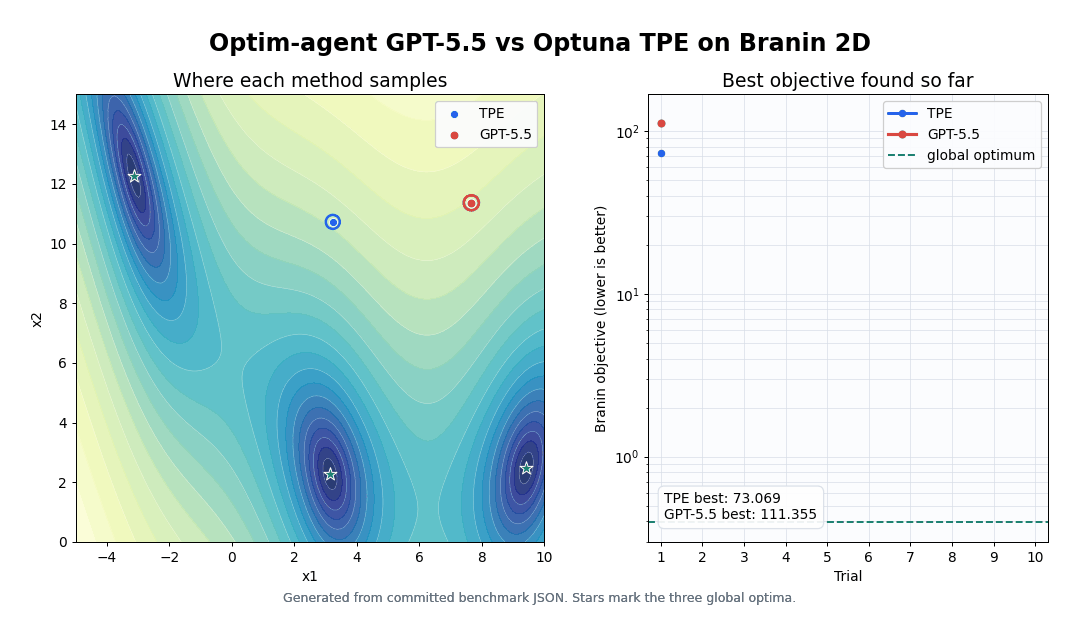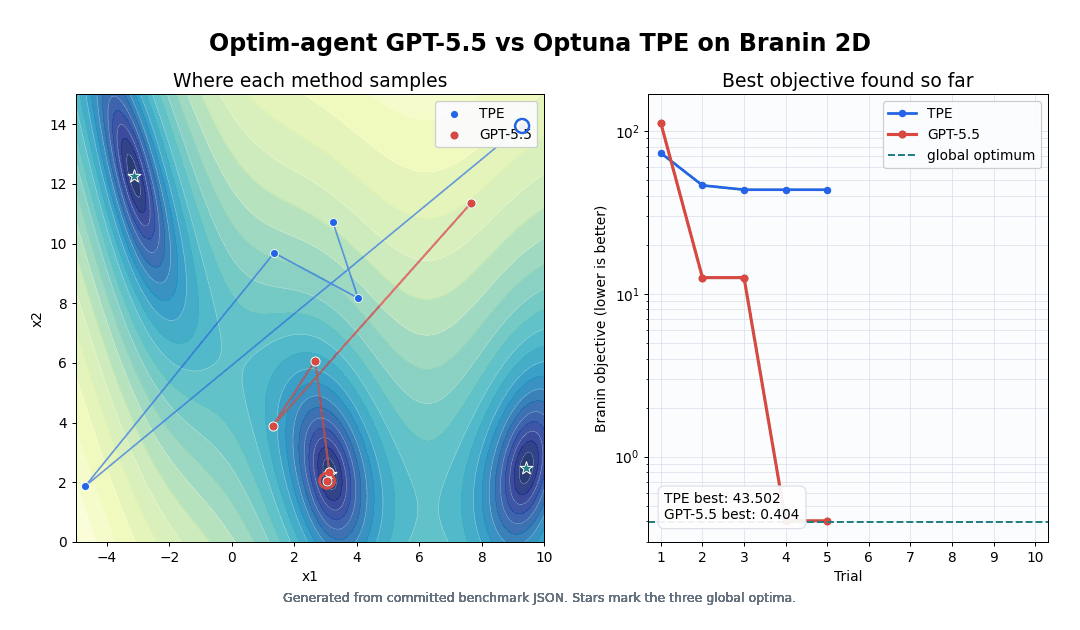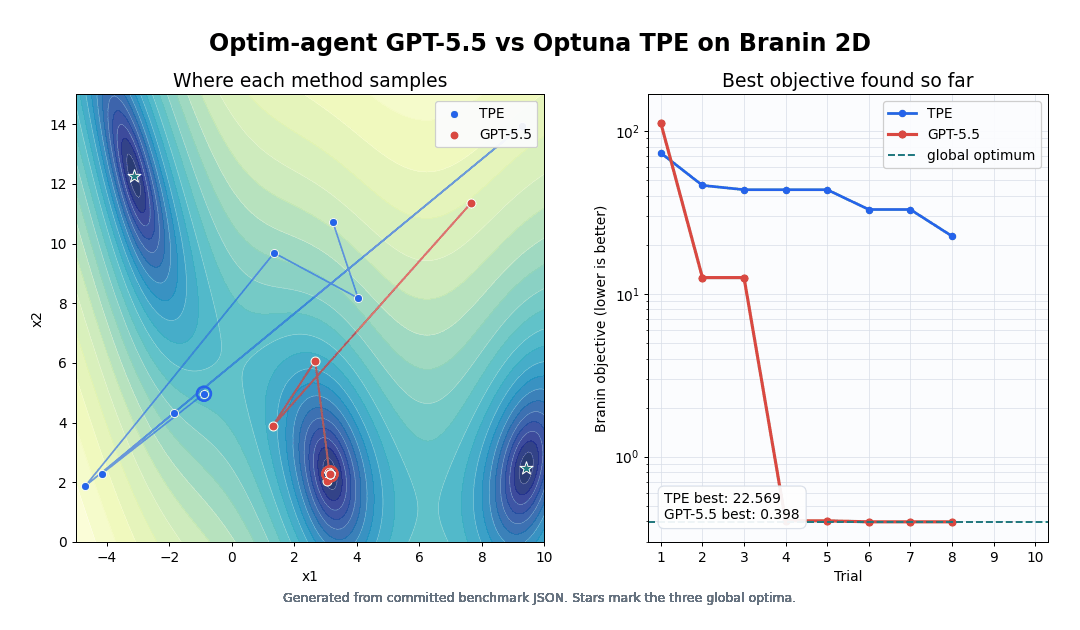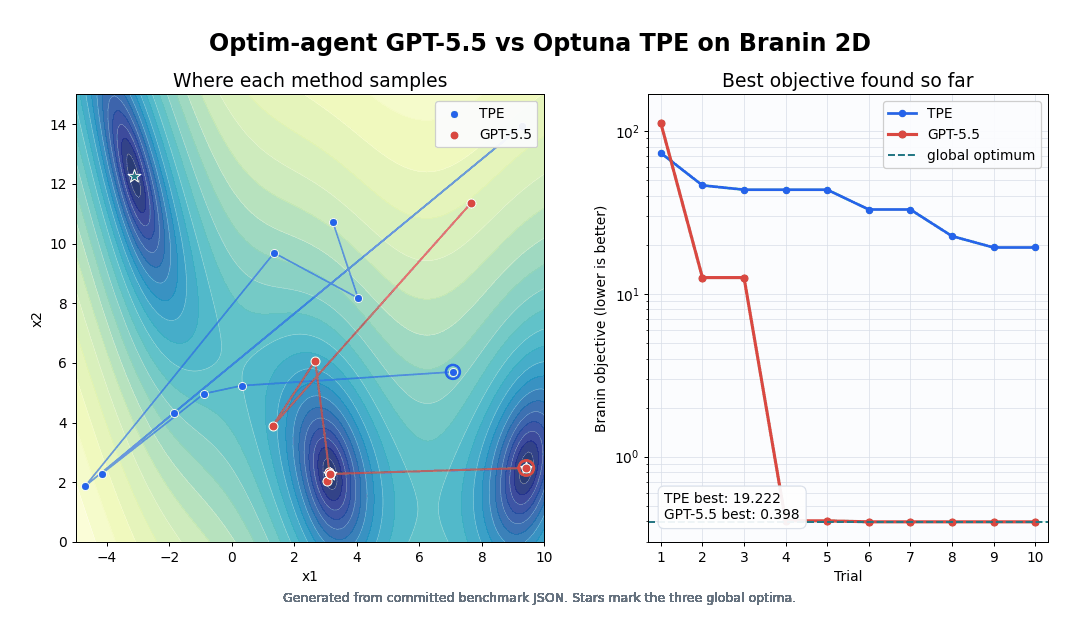
这条 seed-0 Branin 轨迹在相同 10 次试验预算下比较 TPE 和 GPT-5.5,
展示每次试验后的 incumbent objective。它只是轨迹说明;聚合基准和复现命令如下。
### 无上下文优化数学函数:Branin-2D 与 Ackley-5D
困难函数智能体**不接收任务上下文**:只有通用参数名 `x1...x5`、数值边界和试验历史。
运行使用 10 次试验和 5 个随机种子;Random 和 TPE 是不变基线。
#### 顶级智能体
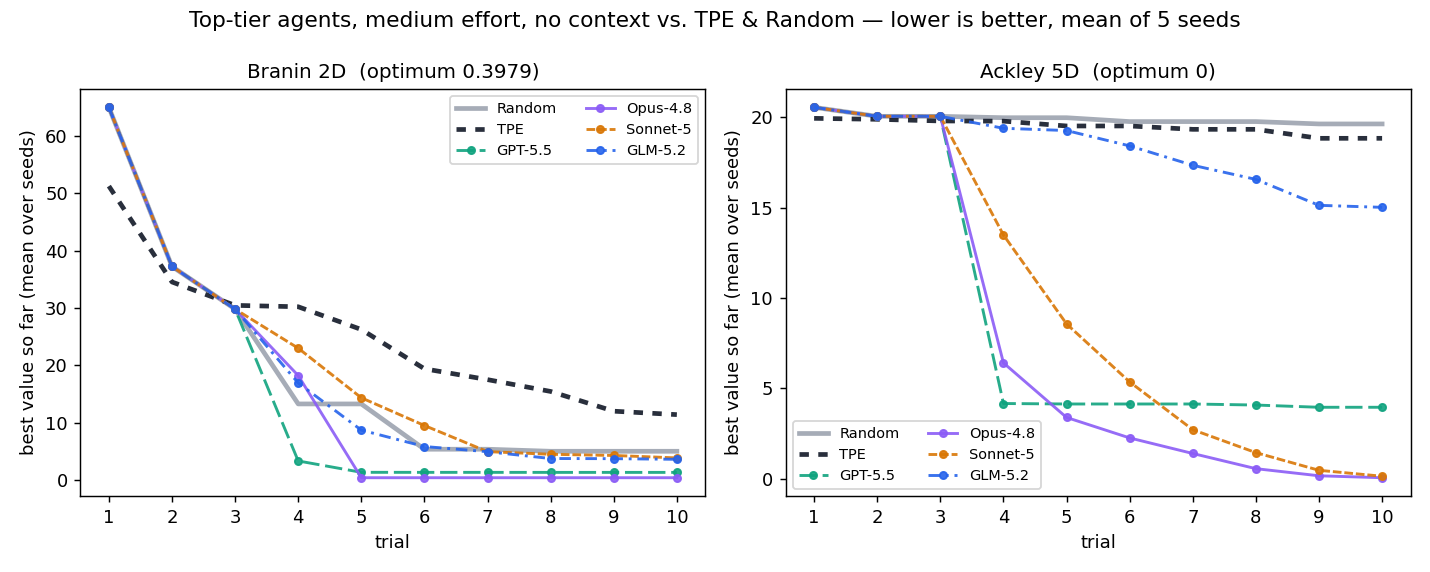
| 方法 | Branin 平均最优值 ↓ | Ackley-5D 平均最优值 ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| GPT-5.5 | 1.326 | 3.960 |
| **Opus-4.8** | **0.398** | **0.061** |
| Sonnet-5 | 3.850 | 0.143 |
| Kimi-K3 | 2.082 | 0.907 |
| Minimax-M3 | 0.970 | 0.574 |
| GLM-5.2 | 3.609 | 15.023 |
固定模型为 `gpt-5.5`、`claude-opus-4-8`、`claude-sonnet-5`、`kimi-k3`、
`MiniMax-M3` 和 `glm-5.2`。
Opus-4.8 在 Branin 上平均到达最优附近,并取得最强的五随机种子 Ackley 均值。
#### OpenCode 免费智能体
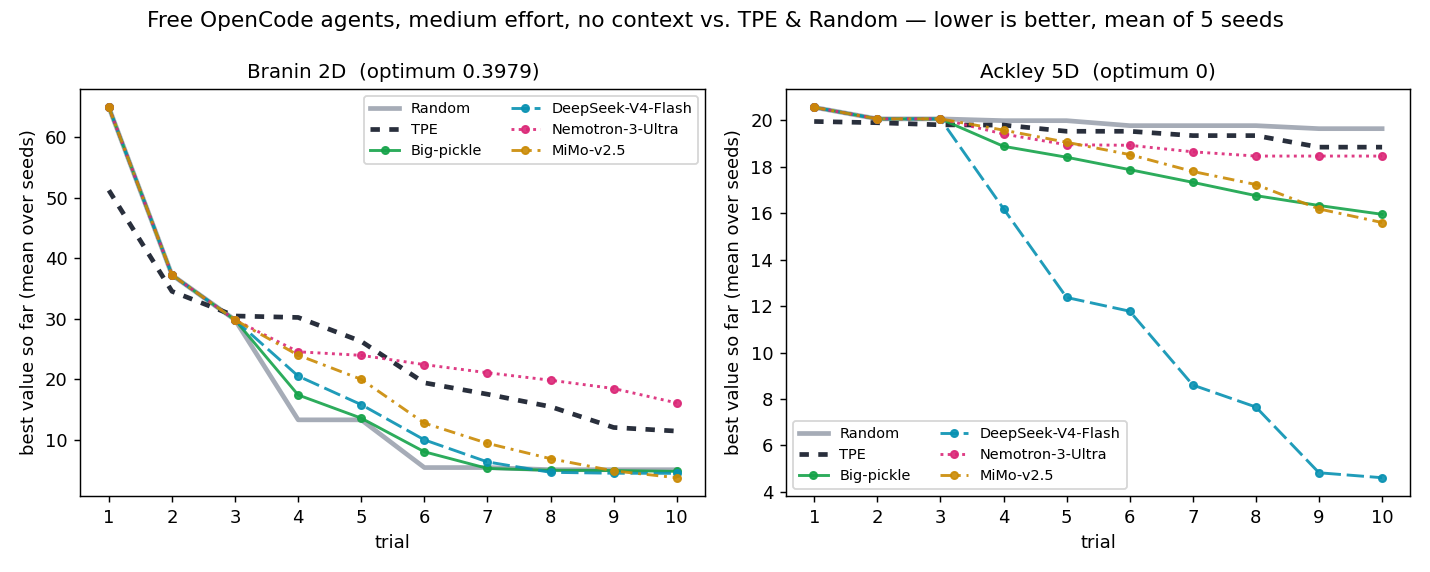
| 方法 | Branin 平均最优值 ↓ | Ackley-5D 平均最优值 ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| Big-pickle | 4.734 | 15.951 |
| **DeepSeek-V4-Flash** | 4.410 | **4.608** |
| Nemotron-3-Ultra | 16.051 | 18.459 |
| **MiMo-v2.5** | **3.682** | 15.597 |
OpenCode 托管模型不需要付费模型 API。免费池会轮换;本次刷新固定
`opencode/big-pickle`、`opencode/deepseek-v4-flash-free`、
`opencode/nemotron-3-ultra-free` 和 `opencode/mimo-v2.5-free`。
DeepSeek V4 Flash 的免费模型 Ackley 均值最强,MiMo-v2.5 的免费模型 Branin 均值最强。
### 调优基于 ResNet 的图像分类器:MNIST 与 CIFAR-10
该分类基准比较 **Random**、Optuna **TPE**、**GPT-5.5 w/ context** 和
**GPT-5.5 w/o context**,使用 5 个随机种子(`0..4`)和 10 次试验。
有上下文条件接收自然语言 study 和参数说明;无上下文条件只接收边界和试验历史。
分类任务的主指标强调快速改进:
```text
cumulative_best_so_far_error = sum(best_test_error_so_far_at_i for i in 1..10)
```
数值越低越好。
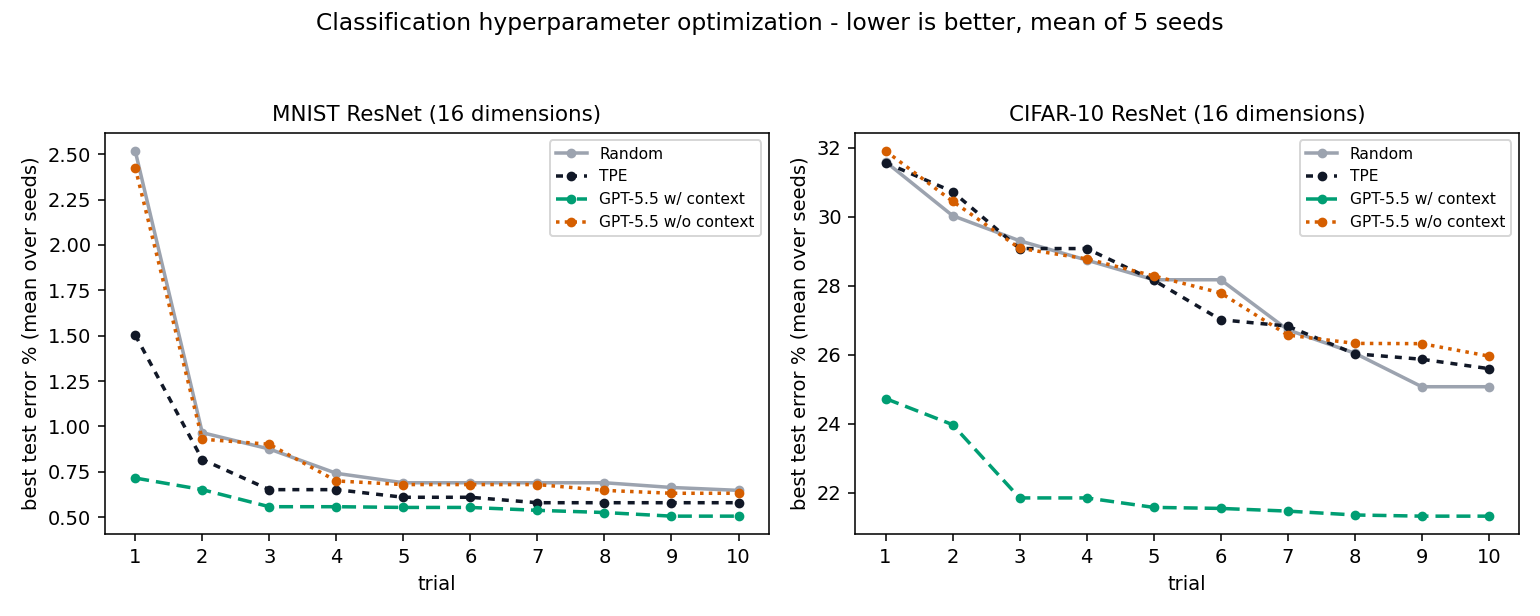
| 方法 | MNIST 累计错误 ↓ | MNIST 最终错误 ↓ | CIFAR-10 累计错误 ↓ | CIFAR-10 最终错误 ↓ |
|---|---:|---:|---:|---:|
| Random | 9.174 | 0.648% | 278.920 | 25.072% |
| TPE | 7.166 | 0.580% | 279.936 | 25.596% |
| **GPT-5.5 w/ context** | **5.668** | **0.506%** | **220.994** | **21.322%** |
| GPT-5.5 w/o context | 8.910 | 0.632% | 281.466 | 25.960% |
相对 TPE,GPT-5.5 w/ context 在 MNIST 上将累计 best-so-far 错误降低 **20.9%**;
相对 Random,在 CIFAR-10 上降低 **20.8%**。无上下文条件在 MNIST 上比 TPE 差
24.3%,在 CIFAR-10 上比 Random 差 0.9%。差异同时包含语义参数信息和更早获得
agent 引导提案的收益。
[`examples/mnist.py`](../../examples/mnist.py) 和
[`examples/cifar10.py`](../../examples/cifar10.py) 都会调优学习率、batch size、
weight decay、label smoothing、三段宽度、三段深度和四个 dropout 控制项。
MNIST 额外包含平移和旋转;CIFAR-10 使用 crop padding 和 flip probability。
### 调优 Q-learning 控制器:Acrobot-v1 与 LunarLander-v3
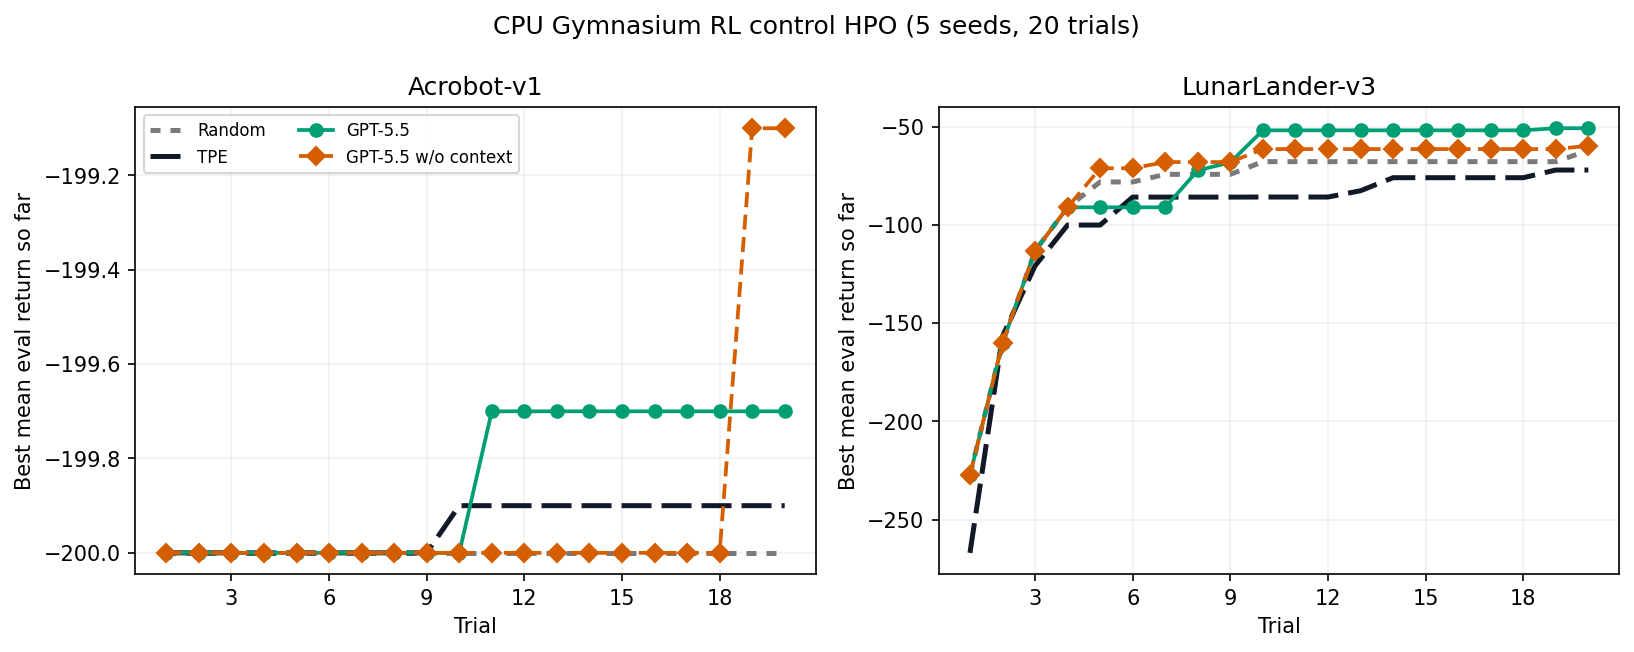
该 CPU-only Gymnasium 基准为 Acrobot-v1 和 LunarLander-v3 调优离散化 Q-learning
控制器。每种方法使用 5 个随机种子(`0..4`)和 20 次试验;目标是平均评估回报,
因此越高越好。runner 会跨随机种子并在每个 HPO study 内通过 `--workers` 并行。
GPT-5.5 分支使用 high modeling effort 和最近 5 次试验历史。胜出的上下文分支关闭
可选的 explicit-reasoning 和 qualitative-note 字段。
| 方法 | Acrobot-v1 回报 ↑ | LunarLander-v3 回报 ↑ |
|---|---:|---:|
| Random | -200.000 | -62.139 |
| TPE | -199.900 | -72.088 |
| **GPT-5.5 w/ context** | **-199.700** | **-50.825** |
| GPT-5.5 w/o context | -199.100 | -59.751 |
在 20 次试验和 5 条 prompt 历史下,GPT-5.5 w/ context 在两个环境上平均回报最强:
Acrobot-v1 比 TPE 高 0.2,LunarLander-v3 比 Random 高 11.3。该结果应视为
CPU HPO 压力测试,而不是通用排名。
动画中,optim-agent 用一个 HPO seed 调优确定性 LunarLander 控制器的 7 个增益。
每个 trial 使用相同 20 个 rollout seed,先按成功着陆数量排序,再按平均回报排序。
被选中的 trial 在全部 20 次 rollout 中成功着陆;GIF 展示其最高回报 rollout。
### 调优梯度提升分类器:信用违约概率
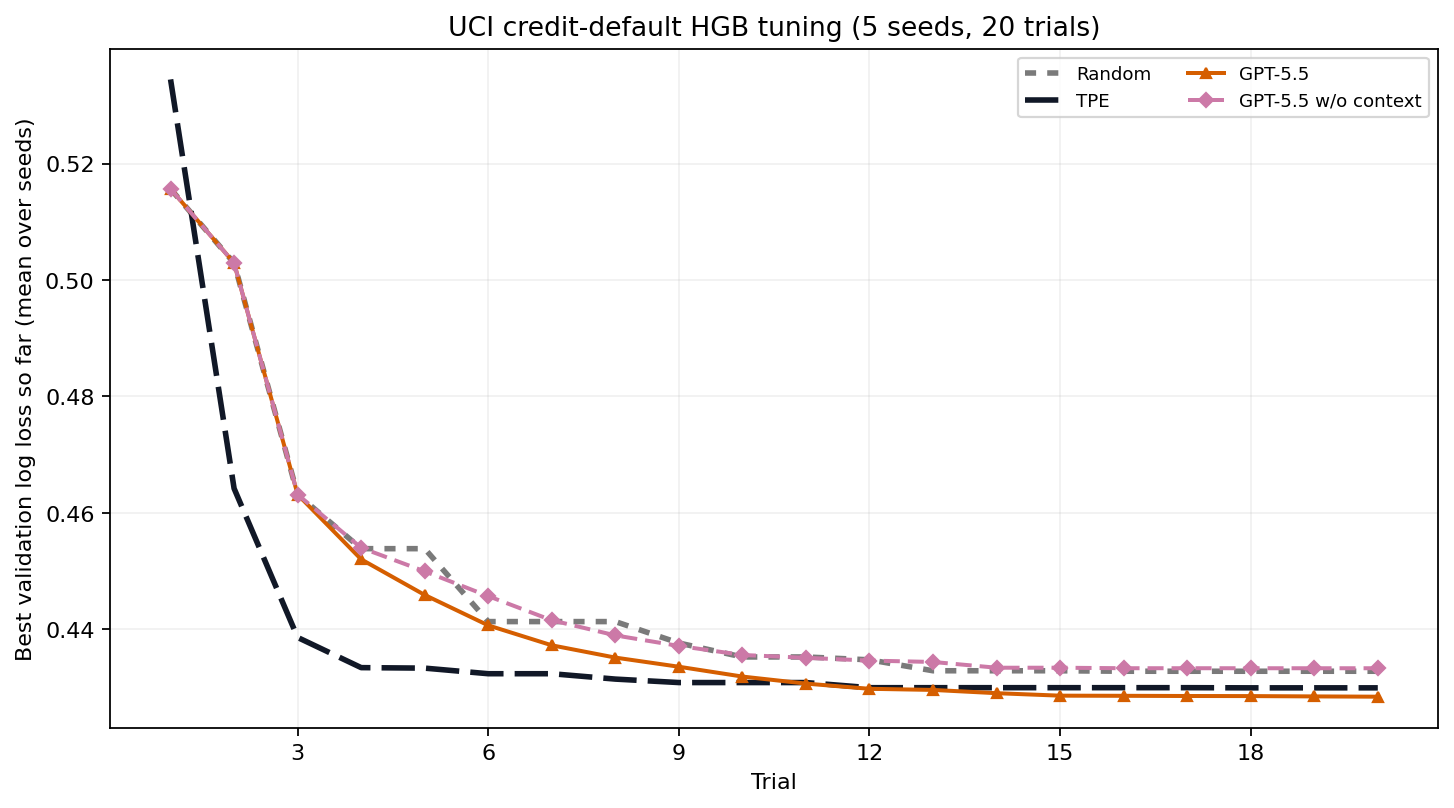
该 CPU-only 基准在 UCI
[Default of Credit Card Clients](https://archive.ics.uci.edu/dataset/350/default+of+credit+card+clients)
数据集上调优 `HistGradientBoostingClassifier` 的 8 个训练参数:30,000 行、23 个特征、
下月违约目标。官方归档按 SHA-256 固定,采用 CC BY 4.0 许可,并一次性切分为
60% 训练、20% 验证和 20% untouched test 数据。所有方法使用相同切分、20 次试验和
随机种子 `0..4`。两个 GPT-5.5 分支都使用 high modeling effort、20 次 prompt 历史、
explicit reasoning 和 qualitative notes。
| 方法 | 最终验证 log loss ↓ | 留出测试 log loss ↓ |
|---|---:|---:|
| Random | 0.433 | 0.425 |
| TPE | 0.430 | 0.422 |
| GP-BO | 0.430 | 0.423 |
| **GPT-5.5 w/ context** | **0.428** | **0.422** |
| GPT-5.5 w/o context | 0.433 | 0.427 |
相比匹配的 no-context 对照,上下文将最终验证 log loss 降低 1.13%,将测试 log loss
降低 1.23%。GPT-5.5 的平均验证和测试 loss 也低于 Random、TPE 和 GP-BO。
由于保留配置时同时使用了验证和测试 loss,测试结果是基准比较,而不是未触碰的
泛化估计。
这是方法学基准,不是生产信用决策系统。部署还需要公平性、校准、漂移、治理和法律审查。
复现基准产物:
```bash
pip install -e ".[examples]"
# Classification
python scripts/verify_classification_cumulative_error.py run-no-context
python scripts/verify_classification_cumulative_error.py
# Hard functions
python examples/hard_functions.py distributed \
--agents Random TPE GPT-5.5 Opus-4.8 Sonnet-5 GLM-5.2 Big-pickle \
DeepSeek-V4-Flash Nemotron-3-Ultra MiMo-v2.5 \
--trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-kimi.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Kimi-K3 --trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-minimax.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Minimax-M3 --trials 10 --seeds 0 1 2 3 4
python examples/hard_functions.py plot
# Credit-card HGB
pip install -e ".[ml,examples]"
python examples/credit_card.py download
python examples/credit_card.py preflight
python examples/credit_card.py run
python examples/credit_card.py selfcheck
python examples/credit_card.py summary
python examples/credit_card.py plot
# RL control
pip install -e ".[rl,examples]"
python examples/rl_control.py preflight
python examples/rl_control.py run --seeds 0 1 2 3 4 --workers 10
python examples/rl_control.py selfcheck
python examples/rl_control.py summary
python examples/rl_control.py plot
python examples/rl_control.py gif
```
## 使用指南
### Sampler Prompt 控制
`effort` 会转发给后端 CLI 的 reasoning-effort 标志。harness prompt 单独控制:
```python
oa.AgentSampler(
backend="codex",
effort="medium",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
)
```
设置 `history=None` 可展示所有已完成/已剪枝 trial。使用
`explicit_reasoning=False` 或 `qualitative_notes=False` 可缩短智能体回复。
### Trial 日志
`study.optimize(..., verbose=...)` 控制每个 trial 的输出:
- `verbose=True`(默认)在交互式终端渲染表格:每个 trial 一行,列为 `trial`、
`value`、`best`、`state`,外加搜索空间中每个参数一列(按首次出现顺序)。过长的行
会用省略号截断以适配终端宽度;缺失值(如失败的 trial)显示为 `-`。
- 当 stdout 不是 TTY(管道输出、CI 日志)时,`verbose=True` / `"table"` 会自动回退到
便于 grep 的单行格式(`[optim-agent] trial 3: value=0.91 state=complete best=0.91`)。
- `verbose="line"` 始终使用单行格式,即使在 TTY 上。
- `verbose="table"` 在 TTY 上使用表格,管道输出时使用单行格式。
- `verbose=False` 关闭每个 trial 的输出。
在 define-by-run 搜索空间中,当某个 trial 引入新的参数键时,会以列的超集重新打印表头。
### Summary Agent
向 `create_study` 传入 `summarize=True`,可让智能体在最后一个 trial 完成后对已结束的
study 做一次总结:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.json",
summarize=True,
)
study.optimize(objective, n_trials=20)
print(study.summary) # 也会持久化到 JSON / SQLite 存储中
```
总结固定为四个部分——最佳配置、搜索空间洞察、轨迹亮点和建议的后续步骤。它会打印到终端
并持久化在 `study.summary` 上(JSON 存储中的附加键以及 SQLite 的 `meta` 表;旧的已存
study 加载时 `summary=None`)。
后端解析顺序:显式的 `summary_backend=` 优先;否则当 sampler 是 `AgentSampler` 时复用其
backend。使用其他 sampler 时,请传入 `summary_backend=`,否则 `create_study` 会抛出指明
修复方法的 `ValueError`。`summary_model=` / `summary_effort=` 会覆盖 sampler 的
model/effort 用于总结。无法解析出全部四个部分的智能体回复会回退为打印原始文本——总结
永远不会导致 study 失败,没有已完成 trial 的 study 会以一行提示跳过总结。`backend="mock"`
同样适用于 summarizer,因此演示和测试无需真实的 agent CLI 即可运行。
### 剪枝
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="codex"),
pruner=oa.AgentPruner(
backend="codex", level="medium", effort="medium",
), # level: loose | medium | tight
)
def objective(trial):
lr = trial.suggest_float("lr", 1e-5, 1e-1, log=True,
context="learning rate for training an image classifier")
for epoch in range(20):
loss = train_one_epoch(lr)
trial.report(loss, epoch)
if trial.should_prune():
raise oa.TrialPruned()
return loss
```
pruner agent 会把当前学习曲线与已完成 trial 对比,并回答 prune/keep;
`loose` 只剪掉明显落后的运行,`tight` 更激进。Agent 错误永远不会剪枝 trial。
### 并发和分布式 Study
设置 `max_concurrency`(默认 `1`)可同时评估多个 trial;使用 SQLite `storage`
文件(`.db` / `.sqlite`)作为并发安全的共享历史:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.db", # SQLite -> safe for many workers; .json stays single-writer
max_concurrency=8, # up to 8 objectives run at once
)
study.optimize(objective, n_trials=100)
```
- **单进程内**,`max_concurrency` 在线程池中运行目标函数。agent sampling 查询会排队
串行执行,以便每次提案看到进程内历史;只有目标函数调用并行。它最适合 I/O 或
子进程型评估,例如模型训练或 API 调用。
- **跨进程/机器**,所有 worker 指向同一个 SQLite `storage`。数据库就是通信通道:
WAL 模式允许每个 worker 追加结果并读取历史,避免写冲突,同时保持 trial 编号唯一。
限制:线程共享 GIL,因此纯 Python CPU-bound 目标最好用独立进程和共享 SQLite storage。
并发 worker 看不到彼此的 in-flight 点,因此偶尔可能探索相近区域。
### Skill 模式(Agent 读取项目代码)
pip 包把目标函数视为黑盒。[optim-agent skill](../../SKILL.md) 会更进一步:
在编程智能体会话中加载后,智能体先**阅读项目**以理解每个参数的作用,再通过
`study.ask(params)` / `study.tell(trial, value)` 驱动同一个 study loop,并用
study JSON 在多次会话间保留历史。
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Claude Code plugin:
```bash
claude plugin marketplace add Optim-Agent/optim-agent
claude plugin install optim-agent@optim-agent
```
Codex plugin:
```bash
codex plugin marketplace add Optim-Agent/optim-agent
codex plugin add optim-agent@optim-agent
```
```python
trial = study.ask({"threshold": 0.72, "budget": 80})
study.tell(trial, evaluate_system(**trial.params))
```
### 离线测试
`AgentSampler(backend="mock")` 是不消耗 token 的替身,会围绕最佳点做 hill climbing,
适合在调用真实 agent 前测试集成。
## 故障排查
- **agent 会话内 `claude` 返回 401** - 嵌套会话会继承 `ANTHROPIC_API_KEY`;请用
`env -u ANTHROPIC_API_KEY` 或干净 shell 运行。
- **后端调用超时或输出无效** - sampler 会警告,并对该 trial 回退到随机点;study 继续运行。
- **OpenCode 与分布式 study** - OpenCode currently does not support distributed computing
in optim-agent;请使用单进程流程,或为分布式运行选择其他后端。
## 贡献
欢迎贡献。要本地开发:
```bash
pip install -e ".[examples]"
pytest # runs tests/test_optim_agent.py
```
较大改动请先开 issue 讨论。添加新 agent backend 通常只需要在
[`optim_agent/agent.py`](../../optim_agent/agent.py) 中加一个小函数。
英文 [`README.md`](../../README.md) 仍是版本号、基准数值和后端名单的权威来源。
## 致谢
- 感谢 [Optuna](https://github.com/optuna/optuna) 推广 Study/Trial 接口、提供贯穿示例和
基准的 TPE 基线,并为实用优化工具树立高标准。
- 感谢 [OpenCode](https://github.com/sst/opencode) 提供本项目在困难函数基准中
评测的免费模型。
## 许可证
[MIT](../../LICENSE)