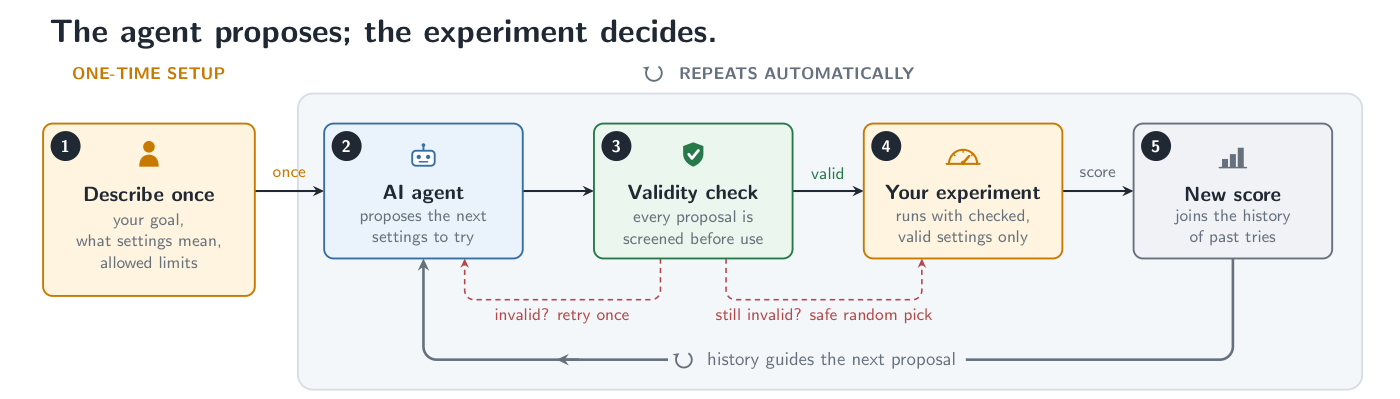
optim-agent permite que Claude Code / Codex / OpenCode ajustem parâmetros reais de sistemas
lendo seu código, propondo trials e registrando resultados objetivos medidos.
Use quando o sistema expõe parâmetros configuráveis e um objetivo mensurável. Ele combina o que cada
parâmetro *significa* com o que o histórico de trials *mostra*, e propõe a próxima configuração a avaliar.
As avaliações do objetivo continuam sendo a autoridade: optim-agent propõe valores, valida contra o espaço
declarado, registra resultados e volta para amostragem segura quando uma resposta de agente é inválida.
| Modelos | Sistemas | Pesquisa |
|---|---|---|
| Treino, arquitetura e experimentos RL | Inferência, latência, custo, controle e regras de decisão | Sinais quantitativos, simulações e workflows científicos |
## Por que usar optim-agent
- **Propostas semânticas** - agentes de programação raciocinam sobre o significado dos parâmetros, contexto e resultados observados, em vez de tratar cada dimensão como uma coordenada anônima.
- **Alavanca em baixo orçamento** - útil quando avaliações são caras e surrogates clássicos ainda têm poucos dados.
- **Ganho com Agent CLI** - a qualidade das propostas pode melhorar conforme os agentes de programação evoluem, por exemplo de GPT-5.5 para GPT-5.6, sem mudar o código de otimização.
- **Decisões auditáveis** - studies JSON/SQLite preservam configurações, resultados, estados, contexto e rationale opcional do agente.
- **Execução limitada** - o agente só propõe valores; optim-agent valida contra o espaço declarado, e saídas inválidas voltam para amostragem segura.
## Instalação
Instale o Codex skill:
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Instale o plugin Claude Code:
```bash
claude plugin marketplace add Optim-Agent/optim-agent && claude plugin install optim-agent@optim-agent
```
Instale o pacote Python:
```bash
# Versão estável do PyPI
python -m pip install optim-agent
# Código mais recente do GitHub
python -m pip install "optim-agent @ git+https://github.com/Optim-Agent/optim-agent.git"
```
Requer um agent CLI autenticado no `PATH`:
[claude](https://docs.anthropic.com/en/docs/claude-code),
[codex](https://github.com/openai/codex) ou
[OpenCode](https://github.com/sst/opencode).
## Início rápido
```python
import optim_agent as oa
def objective(trial):
threshold = trial.suggest_float(
"threshold", 0.05, 0.95,
context="decision threshold; higher values trade recall for precision",
)
budget = trial.suggest_int(
"budget", 10, 200, log=True,
context="compute or operating budget; larger values may improve quality",
)
return evaluate_system(threshold=threshold, budget=budget) # domain code
study = oa.create_study(
direction="maximize",
sampler=oa.AgentSampler(
backend="claude", # or "codex" / "opencode"
effort="high",
context="maximize system quality under a strict operating-cost budget",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
),
storage="study.json", # optional: persist and resume
summarize=True, # optional: agent-written result summary after the last trial
)
study.optimize(objective, n_trials=20)
print(study.best_value, study.best_params)
print(study.summary) # the summary agent's narration of the finished study
```
O `context` opcional dá significado de domínio ao study e aos parâmetros. Forneça em
`AgentSampler(context=...)`, em `suggest_*(..., context=...)`, ou nos dois.
Você também pode executar [`examples/quickstart.py`](../../examples/quickstart.py) ou seguir
[`tutorials/quickstart.ipynb`](../../tutorials/quickstart.ipynb).
## Onde se aplica
| Área | Parâmetros que optim-agent pode ajustar | Objetivo de exemplo |
|---|---|---|
| **Treino de modelos** | learning rates, arquiteturas, augmentação, regularização | qualidade de validação, computação, robustez |
| **Inferência e serving** | quantização, batching, decoding, caching, routing | qualidade, latência, throughput, custo |
| **Pesquisa quantitativa** | janelas de sinal, thresholds, regras de rebalanceamento, controles de risco | retorno walk-forward, drawdown, turnover |
| **RL e decisões** | pesos de objetivo, agendas de exploração, parâmetros de ambiente, thresholds de policy | retorno, segurança, eficiência amostral |
| **Workflows científicos** | entradas de simulação, configurações de solver, controles experimentais | ajuste, erro, tempo, uso de recursos |
| **Sistemas caixa-preta** | qualquer configuração categórica, inteira ou contínua limitada | score objetivo escalar |
Mais exemplos: [`examples/sklearn_tuning.py`](../../examples/sklearn_tuning.py) e
[`examples/inference_tuning.py`](../../examples/inference_tuning.py).
Em reinforcement learning, optim-agent ajusta o sistema ao redor do loop de aprendizado;
ele não substitui o algoritmo de aprendizado de policy.
## Trajetória de otimização
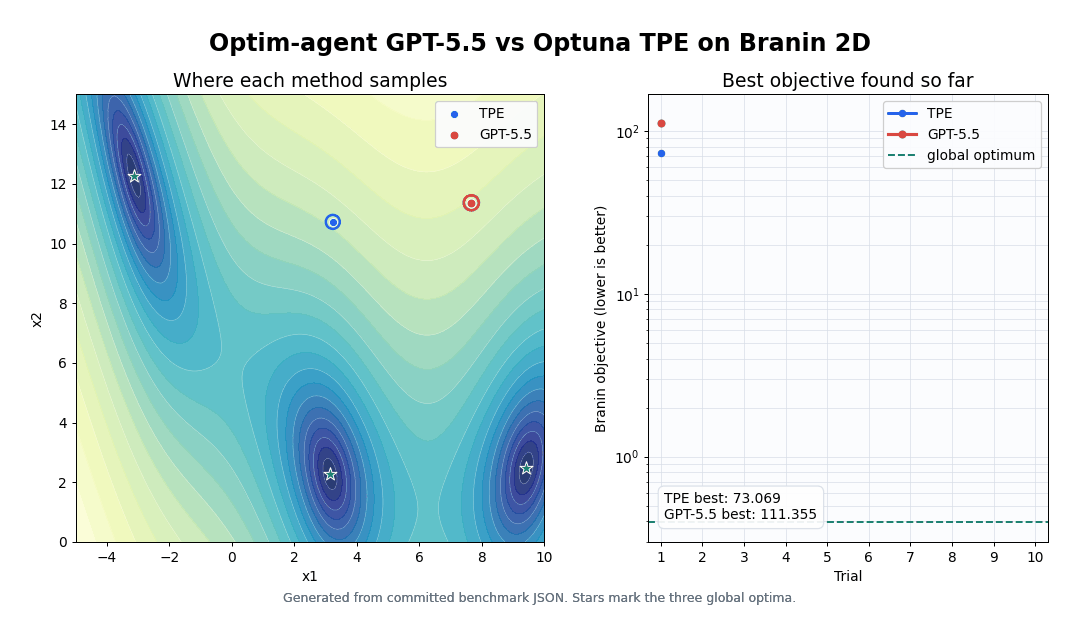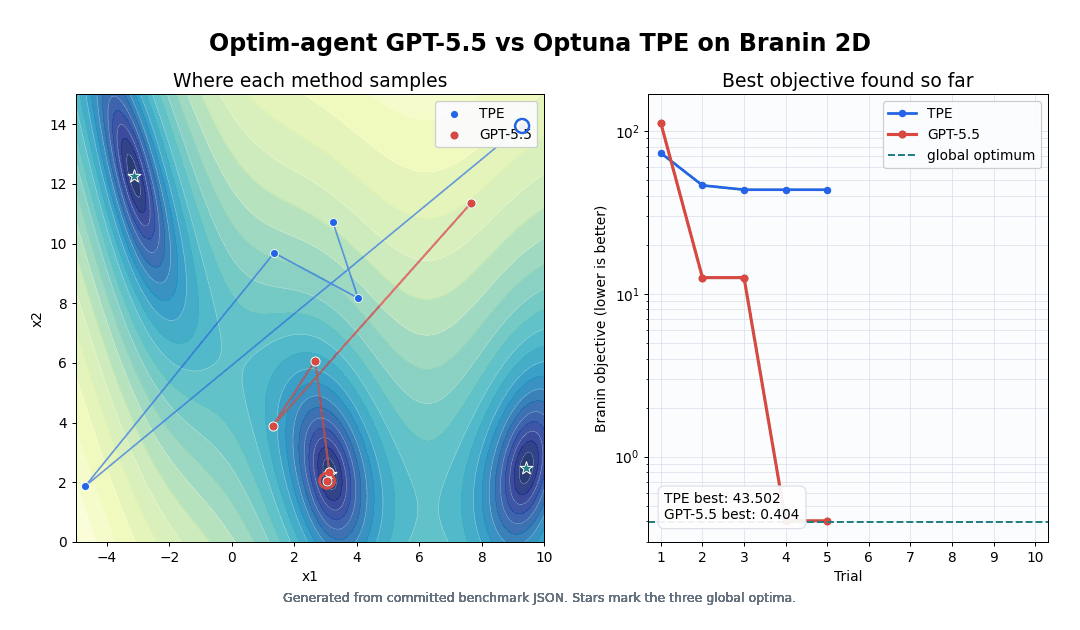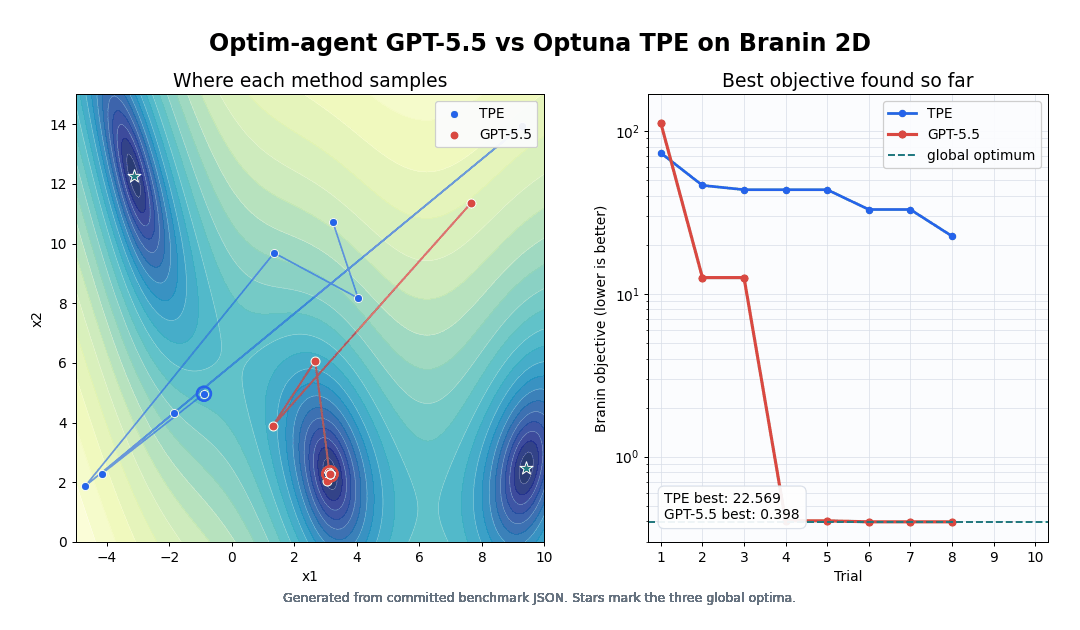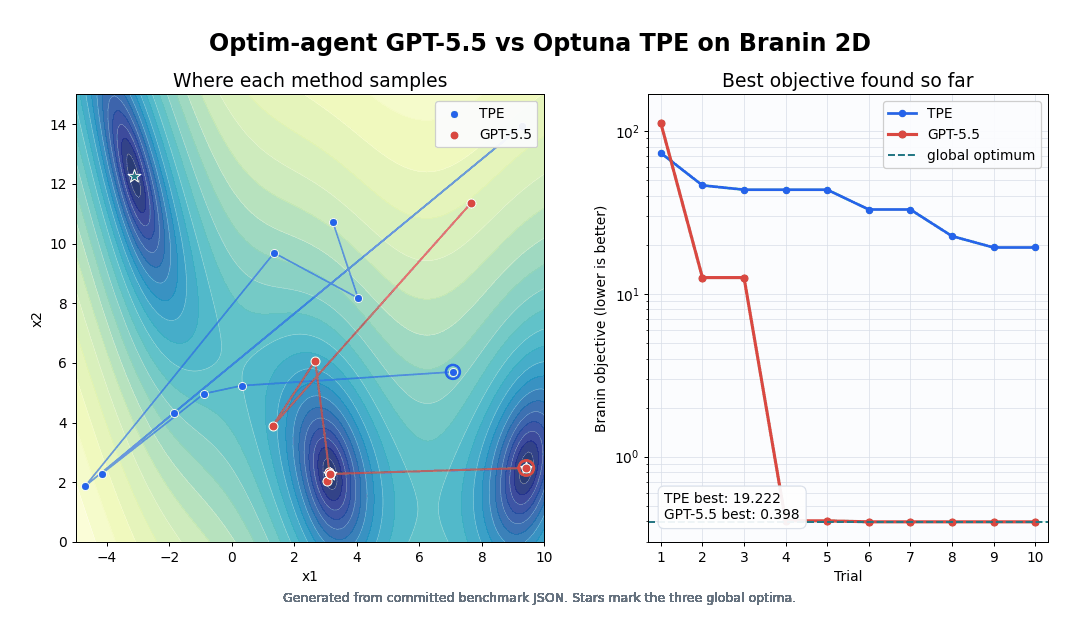
Este traço Branin seed-0 compara TPE e GPT-5.5 com o mesmo orçamento de 10 trials,
mostrando o objective incumbent após cada trial. É uma ilustração de trajetória;
os resultados agregados e comandos de reprodução aparecem abaixo.
### Otimizando funções matemáticas sem contexto: Branin-2D e Ackley-5D
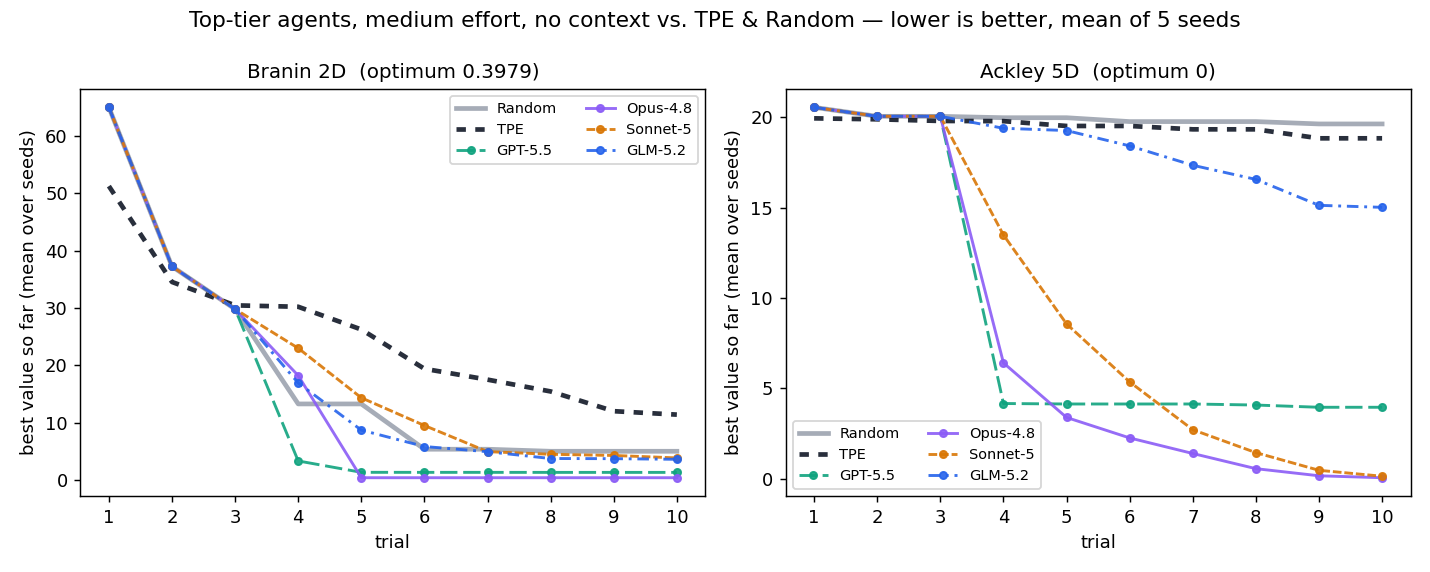
Agentes de hard functions **não recebem contexto de tarefa**: apenas nomes genéricos `x1...x5`,
limites numéricos e histórico de trials. As execuções usam 10 trials em cinco seeds;
Random e TPE são baselines sem alteração.
#### Agentes de primeira linha
| método | melhor Branin médio ↓ | melhor Ackley-5D médio ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| GPT-5.5 | 1.326 | 3.960 |
| **Opus-4.8** | **0.398** | **0.061** |
| Sonnet-5 | 3.850 | 0.143 |
| Kimi-K3 | 2.082 | 0.907 |
| Minimax-M3 | 0.970 | 0.574 |
| GLM-5.2 | 3.609 | 15.023 |
Os modelos fixados são `gpt-5.5`, `claude-opus-4-8`, `claude-sonnet-5`,
`kimi-k3`, `MiniMax-M3` e `glm-5.2`.
Opus-4.8 atinge o ótimo de Branin em média e tem a melhor média Ackley em cinco seeds.
#### Agentes OpenCode (gratuitos)
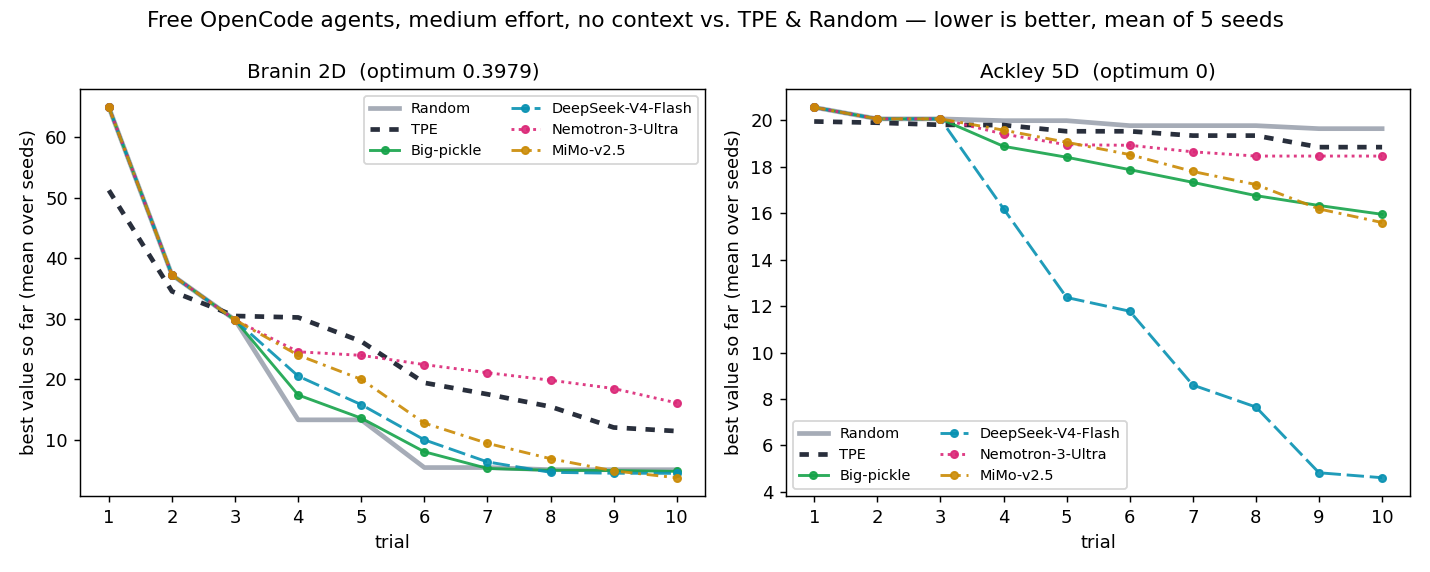
| método | melhor Branin médio ↓ | melhor Ackley-5D médio ↓ |
|---|---:|---:|
| Random | 5.008 | 19.639 |
| TPE | 11.395 | 18.843 |
| Big-pickle | 4.734 | 15.951 |
| **DeepSeek-V4-Flash** | 4.410 | **4.608** |
| Nemotron-3-Ultra | 16.051 | 18.459 |
| **MiMo-v2.5** | **3.682** | 15.597 |
Modelos hospedados no OpenCode não exigem API paga de modelo. O pool gratuito muda;
este refresh fixa `opencode/big-pickle`, `opencode/deepseek-v4-flash-free`,
`opencode/nemotron-3-ultra-free` e `opencode/mimo-v2.5-free`. DeepSeek V4 Flash tem a melhor
média Ackley entre modelos gratuitos, enquanto MiMo-v2.5 tem a melhor média Branin.
### Ajustando classificadores de imagem baseados em ResNet: MNIST e CIFAR-10
O benchmark de classificação compara **Random**, Optuna **TPE**, **GPT-5.5 w/ context**
e **GPT-5.5 w/o context** em cinco seeds (`0..4`) e 10 trials. A condição com contexto recebe
descrições em linguagem natural do study e dos parâmetros; a condição sem contexto recebe apenas limites e histórico.
A métrica principal enfatiza melhoria rápida:
```text
cumulative_best_so_far_error = sum(best_test_error_so_far_at_i for i in 1..10)
```
Menor é melhor.
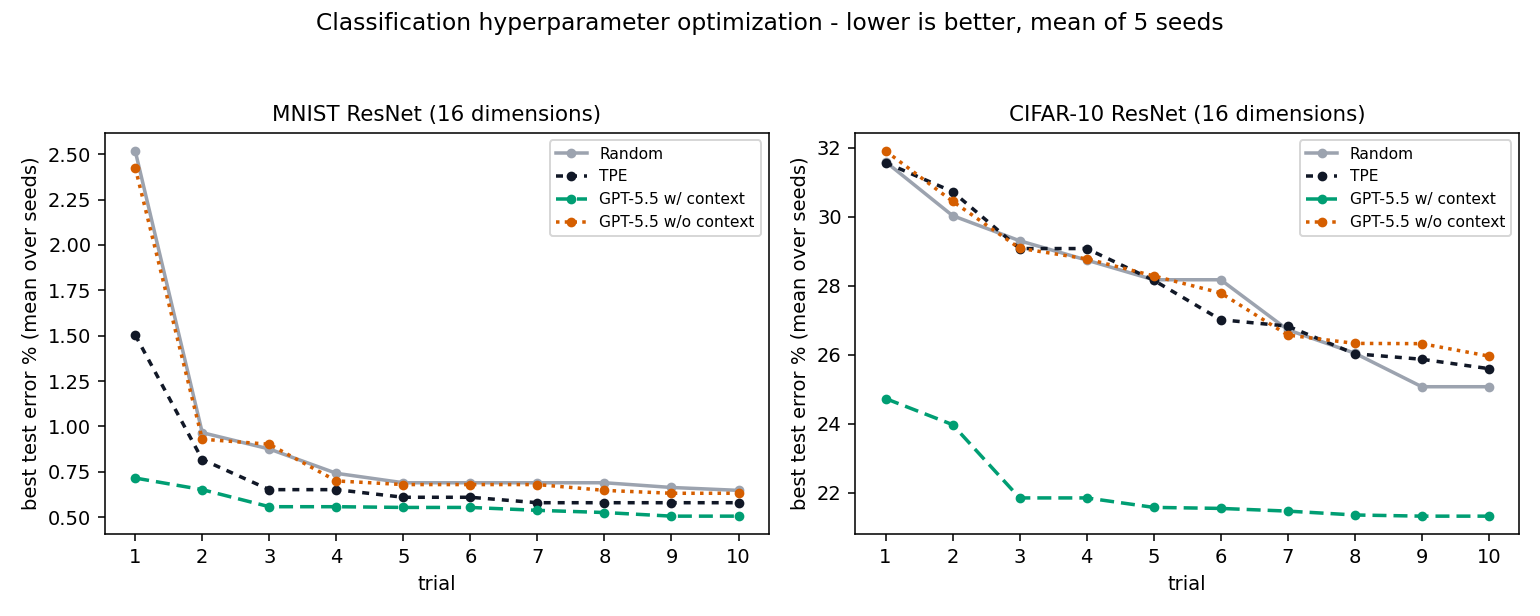
| método | erro cumulativo MNIST ↓ | erro final MNIST ↓ | erro cumulativo CIFAR-10 ↓ | erro final CIFAR-10 ↓ |
|---|---:|---:|---:|---:|
| Random | 9.174 | 0.648% | 278.920 | 25.072% |
| TPE | 7.166 | 0.580% | 279.936 | 25.596% |
| **GPT-5.5 w/ context** | **5.668** | **0.506%** | **220.994** | **21.322%** |
| GPT-5.5 w/o context | 8.910 | 0.632% | 281.466 | 25.960% |
GPT-5.5 w/ context reduz o erro cumulative best-so-far em **20.9%** contra TPE no MNIST
e em **20.8%** contra Random no CIFAR-10. Sem contexto, fica 24.3% pior que TPE no MNIST
e 0.9% pior que Random no CIFAR-10.
[`examples/mnist.py`](../../examples/mnist.py) e [`examples/cifar10.py`](../../examples/cifar10.py)
ajustam learning rate, batch size, weight decay, label smoothing, três stage widths,
três stage depths e quatro controles de dropout. MNIST adiciona translation e rotation;
CIFAR-10 usa crop padding e flip probability.
### Ajustando controladores Q-learning: Acrobot-v1 e LunarLander-v3
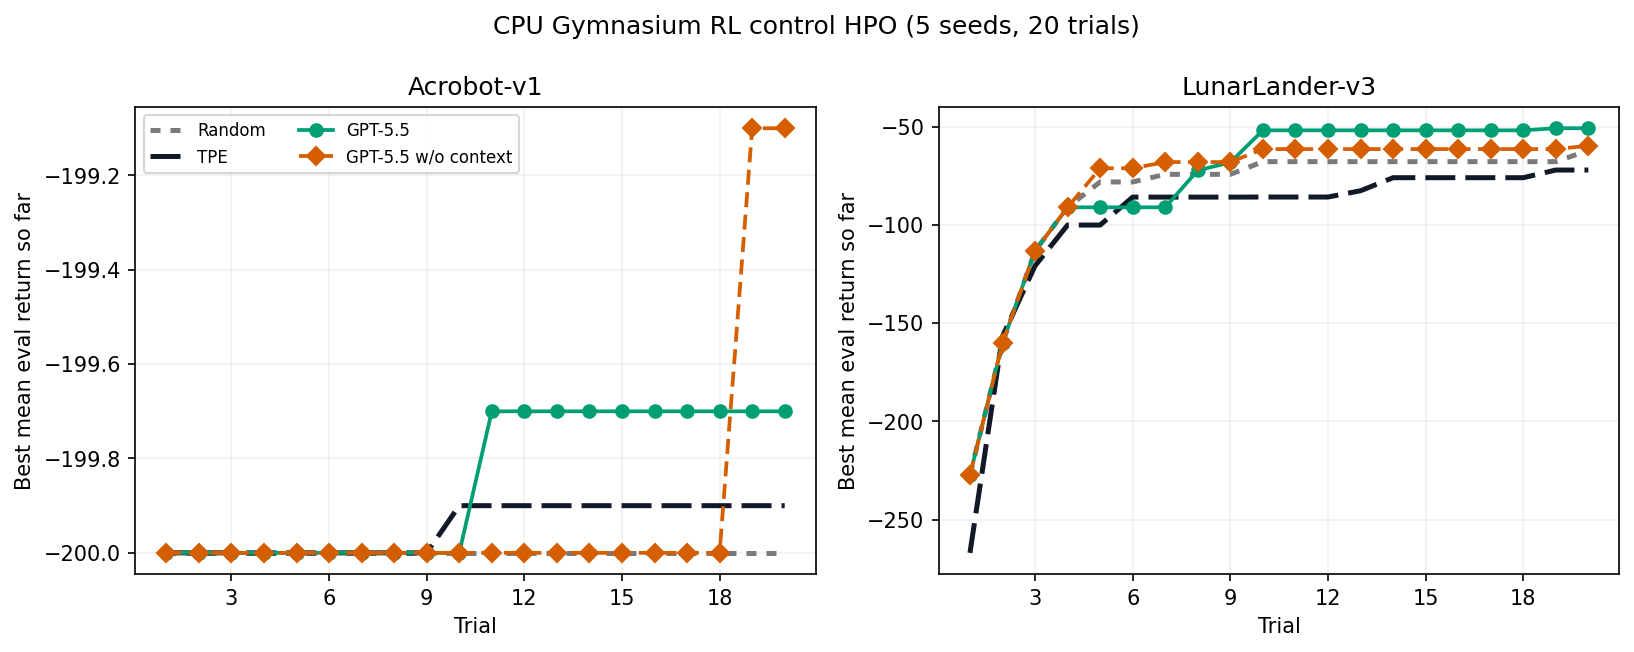
Este benchmark CPU-only do Gymnasium ajusta um controlador Q-learning discretizado para Acrobot-v1 e LunarLander-v3.
Cada método executa 20 trials em cinco seeds (`0..4`); o objetivo é o retorno médio de avaliação,
então maior é melhor. O runner paraleliza entre seeds e dentro de cada study HPO com `--workers`.
Os braços GPT-5.5 usam high modeling effort e os últimos 5 trials de histórico.
| método | retorno Acrobot-v1 ↑ | retorno LunarLander-v3 ↑ |
|---|---:|---:|
| Random | -200.000 | -62.139 |
| TPE | -199.900 | -72.088 |
| **GPT-5.5 w/ context** | **-199.700** | **-50.825** |
| GPT-5.5 w/o context | -199.100 | -59.751 |
Com 20 trials e cinco trials de histórico no prompt, GPT-5.5 w/ context tem o melhor retorno médio
nos dois ambientes: 0.2 acima de TPE em Acrobot-v1 e 11.3 acima de Random em LunarLander-v3.
Trate isso como um stress test CPU HPO, não como um ranking universal.
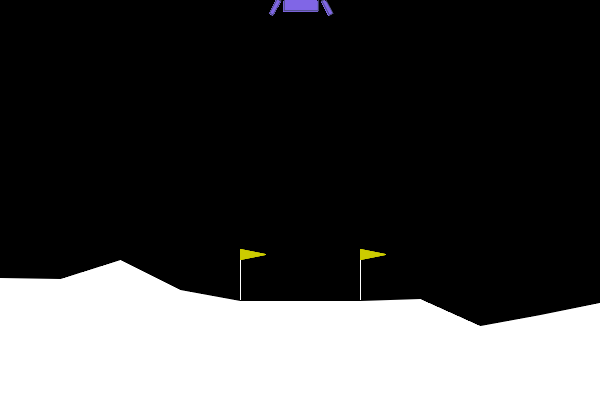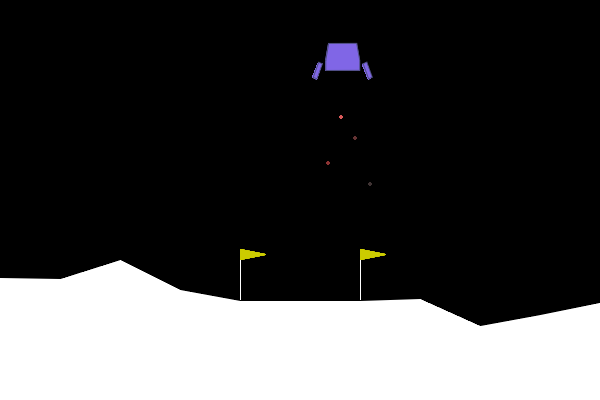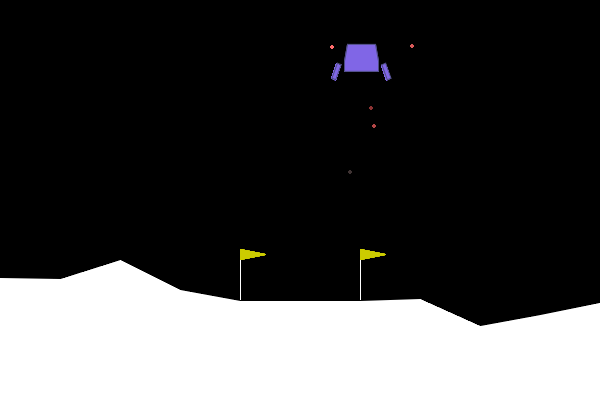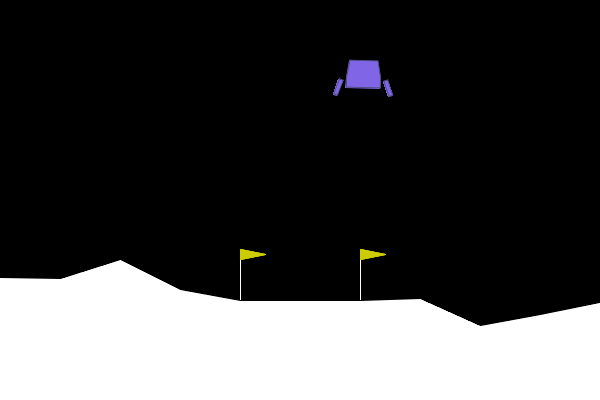
Na animação, optim-agent ajusta sete ganhos de um controlador determinístico LunarLander com um HPO seed.
Cada trial roda nos mesmos 20 rollout seeds, priorizando o número de pousos bem-sucedidos e depois o retorno médio.
O trial selecionado pousou em todos os 20 rollouts; o GIF mostra o rollout de maior retorno.
### Ajustando classificador gradient boosting: probabilidades de inadimplência
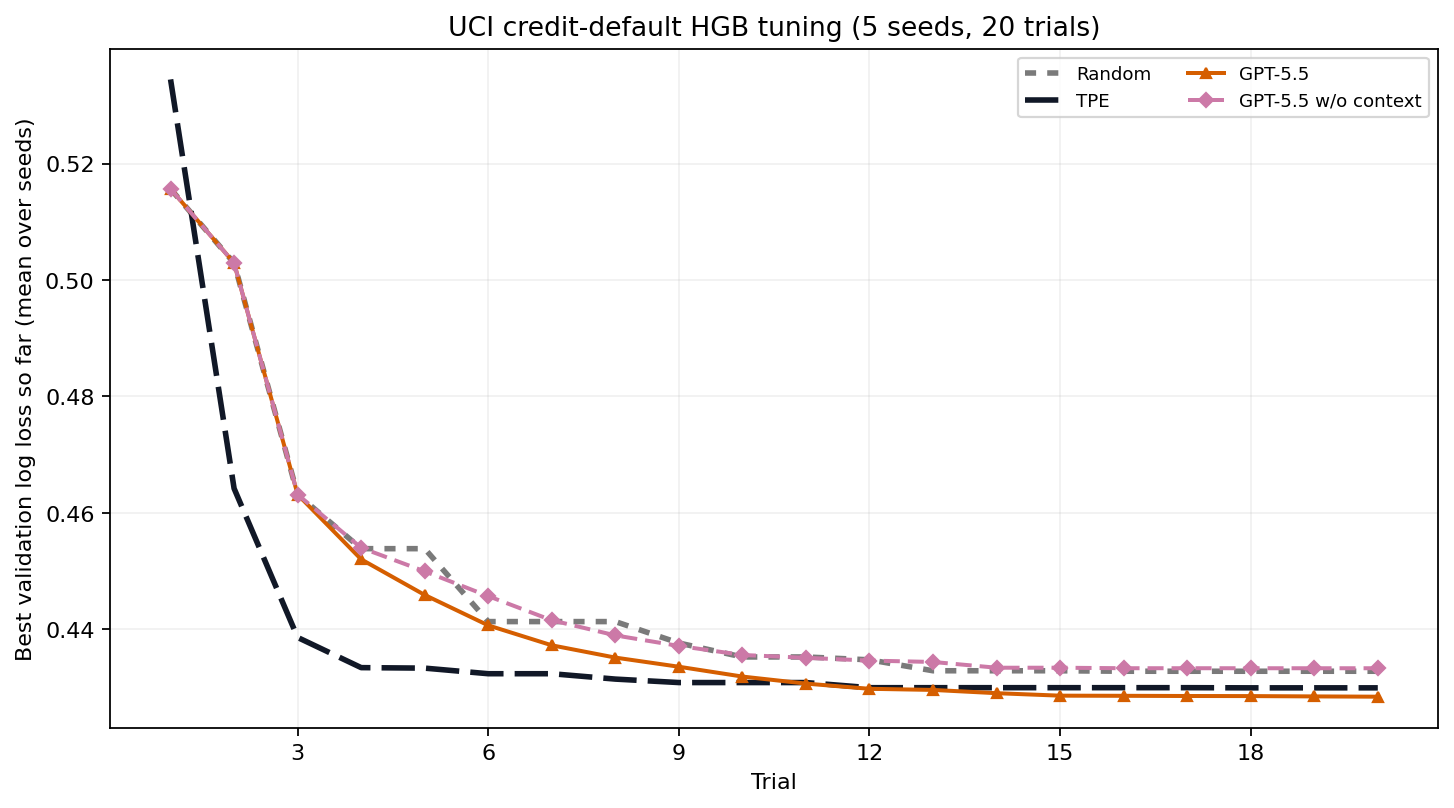
Este benchmark somente CPU ajusta oito parâmetros de treino de um `HistGradientBoostingClassifier` no UCI
[Default of Credit Card Clients](https://archive.ics.uci.edu/dataset/350/default+of+credit+card+clients):
30.000 linhas, 23 atributos e alvo de inadimplência no mês seguinte. O arquivo oficial é fixado por SHA-256,
licenciado CC BY 4.0 e dividido uma vez em 60% train, 20% validation e 20% untouched test data.
Todos os métodos usam a mesma divisão, 20 trials e seeds `0..4`. As duas condições GPT-5.5 usam
high modeling effort, 20 trials de prompt history, explicit reasoning e qualitative notes.
| método | log loss final de validação ↓ | log loss de teste retido ↓ |
|---|---:|---:|
| Random | 0.433 | 0.425 |
| TPE | 0.430 | 0.422 |
| GP-BO | 0.430 | 0.423 |
| **GPT-5.5 w/ context** | **0.428** | **0.422** |
| GPT-5.5 w/o context | 0.433 | 0.427 |
O contexto reduz o log loss final de validação em 1.13% e o log loss de teste em 1.23%
em relação ao controle no-context correspondente. GPT-5.5 também tem loss médio de validação e teste menor que Random, TPE e GP-BO.
Como a configuração retida foi escolhida usando validation e test loss, o resultado de teste é uma comparação benchmark,
não uma estimativa intocada de generalização.
Este é um benchmark metodológico, não um sistema de decisão de crédito em produção. Deploy exigiria revisão de fairness,
calibration, drift, governance e legal.
Reproduzir os artefatos de benchmark:
```bash
pip install -e ".[examples]"
# Classification
python scripts/verify_classification_cumulative_error.py run-no-context
python scripts/verify_classification_cumulative_error.py
# Hard functions
python examples/hard_functions.py distributed \
--agents Random TPE GPT-5.5 Opus-4.8 Sonnet-5 GLM-5.2 Big-pickle \
DeepSeek-V4-Flash Nemotron-3-Ultra MiMo-v2.5 \
--trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-kimi.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Kimi-K3 --trials 10 --seeds 0 1 2 3 4
cp ~/.claude/settings-minimax.json ~/.claude/settings.json
python examples/hard_functions.py distributed --agents Minimax-M3 --trials 10 --seeds 0 1 2 3 4
python examples/hard_functions.py plot
# Credit-card HGB
pip install -e ".[ml,examples]"
python examples/credit_card.py download
python examples/credit_card.py preflight
python examples/credit_card.py run
python examples/credit_card.py selfcheck
python examples/credit_card.py summary
python examples/credit_card.py plot
# RL control
pip install -e ".[rl,examples]"
python examples/rl_control.py preflight
python examples/rl_control.py run --seeds 0 1 2 3 4 --workers 10
python examples/rl_control.py selfcheck
python examples/rl_control.py summary
python examples/rl_control.py plot
python examples/rl_control.py gif
```
## Guia de uso
### Controles do prompt do sampler
`effort` é encaminhado ao flag reasoning-effort do backend CLI. O prompt do harness é controlado separadamente:
```python
oa.AgentSampler(
backend="codex",
effort="medium",
history=5,
explicit_reasoning=True,
qualitative_notes=True,
)
```
Defina `history=None` para mostrar todos os trials concluídos/pruned. Use
`explicit_reasoning=False` ou `qualitative_notes=False` para respostas mais curtas do agente.
### Log de trials
`study.optimize(..., verbose=...)` controla a saída por trial:
- `verbose=True` (padrão) renderiza uma tabela em um terminal interativo: uma linha por
trial com as colunas `trial`, `value`, `best`, `state`, mais uma coluna por parâmetro
do espaço de busca na ordem de primeira aparição. Linhas longas são truncadas com
reticências para caber na largura do terminal; valores ausentes (p. ex. trials
falhados) aparecem como `-`.
- Quando stdout não é um TTY (saída redirecionada, logs de CI), `verbose=True` / `"table"`
recorre automaticamente ao formato de uma linha, compatível com grep
(`[optim-agent] trial 3: value=0.91 state=complete best=0.91`).
- `verbose="line"` usa sempre o formato de uma linha, mesmo em um TTY.
- `verbose="table"` usa a tabela em um TTY e o formato de uma linha ao redirecionar.
- `verbose=False` silencia a saída por trial.
Com espaços define-by-run, um trial que introduz uma nova chave de parâmetro reimprime o
cabeçalho com o superconjunto de colunas.
### Agente de resumo
Passe `summarize=True` para `create_study` para que o agente narre o study concluído uma
vez, após o último trial:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.json",
summarize=True,
)
study.optimize(objective, n_trials=20)
print(study.summary) # também persistido no armazenamento JSON / SQLite
```
O resumo é estruturado em quatro seções — melhor configuração, insights do espaço de
busca, destaques da trajetória e próximos passos sugeridos. Ele é impresso no terminal e
persistido em `study.summary` (chave aditiva no armazenamento JSON e na tabela `meta` do
SQLite; studies antigos são carregados com `summary=None`).
Resolução do backend: um `summary_backend=` explícito tem prioridade; caso contrário, o
backend do sampler é reutilizado quando o sampler é um `AgentSampler`. Com qualquer outro
sampler, passe `summary_backend=` ou `create_study` lançará um `ValueError` indicando a
correção. `summary_model=` / `summary_effort=` sobrescrevem o model/effort do sampler
para o resumo. Respostas do agente que não possam ser parseadas nas quatro seções recorrem
à impressão do texto bruto — um resumo nunca faz o study falhar, e studies sem trials
concluídos o pulam com um aviso de uma linha. `backend="mock"` também funciona para o
summarizer, então demos e testes rodam sem um CLI de agente real.
### Pruning
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="codex"),
pruner=oa.AgentPruner(
backend="codex", level="medium", effort="medium",
), # level: loose | medium | tight
)
def objective(trial):
lr = trial.suggest_float("lr", 1e-5, 1e-1, log=True,
context="learning rate for training an image classifier")
for epoch in range(20):
loss = train_one_epoch(lr)
trial.report(loss, epoch)
if trial.should_prune():
raise oa.TrialPruned()
return loss
```
O pruner agent compara a curva de aprendizado atual com trials concluídos e responde prune/keep;
`loose` só poda runs claramente ruins, enquanto `tight` poda de forma mais agressiva.
Erros do agente nunca podam um trial.
### Concorrência e studies distribuídos
Defina `max_concurrency` (padrão `1`) para avaliar vários trials ao mesmo tempo e use um arquivo SQLite
`storage` (`.db` / `.sqlite`) como histórico compartilhado seguro para concorrência:
```python
study = oa.create_study(
sampler=oa.AgentSampler(backend="claude"),
storage="study.db", # SQLite -> safe for many workers; .json stays single-writer
max_concurrency=8, # up to 8 objectives run at once
)
study.optimize(objective, n_trials=100)
```
- **Dentro de um processo**, `max_concurrency` executa objectives em um thread pool. As consultas de agent sampling
são enfileiradas e serializadas para que cada proposta veja o histórico do processo; apenas chamadas objective rodam em paralelo.
- **Entre processos / máquinas**, aponte todos para o mesmo `storage` SQLite. O banco de dados é o canal de comunicação:
WAL permite adicionar resultados e ler histórico sem conflitos de escrita.
Limitações: threads compartilham o GIL, então objectives CPU-bound em Python puro funcionam melhor em processos separados com SQLite compartilhado.
Workers concorrentes não veem os pontos in-flight uns dos outros e podem explorar regiões próximas.
### Modo skill (o agente lê o código do projeto)
O pacote pip trata o objective como caixa-preta. O [optim-agent skill](../../SKILL.md) vai além:
em uma sessão de agente de programação, o agente primeiro lê o projeto para entender o papel de cada parâmetro,
depois conduz o mesmo study loop com `study.ask(params)` / `study.tell(trial, value)`, usando o JSON do study como histórico.
```text
$skill-installer install https://github.com/Optim-Agent/optim-agent
```
Plugin Claude Code:
```bash
claude plugin marketplace add Optim-Agent/optim-agent
claude plugin install optim-agent@optim-agent
```
Plugin Codex:
```bash
codex plugin marketplace add Optim-Agent/optim-agent
codex plugin add optim-agent@optim-agent
```
```python
trial = study.ask({"threshold": 0.72, "budget": 80})
study.tell(trial, evaluate_system(**trial.params))
```
### Testes offline
`AgentSampler(backend="mock")` é um substituto sem tokens que faz hill climbing ao redor do melhor ponto,
útil para testar integrações antes das chamadas de agente.
## Solução de problemas
- **`claude` retorna 401 dentro de uma sessão de agente** - sessões aninhadas herdam `ANTHROPIC_API_KEY`;
execute com `env -u ANTHROPIC_API_KEY` ou a partir de um shell limpo.
- **Uma chamada backend expira ou emite saída inválida** - o sampler avisa e volta para um ponto aleatório nesse trial; o study continua.
- **OpenCode com studies distribuídos** - OpenCode currently does not support distributed computing
in optim-agent; use o fluxo de processo único ou outro backend.
## Contribuição
Desenvolvimento local:
```bash
pip install -e ".[examples]"
pytest # runs tests/test_optim_agent.py
```
Abra uma issue para discutir mudanças maiores antes de enviar um PR. Adicionar um novo backend de agente normalmente significa
uma pequena função em [`optim_agent/agent.py`](../../optim_agent/agent.py).
O [`README.md`](../../README.md) em inglês continua sendo a fonte de autoridade para versões, valores de benchmark e backends.
## Agradecimentos
- [Optuna](https://github.com/optuna/optuna) por popularizar a interface Study/Trial, fornecer a baseline TPE usada
nos exemplos e benchmarks, e definir um alto padrão para ferramentas práticas de otimização.
- [OpenCode](https://github.com/sst/opencode) por fornecer acesso aos modelos gratuitos avaliados nos benchmarks de funções difíceis.
## Licença
[MIT](../../LICENSE)