Ihr Coding-Agent merkt sich alles. Schluss mit dem ständigen Wiederholen.
Built on iii engine
Persistentes Gedächtnis für Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, OpenCode und jeden MCP-Client.
Das Gist erweitert Karpathys LLM-Wiki-Muster um Confidence Scoring, Lifecycle, Knowledge Graphs und hybride Suche: agentmemory ist die Implementierung.
---
## Install
Voraussetzungen:
- Node.js 20 oder neuer mit npm und npx (`node -v`, `npm -v` und `npx -v`).
- Die automatische iii-engine-Installation unter macOS/Linux benötigt außerdem `curl`, eine POSIX-`sh` und `tar`. Minimale Images wie `node:20-slim` enthalten diese unter Umständen nicht.
- Natives Windows erfordert, dass die gepinnte iii-engine v0.22.1 `iii.exe` manuell installiert wird. WSL2 oder Docker Desktop sind die anderen unterstützten Wege.
Kanonischer Befehl für die Frischinstallation:
```bash
npx -y @agentmemory/agentmemory@latest
```
Der erste Lauf ist ein interaktives Setup: Wählen Sie die zu verdrahtenden Agenten (Claude Code, Cursor, Codex, Gemini CLI, OpenCode, ...), wählen Sie einen LLM-Provider oder bleiben Sie ohne Schlüssel, und es legt die Konfiguration an, startet den Memory-Server und seine gepinnte iii-Engine und bietet an, global zu installieren, sodass der nackte Befehl `agentmemory` anschließend überall funktioniert. `-y` akzeptiert npx' Paket-Prompt, und `@latest` vermeidet eine veraltete gecachte Version. Ein Provider macht LLM-Funktionen verfügbar, aber die LLM-geschriebene Beobachtungs-Kompression startet erst, wenn zusätzlich `AGENTMEMORY_AUTO_COMPRESS=true` gesetzt ist.
Der schlüssellose Modus deaktiviert Vector-Embeddings. `memory_recall` (der Pfad `mem::search`) verwendet BM25, während `memory_smart_search` zusätzlich strukturelle Graph-Treffer einbeziehen kann, wenn bereits Graph-Daten existieren. Für kostenloses semantisches Recall auf dem eigenen Gerät setzen Sie `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` und starten neu. Die erste Embedding-Anfrage lädt `Xenova/all-MiniLM-L6-v2` herunter; danach läuft die Inferenz lokal.
Die lokale Runtime verwendet vier Ports: `3111` für REST/MCP HTTP, `3112` für iii-Streams, `3113` für den Viewer und `49134` für den WebSocket des iii-Workers. Persistenter iii-State liegt unter `~/Library/Application Support/agentmemory` auf macOS, `$XDG_DATA_HOME/agentmemory` bzw. `~/.local/share/agentmemory` auf Linux und `%APPDATA%\agentmemory` auf Windows. Verwenden Sie `--data-dir ` oder `AGENTMEMORY_DATA_DIR`, um das zu überschreiben, und nutzen Sie bei jedem Neustart denselben Wert. Aus Gründen der Abwärtskompatibilität hat eine bereits vorhandene `./data/state_store.db` oder `./data/iii-config.yaml` für Instanz 0 Vorrang vor dem Plattform-Standard; ein expliziter Flag- oder Umgebungs-Override gewinnt trotzdem.
Beweisen Sie dann, dass Recall funktioniert, und geben Sie Ihrem Agenten seine Skills:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
Die Keyword-Suchen sollten im Standard-Modus ohne Schlüssel über BM25 treffen. Die `database performance optimization`-Abfrage der Demo ist bewusst semantisch und kann null Treffer liefern, bis ein Embedding-Provider konfiguriert ist.
Möchten Sie das Ganze lieber von einem Coding-Agenten erledigen lassen? Geben Sie ihm eine einzige Anweisung:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
Verdrahten Sie jederzeit weitere Agenten mit `agentmemory connect ` — 20 Adapter sind unter [Funktioniert mit jedem Agenten](#works-with-every-agent) aufgelistet. Vollständige Befehlsreferenz unter [Schnellstart](#quick-start).
Windows
Der schnelle Weg ist WSL2. Das native Windows-Engine-Setup erfordert, dass die gepinnte v0.22.1-ZIP herunterladen und `iii.exe` manuell extrahiert wird; die CLI extrahiert sie nicht automatisch. Docker Desktop wird ebenfalls unterstützt. Siehe die [Windows-Hinweise](#windows) für die Schritt-für-Schritt-Anleitung.
Globale Installation / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
Der obige npx-Befehl bleibt der kanonische Weg für die Frischinstallation und vermeidet Berechtigungsprobleme mit dem globalen Präfix.
npx liefert eine alte Version
npx cached pro Version. Erzwingen Sie die neueste mit `npx -y @agentmemory/agentmemory@latest`, oder leeren Sie den Cache einmalig mit `rm -rf ~/.npm/_npx` (macOS/Linux; unter Windows löschen Sie `%LOCALAPPDATA%\npm-cache\_npx`).
Sie betreiben bereits eine eigene iii-Engine
agentmemory pinnt iii-engine v0.22.1 und verbindet sich nicht mit einer anderen Version (der Worker kann das Protokoll einer anderen Engine nicht sprechen). Stoppen Sie die andere Engine und führen Sie dann `npx -y @agentmemory/agentmemory@latest` aus. Es installiert und startet das gepinnte v0.22.1 in `~/.agentmemory/bin` und lässt Ihre eigene `iii` unangetastet.
---
agentmemory funktioniert mit jedem Agenten, der Hooks, MCP oder REST API unterstützt. Alle Agenten teilen sich denselben Memory-Server.
Claude Code natives Plugin + 12 Hooks + MCP
Codex CLI natives Plugin + 6 Hooks + MCP
GitHub Copilot CLI MCP + Plugin-Hooks/Skills
Cursor natives Plugin + 7 Hooks + MCP
OpenCode Capture-Plugin + MCP
Devin 6 Hooks + Skills + MCP
OpenClaw natives Plugin + MCP
Hermes natives Plugin + MCP
pi natives Plugin + MCP
OpenHuman natives Memory-Trait-Backend
Gemini CLI MCP-Server
Antigravity MCP + Hooks
Claude Desktop MCP-Server
Warp connect + MCP + Skills
Zed MCP-Server
Cline MCP-Server
Continue MCP-Server
Droid MCP-Server
Kiro MCP-Server
Qwen Code MCP-Server
DeepSeek Harness MCP-Server
Roo Code MCP-Server
Kilo Code MCP-Server
Goose MCP-Server
Aider REST API
Funktioniert mit jedem Agenten, der MCP oder HTTP spricht. Ein Server, gemeinsame Erinnerungen für alle.
---
Sie erklären in jeder Session dieselbe Architektur. Sie entdecken dieselben Bugs erneut. Sie bringen dem Agenten dieselben Präferenzen wieder bei. Eingebautes Gedächtnis (CLAUDE.md, .cursorrules) ist bei 200 Zeilen am Ende und veraltet. agentmemory behebt das. Es erfasst stillschweigend, was Ihr Agent tut, komprimiert das Ganze in durchsuchbares Gedächtnis und injiziert beim Start der nächsten Session den passenden Kontext. Ein Befehl. Funktioniert über Agenten hinweg.
**Was sich ändert:** Session 1 richten Sie JWT-Authentifizierung ein. Session 2 fragen Sie nach Rate Limiting. Der Agent weiß bereits, dass Ihre Auth jose-Middleware in `src/middleware/auth.ts` verwendet, dass Ihre Tests Token-Validierung abdecken und dass Sie sich aus Gründen der Edge-Kompatibilität für jose statt jsonwebtoken entschieden haben, ohne erneutes Erklären und ohne Copy-Paste.
```bash
npx -y @agentmemory/agentmemory@latest
```
Standardmäßig speichert agentmemory den iii-engine-State außerhalb des Repositorys, aus dem Sie es starten: `~/Library/Application Support/agentmemory` auf macOS, `$XDG_DATA_HOME/agentmemory` bzw. `~/.local/share/agentmemory` auf Linux und `%APPDATA%\agentmemory` auf Windows. Eine bereits vorhandene Legacy-`./data/state_store.db` oder `./data/iii-config.yaml` wird für Instanz 0 vor diesem Plattform-Standard wiederverwendet. Um einen Ort explizit zu wählen, übergeben Sie `--data-dir ` oder setzen Sie `AGENTMEMORY_DATA_DIR`; beide expliziten Einstellungen haben Vorrang vor der Legacy-Erkennung:
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
Native Starts und Docker-Starts verwenden dasselbe aufgelöste Host-Verzeichnis; Docker bindet es per Bind-Mount an `/data`. `--instance 1` hängt `instance-1` an das aufgelöste Verzeichnis an und wählt das separate Standard-Port-Quartett `3211/3212/3213/49234`.
Neueste Release-Hinweise: [CHANGELOG.md](../CHANGELOG.md).
---
### Retrieval-Genauigkeit
**coding-agent-life-v1** (interner Korpus, Sandbox-reproduzierbar)
| Adapter | P@5 | R@5 | Top-5-Trefferquote | p50-Latenz |
|---|---|---|---|---|
| **agentmemory hybrid** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| grep-Baseline | 0.227 | 0.967 | 15 / 15 | 0 ms |
100 % Top-5-Trefferquote an der **mathematischen P@5-Obergrenze** für diesen Korpus (0.240, siehe Scorecard). Hybrid findet jede Gold-Session; grep verfehlt 1 von 2 Gold-Sessions bei der Multi-Session-Temporalanfrage. Der Gewinn ist **Recall + Temporal**, nicht aggregierte Präzision. Dieser Benchmark ist klein und Gold-arm; das größere LongMemEval-S unten differenziert besser. Vollständige Aufschlüsselung pro Typ + Korrekturhinweis: [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md).
**LongMemEval-S** (ICLR 2025, 500 Fragen)
| System | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| Nur-BM25-Fallback | 86.2% | 94.6% | 71.5% |
> Embedding-Modell: `all-MiniLM-L6-v2` (lokal, kostenlos, kein API-Schlüssel). Vollständige Berichte: [`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md), [`benchmark/QUALITY.md`](../benchmark/QUALITY.md), [`benchmark/SCALE.md`](../benchmark/SCALE.md). Konkurrenzvergleich: [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md), der agentmemory vs mem0, Letta, Khoj, supermemory, TencentDB Agent Memory, MemPalace, Zep/Graphiti, Cognee, Hippo abdeckt.
**Lokal reproduzieren:** [`eval/README.md`](../eval/README.md), ein Adapter-pluggable Harness für LongMemEval `_s` (öffentlich, 500 Fragen) + `coding-agent-life-v1` (interner 15-Session-Korpus). Adapter für Grep / Vector / agentmemory werden direkt verglichen, NDJSON-Ausgabe, veröffentlichte Scorecards landen in [`docs/benchmarks/`](../docs/benchmarks/).
**Funktioniert kombiniert mit [codegraph](https://github.com/colbymchenry/codegraph), [Understand Anything](https://github.com/Lum1104/Understand-Anything) und [Graphify](https://github.com/safishamsi/graphify).** Code-Graph-Indizierung, mehragentige Build-Pipelines und breitere Knowledge Graphs über Docs / PDFs / Bilder / Videos. agentmemory merkt sich die Arbeit; diese drei Projekte beleuchten den Rest der Kontextschicht. Rezepte + Frage-Routing-Tabelle: [`docs/recipes/pairings.md`](../docs/recipes/pairings.md).
---
agentmemory
mem0 (63K ⭐)
Letta / MemGPT (24K ⭐)
Khoj (36K ⭐)
supermemory (29K ⭐)
TencentDB Agent Memory (22K ⭐)
MemPalace (54K ⭐)
oracleagentmemory
Hippo
Eingebaut (CLAUDE.md)
Typ
Memory-Engine + MCP-Server
Memory-Layer-API
Komplette Agenten-Runtime
Persönliche KI
Memory-API + App
Team-Memory-Hub (LLM-Proxy)
Vector-Memory (OSS)
Memory-Engine (Oracle DB)
Memory-System
Statische Datei
Retrieval R@5
95.2%
68.5% (LoCoMo)
83.2% (LoCoMo)
N/V
Selbst berichtet
PersonaMem 76% (selbst berichtet)
~96.6% (selbst berichtet)
94.4% (selbst berichtet)
N/V
N/V (grep)
Auto-Erfassung
12 Hooks (null manueller Aufwand)
Manuelle add()-Aufrufe
Agent bearbeitet sich selbst
Manuell
API-seitige Extraktion
Proxy-Interception (Base-URL-Tausch)
Manuell
API-Extraktion
Manuell
Manuelle Bearbeitung
Suche
BM25 + Vector + Graph (RRF-Fusion)
Vector + Graph
Vector (Archival)
Semantisch
Vector + RAG
4 Asset-Typen (Chat / Skill / Wiki / CodeGraph)
Nur Vector
Vector + semantisch
Decay-gewichtet
Lädt alles in den Kontext
Multi-Agent
MCP + REST + Leases + Signals
API (keine Koordination)
Nur innerhalb der Letta-Runtime
Nein
Nein
Team-Rollen + geteilte Assets
Nein
Nur Scoped
Multi-Agent geteilt
Dateien pro Agent
Framework-Lock-in
Keiner (jeder MCP-Client)
Keiner
Hoch (Letta erforderlich)
Standalone
Keiner
Proxy sitzt vor jedem Modellaufruf
Keiner
Oracle Database
Keiner
Format pro Agent
Externe Abhängigkeiten
Keine (SQLite + iii-engine)
Qdrant / pgvector
Postgres + Vector-DB
Mehrere
Managed Cloud
Docker-Stack (Core + Hub + Proxy)
Vector-Store
Oracle AI Database
Keine
Keine
Memory-Lifecycle
4-stufige Konsolidierung + Decay + Auto-Forget
Passive Extraktion
Vom Agenten verwaltet
Manuell
Auto-Forget
Manuelles Review; Auto-Routing in Arbeit
Keiner
Nicht angegeben
Decay + Konsolidierung
Manuelles Pruning
Token-Effizienz
~1,900 Tokens/Session ($10/Jahr)
Je nach Integration unterschiedlich
Core Memory im Kontext
Variiert
Cloud-Preise
Nicht angegeben
Kein Token-Budget
LLM-gestützt (variiert)
Variiert
22K+ Tokens bei 240 Beobachtungen
Echtzeit-Viewer
Ja (Port 3113)
Cloud-Dashboard
Cloud-Dashboard
Web-UI
Cloud-Dashboard
Hub-Web-UI
Nein
Nein
Nein
Nein
Self-hosted
Ja (Standard)
Optional
Optional
Ja
Nein (nur Cloud)
Ja (Docker)
Ja
Ja (Oracle DB)
Ja
Ja
Benchmark-Hinweis: Nur agentmemorys R@5 ist unser eigenes gemessenes Ergebnis (LongMemEval-S, reproduzierbar aus benchmark/COMPARISON.md). Die Zahlen von mem0 und Letta sind deren veröffentlichte LoCoMo-Werte (ein anderer Datensatz); die Zahlen von MemPalace, supermemory, TencentDB (PersonaMem) und oracleagentmemory sind selbst berichtete Herstellerangaben, die wir nicht unabhängig reproduziert haben (der Lauf von oracleagentmemory verwendete GPT-5.5 gegen eine Oracle AI Database). Nebeneinander nur zur groben Einordnung gezeigt, kein direkter Vergleich auf identischen Daten. Star-Zahlen sind ungefähr und driften über die Zeit.
**Neuere Einsteiger**, die man kennen sollte, ausführlich verglichen in [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md):
| System | ⭐ | Ausrichtung |
|--------|---|-------|
| Zep / Graphiti | 30K | Temporaler Knowledge Graph; stärkste veröffentlichte Temporal-Query-Ergebnisse (LongMemEval 63.8%), aber der Graph wird asynchron aufgebaut, sodass frische Fakten hinterherhinken können |
| Cognee | 30K | Dokument-zu-Knowledge-Graph-Ingestion, nur Python, gebaut für strukturierte Entitäten-Extraktion statt Session-Erfassung |
Keines davon erfasst automatisch aus Coding-Agent-Hooks, liefert einen local-first Viewer mit oder läuft ohne Schlüssel — die Kombination, um die agentmemory herum gebaut ist.
---
Kompatibilität: Diese Version zielt auf `iii-sdk` 0.22.1 und pinnt iii-engine v0.22.1.
### In 30 Sekunden ausprobieren
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` befüllt 3 realistische Sessions (JWT-Auth, N+1-Query-Fix, Rate Limiting) und führt Suchen darauf aus. Installationen ohne Schlüssel deaktivieren Vectors, daher sollten die Keyword-Abfragen von `mem::search` über BM25 treffen, während `database performance optimization` null Treffer liefern kann. `smart-search` kann zusätzlich strukturelle Graph-Treffer liefern, wenn Graph-Daten existieren. Damit die semantische Abfrage den N+1-Fix über Vectors findet, setzen Sie `EMBEDDING_PROVIDER=local`, starten neu und lassen den ersten Modell-Download abschließen.
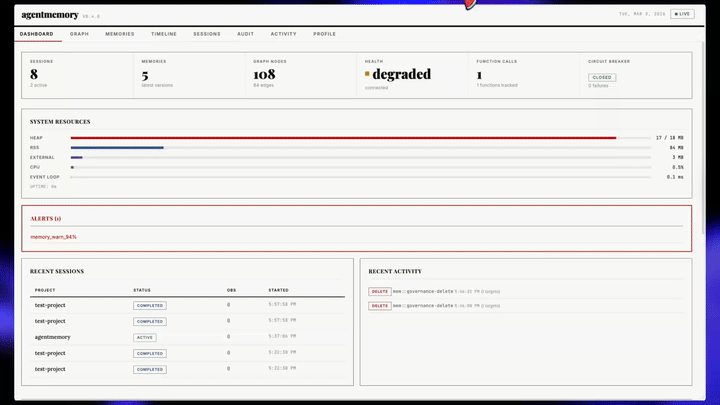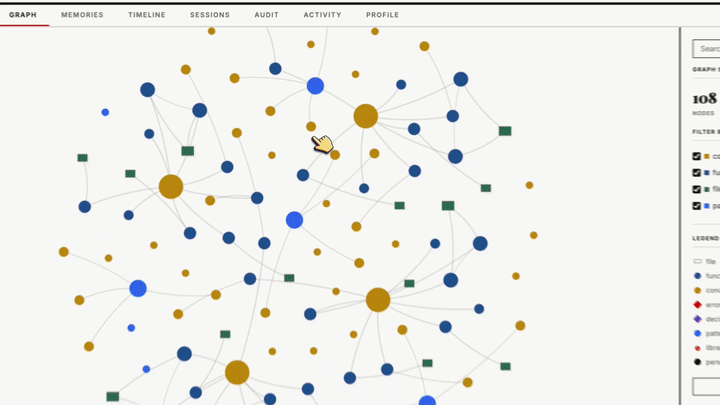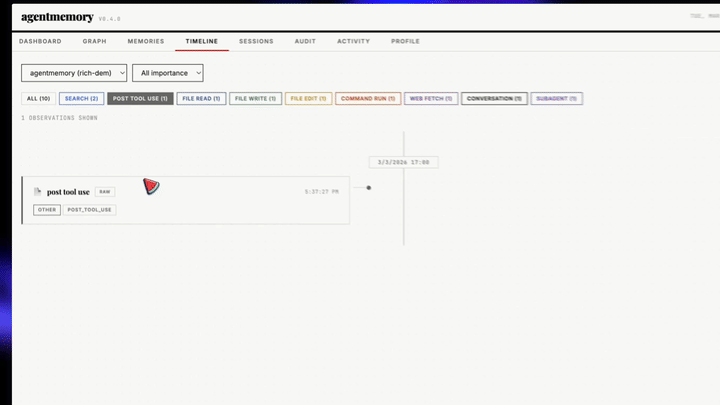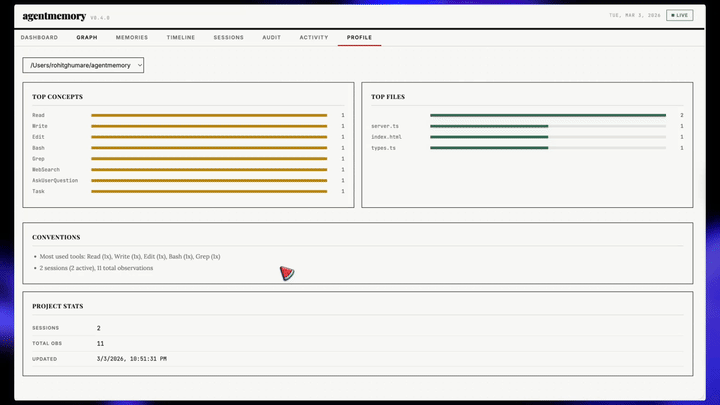
Öffnen Sie `http://localhost:3113`, um das Memory in Echtzeit aufgebaut zu sehen.
### Eine Frischinstallation und die Persistenz nach einem Neustart validieren
Validieren Sie bei laufendem Server REST, Health, den Viewer und den iii-gestützten Runtime-Status:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
Das Startup-Ready-Panel berücksichtigt alle vier Ports: REST/MCP HTTP auf 3111, iii-Streams auf 3112, den Viewer auf 3113 und den WebSocket des iii-Workers auf 49134. `status` bestätigt die agentmemory-Health und den aktiven Provider-/Embedding-Modus. Speichern Sie eine Probe und prüfen Sie, dass sie durchsuchbar ist:
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
Führen Sie dann `npx -y @agentmemory/agentmemory@latest stop` aus, starten Sie den kanonischen Befehl in Terminal 1 erneut, warten Sie auf `/agentmemory/livez` und wiederholen Sie die Suche. Die Probe muss weiterhin zurückgegeben werden. Wenn Sie ein eigenes `--data-dir` gewählt haben, übergeben Sie beim Neustart dasselbe Verzeichnis.
### Alltagsbefehle
Installation und Setup stehen oben unter [Install](#install) (der erste Lauf führt Sie hindurch). Im Alltag:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### Session-Replay
Jede Session, die agentmemory aufzeichnet, ist abspielbar. Öffnen Sie den Viewer, wählen Sie den Reiter **Replay** und scrubben Sie durch die Timeline: Prompts, Tool-Aufrufe, Tool-Ergebnisse und Antworten werden als diskrete Events mit Play/Pause, Geschwindigkeitssteuerung (0,5x bis 4x) und Tastenkürzeln (Leertaste zum Umschalten, Pfeile zum Schrittweisen) gerendert.
So übernehmen Sie ältere Claude-Code-JSONL-Transkripte:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
Importierte Sessions tauchen im Replay-Picker neben den nativen auf. Intern routet jeder Eintrag durch die iii-Funktionen `mem::replay::load`, `mem::replay::sessions` und `mem::replay::import-jsonl`, ohne Seitenkanal-Server. Jedes importierte Transkript wird für die Suche indiziert, mit dem Ursprungskanal `import` gestempelt, und daraus werden ein Session-Crystal und Lessons gewonnen.
> **Achtung, wenn Sie sich auf `import-jsonl` als primären Erfassungspfad verlassen:** Claude Codes `cleanupPeriodDays` (in `~/.claude/settings.json`, Standard **30**) löscht JSONL-Transkripte, die älter als dieses Fenster sind, automatisch aus `~/.claude/projects/`. Wenn Sie agentmemory frisch auf einer monatealten Claude-Code-Historie installieren, ist alles, was älter als 30 Tage ist, schon vor dem ersten Import weg. Führen Sie `import-jsonl` entweder per Cron aus, erhöhen Sie `cleanupPeriodDays` auf einen höheren Wert, oder verdrahten Sie die Auto-Capture-Hooks (den Standard-Plugin-Installationspfad), sodass jeder Turn in agentmemory landet, während die Session live ist, und das JSONL-Cleanup keine Rolle mehr spielt.
### Upgrade / Wartung
Verwenden Sie den Wartungsbefehl, wenn Sie Ihr lokales Runtime bewusst aktualisieren wollen:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
Achtung: Dieser Befehl verändert den aktuellen Workspace/Runtime. Er kann JavaScript-Abhängigkeiten aktualisieren und das gepinnte Docker-Image `iiidev/iii:0.22.1` ziehen. Er installiert niemals eine ungepinnte oder neuere iii-Engine.
Implementierungsdetails in `src/cli.ts` (siehe `runUpgrade` rund um den Bereich `src/cli.ts:544-595`).
### Claude Code (ein Block, einfügen)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code ohne Plugin-Installation (MCP-Standalone-Pfad)
Wenn Sie den MCP-Server von agentmemory direkt über `~/.claude.json` verdrahten anstatt über `/plugin install`, löst Claude Code `${CLAUDE_PLUGIN_ROOT}` niemals auf, und Sie müssen Hook-Skripte in `~/.claude/settings.json` auf absolute Pfade zeigen lassen. Diese Pfade enthalten typischerweise die agentmemory-Version (z. B. `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`), sodass das nächste Upgrade jeden Hook stillschweigend bricht.
Workaround:
```bash
agentmemory connect claude-code --with-hooks
```
Das mischt dieselben Hook-Befehle in `~/.claude/settings.json` ein, mit absoluten Pfaden, die in das mitgelieferte `plugin/`-Verzeichnis des aktuell installierten `@agentmemory/agentmemory`-Pakets auflösen. Führen Sie den Befehl nach einem agentmemory-Upgrade erneut aus, um die Pfade zu aktualisieren. Eigene Einträge in derselben Datei bleiben erhalten; nur frühere agentmemory-Einträge werden ersetzt. Den `/plugin install`-Pfad zu nutzen, bleibt der empfohlene Ansatz.
Für entfernte oder geschützte Deployments starten Sie Claude Code mit gesetztem `AGENTMEMORY_URL` und `AGENTMEMORY_SECRET`. Das Plugin reicht beide Werte an seinen mitgelieferten MCP-Server weiter; ist `AGENTMEMORY_URL` leer, verwendet das MCP-Shim `http://localhost:3111`.
### Codex CLI (Codex-Plugin-Plattform)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
Das Codex-Plugin wird aus demselben `plugin/`-Verzeichnis ausgeliefert wie das Claude-Code-Plugin. Es registriert:
- Eine mitgelieferte stdio-MCP-Bridge zum laufenden Daemon, ohne npm-Download oder Fallback-Store. Siehe den [lokalen Codex-Leitfaden](../docs/plugins/codex-local.md), um einen unveröffentlichten Build zu testen.
- 6 Lifecycle-Hooks: `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop`
- 9 aufrufbare Skills: `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, plus 8 Referenz-Skills, die der Agent bei Bedarf lädt (memory discipline, MCP-Tools, REST-API, Konfiguration, Agents, Hooks, Architektur und der Skill-Autorenleitfaden)
Codex' Hook-Engine injiziert `CLAUDE_PLUGIN_ROOT` in Hook-Subprozesse (siehe [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)), sodass dieselben Hook-Skripte ohne Duplikation auf beiden Hosts laufen. Die Events Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure gibt es nur in Claude Code und werden für Codex nicht registriert.
#### Codex-Hooks: Vertrauen und Kompatibilität
Der native Plugin-Hook-Dispatch ist mit Codex CLI 0.150.1 verifiziert. Vertrauen Sie den Plugin-Hooks, bevor Sie Erfassung erwarten. Das Verhalten von Codex Desktop hängt von seiner mitgelieferten Runtime ab; prüfen Sie `/hooks` und bestätigen Sie ein erfasstes Event, bevor Sie einen Workaround aktivieren.
Wenn Ihr Host globale Hooks benötigt, spiegeln Sie die Befehle in die globale `~/.codex/hooks.json`. Wenn MCP bereits verdrahtet ist, braucht der aktuelle `connect`-Adapter `--force`, um die Hook-Installation zu erreichen:
```bash
agentmemory connect codex --with-hooks --force
```
Das mischt globale Hooks und schreibt den agentmemory-MCP-Eintrag um, wobei unabhängige Einträge erhalten bleiben. Prüfen Sie alle benutzerdefinierten agentmemory-Endpunkt-Einstellungen, bevor Sie `--force` verwenden. Führen Sie es nach einem Upgrade erneut aus, um die Skript-Pfade zu aktualisieren. Aktivieren Sie entweder native Plugin-Hooks oder globale Kopien, um doppelte Erfassung zu vermeiden.
### GitHub Copilot CLI
Für den VS-Code-Agentenmodus nutzen Sie den [Copilot-MCP- und Auto-Capture-Leitfaden](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions). Der CLI-Connector konfiguriert VS Code nicht.
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` führt `mcpServers.agentmemory` in `~/.copilot/mcp-config.json` zusammen (oder `$COPILOT_HOME/mcp-config.json`, wenn `COPILOT_HOME` gesetzt ist) und bewahrt bestehende Server. Auf nativem Windows ist dies der einzige automatisierte `connect`-Adapter; konfigurieren Sie jeden anderen nativen Windows-Agenten manuell. `connect` unter WSL ist nur dann sinnvoll, wenn der Ziel-Agent auch in derselben WSL-Umgebung installiert ist. Copilot übernimmt den MCP-Server beim nächsten Start oder nach `/mcp`. Installieren Sie zusätzlich das Plugin, wenn Sie die volle Hook-/Skill-Erfahrung wollen.
OpenClaw (diesen Prompt einfügen)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
Vollständiger Leitfaden: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (diesen Prompt einfügen)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
Vollständiger Leitfaden: [`integrations/hermes/`](../integrations/hermes/)
### Andere Agenten
Starten Sie den Memory-Server: `npx -y @agentmemory/agentmemory@latest`
#### Native Skills via `npx skills add` (50+ Agenten)
agentmemory liefert 17 Skills im Claude-Code-artigen `/SKILL.md`-Format: 9 aufrufbare Action-Skills (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) und 8 Referenz-Skills, die der Agent bei Bedarf lädt (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`). Die Referenz-Skills tragen aus dem Quellcode generierte Datentabellen, sodass sie nie driften. Die [`skills`](https://npmjs.com/package/skills)-CLI von vercel-labs installiert sie automatisch in das native Skill-Verzeichnis des aufrufenden Agenten, über 50+ Agenten hinweg (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf und mehr):
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
Das ist **komplementär** zu `agentmemory connect `:
- `agentmemory connect ` schreibt die MCP-Server-Konfig, damit die Tools verfügbar sind.
- `npx skills add rohitg00/agentmemory` installiert die Skills, damit der Agent weiß, wann er sie aufrufen soll.
Für die wenigen Agenten, die die skills-CLI noch nicht abdeckt (Zed v1.3.x und darunter), legen Sie die 17 SKILL.md-Dateien selbst unter dem nativen Skill-Verzeichnis des Agenten ab; dasselbe Format funktioniert überall.
#### Standard-MCP-Block
Der agentmemory-Eintrag ist der **gleiche MCP-Server-Block** für jeden Host, der das `mcpServers`-Format verwendet (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw):
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**Fügen Sie diesen Eintrag in das bestehende `mcpServers`-Objekt** in der Konfigurationsdatei des Hosts ein; ersetzen Sie nicht die Datei. Wenn die Datei bereits andere Server enthält, fügen Sie `agentmemory` als zusätzlichen Schlüssel innerhalb von `mcpServers` daneben ein. Fehlt `mcpServers` ganz, fügen Sie den Block innerhalb von `{ "mcpServers": { ... } }` ein. Die `${VAR}`-Platzhalter übernehmen `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` aus der Shell beim Start des MCP-Servers; nicht gesetzte Variablen werden als leere Strings übergeben, und das Shim fällt auf `http://localhost:3111` zurück. Ein einziger verdrahteter Eintrag deckt sowohl lokale als auch entfernte (k8s / reverse-proxied) Deployments ab.
| Agent | Konfigurationsdatei | Hinweise |
|---|---|---|
| **Cursor (nur MCP)** | `~/.cursor/mcp.json` | In `mcpServers` einfügen, oder `agentmemory connect cursor`. Ein-Klick-Deeplink auch auf der Website. |
| **Cursor (volles Plugin)** | `.cursor-plugin/` | Cursor-Marketplace-Eintrag (Einreichung in Prüfung) oder Cursor Settings → Plugins → lokaler Checkout. Registriert 7 Auto-Capture-Hooks (sessionStart, beforeSubmitPrompt, preToolUse, postToolUse, postToolUseFailure, stop, sessionEnd) + 17 Skills + den MCP-Server, wobei `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` im Cursor-Plugin-Dashboard verwaltet werden. Funktioniert in der Cursor-IDE und der `cursor-agent`-CLI; Print-Mode-Prompts der CLI werden am Session-Ende aus dem Session-Transkript nachgefüllt. |
| **Claude Desktop** | `claude_desktop_config.json` (Application Support) | In `mcpServers` einfügen. Claude Desktop nach dem Editieren neu starten. |
| **Cline / Roo Code / Kilo Code** | Cline-MCP-Einstellungen (Settings UI → MCP Servers → Edit) | Gleicher `mcpServers`-Block. |
| **Devin CLI (MCP + Hooks)** | `~/.config/devin/config.json` | `agentmemory connect devin` fügt den MCP-Eintrag ein; `--with-hooks` ergänzt sechs native Auto-Capture-Hooks (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) mit Devins kleingeschriebenen Tool-Matchern. Prüfen mit `devin mcp list` und `/hooks` in devin. |
| **Devin CLI (volles Plugin)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` aus einem Checkout registriert alle 17 Skills als `/agentmemory:`-Slash-Befehle plus den MCP-Server. Devin-Plugin-Hooks können `SessionStart`/`SessionEnd` nicht auslösen, daher kombinieren Sie es mit `connect devin --with-hooks` für vollständige Session-Erfassung. |
| **Devin (Cloud)** | Settings → Connections → MCP servers | Einen benutzerdefinierten MCP (STDIO) hinzufügen: Command `npx`, Args `-y @agentmemory/mcp@latest`, Env `AGENTMEMORY_URL`, das auf ein netzwerkerreichbares agentmemory-Deployment zeigt, plus `AGENTMEMORY_SECRET` (Cloud-Sitzungen erreichen kein localhost — siehe [`deploy/`](../deploy/)). Speichern Sie das Secret in Devin Secrets und nutzen Sie dann „Test listing tools", um zu prüfen, dass alle 54 Tools erscheinen. |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (automatisches Mergen). |
| **GitHub Copilot CLI (nur MCP)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` merged `mcpServers.agentmemory`; Copilot übernimmt es beim nächsten Start oder per `/mcp`. |
| **GitHub Copilot CLI (volles Plugin)** | Copilot-Plugin-Installation | `copilot plugin install rohitg00/agentmemory:plugin` für das Plugin aus dem GitHub-Unterverzeichnis. |
| **OpenClaw** | OpenClaw-MCP-Konfig | Gleicher `mcpServers`-Block. Tiefer: `openclaw plugins install ./integrations/openclaw` beansprucht OpenClaws Memory-Slot (wechselt automatisch von `memory-core`); setzen Sie `plugins.entries.agentmemory.hooks.allowConversationAccess=true`, sonst wird die Turn-Erfassung stillschweigend blockiert. Siehe [`integrations/openclaw`](../integrations/openclaw/). |
| **Codex CLI (nur MCP)** | `.codex/config.toml` | TOML-Form: `codex mcp add agentmemory -- npx -y @agentmemory/mcp`, oder `[mcp_servers.agentmemory]` manuell hinzufügen. |
| **Codex CLI (volles Plugin)** | Codex-Plugin-Marketplace | `codex plugin marketplace add rohitg00/agentmemory`, dann `codex plugin add agentmemory@agentmemory`. Registriert MCP + 6 Lifecycle-Hooks + 17 Skills. Vertrauen Sie den Hooks und verifizieren Sie die Erfassung in Ihrem Host; siehe [Codex-Setup und -Validierung](../docs/plugins/codex-local.md). |
| **OpenCode (nur MCP)** | `opencode.json` | Anderes Format: `mcp`-Schlüssel auf oberster Ebene, Command als Array: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`. |
| **OpenCode (volles Plugin)** | `plugin/opencode/` | 22 Auto-Capture-Hooks für Session-Lifecycle, Messages, Tools, Fehler. Die Projekt-Zuordnung erfolgt pro Session, sodass ein OpenCode-Prozess, der mehrere Repositories umspannt, jede Session unter ihrem eigenen Projekt ablegt. Zwei Slash-Befehle (`/recall`, `/remember`). Kopieren Sie `plugin/opencode/` in Ihren OpenCode-Workspace und fügen Sie den Plugin-Eintrag zu `opencode.json` hinzu. Siehe [`plugin/opencode/README.md`](../plugin/opencode/README.md) für die vollständige Hook-Tabelle + Gap-Analyse. |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` installiert die mitgelieferte Extension in pis Auto-Discovery-Verzeichnis (Recall beim Agent-Start, Capture beim Agent-Ende, `memory_search` / `memory_save` / `memory_health` Tools, `/agentmemory-status`). `/reload` in einem laufenden pi übernimmt sie. [`integrations/pi`](../integrations/pi/) ist außerdem ein pi-Paket (`pi install ./integrations/pi` aus einem Checkout). |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` liefert den 6-Hook-Memory-Provider (Prefetch, Turn-Erfassung, Session-Ende, Vorkomprimierung, MEMORY.md-Spiegelung, System-Prompt-Block). Validieren Sie mit `hermes plugins doctor` und `hermes memory status`. Siehe [`integrations/hermes`](../integrations/hermes/). |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` schreibt den standardmäßigen `mcpServers`-Block. Die Hook-Payload ist feldkompatibel mit Claude Code, sodass die bestehenden 12 Hook-Skripte ohne Änderung funktionieren; verdrahten Sie sie über den Abschnitt `hooks` in derselben `settings.json`. |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` installiert MCP und Capture-Hooks im gemeinsam genutzten Customization-Verzeichnis. Siehe [Antigravity-Setup und -Grenzen](../docs/plugins/antigravity.md). |
| **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` verwendet dieselbe MCP- und Hook-Konfiguration wie aktuelle IDE-Versionen. Bestehende Installationen sollten mit `--force` aktualisieren; siehe die [Upgrade-Hinweise](../docs/plugins/antigravity.md). |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` schreibt die Konfig auf Benutzerebene. Workspace-Overrides liegen in `.kiro/settings/mcp.json` neben Ihrem Code. |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` schreibt den standardmäßigen `mcpServers`-Block. Warp entdeckt außerdem Skills aus `.claude/skills/` automatisch; sobald das Claude-Code-Plugin installiert ist, erscheinen die 8 agentmemory-Skills (`remember`, `recall`, `recap`, `handoff`, `forget`, `commit-context`, `commit-history`, `session-history`) nativ in Warps Slash-Command-Palette. |
| **Cline (CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` schreibt den standardmäßigen `mcpServers`-Block. Nutzer der VS-Code-Extension: Fügen Sie denselben Block über Cline Settings → MCP Servers → Edit JSON ein. |
| **Continue.dev** | `~/.continue/config.yaml` (bevorzugt) oder `config.json` (Legacy) | `agentmemory connect continue` erstellt `config.yaml` von Grund auf, wenn keine der beiden existiert, oder modifiziert eine bestehende `config.json`. **Wenn Sie bereits eine `config.yaml` haben**, gibt der Adapter den exakten Block aus, den Sie unter `mcpServers:` einfügen; er schreibt Ihre yaml nicht stillschweigend um, weil das sichere Bewahren von Kommentaren und Ankern einen YAML-Parser braucht, den das Paket nicht mitliefert. Continue verwendet die Array-Form (kein Objekt) für `mcpServers`. |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` schreibt unter `context_servers` (Zeds Schlüssel, NICHT `mcpServers`). Remote-MCP-Server können stattdessen via `{"url": "..."}` verdrahtet werden. |
| **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` schreibt den standardmäßigen `mcpServers`-Block. Projektbezogene Overrides liegen in `/.factory/mcp.json`. Übergeben Sie `--with-hooks` für native Auto-Erfassung. |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` hängt eine `@deepseek-ai/dsh-mcp-client`-Zeile an die Home-Level-Patch-Schicht an, die jedes Harness-Profil lädt; Tools registrieren sich als `mcp__agentmemory__*`. Übergeben Sie `--with-hooks`, um zusätzlich Auto-Erfassung zu verdrahten: Die mitgelieferten Claude-Code-Hook-Skripte laufen über Harness' First-Party-Bridge `@deepseek-ai/dsh-hooks-claude-code` (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop) via eines Manifests, das nach `$DSH_HOME/agentmemory.hooks.json` geschrieben wird. Standard ist `~/.dsh`, wenn `DSH_HOME` nicht gesetzt ist. |
| **Goose** | Goose-MCP-Einstellungen-UI | Gleicher `mcpServers`-Block; nutzen Sie `goose configure` → Add Extension → MCP. Direktes YAML-Editieren unter `~/.config/goose/config.yaml` wird unterstützt, aber das Schema verwendet `extensions:` + `cmd` (nicht `mcpServers:` + `command`). |
| **Aider** | n/v | Sprechen Sie direkt mit der REST API: `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`. |
| **Jeder Agent (32+)** | n/v | `npx skillkit install agentmemory` erkennt den Host automatisch und merged. |
**MCP-Clients in Sandboxen** (Flatpak / Snap / restriktive Container), die den `localhost` des Hosts nicht erreichen können: Setzen Sie zusätzlich `"AGENTMEMORY_FORCE_PROXY": "1"` im `env`-Block und lassen Sie `AGENTMEMORY_URL` auf eine Route zeigen, die die Sandbox tatsächlich erreichen kann (z. B. Ihre LAN-IP).
### Programmatischer Zugriff (Python / Rust / Node)
agentmemory registriert seine Kernoperationen als iii-Funktionen (`mem::remember`, `mem::observe`, `mem::context`, `mem::smart-search`, `mem::forget`). Jede Sprache mit einem iii-SDK kann sie direkt über `ws://localhost:49134` aufrufen, ohne separaten REST-Client pro Sprache.
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
Durchgearbeitetes Beispiel: [`examples/python/`](../examples/python/) (Quickstart + Beobachtungs-/Recall-Fluss). REST auf `:3111` bleibt verfügbar für Hosts ohne iii-Runtime.
### Aus den Quellen
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
Das startet agentmemory mit einer lokalen `iii-engine`, falls das gepinnte Binary bereits installiert ist, oder verwendet Docker Compose, wenn das ausgewählt ist. REST, Streams und der Viewer binden sich standardmäßig an `127.0.0.1`. Der automatische Binary-Pfad für macOS/Linux erfordert `curl`, eine POSIX-`sh` und `tar`.
`iii-engine` manuell installieren. **agentmemory pinnt `iii-engine` derzeit auf `v0.22.1`**, dieselbe Version wie seine `iii-sdk`-Abhängigkeit; der Worker spricht das Wire-Protokoll genau dieser Engine, und 0.20.0 hat die SDK-Oberfläche neu organisiert, daher werden beide in agentmemory-Releases gemeinsam angehoben. Mit `AGENTMEMORY_III_VERSION=` überschreiben, wenn Sie eine eigene Engine betreiben und wissen, dass sie passt.
- **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64:** `aarch64-apple-darwin` durch `x86_64-apple-darwin` ersetzen
- **Linux x64:** durch `x86_64-unknown-linux-gnu` ersetzen
- **Linux arm64:** durch `aarch64-unknown-linux-gnu` ersetzen
- **Windows:** `iii-x86_64-pc-windows-msvc.zip` von [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) herunterladen und `iii.exe` nach `%USERPROFILE%\.agentmemory\bin\iii.exe` extrahieren
Jedes Archiv hat eine passende `.sha256`-Datei auf der Release-Seite; wenn Sie die Plattform wechseln, verwenden Sie den Hash dieser Datei in der obigen Prüfung (unter Windows: `Get-FileHash`). Der automatische Installer in `npx @agentmemory/agentmemory` pinnt diese Hashes und lehnt ein Archiv ab, das nicht übereinstimmt.
Oder Docker verwenden (die mitgelieferte `docker-compose.yml` zieht `iiidev/iii:0.22.1`). Vollständige Doku: [iii.dev/docs](https://iii.dev/docs).
### Windows
agentmemory läuft auf Windows 10/11, aber das Node.js-Paket allein genügt nicht; Sie brauchen außerdem die gepinnte iii-engine-v0.22.1-Runtime als Hintergrundprozess. Die CLI extrahiert die Windows-ZIP nicht automatisch, daher müssen native Windows-Nutzer `iii.exe` manuell installieren, WSL2 verwenden oder Docker Desktop wählen.
Die automatisierte native Windows-MCP-Verdrahtung unterstützt nur `agentmemory connect copilot-cli`. Für Claude Code, Codex, Cursor und jeden anderen nativen Windows-Agenten kopieren Sie den manuellen MCP-Block aus [Andere Agenten](#other-agents) in die Windows-Konfig dieses Agenten. `connect` in WSL auszuführen ist nur dann sinnvoll, wenn der Ziel-Agent auch in derselben WSL-Umgebung installiert ist; es editiert nicht die Konfiguration eines Windows-Host-Agenten.
**Option A: vorgebautes Windows-Binary (empfohlen)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**Option B: Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**Option C: Nur Standalone-MCP (ohne Engine).** Wenn Sie nur die MCP-Tools für Ihren Agenten brauchen und weder REST API, Viewer noch Cron-Jobs, überspringen Sie die Engine ganz:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**Diagnose unter Windows:** Wenn `npx -y @agentmemory/agentmemory@latest` fehlschlägt, mit `--verbose` neu starten, um das tatsächliche Engine-stderr zu sehen. Häufige Fehlerbilder:
| Symptom | Lösung |
|---|---|
| `The engine process started but the REST API never responded.` | Prüfen Sie, dass alle vier abgeleiteten Ports frei sind, verifizieren Sie, dass die gepinnte `iii.exe` am Leben blieb, starten Sie dann mit `--verbose` neu und prüfen Sie das erfasste Engine-stderr |
| `Could not start iii-engine` | Weder `iii.exe` noch Docker ist installiert. Siehe Option A oder B oben |
| Port-Konflikt | `netstat -ano \| findstr :3111`, um zu sehen, was gebunden ist, dann beenden oder `--port ` verwenden |
| Docker-Fallback wird übersprungen, obwohl Docker installiert ist | Stellen Sie sicher, dass Docker Desktop tatsächlich läuft (Taskleisten-Icon) |
> Hinweis: Die iii-**Engine** ist ein vorgebautes Binary, kein Cargo-Crate, versuchen Sie also nicht, sie per `cargo install` zu installieren. (Die iii-**SDKs** sind auf crates.io, npm und PyPI veröffentlicht, aber agentmemory benötigt sie nicht.) Unterstützte Engine-Installationsmethoden, alle auf v0.22.1 gepinnt: das vorgebaute Binary oben, agentmemorys automatischer Installationspfad für macOS/Linux (erfordert `curl`, POSIX-`sh` und `tar`) und das Docker-Image `iiidev/iii:0.22.1`. Ein bloßes Upstream-`install.sh | sh` installiert die neueste Engine, die agentmemory nicht unterstützt. Verwenden Sie `npx -y @agentmemory/agentmemory@latest`; unter macOS/Linux holt es die gepinnte Engine nach `~/.agentmemory/bin`.
---
Deploy
Ein-Klick-Vorlagen für gemanagte Hosts. Jede liefert ein autonomes
Dockerfile aus, das `@agentmemory/agentmemory` aus npm bezieht und das
iii-engine-Binary aus dem offiziellen `iiidev/iii`-Image vom Docker Hub
kopiert; kein vorgebautes agentmemory-Image erforderlich. Persistenter
Speicher wird unter `/data` gemountet; der Entrypoint beim ersten Boot
überschreibt die per npm gelieferte iii-Konfig (die `127.0.0.1` bindet)
mit einer deploy-tauglichen Variante, die `0.0.0.0` bindet und absolute
`/data`-Pfade verwendet, generiert das HMAC-Secret und senkt dann die
Privilegien von `root` auf `node` via `gosu`, bevor er die agentmemory-CLI exec't.
Der Ein-Klick-Deploy-Button von Render erfordert eine `render.yaml` im Repository-Root, das wir bewusst sauber halten. Verwenden Sie den Render-Blueprint-Fluss, dokumentiert in [`deploy/render/`](.././deploy/render/README.md), um manuell auf das im Repo liegende Blueprint zu zeigen.
Vollständige Setup-Details (HMAC-Capture, Viewer-SSH-Tunnel, Rotation, Backup,
Kostenuntergrenzen) finden Sie in [`deploy/`](.././deploy/README.md):
- [`deploy/fly`](.././deploy/fly/README.md): Einzelmaschine mit
`auto_stop_machines = "stop"`; am günstigsten im Leerlauf.
- [`deploy/railway`](.././deploy/railway/README.md): Hobby-Plan mit Pauschalpreis,
Volume im Dashboard.
- [`deploy/render`](.././deploy/render/README.md): Blueprint-Fluss,
automatische Disk-Snapshots auf bezahlten Plänen.
- [`deploy/coolify`](.././deploy/coolify/README.md): self-hosted auf Ihrem
eigenen VPS via [Coolify](https://coolify.io/self-hosted); derselbe
Docker-Compose-Stack, Sie besitzen Host und Daten.
Nur Port `3111` wird veröffentlicht. Der Viewer auf `3113` bleibt im
Container an Loopback gebunden; jedes Template-README dokumentiert
das SSH-Tunnel-Muster, um ihn zu erreichen.
---
Jeder Coding-Agent vergisst alles, wenn die Session endet, und jede neue Session beginnt damit, dass Sie Ihren Stack erneut erklären. agentmemory läuft im Hintergrund und schafft diesen Schritt ab.
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### vs. eingebautes Agent-Memory
Jeder KI-Coding-Agent kommt mit eingebautem Memory: Claude Code hat `MEMORY.md`, Cursor hat Notepads, Cline hat Memory Bank. Das funktioniert wie Klebezettel. agentmemory ist die durchsuchbare Datenbank hinter den Klebezetteln.
| | Eingebaut (CLAUDE.md) | agentmemory |
|---|---|---|
| Skalierung | 200-Zeilen-Limit | Unbegrenzt |
| Suche | Lädt alles in den Kontext | BM25 + Vector + Graph (nur Top-K) |
| Token-Kosten | 22K+ bei 240 Beobachtungen | ~1,900 Tokens (92 % weniger) |
| Agentenübergreifend | Dateien pro Agent | MCP + REST (jeder Agent) |
| Koordination | Keine | Leases, Signale, Actions, Routinen |
| Observability | Dateien manuell lesen | Echtzeit-Viewer auf :3113 |
---
### Memory-Pipeline
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### 4-stufige Memory-Konsolidierung
Modelliert nach der Art, wie menschliche Gehirne Erinnerungen verarbeiten, einschließlich der Schlafkonsolidierung.
| Stufe | Was | Analogie |
|------|------|---------|
| **Working** | Rohbeobachtungen aus Tool-Nutzung | Kurzzeitgedächtnis |
| **Episodic** | Komprimierte Session-Zusammenfassungen | „Was passiert ist" |
| **Semantic** | Extrahierte Fakten und Muster | „Was ich weiß" |
| **Procedural** | Workflows und Entscheidungsmuster | „Wie es geht" |
Erinnerungen klingen mit der Zeit ab (Ebbinghaus-Kurve). Häufig abgerufene Erinnerungen werden verstärkt. Veraltete Erinnerungen werden automatisch evakuiert. Widersprüche werden erkannt und aufgelöst.
### Was erfasst wird
| Hook | Erfasst |
|------|----------|
| `SessionStart` | Projektpfad, Session-ID |
| `UserPromptSubmit` | Benutzer-Prompts (Privacy-gefiltert) |
| `PreToolUse` | Datei-Zugriffsmuster + angereicherter Kontext |
| `PostToolUse` | Tool-Name, Eingabe, Ausgabe |
| `PostToolUseFailure` | Fehlerkontext |
| `PreCompact` | Re-injiziert Memory vor der Kompaktierung |
| `SubagentStart/Stop` | Sub-Agent-Lifecycle |
| `Stop` | Zusammenfassung am Session-Ende |
| `SessionEnd` | Session-Abschluss-Marker |
### Kernfähigkeiten
| Fähigkeit | Beschreibung |
|---|---|
| **Automatische Erfassung** | Jede Tool-Nutzung via Hooks aufgezeichnet, kein manueller Aufwand |
| **Semantische Suche** | BM25 + Vector + Knowledge Graph mit RRF-Fusion |
| **Memory-Evolution** | Versionierung, Supersession, Beziehungsgraphen |
| **Recall-Hygiene** | Überholte Memory-Versionen verlassen die Suchindizes; die Versionskette im KV behält die volle Historie |
| **Near-Duplicate-Hinweise** | Saves melden einen beratenden `similarTo`-Treffer, wenn neuer Inhalt einem bestehenden Memory stark ähnelt |
| **Per-Agent-Scoping** | `agentId` zieht sich durch Save und Recall über REST, MCP und den Suchindex, im Shared- oder Isolated-Modus |
| **Provenienz zur Schreibzeit** | Jede Beobachtung und jedes Memory trägt einen unveränderlichen Ursprungskanal (user, agent, tool, import oder shared), gestempelt bei Capture, Save und Import |
| **Auto-Vergessen** | TTL-Ablauf, Widerspruchserkennung, Wichtigkeits-Eviction |
| **Privacy first** | API-Keys, Secrets, ``-Tags vor Speicherung entfernt |
| **Selbstheilung** | Circuit Breaker, Provider-Fallback-Kette, Health-Monitoring |
| **Claude-Bridge** | Bidirektionale Synchronisierung mit MEMORY.md |
| **Knowledge Graph** | Entitäten-Extraktion + BFS-Traversal |
| **Team-Memory** | Namensraum-getrennt geteilt + privat über Teammitglieder hinweg |
| **Zitations-Provenienz** | Jedes Memory bis zu Ursprungsbeobachtungen zurückverfolgen |
| **Git-Snapshots** | Memory-Stand versionieren, zurückrollen und diffen |
---
Triple-Stream-Retrieval, das drei Signale kombiniert:
| Stream | Was es tut | Wann |
|---|---|---|
| **BM25** | Gestemmter Keyword-Abgleich mit Synonymerweiterung | Immer aktiv |
| **Vector** | Cosinus-Ähnlichkeit über dichte Embeddings | Embedding-Provider konfiguriert |
| **Graph** | Knowledge-Graph-Traversal via Entitäten-Abgleich | Entitäten in der Anfrage erkannt |
Verschmolzen mit Reciprocal Rank Fusion (RRF, k=60) und session-diversifiziert (max. 3 Ergebnisse pro Session).
Wenn ein Vector-Index befüllt ist, verwendet `mem::search` (hinter `memory_recall`) den hybriden BM25-+-Vector-Ranker. Ohne Embeddings verwendet es BM25. `smart-search` kann zusätzlich strukturelle Graph-Treffer einbeziehen, wenn Graph-Daten existieren, auch im schlüssellosen Modus. Lesson-Recall läuft auf einem dedizierten In-Memory-BM25-Index, statt bei jeder Anfrage den ganzen Korpus zu scannen. Überholte Memory-Versionen sind von jedem Recall-Pfad ausgeschlossen; die Versionskette bewahrt ihre Historie.
Vectors überleben einen Absturz oder Force-Kill. Der Vector-Index wird in Buckets gespeichert, höchstens alle `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS` (10 Minuten). Jeder dazwischen hinzugefügte oder entfernte Vector wird außerdem sofort in ein kleines Pending-Log im State-Store geschrieben, und der nächste Start spielt es ab, ohne den Embedding-Provider aufzurufen. Jedes erfolgreiche Speichern leert das Log. Dokumente, die nach dem Replay noch keinen Vector haben, werden im Hintergrund in Batches von `AGENTMEMORY_VECTOR_BACKFILL_MAX` (500) neu eingebettet, bis keine mehr übrig sind, und ein gestopptes Backfill wird beim nächsten Start fortgesetzt. `/agentmemory/status` und der Viewer zeigen die Größe des Pending-Logs und den Backfill-Status. Schlüssellose Installationen schreiben nichts.
BM25 tokenisiert Griechisch, Kyrillisch, Hebräisch, Arabisch und akzentuiertes Latein standardmäßig. Für Erinnerungen in Chinesisch / Japanisch / Koreanisch installieren Sie die optionalen Segmentierer (`npm install @node-rs/jieba tiny-segmenter`), um CJK-Folgen in Worttokens aufzuteilen; ohne sie fällt agentmemory weich auf eine Tokenisierung als gesamte Folge zurück und gibt einmalig einen Hinweis auf stderr aus.
### Embedding-Provider
Schlüssellose Installationen deaktivieren Vector-Embeddings: `mem::search` verwendet BM25, während `smart-search` zusätzlich bestehende strukturelle Graph-Daten verwenden kann. Um kostenlose semantische Embeddings auf dem eigenen Gerät zu aktivieren, fügen Sie dies zu `~/.agentmemory/.env` hinzu und starten Sie agentmemory neu:
```env
EMBEDDING_PROVIDER=local
```
Die normale npm-Installation enthält die optionale `@huggingface/transformers`-Runtime. Die erste Embedding-Anfrage lädt `Xenova/all-MiniLM-L6-v2` herunter, braucht also Netzwerkzugang und kann länger dauern; nachfolgende Inferenz läuft on-device. Remote-Provider werden anhand ihrer Schlüssel automatisch erkannt, sofern `EMBEDDING_PROVIDER` sie nicht überschreibt.
| Provider | Modell | Kosten | Hinweise |
|---|---|---|---|
| **Lokal (empfohlenes Opt-in)** | `all-MiniLM-L6-v2` | Kostenlos | On-device nach dem ersten Modell-Download, +8pp Recall gegenüber Nur-BM25 |
| Gemini | `gemini-embedding-001` | Free Tier | 100+ Sprachen, 768/1536/3072 Dims (MRL), 2048-Token-Eingabe. Ersetzt `text-embedding-004` ([deprecated, Abschaltung 14. Jan. 2026](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | $0.02/1M | Höchste Qualität |
| Voyage AI | `voyage-code-3` | Kostenpflichtig | Auf Code optimiert |
| Cohere | `embed-english-v3.0` | Testzugang | Allzweck |
| OpenRouter | Beliebiges Modell | Variabel | Multi-Modell-Proxy |
---
54 Tools, 6 Resources, 3 Prompts und 17 Skills.
> **MCP-Shim vs. voller Server:** Das veröffentlichte `@agentmemory/mcp`-Paket ist ein dünnes Shim. Es legt die volle 54-Tool-Oberfläche **nur dann** offen, wenn es per `AGENTMEMORY_URL` einen laufenden agentmemory-Server erreichen kann (Proxy-Modus). Ohne erreichbaren Server fällt das Shim auf einen lokalen 7-Tool-Satz zurück (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`). Die Umgebungsvariable `AGENTMEMORY_TOOLS=core|all` ist ein *serverseitiger* Schalter; sie im `env`-Block des Shims zu setzen hat keinen Effekt. Wenn Sie in Cursor / OpenCode / Gemini CLI nur 7 Tools sehen, starten Sie `npx -y @agentmemory/agentmemory@latest` (oder den Docker-Stack) und setzen Sie `AGENTMEMORY_URL=http://localhost:3111`.
### 54 Tools
Drei Tool-Oberflächen, von der kleinsten zur größten: `AGENTMEMORY_TOOLS=core` reduziert die Sichtbarkeit auf 8 essenzielle Tools (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`); der Basis-Satz unten sind die 14 grundlegenden Tools der Registry; der Standard (`AGENTMEMORY_TOOLS=all`) legt alle 54 offen.
Basis-Tools (14)
| Tool | Beschreibung |
|------|-------------|
| `memory_recall` | Vergangene Beobachtungen durchsuchen |
| `memory_compress_file` | Markdown-Dateien unter Erhalt der Struktur komprimieren |
| `memory_save` | Erkenntnis, Entscheidung oder Muster speichern |
| `memory_file_history` | Vergangene Beobachtungen zu bestimmten Dateien |
| `memory_patterns` | Wiederkehrende Muster erkennen |
| `memory_sessions` | Letzte Sessions auflisten |
| `memory_smart_search` | Hybride semantische + Keyword-Suche |
| `memory_vision_search` | Bild-Beobachtungen durchsuchen |
| `memory_timeline` | Chronologische Beobachtungen |
| `memory_profile` | Projektprofil (Konzepte, Dateien, Muster) |
| `memory_export` | Alle Memory-Daten exportieren |
| `memory_relations` | Beziehungsgraph abfragen |
| `memory_commit_lookup` | Sessions hinter einem Git-Commit |
| `memory_commits` | Für eine Session aufgezeichnete Commits |
Erweiterte Tools (insgesamt 54, die Standard-Oberfläche)
| Tool | Beschreibung |
|------|-------------|
| `memory_patterns` | Wiederkehrende Muster erkennen |
| `memory_timeline` | Chronologische Beobachtungen |
| `memory_relations` | Beziehungsgraph abfragen |
| `memory_graph_query` | Knowledge-Graph-Traversal |
| `memory_consolidate` | 4-stufige Konsolidierung ausführen |
| `memory_claude_bridge_sync` | Mit MEMORY.md synchronisieren |
| `memory_team_share` | Mit Teammitgliedern teilen |
| `memory_team_feed` | Kürzlich geteilte Einträge |
| `memory_audit` | Audit-Trail der Operationen |
| `memory_governance_delete` | Mit Audit-Trail löschen |
| `memory_snapshot_create` | Git-versionierter Snapshot |
| `memory_action_create` | Arbeitspakete mit Abhängigkeiten anlegen |
| `memory_action_update` | Action-Status aktualisieren |
| `memory_frontier` | Entblockte Actions nach Priorität sortiert |
| `memory_next` | Einzelne wichtigste nächste Action |
| `memory_lease` | Exklusive Action-Leases (Multi-Agent) |
| `memory_routine_run` | Workflow-Routinen instanziieren |
| `memory_signal_send` | Inter-Agent-Messaging |
| `memory_signal_read` | Nachrichten mit Empfangsquittungen lesen |
| `memory_checkpoint` | Externe Bedingungs-Gates |
| `memory_mesh_sync` | P2P-Sync zwischen Instanzen |
| `memory_sentinel_create` | Ereignisgesteuerte Watcher |
| `memory_sentinel_trigger` | Sentinels extern auslösen |
| `memory_sketch_create` | Ephemere Action-Graphen |
| `memory_sketch_promote` | In permanent überführen |
| `memory_crystallize` | Action-Ketten kompaktieren |
| `memory_diagnose` | Health-Checks |
| `memory_heal` | Festsitzenden Zustand auto-fixen |
| `memory_facet_tag` | Dimension:Wert-Tags |
| `memory_facet_query` | Nach Facetten-Tags abfragen |
| `memory_verify` | Provenienz nachverfolgen |
### 6 Resources · 3 Prompts · 17 Skills
| Typ | Name | Beschreibung |
|------|------|-------------|
| Resource | `agentmemory://status` | Health, Session-Anzahl, Memory-Anzahl |
| Resource | `agentmemory://project/{name}/profile` | Projektspezifische Intelligenz |
| Resource | `agentmemory://project/{name}/recent` | Letzte Beobachtungen eines Projekts |
| Resource | `agentmemory://memories/latest` | Die 10 neuesten aktiven Erinnerungen |
| Resource | `agentmemory://graph/stats` | Knowledge-Graph-Statistiken |
| Resource | `agentmemory://team/{id}/profile` | Geteiltes Team-Profil |
| Prompt | `recall_context` | Suche + Rückgabe von Kontext-Nachrichten |
| Prompt | `session_handoff` | Handoff-Daten zwischen Agenten |
| Prompt | `detect_patterns` | Wiederkehrende Muster analysieren |
| Skill | `/recall` | Memory durchsuchen |
| Skill | `/remember` | Im Langzeit-Memory speichern |
| Skill | `/session-history` | Zusammenfassungen letzter Sessions |
| Skill | `/forget` | Beobachtungen/Sessions löschen |
Die Tabelle zeigt die vier Kern-Skills. Der volle Satz umfasst 9 aufrufbare Skills plus 8 Referenz-Skills; siehe den Abschnitt Native Skills oben.
### Standalone MCP
Ohne den vollen Server laufen lassen, für jeden MCP-Client. Eines der folgenden geht:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
Oder zur MCP-Konfig Ihres Agenten hinzufügen:
Die meisten Agenten (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
Fügen Sie den `agentmemory`-Eintrag in das vorhandene `mcpServers`-Objekt Ihres Hosts ein, statt die Datei zu ersetzen. Für Sandbox-Clients, die den `localhost` des Hosts nicht erreichen können, fügen Sie `"AGENTMEMORY_FORCE_PROXY": "1"` zum env-Block hinzu und lassen `AGENTMEMORY_URL` auf eine Route zeigen, die die Sandbox erreicht.
OpenCode (`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
Plugin-Datei aus dem Repo kopieren:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---
Startet automatisch auf Port `3113`. Der Viewer lädt beim Verbinden einen Snapshot (`GET /agentmemory/viewer/snapshot`) und wendet danach Live-Stream-Events an: neue Erinnerungen, Lessons, Beobachtungen, Audit-Einträge, Graph-Änderungen und Health-Updates erscheinen ohne Polling oder Seiten-Reloads. Die einzigen weiteren Requests sind die Aktionen, die Sie anklicken, „load more"-Seiten und Suchen. Wenn der Stream abreißt, zeigt der Viewer, wie alt seine Zahlen sind, verbindet sich mit Backoff neu und synchronisiert sich wieder aus einem Snapshot.
- **12 Tabs in vier Gruppen** mit Live-Zählern, Deep-Links (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), Tastenkürzeln und einem Mobile-Menü.
- **Memories:** serverseitige Suche, Filter nach Projekt, Agent und Typ, ein Detail-Panel mit der Versionskette und einem Wort-Diff, Provenienz-Links, Kopierknöpfe für die ID, den MCP-Aufruf und einen curl-Befehl, Editieren (eine neue Version), Forget mit Bestätigung, Bulk-Forget und JSON-Export.
- **Sessions:** eine inline eingebettete Beobachtungs-Timeline mit lesbarer Tool-Eingabe und -Ausgabe, Filtern und Paging sowie den Memories und Lessons, die jede Session erzeugt hat.
- **Graph:** Suche, Knoten-Detail mit Relationen und Quellen, eine Legende, die sich nicht allein auf Farbe verlässt, und Zoom-Steuerung.
- **Health:** die Live-Version von `GET /agentmemory/status`. Jedes Problem kommt mit seinem Fix, plus dem State-Backend, dem Index-Speicherstatus, dem Fortschritt der Graph-Provenienz-Kompaktierung und einem Konsolidierungs-Erklärer mit den echten Schwellenwerten.
- **Audit-, Activity-, Profile-, Replay-, Lessons-, Actions- und Crystals**-Seiten, jede mit einem Leerzustand, der erklärt, was der Abschnitt ist, warum er leer ist und welcher Befehl ihn befüllt, sowie einem `?`-Glossar-Tooltip an jedem Begriff und jeder Zahl.
```bash
open http://localhost:3113
```
Der Viewer-Server bindet sich standardmäßig an `127.0.0.1` und hängt das Server-Secret an, wenn er Requests an die REST API weiterleitet, braucht also kein eigenes Setup. Der per REST ausgelieferte `/agentmemory/viewer`-Endpunkt folgt den üblichen Bearer-Token-Regeln und leitet Browser ohne Token auf den Viewer-Port um. CSP-Header verwenden eine Skript-Nonce pro Response und deaktivieren Inline-Handler-Attribute (`script-src-attr 'none'`).
---
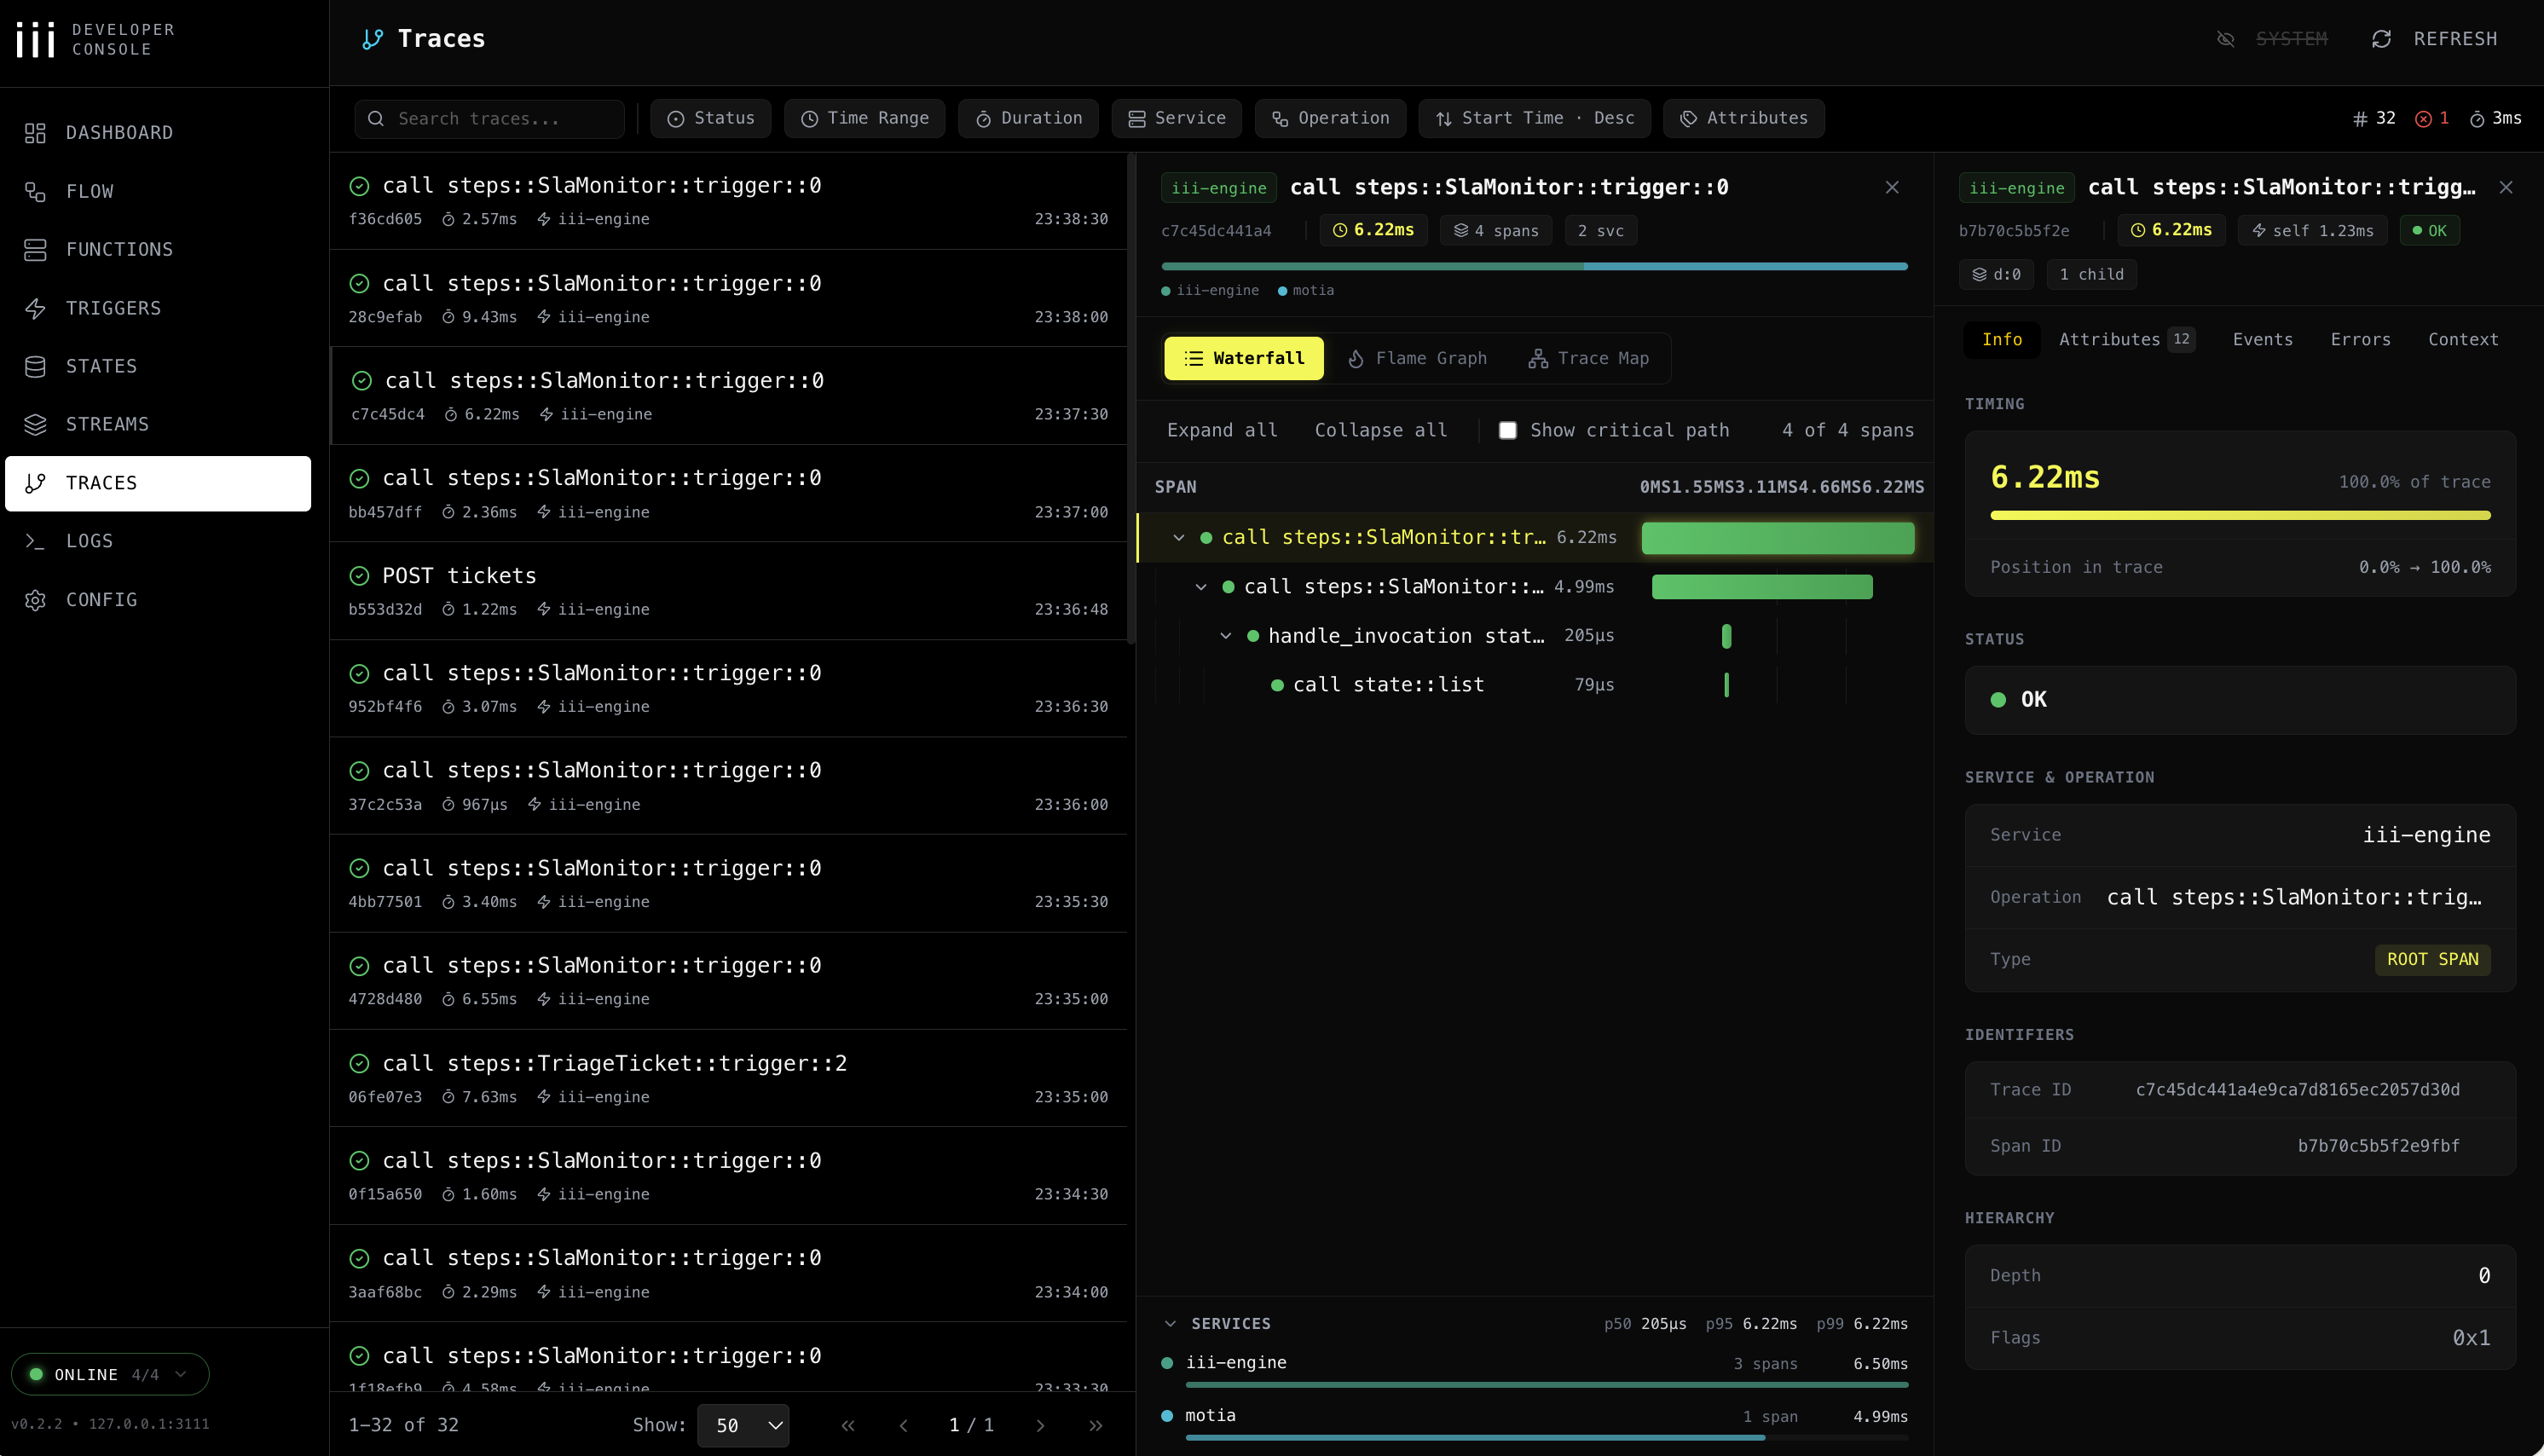
Der Viewer auf `:3113` zeigt, was Ihr Agent **gespeichert hat**. Die [iii console](https://iii.dev/docs/console) zeigt, was Ihr Agent **getan hat**: jede Memory-Operation als OpenTelemetry-Trace, jeden KV-Eintrag editierbar, jede Funktion aufrufbar, jeden Stream abgreifbar. Zwei Fenster auf dasselbe Memory: eines produktnah, eines engine-nah.
Sehen Sie, wie ein `memory_smart_search` feuert, und beobachten Sie BM25-Scan → Embedding-Lookup → RRF-Fusion → Reranker als Wasserfall. Editieren Sie einen festsitzenden Konsolidierungs-Timer im KV-Browser. Spielen Sie einen `PostToolUse`-Hook mit angepasster Payload erneut ab. Pinnen Sie den WebSocket-Stream an und sehen Sie Beobachtungen live eintrudeln.
agentmemory liefert das umsonst, weil jeder Funktionsaufruf und jeder Trigger durch iii feuert; nichts Eigenes, nichts zu instrumentieren.
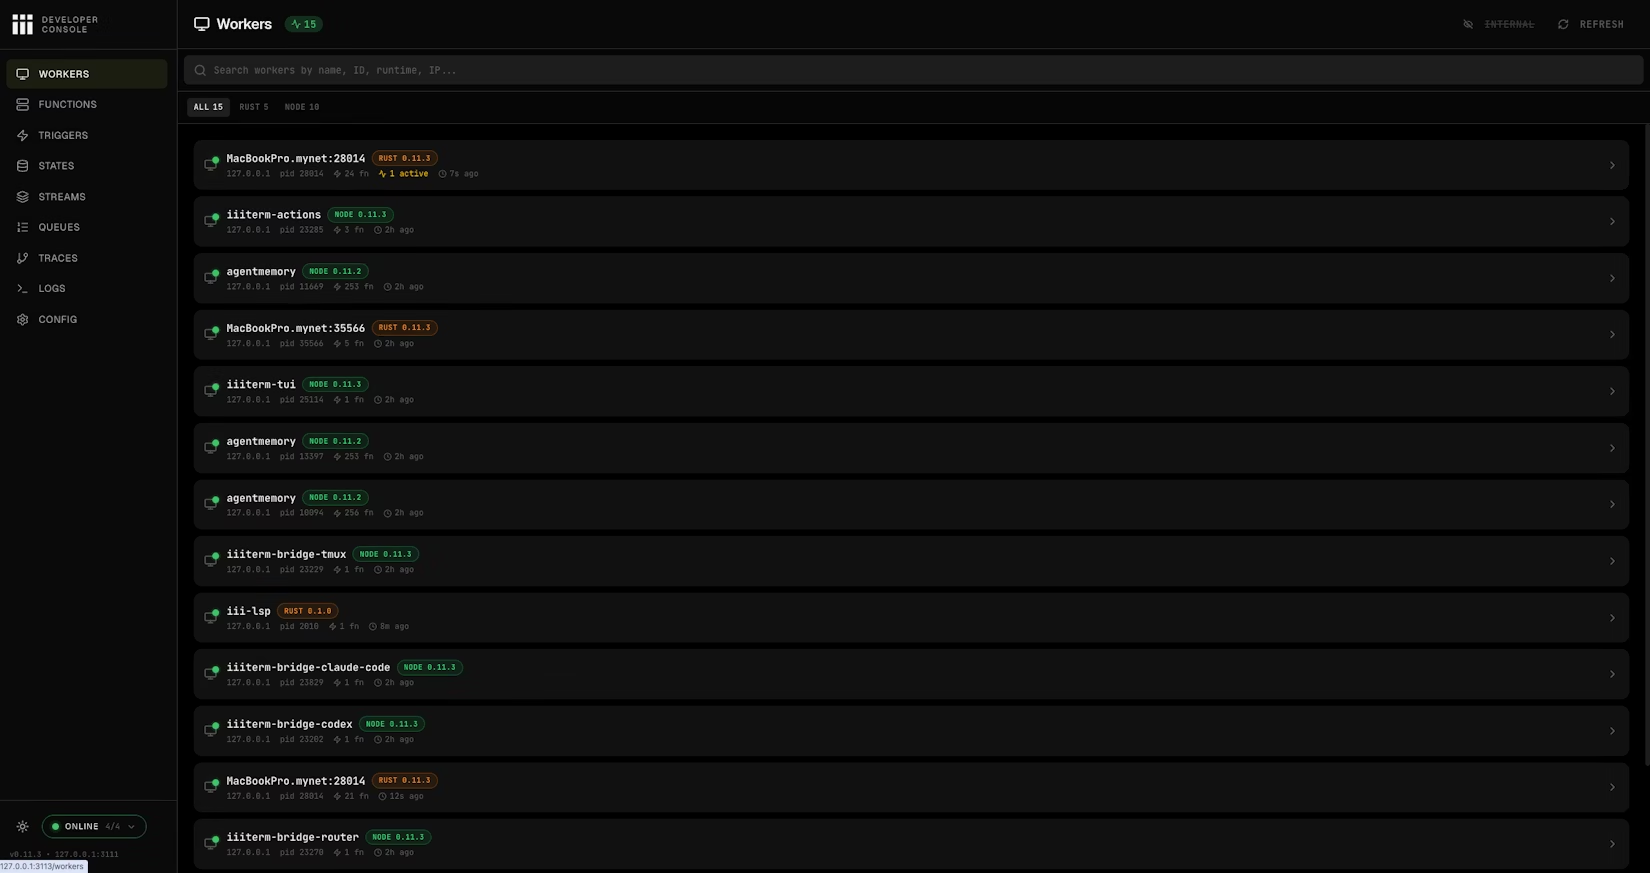
Workers-Seite: jeder verbundene Worker, einschließlich agentmemory selbst, mit PID, Funktionsanzahl, Runtime und last-seen.
**Bereits installiert.** Die Console wird mit der gepinnten `iii`-Engine ausgeliefert (0.22+); nichts Separates zu installieren. Der erste Start lädt das Console-Binary neben die Engine herunter.
**Neben agentmemory starten:**
```bash
agentmemory console
```
Das führt die `iii console` der gepinnten Engine gegen die von agentmemory aufgelösten Ports aus (REST, Streams, Bridge) und liefert sie einen Port über dem Viewer aus, standardmäßig `http://localhost:3114`. `--console-port N` wählt einen anderen Port; `--port` und `--instance` wählen die agentmemory-Instanz auf dieselbe Weise wie bei `stop`; jedes andere Flag wird durchgereicht, zum Beispiel `--enable-flow` für die experimentelle Architektur-Graph-Seite.
Dasselbe von Hand, nützlich, wenn `agentmemory` nicht im PATH liegt:
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**Was Sie aus der Console heraus tun können:**
| Seite | Verwenden Sie sie für |
|------|-----------|
| **Workers** | Jeden verbundenen Worker und seine Live-Metriken sehen, einschließlich des agentmemory-Workers selbst. |
| **Functions** | Jede Funktion von agentmemory direkt mit einer JSON-Payload aufrufen; handlich zum Testen von `memory.recall`, `memory.consolidate`, `graph.query` ohne Client zu verdrahten. |
| **Triggers** | HTTP-, Cron-, Event- und State-Trigger erneut abspielen: den Konsolidierungs-Cron manuell auslösen, eine HTTP-Route wiederholen, einen State-Change emittieren. |
| **States** | KV-Browser mit vollem CRUD über Sessions, Memory-Slots, Lifecycle-Timer und den Embeddings-Index; Werte direkt bearbeiten. |
| **Streams** | Live-WebSocket-Monitor für Memory-Schreibvorgänge, Hook-Events und Beobachtungsupdates, wie sie durch iii-Streams fließen. |
| **Queues** | Durable Queue-Topics + Dead-Letter-Verwaltung. Fehlgeschlagene Embedding-/Kompressions-Jobs wiederholen oder verwerfen. |
| **Traces** | OpenTelemetry-Wasserfall- / Flame- / Service-Breakdown-Ansichten. Nach `trace_id` filtern, um exakt zu sehen, welche Funktionen, DB-Calls und Embedding-Anfragen eine einzelne `memory.search` ausgelöst hat. |
| **Logs** | Strukturierte OTEL-Logs, gefiltert und korreliert mit Trace-/Span-IDs. |
| **Config** | Runtime-Konfiguration: sehen Sie genau, mit welchen Workern, Providern und Ports Ihre Engine läuft. |
| **Flow** | (Optional, `--enable-flow`) Interaktiver Architekturgraph jedes Workers, Triggers und Streams. |
Traces: Wasserfall / Flame / Service-Breakdown für jede Memory-Operation.
**Traces sind bereits aktiv:**
`iii-config.yaml` wird mit aktiviertem `iii-observability`-Worker ausgeliefert (`exporter: memory`, `sampling_ratio: 0.1`, Metriken + Logs). Keine zusätzliche Konfig nötig; in dem Moment, in dem agentmemory startet, emittiert jede Memory-Operation ein strukturiertes Log, das die Console lesen kann, und jede zehnte (`sampling_ratio: 0.1`) zusätzlich einen Trace-Span.
Wenn Sie stattdessen zu Jaeger/Honeycomb/Grafana Tempo exportieren wollen, ändern Sie `exporter: memory` zu `exporter: otlp` und setzen den Collector-Endpunkt gemäß der iii-Observability-Doku.
> **Achtung:** Auf der Console selbst wird keine Auth erzwungen; lassen Sie sie an `127.0.0.1` gebunden (Standard) und stellen Sie sie niemals öffentlich bereit.
---
agentmemory ist **bereits eine laufende [iii](https://iii.dev)-Instanz**. Drei Primitiven (Worker, Funktion, Trigger) bilden die Runtime; KV-State, Streams und OTEL-Traces kommen von den Workern iii-state, iii-stream und iii-observability, die mit iii ausgeliefert werden. Sie haben weder Postgres noch Redis, Express, pm2 oder Prometheus installiert, weil iii sie ersetzt.
Das bedeutet, ein weiterer Befehl erweitert agentmemory um eine komplett neue Fähigkeit.
### agentmemory mit weiteren Workern erweitern
Die Builtins, die agentmemory braucht, sind bereits in `iii-config.yaml` und starten mit ihr: `iii-state` (KV), `iii-queue` (durable Retries für die Event-Subscriber), `iii-pubsub`, `iii-cron`, `iii-stream` und `iii-observability` (OTEL-Traces, Metriken und Logs bei jeder Funktion). Alles andere aus der [iii-Worker-Registry](https://workers.iii.dev) steckt in denselben Engine: Kopieren Sie `iii-config.yaml` nach `~/.agentmemory/iii-config.yaml` (die CLI bevorzugt diese Datei vor der mitgelieferten und rendert Ports und Datenpfade weiterhin in sie hinein), fügen Sie den Eintrag hinzu, installieren Sie die Worker-Runtime einmalig mit `~/.agentmemory/bin/iii update worker`, und starten Sie agentmemory neu.
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | Was Sie zusätzlich zu agentmemory erhalten |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | SQL-gestützter State-Adapter, wenn Sie die In-Memory-KV-Voreinstellungen überwachsen |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | Code, der aus `memory_recall` kommt, läuft in einer Wegwerf-VM, nicht in Ihrer Shell |
| [`mcp`](https://workers.iii.dev/workers/mcp) | Zusätzliche MCP-Server neben dem von agentmemory aufstellen, die sich denselben Engine teilen |
Auf Engine 0.22.x halten Sie für die obigen Builtins die `iii-`-präfixierten Namen; die unpräfixierten Einträge `http`, `state`, `queue`, `pubsub` und `cron` sind die eigenständigen Registry-Worker, zu denen agentmemory mit der 0.23-Migration wechselt.
Volle Registry: [workers.iii.dev](https://workers.iii.dev). Jeder Worker dort komponiert sich über dieselben Primitiven wie agentmemory, und das agentmemory, das Sie bereits haben, ist einer davon.
### Engine-Konfiguration und Bind-Adresse
`agentmemory start` liest die Engine-Konfig aus der ersten vorhandenen Datei: `AGENTMEMORY_III_CONFIG`, `./iii-config.yaml` im aktuellen Verzeichnis, `~/.agentmemory/iii-config.yaml`, dann die mitgelieferte `iii-config.yaml`. Bei jedem Start rendert es diese Datei (Datenpfade, Ports, State-Backend) nach `~/.agentmemory/data/iii-config.runtime.yaml` und startet die Engine mit der gerenderten Kopie, editieren Sie also die Quelldatei, nicht die gerenderte. Die `host:`-Werte der Quelldatei werden so übernommen, wie sie geschrieben sind.
Die mitgelieferte `iii-config.yaml` bindet absichtlich `127.0.0.1`, und dieser Standard gilt auch innerhalb eines Containers. Eine in einem Container gestartete CLI lauscht auf dem Loopback des Containers, sodass veröffentlichte Ports nichts erreichen. Um eine containerisierte CLI über veröffentlichte Ports zu bedienen, setzen Sie `AGENTMEMORY_III_CONFIG` auf eine Konfig, die `0.0.0.0` bindet. Die mitgelieferte `iii-config.docker.yaml` ist eine solche: Sie bindet `iii-http`, `iii-stream` und den Engine-Port an `0.0.0.0` und speichert den State unter `/data`, mounten Sie dort also ein schreibbares Volume. Halten Sie `AGENTMEMORY_SECRET` gesetzt und veröffentlichen Sie nur die Ports, die Sie brauchen, auf `127.0.0.1` oder hinter einem Proxy, dem Sie vertrauen.
Die `docker-compose.yml` dieses Repos geht nicht über die Konfig-Suche der CLI: Sie mountet `iii-config.docker.yaml` nach `/app/config.yaml`, und der `iii-engine`-Container startet mit `--config /app/config.yaml`. Die Ein-Klick-[Deploy-Vorlagen](../deploy/) schreiben in ihren Entrypoints ihre eigene `0.0.0.0`-Konfig.
### Storage-Backend: file (Standard) vs. redis
`iii-state` und `iii-stream` greifen standardmäßig auf den mitgelieferten dateibasierten KV-Store der iii-engine zurück: eine JSON-Datei pro Scope, im Speicher des Engine-Prozesses gehalten und nach einem Timer auf die Festplatte zurückgeschrieben. Das ist der richtige Standard für eine lokale Einzelbenutzer-Installation; ein gemeinsam genutzter Daemon mit mehreren gleichzeitigen Schreibern erhält von Redis echte Per-Key-Writes, auf Kosten eines Netzwerk-Roundtrips pro Operation (jeder `state::*`-Aufruf serialisiert weiterhin auf einer Redis-Verbindung, das tauscht also das Lock des File-Stores gegen eine Socket-Verbindung, nicht gegen Parallelität).
Setzen Sie `AGENTMEMORY_STATE_BACKEND=redis` (plus `AGENTMEMORY_REDIS_URL`), um beide Worker auf den eingebauten `redis`-Adapter der iii-engine umzustellen, der jeden Schlüssel als Redis-Hash-Feld speichert (`HSET`) statt bei jedem Write einen ganzen Scope umzuschreiben:
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` ist standardmäßig `file`; lassen Sie es ungesetzt, bleibt das heutige Verhalten unverändert, und ein nicht erkannter Wert (alles außer `file` oder `redis`) ist ein Startfehler statt eines stillen Fallbacks. `/agentmemory/status` und die Health-Seite des Viewers (die Zeile State Store) melden, welches Backend aktiv ist und ob es antwortet, niemals die URL.
**Nur reines `redis://`.** Die gepinnte Engine (0.22.1) baut ihren Redis-Client ohne TLS-Unterstützung, daher schlägt eine `rediss://`-URL fehl (die meisten gemanagten Redis-Angebote, etwa Upstash, Redis Cloud und ElastiCache mit Transit-Verschlüsselung, sind standardmäßig TLS-only). Die Verbindung ist unverschlüsselt, daher laufen das Redis-Passwort und jedes gespeicherte Memory im Klartext über die Leitung: Zeigen Sie auf ein lokales Redis oder eines in einem privaten Netzwerk, dem Sie vertrauen. Für jedes andere Redis betreiben Sie einen verschlüsselten Tunnel (stunnel, SSH oder ein VPN) auf dem agentmemory-Host, sodass die reine `redis://`-Strecke auf diesem Host bleibt und die Upstream-Verbindung des Tunnels verschlüsselt und authentifiziert ist. Enthält ein Redis-Passwort ein einfaches Anführungszeichen, kodieren Sie es per Prozent (`%27`); die Engine expandiert die URL in ihre YAML-Konfig, bevor sie geparst wird.
**Ein Redis-Server pro `--instance`.** Die Redis-Schlüsselpräfixe der Engine (`state:`, `stream::`) sind fest, daher überschreiben zwei auf dieselbe Datenbank gerichtete agentmemory-Instanzen (`--instance 1`, `--instance 2`, ...) gegenseitig ihre Daten. Ein separater Datenbankindex (`redis://localhost:6379/1`) hält die gespeicherten Daten getrennt, aber die Engine leitet Live-Viewer-Events über einen einzigen Redis-Pub/Sub-Kanal (`stream::events`) weiter, und Redis-Pub/Sub ignoriert den Datenbankindex, sodass der Viewer jeder Instanz trotzdem die Live-Events der anderen zeigen würde. Geben Sie jeder Instanz ihren eigenen Redis-Server (oder Port), wenn Sie mehr als eine betreiben.
**Was gleich bleibt, und was sich unterscheidet.** Jede agentmemory-Funktion funktioniert auf Redis: Sessions, Beobachtungen, Memories (remember, supersede, evolve, forget), Suche und die Index-Buckets, Lessons, der Graph, das Audit-Log mit seinen Monats-Scopes, Export und Import, Governance-Deletes, Konsolidierungsstatus, der Viewer-Snapshot mit seinem Live-Stream und der Health-Monitor. Die Engine speichert jeden Scope als einen Redis-Hash (`HSET`/`HGET`/`HGETALL`) und feuert dieselben State-Trigger wie der File-Store. Drei Engine-Unterschiede werden innerhalb von agentmemory behandelt:
- Redis gibt die Datensätze eines Scopes in keiner festen Reihenfolge zurück. agentmemory sortiert sie älteste zuerst (nach dem Erstellungszeitpunkt in der Datensatz-ID, dann nach ihrem Zeitstempel), sodass Listen, Paging und Export-Chunks in derselben Reihenfolge zurückkommen wie beim File-Store.
- Die Engine wendet partielle Updates auf Redis in einem Lua-Skript an, das leere Arrays in leere Objekte verwandelt. agentmemory wendet diese Updates selbst an (lesen, ändern, unter einem Per-Key-Lock schreiben) auf Redis, sodass Felder wie `tags: []` Arrays bleiben.
- Die Legacy-Audit-Log-Prüfung liest den alten Scope aus Redis, statt auf der Festplatte nach der Datei des File-Stores zu suchen.
Ein Unterschied braucht Ihr Eingreifen: **nach einem Redis-Neustart stellt die Engine das Weiterleiten von Live-Events** an den Viewer ein, bis agentmemory neu startet. Daten werden weiterhin normal gespeichert und gelesen. Der Health-Monitor sendet alle 30 Sekunden ein Testereignis über Redis; kommt es nicht zurück, zeigen `/agentmemory/status` und die Health-Seite des Viewers „Live-Updates erreichen den Viewer nicht" mit dem Fix: agentmemory neu starten. Ist Redis down, zeigt der Statusbericht „Der State Store antwortet nicht" und wie man das prüft (`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`). Das Auflisten eines sehr großen Scopes liest den gesamten Hash in einem `HGETALL`, denselben Aufwand, den der File-Store hätte, ihn im Speicher zu halten.
**Empfohlene Redis-Einstellungen.** Die Standard-Snapshot-Policy `save 3600 1 300 100 60 10000` kann bei einem Absturz Minuten an Writes verlieren, schlechter als das 5-Sekunden-Flush-Fenster des File-Stores. Setzen Sie `appendonly yes` für alles, dessen Verlust Sie stören würde. Setzen Sie `maxmemory-policy noeviction`; `allkeys-lru` oder Ähnliches verwirft stillschweigend Erinnerungen, sobald Redis sein Speicherlimit erreicht.
Ein nativer (Nicht-Docker-)Start und jede Ein-Klick-[Deploy-Vorlage](../deploy/) (sie überschreiben die mitgelieferte `iii-config.yaml` und starten nativ) lesen `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` und rendern sie in die gestartete `iii-config`. Die URL selbst wird nie in diese gerenderte Datei geschrieben, nur eine `${AGENTMEMORY_REDIS_URL}`-Referenz, die der Engine-Prozess beim Booten aus seiner eigenen Umgebung expandiert. Nur der eigene Docker-Compose-Pfad dieses Repos (`AGENTMEMORY_USE_DOCKER=1`, oder das Fortsetzen einer bereits so gestarteten Engine) mountet `iii-config.docker.yaml` read-only und rendert nie; `agentmemory start` warnt, wenn es diese Kombination erkennt. Ändern Sie diese Datei von Hand, nach derselben `name: redis` / `config: redis_url: ...`-Form, die in den Worker-Docs von [iii-state](https://workers.iii.dev/workers/iii-state) und [iii-stream](https://workers.iii.dev/workers/iii-stream) gezeigt wird, und lassen Sie `redis_url` auf ein vom Container erreichbares Redis zeigen. `docker-compose.yml` gibt `AGENTMEMORY_REDIS_URL` in den Engine-Container weiter, sodass `redis_url: '${AGENTMEMORY_REDIS_URL}'` dort funktioniert und die URL aus der gemounteten Datei heraushält.
Die gerenderte Konfig hält die URL aus `~/.agentmemory/data/iii-config.runtime.yaml` heraus, aber der eigene Konfigurations-Worker der Engine persistiert den *expandierten* Wert trotzdem nach `~/.agentmemory/config/iii-state.yaml` und `iii-stream.yaml`, sobald sie bootet (die `${VAR}`-Expansion der iii-engine passiert, bevor dieser Worker seinen Seed speichert, und er speichert den aufgelösten Wert, nicht die Referenz). Behandeln Sie dieses Verzeichnis so, als enthielte es ein Credential: `chmod 700 ~/.agentmemory` auf jedem gemeinsam genutzten Host, und bevorzugen Sie einen auf das von agentmemory Benötigte beschränkten Redis-ACL-Benutzer vor den Admin-Credentials der Datenbank.
**Migration ist nicht automatisch.** Das Umschalten von `AGENTMEMORY_STATE_BACKEND` startet auf beiden Seiten mit einem leeren Store; nichts kopiert bestehende Daten von File nach Redis oder zurück. Exportieren Sie aus dem Backend, das Sie verlassen, und importieren Sie in das, zu dem Sie wechseln. Das läuft identisch unter bash und zsh (auch `bash -u`). Ein Array wie `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` tut das nicht: zsh behält den Header als ein fehlgeformtes Wort, während bash ihn in zwei aufteilt, sodass beide Requests 401 liefern, sobald `AGENTMEMORY_SECRET` gesetzt ist:
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` akzeptiert außerdem `?maxSessions=` und `?offset=`, um einen großen Korpus über mehrere Aufrufe zu zerlegen; `strategy` beim Import ist `merge` (standardmäßig sicher), `replace` oder `skip`.
### Was iii ersetzt
| Traditioneller Stack | agentmemory verwendet |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + In-Memory-Vector-Index |
| SSE / Socket.io | iii Streams (WebSocket) |
| pm2 / systemd | iii-Engine-Worker-Supervision |
| Prometheus / Grafana | iii OTEL + Health-Monitor |
| Eigene Plugin-Systeme | `iii worker add ` |
**219 Quelldateien · ~52,000 LOC · 2,500+ Tests · 311 Funktionen · 60 KV-Scopes**, alles auf drei Primitiven. Kein `agentmemory plugin install`. Das Plugin-System ist iii selbst.
---
### LLM-Provider
agentmemory erkennt Provider automatisch aus Ihrer Umgebung. Ein Provider macht LLM-gestützte Operationen verfügbar, aber die Provider-Konfiguration allein aktiviert noch nicht die LLM-geschriebene Beobachtungs-Kompression. Dieser Pfad erfordert sowohl einen Provider als auch `AGENTMEMORY_AUTO_COMPRESS=true`.
| Provider | Konfig | Hinweise |
|----------|--------|-------|
| **No-op (Standard)** | Keine Konfig nötig | LLM-gestütztes Compress/Summarize ist deaktiviert. Synthetische Kompression und BM25-Recall funktionieren weiter. Siehe `AGENTMEMORY_ALLOW_AGENT_SDK` unten, falls Sie früher auf den Claude-Abonnement-Fallback gesetzt haben. |
| Anthropic API | `ANTHROPIC_API_KEY` | Abrechnung pro Token |
| MiniMax | `MINIMAX_API_KEY` | Anthropic-kompatibel |
| Gemini | `GEMINI_API_KEY` | Aktiviert zusätzlich Embeddings |
| OpenRouter | `OPENROUTER_API_KEY` | Beliebiges Modell |
| OpenAI API | `OPENAI_API_KEY` | Standard `gpt-5.6-luna`, Override per `OPENAI_MODEL` |
| **Lokal (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) oder `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | Alles, was OpenAI-API-kompatibel ist. Null Kosten, läuft auf Ihrer Hardware. Siehe [Lokale Modelle](#local-models-ollama--lm-studio--vllm) unten. |
| Claude-Abonnement-Fallback | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | Nur als Opt-in. Startet `@anthropic-ai/claude-agent-sdk`-Sessions; verursachte früher unbegrenzte Stop-Hook-Rekursion, daher nicht mehr Standard. |
### Lokale Modelle (Ollama / LM Studio / vLLM)
agentmemory spricht mit jedem OpenAI-API-kompatiblen Server, daher funktioniert alles, was `/v1/chat/completions` bereitstellt, ohne Codeänderungen. Keine bezahlten Schlüssel, keine Cloud, keine Rate-Limits; läuft vollständig auf Ihrer Hardware.
**Ollama** (Standard-Port `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio** (Standard-Port `1234`):
Öffnen Sie LM Studio → Reiter „Local Server" → Start Server. Wählen Sie ein beliebiges Chat-Modell aus dem Picker (Qwen 3, gpt-oss, DeepSeek R1 usw.).
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**: gleiche Form. Zeigen Sie mit `OPENAI_BASE_URL` auf die URL, die Ihr Server bereitstellt, und setzen Sie `OPENAI_MODEL` auf einen Namen, den Ihr Server akzeptiert.
**Modellempfehlungen für Memory-Arbeit**: Kompression und Zusammenfassung sind kurze Aufgaben (<2K Tokens rein, <500 Tokens raus), für die ein 7B-Instruct-Modell völlig ausreicht. Empfehlungen:
| Modell | Größe | Warum |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | Ausgewogener Standard auf einer 16-GB-Maschine; stark bei Extraktion und tool-förmigem Text |
| `qwen3:4b` | ~2.6 GB | Kleinste vernünftige Option; gut für Kompression, schwächer bei Graph-Extraktion |
| `qwen3-coder:30b` | ~19 GB | Beste lokale Wahl für codelastige Sessions (30B MoE, 3.3B aktiv) auf 24-32-GB-Hardware |
| `gpt-oss:20b` | ~14 GB | Starkes Allzweckmodell, das in 16 GB RAM passt |
| `deepseek-r1:8b` | ~5.2 GB | Reasoning-Distill; langsamer, aber sauberere Extraktionen |
Qwen-3-Modelle denken standardmäßig und können das ganze Token-Budget für Reasoning verbrennen, bevor irgendeine Ausgabe kommt. Setzen Sie `AGENTMEMORY_LLM_NOTHINK=1`, um `/no_think` an Graph-Extraktions-Prompts anzuhängen, und erhöhen Sie `MAX_TOKENS` (16384 funktioniert), falls Extraktionen leer zurückkommen.
Modelle der Reasoning-Klasse (`o1`-artig mit ``-Blöcken) können leeren `content` mit einem `reasoning`-Feld zurückgeben, das Ihr lokaler Server womöglich nicht durchreicht. Wenn Extraktionen leer zurückkommen, wechseln Sie zuerst zu einem Nicht-Reasoning-Modell. Die Env-Variable `OPENAI_REASONING_EFFORT=none` kann das Denken auch auf Ollama-Cloud-Thinking-Modellen deaktivieren, die das OpenAI-Reasoning-Schema spiegeln.
Lokale Embeddings werden als optionale Abhängigkeit ausgeliefert, sind aber standardmäßig nicht aktiviert. Setzen Sie `EMBEDDING_PROVIDER=local`, um `Xenova/all-MiniLM-L6-v2` (384-dim) zu aktivieren. Die erste Embedding-Anfrage lädt das Modell herunter; die Inferenz läuft danach on-device. Ohne diese Einstellung oder einen Remote-Embedding-Schlüssel bleiben Vectors deaktiviert, `mem::search` verwendet BM25, und `smart-search` kann weiterhin bestehende Graph-Treffer hinzufügen.
### Kostenbewusste Modellwahl
Wenn LLM-geschriebene Hintergrund-Kompression sowohl mit einem Provider als auch mit `AGENTMEMORY_AUTO_COMPRESS=true` aktiviert ist, läuft sie bei jeder Beobachtung, daher beeinflusst die Modellwahl die monatlichen Kosten spürbar. Erfasste Lastdaten: 635 Requests / 888K Tokens / 35 Stunden aktive Nutzung, gegen drei OpenRouter-Modelle zu den Preisen vom 2026-05-23.
| Stufe | Modell | Eingabe / 1M | Ausgabe / 1M | Kosten für die erfassten 35 h | Hinweise |
|------|-------|------------|-------------|---------------------------|-------|
| Empfohlen | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07 (est.) | Neuestes DeepSeek; günstigste empfohlene Wahl für Kompressions-Workloads. |
| Empfohlen | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | Solide Kompressions-/Summarize-Qualität zu ~10× geringeren Kosten als Sonnet. |
| Empfohlen | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | Starkes Code-Reasoning, wenn Ihre Sessions stark codelastig sind. |
| Premium | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02 (est.) | Gleicher Listenpreis wie der gemessene Sonnet-4.6-Lauf; Einführungspreis $2/$10 bis 2026-08-31. |
| Premium | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9 (est.) | Flaggschiff-Stufe; teuer für dauerhafte Hintergrundarbeit. |
| Vermeiden | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40 (est.) | Modell der Flaggschiff-Klasse; Überausgabe für Kompression. |
Gemessene Zeilen stammen aus dem erfassten Lauf; (est.)-Zeilen skalieren denselben Token-Mix mit dem Listenpreis des jeweiligen Modells.
agentmemory gibt eine Runtime-Warnung aus, wenn `OPENROUTER_MODEL` auf ein Premium-Tier-Muster passt. Setzen Sie `AGENTMEMORY_SUPPRESS_COST_WARNING=1`, um sie zum Schweigen zu bringen, sobald Sie eine bewusste Wahl getroffen haben.
Qualitäts-Kosten-Abwägung für Memory-Arbeit: Kompression ist eine Summarize-Aufgabe mit eher lockerer Qualitätsanforderung (der Agent liest die Zusammenfassung erneut, nicht der Benutzer). DeepSeek V4 Flash / V4 Pro / Qwen3-Coder landen bei dieser Aufgabe innerhalb von Rundungsfehlern an Sonnet, bei 10-70× weniger Kosten. Heben Sie Premium-Modelle für Anfragen auf, die Sie direkt lesen.
Quellen: [OpenRouter-Preise für Claude Sonnet 5](https://openrouter.ai/anthropic/claude-sonnet-5), [DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731), [DeepSeek-Preis-Hinweise](https://api-docs.deepseek.com/quick_start/pricing/).
### Multi-Agent-Memory (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
In Multi-Agent-Setups, in denen sich mehrere Rollen einen agentmemory-Server teilen (architect / developer / reviewer / researcher / support-agent), markiert `AGENT_ID` jede Schreibaktion mit der Rolle, die sie ausgelöst hat. `AGENTMEMORY_AGENT_SCOPE` steuert, ob der Recall nach diesem Tag filtert.
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
Zwei Modi:
| Modus | Schreibvorgänge markieren | Recall filtern | Wann verwenden |
|------|------------|---------------|-------------|
| `shared` (Standard) | ja | nein | Agentenübergreifender Kontext mit Audit-Trail. Architect sieht, was Developer notiert hat, aber jede Zeile vermerkt, wer es gesagt hat. |
| `isolated` | ja | ja | Strikte Trennung. Architect sieht niemals Beobachtungen / Erinnerungen / Sessions von Developer. |
Was getaggt wird, wenn `AGENT_ID` gesetzt ist: `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId`. Die Rolle fließt von `api::session::start` → `mem::observe` → `mem::compress` → KV.
Was im Isolated-Modus gefiltert wird: `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions`. Jeder Endpunkt akzeptiert `?agentId=` als Per-Request-Override und `?agentId=*`, um sich komplett aus dem env-Scope auszuklinken. `/memories` akzeptiert zudem `?includeOrphans=true`, um Pre-AGENT_ID-Erinnerungen, deren `agentId` undefiniert ist, sichtbar zu machen.
Per-Call-Override auf SDK-/REST-Ebene: Jeder mutierende Endpunkt (`/session/start`, `/remember`) akzeptiert ein `agentId`-Feld im Request-Body, das die env-Variable überschreibt. Nützlich für Runtimes, die viele Rollen durch einen einzigen Serverprozess routen. Das MCP-Tool `memory_save` legt dasselbe `agentId`-Feld offen, der Standalone-stdio-Server reicht sowohl `agentId` als auch `project` weiter, und gespeicherte Memories tragen `agentId` in den Suchindex, sodass agent-gescopte Suche Memories ebenso abdeckt wie Beobachtungen.
Wenn `AGENT_ID` nicht gesetzt ist, bleibt Memory unscoped (Legacy-Verhalten, keine Tags, keine Filter).
### Ports
agentmemory + iii-engine binden standardmäßig vier Ports. Wenn ein Neustart mit `port in use` fehlschlägt, sagt Ihnen diese Tabelle, nach welchem Prozess Sie suchen müssen.
| Port | Prozess | Zweck | Env-Override |
|------|---------|---------|--------------|
| `3111` | agentmemory | REST API + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | Interner Streams-Worker (von agentmemory + Viewer verwendet) | `III_STREAM_PORT` (bevorzugt) oder legacy `III_STREAMS_PORT` |
| `3113` | agentmemory | Echtzeit-Viewer (`http://localhost:3113`) | `III_VIEWER_PORT` oder `AGENTMEMORY_VIEWER_URL` für die gemeldete URL |
| `49134` | iii-engine | WebSocket; Worker registrieren sich hier, OTel-Telemetrie fließt darüber | `III_ENGINE_PORT` oder `III_ENGINE_URL` |
`--port ` ändert den REST-Anker und leitet Streams `N+1`, Viewer `N+2` und den Engine-WebSocket `N+46023` nur dort ab, wo der entsprechende explizite Port oder die URL oben ungesetzt ist. Es erzeugt keinen isolierten Lifecycle-Namespace. Verwenden Sie `--instance 1` für einen zweiten Daemon; er nutzt den Anker 3211, standardmäßig `3211/3212/3213/49234`, und erhält ein separates `instance-1`-Daten- und Lifecycle-Verzeichnis. Instanzen 1 bis 50 folgen demselben Muster.
Die gepinnte Engine startet mit `--no-update-check` (keine Update- oder Security-Advisory-Abfragen gegen GitHub beim Booten) und mit deaktivierter anonymer Nutzungstelemetrie von iii: agentmemory setzt `III_TELEMETRY_ENABLED=false` für die Engine, die es spawnt, sofern Sie die Variable nicht selbst exportieren, und die mitgelieferte Compose-Datei macht dasselbe.
Aufräumen veralteter Prozesse, wenn Ports nach einem abgestürzten Lauf gebunden bleiben:
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` räumt sowohl den Worker als auch das Engine-Pidfile bei einem geordneten nativen Shutdown sauber auf. Im Docker-Modus leert es den nativen Worker, stoppt genau den validierten Engine-Container und bewahrt sowohl den Container als auch sein `/data`-Mount für einen verlustfreien Neustart; der nächste Start validiert und setzt denselben Container fort. Docker-gestütztes Deinstallieren erfordert `agentmemory remove --keep-data`: Es entfernt gemeinsam genutzte, von agentmemory verwaltete Dateien und bewahrt dabei den validierten Container, sein Daten-Mount und den Lifecycle-Eintrag, der zu ihrer Wiederherstellung nötig ist. Destruktives Löschen von Docker-Daten wird bewusst dem Betreiber nach einem Backup überlassen. Die CLI weigert sich außerdem, Docker- oder VM-Port-Inhaber (Docker-Backend, vpnkit, colima) als native Engine zu adoptieren oder zu signalisieren, sofern nicht `--force` übergeben wird. Das manuelle Cleanup oben ist nur für den Post-Crash-Fall nötig, in dem kein Pidfile zurückbleibt.
### Konfigurationsdatei
Legen Sie die agentmemory-Runtime-Konfiguration in `~/.agentmemory/.env` ab, statt Variablen in jeder Shell zu exportieren. Wenn der Viewer einen Setup-Hinweis wie `export ANTHROPIC_API_KEY=...` zeigt, kopieren Sie ihn als `ANTHROPIC_API_KEY=...` ohne `export`-Präfix in diese Datei und starten Sie agentmemory neu.
Prozess-Umgebungsvariablen funktionieren weiterhin und haben Vorrang vor Werten in der Datei.
Unter Windows liegt dieselbe Datei unter `%USERPROFILE%\.agentmemory\.env`:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
Um mit einem Claude Code Pro/Max-Abonnement statt eines API-Schlüssels zu testen, stimmen Sie explizit zu:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
LLM-geschriebene Beobachtungs-Kompression erfordert beide Zeilen: Zugang zu einem LLM-Provider (einschließlich dieses expliziten Abonnement-Fallbacks) und `AGENTMEMORY_AUTO_COMPRESS=true`. Ein Provider allein lässt den standardmäßigen synthetischen Kompressionspfad unangetastet.
Konsolidierung (Graph-Knoten, Lessons, Crystals) ist standardmäßig aktiv, sobald ein LLM-Provider konfiguriert ist. Deaktivieren Sie das explizit mit `CONSOLIDATION_ENABLED=false`, wenn Sie LLM-freien Betrieb wollen. Graph-Extraktion ist ein separates Flag:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### Umgebungsvariablen
`~/.agentmemory/.env` anlegen:
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---
138 Endpunkte auf Port `3111`. Die REST API bindet sich standardmäßig an `127.0.0.1`. Geschützte Endpunkte verlangen `Authorization: Bearer `, und Mesh-Sync-Endpunkte erfordern ein explizit gesetztes `AGENTMEMORY_SECRET` auf beiden Peers.
**Authentifizierung ist standardmäßig aktiv.** Wenn `AGENTMEMORY_SECRET` nicht gesetzt ist (weder in der Shell noch in `~/.agentmemory/.env`), erzeugt der Server beim ersten Start ein zufälliges Secret und speichert es in `~/.agentmemory/secret` mit dem Modus `0600`. Jeder mitgelieferte Client liest es von dort, wenn er mit einem lokalen Server spricht: die CLI, der Viewer, die Hooks unter `plugin/scripts`, der MCP-Server und das `@agentmemory/mcp`-Shim, die von `agentmemory connect` geschriebenen Konfigs sowie die mitgelieferten Integrationen für OpenCode, Pi, OpenClaw, Hermes und den Filesystem-Watcher. Das gespeicherte Secret wird nur an Loopback-URLs gesendet (`localhost`, `127.0.0.0/8`, `::1`). Ein explizites `AGENTMEMORY_SECRET` gewinnt immer, und Remote-Clients benötigen es trotzdem gesetzt. Docker und die `deploy/`-Entrypoints erzeugen und exportieren bereits ihr eigenes Secret. Um die API von Hand aufzurufen:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**Request-Regeln für Writes.** `POST`-, `PUT`-, `PATCH`- und `DELETE`-Requests an die REST API und den Viewer müssen `Content-Type: application/json` senden (ein `charset`-Parameter ist in Ordnung), wann immer sie einen Body tragen, und ein `Origin`-Header muss, wenn vorhanden, ein Loopback-Origin für den konfigurierten REST- oder Viewer-Port sein oder in `VIEWER_ALLOWED_ORIGINS` aufgeführt sein (kommasepariert, z. B. `https://memory.example.com`). Clients, die keinen `Origin`-Header senden (CLI, Hooks, MCP, curl, Server-zu-Server), sind nicht betroffen. Der Viewer akzeptiert außerdem seinen eigenen Origin.
**Dateipfade.** Endpunkte, die Dateien lesen oder schreiben (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`), akzeptieren nur Pfade unter `~/.agentmemory`, dem Instanz-Datenverzeichnis oder einem in `AGENTMEMORY_IMPORT_ROOT` aufgeführten Verzeichnis (mehrere getrennt mit `:`, unter Windows mit `;`). `/replay/import-jsonl` akzeptiert außerdem seinen Standard `~/.claude/projects`. `/obsidian/export` bleibt innerhalb von `AGENTMEMORY_EXPORT_ROOT` und `/migrate` innerhalb von `~/.agentmemory`. Symlinks werden vor jeder Prüfung aufgelöst.
**Secret-Bereinigung.** API-Schlüssel, Bearer-Tokens, PEM-Private-Key-Blöcke und in URLs eingebettete Credentials (`scheme://user:password@host`) werden vor dem Speichern von Text auf jedem Write-Pfad geschwärzt: Beobachtungen, Remember, Evolve, Slots, Lessons, Actions, Sketches, Signals, Checkpoints, Imports, JSONL-Replay, Mesh-Sync, Team-Shares, Kompressions- und Summary-Ausgabe, Crystals und Graph-Knoten.
Wichtige Endpunkte
| Methode | Pfad | Beschreibung |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | Health-Check (immer öffentlich) |
| `GET` | `/agentmemory/status` | Was nicht stimmt und wie man es behebt (HTML für Browser, sonst JSON) |
| `GET` | `/agentmemory/viewer/snapshot` | Alles, was der Viewer zeigt, in einer Antwort |
| `POST` | `/agentmemory/session/start` | Session starten + Kontext holen |
| `POST` | `/agentmemory/session/end` | Session beenden |
| `POST` | `/agentmemory/observe` | Beobachtung erfassen (siehe Capture-Delivery unten) |
| `GET` | `/agentmemory/capture` | Capture-Inbox, Dead Letters und Offline-Spool |
| `POST` | `/agentmemory/capture/retry` | Dead-Letter-Captures erneut versuchen |
| `POST` | `/agentmemory/capture/drain` | Den lokalen Offline-Spool jetzt senden |
| `POST` | `/agentmemory/smart-search` | Hybride Suche |
| `POST` | `/agentmemory/context` | Kontext erzeugen |
| `POST` | `/agentmemory/remember` | In Langzeit-Memory speichern |
| `POST` | `/agentmemory/forget` | Beobachtungen löschen |
| `POST` | `/agentmemory/enrich` | Dateikontext + Erinnerungen + Bugs |
| `GET` | `/agentmemory/profile` | Projektprofil |
| `GET` | `/agentmemory/export` | Alle Daten exportieren |
| `POST` | `/agentmemory/import` | Aus JSON importieren |
| `POST` | `/agentmemory/graph/query` | Knowledge-Graph-Anfrage |
| `POST` | `/agentmemory/graph/compact` | Übergroße Graph-Provenienz trimmen |
| `POST` | `/agentmemory/team/share` | Mit Team teilen |
| `GET` | `/agentmemory/audit` | Audit-Trail |
Volle Endpunktliste: [`src/triggers/api.ts`](../src/triggers/api.ts)
**Capture-Delivery.** Hooks senden jede Beobachtung einmal an `POST /agentmemory/observe` mit einer `eventId`. Das ist die eigene ID des Hosts für den Aufruf, wenn die Payload eine hat (zum Beispiel Claude Codes `tool_use_id`), sonst ein Hash aus Session, Hook-Typ, Tool-Name, Eingabe, Ausgabe und Host-Zeitstempel. Der Server schreibt das Event in eine Capture-Inbox im State-Store, speichert die Beobachtung und entfernt dann den Inbox-Eintrag. Der Statuscode sagt, was passiert ist:
| Status | `status`-Feld | Bedeutung |
|---|---|---|
| `201` | `accepted` | Gespeichert. `observationId` ist die neue Beobachtung. |
| `202` | `accepted` (`state: "retrying"`) | Akzeptiert, aber das Speichern schlug fehl. Der Server versucht es erneut, auch nach einem Neustart. |
| `200` | `duplicate` | Diese `eventId` wurde bereits akzeptiert. `observationId` ist die bestehende Beobachtung; nichts Neues wird gespeichert. |
| `400` / `422` | `rejected` | Ungültige Payload, oder das Speichern ist endgültig fehlgeschlagen (das Event wird als Dead Letter behalten). |
| `503` | `rejected` (`retryable: true`) | Die Inbox ist voll (`AGENTMEMORY_CAPTURE_INBOX_MAX`). Hooks spoolen das Event und senden es später. |
Fehlgeschlagene Events werden alle `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 s) mit verdoppelndem Backoff wiederholt, bis zu `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5). Events, die weiterhin fehlschlagen, bleiben als Dead Letters in der Inbox, werden auf `/agentmemory/status` und der Health-Seite des Viewers aufgeführt und können mit `POST /agentmemory/capture/retry` erneut versucht werden (`{"eventId": "..."}` oder `{"all": true}`). Akzeptierte Event-IDs werden für `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 Stunden, höchstens `AGENTMEMORY_CAPTURE_EVENTS_MAX` IDs) gemerkt, sodass ein nach einem Timeout oder Neustart wiederholter Hook einmal gespeichert wird, während zwei separate Tool-Aufrufe mit ihren eigenen Host-IDs zweimal gespeichert werden, auch wenn ihr Inhalt identisch ist. Wenn eine Beobachtung gelöscht wird (Forget, Session-Delete, Eviction, Auto-Forget oder ein Import, der den Store ersetzt), wird ihr Event als gelöscht markiert, bevor die Beobachtung entfernt wird, sodass ein Replay dieses Events innerhalb desselben Fensters als Duplikat beantwortet wird und nichts speichert. Der State-Store schreibt alle 2 Sekunden auf die Festplatte, daher kann eine beantwortete Event noch einen Moment lang nur im Speicher stehen. Um das abzudecken, trägt jede `2xx`-Antwort zusätzlich die `bootId` des Servers (neu bei jedem Start), `acceptedAt` und `durableAfterMs` (das Speicherintervall plus 1,5 s beim File-Store, 1,5 s bei Redis, wo Persistenz die Einstellung des Betreibers ist). Hooks behalten das Event im lokalen Spool, bis dieses Fenster vergangen ist, und löschen es bei einem späteren Aufruf ohne einen weiteren Request. Hat sich die `bootId` bis dahin geändert, ist der Server neu gestartet, daher sendet der Hook das Event erneut mit derselben `eventId`; ein Event, das die Festplatte tatsächlich erreicht hat, wird nicht doppelt gespeichert. Der Server sendet solche Events auch selbst beim Start und bei jedem Retry-Intervall, sodass ein Neustart nichts verliert, selbst wenn danach kein Hook läuft. Ältere Hooks ignorieren die zusätzlichen Felder, und neue Hooks gegen einen älteren Server verwerfen das Event bei `2xx` wie zuvor.
Wenn der Server down ist, nicht rechtzeitig antwortet oder einen 5xx zurückgibt, hängt der Hook die Beobachtung an eine lokale Spool-Datei an, `/capture-spool/-.jsonl` (den Ordner mit `AGENTMEMORY_CAPTURE_SPOOL_DIR` überschreiben). Die Datei ist privat für Ihren Benutzer (Modus 600), Secrets werden auf dieselbe Weise geschwärzt wie beim Server, sie fasst höchstens `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 MiB) und verwirft Einträge, die älter als `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168) sind. Ist sie voll, werden neue Einträge verworfen und gezählt, und `/agentmemory/status` meldet das. Der Hook beendet sich innerhalb seines Zeitlimits weiterhin mit 0 und fügt keinen Request hinzu, wenn der Server gesund ist. Der Spool wird beim nächsten Start gesendet und vom ersten Hook, der den Server wieder erreicht, in einem Hintergrundprozess, sodass der Agent nicht wartet. Event-IDs machen das sicher: Eine Beobachtung, die vor einem Timeout tatsächlich angekommen ist, wird nicht doppelt gespeichert. `npx @agentmemory/agentmemory capture` zeigt den Spool und die Server-Inbox, `--drain` sendet den Spool jetzt, und `GET /agentmemory/capture` liefert dasselbe als JSON. Setzen Sie `AGENTMEMORY_CAPTURE_SPOOL=false`, um den Spool abzuschalten.
**Graph-Provenienz kompaktieren.** Jeder Knowledge-Graph-Knoten und jede Kante behält die IDs der neuesten 32 Beobachtungen, aus denen sie stammt. Vor diesem Cap geschriebene Stores können Tausende von IDs pro heißem Knoten enthalten, was die Graph-Suche und den Viewer langsam macht oder den Worker zum Absturz bringt. agentmemory behebt das selbst: Beim ersten Start nach einem Upgrade trimmt es jeden Knoten, jede Kante, jede überholte Kante (die temporale Graph-Historie) und den gecachten Snapshot im Hintergrund auf das Cap, in kleinen Scheiben mit einer Pause dazwischen, sodass Suche, Capture und der Viewer weiter funktionieren. Es speichert seinen Fortschritt, setzt nach einem Neustart fort und läuft nie wieder, sobald es fertig ist. `/agentmemory/status` und die Health-Seite des Viewers zeigen es als ausstehend, laufend (mit dem aktuellen Scope und der Position), fertig oder fehlgeschlagen. Setzen Sie `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false`, um es abzuschalten.
Um es von Hand auszuführen, rufen Sie `POST /agentmemory/graph/compact` auf. Es durchläuft die Name- und Edge-Key-Indizes, statt jeden Knoten und jede Kante aufzulisten, und kann sicher erneut ausgeführt werden. Wenn es IDs trimmt, schreibt es einen `graph_compact`-Audit-Eintrag.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
Bei einem großen Store, oder wenn der Aufruf 504 zurückgibt, führen Sie es in Scheiben aus. Senden Sie `scope` (`nodes`, `edges` oder `history`), `offset` und `limit`, und rufen Sie es dann mit dem zurückgegebenen `nextOffset` erneut auf, bis er `null` ist. Tun Sie das für `nodes`, `edges` und `history`, und schließen Sie mit einem einzigen `{"scope":"snapshot"}`-Aufruf ab, da ein in Scheiben ausgeführter Lauf den gecachten Snapshot nicht berührt.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---
```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**Voraussetzungen:** Node.js >= 20 mit npm/npx; [iii-engine](https://iii.dev/docs) v0.22.1 oder Docker. Die automatische Engine-Installation unter macOS/Linux benötigt außerdem `curl`, eine POSIX-`sh` und `tar`; natives Windows verwendet die manuell gepinnte `iii.exe`, WSL2 oder Docker Desktop.