Seu agente de codificação lembra de tudo. Chega de re-explicar.
Construído sobre iii engine
Memória persistente para Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, OpenCode e qualquer cliente MCP.
O gist estende o padrão LLM Wiki do Karpathy com pontuação de confiança, ciclo de vida, grafos de conhecimento e busca híbrida: agentmemory é a implementação.
---
## Install
Requisitos:
- Node.js 20 ou mais recente, com npm e npx (`node -v`, `npm -v` e `npx -v`).
- A instalação automática do iii-engine no macOS/Linux também precisa de `curl`, um `sh` POSIX e `tar`. Imagens mínimas como `node:20-slim` podem não incluí-los.
- O Windows nativo exige que o `iii.exe` da versão fixada do iii-engine v0.22.1 seja instalado manualmente. WSL2 ou Docker Desktop são os outros caminhos suportados.
Comando canônico para instalação do zero:
```bash
npx -y @agentmemory/agentmemory@latest
```
A primeira execução é um setup interativo: escolha os agentes a conectar (Claude Code, Cursor, Codex, Gemini CLI, OpenCode, ...), escolha um provider de LLM ou fique sem chave, e ele semeia a configuração, inicia o servidor de memória e o seu iii engine fixado, e se oferece para instalar globalmente, de modo que o comando `agentmemory` simples funcione em qualquer lugar depois. O `-y` aceita o prompt de pacote do npx e o `@latest` evita um release antigo em cache. Um provider libera os recursos de LLM, mas a compressão de observações escrita por LLM só começa quando `AGENTMEMORY_AUTO_COMPRESS=true` também está definido.
O modo sem chave desativa os embeddings vetoriais. O `memory_recall` (o caminho `mem::search`) usa BM25, enquanto o `memory_smart_search` também pode combinar correspondências estruturais do grafo quando já existem dados de grafo. Para recall semântico gratuito e no dispositivo, defina `EMBEDDING_PROVIDER=local` em `~/.agentmemory/.env` e reinicie. A primeira requisição de embedding baixa o `Xenova/all-MiniLM-L6-v2`; a inferência roda localmente depois desse download inicial do modelo.
O runtime local usa quatro portas: `3111` para REST/MCP HTTP, `3112` para os streams do iii, `3113` para o viewer e `49134` para o WebSocket do worker iii. O estado persistente do iii mora em `~/Library/Application Support/agentmemory` no macOS, em `$XDG_DATA_HOME/agentmemory` ou `~/.local/share/agentmemory` no Linux, e em `%APPDATA%\agentmemory` no Windows. Use `--data-dir ` ou `AGENTMEMORY_DATA_DIR` para sobrescrever isso, e reutilize o mesmo valor em cada reinício. Por compatibilidade retroativa, um `./data/state_store.db` ou `./data/iii-config.yaml` já existente tem precedência sobre o padrão da plataforma para a instância 0; uma flag explícita ou override de ambiente ainda prevalece.
Depois prove que o recall funciona e dê ao seu agente as skills dele:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
As buscas por palavra-chave devem acertar no modo sem chave padrão, via BM25. A query `database performance optimization` do demo é intencionalmente semântica e pode retornar zero até que um provider de embedding seja configurado.
Prefere deixar um agente de codificação fazer tudo? Entregue a ele uma única instrução:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
Conecte mais agentes a qualquer momento com `agentmemory connect ` — 20 adaptadores listados em [Funciona com qualquer agente](#works-with-every-agent). Referência completa de comandos em [Início rápido](#quick-start).
Windows
O caminho rápido é o WSL2. O setup nativo do engine no Windows exige que o ZIP fixado da v0.22.1 seja baixado e o `iii.exe` extraído manualmente; o CLI não o extrai automaticamente. O Docker Desktop também é suportado. Veja as [notas de Windows](#windows) para o passo a passo.
Instalação global / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
O comando npx acima continua sendo o caminho canônico de instalação do zero e evita problemas de permissão de prefixo global.
npx serve uma versão antiga
O npx faz cache por versão. Force a mais recente com `npx -y @agentmemory/agentmemory@latest`, ou limpe o cache uma vez com `rm -rf ~/.npm/_npx` (macOS/Linux; no Windows apague `%LOCALAPPDATA%\npm-cache\_npx`).
Já roda seu próprio engine iii
agentmemory fixa o iii-engine em v0.22.1 e não se conecta a uma versão diferente (o worker não fala o protocolo de outro engine). Pare o outro engine e rode `npx -y @agentmemory/agentmemory@latest`. Ele instala e executa a v0.22.1 fixada em `~/.agentmemory/bin`, deixando o seu próprio `iii` intocado.
---
agentmemory funciona com qualquer agente que suporte hooks, MCP ou REST API. Todos os agentes compartilham o mesmo servidor de memória.
Claude Code native plugin + 12 hooks + MCP
Codex CLI native plugin + 6 hooks + MCP
GitHub Copilot CLI MCP + plugin hooks/skills
Cursor native plugin + 7 hooks + MCP
OpenCode capture plugin + MCP
Devin 6 hooks + skills + MCP
OpenClaw native plugin + MCP
Hermes native plugin + MCP
pi native plugin + MCP
OpenHuman native Memory trait backend
Gemini CLI MCP server
Antigravity MCP + hooks
Claude Desktop MCP server
Warp connect + MCP + skills
Zed MCP server
Cline MCP server
Continue MCP server
Droid MCP server
Kiro MCP server
Qwen Code MCP server
DeepSeek Harness MCP server
Roo Code MCP server
Kilo Code MCP server
Goose MCP server
Aider REST API
Funciona com qualquer agente que fale MCP ou HTTP. Um servidor, memórias compartilhadas entre todos eles.
---
Você explica a mesma arquitetura toda sessão. Você redescobre os mesmos bugs. Você reensina as mesmas preferências. A memória integrada (CLAUDE.md, .cursorrules) bate no teto das 200 linhas e fica desatualizada. agentmemory resolve isso. Ele captura silenciosamente o que seu agente faz, comprime em memória pesquisável e injeta o contexto certo quando a próxima sessão começa. Um comando. Funciona entre agentes.
**O que muda:** Na sessão 1 você configura autenticação JWT. Na sessão 2 você pede rate limiting. O agente já sabe que sua autenticação usa o middleware jose em `src/middleware/auth.ts`, que seus testes cobrem a validação de tokens e que você escolheu jose em vez de jsonwebtoken por compatibilidade com Edge, sem re-explicar e sem copiar e colar.
```bash
npx -y @agentmemory/agentmemory@latest
```
Por padrão, agentmemory guarda o estado do iii-engine fora do repositório a partir do qual você o inicia: `~/Library/Application Support/agentmemory` no macOS, `$XDG_DATA_HOME/agentmemory` ou `~/.local/share/agentmemory` no Linux, e `%APPDATA%\agentmemory` no Windows. Um `./data/state_store.db` ou `./data/iii-config.yaml` legado já existente é reutilizado para a instância 0 antes desse padrão da plataforma. Para escolher um local explicitamente, passe `--data-dir ` ou defina `AGENTMEMORY_DATA_DIR`; qualquer uma das duas opções explícitas tem precedência sobre a descoberta legada:
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
Execuções nativas e via Docker usam esse mesmo diretório-host resolvido; o Docker monta esse bind em `/data`. `--instance 1` acrescenta `instance-1` ao diretório resolvido e seleciona o quarteto de portas padrão separado `3211/3212/3213/49234`.
Notas da última versão: [CHANGELOG.md](../CHANGELOG.md).
---
### Precisão de recuperação
**coding-agent-life-v1** (corpus interno, reproduzível em sandbox)
| Adaptador | P@5 | R@5 | Taxa de acerto top-5 | Latência p50 |
|---|---|---|---|---|
| **agentmemory hybrid** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| grep baseline | 0.227 | 0.967 | 15 / 15 | 0 ms |
Taxa de acerto top-5 de 100% no **teto matemático de P@5** deste corpus (0.240, veja a scorecard). O híbrido recupera todas as sessões gold; o grep perde 1 de 2 golds na query temporal multi-sessão. O ganho é **recall + temporal**, não precisão agregada. Este benchmark é pequeno e esparso em golds; o LongMemEval-S maior abaixo diferencia melhor. Detalhamento completo por tipo + nota de correção: [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md).
**LongMemEval-S** (ICLR 2025, 500 perguntas)
| Sistema | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| BM25-only fallback | 86.2% | 94.6% | 71.5% |
> Modelo de embedding: `all-MiniLM-L6-v2` (local, gratuito, sem API key). Relatórios completos: [`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md), [`benchmark/QUALITY.md`](../benchmark/QUALITY.md), [`benchmark/SCALE.md`](../benchmark/SCALE.md). Comparativo com concorrentes: [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md) cobrindo agentmemory vs mem0, Letta, Khoj, supermemory, TencentDB Agent Memory, MemPalace, Zep/Graphiti, Cognee, Hippo.
**Reproduza localmente:** [`eval/README.md`](../eval/README.md), um harness com adaptadores plugáveis para LongMemEval `_s` (500-Q públicas) e `coding-agent-life-v1` (corpus interno de 15 sessões). Adaptadores grep / vector / agentmemory são pontuados lado a lado, saída em NDJSON, e as scorecards publicadas ficam em [`docs/benchmarks/`](../docs/benchmarks/).
**Combina com [codegraph](https://github.com/colbymchenry/codegraph), [Understand Anything](https://github.com/Lum1104/Understand-Anything) e [Graphify](https://github.com/safishamsi/graphify).** Indexação de grafos de código, pipelines de build multiagente e grafos de conhecimento mais amplos sobre docs / PDFs / imagens / vídeos. agentmemory lembra do trabalho; esses três projetos iluminam o resto da camada de contexto. Recipes e tabela de roteamento por pergunta: [`docs/recipes/pairings.md`](../docs/recipes/pairings.md).
---
agentmemory
mem0 (63K ⭐)
Letta / MemGPT (24K ⭐)
Khoj (36K ⭐)
supermemory (29K ⭐)
TencentDB Agent Memory (22K ⭐)
MemPalace (54K ⭐)
oracleagentmemory
Hippo
Built-in (CLAUDE.md)
Tipo
Engine de memória + servidor MCP
API de camada de memória
Runtime de agente completo
IA pessoal
API de memória + app
Hub de memória de time (proxy de LLM)
Memória vetorial (OSS)
Engine de memória (Oracle DB)
Sistema de memória
Arquivo estático
Retrieval R@5
95.2%
68.5% (LoCoMo)
83.2% (LoCoMo)
N/A
Autorreportado
PersonaMem 76% (autorreportado)
~96.6% (autorreportado)
94.4% (autorreportado)
N/A
N/A (grep)
Captura automática
12 hooks (esforço manual zero)
Chamadas manuais a add()
O agente se autoedita
Manual
Extração no lado da API
Interceptação por proxy (troca de base-URL)
Manual
Extração via API
Manual
Edição manual
Busca
BM25 + Vector + Graph (fusão RRF)
Vector + Graph
Vector (archival)
Semântica
Vector + RAG
4 tipos de asset (Chat / Skill / Wiki / CodeGraph)
Somente vector
Vector + semântica
Ponderada por decaimento
Carrega tudo no contexto
Multiagente
MCP + REST + leases + signals
API (sem coordenação)
Somente dentro do runtime do Letta
Não
Não
Papéis de time + assets compartilhados
Não
Somente com escopo
Compartilhado multiagente
Arquivos por agente
Dependência de framework
Nenhuma (qualquer cliente MCP)
Nenhuma
Alta (precisa usar Letta)
Standalone
Nenhuma
Proxy na frente de toda chamada de modelo
Nenhuma
Oracle Database
Nenhuma
Formato por agente
Dependências externas
Nenhuma (SQLite + iii-engine)
Qdrant / pgvector
Postgres + BD vetorial
Várias
Nuvem gerenciada
Stack Docker (Core + Hub + Proxy)
Vector store
Oracle AI Database
Nenhuma
Nenhuma
Ciclo de vida da memória
Consolidação de 4 níveis + decaimento + auto-esquecimento
Extração passiva
Gerenciado pelo agente
Manual
Auto-esquecimento
Revisão manual; roteamento automático em andamento
Nenhum
Não informado
Decaimento + consolidação
Poda manual
Eficiência de tokens
~1,900 tokens/sessão ($10/ano)
Varia por integração
Memória principal no contexto
Varia
Precificação em nuvem
Não informado
Sem orçamento de tokens
Baseado em LLM (varia)
Varia
22K+ tokens em 240 observações
Viewer em tempo real
Sim (porta 3113)
Dashboard na nuvem
Dashboard na nuvem
Web UI
Dashboard na nuvem
Web UI do Hub
Não
Não
Não
Não
Self-hosted
Sim (padrão)
Opcional
Opcional
Sim
Não (somente nuvem)
Sim (Docker)
Sim
Sim (Oracle DB)
Sim
Sim
Nota de benchmark: apenas o R@5 do agentmemory é resultado medido por nós mesmos (LongMemEval-S, reproduzível a partir de benchmark/COMPARISON.md). Os números de mem0 e Letta são os números LoCoMo publicados por eles (um dataset diferente); os números de MemPalace, supermemory, TencentDB (PersonaMem) e oracleagentmemory são alegações autorreportadas dos fornecedores que não reproduzimos de forma independente (a execução do oracleagentmemory usou GPT-5.5 contra um Oracle AI Database). Mostrados lado a lado apenas como ordem de grandeza, não como comparação direta sobre dados idênticos. As contagens de stars são aproximadas e mudam com o tempo.
**Novos entrantes** que vale a pena conhecer, comparados em profundidade em [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md):
| Sistema | ⭐ | Abordagem |
|--------|---|-------|
| Zep / Graphiti | 30K | Grafo de conhecimento temporal; os resultados publicados mais fortes em queries temporais (LongMemEval 63.8%), mas o grafo é construído de forma assíncrona, então fatos recentes podem atrasar |
| Cognee | 30K | Ingestão de documento para grafo de conhecimento, somente Python, feito para extração estruturada de entidades em vez de captura de sessão |
Nenhum deles faz captura automática a partir de hooks de agentes de codificação, entrega um viewer local-first ou roda sem chave — a combinação em torno da qual o agentmemory foi construído.
---
Compatibilidade: esta versão usa `iii-sdk` 0.22.1 e fixa o iii-engine na v0.22.1.
### Teste em 30 segundos
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` semeia 3 sessões realistas (autenticação JWT, correção de query N+1, rate limiting) e roda buscas contra elas. Instalações sem chave desativam os vetores, então as buscas por palavra-chave do `mem::search` devem acertar via BM25, enquanto `database performance optimization` pode retornar zero. O `smart-search` também pode retornar correspondências estruturais do grafo quando existem dados de grafo. Para que a query semântica encontre a correção de N+1 via vetores, defina `EMBEDDING_PROVIDER=local`, reinicie e espere o primeiro download do modelo terminar.
Abra `http://localhost:3113` para acompanhar a memória sendo construída ao vivo.
### Valide uma instalação nova e a persistência ao reiniciar
Com o servidor em execução, valide o REST, o health, o viewer e o status do runtime baseado em iii:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
O painel de pronto de inicialização contabiliza as quatro portas: REST/MCP HTTP na 3111, streams do iii na 3112, o viewer na 3113 e o WebSocket do worker iii na 49134. `status` confirma a saúde do agentmemory e o provider/modo de embedding ativo. Salve uma sonda e confirme que ela é pesquisável:
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
Depois rode `npx -y @agentmemory/agentmemory@latest stop`, inicie novamente o comando canônico no Terminal 1, espere por `/agentmemory/livez` e repita a busca. A sonda deve continuar sendo retornada. Se você selecionou um `--data-dir` customizado, passe o mesmo diretório no reinício.
### Comandos do dia a dia
Instalação e setup estão em [Install](#install) acima (a primeira execução te guia por eles). No dia a dia:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### Replay de sessão
Toda sessão que o agentmemory grava é reproduzível. Abra o viewer, escolha a aba **Replay** e arraste pela timeline: prompts, chamadas a tools, resultados de tools e respostas renderizam como eventos discretos com play/pause, controle de velocidade (0.5x a 4x) e atalhos de teclado (espaço para alternar, setas para avançar passo a passo).
Para trazer transcripts JSONL mais antigos do Claude Code:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
Sessões importadas aparecem no seletor de Replay ao lado das nativas. Sob o capô, cada entrada passa pelas funções iii `mem::replay::load`, `mem::replay::sessions` e `mem::replay::import-jsonl`, sem servidores paralelos. Cada transcript importado é indexado para busca, carimbado com o canal de origem `import` e minerado para gerar um crystal de sessão e lessons.
> **Atenção se você depende do `import-jsonl` como caminho primário de captura:** o `cleanupPeriodDays` do Claude Code (em `~/.claude/settings.json`, padrão **30**) apaga automaticamente de `~/.claude/projects/` os transcripts JSONL mais antigos que essa janela. Se você instalar o agentmemory do zero sobre um histórico de Claude Code com meses de idade, tudo com mais de 30 dias já se foi antes do primeiro import. Rode `import-jsonl` em um cron, aumente `cleanupPeriodDays` para algo maior, ou conecte os hooks de captura automática (o caminho padrão de instalação do plugin) para que cada turno chegue ao agentmemory enquanto a sessão está viva e a limpeza dos JSONL deixe de importar.
### Upgrade / Manutenção
Use o comando de manutenção quando você quiser intencionalmente atualizar seu runtime local:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
Aviso: este comando altera o workspace/runtime atual. Ele pode atualizar dependências JavaScript e baixar a imagem Docker fixada `iiidev/iii:0.22.1`. Ele nunca instala um iii engine não fixado ou mais novo.
Detalhes de implementação estão em `src/cli.ts` (veja `runUpgrade` em torno da região `src/cli.ts:544-595`).
### Claude Code (um bloco só, cole e vá)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code sem instalar o plugin (caminho MCP standalone)
Se você cabear o servidor MCP do agentmemory via `~/.claude.json` diretamente em vez de usar `/plugin install`, o Claude Code nunca resolve `${CLAUDE_PLUGIN_ROOT}` e você tem que apontar os scripts de hook para caminhos absolutos em `~/.claude/settings.json`. Esses caminhos tipicamente embutem a versão do agentmemory (ex.: `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`), então a próxima atualização quebra silenciosamente todos os hooks.
Contorno:
```bash
agentmemory connect claude-code --with-hooks
```
Isso mescla os mesmos comandos de hook em `~/.claude/settings.json` com caminhos absolutos resolvidos para o diretório `plugin/` empacotado do pacote `@agentmemory/agentmemory` atualmente instalado. Rode o comando novamente após atualizar o agentmemory para atualizar os caminhos. Entradas de usuário no mesmo arquivo são preservadas; apenas entradas anteriores do agentmemory são substituídas. Usar o caminho `/plugin install` continua sendo a abordagem recomendada.
Para deploys remotos ou protegidos, inicie o Claude Code com `AGENTMEMORY_URL` e `AGENTMEMORY_SECRET` definidos. O plugin repassa ambos os valores para seu servidor MCP empacotado; quando `AGENTMEMORY_URL` está vazio, o shim MCP usa `http://localhost:3111`.
### Codex CLI (plataforma de plugins do Codex)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
O plugin do Codex é entregue a partir do mesmo diretório `plugin/` do plugin do Claude Code. Ele registra:
- Uma bridge MCP via stdio empacotada para o daemon em execução, sem download via npm nem armazenamento de fallback. Veja o [guia local do Codex](../docs/plugins/codex-local.md) para testar uma build ainda não lançada.
- 6 hooks de ciclo de vida: `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop`
- 9 skills invocáveis: `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, mais 8 skills de referência que o agente carrega sob demanda (disciplina de memória, tools MCP, REST API, config, agentes, hooks, arquitetura e o guia de autoria de skills)
A engine de hooks do Codex injeta `CLAUDE_PLUGIN_ROOT` nos subprocessos de hook (conforme [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)), então os mesmos scripts de hook funcionam nos dois hosts sem duplicação. Os eventos Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure são exclusivos do Claude Code e não são registrados para o Codex.
#### Confiança e compatibilidade dos hooks do Codex
O despacho nativo de hooks de plugin está verificado com o Codex CLI 0.150.1. Confie nos hooks do plugin antes de esperar captura. O comportamento no Desktop depende do runtime empacotado dele; verifique `/hooks` e confirme um evento capturado antes de habilitar um contorno.
Se o seu host exigir hooks globais, espelhe os comandos em `~/.codex/hooks.json`. Quando o MCP já está configurado, o conector atual precisa de `--force` para chegar à instalação dos hooks:
```bash
agentmemory connect codex --with-hooks --force
```
Isso mescla os hooks globais e reescreve a entrada MCP do agentmemory, preservando as entradas não relacionadas. Revise quaisquer configurações customizadas de endpoint do agentmemory antes de usar `--force`. Rode novamente após atualizar para atualizar os caminhos dos scripts. Habilite os hooks nativos do plugin ou as cópias globais para evitar captura duplicada.
### GitHub Copilot CLI
Para o modo agente do VS Code, use o [guia de MCP e captura automática do Copilot](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions). O conector do CLI não configura o VS Code.
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` mescla `mcpServers.agentmemory` em `~/.copilot/mcp-config.json` (ou `$COPILOT_HOME/mcp-config.json` quando `COPILOT_HOME` está definido) e preserva os servidores existentes. No Windows nativo este é o único adaptador `connect` automatizado; configure todo outro agente nativo do Windows manualmente. O `connect` no WSL só é suportado quando o agente de destino está instalado nesse mesmo ambiente WSL. O Copilot detecta o servidor MCP no próximo lançamento ou depois de `/mcp`. Instale o plugin também quando quiser a experiência completa de hooks/skills.
OpenClaw (cole este prompt)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
Guia completo: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (cole este prompt)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
Guia completo: [`integrations/hermes/`](../integrations/hermes/)
### Outros agentes
Inicie o servidor de memória: `npx -y @agentmemory/agentmemory@latest`
#### Skills nativas via `npx skills add` (50+ agentes)
agentmemory entrega 17 skills no formato `/SKILL.md` estilo Claude Code: 9 skills de ação invocáveis (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) e 8 skills de referência que o agente carrega sob demanda (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`). As skills de referência carregam tabelas de dados geradas a partir do código-fonte, então nunca ficam defasadas. O CLI [`skills`](https://npmjs.com/package/skills) da vercel-labs as instala automaticamente no diretório nativo de skills do agente chamador em 50+ agentes (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf e mais):
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
Isso é **complementar** a `agentmemory connect `:
- `agentmemory connect ` escreve a configuração do servidor MCP para que as tools fiquem disponíveis.
- `npx skills add rohitg00/agentmemory` instala as skills para que o agente saiba quando chamá-las.
Para os poucos agentes que o CLI de skills ainda não cobre (Zed v1.3.x e anteriores), coloque você mesmo os 17 arquivos SKILL.md no diretório nativo de skills do agente; o mesmo formato funciona em todo lugar.
#### Bloco MCP padrão
A entrada do agentmemory é o **mesmo bloco de servidor MCP** em todo host que usa o formato `mcpServers` (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw):
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**Mescle esta entrada no objeto `mcpServers` existente** no arquivo de configuração do host; não substitua o arquivo. Se o arquivo já tem outros servidores, adicione `agentmemory` ao lado deles como outra chave dentro de `mcpServers`. Se `mcpServers` não existir, cole o bloco dentro de `{ "mcpServers": { ... } }`. Os placeholders `${VAR}` herdam `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` do shell no momento em que o servidor MCP sobe; variáveis não definidas passam string vazia e o shim cai para `http://localhost:3111`. Uma única entrada cabeada cobre tanto deploys locais quanto remotos (k8s / com reverse-proxy).
| Agente | Arquivo de config | Notas |
|---|---|---|
| **Cursor (somente MCP)** | `~/.cursor/mcp.json` | Mescle em `mcpServers`, ou `agentmemory connect cursor`. Deeplink de um clique também disponível no site. |
| **Cursor (plugin completo)** | `.cursor-plugin/` | Listagem no Cursor Marketplace (submissão em análise) ou Cursor Settings → Plugins → checkout local. Registra 7 hooks de captura automática (sessionStart, beforeSubmitPrompt, preToolUse, postToolUse, postToolUseFailure, stop, sessionEnd) + 17 skills + o servidor MCP, com `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` gerenciados no dashboard de plugins do Cursor. Funciona na IDE do Cursor e no CLI `cursor-agent`; prompts do modo print do CLI são preenchidos retroativamente a partir do transcript da sessão no fim da sessão. |
| **Claude Desktop** | `claude_desktop_config.json` (Application Support) | Mescle em `mcpServers`. Reinicie o Claude Desktop depois de editar. |
| **Cline / Roo Code / Kilo Code** | Configurações MCP do Cline (Settings UI → MCP Servers → Edit) | Mesmo bloco `mcpServers`. |
| **Devin CLI (MCP + hooks)** | `~/.config/devin/config.json` | `agentmemory connect devin` mescla a entrada MCP; `--with-hooks` adiciona seis hooks nativos de captura automática (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) com os matchers de ferramentas em minúsculas do Devin. Verifique com `devin mcp list` e `/hooks` dentro do devin. |
| **Devin CLI (plugin completo)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` a partir de um checkout registra todas as 17 skills como slash commands `/agentmemory:` mais o servidor MCP. Hooks de plugin do Devin não conseguem disparar `SessionStart`/`SessionEnd`, então combine com `connect devin --with-hooks` para captura completa de sessão. |
| **Devin (cloud)** | Settings → Connections → MCP servers | Adicione um MCP customizado (STDIO): comando `npx`, args `-y @agentmemory/mcp@latest`, env `AGENTMEMORY_URL` apontando para um deploy do agentmemory alcançável pela rede, mais `AGENTMEMORY_SECRET` (sessões na cloud não conseguem alcançar localhost — veja [`deploy/`](../deploy/)). Guarde o secret nos Devin Secrets, depois use "Test listing tools" para verificar que as 54 tools aparecem. |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (mescla automaticamente). |
| **GitHub Copilot CLI (somente MCP)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` mescla `mcpServers.agentmemory`; o Copilot detecta no próximo lançamento ou em `/mcp`. |
| **GitHub Copilot CLI (plugin completo)** | Instalação de plugin do Copilot | `copilot plugin install rohitg00/agentmemory:plugin` para o plugin a partir do subdiretório do GitHub. |
| **OpenClaw** | Configuração MCP do OpenClaw | Mesmo bloco `mcpServers`. Mais profundo: `openclaw plugins install ./integrations/openclaw` reivindica o slot de memória do OpenClaw (alterna automaticamente de `memory-core`); defina `plugins.entries.agentmemory.hooks.allowConversationAccess=true` ou a captura de turnos fica bloqueada silenciosamente. Veja [`integrations/openclaw`](../integrations/openclaw/). |
| **Codex CLI (somente MCP)** | `.codex/config.toml` | Formato TOML: `codex mcp add agentmemory -- npx -y @agentmemory/mcp`, ou adicione `[mcp_servers.agentmemory]` manualmente. |
| **Codex CLI (plugin completo)** | Marketplace de plugins do Codex | `codex plugin marketplace add rohitg00/agentmemory` e depois `codex plugin add agentmemory@agentmemory`. Registra MCP + 6 hooks de ciclo de vida + 17 skills. Confie nos hooks e verifique a captura no seu host; veja [configuração e validação do Codex](../docs/plugins/codex-local.md). |
| **OpenCode (somente MCP)** | `opencode.json` | Formato diferente: chave de nível superior `mcp`, comando como array: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`. |
| **OpenCode (plugin completo)** | `plugin/opencode/` | 22 hooks de captura automática cobrindo ciclo de vida de sessão, mensagens, tools e erros. A atribuição de projeto é por sessão, então um único processo do OpenCode abrangendo vários repositórios arquiva cada sessão sob o próprio projeto. Dois slash commands (`/recall`, `/remember`). Copie `plugin/opencode/` para o seu workspace do OpenCode e adicione a entrada do plugin em `opencode.json`. Veja [`plugin/opencode/README.md`](../plugin/opencode/README.md) para a tabela completa de hooks + análise de gaps. |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` instala a extensão empacotada no diretório de auto-descoberta do pi (recall no início do agente, captura no fim do agente, tools `memory_search` / `memory_save` / `memory_health`, `/agentmemory-status`). `/reload` em um pi em execução reconhece a extensão. [`integrations/pi`](../integrations/pi/) também é um pacote pi (`pi install ./integrations/pi` a partir de um checkout). |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` ativa o memory provider de 6 hooks (prefetch, captura de turnos, fim de sessão, pré-compressão, espelhamento do MEMORY.md, bloco de system prompt). Valide com `hermes plugins doctor` e `hermes memory status`. Veja [`integrations/hermes`](../integrations/hermes/). |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` escreve o bloco `mcpServers` padrão. O payload dos hooks é compatível em nível de campo com o Claude Code, então os scripts dos 12 hooks existentes funcionam sem modificação; conecte-os via a seção `hooks` do mesmo `settings.json`. |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` instala o MCP e os hooks de captura no diretório de customização compartilhado. Veja [configuração e limites do Antigravity](../docs/plugins/antigravity.md). |
| **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` usa a mesma configuração de MCP e hooks das versões atuais do IDE. Instalações existentes devem atualizar com `--force`; veja as [notas de atualização](../docs/plugins/antigravity.md). |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` escreve a configuração no nível de usuário. Overrides de workspace vão em `.kiro/settings/mcp.json` ao lado do seu código. |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` escreve o bloco `mcpServers` padrão. O Warp também auto-descobre skills de `.claude/skills/`; instalado o plugin do Claude Code, as 8 skills do agentmemory (`remember`, `recall`, `recap`, `handoff`, `forget`, `commit-context`, `commit-history`, `session-history`) aparecem nativamente na paleta de slash commands do Warp. |
| **Cline (CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` escreve o bloco `mcpServers` padrão. Usuários da extensão do VS Code: cole o mesmo bloco via Cline Settings → MCP Servers → Edit JSON. |
| **Continue.dev** | `~/.continue/config.yaml` (preferido) ou `config.json` (legado) | `agentmemory connect continue` cria `config.yaml` do zero quando nenhum dos dois existe, ou modifica o `config.json` existente. **Se você já tem `config.yaml`**, o adaptador imprime o bloco exato para colar sob `mcpServers:`; ele não reescreve seu yaml silenciosamente porque preservar comentários e anchors com segurança precisa de um parser YAML que o pacote não inclui. O Continue usa forma de array (não objeto) para `mcpServers`. |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` escreve sob `context_servers` (a chave do Zed, NÃO `mcpServers`). Servidores MCP remotos podem ser cabeados via `{"url": "..."}` em vez disso. |
| **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` escreve o bloco `mcpServers` padrão. Overrides com escopo de projeto vão em `/.factory/mcp.json`. Passe `--with-hooks` para captura automática nativa. |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` acrescenta uma linha `@deepseek-ai/dsh-mcp-client` à camada de patch no nível do home que todo perfil do Harness carrega; as tools se registram como `mcp__agentmemory__*`. Passe `--with-hooks` para também conectar a captura automática: os scripts de hook do Claude Code empacotados rodam pela bridge first-party `@deepseek-ai/dsh-hooks-claude-code` do Harness (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop) via um manifesto escrito em `$DSH_HOME/agentmemory.hooks.json`. O padrão é `~/.dsh` quando `DSH_HOME` não está definido. |
| **Goose** | UI de configurações MCP do Goose | Mesmo bloco `mcpServers`; use `goose configure` → Add Extension → MCP. Edição direta do YAML em `~/.config/goose/config.yaml` é suportada, mas o schema usa `extensions:` + `cmd` (não `mcpServers:` + `command`). |
| **Aider** | n/a | Fale direto com a REST API: `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`. |
| **Qualquer agente (32+)** | n/a | `npx skillkit install agentmemory` autodetecta o host e mescla. |
**Clientes MCP em sandbox** (Flatpak / Snap / containers restritivos) que não conseguem alcançar o `localhost` do host: defina também `"AGENTMEMORY_FORCE_PROXY": "1"` no bloco `env`, e aponte `AGENTMEMORY_URL` para uma rota que o sandbox consiga de fato alcançar (por exemplo, o IP da sua LAN).
### Acesso programático (Python / Rust / Node)
agentmemory registra suas operações principais como funções iii (`mem::remember`, `mem::observe`, `mem::context`, `mem::smart-search`, `mem::forget`). Qualquer linguagem com um SDK iii pode chamá-las diretamente via `ws://localhost:49134`, sem um cliente REST separado por linguagem.
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
Exemplo prático: [`examples/python/`](../examples/python/) (quickstart + fluxo de observação/recall). A REST na `:3111` continua disponível para hosts sem runtime iii.
### A partir do código-fonte
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
Isso inicia o agentmemory com um `iii-engine` local se o binário fixado já estiver instalado, ou usa o Docker Compose quando selecionado. REST, streams e o viewer fazem bind em `127.0.0.1` por padrão. O caminho automático de binário no macOS/Linux exige `curl`, um `sh` POSIX e `tar`.
Instale o `iii-engine` manualmente. **O agentmemory atualmente fixa o `iii-engine` em `v0.22.1`**, o mesmo release da sua dependência `iii-sdk`; o worker fala o protocolo de wire desse engine, e a 0.20.0 reorganizou a superfície do SDK, então os dois avançam juntos a cada release do agentmemory. Sobrescreva com `AGENTMEMORY_III_VERSION=` se você roda seu próprio engine e sabe que ele corresponde.
- **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64:** troque `aarch64-apple-darwin` por `x86_64-apple-darwin`
- **Linux x64:** troque por `x86_64-unknown-linux-gnu`
- **Linux arm64:** troque por `aarch64-unknown-linux-gnu`
- **Windows:** baixe `iii-x86_64-pc-windows-msvc.zip` de [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) e extraia o `iii.exe` para `%USERPROFILE%\.agentmemory\bin\iii.exe`
Todo arquivo tem um `.sha256` correspondente na página do release; ao trocar a plataforma, use o hash desse arquivo na verificação acima (no Windows: `Get-FileHash`). O instalador automático em `npx @agentmemory/agentmemory` fixa esses hashes e recusa um arquivo que não corresponda.
Ou use Docker (o `docker-compose.yml` empacotado baixa `iiidev/iii:0.22.1`). Documentação completa: [iii.dev/docs](https://iii.dev/docs).
### Windows
agentmemory roda no Windows 10/11, mas o pacote Node.js sozinho não é suficiente; você também precisa do runtime fixado do iii-engine v0.22.1 como processo em segundo plano. O CLI não extrai automaticamente o ZIP do Windows, então usuários do Windows nativo precisam instalar o `iii.exe` manualmente, usar o WSL2 ou escolher o Docker Desktop.
A instalação automatizada nativa de MCP no Windows suporta apenas `agentmemory connect copilot-cli`. Para Claude Code, Codex, Cursor e todo outro agente nativo do Windows, copie o bloco MCP manual de [Outros agentes](#other-agents) para a configuração desse agente no Windows. Rodar `connect` no WSL só é apropriado quando o agente de destino também está instalado nesse mesmo ambiente WSL; isso não edita a configuração de um agente que roda no host Windows.
**Opção A: binário Windows pré-compilado (recomendado)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**Opção B: Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**Opção C: somente MCP standalone (sem engine).** Se você só precisa das tools MCP para o seu agente e não precisa da REST API, do viewer ou dos cron jobs, pule o engine completamente:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**Diagnóstico para Windows:** se `npx -y @agentmemory/agentmemory@latest` falhar, rode de novo com `--verbose` para ver o stderr real do engine. Modos de falha comuns:
| Sintoma | Correção |
|---|---|
| `The engine process started but the REST API never responded.` | Confirme que as quatro portas derivadas estão livres, verifique que o `iii.exe` fixado continuou vivo, depois rode de novo com `--verbose` e inspecione o stderr capturado do engine |
| `Could not start iii-engine` | Nem o `iii.exe` nem o Docker estão instalados. Veja a Opção A ou B acima |
| Conflito de porta | `netstat -ano \| findstr :3111` para ver o que está em uso, depois mate o processo ou use `--port ` |
| Fallback para Docker pulado mesmo com o Docker instalado | Garanta que o Docker Desktop esteja realmente em execução (ícone na bandeja do sistema) |
> Nota: o **engine** do iii é um binário pré-compilado, não um crate cargo, então não tente dar `cargo install` nele. (Os **SDKs** do iii são publicados no crates.io, npm e PyPI, mas o agentmemory não precisa deles.) Os métodos de instalação do engine suportados estão todos fixados na v0.22.1: o binário pré-compilado acima, o caminho de auto-instalação do agentmemory para macOS/Linux (exige `curl`, `sh` POSIX e `tar`), e a imagem Docker `iiidev/iii:0.22.1`. Um `install.sh | sh` puro do upstream instala a versão mais recente do engine, que o agentmemory não suporta. Use `npx -y @agentmemory/agentmemory@latest`; no macOS/Linux ele busca o engine fixado para `~/.agentmemory/bin`.
---
Deploy
Templates de um clique para hosts gerenciados. Cada um entrega um
Dockerfile autocontido que baixa `@agentmemory/agentmemory` do npm e
copia o binário do engine iii de dentro da imagem Docker oficial
`iiidev/iii` do Docker Hub; nenhuma imagem pré-construída do
agentmemory é necessária. O armazenamento persistente monta em
`/data`; o entrypoint de primeiro boot sobrescreve a configuração do
iii empacotada no npm (que faz bind em `127.0.0.1`) com uma ajustada
para deploy que faz bind em `0.0.0.0` e usa caminhos `/data`
absolutos, gera o secret HMAC e então solta os privilégios de `root`
para `node` via `gosu` antes de executar o CLI do agentmemory.
O botão de deploy de um clique do Render exige um `render.yaml` na raiz do repositório, que deliberadamente mantemos limpa. Use o fluxo de Render Blueprint documentado em [`deploy/render/`](.././deploy/render/README.md) para apontar manualmente para o blueprint que já está no repositório.
Detalhes completos de setup (captura de HMAC, túnel SSH do viewer,
rotação, backup, pisos de custo) ficam em [`deploy/`](.././deploy/README.md):
- [`deploy/fly`](.././deploy/fly/README.md): uma única máquina com
`auto_stop_machines = "stop"`; a mais barata quando ociosa.
- [`deploy/railway`](.././deploy/railway/README.md): taxa fixa do plano
Hobby, volume no dashboard.
- [`deploy/render`](.././deploy/render/README.md): fluxo de Blueprint,
snapshots automáticos de disco nos planos pagos.
- [`deploy/coolify`](.././deploy/coolify/README.md): self-hosted na sua
própria VPS via [Coolify](https://coolify.io/self-hosted); mesma
stack Docker Compose, você é dono do host e dos dados.
Apenas a porta `3111` é publicada. O viewer na `3113` fica em bind no
loopback dentro do contêiner; o README de cada template documenta o
padrão de túnel SSH para alcançá-lo.
---
Todo agente de codificação esquece tudo quando a sessão termina, e cada nova sessão começa com você re-explicando sua stack. agentmemory roda em segundo plano e remove essa etapa.
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### vs memória integrada do agente
Todo agente de codificação com IA vem com memória integrada: Claude Code tem `MEMORY.md`, Cursor tem notepads, Cline tem memory bank. Elas funcionam como post-its. agentmemory é o banco de dados pesquisável por trás dos post-its.
| | Integrada (CLAUDE.md) | agentmemory |
|---|---|---|
| Escala | Teto de 200 linhas | Ilimitado |
| Busca | Carrega tudo no contexto | BM25 + vector + graph (somente top-K) |
| Custo em tokens | 22K+ em 240 observações | ~1,900 tokens (92% menos) |
| Entre agentes | Arquivos por agente | MCP + REST (qualquer agente) |
| Coordenação | Nenhuma | Leases, signals, actions, routines |
| Observabilidade | Leitura manual de arquivos | Viewer em tempo real na :3113 |
---
### Pipeline de memória
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### Consolidação de memória em 4 níveis
Modelada em como o cérebro humano processa memória, incluindo a consolidação do sono.
| Nível | O quê | Analogia |
|------|------|---------|
| **Working** | Observações brutas do uso de tools | Memória de curto prazo |
| **Episodic** | Resumos de sessão comprimidos | "O que aconteceu" |
| **Semantic** | Fatos e padrões extraídos | "O que eu sei" |
| **Procedural** | Workflows e padrões de decisão | "Como fazer" |
As memórias decaem com o tempo (curva de Ebbinghaus). Memórias acessadas com frequência se reforçam. Memórias obsoletas são evictadas automaticamente. Contradições são detectadas e resolvidas.
### O que é capturado
| Hook | Captura |
|------|----------|
| `SessionStart` | Caminho do projeto, ID da sessão |
| `UserPromptSubmit` | Prompts do usuário (filtrados por privacidade) |
| `PreToolUse` | Padrões de acesso a arquivos + contexto enriquecido |
| `PostToolUse` | Nome da tool, entrada, saída |
| `PostToolUseFailure` | Contexto de erro |
| `PreCompact` | Reinjeta memória antes da compactação |
| `SubagentStart/Stop` | Ciclo de vida de sub-agentes |
| `Stop` | Resumo de fim de sessão |
| `SessionEnd` | Marcador de sessão completa |
### Principais capacidades
| Capacidade | Descrição |
|---|---|
| **Captura automática** | Todo uso de tool registrado via hooks, sem esforço manual |
| **Busca semântica** | BM25 + vector + grafo de conhecimento com fusão RRF |
| **Evolução de memória** | Versionamento, supersessão, grafos de relacionamento |
| **Higiene de recall** | Versões supersedidas de memória saem dos índices de busca; a cadeia de versões no KV mantém o histórico completo |
| **Dicas de quase-duplicata** | Saves reportam uma correspondência consultiva `similarTo` quando o conteúdo novo se parece muito com uma memória existente |
| **Escopo por agente** | `agentId` atravessa save e recall em REST, MCP e no índice de busca, em modo shared ou isolated |
| **Provenance em tempo de escrita** | Toda observação e memória carrega um canal de origem imutável (user, agent, tool, import ou shared) carimbado na captura, no save e no import |
| **Auto-esquecimento** | Expiração por TTL, detecção de contradição, eviction por importância |
| **Privacidade antes de tudo** | API keys, secrets e tags `` são removidos antes do armazenamento |
| **Self-healing** | Circuit breaker, cadeia de fallback de providers, monitoramento de saúde |
| **Bridge com o Claude** | Sincronização bidirecional com o MEMORY.md |
| **Grafo de conhecimento** | Extração de entidades + travessia BFS |
| **Memória de time** | Compartilhada e privada com namespace entre membros do time |
| **Provenance de citação** | Rastreia qualquer memória de volta às observações de origem |
| **Snapshots do git** | Versiona, reverte e faz diff do estado da memória |
---
Recuperação em stream triplo, combinando três sinais:
| Stream | O que faz | Quando |
|---|---|---|
| **BM25** | Correspondência por palavra-chave com stemming e expansão de sinônimos | Sempre ativo |
| **Vector** | Similaridade de cosseno sobre embeddings densos | Provider de embedding configurado |
| **Graph** | Travessia do grafo de conhecimento via correspondência de entidades | Entidades detectadas na query |
Combinados com Reciprocal Rank Fusion (RRF, k=60) e diversificados por sessão (máximo 3 resultados por sessão).
Quando um índice vetorial está populado, o `mem::search` (por trás do `memory_recall`) usa o ranker híbrido BM25 + vector. Sem embeddings ele usa BM25. O `smart-search` pode ainda combinar correspondências estruturais do grafo quando existem dados de grafo, inclusive no modo sem chave. O recall de lessons roda sobre um índice BM25 dedicado em memória, em vez de escanear todo o corpus a cada query. Versões supersedidas de memória são excluídas de todo caminho de recall; a cadeia de versões mantém o histórico delas.
Vetores sobrevivem a um crash ou force-kill. O índice vetorial é salvo em buckets no máximo a cada `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS` (10 minutos). Todo vetor adicionado ou removido nesse meio tempo também é gravado imediatamente em um pequeno log pendente no state store, e o próximo início o reproduz sem chamar o provider de embedding. Cada save bem-sucedido esvazia o log. Documentos que ainda não têm vetor depois da reprodução são re-embeddados em segundo plano em lotes de `AGENTMEMORY_VECTOR_BACKFILL_MAX` (500) até que não reste nenhum, e um backfill interrompido continua no próximo início. `/agentmemory/status` e o viewer mostram o tamanho do log pendente e o estado do backfill. Instalações sem chave não escrevem nada.
O BM25 tokeniza grego, cirílico, hebraico, árabe e latim acentuado nativamente. Para memórias em chinês / japonês / coreano, instale os segmentadores opcionais (`npm install @node-rs/jieba tiny-segmenter`) para dividir sequências CJK em tokens no nível de palavra; sem eles, o agentmemory cai graciosamente para tokenização da sequência inteira e imprime uma dica única no stderr.
### Providers de embedding
Instalações sem chave desativam os embeddings vetoriais: o `mem::search` usa BM25, enquanto o `smart-search` também pode usar dados estruturais de grafo já existentes. Para optar por embeddings semânticos gratuitos e no dispositivo, adicione isto a `~/.agentmemory/.env` e reinicie o agentmemory:
```env
EMBEDDING_PROVIDER=local
```
A instalação normal via npm inclui o runtime opcional `@huggingface/transformers`. A primeira requisição de embedding baixa o `Xenova/all-MiniLM-L6-v2`, então precisa de acesso à rede e pode demorar mais; a inferência seguinte roda no dispositivo. Providers remotos são detectados automaticamente a partir de suas chaves, a menos que `EMBEDDING_PROVIDER` as sobrescreva.
| Provider | Modelo | Custo | Notas |
|---|---|---|---|
| **Local (opt-in recomendado)** | `all-MiniLM-L6-v2` | Gratuito | No dispositivo após o primeiro download do modelo, +8pp de recall sobre BM25 sozinho |
| Gemini | `gemini-embedding-001` | Camada gratuita | 100+ idiomas, dimensões 768/1536/3072 (MRL), entrada de 2048 tokens. Substitui o `text-embedding-004` ([descontinuado, desligamento em 14 de jan. de 2026](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | $0.02/1M | Maior qualidade |
| Voyage AI | `voyage-code-3` | Pago | Otimizado para código |
| Cohere | `embed-english-v3.0` | Trial gratuito | Uso geral |
| OpenRouter | Qualquer modelo | Varia | Proxy multi-modelo |
---
54 tools, 6 resources, 3 prompts e 17 skills.
> **Shim MCP vs servidor completo:** o pacote publicado `@agentmemory/mcp` é um shim fino. Ele expõe a superfície completa de 54 tools **somente quando consegue alcançar um servidor agentmemory em execução** via `AGENTMEMORY_URL` (modo proxy). Sem nenhum servidor acessível, o shim cai para um conjunto local de 7 tools (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`). A env var `AGENTMEMORY_TOOLS=core|all` é uma flag do *lado do servidor*; defini-la no bloco `env` do shim não tem efeito. Se você vê apenas 7 tools no Cursor / OpenCode / Gemini CLI, inicie `npx -y @agentmemory/agentmemory@latest` (ou a stack Docker) e defina `AGENTMEMORY_URL=http://localhost:3111`.
### 54 Tools
Três superfícies de tools, da menor para a maior: `AGENTMEMORY_TOOLS=core` reduz a visibilidade a 8 essenciais (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`); o conjunto base abaixo são as 14 tools fundamentais do registry; o padrão (`AGENTMEMORY_TOOLS=all`) expõe todas as 54.
Tools base (14)
| Tool | Descrição |
|------|-------------|
| `memory_recall` | Busca observações passadas |
| `memory_compress_file` | Comprime arquivos markdown preservando a estrutura |
| `memory_save` | Salva um insight, decisão ou padrão |
| `memory_file_history` | Observações passadas sobre arquivos específicos |
| `memory_patterns` | Detecta padrões recorrentes |
| `memory_sessions` | Lista sessões recentes |
| `memory_smart_search` | Busca híbrida semântica + palavra-chave |
| `memory_vision_search` | Busca observações de imagem |
| `memory_timeline` | Observações em ordem cronológica |
| `memory_profile` | Perfil do projeto (conceitos, arquivos, padrões) |
| `memory_export` | Exporta todos os dados de memória |
| `memory_relations` | Consulta o grafo de relacionamento |
| `memory_commit_lookup` | Sessões por trás de um commit git |
| `memory_commits` | Commits registrados para uma sessão |
Tools estendidas (54 no total, a superfície padrão)
| Tool | Descrição |
|------|-------------|
| `memory_patterns` | Detecta padrões recorrentes |
| `memory_timeline` | Observações em ordem cronológica |
| `memory_relations` | Consulta o grafo de relacionamento |
| `memory_graph_query` | Travessia do grafo de conhecimento |
| `memory_consolidate` | Executa a consolidação de 4 níveis |
| `memory_claude_bridge_sync` | Sincroniza com o MEMORY.md |
| `memory_team_share` | Compartilha com membros do time |
| `memory_team_feed` | Itens compartilhados recentes |
| `memory_audit` | Trilha de auditoria das operações |
| `memory_governance_delete` | Deleta com trilha de auditoria |
| `memory_snapshot_create` | Snapshot versionado com git |
| `memory_action_create` | Cria work items com dependências |
| `memory_action_update` | Atualiza o status de uma action |
| `memory_frontier` | Actions desbloqueadas, ranqueadas por prioridade |
| `memory_next` | A próxima action mais importante, uma só |
| `memory_lease` | Leases exclusivos de action (multiagente) |
| `memory_routine_run` | Instancia routines de workflow |
| `memory_signal_send` | Mensageria entre agentes |
| `memory_signal_read` | Lê mensagens com confirmação de recebimento |
| `memory_checkpoint` | Gates de condição externa |
| `memory_mesh_sync` | Sync P2P entre instâncias |
| `memory_sentinel_create` | Watchers orientados a evento |
| `memory_sentinel_trigger` | Dispara sentinels externamente |
| `memory_sketch_create` | Grafos de action efêmeros |
| `memory_sketch_promote` | Promove a permanente |
| `memory_crystallize` | Compacta cadeias de action |
| `memory_diagnose` | Checagens de saúde |
| `memory_heal` | Corrige automaticamente estado travado |
| `memory_facet_tag` | Tags dimensão:valor |
| `memory_facet_query` | Consulta por facet tags |
| `memory_verify` | Rastreia provenance |
### 6 Resources · 3 Prompts · 17 Skills
| Tipo | Nome | Descrição |
|------|------|-------------|
| Resource | `agentmemory://status` | Saúde, contagem de sessões, contagem de memórias |
| Resource | `agentmemory://project/{name}/profile` | Inteligência por projeto |
| Resource | `agentmemory://project/{name}/recent` | Observações recentes de um projeto |
| Resource | `agentmemory://memories/latest` | As 10 memórias ativas mais recentes |
| Resource | `agentmemory://graph/stats` | Estatísticas do grafo de conhecimento |
| Resource | `agentmemory://team/{id}/profile` | Perfil de time compartilhado |
| Prompt | `recall_context` | Busca + retorna mensagens de contexto |
| Prompt | `session_handoff` | Dados de handoff entre agentes |
| Prompt | `detect_patterns` | Analisa padrões recorrentes |
| Skill | `/recall` | Busca na memória |
| Skill | `/remember` | Salva na memória de longo prazo |
| Skill | `/session-history` | Resumos de sessões recentes |
| Skill | `/forget` | Deleta observações/sessões |
A tabela mostra as quatro skills principais. O conjunto completo é de 9 skills invocáveis mais 8 skills de referência; veja a seção de skills nativas acima.
### MCP standalone
Rode sem o servidor completo, para qualquer cliente MCP. Qualquer uma destas opções funciona:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
Ou adicione à configuração MCP do seu agente:
A maioria dos agentes (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
Mescle a entrada `agentmemory` no objeto `mcpServers` já existente do seu host, em vez de substituir o arquivo. Para clientes em sandbox que não conseguem alcançar o `localhost` do host, adicione `"AGENTMEMORY_FORCE_PROXY": "1"` ao bloco `env` e defina `AGENTMEMORY_URL` para uma rota que o sandbox consiga alcançar.
OpenCode (`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
Copie o arquivo do plugin a partir do repositório:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---
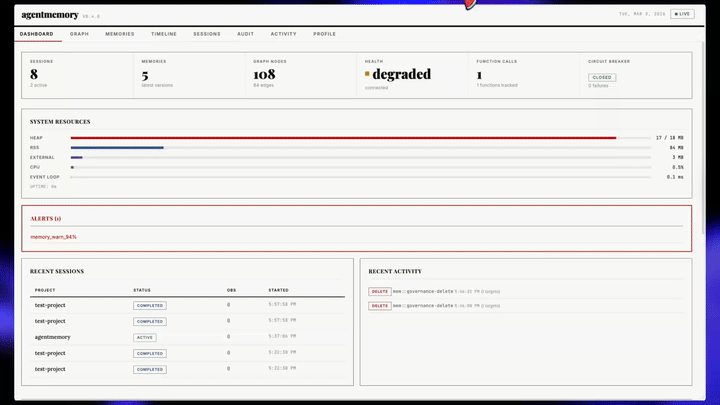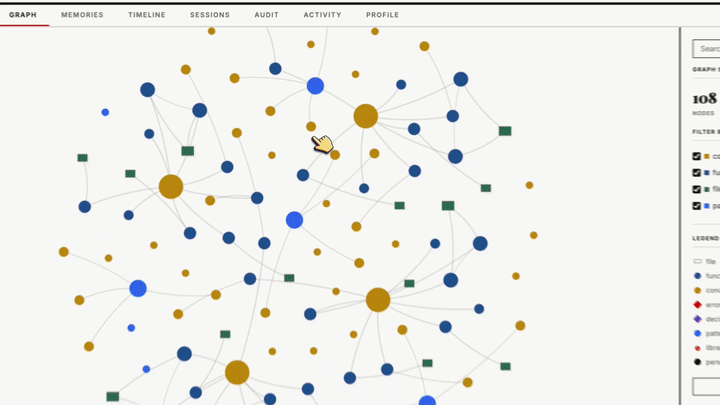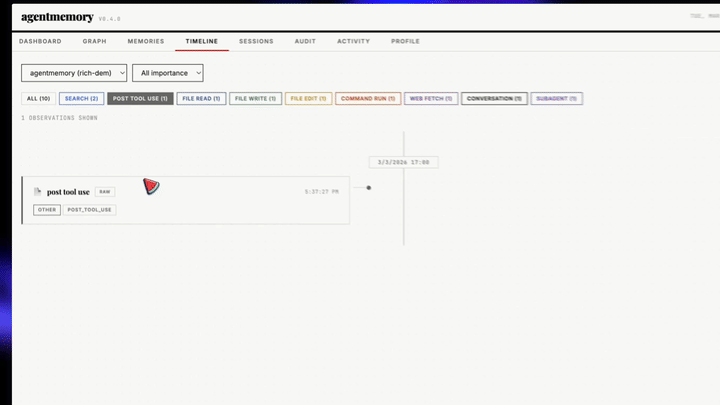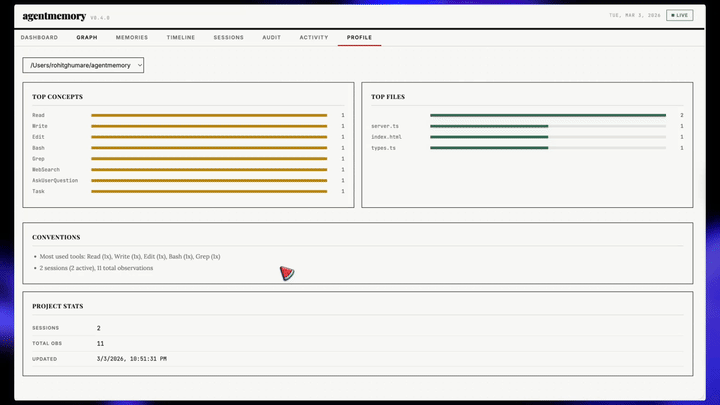
Inicia automaticamente na porta `3113`. O viewer carrega um snapshot quando se conecta (`GET /agentmemory/viewer/snapshot`) e depois aplica eventos de stream ao vivo: novas memórias, lessons, observações, entradas de auditoria, mudanças no grafo e atualizações de saúde aparecem sem polling ou recarregamento de página. As únicas outras requisições são as ações que você clica, páginas de "carregar mais" e buscas. Quando o stream cai, o viewer mostra há quanto tempo seus números estão desatualizados, reconecta com backoff e resincroniza a partir de um snapshot.
- **12 abas em quatro grupos** com contagens ao vivo, deep links (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), atalhos de teclado e um menu mobile.
- **Memories:** busca no lado do servidor, filtros por projeto, agente e tipo, um painel de detalhe com a cadeia de versões e um diff de palavras, links de provenance, botões de copiar para o id, a chamada MCP e um comando curl, editar (uma nova versão), forget com confirmação, forget em massa e export em JSON.
- **Sessions:** uma timeline inline de observações com entrada e saída de tool legíveis, filtros e paginação, e as memórias e lessons que cada sessão produziu.
- **Graph:** busca, detalhe do node com relações e fontes, uma legenda que não depende só de cor, e controles de zoom.
- **Health:** a versão ao vivo de `GET /agentmemory/status`. Todo problema vem com a sua correção, mais o backend de estado, o estado de save do índice, o progresso de compactação de provenance do grafo e um explicador de consolidação com os thresholds reais.
- **Páginas Audit, Activity, Profile, Replay, Lessons, Actions e Crystals**, cada uma com um estado vazio que explica o que a seção é, por que está vazia e o comando que a preenche, e um tooltip `?` de glossário em todo termo e número.
```bash
open http://localhost:3113
```
O servidor do viewer faz bind em `127.0.0.1` por padrão e anexa o secret do servidor quando repassa requisições para a REST API, então ele não precisa de nenhum setup. O endpoint `/agentmemory/viewer` servido via REST segue as regras normais de bearer-token e redireciona navegadores sem token para a porta do viewer. Os headers CSP usam um nonce de script por resposta e desabilitam atributos de handler inline (`script-src-attr 'none'`).
---
O viewer na `:3113` mostra o que o seu agente **lembrou**. O [iii console](https://iii.dev/docs/console) mostra o que o seu agente **fez**: toda operação de memória como um trace OpenTelemetry, toda entrada KV editável, toda função invocável, todo stream "tappable". Duas janelas sobre a mesma memória: uma no formato de produto, outra no formato de engine.
Veja um `memory_smart_search` disparar e acompanhe o scan de BM25 → lookup de embedding → fusão RRF → reranker como um waterfall. Edite um timer de consolidação travado no navegador de KV. Reproduza um hook `PostToolUse` com um payload ajustado. Fixe o stream WebSocket e veja as observações chegando ao vivo.
agentmemory entrega isso de graça porque toda chamada de função e trigger dispara através do iii; nada custom, nada para instrumentar.
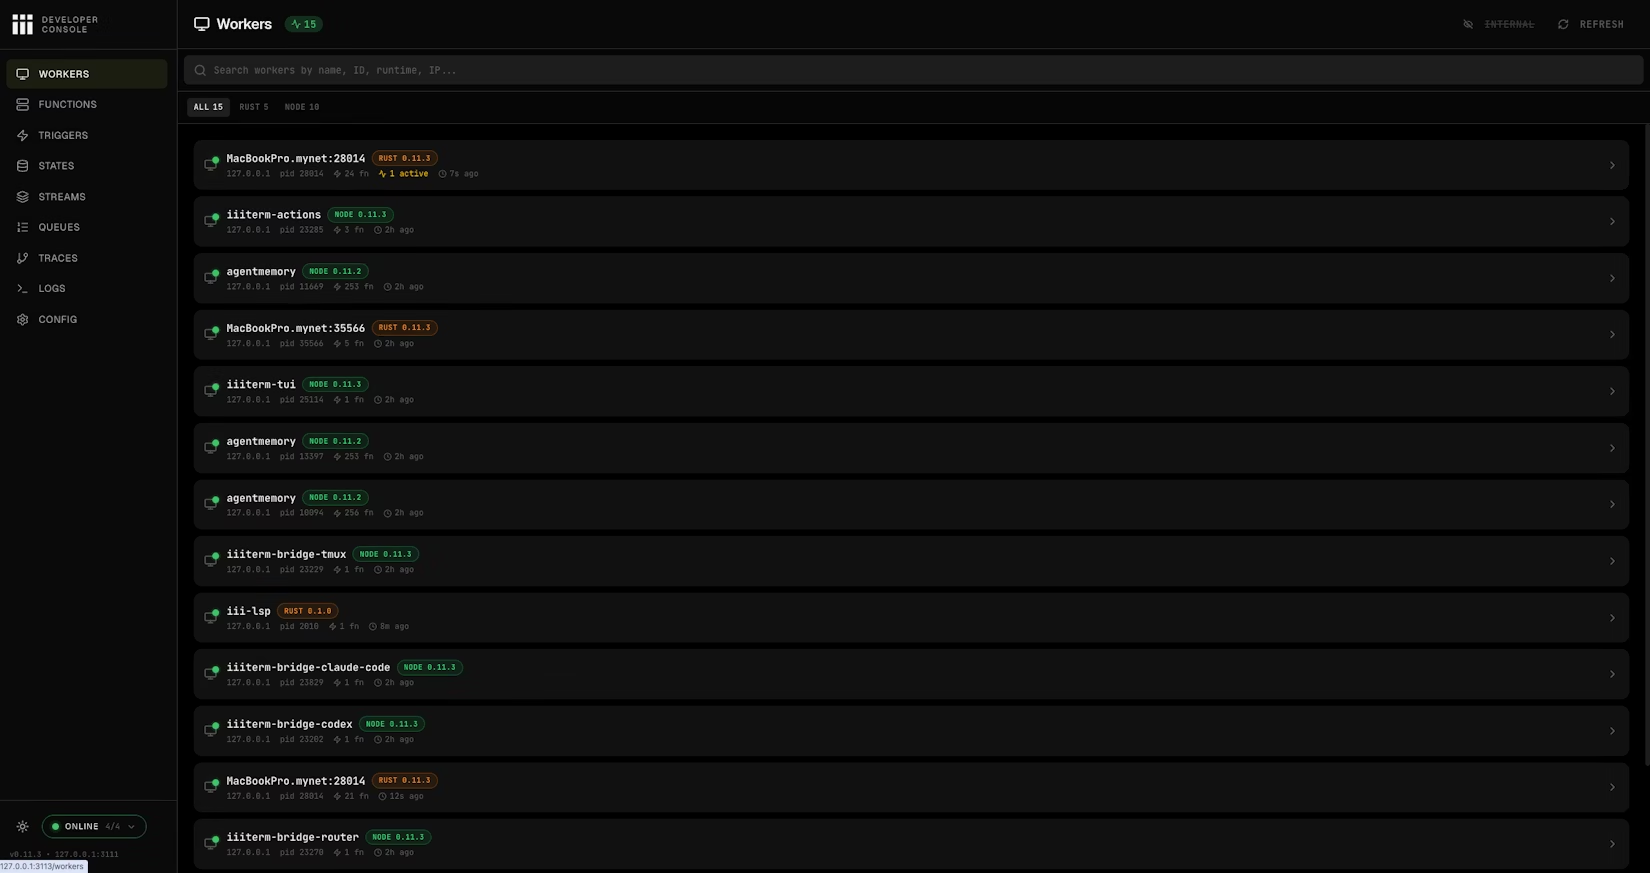
Página Workers: todo worker conectado, incluindo o próprio agentmemory, com PID, contagem de funções, runtime e last-seen.
**Já instalado.** O console vem junto com o engine `iii` fixado (0.22+); nada separado para instalar. O primeiro lançamento baixa o binário do console ao lado do engine.
**Lançando junto com o agentmemory:**
```bash
agentmemory console
```
Isso roda o `iii console` do engine fixado contra as portas que o agentmemory resolveu (REST, streams, bridge) e o serve uma porta acima do viewer, `http://localhost:3114` por padrão. `--console-port N` escolhe outra porta; `--port` e `--instance` selecionam a instância do agentmemory do mesmo jeito que fazem para `stop`; qualquer outra flag é repassada, por exemplo `--enable-flow` para a página experimental de grafo de arquitetura.
A mesma coisa na mão, útil quando `agentmemory` não está no PATH:
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**O que você pode fazer a partir do console:**
| Página | Use para |
|------|-----------|
| **Workers** | Ver todo worker conectado e suas métricas ao vivo, incluindo o próprio worker do agentmemory. |
| **Functions** | Invocar qualquer função do agentmemory diretamente com um payload JSON; prático para testar `memory.recall`, `memory.consolidate`, `graph.query` sem cabear um cliente. |
| **Triggers** | Reproduzir triggers HTTP, cron, event e state: disparar o cron de consolidação manualmente, reexecutar uma rota HTTP, emitir uma mudança de estado. |
| **States** | Navegador de KV com CRUD completo sobre sessões, slots de memória, timers de ciclo de vida e o índice de embeddings; edite valores no lugar. |
| **Streams** | Monitor de WebSocket ao vivo para escritas de memória, eventos de hook e atualizações de observação conforme fluem pelos streams do iii. |
| **Queues** | Tópicos de queue duráveis + gerenciamento de dead-letter. Reproduza ou descarte jobs falhos de embedding / compressão. |
| **Traces** | Vistas waterfall / flame / breakdown por serviço do OpenTelemetry. Filtre por `trace_id` para ver exatamente quais funções, chamadas a DB e requisições de embedding um único `memory.search` produziu. |
| **Logs** | Logs OTEL estruturados, filtrados e correlacionados a trace/span IDs. |
| **Config** | Configuração de runtime: veja exatamente com quais workers, providers e portas o seu engine está rodando. |
| **Flow** | (Opcional, `--enable-flow`) Grafo de arquitetura interativo de todo worker, trigger e stream. |
Traces: waterfall / flame / breakdown por serviço para toda operação de memória.
**Os traces já vêm ativados:**
O `iii-config.yaml` vem com o worker `iii-observability` habilitado (`exporter: memory`, `sampling_ratio: 0.1`, métricas + logs). Sem config extra necessária; no momento em que o agentmemory inicia, toda operação de memória emite um log estruturado que o console consegue ler, e uma em cada dez delas (`sampling_ratio: 0.1`) também emite um trace span.
Se você quiser exportar para Jaeger/Honeycomb/Grafana Tempo em vez disso, troque `exporter: memory` por `exporter: otlp` e configure o endpoint do collector conforme a documentação de observabilidade do iii.
> **Atenção:** nenhuma autenticação é aplicada no próprio console; mantenha-o em bind em `127.0.0.1` (o padrão) e nunca o exponha publicamente.
---
agentmemory **já é uma instância [iii](https://iii.dev) em execução**. Três primitivos (worker, function, trigger) compõem o runtime; estado KV, streams e traces OTEL vêm dos workers iii-state, iii-stream e iii-observability que acompanham o iii. Você não instalou Postgres, Redis, Express, pm2 ou Prometheus, porque o iii os substitui.
Isso significa que mais um comando estende o agentmemory com uma capacidade inteiramente nova.
### Estenda o agentmemory com mais workers
Os builtins de que o agentmemory precisa já estão no `iii-config.yaml` e sobem junto com ele: `iii-state` (KV), `iii-queue` (retries duráveis para os subscribers de evento), `iii-pubsub`, `iii-cron`, `iii-stream` e `iii-observability` (traces, métricas e logs OTEL em toda função). Qualquer outra coisa do [registry de workers do iii](https://workers.iii.dev) se conecta ao mesmo engine: copie `iii-config.yaml` para `~/.agentmemory/iii-config.yaml` (o CLI prefere esse arquivo em vez do empacotado, e ainda renderiza portas e caminhos de dados dentro dele), adicione a entrada, instale o runtime do worker uma vez com `~/.agentmemory/bin/iii update worker`, e reinicie o agentmemory.
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | O que você ganha além do agentmemory |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | Adaptador de estado com backend SQL para quando você crescer além dos padrões de KV em memória |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | Código que saiu do `memory_recall` roda dentro de uma VM descartável, não no seu shell |
| [`mcp`](https://workers.iii.dev/workers/mcp) | Suba servidores MCP extras ao lado dos do agentmemory, compartilhando o mesmo engine |
Na engine 0.22.x mantenha os nomes com prefixo `iii-` para os builtins acima; as entradas sem prefixo `http`, `state`, `queue`, `pubsub` e `cron` são os workers standalone do registry para os quais o agentmemory migra com a 0.23.
Registry completo: [workers.iii.dev](https://workers.iii.dev). Todo worker lá compõe através dos mesmos primitivos que o agentmemory usa, e o agentmemory que você já tem é um deles.
### Config do engine e endereço de bind
`agentmemory start` lê a config do engine a partir do primeiro arquivo que existir: `AGENTMEMORY_III_CONFIG`, `./iii-config.yaml` no diretório atual, `~/.agentmemory/iii-config.yaml`, depois o `iii-config.yaml` empacotado. A cada início, ele renderiza esse arquivo (caminhos de dados, portas, backend de estado) em `~/.agentmemory/data/iii-config.runtime.yaml` e lança o engine com a cópia renderizada, então edite o arquivo de origem, não o renderizado. Os valores de `host:` do arquivo de origem são mantidos como escritos.
O `iii-config.yaml` empacotado faz bind em `127.0.0.1` de propósito, e esse padrão também se aplica dentro de um contêiner. Um CLI iniciado em um contêiner escuta no loopback do contêiner, então as portas publicadas não alcançam nada. Para servir um CLI containerizado através de portas publicadas, defina `AGENTMEMORY_III_CONFIG` para uma config que faça bind em `0.0.0.0`. O `iii-config.docker.yaml` empacotado é uma delas: ele faz bind do `iii-http`, do `iii-stream` e da porta do engine em `0.0.0.0` e guarda o estado em `/data`, então monte um volume gravável lá. Mantenha `AGENTMEMORY_SECRET` definido, e publique apenas as portas que você precisa, em `127.0.0.1` ou por trás de um proxy em que você confie.
O `docker-compose.yml` deste repositório não passa pela busca de config do CLI: ele monta `iii-config.docker.yaml` em `/app/config.yaml`, e o contêiner `iii-engine` inicia com `--config /app/config.yaml`. Os [templates de deploy](../deploy/) de um clique escrevem a própria config `0.0.0.0` em seus entrypoints.
### Backend de armazenamento: file (padrão) vs redis
`iii-state` e `iii-stream` usam por padrão o store KV baseado em arquivo embutido no iii-engine: um arquivo JSON por scope, mantido na memória do processo do engine e reescrito em disco em um timer. Esse é o padrão certo para uma instalação local de um único usuário; um daemon compartilhado com vários escritores concorrentes ganha escritas reais por chave do Redis em vez disso, ao custo de uma viagem de rede por operação (toda chamada `state::*` ainda serializa em uma única conexão Redis, então isso troca o lock do store de arquivo por um socket, não por paralelismo).
Defina `AGENTMEMORY_STATE_BACKEND=redis` (mais `AGENTMEMORY_REDIS_URL`) para trocar os dois workers para o adaptador `redis` embutido no iii-engine, que guarda cada chave como um campo de hash do Redis (`HSET`) em vez de reescrever um scope inteiro a cada escrita:
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` tem como padrão `file`; deixá-lo indefinido mantém o comportamento de hoje sem mudanças, e um valor não reconhecido (qualquer coisa além de `file` ou `redis`) é um erro de inicialização, não um fallback silencioso. `/agentmemory/status` e a página Health do viewer (a linha State store) informam qual backend está ativo e se ele está respondendo, nunca a URL.
**Somente `redis://` puro.** O engine fixado (0.22.1) compila seu cliente Redis sem suporte a TLS, então uma URL `rediss://` (a maioria das ofertas de Redis gerenciado, como Upstash, Redis Cloud e ElastiCache com criptografia em trânsito, vêm por padrão somente com TLS) falha ao conectar. A conexão não é criptografada, então a senha do Redis e toda memória armazenada cruzam a rede em texto claro: aponte para um Redis local ou um em uma rede privada em que você confie. Para qualquer outro Redis, rode um túnel criptografado (stunnel, SSH ou uma VPN) no host do agentmemory, de modo que o salto `redis://` puro fique nesse host e a conexão upstream do túnel seja criptografada e autenticada. Se uma senha do Redis contiver um apóstrofo, codifique-o em percent-encoding (`%27`); o engine expande a URL dentro da sua config YAML antes de analisá-la.
**Um servidor Redis por `--instance`.** Os prefixos de chave Redis do engine (`state:`, `stream::`) são fixos, então duas instâncias do agentmemory (`--instance 1`, `--instance 2`, ...) apontando para o mesmo banco de dados sobrescrevem os dados uma da outra. Um índice de banco separado (`redis://localhost:6379/1`) mantém os dados armazenados separados, mas o engine retransmite os eventos do viewer em tempo real por um único canal pub/sub do Redis (`stream::events`), e o pub/sub do Redis ignora o índice do banco, então o viewer de cada instância ainda mostraria os eventos ao vivo da outra. Dê a cada instância seu próprio servidor Redis (ou porta) quando você rodar mais de uma.
**O que permanece igual, e o que muda.** Todo recurso do agentmemory funciona no Redis: sessões, observações, memórias (remember, supersede, evolve, forget), busca e os buckets de índice, lessons, o grafo, o log de auditoria e seus scopes mensais, export e import, governance deletes, status de consolidação, o snapshot do viewer e seu stream ao vivo, e o monitor de saúde. O engine guarda cada scope como um hash do Redis (`HSET`/`HGET`/`HGETALL`) e dispara os mesmos state triggers que o store de arquivo. Três diferenças do engine são tratadas dentro do agentmemory:
- O Redis retorna os registros de um scope em nenhuma ordem fixa. O agentmemory os ordena do mais antigo para o mais novo (pelo horário de criação no id do registro, depois pelo seu timestamp), então listas, paginação e chunks de export vêm de volta na mesma ordem que no store de arquivo.
- O engine aplica updates parciais no Redis em um script Lua que transforma arrays vazios em objetos vazios. O agentmemory aplica esses updates ele mesmo (lê, muda, escreve sob um lock por chave) no Redis, então campos como `tags: []` continuam sendo arrays.
- A checagem do log de auditoria legado lê o scope antigo do Redis em vez de procurar o arquivo do store de arquivo em disco.
Uma diferença exige ação sua: **depois que o Redis reinicia, o engine para de retransmitir eventos ao vivo** para o viewer até que o agentmemory reinicie. Os dados continuam sendo salvos e lidos normalmente. O monitor de saúde envia um evento de teste pelo Redis a cada 30 segundos; quando ele não volta, `/agentmemory/status` e a página Health do viewer mostram "Live updates are not reaching the viewer" com a correção: reinicie o agentmemory. Se o Redis estiver fora do ar, o relatório de status mostra "The state store is not answering" e como checar isso (`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`). Listar um scope muito grande lê o hash inteiro em um único `HGETALL`, o mesmo custo do store de arquivo mantendo-o em memória.
**Configurações de Redis recomendadas.** A política de snapshot padrão `save 3600 1 300 100 60 10000` pode perder minutos de escritas em um crash, pior que a janela de flush de 5s do store de arquivo. Defina `appendonly yes` para qualquer coisa que você se importaria em perder. Defina `maxmemory-policy noeviction`; `allkeys-lru` ou similar descarta memórias silenciosamente quando o Redis atinge seu limite de memória.
Um início nativo (sem Docker), e todo [template de deploy](../deploy/) de um clique (eles sobrescrevem o `iii-config.yaml` empacotado e iniciam nativamente), leem `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` e os renderizam na `iii-config` lançada. A própria URL nunca é escrita nesse arquivo renderizado, apenas uma referência `${AGENTMEMORY_REDIS_URL}` que o processo do engine expande a partir do seu próprio ambiente no boot. Somente o caminho de Docker Compose deste próprio repositório (`AGENTMEMORY_USE_DOCKER=1`, ou retomando um engine já iniciado desse jeito) monta `iii-config.docker.yaml` como somente leitura e nunca renderiza; `agentmemory start` avisa quando detecta essa combinação. Troque esse arquivo manualmente, seguindo o mesmo formato `name: redis` / `config: redis_url: ...` mostrado na documentação dos workers [iii-state](https://workers.iii.dev/workers/iii-state) e [iii-stream](https://workers.iii.dev/workers/iii-stream), e aponte `redis_url` para um Redis alcançável a partir do contêiner. O `docker-compose.yml` passa `AGENTMEMORY_REDIS_URL` para o contêiner do engine, então `redis_url: '${AGENTMEMORY_REDIS_URL}'` funciona lá e mantém a URL fora do arquivo montado.
A config renderizada mantém a URL fora de `~/.agentmemory/data/iii-config.runtime.yaml`, mas o próprio worker de configuração do engine ainda persiste o valor *expandido* em `~/.agentmemory/config/iii-state.yaml` e `iii-stream.yaml` depois que ele sobe (a expansão `${VAR}` do iii-engine acontece antes desse worker guardar seu seed, e ele guarda o valor resolvido, não a referência). Trate esse diretório como se guardasse uma credencial: `chmod 700 ~/.agentmemory` em qualquer host compartilhado, e prefira um usuário ACL do Redis com escopo no que o agentmemory precisa, em vez das credenciais de admin do banco.
**A migração não é automática.** Trocar `AGENTMEMORY_STATE_BACKEND` começa de um store vazio em ambos os lados; nada copia os dados existentes de file para Redis ou vice-versa. Exporte do backend que você está deixando e importe para aquele para o qual você está indo. Isto roda de forma idêntica em bash e zsh (incluindo `bash -u`). Um array como `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` não roda: o zsh mantém o header como uma única palavra malformada onde o bash o divide em duas, então ambas as requisições recebem 401 sempre que `AGENTMEMORY_SECRET` está definido:
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` também aceita `?maxSessions=` e `?offset=` para dividir um corpus grande em várias chamadas; `strategy` no import é `merge` (seguro por padrão), `replace` ou `skip`.
### O que o iii substitui
| Stack tradicional | agentmemory usa |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + índice vetorial em memória |
| SSE / Socket.io | iii Streams (WebSocket) |
| pm2 / systemd | Supervisão de worker do engine iii |
| Prometheus / Grafana | iii OTEL + monitor de saúde |
| Sistemas de plugin customizados | `iii worker add ` |
**219 arquivos de código · ~52,000 LOC · 2,500+ testes · 311 funções · 60 escopos KV**, tudo em cima de três primitivos. Sem `agentmemory plugin install`. O sistema de plugins é o próprio iii.
---
### Providers de LLM
agentmemory detecta providers automaticamente a partir do seu ambiente. Um provider libera operações baseadas em LLM, mas a configuração de um provider por si só não ativa a compressão de observações escrita por LLM. Esse caminho exige tanto um provider quanto `AGENTMEMORY_AUTO_COMPRESS=true`.
| Provider | Config | Notas |
|----------|--------|-------|
| **No-op (padrão)** | Nenhuma config necessária | Compress/summarize baseados em LLM ficam desativados. Compressão sintética e recall via BM25 continuam funcionando. Veja `AGENTMEMORY_ALLOW_AGENT_SDK` abaixo se você costumava depender do fallback via assinatura Claude. |
| API Anthropic | `ANTHROPIC_API_KEY` | Cobrança por token |
| MiniMax | `MINIMAX_API_KEY` | Compatível com Anthropic |
| Gemini | `GEMINI_API_KEY` | Também ativa embeddings |
| OpenRouter | `OPENROUTER_API_KEY` | Qualquer modelo |
| API OpenAI | `OPENAI_API_KEY` | Padrão `gpt-5.6-luna`, sobrescreva com `OPENAI_MODEL` |
| **Local (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) ou `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | Qualquer coisa compatível com a API da OpenAI. Custo zero, roda no seu hardware. Veja [Modelos locais](#local-models-ollama--lm-studio--vllm) abaixo. |
| Fallback de assinatura Claude | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | Somente opt-in. Dispara sessões do `@anthropic-ai/claude-agent-sdk`; costumava causar recursão sem limite no Stop hook, então deixou de ser o padrão. |
### Modelos locais (Ollama / LM Studio / vLLM)
agentmemory fala com qualquer servidor compatível com a API da OpenAI, então qualquer coisa que exponha `/v1/chat/completions` funciona sem mudanças de código. Sem chaves pagas, sem nuvem, sem rate limits; roda inteiramente no seu hardware.
**Ollama** (porta padrão `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio** (porta padrão `1234`):
Abra o LM Studio → aba Local Server → Start Server. Escolha qualquer modelo de chat no seletor (Qwen 3, gpt-oss, DeepSeek R1, etc.).
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**: mesmo formato. Aponte `OPENAI_BASE_URL` para a URL que o seu servidor expõe e defina `OPENAI_MODEL` para um nome que o seu servidor vai aceitar.
**Escolhas de modelo para trabalho de memória**: compressão e sumarização são tarefas curtas (<2K tokens de entrada, <500 tokens de saída) onde um modelo instruct de 7B já é suficiente. Recomendações:
| Modelo | Tamanho | Por quê |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | Padrão equilibrado numa máquina de 16 GB; forte em extração e texto no formato de tool |
| `qwen3:4b` | ~2.6 GB | Menor opção sensata; ok para compressão, mais fraco para extração de grafo |
| `qwen3-coder:30b` | ~19 GB | Melhor escolha local para sessões no formato de código (30B MoE, 3.3B ativo) em hardware de 24-32 GB |
| `gpt-oss:20b` | ~14 GB | Modelo geral forte que cabe em 16 GB de RAM |
| `deepseek-r1:8b` | ~5.2 GB | Distill de raciocínio; mais lento, mas com extrações mais limpas |
Os modelos Qwen 3 pensam por padrão e podem queimar todo o token budget em raciocínio antes de qualquer saída. Defina `AGENTMEMORY_LLM_NOTHINK=1` para anexar `/no_think` aos prompts de extração de grafo, e aumente `MAX_TOKENS` (16384 funciona) se as extrações voltarem vazias.
Modelos da classe reasoning (estilo `o1` com blocos ``) podem retornar `content` vazio com um campo `reasoning` que o seu servidor local pode não expor. Se as extrações voltarem vazias, troque primeiro para um modelo sem reasoning. A env `OPENAI_REASONING_EFFORT=none` também pode desativar o thinking em modelos de thinking do Ollama Cloud que espelham o schema de reasoning da OpenAI.
Embeddings locais vêm como uma dependência opcional, mas não são ativados por padrão. Defina `EMBEDDING_PROVIDER=local` para optar pelo `Xenova/all-MiniLM-L6-v2` (384 dim). A primeira requisição de embedding baixa o modelo; a inferência fica no dispositivo depois disso. Sem essa configuração ou uma chave de embedding remota, os vetores ficam desativados, o `mem::search` usa BM25, e o `smart-search` ainda pode adicionar correspondências de grafo já existentes.
### Seleção de modelo com consciência de custo
Quando a compressão em segundo plano escrita por LLM está ativada, com tanto um provider quanto `AGENTMEMORY_AUTO_COMPRESS=true`, ela roda em toda observação, então a escolha do modelo muda de forma significativa o gasto mensal. Dados de carga capturados: 635 requisições / 888K tokens / 35 horas de uso ativo, rodados contra três modelos do OpenRouter com os preços de 2026-05-23.
| Nível | Modelo | Entrada / 1M | Saída / 1M | Custo das 35h capturadas | Notas |
|------|-------|------------|-------------|---------------------------|-------|
| Recomendado | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07 (est.) | DeepSeek mais recente; a escolha recomendada mais barata para cargas de compressão. |
| Recomendado | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | Boa qualidade de compressão + sumarização a ~10x menos custo que o Sonnet. |
| Recomendado | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | Raciocínio de código forte se suas sessões forem bastante no formato de código. |
| Premium | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02 (est.) | Mesmo preço de tabela da execução medida com o Sonnet 4.6; preço de lançamento de $2/$10 até 2026-08-31. |
| Premium | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9 (est.) | Nível flagship; caro para trabalho sempre ativo em segundo plano. |
| Evitar | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40 (est.) | Modelo de classe flagship; gasto excessivo para compressão. |
As linhas medidas vêm da execução capturada; as linhas (est.) escalam a mesma mistura de tokens pelo preço de tabela de cada modelo.
agentmemory imprime um aviso em runtime quando `OPENROUTER_MODEL` corresponde a um padrão de nível premium. Defina `AGENTMEMORY_SUPPRESS_COST_WARNING=1` para silenciar isso depois que você tiver feito uma escolha informada.
Tradeoff de qualidade vs custo para trabalho de memória: compressão é uma tarefa de sumarização com padrões de qualidade relativamente soltos (o agente relê o resumo, não o usuário). DeepSeek V4 Flash / V4 Pro / Qwen3-Coder ficam dentro da margem de erro do Sonnet nessa tarefa, custando 10-70x menos. Guarde os modelos de nível premium para queries que você lê diretamente.
Fontes: [preços do OpenRouter para o Claude Sonnet 5](https://openrouter.ai/anthropic/claude-sonnet-5), [DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731), [notas de preços da DeepSeek](https://api-docs.deepseek.com/quick_start/pricing/).
### Memória multiagente (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
Em setups multiagente onde vários papéis compartilham um único servidor agentmemory (architect / developer / reviewer / researcher / support-agent), `AGENT_ID` marca toda escrita com o papel que a fez. `AGENTMEMORY_AGENT_SCOPE` controla se o recall filtra por essa tag.
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
Dois modos:
| Modo | Marca escritas | Filtra recall | Quando usar |
|------|------------|---------------|-------------|
| `shared` (padrão) | sim | não | Contexto entre agentes com trilha de auditoria. O architect pode ver o que o developer anotou, mas toda linha registra quem disse o quê. |
| `isolated` | sim | sim | Separação estrita. O architect nunca vê as observações / memórias / sessões do developer. |
O que é marcado quando `AGENT_ID` está definido: `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId`. O papel flui de `api::session::start` → `mem::observe` → `mem::compress` → KV.
O que é filtrado no modo isolated: `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions`. Cada endpoint aceita `?agentId=` para sobrescrever por requisição, e `?agentId=*` para sair do escopo do env por completo. `/memories` também aceita `?includeOrphans=true` para mostrar memórias pré-AGENT_ID cujo `agentId` é undefined.
Override por chamada na camada SDK / REST: todo endpoint mutador (`/session/start`, `/remember`) aceita um campo `agentId` no body da requisição que vence o env. Útil para runtimes que roteiam muitos papéis por um único processo de servidor. A tool MCP `memory_save` expõe o mesmo campo `agentId`, o servidor stdio standalone repassa tanto `agentId` quanto `project`, e memórias salvas carregam `agentId` para o índice de busca, então a busca com escopo de agente cobre memórias além de observações.
Quando `AGENT_ID` não está definido, a memória permanece sem escopo (comportamento legado, sem tags, sem filtros).
### Portas
agentmemory + iii-engine fazem bind em quatro portas por padrão. Se um reinício falhar com `port in use`, esta tabela diz qual processo procurar.
| Porta | Processo | Finalidade | Override de env |
|------|---------|---------|--------------|
| `3111` | agentmemory | REST API + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | Worker interno de streams (consumido pelo agentmemory + viewer) | `III_STREAM_PORT` (preferido) ou o legado `III_STREAMS_PORT` |
| `3113` | agentmemory | Viewer em tempo real (`http://localhost:3113`) | `III_VIEWER_PORT` ou `AGENTMEMORY_VIEWER_URL` para a URL reportada |
| `49134` | iii-engine | WebSocket; workers se registram aqui, a telemetria OTel flui por aqui | `III_ENGINE_PORT` ou `III_ENGINE_URL` |
`--port ` muda a âncora REST e deriva streams em `N+1`, viewer em `N+2` e o WebSocket do engine em `N+46023`, só onde a porta ou URL explícita correspondente acima não estiver definida. Isso não cria um namespace isolado de ciclo de vida. Use `--instance 1` para um segundo daemon; ele usa a âncora 3211, com padrão `3211/3212/3213/49234`, e recebe um diretório separado de dados e ciclo de vida `instance-1`. As instâncias de 1 a 50 seguem o mesmo padrão.
O engine fixado inicia com `--no-update-check` (sem buscas de update ou aviso de segurança contra o GitHub no boot) e com a telemetria de uso anônima do iii desativada: agentmemory define `III_TELEMETRY_ENABLED=false` para o engine que ele dispara, a menos que você mesmo exporte a variável, e o compose file empacotado faz o mesmo.
Limpeza de processo obsoleto quando as portas continuam em uso depois de uma execução que travou:
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` recolhe tanto o worker quanto o pidfile do engine de forma limpa, num shutdown gracioso e nativo. No modo Docker, ele esvazia o worker nativo, para exatamente o contêiner do engine validado, e preserva tanto o contêiner quanto seu mount `/data` para um reinício sem perdas; o próximo início valida e retoma esse mesmo contêiner. A desinstalação com backend Docker exige `agentmemory remove --keep-data`: ela remove os arquivos compartilhados gerenciados pelo agentmemory preservando o contêiner validado, seu mount de dados e o registro de ciclo de vida necessário para recuperá-los. A deleção destrutiva de dados do Docker é deixada intencionalmente para o operador, depois de um backup. O CLI também se recusa a adotar ou sinalizar processos Docker ou de VM segurando portas (Docker backend, vpnkit, colima) como se fossem o engine nativo, a menos que `--force` seja passado. A limpeza manual acima só serve para o caso pós-crash em que nenhum pidfile foi deixado para trás.
### Arquivo de config
Coloque a configuração de runtime do agentmemory em `~/.agentmemory/.env` em vez de exportar variáveis em todo shell. Se o viewer mostrar uma dica de setup como `export ANTHROPIC_API_KEY=...`, copie-a para esse arquivo como `ANTHROPIC_API_KEY=...`, sem o prefixo `export`, e então reinicie o agentmemory.
Variáveis de ambiente do processo continuam funcionando e têm precedência sobre valores no arquivo.
No Windows, o mesmo arquivo mora em `%USERPROFILE%\.agentmemory\.env`:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
Para testar com uma assinatura Claude Code Pro/Max em vez de uma API key, opte por isso explicitamente:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
A compressão de observações escrita por LLM exige as duas linhas: acesso a um provider de LLM (incluindo este fallback explícito de assinatura) e `AGENTMEMORY_AUTO_COMPRESS=true`. Um provider por si só deixa o caminho padrão de compressão sintética no lugar.
A consolidação (nodes de grafo, lessons, crystals) vem ativada por padrão sempre que um provider de LLM está configurado. Desative explicitamente com `CONSOLIDATION_ENABLED=false` se você quiser operação sem LLM. A extração de grafo é uma flag separada:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### Variáveis de ambiente
Crie `~/.agentmemory/.env`:
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---
138 endpoints na porta `3111`. A REST API faz bind em `127.0.0.1` por padrão. Endpoints protegidos exigem `Authorization: Bearer `, e endpoints de mesh sync exigem um `AGENTMEMORY_SECRET` explicitamente definido em ambos os peers.
**A autenticação vem ativada por padrão.** Quando `AGENTMEMORY_SECRET` não está definido (no shell ou em `~/.agentmemory/.env`), o servidor gera um secret aleatório no primeiro início e o guarda em `~/.agentmemory/secret` com modo `0600`. Todo cliente empacotado o lê de lá quando fala com um servidor local: o CLI, o viewer, os hooks em `plugin/scripts`, o servidor MCP e o shim `@agentmemory/mcp`, as configs escritas por `agentmemory connect`, e as integrações empacotadas de OpenCode, Pi, OpenClaw, Hermes e filesystem-watcher. O secret guardado só é enviado para URLs de loopback (`localhost`, `127.0.0.0/8`, `::1`). Um `AGENTMEMORY_SECRET` explícito sempre prevalece, e clientes remotos ainda precisam dele definido. O Docker e os entrypoints de `deploy/` já geram e exportam o próprio secret. Para chamar a API manualmente:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**Regras de requisição para escritas.** Requisições `POST`, `PUT`, `PATCH` e `DELETE` para a REST API e o viewer devem enviar `Content-Type: application/json` (um parâmetro `charset` não tem problema) sempre que carregarem um body, e um header `Origin`, quando presente, deve ser uma origem de loopback para a porta REST ou do viewer configurada, ou estar listado em `VIEWER_ALLOWED_ORIGINS` (separado por vírgulas, por exemplo `https://memory.example.com`). Clientes que não enviam header `Origin` (CLI, hooks, MCP, curl, servidor-para-servidor) não são afetados. O viewer também aceita sua própria origem.
**Caminhos de arquivo.** Endpoints que leem ou escrevem arquivos (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`) só aceitam caminhos dentro de `~/.agentmemory`, do diretório de dados da instância, ou de um diretório listado em `AGENTMEMORY_IMPORT_ROOT` (separe vários com `:`, ou `;` no Windows). `/replay/import-jsonl` também aceita seu padrão `~/.claude/projects`. `/obsidian/export` fica dentro de `AGENTMEMORY_EXPORT_ROOT` e `/migrate` dentro de `~/.agentmemory`. Symlinks são resolvidos antes de toda checagem.
**Limpeza de secrets.** API keys, bearer tokens, blocos de chave privada PEM e credenciais embutidas em URLs (`scheme://user:password@host`) são redigidas antes de o texto ser armazenado, em todo caminho de escrita: observations, remember, evolve, slots, lessons, actions, sketches, signals, checkpoints, imports, jsonl replay, mesh sync, team shares, saída de compressão e resumo, crystals e nodes de grafo.
Endpoints principais
| Método | Caminho | Descrição |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | Health check (sempre público) |
| `GET` | `/agentmemory/status` | O que está errado e como corrigir (HTML para navegadores, JSON para o resto) |
| `GET` | `/agentmemory/viewer/snapshot` | Tudo o que o viewer mostra, em uma única resposta |
| `POST` | `/agentmemory/session/start` | Inicia sessão + obtém contexto |
| `POST` | `/agentmemory/session/end` | Finaliza sessão |
| `POST` | `/agentmemory/observe` | Captura observação (veja a entrega de captura abaixo) |
| `GET` | `/agentmemory/capture` | Inbox de captura, dead letters e spool offline |
| `POST` | `/agentmemory/capture/retry` | Tenta de novo as capturas em dead-letter |
| `POST` | `/agentmemory/capture/drain` | Envia agora o spool offline local |
| `POST` | `/agentmemory/smart-search` | Busca híbrida |
| `POST` | `/agentmemory/context` | Gera contexto |
| `POST` | `/agentmemory/remember` | Salva na memória de longo prazo |
| `POST` | `/agentmemory/forget` | Deleta observações |
| `POST` | `/agentmemory/enrich` | Contexto de arquivo + memórias + bugs |
| `GET` | `/agentmemory/profile` | Perfil do projeto |
| `GET` | `/agentmemory/export` | Exporta todos os dados |
| `POST` | `/agentmemory/import` | Importa a partir de JSON |
| `POST` | `/agentmemory/graph/query` | Consulta ao grafo de conhecimento |
| `POST` | `/agentmemory/graph/compact` | Reduz provenance de grafo superdimensionada |
| `POST` | `/agentmemory/team/share` | Compartilha com o time |
| `GET` | `/agentmemory/audit` | Trilha de auditoria |
Lista completa de endpoints: [`src/triggers/api.ts`](../src/triggers/api.ts)
**Entrega de captura.** Os hooks enviam cada observação uma única vez para `POST /agentmemory/observe` com um `eventId`. Esse id é o próprio id do host para a chamada, quando o payload tem um (por exemplo, o `tool_use_id` do Claude Code), ou então um hash da sessão, tipo de hook, nome da tool, entrada, saída e timestamp do host. O servidor grava o evento em um inbox de captura no state store, armazena a observação e então remove a entrada do inbox. O status code diz o que aconteceu:
| Status | Campo `status` | Significado |
|---|---|---|
| `201` | `accepted` | Armazenada. `observationId` é a nova observação. |
| `202` | `accepted` (`state: "retrying"`) | Aceita, mas o armazenamento falhou. O servidor tenta de novo, inclusive depois de um restart. |
| `200` | `duplicate` | Este `eventId` já havia sido aceito. `observationId` é a observação existente; nada novo é armazenado. |
| `400` / `422` | `rejected` | Payload inválido, ou o armazenamento falhou de forma definitiva (o evento é mantido como dead letter). |
| `503` | `rejected` (`retryable: true`) | O inbox está cheio (`AGENTMEMORY_CAPTURE_INBOX_MAX`). Os hooks colocam o evento no spool e o enviam depois. |
Eventos que falham são tentados de novo a cada `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 s) com backoff que dobra, até `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5). Eventos que continuam falhando ficam no inbox como dead letters, são listados em `/agentmemory/status` e na página Health do viewer, e podem ser tentados de novo com `POST /agentmemory/capture/retry` (`{"eventId": "..."}` ou `{"all": true}`). Ids de evento aceitos são lembrados por `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 horas, no máximo `AGENTMEMORY_CAPTURE_EVENTS_MAX` ids), então um hook reproduzido depois de um timeout ou de um restart é armazenado uma única vez, enquanto duas chamadas de tool separadas com seus próprios ids de host são armazenadas duas vezes, mesmo quando o conteúdo delas é idêntico. Quando uma observação é deletada (forget, deleção de sessão, eviction, auto-forget ou um import que substitui o store), o evento dela é marcado como deletado antes que a observação seja removida, então uma reprodução desse evento dentro da mesma janela é respondida como duplicata e não armazena nada. O state store grava em disco a cada 2 segundos, então um evento já respondido ainda pode estar só em memória por um instante. Para cobrir isso, toda resposta `2xx` também carrega o `bootId` do servidor (novo a cada início), `acceptedAt` e `durableAfterMs` (o intervalo de save mais 1.5 s no store de arquivo, 1.5 s no redis, onde a persistência é configuração do operador). Os hooks mantêm o evento no spool local até que essa janela tenha passado, e o deletam numa chamada posterior sem fazer outra requisição. Se o `bootId` tiver mudado até então, o servidor reiniciou, então o hook envia o evento de novo com o mesmo `eventId`; um evento que de fato chegou ao disco não é armazenado duas vezes. O servidor também envia esses eventos por conta própria no início e a cada intervalo de retry, então um restart não perde nada mesmo quando nenhum hook roda depois. Hooks antigos ignoram os campos extras, e hooks novos contra um servidor mais antigo descartam o evento no `2xx` como antes.
Quando o servidor está fora do ar, não responde a tempo ou retorna um 5xx, o hook anexa a observação a um arquivo de spool local, `/capture-spool/-.jsonl` (sobrescreva a pasta com `AGENTMEMORY_CAPTURE_SPOOL_DIR`). O arquivo é privado ao seu usuário (modo 600), secrets são redigidos da mesma forma que o servidor os redige, ele guarda no máximo `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 MiB) e descarta entradas mais antigas que `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168). Quando está cheio, novas entradas são descartadas e contadas, e `/agentmemory/status` reporta isso. O hook ainda sai com código 0 dentro do seu limite de tempo e não adiciona nenhuma requisição quando o servidor está saudável. O spool é enviado no próximo início e pelo primeiro hook que alcançar o servidor de novo, em um processo em segundo plano para que o agente não espere. Ids de evento tornam isso seguro: uma observação que já chegou antes de um timeout não é armazenada duas vezes. `npx @agentmemory/agentmemory capture` mostra o spool e o inbox do servidor, `--drain` envia o spool agora, e `GET /agentmemory/capture` retorna o mesmo em JSON. Defina `AGENTMEMORY_CAPTURE_SPOOL=false` para desativar o spool.
**Compactando provenance de grafo.** Todo node e edge do grafo de conhecimento guarda os ids das 32 observações mais recentes de onde ele veio. Stores escritos antes desse limite podem acumular milhares de ids por node quente, o que torna a busca de grafo e o viewer lentos ou derruba o worker. agentmemory corrige isso por conta própria: no primeiro início depois de um upgrade, ele reduz todo node, edge, edge supersedido (o histórico temporal do grafo) e o snapshot em cache para o limite, em segundo plano, em fatias pequenas com uma pausa entre elas, de modo que busca, captura e o viewer continuem funcionando. Ele salva seu progresso, retoma depois de um restart e nunca roda de novo depois de terminar. `/agentmemory/status` e a página Health do viewer mostram isso como pendente, em execução (com o scope e a posição atuais), concluído ou falho. Defina `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false` para desativar.
Para rodar manualmente, chame `POST /agentmemory/graph/compact`. Ele percorre os índices de nome e de chave de edge em vez de listar todo node e edge, e é seguro rodar de novo. Quando reduz ids, ele grava uma entrada de auditoria `graph_compact`.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
Em um store grande, ou quando a chamada retorna 504, rode em fatias. Envie `scope` (`nodes`, `edges` ou `history`), `offset` e `limit`, depois chame de novo com o `nextOffset` retornado até que seja `null`. Faça isso para `nodes`, `edges` e `history`, e termine com uma chamada `{"scope":"snapshot"}`, porque uma execução em fatias não toca o snapshot em cache.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---
```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**Pré-requisitos:** Node.js >= 20 com npm/npx; [iii-engine](https://iii.dev/docs) v0.22.1 ou Docker. A instalação automática do engine no macOS/Linux também exige `curl`, um `sh` POSIX e `tar`; o Windows nativo usa o `iii.exe` fixado manual, o WSL2 ou o Docker Desktop.