Il tuo agente di coding si ricorda tutto. Basta ri-spiegare tutto da capo.
Costruito su iii engine
Memoria persistente per Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, OpenCode e qualsiasi client MCP.
Il gist estende il pattern LLM Wiki di Karpathy con punteggio di confidenza, ciclo di vita, grafi di conoscenza e ricerca ibrida: agentmemory è l'implementazione.
---
## Installazione
Requisiti:
- Node.js 20 o più recente con npm e npx (`node -v`, `npm -v` e `npx -v`).
- L'installazione automatica di iii-engine su macOS/Linux richiede anche `curl`, una `sh` POSIX e `tar`. Immagini minimali come `node:20-slim` potrebbero non includerli.
- Windows nativo richiede l'installazione manuale della versione fissata di iii-engine v0.22.1 `iii.exe`. WSL2 o Docker Desktop sono le altre strade supportate.
Comando canonico per l'installazione da zero:
```bash
npx -y @agentmemory/agentmemory@latest
```
La prima esecuzione è una configurazione interattiva: scegli gli agenti da collegare (Claude Code, Cursor, Codex, Gemini CLI, OpenCode, ...), scegli un provider LLM oppure resta senza chiave (keyless), e il tool popola la configurazione, avvia il server di memoria e il suo iii engine fissato, e offre di installarlo globalmente così il comando nudo `agentmemory` funziona ovunque in seguito. `-y` accetta il prompt del pacchetto di npx e `@latest` evita una release obsoleta in cache. Un provider rende disponibili le funzionalità LLM, ma la compressione delle osservazioni scritta da un LLM si attiva solo quando è impostato anche `AGENTMEMORY_AUTO_COMPRESS=true`.
La modalità keyless disabilita gli embedding vettoriali. `memory_recall` (il percorso `mem::search`) usa BM25, mentre `memory_smart_search` può anche fondere corrispondenze strutturali del grafo quando i dati del grafo esistono già. Per il recall semantico gratuito on-device, imposta `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` e riavvia. La prima richiesta di embedding scarica `Xenova/all-MiniLM-L6-v2`; l'inferenza dopo quel primo download del modello viene eseguita localmente.
Il runtime locale usa quattro porte: `3111` per REST/MCP HTTP, `3112` per gli stream iii, `3113` per il viewer e `49134` per il WebSocket del worker iii. Lo stato persistente di iii risiede in `~/Library/Application Support/agentmemory` su macOS, `$XDG_DATA_HOME/agentmemory` oppure `~/.local/share/agentmemory` su Linux, e `%APPDATA%\agentmemory` su Windows. Usa `--data-dir ` o `AGENTMEMORY_DATA_DIR` per sovrascriverlo, e riusa lo stesso valore a ogni riavvio. Per compatibilità con le versioni precedenti, un `./data/state_store.db` o `./data/iii-config.yaml` esistente ha precedenza sul percorso predefinito della piattaforma per l'istanza 0; un flag esplicito o una variabile d'ambiente prevalgono comunque.
Poi verifica che il recall funzioni e dai al tuo agente le sue skill:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
Le ricerche per parole chiave dovrebbero funzionare in modalità keyless predefinita tramite BM25. La query `database performance optimization` della demo è intenzionalmente semantica e può restituire zero risultati finché non è configurato un provider di embedding.
Preferisci far fare tutto a un agente di coding? Dagli un'unica istruzione:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
Collega altri agenti in qualsiasi momento con `agentmemory connect ` — 20 adapter elencati in [Funziona con qualsiasi agente](#works-with-every-agent). Riferimento completo dei comandi in [Avvio rapido](#quick-start).
Windows
La via più rapida è WSL2. La configurazione nativa del motore su Windows richiede che lo ZIP fissato v0.22.1 venga scaricato e `iii.exe` estratto manualmente; la CLI non lo estrae automaticamente. È supportato anche Docker Desktop. Vedi le [note su Windows](#windows) per la procedura passo-passo.
Installazione globale / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
Il comando npx sopra resta il percorso canonico per l'installazione da zero ed evita i problemi di permessi del prefisso globale.
npx serve una versione vecchia
npx mette in cache per versione. Forza l'ultima versione con `npx -y @agentmemory/agentmemory@latest`, oppure svuota la cache una volta con `rm -rf ~/.npm/_npx` (macOS/Linux; su Windows elimina `%LOCALAPPDATA%\npm-cache\_npx`).
Hai già un tuo iii engine in esecuzione
agentmemory fissa iii-engine alla v0.22.1 e non si collegherà a una versione diversa (il worker non può parlare il protocollo di un altro engine). Arresta l'altro engine, poi esegui `npx -y @agentmemory/agentmemory@latest`. Installa ed esegue la versione fissata v0.22.1 in `~/.agentmemory/bin`, lasciando intatto il tuo `iii`.
---
agentmemory funziona con qualsiasi agente che supporti hook, MCP o API REST. Tutti gli agenti condividono lo stesso server di memoria.
Claude Code plugin nativo + 12 hook + MCP
Codex CLI plugin nativo + 6 hook + MCP
GitHub Copilot CLI MCP + hook/skill del plugin
Cursor plugin nativo + 7 hook + MCP
OpenCode plugin di capture + MCP
Devin 6 hook + skill + MCP
OpenClaw plugin nativo + MCP
Hermes plugin nativo + MCP
pi plugin nativo + MCP
OpenHuman backend nativo del trait Memory
Gemini CLI server MCP
Antigravity MCP + hook
Claude Desktop server MCP
Warp connect + MCP + skill
Zed server MCP
Cline server MCP
Continue server MCP
Droid server MCP
Kiro server MCP
Qwen Code server MCP
DeepSeek Harness server MCP
Roo Code server MCP
Kilo Code server MCP
Goose server MCP
Aider API REST
Funziona con qualsiasi agente che parli MCP o HTTP. Un solo server, memorie condivise tra tutti.
---
Spieghi la stessa architettura ogni sessione. Riscopri gli stessi bug. Ri-insegni le stesse preferenze. La memoria integrata (CLAUDE.md, .cursorrules) ha un limite di 200 righe e diventa obsoleta. agentmemory risolve questo problema. Catturi silenziosamente ciò che fa il tuo agente, lo comprimi in una memoria ricercabile e inietti il contesto giusto quando inizia la sessione successiva. Un solo comando. Funziona tra agenti diversi.
**Cosa cambia:** Nella sessione 1 configuri l'autenticazione JWT. Nella sessione 2 chiedi il rate limiting. L'agente sa già che la tua autenticazione usa il middleware jose in `src/middleware/auth.ts`, che i tuoi test coprono la validazione dei token, e che hai scelto jose rispetto a jsonwebtoken per la compatibilità con Edge, senza bisogno di ri-spiegare nulla né di copiare e incollare.
```bash
npx -y @agentmemory/agentmemory@latest
```
Per impostazione predefinita, agentmemory salva lo stato di iii-engine fuori dal repository da cui lo avvii: `~/Library/Application Support/agentmemory` su macOS, `$XDG_DATA_HOME/agentmemory` oppure `~/.local/share/agentmemory` su Linux, e `%APPDATA%\agentmemory` su Windows. Un `./data/state_store.db` o `./data/iii-config.yaml` legacy esistente viene riutilizzato per l'istanza 0 prima di quel percorso predefinito della piattaforma. Per scegliere esplicitamente una posizione, passa `--data-dir ` oppure imposta `AGENTMEMORY_DATA_DIR`; entrambe le impostazioni esplicite hanno la precedenza sulla ricerca legacy:
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
Gli avvii nativi e Docker usano questa stessa directory host risolta; Docker la monta con bind in `/data`. `--instance 1` aggiunge `instance-1` alla directory risolta e seleziona il quartetto di porte predefinito separato `3211/3212/3213/49234`.
Note sull'ultima release: [CHANGELOG.md](../CHANGELOG.md).
---
### Precisione del retrieval
**coding-agent-life-v1** (corpus interno, riproducibile in sandbox)
| Adapter | P@5 | R@5 | Tasso di successo top-5 | latenza p50 |
|---|---|---|---|---|
| **agentmemory ibrido** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| grep di base | 0.227 | 0.967 | 15 / 15 | 0 ms |
Tasso di successo top-5 del 100% al **limite matematico di P@5** per questo corpus (0.240, vedi scorecard). L'ibrido recupera ogni sessione gold; grep ne manca 1 su 2 nella query temporale multi-sessione. Il guadagno è su **recall + temporale**, non sulla precisione aggregata. Questo benchmark è piccolo e povero di dati gold; il più ampio LongMemEval-S sotto differenzia meglio. Analisi completa per tipo + nota di correzione: [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md).
**LongMemEval-S** (ICLR 2025, 500 domande)
| Sistema | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| Fallback solo BM25 | 86.2% | 94.6% | 71.5% |
> Modello di embedding: `all-MiniLM-L6-v2` (locale, gratuito, senza chiave API). Report completi: [`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md), [`benchmark/QUALITY.md`](../benchmark/QUALITY.md), [`benchmark/SCALE.md`](../benchmark/SCALE.md). Confronto con i concorrenti: [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md) che copre agentmemory vs mem0, Letta, Khoj, supermemory, TencentDB Agent Memory, MemPalace, Zep/Graphiti, Cognee, Hippo.
**Riproducibile in locale:** [`eval/README.md`](../eval/README.md), un harness con adapter collegabili per LongMemEval `_s` (500 domande pubbliche) + `coding-agent-life-v1` (corpus interno di 15 sessioni). Gli adapter grep / vettoriale / agentmemory ottengono un punteggio fianco a fianco, output NDJSON, le scorecard pubblicate finiscono in [`docs/benchmarks/`](../docs/benchmarks/).
**Si combina con [codegraph](https://github.com/colbymchenry/codegraph), [Understand Anything](https://github.com/Lum1104/Understand-Anything) e [Graphify](https://github.com/safishamsi/graphify).** Indicizzazione code-graph, pipeline di build multi-agente e grafi di conoscenza più ampi su documenti / PDF / immagini / video. agentmemory ricorda il lavoro; questi tre progetti illuminano il resto dello strato di contesto. Ricette + tabella di instradamento delle domande: [`docs/recipes/pairings.md`](../docs/recipes/pairings.md).
---
agentmemory
mem0 (63K ⭐)
Letta / MemGPT (24K ⭐)
Khoj (36K ⭐)
supermemory (29K ⭐)
TencentDB Agent Memory (22K ⭐)
MemPalace (54K ⭐)
oracleagentmemory
Hippo
Integrata (CLAUDE.md)
Tipo
Motore di memoria + server MCP
API livello memoria
Runtime agente completo
IA personale
API memoria + app
Hub memoria di team (proxy LLM)
Memoria vettoriale (OSS)
Motore di memoria (Oracle DB)
Sistema di memoria
File statico
Retrieval R@5
95.2%
68.5% (LoCoMo)
83.2% (LoCoMo)
N/D
Auto-dichiarato
PersonaMem 76% (auto-dichiarato)
~96.6% (auto-dichiarato)
94.4% (auto-dichiarato)
N/D
N/D (grep)
Acquisizione automatica
12 hook (zero sforzo manuale)
Chiamate manuali add()
Auto-modifiche dell'agente
Manuale
Estrazione lato API
Intercettazione proxy (sostituzione base-URL)
Manuale
Estrazione API
Manuale
Modifica manuale
Ricerca
BM25 + vettoriale + grafo (fusione RRF)
Vettoriale + grafo
Vettoriale (archivio)
Semantica
Vettoriale + RAG
4 tipi di asset (Chat / Skill / Wiki / CodeGraph)
Solo vettoriale
Vettoriale + semantica
Pesata per decadimento
Carica tutto nel contesto
Multi-agente
MCP + REST + lease + segnali
API (nessun coordinamento)
Solo all'interno del runtime Letta
No
No
Ruoli di team + asset condivisi
No
Solo con ambito limitato
Condiviso multi-agente
File per agente
Vincolo al framework
Nessuno (qualsiasi client MCP)
Nessuno
Alto (deve usare Letta)
Autonomo
Nessuno
Il proxy intercetta ogni chiamata al modello
Nessuno
Oracle Database
Nessuno
Formato per agente
Dipendenze esterne
Nessuna (SQLite + iii-engine)
Qdrant / pgvector
Postgres + DB vettoriale
Multiple
Cloud gestito
Stack Docker (Core + Hub + Proxy)
Vector store
Oracle AI Database
Nessuna
Nessuna
Ciclo di vita della memoria
Consolidamento a 4 livelli + decadimento + auto-oblio
Estrazione passiva
Gestito dall'agente
Manuale
Auto-oblio
Revisione manuale; instradamento automatico in corso
Nessuno
Non dichiarato
Decadimento + consolidamento
Pulizia manuale
Efficienza dei token
~1,900 token/sessione ($10/anno)
Varia per integrazione
Memoria core nel contesto
Varia
Prezzo cloud
Non dichiarato
Nessun budget di token
Basato su LLM (varia)
Varia
22K+ token a 240 osservazioni
Viewer in tempo reale
Sì (porta 3113)
Dashboard cloud
Dashboard cloud
UI web
Dashboard cloud
UI web Hub
No
No
No
No
Self-hosted
Sì (predefinito)
Opzionale
Opzionale
Sì
No (solo cloud)
Sì (Docker)
Sì
Sì (Oracle DB)
Sì
Sì
Nota sul benchmark: solo l'R@5 di agentmemory è un risultato misurato da noi (LongMemEval-S, riproducibile da benchmark/COMPARISON.md). I valori di mem0 e Letta sono i loro numeri pubblicati su LoCoMo (un dataset diverso); i valori di MemPalace, supermemory, TencentDB (PersonaMem) e oracleagentmemory sono dichiarazioni auto-riportate dai rispettivi fornitori che non abbiamo riprodotto in modo indipendente (l'esecuzione di oracleagentmemory ha usato GPT-5.5 contro un Oracle AI Database). Mostrati fianco a fianco solo per un confronto approssimativo, non un testa a testa su dati identici. I conteggi delle stelle sono approssimativi e cambiano nel tempo.
**Nuovi arrivati** da conoscere, confrontati in profondità in [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md):
| Sistema | ⭐ | Approccio |
|--------|---|-------|
| Zep / Graphiti | 30K | Grafo di conoscenza temporale; i risultati pubblicati più solidi sulle query temporali (LongMemEval 63.8%), ma il grafo si costruisce in modo asincrono quindi i fatti recenti possono essere in ritardo |
| Cognee | 30K | Ingestione da documento a grafo di conoscenza, solo Python, costruito per l'estrazione strutturata di entità più che per l'acquisizione di sessioni |
Nessuno di questi acquisisce automaticamente dagli hook degli agenti di coding, offre un viewer local-first, o funziona senza chiave — la combinazione su cui è costruito agentmemory.
---
Compatibilità: questa release ha come target `iii-sdk` 0.22.1 e fissa iii-engine alla v0.22.1.
### Provalo in 30 secondi
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` crea 3 sessioni realistiche (autenticazione JWT, fix di una query N+1, rate limiting) ed esegue ricerche su di esse. Le installazioni keyless disabilitano i vettori, quindi le query per parole chiave `mem::search` dovrebbero funzionare tramite BM25 mentre `database performance optimization` può restituire zero risultati. `smart-search` può inoltre restituire corrispondenze strutturali del grafo quando i dati del grafo esistono. Per far trovare alla query semantica il fix dell'N+1 tramite i vettori, imposta `EMBEDDING_PROVIDER=local`, riavvia e lascia completare il primo download del modello.
Apri `http://localhost:3113` per osservare la memoria costruirsi in tempo reale.
### Valida un'installazione nuova e la persistenza al riavvio
Con il server in esecuzione, valida REST, health, il viewer e lo stato del runtime basato su iii:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
Il pannello di avvio pronto considera tutte e quattro le porte: REST/MCP HTTP sulla 3111, stream iii sulla 3112, il viewer sulla 3113 e il WebSocket del worker iii sulla 49134. `status` confirma lo stato di salute di agentmemory e il provider/modalità di embedding attivo. Salva una sonda e verifica che sia ricercabile:
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
Poi esegui `npx -y @agentmemory/agentmemory@latest stop`, riavvia il comando canonico nel Terminal 1, attendi `/agentmemory/livez` e ripeti la ricerca. La sonda deve essere ancora restituita. Se hai scelto un `--data-dir` personalizzato, passa la stessa directory al riavvio.
### Comandi quotidiani
Installazione e configurazione sono descritte in [Installazione](#install) sopra (la prima esecuzione ti guida passo passo). Quotidianamente:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### Replay delle sessioni
Ogni sessione registrata da agentmemory è riproducibile (replay). Apri il viewer, scegli la tab **Replay** e scorri la timeline: prompt, chiamate agli strumenti, risultati degli strumenti e risposte vengono renderizzati come eventi discreti con play/pause, controllo della velocità (da 0.5x a 4x) e scorciatoie da tastiera (spazio per attivare/disattivare, le freccie per avanzare passo passo).
Per importare transcript JSONL più vecchi di Claude Code:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
Le sessioni importate appaiono nel selettore Replay insieme a quelle native. Dietro le quinte ogni voce passa attraverso le funzioni iii `mem::replay::load`, `mem::replay::sessions` e `mem::replay::import-jsonl`, senza server a canale laterale. Ogni transcript importato viene indicizzato per la ricerca, marcato con il canale di origine `import` ed elaborato per produrre un cristallo di sessione e delle lezioni.
> **Attenzione se usi `import-jsonl` come percorso di acquisizione principale:** `cleanupPeriodDays` di Claude Code (in `~/.claude/settings.json`, predefinito **30**) elimina automaticamente i transcript JSONL più vecchi di quella finestra da `~/.claude/projects/`. Se installi agentmemory su una cronologia di Claude Code vecchia di mesi, tutto ciò che ha più di 30 giorni è già sparito prima della prima importazione. Puoi eseguire `import-jsonl` tramite cron, aumentare `cleanupPeriodDays` a un valore più alto, oppure collegare gli hook di acquisizione automatica (il percorso di installazione predefinito del plugin) così che ogni turno finisca in agentmemory mentre la sessione è ancora attiva e la pulizia dei JSONL non sia più un problema.
### Aggiornamento / Manutenzione
Usa il comando di manutenzione quando vuoi intenzionalmente aggiornare il tuo runtime locale:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
Attenzione: questo comando modifica il workspace/runtime corrente. Può aggiornare le dipendenze JavaScript e scaricare l'immagine Docker fissata `iiidev/iii:0.22.1`. Non installa mai un iii engine non fissato o più recente.
I dettagli implementativi si trovano in `src/cli.ts` (vedi `runUpgrade` nella regione `src/cli.ts:544-595`).
### Claude Code (un blocco, incollalo)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code senza l'installazione del plugin (percorso MCP standalone)
Se collegi il server MCP di agentmemory tramite `~/.claude.json` direttamente invece di usare `/plugin install`, Claude Code non risolve mai `${CLAUDE_PLUGIN_ROOT}` e devi puntare gli script degli hook a percorsi assoluti in `~/.claude/settings.json`. Questi percorsi di solito incorporano la versione di agentmemory (ad es. `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`), quindi il prossimo aggiornamento rompe silenziosamente ogni hook.
Soluzione alternativa:
```bash
agentmemory connect claude-code --with-hooks
```
Questo unisce gli stessi comandi degli hook in `~/.claude/settings.json` con percorsi assoluti risolti verso la directory `plugin/` incorporata nel pacchetto `@agentmemory/agentmemory` attualmente installato. Riesegui il comando dopo aver aggiornato agentmemory per aggiornare i percorsi. Le voci dell'utente nello stesso file vengono preservate; vengono sostituite solo le voci precedenti di agentmemory. Usare il percorso `/plugin install` resta l'approccio consigliato.
Per deployment remoti o protetti, avvia Claude Code con `AGENTMEMORY_URL` e `AGENTMEMORY_SECRET` impostati. Il plugin passa entrambi i valori al suo server MCP incorporato; quando `AGENTMEMORY_URL` è vuoto, lo shim MCP usa `http://localhost:3111`.
### Codex CLI (piattaforma plugin di Codex)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
Il plugin Codex viene distribuito dalla stessa directory `plugin/` del plugin Claude Code. Registra:
- Un bridge MCP via stdio incorporato per il daemon in esecuzione, senza download npm né archivio di fallback. Consulta la [guida locale di Codex](../docs/plugins/codex-local.md) per testare una build non ancora rilasciata.
- 6 hook del ciclo di vita: `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop`
- 9 skill invocabili: `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, più 8 skill di riferimento che l'agente carica su richiesta (disciplina della memoria, strumenti MCP, API REST, configurazione, agenti, hook, architettura, e la guida alla scrittura delle skill)
Il motore degli hook di Codex inietta `CLAUDE_PLUGIN_ROOT` nei sottoprocessi degli hook (vedi [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)), quindi gli stessi script degli hook funzionano su entrambi gli host senza duplicazione. Gli eventi Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure sono esclusivi di Claude Code e non vengono registrati per Codex.
#### Fiducia e compatibilità degli hook di Codex
L'invio nativo degli hook del plugin è verificato con Codex CLI 0.150.1. Fidati degli hook del plugin prima di aspettarti l'acquisizione. Il comportamento su Desktop dipende dal suo runtime incorporato; controlla `/hooks` e conferma un evento acquisito prima di abilitare una soluzione alternativa.
Se il tuo host richiede hook globali, rispecchia i comandi in `~/.codex/hooks.json`. Quando l'MCP è già configurato, il connettore attuale richiede `--force` per raggiungere l'installazione degli hook:
```bash
agentmemory connect codex --with-hooks --force
```
Questo unisce gli hook globali e riscrive la voce MCP di agentmemory, preservando le voci non correlate. Rivedi eventuali impostazioni personalizzate dell'endpoint di agentmemory prima di usare `--force`. Riesegui dopo l'aggiornamento per aggiornare i percorsi degli script. Abilita gli hook nativi del plugin oppure le copie globali per evitare l'acquisizione duplicata.
### GitHub Copilot CLI
Per la modalità agente di VS Code, usa la [guida MCP e acquisizione automatica di Copilot](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions). Il connettore CLI non configura VS Code.
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` unisce `mcpServers.agentmemory` in `~/.copilot/mcp-config.json` (o `$COPILOT_HOME/mcp-config.json` quando `COPILOT_HOME` è impostato) e preserva i server esistenti. Su Windows nativo questo è l'unico adapter `connect` automatizzato; configura manualmente ogni altro agente Windows nativo. `connect` in WSL è adatto solo quando l'agente target è installato nel medesimo ambiente WSL. Copilot recepisce il server MCP al prossimo avvio o dopo `/mcp`. Installa anche il plugin quando vuoi l'esperienza completa di hook/skill.
OpenClaw (incolla questo prompt)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
Guida completa: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (incolla questo prompt)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
Guida completa: [`integrations/hermes/`](../integrations/hermes/)
### Altri agenti
Avvia il server di memoria: `npx -y @agentmemory/agentmemory@latest`
#### Skill native tramite `npx skills add` (50+ agenti)
agentmemory distribuisce 17 skill nel formato `/SKILL.md` in stile Claude Code: 9 skill d'azione invocabili (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) e 8 skill di riferimento che l'agente carica su richiesta (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`). Le skill di riferimento portano tabelle di dati generate dalla fonte, quindi non diventano mai obsolete. La CLI [`skills`](https://npmjs.com/package/skills) di vercel-labs le installa automaticamente nella directory delle skill native dell'agente chiamante su 50+ agenti (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf, e altri):
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
Questo è **complementare** a `agentmemory connect `:
- `agentmemory connect ` scrive la configurazione del server MCP così gli strumenti diventano disponibili.
- `npx skills add rohitg00/agentmemory` installa le skill così l'agente sa quando chiamarle.
Per i pochi agenti che la CLI skills non copre ancora (Zed v1.3.x e versioni precedenti), copia tu stesso i 17 file SKILL.md nella directory delle skill native dell'agente; lo stesso formato funziona ovunque.
#### Blocco MCP standard
La voce agentmemory è lo **stesso blocco server MCP** su ogni host che usa la forma `mcpServers` (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw):
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**Unisci questa voce nell'oggetto `mcpServers` esistente** nel file di configurazione dell'host; non sostituire il file. Se il file ha già altri server, aggiungi `agentmemory` accanto a loro come un'altra chiave dentro `mcpServers`. Se `mcpServers` manca del tutto, incolla il blocco dentro `{ "mcpServers": { ... } }`. I placeholder `${VAR}` ereditano `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` dalla shell all'avvio del server MCP; le variabili non impostate passano stringhe vuote e lo shim ricade su `http://localhost:3111`. Una singola voce collegata copre sia i deployment locali che quelli remoti (k8s / dietro reverse-proxy).
| Agente | File di configurazione | Note |
|---|---|---|
| **Cursor (solo MCP)** | `~/.cursor/mcp.json` | Unisci in `mcpServers`, oppure `agentmemory connect cursor`. Disponibile anche un deeplink one-click sul sito web. |
| **Cursor (plugin completo)** | `.cursor-plugin/` | Elenco nel Cursor Marketplace (candidatura in revisione) oppure Cursor Settings → Plugins → checkout locale. Registra 7 hook di acquisizione automatica (sessionStart, beforeSubmitPrompt, preToolUse, postToolUse, postToolUseFailure, stop, sessionEnd) + 17 skill + il server MCP, con `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` gestiti nella dashboard del plugin di Cursor. Funziona nell'IDE Cursor e nella CLI `cursor-agent`; i prompt in modalità print della CLI vengono ricostruiti a posteriori dal transcript della sessione alla fine della sessione. |
| **Claude Desktop** | `claude_desktop_config.json` (Application Support) | Unisci in `mcpServers`. Riavvia Claude Desktop dopo la modifica. |
| **Cline / Roo Code / Kilo Code** | Impostazioni MCP di Cline (Settings UI → MCP Servers → Edit) | Stesso blocco `mcpServers`. |
| **Devin CLI (MCP + hook)** | `~/.config/devin/config.json` | `agentmemory connect devin` unisce la voce MCP; `--with-hooks` aggiunge sei hook nativi di acquisizione automatica (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) con i matcher di strumenti in minuscolo di Devin. Verifica con `devin mcp list` e `/hooks` dentro devin. |
| **Devin CLI (plugin completo)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` da un checkout registra tutte le 17 skill come slash command `/agentmemory:` più il server MCP. Gli hook del plugin di Devin non possono far scattare `SessionStart`/`SessionEnd`, quindi abbinalo a `connect devin --with-hooks` per una cattura completa della sessione. |
| **Devin (cloud)** | Settings → Connections → MCP servers | Aggiungi un MCP personalizzato (STDIO): comando `npx`, argomenti `-y @agentmemory/mcp@latest`, env `AGENTMEMORY_URL` che punta a un deployment agentmemory raggiungibile in rete più `AGENTMEMORY_SECRET` (le sessioni cloud non possono raggiungere localhost — vedi [`deploy/`](../deploy/)). Salva il secret in Devin Secrets, poi usa "Test listing tools" per verificare che tutti i 54 strumenti appaiano. |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (unisce automaticamente). |
| **GitHub Copilot CLI (solo MCP)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` unisce `mcpServers.agentmemory`; Copilot lo recepisce al prossimo avvio o con `/mcp`. |
| **GitHub Copilot CLI (plugin completo)** | Installazione plugin Copilot | `copilot plugin install rohitg00/agentmemory:plugin` per il plugin dalla sottodirectory GitHub. |
| **OpenClaw** | Configurazione MCP di OpenClaw | Stesso blocco `mcpServers`. Più in profondità: `openclaw plugins install ./integrations/openclaw` rivendica lo slot di memoria di OpenClaw (passa automaticamente da `memory-core`); imposta `plugins.entries.agentmemory.hooks.allowConversationAccess=true` altrimenti la cattura del turno viene bloccata silenziosamente. Vedi [`integrations/openclaw`](../integrations/openclaw/). |
| **Codex CLI (solo MCP)** | `.codex/config.toml` | Forma TOML: `codex mcp add agentmemory -- npx -y @agentmemory/mcp`, oppure aggiungi `[mcp_servers.agentmemory]` manualmente. |
| **Codex CLI (plugin completo)** | Marketplace plugin di Codex | `codex plugin marketplace add rohitg00/agentmemory` poi `codex plugin add agentmemory@agentmemory`. Registra MCP + 6 hook del ciclo di vita + 17 skill. Fidati degli hook e verifica l'acquisizione nel tuo host; consulta [configurazione e validazione di Codex](../docs/plugins/codex-local.md). |
| **OpenCode (solo MCP)** | `opencode.json` | Forma diversa: chiave di primo livello `mcp`, comando come array: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`. |
| **OpenCode (plugin completo)** | `plugin/opencode/` | 22 hook di acquisizione automatica che coprono il ciclo di vita della sessione, i messaggi, gli strumenti, gli errori. L'attribuzione del progetto è per sessione, quindi un singolo processo OpenCode che abbraccia più repository registra ogni sessione sotto il proprio progetto. Due slash command (`/recall`, `/remember`). Copia `plugin/opencode/` nel tuo workspace OpenCode e aggiungi la voce del plugin a `opencode.json`. Vedi [`plugin/opencode/README.md`](../plugin/opencode/README.md) per la tabella completa degli hook + l'analisi delle lacune. |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` installa l'estensione incorporata nella directory di auto-discovery di pi (recall all'avvio dell'agente, cattura alla fine dell'agente, strumenti `memory_search` / `memory_save` / `memory_health`, `/agentmemory-status`). `/reload` in un pi in esecuzione lo recepisce. [`integrations/pi`](../integrations/pi/) è anche un pacchetto pi (`pi install ./integrations/pi` da un checkout). |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` fornisce il provider di memoria a 6 hook (prefetch, cattura del turno, fine sessione, pre-compressione, mirroring di MEMORY.md, blocco del system prompt). Valida con `hermes plugins doctor` e `hermes memory status`. Vedi [`integrations/hermes`](../integrations/hermes/). |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` scrive il blocco standard `mcpServers`. Il payload degli hook è compatibile a livello di campi con Claude Code, quindi gli script esistenti dei 12 hook funzionano senza modifiche; collegali tramite la sezione `hooks` nello stesso `settings.json`. |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` installa l'MCP e gli hook di acquisizione nella directory di personalizzazione condivisa. Consulta [configurazione e limiti di Antigravity](../docs/plugins/antigravity.md). |
| **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` usa la stessa configurazione MCP e hook delle versioni IDE attuali. Le installazioni esistenti dovrebbero aggiornare con `--force`; consulta le [note di aggiornamento](../docs/plugins/antigravity.md). |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` scrive la configurazione a livello utente. Gli override per workspace vanno in `.kiro/settings/mcp.json` accanto al tuo codice. |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` scrive il blocco standard `mcpServers`. Warp rileva automaticamente anche le skill da `.claude/skills/`; una volta installato il plugin Claude Code, le 8 skill di agentmemory (`remember`, `recall`, `recap`, `handoff`, `forget`, `commit-context`, `commit-history`, `session-history`) appaiono nativamente nella palette slash-command di Warp. |
| **Cline (CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` scrive il blocco standard `mcpServers`. Utenti dell'estensione VS Code: incolla lo stesso blocco tramite Cline Settings → MCP Servers → Edit JSON. |
| **Continue.dev** | `~/.continue/config.yaml` (preferito) o `config.json` (legacy) | `agentmemory connect continue` crea `config.yaml` da zero quando nessuno dei due esiste, oppure modifica il `config.json` esistente. **Se hai già `config.yaml`** l'adapter stampa il blocco esatto da incollare sotto `mcpServers:`; non riscrive silenziosamente il tuo yaml perché preservare commenti e anchor in modo sicuro richiede un parser YAML che il pacchetto non include. Continue usa la forma array (non oggetto) per `mcpServers`. |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` scrive sotto `context_servers` (la chiave di Zed, NON `mcpServers`). I server MCP remoti possono essere collegati tramite `{"url": "..."}` invece. |
| **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` scrive il blocco standard `mcpServers`. Gli override a livello di progetto vanno in `/.factory/mcp.json`. Passa `--with-hooks` per l'acquisizione automatica nativa. |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` aggiunge una riga `@deepseek-ai/dsh-mcp-client` al livello di patch a livello home che ogni profilo Harness carica; gli strumenti si registrano come `mcp__agentmemory__*`. Passa `--with-hooks` per collegare anche l'acquisizione automatica: gli script degli hook incorporati di Claude Code funzionano tramite il bridge nativo `@deepseek-ai/dsh-hooks-claude-code` di Harness (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop) tramite un manifesto scritto in `$DSH_HOME/agentmemory.hooks.json`. Il default è `~/.dsh` quando `DSH_HOME` non è impostato. |
| **Goose** | UI delle impostazioni MCP di Goose | Stesso blocco `mcpServers`; usa `goose configure` → Add Extension → MCP. La modifica diretta del YAML in `~/.config/goose/config.yaml` è supportata ma lo schema usa `extensions:` + `cmd` (non `mcpServers:` + `command`). |
| **Aider** | n/d | Parla direttamente con l'API REST: `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`. |
| **Qualsiasi agente (32+)** | n/d | `npx skillkit install agentmemory` rileva automaticamente l'host e unisce la configurazione. |
**Client MCP in sandbox** (Flatpak / Snap / container restrittivi) che non possono raggiungere il `localhost` dell'host: imposta anche `"AGENTMEMORY_FORCE_PROXY": "1"` nel blocco `env`, e punta `AGENTMEMORY_URL` verso una rotta che la sandbox possa effettivamente raggiungere (ad es. il tuo IP LAN).
### Accesso programmatico (Python / Rust / Node)
agentmemory registra le sue operazioni core come funzioni iii (`mem::remember`, `mem::observe`, `mem::context`, `mem::smart-search`, `mem::forget`). Qualsiasi linguaggio con un SDK iii può chiamarle direttamente su `ws://localhost:49134`, senza bisogno di un client REST separato per ogni linguaggio.
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
Esempio completo: [`examples/python/`](../examples/python/) (avvio rapido + flusso di osservazione/recall). REST sulla `:3111` resta disponibile per host senza un runtime iii.
### Dal codice sorgente
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
Questo avvia agentmemory con un `iii-engine` locale se il binario fissato è già installato, oppure usa Docker Compose quando selezionato. REST, stream e il viewer si collegano a `127.0.0.1` per impostazione predefinita. Il percorso automatico del binario per macOS/Linux richiede `curl`, una `sh` POSIX e `tar`.
Installa `iii-engine` manualmente. **agentmemory al momento fissa `iii-engine` alla `v0.22.1`**, la stessa release della sua dipendenza `iii-sdk`; il worker parla il protocollo wire di quell'engine, e la 0.20.0 ha riorganizzato la superficie dell'SDK, quindi le due si muovono insieme nelle release di agentmemory. Sovrascrivi con `AGENTMEMORY_III_VERSION=` se esegui il tuo engine e sai che corrisponde.
- **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64:** sostituisci `aarch64-apple-darwin` con `x86_64-apple-darwin`
- **Linux x64:** sostituisci con `x86_64-unknown-linux-gnu`
- **Linux arm64:** sostituisci con `aarch64-unknown-linux-gnu`
- **Windows:** scarica `iii-x86_64-pc-windows-msvc.zip` da [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) ed estrai `iii.exe` in `%USERPROFILE%\.agentmemory\bin\iii.exe`
Ogni archivio ha un file `.sha256` corrispondente sulla pagina della release; quando cambi piattaforma, usa l'hash di quel file nella verifica sopra (su Windows: `Get-FileHash`). L'installer automatico in `npx @agentmemory/agentmemory` fissa questi hash e rifiuta un archivio che non corrisponde.
Oppure usa Docker (il `docker-compose.yml` incluso scarica `iiidev/iii:0.22.1`). Documentazione completa: [iii.dev/docs](https://iii.dev/docs).
### Windows
agentmemory funziona su Windows 10/11, ma il pacchetto Node.js da solo non basta; serve anche il runtime fissato di iii-engine v0.22.1 come processo in background. La CLI non estrae automaticamente lo ZIP Windows, quindi gli utenti Windows nativi devono installare `iii.exe` manualmente, usare WSL2 oppure scegliere Docker Desktop.
Il collegamento MCP automatizzato su Windows nativo supporta solo `agentmemory connect copilot-cli`. Per Claude Code, Codex, Cursor e ogni altro agente Windows nativo, copia il blocco MCP manuale da [Altri agenti](#other-agents) nella configurazione Windows di quell'agente. Eseguire `connect` in WSL è appropriato solo quando l'agente target è installato anche in quello stesso ambiente WSL; non modifica la configurazione di un agente ospitato su Windows.
**Opzione A: binario Windows precompilato (consigliata)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**Opzione B: Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**Opzione C: solo MCP standalone (nessun engine).** Se ti serve solo gli strumenti MCP per il tuo agente e non hai bisogno dell'API REST, del viewer o dei cron job, salta del tutto l'engine:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**Diagnostica per Windows:** se `npx -y @agentmemory/agentmemory@latest` fallisce, riesegui con `--verbose` per vedere lo stderr effettivo dell'engine. Modalità di errore comuni:
| Sintomo | Soluzione |
|---|---|
| `The engine process started but the REST API never responded.` | Verifica che tutte le quattro porte derivate siano libere, controlla che il `iii.exe` fissato sia rimasto attivo, poi riesegui con `--verbose` e ispeziona lo stderr catturato dell'engine |
| `Could not start iii-engine` | Né `iii.exe` né Docker sono installati. Vedi l'Opzione A o B sopra |
| Conflitto di porta | `netstat -ano \| findstr :3111` per vedere cosa è collegato, poi terminalo o usa `--port ` |
| Fallback a Docker saltato anche se Docker è installato | Assicurati che Docker Desktop sia effettivamente in esecuzione (icona nella system tray) |
> Nota: l'**engine** iii è un binario precompilato, non un crate cargo, quindi non provare a farci `cargo install`. (Gli **SDK** iii sono pubblicati su crates.io, npm e PyPI, ma agentmemory non ne ha bisogno.) I metodi di installazione dell'engine supportati sono tutti fissati alla v0.22.1: il binario precompilato sopra, il percorso di installazione automatica di agentmemory per macOS/Linux (richiede `curl`, `sh` POSIX e `tar`), e l'immagine Docker `iiidev/iii:0.22.1`. Un `install.sh | sh` upstream nudo installa l'ultimo engine, che agentmemory non supporta. Usa `npx -y @agentmemory/agentmemory@latest`; su macOS/Linux scarica l'engine fissato in `~/.agentmemory/bin`.
---
Deploy
Template one-click per host gestiti. Ognuno distribuisce un
Dockerfile autosufficiente che scarica `@agentmemory/agentmemory` da npm e copia
il binario dell'engine iii dall'immagine Docker Hub ufficiale `iiidev/iii`;
non è richiesta nessuna immagine agentmemory precostruita. Lo storage persistente
viene montato su `/data`; l'entrypoint del primo avvio sovrascrive
la configurazione iii inclusa in npm (che si collega a `127.0.0.1`) con una
ottimizzata per il deploy che si collega a `0.0.0.0` e usa percorsi `/data`
assoluti, genera il secret HMAC, poi abbandona i privilegi da
`root` a `node` tramite `gosu` prima di eseguire la CLI di agentmemory.
Il pulsante di deploy one-click di Render richiede `render.yaml` nella radice del repository, che manteniamo deliberatamente puro. Usa il flusso Render Blueprint documentato in [`deploy/render/`](.././deploy/render/README.md) per puntare manualmente al blueprint nel repository.
I dettagli completi di configurazione (acquisizione HMAC, tunnel SSH per il viewer, rotazione, backup,
costi minimi) si trovano in [`deploy/`](.././deploy/README.md):
- [`deploy/fly`](.././deploy/fly/README.md): macchina singola con
`auto_stop_machines = "stop"`; il minimo costo a riposo.
- [`deploy/railway`](.././deploy/railway/README.md): tariffa fissa del piano Hobby,
volume nella dashboard.
- [`deploy/render`](.././deploy/render/README.md): flusso Blueprint,
snapshot automatici del disco sui piani a pagamento.
- [`deploy/coolify`](.././deploy/coolify/README.md): self-hosted sul tuo
VPS tramite [Coolify](https://coolify.io/self-hosted); stesso stack Docker
Compose, tu possiedi l'host e i dati.
È pubblicata solo la porta `3111`. Il viewer sulla `3113` resta collegato a
loopback dentro il container; il README di ogni template documenta il
pattern del tunnel SSH per raggiungerlo.
---
Ogni agente di coding scorda tutto quando la sessione finisce, e ogni nuova sessione inizia con te che ri-spieghi il tuo stack. agentmemory funziona in background e elimina questo passaggio.
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### vs la memoria integrata degli agenti
Ogni agente di coding AI ha una memoria integrata: Claude Code ha `MEMORY.md`, Cursor ha i notepad, Cline ha la memory bank. Funzionano come post-it. agentmemory è il database ricercabile dietro i post-it.
| | Integrata (CLAUDE.md) | agentmemory |
|---|---|---|
| Scala | Limite di 200 righe | Illimitata |
| Ricerca | Carica tutto nel contesto | BM25 + vettoriale + grafo (solo top-K) |
| Costo in token | 22K+ a 240 osservazioni | ~1,900 token (92% in meno) |
| Cross-agente | File per agente | MCP + REST (qualsiasi agente) |
| Coordinamento | Nessuno | Lease, segnali, azioni, routine |
| Osservabilità | Lettura manuale dei file | Viewer in tempo reale su :3113 |
---
### Pipeline della memoria
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### Consolidamento della memoria a 4 livelli
Modellato su come i cervelli umani elaborano la memoria, incluso il consolidamento durante il sonno.
| Livello | Cosa | Analogia |
|------|------|---------|
| **Working** | Osservazioni grezze dall'uso degli strumenti | Memoria a breve termine |
| **Episodic** | Riassunti compressi delle sessioni | "Cosa è successo" |
| **Semantic** | Fatti e pattern estratti | "Cosa so" |
| **Procedural** | Flussi di lavoro e pattern decisionali | "Come farlo" |
Le memorie decadono nel tempo (curva di Ebbinghaus). Le memorie accedute frequentemente si rafforzano. Le memorie obsolete vengono eliminate automaticamente. Le contraddizioni vengono rilevate e risolte.
### Cosa viene catturato
| Hook | Catture |
|------|----------|
| `SessionStart` | Percorso del progetto, ID sessione |
| `UserPromptSubmit` | Prompt dell'utente (filtrati per privacy) |
| `PreToolUse` | Pattern di accesso ai file + contesto arricchito |
| `PostToolUse` | Nome dello strumento, input, output |
| `PostToolUseFailure` | Contesto dell'errore |
| `PreCompact` | Reinietta la memoria prima della compattazione |
| `SubagentStart/Stop` | Ciclo di vita dei sub-agenti |
| `Stop` | Riassunto di fine sessione |
| `SessionEnd` | Marcatore di sessione completata |
### Capacità principali
| Capacità | Descrizione |
|---|---|
| **Acquisizione automatica** | Ogni uso di strumento registrato tramite hook, nessuno sforzo manuale |
| **Ricerca semantica** | BM25 + vettoriale + grafo di conoscenza con fusione RRF |
| **Evoluzione della memoria** | Versionamento, supersessione, grafi di relazioni |
| **Igiene del recall** | Le versioni superate della memoria escono dagli indici di ricerca; la catena delle versioni nel KV conserva la storia completa |
| **Suggerimenti di quasi-duplicati** | I salvataggi segnalano un match consultivo `similarTo` quando un nuovo contenuto assomiglia molto a una memoria esistente |
| **Scoping per agente** | `agentId` attraversa salvataggio e recall su REST, MCP e l'indice di ricerca, in modalità condivisa o isolata |
| **Provenienza al momento della scrittura** | Ogni osservazione e memoria porta un canale di origine immutabile (user, agent, tool, import o shared) impresso al momento della cattura, del salvataggio e dell'importazione |
| **Auto-oblio** | Scadenza TTL, rilevamento di contraddizioni, eliminazione per importanza |
| **Privacy prima di tutto** | Chiavi API, segreti, tag `` rimossi prima della memorizzazione |
| **Auto-guarigione** | Circuit breaker, catena di fallback dei provider, monitoraggio della salute |
| **Bridge Claude** | Sincronizzazione bidirezionale con MEMORY.md |
| **Grafo di conoscenza** | Estrazione di entità + attraversamento BFS |
| **Memoria di team** | Condivisa e privata con namespace tra i membri del team |
| **Provenienza delle citazioni** | Risali da qualsiasi memoria alle osservazioni di origine |
| **Snapshot Git** | Versiona, ripristina e confronta lo stato della memoria |
---
Recupero a triplo flusso che combina tre segnali:
| Flusso | Cosa fa | Quando |
|---|---|---|
| **BM25** | Corrispondenza di parole chiave con stemming ed espansione di sinonimi | Sempre attivo |
| **Vettoriale** | Similarità coseno su embedding densi | Provider di embedding configurato |
| **Grafo** | Attraversamento del grafo di conoscenza tramite corrispondenza di entità | Entità rilevate nella query |
Fuso con Reciprocal Rank Fusion (RRF, k=60) e diversificato per sessione (massimo 3 risultati per sessione).
Quando un indice vettoriale è popolato, `mem::search` (dietro `memory_recall`) usa il ranker ibrido BM25 + vettoriale. Senza embedding usa BM25. `smart-search` può inoltre fondere corrispondenze strutturali del grafo quando i dati del grafo esistono, anche in modalità keyless. Il recall delle lezioni funziona su un indice BM25 dedicato in memoria invece di scansionare l'intero corpus per ogni query. Le versioni superate della memoria sono escluse da ogni percorso di recall; la catena delle versioni conserva la loro storia.
I vettori sopravvivono a un crash o a un force-kill. L'indice vettoriale viene salvato a blocchi almeno ogni `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS` (10 minuti). Ogni vettore aggiunto o rimosso nel frattempo viene anche scritto immediatamente in un piccolo log in sospeso nello state store, e il prossimo avvio lo riapplica senza chiamare il provider di embedding. Ogni salvataggio riuscito svuota il log. I documenti che restano senza vettore dopo la riapplicazione vengono ri-embeddati in background a lotti di `AGENTMEMORY_VECTOR_BACKFILL_MAX` (500) finché non ne resta nessuno, e un backfill interrotto riprende al prossimo avvio. `/agentmemory/status` e il viewer mostrano la dimensione del log in sospeso e lo stato del backfill. Le installazioni keyless non scrivono nulla.
BM25 tokenizza nativamente greco, cirillico, ebraico, arabo e latino accentato. Per le memorie in cinese / giapponese / coreano, installa i segmentatori opzionali (`npm install @node-rs/jieba tiny-segmenter`) per dividere le sequenze CJK in token a livello di parola; senza di essi, agentmemory ricade in modo graduale sulla tokenizzazione dell'intera sequenza e stampa un suggerimento una tantum su stderr.
### Provider di embedding
Le installazioni keyless disabilitano gli embedding vettoriali: `mem::search` usa BM25, mentre `smart-search` può anche usare i dati strutturali esistenti del grafo. Per attivare gli embedding semantici gratuiti on-device, aggiungi questo a `~/.agentmemory/.env` e riavvia agentmemory:
```env
EMBEDDING_PROVIDER=local
```
L'installazione npm normale include il runtime opzionale `@huggingface/transformers`. La prima richiesta di embedding scarica `Xenova/all-MiniLM-L6-v2`, quindi serve l'accesso alla rete e può richiedere più tempo; l'inferenza successiva viene eseguita on-device. I provider remoti vengono rilevati automaticamente dalle loro chiavi a meno che `EMBEDDING_PROVIDER` non le sovrascriva.
| Provider | Modello | Costo | Note |
|---|---|---|---|
| **Locale (consigliato come opt-in)** | `all-MiniLM-L6-v2` | Gratuito | On-device dopo il primo download del modello, +8pp di recall rispetto a solo BM25 |
| Gemini | `gemini-embedding-001` | Livello gratuito | 100+ lingue, 768/1536/3072 dimensioni (MRL), input di 2048 token. Sostituisce `text-embedding-004` ([deprecato, spegnimento il 14 gennaio 2026](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | $0.02/1M | Qualità più alta |
| Voyage AI | `voyage-code-3` | A pagamento | Ottimizzato per il codice |
| Cohere | `embed-english-v3.0` | Prova gratuita | Uso generale |
| OpenRouter | Qualsiasi modello | Variabile | Proxy multi-modello |
---
54 strumenti, 6 risorse, 3 prompt e 17 skill.
> **Shim MCP vs server completo:** il pacchetto pubblicato `@agentmemory/mcp` è uno shim leggero. Espone la superficie completa di 54 strumenti **solo quando può raggiungere un server agentmemory in esecuzione** tramite `AGENTMEMORY_URL` (modalità proxy). Senza un server raggiungibile, lo shim ricade su un set locale di 7 strumenti (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`). La variabile d'ambiente `AGENTMEMORY_TOOLS=core|all` è un flag *lato server*; impostarla nel blocco `env` dello shim non ha alcun effetto. Se vedi solo 7 strumenti in Cursor / OpenCode / Gemini CLI, avvia `npx -y @agentmemory/agentmemory@latest` (o lo stack Docker) e imposta `AGENTMEMORY_URL=http://localhost:3111`.
### 54 strumenti
Tre superfici di strumenti, dalla più piccola alla più grande: `AGENTMEMORY_TOOLS=core` riduce la visibilità a 8 strumenti essenziali (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`); il set base sotto è composto dai 14 strumenti fondamentali del registro; il predefinito (`AGENTMEMORY_TOOLS=all`) espone tutti i 54.
Strumenti base (14)
| Strumento | Descrizione |
|------|-------------|
| `memory_recall` | Cerca osservazioni passate |
| `memory_compress_file` | Comprime file markdown preservando la struttura |
| `memory_save` | Salva un'intuizione, una decisione o un pattern |
| `memory_file_history` | Osservazioni passate su file specifici |
| `memory_patterns` | Rileva pattern ricorrenti |
| `memory_sessions` | Elenca le sessioni recenti |
| `memory_smart_search` | Ricerca ibrida semantica + per parole chiave |
| `memory_vision_search` | Cerca osservazioni di immagini |
| `memory_timeline` | Osservazioni in ordine cronologico |
| `memory_profile` | Profilo del progetto (concetti, file, pattern) |
| `memory_export` | Esporta tutti i dati di memoria |
| `memory_relations` | Interroga il grafo delle relazioni |
| `memory_commit_lookup` | Sessioni dietro un commit git |
| `memory_commits` | Commit registrati per una sessione |
Strumenti estesi (54 totali, la superficie predefinita)
| Strumento | Descrizione |
|------|-------------|
| `memory_patterns` | Rileva pattern ricorrenti |
| `memory_timeline` | Osservazioni in ordine cronologico |
| `memory_relations` | Interroga il grafo delle relazioni |
| `memory_graph_query` | Attraversamento del grafo di conoscenza |
| `memory_consolidate` | Esegue il consolidamento a 4 livelli |
| `memory_claude_bridge_sync` | Sincronizza con MEMORY.md |
| `memory_team_share` | Condivide con i membri del team |
| `memory_team_feed` | Elementi condivisi recenti |
| `memory_audit` | Traccia di controllo delle operazioni |
| `memory_governance_delete` | Elimina con traccia di controllo |
| `memory_snapshot_create` | Snapshot versionato con Git |
| `memory_action_create` | Crea elementi di lavoro con dipendenze |
| `memory_action_update` | Aggiorna lo stato di un'azione |
| `memory_frontier` | Azioni non bloccate classificate per priorità |
| `memory_next` | La singola azione successiva più importante |
| `memory_lease` | Lease esclusivi per azioni (multi-agente) |
| `memory_routine_run` | Istanzia routine di workflow |
| `memory_signal_send` | Messaggistica tra agenti |
| `memory_signal_read` | Legge i messaggi con ricevute |
| `memory_checkpoint` | Gate su condizioni esterne |
| `memory_mesh_sync` | Sincronizzazione P2P tra istanze |
| `memory_sentinel_create` | Osservatori basati su eventi |
| `memory_sentinel_trigger` | Attiva i sentinel dall'esterno |
| `memory_sketch_create` | Grafi di azione effimeri |
| `memory_sketch_promote` | Promuove a permanente |
| `memory_crystallize` | Compatta catene di azioni |
| `memory_diagnose` | Controlli di salute |
| `memory_heal` | Auto-correzione di stati bloccati |
| `memory_facet_tag` | Tag dimensione:valore |
| `memory_facet_query` | Interroga per tag di facet |
| `memory_verify` | Traccia la provenienza |
### 6 risorse · 3 prompt · 17 skill
| Tipo | Nome | Descrizione |
|------|------|-------------|
| Risorsa | `agentmemory://status` | Salute, conteggio sessioni, conteggio memorie |
| Risorsa | `agentmemory://project/{name}/profile` | Intelligence per progetto |
| Risorsa | `agentmemory://project/{name}/recent` | Osservazioni recenti per un progetto |
| Risorsa | `agentmemory://memories/latest` | Ultime 10 memorie attive |
| Risorsa | `agentmemory://graph/stats` | Statistiche del grafo di conoscenza |
| Risorsa | `agentmemory://team/{id}/profile` | Profilo di team condiviso |
| Prompt | `recall_context` | Cerca e restituisce messaggi di contesto |
| Prompt | `session_handoff` | Dati di passaggio tra agenti |
| Prompt | `detect_patterns` | Analizza pattern ricorrenti |
| Skill | `/recall` | Cerca nella memoria |
| Skill | `/remember` | Salva nella memoria a lungo termine |
| Skill | `/session-history` | Riassunti delle sessioni recenti |
| Skill | `/forget` | Elimina osservazioni/sessioni |
La tabella mostra le quattro skill core. Il set completo è di 9 skill invocabili più 8 skill di riferimento; vedi la sezione Skill native sopra.
### MCP standalone
Eseguilo senza il server completo, per qualsiasi client MCP. Funziona uno dei due:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
Oppure aggiungi alla configurazione MCP del tuo agente:
La maggior parte degli agenti (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
Unisci la voce `agentmemory` nell'oggetto `mcpServers` esistente del tuo host invece di sostituire il file. Per i client in sandbox che non possono raggiungere il `localhost` dell'host, aggiungi `"AGENTMEMORY_FORCE_PROXY": "1"` al blocco env e imposta `AGENTMEMORY_URL` su una rotta che la sandbox possa raggiungere.
OpenCode (`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
Copia il file del plugin dal repository:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---
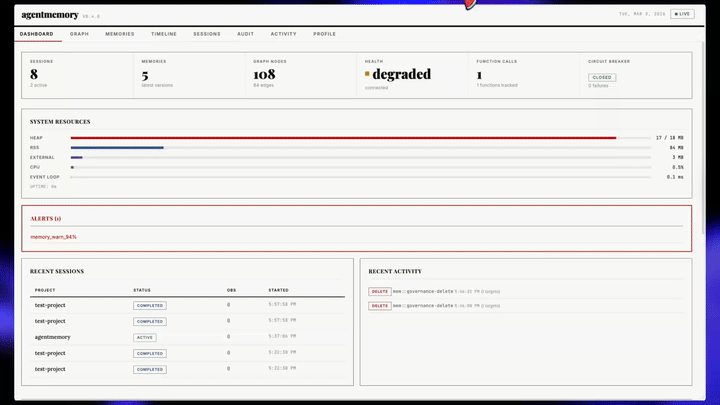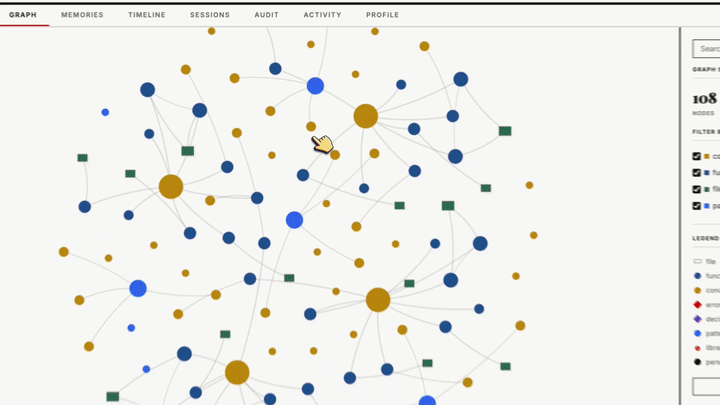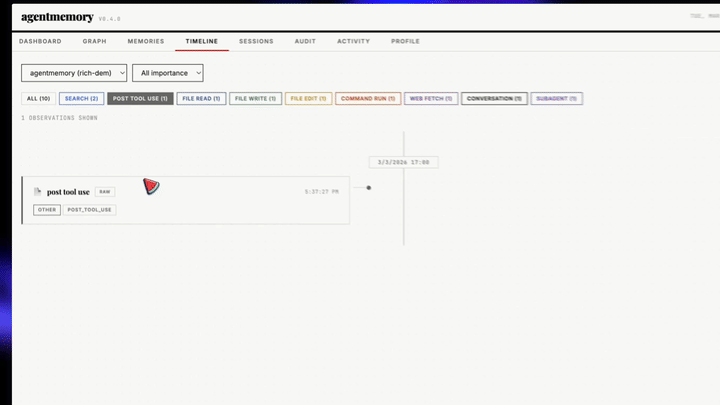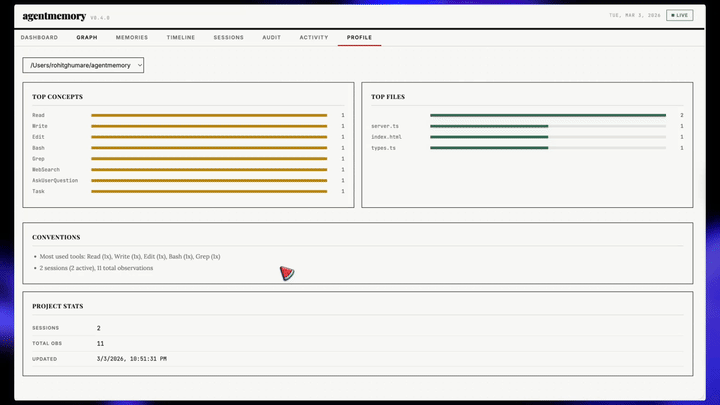
Si avvia automaticamente sulla porta `3113`. Il viewer carica uno snapshot quando si connette (`GET /agentmemory/viewer/snapshot`) e poi applica eventi di stream dal vivo: nuove memorie, lezioni, osservazioni, voci di audit, cambiamenti del grafo e aggiornamenti di salute appaiono senza polling o ricaricamenti di pagina. Le uniche altre richieste sono le azioni che clicchi, le pagine "carica altro" e le ricerche. Quando lo stream si interrompe, il viewer mostra quanto sono vecchi i suoi numeri, si riconnette con backoff e si risincronizza da uno snapshot.
- **12 tab in quattro gruppi** con conteggi dal vivo, deep link (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), scorciatoie da tastiera e un menu mobile.
- **Memorie:** ricerca lato server, filtri per progetto, agente e tipo, un pannello di dettaglio con la catena delle versioni e un diff per parola, link di provenienza, pulsanti copia per l'id, la chiamata MCP e un comando curl, modifica (una nuova versione), dimentica con conferma, dimentica in blocco ed esportazione JSON.
- **Sessioni:** una timeline di osservazioni inline con input e output degli strumenti leggibili, filtri e paginazione, e le memorie e le lezioni prodotte da ogni sessione.
- **Grafo:** ricerca, dettaglio del nodo con relazioni e fonti, una legenda che non si basa solo sul colore, e controlli di zoom.
- **Salute:** la versione dal vivo di `GET /agentmemory/status`. Ogni problema arriva con la sua soluzione, oltre al backend di stato, lo stato di salvataggio dell'indice, l'avanzamento della compattazione della provenienza del grafo e una spiegazione del consolidamento con le soglie reali.
- Pagine **Audit, Attività, Profilo, Replay, Lezioni, Azioni e Cristalli**, ognuna con uno stato vuoto che spiega cosa è la sezione, perché è vuota e il comando che la popola, e un tooltip glossario `?` su ogni termine e numero.
```bash
open http://localhost:3113
```
Il server del viewer si collega a `127.0.0.1` per impostazione predefinita e aggiunge il secret del server quando inoltra le richieste all'API REST, quindi non richiede configurazione. L'endpoint `/agentmemory/viewer` servito via REST segue le normali regole del bearer-token e reindirizza i browser senza token alla porta del viewer. Gli header CSP usano un nonce dello script per risposta e disabilitano gli attributi di gestore inline (`script-src-attr 'none'`).
---
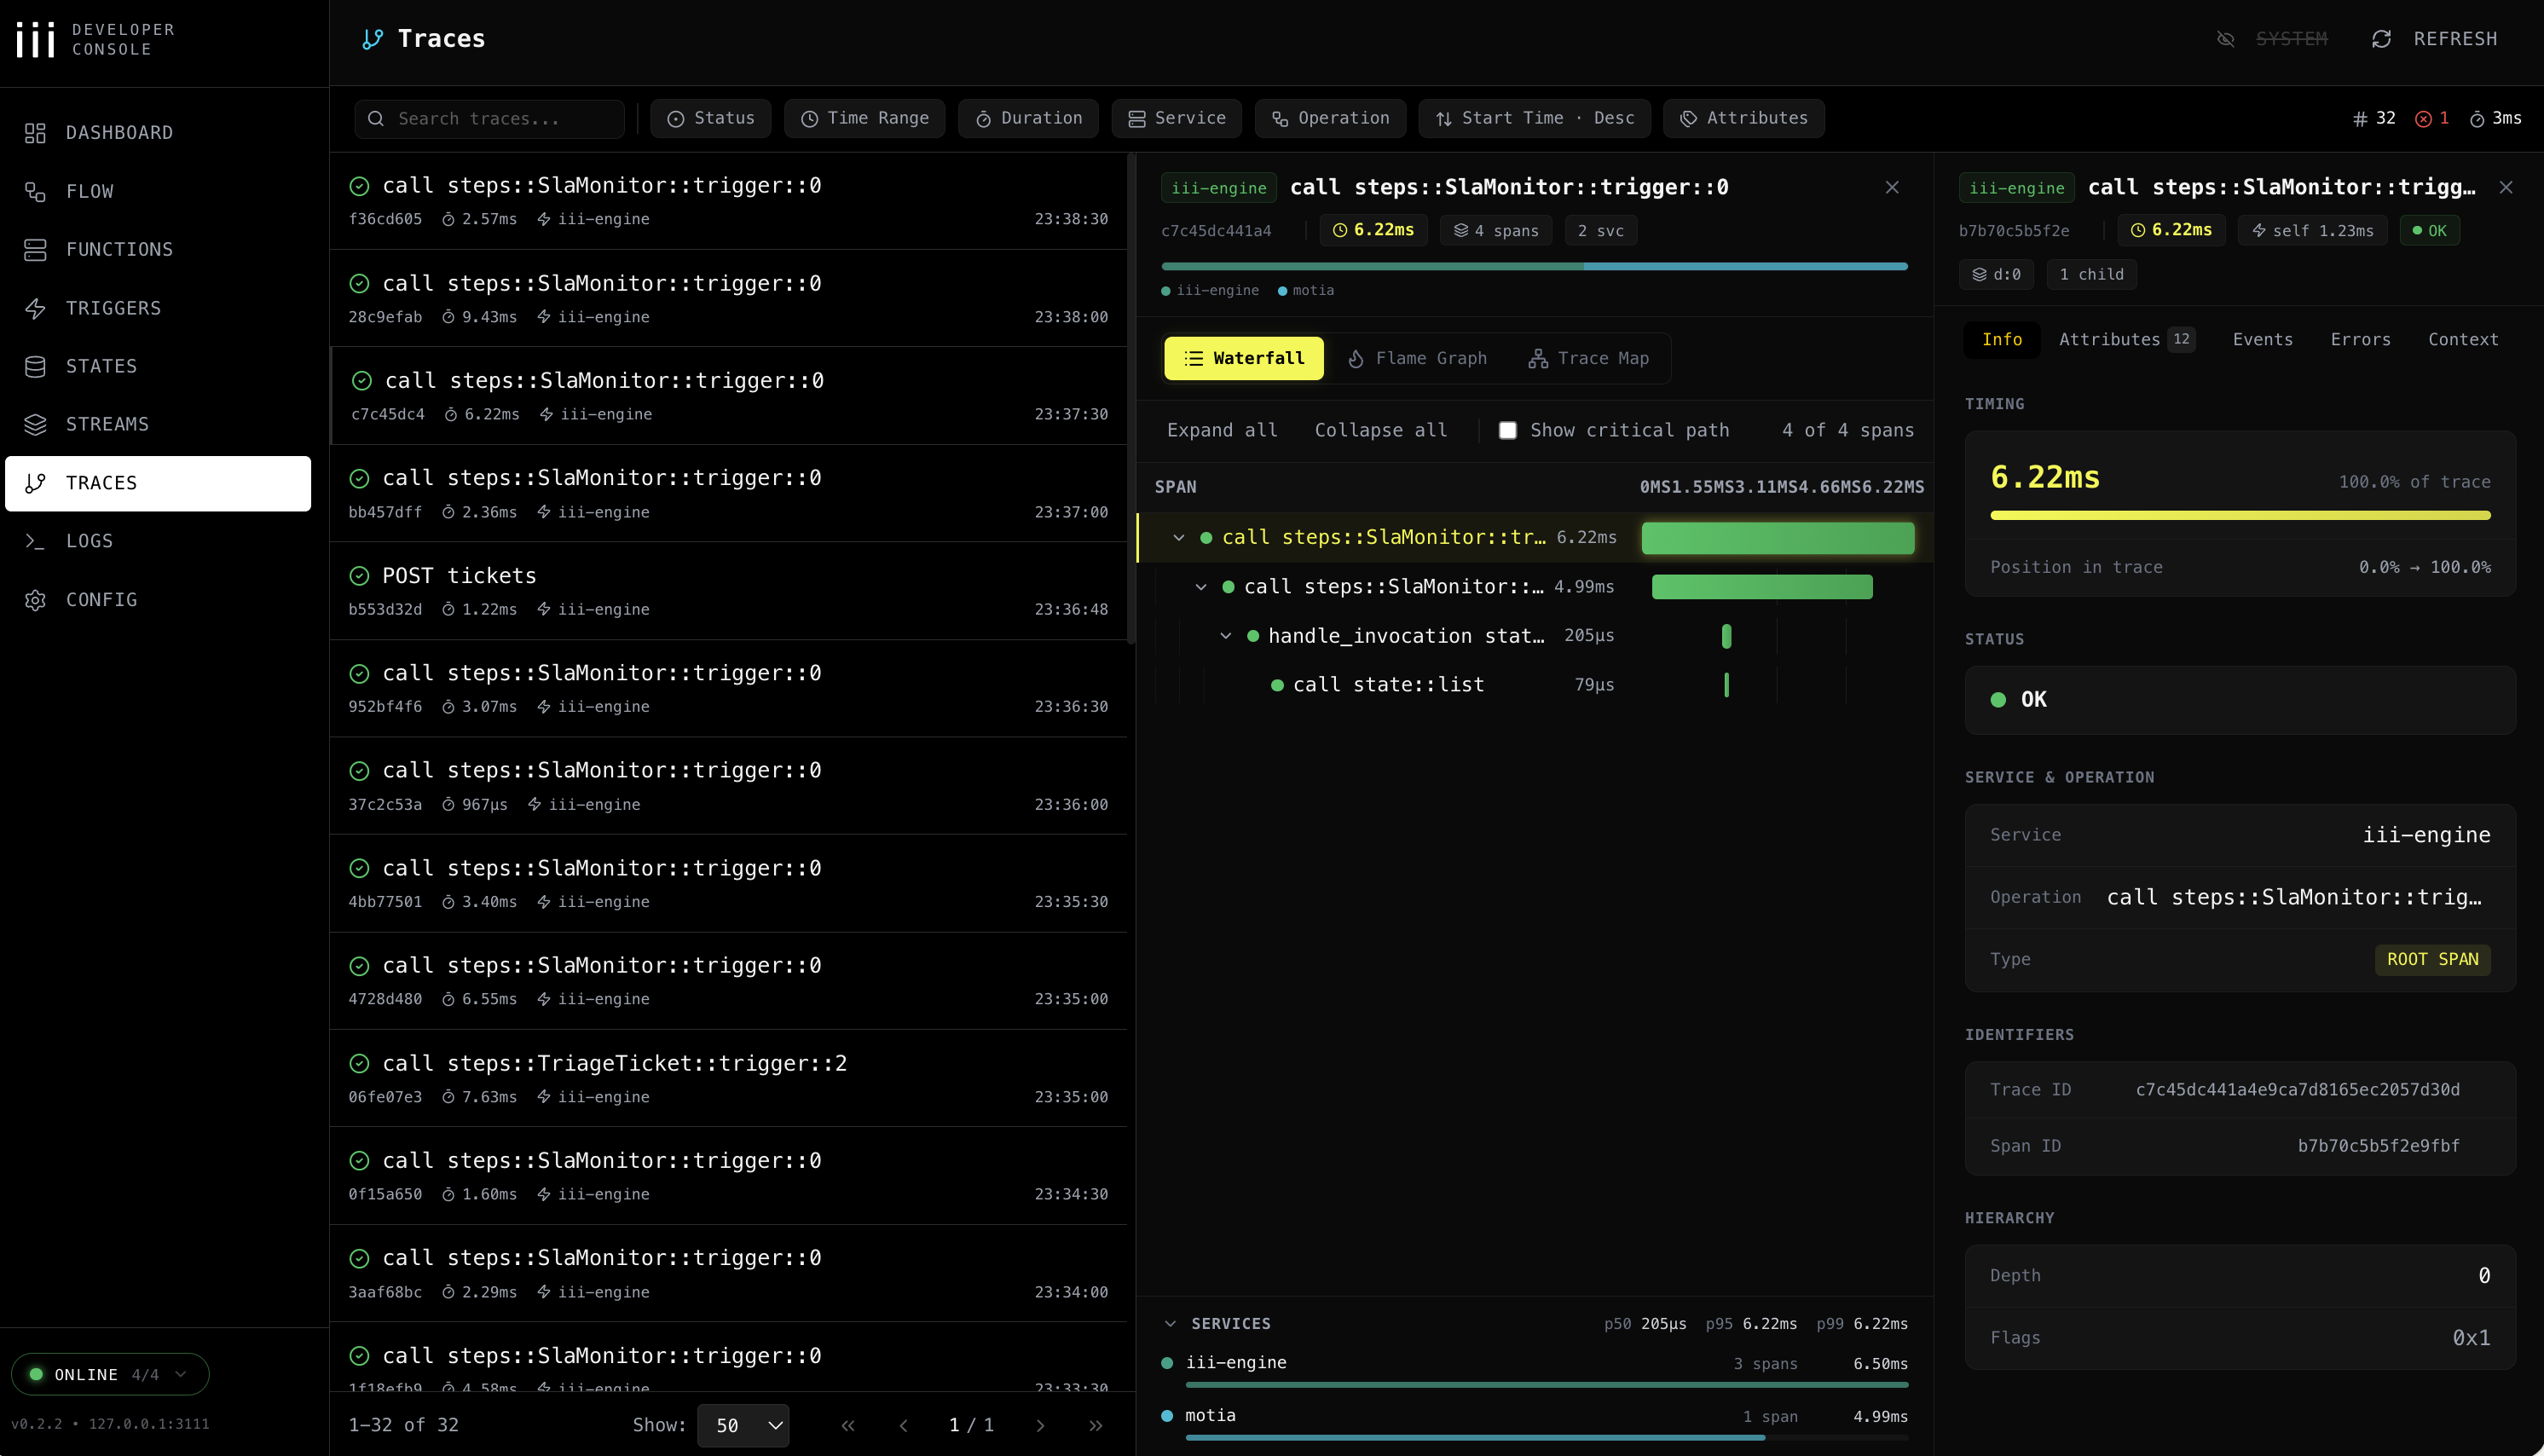
Il viewer su `:3113` mostra ciò che il tuo agente **ha ricordato**. La [iii console](https://iii.dev/docs/console) mostra ciò che il tuo agente **ha fatto**: ogni operazione di memoria come traccia OpenTelemetry, ogni voce KV modificabile, ogni funzione invocabile, ogni stream intercettabile. Due finestre sulla stessa memoria: una a forma di prodotto, una a forma di engine.
Osserva l'attivazione di una `memory_smart_search` e guarda la scansione BM25 → ricerca embedding → fusione RRF → reranker come un waterfall. Modifica un timer di consolidamento bloccato nel browser KV. Riproduci un hook `PostToolUse` con un payload modificato. Fissa lo stream WebSocket e guarda le osservazioni arrivare dal vivo.
agentmemory offre tutto questo gratis perché ogni chiamata di funzione e trigger passa attraverso iii; niente di personalizzato, niente da strumentare.
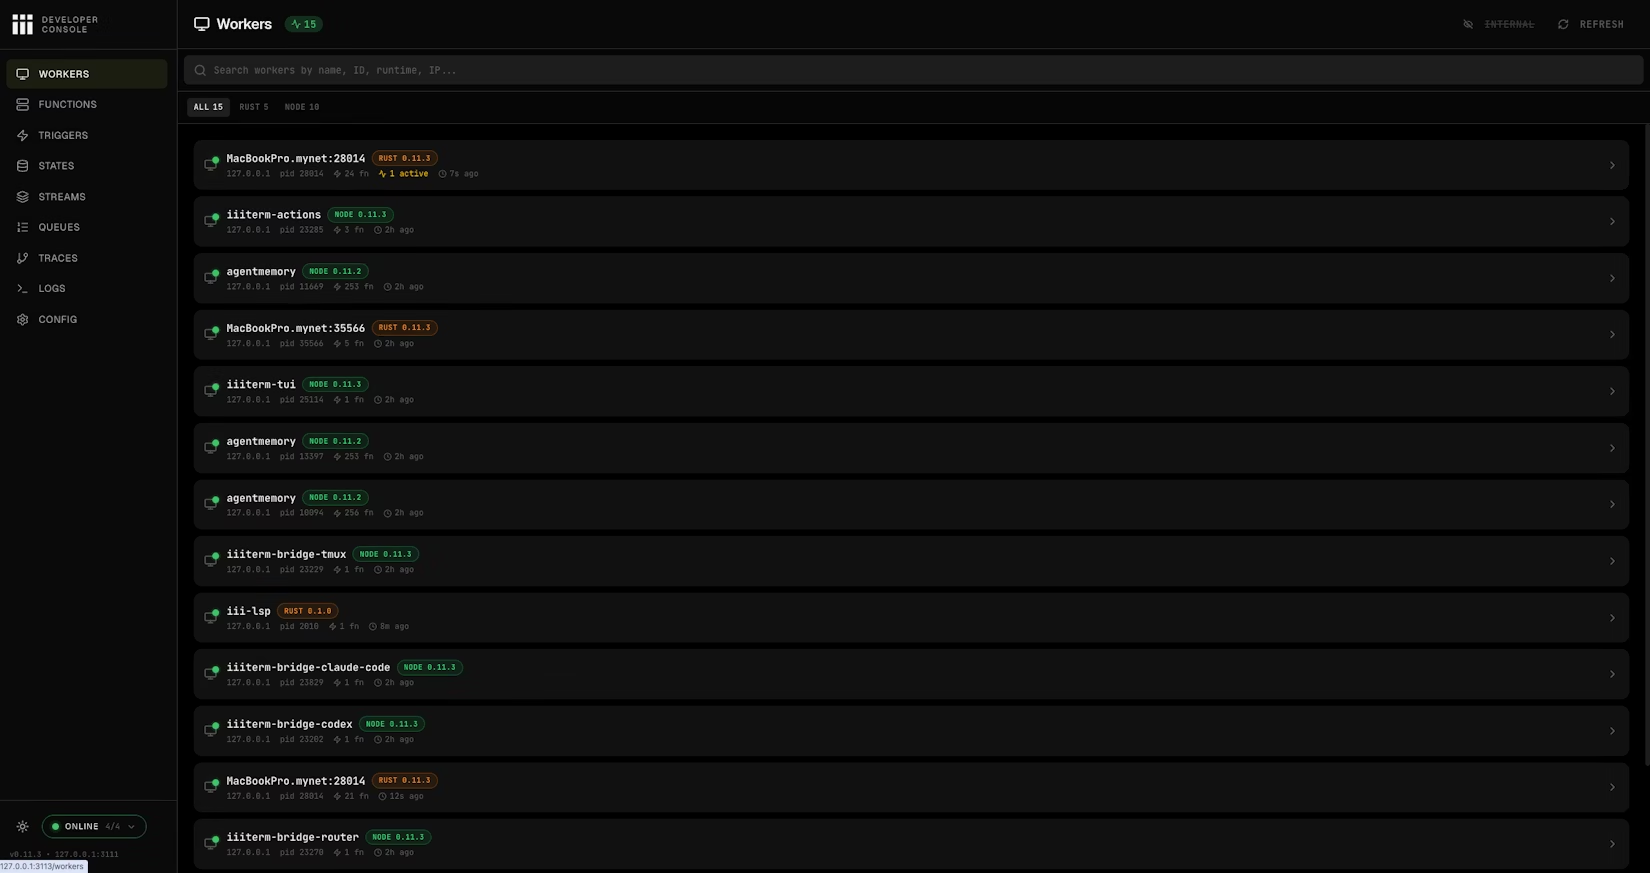
Pagina Workers: ogni worker connesso, incluso agentmemory stesso, con PID, conteggio delle funzioni, runtime e ultimo avvistamento.
**Già installata.** La console viene distribuita con l'engine `iii` fissato (0.22+); nulla da installare separatamente. Il primo avvio scarica il binario della console accanto all'engine.
**Avviala insieme ad agentmemory:**
```bash
agentmemory console
```
Questo esegue `iii console` dell'engine fissato contro le porte risolte da agentmemory (REST, stream, bridge) e la serve una porta sopra il viewer, `http://localhost:3114` per impostazione predefinita. `--console-port N` ne scelgie un'altra; `--port` e `--instance` selezionano l'istanza agentmemory nello stesso modo in cui lo fanno per `stop`; qualsiasi altro flag viene passato direttamente, ad esempio `--enable-flow` per la pagina sperimentale del grafo di architettura.
La stessa cosa a mano, utile quando `agentmemory` non è nel PATH:
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**Cosa puoi fare dalla console:**
| Pagina | Usala per |
|------|-----------|
| **Workers** | Vedere ogni worker connesso e le sue metriche dal vivo, incluso il worker agentmemory stesso. |
| **Functions** | Invocare direttamente qualsiasi funzione di agentmemory con un payload JSON; utile per testare `memory.recall`, `memory.consolidate`, `graph.query` senza collegare un client. |
| **Triggers** | Riprodurre trigger HTTP, cron, evento e stato: far scattare manualmente il cron di consolidamento, ritentare una rotta HTTP, emettere un cambiamento di stato. |
| **States** | Browser KV con CRUD completo su sessioni, slot di memoria, timer del ciclo di vita e indice degli embedding; modifica i valori sul posto. |
| **Streams** | Monitor WebSocket dal vivo per scritture di memoria, eventi degli hook e aggiornamenti delle osservazioni mentre fluiscono attraverso gli stream iii. |
| **Queues** | Topic di coda durevoli + gestione delle dead-letter. Riproduci o scarta i job di embedding/compressione falliti. |
| **Traces** | Vista waterfall / flame / scomposizione per servizio di OpenTelemetry. Filtra per `trace_id` per vedere esattamente quali funzioni, chiamate DB e richieste di embedding ha prodotto una singola `memory.search`. |
| **Logs** | Log OTEL strutturati filtrati e correlati agli ID di trace/span. |
| **Config** | Configurazione runtime: vedi esattamente con quali worker, provider e porte sta funzionando il tuo engine. |
| **Flow** | (Opzionale, `--enable-flow`) Grafo di architettura interattivo di ogni worker, trigger e stream. |
Traces: vista waterfall / flame / scomposizione per servizio per ogni operazione di memoria.
**Le tracce sono già attive:**
`iii-config.yaml` viene distribuito con il worker `iii-observability` abilitato (`exporter: memory`, `sampling_ratio: 0.1`, metriche + log). Nessuna configurazione extra necessaria; nel momento in cui agentmemory si avvia, ogni operazione di memoria emette un log strutturato che la console può leggere, e una su dieci di esse (`sampling_ratio: 0.1`) emette anche uno span di traccia.
Se vuoi esportare verso Jaeger/Honeycomb/Grafana Tempo invece, cambia `exporter: memory` in `exporter: otlp` e imposta l'endpoint del collector secondo la documentazione di osservabilità di iii.
> **Attenzione:** nessuna autenticazione è applicata sulla console stessa; mantienila collegata a `127.0.0.1` (il default) e non esporla mai pubblicamente.
---
agentmemory è **già un'istanza [iii](https://iii.dev) in esecuzione**. Tre primitive (worker, function, trigger) compongono il runtime; lo stato KV, gli stream e le tracce OTEL provengono dai worker iii-state, iii-stream e iii-observability distribuiti con iii. Non hai installato Postgres, Redis, Express, pm2 o Prometheus, perché iii li sostituisce.
Questo significa che un comando in più estende agentmemory con un'intera nuova capacità.
### Estendi agentmemory con altri worker
I builtin di cui agentmemory ha bisogno sono già in `iii-config.yaml` e si avviano con esso: `iii-state` (KV), `iii-queue` (retry durevoli per i subscriber di eventi), `iii-pubsub`, `iii-cron`, `iii-stream` e `iii-observability` (tracce, metriche e log OTEL su ogni funzione). Qualsiasi altra cosa dal [registro dei worker iii](https://workers.iii.dev) si collega allo stesso engine: copia `iii-config.yaml` in `~/.agentmemory/iii-config.yaml` (la CLI preferisce quel file rispetto a quello incluso e vi rende ancora porte e percorsi dei dati), aggiungi la voce, installa il runtime del worker una volta con `~/.agentmemory/bin/iii update worker`, e riavvia agentmemory.
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | Cosa ottieni in più rispetto ad agentmemory |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | Adapter di stato basato su SQL quando superi i default KV in memoria |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | Il codice uscito da `memory_recall` viene eseguito dentro una VM usa e getta, non nella tua shell |
| [`mcp`](https://workers.iii.dev/workers/mcp) | Avvia altri server MCP accanto a quello di agentmemory, condividendo lo stesso engine |
Sull'engine 0.22.x mantieni i nomi con prefisso `iii-` per i builtin sopra; le voci senza prefisso `http`, `state`, `queue`, `pubsub` e `cron` sono i worker standalone del registro verso cui agentmemory si sposta con la migrazione alla 0.23.
Registro completo: [workers.iii.dev](https://workers.iii.dev). Ogni worker lì compone attraverso le stesse primitive che usa agentmemory, e l'agentmemory che hai già è uno di loro.
### Configurazione dell'engine e indirizzo di bind
`agentmemory start` legge la configurazione dell'engine dal primo file che esiste: `AGENTMEMORY_III_CONFIG`, `./iii-config.yaml` nella directory corrente, `~/.agentmemory/iii-config.yaml`, poi il `iii-config.yaml` incluso. A ogni avvio rende quel file (percorsi dei dati, porte, backend di stato) in `~/.agentmemory/data/iii-config.runtime.yaml` e avvia l'engine con la copia resa, quindi modifica il file sorgente, non quello reso. I valori `host:` del file sorgente vengono mantenuti come scritti.
Il `iii-config.yaml` incluso si collega a `127.0.0.1` di proposito, e quel default si applica anche dentro un container. Una CLI avviata in un container si collega al loopback del container, quindi le porte pubblicate non raggiungono nulla. Per servire una CLI containerizzata tramite le porte pubblicate, imposta `AGENTMEMORY_III_CONFIG` su una configurazione che si collega a `0.0.0.0`. Il `iii-config.docker.yaml` incluso è una di queste: collega `iii-http`, `iii-stream` e la porta dell'engine a `0.0.0.0` e memorizza lo stato sotto `/data`, quindi monta lì un volume scrivibile. Mantieni `AGENTMEMORY_SECRET` impostato, e pubblica solo le porte di cui hai bisogno, su `127.0.0.1` o dietro un proxy di cui ti fidi.
Il `docker-compose.yml` di questo repository non passa attraverso la ricerca di configurazione della CLI: monta `iii-config.docker.yaml` su `/app/config.yaml`, e il container `iii-engine` si avvia con `--config /app/config.yaml`. I template di [deploy](../deploy/) one-click scrivono la propria configurazione `0.0.0.0` nei loro entrypoint.
### Backend di storage: file (predefinito) vs redis
`iii-state` e `iii-stream` usano per default lo store KV basato su file incluso in iii-engine: un file JSON per scope, mantenuto nella memoria del processo dell'engine e riscritto su disco a intervalli. È il default giusto per un'installazione locale a utente singolo; un daemon condiviso con diversi scrittori simultanei ottiene scritture per-chiave reali da Redis invece, al costo di un round trip di rete per operazione (ogni chiamata `state::*` si serializza ancora su una connessione Redis, quindi questo scambia il lock dello store a file per un socket, non per il parallelismo).
Imposta `AGENTMEMORY_STATE_BACKEND=redis` (più `AGENTMEMORY_REDIS_URL`) per far passare entrambi i worker all'adapter `redis` integrato di iii-engine, che memorizza ogni chiave come campo di un hash Redis (`HSET`) invece di riscrivere un intero scope a ogni scrittura:
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` ha come default `file`; lasciarlo non impostato mantiene inalterato il comportamento attuale, e un valore non riconosciuto (qualsiasi cosa diversa da `file` o `redis`) è un errore di avvio piuttosto che un fallback silenzioso. `/agentmemory/status` e la pagina Health del viewer (la riga dello state store) riportano quale backend è attivo e se risponde, mai l'URL.
**Solo `redis://` semplice.** L'engine fissato (0.22.1) costruisce il suo client Redis senza supporto TLS, quindi un URL `rediss://` (la maggior parte delle offerte Redis gestite, come Upstash, Redis Cloud ed ElastiCache con crittografia in transito, è predefinita a solo-TLS) non riesce a connettersi. La connessione è non crittografata, quindi la password Redis e ogni memoria salvata attraversano la rete in chiaro: puntala a un Redis locale o su una rete privata di cui ti fidi. Per qualsiasi altro Redis, esegui un tunnel crittografato (stunnel, SSH o una VPN) sull'host di agentmemory, così il salto `redis://` semplice resta su quell'host e la connessione a monte del tunnel è crittografata e autenticata. Se una password Redis contiene un apostrofo, codificalo in percent-encoding (`%27`); l'engine espande l'URL nella sua configurazione YAML prima di analizzarlo.
**Un server Redis per ogni `--instance`.** I prefissi delle chiavi Redis dell'engine (`state:`, `stream::`) sono fissi, quindi due istanze di agentmemory (`--instance 1`, `--instance 2`, ...) puntate allo stesso database si sovrascrivono i dati a vicenda. Un indice di database separato (`redis://localhost:6379/1`) mantiene separati i dati memorizzati, ma l'engine fa da relay per gli eventi del viewer dal vivo su un unico canale pub/sub Redis (`stream::events`), e il pub/sub di Redis ignora l'indice del database, quindi il viewer di ogni istanza mostrerebbe comunque gli eventi dal vivo dell'altra. Dai a ogni istanza il proprio server Redis (o la propria porta) quando ne esegui più di una.
**Cosa resta uguale, e cosa cambia.** Ogni funzionalità di agentmemory funziona su Redis: sessioni, osservazioni, memorie (remember, supersede, evolve, forget), ricerca e i bucket dell'indice, lezioni, il grafo, il log di audit e i suoi scope mensili, export e import, eliminazioni di governance, stato del consolidamento, lo snapshot del viewer e il suo stream dal vivo, e il monitor di salute. L'engine memorizza ogni scope come un hash Redis (`HSET`/`HGET`/`HGETALL`) e fa scattare gli stessi trigger di stato dello store a file. Tre differenze dell'engine sono gestite dentro agentmemory:
- Redis restituisce i record di uno scope in nessun ordine fisso. agentmemory li ordina prima i più vecchi (per il momento di creazione nell'id del record, poi il suo timestamp) così liste, paginazione e blocchi di export tornano nello stesso ordine dello store a file.
- L'engine applica gli aggiornamenti parziali su Redis in uno script Lua che trasforma gli array vuoti in oggetti vuoti. agentmemory applica quegli aggiornamenti da sé (legge, modifica, scrive sotto un lock per chiave) su Redis, così campi come `tags: []` restano array.
- Il controllo legacy del log di audit legge il vecchio scope da Redis invece di cercare il file dello store su disco.
Una differenza richiede il tuo intervento: **dopo il riavvio di Redis, l'engine smette di fare il relay degli eventi dal vivo** verso il viewer finché agentmemory non viene riavviato. I dati continuano a essere salvati e letti normalmente. Il monitor di salute invia un evento di test attraverso Redis ogni 30 secondi; quando non torna, `/agentmemory/status` e la pagina Health del viewer mostrano "Gli aggiornamenti dal vivo non raggiungono il viewer" con la soluzione: riavvia agentmemory. Se Redis è down, il report di stato mostra "Lo state store non risponde" e come verificarlo (`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`). Elencare uno scope molto grande legge l'intero hash in un unico `HGETALL`, lo stesso costo dello store a file che lo mantiene in memoria.
**Impostazioni Redis consigliate.** La policy di snapshot predefinita `save 3600 1 300 100 60 10000` può perdere minuti di scritture in caso di crash, peggio della finestra di flush di 5s dello store a file. Imposta `appendonly yes` per qualsiasi cosa di cui ti importerebbe la perdita. Imposta `maxmemory-policy noeviction`; `allkeys-lru` o simili eliminano silenziosamente le memorie una volta che Redis raggiunge il suo limite di memoria.
Un avvio nativo (non-Docker), e ogni [template di deploy](../deploy/) one-click (sovrascrivono il `iii-config.yaml` incluso e si avviano nativamente), leggono `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` e li rendono nel `iii-config` avviato. L'URL stesso non viene mai scritto in quel file reso, solo un riferimento `${AGENTMEMORY_REDIS_URL}` che il processo dell'engine espande dal proprio ambiente all'avvio. Solo il percorso Docker Compose di questo stesso repository (`AGENTMEMORY_USE_DOCKER=1`, o la ripresa di un engine già avviato in quel modo) monta `iii-config.docker.yaml` in sola lettura e non lo rende mai; `agentmemory start` avvisa quando rileva questa combinazione. Cambia quel file a mano, seguendo la stessa forma `name: redis` / `config: redis_url: ...` mostrata nella documentazione dei worker [iii-state](https://workers.iii.dev/workers/iii-state) e [iii-stream](https://workers.iii.dev/workers/iii-stream), e punta `redis_url` a un Redis raggiungibile dal container. `docker-compose.yml` passa `AGENTMEMORY_REDIS_URL` nel container dell'engine, quindi `redis_url: '${AGENTMEMORY_REDIS_URL}'` funziona lì e mantiene l'URL fuori dal file montato.
La configurazione resa mantiene l'URL fuori da `~/.agentmemory/data/iii-config.runtime.yaml`, ma il worker di configurazione dell'engine stesso persiste comunque il valore *espanso* in `~/.agentmemory/config/iii-state.yaml` e `iii-stream.yaml` una volta avviato (l'espansione `${VAR}` di iii-engine avviene prima che quel worker memorizzi il suo seed, e memorizza il valore risolto, non il riferimento). Tratta quella directory come se contenesse una credenziale: `chmod 700 ~/.agentmemory` su qualsiasi host condiviso, e preferisci un utente ACL Redis con ambito limitato a ciò di cui agentmemory ha bisogno piuttosto che le credenziali admin del database.
**La migrazione non è automatica.** Passare `AGENTMEMORY_STATE_BACKEND` parte da uno store vuoto su entrambi i lati; nulla copia i dati esistenti da file a Redis o viceversa. Esporta dal backend che stai lasciando e importa in quello verso cui ti stai spostando. Questo funziona identicamente sotto bash e zsh (incluso `bash -u`). Un array come `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` non funziona: zsh mantiene l'header come una singola parola malformata dove bash lo divide in due, quindi entrambe le richieste restituiscono 401 ogni volta che `AGENTMEMORY_SECRET` è impostato:
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` accetta anche `?maxSessions=` e `?offset=` per suddividere un corpus grande su più chiamate; `strategy` nell'import è `merge` (predefinito, sicuro), `replace`, o `skip`.
### Cosa sostituisce iii
| Stack tradizionale | agentmemory usa |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + indice vettoriale in memoria |
| SSE / Socket.io | iii Streams (WebSocket) |
| pm2 / systemd | Supervisione dei worker dell'engine iii |
| Prometheus / Grafana | iii OTEL + monitor di salute |
| Sistemi di plugin personalizzati | `iii worker add ` |
**219 file sorgente · ~52,000 righe di codice · 2,500+ test · 311 funzioni · 60 scope KV**, tutto su tre primitive. Nessun `agentmemory plugin install`. Il sistema di plugin è iii stesso.
---
### Provider LLM
agentmemory rileva automaticamente i provider dal tuo ambiente. Un provider rende disponibili le operazioni basate su LLM, ma la sola configurazione del provider non attiva la compressione delle osservazioni scritta da un LLM. Quel percorso richiede sia un provider sia `AGENTMEMORY_AUTO_COMPRESS=true`.
| Provider | Configurazione | Note |
|----------|--------|-------|
| **No-op (predefinito)** | Nessuna configurazione necessaria | Compress/summarize basati su LLM disabilitati. La compressione sintetica e il recall BM25 funzionano comunque. Vedi `AGENTMEMORY_ALLOW_AGENT_SDK` sotto se facevi affidamento sul fallback dell'abbonamento Claude. |
| Anthropic API | `ANTHROPIC_API_KEY` | Fatturazione per token |
| MiniMax | `MINIMAX_API_KEY` | Compatibile con Anthropic |
| Gemini | `GEMINI_API_KEY` | Abilita anche gli embedding |
| OpenRouter | `OPENROUTER_API_KEY` | Qualsiasi modello |
| OpenAI API | `OPENAI_API_KEY` | Predefinito `gpt-5.6-luna`, sovrascrivi con `OPENAI_MODEL` |
| **Locale (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) oppure `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | Qualsiasi cosa compatibile con l'API OpenAI. Costo zero, funziona sul tuo hardware. Vedi [Modelli locali](#local-models-ollama--lm-studio--vllm) sotto. |
| Fallback abbonamento Claude | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | Solo opt-in. Avvia sessioni `@anthropic-ai/claude-agent-sdk`; in passato causava una ricorsione illimitata dell'hook Stop, quindi non è più il predefinito. |
### Modelli locali (Ollama / LM Studio / vLLM)
agentmemory parla con qualsiasi server compatibile con l'API OpenAI, quindi qualsiasi cosa esponga `/v1/chat/completions` funziona senza modifiche al codice. Nessuna chiave a pagamento, nessun cloud, nessun limite di rate; funziona interamente sul tuo hardware.
**Ollama** (porta predefinita `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio** (porta predefinita `1234`):
Apri LM Studio → tab Local Server → Start Server. Scegli qualsiasi modello di chat dal selettore (Qwen 3, gpt-oss, DeepSeek R1, ecc.).
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**: stessa forma. Punta `OPENAI_BASE_URL` all'URL esposto dal tuo server e imposta `OPENAI_MODEL` su un nome che il tuo server accetterà.
**Scelte di modello per il lavoro di memoria**: compressione e riassunto sono compiti brevi (<2K token in ingresso, <500 token in uscita) dove un modello instruct da 7B è più che sufficiente. Raccomandazioni:
| Modello | Dimensione | Perché |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | Default equilibrato su una macchina da 16 GB; forte nell'estrazione e nel testo a forma di strumento |
| `qwen3:4b` | ~2.6 GB | Opzione più piccola ragionevole; va bene per la compressione, più debole per l'estrazione del grafo |
| `qwen3-coder:30b` | ~19 GB | Migliore scelta locale per sessioni a forma di codice (30B MoE, 3.3B attivi) su hardware da 24-32 GB |
| `gpt-oss:20b` | ~14 GB | Modello generale forte che entra in 16 GB di RAM |
| `deepseek-r1:8b` | ~5.2 GB | Distillazione di reasoning; più lento ma estrazioni più pulite |
I modelli Qwen 3 "pensano" per default e possono bruciare tutto il budget di token nel reasoning prima di qualsiasi output. Imposta `AGENTMEMORY_LLM_NOTHINK=1` per aggiungere `/no_think` ai prompt di estrazione del grafo, e aumenta `MAX_TOKENS` (16384 funziona) se le estrazioni tornano vuote.
I modelli di classe reasoning (stile `o1` con blocchi ``) possono restituire un `content` vuoto con un campo `reasoning` che il tuo server locale potrebbe non esporre. Se le estrazioni tornano vuote, passa prima a un modello non-reasoning. La variabile d'ambiente `OPENAI_REASONING_EFFORT=none` può anche disabilitare il pensiero sui modelli di pensiero di Ollama Cloud che rispecchiano lo schema di reasoning di OpenAI.
Gli embedding locali sono distribuiti come dipendenza opzionale ma non sono abilitati per default. Imposta `EMBEDDING_PROVIDER=local` per attivare `Xenova/all-MiniLM-L6-v2` (384 dimensioni). La prima richiesta di embedding scarica il modello; l'inferenza è on-device in seguito. Senza quell'impostazione o una chiave di embedding remota, i vettori restano disabilitati, `mem::search` usa BM25, e `smart-search` può comunque aggiungere corrispondenze del grafo esistenti.
### Selezione del modello consapevole dei costi
Quando la compressione in background scritta da un LLM è abilitata con sia un provider sia `AGENTMEMORY_AUTO_COMPRESS=true`, viene eseguita su ogni osservazione, quindi la scelta del modello cambia in modo significativo la spesa mensile. Dati del carico di lavoro catturato: 635 richieste / 888K token / 35 ore di uso attivo, eseguite contro tre modelli OpenRouter con i prezzi del 2026-05-23.
| Livello | Modello | Input / 1M | Output / 1M | Costo per le 35h catturate | Note |
|------|-------|------------|-------------|---------------------------|-------|
| Consigliato | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07 (stimato) | DeepSeek più recente; la scelta consigliata più economica per i carichi di lavoro di compressione. |
| Consigliato | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | Solida qualità di compressione + riassunto a un costo ~10× inferiore rispetto a Sonnet. |
| Consigliato | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | Forte reasoning sul codice se le tue sessioni sono fortemente orientate al codice. |
| Premium | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02 (stimato) | Stesso prezzo di listino dell'esecuzione misurata su Sonnet 4.6; prezzo introduttivo $2/$10 fino al 2026-08-31. |
| Premium | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9 (stimato) | Livello flagship; costoso per lavoro in background always-on. |
| Da evitare | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40 (stimato) | Modello di classe flagship; spesa eccessiva per la compressione. |
Le righe misurate provengono dall'esecuzione catturata; le righe (stimato) scalano lo stesso mix di token secondo il prezzo di listino di ciascun modello.
agentmemory stampa un avviso a runtime quando `OPENROUTER_MODEL` corrisponde a un pattern di livello premium. Imposta `AGENTMEMORY_SUPPRESS_COST_WARNING=1` per silenziarlo una volta fatta una scelta informata.
Compromesso qualità vs costo per il lavoro di memoria: la compressione è un compito di riassunto con soglie di qualità relativamente permissive (l'agente rilegge il riassunto, non l'utente). DeepSeek V4 Flash / V4 Pro / Qwen3-Coder restano nel margine d'errore rispetto a Sonnet su questo compito costando 10-70× meno. Riserva i modelli di livello premium alle query che leggi direttamente.
Fonti: [prezzi OpenRouter per Claude Sonnet 5](https://openrouter.ai/anthropic/claude-sonnet-5), [DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731), [note sui prezzi DeepSeek](https://api-docs.deepseek.com/quick_start/pricing/).
### Memoria multi-agente (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
Nelle configurazioni multi-agente dove diversi ruoli condividono un server agentmemory (architetto / sviluppatore / revisore / ricercatore / agente di supporto), `AGENT_ID` etichetta ogni scrittura con il ruolo che l'ha fatta. `AGENTMEMORY_AGENT_SCOPE` controlla se il recall filtra per quella etichetta.
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
Due modalità:
| Modalità | Etichetta le scritture | Filtra il recall | Quando usarla |
|------|------------|---------------|-------------|
| `shared` (predefinita) | sì | no | Contesto cross-agente con traccia di controllo. L'architetto può vedere ciò che lo sviluppatore ha annotato, ma ogni riga registra chi lo ha detto. |
| `isolated` | sì | sì | Separazione stretta. L'architetto non vede mai le osservazioni/memorie/sessioni dello sviluppatore. |
Cosa viene etichettato quando `AGENT_ID` è impostato: `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId`. Il ruolo fluisce da `api::session::start` → `mem::observe` → `mem::compress` → KV.
Cosa viene filtrato in modalità isolata: `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions`. Ogni endpoint accetta `?agentId=` per sovrascrivere per-richiesta, e `?agentId=*` per disattivare completamente lo scope dell'ambiente. `/memories` accetta anche `?includeOrphans=true` per far emergere le memorie precedenti ad `AGENT_ID` il cui `agentId` è indefinito.
Override per-chiamata a livello di SDK / REST: ogni endpoint che muta (`/session/start`, `/remember`) accetta un campo `agentId` nel corpo della richiesta che vince sull'ambiente. Utile per i runtime che instradano molti ruoli attraverso un singolo processo server. Lo strumento MCP `memory_save` espone lo stesso campo `agentId`, il server stdio standalone trasmette sia `agentId` sia `project`, e le memorie salvate portano `agentId` nell'indice di ricerca, così la ricerca con ambito agente copre anche le memorie oltre alle osservazioni.
Quando `AGENT_ID` non è impostato, la memoria resta senza ambito (comportamento legacy, nessuna etichetta, nessun filtro).
### Porte
agentmemory + iii-engine collegano quattro porte per default. Se un riavvio fallisce con `port in use`, questa tabella ti dice quale processo cercare.
| Porta | Processo | Scopo | Override ambiente |
|------|---------|---------|--------------|
| `3111` | agentmemory | API REST + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | Worker interno degli stream (consumato da agentmemory + viewer) | `III_STREAM_PORT` (preferito) o il legacy `III_STREAMS_PORT` |
| `3113` | agentmemory | Viewer in tempo reale (`http://localhost:3113`) | `III_VIEWER_PORT` oppure `AGENTMEMORY_VIEWER_URL` per l'URL riportato |
| `49134` | iii-engine | WebSocket; i worker si registrano qui, la telemetria OTel fluisce su di esso | `III_ENGINE_PORT` oppure `III_ENGINE_URL` |
`--port ` cambia l'ancora REST e deriva gli stream `N+1`, il viewer `N+2` e il WebSocket dell'engine `N+46023` solo dove la porta o l'URL espliciti corrispondenti sopra non sono impostati. Non crea uno spazio dei nomi del ciclo di vita isolato. Usa `--instance 1` per un secondo daemon; usa l'ancora 3211, ha come default `3211/3212/3213/49234`, e riceve una directory separata `instance-1` per dati e ciclo di vita. Le istanze da 1 a 50 seguono lo stesso pattern.
L'engine fissato si avvia con `--no-update-check` (nessuna ricerca di aggiornamenti o avvisi di sicurezza contro GitHub all'avvio) e con la telemetria di utilizzo anonima di iii disattivata: agentmemory imposta `III_TELEMETRY_ENABLED=false` per l'engine che avvia a meno che tu non esporti la variabile da solo, e il file compose incluso fa lo stesso.
Pulizia dei processi bloccati quando le porte restano occupate dopo un'esecuzione andata in crash:
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` recupera in modo pulito sia il worker sia il pidfile dell'engine su uno spegnimento nativo elegante. In modalità Docker, svuota il worker nativo, arresta esattamente il container dell'engine validato, e preserva sia il container sia il suo mount `/data` per un riavvio senza perdita di dati; il prossimo avvio valida e riprende quello stesso container. La disinstallazione con backend Docker richiede `agentmemory remove --keep-data`: rimuove i file gestiti condivisi di agentmemory preservando il container validato, il suo mount dei dati e il record del ciclo di vita necessario per recuperarli. L'eliminazione distruttiva dei dati Docker è intenzionalmente lasciata all'operatore dopo un backup. La CLI rifiuta anche di adottare o segnalare i detentori di porta Docker o VM (backend Docker, vpnkit, colima) come l'engine nativo a meno che non venga passato `--force`. La pulizia manuale sopra serve solo per il caso post-crash in cui non resta nessun pidfile.
### File di configurazione
Metti la configurazione runtime di agentmemory in `~/.agentmemory/.env` invece di esportare variabili in ogni shell. Se il viewer mostra un suggerimento di configurazione come `export ANTHROPIC_API_KEY=...`, copialo in questo file come `ANTHROPIC_API_KEY=...` senza il prefisso `export`, poi riavvia agentmemory.
Le variabili d'ambiente del processo funzionano comunque e hanno la precedenza sui valori nel file.
Su Windows, lo stesso file risiede in `%USERPROFILE%\.agentmemory\.env`:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
Per testare con un abbonamento Claude Code Pro/Max invece di una chiave API, attiva l'opzione esplicitamente:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
La compressione delle osservazioni scritta da un LLM richiede entrambe le righe: accesso a un provider LLM (incluso questo fallback esplicito dell'abbonamento) e `AGENTMEMORY_AUTO_COMPRESS=true`. Un provider da solo lascia in vigore il percorso predefinito di compressione sintetica.
Il consolidamento (nodi del grafo, lezioni, cristalli) è attivo per default ogni volta che è configurato un provider LLM. Disattivalo esplicitamente con `CONSOLIDATION_ENABLED=false` se vuoi un funzionamento senza LLM. L'estrazione del grafo è un flag separato:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### Variabili d'ambiente
Crea `~/.agentmemory/.env`:
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---
138 endpoint sulla porta `3111`. L'API REST si collega a `127.0.0.1` per impostazione predefinita. Gli endpoint protetti richiedono `Authorization: Bearer `, e gli endpoint di sincronizzazione mesh richiedono un `AGENTMEMORY_SECRET` impostato esplicitamente su entrambi i peer.
**L'autenticazione è attiva per default.** Quando `AGENTMEMORY_SECRET` non è impostato (nella shell o in `~/.agentmemory/.env`), il server genera un secret casuale al primo avvio e lo memorizza in `~/.agentmemory/secret` con modalità `0600`. Ogni client incluso lo legge da lì quando parla con un server locale: la CLI, il viewer, gli hook sotto `plugin/scripts`, il server MCP e lo shim `@agentmemory/mcp`, le configurazioni scritte da `agentmemory connect`, e le integrazioni incluse OpenCode, Pi, OpenClaw, Hermes e filesystem-watcher. Il secret memorizzato viene inviato solo a URL loopback (`localhost`, `127.0.0.0/8`, `::1`). Un `AGENTMEMORY_SECRET` esplicito vince sempre, e i client remoti devono comunque averlo impostato. Docker e gli entrypoint di `deploy/` generano ed esportano già il proprio secret. Per chiamare l'API a mano:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**Regole di richiesta per le scritture.** Le richieste `POST`, `PUT`, `PATCH` e `DELETE` all'API REST e al viewer devono inviare `Content-Type: application/json` (un parametro `charset` va bene) ogni volta che portano un corpo, e un header `Origin`, quando presente, deve essere un'origine loopback per la porta REST o viewer configurata oppure essere elencato in `VIEWER_ALLOWED_ORIGINS` (separato da virgole, ad es. `https://memory.example.com`). I client che non inviano nessun header `Origin` (CLI, hook, MCP, curl, server-to-server) non sono affetti. Il viewer accetta anche la propria origine.
**Percorsi dei file.** Gli endpoint che leggono o scrivono file (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`) accettano solo percorsi sotto `~/.agentmemory`, la directory dei dati dell'istanza, o una directory elencata in `AGENTMEMORY_IMPORT_ROOT` (separane diverse con `:`, o `;` su Windows). `/replay/import-jsonl` accetta anche il suo default `~/.claude/projects`. `/obsidian/export` resta dentro `AGENTMEMORY_EXPORT_ROOT` e `/migrate` dentro `~/.agentmemory`. I symlink vengono risolti prima di ogni controllo.
**Rimozione dei segreti.** Chiavi API, bearer token, blocchi di chiavi private PEM e credenziali incorporate negli URL (`scheme://user:password@host`) vengono oscurati prima che il testo venga memorizzato, su ogni percorso di scrittura: osservazioni, remember, evolve, slot, lezioni, azioni, sketch, segnali, checkpoint, import, replay jsonl, sincronizzazione mesh, condivisioni di team, output di compressione e riassunto, cristalli e nodi del grafo.
Endpoint principali
| Metodo | Percorso | Descrizione |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | Controllo di salute (sempre pubblico) |
| `GET` | `/agentmemory/status` | Cosa non va e come risolverlo (HTML per i browser, JSON altrimenti) |
| `GET` | `/agentmemory/viewer/snapshot` | Tutto ciò che il viewer mostra, in un'unica risposta |
| `POST` | `/agentmemory/session/start` | Avvia sessione + ottieni contesto |
| `POST` | `/agentmemory/session/end` | Termina sessione |
| `POST` | `/agentmemory/observe` | Cattura osservazione (vedi la consegna della cattura sotto) |
| `GET` | `/agentmemory/capture` | Inbox di cattura, dead letter e spool offline |
| `POST` | `/agentmemory/capture/retry` | Riprova le catture dead-letter |
| `POST` | `/agentmemory/capture/drain` | Invia ora lo spool offline locale |
| `POST` | `/agentmemory/smart-search` | Ricerca ibrida |
| `POST` | `/agentmemory/context` | Genera contesto |
| `POST` | `/agentmemory/remember` | Salva nella memoria a lungo termine |
| `POST` | `/agentmemory/forget` | Elimina osservazioni |
| `POST` | `/agentmemory/enrich` | Contesto del file + memorie + bug |
| `GET` | `/agentmemory/profile` | Profilo del progetto |
| `GET` | `/agentmemory/export` | Esporta tutti i dati |
| `POST` | `/agentmemory/import` | Importa da JSON |
| `POST` | `/agentmemory/graph/query` | Query sul grafo di conoscenza |
| `POST` | `/agentmemory/graph/compact` | Riduce la provenienza del grafo sovradimensionata |
| `POST` | `/agentmemory/team/share` | Condividi con il team |
| `GET` | `/agentmemory/audit` | Traccia di audit |
Elenco completo degli endpoint: [`src/triggers/api.ts`](../src/triggers/api.ts)
**Consegna della cattura.** Gli hook inviano ogni osservazione una volta a `POST /agentmemory/observe` con un `eventId`. È l'id proprio dell'host per la chiamata quando il payload ne ha uno (per esempio il `tool_use_id` di Claude Code), altrimenti un hash della sessione, del tipo di hook, del nome dello strumento, dell'input, dell'output e del timestamp dell'host. Il server scrive l'evento in un inbox di cattura nello state store, memorizza l'osservazione, poi rimuove la voce dall'inbox. Il codice di stato dice cosa è successo:
| Stato | Campo `status` | Significato |
|---|---|---|
| `201` | `accepted` | Memorizzato. `observationId` è la nuova osservazione. |
| `202` | `accepted` (`state: "retrying"`) | Accettato, ma la memorizzazione è fallita. Il server lo riprova, anche dopo un riavvio. |
| `200` | `duplicate` | Questo `eventId` era già stato accettato. `observationId` è l'osservazione esistente; non viene memorizzato nulla di nuovo. |
| `400` / `422` | `rejected` | Payload non valido, oppure la memorizzazione è fallita definitivamente (l'evento viene conservato come dead letter). |
| `503` | `rejected` (`retryable: true`) | L'inbox è piena (`AGENTMEMORY_CAPTURE_INBOX_MAX`). Gli hook mettono l'evento in spool e lo inviano più tardi. |
Gli eventi falliti vengono ritentati ogni `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 s) con backoff che raddoppia, fino a `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5). Gli eventi che continuano a fallire restano nell'inbox come dead letter, sono elencati su `/agentmemory/status` e nella pagina Health del viewer, e possono essere ritentati con `POST /agentmemory/capture/retry` (`{"eventId": "..."}` oppure `{"all": true}`). Gli id degli eventi accettati vengono ricordati per `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 ore, al massimo `AGENTMEMORY_CAPTURE_EVENTS_MAX` id), quindi un hook rieseguito dopo un timeout o un riavvio viene memorizzato una volta, mentre due chiamate di strumento separate con i propri id host vengono memorizzate due volte anche quando il loro contenuto è identico. Quando un'osservazione viene eliminata (forget, eliminazione della sessione, eviction, auto-forget o un import che sostituisce lo store), il suo evento viene marcato come eliminato prima che l'osservazione venga rimossa, così una riesecuzione di quell'evento nella stessa finestra viene risposta come duplicato e non memorizza nulla. Lo state store scrive su disco ogni 2 secondi, quindi una risposta accettata può essere ancora solo in memoria per un istante. Per coprire questo, ogni risposta `2xx` porta anche il `bootId` del server (nuovo a ogni avvio), `acceptedAt` e `durableAfterMs` (l'intervallo di salvataggio più 1.5 s sullo store a file, 1.5 s su redis, dove la persistenza è un'impostazione dell'operatore). Gli hook mantengono l'evento nello spool locale finché quella finestra non è passata e lo eliminano a una chiamata successiva senza un'altra richiesta. Se il `bootId` è cambiato da allora, il server è stato riavviato, quindi l'hook invia di nuovo l'evento con lo stesso `eventId`; un evento che è arrivato sul disco non viene memorizzato due volte. Il server invia anche da sé tali eventi all'avvio e a ogni intervallo di retry, così un riavvio non perde nulla anche quando nessun hook viene eseguito in seguito. Gli hook più vecchi ignorano i campi extra, e i nuovi hook contro un server più vecchio scartano l'evento su `2xx` come prima.
Quando il server è spento, non risponde in tempo o restituisce un 5xx, l'hook aggiunge l'osservazione a un file di spool locale, `/capture-spool/-.jsonl` (sovrascrivi la cartella con `AGENTMEMORY_CAPTURE_SPOOL_DIR`). Il file è privato per il tuo utente (modalità 600), i segreti vengono oscurati allo stesso modo in cui li oscura il server, contiene al massimo `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 MiB) ed elimina le voci più vecchie di `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168). Quando è pieno, le nuove voci vengono scartate e contate, e `/agentmemory/status` lo segnala. L'hook esce comunque con 0 entro il suo limite di tempo e non aggiunge nessuna richiesta quando il server è sano. Lo spool viene inviato al prossimo avvio e dal primo hook che raggiunge di nuovo il server, in un processo in background così l'agente non aspetta. Gli id degli eventi rendono questo sicuro: un'osservazione che è arrivata prima di un timeout non viene memorizzata due volte. `npx @agentmemory/agentmemory capture` mostra lo spool e l'inbox del server, `--drain` invia subito lo spool, e `GET /agentmemory/capture` restituisce lo stesso come JSON. Imposta `AGENTMEMORY_CAPTURE_SPOOL=false` per disattivare lo spool.
**Compattazione della provenienza del grafo.** Ogni nodo e arco del grafo di conoscenza mantiene gli id delle 32 osservazioni più recenti da cui è derivato. Gli store scritti prima di quel limite possono contenere migliaia di id per nodo caldo, il che rende lenta la ricerca nel grafo e il viewer o fa cadere il worker. agentmemory risolve questo da solo: al primo avvio dopo l'aggiornamento riduce ogni nodo, arco, arco superato (la storia temporale del grafo) e lo snapshot in cache al limite in background, in piccole porzioni con una pausa tra di esse, così ricerca, cattura e viewer continuano a funzionare. Salva il suo progresso, riprende dopo un riavvio e non viene più eseguito una volta terminato. `/agentmemory/status` e la pagina Health del viewer lo mostrano come in attesa, in esecuzione (con lo scope e la posizione correnti), completato o fallito. Imposta `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false` per disattivarlo.
Per eseguirlo a mano, chiama `POST /agentmemory/graph/compact`. Percorre gli indici dei nomi e delle chiavi degli archi invece di elencare ogni nodo e arco, ed è sicuro da rieseguire. Quando riduce gli id scrive una voce di audit `graph_compact`.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
Su uno store grande, o quando la chiamata restituisce 504, eseguilo a porzioni. Invia `scope` (`nodes`, `edges` o `history`), `offset` e `limit`, poi richiama con il `nextOffset` restituito finché non è `null`. Fallo per `nodes`, `edges` e `history`, e termina con un'unica chiamata `{"scope":"snapshot"}`, perché un'esecuzione a porzioni non toglie lo snapshot in cache.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---
```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**Prerequisiti:** Node.js >= 20 con npm/npx; [iii-engine](https://iii.dev/docs) v0.22.1 o Docker. L'installazione automatica dell'engine su macOS/Linux richiede anche `curl`, una `sh` POSIX e `tar`; Windows nativo usa il `iii.exe` fissato manuale, WSL2, o Docker Desktop.