Je coding agent onthoudt alles. Geen uitleg meer nodig.
Gebouwd op iii engine
Persistent geheugen voor Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, OpenCode, en elke MCP-client.
---
## Install
Vereisten:
- Node.js 20 of nieuwer met npm en npx (`node -v`, `npm -v` en `npx -v`).
- Automatische iii-engine-installatie op macOS/Linux heeft ook `curl`, een POSIX `sh` en `tar` nodig. Minimale images zoals `node:20-slim` bevatten deze mogelijk niet.
- Native Windows vereist dat de vastgezette iii-engine v0.22.1 `iii.exe` handmatig wordt geïnstalleerd. WSL2 of Docker Desktop zijn de andere ondersteunde paden.
Canonieke opdracht voor een nieuwe installatie:
```bash
npx -y @agentmemory/agentmemory@latest
```
De eerste run is een interactieve setup: je kiest de agents die je wilt koppelen (Claude Code, Cursor, Codex, Gemini CLI, OpenCode, ...), kiest een LLM-provider of blijft keyless, en de setup zet de config klaar, start de memory server en de bijbehorende vastgezette iii engine, en biedt aan om globaal te installeren zodat het kale `agentmemory`-commando daarna overal werkt. `-y` accepteert de package-prompt van npx en `@latest` voorkomt een verouderde gecachte release. Een provider maakt LLM-functies beschikbaar, maar LLM-geschreven compressie van observaties start alleen wanneer ook `AGENTMEMORY_AUTO_COMPRESS=true` is ingesteld.
Keyless-modus schakelt vector-embeddings uit. `memory_recall` (het `mem::search`-pad) gebruikt BM25, terwijl `memory_smart_search` ook structurele graph-matches kan combineren wanneer er al graph-data bestaat. Voor gratis semantisch ophalen op het eigen apparaat stel je `EMBEDDING_PROVIDER=local` in in `~/.agentmemory/.env` en herstart je. De eerste embedding-aanvraag downloadt `Xenova/all-MiniLM-L6-v2`; inference draait daarna lokaal, na die eerste modeldownload.
De lokale runtime gebruikt vier poorten: `3111` voor REST/MCP HTTP, `3112` voor iii-streams, `3113` voor de viewer en `49134` voor de iii worker WebSocket. Persistente iii-state leeft in `~/Library/Application Support/agentmemory` op macOS, `$XDG_DATA_HOME/agentmemory` of `~/.local/share/agentmemory` op Linux, en `%APPDATA%\agentmemory` op Windows. Gebruik `--data-dir ` of `AGENTMEMORY_DATA_DIR` om dit te overschrijven, en gebruik bij elke herstart opnieuw dezelfde waarde. Voor achterwaartse compatibiliteit krijgt een bestaande `./data/state_store.db` of `./data/iii-config.yaml` voorrang boven de platformstandaard voor instantie 0; een expliciete flag of environment-override wint nog steeds.
Bewijs vervolgens dat recall werkt en geef je agent zijn skills:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
De keyword-zoekopdrachten zouden in de standaard keyless-modus via BM25 moeten raken. De `database performance optimization`-query van de demo is doelbewust semantisch en kan nul resultaten opleveren totdat er een embedding-provider is geconfigureerd.
Wil je liever dat een coding agent dit allemaal voor je doet? Geef hem één instructie:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
Koppel op elk moment meer agents met `agentmemory connect ` — er staan 20 adapters vermeld bij [Werkt met elke agent](#works-with-every-agent). Volledige commando-referentie bij [Snelstart](#quick-start).
Windows
De snelste weg is WSL2. Voor een native Windows-engine-setup moet de vastgezette v0.22.1 ZIP worden gedownload en `iii.exe` handmatig worden uitgepakt; de CLI pakt dit niet automatisch uit. Docker Desktop wordt ook ondersteund. Zie de [Windows-notities](#windows) voor de stap-voor-stap-uitleg.
Globale installatie / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
Het npx-commando hierboven blijft het canonieke pad voor een nieuwe installatie en voorkomt problemen met globale-prefix-rechten.
npx serveert een oude versie
npx cachet per versie. Forceer de laatste versie met `npx -y @agentmemory/agentmemory@latest`, of wis de cache eenmalig met `rm -rf ~/.npm/_npx` (macOS/Linux; verwijder op Windows `%LOCALAPPDATA%\npm-cache\_npx`).
Je draait al je eigen iii engine
agentmemory zet iii-engine vast op v0.22.1 en koppelt niet aan een andere versie (de worker kan het protocol van een andere engine niet spreken). Stop de andere engine en voer dan `npx -y @agentmemory/agentmemory@latest` uit. Dit installeert en draait de vastgezette v0.22.1 in `~/.agentmemory/bin`, en laat je eigen `iii` ongewijzigd.
---
agentmemory werkt met elke agent die hooks, MCP of een REST API ondersteunt. Alle agents delen dezelfde memory server.
Claude Code native plugin + 12 hooks + MCP
Codex CLI native plugin + 6 hooks + MCP
GitHub Copilot CLI MCP + plugin hooks/skills
Cursor native plugin + 7 hooks + MCP
OpenCode capture plugin + MCP
Devin 6 hooks + skills + MCP
OpenClaw native plugin + MCP
Hermes native plugin + MCP
pi native plugin + MCP
OpenHuman native Memory-trait-backend
Gemini CLI MCP-server
Antigravity MCP + hooks
Claude Desktop MCP-server
Warp connect + MCP + skills
Zed MCP-server
Cline MCP-server
Continue MCP-server
Droid MCP-server
Kiro MCP-server
Qwen Code MCP-server
DeepSeek Harness MCP-server
Roo Code MCP-server
Kilo Code MCP-server
Goose MCP-server
Aider REST API
Werkt met elke agent die MCP of HTTP spreekt. Eén server, memories gedeeld over al deze agents.
---
Je legt elke sessie opnieuw dezelfde architectuur uit. Je ontdekt opnieuw dezelfde bugs. Je leert je agent opnieuw dezelfde voorkeuren aan. Ingebouwd geheugen (CLAUDE.md, .cursorrules) loopt vast op 200 regels en veroudert. agentmemory verhelpt dit. Het legt stilletjes vast wat je agent doet, comprimeert dat tot doorzoekbaar geheugen, en injecteert de juiste context wanneer de volgende sessie begint. Één commando. Werkt met meerdere agents.
**Wat er verandert:** In sessie 1 zet je JWT-auth op. In sessie 2 vraag je om rate limiting. De agent weet al dat je auth jose middleware gebruikt in `src/middleware/auth.ts`, dat je tests tokenvalidatie dekken, en dat je jose boven jsonwebtoken koos voor Edge-compatibiliteit, zonder opnieuw uit te leggen en zonder te copy-pasten.
```bash
npx -y @agentmemory/agentmemory@latest
```
Standaard slaat agentmemory iii-engine-state op buiten de repository waarin je het start: `~/Library/Application Support/agentmemory` op macOS, `$XDG_DATA_HOME/agentmemory` of `~/.local/share/agentmemory` op Linux, en `%APPDATA%\agentmemory` op Windows. Een bestaande legacy `./data/state_store.db` of `./data/iii-config.yaml` wordt hergebruikt voor instantie 0, vóór die platformstandaard. Om expliciet een locatie te kiezen geef je `--data-dir ` door of stel je `AGENTMEMORY_DATA_DIR` in; beide expliciete instellingen krijgen voorrang boven legacy-detectie:
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
Native en Docker-starts gebruiken dezelfde opgeloste hostmap; Docker mount deze via bind-mount op `/data`. `--instance 1` voegt `instance-1` toe aan de opgeloste map en selecteert het aparte standaard poortkwartet `3211/3212/3213/49234`.
Laatste release notes: [CHANGELOG.md](../CHANGELOG.md).
---
### Retrieval-nauwkeurigheid
**coding-agent-life-v1** (eigen corpus, reproduceerbaar in een sandbox)
| Adapter | P@5 | R@5 | Top-5-hitrate | p50-latentie |
|---|---|---|---|---|
| **agentmemory hybrid** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| grep-baseline | 0.227 | 0.967 | 15 / 15 | 0 ms |
100% top-5-hitrate op het **P@5-wiskundige plafond** voor dit corpus (0.240, zie scorecard). Hybride haalt elke gold session op; grep mist 1 van 2 gold-resultaten bij de multi-session temporele query. De winst zit in **recall + temporeel**, niet in geaggregeerde precisie. Deze benchmark is klein en gold-sparse; de grotere LongMemEval-S hieronder onderscheidt beter. Volledige uitsplitsing per type + correctienotitie: [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md).
**LongMemEval-S** (ICLR 2025, 500 vragen)
| Systeem | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| BM25-only fallback | 86.2% | 94.6% | 71.5% |
> Embeddingmodel: `all-MiniLM-L6-v2` (lokaal, gratis, geen API-key nodig). Volledige rapporten: [`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md), [`benchmark/QUALITY.md`](../benchmark/QUALITY.md), [`benchmark/SCALE.md`](../benchmark/SCALE.md). Vergelijking met concurrenten: [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md), met agentmemory tegenover mem0, Letta, Khoj, supermemory, TencentDB Agent Memory, MemPalace, Zep/Graphiti, Cognee en Hippo.
**Lokaal reproduceren:** [`eval/README.md`](../eval/README.md), een harness met inpluggbare adapters voor LongMemEval `_s` (publieke set van 500 vragen) + `coding-agent-life-v1` (eigen corpus van 15 sessies). Grep-, vector- en agentmemory-adapters scoren naast elkaar, NDJSON-output, gepubliceerde scorecards komen terecht in [`docs/benchmarks/`](../docs/benchmarks/).
**Combineert goed met [codegraph](https://github.com/colbymchenry/codegraph), [Understand Anything](https://github.com/Lum1104/Understand-Anything) en [Graphify](https://github.com/safishamsi/graphify).** Code-graph-indexering, multi-agent build-pipelines en bredere knowledge graphs over docs / PDF's / afbeeldingen / video's. agentmemory onthoudt het werk; die drie projecten verlichten de rest van de context-laag. Recepten + tabel voor vraagroutering: [`docs/recipes/pairings.md`](../docs/recipes/pairings.md).
---
agentmemory
mem0 (63K ⭐)
Letta / MemGPT (24K ⭐)
Khoj (36K ⭐)
supermemory (29K ⭐)
TencentDB Agent Memory (22K ⭐)
MemPalace (54K ⭐)
oracleagentmemory
Hippo
Ingebouwd (CLAUDE.md)
Type
Memory engine + MCP-server
Memory-laag-API
Volledige agent-runtime
Persoonlijke AI
Memory-API + app
Team-memory-hub (LLM-proxy)
Vector-memory (OSS)
Memory engine (Oracle DB)
Memory-systeem
Statisch bestand
Retrieval R@5
95.2%
68.5% (LoCoMo)
83.2% (LoCoMo)
N/A
Zelf gerapporteerd
PersonaMem 76% (zelf gerapporteerd)
~96.6% (zelf gerapporteerd)
94.4% (zelf gerapporteerd)
N/A
N/A (grep)
Auto-capture
12 hooks (geen handmatige moeite)
Handmatige add()-aanroepen
Agent bewerkt zelf
Handmatig
Extractie aan de API-kant
Proxy-interceptie (base-URL wisselen)
Handmatig
API-extractie
Handmatig
Handmatig bewerken
Zoeken
BM25 + Vector + Graph (RRF-fusie)
Vector + Graph
Vector (archief)
Semantisch
Vector + RAG
4 asset-types (Chat / Skill / Wiki / CodeGraph)
Alleen vector
Vector + semantisch
Decay-gewogen
Laadt alles in de context
Multi-agent
MCP + REST + leases + signals
API (geen coördinatie)
Alleen binnen Letta-runtime
Nee
Nee
Teamrollen + gedeelde assets
Nee
Alleen scoped
Gedeeld tussen meerdere agents
Bestanden per agent
Framework lock-in
Geen (elke MCP-client)
Geen
Hoog (moet Letta gebruiken)
Standalone
Geen
Proxy staat voor elke model-aanroep
Geen
Oracle Database
Geen
Formaat per agent
Externe dependencies
Geen (SQLite + iii-engine)
Qdrant / pgvector
Postgres + vector-db
Meerdere
Managed cloud
Docker-stack (Core + Hub + Proxy)
Vector store
Oracle AI Database
Geen
Geen
Memory lifecycle
4-laags consolidatie + decay + auto-forget
Passieve extractie
Beheerd door agent
Handmatig
Auto-forget
Handmatige review; auto-routing in ontwikkeling
Geen
Niet vermeld
Decay + consolidatie
Handmatig opschonen
Tokenefficiëntie
~1,900 tokens/sessie ($10/jaar)
Varieert per integratie
Core memory in context
Varieert
Cloud pricing
Niet vermeld
Geen tokenbudget
LLM-ondersteund (varieert)
Varieert
22K+ tokens bij 240 observaties
Realtime viewer
Ja (poort 3113)
Cloud dashboard
Cloud dashboard
Web UI
Cloud dashboard
Hub web UI
Nee
Nee
Nee
Nee
Self-hosted
Ja (standaard)
Optioneel
Optioneel
Ja
Nee (alleen cloud)
Ja (Docker)
Ja
Ja (Oracle DB)
Ja
Ja
Opmerking over de benchmark: alleen de R@5 van agentmemory is ons eigen gemeten resultaat (LongMemEval-S, reproduceerbaar via benchmark/COMPARISON.md). De cijfers van mem0 en Letta zijn hun gepubliceerde LoCoMo-cijfers (een andere dataset); de cijfers van MemPalace, supermemory, TencentDB (PersonaMem) en oracleagentmemory zijn door de leverancier zelf gerapporteerde claims die we niet onafhankelijk hebben gereproduceerd (de run van oracleagentmemory gebruikte GPT-5.5 tegen een Oracle AI Database). Naast elkaar getoond voor een ruwe inschatting, niet als head-to-head op identieke data. Stertallen zijn benaderend en veranderen in de tijd.
**Nieuwere spelers** die het kennen waard zijn, in detail vergeleken in [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md):
| Systeem | ⭐ | Invalshoek |
|--------|---|-------|
| Zep / Graphiti | 30K | Temporele knowledge graph; sterkste gepubliceerde resultaten voor temporele queries (LongMemEval 63.8%), maar de graph wordt asynchroon opgebouwd, waardoor verse feiten kunnen achterblijven |
| Cognee | 30K | Document-naar-knowledge-graph-ingestie, alleen Python, gebouwd voor gestructureerde entiteitsextractie in plaats van sessie-capture |
Geen van deze vangt automatisch vanuit coding-agent-hooks, levert een local-first viewer, of draait keyless — de combinatie waar agentmemory om gebouwd is.
---
Compatibiliteit: deze release richt zich op `iii-sdk` 0.22.1 en zet iii-engine vast op v0.22.1.
### Probeer het in 30 seconden
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` zet 3 realistische sessies klaar (JWT-auth, N+1-queryfix, rate limiting) en voert zoekopdrachten erop uit. Keyless-installaties schakelen vectoren uit, dus de keyword-queries via `mem::search` zouden via BM25 moeten raken, terwijl `database performance optimization` nul resultaten kan opleveren. `smart-search` kan daarnaast structurele graph-matches teruggeven wanneer er graph-data bestaat. Om de semantische query de N+1-fix via vectoren te laten vinden, stel je `EMBEDDING_PROVIDER=local` in, herstart je, en laat je de eerste modeldownload afronden.
Open `http://localhost:3113` om het geheugen live te zien opbouwen.
### Een nieuwe installatie en persistentie na herstart valideren
Valideer met de server actief de REST API, health, de viewer en de iii-gebaseerde runtime-status:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
Het ready-panel bij het opstarten houdt rekening met alle vier poorten: REST/MCP HTTP op 3111, iii-streams op 3112, de viewer op 3113, en de iii worker WebSocket op 49134. `status` bevestigt de gezondheid van agentmemory en de actieve provider/embedding-modus. Sla een test-probe op en controleer of deze doorzoekbaar is:
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
Voer vervolgens `npx -y @agentmemory/agentmemory@latest stop` uit, start het canonieke commando opnieuw in Terminal 1, wacht op `/agentmemory/livez`, en herhaal de zoekopdracht. De probe moet nog steeds worden teruggegeven. Als je een aangepaste `--data-dir` koos, geef dan bij de herstart dezelfde map door.
### Dagelijkse commando's
Installatie en setup staan hierboven bij [Install](#install) (de eerste run begeleidt je erdoorheen). Dagelijks gebruik:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### Sessie-replay
Elke sessie die agentmemory vastlegt, is afspeelbaar. Open de viewer, kies het tabblad **Replay**, en schuif door de tijdlijn: prompts, tool calls, tool-resultaten en antwoorden worden weergegeven als afzonderlijke events met play/pause, snelheidsregeling (0.5x tot 4x) en toetsenbordsneltoetsen (spatie om te schakelen, pijltjes om stap voor stap te gaan).
Om oudere Claude Code JSONL-transcripten te importeren:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
Geïmporteerde sessies verschijnen in de Replay-kiezer naast de native sessies. Onder de motorkap loopt elke entry via de iii-functies `mem::replay::load`, `mem::replay::sessions` en `mem::replay::import-jsonl`, zonder side-channel-servers. Elk geïmporteerd transcript wordt geïndexeerd voor zoeken, gestempeld met oorsprongkanaal `import`, en doorzocht op een sessie-crystal en lessen.
> **Let op als je `import-jsonl` als je primaire capture-pad gebruikt:** de `cleanupPeriodDays` van Claude Code (in `~/.claude/settings.json`, standaard **30**) verwijdert automatisch JSONL-transcripten die ouder zijn dan dat venster uit `~/.claude/projects/`. Als je agentmemory vers installeert op een Claude Code-geschiedenis van maanden oud, is alles ouder dan 30 dagen al verdwenen vóór de eerste import. Draai `import-jsonl` op een cron, verhoog `cleanupPeriodDays` naar een hogere waarde, of koppel de auto-capture-hooks (het standaard installatiepad via de plugin) zodat elke turn in agentmemory terechtkomt terwijl de sessie live is en de JSONL-cleanup er niet meer toe doet.
### Upgraden / onderhoud
Gebruik het onderhoudscommando wanneer je bewust je lokale runtime wilt bijwerken:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
Waarschuwing: dit commando wijzigt de huidige workspace/runtime. Het kan JavaScript-dependencies bijwerken en de vastgezette `iiidev/iii:0.22.1`-Docker-image ophalen. Het installeert nooit een niet-vastgezette of nieuwere iii engine.
Implementatiedetails staan in `src/cli.ts` (zie `runUpgrade` rond de regels `src/cli.ts:544-595`).
### Claude Code (één blok, plak dit)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code zonder de plugin-installatie (MCP-standalone pad)
Als je de MCP-server van agentmemory rechtstreeks via `~/.claude.json` koppelt in plaats van `/plugin install` te gebruiken, lost Claude Code `${CLAUDE_PLUGIN_ROOT}` nooit op en moet je hook-scripts naar absolute paden in `~/.claude/settings.json` laten verwijzen. Die paden bevatten doorgaans de agentmemory-versie (bijv. `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`), waardoor de volgende upgrade stilletjes elke hook stuk maakt.
Workaround:
```bash
agentmemory connect claude-code --with-hooks
```
Dit voegt dezelfde hook-commando's samen in `~/.claude/settings.json`, met absolute paden die verwijzen naar de gebundelde `plugin/`-map van het momenteel geïnstalleerde `@agentmemory/agentmemory`-package. Voer het commando opnieuw uit na het upgraden van agentmemory om de paden te verversen. Gebruikersinvoer in hetzelfde bestand blijft behouden; alleen eerdere agentmemory-invoer wordt vervangen. Het `/plugin install`-pad blijft de aanbevolen aanpak.
Voor remote of beveiligde deployments start je Claude Code met `AGENTMEMORY_URL` en `AGENTMEMORY_SECRET` ingesteld. De plugin geeft beide waarden door aan zijn gebundelde MCP-server; wanneer `AGENTMEMORY_URL` leeg is, gebruikt de MCP-shim `http://localhost:3111`.
### Codex CLI (Codex-pluginplatform)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
De Codex-plugin komt uit dezelfde `plugin/`-map als de Claude Code-plugin. Hij registreert:
- Een gebundelde stdio MCP-bridge naar de draaiende daemon, zonder npm-download of fallback-store. Zie de [lokale Codex-guide](../docs/plugins/codex-local.md) om een niet-uitgebrachte build te testen.
- 6 lifecycle-hooks: `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop`
- 9 aanroepbare skills: `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, plus 8 referentieskills die de agent op aanvraag laadt (memory discipline, MCP-tools, REST API, config, agents, hooks, architecture, en de skill-authoring guide)
De hook-engine van Codex injecteert `CLAUDE_PLUGIN_ROOT` in hook-subprocessen (zie [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)), zodat dezelfde hook-scripts op beide hosts werken zonder duplicatie. Subagent-, SessionEnd-, Notification-, TaskCompleted- en PostToolUseFailure-events zijn alleen voor Claude Code en worden niet geregistreerd voor Codex.
#### Codex-hooks: vertrouwen en compatibiliteit
Native plugin-hook-dispatch is geverifieerd met Codex CLI 0.150.1. Vertrouw de plugin-hooks voordat je capture verwacht. Het gedrag van Codex Desktop hangt af van de gebundelde runtime; controleer `/hooks` en bevestig een vastgelegd event voordat je een workaround inschakelt.
Als je host globale hooks nodig heeft, spiegel je de commando's naar de globale `~/.codex/hooks.json`. Wanneer MCP al gekoppeld is, heeft de huidige `connect`-adapter `--force` nodig om bij de hook-installatie te komen:
```bash
agentmemory connect codex --with-hooks --force
```
Dit voegt globale hooks samen en herschrijft de agentmemory MCP-entry, met behoud van niet-gerelateerde entries. Controleer aangepaste agentmemory-endpoint-instellingen voordat je `--force` gebruikt. Voer opnieuw uit na het upgraden om de scriptpaden te verversen. Schakel ofwel native plugin-hooks ofwel globale kopieën in om dubbele capture te vermijden.
### GitHub Copilot CLI
Voor de VS Code-agentmodus gebruik je de [Copilot MCP- en auto-capture-guide](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions). De CLI-connector configureert VS Code niet.
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` voegt `mcpServers.agentmemory` samen in `~/.copilot/mcp-config.json` (of `$COPILOT_HOME/mcp-config.json` wanneer `COPILOT_HOME` is ingesteld) en behoudt bestaande servers. Op native Windows is dit de enige geautomatiseerde `connect`-adapter; configureer elke andere native Windows-agent handmatig. `connect` via WSL wordt alleen ondersteund wanneer de doelagent in diezelfde WSL-omgeving is geïnstalleerd. Copilot pikt de MCP-server op bij de volgende start of na `/mcp`. Installeer ook de plugin wanneer je de volledige hook/skill-ervaring wilt.
OpenClaw (plak deze prompt)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
Volledige handleiding: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (plak deze prompt)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
Volledige handleiding: [`integrations/hermes/`](../integrations/hermes/)
### Other agents
Start de memory server: `npx -y @agentmemory/agentmemory@latest`
#### Native skills via `npx skills add` (50+ agents)
agentmemory levert 17 skills in het Claude-Code-achtige `/SKILL.md`-formaat: 9 aanroepbare actie-skills (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) en 8 referentieskills die de agent op aanvraag laadt (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`). De referentieskills bevatten datatabellen die uit de bron gegenereerd zijn, dus ze lopen nooit uit de pas. De [`skills`](https://npmjs.com/package/skills)-CLI van vercel-labs installeert ze automatisch in de native skills-map van de aanroepende agent, verspreid over 50+ agents (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf, en meer):
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
Dit is **complementair** aan `agentmemory connect `:
- `agentmemory connect ` schrijft de MCP-serverconfig zodat de tools beschikbaar zijn.
- `npx skills add rohitg00/agentmemory` installeert de skills zodat de agent weet wanneer hij ze moet aanroepen.
Voor de paar agents die de skills-CLI nog niet dekt (Zed v1.3.x en lager), plaats je de 17 SKILL.md-bestanden zelf in de native skills-map van de agent; hetzelfde formaat werkt overal.
#### Standaard MCP-blok
De agentmemory-entry is hetzelfde **MCP-serverblok** op elke host die de `mcpServers`-vorm gebruikt (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw):
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**Voeg deze entry samen met het bestaande `mcpServers`-object** in het configuratiebestand van de host; vervang het bestand niet. Als het bestand al andere servers heeft, voeg je `agentmemory` ernaast toe als een extra key binnen `mcpServers`. Als `mcpServers` volledig ontbreekt, plak je het blok binnen `{ "mcpServers": { ... } }`. De `${VAR}`-placeholders erven `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` van de shell bij het starten van de MCP-server; niet-ingestelde variabelen geven lege strings door en de shim valt terug op `http://localhost:3111`. Eén gekoppelde entry dekt zowel lokale als remote (k8s / reverse-proxied) deployments.
| Agent | Configuratiebestand | Opmerkingen |
|---|---|---|
| **Cursor (alleen MCP)** | `~/.cursor/mcp.json` | Voeg samen in `mcpServers`, of `agentmemory connect cursor`. Eén-klik-deeplink ook beschikbaar op de website. |
| **Cursor (volledige plugin)** | `.cursor-plugin/` | Cursor Marketplace-vermelding (inzending in review) of Cursor Settings → Plugins → lokale checkout. Registreert 7 auto-capture-hooks (sessionStart, beforeSubmitPrompt, preToolUse, postToolUse, postToolUseFailure, stop, sessionEnd) + 17 skills + de MCP-server, met `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` beheerd in het plugin-dashboard van Cursor. Werkt in de Cursor IDE en de `cursor-agent`-CLI; in CLI-print-modus worden prompts achteraf aangevuld vanuit het sessietranscript aan het einde van de sessie. |
| **Claude Desktop** | `claude_desktop_config.json` (Application Support) | Voeg samen in `mcpServers`. Herstart Claude Desktop na het bewerken. |
| **Cline / Roo Code / Kilo Code** | Cline MCP-instellingen (Settings UI → MCP Servers → Edit) | Hetzelfde `mcpServers`-blok. |
| **Devin CLI (MCP + hooks)** | `~/.config/devin/config.json` | `agentmemory connect devin` voegt de MCP-entry samen; `--with-hooks` voegt zes native auto-capture-hooks toe (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) met de kleine-letter-toolmatchers van Devin. Controleer met `devin mcp list` en `/hooks` binnen devin. |
| **Devin CLI (volledige plugin)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` vanuit een checkout registreert alle 17 skills als `/agentmemory:`-slashcommando's plus de MCP-server. Devin-plugin-hooks kunnen `SessionStart`/`SessionEnd` niet afvuren, combineer dit dus met `connect devin --with-hooks` voor volledige sessie-capture. |
| **Devin (cloud)** | Settings → Connections → MCP servers | Voeg een aangepaste MCP toe (STDIO): command `npx`, args `-y @agentmemory/mcp@latest`, env `AGENTMEMORY_URL` die wijst naar een netwerkbereikbare agentmemory-deployment, plus `AGENTMEMORY_SECRET` (cloudsessies kunnen localhost niet bereiken — zie [`deploy/`](../deploy/)). Bewaar het secret in Devin Secrets, en gebruik vervolgens "Test listing tools" om te controleren of alle 54 tools verschijnen. |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (voegt automatisch samen). |
| **GitHub Copilot CLI (alleen MCP)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` voegt `mcpServers.agentmemory` samen; Copilot pikt dit op bij de volgende start of `/mcp`. |
| **GitHub Copilot CLI (volledige plugin)** | Copilot plugin-installatie | `copilot plugin install rohitg00/agentmemory:plugin` voor de plugin vanuit de GitHub-submap. |
| **OpenClaw** | OpenClaw MCP-config | Hetzelfde `mcpServers`-blok. Dieper: `openclaw plugins install ./integrations/openclaw` claimt de memory-slot van OpenClaw (schakelt automatisch over vanaf `memory-core`); stel `plugins.entries.agentmemory.hooks.allowConversationAccess=true` in, anders wordt turn-capture stilletjes geblokkeerd. Zie [`integrations/openclaw`](../integrations/openclaw/). |
| **Codex CLI (alleen MCP)** | `.codex/config.toml` | TOML-vorm: `codex mcp add agentmemory -- npx -y @agentmemory/mcp`, of voeg handmatig `[mcp_servers.agentmemory]` toe. |
| **Codex CLI (volledige plugin)** | Codex plugin-marketplace | `codex plugin marketplace add rohitg00/agentmemory`, daarna `codex plugin add agentmemory@agentmemory`. Registreert MCP + 6 lifecycle-hooks + 17 skills. Vertrouw de hooks en verifieer de capture in je host; zie [Codex-setup en -validatie](../docs/plugins/codex-local.md). |
| **OpenCode (alleen MCP)** | `opencode.json` | Andere vorm: top-level `mcp`-key, command als array: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`. |
| **OpenCode (volledige plugin)** | `plugin/opencode/` | 22 auto-capture-hooks voor sessie-lifecycle, berichten, tools en errors. Projecttoewijzing is per sessie, dus één OpenCode-proces dat meerdere repositories omspant, bestandt elke sessie onder zijn eigen project. Twee slashcommando's (`/recall`, `/remember`). Kopieer `plugin/opencode/` naar je OpenCode-workspace en voeg de plugin-entry toe aan `opencode.json`. Zie [`plugin/opencode/README.md`](../plugin/opencode/README.md) voor de volledige hooktabel + gap-analyse. |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` installeert de gebundelde extensie in de auto-discovery-map van pi (recall bij agentstart, capture bij agent-einde, `memory_search` / `memory_save` / `memory_health`-tools, `/agentmemory-status`). `/reload` in een draaiende pi pikt dit op. [`integrations/pi`](../integrations/pi/) is ook een pi-package (`pi install ./integrations/pi` vanuit een checkout). |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` geeft de 6-hook memory-provider (prefetch, turn-capture, session-end, pre-compress, MEMORY.md-mirroring, system-prompt-blok). Valideer met `hermes plugins doctor` en `hermes memory status`. Zie [`integrations/hermes`](../integrations/hermes/). |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` schrijft het standaard `mcpServers`-blok. De hook-payload is veldcompatibel met Claude Code, dus de bestaande 12-hook-scripts werken zonder aanpassing; koppel ze via de `hooks`-sectie in hetzelfde `settings.json`. |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` installeert MCP en capture-hooks in de gedeelde customization-map. Zie [Antigravity-setup en -beperkingen](../docs/plugins/antigravity.md). |
| **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` gebruikt dezelfde MCP- en hookconfiguratie als de huidige IDE-versies. Bestaande installaties moeten verversen met `--force`; zie de [upgrade-notities](../docs/plugins/antigravity.md). |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` schrijft de config op gebruikersniveau. Workspace-overrides komen in `.kiro/settings/mcp.json` naast je code. |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` schrijft het standaard `mcpServers`-blok. Warp ontdekt ook automatisch skills vanuit `.claude/skills/`; zodra de Claude Code-plugin is geïnstalleerd, verschijnen de 8 agentmemory-skills (`remember`, `recall`, `recap`, `handoff`, `forget`, `commit-context`, `commit-history`, `session-history`) native in het slashcommando-palet van Warp. |
| **Cline (CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` schrijft het standaard `mcpServers`-blok. Gebruikers van de VS Code-extensie: plak hetzelfde blok via Cline Settings → MCP Servers → Edit JSON. |
| **Continue.dev** | `~/.continue/config.yaml` (voorkeur) of `config.json` (legacy) | `agentmemory connect continue` maakt `config.yaml` helemaal opnieuw aan wanneer geen van beide bestaat, of past een bestaande `config.json` aan. **Als je al een `config.yaml` hebt**, print de adapter het exacte blok om onder `mcpServers:` te plakken; hij herschrijft je yaml niet stilletjes, omdat het veilig behouden van comments en anchors een YAML-parser vereist die het package niet meelevert. Continue gebruikt de array-vorm (geen object) voor `mcpServers`. |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` schrijft onder `context_servers` (de key van Zed, NIET `mcpServers`). Remote MCP-servers kunnen in plaats daarvan gekoppeld worden via `{"url": "..."}`. |
| **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` schrijft het standaard `mcpServers`-blok. Project-scoped overrides komen in `/.factory/mcp.json`. Geef `--with-hooks` door voor native auto-capture. |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` voegt een `@deepseek-ai/dsh-mcp-client`-rij toe aan de patch-laag op home-niveau die elk Harness-profiel laadt; tools registreren als `mcp__agentmemory__*`. Geef `--with-hooks` door om ook auto-capture te koppelen: de gebundelde Claude Code-hookscripts draaien via de first-party `@deepseek-ai/dsh-hooks-claude-code`-bridge van Harness (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop) via een manifest geschreven naar `$DSH_HOME/agentmemory.hooks.json`. Standaard `~/.dsh` wanneer `DSH_HOME` niet is ingesteld. |
| **Goose** | Goose MCP-instellingen-UI | Hetzelfde `mcpServers`-blok; gebruik `goose configure` → Add Extension → MCP. Direct bewerken van de YAML op `~/.config/goose/config.yaml` wordt ondersteund, maar het schema gebruikt `extensions:` + `cmd` (niet `mcpServers:` + `command`). |
| **Aider** | n/a | Praat rechtstreeks met de REST API: `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`. |
| **Elke agent (32+)** | n/a | `npx skillkit install agentmemory` detecteert automatisch de host en voegt samen. |
**Gesandboxte MCP-clients** (Flatpak / Snap / restrictieve containers) die de `localhost` van de host niet kunnen bereiken: stel ook `"AGENTMEMORY_FORCE_PROXY": "1"` in het `env`-blok in, en richt `AGENTMEMORY_URL` op een route die de sandbox daadwerkelijk kan bereiken (bijv. je LAN-IP).
### Programmatische toegang (Python / Rust / Node)
agentmemory registreert zijn kernoperaties als iii-functies (`mem::remember`, `mem::observe`, `mem::context`, `mem::smart-search`, `mem::forget`). Elke taal met een iii-SDK kan ze rechtstreeks aanroepen via `ws://localhost:49134`, zonder een apart REST-client per taal.
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
Uitgewerkt voorbeeld: [`examples/python/`](../examples/python/) (snelstart + observation/recall-flow). REST op `:3111` blijft beschikbaar voor hosts zonder iii-runtime.
### Vanuit de bron
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
Dit start agentmemory met een lokale `iii-engine` als de vastgezette binary al is geïnstalleerd, of gebruikt Docker Compose wanneer dat gekozen is. REST, streams en de viewer binden standaard aan `127.0.0.1`. Het automatische binary-pad voor macOS/Linux vereist `curl`, een POSIX `sh` en `tar`.
Installeer `iii-engine` handmatig. **agentmemory zet `iii-engine` momenteel vast op `v0.22.1`**, dezelfde release als zijn `iii-sdk`-dependency; de worker spreekt het wire-protocol van die engine, en 0.20.0 herorganiseerde het SDK-oppervlak, dus die twee bewegen samen op in agentmemory-releases. Overschrijf met `AGENTMEMORY_III_VERSION=` als je je eigen engine draait en weet dat die matcht.
- **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64:** vervang `aarch64-apple-darwin` door `x86_64-apple-darwin`
- **Linux x64:** vervang door `x86_64-unknown-linux-gnu`
- **Linux arm64:** vervang door `aarch64-unknown-linux-gnu`
- **Windows:** download `iii-x86_64-pc-windows-msvc.zip` van [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) en pak `iii.exe` uit naar `%USERPROFILE%\.agentmemory\bin\iii.exe`
Elk archief heeft een bijpassend `.sha256`-bestand op de releasepagina; wanneer je het platform wisselt, gebruik je de hash van dat bestand in de controle hierboven (op Windows: `Get-FileHash`). De automatische installer in `npx @agentmemory/agentmemory` legt deze hashes vast en weigert een archief dat niet overeenkomt.
Of gebruik Docker (de gebundelde `docker-compose.yml` haalt `iiidev/iii:0.22.1` op). Volledige documentatie: [iii.dev/docs](https://iii.dev/docs).
### Windows
agentmemory draait op Windows 10/11, maar het Node.js-package alleen is niet genoeg; je hebt ook de vastgezette iii-engine v0.22.1-runtime nodig als achtergrondproces. De CLI pakt de Windows ZIP niet automatisch uit, dus native Windows-gebruikers moeten `iii.exe` handmatig installeren, WSL2 gebruiken, of Docker Desktop kiezen.
Geautomatiseerde MCP-koppeling op native Windows ondersteunt alleen `agentmemory connect copilot-cli`. Voor Claude Code, Codex, Cursor en elke andere native Windows-agent kopieer je het handmatige MCP-blok uit [Other agents](#other-agents) naar de Windows-config van die agent. `connect` draaien in WSL is alleen geschikt wanneer de doelagent ook in dezelfde WSL-omgeving is geïnstalleerd; het bewerkt niet de configuratie van een agent op de Windows-host.
**Optie A: vooraf gebouwde Windows-binary (aanbevolen)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**Optie B: Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**Optie C: alleen standalone MCP (geen engine).** Als je alleen de MCP-tools voor je agent nodig hebt en geen REST API, viewer of cron-jobs nodig hebt, sla je de engine helemaal over:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**Diagnostiek voor Windows:** als `npx -y @agentmemory/agentmemory@latest` mislukt, voer je het opnieuw uit met `--verbose` om de werkelijke engine-stderr te zien. Veelvoorkomende faalmodi:
| Symptoom | Oplossing |
|---|---|
| `The engine process started but the REST API never responded.` | Controleer of alle vier afgeleide poorten vrij zijn, verifieer dat de vastgezette `iii.exe` actief bleef, voer dan opnieuw uit met `--verbose` en inspecteer de opgevangen engine-stderr |
| `Could not start iii-engine` | Noch `iii.exe` noch Docker is geïnstalleerd. Zie Optie A of B hierboven |
| Poortconflict | `netstat -ano \| findstr :3111` om te zien wat gebonden is, kill het dan of gebruik `--port ` |
| Docker-fallback overgeslagen terwijl Docker wel geïnstalleerd is | Zorg dat Docker Desktop daadwerkelijk draait (systeemvak-icoon) |
> Opmerking: de iii **engine** is een vooraf gebouwde binary, geen cargo-crate, probeer dus niet om `cargo install` erop te gebruiken. (De iii **SDK's** zijn gepubliceerd op crates.io, npm en PyPI, maar agentmemory heeft ze niet nodig.) Ondersteunde installatiemethoden voor de engine zijn allemaal vastgezet op v0.22.1: de vooraf gebouwde binary hierboven, het auto-installatiepad van agentmemory voor macOS/Linux (`curl`, POSIX `sh` en `tar` vereist), en de Docker-image `iiidev/iii:0.22.1`. Een kale upstream `install.sh | sh` installeert de nieuwste engine, wat agentmemory niet ondersteunt. Gebruik `npx -y @agentmemory/agentmemory@latest`; op macOS/Linux haalt dit de vastgezette engine binnen in `~/.agentmemory/bin`.
---
Deployment
Eén-klik-templates voor managed hosts. Elke template levert een zelfstandige
Dockerfile die `@agentmemory/agentmemory` van npm ophaalt en de iii-engine-binary
kopieert vanuit de officiële `iiidev/iii`-Docker-Hub-image; er is geen vooraf
gebouwde agentmemory-image nodig. Persistente opslag wordt gemount op `/data`;
het entrypoint bij de eerste boot overschrijft de door npm gebundelde
iii-config (die bindt aan `127.0.0.1`) met een voor deployment afgestemde
versie die bindt aan `0.0.0.0` en absolute `/data`-paden gebruikt, genereert
het HMAC-secret, en laat dan via `gosu` de privileges zakken van `root` naar
`node` voordat de agentmemory-CLI wordt uitgevoerd (`exec`).
De één-klik-deployknop van Render vereist een `render.yaml` in de root van de repository, die we bewust leeg houden. Gebruik de Render Blueprint-flow die gedocumenteerd is in [`deploy/render/`](.././deploy/render/README.md) om handmatig naar de blueprint in de repo te wijzen.
Volledige setupdetails (HMAC-capture, SSH-tunnel voor de viewer, rotatie, backup,
minimale kosten) staan in [`deploy/`](.././deploy/README.md):
- [`deploy/fly`](.././deploy/fly/README.md): één machine met
`auto_stop_machines = "stop"`; goedkoopst in rust.
- [`deploy/railway`](.././deploy/railway/README.md): vast tarief op het Hobby-plan,
volume in het dashboard.
- [`deploy/render`](.././deploy/render/README.md): Blueprint-flow,
automatische disk-snapshots op betaalde plannen.
- [`deploy/coolify`](.././deploy/coolify/README.md): self-hosted op je
eigen VPS via [Coolify](https://coolify.io/self-hosted); dezelfde Docker
Compose-stack, jij bent eigenaar van de host en de data.
Alleen poort `3111` wordt gepubliceerd. De viewer op `3113` blijft gebonden aan
loopback binnen de container; de README van elke template documenteert de
SSH-tunnel-aanpak om deze te bereiken.
---
Elke coding agent vergeet alles wanneer de sessie eindigt, en elke nieuwe sessie begint met jou die opnieuw je stack uitlegt. agentmemory draait op de achtergrond en laat die stap vervallen.
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### vs ingebouwd agentgeheugen
Elke AI coding agent levert ingebouwd geheugen: Claude Code heeft `MEMORY.md`, Cursor heeft notepads, Cline heeft een memory bank. Deze werken als geheugensteuntjes. agentmemory is de doorzoekbare database achter die geheugensteuntjes.
| | Ingebouwd (CLAUDE.md) | agentmemory |
|---|---|---|
| Schaal | Limiet van 200 regels | Onbeperkt |
| Zoeken | Laadt alles in de context | BM25 + vector + graph (alleen top-K) |
| Tokenkosten | 22K+ bij 240 observaties | ~1,900 tokens (92% minder) |
| Cross-agent | Bestanden per agent | MCP + REST (elke agent) |
| Coördinatie | Geen | Leases, signals, actions, routines |
| Observability | Bestanden handmatig lezen | Realtime viewer op :3113 |
---
### Memory-pipeline
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### 4-laagse memory-consolidatie
Gemodelleerd naar hoe menselijke breinen geheugen verwerken, inclusief consolidatie tijdens slaap.
| Laag | Wat | Analogie |
|------|------|---------|
| **Working** | Ruwe observaties uit toolgebruik | Kortetermijngeheugen |
| **Episodic** | Gecomprimeerde sessiesamenvattingen | "Wat er gebeurd is" |
| **Semantic** | Geëxtraheerde feiten en patronen | "Wat ik weet" |
| **Procedural** | Workflows en beslispatronen | "Hoe je het doet" |
Memories vervagen in de tijd (Ebbinghaus-curve). Vaak opgevraagde memories worden sterker. Verouderde memories worden automatisch verwijderd. Tegenstrijdigheden worden gedetecteerd en opgelost.
### Wat er wordt vastgelegd
| Hook | Legt vast |
|------|----------|
| `SessionStart` | Projectpad, session ID |
| `UserPromptSubmit` | Gebruikersprompts (privacy-gefilterd) |
| `PreToolUse` | Bestandstoegangspatronen + verrijkte context |
| `PostToolUse` | Toolnaam, input, output |
| `PostToolUseFailure` | Errorcontext |
| `PreCompact` | Injecteert geheugen opnieuw vóór compactie |
| `SubagentStart/Stop` | Lifecycle van sub-agents |
| `Stop` | Samenvatting aan het einde van de sessie |
| `SessionEnd` | Markering dat de sessie voltooid is |
### Belangrijkste functies
| Functie | Beschrijving |
|---|---|
| **Automatische capture** | Elk toolgebruik vastgelegd via hooks, zonder handmatige moeite |
| **Semantisch zoeken** | BM25 + vector + knowledge graph met RRF-fusie |
| **Memory-evolutie** | Versiebeheer, supersession, relatiegraphs |
| **Recall-hygiëne** | Vervangen memory-versies verlaten de zoekindexen; de versieketen in KV behoudt de volledige geschiedenis |
| **Near-duplicate-hints** | Bij opslaan wordt een adviserende `similarTo`-match gerapporteerd wanneer nieuwe content sterk op een bestaande memory lijkt |
| **Scoping per agent** | `agentId` loopt door save en recall heen, over REST, MCP en de zoekindex, in shared of isolated modus |
| **Provenance op schrijfmoment** | Elke observatie en memory draagt een onveranderlijk oorsprongkanaal (user, agent, tool, import of shared), gestempeld bij capture, save en import |
| **Auto-forgetting** | TTL-verval, detectie van tegenstrijdigheden, eviction op basis van belang |
| **Privacy eerst** | API-keys, secrets en ``-tags verwijderd vóór opslag |
| **Zelfherstellend** | Circuit breaker, fallback-keten van providers, health monitoring |
| **Claude-bridge** | Bidirectionele sync met MEMORY.md |
| **Knowledge graph** | Entiteitsextractie + BFS-traversal |
| **Team memory** | Namespaced shared + private tussen teamleden |
| **Citation-provenance** | Traceer elke memory terug naar de bron-observaties |
| **Git-snapshots** | Versioneer, rollback en diff van memory-state |
---
Triple-stream retrieval combineert drie signalen:
| Stream | Wat het doet | Wanneer |
|---|---|---|
| **BM25** | Keyword-matching met stemming en synonym-expansion | Altijd actief |
| **Vector** | Cosine similarity over dense embeddings | Embedding-provider geconfigureerd |
| **Graph** | Knowledge-graph-traversal via entity-matching | Entiteiten gedetecteerd in de query |
Samengevoegd met Reciprocal Rank Fusion (RRF, k=60) en gediversifieerd per sessie (max. 3 resultaten per sessie).
Wanneer een vector-index gevuld is, gebruikt `mem::search` (achter `memory_recall`) de hybride BM25 + vector-ranker. Zonder embeddings gebruikt het BM25. `smart-search` kan daarnaast structurele graph-matches samenvoegen wanneer er graph-data bestaat, ook in keyless-modus. Lesson-recall draait op een eigen in-memory BM25-index in plaats van het hele corpus per query te doorzoeken. Vervangen memory-versies worden uitgesloten van elk recall-pad; de versieketen behoudt hun geschiedenis.
Vectoren overleven een crash of force-kill. De vector-index wordt in batches opgeslagen, maximaal elke `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS` (10 minuten). Elke vector die er tussendoor bijkomt of verdwijnt, wordt ook meteen geschreven naar een klein pending-log in de state store, en de volgende start speelt dit af zonder de embedding-provider aan te roepen. Elke succesvolle save maakt het log leeg. Documenten die na het afspelen nog geen vector hebben, worden op de achtergrond opnieuw ge-embed in batches van `AGENTMEMORY_VECTOR_BACKFILL_MAX` (500) totdat er geen meer over zijn, en een backfill die gestopt wordt, gaat bij de volgende start verder. `/agentmemory/status` en de viewer tonen de grootte van het pending-log en de status van de backfill. Keyless-installaties schrijven niets.
BM25 tokeniseert standaard Grieks, Cyrillisch, Hebreeuws, Arabisch en Latijn met accenten. Voor Chinese / Japanse / Koreaanse memories installeer je de optionele segmenters (`npm install @node-rs/jieba tiny-segmenter`) om CJK-reeksen op te splitsen in tokens op woordniveau; zonder deze valt agentmemory soft terug op tokenisatie van de hele reeks en print het eenmalig een hint naar stderr.
### Embedding-providers
Keyless-installaties schakelen vector-embeddings uit: `mem::search` gebruikt BM25, terwijl `smart-search` ook bestaande structurele graph-data kan gebruiken. Om in te stappen op gratis semantische embeddings op het eigen apparaat, voeg je dit toe aan `~/.agentmemory/.env` en herstart je agentmemory:
```env
EMBEDDING_PROVIDER=local
```
De normale npm-installatie bevat de optionele `@huggingface/transformers`-runtime. De eerste embedding-aanvraag downloadt `Xenova/all-MiniLM-L6-v2`, waarvoor netwerktoegang nodig is en wat langer kan duren; latere inference draait op het eigen apparaat. Remote providers worden automatisch gedetecteerd aan hun keys, tenzij `EMBEDDING_PROVIDER` ze overschrijft.
| Provider | Model | Kosten | Opmerkingen |
|---|---|---|---|
| **Lokaal (aanbevolen opt-in)** | `all-MiniLM-L6-v2` | Gratis | Op het eigen apparaat na de eerste modeldownload, +8pp recall t.o.v. alleen BM25 |
| Gemini | `gemini-embedding-001` | Gratis tier | 100+ talen, 768/1536/3072 dims (MRL), input tot 2048 tokens. Vervangt `text-embedding-004` ([deprecated, uitgefaseerd op 14 jan. 2026](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | $0.02/1M | Hoogste kwaliteit |
| Voyage AI | `voyage-code-3` | Betaald | Geoptimaliseerd voor code |
| Cohere | `embed-english-v3.0` | Gratis trial | Algemeen inzetbaar |
| OpenRouter | Elk model | Varieert | Multi-model-proxy |
---
54 tools, 6 resources, 3 prompts en 17 skills.
> **MCP-shim versus volledige server:** het gepubliceerde `@agentmemory/mcp`-package is een dunne shim. Het toont het volledige oppervlak van 54 tools **alleen wanneer het een draaiende agentmemory server kan bereiken** via `AGENTMEMORY_URL` (proxy-modus). Als er geen server bereikbaar is, valt de shim terug op een lokale set van 7 tools (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`). De env-variabele `AGENTMEMORY_TOOLS=core|all` is een vlag aan de *serverzijde*; deze instellen in het `env`-blok van de shim heeft geen effect. Zie je maar 7 tools in Cursor / OpenCode / Gemini CLI, start dan `npx -y @agentmemory/agentmemory@latest` (of de Docker-stack) en stel `AGENTMEMORY_URL=http://localhost:3111` in.
### 54 tools
Drie tool-oppervlakken, van klein naar groot: `AGENTMEMORY_TOOLS=core` beperkt de zichtbaarheid tot 8 essentiële tools (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`); de basisset hieronder bestaat uit de 14 fundamentele tools van het registry; de standaard (`AGENTMEMORY_TOOLS=all`) toont alle 54.
Basistools (14)
| Tool | Beschrijving |
|------|-------------|
| `memory_recall` | Doorzoek eerdere observaties |
| `memory_compress_file` | Comprimeer markdown-bestanden met behoud van structuur |
| `memory_save` | Sla een inzicht, beslissing of patroon op |
| `memory_file_history` | Eerdere observaties over specifieke bestanden |
| `memory_patterns` | Detecteer terugkerende patronen |
| `memory_sessions` | Lijst recente sessies |
| `memory_smart_search` | Hybride semantisch + keyword-zoeken |
| `memory_vision_search` | Doorzoek afbeeldingsobservaties |
| `memory_timeline` | Chronologische observaties |
| `memory_profile` | Projectprofiel (concepten, bestanden, patronen) |
| `memory_export` | Exporteer alle memory-data |
| `memory_relations` | Query de relatiegraph |
| `memory_commit_lookup` | Sessies achter een git-commit |
| `memory_commits` | Commits vastgelegd voor een sessie |
Uitgebreide tools (54 in totaal, het standaardoppervlak)
| Tool | Beschrijving |
|------|-------------|
| `memory_patterns` | Detecteer terugkerende patronen |
| `memory_timeline` | Chronologische observaties |
| `memory_relations` | Query de relatiegraph |
| `memory_graph_query` | Knowledge-graph-traversal |
| `memory_consolidate` | Voer 4-laagse consolidatie uit |
| `memory_claude_bridge_sync` | Sync met MEMORY.md |
| `memory_team_share` | Deel met teamleden |
| `memory_team_feed` | Recent gedeelde items |
| `memory_audit` | Audit trail van operaties |
| `memory_governance_delete` | Verwijderen met audit trail |
| `memory_snapshot_create` | Git-versiebeheerde snapshot |
| `memory_action_create` | Maak werkitems met dependencies |
| `memory_action_update` | Werk actiestatus bij |
| `memory_frontier` | Niet-geblokkeerde acties gerangschikt op prioriteit |
| `memory_next` | De ene belangrijkste volgende actie |
| `memory_lease` | Exclusieve action leases (multi-agent) |
| `memory_routine_run` | Instantieer workflow-routines |
| `memory_signal_send` | Berichten tussen agents |
| `memory_signal_read` | Lees berichten met ontvangstbevestigingen |
| `memory_checkpoint` | Externe conditiepoorten |
| `memory_mesh_sync` | P2P-sync tussen instanties |
| `memory_sentinel_create` | Event-gestuurde watchers |
| `memory_sentinel_trigger` | Vuur sentinels extern af |
| `memory_sketch_create` | Tijdelijke action graphs |
| `memory_sketch_promote` | Promoveer naar permanent |
| `memory_crystallize` | Comprimeer actieketens |
| `memory_diagnose` | Health-checks |
| `memory_heal` | Herstel vastgelopen state automatisch |
| `memory_facet_tag` | Dimensie:waarde-tags |
| `memory_facet_query` | Query op facet-tags |
| `memory_verify` | Traceer provenance |
### 6 resources · 3 prompts · 17 skills
| Type | Naam | Beschrijving |
|------|------|-------------|
| Resource | `agentmemory://status` | Health, aantal sessies, aantal memories |
| Resource | `agentmemory://project/{name}/profile` | Intelligence per project |
| Resource | `agentmemory://project/{name}/recent` | Recente observaties voor een project |
| Resource | `agentmemory://memories/latest` | Laatste 10 actieve memories |
| Resource | `agentmemory://graph/stats` | Knowledge-graph-statistieken |
| Resource | `agentmemory://team/{id}/profile` | Gedeeld teamprofiel |
| Prompt | `recall_context` | Zoek + geef contextberichten terug |
| Prompt | `session_handoff` | Handoff-data tussen agents |
| Prompt | `detect_patterns` | Analyseer terugkerende patronen |
| Skill | `/recall` | Doorzoek geheugen |
| Skill | `/remember` | Sla op in langetermijngeheugen |
| Skill | `/session-history` | Recente sessiesamenvattingen |
| Skill | `/forget` | Verwijder observaties/sessies |
De tabel toont de vier kernskills. De volledige set is 9 aanroepbare skills plus 8 referentieskills; zie de sectie Native skills hierboven.
### Standalone MCP
Draai zonder de volledige server, voor elke MCP-client. Beide werken:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
Of voeg toe aan de MCP-config van je agent:
De meeste agents (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
Voeg de `agentmemory`-entry samen met het bestaande `mcpServers`-object van je host, in plaats van het bestand te vervangen. Voor gesandboxte clients die de `localhost` van de host niet kunnen bereiken, voeg je `"AGENTMEMORY_FORCE_PROXY": "1"` toe aan het env-blok en stel je `AGENTMEMORY_URL` in op een route die de sandbox kan bereiken.
OpenCode (`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
Kopieer het plugin-bestand uit de repo:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---
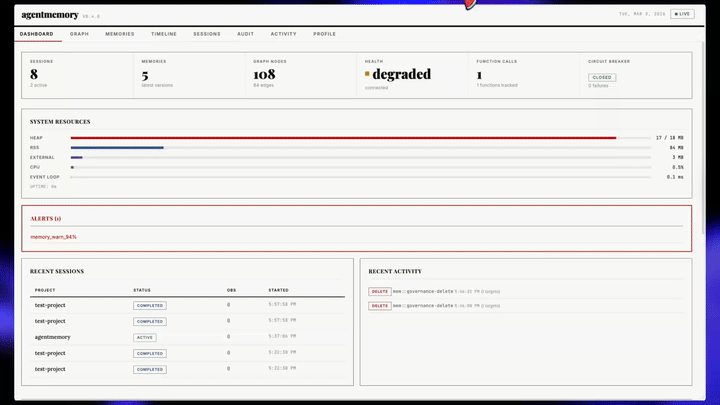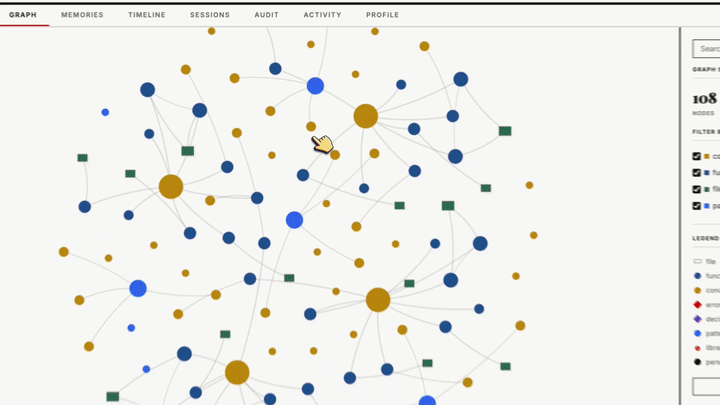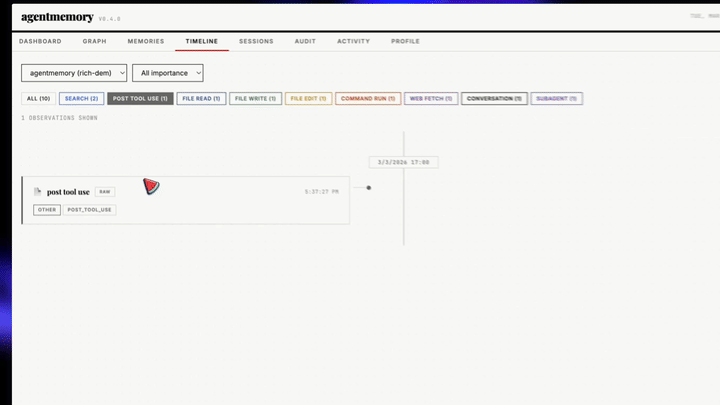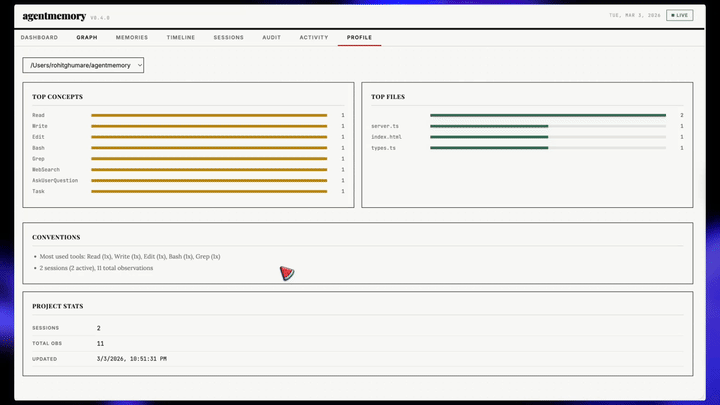
Start automatisch op poort `3113`. De viewer laadt één snapshot bij het verbinden (`GET /agentmemory/viewer/snapshot`) en past daarna live stream-events toe: nieuwe memories, lessen, observaties, audit-entries, graph-wijzigingen en health-updates verschijnen zonder polling of het herladen van de pagina. De enige andere verzoeken zijn de acties die je aanklikt, "load more"-pagina's en zoekopdrachten. Wanneer de stream wegvalt, toont de viewer hoe oud zijn cijfers zijn, maakt opnieuw verbinding met backoff en synchroniseert opnieuw vanaf één snapshot.
- **12 tabbladen in vier groepen** met live aantallen, deep links (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), toetsenbordsneltoetsen en een mobiel menu.
- **Memories:** server-side zoeken, filters op project, agent en type, een detailpaneel met de versieketen en een word-diff, provenance-links, kopieerknoppen voor de id, de MCP-aanroep en een curl-commando, bewerken (een nieuwe versie), forget met bevestiging, bulk-forget en JSON-export.
- **Sessions:** een inline observatietijdlijn met leesbare tool-input en -output, filters en paginering, en de memories en lessen die elke sessie heeft opgeleverd.
- **Graph:** zoeken, node-detail met relaties en bronnen, een legenda die niet alleen op kleur vertrouwt, en zoomregeling.
- **Health:** de live versie van `GET /agentmemory/status`. Elk probleem komt met zijn oplossing, plus de state-backend, de save-status van de index, de voortgang van graph-provenance-compactie en een consolidatie-uitleg met de echte drempelwaarden.
- **Audit-, Activity-, Profile-, Replay-, Lessons-, Actions- en Crystals**-pagina's, elk met een lege staat die vertelt wat de sectie is, waarom hij leeg is en welk commando hem vult, en een `?`-woordenlijsttooltip bij elke term en elk getal.
```bash
open http://localhost:3113
```
De viewer-server bindt standaard aan `127.0.0.1` en voegt het server-secret toe wanneer hij verzoeken doorstuurt naar de REST API, dus er is geen setup nodig. Het via REST geserveerde `/agentmemory/viewer`-endpoint volgt de normale bearer-token-regels en stuurt browsers zonder token door naar de viewer-poort. CSP-headers gebruiken een per-response script-nonce en schakelen inline handler-attributen uit (`script-src-attr 'none'`).
---
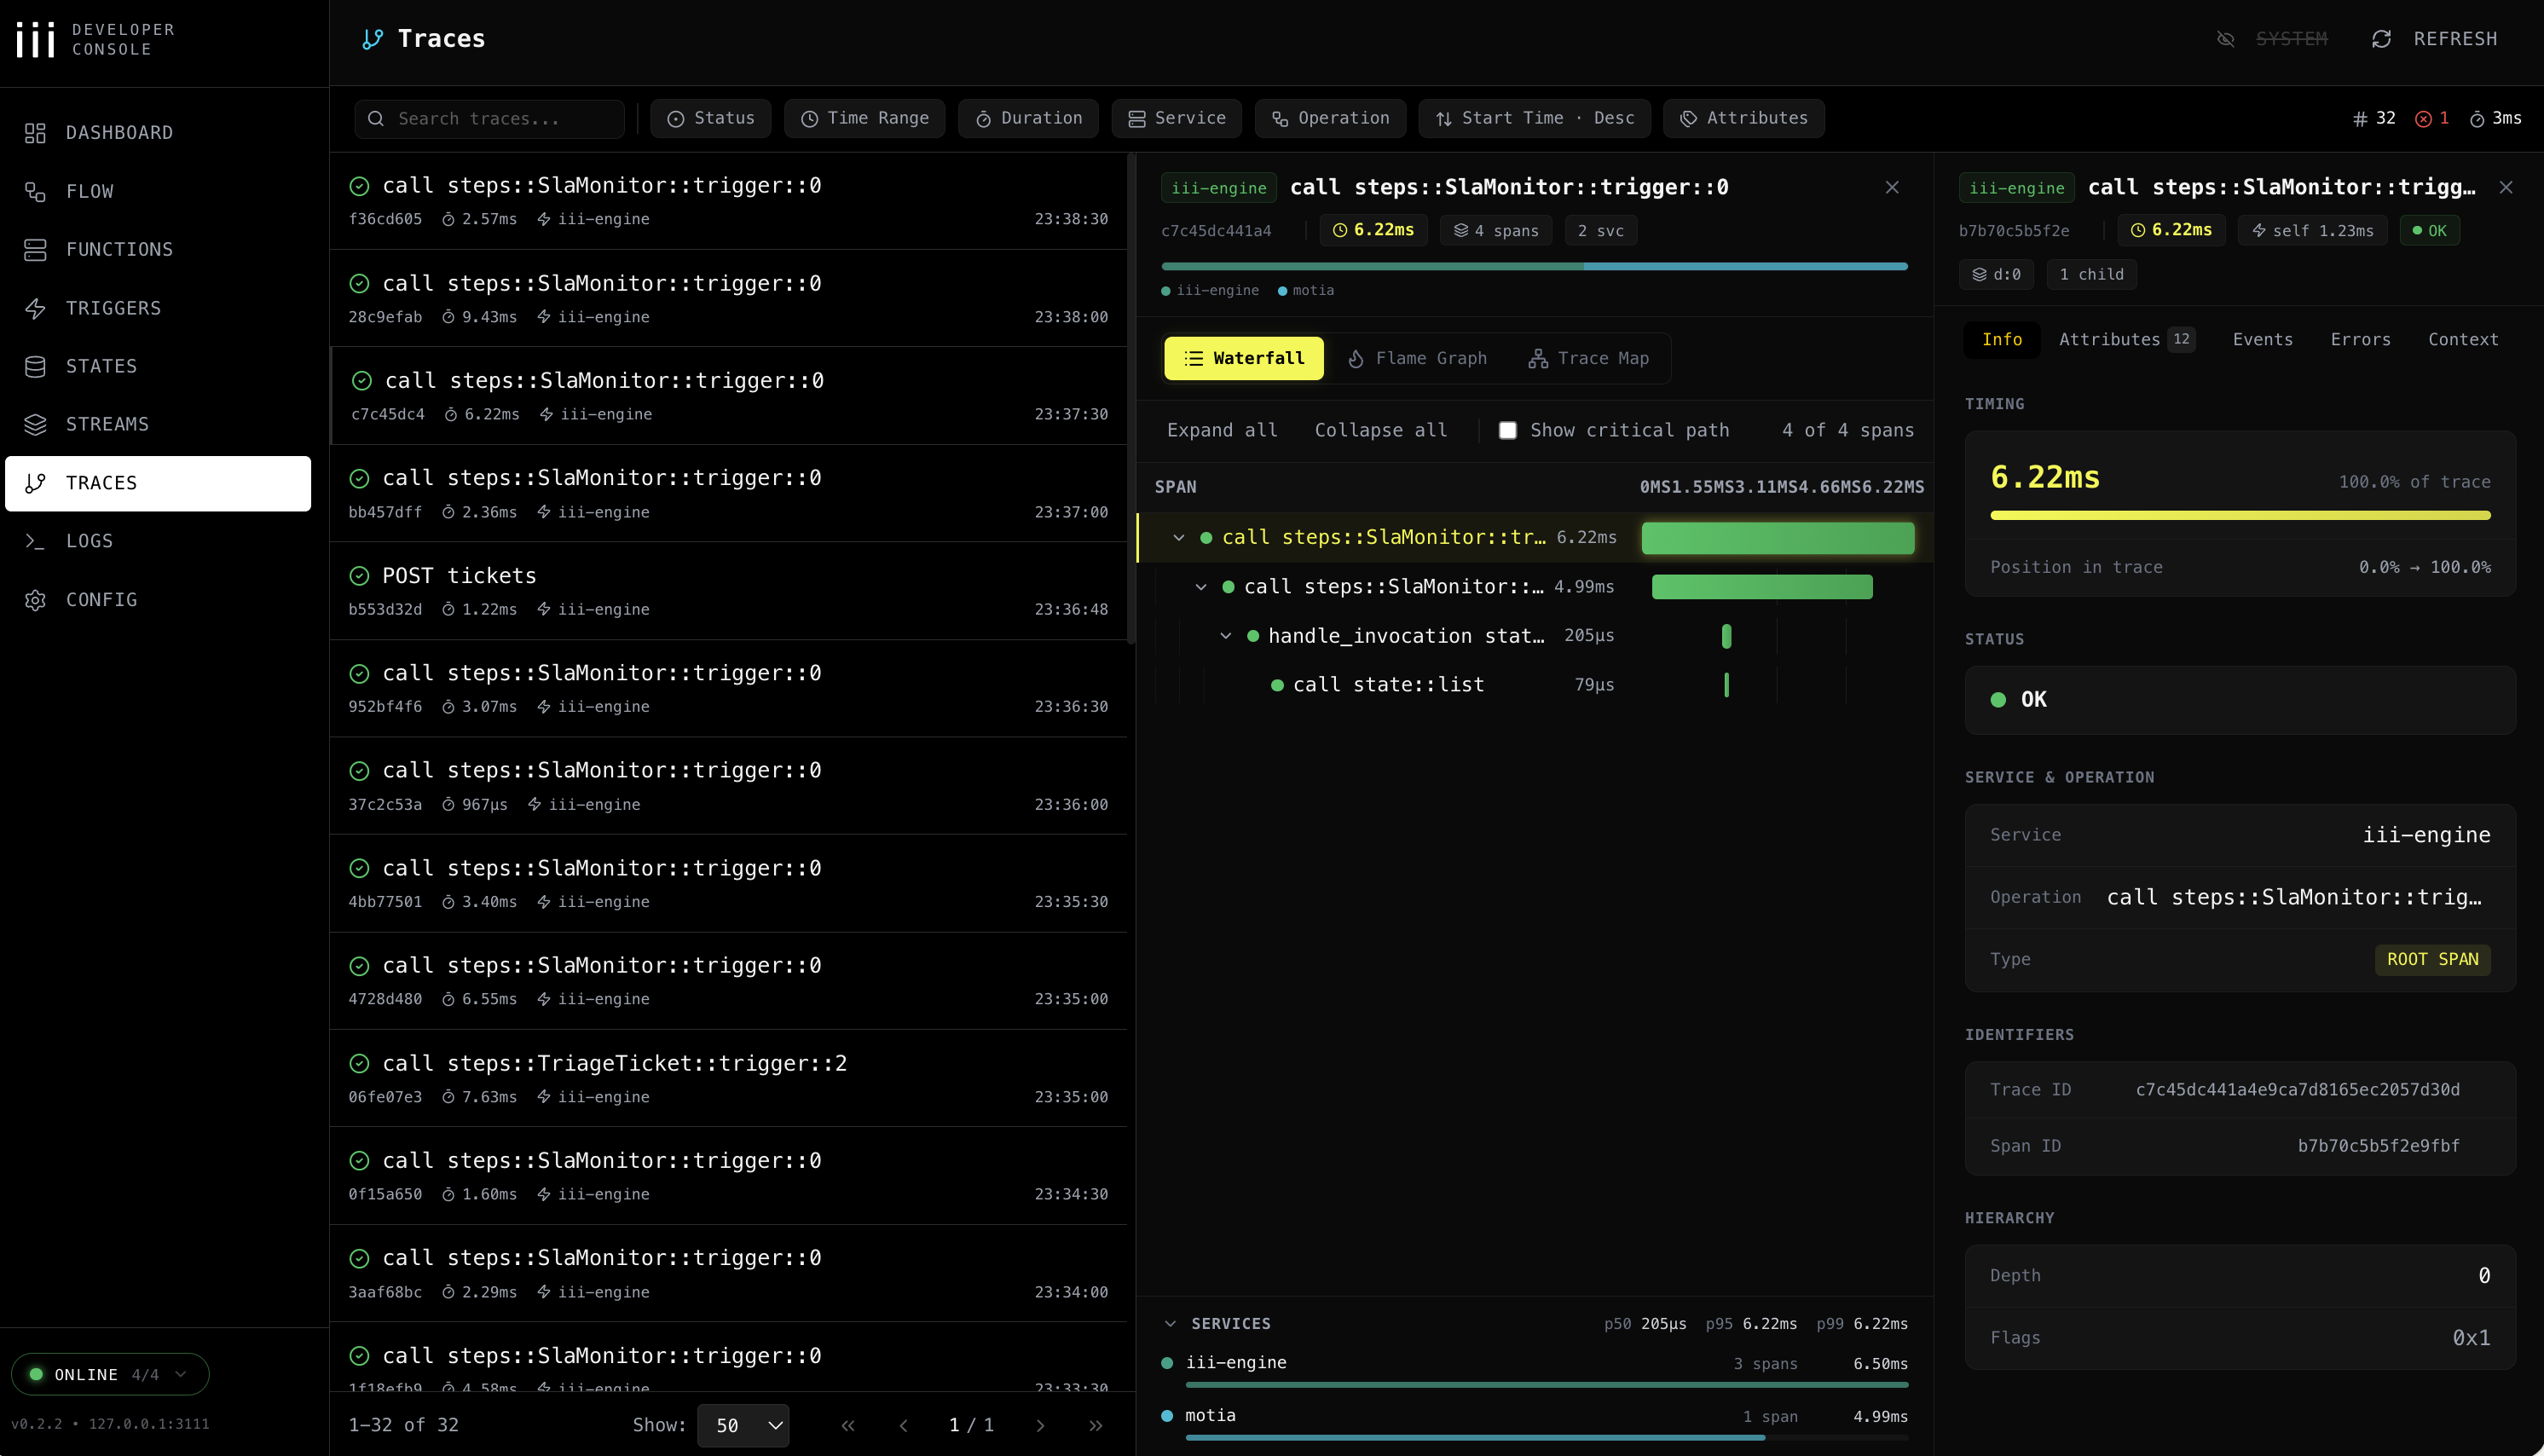
De viewer op `:3113` toont wat je agent **onthouden heeft**. De [iii console](https://iii.dev/docs/console) toont wat je agent **gedaan heeft**: elke memory-operatie als een OpenTelemetry-trace, elke KV-entry bewerkbaar, elke functie aanroepbaar, elke stream aftapbaar. Twee vensters op hetzelfde geheugen: één productvormig, één enginevormig.
Zie een `memory_smart_search` afgaan en bekijk de BM25-scan → embedding-lookup → RRF-fusie → reranker als een waterfall. Bewerk een vastgelopen consolidatietimer in de KV-browser. Speel een `PostToolUse`-hook opnieuw af met een aangepaste payload. Pin de WebSocket-stream en bekijk observaties live binnenkomen.
agentmemory levert dit gratis mee, omdat elke function call en trigger via iii loopt; niets custom, niets om te instrumenteren.
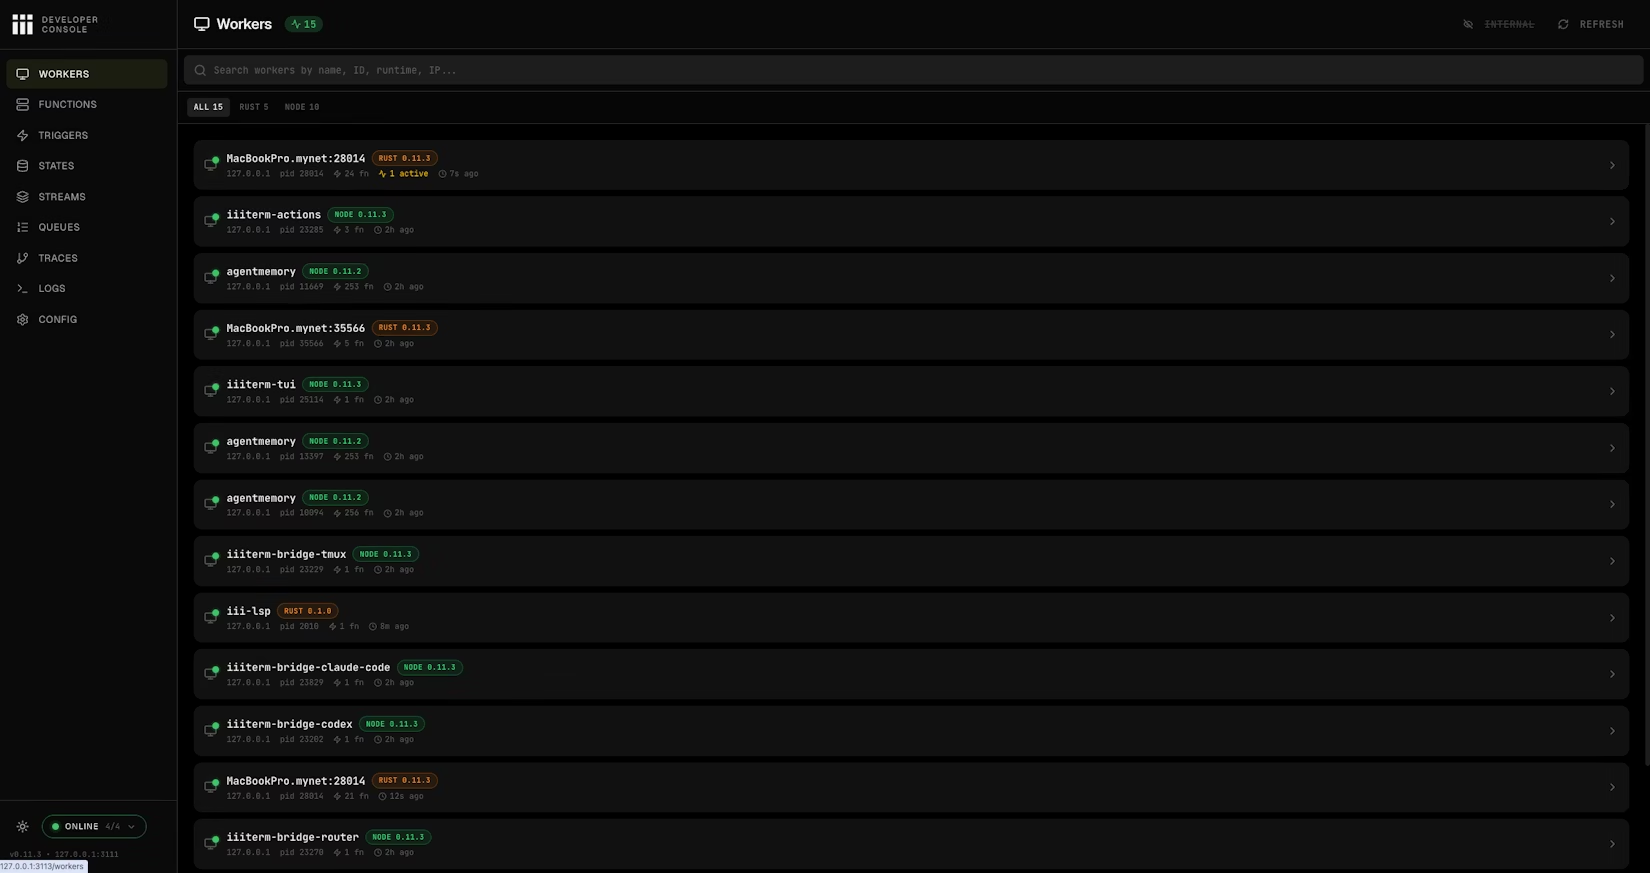
Workers-pagina: elke verbonden worker, inclusief agentmemory zelf, met PID, functietelling, runtime en laatst gezien.
**Al geïnstalleerd.** De console wordt meegeleverd met de vastgezette `iii`-engine (0.22+); niets apart te installeren. De eerste start downloadt de console-binary naast de engine.
**Starten naast agentmemory:**
```bash
agentmemory console
```
Dit draait de `iii console` van de vastgezette engine tegen de poorten die agentmemory heeft opgelost (REST, streams, bridge) en serveert deze op één poort boven de viewer, standaard `http://localhost:3114`. `--console-port N` kiest een andere poort; `--port` en `--instance` selecteren de agentmemory-instantie op dezelfde manier als bij `stop`; elke andere flag wordt doorgegeven, bijvoorbeeld `--enable-flow` voor de experimentele architecture-graph-pagina.
Hetzelfde handmatig, handig wanneer `agentmemory` niet op PATH staat:
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**Wat je kunt doen vanuit de console:**
| Pagina | Gebruik dit om |
|------|-----------|
| **Workers** | Elke verbonden worker en zijn live metrics te zien, inclusief de agentmemory-worker zelf. |
| **Functions** | Elke functie van agentmemory rechtstreeks aan te roepen met een JSON-payload; handig om `memory.recall`, `memory.consolidate`, `graph.query` te testen zonder een client te koppelen. |
| **Triggers** | HTTP-, cron-, event- en state-triggers opnieuw af te spelen: de consolidatie-cron handmatig afvuren, een HTTP-route opnieuw proberen, een state-wijziging uitzenden. |
| **States** | Een KV-browser met volledige CRUD over sessies, memory-slots, lifecycle-timers en de embeddings-index; waarden direct ter plekke bewerken. |
| **Streams** | Live WebSocket-monitor voor memory-writes, hook-events en observatie-updates terwijl ze door iii-streams stromen. |
| **Queues** | Durable queue-topics + dead-letter-beheer. Mislukte embedding-/compressiejobs opnieuw afspelen of verwijderen. |
| **Traces** | OpenTelemetry waterfall-/flame-/service-breakdown-weergaven. Filter op `trace_id` om precies te zien welke functies, DB-aanroepen en embedding-aanvragen één `memory.search` opleverde. |
| **Logs** | Gestructureerde OTEL-logs gefilterd en gecorreleerd aan trace-/span-ID's. |
| **Config** | Runtime-configuratie: precies zien met welke workers, providers en poorten je engine draait. |
| **Flow** | (Optioneel, `--enable-flow`) Interactieve architecture-graph van elke worker, trigger en stream. |
Traces: waterfall / flame / service-breakdown voor elke memory-operatie.
**Traces staan al aan:**
`iii-config.yaml` wordt geleverd met de `iii-observability`-worker ingeschakeld (`exporter: memory`, `sampling_ratio: 0.1`, metrics + logs). Geen extra config nodig; zodra agentmemory start, geeft elke memory-operatie een gestructureerde log die de console kan lezen, en één op de tien (`sampling_ratio: 0.1`) geeft ook een trace-span af.
Als je in plaats daarvan wilt exporteren naar Jaeger/Honeycomb/Grafana Tempo, verander je `exporter: memory` in `exporter: otlp` en stel je het collector-endpoint in volgens de observability-documentatie van iii.
> **Let op:** er wordt geen auth afgedwongen op de console zelf; houd deze gebonden aan `127.0.0.1` (de standaard) en stel hem nooit publiek bloot.
---
agentmemory is **al een draaiende [iii](https://iii.dev)-instantie**. Drie primitieven (worker, functie, trigger) stellen de runtime samen; KV-state, streams en OTEL-traces komen van de iii-state-, iii-stream- en iii-observability-workers die met iii meegeleverd worden. Je hebt geen Postgres, Redis, Express, pm2 of Prometheus geïnstalleerd, omdat iii die vervangt.
Dat betekent dat één extra commando agentmemory uitbreidt met een volledig nieuwe functie.
### agentmemory uitbreiden met meer workers
De builtins die agentmemory nodig heeft, staan al in `iii-config.yaml` en starten ermee op: `iii-state` (KV), `iii-queue` (durable retries voor de event-subscribers), `iii-pubsub`, `iii-cron`, `iii-stream` en `iii-observability` (OTEL-traces, metrics en logs op elke functie). Alles anders uit het [iii worker-registry](https://workers.iii.dev) sluit aan op dezelfde engine: kopieer `iii-config.yaml` naar `~/.agentmemory/iii-config.yaml` (de CLI geeft de voorkeur aan dat bestand boven het gebundelde, en rendert nog steeds poorten en datapaden erin), voeg de entry toe, installeer de worker-runtime eenmalig met `~/.agentmemory/bin/iii update worker`, en herstart agentmemory.
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | Wat je extra krijgt bovenop agentmemory |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | SQL-backed state-adapter wanneer je de in-memory KV-standaardwaarden ontgroeit |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | Code die uit `memory_recall` komt, draait in een wegwerp-VM, niet in je shell |
| [`mcp`](https://workers.iii.dev/workers/mcp) | Zet extra MCP-servers naast die van agentmemory, met dezelfde engine |
Op engine 0.22.x houd je de `iii-`-voorvoegsel-namen aan voor de builtins hierboven; de entries zonder voorvoegsel (`http`, `state`, `queue`, `pubsub` en `cron`) zijn de standalone registry-workers waar agentmemory naar overstapt met de 0.23-migratie.
Volledig registry: [workers.iii.dev](https://workers.iii.dev). Elke worker daar is samengesteld uit dezelfde primitieven die agentmemory gebruikt, en de agentmemory die je al hebt, is er één van.
### Engine-config en bind-adres
`agentmemory start` leest de engine-config vanuit het eerste bestand dat bestaat: `AGENTMEMORY_III_CONFIG`, `./iii-config.yaml` in de huidige map, `~/.agentmemory/iii-config.yaml`, en dan het gebundelde `iii-config.yaml`. Bij elke start rendert het dat bestand (datapaden, poorten, state-backend) naar `~/.agentmemory/data/iii-config.runtime.yaml` en start het de engine met de gerenderde kopie, dus bewerk het bronbestand, niet het gerenderde. De `host:`-waarden van het bronbestand blijven zoals geschreven.
Het gebundelde `iii-config.yaml` bindt met opzet aan `127.0.0.1`, en die standaard geldt ook binnen een container. Een CLI die in een container start, luistert op de loopback van de container, dus gepubliceerde poorten bereiken niets. Om een gecontaineriseerde CLI via gepubliceerde poorten te serveren, stel je `AGENTMEMORY_III_CONFIG` in op een config die bindt aan `0.0.0.0`. De gebundelde `iii-config.docker.yaml` is er zo een: deze bindt `iii-http`, `iii-stream` en de engine-poort aan `0.0.0.0` en bewaart state onder `/data`, dus mount daar een schrijfbaar volume. Houd `AGENTMEMORY_SECRET` ingesteld, en publiceer alleen de poorten die je nodig hebt, op `127.0.0.1` of achter een proxy die je vertrouwt.
De `docker-compose.yml` van deze repo gaat niet via de config-lookup van de CLI: deze mount `iii-config.docker.yaml` op `/app/config.yaml`, en de `iii-engine`-container start met `--config /app/config.yaml`. De één-klik-[deploy-templates](../deploy/) schrijven hun eigen `0.0.0.0`-config in hun entrypoints.
### Storage-backend: file (standaard) versus redis
`iii-state` en `iii-stream` gebruiken standaard de bij iii-engine gebundelde file-based KV-store: één JSON-bestand per scope, gehouden in het geheugen van het engine-proces en op een timer terug naar disk geschreven. Dat is de juiste standaard voor een lokale installatie met één gebruiker; een gedeelde daemon met meerdere gelijktijdige writers krijgt in plaats daarvan echte per-key writes van Redis, tegen de prijs van een netwerk-round-trip per operatie (elke `state::*`-aanroep serialiseert nog steeds op één Redis-verbinding, dus dit ruilt het lock van de file store in voor een socket, niet voor parallellisme).
Stel `AGENTMEMORY_STATE_BACKEND=redis` in (plus `AGENTMEMORY_REDIS_URL`) om beide workers over te schakelen naar de ingebouwde `redis`-adapter van iii-engine, die elke key opslaat als een Redis-hashveld (`HSET`) in plaats van een hele scope bij elke write te herschrijven:
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` is standaard `file`; het niet instellen houdt het huidige gedrag ongewijzigd, en een niet-herkende waarde (iets anders dan `file` of `redis`) geeft een opstartfout in plaats van een stille fallback. `/agentmemory/status` en de Health-pagina van de viewer (de rij State store) melden welke backend actief is en of deze antwoordt, nooit de URL.
**Alleen kale `redis://`.** De vastgezette engine (0.22.1) bouwt zijn Redis-client zonder TLS-ondersteuning, dus een `rediss://`-URL (de meeste managed Redis-aanbieders, zoals Upstash, Redis Cloud en ElastiCache met encryptie tijdens transport, staan standaard alleen TLS toe) kan niet verbinden. De verbinding is onversleuteld, dus het Redis-wachtwoord en elke opgeslagen memory gaan in leesbare tekst over de lijn: richt je op een lokale Redis of één op een privénetwerk dat je vertrouwt. Voor elke andere Redis draai je een versleutelde tunnel (stunnel, SSH, of een VPN) op de agentmemory-host, zodat de kale `redis://`-hop op die host blijft en de upstream-verbinding van de tunnel versleuteld en geauthenticeerd is. Als een Redis-wachtwoord een enkel aanhalingsteken bevat, percent-encode je dit (`%27`); de engine breidt de URL uit in zijn YAML-config voordat deze geparsed wordt.
**Eén Redis-server per `--instance`.** De Redis-keyvoorvoegsels van de engine (`state:`, `stream::`) zijn vast, dus twee agentmemory-instanties (`--instance 1`, `--instance 2`, ...) die naar dezelfde database wijzen, overschrijven elkaars data. Een aparte database-index (`redis://localhost:6379/1`) houdt de opgeslagen data apart, maar de engine relayt live viewer-events over één Redis-pub/sub-kanaal (`stream::events`), en Redis-pub/sub negeert de database-index, dus de viewer van elke instantie zou nog steeds de live events van de andere laten zien. Geef elke instantie zijn eigen Redis-server (of poort) wanneer je er meer dan één draait.
**Wat gelijk blijft, en wat verschilt.** Elke functie van agentmemory werkt op Redis: sessions, observaties, memories (remember, supersede, evolve, forget), zoeken en de index-buckets, lessen, de graph, de audit-log en zijn maandelijkse scopes, export en import, governance-deletes, consolidatiestatus, de viewer-snapshot en zijn live stream, en de health-monitor. De engine bewaart elke scope als één Redis-hash (`HSET`/`HGET`/`HGETALL`) en vuurt dezelfde state-triggers af als de file store. Drie engine-verschillen worden binnen agentmemory opgevangen:
- Redis geeft de records van een scope terug in geen vaste volgorde. agentmemory sorteert ze oudste eerst (op de aanmaaktijd in de record-id, dan het timestamp), zodat lijsten, paginering en export-chunks in dezelfde volgorde terugkomen als bij de file store.
- De engine past partiële updates op Redis toe in een Lua-script dat lege arrays omzet in lege objecten. agentmemory past die updates zelf toe (lezen, wijzigen, schrijven onder een per-key lock) op Redis, zodat velden zoals `tags: []` arrays blijven.
- De legacy audit-log-check leest de oude scope van Redis in plaats van te zoeken naar het bestand van de file store op disk.
Eén verschil vraagt actie van jou: **nadat Redis herstart, stopt de engine met het relayen van live events** naar de viewer totdat agentmemory herstart. Data wordt nog steeds normaal opgeslagen en gelezen. De health-monitor stuurt elke 30 seconden een testevent via Redis; als dit niet terugkomt, tonen `/agentmemory/status` en de Health-pagina van de viewer "Live updates are not reaching the viewer" met de oplossing: herstart agentmemory. Als Redis down is, toont het statusrapport "The state store is not answering" en hoe je dit controleert (`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`). Een zeer grote scope opvragen leest de hele hash in één `HGETALL`, dezelfde kost als wanneer de file store dit in het geheugen houdt.
**Aanbevolen Redis-instellingen.** Het standaard snapshotbeleid `save 3600 1 300 100 60 10000` kan bij een crash minuten aan writes verliezen, erger dan het flush-venster van 5s van de file store. Stel `appendonly yes` in voor alles wat je niet wilt verliezen. Stel `maxmemory-policy noeviction` in; `allkeys-lru` of vergelijkbaar laat stilletjes memories vallen zodra Redis zijn geheugenlimiet bereikt.
Een native (niet-Docker) start, en elke één-klik-[deploy-template](../deploy/) (die overschrijven het gebundelde `iii-config.yaml` en starten native), lezen `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` en renderen die in de gestarte `iii-config`. De URL zelf wordt nooit naar dat gerenderde bestand geschreven, alleen een `${AGENTMEMORY_REDIS_URL}`-referentie die het engine-proces bij het opstarten uit zijn eigen omgeving uitbreidt. Alleen het eigen Docker-Compose-pad van deze repo (`AGENTMEMORY_USE_DOCKER=1`, of het hervatten van een engine die al zo gestart is) mount `iii-config.docker.yaml` read-only en rendert nooit; `agentmemory start` waarschuwt wanneer het die combinatie detecteert. Wijzig dat bestand handmatig, volgens dezelfde `name: redis` / `config: redis_url: ...`-vorm die getoond wordt in de [iii-state](https://workers.iii.dev/workers/iii-state)- en [iii-stream](https://workers.iii.dev/workers/iii-stream)-workerdocumentatie, en richt `redis_url` op een Redis die bereikbaar is vanuit de container. `docker-compose.yml` geeft `AGENTMEMORY_REDIS_URL` door aan de engine-container, dus `redis_url: '${AGENTMEMORY_REDIS_URL}'` werkt daar en houdt de URL buiten het gemounte bestand.
De gerenderde config houdt de URL buiten `~/.agentmemory/data/iii-config.runtime.yaml`, maar de eigen configuration-worker van de engine bewaart de *uitgebreide* waarde nog steeds naar `~/.agentmemory/config/iii-state.yaml` en `iii-stream.yaml` zodra deze opstart (de `${VAR}`-expansie van iii-engine gebeurt voordat die worker zijn seed opslaat, en hij slaat de opgeloste waarde op, niet de referentie). Behandel die map alsof hij een credential bevat: `chmod 700 ~/.agentmemory` op elke gedeelde host, en geef de voorkeur aan een Redis-ACL-gebruiker die beperkt is tot wat agentmemory nodig heeft, boven de adminreferenties van de database.
**Migratie gaat niet automatisch.** Het wisselen van `AGENTMEMORY_STATE_BACKEND` begint aan beide kanten met een lege store; niets kopieert bestaande data van file naar Redis of terug. Exporteer vanuit de backend die je verlaat en importeer in degene waar je naartoe gaat. Dit draait identiek onder bash en zsh (inclusief `bash -u`). Een array zoals `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` doet dat niet: zsh houdt de header als één misvormd woord, waar bash hem in twee splitst, waardoor beide verzoeken een 401 krijgen zodra `AGENTMEMORY_SECRET` is ingesteld:
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` accepteert ook `?maxSessions=` en `?offset=` om een groot corpus over meerdere aanroepen te verdelen; `strategy` bij import is `merge` (standaard-veilig), `replace`, of `skip`.
### Wat iii vervangt
| Traditionele stack | agentmemory gebruikt |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + in-memory vector-index |
| SSE / Socket.io | iii Streams (WebSocket) |
| pm2 / systemd | iii engine worker-supervisie |
| Prometheus / Grafana | iii OTEL + health monitor |
| Custom plugin-systemen | `iii worker add ` |
**219 bronbestanden · ~52,000 LOC · 2,500+ tests · 311 functies · 60 KV-scopes**, allemaal op drie primitieven. Geen `agentmemory plugin install`. Het pluginsysteem is iii zelf.
---
### LLM-providers
agentmemory detecteert providers automatisch vanuit je environment. Een provider maakt LLM-ondersteunde operaties beschikbaar, maar het configureren van een provider alleen schakelt LLM-geschreven compressie van observaties niet in. Dat pad vereist zowel een provider als `AGENTMEMORY_AUTO_COMPRESS=true`.
| Provider | Config | Opmerkingen |
|----------|--------|-------|
| **No-op (standaard)** | Geen config nodig | LLM-ondersteund compress/summarize is uitgeschakeld. Synthetic compressie en BM25-recall werken nog steeds. Zie `AGENTMEMORY_ALLOW_AGENT_SDK` hieronder als je vroeger vertrouwde op de Claude-abonnement-fallback. |
| Anthropic API | `ANTHROPIC_API_KEY` | Facturering per token |
| MiniMax | `MINIMAX_API_KEY` | Anthropic-compatibel |
| Gemini | `GEMINI_API_KEY` | Schakelt ook embeddings in |
| OpenRouter | `OPENROUTER_API_KEY` | Elk model |
| OpenAI API | `OPENAI_API_KEY` | Standaard `gpt-5.6-luna`, overschrijf met `OPENAI_MODEL` |
| **Lokaal (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) of `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | Alles wat OpenAI-API-compatibel is. Geen kosten, draait op je eigen hardware. Zie [Local models](#local-models-ollama--lm-studio--vllm) hieronder. |
| Claude-abonnement-fallback | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | Alleen opt-in. Spawnt `@anthropic-ai/claude-agent-sdk`-sessies; dit veroorzaakte vroeger onbegrensde Stop-hook-recursie, dus het is niet langer de standaard. |
### Local models (Ollama / LM Studio / vLLM)
agentmemory praat met elke OpenAI-API-compatibele server, dus alles dat `/v1/chat/completions` blootstelt werkt zonder codewijzigingen. Geen betaalde keys, geen cloud, geen rate limits; draait volledig op je eigen hardware.
**Ollama** (standaardpoort `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio** (standaardpoort `1234`):
Open LM Studio → tabblad Local Server → Start Server. Kies een willekeurig chatmodel uit de kiezer (Qwen 3, gpt-oss, DeepSeek R1, enz.).
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**: zelfde vorm. Richt `OPENAI_BASE_URL` op welke URL je server ook blootstelt en stel `OPENAI_MODEL` in op een naam die je server accepteert.
**Modelkeuzes voor memory-werk**: compressie en samenvatting zijn korte taken (<2K tokens in, <500 tokens uit) waarbij een 7B instruct-model ruim voldoende is. Aanbevelingen:
| Model | Grootte | Waarom |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | Gebalanceerde standaard op een 16 GB-machine; sterk in extractie en tool-vormige tekst |
| `qwen3:4b` | ~2.6 GB | Kleinste zinnige optie; prima voor compressie, zwakker bij graph-extractie |
| `qwen3-coder:30b` | ~19 GB | Beste lokale keuze voor code-vormige sessies (30B MoE, 3.3B actief) op 24-32 GB hardware |
| `gpt-oss:20b` | ~14 GB | Sterk algemeen model dat past binnen 16 GB RAM |
| `deepseek-r1:8b` | ~5.2 GB | Reasoning-distillatie; trager maar schonere extracties |
Qwen 3-modellen denken standaard en kunnen het hele tokenbudget opbranden aan reasoning voordat er output is. Stel `AGENTMEMORY_LLM_NOTHINK=1` in om `/no_think` toe te voegen aan graph-extractie-prompts, en verhoog `MAX_TOKENS` (16384 werkt) als extracties leeg terugkomen.
Reasoning-modellen (`o1`-achtig met ``-blokken) kunnen een lege `content` teruggeven met een `reasoning`-veld dat je lokale server mogelijk niet toont. Als extracties leeg terugkomen, schakel dan eerst over naar een niet-reasoning-model. De env `OPENAI_REASONING_EFFORT=none` kan ook thinking uitschakelen bij Ollama Cloud thinking-modellen die het OpenAI-reasoning-schema spiegelen.
Lokale embeddings worden als optionele dependency meegeleverd, maar zijn niet standaard ingeschakeld. Stel `EMBEDDING_PROVIDER=local` in om in te stappen op `Xenova/all-MiniLM-L6-v2` (384-dim). De eerste embedding-aanvraag downloadt het model; inference gebeurt daarna op het eigen apparaat. Zonder die instelling of een remote embedding-key blijven vectoren uitgeschakeld, gebruikt `mem::search` BM25, en kan `smart-search` nog steeds bestaande graph-matches toevoegen.
### Kostenbewuste modelkeuze
Wanneer LLM-geschreven achtergrondcompressie ingeschakeld is met zowel een provider als `AGENTMEMORY_AUTO_COMPRESS=true`, draait dit op elke observatie, dus modelkeuze verandert de maandelijkse uitgaven merkbaar. Vastgelegde workload-data: 635 requests / 888K tokens / 35 uur actief gebruik, gedraaid tegen drie OpenRouter-modellen op prijzen van 2026-05-23.
| Tier | Model | Input / 1M | Output / 1M | Kosten voor de vastgelegde 35h | Opmerkingen |
|------|-------|------------|-------------|---------------------------|-------|
| Aanbevolen | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07 (geschat) | Nieuwste DeepSeek; goedkoopste aanbevolen keuze voor compressie-workloads. |
| Aanbevolen | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | Solide compressie- + samenvattingskwaliteit tegen ~10× lagere kosten dan Sonnet. |
| Aanbevolen | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | Sterke code-reasoning als je sessies sterk code-vormig zijn. |
| Premium | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02 (geschat) | Zelfde catalogusprijs als de gemeten Sonnet-4.6-run; introductieprijs $2/$10 tot en met 2026-08-31. |
| Premium | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9 (geschat) | Vlaggenschip-tier; duur voor altijd-aan achtergrondwerk. |
| Vermijden | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40 (geschat) | Vlaggenschip-klasse model; overkill voor compressie. |
Gemeten rijen komen uit de vastgelegde run; (geschat)-rijen schalen dezelfde tokenmix met de catalogusprijs van elk model.
agentmemory print een runtime-waarschuwing wanneer `OPENROUTER_MODEL` overeenkomt met een premium-tier-patroon. Stel `AGENTMEMORY_SUPPRESS_COST_WARNING=1` in om dit te onderdrukken zodra je een geïnformeerde keuze hebt gemaakt.
Afweging kwaliteit versus kosten voor memory-werk: compressie is een samenvattingstaak met relatief losse kwaliteitseisen (de agent leest de samenvatting opnieuw, niet de gebruiker). DeepSeek V4 Flash / V4 Pro / Qwen3-Coder liggen bij deze taak binnen de afrondingsmarge van Sonnet, terwijl ze 10-70× minder kosten. Bewaar de premium-tier-modellen voor queries die jij zelf direct leest.
Bronnen: [OpenRouter-prijzen voor Claude Sonnet 5](https://openrouter.ai/anthropic/claude-sonnet-5), [DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731), [DeepSeek-prijsnotities](https://api-docs.deepseek.com/quick_start/pricing/).
### Multi-agent memory (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
In multi-agent-opzetten waarbij meerdere rollen één agentmemory server delen (architect / developer / reviewer / researcher / support-agent), tagt `AGENT_ID` elke write met de rol die deze maakte. `AGENTMEMORY_AGENT_SCOPE` bepaalt of recall op die tag filtert.
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
Twee modi:
| Modus | Tagt writes | Filtert recall | Wanneer te gebruiken |
|------|------------|---------------|-------------|
| `shared` (standaard) | ja | nee | Cross-agent context met audit trail. De architect kan zien wat de developer noteerde, maar elke rij legt vast wie het zei. |
| `isolated` | ja | ja | Strikte scheiding. De architect ziet nooit de observaties / memories / sessies van de developer. |
Wat getagd wordt wanneer `AGENT_ID` is ingesteld: `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId`. De rol stroomt van `api::session::start` → `mem::observe` → `mem::compress` → KV.
Wat gefilterd wordt in isolated-modus: `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions`. Elk endpoint accepteert `?agentId=` om per request te overschrijven, en `?agentId=*` om volledig uit de env-scope te stappen. `/memories` accepteert ook `?includeOrphans=true` om memories van vóór AGENT_ID te tonen waarvan `agentId` undefined is.
Override per aanroep op de SDK-/REST-laag: elk muterend endpoint (`/session/start`, `/remember`) accepteert een `agentId`-veld in de request body dat voorrang heeft op de env. Handig voor runtimes die veel rollen door één serverproces routeren. De MCP-tool `memory_save` biedt hetzelfde `agentId`-veld, de standalone stdio-server geeft zowel `agentId` als `project` door, en opgeslagen memories dragen `agentId` mee de zoekindex in, zodat agent-scoped zoeken zowel memories als observaties dekt.
Wanneer `AGENT_ID` niet is ingesteld, blijft memory unscoped (legacy-gedrag, geen tags, geen filters).
### Poorten
agentmemory + iii-engine binden standaard aan vier poorten. Als een herstart mislukt met `port in use`, vertelt deze tabel je welk proces je moet zoeken.
| Poort | Proces | Doel | Env-override |
|------|---------|---------|--------------|
| `3111` | agentmemory | REST API + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | Interne streams-worker (gebruikt door agentmemory + viewer) | `III_STREAM_PORT` (voorkeur) of legacy `III_STREAMS_PORT` |
| `3113` | agentmemory | Realtime viewer (`http://localhost:3113`) | `III_VIEWER_PORT` of `AGENTMEMORY_VIEWER_URL` voor de gerapporteerde URL |
| `49134` | iii-engine | WebSocket; workers registreren hier, OTel-telemetrie loopt erover | `III_ENGINE_PORT` of `III_ENGINE_URL` |
`--port ` wijzigt het REST-ankerpunt en leidt streams `N+1`, viewer `N+2`, en engine-WebSocket `N+46023` af, maar alleen waar de bijbehorende expliciete poort of URL hierboven niet is ingesteld. Dit creëert geen geïsoleerde lifecycle-namespace. Gebruik `--instance 1` voor een tweede daemon; deze gebruikt ankerpunt 3211, standaard `3211/3212/3213/49234`, en krijgt een eigen `instance-1`-map voor data en lifecycle. Instanties 1 tot en met 50 volgen hetzelfde patroon.
De vastgezette engine start met `--no-update-check` (geen update- of security-advisory-lookups bij GitHub tijdens het opstarten) en met de anonieme gebruikstelemetrie van iii uit: agentmemory stelt `III_TELEMETRY_ENABLED=false` in voor de engine die het spawnt, tenzij je de variabele zelf exporteert, en het gebundelde compose-bestand doet hetzelfde.
Opruimen van verweesde processen wanneer poorten gebonden blijven na een gecrashte run:
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` ruimt zowel de worker als het pidfile van de engine netjes op bij een nette native shutdown. In Docker-modus flusht het de native worker, stopt het precies de gevalideerde engine-container, en behoudt het zowel de container als zijn `/data`-mount voor een lossless herstart; de volgende start valideert en hervat diezelfde container. Docker-gebaseerde uninstall vereist `agentmemory remove --keep-data`: dit verwijdert gedeelde door agentmemory beheerde bestanden met behoud van de gevalideerde container, zijn datamount, en het lifecycle-record dat nodig is om ze te herstellen. Destructieve verwijdering van Docker-data is bewust overgelaten aan de operator, na een backup. De CLI weigert ook om Docker- of VM-poorthouders (Docker-backend, vpnkit, colima) als de native engine te adopteren of te signaleren, tenzij `--force` is doorgegeven. De handmatige opruiming hierboven is alleen voor het geval na een crash waarbij geen van beide pidfiles achterblijft.
### Configuratiebestand
Zet de runtime-configuratie van agentmemory in `~/.agentmemory/.env` in plaats van variabelen in elke shell te exporteren. Als de viewer een setup-hint toont zoals `export ANTHROPIC_API_KEY=...`, kopieer je deze naar dit bestand als `ANTHROPIC_API_KEY=...` zonder het `export`-voorvoegsel, en herstart je dan agentmemory.
Environment-variabelen van het proces werken nog steeds en krijgen voorrang boven waarden in het bestand.
Op Windows leeft hetzelfde bestand op `%USERPROFILE%\.agentmemory\.env`:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
Om te testen met een Claude Code Pro/Max-abonnement in plaats van een API-key, stap je er expliciet in:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
LLM-geschreven compressie van observaties vereist beide regels: toegang tot een LLM-provider (inclusief deze expliciete abonnement-fallback) en `AGENTMEMORY_AUTO_COMPRESS=true`. Een provider alleen laat het standaard synthetic-compressiepad ongewijzigd.
Consolidatie (graph-nodes, lessen, crystals) staat standaard aan zodra een LLM-provider geconfigureerd is. Stap er expliciet uit met `CONSOLIDATION_ENABLED=false` als je LLM-vrije werking wilt. Graph-extractie is een aparte flag:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### Environment-variabelen
Maak `~/.agentmemory/.env` aan:
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---
138 endpoints op poort `3111`. De REST API bindt standaard aan `127.0.0.1`. Beschermde endpoints vereisen `Authorization: Bearer `, en mesh-sync-endpoints vereisen een expliciet ingestelde `AGENTMEMORY_SECRET` op beide peers.
**Authenticatie staat standaard aan.** Wanneer `AGENTMEMORY_SECRET` niet is ingesteld (in de shell of in `~/.agentmemory/.env`), genereert de server bij de eerste start een willekeurig secret en bewaart dit in `~/.agentmemory/secret` met modus `0600`. Elke gebundelde client leest dit vandaar wanneer hij met een lokale server praat: de CLI, de viewer, de hooks onder `plugin/scripts`, de MCP-server en de `@agentmemory/mcp`-shim, de configs geschreven door `agentmemory connect`, en de gebundelde OpenCode-, Pi-, OpenClaw-, Hermes- en filesystem-watcher-integraties. Het opgeslagen secret wordt alleen verstuurd naar loopback-URL's (`localhost`, `127.0.0.0/8`, `::1`). Een expliciete `AGENTMEMORY_SECRET` wint altijd, en remote clients moeten deze nog steeds instellen. Docker en de `deploy/`-entrypoints genereren en exporteren al hun eigen secret. Om de API handmatig aan te roepen:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**Verzoekregels voor writes.** `POST`-, `PUT`-, `PATCH`- en `DELETE`-verzoeken naar de REST API en de viewer moeten `Content-Type: application/json` versturen (een `charset`-parameter is prima) wanneer ze een body dragen, en een `Origin`-header, indien aanwezig, moet een loopback-origin zijn voor de geconfigureerde REST- of viewer-poort, of vermeld staan in `VIEWER_ALLOWED_ORIGINS` (komma-gescheiden, bijv. `https://memory.example.com`). Clients die geen `Origin`-header versturen (CLI, hooks, MCP, curl, server-naar-server) zijn hier niet door geraakt. De viewer accepteert ook zijn eigen origin.
**Bestandspaden.** Endpoints die bestanden lezen of schrijven (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`) accepteren alleen paden onder `~/.agentmemory`, de instance-datamap, of een map vermeld in `AGENTMEMORY_IMPORT_ROOT` (meerdere scheiden met `:`, of `;` op Windows). `/replay/import-jsonl` accepteert ook zijn standaard `~/.claude/projects`. `/obsidian/export` blijft binnen `AGENTMEMORY_EXPORT_ROOT` en `/migrate` binnen `~/.agentmemory`. Symlinks worden opgelost vóór elke check.
**Secret-scrubbing.** API-keys, bearer tokens, PEM-private-key-blokken en credentials die in URL's zitten (`scheme://user:password@host`) worden geredigeerd voordat tekst wordt opgeslagen, op elk schrijfpad: observations, remember, evolve, slots, lessons, actions, sketches, signals, checkpoints, imports, jsonl-replay, mesh-sync, team-shares, compressie- en summary-output, crystals en graph-nodes.
Belangrijkste endpoints
| Methode | Pad | Beschrijving |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | Health-check (altijd publiek) |
| `GET` | `/agentmemory/status` | Wat er mis is en hoe je het oplost (HTML voor browsers, anders JSON) |
| `GET` | `/agentmemory/viewer/snapshot` | Alles wat de viewer toont, in één response |
| `POST` | `/agentmemory/session/start` | Start sessie + haal context op |
| `POST` | `/agentmemory/session/end` | Beëindig sessie |
| `POST` | `/agentmemory/observe` | Leg observatie vast (zie capture-levering hieronder) |
| `GET` | `/agentmemory/capture` | Capture-inbox, dead letters en offline spool |
| `POST` | `/agentmemory/capture/retry` | Probeer dead-letter-captures opnieuw |
| `POST` | `/agentmemory/capture/drain` | Stuur de lokale offline spool nu |
| `POST` | `/agentmemory/smart-search` | Hybride zoeken |
| `POST` | `/agentmemory/context` | Genereer context |
| `POST` | `/agentmemory/remember` | Sla op in langetermijngeheugen |
| `POST` | `/agentmemory/forget` | Verwijder observaties |
| `POST` | `/agentmemory/enrich` | Bestandscontext + memories + bugs |
| `GET` | `/agentmemory/profile` | Projectprofiel |
| `GET` | `/agentmemory/export` | Exporteer alle data |
| `POST` | `/agentmemory/import` | Importeer vanuit JSON |
| `POST` | `/agentmemory/graph/query` | Knowledge-graph-query |
| `POST` | `/agentmemory/graph/compact` | Trim overmatige graph-provenance |
| `POST` | `/agentmemory/team/share` | Deel met team |
| `GET` | `/agentmemory/audit` | Audit trail |
Volledige endpointlijst: [`src/triggers/api.ts`](../src/triggers/api.ts)
**Capture-levering.** Hooks sturen elke observatie één keer naar `POST /agentmemory/observe` met een `eventId`. Dit is de eigen id van de host voor de aanroep wanneer de payload er één heeft (bijvoorbeeld de `tool_use_id` van Claude Code), anders een hash van de sessie, hooktype, toolnaam, input, output en host-timestamp. De server schrijft het event naar een capture-inbox in de state store, slaat de observatie op, en verwijdert dan de inbox-entry. De statuscode zegt wat er gebeurd is:
| Status | `status`-veld | Betekenis |
|---|---|---|
| `201` | `accepted` | Opgeslagen. `observationId` is de nieuwe observatie. |
| `202` | `accepted` (`state: "retrying"`) | Geaccepteerd, maar opslaan mislukte. De server probeert het opnieuw, ook na een herstart. |
| `200` | `duplicate` | Deze `eventId` was al geaccepteerd. `observationId` is de bestaande observatie; er wordt niets nieuws opgeslagen. |
| `400` / `422` | `rejected` | Ongeldige payload, of opslaan mislukte definitief (het event wordt bewaard als dead letter). |
| `503` | `rejected` (`retryable: true`) | De inbox is vol (`AGENTMEMORY_CAPTURE_INBOX_MAX`). Hooks spoolen het event en versturen het later. |
Mislukte events worden elke `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 s) opnieuw geprobeerd met verdubbelende backoff, tot `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5). Events die nog steeds mislukken blijven als dead letters in de inbox staan, worden vermeld op `/agentmemory/status` en de Health-pagina van de viewer, en kunnen opnieuw geprobeerd worden met `POST /agentmemory/capture/retry` (`{"eventId": "..."}` of `{"all": true}`). Geaccepteerde event-id's worden onthouden voor `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 uur, maximaal `AGENTMEMORY_CAPTURE_EVENTS_MAX` id's), zodat een hook die na een timeout of herstart opnieuw afgespeeld wordt, één keer wordt opgeslagen, terwijl twee afzonderlijke tool calls met hun eigen host-id's twee keer worden opgeslagen, ook als hun inhoud identiek is. Wanneer een observatie wordt verwijderd (forget, sessie-delete, eviction, auto-forget of een import die de store vervangt), wordt het event als verwijderd gemarkeerd voordat de observatie verdwijnt, zodat het opnieuw afspelen van dat event binnen hetzelfde venster beantwoord wordt als duplicate en niets opslaat. De state store schrijft elke 2 seconden naar disk, dus een beantwoord event kan nog even alleen in het geheugen staan. Om dat te dekken draagt elk `2xx`-antwoord ook de `bootId` van de server (nieuw bij elke start), `acceptedAt` en `durableAfterMs` (het save-interval plus 1.5 s op de file store, 1.5 s op redis, waar persistentie de instelling van de operator is). Hooks houden het event in de lokale spool totdat dat venster verstreken is en verwijderen het bij een latere aanroep zonder een extra request. Als de `bootId` inmiddels veranderd is, is de server herstart, dus stuurt de hook het event opnieuw met dezelfde `eventId`; een event dat de disk al bereikt had, wordt niet twee keer opgeslagen. De server stuurt zulke events ook zelf bij het opstarten en bij elk retry-interval, zodat een herstart niets verliest, zelfs als er daarna geen hook meer draait. Oudere hooks negeren de extra velden, en nieuwe hooks tegen een oudere server verwerpen het event bij `2xx` zoals voorheen.
Wanneer de server down is, niet op tijd antwoordt, of een 5xx teruggeeft, voegt de hook de observatie toe aan een lokaal spool-bestand, `/capture-spool/-.jsonl` (overschrijf de map met `AGENTMEMORY_CAPTURE_SPOOL_DIR`). Het bestand is privé voor je gebruiker (modus 600), secrets worden op dezelfde manier geredigeerd als de server ze redigeert, het bevat maximaal `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 MiB) en laat entries vallen die ouder zijn dan `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168). Wanneer het vol is, worden nieuwe entries verwijderd en geteld, en rapporteert `/agentmemory/status` dit. De hook sluit nog steeds af met 0 binnen zijn tijdslimiet en voegt geen request toe wanneer de server gezond is. De spool wordt verstuurd bij de volgende start en door de eerste hook die de server weer bereikt, in een achtergrondproces zodat de agent niet wacht. Event-id's maken dit veilig: een observatie die al aankwam vóór een timeout wordt niet twee keer opgeslagen. `npx @agentmemory/agentmemory capture` toont de spool en de server-inbox, `--drain` stuurt de spool nu, en `GET /agentmemory/capture` geeft hetzelfde terug als JSON. Stel `AGENTMEMORY_CAPTURE_SPOOL=false` in om de spool uit te zetten.
**Graph-provenance compacten.** Elke knowledge-graph-node en -edge houdt de id's van de nieuwste 32 observaties bij waar hij vandaan komt. Stores geschreven vóór die cap kunnen duizenden id's per hot node bevatten, wat graph-zoeken en de viewer traag maakt of de worker laat vallen. agentmemory herstelt dit zelf: bij de eerste start na een upgrade trimt het elke node, edge, vervangen edge (de temporele graph-geschiedenis) en de gecachte snapshot tot de cap, op de achtergrond, in kleine stukken met een pauze ertussen, zodat zoeken, capture en de viewer blijven werken. Het bewaart zijn voortgang, hervat na een herstart en draait nooit opnieuw zodra het klaar is. `/agentmemory/status` en de Health-pagina van de viewer tonen het als pending, running (met de huidige scope en positie), done of failed. Stel `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false` in om dit uit te zetten.
Om het handmatig te draaien, roep je `POST /agentmemory/graph/compact` aan. Het loopt door de name- en edge-key-indexen in plaats van elke node en edge op te lijsten, en is veilig om opnieuw te draaien. Wanneer het id's trimt, schrijft het een `graph_compact`-audit-entry.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
Draai het op een grote store, of wanneer de aanroep 504 teruggeeft, in stukken. Stuur `scope` (`nodes`, `edges` of `history`), `offset` en `limit`, en roep het dan opnieuw aan met de teruggegeven `nextOffset` totdat deze `null` is. Doe dit voor `nodes`, `edges` en `history`, en sluit af met één `{"scope":"snapshot"}`-aanroep, omdat een gestukte run de gecachte snapshot niet aanraakt.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---
```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**Vereisten:** Node.js >= 20 met npm/npx; [iii-engine](https://iii.dev/docs) v0.22.1 of Docker. De automatische engine-installatie op macOS/Linux vereist ook `curl`, een POSIX `sh` en `tar`; native Windows gebruikt de handmatig vastgezette `iii.exe`, WSL2, of Docker Desktop.