Twój agent kodujący pamięta wszystko. Koniec z tłumaczeniem wszystkiego od nowa.
Zbudowany na iii engine
Trwała pamięć dla Claude Code, GitHub Copilot CLI, Cursor, Gemini CLI, Codex CLI, Hermes, OpenClaw, pi, OpenCode i każdego klienta MCP.
---
## Install
Wymagania:
- Node.js 20 lub nowszy wraz z npm i npx (`node -v`, `npm -v` i `npx -v`).
- Automatyczna instalacja iii-engine na macOS/Linux wymaga również `curl`, POSIX-owego `sh` oraz `tar`. Minimalne obrazy, takie jak `node:20-slim`, mogą ich nie zawierać.
- Natywny Windows wymaga ręcznej instalacji przypiętej wersji iii-engine v0.22.1, czyli `iii.exe`. Pozostałymi wspieranymi ścieżkami są WSL2 lub Docker Desktop.
Kanoniczna komenda do świeżej instalacji:
```bash
npx -y @agentmemory/agentmemory@latest
```
Pierwsze uruchomienie to interaktywna konfiguracja: wybierasz agentów do podłączenia (Claude Code, Cursor, Codex, Gemini CLI, OpenCode, ...), wybierasz dostawcę LLM albo zostajesz w trybie bez klucza, po czym narzędzie tworzy konfigurację, uruchamia serwer pamięci wraz z przypiętym silnikiem iii i proponuje instalację globalną, dzięki której sama komenda `agentmemory` działa potem wszędzie. `-y` akceptuje monit npx dotyczący pakietu, a `@latest` zapobiega użyciu nieaktualnej wersji z pamięci podręcznej. Dostawca LLM udostępnia funkcje oparte na LLM, ale kompresja obserwacji zapisywana przez LLM uruchamia się tylko wtedy, gdy ustawiono również `AGENTMEMORY_AUTO_COMPRESS=true`.
Tryb bez klucza wyłącza wektorowe embeddingi. `memory_recall` (ścieżka `mem::search`) korzysta z BM25, natomiast `memory_smart_search` może dodatkowo łączyć strukturalne dopasowania z grafu, jeśli dane grafu już istnieją. Aby bezpłatnie włączyć semantyczne przywołanie lokalnie na urządzeniu, ustaw `EMBEDDING_PROVIDER=local` w `~/.agentmemory/.env` i zrestartuj. Pierwsze żądanie embeddingu pobiera `Xenova/all-MiniLM-L6-v2`; po tym początkowym pobraniu modelu wnioskowanie działa już lokalnie.
Lokalne środowisko wykonawcze korzysta z czterech portów: `3111` dla REST/MCP HTTP, `3112` dla strumieni iii, `3113` dla podglądu i `49134` dla WebSocketu workera iii. Trwały stan iii znajduje się w `~/Library/Application Support/agentmemory` na macOS, `$XDG_DATA_HOME/agentmemory` lub `~/.local/share/agentmemory` na Linuksie oraz `%APPDATA%\agentmemory` na Windows. Użyj `--data-dir ` lub `AGENTMEMORY_DATA_DIR`, aby to nadpisać, i używaj tej samej wartości przy każdym restarcie. Dla zgodności ze starszymi wersjami istniejący `./data/state_store.db` lub `./data/iii-config.yaml` ma pierwszeństwo przed domyślną ścieżką platformy dla instancji 0; wyraźnie podana flaga lub zmienna środowiskowa nadal wygrywa.
Następnie udowodnij, że przywołanie działa, i daj swojemu agentowi jego skille:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
Wyszukiwania po słowach kluczowych powinny trafiać w domyślnym trybie bez klucza za pomocą BM25. Zapytanie demo `database performance optimization` jest celowo semantyczne i może zwrócić zero wyników, dopóki nie skonfigurujesz dostawcy embeddingów.
Chcesz, aby całą robotę wykonał agent kodujący? Podaj mu jedną instrukcję:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
Możesz podłączyć więcej agentów w każdej chwili za pomocą `agentmemory connect ` — 20 adapterów wymienionych w sekcji [Works with every agent](#works-with-every-agent). Pełne zestawienie komend znajdziesz w sekcji [Quick Start](#quick-start).
Windows
Najprostszą ścieżką jest WSL2. Natywna konfiguracja silnika na Windows wymaga ręcznego pobrania przypiętego pliku ZIP v0.22.1 i wypakowania `iii.exe`; CLI nie robi tego automatycznie. Wspierany jest również Docker Desktop. Zobacz [sekcję Windows](#windows), aby uzyskać instrukcje krok po kroku.
Instalacja globalna / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
Powyższa komenda npx pozostaje kanoniczną ścieżką świeżej instalacji i pozwala uniknąć problemów z uprawnieniami do globalnego prefiksu.
npx serwuje starą wersję
npx buforuje dane w podziale na wersje. Wymuś najnowszą wersję za pomocą `npx -y @agentmemory/agentmemory@latest` albo wyczyść pamięć podręczną jednorazowo komendą `rm -rf ~/.npm/_npx` (macOS/Linux; na Windows usuń `%LOCALAPPDATA%\npm-cache\_npx`).
Masz już uruchomiony własny silnik iii
agentmemory przypina iii-engine do wersji v0.22.1 i nie podłączy się do innej wersji (worker nie mówi protokołem innego silnika). Zatrzymaj inny silnik, a następnie uruchom `npx -y @agentmemory/agentmemory@latest`. Zainstaluje i uruchomi przypiętą wersję v0.22.1 w `~/.agentmemory/bin`, nie dotykając twojego własnego `iii`.
---
agentmemory współpracuje z każdym agentem, który wspiera hooki, MCP lub REST API. Wszyscy agenci współdzielą ten sam serwer pamięci.
Claude Code plugin natywny + 12 hooków + MCP
Codex CLI plugin natywny + 6 hooków + MCP
GitHub Copilot CLI MCP + hooki/skille pluginu
Cursor plugin natywny + 7 hooków + MCP
OpenCode plugin przechwytujący + MCP
Devin 6 hooków + skille + MCP
OpenClaw plugin natywny + MCP
Hermes plugin natywny + MCP
pi plugin natywny + MCP
OpenHuman natywny backend oparty na trait Memory
Gemini CLI serwer MCP
Antigravity MCP + hooki
Claude Desktop serwer MCP
Warp connect + MCP + skille
Zed serwer MCP
Cline serwer MCP
Continue serwer MCP
Droid serwer MCP
Kiro serwer MCP
Qwen Code serwer MCP
DeepSeek Harness serwer MCP
Roo Code serwer MCP
Kilo Code serwer MCP
Goose serwer MCP
Aider REST API
Współpracuje z każdym agentem mówiącym w MCP lub HTTP. Jeden serwer, wspomnienia współdzielone między wszystkimi.
---
Przy każdej sesji tłumaczysz tę samą architekturę od nowa. Odkrywasz te same błędy po raz kolejny. Uczysz agenta tych samych preferencji po raz kolejny. Wbudowana pamięć (CLAUDE.md, .cursorrules) ma limit 200 linii i szybko się dezaktualizuje. agentmemory to naprawia. Bezgłośnie przechwytuje to, co robi twój agent, kompresuje to do przeszukiwalnej pamięci i wstrzykuje właściwy kontekst, gdy zaczyna się kolejna sesja. Jedna komenda. Działa między różnymi agentami.
**Co się zmienia:** W sesji 1 konfigurujesz autoryzację JWT. W sesji 2 prosisz o rate limiting. Agent już wie, że twoja autoryzacja korzysta z middleware jose w `src/middleware/auth.ts`, że twoje testy obejmują walidację tokenów i że wybrałeś jose zamiast jsonwebtoken ze względu na kompatybilność z Edge — bez ponownych wyjaśnień i bez kopiowania wklejania.
```bash
npx -y @agentmemory/agentmemory@latest
```
Domyślnie agentmemory przechowuje stan iii-engine poza repozytorium, z którego go uruchamiasz: `~/Library/Application Support/agentmemory` na macOS, `$XDG_DATA_HOME/agentmemory` lub `~/.local/share/agentmemory` na Linuksie oraz `%APPDATA%\agentmemory` na Windows. Istniejący, starszy `./data/state_store.db` lub `./data/iii-config.yaml` jest ponownie używany dla instancji 0 przed tą domyślną ścieżką platformy. Aby wskazać lokalizację wyraźnie, podaj `--data-dir ` lub ustaw `AGENTMEMORY_DATA_DIR`; każde z tych wyraźnych ustawień ma pierwszeństwo przed wykrywaniem starszej ścieżki:
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
Uruchomienia natywne i w Dockerze używają tego samego rozwiązanego katalogu hosta; Docker montuje go (bind-mount) pod `/data`. `--instance 1` dodaje `instance-1` do rozwiązanego katalogu i wybiera osobny, domyślny kwartet portów `3211/3212/3213/49234`.
Najnowsze informacje o wydaniach: [CHANGELOG.md](../CHANGELOG.md).
---
### Dokładność wyszukiwania
**coding-agent-life-v1** (korpus własny, odtwarzalny w sandboksie)
| Adapter | P@5 | R@5 | Trafienia w top-5 | opóźnienie p50 |
|---|---|---|---|---|
| **agentmemory hybrid** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| grep baseline | 0.227 | 0.967 | 15 / 15 | 0 ms |
100% trafień w top-5 przy **matematycznym suficie P@5** dla tego korpusu (0.240, zobacz scorecard). Hybrid odzyskuje każdą złotą sesję; grep pomija 1 z 2 złotych sesji w zapytaniu temporalnym obejmującym wiele sesji. Przewaga dotyczy **recall + czasu**, a nie zagregowanej precyzji. Ten benchmark jest mały i ma mało danych złotych; większy LongMemEval-S poniżej różnicuje lepiej. Pełny podział per typ + uwaga o korekcie: [`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md).
**LongMemEval-S** (ICLR 2025, 500 pytań)
| System | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| Fallback tylko BM25 | 86.2% | 94.6% | 71.5% |
Uwaga dotycząca benchmarku: tylko wynik R@5 agentmemory jest naszym własnym zmierzonym wynikiem (LongMemEval-S, odtwarzalny na podstawie benchmark/COMPARISON.md). Wartości mem0 i Letta to ich opublikowane liczby LoCoMo (inny zbiór danych); wartości MemPalace, supermemory, TencentDB (PersonaMem) i oracleagentmemory to deklaracje producentów, których nie odtworzyliśmy niezależnie (uruchomienie oracleagentmemory używało GPT-5.5 względem Oracle AI Database). Zestawione obok siebie tylko orientacyjnie, nie jako test głowa w głowę na identycznych danych. Liczby gwiazdek są przybliżone i zmieniają się w czasie.
**Nowsi uczestnicy** warci uwagi, porównani szerzej w [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md):
| System | ⭐ | Podejście |
|--------|---|-------|
| Zep / Graphiti | 30K | Temporalny graf wiedzy; najsilniejsze opublikowane wyniki zapytań temporalnych (LongMemEval 63.8%), ale graf buduje się asynchronicznie, więc świeże fakty mogą się spóźniać |
| Cognee | 30K | Ingestia dokumentów do grafu wiedzy, tylko Python, zbudowane do strukturalnej ekstrakcji encji, a nie przechwytywania sesji |
Żaden z nich nie przechwytuje automatycznie z hooków agenta kodującego, nie dostarcza podglądu lokalnego jako priorytetu ani nie działa bez klucza — to połączenie, wokół którego zbudowano agentmemory.
---
Kompatybilność: to wydanie celuje w `iii-sdk` 0.22.1 i przypina iii-engine do wersji v0.22.1.
### Wypróbuj w 30 sekund
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` tworzy 3 realistyczne sesje (autoryzacja JWT, naprawa zapytania N+1, rate limiting) i wykonuje na nich wyszukiwania. Instalacje bez klucza wyłączają wektory, więc zapytania słowno-kluczowe `mem::search` powinny trafiać przez BM25, podczas gdy `database performance optimization` może zwrócić zero wyników. `smart-search` może dodatkowo zwracać strukturalne dopasowania z grafu, jeśli dane grafu istnieją. Aby zapytanie semantyczne znalazło naprawę N+1 za pomocą wektorów, ustaw `EMBEDDING_PROVIDER=local`, zrestartuj i pozwól, aby pierwsze pobranie modelu się zakończyło.
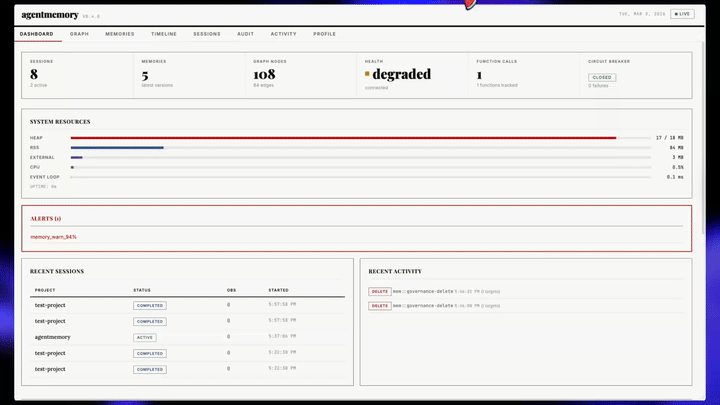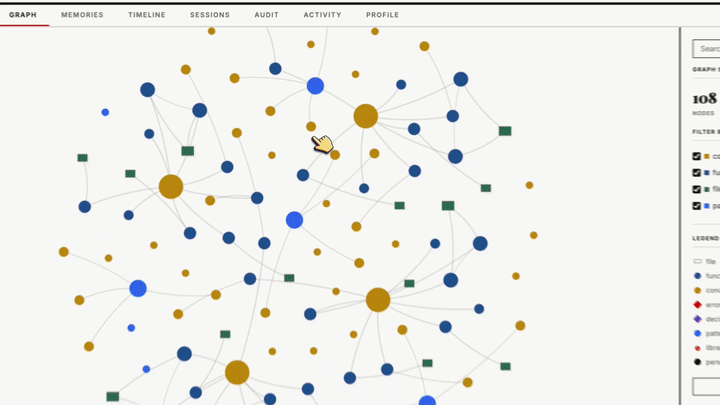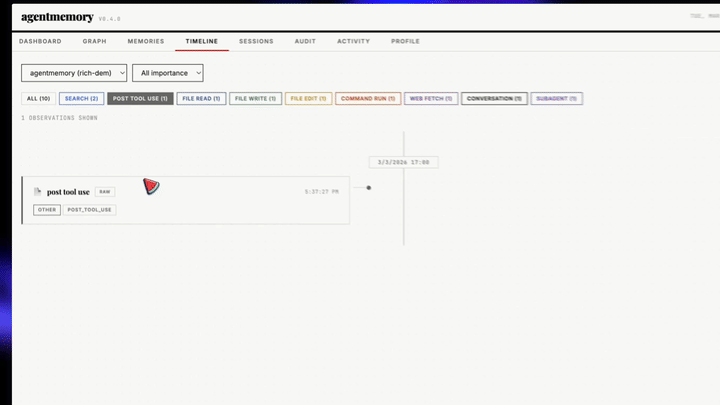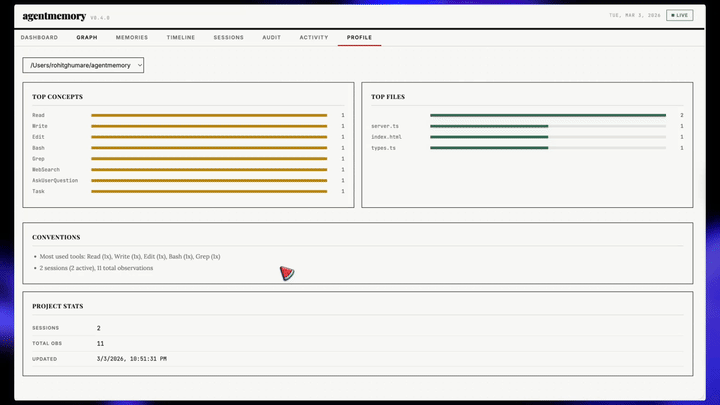
Otwórz `http://localhost:3113`, aby na żywo obserwować budowanie pamięci.
### Zweryfikuj świeżą instalację i trwałość po restarcie
Gdy serwer działa, zweryfikuj REST, stan (health), podgląd oraz status środowiska uruchomieniowego opartego na iii:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
Panel gotowości przy starcie uwzględnia wszystkie cztery porty: REST/MCP HTTP na 3111, strumienie iii na 3112, podgląd na 3113 i WebSocket workera iii na 49134. `status` potwierdza stan agentmemory oraz aktywny tryb dostawcy/embeddingów. Zapisz sondę i potwierdź, że jest wyszukiwalna:
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
Następnie uruchom `npx -y @agentmemory/agentmemory@latest stop`, ponownie uruchom kanoniczną komendę w Terminalu 1, zaczekaj na `/agentmemory/livez` i powtórz wyszukiwanie. Sonda musi wciąż zostać zwrócona. Jeśli wybrałeś własny `--data-dir`, podaj ten sam katalog przy restarcie.
### Codzienne komendy
Instalacja i konfiguracja są opisane w sekcji [Install](#install) powyżej (pierwsze uruchomienie przeprowadzi cię przez ten proces). Na co dzień:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### Replay sesji
Każdą sesję zapisaną przez agentmemory można odtworzyć. Otwórz podgląd, wybierz zakładkę **Replay** i przewijaj osię czasu: prompty, wywołania narzędzi, wyniki narzędzi i odpowiedzi renderują się jako osobne zdarzenia z odtwarzaniem/pauzą, kontrolą prędkości (0.5x do 4x) i skrótami klawiszowymi (spacja do przełączania, strzałki do kroku po kroku).
Aby zaimportować starsze transkrypty JSONL z Claude Code:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
Zaimportowane sesje pojawiają się w selektorze Replay razem z natywnymi. Pod maską każdy wpis przechodzi przez funkcje iii `mem::replay::load`, `mem::replay::sessions` i `mem::replay::import-jsonl`, bez żadnych serwerów pobocznych. Każdy zaimportowany transkrypt jest indeksowany do wyszukiwania, oznaczony kanałem pochodzenia `import` i przetwarzany w poszukiwaniu kryształu sesji oraz lekcji.
> **Uwaga, jeśli `import-jsonl` jest twoją główną ścieżką przechwytywania:** `cleanupPeriodDays` w Claude Code (w `~/.claude/settings.json`, domyślnie **30**) automatycznie usuwa transkrypty JSONL starsze niż to okno z `~/.claude/projects/`. Jeśli instalujesz agentmemory od zera na historii Claude Code mającej kilka miesięcy, wszystko starsze niż 30 dni jest już usunięte przed pierwszym importem. Albo uruchamiaj `import-jsonl` w cronie, albo zwiększ `cleanupPeriodDays`, albo podłącz hooki automatycznego przechwytywania (domyślna ścieżka instalacji pluginu), aby każda tura trafiała do agentmemory, gdy sesja jest jeszcze aktywna, dzięki czemu czyszczenie JSONL przestaje mieć znaczenie.
### Aktualizacja / utrzymanie
Użyj komendy utrzymania, gdy chcesz celowo zaktualizować swoje lokalne środowisko wykonawcze:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
Ostrzeżenie: ta komenda modyfikuje bieżący workspace/środowisko wykonawcze. Może zaktualizować zależności JavaScript i pobrać przypięty obraz Docker `iiidev/iii:0.22.1`. Nigdy nie instaluje nieprzypiętego lub nowszego silnika iii.
Szczegóły implementacji znajdują się w `src/cli.ts` (zobacz `runUpgrade` w okolicach `src/cli.ts:544-595`).
### Claude Code (jeden blok, wklej go)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code bez instalacji pluginu (ścieżka samodzielnego MCP)
Jeśli podłączasz serwer MCP agentmemory bezpośrednio przez `~/.claude.json` zamiast używać `/plugin install`, Claude Code nigdy nie rozwiąże `${CLAUDE_PLUGIN_ROOT}` i musisz wskazać skryptom hooków bezwzględne ścieżki w `~/.claude/settings.json`. Te ścieżki zwykle zawierają w sobie wersję agentmemory (np. `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`), więc kolejna aktualizacja po cichu psuje każdy hook.
Rozwiązanie zastępcze:
```bash
agentmemory connect claude-code --with-hooks
```
To scala te same komendy hooków do `~/.claude/settings.json`, z bezwzględnymi ścieżkami rozwiązanymi do dołączonego katalogu `plugin/` aktualnie zainstalowanego pakietu `@agentmemory/agentmemory`. Uruchom tę komendę ponownie po aktualizacji agentmemory, aby odświeżyć ścieżki. Wpisy użytkownika w tym samym pliku są zachowywane; zastępowane są tylko wcześniejsze wpisy agentmemory. Zalecanym podejściem pozostaje ścieżka `/plugin install`.
Dla zdalnych lub chronionych wdrożeń uruchom Claude Code z ustawionymi `AGENTMEMORY_URL` i `AGENTMEMORY_SECRET`. Plugin przekazuje obie wartości dalej do swojego dołączonego serwera MCP; gdy `AGENTMEMORY_URL` jest puste, shim MCP używa `http://localhost:3111`.
### Codex CLI (platforma pluginów Codex)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
Plugin Codex jest dostarczany z tego samego katalogu `plugin/` co plugin Claude Code. Rejestruje:
- Dołączony mostek stdio MCP do działającego daemona, bez pobierania z npm i bez magazynu fallback. Zobacz [lokalny przewodnik po Codex](../docs/plugins/codex-local.md), aby przetestować niewydany build.
- 6 hooków cyklu życia: `SessionStart`, `UserPromptSubmit`, `PreToolUse`, `PostToolUse`, `PreCompact`, `Stop`
- 9 wywoływalnych skilli: `/recall`, `/remember`, `/session-history`, `/forget`, `/recap`, `/handoff`, `/lesson`, `/commit-context`, `/commit-history`, plus 8 skilli referencyjnych wczytywanych przez agenta na żądanie (dyscyplina pamięci, narzędzia MCP, REST API, konfiguracja, agenci, hooki, architektura oraz przewodnik tworzenia skilli)
Silnik hooków Codex wstrzykuje `CLAUDE_PLUGIN_ROOT` do podprocesów hooków (zgodnie z [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)), dzięki czemu te same skrypty hooków działają w obu hostach bez duplikacji. Zdarzenia Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure są dostępne tylko w Claude Code i nie są rejestrowane dla Codex.
#### Hooki Codex: zaufanie i kompatybilność
Natywne wywoływanie hooków pluginu jest zweryfikowane w Codex CLI 0.150.1. Zaufaj hookom pluginu, zanim oczekujesz przechwytywania. Zachowanie Codex Desktop zależy od dołączonego runtime; sprawdź `/hooks` i potwierdź przechwycone zdarzenie, zanim włączysz rozwiązanie zastępcze.
Jeśli twój host wymaga globalnych hooków, zduplikuj komendy do globalnego `~/.codex/hooks.json`. Gdy MCP jest już podłączone, aktualny adapter `connect` potrzebuje `--force`, aby dotrzeć do instalacji hooków:
```bash
agentmemory connect codex --with-hooks --force
```
To scala globalne hooki i przepisuje wpis MCP agentmemory, zachowując niepowiązane wpisy. Sprawdź własne ustawienia endpointu agentmemory przed użyciem `--force`. Uruchom ponownie po aktualizacji, aby odświeżyć ścieżki skryptów. Włącz albo natywne hooki pluginu, albo globalne kopie, aby uniknąć podwójnego przechwytywania.
### GitHub Copilot CLI
Dla trybu agenta VS Code użyj [przewodnika MCP i auto-przechwytywania Copilot](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions). Konektor CLI nie konfiguruje VS Code.
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` scala `mcpServers.agentmemory` do `~/.copilot/mcp-config.json` (lub `$COPILOT_HOME/mcp-config.json`, gdy ustawiono `COPILOT_HOME`) i zachowuje istniejące serwery. Na natywnym Windows jest to jedyny zautomatyzowany adapter `connect`; każdego innego natywnego agenta Windows skonfiguruj ręcznie. `connect` w WSL jest wspierane tylko wtedy, gdy docelowy agent jest zainstalowany w tym samym środowisku WSL. Copilot podchwytuje serwer MCP przy następnym uruchomieniu lub po `/mcp`. Zainstaluj też plugin, jeśli chcesz pełne doświadczenie hooków/skilli.
OpenClaw (wklej ten prompt)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
Pełny przewodnik: [`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent (wklej ten prompt)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
Pełny przewodnik: [`integrations/hermes/`](../integrations/hermes/)
### Inni agenci
Uruchom serwer pamięci: `npx -y @agentmemory/agentmemory@latest`
#### Natywne skille przez `npx skills add` (50+ agentów)
agentmemory dostarcza 17 skilli w formacie `/SKILL.md` w stylu Claude Code: 9 wywoływalnych skilli akcji (`remember`, `recall`, `recap`, `handoff`, `forget`, `lesson`, `commit-context`, `commit-history`, `session-history`) oraz 8 skilli referencyjnych wczytywanych przez agenta na żądanie (`memory-discipline`, `agentmemory-mcp-tools`, `agentmemory-rest-api`, `agentmemory-config`, `agentmemory-agents`, `agentmemory-hooks`, `agentmemory-architecture`, `write-agentmemory-skill`). Skille referencyjne zawierają tabele danych generowane ze źródła, więc nigdy się nie rozjeżdżają. CLI [`skills`](https://npmjs.com/package/skills) od vercel-labs automatycznie instaluje je w natywnym katalogu skilli wywołującego agenta, obejmując ponad 50 agentów (Claude Code, Cursor, Cline, Continue, Droid, Warp, Codex, Antigravity, Kiro, OpenCode, Goose, Roo, Trae, Windsurf i inne):
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
Jest to **uzupełnienie** dla `agentmemory connect `:
- `agentmemory connect ` zapisuje konfigurację serwera MCP, dzięki czemu narzędzia są dostępne.
- `npx skills add rohitg00/agentmemory` instaluje skille, dzięki czemu agent wie, kiedy je wywołać.
Dla tej niewielkiej liczby agentów, których CLI `skills` jeszcze nie obsługuje (Zed v1.3.x i starsze), umieść 17 plików SKILL.md w natywnym katalogu skilli agenta samodzielnie; ten sam format działa wszędzie.
#### Standardowy blok MCP
Wpis agentmemory to **ten sam blok serwera MCP** we wszystkich hostach, które używają struktury `mcpServers` (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI, OpenClaw):
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**Scal ten wpis z istniejącym obiektem `mcpServers`** w pliku konfiguracyjnym hosta; nie zastępuj całego pliku. Jeśli plik już ma inne serwery, dodaj `agentmemory` obok nich jako kolejny klucz wewnątrz `mcpServers`. Jeśli `mcpServers` całkowicie nie istnieje, wklej ten blok wewnątrz `{ "mcpServers": { ... } }`. Placeholdery `${VAR}` dziedziczą `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` z shella w momencie uruchamiania serwera MCP; nieustawione zmienne przekazują puste ciągi i shim wraca do `http://localhost:3111`. Jeden podłączony wpis obsługuje zarówno wdrożenia lokalne, jak i zdalne (k8s / za reverse-proxy).
| Agent | Plik konfiguracyjny | Uwagi |
|---|---|---|
| **Cursor (tylko MCP)** | `~/.cursor/mcp.json` | Scal z `mcpServers`, albo użyj `agentmemory connect cursor`. Na stronie dostępny jest też deeplink jednym kliknięciem. |
| **Cursor (pełny plugin)** | `.cursor-plugin/` | Wpis w Cursor Marketplace (zgłoszenie w trakcie weryfikacji) albo Cursor Settings → Plugins → lokalny checkout. Rejestruje 7 hooków auto-przechwytywania (sessionStart, beforeSubmitPrompt, preToolUse, postToolUse, postToolUseFailure, stop, sessionEnd) + 17 skilli + serwer MCP, z `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` zarządzanymi w panelu pluginów Cursor. Działa w Cursor IDE oraz w CLI `cursor-agent`; prompty w trybie print CLI są uzupełniane retroaktywnie z transkryptu sesji na jej koniec. |
| **Claude Desktop** | `claude_desktop_config.json` (Application Support) | Scal z `mcpServers`. Zrestartuj Claude Desktop po edycji. |
| **Cline / Roo Code / Kilo Code** | Ustawienia MCP w Cline (Settings UI → MCP Servers → Edit) | Ten sam blok `mcpServers`. |
| **Devin CLI (MCP + hooki)** | `~/.config/devin/config.json` | `agentmemory connect devin` scala wpis MCP; `--with-hooks` dodaje sześć natywnych hooków auto-przechwytywania (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop, SessionEnd) z pisanymi małymi literami matcherami narzędzi Devin. Zweryfikuj za pomocą `devin mcp list` oraz `/hooks` wewnątrz devin. |
| **Devin CLI (pełny plugin)** | `plugin/.devin-plugin/` | `devin plugins install ./plugin` z checkoutu rejestruje wszystkie 17 skilli jako komendy ukośnikowe `/agentmemory:` oraz serwer MCP. Hooki pluginu Devin nie mogą wywołać `SessionStart`/`SessionEnd`, więc połącz to z `connect devin --with-hooks`, aby uzyskać pełne przechwytywanie sesji. |
| **Devin (cloud)** | Settings → Connections → MCP servers | Dodaj niestandardowy MCP (STDIO): komenda `npx`, argumenty `-y @agentmemory/mcp@latest`, zmienna środowiskowa `AGENTMEMORY_URL` wskazująca na wdrożenie agentmemory dostępne w sieci, plus `AGENTMEMORY_SECRET` (sesje w chmurze nie mają dostępu do localhost — zobacz [`deploy/`](../deploy/)). Zapisz sekret w Devin Secrets, a następnie użyj „Test listing tools”, aby zweryfikować, że pojawia się wszystkich 54 narzędzi. |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user` (scala automatycznie). |
| **GitHub Copilot CLI (tylko MCP)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` scala `mcpServers.agentmemory`; Copilot podchwytuje to przy następnym uruchomieniu lub po `/mcp`. |
| **GitHub Copilot CLI (pełny plugin)** | Instalacja pluginu Copilot | `copilot plugin install rohitg00/agentmemory:plugin`, aby zainstalować plugin z podkatalogu GitHub. |
| **OpenClaw** | Konfiguracja MCP OpenClaw | Ten sam blok `mcpServers`. Głębsza integracja: `openclaw plugins install ./integrations/openclaw` zajmuje slot pamięci OpenClaw (automatycznie przełącza z `memory-core`); ustaw `plugins.entries.agentmemory.hooks.allowConversationAccess=true`, inaczej przechwytywanie tury jest po cichu blokowane. Zobacz [`integrations/openclaw`](../integrations/openclaw/). |
| **Codex CLI (tylko MCP)** | `.codex/config.toml` | Struktura TOML: `codex mcp add agentmemory -- npx -y @agentmemory/mcp`, albo dodaj `[mcp_servers.agentmemory]` ręcznie. |
| **Codex CLI (pełny plugin)** | Marketplace pluginów Codex | `codex plugin marketplace add rohitg00/agentmemory`, a następnie `codex plugin add agentmemory@agentmemory`. Rejestruje MCP + 6 hooków cyklu życia + 17 skilli. Zaufaj hookom i zweryfikuj przechwytywanie w swoim hoście; zobacz [Konfiguracja i walidacja Codex](../docs/plugins/codex-local.md). |
| **OpenCode (tylko MCP)** | `opencode.json` | Inna struktura: klucz `mcp` na najwyższym poziomie, komenda jako tablica: `{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`. |
| **OpenCode (pełny plugin)** | `plugin/opencode/` | 22 hooki auto-przechwytywania obejmujące cykl życia sesji, wiadomości, narzędzia i błędy. Przypisanie do projektu jest per sesja, więc jeden proces OpenCode obejmujący kilka repozytoriów zapisuje każdą sesję pod jej własnym projektem. Dwie komendy ukośnikowe (`/recall`, `/remember`). Skopiuj `plugin/opencode/` do swojego workspace OpenCode i dodaj wpis pluginu do `opencode.json`. Zobacz [`plugin/opencode/README.md`](../plugin/opencode/README.md), aby zobaczyć pełną tabelę hooków i analizę braków. |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` instaluje dołączone rozszerzenie w katalogu auto-wykrywania pi (przywołanie przy starcie agenta, przechwytywanie przy jego zakończeniu, narzędzia `memory_search` / `memory_save` / `memory_health`, `/agentmemory-status`). `/reload` w działającym pi podchwytuje to rozszerzenie. [`integrations/pi`](../integrations/pi/) jest też pakietem pi (`pi install ./integrations/pi` z checkoutu). |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` + `memory.provider: agentmemory` daje dostawcę pamięci z 6 hookami (prefetch, przechwytywanie tury, koniec sesji, pre-compress, odzwierciedlanie MEMORY.md, blok system prompt). Zweryfikuj za pomocą `hermes plugins doctor` i `hermes memory status`. Zobacz [`integrations/hermes`](../integrations/hermes/). |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` zapisuje standardowy blok `mcpServers`. Payload hooków jest kompatybilny co do pól z Claude Code, więc istniejące skrypty 12 hooków działają bez modyfikacji; podłącz je przez sekcję `hooks` w tym samym `settings.json`. |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` instaluje MCP i hooki przechwytywania we współdzielonym katalogu personalizacji. Zobacz [Konfiguracja i ograniczenia Antigravity](../docs/plugins/antigravity.md). |
| **Antigravity CLI** (`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` używa tej samej konfiguracji MCP i hooków, jak aktualne wersje IDE. Istniejące instalacje powinny odświeżyć się za pomocą `--force`; zobacz [uwagi dotyczące aktualizacji](../docs/plugins/antigravity.md). |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` zapisuje konfigurację na poziomie użytkownika. Nadpisania na poziomie workspace idą do `.kiro/settings/mcp.json` obok twojego kodu. |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` zapisuje standardowy blok `mcpServers`. Warp automatycznie wykrywa też skille z `.claude/skills/`; gdy zainstalowany jest plugin Claude Code, 8 skilli agentmemory (`remember`, `recall`, `recap`, `handoff`, `forget`, `commit-context`, `commit-history`, `session-history`) pojawia się natywnie w palecie komend ukośnikowych Warp. |
| **Cline (CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` zapisuje standardowy blok `mcpServers`. Użytkownicy rozszerzenia VS Code: wklej ten sam blok przez Cline Settings → MCP Servers → Edit JSON. |
| **Continue.dev** | `~/.continue/config.yaml` (preferowane) lub `config.json` (starsze) | `agentmemory connect continue` tworzy `config.yaml` od zera, gdy żaden z plików nie istnieje, albo modyfikuje istniejący `config.json`. **Jeśli masz już `config.yaml`**, adapter wypisuje dokładny blok do wklejenia pod `mcpServers:`; nie nadpisuje po cichu twojego yaml, bo bezpieczne zachowanie komentarzy i kotwic (anchors) wymaga parsera YAML, którego pakiet nie dostarcza. Continue używa formy tablicowej (nie obiektu) dla `mcpServers`. |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` zapisuje pod `context_servers` (klucz Zed, a NIE `mcpServers`). Zdalne serwery MCP można podłączyć zamiast tego przez `{"url": "..."}`. |
| **Droid (Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` zapisuje standardowy blok `mcpServers`. Nadpisania w zakresie projektu idą do `/.factory/mcp.json`. Podaj `--with-hooks`, aby uzyskać natywne auto-przechwytywanie. |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` dopisuje wiersz `@deepseek-ai/dsh-mcp-client` do warstwy patchy na poziomie home, którą wczytuje każdy profil Harness; narzędzia rejestrują się jako `mcp__agentmemory__*`. Podaj `--with-hooks`, aby dodatkowo podłączyć auto-przechwytywanie: dołączone skrypty hooków Claude Code działają przez pierwszorzędny mostek Harness `@deepseek-ai/dsh-hooks-claude-code` (SessionStart, UserPromptSubmit, PreToolUse, PostToolUse, Stop) za pomocą manifestu zapisanego w `$DSH_HOME/agentmemory.hooks.json`. Domyślnie `~/.dsh`, gdy `DSH_HOME` nie jest ustawione. |
| **Goose** | Interfejs ustawień MCP w Goose | Ten sam blok `mcpServers`; użyj `goose configure` → Add Extension → MCP. Bezpośrednia edycja YAML w `~/.config/goose/config.yaml` jest wspierana, ale schemat używa `extensions:` + `cmd` (nie `mcpServers:` + `command`). |
| **Aider** | n/d | Rozmawiaj bezpośrednio z REST API: `curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`. |
| **Każdy agent (32+)** | n/d | `npx skillkit install agentmemory` automatycznie wykrywa hosta i scala. |
**Klienci MCP w sandboksie** (Flatpak / Snap / restrykcyjne kontenery), które nie mają dostępu do `localhost` hosta: ustaw dodatkowo `"AGENTMEMORY_FORCE_PROXY": "1"` w bloku `env` i wskaż `AGENTMEMORY_URL` na trasę, do której sandbox faktycznie ma dostęp (np. twój adres IP w sieci LAN).
### Dostęp programistyczny (Python / Rust / Node)
agentmemory rejestruje swoje główne operacje jako funkcje iii (`mem::remember`, `mem::observe`, `mem::context`, `mem::smart-search`, `mem::forget`). Każdy język z SDK iii może wywołać je bezpośrednio przez `ws://localhost:49134`, bez potrzeby osobnego klienta REST dla każdego języka.
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
Przykład praktyczny: [`examples/python/`](../examples/python/) (szybki start + przepływ obserwacji/przywołania). REST na `:3111` pozostaje dostępny dla hostów bez środowiska uruchomieniowego iii.
### Ze źródeł
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
To uruchamia agentmemory z lokalnym `iii-engine`, jeśli przypięty plik binarny jest już zainstalowany, albo używa Docker Compose, gdy zostanie wybrane. REST, strumienie i podgląd domyślnie wiążą się z `127.0.0.1`. Automatyczna ścieżka binarna na macOS/Linux wymaga `curl`, POSIX-owego `sh` i `tar`.
Zainstaluj `iii-engine` ręcznie. **agentmemory obecnie przypina `iii-engine` do wersji `v0.22.1`**, tego samego wydania co jego zależność `iii-sdk`; worker mówi protokołem przewodowym tego silnika, a 0.20.0 zreorganizowało powierzchnię SDK, więc te dwa elementy przesuwają się razem w wydaniach agentmemory. Nadpisz to za pomocą `AGENTMEMORY_III_VERSION=`, jeśli uruchamiasz własny silnik i wiesz, że jest zgodny.
- **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64:** zamień `aarch64-apple-darwin` na `x86_64-apple-darwin`
- **Linux x64:** zamień na `x86_64-unknown-linux-gnu`
- **Linux arm64:** zamień na `aarch64-unknown-linux-gnu`
- **Windows:** pobierz `iii-x86_64-pc-windows-msvc.zip` z [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) i wypakuj `iii.exe` do `%USERPROFILE%\.agentmemory\bin\iii.exe`
Każde archiwum ma odpowiadający mu plik `.sha256` na stronie wydania; gdy zmieniasz platformę, użyj hasha z tego pliku w powyższej weryfikacji (na Windows: `Get-FileHash`). Automatyczny instalator w `npx @agentmemory/agentmemory` przypina te hashe i odrzuca archiwum, które się nie zgadza.
Albo użyj Dockera (dołączony `docker-compose.yml` pobiera `iiidev/iii:0.22.1`). Pełna dokumentacja: [iii.dev/docs](https://iii.dev/docs).
### Windows
agentmemory działa na Windows 10/11, ale sam pakiet Node.js nie wystarczy; potrzebujesz również przypiętego środowiska uruchomieniowego iii-engine v0.22.1 jako procesu w tle. CLI nie wypakowuje automatycznie pliku ZIP dla Windows, więc użytkownicy natywnego Windows muszą zainstalować `iii.exe` ręcznie, użyć WSL2 albo wybrać Docker Desktop.
Zautomatyzowane podłączanie MCP na natywnym Windows wspiera tylko `agentmemory connect copilot-cli`. Dla Claude Code, Codex, Cursor i każdego innego natywnego agenta Windows skopiuj ręczny blok MCP z sekcji [Other agents](#other-agents) do konfiguracji Windows tego agenta. Uruchamianie `connect` w WSL ma sens tylko wtedy, gdy docelowy agent jest również zainstalowany w tym samym środowisku WSL; nie edytuje ono konfiguracji agenta hostowanego na Windows.
**Opcja A: gotowy plik binarny dla Windows (zalecane)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**Opcja B: Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**Opcja C: tylko samodzielny MCP (bez silnika).** Jeśli potrzebujesz tylko narzędzi MCP dla swojego agenta i nie potrzebujesz REST API, podglądu ani zadań cron, pomiń silnik całkowicie:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**Diagnostyka dla Windows:** jeśli `npx -y @agentmemory/agentmemory@latest` zawiedzie, uruchom ją ponownie z `--verbose`, aby zobaczyć rzeczywisty stderr silnika. Typowe przypadki błędów:
| Symptom | Rozwiązanie |
|---|---|
| `The engine process started but the REST API never responded.` | Sprawdź, czy wszystkie cztery wyznaczone porty są wolne, zweryfikuj, że przypięty `iii.exe` nadal działa, a następnie uruchom ponownie z `--verbose` i przeanalizuj przechwycony stderr silnika |
| `Could not start iii-engine` | Nie zainstalowano ani `iii.exe`, ani Dockera. Zobacz opcję A lub B powyżej |
| Konflikt portów | `netstat -ano \| findstr :3111`, aby zobaczyć, co zajmuje port, a następnie zakończ ten proces albo użyj `--port ` |
| Fallback do Dockera jest pomijany, mimo że Docker jest zainstalowany | Sprawdź, czy Docker Desktop faktycznie działa (ikona w zasobniku systemowym) |
> Uwaga: iii **engine** to gotowy plik binarny, a nie crate cargo, więc nie próbuj go instalować przez `cargo install`. (**SDK** iii są opublikowane na crates.io, npm i PyPI, ale agentmemory ich nie potrzebuje.) Wszystkie wspierane metody instalacji silnika są przypięte do v0.22.1: gotowy plik binarny powyżej, automatyczna ścieżka instalacji agentmemory na macOS/Linux (wymaga `curl`, POSIX `sh` i `tar`) oraz obraz Dockera `iiidev/iii:0.22.1`. Goły upstreamowy `install.sh | sh` instaluje najnowszy silnik, którego agentmemory nie wspiera. Użyj `npx -y @agentmemory/agentmemory@latest`; na macOS/Linux pobiera on przypięty silnik do `~/.agentmemory/bin`.
---
Wdrożenie
Szablony jednoklikowe dla zarządzanych hostingów. Każdy z nich dostarcza samodzielny
Dockerfile, który pobiera `@agentmemory/agentmemory` z npm i kopiuje
plik binarny silnika iii z oficjalnego obrazu Docker Hub `iiidev/iii`;
nie jest wymagany gotowy obraz agentmemory. Trwałe przechowywanie
montowane jest pod `/data`; punkt wejścia przy pierwszym starcie nadpisuje
dołączoną do npm konfigurację iii (która wiąże się z `127.0.0.1`) konfiguracją
dostosowaną do wdrożenia, która wiąże się z `0.0.0.0` i używa bezwzględnych
ścieżek `/data`, generuje sekret HMAC, a następnie zrzuca uprawnienia
z `root` do `node` za pomocą `gosu`, zanim wykona (exec) CLI agentmemory.
Przycisk jednoklikowego wdrożenia Render wymaga `render.yaml` w katalogu głównym repozytorium, który celowo zostawiamy czysty. Użyj przepływu Render Blueprint opisanego w [`deploy/render/`](.././deploy/render/README.md), aby ręcznie wskazać blueprint znajdujący się w repozytorium.
Pełne szczegóły konfiguracji (przechwytywanie HMAC, tunel SSH do podglądu, rotacja, backup,
minimalne koszty) znajdują się w [`deploy/`](.././deploy/README.md):
- [`deploy/fly`](.././deploy/fly/README.md): pojedyncza maszyna z
`auto_stop_machines = "stop"`; najtańsza opcja w stanie bezczynności.
- [`deploy/railway`](.././deploy/railway/README.md): stała opłata w planie Hobby,
wolumin w panelu.
- [`deploy/render`](.././deploy/render/README.md): przepływ Blueprint,
automatyczne migawki dysku w planach płatnych.
- [`deploy/coolify`](.././deploy/coolify/README.md): hostowane samodzielnie na
własnym VPS za pomocą [Coolify](https://coolify.io/self-hosted); ten sam
stos Docker Compose, host i dane należą do ciebie.
Publikowany jest tylko port `3111`. Podgląd na `3113` pozostaje związany z
loopbackiem wewnątrz kontenera; README każdego szablonu opisuje wzorzec
tunelu SSH, aby się do niego dostać.
---
Każdy agent kodujący zapomina wszystko, gdy sesja się kończy, a każda nowa sesja zaczyna się od tego, że ponownie wyjaśniasz swój stack. agentmemory działa w tle i usuwa ten krok.
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### agentmemory kontra wbudowana pamięć agenta
Każdy kodujący agent AI ma wbudowaną pamięć: Claude Code ma `MEMORY.md`, Cursor ma notepady, Cline ma memory bank. Działają jak karteczki samoprzylepne. agentmemory to przeszukiwalna baza danych stojąca za tymi karteczkami.
| | Wbudowana (CLAUDE.md) | agentmemory |
|---|---|---|
| Skala | limit 200 linii | Bez limitu |
| Wyszukiwanie | Wczytuje wszystko do kontekstu | BM25 + wektor + graf (tylko top-K) |
| Koszt tokenów | 22K+ przy 240 obserwacjach | ~1,900 tokenów (92% mniej) |
| Między agentami | Pliki per agent | MCP + REST (każdy agent) |
| Koordynacja | Brak | Leasy, sygnały, akcje, rutyny |
| Obserwowalność | Ręczne czytanie plików | Podgląd w czasie rzeczywistym na :3113 |
---
### Potok pamięci
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### 4-poziomowa konsolidacja pamięci
Wzorowane na tym, jak ludzki mózg przetwarza pamięć, włącznie z konsolidacją podczas snu.
| Poziom | Co | Analogia |
|------|------|---------|
| **Working (robocza)** | Surowe obserwacje z użycia narzędzi | Pamięć krótkotrwała |
| **Episodic (epizodyczna)** | Skompresowane podsumowania sesji | „Co się wydarzyło” |
| **Semantic (semantyczna)** | Wyodrębnione fakty i wzorce | „Co wiem” |
| **Procedural (proceduralna)** | Przepływy pracy i wzorce decyzyjne | „Jak to zrobić” |
Wspomnienia zanikają z czasem (krzywa Ebbinghausa). Często używane wspomnienia wzmacniają się. Nieaktualne wspomnienia są automatycznie usuwane. Sprzeczności są wykrywane i rozwiązywane.
### Co jest przechwytywane
| Hook | Przechwytuje |
|------|----------|
| `SessionStart` | Ścieżkę projektu, ID sesji |
| `UserPromptSubmit` | Prompty użytkownika (filtrowane pod kątem prywatności) |
| `PreToolUse` | Wzorce dostępu do plików + wzbogacony kontekst |
| `PostToolUse` | Nazwę narzędzia, wejście, wyjście |
| `PostToolUseFailure` | Kontekst błędu |
| `PreCompact` | Ponownie wstrzykuje pamięć przed kompaktowaniem |
| `SubagentStart/Stop` | Cykl życia subagenta |
| `Stop` | Podsumowanie końca sesji |
| `SessionEnd` | Znacznik zakończenia sesji |
### Kluczowe możliwości
| Możliwość | Opis |
|---|---|
| **Automatyczne przechwytywanie** | Każde użycie narzędzia zapisywane przez hooki, bez pracy ręcznej |
| **Wyszukiwanie semantyczne** | BM25 + wektor + graf wiedzy z fuzją RRF |
| **Ewolucja pamięci** | Wersjonowanie, zastępowanie (supersession), grafy relacji |
| **Higiena przywołania** | Zastąpione wersje pamięci opuszczają indeksy wyszukiwania; łańcuch wersji w KV zachowuje pełną historię |
| **Wskazówki o bliskich duplikatach** | Zapisy zgłaszają poglądowe dopasowanie `similarTo`, gdy nowa treść jest bliska istniejącemu wspomnieniu |
| **Zakresowanie per agent** | `agentId` przechodzi przez zapis i przywołanie w REST, MCP i indeksie wyszukiwania, w trybie shared lub isolated |
| **Pochodzenie w momencie zapisu** | Każda obserwacja i każde wspomnienie niesie niezmienny kanał pochodzenia (user, agent, tool, import lub shared), oznaczony przy przechwyceniu, zapisie i imporcie |
| **Auto-zapominanie** | Wygasanie TTL, wykrywanie sprzeczności, usuwanie na podstawie ważności |
| **Prywatność na pierwszym miejscu** | Klucze API, sekrety, tagi `` są usuwane przed zapisem |
| **Samonaprawa** | Circuit breaker, łańcuch fallback dostawców, monitorowanie stanu |
| **Mostek Claude** | Dwustronna synchronizacja z MEMORY.md |
| **Graf wiedzy** | Ekstrakcja encji + przeszukiwanie BFS |
| **Pamięć zespołowa** | Współdzielona i prywatna, podzielona na przestrzenie nazw między członkami zespołu |
| **Pochodzenie cytowań** | Śledzenie każdego wspomnienia z powrotem do źródłowych obserwacji |
| **Migawki Git** | Wersjonowanie, rollback i diff stanu pamięci |
---
Wyszukiwanie w trzech strumieniach, łączące trzy sygnały:
| Strumień | Co robi | Kiedy |
|---|---|---|
| **BM25** | Dopasowywanie słów kluczowych ze stemmingiem i rozszerzaniem synonimów | Zawsze włączone |
| **Wektor** | Podobieństwo kosinusowe na gęstych embeddingach | Gdy skonfigurowano dostawcę embeddingów |
| **Graf** | Przeszukiwanie grafu wiedzy przez dopasowywanie encji | Gdy w zapytaniu wykryto encje |
Łączone za pomocą Reciprocal Rank Fusion (RRF, k=60) i zróżnicowane pod względem sesji (maks. 3 wyniki na sesję).
Gdy indeks wektorowy jest wypełniony, `mem::search` (stojące za `memory_recall`) używa hybrydowego rankera BM25 + wektor. Bez embeddingów używa BM25. `smart-search` może dodatkowo łączyć strukturalne dopasowania z grafu, gdy dane grafu istnieją, również w trybie bez klucza. Przywołanie lekcji działa na dedykowanym indeksie BM25 w pamięci, zamiast skanować cały korpus przy każdym zapytaniu. Zastąpione wersje pamięci są wykluczone z każdej ścieżki przywołania; łańcuch wersji zachowuje ich historię.
Wektory przetrwają awarię lub wymuszone zabicie procesu. Indeks wektorowy jest zapisywany w paczkach (buckets) nie częściej niż co `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS` (10 minut). Każdy wektor dodany lub usunięty w międzyczasie jest też natychmiast zapisywany do małego dziennika oczekujących w magazynie stanu, a przy kolejnym starcie jest odtwarzany bez wywoływania dostawcy embeddingów. Każdy udany zapis opróżnia ten dziennik. Dokumenty, które po odtworzeniu wciąż nie mają wektora, są ponownie embeddowane w tle w paczkach po `AGENTMEMORY_VECTOR_BACKFILL_MAX` (500), aż żaden nie zostanie, a zatrzymane uzupełnianie kontynuuje się przy następnym starcie. `/agentmemory/status` i podgląd pokazują rozmiar dziennika oczekujących i stan uzupełniania. Instalacje bez klucza nic nie zapisują.
BM25 od razu tokenizuje grekę, cyrylicę, hebrajski, arabski i akcentowaną łacinę. Dla wspomnień w chińskim / japońskim / koreańskim zainstaluj opcjonalne segmentery (`npm install @node-rs/jieba tiny-segmenter`), aby dzielić ciągi CJK na tokeny na poziomie słów; bez nich agentmemory łagodnie przechodzi na tokenizację całych ciągów i jednorazowo wypisuje wskazówkę na stderr.
### Dostawcy embeddingów
Instalacje bez klucza wyłączają wektorowe embeddingi: `mem::search` używa BM25, natomiast `smart-search` może też użyć istniejących strukturalnych danych grafu. Aby włączyć bezpłatne, lokalne (on-device) embeddingi semantyczne, dodaj to do `~/.agentmemory/.env` i zrestartuj agentmemory:
```env
EMBEDDING_PROVIDER=local
```
Zwykła instalacja npm zawiera opcjonalne środowisko uruchomieniowe `@huggingface/transformers`. Pierwsze żądanie embeddingu pobiera `Xenova/all-MiniLM-L6-v2`, więc potrzebuje dostępu do sieci i może potrwać dłużej; kolejne wnioskowanie działa lokalnie. Zdalni dostawcy są automatycznie wykrywani na podstawie ich kluczy, o ile `EMBEDDING_PROVIDER` nie nadpisuje tego wyboru.
| Dostawca | Model | Koszt | Uwagi |
|---|---|---|---|
| **Lokalny (zalecany opt-in)** | `all-MiniLM-L6-v2` | Bezpłatny | Lokalnie po pierwszym pobraniu modelu, +8pp recall względem samego BM25 |
| Gemini | `gemini-embedding-001` | Darmowy poziom | 100+ języków, wymiary 768/1536/3072 (MRL), wejście do 2048 tokenów. Zastępuje `text-embedding-004` ([przestarzały, wyłączenie 14 stycznia 2026](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | $0.02/1M | Najwyższa jakość |
| Voyage AI | `voyage-code-3` | Płatny | Zoptymalizowany pod kod |
| Cohere | `embed-english-v3.0` | Darmowy okres próbny | Ogólnego przeznaczenia |
| OpenRouter | Każdy model | Zależnie | Proxy dla wielu modeli |
---
54 narzędzia, 6 zasobów, 3 prompty i 17 skilli.
> **Shim MCP a pełny serwer:** opublikowany pakiet `@agentmemory/mcp` to cienki shim. Udostępnia pełną powierzchnię 54 narzędzi **tylko wtedy, gdy może dotrzeć do działającego serwera agentmemory** przez `AGENTMEMORY_URL` (tryb proxy). Gdy żaden serwer nie jest dostępny, shim wraca do lokalnego zestawu 7 narzędzi (`memory_save`, `memory_recall`, `memory_smart_search`, `memory_sessions`, `memory_export`, `memory_audit`, `memory_governance_delete`). Zmienna środowiskowa `AGENTMEMORY_TOOLS=core|all` jest flagą *po stronie serwera*; ustawienie jej w bloku `env` shimu nie ma żadnego efektu. Jeśli widzisz tylko 7 narzędzi w Cursor / OpenCode / Gemini CLI, uruchom `npx -y @agentmemory/agentmemory@latest` (albo stos Docker) i ustaw `AGENTMEMORY_URL=http://localhost:3111`.
### 54 narzędzia
Trzy powierzchnie narzędzi, od najmniejszej do największej: `AGENTMEMORY_TOOLS=core` ogranicza widoczność do 8 niezbędnych narzędzi (`memory_save`, `memory_recall`, `memory_consolidate`, `memory_smart_search`, `memory_sessions`, `memory_diagnose`, `memory_lesson_save`, `memory_reflect`); poniższy podstawowy zestaw to 14 podstawowych narzędzi z rejestru; wartość domyślna (`AGENTMEMORY_TOOLS=all`) udostępnia wszystkie 54.
Narzędzia podstawowe (14)
| Narzędzie | Opis |
|------|-------------|
| `memory_recall` | Wyszukuje wcześniejsze obserwacje |
| `memory_compress_file` | Kompresuje pliki markdown, zachowując strukturę |
| `memory_save` | Zapisuje wgląd, decyzję lub wzorzec |
| `memory_file_history` | Wcześniejsze obserwacje dotyczące konkretnych plików |
| `memory_patterns` | Wykrywa powtarzające się wzorce |
| `memory_sessions` | Listuje ostatnie sesje |
| `memory_smart_search` | Hybrydowe wyszukiwanie semantyczne + słowno-kluczowe |
| `memory_vision_search` | Wyszukuje obserwacje obrazów |
| `memory_timeline` | Chronologiczne obserwacje |
| `memory_profile` | Profil projektu (koncepcje, pliki, wzorce) |
| `memory_export` | Eksportuje wszystkie dane pamięci |
| `memory_relations` | Odpytuje graf relacji |
| `memory_commit_lookup` | Sesje stojące za commitem git |
| `memory_commits` | Commity zapisane dla sesji |
Narzędzia rozszerzone (54 łącznie, domyślna powierzchnia)
| Narzędzie | Opis |
|------|-------------|
| `memory_patterns` | Wykrywa powtarzające się wzorce |
| `memory_timeline` | Chronologiczne obserwacje |
| `memory_relations` | Odpytuje graf relacji |
| `memory_graph_query` | Przeszukiwanie grafu wiedzy |
| `memory_consolidate` | Uruchamia 4-poziomową konsolidację |
| `memory_claude_bridge_sync` | Synchronizuje z MEMORY.md |
| `memory_team_share` | Udostępnia członkom zespołu |
| `memory_team_feed` | Ostatnio udostępnione elementy |
| `memory_audit` | Ścieżka audytu operacji |
| `memory_governance_delete` | Usuwa ze ścieżką audytu |
| `memory_snapshot_create` | Migawka wersjonowana w Git |
| `memory_action_create` | Tworzy zadania z zależnościami |
| `memory_action_update` | Aktualizuje status akcji |
| `memory_frontier` | Odblokowane akcje uszeregowane według priorytetu |
| `memory_next` | Jedna najważniejsza następna akcja |
| `memory_lease` | Wyłączne leasy akcji (wiele agentów) |
| `memory_routine_run` | Tworzy instancje rutyn przepływu pracy |
| `memory_signal_send` | Komunikacja między agentami |
| `memory_signal_read` | Odczytuje wiadomości z potwierdzeniami odbioru |
| `memory_checkpoint` | Bramki warunków zewnętrznych |
| `memory_mesh_sync` | Synchronizacja P2P między instancjami |
| `memory_sentinel_create` | Obserwatory kierowane zdarzeniami |
| `memory_sentinel_trigger` | Wyzwala wartowników (sentinels) z zewnątrz |
| `memory_sketch_create` | Efemeryczne grafy akcji |
| `memory_sketch_promote` | Awansuje do stałego |
| `memory_crystallize` | Kompaktuje łańcuchy akcji |
| `memory_diagnose` | Kontrole stanu |
| `memory_heal` | Automatycznie naprawia zablokowany stan |
| `memory_facet_tag` | Tagi wymiar:wartość |
| `memory_facet_query` | Odpytywanie po tagach fasetowych |
| `memory_verify` | Śledzi pochodzenie |
### 6 zasobów · 3 prompty · 17 skilli
| Typ | Nazwa | Opis |
|------|------|-------------|
| Zasób | `agentmemory://status` | Stan, liczba sesji, liczba wspomnień |
| Zasób | `agentmemory://project/{name}/profile` | Inteligencja per projekt |
| Zasób | `agentmemory://project/{name}/recent` | Ostatnie obserwacje dla projektu |
| Zasób | `agentmemory://memories/latest` | Ostatnie 10 aktywnych wspomnień |
| Zasób | `agentmemory://graph/stats` | Statystyki grafu wiedzy |
| Zasób | `agentmemory://team/{id}/profile` | Współdzielony profil zespołu |
| Prompt | `recall_context` | Wyszukuje i zwraca wiadomości kontekstowe |
| Prompt | `session_handoff` | Dane przekazania między agentami |
| Prompt | `detect_patterns` | Analizuje powtarzające się wzorce |
| Skill | `/recall` | Przeszukuje pamięć |
| Skill | `/remember` | Zapisuje do pamięci długotrwałej |
| Skill | `/session-history` | Podsumowania ostatnich sesji |
| Skill | `/forget` | Usuwa obserwacje/sesje |
Tabela pokazuje cztery podstawowe skille. Pełny zestaw to 9 wywoływalnych skilli plus 8 skilli referencyjnych; zobacz sekcję Native skills powyżej.
### Samodzielny MCP
Działa bez pełnego serwera, dla każdego klienta MCP. Działa jedno z poniższych:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
Albo dodaj do konfiguracji MCP swojego agenta:
Większość agentów (Cursor, Claude Desktop, Cline, Roo Code, Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
Scal wpis `agentmemory` z istniejącym obiektem `mcpServers` twojego hosta, zamiast zastępować cały plik. Dla klientów w sandboksie, które nie mają dostępu do `localhost` hosta, dodaj `"AGENTMEMORY_FORCE_PROXY": "1"` do bloku env i ustaw `AGENTMEMORY_URL` na trasę, do której sandbox ma dostęp.
OpenCode (`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
Skopiuj plik pluginu z repozytorium:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---
Uruchamia się automatycznie na porcie `3113`. Podgląd wczytuje jedną migawkę przy połączeniu (`GET /agentmemory/viewer/snapshot`), a następnie stosuje zdarzenia z żywego strumienia: nowe wspomnienia, lekcje, obserwacje, wpisy audytu, zmiany grafu i aktualizacje stanu pojawiają się bez odpytywania (polling) czy przeładowywania strony. Jedynymi innymi żądaniami są akcje, które klikasz, strony „wczytaj więcej” i wyszukiwania. Gdy strumień się zrywa, podgląd pokazuje, jak nieaktualne są jego dane, ponownie łączy się z narastającym odstępem (backoff) i synchronizuje się od nowa z jednej migawki.
- **12 zakładek w czterech grupach** z licznikami na żywo, głębokimi linkami (`#memories/`, `#sessions/?obs=`, `#graph/`, `#health/consolidation`), skrótami klawiszowymi i menu mobilnym.
- **Wspomnienia:** wyszukiwanie po stronie serwera, filtry po projekcie, agencie i typie, panel szczegółów z łańcuchem wersji i diffem słów, linki pochodzenia, przyciski kopiowania dla id, wywołania MCP i komendy curl, edycja (nowa wersja), zapominanie z potwierdzeniem, masowe zapominanie i eksport JSON.
- **Sesje:** wbudowana osią czasu obserwacji z czytelnym wejściem i wyjściem narzędzi, filtry i paginacja, a także wspomnienia i lekcje wyprodukowane przez każdą sesję.
- **Graf:** wyszukiwanie, szczegóły węzła z relacjami i źródłami, legenda niezależna wyłącznie od kolorów oraz kontrolki powiększenia.
- **Stan (Health):** żywa wersja `GET /agentmemory/status`. Każdy problem ma podany sposób naprawy, a do tego backend stanu, stan zapisu indeksu, postęp kompaktowania pochodzenia grafu oraz objaśnienie konsolidacji z rzeczywistymi progami.
- **Strony Audyt, Aktywność, Profil, Replay, Lekcje, Akcje i Kryształy**, każda z pustym stanem opisującym, czym jest ta sekcja, czemu jest pusta i jaka komenda ją wypełni, a także podpowiedź słownikowa `?` przy każdym terminie i liczbie.
```bash
open http://localhost:3113
```
Serwer podglądu domyślnie wiąże się z `127.0.0.1` i dołącza sekret serwera, gdy przekazuje żądania do REST API, więc nie wymaga żadnej konfiguracji. Endpoint `/agentmemory/viewer` obsługiwany przez REST stosuje normalne zasady tokenu bearer i przekierowuje przeglądarki bez tokenu na port podglądu. Nagłówki CSP używają nonce skryptu per odpowiedź i wyłączają atrybuty handlerów inline (`script-src-attr 'none'`).
---
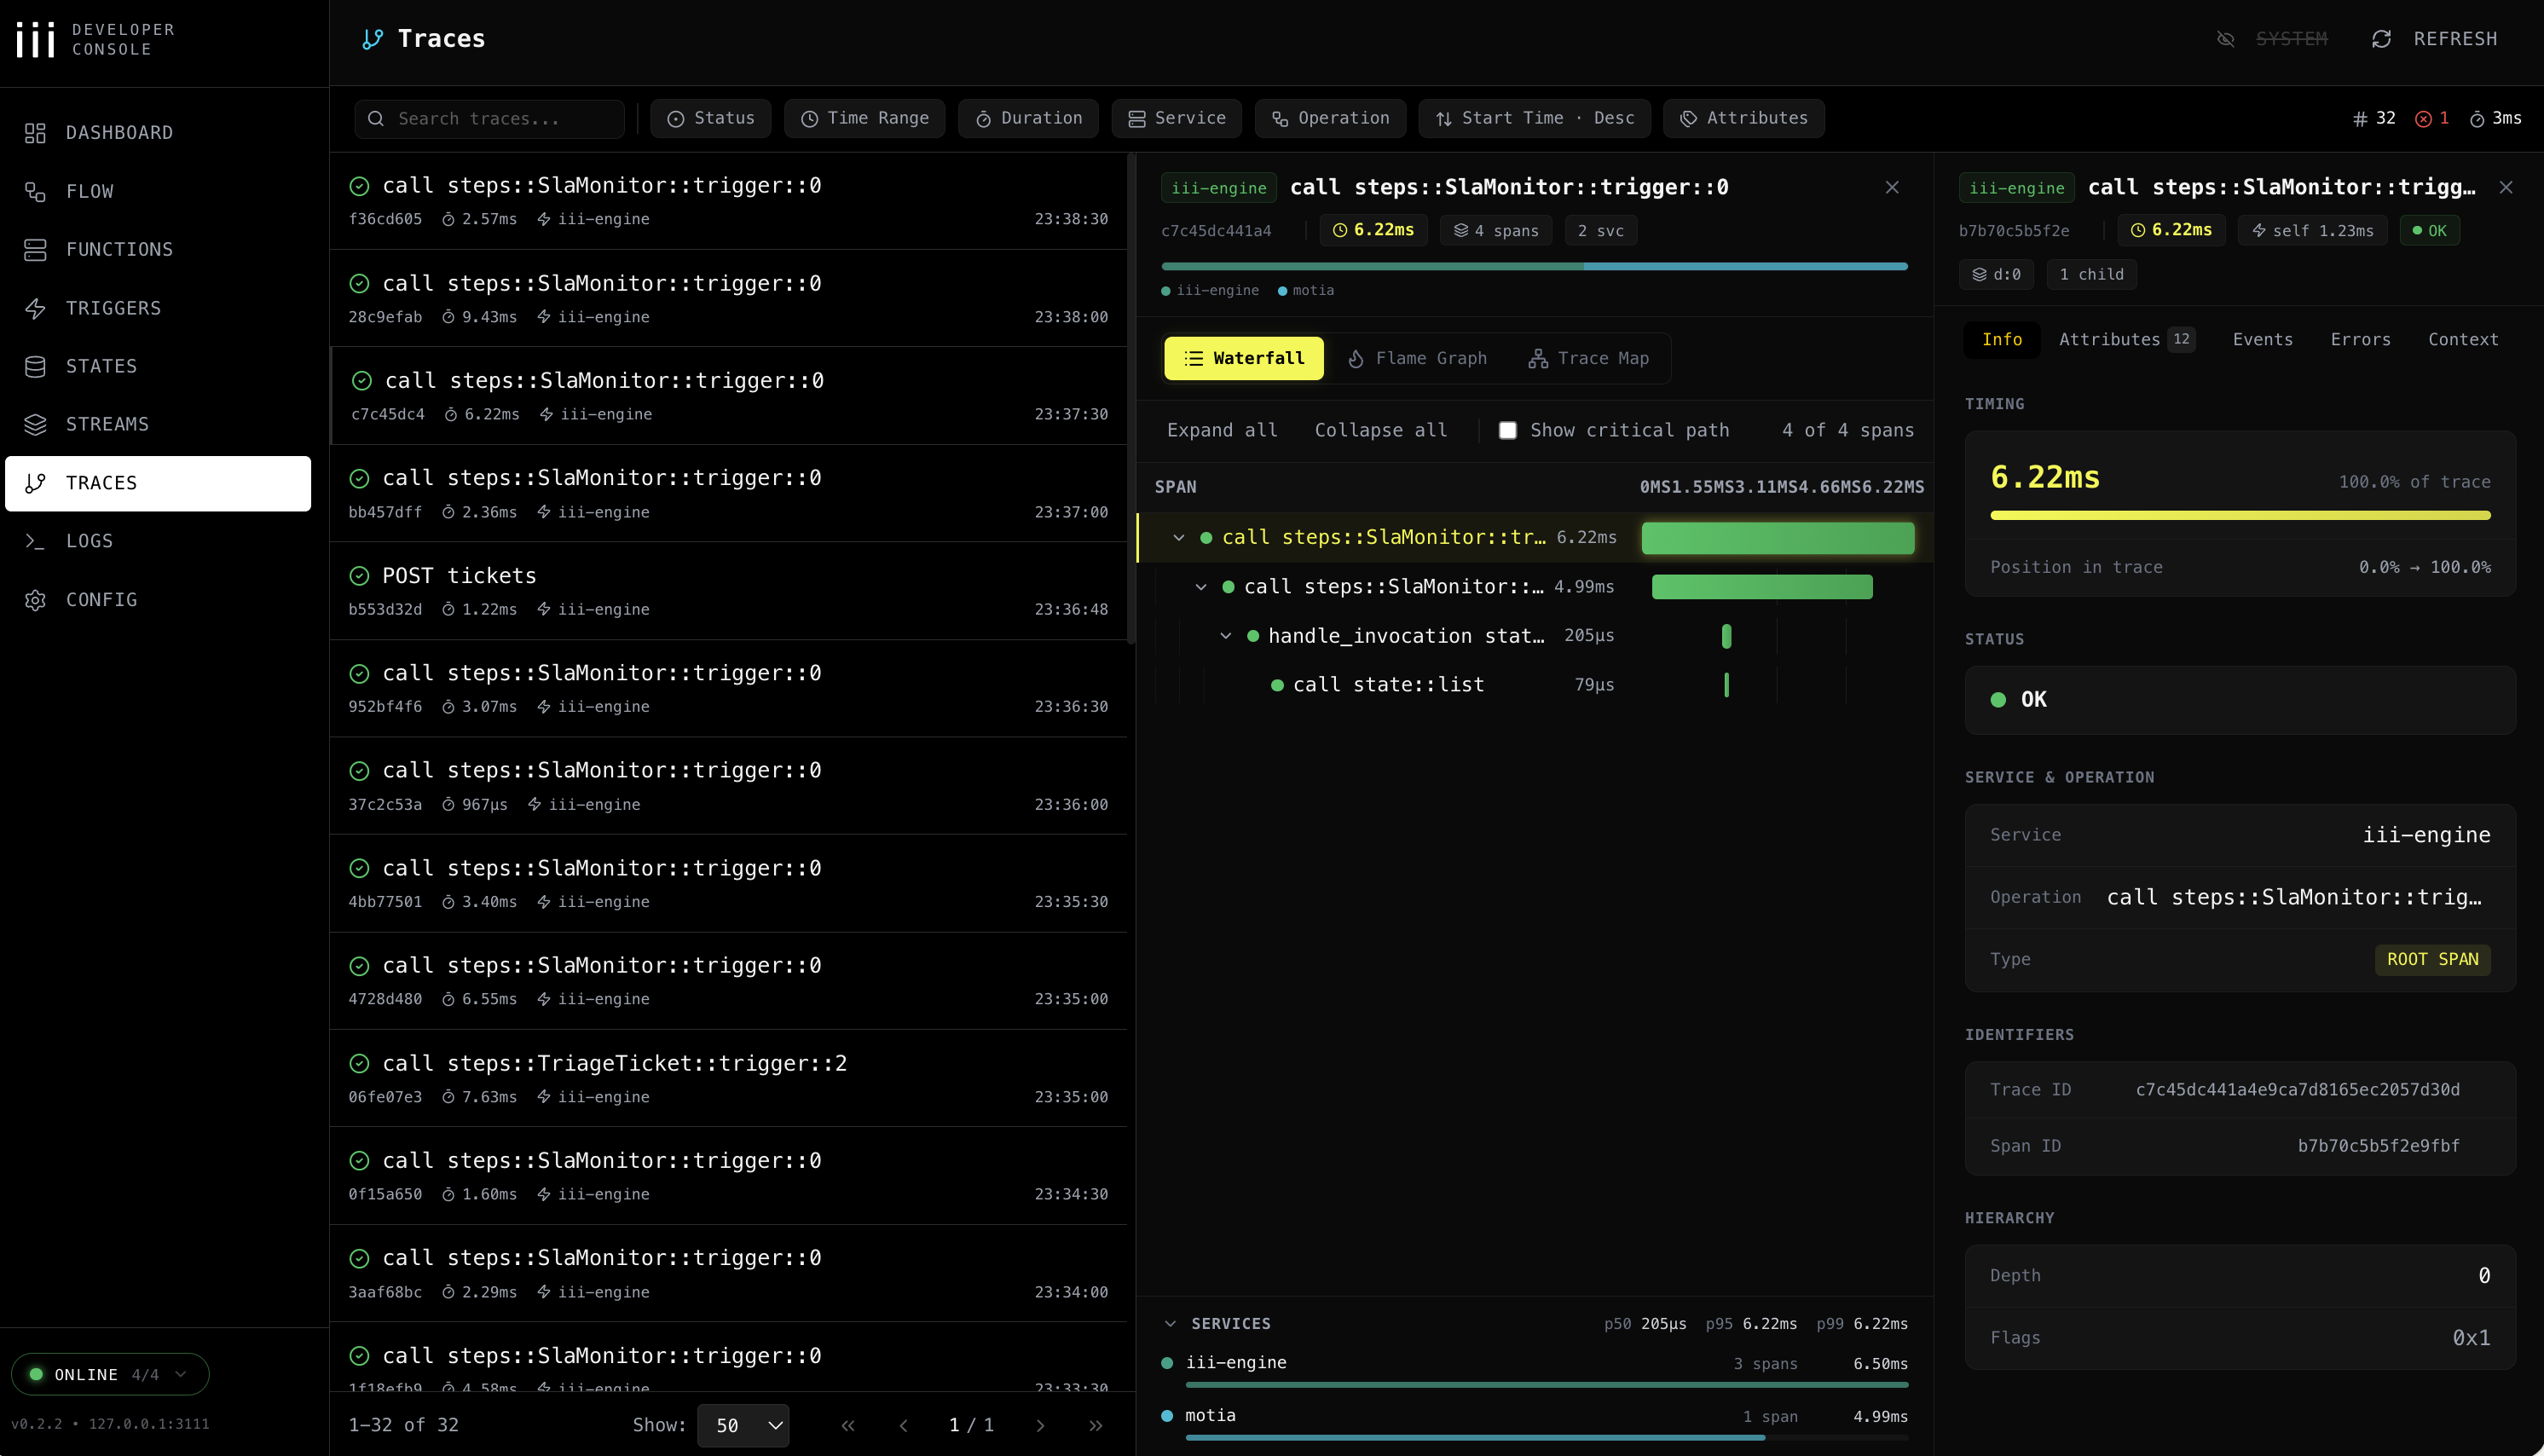
Podgląd na `:3113` pokazuje, co twój agent **zapamiętał**. [Konsola iii](https://iii.dev/docs/console) pokazuje, co twój agent **zrobił**: każdą operację pamięci jako trace OpenTelemetry, każdy wpis KV edytowalny, każdą funkcję wywoływalną, każdy strumień podsłuchiwalny. Dwa okna na tę samą pamięć: jedno w kształcie produktu, drugie w kształcie silnika.
Obserwuj, jak `memory_smart_search` się wyzwala, i zobacz skan BM25 → wyszukanie embeddingu → fuzję RRF → reranker jako wodospad (waterfall). Edytuj zablokowany timer konsolidacji w przeglądarce KV. Odtwórz hook `PostToolUse` ze zmodyfikowanym payloadem. Przypnij strumień WebSocket i obserwuj, jak obserwacje spływają na żywo.
agentmemory dostarcza to bezpłatnie, bo każde wywołanie funkcji i trigger przechodzi przez iii; nic niestandardowego, nic do instrumentowania.
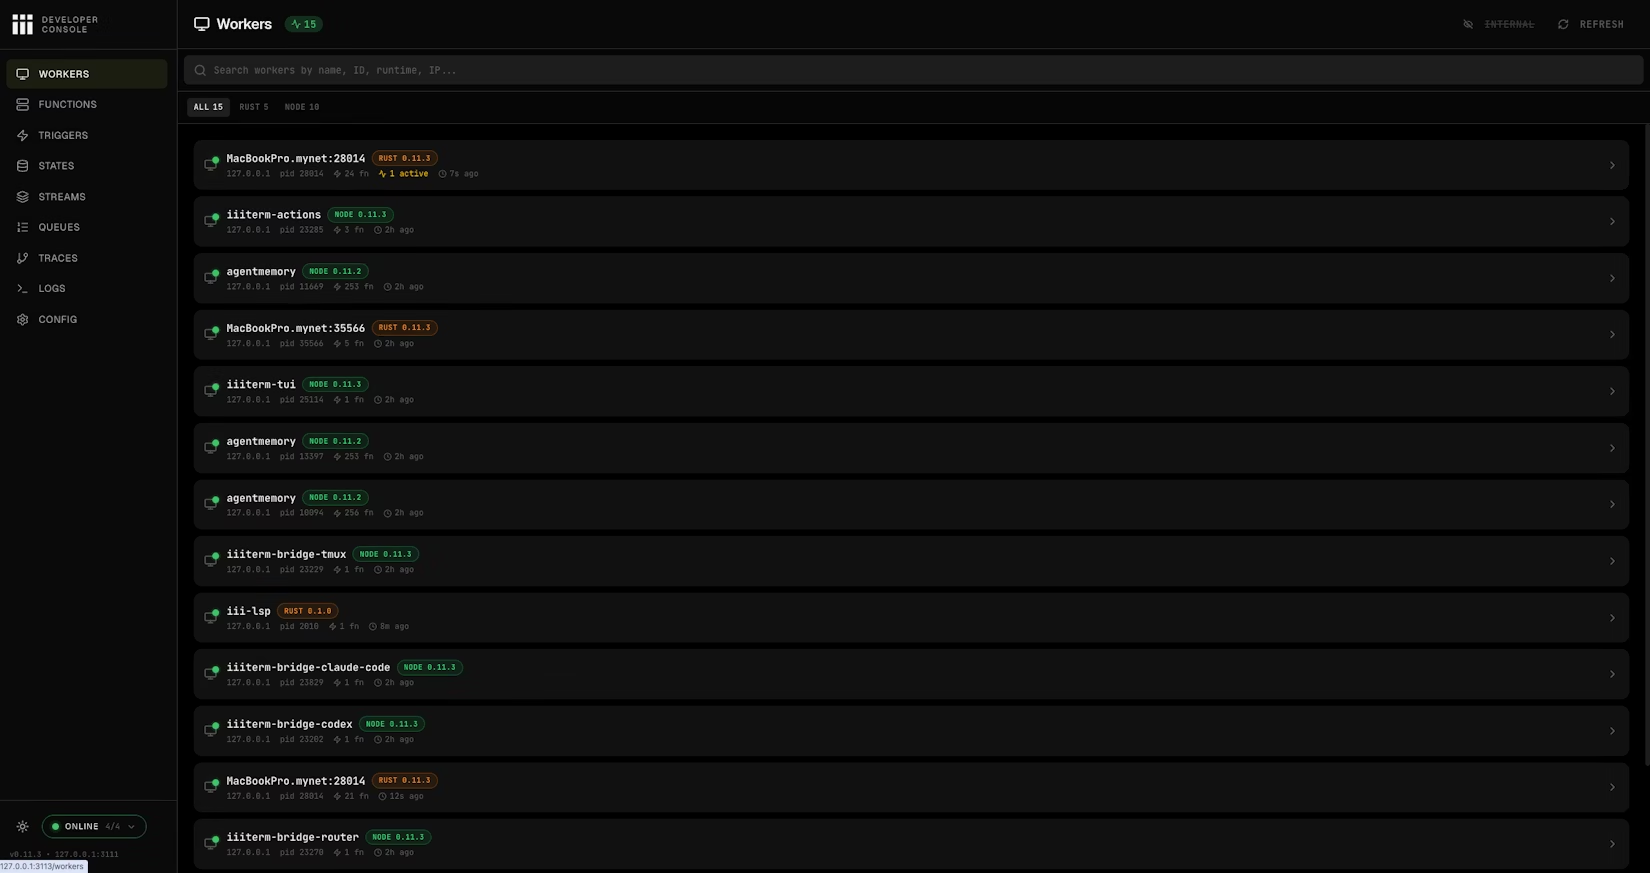
Strona Workers: każdy podłączony worker, w tym sam agentmemory, z PID, liczbą funkcji, środowiskiem wykonawczym i czasem ostatniej aktywności.
**Już zainstalowana.** Konsola jest dostarczana z przypiętym silnikiem `iii` (0.22+); nie trzeba niczego instalować osobno. Pierwsze uruchomienie pobiera plik binarny konsoli obok silnika.
**Uruchom razem z agentmemory:**
```bash
agentmemory console
```
To uruchamia `iii console` przypiętego silnika względem portów rozwiązanych przez agentmemory (REST, strumienie, mostek) i serwuje ją jeden port nad podglądem, domyślnie `http://localhost:3114`. `--console-port N` wybiera inny port; `--port` i `--instance` wybierają instancję agentmemory tak samo, jak dla `stop`; każda inna flaga jest przekazywana dalej, na przykład `--enable-flow` dla eksperymentalnej strony grafu architektury.
To samo ręcznie, przydatne, gdy `agentmemory` nie jest w PATH:
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**Co można zrobić z konsoli:**
| Strona | Służy do |
|------|-----------|
| **Workers** | Zobaczenia każdego podłączonego workera i jego metryk na żywo, włącznie z samym workerem agentmemory. |
| **Functions** | Wywołania bezpośrednio każdej funkcji agentmemory z payloadem JSON; przydatne do testowania `memory.recall`, `memory.consolidate`, `graph.query` bez podłączania klienta. |
| **Triggers** | Odtworzenia triggerów HTTP, cron, zdarzeń i stanu: ręcznego wyzwolenia crona konsolidacji, ponownej próby trasy HTTP, wyemitowania zmiany stanu. |
| **States** | Przeglądarki KV z pełnym CRUD na sesjach, slotach pamięci, timerach cyklu życia i indeksie embeddingów; edycji wartości w miejscu. |
| **Streams** | Monitora WebSocket na żywo dla zapisów pamięci, zdarzeń hooków i aktualizacji obserwacji, gdy przepływają przez strumienie iii. |
| **Queues** | Trwałych tematów kolejek + zarządzania dead-letter. Odtworzenia lub odrzucenia nieudanych zadań embeddingu / kompresji. |
| **Traces** | Widoków waterfall / flame / rozbicia na usługi OpenTelemetry. Filtrowania po `trace_id`, aby zobaczyć, które funkcje, wywołania bazy danych i żądania embeddingu wyprodukowało jedno `memory.search`. |
| **Logs** | Ustrukturyzowanych logów OTEL filtrowanych i skorelowanych z ID trace/span. |
| **Config** | Konfiguracji runtime: zobaczenia dokładnie, z jakimi workerami, dostawcami i portami działa twój silnik. |
| **Flow** | (Opcjonalnie, `--enable-flow`) Interaktywnego grafu architektury każdego workera, triggera i strumienia. |
Traces: waterfall / flame / rozbicie na usługi dla każdej operacji pamięci.
**Traces są już włączone:**
`iii-config.yaml` jest dostarczany z włączonym workerem `iii-observability` (`exporter: memory`, `sampling_ratio: 0.1`, metryki + logi). Nie jest potrzebna dodatkowa konfiguracja; w momencie, gdy agentmemory się uruchamia, każda operacja pamięci emituje ustrukturyzowany log, który konsola może odczytać, a jedna na dziesięć z nich (`sampling_ratio: 0.1`) emituje też span trace.
Jeśli chcesz zamiast tego eksportować do Jaeger/Honeycomb/Grafana Tempo, zmień `exporter: memory` na `exporter: otlp` i ustaw endpoint kolektora zgodnie z dokumentacją obserwowalności iii.
> **Uwaga:** na samej konsoli nie jest wymuszona autoryzacja; trzymaj ją związaną z `127.0.0.1` (ustawienie domyślne) i nigdy nie wystawiaj jej publicznie.
---
agentmemory **jest już działającą instancją [iii](https://iii.dev)**. Trzy prymitywy (worker, funkcja, trigger) składają się na środowisko wykonawcze; stan KV, strumienie i trace OTEL pochodzą z workerów iii-state, iii-stream i iii-observability, które są dostarczane z iii. Nie instalowałeś Postgresa, Redisa, Expressa, pm2 ani Prometheusa, bo iii je zastępuje.
To oznacza, że jedna dodatkowa komenda rozszerza agentmemory o całkiem nową możliwość.
### Rozszerz agentmemory o kolejne workery
Wbudowane workery, których potrzebuje agentmemory, są już w `iii-config.yaml` i startują razem z nim: `iii-state` (KV), `iii-queue` (trwałe powtórzenia dla subskrybentów zdarzeń), `iii-pubsub`, `iii-cron`, `iii-stream` i `iii-observability` (trace OTEL, metryki i logi dla każdej funkcji). Wszystko inne z [rejestru workerów iii](https://workers.iii.dev) podłącza się do tego samego silnika: skopiuj `iii-config.yaml` do `~/.agentmemory/iii-config.yaml` (CLI preferuje ten plik nad dołączonym i wciąż renderuje do niego porty i ścieżki danych), dodaj wpis, zainstaluj raz środowisko workera za pomocą `~/.agentmemory/bin/iii update worker` i zrestartuj agentmemory.
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | Co zyskujesz oprócz agentmemory |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | Adapter stanu oparty na SQL, gdy wyrośniesz z domyślnego KV w pamięci |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | Kod, który wyszedł z `memory_recall`, działa wewnątrz jednorazowej maszyny wirtualnej, a nie w twoim shellu |
| [`mcp`](https://workers.iii.dev/workers/mcp) | Postawienia dodatkowych serwerów MCP obok serwera agentmemory, dzielących ten sam silnik |
Na silniku 0.22.x zachowaj nazwy z prefiksem `iii-` dla powyższych wbudowanych workerów; wpisy bez prefiksu `http`, `state`, `queue`, `pubsub` i `cron` to samodzielne workery z rejestru, na które agentmemory przechodzi w migracji do 0.23.
Pełny rejestr: [workers.iii.dev](https://workers.iii.dev). Każdy worker tam dostępny komponuje się przez te same prymitywy, które wykorzystuje agentmemory, a posiadany już przez ciebie agentmemory jest jednym z nich.
### Konfiguracja silnika i adres bindowania
`agentmemory start` odczytuje konfigurację silnika z pierwszego istniejącego pliku: `AGENTMEMORY_III_CONFIG`, `./iii-config.yaml` w bieżącym katalogu, `~/.agentmemory/iii-config.yaml`, a następnie dołączony `iii-config.yaml`. Przy każdym starcie renderuje ten plik (ścieżki danych, porty, backend stanu) do `~/.agentmemory/data/iii-config.runtime.yaml` i uruchamia silnik z wyrenderowaną kopią, więc edytuj plik źródłowy, a nie wyrenderowany. Wartości `host:` z pliku źródłowego są zachowywane tak, jak zostały zapisane.
Dołączony `iii-config.yaml` celowo wiąże się z `127.0.0.1`, i to ustawienie domyślne obowiązuje też wewnątrz kontenera. CLI uruchomione w kontenerze słucha na loopbacku kontenera, więc opublikowane porty nie prowadzą do niczego. Aby obsłużyć skonteneryzowane CLI przez opublikowane porty, ustaw `AGENTMEMORY_III_CONFIG` na konfigurację, która wiąże się z `0.0.0.0`. Jedną z nich jest spakowany `iii-config.docker.yaml`: wiąże `iii-http`, `iii-stream` i port silnika z `0.0.0.0` i przechowuje stan pod `/data`, więc zamontuj tam wolumin z prawem zapisu. Trzymaj ustawione `AGENTMEMORY_SECRET` i publikuj tylko te porty, których potrzebujesz, na `127.0.0.1` albo za proxy, któremu ufasz.
`docker-compose.yml` tego repozytorium nie przechodzi przez wyszukiwanie konfiguracji CLI: montuje `iii-config.docker.yaml` pod `/app/config.yaml`, a kontener `iii-engine` startuje z `--config /app/config.yaml`. Jednoklikowe [szablony wdrożeń](../deploy/) zapisują własną konfigurację `0.0.0.0` w swoich punktach wejścia.
### Backend przechowywania: plik (domyślny) kontra redis
`iii-state` i `iii-stream` domyślnie korzystają z dołączonego do iii-engine magazynu KV opartego na plikach: jeden plik JSON na zakres (scope), przechowywany w pamięci procesu silnika i okresowo zapisywany na dysk. To właściwa wartość domyślna dla lokalnej instalacji jednoosobowej; współdzielony daemon z kilkoma równoczesnymi zapisującymi dostaje za to rzeczywiste zapisy per klucz z Redisa, kosztem rundy sieciowej na operację (każde wywołanie `state::*` wciąż serializuje się na jednym połączeniu z Redisem, więc to zamienia blokadę magazynu plikowego na gniazdo sieciowe, a nie na współbieżność).
Ustaw `AGENTMEMORY_STATE_BACKEND=redis` (plus `AGENTMEMORY_REDIS_URL`), aby przełączyć oba workery na wbudowany w iii-engine adapter `redis`, który przechowuje każdy klucz jako pole hasha Redisa (`HSET`) zamiast zapisywać cały zakres przy każdym zapisie:
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` domyślnie to `file`; nieustawienie tej wartości zachowuje dzisiejsze zachowanie bez zmian, a nierozpoznana wartość (cokolwiek innego niż `file` lub `redis`) to błąd startu, a nie ciche przełączenie zapasowe. `/agentmemory/status` i strona Stan (Health) podglądu (wiersz magazynu stanu) pokazują, który backend jest aktywny i czy odpowiada, nigdy jego URL.
**Tylko zwykłe `redis://`.** Przypięty silnik (0.22.1) buduje swojego klienta Redis bez wsparcia TLS, więc URL `rediss://` (większość zarządzanych ofert Redisa, takich jak Upstash, Redis Cloud i ElastiCache z szyfrowaniem w transporcie, domyślnie wymaga wyłącznie TLS) nie połączy się. Połączenie jest nieszyfrowane, więc hasło do Redisa i każde zapisane wspomnienie przechodzą przez sieć w postaci czystego tekstu: wskazuj na lokalny Redis albo taki w prywatnej sieci, której ufasz. Dla każdego innego Redisa uruchom zaszyfrowany tunel (stunnel, SSH albo VPN) na hoście agentmemory, dzięki czemu zwykłe `redis://` zostaje na tym hoście, a połączenie tunelu w górę jest zaszyfrowane i uwierzytelnione. Jeśli hasło do Redisa zawiera apostrof, zakoduj go procentowo (`%27`); silnik rozwija URL do swojej konfiguracji YAML przed jego sparsowaniem.
**Jeden serwer Redis na `--instance`.** Prefiksy kluczy Redisa silnika (`state:`, `stream::`) są ustalone, więc dwie instancje agentmemory (`--instance 1`, `--instance 2`, ...) wskazujące na tę samą bazę danych nadpisują sobie dane. Osobny indeks bazy danych (`redis://localhost:6379/1`) utrzymuje zapisane dane rozdzielone, ale silnik przekazuje żywe zdarzenia podglądu przez jeden kanał pub/sub Redisa (`stream::events`), a pub/sub Redisa ignoruje indeks bazy danych, więc podgląd każdej instancji wciąż pokazywałby żywe zdarzenia drugiej. Gdy uruchamiasz więcej niż jedną instancję, daj każdej własny serwer Redis (albo port).
**Co się nie zmienia, a co się różni.** Każda funkcja agentmemory działa na Redisie: sesje, obserwacje, wspomnienia (remember, supersede, evolve, forget), wyszukiwanie i paczki indeksu, lekcje, graf, log audytu i jego miesięczne zakresy, eksport i import, usunięcia governance, status konsolidacji, migawka podglądu i jej żywy strumień oraz monitor stanu. Silnik przechowuje każdy zakres jako jeden hash Redisa (`HSET`/`HGET`/`HGETALL`) i wyzwala te same triggery stanu, co magazyn plikowy. Trzy różnice silnika są obsługiwane wewnątrz agentmemory:
- Redis zwraca rekordy zakresu w nieustalonej kolejności. agentmemory sortuje je od najstarszych (według czasu utworzenia zakodowanego w id rekordu, a następnie jego znacznika czasu), dzięki czemu listy, paginacja i fragmenty eksportu wracają w tej samej kolejności, jak w magazynie plikowym.
- Silnik stosuje częściowe aktualizacje na Redisie w skrypcie Lua, który zamienia puste tablice na puste obiekty. agentmemory stosuje te aktualizacje samodzielnie (odczyt, zmiana, zapis pod blokadą per klucz) na Redisie, dzięki czemu pola takie jak `tags: []` pozostają tablicami.
- Starsze sprawdzenie logu audytu odczytuje stary zakres z Redisa, zamiast szukać pliku magazynu plikowego na dysku.
Jedna różnica wymaga twojej uwagi: **po restarcie Redisa silnik przestaje przekazywać żywe zdarzenia** do podglądu, dopóki agentmemory się nie zrestartuje. Dane są wciąż normalnie zapisywane i odczytywane. Monitor stanu wysyła testowe zdarzenie przez Redis co 30 sekund; gdy nie wraca, `/agentmemory/status` i strona Stan podglądu pokazują „Live updates are not reaching the viewer” z sugerowaną naprawą: zrestartuj agentmemory. Jeśli Redis nie działa, raport statusu pokazuje „The state store is not answering” oraz sposób sprawdzenia tego (`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`). Listowanie bardzo dużego zakresu odczytuje cały hash w jednym `HGETALL`, czyli taki sam koszt, jak trzymanie go w pamięci przez magazyn plikowy.
**Zalecane ustawienia Redisa.** Domyślna polityka migawek `save 3600 1 300 100 60 10000` może stracić minuty zapisów przy awarii, co jest gorsze niż 5-sekundowe okno zapisu magazynu plikowego. Ustaw `appendonly yes` dla wszystkiego, czego strata by cię martwiła. Ustaw `maxmemory-policy noeviction`; `allkeys-lru` lub podobne po cichu usuwają wspomnienia, gdy Redis dojdzie do swojego limitu pamięci.
Natywny start (bez Dockera) i każdy jednoklikowy [szablon wdrożenia](../deploy/) (nadpisują dołączony `iii-config.yaml` i startują natywnie) odczytują `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL` i renderują je do uruchamianej `iii-config`. Sam URL nigdy nie jest zapisywany do tego wyrenderowanego pliku, tylko referencja `${AGENTMEMORY_REDIS_URL}`, którą proces silnika rozwija z własnego środowiska przy starcie. Tylko własna ścieżka Docker Compose tego repozytorium (`AGENTMEMORY_USE_DOCKER=1`, albo wznowienie silnika już w ten sposób uruchomionego) montuje `iii-config.docker.yaml` w trybie tylko do odczytu i nigdy nie renderuje; `agentmemory start` ostrzega, gdy wykryje tę kombinację. Zmień ten plik ręcznie, stosując tę samą strukturę `name: redis` / `config: redis_url: ...` pokazaną w dokumentacji workerów [iii-state](https://workers.iii.dev/workers/iii-state) i [iii-stream](https://workers.iii.dev/workers/iii-stream), i wskaż `redis_url` na Redisa dostępnego z kontenera. `docker-compose.yml` przekazuje `AGENTMEMORY_REDIS_URL` do kontenera silnika, więc `redis_url: '${AGENTMEMORY_REDIS_URL}'` działa tam i trzyma URL poza zamontowanym plikiem.
Wyrenderowana konfiguracja trzyma URL poza `~/.agentmemory/data/iii-config.runtime.yaml`, ale własny worker konfiguracji silnika i tak zapisuje trwale *rozwiniętą* wartość do `~/.agentmemory/config/iii-state.yaml` i `iii-stream.yaml`, gdy się uruchamia (rozwijanie `${VAR}` iii-engine zachodzi przed tym, jak ten worker zapisuje swój seed, i zapisuje rozwiązaną wartość, a nie referencję). Traktuj ten katalog jak zawierający dane uwierzytelniające: `chmod 700 ~/.agentmemory` na każdym współdzielonym hoście i preferuj użytkownika ACL Redisa ograniczonego do tego, czego potrzebuje agentmemory, nad danymi administratora bazy.
**Migracja nie jest automatyczna.** Przełączenie `AGENTMEMORY_STATE_BACKEND` zaczyna od pustego magazynu po obu stronach; nic nie kopiuje istniejących danych z pliku do Redisa albo z powrotem. Wyeksportuj z backendu, który opuszczasz, i zaimportuj do tego, na który się przenosisz. To działa identycznie pod bash i zsh (włącznie z `bash -u`). Tablica taka jak `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` już nie: zsh zachowuje nagłówek jako jedno zdeformowane słowo, tam gdzie bash dzieli je na dwa, więc oba żądania zwracają 401, gdy ustawione jest `AGENTMEMORY_SECRET`:
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` przyjmuje też `?maxSessions=` i `?offset=` do dzielenia dużego korpusu na kilka wywołań; `strategy` przy imporcie to `merge` (bezpieczna wartość domyślna), `replace` albo `skip`.
### Co zastępuje iii
| Tradycyjny stos | agentmemory używa |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + indeks wektorowy w pamięci |
| SSE / Socket.io | iii Streams (WebSocket) |
| pm2 / systemd | nadzór workerów silnika iii |
| Prometheus / Grafana | iii OTEL + monitor stanu |
| Niestandardowe systemy pluginów | `iii worker add ` |
**219 plików źródłowych · ~52,000 LOC · 2,500+ testów · 311 funkcji · 60 zakresów KV**, wszystko na trzech prymitywach. Nie ma `agentmemory plugin install`. Systemem pluginów jest sam iii.
---
### Dostawcy LLM
agentmemory automatycznie wykrywa dostawców na podstawie twojego środowiska. Dostawca udostępnia operacje oparte na LLM, ale samo skonfigurowanie dostawcy nie włącza kompresji obserwacji pisanej przez LLM. Ta ścieżka wymaga zarówno dostawcy, jak i `AGENTMEMORY_AUTO_COMPRESS=true`.
| Dostawca | Konfiguracja | Uwagi |
|----------|--------|-------|
| **No-op (domyślny)** | Konfiguracja niepotrzebna | Kompresja/podsumowywanie oparte na LLM jest wyłączone. Kompresja syntetyczna i przywołanie przez BM25 wciąż działają. Zobacz `AGENTMEMORY_ALLOW_AGENT_SDK` poniżej, jeśli wcześniej korzystałeś z fallbacku na subskrypcję Claude. |
| Anthropic API | `ANTHROPIC_API_KEY` | Rozliczanie per token |
| MiniMax | `MINIMAX_API_KEY` | Kompatybilny z Anthropic |
| Gemini | `GEMINI_API_KEY` | Włącza też embeddingi |
| OpenRouter | `OPENROUTER_API_KEY` | Każdy model |
| OpenAI API | `OPENAI_API_KEY` | Domyślnie `gpt-5.6-luna`, nadpisz za pomocą `OPENAI_MODEL` |
| **Lokalny (Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1` (Ollama) albo `http://localhost:1234/v1` (LM Studio) + `OPENAI_MODEL=` | Wszystko kompatybilne z API OpenAI. Zerowy koszt, działa na twoim sprzęcie. Zobacz [Modele lokalne](#local-models-ollama--lm-studio--vllm) poniżej. |
| Fallback na subskrypcję Claude | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | Tylko opt-in. Tworzy sesje `@anthropic-ai/claude-agent-sdk`; wcześniej powodowało to nieograniczoną rekursję hooka Stop, więc nie jest to już wartość domyślna. |
### Modele lokalne (Ollama / LM Studio / vLLM)
agentmemory rozmawia z każdym serwerem kompatybilnym z API OpenAI, więc wszystko, co wystawia `/v1/chat/completions`, działa bez zmian w kodzie. Bez płatnych kluczy, bez chmury, bez limitów zapytań; działa całkowicie na twoim sprzęcie.
**Ollama** (domyślny port `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio** (domyślny port `1234`):
Otwórz LM Studio → zakładka Local Server → Start Server. Wybierz jakikolwiek model czatu z listy (Qwen 3, gpt-oss, DeepSeek R1 itd.).
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**: ta sama struktura. Wskaż `OPENAI_BASE_URL` na URL wystawiany przez twój serwer i ustaw `OPENAI_MODEL` na nazwę, którą twój serwer zaakceptuje.
**Wybór modelu do pracy z pamięcią**: kompresja i podsumowywanie to krótkie zadania (<2K tokenów na wejściu, <500 tokenów na wyjściu), do których w pełni wystarczy model instrukcyjny 7B. Zalecenia:
| Model | Rozmiar | Dlaczego |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | Zbalansowana wartość domyślna na maszynie z 16 GB; silny w ekstrakcji i tekście w formie narzędziowej |
| `qwen3:4b` | ~2.6 GB | Najmniejsza sensowna opcja; dobra do kompresji, słabsza do ekstrakcji grafu |
| `qwen3-coder:30b` | ~19 GB | Najlepszy lokalny wybór dla sesji o profilu kodu (30B MoE, 3.3B aktywne) na sprzęcie 24-32 GB |
| `gpt-oss:20b` | ~14 GB | Silny model ogólny, który mieści się w 16 GB RAM |
| `deepseek-r1:8b` | ~5.2 GB | Dystylat rozumowania; wolniejszy, ale czystsze ekstrakcje |
Modele Qwen 3 domyślnie myślą i mogą spalić cały budżet tokenów na rozumowanie, zanim pojawi się jakiekolwiek wyjście. Ustaw `AGENTMEMORY_LLM_NOTHINK=1`, aby dołączyć `/no_think` do promptów ekstrakcji grafu, i zwiększ `MAX_TOKENS` (16384 działa dobrze), jeśli ekstrakcje wracają puste.
Modele klasy reasoning (w stylu `o1`, z blokami ``) mogą zwracać puste `content` z polem `reasoning`, którego twój lokalny serwer może nie udostępniać. Jeśli ekstrakcje wracają puste, najpierw przełącz się na model bez reasoning. Zmienna środowiskowa `OPENAI_REASONING_EFFORT=none` może też wyłączyć myślenie na modelach myślących Ollama Cloud, które odwzorowują schemat reasoning OpenAI.
Lokalne embeddingi są dostarczane jako opcjonalna zależność, ale nie są włączone domyślnie. Ustaw `EMBEDDING_PROVIDER=local`, aby włączyć `Xenova/all-MiniLM-L6-v2` (384 wymiary). Pierwsze żądanie embeddingu pobiera model; wnioskowanie działa potem lokalnie. Bez tego ustawienia albo zdalnego klucza embeddingów wektory pozostają wyłączone, `mem::search` używa BM25, a `smart-search` może wciąż dodawać istniejące dopasowania z grafu.
### Dobór modelu z uwzględnieniem kosztów
Gdy kompresja w tle pisana przez LLM jest włączona (zarówno dostawca, jak i `AGENTMEMORY_AUTO_COMPRESS=true`), działa przy każdej obserwacji, więc wybór modelu znacząco zmienia miesięczny wydatek. Zebrane dane obciążenia: 635 żądań / 888K tokenów / 35 godzin aktywnego użycia, uruchomione na trzech modelach OpenRouter według cennika z 2026-05-23.
| Poziom | Model | Wejście / 1M | Wyjście / 1M | Koszt za zebrane 35h | Uwagi |
|------|-------|------------|-------------|---------------------------|-------|
| Zalecany | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07 (szac.) | Najnowszy DeepSeek; najtańszy zalecany wybór do zadań kompresji. |
| Zalecany | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | Solidna jakość kompresji + podsumowywania przy koszcie ~10× niższym niż Sonnet. |
| Zalecany | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | Silne rozumowanie kodu, jeśli twoje sesje są silnie zorientowane na kod. |
| Premium | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02 (szac.) | Taka sama cena cennikowa, jak w zmierzonym uruchomieniu Sonnet 4.6; wprowadzająca cena $2/$10 do 2026-08-31. |
| Premium | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9 (szac.) | Poziom flagowy; drogi dla stale działającej pracy w tle. |
| Unikać | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40 (szac.) | Model klasy flagowej; przepłacanie za kompresję. |
Zmierzone wiersze pochodzą z zebranego uruchomienia; wiersze (szac.) skalują ten sam miks tokenów według ceny cennikowej każdego modelu.
agentmemory wypisuje ostrzeżenie w runtime, gdy `OPENROUTER_MODEL` odpowiada wzorcowi poziomu premium. Ustaw `AGENTMEMORY_SUPPRESS_COST_WARNING=1`, aby je wyciszyć, gdy już podejmiesz świadomą decyzję.
Kompromis jakość kontra koszt dla pracy z pamięcią: kompresja to zadanie podsumowujące z relatywnie niskim progiem jakości (podsumowanie czyta ponownie agent, nie użytkownik). DeepSeek V4 Flash / V4 Pro / Qwen3-Coder wypadają w tym zadaniu w granicach błędu zaokrąglenia względem Sonnet, kosztując 10-70× mniej. Modele poziomu premium zachowaj do zapytań, które czytasz bezpośrednio.
Źródła: [cennik OpenRouter dla Claude Sonnet 5](https://openrouter.ai/anthropic/claude-sonnet-5), [DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731), [uwagi o cenniku DeepSeek](https://api-docs.deepseek.com/quick_start/pricing/).
### Pamięć wieloagentowa (`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
W konfiguracjach wieloagentowych, gdzie kilka ról współdzieli jeden serwer agentmemory (architekt / developer / reviewer / researcher / support-agent), `AGENT_ID` tagguje każdy zapis rolą, która go wykonała. `AGENTMEMORY_AGENT_SCOPE` kontroluje, czy przywołanie filtruje po tym tagu.
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
Dwa tryby:
| Tryb | Taguje zapisy | Filtruje przywołanie | Kiedy używać |
|------|------------|---------------|-------------|
| `shared` (domyślny) | tak | nie | Kontekst między agentami ze ścieżką audytu. Architekt widzi, co zanotował developer, ale każdy wiersz zapisuje, kto to powiedział. |
| `isolated` | tak | tak | Ścisłe rozdzielenie. Architekt nigdy nie widzi obserwacji / wspomnień / sesji developera. |
Co jest tagowane, gdy ustawiono `AGENT_ID`: `Session.agentId`, `RawObservation.agentId`, `CompressedObservation.agentId`, `Memory.agentId`. Rola przepływa od `api::session::start` → `mem::observe` → `mem::compress` → KV.
Co jest filtrowane w trybie isolated: `mem::smart-search`, `/agentmemory/memories`, `/agentmemory/observations`, `/agentmemory/sessions`. Każdy endpoint przyjmuje `?agentId=`, aby nadpisać to per żądanie, i `?agentId=*`, aby całkowicie zrezygnować z zakresu ze zmiennych środowiskowych. `/memories` przyjmuje też `?includeOrphans=true`, aby ujawnić wspomnienia sprzed `AGENT_ID`, których `agentId` jest niezdefiniowane.
Nadpisanie per wywołanie na poziomie SDK / REST: każdy mutujący endpoint (`/session/start`, `/remember`) przyjmuje w treści żądania pole `agentId`, które wygrywa nad zmienną środowiskową. Przydatne dla środowisk uruchomieniowych routujących wiele ról przez jeden proces serwera. Narzędzie MCP `memory_save` udostępnia to samo pole `agentId`, samodzielny serwer stdio przekazuje dalej zarówno `agentId`, jak i `project`, a zapisane wspomnienia niosą `agentId` do indeksu wyszukiwania, więc wyszukiwanie w zakresie agenta obejmuje zarówno wspomnienia, jak i obserwacje.
Gdy `AGENT_ID` nie jest ustawione, pamięć pozostaje bez zakresu (zachowanie historyczne, brak tagów, brak filtrów).
### Porty
agentmemory + iii-engine domyślnie wiążą cztery porty. Jeśli restart zawiedzie z `port in use`, ta tabela mówi, jakiego procesu szukać.
| Port | Proces | Przeznaczenie | Nadpisanie zmienną środowiskową |
|------|---------|---------|--------------|
| `3111` | agentmemory | REST API + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | Wewnętrzny worker strumieni (konsumowany przez agentmemory + podgląd) | `III_STREAM_PORT` (preferowane) albo starsze `III_STREAMS_PORT` |
| `3113` | agentmemory | Podgląd w czasie rzeczywistym (`http://localhost:3113`) | `III_VIEWER_PORT` albo `AGENTMEMORY_VIEWER_URL` dla zgłaszanego URL |
| `49134` | iii-engine | WebSocket; tu rejestrują się workery, przez niego przepływa telemetria OTel | `III_ENGINE_PORT` albo `III_ENGINE_URL` |
`--port ` zmienia kotwicę REST i wyprowadza strumienie `N+1`, podgląd `N+2` oraz WebSocket silnika `N+46023`, tylko tam, gdzie odpowiadający jej wyraźny port albo URL powyżej nie jest ustawiony. Nie tworzy to osobnej przestrzeni nazw cyklu życia. Użyj `--instance 1` dla drugiego daemona; używa kotwicy 3211, domyślnie `3211/3212/3213/49234`, i otrzymuje osobny katalog danych i cyklu życia `instance-1`. Instancje od 1 do 50 działają według tego samego wzorca.
Przypięty silnik startuje z `--no-update-check` (bez sprawdzania aktualizacji ani wskazówek bezpieczeństwa względem GitHub przy starcie) i z wyłączoną anonimową telemetrią użycia iii: agentmemory ustawia `III_TELEMETRY_ENABLED=false` dla uruchamianego przez siebie silnika, o ile sam nie wyeksportujesz tej zmiennej, a dołączony plik compose robi to samo.
Czyszczenie nieaktualnych procesów, gdy porty pozostają związane po awarii:
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` czysto zbiera pidfile workera i silnika przy łagodnym natywnym zamknięciu. W trybie Docker opróżnia natywnego workera, zatrzymuje dokładnie ten zweryfikowany kontener silnika i zachowuje zarówno kontener, jak i jego montowanie `/data` na potrzeby restartu bez utraty danych; kolejny start weryfikuje i wznawia ten sam kontener. Odinstalowanie oparte na Dockerze wymaga `agentmemory remove --keep-data`: usuwa współdzielone pliki zarządzane przez agentmemory, zachowując zweryfikowany kontener, jego montowanie danych i rekord cyklu życia potrzebny do ich odzyskania. Destrukcyjne usunięcie danych Dockera jest celowo pozostawione operatorowi po wykonaniu backupu. CLI odmawia też przejęcia lub zasygnalizowania posiadaczy portów Dockera lub VM (backend Dockera, vpnkit, colima) jako natywnego silnika, jeśli nie podano `--force`. Powyższe ręczne czyszczenie jest tylko na wypadek sytuacji po awarii, gdy nie został po sobie żaden pidfile.
### Plik konfiguracyjny
Umieść konfigurację runtime agentmemory w `~/.agentmemory/.env`, zamiast eksportować zmienne w każdym shellu. Jeśli podgląd pokazuje wskazówkę konfiguracyjną jak `export ANTHROPIC_API_KEY=...`, skopiuj ją do tego pliku jako `ANTHROPIC_API_KEY=...` bez prefiksu `export`, a następnie zrestartuj agentmemory.
Zmienne środowiska procesu wciąż działają i mają pierwszeństwo przed wartościami z pliku.
Na Windows ten sam plik znajduje się w `%USERPROFILE%\.agentmemory\.env`:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
Aby testować z subskrypcją Claude Code Pro/Max zamiast klucza API, zdecyduj się na to wyraźnie:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
Kompresja obserwacji pisana przez LLM wymaga obu linii: dostępu do dostawcy LLM (włącznie z tym wyraźnym fallbackiem na subskrypcję) oraz `AGENTMEMORY_AUTO_COMPRESS=true`. Sam dostawca pozostawia domyślną ścieżkę kompresji syntetycznej.
Konsolidacja (węzły grafu, lekcje, kryształy) jest domyślnie włączona, gdy skonfigurowano dostawcę LLM. Wyraźnie zrezygnuj za pomocą `CONSOLIDATION_ENABLED=false`, jeśli chcesz działania bez LLM. Ekstrakcja grafu to osobna flaga:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### Zmienne środowiskowe
Utwórz `~/.agentmemory/.env`:
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---
138 endpointów na porcie `3111`. REST API domyślnie wiąże się z `127.0.0.1`. Chronione endpointy wymagają `Authorization: Bearer `, a endpointy synchronizacji mesh wymagają wyraźnie ustawionego `AGENTMEMORY_SECRET` na obu peerach.
**Autoryzacja jest domyślnie włączona.** Gdy `AGENTMEMORY_SECRET` nie jest ustawione (w shellu albo w `~/.agentmemory/.env`), serwer generuje losowy sekret przy pierwszym starcie i zapisuje go w `~/.agentmemory/secret` z uprawnieniami `0600`. Każdy dołączony klient czyta go z tego miejsca, gdy rozmawia z lokalnym serwerem: CLI, podgląd, hooki w `plugin/scripts`, serwer MCP i shim `@agentmemory/mcp`, konfiguracje zapisywane przez `agentmemory connect` oraz dołączone integracje OpenCode, Pi, OpenClaw, Hermes i filesystem-watchera. Zapisany sekret jest wysyłany tylko na adresy loopback (`localhost`, `127.0.0.0/8`, `::1`). Wyraźnie podane `AGENTMEMORY_SECRET` zawsze wygrywa, a zdalni klienci wciąż muszą mieć je ustawione. Docker i punkty wejścia w `deploy/` już generują i eksportują swój własny sekret. Aby wywołać API ręcznie:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**Zasady żądań dla zapisów.** Żądania `POST`, `PUT`, `PATCH` i `DELETE` do REST API i podglądu muszą wysyłać `Content-Type: application/json` (parametr `charset` jest w porządku), kiedy niosą treść, a nagłówek `Origin`, jeśli jest obecny, musi być originem loopback dla skonfigurowanego portu REST albo podglądu, albo być wymieniony w `VIEWER_ALLOWED_ORIGINS` (lista rozdzielona przecinkami, np. `https://memory.example.com`). Klienci, które nie wysyłają nagłówka `Origin` (CLI, hooki, MCP, curl, serwer-do-serwera), nie są tym objęci. Podgląd akceptuje też swój własny origin.
**Ścieżki plików.** Endpointy, które czytają lub zapisują pliki (`/compress-file`, `/replay/import-jsonl`, `/graph/import-graphify`), przyjmują tylko ścieżki pod `~/.agentmemory`, katalogiem danych instancji albo katalogiem wymienionym w `AGENTMEMORY_IMPORT_ROOT` (rozdzielaj kilka za pomocą `:`, albo `;` na Windows). `/replay/import-jsonl` przyjmuje też swój domyślny `~/.claude/projects`. `/obsidian/export` zostaje wewnątrz `AGENTMEMORY_EXPORT_ROOT`, a `/migrate` wewnątrz `~/.agentmemory`. Linki symboliczne są rozwiązywane przed każdym sprawdzeniem.
**Czyszczenie sekretów.** Klucze API, tokeny bearer, bloki prywatnych kluczy PEM i dane uwierzytelniające wbudowane w adresy URL (`scheme://user:password@host`) są redagowane (usuwane) przed zapisaniem tekstu, na każdej ścieżce zapisu: obserwacjach, remember, evolve, slotach, lekcjach, akcjach, sketchach, sygnałach, checkpointach, importach, replayu jsonl, synchronizacji mesh, udostępnieniach zespołowych, wyjściu kompresji i podsumowań, kryształach i węzłach grafu.
Kluczowe endpointy
| Metoda | Ścieżka | Opis |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | Kontrola stanu (zawsze publiczna) |
| `GET` | `/agentmemory/status` | Co jest nie tak i jak to naprawić (HTML dla przeglądarek, w innym wypadku JSON) |
| `GET` | `/agentmemory/viewer/snapshot` | Wszystko, co pokazuje podgląd, w jednej odpowiedzi |
| `POST` | `/agentmemory/session/start` | Rozpoczyna sesję + pobiera kontekst |
| `POST` | `/agentmemory/session/end` | Kończy sesję |
| `POST` | `/agentmemory/observe` | Przechwytuje obserwację (zobacz dostawę przechwytywania poniżej) |
| `GET` | `/agentmemory/capture` | Skrzynka przechwytywania, dead lettery i spool offline |
| `POST` | `/agentmemory/capture/retry` | Ponawia przechwycenia dead-letter |
| `POST` | `/agentmemory/capture/drain` | Wysyła teraz lokalny spool offline |
| `POST` | `/agentmemory/smart-search` | Wyszukiwanie hybrydowe |
| `POST` | `/agentmemory/context` | Generuje kontekst |
| `POST` | `/agentmemory/remember` | Zapisuje do pamięci długotrwałej |
| `POST` | `/agentmemory/forget` | Usuwa obserwacje |
| `POST` | `/agentmemory/enrich` | Kontekst plikowy + wspomnienia + błędy |
| `GET` | `/agentmemory/profile` | Profil projektu |
| `GET` | `/agentmemory/export` | Eksportuje wszystkie dane |
| `POST` | `/agentmemory/import` | Importuje z JSON |
| `POST` | `/agentmemory/graph/query` | Odpytanie grafu wiedzy |
| `POST` | `/agentmemory/graph/compact` | Przycina nadmiarowe pochodzenie grafu |
| `POST` | `/agentmemory/team/share` | Udostępnia zespołowi |
| `GET` | `/agentmemory/audit` | Ścieżka audytu |
Pełna lista endpointów: [`src/triggers/api.ts`](../src/triggers/api.ts)
**Dostawa przechwytywania.** Hooki wysyłają każdą obserwację raz do `POST /agentmemory/observe` z `eventId`. Jest to własny id hosta dla tego wywołania, gdy payload go ma (na przykład `tool_use_id` Claude Code), albo w innym wypadku hash sesji, typu hooka, nazwy narzędzia, wejścia, wyjścia i znacznika czasu hosta. Serwer zapisuje zdarzenie do skrzynki przechwytywania w magazynie stanu, zapisuje obserwację, a następnie usuwa wpis ze skrzynki. Kod statusu mówi, co się stało:
| Status | Pole `status` | Znaczenie |
|---|---|---|
| `201` | `accepted` | Zapisano. `observationId` to nowa obserwacja. |
| `202` | `accepted` (`state: "retrying"`) | Zaakceptowano, ale zapis się nie powiódł. Serwer ponawia, również po restarcie. |
| `200` | `duplicate` | Ten `eventId` był już zaakceptowany. `observationId` to istniejąca obserwacja; nic nowego nie zostaje zapisane. |
| `400` / `422` | `rejected` | Nieprawidłowy payload, albo zapis nie powiódł się ostatecznie (zdarzenie jest zachowane jako dead letter). |
| `503` | `rejected` (`retryable: true`) | Skrzynka jest pełna (`AGENTMEMORY_CAPTURE_INBOX_MAX`). Hooki umieszczają zdarzenie w spoolu i wysyłają je później. |
Nieudane zdarzenia są ponawiane co `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS` (10 s) z podwajającym się odstępem (backoff), do `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS` (5). Zdarzenia, które wciąż zawodzą, zostają w skrzynce jako dead lettery, są wymienione na `/agentmemory/status` i stronie Stan podglądu, i mogą być ponowione za pomocą `POST /agentmemory/capture/retry` (`{"eventId": "..."}` albo `{"all": true}`). Zaakceptowane id zdarzeń są pamiętane przez `AGENTMEMORY_CAPTURE_DEDUP_HOURS` (168 godzin, maksymalnie `AGENTMEMORY_CAPTURE_EVENTS_MAX` id), więc hook odtworzony po timeoucie albo restarcie jest zapisany raz, natomiast dwa osobne wywołania narzędzia z własnymi id hosta są zapisywane dwukrotnie, nawet gdy ich treść jest identyczna. Gdy obserwacja jest usuwana (forget, usunięcie sesji, eviction, auto-forget albo import, który zastępuje magazyn), jej zdarzenie jest oznaczane jako usunięte przed usunięciem obserwacji, więc odtworzenie tego zdarzenia w tym samym oknie jest traktowane jako duplikat i nic nie zapisuje. Magazyn stanu zapisuje na dysk co 2 sekundy, więc odpowiedziane zdarzenie może przez chwilę istnieć jeszcze tylko w pamięci. Aby to pokryć, każda odpowiedź `2xx` niesie też `bootId` serwera (nowy przy każdym starcie), `acceptedAt` i `durableAfterMs` (odstęp zapisu plus 1.5 s w magazynie plikowym, 1.5 s na redisie, gdzie trwałość jest ustawieniem operatora). Hooki trzymają zdarzenie w lokalnym spoolu, dopóki to okno nie minie, i usuwają je przy kolejnym wywołaniu, bez dodatkowego żądania. Jeśli `bootId` zmienił się do tego czasu, serwer zrestartował się, więc hook wysyła zdarzenie ponownie z tym samym `eventId`; zdarzenie, które dotarło na dysk, nie jest zapisywane dwukrotnie. Serwer sam wysyła też takie zdarzenia przy starcie i w każdym interwale ponowień, więc restart niczego nie gubi, nawet jeśli potem żaden hook nie zostanie uruchomiony. Starsze hooki ignorują dodatkowe pola, a nowe hooki wobec starszego serwera odrzucają zdarzenie przy `2xx` jak dawniej.
Gdy serwer jest wyłączony, nie odpowiada w czasie albo zwraca 5xx, hook dopisuje obserwację do lokalnego pliku spool, `/capture-spool/-.jsonl` (nadpisz folder za pomocą `AGENTMEMORY_CAPTURE_SPOOL_DIR`). Plik jest prywatny dla twojego użytkownika (uprawnienia 600), sekrety są redagowane w ten sam sposób, w jaki redaguje je serwer, zawiera maksymalnie `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES` (5 MiB) i odrzuca wpisy starsze niż `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS` (168). Gdy jest pełny, nowe wpisy są odrzucane i zliczane, a `/agentmemory/status` to raportuje. Hook wciąż kończy się kodem 0 w ramach swojego limitu czasu i nie dodaje żadnego żądania, gdy serwer jest zdrowy. Spool jest wysyłany przy następnym starcie i przez pierwszy hook, który ponownie dotrze do serwera, w procesie w tle, więc agent nie czeka. Id zdarzeń zapewniają bezpieczeństwo tego mechanizmu: obserwacja, która dotarła przed timeoutem, nie jest zapisywana dwukrotnie. `npx @agentmemory/agentmemory capture` pokazuje spool i skrzynkę serwera, `--drain` wysyła spool teraz, a `GET /agentmemory/capture` zwraca to samo jako JSON. Ustaw `AGENTMEMORY_CAPTURE_SPOOL=false`, aby wyłączyć spool.
**Kompaktowanie pochodzenia grafu.** Każdy węzeł i krawędź grafu wiedzy przechowuje id 32 najnowszych obserwacji, z których powstał. Magazyny zapisane przed tym limitem mogą mieć tysiące id na gorący węzeł, co spowalnia wyszukiwanie w grafie i podgląd albo zrzuca workera. agentmemory naprawia to samodzielnie: przy pierwszym starcie po aktualizacji przycina w tle każdy węzeł, krawędź, zastąpioną krawędź (temporalna historia grafu) i zbuforowaną migawkę do limitu, w małych fragmentach z przerwą między nimi, dzięki czemu wyszukiwanie, przechwytywanie i podgląd nadal działają. Zapisuje swój postęp, wznawia po restarcie i nigdy nie uruchamia się ponownie, gdy już skończy. `/agentmemory/status` i strona Stan podglądu pokazują to jako pending, running (z bieżącym zakresem i pozycją), done albo failed. Ustaw `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false`, aby to wyłączyć.
Aby uruchomić to ręcznie, wywołaj `POST /agentmemory/graph/compact`. Przechodzi przez indeksy nazw i kluczy krawędzi, zamiast listować każdy węzeł i krawędź, i jest bezpieczne do wielokrotnego uruchomienia. Gdy przycina id, zapisuje wpis audytu `graph_compact`.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
Na dużym magazynie, albo gdy wywołanie zwraca 504, uruchom to we fragmentach. Wyślij `scope` (`nodes`, `edges` albo `history`), `offset` i `limit`, a potem wywołaj znowu ze zwróconym `nextOffset`, aż będzie `null`. Zrób to dla `nodes`, `edges` i `history`, a zakończ jednym wywołaniem `{"scope":"snapshot"}`, bo uruchomienie we fragmentach nie dotyka zbuforowanej migawki.
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---
```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**Wymagania wstępne:** Node.js >= 20 z npm/npx; [iii-engine](https://iii.dev/docs) v0.22.1 albo Docker. Automatyczna instalacja silnika na macOS/Linux wymaga też `curl`, POSIX-owego `sh` i `tar`; natywny Windows używa ręcznie przypiętego `iii.exe`, WSL2 albo Docker Desktop.