让你的编码代理记住一切。不再重复解释。
基于 iii engine 构建
为 Claude Code、GitHub Copilot CLI、Cursor、Gemini CLI、Codex CLI、Hermes、OpenClaw、pi、OpenCode 以及任何 MCP 客户端提供持久化记忆。
🇬🇧 English •
🇨🇳 简体中文 •
🇹🇼 繁體中文 •
🇯🇵 日本語 •
🇰🇷 한국어 •
🇵🇹 Português •
🇧🇷 Português (Brasil) •
🇪🇸 Español •
🇩🇪 Deutsch •
🇫🇷 Français •
🇮🇹 Italiano •
🇳🇱 Nederlands •
🇵🇱 Polski •
🇨🇿 Čeština •
🇷🇴 Română •
🇭🇺 Magyar •
🇬🇷 Ελληνικά •
🇸🇪 Svenska •
🇩🇰 Dansk •
🇳🇴 Norsk •
🇫🇮 Suomi •
🇷🇺 Русский •
🇺🇦 Українська •
🇹🇷 Türkçe •
🇮🇱 עברית •
🇸🇦 العربية •
🇮🇳 हिन्दी •
🇧🇩 বাংলা •
🇵🇰 اردو •
🇹🇭 ไทย •
🇻🇳 Tiếng Việt •
🇮🇩 Bahasa Indonesia •
🇵🇭 Tagalog


这份 gist 在 Karpathy 的 LLM Wiki 模式基础上扩展了置信度评分、生命周期管理、知识图谱和混合搜索:agentmemory 就是其实现。


安装 •
快速开始 •
基准测试 •
对比竞品 •
代理 •
工作原理 •
MCP •
查看器 •
由 iii 驱动 •
配置 •
API
---
## 安装
环境要求:
- Node.js 20 或更新版本,并安装 npm 和 npx(`node -v`、`npm -v` 和 `npx -v`)。
- macOS/Linux 下自动安装 iii-engine 还需要 `curl`、POSIX `sh` 和 `tar`。像 `node:20-slim` 这样的精简镜像可能不包含它们。
- 原生 Windows 需要手动安装锚定版本 iii-engine v0.22.1 的 `iii.exe`。另外支持的途径是 WSL2 或 Docker Desktop。
标准的全新安装命令:
```bash
npx -y @agentmemory/agentmemory@latest
```
首次运行是一次交互式设置:选择要接入的代理(Claude Code、Cursor、Codex、Gemini CLI、OpenCode……),选择一个 LLM 提供者或保持无密钥模式;随后它会生成配置、启动记忆服务器及其锚定的 iii 引擎,并询问是否要全局安装,这样之后在任何地方都能直接使用 `agentmemory` 命令。`-y` 用于接受 npx 的包安装提示,`@latest` 用于避免使用过期的缓存版本。配置好提供者后,LLM 相关功能才可用,但只有同时设置了 `AGENTMEMORY_AUTO_COMPRESS=true`,LLM 撰写的观测压缩才会启动。
无密钥模式会关闭向量嵌入。`memory_recall`(即 `mem::search` 路径)使用 BM25,而当图数据已经存在时,`memory_smart_search` 还可以融合结构化的图匹配结果。要免费启用本地设备上的语义召回,在 `~/.agentmemory/.env` 中设置 `EMBEDDING_PROVIDER=local` 并重启。首次嵌入请求会下载 `Xenova/all-MiniLM-L6-v2`;完成这次初始模型下载后,推理就会在本地运行。
本地运行时使用四个端口:`3111` 用于 REST/MCP HTTP,`3112` 用于 iii 流,`3113` 用于查看器,`49134` 用于 iii worker 的 WebSocket。持久化的 iii 状态保存位置为:macOS 上的 `~/Library/Application Support/agentmemory`,Linux 上的 `$XDG_DATA_HOME/agentmemory` 或 `~/.local/share/agentmemory`,以及 Windows 上的 `%APPDATA%\agentmemory`。使用 `--data-dir ` 或 `AGENTMEMORY_DATA_DIR` 来覆盖这个位置,并在之后每次重启时复用同一个值。出于向后兼容考虑,对于实例 0,已存在的 `./data/state_store.db` 或 `./data/iii-config.yaml` 会优先于平台默认路径;显式的命令行参数或环境变量覆盖始终优先级最高。
然后验证召回是否生效,并为你的代理装上它的 skills:
```bash
npx -y @agentmemory/agentmemory@latest demo # seed sample sessions + exercise recall
npx skills add rohitg00/agentmemory -y # 17 native skills so your agent knows when to reach for memory
```
在默认的无密钥模式下,关键词搜索应该能通过 BM25 命中结果。演示中的 `database performance optimization` 查询刻意设计为语义查询,在配置嵌入提供者之前可能返回零结果。
更想让编码代理替你完成整个安装过程?给它一条指令就行:
> Retrieve and follow the instructions at: https://raw.githubusercontent.com/rohitg00/agentmemory/main/INSTALL_FOR_AGENTS.md
随时可以用 `agentmemory connect ` 接入更多代理 —— [适用于所有代理](#works-with-every-agent) 中列出了 20 个适配器。完整命令参考见 [快速开始](#quick-start)。
Windows
最省心的路径是 WSL2。原生 Windows 引擎设置需要手动下载锚定版本 v0.22.1 的 ZIP 并解压出 `iii.exe`;CLI 不会自动解压它。也支持 Docker Desktop。具体步骤见 [Windows 说明](#windows)。
全局安装 / EACCES
```bash
npm install -g @agentmemory/agentmemory@latest
```
上面的 npx 命令仍是标准的全新安装路径,并且能避免全局前缀的权限问题。
npx 提供的是旧版本
npx 按版本缓存。用 `npx -y @agentmemory/agentmemory@latest` 强制使用最新版本,或清一次缓存:`rm -rf ~/.npm/_npx`(macOS/Linux;Windows 上删除 `%LOCALAPPDATA%\npm-cache\_npx`)。
已经在运行自己的 iii 引擎
agentmemory 锚定 iii-engine v0.22.1,不会连接到其他版本(worker 无法说另一个引擎版本的协议)。先停掉那个引擎,再运行 `npx -y @agentmemory/agentmemory@latest`。它会在 `~/.agentmemory/bin` 中安装并运行锚定的 v0.22.1 版本,不会动你自己的 `iii`。
---

agentmemory 适用于任何支持 hooks、MCP 或 REST API 的代理。所有代理共享同一个记忆服务器。

Claude Code
原生插件 + 12 hooks + MCP
|

Codex CLI
原生插件 + 6 hooks + MCP
|

GitHub Copilot CLI
MCP + 插件 hooks/skills
|

Cursor
原生插件 + 7 hooks + MCP
|
OpenCode
捕获插件 + MCP
|
Devin
6 hooks + skills + MCP
|

OpenClaw
原生插件 + MCP
|

Hermes
原生插件 + MCP
|

pi
原生插件 + MCP
|
OpenHuman
原生 Memory trait 后端
|
Gemini CLI
MCP 服务器
|

Antigravity
MCP + hooks
|
Claude Desktop
MCP 服务器
|

Warp
connect + MCP + skills
|

Zed
MCP 服务器
|

Cline
MCP 服务器
|

Continue
MCP 服务器
|

Droid
MCP 服务器
|

Kiro
MCP 服务器
|

Qwen Code
MCP 服务器
|

DeepSeek Harness
MCP 服务器
|

Roo Code
MCP 服务器
|

Kilo Code
MCP 服务器
|

Goose
MCP 服务器
|

Aider
REST API
|
适用于任何使用 MCP 或 HTTP 的代理。一个服务器,所有代理共享记忆。
---
你在每次会话中都要重新解释同样的架构。你反复发现同样的 bug。你反复教会它同样的偏好。内建记忆(CLAUDE.md、.cursorrules)上限是 200 行,而且会过时。agentmemory 解决了这个问题。它会静默捕获代理所做的一切,将其压缩为可搜索的记忆,并在下一次会话开始时注入正确的上下文。一条命令。跨代理生效。
**改变了什么:** 会话 1 你搭建了 JWT 鉴权。会话 2 你要求加上限流。代理已经知道你的鉴权使用了 `src/middleware/auth.ts` 中的 jose 中间件,测试覆盖了 token 校验,并且你为了 Edge 兼容性选择了 jose 而非 jsonwebtoken —— 不需要重新解释,也不需要复制粘贴。
```bash
npx -y @agentmemory/agentmemory@latest
```
默认情况下,agentmemory 会把 iii-engine 状态存储在启动它的仓库之外:macOS 上的 `~/Library/Application Support/agentmemory`,Linux 上的 `$XDG_DATA_HOME/agentmemory` 或 `~/.local/share/agentmemory`,以及 Windows 上的 `%APPDATA%\agentmemory`。对于实例 0,已存在的旧版 `./data/state_store.db` 或 `./data/iii-config.yaml` 会在平台默认路径之前被复用。要显式选择一个位置,传入 `--data-dir ` 或设置 `AGENTMEMORY_DATA_DIR`;这两种显式设置都优先于旧版探测逻辑:
```bash
npx -y @agentmemory/agentmemory@latest --data-dir ~/.agentmemory-projects/main
AGENTMEMORY_DATA_DIR=~/.agentmemory-projects/main npx -y @agentmemory/agentmemory@latest
```
原生启动和 Docker 启动使用的是同一个解析得到的主机目录;Docker 会把它绑定挂载到 `/data`。`--instance 1` 会在解析出的目录后追加 `instance-1`,并选用单独的默认端口四元组 `3211/3212/3213/49234`。
最新发布说明见:[CHANGELOG.md](../CHANGELOG.md)。
---

|
### 检索准确率
**coding-agent-life-v1**(内部语料库,可在沙箱中复现)
| 适配器 | P@5 | R@5 | Top-5 命中率 | p50 延迟 |
|---|---|---|---|---|
| **agentmemory 混合** | **0.240** | **1.000** | **15 / 15** | 14 ms |
| grep 基线 | 0.227 | 0.967 | 15 / 15 | 0 ms |
在该语料库上,命中率达到了 **P@5 的数学上限**(0.240,详见 scorecard)下的 100% top-5 命中率。混合检索能取回每一个 gold 会话;grep 在多会话时间性查询上漏掉了 2 个 gold 中的 1 个。这里的提升体现在**召回率 + 时间性**,而不是整体精确率。这个基准规模较小、gold 样本稀疏;下方更大规模的 LongMemEval-S 区分度更好。完整的按类型拆分 + 修正说明见:[`docs/benchmarks/2026-05-20-coding-agent-life-v1.md`](../docs/benchmarks/2026-05-20-coding-agent-life-v1.md)。
**LongMemEval-S**(ICLR 2025,500 个问题)
| 系统 | R@5 | R@10 | MRR |
|---|---|---|---|
| **agentmemory** | **95.2%** | **98.6%** | **88.2%** |
| 仅 BM25 回退 | 86.2% | 94.6% | 71.5% |
|
### Token 节省
| 方案 | Tokens/年 | 成本/年 |
|---|---|---|
| 粘贴完整上下文 | 19.5M+ | 不可行(超出窗口) |
| LLM 摘要 | ~650K | ~$500 |
| **agentmemory** | **~170K** | **~$10** |
| agentmemory + 本地嵌入 | ~170K | **$0** |
|
> 嵌入模型:`all-MiniLM-L6-v2`(本地、免费、无需 API key)。完整报告见:[`benchmark/LONGMEMEVAL.md`](../benchmark/LONGMEMEVAL.md)、[`benchmark/QUALITY.md`](../benchmark/QUALITY.md)、[`benchmark/SCALE.md`](../benchmark/SCALE.md)。竞品对比见 [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md),涵盖 agentmemory 与 mem0、Letta、Khoj、supermemory、TencentDB Agent Memory、MemPalace、Zep/Graphiti、Cognee、Hippo 的对比。
**本地复现:** [`eval/README.md`](../eval/README.md) 是一个可插拔适配器的测试框架,面向 LongMemEval `_s`(公开的 500 题)+ `coding-agent-life-v1`(内部 15 会话语料库)。Grep / 向量 / agentmemory 适配器并排评分,输出 NDJSON,发布的 scorecard 存放在 [`docs/benchmarks/`](../docs/benchmarks/)。
**可与 [codegraph](https://github.com/colbymchenry/codegraph)、[Understand Anything](https://github.com/Lum1104/Understand-Anything) 和 [Graphify](https://github.com/safishamsi/graphify) 搭配使用。** 分别覆盖代码图索引、多代理构建流水线,以及跨文档 / PDF / 图像 / 视频的更广泛知识图谱。agentmemory 记住的是工作过程;这三个项目则点亮了上下文层的其余部分。配方 + 问题路由表见:[`docs/recipes/pairings.md`](../docs/recipes/pairings.md)。
---

|
agentmemory |
mem0 (63K ⭐) |
Letta / MemGPT (24K ⭐) |
Khoj (36K ⭐) |
supermemory (29K ⭐) |
TencentDB Agent Memory (22K ⭐) |
MemPalace (54K ⭐) |
oracleagentmemory |
Hippo |
内建 (CLAUDE.md) |
| 类型 |
记忆引擎 + MCP 服务器 |
记忆层 API |
完整代理运行时 |
个人 AI |
记忆 API + 应用 |
团队记忆中枢(LLM 代理层) |
向量记忆(开源) |
记忆引擎(Oracle DB) |
记忆系统 |
静态文件 |
| 检索 R@5 |
95.2% |
68.5% (LoCoMo) |
83.2% (LoCoMo) |
N/A |
自报 |
PersonaMem 76%(自报) |
~96.6%(自报) |
94.4%(自报) |
N/A |
N/A (grep) |
| 自动捕获 |
12 hooks(零人工) |
手动调用 add() |
代理自编辑 |
手动 |
API 侧提取 |
代理层拦截(替换 base-URL) |
手动 |
API 提取 |
手动 |
手动编辑 |
| 搜索 |
BM25 + 向量 + 图(RRF 融合) |
向量 + 图 |
向量(归档) |
语义 |
向量 + RAG |
4 种资产类型(Chat / Skill / Wiki / CodeGraph) |
仅向量 |
向量 + 语义 |
衰减加权 |
将所有内容加载到上下文 |
| 多代理 |
MCP + REST + 租约 + 信号 |
API(无协调) |
仅在 Letta 运行时内部 |
无 |
无 |
团队角色 + 共享资产 |
无 |
仅作用域 |
多代理共享 |
每代理一个文件 |
| 框架锁定 |
无(任何 MCP 客户端) |
无 |
高(必须使用 Letta) |
独立 |
无 |
代理层截获每次模型调用 |
无 |
Oracle Database |
无 |
每代理格式 |
| 外部依赖 |
无(SQLite + iii-engine) |
Qdrant / pgvector |
Postgres + 向量数据库 |
多个 |
托管云 |
Docker 栈(Core + Hub + Proxy) |
向量存储 |
Oracle AI Database |
无 |
无 |
| 记忆生命周期 |
4 层整合 + 衰减 + 自动遗忘 |
被动提取 |
代理管理 |
手动 |
自动遗忘 |
人工审核;自动路由开发中 |
无 |
未说明 |
衰减 + 整合 |
手动清理 |
| Token 效率 |
~1,900 tokens/会话($10/年) |
依集成方式不同 |
核心记忆位于上下文 |
不定 |
云端定价 |
未说明 |
无 token 预算 |
LLM 支撑(不定) |
不定 |
240 条观测达 22K+ tokens |
| 实时查看器 |
是(端口 3113) |
云端仪表板 |
云端仪表板 |
Web UI |
云端仪表板 |
Hub Web UI |
无 |
无 |
无 |
无 |
| 自托管 |
是(默认) |
可选 |
可选 |
是 |
否(仅云端) |
是(Docker) |
是 |
是(Oracle DB) |
是 |
是 |
基准说明:只有 agentmemory 的 R@5 是我们自己测得的结果(LongMemEval-S,可从 benchmark/COMPARISON.md 复现)。mem0 和 Letta 的数字是它们公布的 LoCoMo 结果(不同数据集);MemPalace、supermemory、TencentDB(PersonaMem)和 oracleagentmemory 的数字是厂商自报、我们未独立复现的声明(oracleagentmemory 的测试使用 GPT-5.5 搭配 Oracle AI Database)。并列展示仅供粗略参考,并非同一数据上的正面对比。星标数为近似值且会随时间漂移。
**值得了解的新入局者**,深入对比见 [`benchmark/COMPARISON.md`](../benchmark/COMPARISON.md):
| 系统 | ⭐ | 切入角度 |
|--------|---|-------|
| Zep / Graphiti | 30K | 时间性知识图谱;已公布的时间性查询结果最强(LongMemEval 63.8%),但图谱是异步构建的,新事实可能滞后 |
| Cognee | 30K | 文档到知识图谱的摄取,仅 Python,为结构化实体抽取而建,而非会话捕获 |
它们都不能从编码代理的 hooks 自动捕获、不提供本地优先的查看器、也不能无密钥运行 —— 而这正是 agentmemory 围绕构建的组合。
---

兼容性:此版本面向 `iii-sdk` 0.22.1,并锚定 iii-engine v0.22.1。
### 30 秒体验
```bash
# Terminal 1: start the server
npx -y @agentmemory/agentmemory@latest
# Terminal 2: seed sample data and see recall in action
npx -y @agentmemory/agentmemory@latest demo
```
`demo` 会生成 3 个贴近真实场景的会话(JWT 鉴权、N+1 查询修复、限流),并对它们执行搜索。无密钥安装会关闭向量,所以 `mem::search` 的关键词查询应该能通过 BM25 命中,而 `database performance optimization` 可能返回零结果。当图数据存在时,`smart-search` 还可能额外返回结构化的图匹配结果。要让这条语义查询通过向量找到 N+1 修复,请设置 `EMBEDDING_PROVIDER=local`,重启,并等待首次模型下载完成。
打开 `http://localhost:3113` 实时观察记忆的构建过程。
### 验证全新安装与重启持久化
服务器运行时,验证 REST、健康检查、查看器以及由 iii 支撑的运行时状态:
```bash
curl -fsS http://localhost:3111/agentmemory/livez
curl -fsS http://localhost:3111/agentmemory/health
curl -fsS -o /dev/null http://localhost:3113/
npx -y @agentmemory/agentmemory@latest status
```
启动完成面板会覆盖全部四个端口:3111 上的 REST/MCP HTTP,3112 上的 iii 流,3113 上的查看器,以及 49134 上的 iii worker WebSocket。`status` 会确认 agentmemory 的健康状况以及当前激活的提供者/嵌入模式。保存一条探测记录并确认它可被搜索到:
```bash
curl -fsS -X POST http://localhost:3111/agentmemory/remember \
-H 'Content-Type: application/json' \
-d '{"content":"agentmemory restart persistence probe","concepts":["install-check"]}'
curl -fsS -X POST http://localhost:3111/agentmemory/smart-search \
-H 'Content-Type: application/json' \
-d '{"query":"restart persistence probe","limit":5}'
```
然后运行 `npx -y @agentmemory/agentmemory@latest stop`,在终端 1 中再次运行标准命令启动,等待 `/agentmemory/livez` 就绪,再重复一次搜索。这条探测记录必须仍然能被返回。如果你选择了自定义的 `--data-dir`,重启时要传入同一个目录。
### 日常命令
安装与设置见上方的 [安装](#install)(首次运行会引导你完成)。日常使用:
```bash
agentmemory # start the server
agentmemory stop # stop it cleanly
agentmemory connect # wire another agent
agentmemory doctor # interactive diagnostics + fix prompts
agentmemory remove # uninstall everything we created
```
### 会话回放
agentmemory 记录的每个会话都可以回放。打开查看器,选择 **Replay** 标签页,然后在时间线上拖动:提示词、工具调用、工具结果和回复都会渲染成独立的事件,支持播放/暂停、速度控制(0.5x 到 4x)以及键盘快捷键(空格切换播放,方向键单步前进)。
要导入旧的 Claude Code JSONL 会话记录:
```bash
# Import everything under the default ~/.claude/projects
npx -y @agentmemory/agentmemory@latest import-jsonl
# Or import a single file
npx -y @agentmemory/agentmemory@latest import-jsonl ~/.claude/projects/-my-project/abc123.jsonl
```
导入的会话会和原生会话一起出现在 Replay 选择器中。在底层,每条记录都经由 `mem::replay::load`、`mem::replay::sessions` 和 `mem::replay::import-jsonl` 这些 iii 函数来处理,没有旁路服务器。每个导入的会话记录都会被编入搜索索引,打上来源渠道 `import` 的标记,并被挖掘出会话 crystal 和经验教训。
> **提醒:如果你把 `import-jsonl` 当作主要的捕获路径:** Claude Code 的 `cleanupPeriodDays`(在 `~/.claude/settings.json` 中,默认 **30**)会自动删除 `~/.claude/projects/` 中超出这个时间窗口的 JSONL 会话记录。如果你是在一个积累了数月历史的 Claude Code 上全新安装 agentmemory,那么超过 30 天的记录在第一次导入之前就已经消失了。要么用 cron 定期运行 `import-jsonl`,要么把 `cleanupPeriodDays` 调高,要么接入自动捕获 hooks(默认的插件安装路径),这样每一轮对话在会话进行中就会进入 agentmemory,JSONL 的清理也就不再重要。
### 升级 / 维护
当你有意要更新本地运行时,使用维护命令:
```bash
npx -y @agentmemory/agentmemory@latest upgrade
```
警告:这个命令会改动当前的工作区/运行时。它可能更新 JavaScript 依赖,并拉取锚定的 `iiidev/iii:0.22.1` Docker 镜像。它绝不会安装未锚定或更新的 iii 引擎。
具体实现见 `src/cli.ts`(参见 `runUpgrade`,大致在 `src/cli.ts:544-595` 区域)。
### Claude Code(一段话,直接粘贴)
```text
Install agentmemory: run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server and its pinned iii engine. Then run `/plugin marketplace add rohitg00/agentmemory` and `/plugin install agentmemory` — the plugin registers all 12 hooks, 17 skills, AND auto-wires the `@agentmemory/mcp` stdio server via its `.mcp.json`, so you get 54 MCP tools (memory_smart_search, memory_save, memory_sessions, memory_governance_delete, etc.) without any extra config step. Verify with `curl http://localhost:3111/agentmemory/health`. The real-time viewer is at http://localhost:3113. Keyless mode disables vectors: `memory_recall` uses BM25, and `memory_smart_search` can also use existing structural graph data. Set `EMBEDDING_PROVIDER=local` in `~/.agentmemory/.env` and restart to opt into on-device semantic recall.
```
#### Claude Code 不使用插件安装(MCP 独立路径)
如果你直接通过 `~/.claude.json` 接入 agentmemory 的 MCP 服务器,而不是使用 `/plugin install`,Claude Code 永远不会解析 `${CLAUDE_PLUGIN_ROOT}`,你必须把 hook 脚本指向 `~/.claude/settings.json` 中的绝对路径。这些路径通常会嵌入 agentmemory 的版本号(例如 `~/.codex/plugins/cache/agentmemory/agentmemory/0.9.22/scripts/…`),因此下一次升级会悄悄破坏所有 hooks。
变通方法:
```bash
agentmemory connect claude-code --with-hooks
```
这会把同样的 hook 命令合并进 `~/.claude/settings.json`,绝对路径会解析到当前安装的 `@agentmemory/agentmemory` 包自带的 `plugin/` 目录。升级 agentmemory 之后重新运行该命令以刷新路径。同一文件中的用户条目会被保留;只会替换之前的 agentmemory 条目。仍然推荐使用 `/plugin install` 路径。
对于远程或受保护的部署,启动 Claude Code 时设置好 `AGENTMEMORY_URL` 和 `AGENTMEMORY_SECRET`。插件会把这两个值传递给它捆绑的 MCP 服务器;当 `AGENTMEMORY_URL` 为空时,MCP shim 会使用 `http://localhost:3111`。
### Codex CLI(Codex 插件平台)
```bash
# 1. start the memory server in a separate terminal
npx -y @agentmemory/agentmemory@latest
# 2. register the agentmemory marketplace and install the plugin
codex plugin marketplace add rohitg00/agentmemory
codex plugin add agentmemory@agentmemory
```
Codex 插件来自与 Claude Code 插件相同的 `plugin/` 目录。它会注册:
- 一个捆绑的 stdio MCP 桥接,直接连接到正在运行的守护进程,无需 npm 下载,也没有回退存储。参见[本地 Codex 指南](../docs/plugins/codex-local.md)以测试尚未发布的构建。
- 6 个生命周期 hooks:`SessionStart`、`UserPromptSubmit`、`PreToolUse`、`PostToolUse`、`PreCompact`、`Stop`
- 9 个可调用 skills:`/recall`、`/remember`、`/session-history`、`/forget`、`/recap`、`/handoff`、`/lesson`、`/commit-context`、`/commit-history`,再加上 8 个代理按需加载的参考 skills(记忆准则、MCP 工具、REST API、配置、代理、hooks、架构,以及 skill 编写指南)
Codex 的 hook 引擎会把 `CLAUDE_PLUGIN_ROOT` 注入 hook 子进程(参见 [`codex-rs/hooks/src/engine/discovery.rs`](https://github.com/openai/codex/blob/main/codex-rs/hooks/src/engine/discovery.rs)),因此同样的 hook 脚本可以在两个宿主上共用,无需重复编写。Subagent / SessionEnd / Notification / TaskCompleted / PostToolUseFailure 事件是 Claude Code 专属的,不会为 Codex 注册。
#### Codex hook 信任与兼容性
原生插件 hook 分发已在 Codex CLI 0.150.1 上验证。在期待捕获生效之前,先信任插件 hooks。Desktop 的行为取决于其捆绑的运行时;在启用变通方法之前,先检查 `/hooks` 并确认已捕获到一个事件。
如果你的宿主需要全局 hooks,请把这些命令镜像进 `~/.codex/hooks.json`。当 MCP 已经配置好后,当前的连接器需要 `--force` 才能完成 hook 安装:
```bash
agentmemory connect codex --with-hooks --force
```
这会合并全局 hooks 并重写 agentmemory 的 MCP 条目,同时保留不相关的条目。在使用 `--force` 之前,先检查你自定义的 agentmemory 端点设置。升级后重新运行以刷新脚本路径。只启用原生插件 hooks 或全局副本中的一种,以避免重复捕获。
### GitHub Copilot CLI
对于 VS Code 代理模式,请参阅[Copilot MCP 与自动捕获指南](../docs/plugins/copilot.md#vs-code-copilot-local-agent-sessions)。CLI 连接器不会配置 VS Code。
```bash
# MCP-only wiring
agentmemory connect copilot-cli
# Alternatively, full hooks/skills plugin from the GitHub subdir
copilot plugin install rohitg00/agentmemory:plugin
```
`agentmemory connect copilot-cli` 会把 `mcpServers.agentmemory` 合并进 `~/.copilot/mcp-config.json`(当设置了 `COPILOT_HOME` 时则是 `$COPILOT_HOME/mcp-config.json`),并保留已有的服务器。在原生 Windows 上,这是唯一自动化的 `connect` 适配器;其他所有原生 Windows 代理都需要手动配置。只有当目标代理也安装在同一个 WSL 环境中时,WSL 下的 `connect` 才受支持。Copilot 会在下次启动或执行 `/mcp` 后拾取这个 MCP 服务器。如果你想要完整的 hook/skill 体验,还需要安装插件。
OpenClaw(粘贴这段提示词)
```text
Install agentmemory for OpenClaw. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to my OpenClaw MCP config so agentmemory is available with all 54 memory tools:
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
Restart OpenClaw. Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper memory-slot integration, copy `integrations/openclaw` to `~/.openclaw/extensions/agentmemory` and enable `plugins.slots.memory = "agentmemory"` in `~/.openclaw/openclaw.json`.
```
完整指南:[`integrations/openclaw/`](../integrations/openclaw/)
Hermes Agent(粘贴这段提示词)
```text
Install agentmemory for Hermes. Run `npx -y @agentmemory/agentmemory@latest` in a separate terminal to start the memory server on localhost:3111. Then add this to ~/.hermes/config.yaml so Hermes can use agentmemory as an MCP server with all 54 memory tools:
mcp_servers:
agentmemory:
command: npx
args: ["-y", "@agentmemory/mcp"]
memory:
provider: agentmemory
Verify with `curl http://localhost:3111/agentmemory/health`. Open http://localhost:3113 for the real-time viewer. For deeper 6-hook memory provider integration (pre-LLM context injection, turn capture, MEMORY.md mirroring, system prompt block), copy integrations/hermes from the agentmemory repo to ~/.hermes/plugins/agentmemory.
```
完整指南:[`integrations/hermes/`](../integrations/hermes/)
### 其他代理
启动记忆服务器:`npx -y @agentmemory/agentmemory@latest`
#### 通过 `npx skills add` 安装原生 skills(50+ 代理)
agentmemory 以 Claude-Code 风格的 `/SKILL.md` 格式提供 17 个 skills:9 个可调用的操作型 skills(`remember`、`recall`、`recap`、`handoff`、`forget`、`lesson`、`commit-context`、`commit-history`、`session-history`)以及 8 个代理按需加载的参考 skills(`memory-discipline`、`agentmemory-mcp-tools`、`agentmemory-rest-api`、`agentmemory-config`、`agentmemory-agents`、`agentmemory-hooks`、`agentmemory-architecture`、`write-agentmemory-skill`)。参考 skills 携带的数据表是从源码生成的,因此不会出现偏差。vercel-labs 开发的 [`skills`](https://npmjs.com/package/skills) CLI 会自动把它们安装到调用方代理的原生 skill 目录,覆盖 50+ 个代理(Claude Code、Cursor、Cline、Continue、Droid、Warp、Codex、Antigravity、Kiro、OpenCode、Goose、Roo、Trae、Windsurf 等):
```bash
npx skills add rohitg00/agentmemory -y # auto-detects the calling agent
npx skills add rohitg00/agentmemory -y -a warp # explicit agent
npx skills add rohitg00/agentmemory -y -a '*' # install to every installed agent
```
这与 `agentmemory connect ` 是**互补**的:
- `agentmemory connect ` 写入 MCP 服务器配置,让工具可用。
- `npx skills add rohitg00/agentmemory` 安装 skills,让代理知道何时调用它们。
对于 skills CLI 尚未覆盖的少数代理(Zed v1.3.x 及更低版本),自己把 17 个 SKILL.md 文件放到代理的原生 skill 目录下即可;同样的格式在各处都适用。
#### 标准 MCP 块
对于每一个使用 `mcpServers` 形状的宿主(Cursor、Claude Desktop、Cline、Roo Code、Gemini CLI、OpenClaw),agentmemory 的条目都是**同一个 MCP 服务器块**:
```json
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "${AGENTMEMORY_URL}",
"AGENTMEMORY_SECRET": "${AGENTMEMORY_SECRET}"
}
}
```
**把这个条目合并进宿主配置文件中已有的 `mcpServers` 对象**;不要替换整个文件。如果文件里已经有其他服务器,把 `agentmemory` 作为 `mcpServers` 内的另一个键添加在它们旁边。如果 `mcpServers` 完全不存在,把这个代码块粘贴进 `{ "mcpServers": { ... } }` 内部。`${VAR}` 占位符会在 MCP 服务器启动时从 shell 继承 `AGENTMEMORY_URL` / `AGENTMEMORY_SECRET`;未设置的变量会传入空字符串,shim 会回退到 `http://localhost:3111`。接好一个条目即可同时覆盖本地和远程(k8s / 反向代理)部署。
| 代理 | 配置文件 | 说明 |
|---|---|---|
| **Cursor(仅 MCP)** | `~/.cursor/mcp.json` | 合并进 `mcpServers`,或使用 `agentmemory connect cursor`。官网上也提供一键深链接。 |
| **Cursor(完整插件)** | `.cursor-plugin/` | Cursor Marketplace 列表(提交审核中)或 Cursor Settings → Plugins → 本地 checkout。注册 7 个自动捕获 hooks(sessionStart、beforeSubmitPrompt、preToolUse、postToolUse、postToolUseFailure、stop、sessionEnd)+ 17 个 skills + MCP 服务器,`AGENTMEMORY_URL` / `AGENTMEMORY_SECRET` 在 Cursor 的插件面板中管理。适用于 Cursor IDE 和 `cursor-agent` CLI;CLI 的 print 模式提示词会在会话结束时从会话记录回填。 |
| **Claude Desktop** | `claude_desktop_config.json`(Application Support) | 合并进 `mcpServers`。编辑后重启 Claude Desktop。 |
| **Cline / Roo Code / Kilo Code** | Cline MCP 设置(Settings UI → MCP Servers → Edit) | 同样的 `mcpServers` 代码块。 |
| **Devin CLI(MCP + hooks)** | `~/.config/devin/config.json` | `agentmemory connect devin` 会合并 MCP 条目;`--with-hooks` 会添加六个原生自动捕获 hooks(SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、Stop、SessionEnd),并使用 Devin 的小写工具匹配器。用 `devin mcp list` 以及 devin 内部的 `/hooks` 验证。 |
| **Devin CLI(完整插件)** | `plugin/.devin-plugin/` | 在 checkout 中运行 `devin plugins install ./plugin`,会把全部 17 个 skills 注册为 `/agentmemory:` 斜杠命令,并加上 MCP 服务器。Devin 的插件 hooks 无法触发 `SessionStart`/`SessionEnd`,所以要配合 `connect devin --with-hooks` 才能实现完整的会话捕获。 |
| **Devin(云端)** | Settings → Connections → MCP servers | 添加一个自定义 MCP(STDIO):命令 `npx`,参数 `-y @agentmemory/mcp@latest`,环境变量 `AGENTMEMORY_URL` 指向一个网络可达的 agentmemory 部署,再加上 `AGENTMEMORY_SECRET`(云端会话无法访问 localhost —— 见 [`deploy/`](../deploy/))。把密钥存进 Devin Secrets,然后用 "Test listing tools" 验证全部 54 个工具都出现了。 |
| **Gemini CLI** | `~/.gemini/settings.json` | `gemini mcp add agentmemory npx -y @agentmemory/mcp --scope user`(自动合并)。 |
| **GitHub Copilot CLI(仅 MCP)** | `~/.copilot/mcp-config.json` | `agentmemory connect copilot-cli` 会合并 `mcpServers.agentmemory`;Copilot 会在下次启动或执行 `/mcp` 后拾取它。 |
| **GitHub Copilot CLI(完整插件)** | Copilot 插件安装 | 运行 `copilot plugin install rohitg00/agentmemory:plugin` 安装来自 GitHub 子目录的插件。 |
| **OpenClaw** | OpenClaw MCP 配置 | 同样的 `mcpServers` 代码块。更深度的用法:`openclaw plugins install ./integrations/openclaw` 会接管 OpenClaw 的记忆槽位(自动从 `memory-core` 切换过来);需要设置 `plugins.entries.agentmemory.hooks.allowConversationAccess=true`,否则轮次捕获会被静默阻止。见 [`integrations/openclaw`](../integrations/openclaw/)。 |
| **Codex CLI(仅 MCP)** | `.codex/config.toml` | TOML 形状:`codex mcp add agentmemory -- npx -y @agentmemory/mcp`,或手动添加 `[mcp_servers.agentmemory]`。 |
| **Codex CLI(完整插件)** | Codex 插件市场 | 先 `codex plugin marketplace add rohitg00/agentmemory`,再 `codex plugin add agentmemory@agentmemory`。会注册 MCP + 6 个生命周期 hooks + 17 个 skills。请在你的宿主上信任 hooks 并验证捕获是否生效;参见[Codex 设置与验证](../docs/plugins/codex-local.md)。 |
| **OpenCode(仅 MCP)** | `opencode.json` | 形状不同:顶层的 `mcp` 键,命令是一个数组:`{"mcp": {"agentmemory": {"type": "local", "command": ["npx", "-y", "@agentmemory/mcp"], "enabled": true}}}`。 |
| **OpenCode(完整插件)** | `plugin/opencode/` | 22 个自动捕获 hooks,覆盖会话生命周期、消息、工具、错误。项目归属是按会话计算的,所以一个跨越多个仓库的 OpenCode 进程会把每个会话归档到各自的项目下。两个斜杠命令(`/recall`、`/remember`)。把 `plugin/opencode/` 复制到你的 OpenCode 工作区,并把插件条目添加进 `opencode.json`。完整的 hook 表 + 差距分析见 [`plugin/opencode/README.md`](../plugin/opencode/README.md)。 |
| **pi** | `~/.pi/agent/extensions/agentmemory` | `agentmemory connect pi` 会把捆绑的扩展安装到 pi 的自动发现目录(代理启动时召回,代理结束时捕获,`memory_search` / `memory_save` / `memory_health` 工具,`/agentmemory-status`)。在正在运行的 pi 中执行 `/reload` 即可拾取。[`integrations/pi`](../integrations/pi/) 本身也是一个 pi 包(在 checkout 中运行 `pi install ./integrations/pi`)。 |
| **Hermes Agent** | `~/.hermes/config.yaml` | `cp -r integrations/hermes ~/.hermes/plugins/agentmemory` 加上 `memory.provider: agentmemory`,即可获得这个 6-hook 的记忆提供者(预取、轮次捕获、会话结束、预压缩、MEMORY.md 镜像、系统提示词代码块)。用 `hermes plugins doctor` 和 `hermes memory status` 验证。见 [`integrations/hermes`](../integrations/hermes/)。 |
| **Qwen Code** | `~/.qwen/settings.json` | `agentmemory connect qwen` 写入标准的 `mcpServers` 代码块。Hook 负载的字段与 Claude Code 兼容,所以已有的 12-hook 脚本无需修改即可使用;在同一个 `settings.json` 的 `hooks` 部分接入它们。 |
| **Antigravity IDE / 2.0** | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity --with-hooks` 会在共享的自定义目录中安装 MCP 和捕获 hooks。参见[Antigravity 设置与限制](../docs/plugins/antigravity.md)。 |
| **Antigravity CLI**(`agy`) | `~/.gemini/config/mcp_config.json` | `agentmemory connect antigravity-cli --with-hooks` 使用与当前 IDE 版本相同的 MCP 和 hook 配置。现有安装应使用 `--force` 刷新;参见[升级说明](../docs/plugins/antigravity.md)。 |
| **Kiro** | `~/.kiro/settings/mcp.json` | `agentmemory connect kiro` 写入用户级配置。工作区级覆盖放在代码旁边的 `.kiro/settings/mcp.json` 中。 |
| **Warp** | `~/.warp/.mcp.json` | `agentmemory connect warp` 写入标准的 `mcpServers` 代码块。Warp 还会从 `.claude/skills/` 自动发现 skills;一旦安装了 Claude Code 插件,8 个 agentmemory skills(`remember`、`recall`、`recap`、`handoff`、`forget`、`commit-context`、`commit-history`、`session-history`)就会原生出现在 Warp 的斜杠命令面板中。 |
| **Cline(CLI)** | `~/.cline/mcp.json` | `agentmemory connect cline` 写入标准的 `mcpServers` 代码块。VS Code 插件用户:通过 Cline Settings → MCP Servers → Edit JSON 粘贴同样的代码块。 |
| **Continue.dev** | `~/.continue/config.yaml`(优先)或 `config.json`(旧版) | 当两者都不存在时,`agentmemory connect continue` 会从零创建 `config.yaml`;如果存在 `config.json` 则修改它。**如果你已经有 `config.yaml`**,适配器会打印出要粘贴到 `mcpServers:` 下的确切代码块;它不会悄悄重写你的 yaml,因为要安全地保留注释和锚点,需要这个包没有附带的 YAML 解析器。Continue 的 `mcpServers` 用的是数组形式(不是对象)。 |
| **Zed** | `~/.config/zed/settings.json` | `agentmemory connect zed` 写入 `context_servers` 下(这是 Zed 自己的键,不是 `mcpServers`)。远程 MCP 服务器也可以改用 `{"url": "..."}` 接入。 |
| **Droid(Factory.ai)** | `~/.factory/mcp.json` | `agentmemory connect droid` 写入标准的 `mcpServers` 代码块。项目级覆盖放在 `/.factory/mcp.json` 中。传入 `--with-hooks` 启用原生自动捕获。 |
| **DeepSeek Harness** | `$DSH_HOME/cordis.patch.yml` | `agentmemory connect dsh` 会在每个 Harness 配置都会加载的主目录级补丁层中追加一行 `@deepseek-ai/dsh-mcp-client`;工具注册为 `mcp__agentmemory__*`。传入 `--with-hooks` 还可以接入自动捕获:捆绑的 Claude Code hook 脚本会通过 Harness 自带的 `@deepseek-ai/dsh-hooks-claude-code` 桥接层运行(SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、Stop),配置清单写入 `$DSH_HOME/agentmemory.hooks.json`。当 `DSH_HOME` 未设置时默认为 `~/.dsh`。 |
| **Goose** | Goose MCP 设置界面 | 同样的 `mcpServers` 代码块;使用 `goose configure` → Add Extension → MCP。也支持直接编辑 `~/.config/goose/config.yaml`,但其 schema 用的是 `extensions:` + `cmd`(不是 `mcpServers:` + `command`)。 |
| **Aider** | 不适用 | 直接调用 REST API:`curl -X POST http://localhost:3111/agentmemory/smart-search -d '{"query": "auth"}'`。 |
| **任意代理(32+)** | 不适用 | `npx skillkit install agentmemory` 会自动检测宿主并合并配置。 |
**沙箱化的 MCP 客户端**(Flatpak / Snap / 限制性容器)如果无法访问宿主的 `localhost`:也在 `env` 代码块中设置 `"AGENTMEMORY_FORCE_PROXY": "1"`,并把 `AGENTMEMORY_URL` 指向沙箱真正能访问到的地址(例如你的局域网 IP)。
### 编程式访问(Python / Rust / Node)
agentmemory 把它的核心操作注册为 iii 函数(`mem::remember`、`mem::observe`、`mem::context`、`mem::smart-search`、`mem::forget`)。任何有 iii SDK 的语言都可以通过 `ws://localhost:49134` 直接调用它们,不需要为每种语言单独写一个 REST 客户端。
```bash
pip install iii-sdk # Python
cargo add iii-sdk # Rust
npm install iii-sdk # Node
```
```python
from iii import register_worker
iii = register_worker("ws://localhost:49134")
iii.connect()
iii.trigger({
"function_id": "mem::smart-search",
"payload": {"project": "demo", "query": "how do tokens refresh"},
})
```
完整示例见:[`examples/python/`](../examples/python/)(快速开始 + 观测/召回流程)。对于没有 iii 运行时的宿主,`:3111` 上的 REST 仍然可用。
### 从源码构建
```bash
git clone https://github.com/rohitg00/agentmemory.git && cd agentmemory
npm install && npm run build && npm start
```
如果已经安装了锚定的二进制文件,这会用本地的 `iii-engine` 启动 agentmemory;如果选择了 Docker Compose,则用它启动。REST、流和查看器默认绑定到 `127.0.0.1`。macOS/Linux 的自动二进制安装路径需要 `curl`、POSIX `sh` 和 `tar`。
手动安装 `iii-engine`。**agentmemory 目前把 `iii-engine` 锚定在 `v0.22.1`**,与它依赖的 `iii-sdk` 是同一个发行版;worker 说的是该引擎版本的通信协议,而 0.20.0 重组了 SDK 的接口面,所以这两者在 agentmemory 的发行版中要一起移动。如果你运行自己的引擎并确认它匹配,可以用 `AGENTMEMORY_III_VERSION=` 覆盖。
- **macOS arm64:** `mkdir -p ~/.local/bin && curl -fsSLo iii.tar.gz https://github.com/iii-hq/iii/releases/download/iii/v0.22.1/iii-aarch64-apple-darwin.tar.gz && echo "2b309019b909a896cae874dc947e2cdf877b4f3c51dd026b79850af858517fa4 iii.tar.gz" | shasum -a 256 -c - && tar -xzf iii.tar.gz -C ~/.local/bin && chmod +x ~/.local/bin/iii`
- **macOS x64:** 把 `aarch64-apple-darwin` 换成 `x86_64-apple-darwin`
- **Linux x64:** 换成 `x86_64-unknown-linux-gnu`
- **Linux arm64:** 换成 `aarch64-unknown-linux-gnu`
- **Windows:** 从 [iii-hq/iii releases v0.22.1](https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1) 下载 `iii-x86_64-pc-windows-msvc.zip`,并把 `iii.exe` 解压到 `%USERPROFILE%\.agentmemory\bin\iii.exe`
发布页面上每个压缩包都有一个对应的 `.sha256` 文件;当你切换平台时,在上面的校验中使用该文件给出的哈希值(Windows 上用 `Get-FileHash`)。`npx @agentmemory/agentmemory` 中的自动安装程序锚定了这些哈希值,并会拒绝不匹配的压缩包。
或者使用 Docker(捆绑的 `docker-compose.yml` 会拉取 `iiidev/iii:0.22.1`)。完整文档:[iii.dev/docs](https://iii.dev/docs)。
### Windows
agentmemory 可以在 Windows 10/11 上运行,但光有 Node.js 包是不够的;你还需要让锚定的 iii-engine v0.22.1 运行时作为后台进程运行。CLI 不会自动解压 Windows 的 ZIP,所以原生 Windows 用户必须手动安装 `iii.exe`,或者使用 WSL2,或者选择 Docker Desktop。
原生 Windows 上自动化的 MCP 接入只支持 `agentmemory connect copilot-cli`。对于 Claude Code、Codex、Cursor 以及其他所有原生 Windows 代理,把 [其他代理](#other-agents) 中手动的 MCP 代码块复制进该代理的 Windows 配置中。只有当目标代理也安装在同一个 WSL 环境中时,在 WSL 中运行 `connect` 才合适;它不会编辑 Windows 宿主上的代理配置。
**方案 A:预编译 Windows 二进制文件(推荐)**
```powershell
# 1. Open https://github.com/iii-hq/iii/releases/tag/iii%2Fv0.22.1 in your browser
# (agentmemory pins the engine to the same release as its iii-sdk;
# v0.22.1 is the current pair)
# 2. Download iii-x86_64-pc-windows-msvc.zip
# (or iii-aarch64-pc-windows-msvc.zip if you're on an ARM machine)
# 3. Extract iii.exe to agentmemory's private engine directory:
New-Item -ItemType Directory -Force "$HOME\.agentmemory\bin"
# Copy iii.exe to $HOME\.agentmemory\bin\iii.exe
# 4. Verify:
& "$HOME\.agentmemory\bin\iii.exe" --version
# Should print: 0.22.1
# 5. Then run agentmemory as usual:
npx -y @agentmemory/agentmemory@latest
```
**方案 B:Docker Desktop**
```powershell
# 1. Install Docker Desktop for Windows
# 2. Start Docker Desktop and make sure the engine is running
# 3. Select Docker explicitly and run agentmemory:
$env:AGENTMEMORY_USE_DOCKER = "1"
npx -y @agentmemory/agentmemory@latest
```
**方案 C:仅独立 MCP(不需要引擎)。** 如果你的代理只需要 MCP 工具,不需要 REST API、查看器或定时任务,可以完全跳过引擎:
```powershell
npx -y @agentmemory/agentmemory@latest mcp
# or via the shim package:
npx -y @agentmemory/mcp
```
**Windows 诊断:** 如果 `npx -y @agentmemory/agentmemory@latest` 失败,加上 `--verbose` 重新运行以查看引擎实际的 stderr。常见的失败模式:
| 症状 | 解决方法 |
|---|---|
| `The engine process started but the REST API never responded.` | 确认四个派生端口都是空闲的,验证锚定的 `iii.exe` 是否仍在运行,然后加上 `--verbose` 重新运行并检查捕获到的引擎 stderr |
| `Could not start iii-engine` | `iii.exe` 和 Docker 都没有安装。见上面的方案 A 或 B |
| 端口冲突 | 用 `netstat -ano \| findstr :3111` 查看占用情况,然后结束该进程或使用 `--port ` |
| 即使安装了 Docker,也跳过了 Docker 回退 | 确认 Docker Desktop 确实在运行(系统托盘图标) |
> 注意:iii **引擎**是一个预编译的二进制文件,不是 cargo crate,所以不要尝试 `cargo install` 它。(iii **SDK** 发布在 crates.io、npm 和 PyPI 上,但 agentmemory 不需要它们。)受支持的引擎安装方式都锚定在 v0.22.1:上面的预编译二进制文件、agentmemory 的 macOS/Linux 自动安装路径(需要 `curl`、POSIX `sh` 和 `tar`),以及 Docker 镜像 `iiidev/iii:0.22.1`。直接运行上游的 `install.sh | sh` 会安装最新版引擎,agentmemory 不支持这种方式。请使用 `npx -y @agentmemory/agentmemory@latest`;在 macOS/Linux 上,它会把锚定的引擎拉取到 `~/.agentmemory/bin`。
---
部署
面向托管宿主的一键模板。每一个模板都自带一个独立的
Dockerfile,从 npm 拉取 `@agentmemory/agentmemory`,再从官方的
`iiidev/iii` Docker Hub 镜像中复制 iii 引擎二进制文件;不需要预先
构建好的 agentmemory 镜像。持久化存储挂载在 `/data`;首次启动的
entrypoint 会用一份针对部署场景调优过的配置覆盖 npm 自带的 iii
配置(原配置绑定 `127.0.0.1`),新配置绑定 `0.0.0.0` 并使用绝对的
`/data` 路径,生成 HMAC 密钥,然后在执行 agentmemory CLI 之前通过
`gosu` 把权限从 `root` 降级到 `node`。
Render 的一键部署按钮需要仓库根目录下有 `render.yaml`,而我们刻意保持根目录干净。请使用 [`deploy/render/`](.././deploy/render/README.md) 中记录的 Render Blueprint 流程,手动指向仓库内的 blueprint。
完整的设置细节(HMAC 捕获、查看器 SSH 隧道、密钥轮换、备份、
最低成本)见 [`deploy/`](.././deploy/README.md):
- [`deploy/fly`](.././deploy/fly/README.md):单机,
`auto_stop_machines = "stop"`;空闲时最省钱。
- [`deploy/railway`](.././deploy/railway/README.md):Hobby 套餐固定费用,
在控制面板中配置卷。
- [`deploy/render`](.././deploy/render/README.md):Blueprint 流程,
付费套餐下自动磁盘快照。
- [`deploy/coolify`](.././deploy/coolify/README.md):通过
[Coolify](https://coolify.io/self-hosted) 自托管在你自己的 VPS 上;
同样的 Docker Compose 技术栈,主机和数据都归你所有。
只会发布 `3111` 端口。容器内 `3113` 上的查看器仍然绑定在
回环地址上;每个模板的 README 都记录了用于访问它的 SSH 隧道模式。
---

每个编码代理在会话结束时都会忘记一切,每个新会话开始时你都要重新解释你的技术栈。agentmemory 在后台运行,免去了这一步。
```text
Session 1: "Add auth to the API"
Agent writes code, runs tests, fixes bugs
agentmemory silently captures every tool use
Session ends -> observations compressed into structured memory
Session 2: "Now add rate limiting"
Agent already knows:
- Auth uses JWT middleware in src/middleware/auth.ts
- Tests in test/auth.test.ts cover token validation
- You chose jose over jsonwebtoken for Edge compatibility
Zero re-explaining. Starts working immediately.
```
### 对比内建代理记忆
每个 AI 编码代理都自带内建记忆:Claude Code 有 `MEMORY.md`,Cursor 有 notepads,Cline 有 memory bank。它们的作用就像便利贴。agentmemory 则是便利贴背后那个可搜索的数据库。
| | 内建(CLAUDE.md) | agentmemory |
|---|---|---|
| 规模 | 200 行上限 | 无限 |
| 搜索 | 把所有内容加载进上下文 | BM25 + 向量 + 图(仅 top-K) |
| Token 成本 | 240 条观测达 22K+ | ~1,900 tokens(减少 92%) |
| 跨代理 | 每代理一个文件 | MCP + REST(任意代理) |
| 协调 | 无 | 租约、信号、动作、例程 |
| 可观测性 | 手动读取文件 | :3113 上的实时查看器 |
---

### 记忆流水线
```text
PostToolUse hook fires
-> SHA-256 dedup (5min window)
-> Privacy filter (strip secrets, API keys)
-> Store raw observation
-> Synthetic compression by default
(LLM-written compression only with a provider + AGENTMEMORY_AUTO_COMPRESS=true)
-> Vector embedding when an embedding provider is active
-> Index in BM25, plus vectors when enabled
Stop / SessionEnd hook fires
-> Summarize session
-> Knowledge graph extraction (if GRAPH_EXTRACTION_ENABLED=true)
-> Slot reflection (if SLOT_REFLECT_ENABLED=true)
SessionStart hook fires
-> Load project profile (top concepts, files, patterns)
-> Hybrid search (BM25 + vector + graph)
-> Token budget (default: 2000 tokens)
-> Inject into conversation
```
### 4 层记忆整合
参照人脑处理记忆的方式建模,包括睡眠期间的记忆整合。
| 层级 | 内容 | 类比 |
|------|------|---------|
| **Working(工作记忆)** | 来自工具使用的原始观测 | 短期记忆 |
| **Episodic(情景记忆)** | 压缩后的会话摘要 | "发生了什么" |
| **Semantic(语义记忆)** | 提取出的事实与模式 | "我知道什么" |
| **Procedural(程序记忆)** | 工作流与决策模式 | "怎么做" |
记忆会随时间衰减(Ebbinghaus 曲线)。频繁访问的记忆会被强化。陈旧的记忆会自动被清除。矛盾会被检测并解决。
### 捕获了什么
| Hook | 捕获内容 |
|------|----------|
| `SessionStart` | 项目路径、会话 ID |
| `UserPromptSubmit` | 用户提示词(隐私过滤) |
| `PreToolUse` | 文件访问模式 + 富化上下文 |
| `PostToolUse` | 工具名、输入、输出 |
| `PostToolUseFailure` | 错误上下文 |
| `PreCompact` | 在压缩前重新注入记忆 |
| `SubagentStart/Stop` | 子代理生命周期 |
| `Stop` | 会话结束摘要 |
| `SessionEnd` | 会话完成标记 |
### 关键能力
| 能力 | 描述 |
|---|---|
| **自动捕获** | 每次工具使用都通过 hooks 记录,无需人工 |
| **语义搜索** | BM25 + 向量 + 知识图谱,RRF 融合 |
| **记忆演化** | 版本控制、覆盖关系、关系图 |
| **召回卫生** | 被取代的记忆版本会离开搜索索引;KV 中的版本链保留完整历史 |
| **近重复提示** | 当新内容与既有记忆高度相似时,保存操作会返回建议性的 `similarTo` 匹配 |
| **按代理作用域** | `agentId` 贯穿 REST、MCP 和搜索索引的保存与召回,支持共享或隔离模式 |
| **写入时溯源** | 每条观测和记忆都携带在捕获、保存和导入时标记的不可变来源渠道(user、agent、tool、import 或 shared) |
| **自动遗忘** | TTL 过期、矛盾检测、重要性驱逐 |
| **隐私优先** | API key、secret、`` 标签存储前被剥离 |
| **自愈** | 熔断器、提供者回退链、健康监控 |
| **Claude 桥接** | 与 MEMORY.md 双向同步 |
| **知识图谱** | 实体抽取 + BFS 遍历 |
| **团队记忆** | 团队成员之间的命名空间共享 + 私有 |
| **引用溯源** | 任意记忆追溯到源观测 |
| **Git 快照** | 记忆状态的版本、回滚、diff |
---

三流检索,结合三种信号:
| 流 | 作用 | 何时启用 |
|---|---|---|
| **BM25** | 词干化关键词匹配 + 同义词扩展 | 始终启用 |
| **Vector(向量)** | 稠密嵌入上的余弦相似度 | 配置了嵌入提供者 |
| **Graph(图)** | 通过实体匹配进行知识图谱遍历 | 查询中检测到实体 |
通过 Reciprocal Rank Fusion(RRF,k=60)融合,并按会话多样化(每个会话最多 3 条结果)。
当向量索引已经建好时,`mem::search`(`memory_recall` 背后的实现)使用混合 BM25 + 向量排序器。没有嵌入时它使用 BM25。当图数据存在时,`smart-search` 还可以额外融合结构化的图匹配结果,即使在无密钥模式下也是如此。经验教训召回运行在一个专用的内存 BM25 索引上,而不是每次查询都扫描整个语料库。被取代的记忆版本会被排除在每条召回路径之外;版本链保留它们的历史。
向量可以在崩溃或强制终止后存活下来。向量索引最多每隔 `AGENTMEMORY_INDEX_SAVE_INTERVAL_MS`(10 分钟)就会按桶保存一次。在此期间新增或删除的每个向量也会立刻写入状态存储中的一个小型待处理日志,下次启动时会重放这个日志而不调用嵌入提供者。每次成功保存都会清空这个日志。重放之后仍然没有向量的文档会在后台按 `AGENTMEMORY_VECTOR_BACKFILL_MAX`(500)为一批重新嵌入,直到没有遗留为止;被中断的回填会在下次启动时继续。`/agentmemory/status` 和查看器会显示待处理日志的大小和回填状态。无密钥安装不会写入任何内容。
BM25 开箱即用支持希腊语、西里尔语、希伯来语、阿拉伯语和带音标的拉丁文分词。对于中文 / 日语 / 韩语的记忆,安装可选的分词器(`npm install @node-rs/jieba tiny-segmenter`)来把 CJK 文本切分为词级 token;如果不安装,agentmemory 会软回退到整串分词,并在 stderr 上打印一次性提示。
### 嵌入提供者
无密钥安装会关闭向量嵌入:`mem::search` 使用 BM25,而 `smart-search` 还可以使用既有的结构化图数据。要启用免费的本地设备语义嵌入,把下面这一行加进 `~/.agentmemory/.env` 并重启 agentmemory:
```env
EMBEDDING_PROVIDER=local
```
常规的 npm 安装已经包含了可选的 `@huggingface/transformers` 运行时。首次嵌入请求会下载 `Xenova/all-MiniLM-L6-v2`,所以需要联网,而且耗时可能更长;之后的推理都在本地设备上运行。远程提供者会根据各自的密钥自动检测,除非 `EMBEDDING_PROVIDER` 覆盖了它们。
| 提供者 | 模型 | 成本 | 备注 |
|---|---|---|---|
| **本地(推荐选用)** | `all-MiniLM-L6-v2` | 免费 | 首次模型下载后在本地运行,召回率比仅用 BM25 高 +8pp |
| Gemini | `gemini-embedding-001` | 免费层 | 100+ 种语言,768/1536/3072 维(MRL),2048-token 输入。替代 `text-embedding-004`([已弃用,2026 年 1 月 14 日下线](https://ai.google.dev/gemini-api/docs/deprecations)) |
| OpenAI | `text-embedding-3-small` | $0.02/1M | 质量最高 |
| Voyage AI | `voyage-code-3` | 付费 | 针对代码优化 |
| Cohere | `embed-english-v3.0` | 免费试用 | 通用 |
| OpenRouter | 任意模型 | 视情况而定 | 多模型代理 |
---

54 个工具,6 个资源,3 个提示词,17 个 skills。
> **MCP shim 对比完整服务器:** 已发布的 `@agentmemory/mcp` 包是一个薄 shim。**只有当它能通过 `AGENTMEMORY_URL`(代理模式)连接到一个正在运行的 agentmemory 服务器时**,它才会暴露完整的 54 工具表面。当没有可达的服务器时,shim 会回退到一个 7 工具的本地集合(`memory_save`、`memory_recall`、`memory_smart_search`、`memory_sessions`、`memory_export`、`memory_audit`、`memory_governance_delete`)。`AGENTMEMORY_TOOLS=core|all` 环境变量是一个*服务器端*标志;在 shim 的 `env` 代码块中设置它不会有任何效果。如果你在 Cursor / OpenCode / Gemini CLI 中只看到 7 个工具,启动 `npx -y @agentmemory/agentmemory@latest`(或 Docker 技术栈),并设置 `AGENTMEMORY_URL=http://localhost:3111`。
### 54 个工具
三层工具表面,从小到大:`AGENTMEMORY_TOOLS=core` 把可见性收窄到 8 个核心工具(`memory_save`、`memory_recall`、`memory_consolidate`、`memory_smart_search`、`memory_sessions`、`memory_diagnose`、`memory_lesson_save`、`memory_reflect`);下方的基础集是注册表中的 14 个基础工具;默认设置(`AGENTMEMORY_TOOLS=all`)暴露全部 54 个。
基础工具(14 个)
| 工具 | 描述 |
|------|-------------|
| `memory_recall` | 搜索过去的观测 |
| `memory_compress_file` | 在保留结构的同时压缩 markdown 文件 |
| `memory_save` | 保存洞察、决策或模式 |
| `memory_file_history` | 关于特定文件的过去观测 |
| `memory_patterns` | 检测反复出现的模式 |
| `memory_sessions` | 列出最近的会话 |
| `memory_smart_search` | 混合语义 + 关键词搜索 |
| `memory_vision_search` | 搜索图像观测 |
| `memory_timeline` | 按时间排列的观测 |
| `memory_profile` | 项目档案(概念、文件、模式) |
| `memory_export` | 导出所有记忆数据 |
| `memory_relations` | 查询关系图 |
| `memory_commit_lookup` | 某个 git 提交背后的会话 |
| `memory_commits` | 某个会话记录的提交 |
扩展工具(共 54 个,默认表面)
| 工具 | 描述 |
|------|-------------|
| `memory_patterns` | 检测反复出现的模式 |
| `memory_timeline` | 按时间排列的观测 |
| `memory_relations` | 查询关系图 |
| `memory_graph_query` | 知识图谱遍历 |
| `memory_consolidate` | 运行 4 层整合 |
| `memory_claude_bridge_sync` | 与 MEMORY.md 同步 |
| `memory_team_share` | 与团队成员共享 |
| `memory_team_feed` | 最近共享条目 |
| `memory_audit` | 操作审计轨迹 |
| `memory_governance_delete` | 带审计轨迹的删除 |
| `memory_snapshot_create` | Git 版本快照 |
| `memory_action_create` | 创建带依赖的工作项 |
| `memory_action_update` | 更新动作状态 |
| `memory_frontier` | 按优先级排序的未阻塞动作 |
| `memory_next` | 单个最重要的下一动作 |
| `memory_lease` | 独占动作租约(多代理) |
| `memory_routine_run` | 实例化工作流例程 |
| `memory_signal_send` | 代理间消息 |
| `memory_signal_read` | 带回执读取消息 |
| `memory_checkpoint` | 外部条件门 |
| `memory_mesh_sync` | 实例间 P2P 同步 |
| `memory_sentinel_create` | 事件驱动监视器 |
| `memory_sentinel_trigger` | 外部触发哨兵 |
| `memory_sketch_create` | 临时动作图 |
| `memory_sketch_promote` | 提升为永久 |
| `memory_crystallize` | 紧凑化动作链 |
| `memory_diagnose` | 健康检查 |
| `memory_heal` | 自动修复卡住的状态 |
| `memory_facet_tag` | 维度:值 标签 |
| `memory_facet_query` | 按 facet 标签查询 |
| `memory_verify` | 追溯来源 |
### 6 个资源 · 3 个提示词 · 17 个 Skills
| 类型 | 名称 | 描述 |
|------|------|-------------|
| Resource | `agentmemory://status` | 健康、会话数、记忆数 |
| Resource | `agentmemory://project/{name}/profile` | 项目级智能 |
| Resource | `agentmemory://project/{name}/recent` | 某项目的最近观测 |
| Resource | `agentmemory://memories/latest` | 最新 10 条活跃记忆 |
| Resource | `agentmemory://graph/stats` | 知识图谱统计 |
| Resource | `agentmemory://team/{id}/profile` | 共享的团队档案 |
| Prompt | `recall_context` | 搜索并返回上下文消息 |
| Prompt | `session_handoff` | 代理之间的交接数据 |
| Prompt | `detect_patterns` | 分析反复出现的模式 |
| Skill | `/recall` | 搜索记忆 |
| Skill | `/remember` | 保存到长期记忆 |
| Skill | `/session-history` | 最近的会话摘要 |
| Skill | `/forget` | 删除观测/会话 |
表中展示的是四个核心 skills。完整集合是 9 个可调用 skills 加 8 个参考 skills;见上方的原生 skills 部分。
### 独立 MCP
无需完整服务器即可运行,适用于任何 MCP 客户端。以下两种方式都可以:
```bash
npx -y @agentmemory/agentmemory@latest mcp # canonical (always available)
npx -y @agentmemory/mcp # shim package alias
```
或者添加到你的代理的 MCP 配置中:
大多数代理(Cursor、Claude Desktop、Cline、Roo Code、Gemini CLI):
```json
{
"mcpServers": {
"agentmemory": {
"command": "npx",
"args": ["-y", "@agentmemory/mcp"],
"env": {
"AGENTMEMORY_URL": "http://localhost:3111"
}
}
}
}
```
把 `agentmemory` 条目合并进宿主已有的 `mcpServers` 对象,而不是替换整个文件。对于无法访问宿主 `localhost` 的沙箱化客户端,在 env 代码块中添加 `"AGENTMEMORY_FORCE_PROXY": "1"`,并把 `AGENTMEMORY_URL` 设置为沙箱能够访问到的地址。
OpenCode(`opencode.json`):
```json
{
"mcp": {
"agentmemory": {
"type": "local",
"command": ["npx", "-y", "@agentmemory/mcp"],
"enabled": true
}
},
"plugin": ["./plugins/agentmemory-capture.ts"]
}
```
从仓库中复制插件文件:
```bash
mkdir -p ~/.config/opencode/plugins
cp plugin/opencode/agentmemory-capture.ts ~/.config/opencode/plugins/
cp plugin/opencode/commands/*.md ~/.config/opencode/commands/
```
---

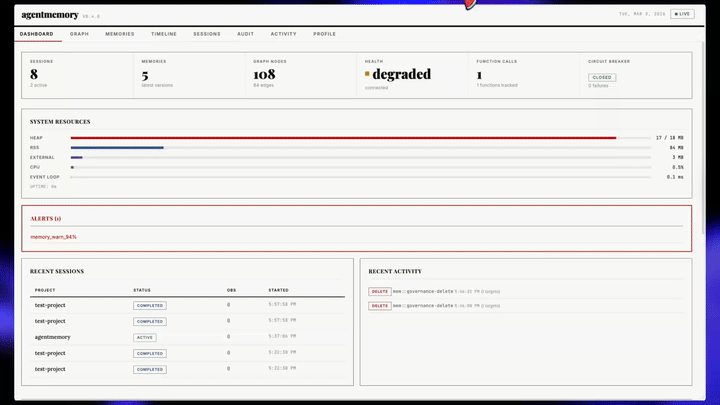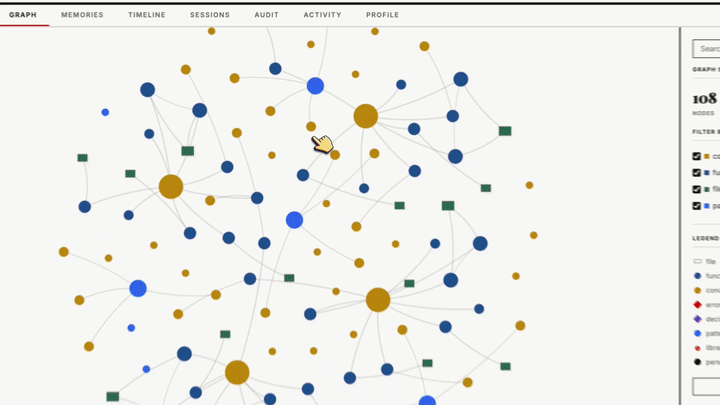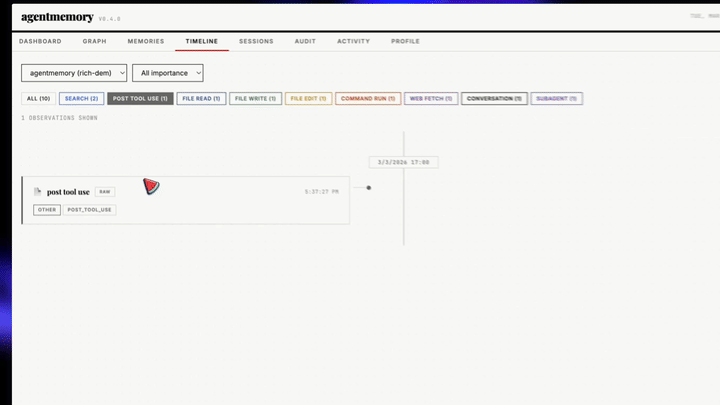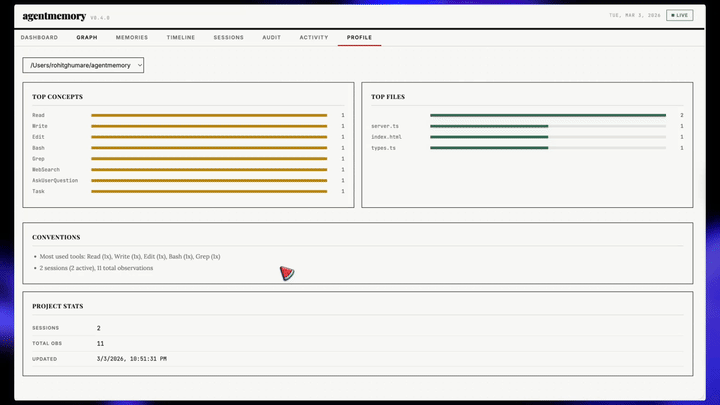
在端口 `3113` 上自动启动。查看器连接时会加载一份快照(`GET /agentmemory/viewer/snapshot`),然后应用实时流事件:新的记忆、经验教训、观测、审计条目、图变化和健康状态更新都会出现,无需轮询或刷新页面。唯一会发出的其他请求,是你点击的操作、"加载更多"分页以及搜索。当流断开时,查看器会显示当前数字已经过时了多久,然后以退避策略重连,并从一份快照重新同步。
- **分四组的 12 个标签页**,带实时计数、深度链接(`#memories/`、`#sessions/?obs=`、`#graph/`、`#health/consolidation`)、键盘快捷键和移动端菜单。
- **Memories:** 服务端搜索,按项目、代理和类型过滤,带版本链和逐词 diff 的详情面板,溯源链接,针对 id、MCP 调用和 curl 命令的复制按钮,编辑(生成新版本)、带确认的遗忘、批量遗忘和 JSON 导出。
- **Sessions:** 内嵌的观测时间线,工具输入输出可读,带过滤和分页,以及每个会话产出的记忆和经验教训。
- **Graph:** 搜索、带关系和来源的节点详情、不单纯依赖颜色的图例,以及缩放控件。
- **Health:** `GET /agentmemory/status` 的实时版本。每个问题都附带修复方法,还有状态后端、索引保存状态、图溯源压缩进度,以及带真实阈值的整合说明。
- **Audit、Activity、Profile、Replay、Lessons、Actions 和 Crystals** 页面,每个页面在空状态下都会说明这个区块是什么、为什么是空的,以及能填充它的命令,并且每个术语和数字上都有一个 `?` 词汇提示。
```bash
open http://localhost:3113
```
查看器服务器默认绑定到 `127.0.0.1`,并在把请求转发给 REST API 时附带服务器密钥,因此不需要额外设置。由 REST 提供的 `/agentmemory/viewer` 端点遵循常规的 bearer-token 规则,并会把没有 token 的浏览器重定向到查看器端口。CSP 头为每个响应使用独立的 script nonce,并禁用内联事件处理属性(`script-src-attr 'none'`)。
---
`:3113` 上的查看器展示你的代理**记住了什么**。[iii 控制台](https://iii.dev/docs/console) 展示你的代理**做了什么**:每个记忆操作都是一个 OpenTelemetry trace,每个 KV 条目都可编辑,每个函数都可调用,每个流都可挂载。同一份记忆的两个窗口:一个面向产品,一个面向引擎。
观察一次 `memory_smart_search` 的触发,以瀑布图的形式看到 BM25 扫描 → 嵌入查找 → RRF 融合 → 重排器。在 KV 浏览器中编辑一个卡住的整合计时器。用调整过的负载重放一次 `PostToolUse` hook。固定 WebSocket 流,实时观察观测落地。
agentmemory 免费提供这一切,因为每个函数调用和触发器都经由 iii 触发;没有定制,也没有需要插桩的地方。
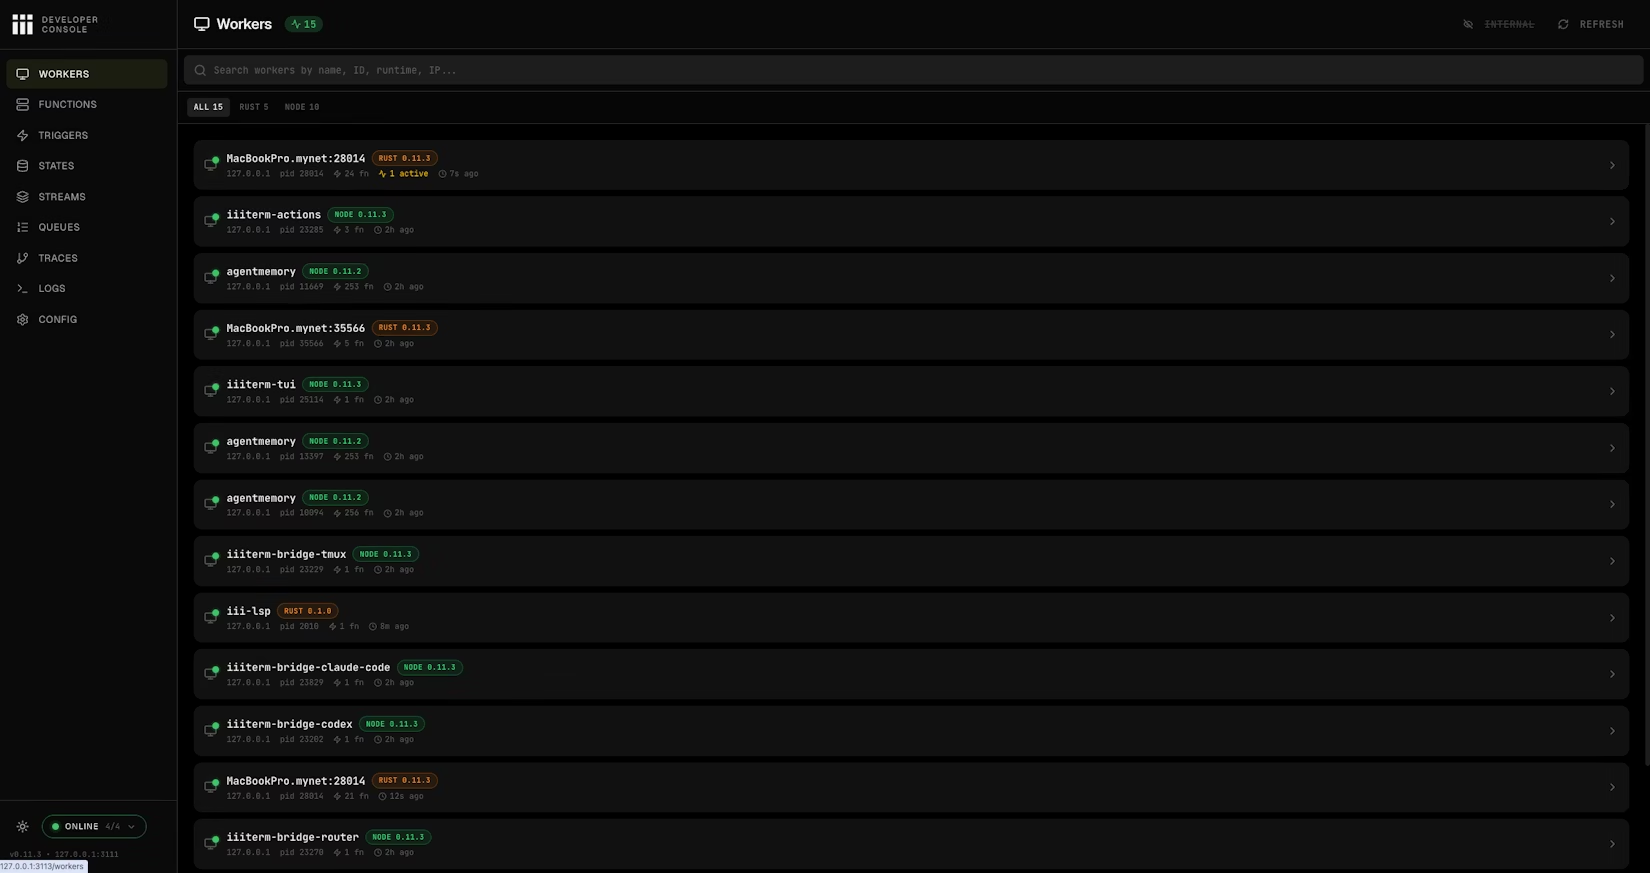
Workers 页面:每一个已连接的 worker,包括 agentmemory 本身,显示 PID、函数数量、运行时和最后在线时间。
**已经装好了。** 控制台随锚定的 `iii` 引擎(0.22+)一起发布;不需要单独安装。首次启动会在引擎旁下载控制台的二进制文件。
**与 agentmemory 并行启动:**
```bash
agentmemory console
```
这会针对 agentmemory 解析出的端口(REST、流、bridge)运行锚定引擎的 `iii console`,并把它服务在查看器端口之上的一个端口,默认是 `http://localhost:3114`。`--console-port N` 可以选择另一个端口;`--port` 和 `--instance` 以与 `stop` 相同的方式选择 agentmemory 实例;其他任何参数都会被原样传递,例如 `--enable-flow` 用于打开实验性的架构图页面。
同样的操作也可以手动完成,在 `agentmemory` 不在 PATH 上时很有用:
```bash
~/.agentmemory/bin/iii console --port 3114 \
--engine-port 3111 \
--ws-port 3112 \
--bridge-port 49134
```
**在控制台中可以做什么:**
| 页面 | 用途 |
|------|-----------|
| **Workers** | 查看每一个已连接的 worker 及其实时指标,包括 agentmemory worker 本身。 |
| **Functions** | 直接用 JSON 负载调用 agentmemory 的任意函数;方便测试 `memory.recall`、`memory.consolidate`、`graph.query`,无需接入客户端。 |
| **Triggers** | 重放 HTTP、cron、事件和状态触发器:手动触发整合用的 cron、重试某个 HTTP 路由、发出一次状态变化。 |
| **States** | 对会话、记忆槽位、生命周期计时器和嵌入索引进行完整 CRUD 的 KV 浏览器;就地编辑值。 |
| **Streams** | 实时 WebSocket 监视器,观察记忆写入、hook 事件和观测更新流经 iii 流的过程。 |
| **Queues** | 持久队列主题 + 死信管理。重放或丢弃失败的嵌入 / 压缩任务。 |
| **Traces** | OpenTelemetry 瀑布图 / 火焰图 / 服务分解视图。按 `trace_id` 过滤,精确查看一次 `memory.search` 产生了哪些函数、数据库调用和嵌入请求。 |
| **Logs** | 结构化的 OTEL 日志,按 trace/span ID 过滤并关联。 |
| **Config** | 运行时配置:精确查看你的引擎正在使用哪些 worker、提供者和端口运行。 |
| **Flow** | (可选,`--enable-flow`)每个 worker、触发器和流的交互式架构图。 |
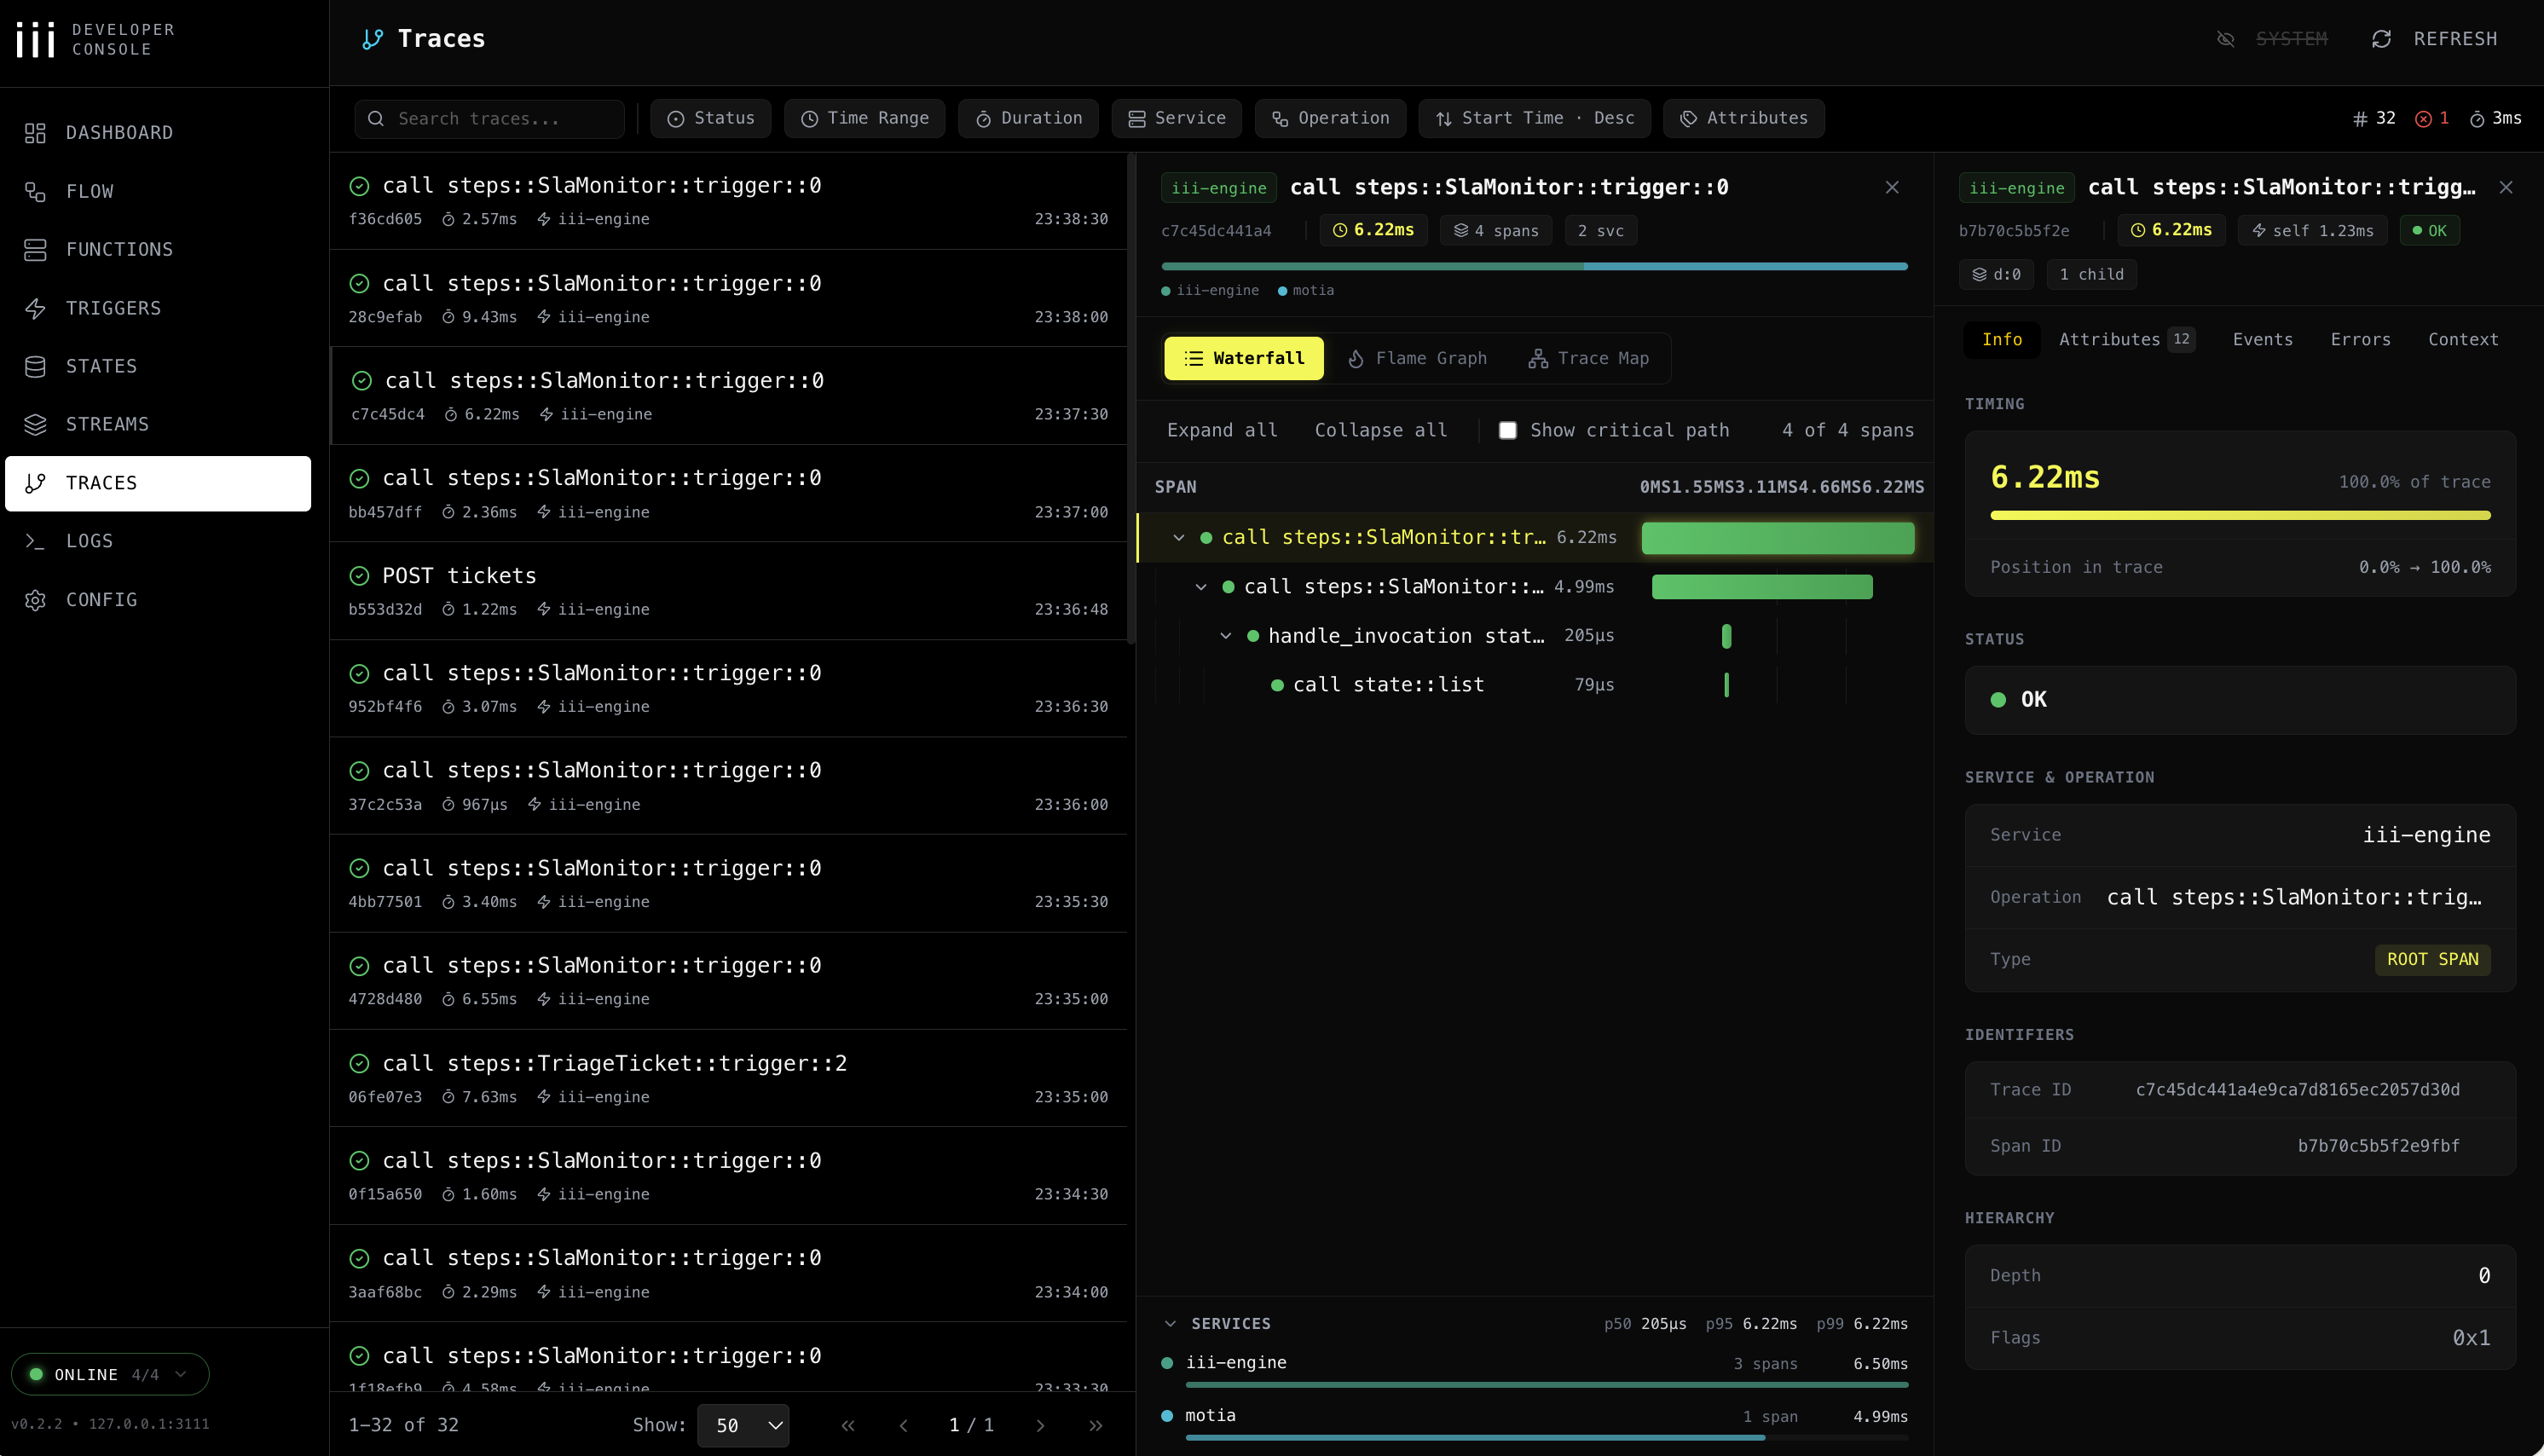
Traces:每个记忆操作的瀑布图 / 火焰图 / 服务分解。
**Traces 已经默认开启:**
`iii-config.yaml` 出厂就启用了 `iii-observability` worker(`exporter: memory`、`sampling_ratio: 0.1`、指标 + 日志)。不需要额外配置;agentmemory 启动的那一刻,每个记忆操作都会发出一条控制台可读的结构化日志,其中十分之一(`sampling_ratio: 0.1`)还会发出一个 trace span。
如果你想改为导出到 Jaeger/Honeycomb/Grafana Tempo,把 `exporter: memory` 改成 `exporter: otlp`,并按照 iii 的可观测性文档设置收集器端点。
> **提醒:** 控制台本身不强制鉴权;保持它绑定在 `127.0.0.1`(默认值)上,永远不要把它对外公开。
---

agentmemory **本身就是一个正在运行的 [iii](https://iii.dev) 实例**。三种原语(worker、函数、触发器)构成了这个运行时;KV 状态、流和 OTEL trace 来自随 iii 一同发布的 iii-state、iii-stream 和 iii-observability worker。你没有安装 Postgres、Redis、Express、pm2 或 Prometheus,因为 iii 替代了它们。
这意味着只需多一条命令,就能给 agentmemory 扩展出一整套全新能力。
### 用更多 worker 扩展 agentmemory
agentmemory 需要的内建 worker 已经在 `iii-config.yaml` 中,并随之启动:`iii-state`(KV)、`iii-queue`(事件订阅者的持久重试)、`iii-pubsub`、`iii-cron`、`iii-stream`,以及 `iii-observability`(每个函数的 OTEL trace、指标和日志)。[iii worker 注册表](https://workers.iii.dev) 中的其他任何 worker 都可以接入同一个引擎:把 `iii-config.yaml` 复制到 `~/.agentmemory/iii-config.yaml`(CLI 会优先使用这个文件而不是捆绑的那个,并且仍然会把端口和数据路径渲染进去),加上新条目,用 `~/.agentmemory/bin/iii update worker` 安装一次 worker 运行时,然后重启 agentmemory。
```yaml
workers:
# ...the bundled entries...
- name: database # SQL-backed state adapter when you outgrow the KV defaults
- name: iii-sandbox # run code that came out of memory_recall inside a throwaway VM
- name: mcp # extra MCP servers next to agentmemory's, same engine
```
| Worker | 在 agentmemory 之上获得的能力 |
|---|---|
| [`database`](https://workers.iii.dev/workers/database) | 当默认的内存 KV 不够用时,提供 SQL 支撑的状态适配器 |
| [`iii-sandbox`](https://workers.iii.dev/workers/iii-sandbox) | 从 `memory_recall` 得到的代码在一次性 VM 中运行,而不是在你的 shell 里 |
| [`mcp`](https://workers.iii.dev/workers/mcp) | 在 agentmemory 旁边架设额外的 MCP 服务器,共享同一个引擎 |
在引擎 0.22.x 上,对于上面这些内建 worker 要保留 `iii-` 前缀的名称;不带前缀的 `http`、`state`、`queue`、`pubsub` 和 `cron` 条目,是 agentmemory 在 0.23 迁移中会切换过去的独立注册表 worker。
完整注册表见:[workers.iii.dev](https://workers.iii.dev)。那里的每个 worker 都通过 agentmemory 所用的同样原语组合而成,而你已经拥有的 agentmemory 本身就是其中之一。
### 引擎配置与绑定地址
`agentmemory start` 会按顺序读取第一个存在的引擎配置文件:`AGENTMEMORY_III_CONFIG`、当前目录下的 `./iii-config.yaml`、`~/.agentmemory/iii-config.yaml`,然后才是捆绑的 `iii-config.yaml`。每次启动时,它都会把这个文件(数据路径、端口、状态后端)渲染进 `~/.agentmemory/data/iii-config.runtime.yaml`,并用渲染后的副本启动引擎,所以要编辑源文件,而不是渲染后的文件。源文件中的 `host:` 值会原样保留。
捆绑的 `iii-config.yaml` 故意绑定在 `127.0.0.1` 上,这个默认设置在容器内部也同样适用。在容器中启动的 CLI 监听的是容器自己的回环地址,所以发布出去的端口什么也访问不到。要让容器化的 CLI 通过发布的端口对外提供服务,把 `AGENTMEMORY_III_CONFIG` 设置为一个绑定 `0.0.0.0` 的配置。打包好的 `iii-config.docker.yaml` 就是这样一个配置:它把 `iii-http`、`iii-stream` 和引擎端口都绑定到 `0.0.0.0`,并把状态存储在 `/data` 下,所以要在那里挂载一个可写的卷。保持 `AGENTMEMORY_SECRET` 已设置,并且只在 `127.0.0.1` 上或在你信任的代理之后,发布你真正需要的端口。
这个仓库的 `docker-compose.yml` 不会经过 CLI 的配置查找逻辑:它把 `iii-config.docker.yaml` 挂载到 `/app/config.yaml`,`iii-engine` 容器以 `--config /app/config.yaml` 启动。一键 [部署模板](../deploy/) 会在它们的 entrypoint 中写入各自的 `0.0.0.0` 配置。
### 存储后端:file(默认)对比 redis
`iii-state` 和 `iii-stream` 默认使用 iii-engine 自带的基于文件的 KV 存储:每个作用域一个 JSON 文件,保存在引擎进程的内存中,并按计时器写回磁盘。对于单用户的本地安装,这就是正确的默认值;而一个有多个并发写入者的共享守护进程,则可以改用 Redis 获得真正的按键写入,代价是每次操作都要多一次网络往返(每个 `state::*` 调用仍然串行在同一个 Redis 连接上,所以这换来的是把文件存储的锁换成了一个 socket,而不是换来了并行性)。
设置 `AGENTMEMORY_STATE_BACKEND=redis`(再加上 `AGENTMEMORY_REDIS_URL`),可以把两个 worker 都切换到 iii-engine 内置的 `redis` 适配器,它把每个键存储为一个 Redis 哈希字段(`HSET`),而不是在每次写入时重写整个作用域:
```env
# ~/.agentmemory/.env
AGENTMEMORY_STATE_BACKEND=redis
AGENTMEMORY_REDIS_URL=redis://localhost:6379
```
`AGENTMEMORY_STATE_BACKEND` 默认是 `file`;不设置它会保持现有行为不变,而一个无法识别的值(除 `file` 或 `redis` 之外的任何值)会导致启动错误,而不是悄悄回退。`/agentmemory/status` 和查看器 Health 页面上的 State store 这一行,会报告当前激活的是哪个后端、它是否响应,但绝不会报告 URL。
**只支持普通的 `redis://`。** 锚定的引擎(0.22.1)在构建它的 Redis 客户端时没有加入 TLS 支持,所以一个 `rediss://` URL(大多数托管 Redis 服务,例如 Upstash、Redis Cloud 以及开启传输加密的 ElastiCache,默认都是仅支持 TLS 的)会连接失败。这个连接是未加密的,所以 Redis 密码和每一条存储的记忆都会以明文形式经过网络:请指向一个本地 Redis,或者一个你信任的私有网络上的 Redis。对于其他任何 Redis,在 agentmemory 主机上运行一个加密隧道(stunnel、SSH 或 VPN),这样普通的 `redis://` 这一跳就留在该主机内部,而隧道的上游连接是加密并经过认证的。如果 Redis 密码中包含单引号,要对它做百分号编码(`%27`);引擎会先把 URL 展开进它的 YAML 配置,然后再解析它。
**每个 `--instance` 对应一个 Redis 服务器。** 引擎的 Redis 键前缀(`state:`、`stream::`)是固定的,所以两个指向同一个数据库的 agentmemory 实例(`--instance 1`、`--instance 2` ……)会互相覆盖对方的数据。一个独立的数据库索引(`redis://localhost:6379/1`)可以把存储的数据分开,但引擎是通过一个 Redis pub/sub 频道(`stream::events`)来转发实时查看器事件的,而 Redis 的 pub/sub 会忽略数据库索引,所以每个实例的查看器仍然会看到对方的实时事件。当你运行多个实例时,给每个实例配一个独立的 Redis 服务器(或端口)。
**哪些保持不变,哪些不同。** agentmemory 的每一项功能在 Redis 上都能工作:会话、观测、记忆(remember、supersede、evolve、forget)、搜索和索引桶、经验教训、图、审计日志及其按月的作用域、导出和导入、治理删除、整合状态、查看器快照及其实时流,以及健康监控。引擎把每个作用域存储为一个 Redis 哈希(`HSET`/`HGET`/`HGETALL`),并触发与文件存储相同的状态触发器。agentmemory 内部处理了三个引擎层面的差异:
- Redis 返回一个作用域的记录时没有固定顺序。agentmemory 会按从旧到新排序(先按记录 id 中的创建时间,再按其时间戳),这样列表、分页和导出分块的顺序就和文件存储上的一致。
- 引擎在 Redis 上应用部分更新时使用的 Lua 脚本会把空数组变成空对象。agentmemory 会在 Redis 上自己应用这些更新(在按键加锁的情况下读取、修改、写入),所以像 `tags: []` 这样的字段仍然是数组。
- 旧版审计日志检查会从 Redis 读取旧的作用域,而不是去磁盘上寻找文件存储的文件。
有一个差异需要你自己处理:**Redis 重启后,引擎会停止向查看器转发实时事件**,直到 agentmemory 重启为止。数据仍然正常保存和读取。健康监控每 30 秒会通过 Redis 发送一个测试事件;当它没有收到回应时,`/agentmemory/status` 和查看器的 Health 页面会显示"实时更新没有到达查看器",并给出修复方法:重启 agentmemory。如果 Redis 挂了,状态报告会显示"状态存储没有响应",并说明如何检查(`redis-cli -u "$AGENTMEMORY_REDIS_URL" ping`)。列出一个非常大的作用域会用一次 `HGETALL` 读取整个哈希,代价和文件存储把它整个保存在内存中是一样的。
**推荐的 Redis 设置。** 默认的 `save 3600 1 300 100 60 10000` 快照策略在崩溃时可能丢失几分钟的写入,比文件存储的 5 秒刷盘窗口还要糟。对于任何你不想丢失的内容,设置 `appendonly yes`。设置 `maxmemory-policy noeviction`;`allkeys-lru` 或类似的策略会在 Redis 达到内存上限后悄悄丢弃记忆。
原生(非 Docker)启动,以及每一个一键 [部署模板](../deploy/)(它们会覆盖捆绑的 `iii-config.yaml` 并以原生方式启动),都会读取 `AGENTMEMORY_STATE_BACKEND`/`AGENTMEMORY_REDIS_URL`,并把它们渲染进启动用的 `iii-config`。URL 本身永远不会写进那个渲染后的文件,只会写入一个 `${AGENTMEMORY_REDIS_URL}` 引用,由引擎进程在启动时从自己的环境中展开。只有这个仓库自己的 Docker Compose 路径(`AGENTMEMORY_USE_DOCKER=1`,或者恢复一个已经用这种方式启动的引擎)会以只读方式挂载 `iii-config.docker.yaml` 并且从不渲染;当 `agentmemory start` 检测到这种组合时会发出警告。要手动切换这个文件,遵循 [iii-state](https://workers.iii.dev/workers/iii-state) 和 [iii-stream](https://workers.iii.dev/workers/iii-stream) worker 文档中展示的同样的 `name: redis` / `config: redis_url: ...` 形状,并把 `redis_url` 指向容器能访问到的 Redis。`docker-compose.yml` 会把 `AGENTMEMORY_REDIS_URL` 传进引擎容器,所以 `redis_url: '${AGENTMEMORY_REDIS_URL}'` 在那里是有效的,并且能让 URL 不出现在挂载的文件里。
渲染后的配置不会把 URL 写进 `~/.agentmemory/data/iii-config.runtime.yaml`,但引擎自己的配置 worker 一旦启动,仍然会把*展开后*的值持久化到 `~/.agentmemory/config/iii-state.yaml` 和 `iii-stream.yaml`(iii-engine 的 `${VAR}` 展开发生在该 worker 存储它的种子数据之前,它存储的是解析后的值,而不是引用)。在任何共享主机上,都要把这个目录当作保存着凭据来对待:执行 `chmod 700 ~/.agentmemory`,并且优先使用一个仅限于 agentmemory 所需权限的 Redis ACL 用户,而不是数据库的管理员凭据。
**迁移不是自动的。** 切换 `AGENTMEMORY_STATE_BACKEND` 会让两边都从一个空存储开始;不会把已有数据从 file 复制到 Redis,反过来也不会。从你要离开的后端导出,再导入到你要迁移到的后端。下面这段在 bash 和 zsh 下(包括 `bash -u`)运行结果完全一致。而类似 `AUTH=(${AGENTMEMORY_SECRET:+-H "Authorization: Bearer $AGENTMEMORY_SECRET"})` 这样的数组写法则不行:zsh 会把这个头保留成一个格式错误的单词,而 bash 会把它拆成两个,所以只要设置了 `AGENTMEMORY_SECRET`,两边的请求都会 401:
```bash
# 0. Use the generated secret when none is exported:
AGENTMEMORY_SECRET="${AGENTMEMORY_SECRET:-$(cat ~/.agentmemory/secret 2>/dev/null)}"
# 1. On the old backend, while agentmemory is still running on it:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" http://localhost:3111/agentmemory/export > backup.json
else
curl -fsS http://localhost:3111/agentmemory/export > backup.json
fi
# 2. Confirm backup.json is a usable export before switching backends:
jq -e '.version and .exportedAt' backup.json > /dev/null || {
echo "backup.json is not a valid export; do not switch backends" >&2
exit 1
}
# 3. Switch AGENTMEMORY_STATE_BACKEND (and AGENTMEMORY_REDIS_URL if needed),
# restart agentmemory against the new backend, then:
if [ -n "${AGENTMEMORY_SECRET:-}" ]; then
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -H "Authorization: Bearer $AGENTMEMORY_SECRET" -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
else
jq -n --slurpfile d backup.json '{exportData: $d[0], strategy: "merge"}' | \
curl -fsS -X POST http://localhost:3111/agentmemory/import \
-H 'Content-Type: application/json' -d @-
fi
```
`/agentmemory/export` 还接受 `?maxSessions=` 和 `?offset=`,用于把一个大语料库拆分成多次调用;导入时的 `strategy` 可以是 `merge`(默认且安全)、`replace` 或 `skip`。
### iii 替代了什么
| 传统技术栈 | agentmemory 使用的方案 |
|---|---|
| Express.js / Fastify | iii HTTP Triggers |
| SQLite / Postgres + pgvector | iii KV State + 内存向量索引 |
| SSE / Socket.io | iii Streams (WebSocket) |
| pm2 / systemd | iii engine worker 监管 |
| Prometheus / Grafana | iii OTEL + 健康监控 |
| Custom plugin systems | `iii worker add ` |
**219 个源文件 · ~52,000 行代码 · 2,500+ 个测试 · 311 个函数 · 60 个 KV 作用域**,全部基于三种原语。没有 `agentmemory plugin install`。插件系统就是 iii 本身。
---

### LLM 提供者
agentmemory 会从你的环境中自动检测提供者。配置好提供者后,由 LLM 支撑的操作才可用,但仅仅配置提供者并不会启用 LLM 撰写的观测压缩。这条路径需要同时满足:一个提供者,以及 `AGENTMEMORY_AUTO_COMPRESS=true`。
| 提供者 | 配置 | 备注 |
|----------|--------|-------|
| **No-op(默认)** | 无需配置 | LLM 支撑的压缩/摘要被禁用。合成压缩和 BM25 召回仍然能用。如果你之前依赖 Claude 订阅回退,见下方的 `AGENTMEMORY_ALLOW_AGENT_SDK`。 |
| Anthropic API | `ANTHROPIC_API_KEY` | 按 token 计费 |
| MiniMax | `MINIMAX_API_KEY` | 兼容 Anthropic |
| Gemini | `GEMINI_API_KEY` | 同时启用嵌入 |
| OpenRouter | `OPENROUTER_API_KEY` | 任意模型 |
| OpenAI API | `OPENAI_API_KEY` | 默认 `gpt-5.6-luna`,用 `OPENAI_MODEL` 覆盖 |
| **本地(Ollama / LM Studio / vLLM / llama.cpp)** | `OPENAI_API_KEY=local` + `OPENAI_BASE_URL=http://localhost:11434/v1`(Ollama)或 `http://localhost:1234/v1`(LM Studio) + `OPENAI_MODEL=` | 任何兼容 OpenAI API 的服务。零成本,运行在你自己的硬件上。见下方的 [本地模型](#local-models-ollama--lm-studio--vllm)。 |
| Claude 订阅回退 | `AGENTMEMORY_ALLOW_AGENT_SDK=true` | 仅限主动开启。会派生 `@anthropic-ai/claude-agent-sdk` 会话;它曾导致无限制的 Stop-hook 递归,所以已不再是默认选项。 |
### 本地模型(Ollama / LM Studio / vLLM)
agentmemory 可以与任何兼容 OpenAI API 的服务器通信,所以任何暴露了 `/v1/chat/completions` 的服务都无需改代码即可使用。不需要付费密钥,不需要云端,没有速率限制;完全运行在你自己的硬件上。
**Ollama**(默认端口 `11434`):
```bash
ollama pull qwen3:8b # or qwen3:4b, gpt-oss:20b, qwen3-coder:30b, etc.
ollama serve
```
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=ollama # any non-empty string; Ollama ignores it
OPENAI_BASE_URL=http://localhost:11434/v1
OPENAI_MODEL=qwen3:8b
```
**LM Studio**(默认端口 `1234`):
打开 LM Studio → Local Server 标签页 → Start Server。从选择器中挑一个聊天模型(Qwen 3、gpt-oss、DeepSeek R1 等)。
```env
# ~/.agentmemory/.env
OPENAI_API_KEY=lmstudio # any non-empty string; LM Studio ignores it
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_MODEL=qwen3-8b # match the model name from LM Studio
```
**vLLM / llama.cpp / Text Generation Inference**:形状相同。把 `OPENAI_BASE_URL` 指向你的服务器暴露出的任何 URL,并把 `OPENAI_MODEL` 设置为你的服务器能接受的名称。
**适合记忆任务的模型选择**:压缩和摘要是短任务(输入 <2K tokens,输出 <500 tokens),一个 7B 的 instruct 模型就足够了。推荐:
| 模型 | 大小 | 理由 |
|-------|------|-----|
| `qwen3:8b` | ~5.2 GB | 在 16 GB 机器上均衡的默认选择;擅长抽取和工具形态的文本 |
| `qwen3:4b` | ~2.6 GB | 最小的可用选项;压缩足够,图抽取较弱 |
| `qwen3-coder:30b` | ~19 GB | 在 24-32 GB 硬件上,针对代码形态会话的最佳本地选择(30B MoE,激活 3.3B) |
| `gpt-oss:20b` | ~14 GB | 适合 16 GB 内存的强力通用模型 |
| `deepseek-r1:8b` | ~5.2 GB | 推理蒸馏模型;更慢但抽取更干净 |
Qwen 3 模型默认会思考,可能在给出任何输出之前就把整个 token 预算都耗在推理上。设置 `AGENTMEMORY_LLM_NOTHINK=1`,给图抽取的提示词追加 `/no_think`;如果抽取结果为空,就调高 `MAX_TOKENS`(16384 可行)。
推理类模型(`o1` 风格,带 `` 代码块)可能返回空的 `content`,而把推理内容放在一个你的本地服务器可能不会暴露出来的 `reasoning` 字段里。如果抽取结果为空,先换成一个非推理模型试试。`OPENAI_REASONING_EFFORT=none` 这个环境变量也可以在那些模仿 OpenAI 推理 schema 的 Ollama Cloud 思考模型上关闭思考过程。
本地嵌入作为一个可选依赖发布,但默认不启用。设置 `EMBEDDING_PROVIDER=local` 来启用 `Xenova/all-MiniLM-L6-v2`(384 维)。首次嵌入请求会下载模型;之后的推理在本地设备上进行。如果不设置这个选项,也没有远程嵌入密钥,向量就会保持关闭,`mem::search` 使用 BM25,而 `smart-search` 仍然可以加上既有的图匹配结果。
### 成本感知的模型选择
当同时配置了提供者并设置 `AGENTMEMORY_AUTO_COMPRESS=true`、启用了 LLM 撰写的后台压缩后,它会在每一条观测上运行,所以模型的选择会实质性地改变每月的花费。实测的工作负载数据:635 次请求 / 888K tokens / 35 小时的活跃使用,针对三个 OpenRouter 模型按 2026-05-23 的定价运行。
| 档位 | 模型 | 输入 / 1M | 输出 / 1M | 实测 35 小时的成本 | 备注 |
|------|-------|------------|-------------|---------------------------|-------|
| 推荐 | `deepseek/deepseek-v4-flash-0731` | $0.07 | $0.14 | ~$0.07(估算) | 最新的 DeepSeek;压缩工作负载中最便宜的推荐选择。 |
| 推荐 | `deepseek/deepseek-v4-pro` | $0.435 | $0.87 | ~$0.46 | 压缩 + 摘要质量扎实,成本比 Sonnet 低约 10 倍。 |
| 推荐 | `qwen/qwen3-coder` | $0.45 | $1.80 | ~$0.55 | 如果你的会话大量是代码形态,这个模型的代码推理能力很强。 |
| 高端 | `anthropic/claude-sonnet-5` | $3.00 | $15.00 | ~$5.02(估算) | 与实测的 Sonnet 4.6 运行同样的标价;到 2026-08-31 前有 $2/$10 的首发价。 |
| 高端 | `openai/gpt-5.6-sol` | $5.00 | $30.00 | ~$9(估算) | 旗舰档位;对于常驻的后台任务来说偏贵。 |
| 避免 | `anthropic/claude-opus-5` | $5.00 | $25.00 | ~$8.40(估算) | 旗舰级模型;用于压缩是过度花费。 |
带实测数据的行来自实际捕获的运行;标(估算)的行则是用相同的 token 比例按各模型的标价推算得出。
agentmemory 会在 `OPENROUTER_MODEL` 匹配高端档位的模式时打印一条运行时警告。一旦你已经做出了知情的选择,可以设置 `AGENTMEMORY_SUPPRESS_COST_WARNING=1` 来消除它。
记忆任务上质量与成本的权衡:压缩是一个摘要任务,质量要求相对宽松(重新读取摘要的是代理,不是用户)。DeepSeek V4 Flash / V4 Pro / Qwen3-Coder 在这个任务上的表现与 Sonnet 的差距几乎可以忽略,而成本却低 10-70 倍。把高端档位的模型留给你会亲自阅读的查询。
来源:[OpenRouter 上 Claude Sonnet 5 的定价](https://openrouter.ai/anthropic/claude-sonnet-5)、[DeepSeek V4 Flash](https://openrouter.ai/deepseek/deepseek-v4-flash-0731)、[DeepSeek 定价说明](https://api-docs.deepseek.com/quick_start/pricing/)。
### 多代理记忆(`AGENT_ID` + `AGENTMEMORY_AGENT_SCOPE`)
在多代理场景中,多个角色共享一个 agentmemory 服务器(architect / developer / reviewer / researcher / support-agent),`AGENT_ID` 会给每一次写入打上发起该写入的角色标签。`AGENTMEMORY_AGENT_SCOPE` 控制召回是否按这个标签过滤。
```env
TEAM_ID=company
USER_ID=engineering-team
AGENT_ID=architect
AGENTMEMORY_AGENT_SCOPE=isolated # optional; default "shared"
```
两种模式:
| 模式 | 标记写入 | 过滤召回 | 何时使用 |
|------|------------|---------------|--------------|
| `shared`(默认) | 是 | 否 | 带审计轨迹的跨代理上下文。Architect 可以看到 developer 记录的内容,但每一行都会记录是谁说的。 |
| `isolated` | 是 | 是 | 严格隔离。Architect 永远看不到 developer 的观测 / 记忆 / 会话。 |
设置 `AGENT_ID` 后会被打标的内容:`Session.agentId`、`RawObservation.agentId`、`CompressedObservation.agentId`、`Memory.agentId`。角色沿着 `api::session::start` → `mem::observe` → `mem::compress` → KV 这条路径流动。
隔离模式下会被过滤的内容:`mem::smart-search`、`/agentmemory/memories`、`/agentmemory/observations`、`/agentmemory/sessions`。每个端点都接受 `?agentId=` 来按请求覆盖,也接受 `?agentId=*` 来完全跳出环境变量设定的作用域。`/memories` 还接受 `?includeOrphans=true`,用于显示那些在引入 AGENT_ID 之前创建、`agentId` 未定义的记忆。
在 SDK / REST 层按调用覆盖:每个变更型端点(`/session/start`、`/remember`)都接受请求体中的 `agentId` 字段,它会优先于环境变量。这对于把多个角色路由进同一个服务器进程的运行时很有用。MCP 的 `memory_save` 工具暴露了同样的 `agentId` 字段,独立的 stdio 服务器会转发 `agentId` 和 `project` 这两个字段,保存的记忆会把 `agentId` 带入搜索索引,所以按代理作用域的搜索既覆盖记忆,也覆盖观测。
当 `AGENT_ID` 未设置时,记忆保持无作用域(旧版行为,没有标签,没有过滤)。
### 端口
agentmemory + iii-engine 默认绑定四个端口。如果重启时失败并提示 `port in use`,下面这张表会告诉你该查找哪个进程。
| 端口 | 进程 | 用途 | 环境变量覆盖 |
|------|---------|---------|--------------|
| `3111` | agentmemory | REST API + MCP HTTP + `/agentmemory/health` + `/agentmemory/livez` | `III_REST_PORT` |
| `3112` | iii-engine | 内部流 worker(由 agentmemory + 查看器消费) | `III_STREAM_PORT`(推荐)或旧版的 `III_STREAMS_PORT` |
| `3113` | agentmemory | 实时查看器(`http://localhost:3113`) | `III_VIEWER_PORT`,或 `AGENTMEMORY_VIEWER_URL` 用于设置报告的 URL |
| `49134` | iii-engine | WebSocket;worker 在这里注册,OTel 遥测数据经由它流动 | `III_ENGINE_PORT` 或 `III_ENGINE_URL` |
`--port ` 会改变 REST 的锚点端口,并在上面对应的显式端口或 URL 未设置的情况下,推导出流端口 `N+1`、查看器端口 `N+2`,以及引擎 WebSocket 端口 `N+46023`。它不会创建一个隔离的生命周期命名空间。要启动第二个守护进程,使用 `--instance 1`;它使用锚点 3211,默认为 `3211/3212/3213/49234`,并获得一个独立的 `instance-1` 数据和生命周期目录。实例 1 到 50 都遵循同样的模式。
锚定的引擎以 `--no-update-check` 启动(启动时不会向 GitHub 查询更新或安全公告),并关闭了 iii 的匿名使用遥测:除非你自己导出了这个变量,agentmemory 会为它派生的引擎设置 `III_TELEMETRY_ENABLED=false`,捆绑的 compose 文件做法相同。
当进程崩溃后端口仍被占用时的清理方法:
```bash
# macOS / Linux — find whatever is on each port and kill it
lsof -i :3111,3112,3113,49134
pkill -f agentmemory || true
pkill -f 'iii ' || true
# Windows
netstat -ano | findstr ":3111 :3112 :3113 :49134"
taskkill /F /PID
```
`agentmemory stop` 在优雅的原生关闭过程中,会干净地回收 worker 和引擎的 pidfile。在 Docker 模式下,它会清空原生 worker,停止那个经过验证的确切引擎容器,并保留容器及其 `/data` 挂载,以便实现无损重启;下次启动时会验证并恢复同一个容器。基于 Docker 的卸载需要 `agentmemory remove --keep-data`:它会移除 agentmemory 管理的共享文件,同时保留经过验证的容器、其数据挂载,以及恢复它们所需的生命周期记录。具有破坏性的 Docker 数据删除,有意留给操作者在备份之后自行执行。除非传入 `--force`,CLI 也拒绝把 Docker 或 VM 的端口占用者(Docker backend、vpnkit、colima)当作原生引擎来接管或发信号。上面的手动清理方法只适用于崩溃后两个 pidfile 都不存在的情况。
### 配置文件
把 agentmemory 的运行时配置放进 `~/.agentmemory/.env`,而不是在每个 shell 中单独导出变量。如果查看器显示了一个类似 `export ANTHROPIC_API_KEY=...` 的设置提示,把它复制进这个文件,写成 `ANTHROPIC_API_KEY=...`,去掉 `export` 前缀,然后重启 agentmemory。
进程环境变量仍然有效,并且优先于文件中的值。
在 Windows 上,同样的文件位于 `%USERPROFILE%\.agentmemory\.env`:
```powershell
New-Item -ItemType Directory -Force $HOME\.agentmemory
notepad $HOME\.agentmemory\.env
```
如果要用 Claude Code Pro/Max 订阅而不是 API key 来测试,需要显式开启:
```env
AGENTMEMORY_ALLOW_AGENT_SDK=true
AGENTMEMORY_AUTO_COMPRESS=true
```
LLM 撰写的观测压缩需要同时满足这两行:能访问一个 LLM 提供者(包括这个显式的订阅回退),以及 `AGENTMEMORY_AUTO_COMPRESS=true`。仅配置提供者本身,会保留默认的合成压缩路径。
只要配置了 LLM 提供者,整合(图节点、经验教训、crystal)就默认开启。如果你想要无 LLM 运行,显式设置 `CONSOLIDATION_ENABLED=false` 来关闭。图抽取是一个单独的开关:
```env
GRAPH_EXTRACTION_ENABLED=true
# CONSOLIDATION_ENABLED=false # opt out of auto-consolidation
```
### 环境变量
创建 `~/.agentmemory/.env`:
```env
# LLM provider (pick one — default is the no-op provider: no LLM calls)
# ANTHROPIC_API_KEY=sk-ant-...
# ANTHROPIC_BASE_URL=... # Optional: Anthropic-compatible proxy / Azure
# GEMINI_API_KEY=...
# OPENROUTER_API_KEY=...
# MINIMAX_API_KEY=...
# OPENAI_API_KEY=*** # NOTE: this same key auto-activates BOTH the
# # OpenAI LLM provider (here) AND the OpenAI
# # embedding provider (further below). Set
# # OPENAI_API_KEY_FOR_LLM=false to scope it
# # to embeddings only.
# OPENAI_BASE_URL=https://api.openai.com # Optional: override for Azure / vLLM / LM Studio / proxies
# # Azure: https://.openai.azure.com/openai/deployments/
# # Auto-detected from `.openai.azure.com` hostname; uses
# # api-key header + api-version query param.
# OPENAI_API_VERSION=2024-08-01-preview # Optional: Azure api-version query param
# OPENAI_MODEL=gpt-5.6-luna # Optional: default model
# OPENAI_TIMEOUT_MS=60000 # Optional: OpenAI-scoped alias for the outbound fetch
# # timeout. Takes precedence over AGENTMEMORY_LLM_TIMEOUT_MS
# # for back-compat with v0.9.17. New configs should
# # prefer the global AGENTMEMORY_LLM_TIMEOUT_MS below.
# OPENAI_REASONING_EFFORT=none # Optional: "low" | "medium" | "high" | "none"
# # Honored only by OpenAI's reasoning models (o1, o3,
# # gpt-*-reasoning) and providers that mirror that
# # schema (Ollama Cloud thinking models). Standard
# # chat models reject this field with 400. Set to
# # "none" for thinking models that return reasoning
# # but no content.
# OPENAI_API_KEY_FOR_LLM=false # Optional: set to false to skip OpenAI auto-detection
# # for LLM (useful if you only want OpenAI for embeddings)
# Opt-in Claude-subscription fallback (spawns @anthropic-ai/claude-agent-sdk);
# leave OFF unless you understand the Stop-hook recursion risk:
# AGENTMEMORY_ALLOW_AGENT_SDK=true
# Embedding provider (BM25-only when unset; local is an explicit opt-in)
# EMBEDDING_PROVIDER=local
# VOYAGE_API_KEY=...
# OPENAI_API_KEY=sk-...
# OPENAI_BASE_URL=https://api.openai.com # Override for Azure / vLLM / LM Studio / proxies
# OPENAI_EMBEDDING_MODEL=text-embedding-3-small
# OPENAI_EMBEDDING_DIMENSIONS=1536 # Required when the model is not in the known-models table
# OPENAI_EMBEDDING_BASE_URL=https://... # Embeddings only; falls back to OPENAI_BASE_URL
# OPENAI_EMBEDDING_API_KEY=sk-... # Embeddings only; wins over OPENAI_API_KEY when set
# Outbound LLM / embedding timeout
# AGENTMEMORY_LLM_TIMEOUT_MS=60000 # Default: 60 000 ms (60 s). Applies to every
# raw-fetch provider (Gemini, OpenRouter, MiniMax,
# OpenAI LLM, OpenAI/Cohere/Voyage/OpenRouter
# embedding). For the OpenAI LLM path, the
# OpenAI-scoped OPENAI_TIMEOUT_MS alias (above)
# takes precedence when set, for back-compat
# with v0.9.17.
# Increase for slow networks or large batch calls;
# decrease to fail-fast on rate-limit holds.
# Search tuning
# BM25_WEIGHT=0.4
# VECTOR_WEIGHT=0.6
# TOKEN_BUDGET=2000
# Auth (generated into ~/.agentmemory/secret on first start when unset)
# AGENTMEMORY_SECRET=your-secret
# VIEWER_ALLOWED_ORIGINS=https://memory.example.com
# AGENTMEMORY_IMPORT_ROOT=~/projects
# Ports (defaults: 3111 API, 3113 viewer)
# III_REST_PORT=3111
# Engine usage telemetry (iii). Off unless you set it; true opts in.
# III_TELEMETRY_ENABLED=false
# Features
# AGENTMEMORY_AUTO_COMPRESS=false # OFF by default. Requires an LLM
# provider as well. When both are on,
# every PostToolUse hook calls your
# LLM provider to compress the
# observation — expect significant
# token spend on active sessions.
# AGENTMEMORY_SLOTS=false # OFF by default. Editable pinned
# memory slots — persona,
# user_preferences, tool_guidelines,
# project_context, guidance,
# pending_items, session_patterns,
# self_notes. Size-limited; agent
# edits via memory_slot_* tools.
# Pinned slots addressable for
# SessionStart injection.
# AGENTMEMORY_REFLECT=false # OFF by default. Requires SLOTS=on.
# Stop hook fires mem::slot-reflect:
# scans recent observations, auto-
# appends TODOs to pending_items,
# counts patterns in
# session_patterns, records touched
# files in project_context. Fire-
# and-forget; does not block.
# AGENTMEMORY_INJECT_CONTEXT=false # OFF by default. When on:
# - SessionStart may inject ~1-2K
# chars of project context into
# the first turn of each session
# (this is what actually reaches
# the model — Claude Code treats
# SessionStart stdout as context)
# - PreToolUse fires /agentmemory/enrich
# on every file-touching tool call
# (resource cleanup, not a token
# fix — PreToolUse stdout is debug
# log only per Claude Code docs)
# Observations are still captured via
# PostToolUse regardless of this flag.
# GRAPH_EXTRACTION_ENABLED=false
# AGENTMEMORY_LLM_NOTHINK=1 # Local reasoning models only: ask the
# model to skip its hidden thinking pass
# during graph extraction. Faster runs;
# relation quality can drop slightly.
# CONSOLIDATION_ENABLED=false # on by default when an LLM provider is configured
# LESSON_DECAY_ENABLED=true
# OBSIDIAN_AUTO_EXPORT=false
# AGENTMEMORY_EXPORT_ROOT=~/.agentmemory
# CLAUDE_MEMORY_BRIDGE=false
# SNAPSHOT_ENABLED=false
# Storage and durability
# AGENTMEMORY_STATE_BACKEND=file # file (default) or redis; see "Storage backend" below
# AGENTMEMORY_REDIS_URL=redis://localhost:6379 # Required with redis, plain redis:// only
# AGENTMEMORY_STATE_SAVE_INTERVAL_MS=2000 # How often the engine writes file state to disk.
# A hard kill loses at most this window.
# AGENTMEMORY_INDEX_SAVE_INTERVAL_MS=600000 # Minimum time between search index saves;
# shutdown and deletes still save at once.
# AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=true # One-time background trim of oversized graph
# provenance; false skips it
# Sessions
# AGENTMEMORY_SESSION_SWEEP_ENABLED=true # Hourly sweep marks sessions left active past
# the threshold as abandoned. Deletes nothing;
# new activity makes the session active again.
# AGENTMEMORY_SESSION_SWEEP_STALE_HOURS=24
# Capture filters (hooks)
# AGENTMEMORY_CAPTURE_ALLOW= # Comma or space list of tool names or globs;
# when set, only these tools are captured
# AGENTMEMORY_CAPTURE_DENY= # Extra names or globs to skip, added to the
# defaults: memory_*, toolsearch,
# listmcpresources, fetchmcpresource
# AGENTMEMORY_CAPTURE_OUTPUT_MAX=8000 # Max characters of tool output per observation
# AGENTMEMORY_PRE_COMPACT_BUDGET=1500 # Token budget for PreCompact context; 0 disables
# Audit log
# AGENTMEMORY_AUDIT_RETENTION_MONTHS=0 # Drop month scopes older than N months; 0 keeps all
# AGENTMEMORY_AUDIT_INDEX_PERSIST=false # 1 or true records index migration and cleanup
# rows (debugging only)
# Team
# TEAM_ID=
# USER_ID=
# TEAM_MODE=private
# Tool visibility: "all" (54 tools, default) or "core" (8 tools, lean)
# AGENTMEMORY_TOOLS=core
```
---

端口 `3111` 上有 138 个端点。REST API 默认绑定到 `127.0.0.1`。受保护的端点需要 `Authorization: Bearer `,mesh 同步端点则需要双方都显式设置 `AGENTMEMORY_SECRET`。
**身份验证默认是开启的。** 当 `AGENTMEMORY_SECRET`(在 shell 或 `~/.agentmemory/.env` 中)没有设置时,服务器会在首次启动时生成一个随机密钥,并以 `0600` 权限存储在 `~/.agentmemory/secret` 中。每个捆绑的客户端在与本地服务器通信时都会从那里读取它:CLI、查看器、`plugin/scripts` 下的 hooks、MCP 服务器和 `@agentmemory/mcp` shim、由 `agentmemory connect` 写入的配置,以及捆绑的 OpenCode、Pi、OpenClaw、Hermes 和文件系统监视集成。存储的密钥只会发送到回环地址(`localhost`、`127.0.0.0/8`、`::1`)。显式设置的 `AGENTMEMORY_SECRET` 始终优先,远程客户端仍然需要设置它。Docker 和 `deploy/` 的 entrypoint 已经会生成并导出自己的密钥。要手动调用 API:
```bash
curl -H "Authorization: Bearer $(cat ~/.agentmemory/secret)" http://localhost:3111/agentmemory/health
```
**写入请求的规则。** 对 REST API 和查看器发出的 `POST`、`PUT`、`PATCH` 和 `DELETE` 请求,只要带有请求体,就必须发送 `Content-Type: application/json`(带 `charset` 参数也可以),而 `Origin` 头(如果存在)必须是配置的 REST 或查看器端口对应的回环源,或者列在 `VIEWER_ALLOWED_ORIGINS` 中(逗号分隔,例如 `https://memory.example.com`)。不发送 `Origin` 头的客户端(CLI、hooks、MCP、curl、服务器到服务器)不受影响。查看器也接受它自己的源。
**文件路径。** 读写文件的端点(`/compress-file`、`/replay/import-jsonl`、`/graph/import-graphify`)只接受 `~/.agentmemory`、实例数据目录,或 `AGENTMEMORY_IMPORT_ROOT` 中列出的目录下的路径(多个目录用 `:` 分隔,Windows 上用 `;`)。`/replay/import-jsonl` 还接受它默认的 `~/.claude/projects`。`/obsidian/export` 只能在 `AGENTMEMORY_EXPORT_ROOT` 内,`/migrate` 只能在 `~/.agentmemory` 内。每次检查之前都会先解析符号链接。
**密钥清理。** 在每一条写入路径上——观测、remember、evolve、槽位、经验教训、动作、sketch、信号、检查点、导入、jsonl 重放、mesh 同步、团队共享、压缩和摘要输出、crystal 和图节点——API 密钥、bearer token、PEM 私钥代码块以及嵌入在 URL 中的凭据(`scheme://user:password@host`)在文本存储之前都会被遮蔽。
关键端点
| 方法 | 路径 | 描述 |
|--------|------|-------------|
| `GET` | `/agentmemory/health` | 健康检查(始终公开) |
| `GET` | `/agentmemory/status` | 哪里出了问题以及如何修复(浏览器访问返回 HTML,否则返回 JSON) |
| `GET` | `/agentmemory/viewer/snapshot` | 查看器展示的一切,打包在一次响应中 |
| `POST` | `/agentmemory/session/start` | 开始会话 + 获取上下文 |
| `POST` | `/agentmemory/session/end` | 结束会话 |
| `POST` | `/agentmemory/observe` | 捕获观测(见下方的捕获投递) |
| `GET` | `/agentmemory/capture` | 捕获收件箱、死信和离线队列 |
| `POST` | `/agentmemory/capture/retry` | 重试死信捕获 |
| `POST` | `/agentmemory/capture/drain` | 立即发送本地离线队列 |
| `POST` | `/agentmemory/smart-search` | 混合搜索 |
| `POST` | `/agentmemory/context` | 生成上下文 |
| `POST` | `/agentmemory/remember` | 保存到长期记忆 |
| `POST` | `/agentmemory/forget` | 删除观测 |
| `POST` | `/agentmemory/enrich` | 文件上下文 + 记忆 + bug |
| `GET` | `/agentmemory/profile` | 项目档案 |
| `GET` | `/agentmemory/export` | 导出所有数据 |
| `POST` | `/agentmemory/import` | 从 JSON 导入 |
| `POST` | `/agentmemory/graph/query` | 知识图谱查询 |
| `POST` | `/agentmemory/graph/compact` | 裁剪过大的图溯源数据 |
| `POST` | `/agentmemory/team/share` | 与团队共享 |
| `GET` | `/agentmemory/audit` | 审计轨迹 |
完整端点列表:[`src/triggers/api.ts`](../src/triggers/api.ts)
**捕获投递。** Hooks 会把每条观测连同一个 `eventId` 发送一次到 `POST /agentmemory/observe`。当负载中自带一个 id 时(例如 Claude Code 的 `tool_use_id`),就用宿主自己的这个 id;否则就用会话、hook 类型、工具名、输入、输出和宿主时间戳计算出的一个哈希值。服务器会把这个事件写入状态存储中的一个捕获收件箱,存储这条观测,然后移除收件箱条目。状态码说明了发生了什么:
| 状态码 | `status` 字段 | 含义 |
|---|---|---|
| `201` | `accepted` | 已存储。`observationId` 就是这条新观测。 |
| `202` | `accepted`(`state: "retrying"`) | 已接受,但存储失败。服务器会重试它,重启后也会重试。 |
| `200` | `duplicate` | 这个 `eventId` 已经被接受过了。`observationId` 是那条既有的观测;不会存储任何新内容。 |
| `400` / `422` | `rejected` | 负载无效,或存储彻底失败(该事件会作为死信保留)。 |
| `503` | `rejected`(`retryable: true`) | 收件箱已满(`AGENTMEMORY_CAPTURE_INBOX_MAX`)。Hooks 会把事件存入队列,稍后再发送。 |
失败的事件会每隔 `AGENTMEMORY_CAPTURE_RETRY_INTERVAL_MS`(10 秒)以倍增退避的方式重试,最多重试 `AGENTMEMORY_CAPTURE_MAX_ATTEMPTS`(5)次。仍然失败的事件会作为死信留在收件箱中,会在 `/agentmemory/status` 和查看器的 Health 页面上列出,并可以用 `POST /agentmemory/capture/retry`(`{"eventId": "..."}` 或 `{"all": true}`)重试。已接受的事件 id 会被记住 `AGENTMEMORY_CAPTURE_DEDUP_HOURS`(168 小时,最多 `AGENTMEMORY_CAPTURE_EVENTS_MAX` 个 id),所以超时或重启后重放的一次 hook 只会被存储一次,而两次各自带有自己宿主 id 的独立工具调用,即使内容完全相同,也会被存储两次。当一条观测被删除时(forget、删除会话、驱逐、自动遗忘,或是一次替换整个存储的导入),它的事件会在观测被移除之前先被标记为已删除,所以在同一个时间窗口内重放那个事件,会被当作重复事件来回应,不会存储任何内容。状态存储每 2 秒写一次磁盘,所以一个已经应答的事件可能仍然只存在于内存中片刻。为了覆盖这种情况,每个 `2xx` 应答都会附带服务器的 `bootId`(每次启动都是新的)、`acceptedAt` 和 `durableAfterMs`(保存间隔加上文件存储的 1.5 秒,或 redis 上的 1.5 秒,持久化本身是操作者的设置)。Hooks 会把事件留在本地队列中,直到这个时间窗口过去,然后在之后的某次调用中删除它,而不需要再发一次请求。如果到那时 `bootId` 已经变化,说明服务器重启过了,于是 hook 会用同一个 `eventId` 再发送一次这个事件;已经到达磁盘的事件不会被存储两次。服务器自己也会在启动时以及每个重试周期发送这类事件,所以即使之后没有任何 hook 运行,重启也不会丢失任何内容。旧版 hooks 会忽略这些额外字段,而针对旧版服务器的新版 hooks,仍然会像以前一样在 `2xx` 时丢弃该事件。
当服务器宕机、没有及时应答,或返回 5xx 时,hook 会把观测追加到一个本地队列文件 `/capture-spool/-.jsonl` 中(用 `AGENTMEMORY_CAPTURE_SPOOL_DIR` 覆盖这个文件夹)。这个文件只对你的用户私有(权限 600),密钥会按服务器同样的方式被遮蔽,它最多容纳 `AGENTMEMORY_CAPTURE_SPOOL_MAX_BYTES`(5 MiB),并会丢弃超过 `AGENTMEMORY_CAPTURE_SPOOL_MAX_AGE_HOURS`(168)的条目。当它满了之后,新条目会被丢弃并计数,`/agentmemory/status` 会报告这一情况。当服务器健康时,hook 仍然会在它的时间限制内退出 0,并且不会增加任何请求。队列会在下次启动时,以及由第一个重新连接到服务器的 hook,在一个后台进程中发送,这样代理就不需要等待。事件 id 让这一切是安全的:一条确实在超时之前到达的观测不会被存储两次。`npx @agentmemory/agentmemory capture` 会显示队列和服务器收件箱,`--drain` 会立即发送队列,`GET /agentmemory/capture` 会以 JSON 返回同样的信息。设置 `AGENTMEMORY_CAPTURE_SPOOL=false` 可以关闭队列。
**压缩图溯源数据。** 每个知识图谱节点和边都保留着它所来自的最新 32 条观测的 id。在这个上限生效之前写入的存储,每个热点节点可能保存着数千个 id,这会让图搜索和查看器变慢,甚至拖垮 worker。agentmemory 会自己修复这个问题:升级后的第一次启动,它会在后台把每个节点、边、被取代的边(时间性图历史)以及缓存的快照都裁剪到这个上限,分成小批次执行,批次之间有间隔,这样搜索、捕获和查看器都能继续工作。它会保存进度,重启后继续,一旦完成就再也不会运行。`/agentmemory/status` 和查看器的 Health 页面会把它显示为待处理、运行中(带当前作用域和位置)、已完成或已失败。设置 `AGENTMEMORY_GRAPH_COMPACT_ON_BOOT=false` 可以关闭它。
要手动运行它,调用 `POST /agentmemory/graph/compact`。它会遍历名称和边键索引,而不是列出每一个节点和边,并且可以安全地重复运行。当它裁剪 id 时,会写入一条 `graph_compact` 审计条目。
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{}'
```
对于一个很大的存储,或者当调用返回 504 时,分批运行它。发送 `scope`(`nodes`、`edges` 或 `history`)、`offset` 和 `limit`,然后用返回的 `nextOffset` 再次调用,直到它变成 `null`。对 `nodes`、`edges` 和 `history` 都这样做,最后用一次 `{"scope":"snapshot"}` 调用收尾,因为分批运行不会触及缓存的快照。
```bash
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"nodes","offset":0,"limit":200}'
curl -X POST http://localhost:3111/agentmemory/graph/compact -H "Content-Type: application/json" -d '{"scope":"snapshot"}'
```
---

```bash
npm run dev # Hot reload
npm run build # Production build
npm test # 2,500+ tests
npm run test:integration # API tests (requires running services)
```
**前置条件:** Node.js >= 20,带 npm/npx;[iii-engine](https://iii.dev/docs) v0.22.1 或 Docker。macOS/Linux 的自动引擎安装还需要 `curl`、POSIX `sh` 和 `tar`;原生 Windows 使用手动安装的锚定 `iii.exe`、WSL2,或 Docker Desktop。

[Apache-2.0](../LICENSE)


